RAP:基于人工海报范例声明式标注的论文转海报生成数据集 RAP: A Dataset for Paper-to-Poster Generation via Declarative Markup from Human-Crafted Exemplars
构建2.5万对论文-海报-HTML三元组,让海报生成成为可验证的视觉编码任务
前置知识
视觉编码
指多模态模型把视觉输入转写为可执行代码的任务族,典型如截图转 HTML(Design2Code)、图表转绘图代码(Plot2Code)。它的关键特征是输出可运行、可渲染,因而能用确定性手段(渲染后与原图对比)客观验证正确性,而不必依赖人工清单或裁判模型的主观打分。
本文的核心主张是把论文转海报归入视觉编码:海报被反渲染成 HTML,保真度靠渲染-对比来度量。理解这一框架才能明白数据集为何以'论文-海报-标记'三元组为基本单元。
反渲染
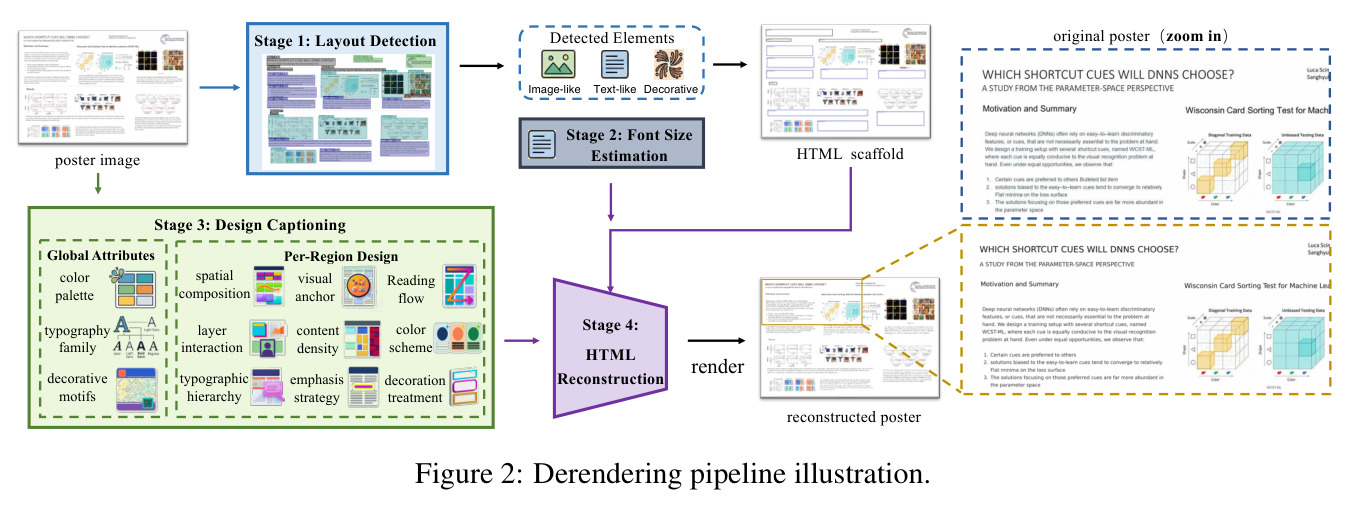
把一张成品海报(或网页截图)逆向工程为结构化、可编辑的声明式标记(HTML/CSS)的过程,通常包含布局检测、文字识别与字号估计、样式推断、代码重建四个环节,产物应能重新渲染出接近原图的页面,且其中每个元素都可寻址、可修改。
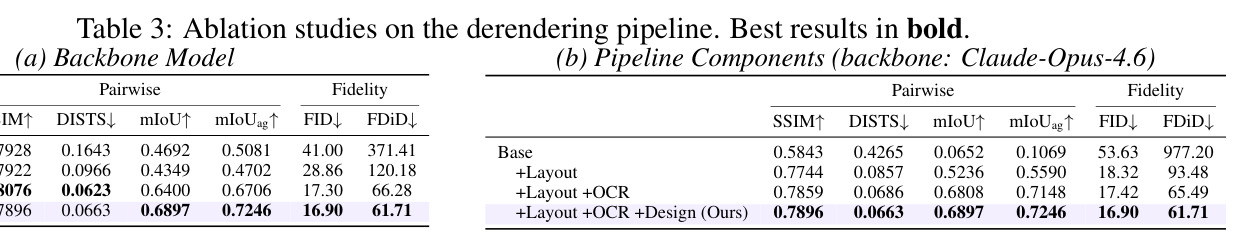
RAP 的数据构建完全依赖反渲染管线,'类型化可回填槽位'这一核心抽象由它产生,Table 3 的骨干与组件消融评估的正是这条管线,它是全文数据质量的根基。
FID 与 FDiD
Fréchet Inception Distance 用预训练 InceptionV3 的特征统计生成图像分布与真实分布之间的 Fréchet 距离,数值越低表示越接近真实分布;FDiD 把特征骨干换成 DINOv2,对布局几何与视觉结构更敏感。两者都在分布层面统计,不需要逐对配准。
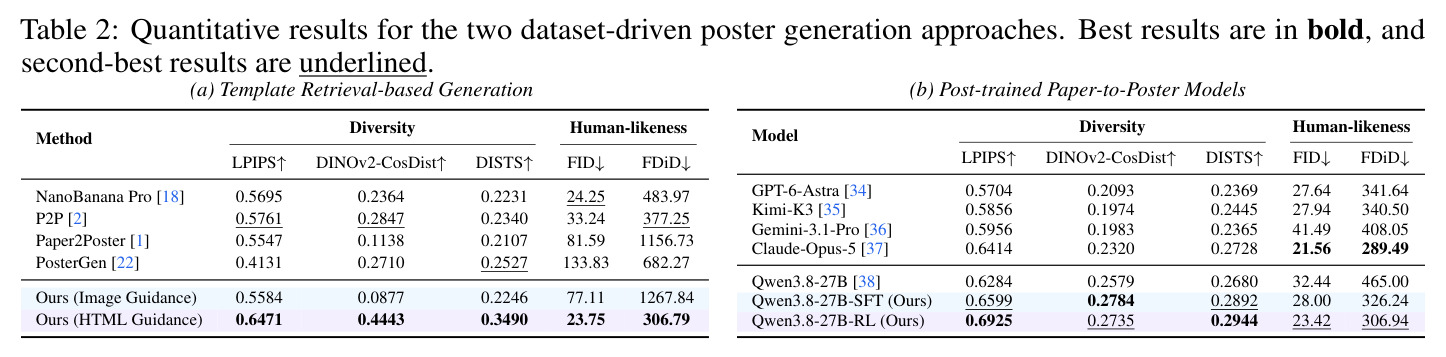
论文用这两个指标衡量生成海报与 2.5 万张人类海报集合的分布相似度(human-likeness),是 Table 2 两大主实验的核心结论指标,方向是越低越好。
GRPO 与可验证奖励
Group Relative Policy Optimization 是一种在线强化学习算法:对同一提示采样一组候选输出,用组内相对优势估计代替价值网络来更新策略,常与可验证奖励(如代码能否运行、规则检查是否通过)配合用于代码与推理任务的后训练。
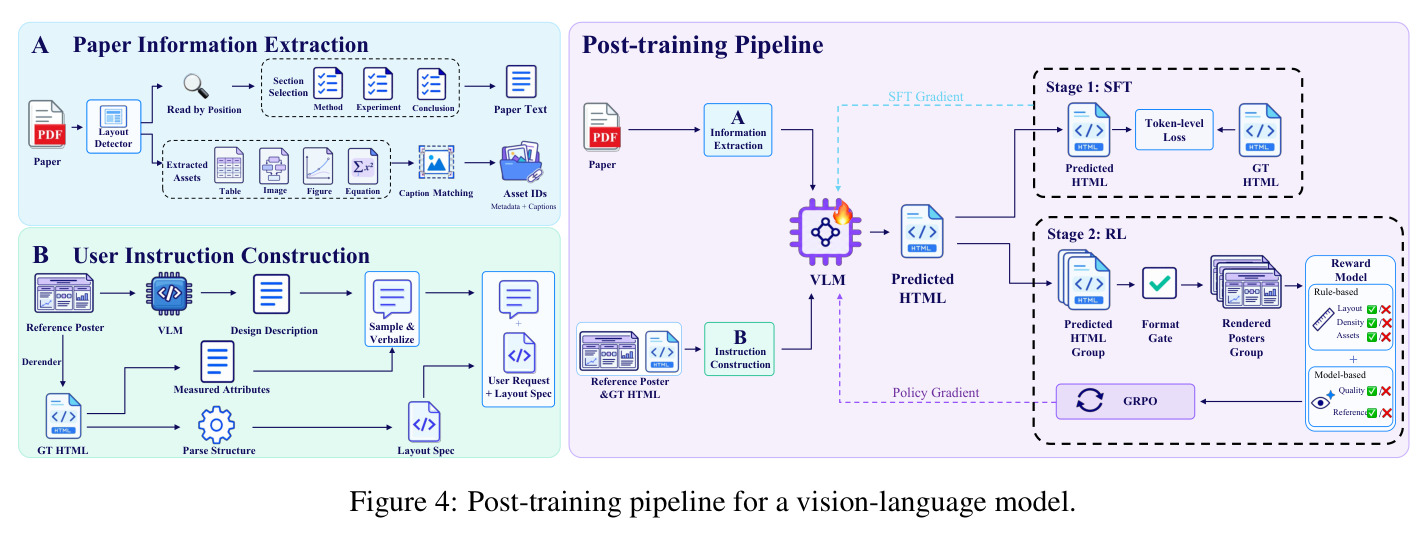
论文用 GRPO 对 Qwen3.8-27B 做渲染感知的强化学习,奖励由有效性门控、规则检查与 VLM 评估加权构成,理解 GRPO 才能看懂 Figure 4 与奖励公式的设计。
检索增强生成(RAG)
生成之前先从外部库中检索相关样例或模板,将其作为上下文注入或直接作为生成骨架,从而继承库中已有的知识与风格、降低凭空编造。典型实现是级联式检索:先粗过滤缩小候选集,再重排,最后择优。
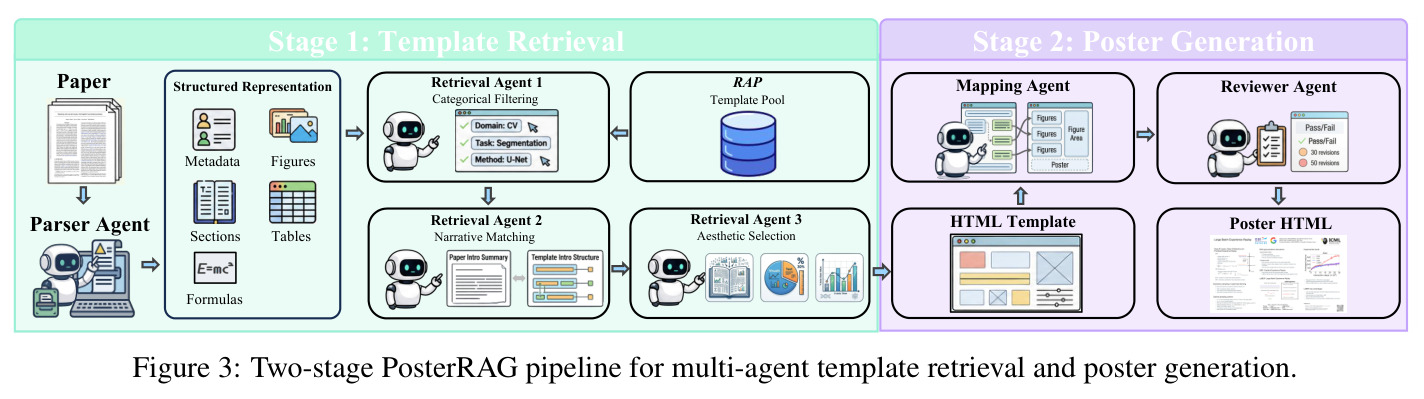
PosterRAG 是数据集的免训练应用:ParserAgent 加三级检索智能体(分类过滤、叙事匹配、美学选择)从 RAP 模板池中选模板,随后只回填内容不改样式,是标准的 RAG 思路在设计领域的迁移。
LPIPS 与 DISTS
两个基于深度特征的感知图像距离:LPIPS 用 AlexNet 特征衡量感知层面的差异,DISTS 用 VGG 特征兼顾结构与纹理。本文反向使用它们作多样性指标——对测试集上生成的海报两两计算距离再取均值,数值越高表示生成结果彼此差异越大、越不千篇一律。
多样性是本文两大评测轴之一,Table 2 中 LPIPS、DINOv2-CosDist、DISTS 三列越高越好,而 FID/FDiD 越低越好,搞混方向会误读实验结论。
研究动机
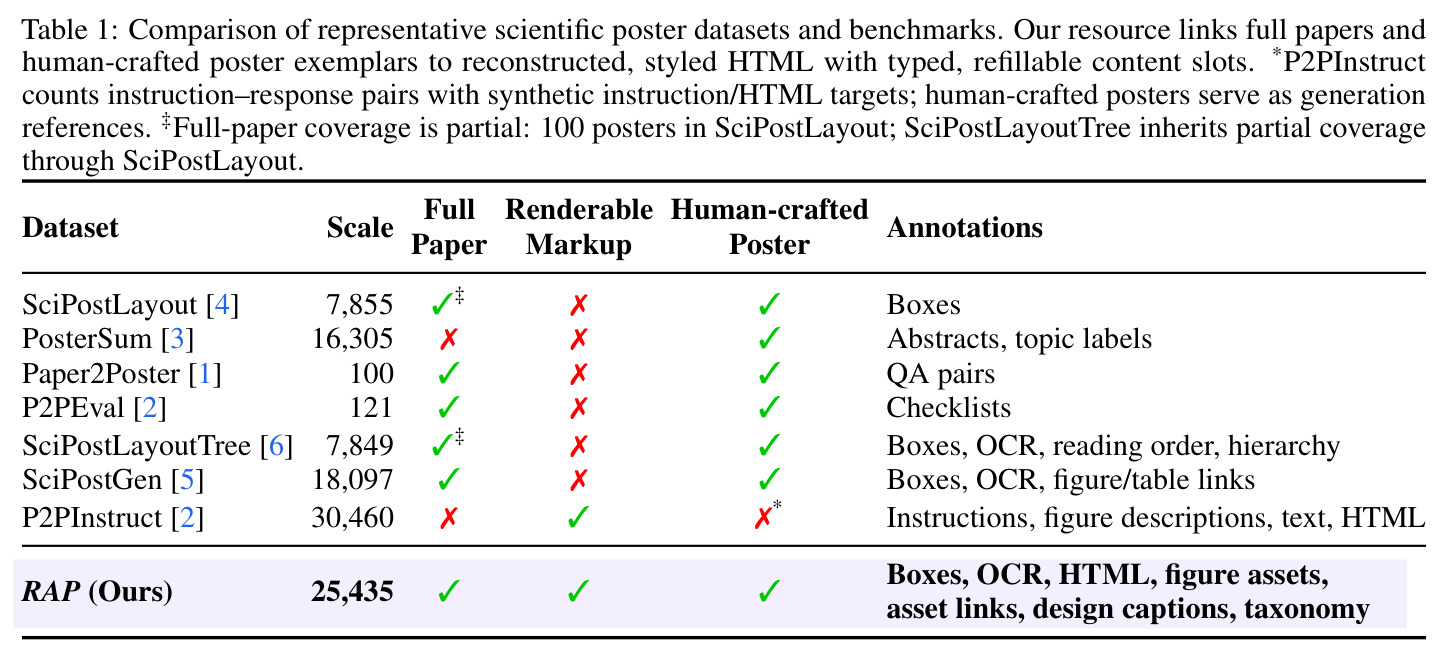
自动把一篇完整论文压缩成一张会议海报,是总结、视觉设计与代码实现三种能力的综合考验,但这一任务长期缺乏可靠的评测与训练资源。现有基准规模小且标注浅:Paper2Poster 仅提供 100 对论文-海报,P2PEval 121 对,PosterSum 的 16,305 对只配摘要而非全文,SciPostGen 虽有 18,097 对但只有布局框级标注,SciPostLayout 的 7,855 张海报中也只有 100 篇配了全文。由于缺少可渲染的标注,评测只能退而求其次地依赖 VLM 打分或人工清单这类主观、昂贵且不可复现的方式,无法做客观的渲染-对比验证。方法层面,主流管线从零生成布局,人工设计的海报完全没有被利用;P2PInstruct 的 30,460 条指令数据里的 HTML 目标是模型合成的,并非源自真实人类作品。结果是这个领域既没有可复用的人类设计库,也没有经过验证的训练监督信号。
本文的目标是本文要把'论文转海报'重新定义为一项视觉编码任务,并为其补齐缺失的资源基础。具体目标有三:其一,构建迄今最大的论文-海报数据集 RAP(Reconstruct A Poster),包含 25,435 对经核验的配对,覆盖 NeurIPS、ICML、ICLR 2022–2026 年的论文,附带 15 领域、20 任务、39 方法的三级分类体系,以及 150 篇保留测试论文(每个领域 10 篇、各配真实人类海报)的基准;其二,开发全自动反渲染管线,把每张光栅海报转写成带类型化、可回填槽位的 HTML/CSS,使每个样本都是'论文-海报-标记'三元组,可以通过渲染后与原图直接对比来客观验证;其三,用同一份语料同时支撑推理与训练两个阶段:免训练的 PosterRAG 检索管线负责推理期复用设计,SFT+RL 后训练配方负责把三元组变成监督信号,证明人类设计既是可复用的设计库,也是可靠的训练参考。
与已有工作不同的是,本文的独特切入在于'反渲染'视角:不把人类海报当作等待被超越的对象,而是先将其逆向工程为可编辑、可验证的声明式标记,再让生成系统直接继承专业设计。与既有视觉编码基准相比,海报任务的输入是整篇长文而非单屏截图,输出是空间受限、信息密集的设计,难度结构完全不同,RAP 首次让这一任务的输出可以在整个语料规模上做渲染-对比验证,而不是只在少数精挑样例上。与 PPTAgent 从少量手工幻灯片中僵化填充不同,RAP 提供了两万五千级的人类设计库,并用消融证明以反渲染出的 HTML 脚手架(而非参考图像)作为生成约束,能同时提升多样性和分布层面的'人类相似度',这回答了'声明式标记本身是否携带设计信息'这一此前无人验证的问题。
核心方法
整体思路分三层。直觉上,既然顶会人工海报本身就是高质量设计,最稳妥的做法是'复用而不是凭空发明':先把海报逆向成结构化 HTML,生成时检索最合适的模板并只替换内容、不动布局与样式。技术上分三步。第一步数据构建:通过 OpenReview 抓取 2022–2026 年 NeurIPS(11,256 对)、ICLR(8,504 对)、ICML(5,675 对)共 25,435 对核验配对,附三级分类标注与蒸馏引言摘要。第二步反渲染管线四阶段:LayoutLMv3 检测布局元素并归类,PaddleOCR 估计字号,MLLM 生成结构化设计描述,最后重建为带槽位的 HTML。第三步是两个应用:免训练的 PosterRAG 多智能体检索管线,负责从模板池选模板并确定性回填;以及对 Qwen3.8-27B 先做监督微调、再做 GRPO 强化学习的后训练配方,其中奖励由渲染验证驱动,规则奖励与 VLM 奖励按 0.4/0.6 加权,把数据集变成可验证奖励的来源。
核心创新是'类型化可回填槽位'的三元组表示。每个反渲染出的 HTML 中,内容块都是可寻址、带类型、可替换的槽位:图像类与装饰类区域直接从原图裁剪并嵌入为 元素,文本类块留空并预注 OCR 量得的字号作为样式约束。它与已有工作的本质区别有三点。一是验证方式:PosterSum、SciPostGen 等只给框级标注,无法渲染复现,而 RAP 的每个样本都能渲染后与原图直接对比,验证是确定性的、可在 2.5 万规模上执行。二是监督来源:P2PInstruct 的 HTML 由模型合成,RAP 的标记全部逆向自人类作品,构成真实接地(human-grounded)的'论文-海报-代码'监督。三是双重用途:同一份槽位化表示,推理期充当设计库——MappingAgent 只改 innerHTML 与 src、完全不碰布局与样式,实现零损伤继承人类设计;训练期充当 SFT 目标与 RL 的参考奖励来源,一次构建、两种用途。
方法步骤详情
数据收集:从 OpenReview 获取论文 PDF/LaTeX、海报文件与元数据,配对得 25,435 对,附 15 领域/20 任务/39 方法分类标签与引言摘要。反渲染四阶段:阶段一微调 LayoutLMv3 检测元素并归入文本类/图像类/装饰类;阶段二对文本框跑 PaddleOCR 并按行分组,以 font_size = (h_bbox / n_lines) × 0.8 估计 CSS 字号;阶段三 MLLM 仅看原图,输出调色板等全局属性与九个区域级设计维度;阶段四程序化生成绝对定位 HTML 脚手架,MLLM 读图回填文本与 CSS。PosterRAG:ParserAgent 解析论文,检索级联依次做分类过滤、叙事匹配、美学评分(三个 1–5 维度,无偏好取中点)选出模板,MappingAgent 确定性回填槽位,ReviewerAgent 迭代修图。后训练:构造 $X_{\text{paper}}$ 与 $X_{\text{instruction}}$ 两路输入,先 SFT 再 GRPO,奖励 $R_i = g(H_i)[\lambda_r R_{\text{rule}}(H_i) + \lambda_v R_{\text{vlm}}(I_i, I^\star)]$,$\lambda_r{=}0.4$、$\lambda_v{=}0.6$,规则奖励查布局裁切重叠、密度与资产引用,模型奖励评渲染质量与参考相似性。
技术新颖性
新颖性体现在四个层面。任务层:首次将论文转海报确立为输出可大规模验证的视觉编码基准,把评测范式从 VLM 主观打分改为渲染-对比的客观度量,解决了可复现性问题。表示层:反渲染产物不是扁平 HTML,而是带设计描述与类型槽位的声明式标记,'槽位'抽象使内容替换与样式保持可以解耦,这是 MappingAgent 能零损伤继承人类设计的前提,也是与 P2PInstruct 模型合成 HTML 的根本分野。监督层:RL 奖励中的 $R_{\text{vlm}}$ 直接以参考海报 $I^\star$ 为条件,把数据集本身变成可验证奖励的供给方,属于参考引导的 RLVR 在文档级设计任务上的少见应用;规则奖励则利用渲染 DOM 的确定性测量(裁切、重叠、密度)防止模型删内容或缩字体的投机行为。实证层:消融证明 HTML 引导显著优于图像引导(FID/FDiD 从 77.11/1267.84 降至 23.75/306.79,DINOv2-CosDist 从 0.0877 升至 0.4443),说明声明式结构本身携带了关键的设计约束信息,而不只是内容的载体。
实验结果
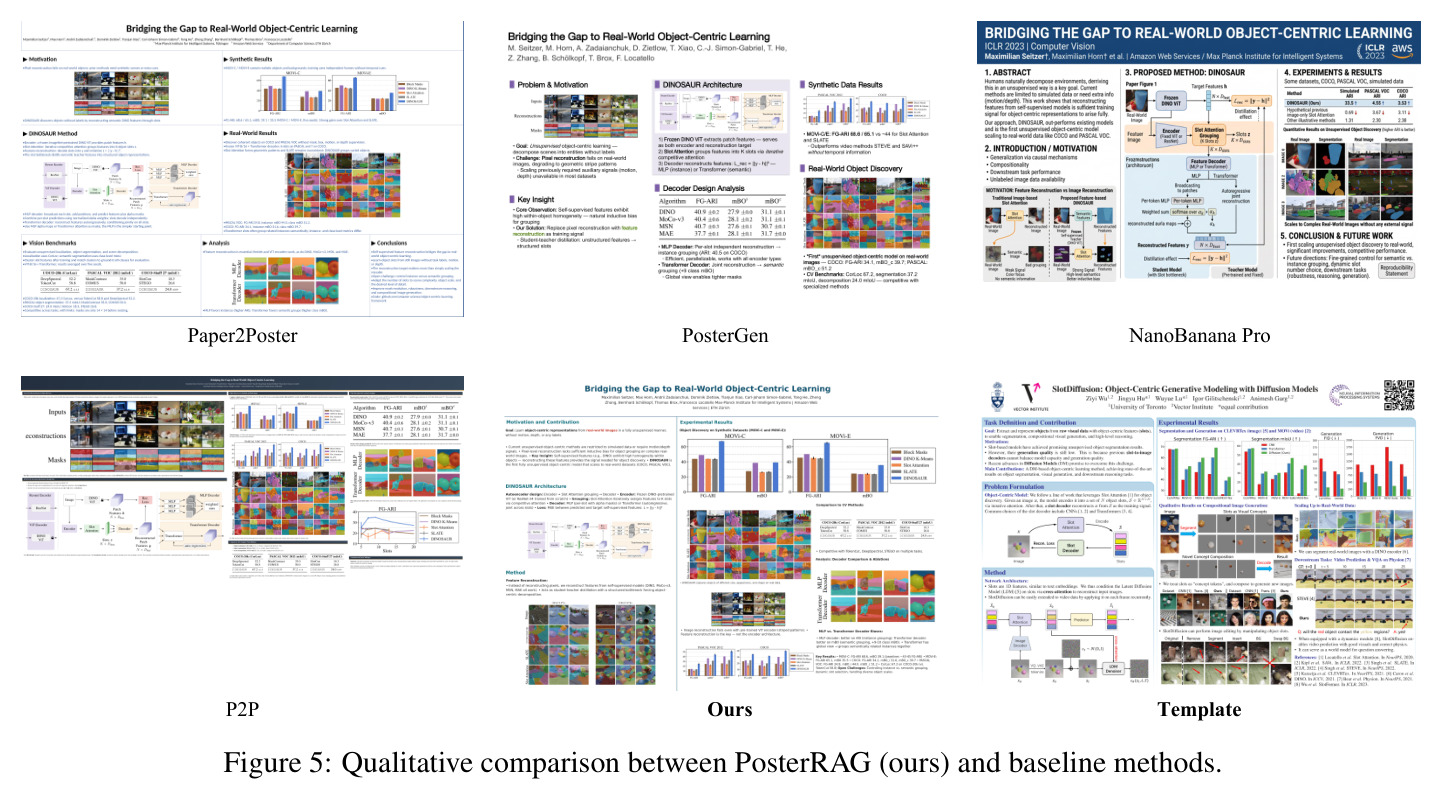
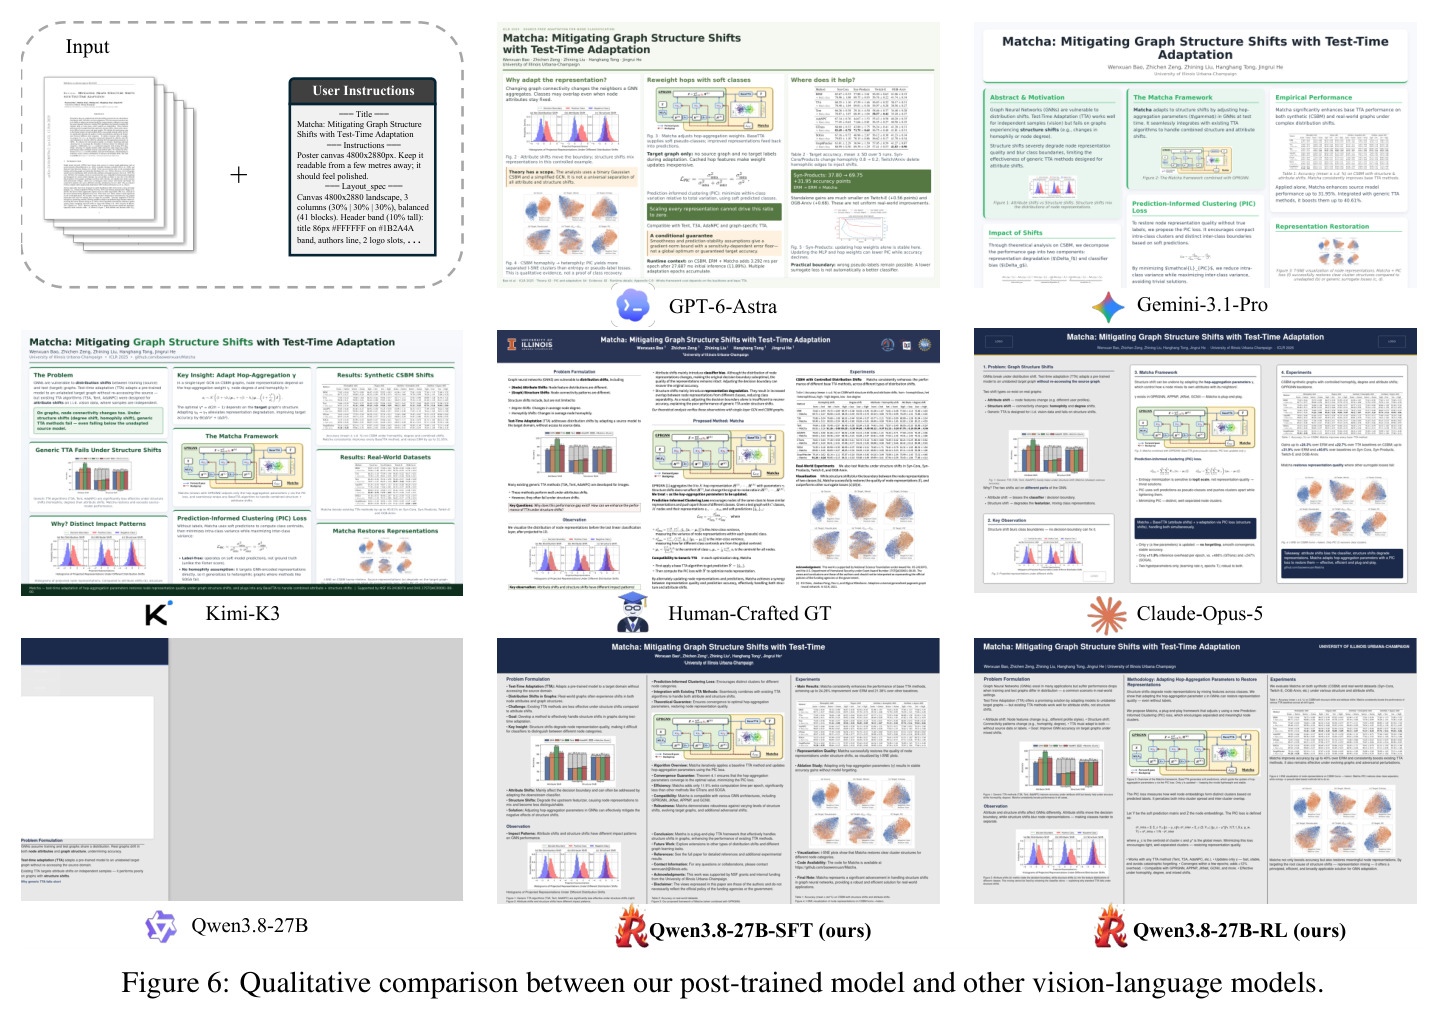
五组实验互相印证。生成评测(Table 2a,150 篇保留测试集):PosterRAG 的 HTML 引导版五项指标全第一,FID 23.75、FDiD 306.79,FDiD 比最佳基线 P2P(377.25)低 18.7%,DINOv2-CosDist 0.4443 远超 P2P 的 0.2847;图像引导版 FID/FDiD 仅 77.11/1267.84,反证 HTML 约束的必要性。后训练(Table 2b):SFT 使 Qwen3.8-27B 五项指标全面优于基座(FDiD 465.00→326.24),RL 再把 FID/FDiD 从 28.00/326.24 降到 23.42/306.94,取得最高 LPIPS 0.6925 与 DISTS 0.2944,FID/FDiD 仅次于 Claude-Opus-5(21.56/289.49)。反渲染骨干消融(Table 3a):Claude-Opus-4.6 布局与分布保真最优,SSIM 0.7896、mIoU 0.6897、FDiD 61.71;Gemini-3.1-Pro 在 SSIM 0.8076 上领先。组件消融(Table 3b):基线 mIoU 仅 0.0652,加布局检测跃升至 0.5236(最大贡献),加 OCR 至 0.6808,加设计描述至 0.6897,FDiD 从 977.20 降至 61.71。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 论文转海报(PosterRAG 模板检索) | FID / FDiD(与人类海报的分布距离,越低越好) | 23.75 / 306.79(HTML Guidance) | P2P 33.24 / 377.25;NanoBanana Pro 24.25 / 483.97;Paper2Poster 81.59 / 1156.73 | FDiD 较最佳基线 P2P 降低 18.7%,FID 为全表最低 |
| 论文转海报(PosterRAG 模板检索) | DINOv2-CosDist(语义多样性,越高越好) | 0.4443 | P2P 0.2847;PosterGen 0.2710;Paper2Poster 0.1138 | 较最佳基线 P2P 提升约 56%,并同步取得最高 LPIPS 0.6471 与 DISTS 0.3490 |
| 论文转海报(后训练模型) | FID / FDiD(分布相似度,越低越好) | 23.42 / 306.94(Qwen3.8-27B-RL) | Claude-Opus-5 21.56 / 289.49;基座 Qwen3.8-27B 32.44 / 465.00 | 较基座 FID 降低 27.7%、FDiD 降低 34.0%,总体仅次于 Claude-Opus-5 |
| 海报反渲染(重建保真) | SSIM / mIoU / FDiD | 0.7896 / 0.6897 / 61.71(Claude-Opus-4.6 骨干) | GPT-4o 0.7928 / 0.4692 / 371.41;Gemini-3.1-Pro 0.8076 / 0.6400 / 66.28 | 布局 mIoU 较 GPT-4o 提升 47%,FDiD 全场最优 |
| 反渲染管线组件消融 | 布局 mIoU(类感知,越高越好) | 0.6897(Layout + OCR + Design 完整管线) | 无约束基线 0.0652 | 布局检测贡献最大(+0.4584),OCR 再 +0.1572,设计描述再 +0.0089,FDiD 从 977.20 降至 61.71 |
局限与改进
作者承认的局限:反渲染保真度并非完美,SSIM 0.79、布局 mIoU 0.69 意味着相当一部分结构信息在转写中丢失或被近似,这些误差会传导给检索模板与 RL 参考奖励;数据仅覆盖 ML 三大会 2022–2026 年,跨领域泛化未知;正文只报告多样性与分布相似度两类指标,没有给出内容忠实度或可读性的人类评测。我的补充观察:其一,FID/FDiD 度量分布层面的'像人类',可能奖励风格噪声而非真正的好设计,DINOv2-CosDist 高也不必然等于对用户有用的多样性;其二,RL 的 VLM 奖励由 Gemini-3.8-Flash 打分,评测者与被评对象之间的偏差与可收买性风险未讨论;其三,150 篇的测试基准偏小,指标方差的置信区间未知;其四,会议海报的版权与再分发许可未见说明,可能影响数据集的实际可用边界;其五,端到端对比中所有方法统一换用 Claude-Opus-4.6 做智能体调用,但检索模板池本身来自同一数据集,存在对基线不完全对利的疑问。
独立分析的弱点
弱点一:反渲染误差级联。布局检测 mIoU 只有 0.69,检测错误的框会固化为错误槽位,而 PosterRAG 的设计原则恰恰是'不改布局',于是会原样继承这些缺陷。改进方向:在反渲染阶段加入渲染反馈的自修复循环,或对同一海报生成多个重建候选并做一致性筛选。弱点二:模板检索是整张单选而非区块组合,当论文内容与任何模板的版式容量都不匹配时(例如图表数量差异大),MappingAgent 只能硬塞或删除内容。改进方向:支持跨模板的区块级拼装,或学习模板间的布局插值。弱点三:领域封闭。三级分类限定在 15 个 ML 领域,检索级联第一步就是分类过滤,面对医学、社科等论文时会直接失效。改进方向:开放词表检索,或先做跨领域模板的对比预训练。弱点四:评测缺少内容忠实度维度——生成海报里的结论、数字是否真的来自输入论文,目前只靠 VLM 奖励里的 faithfulness 项间接约束,而科学传播场景里这比美观更关键。改进方向:增加基于论文全文的自动事实验证指标。
未来方向
作者提出的方向:进一步提升反渲染质量,使重建结果更接近像素级真值;扩展 RL 奖励中模型评估的维度覆盖;对指令条件生成做更细粒度的用户偏好建模。基于成果可延伸的方向:其一,把 RAP 从静态数据集升级为'设计检索即服务',同一'长文压缩到固定画布'的表示可直接迁移到论文转幻灯片、转信息图、转封面图等同构任务;其二,利用数据收集时已经获取的 LaTeX 源码做矢量级反渲染,绕过光栅检测的误差下限;其三,把 PosterRAG 的确定性回填与后训练模型组合成混合系统——检索定骨架、模型填细节并做局部重排,可能同时吃到免训练管线的分布相似性和训练模型的指令遵循能力;其四,在 RL 之外引入人类偏好对齐(如以可读性评分构造 DPO 数据),直接优化人眼阅读体验;其五,把 150 篇基准扩展为随会议年度滚动更新的常设评测榜,配合渲染验证维持长期客观性。
复现评估
复现条件较好但成本不低。开源情况:论文承诺发布数据集、反渲染管线、代码库与在线演示(reconstruct-a-poster.github.io),25,435 对三元组、三级分类标注与 150 篇测试集是核心资产。算力与费用需求:反渲染 2.5 万张海报依赖 Claude-Opus-4.6 级别的 MLLM,每张至少经历布局、描述、重建三次以上强模型调用,API 成本按数据集规模线性增长;后训练需要在 Qwen3.8-27B 上做 SFT 加 GRPO 采样与渲染,需多卡集群,且 VLM 奖励还要持续调用 Gemini-3.8-Flash。难度评估分两档:下游使用者复现 PosterRAG 只需检索与确定性回填,无训练成本、门槛低;要复现 RL 部分则需重写规则奖励的 DOM 测量逻辑(裁切、重叠、覆盖率、资产校验),工程量中等,且奖励超参($\lambda_r = 0.4$、$\lambda_v = 0.6$)未必迁移友好。整体上,渲染-对比验证天然确定、可重复,是该工作最利于复现的设计选择。
论文图表
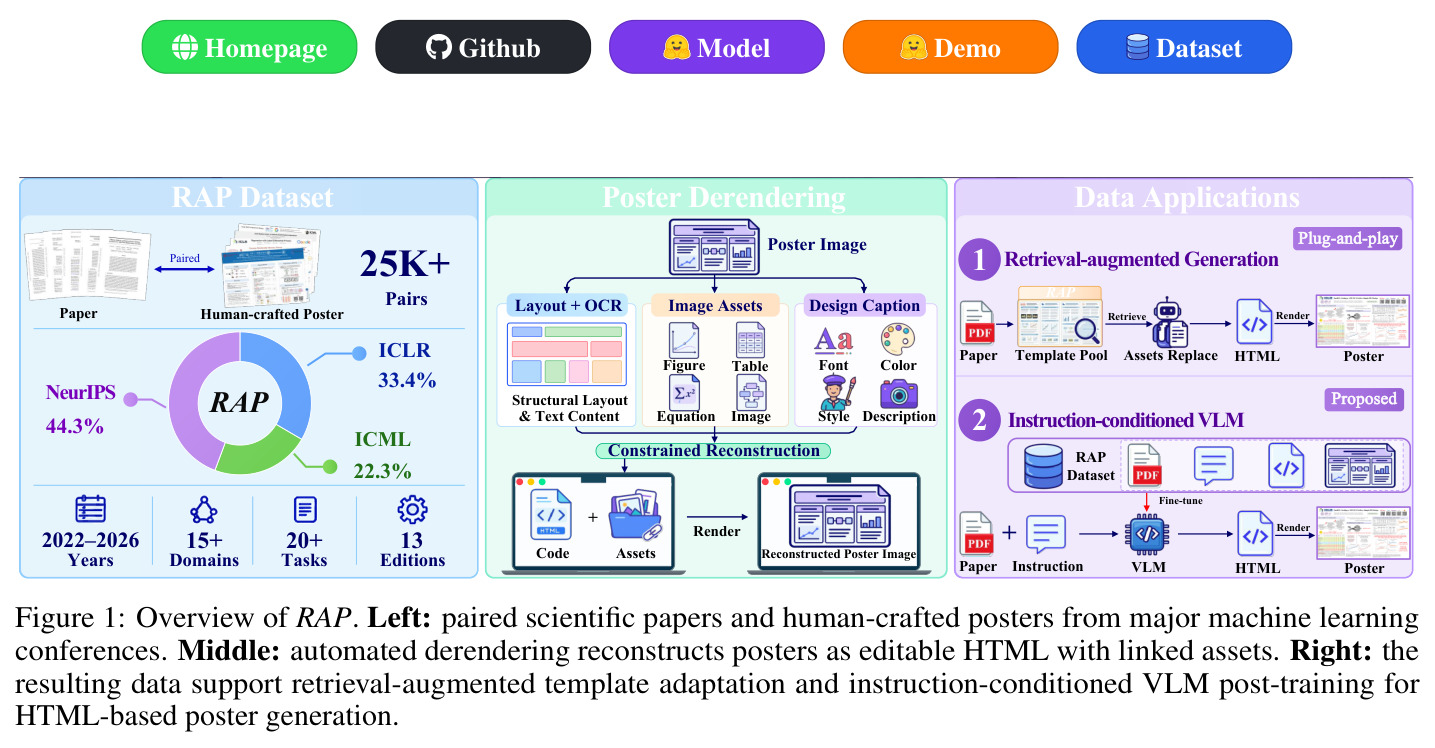
总览图分三块:左侧是从主流 ML 会议收集的论文与人工海报配对(25K+ 配对,含 22.3%/33.4%/44.3% 的 ICLR/NeurIPS/ICML 占比示意);中间是自动反渲染流程,把海报经布局与 OCR 重建为带资产链接的可编辑 HTML;右侧是数据支撑的两大应用——检索增强的模板适配(RAP 检索、资产替换、渲染成海报)和指令条件 VLM 后训练(论文加指令输入 VLM 输出 HTML),并标注覆盖 2022–2026、15+ 领域、20+ 任务、13 种任务用途等统计。
一图总览'收集-反渲染-双应用'的完整闭环和关键数字,是理解全文叙事结构的地图,读论文其他部分时应随时回来对照。