nanoMuse:装进你每台设备的开源个人智能体 nanoMuse: An Open-Source Personal Agent for Every Device You Own
nanoMuse:把完整个人智能体装进每台设备,开源、带屏幕之手与 Sentinel 审批门控
前置知识
个人智能体(Personal Agent)
与一次性任务型 agent 不同,个人智能体是长期为同一个人服务的程序:在其账户、设备与文件上代其行动,跨周记忆其偏好与事实,值得时会主动先开口,并以日志、账本与权限清单对其所为负责。它是一种软件形态而非一个模型。
全文围绕'个人智能体应该是什么、由谁运行'展开,这是理解五问框架与 nanoMuse 设计取舍的前提。
Sentinel 与作用域授权
位于所有工具调用之前的闸门,按固定顺序裁决:拒绝表→用户规则→always-allow/ask 清单→污点状态→工具风险对安全模式→不可豁免警告。授权不是简单的'是',而是带作用域的 grant:一次、本对话、或对特定目标永久,可在权限页撤销;带警告的调用只批一次。
nanoMuse 的安全叙事完全建立在 Sentinel 的决策顺序上,理解它才能读懂与 Muse 特权边界的本质对比。
污点追踪(Taint Tracking)
标记数据的传播属性:一个进程一旦读取了用户私密数据即被标记为'污',此后任何把数据发往白名单之外网络的调用都会升级为'必须询问',且状态只升不降。Muse 在内核层面实现,nanoMuse 在同进程策略层模拟。
它解释了提示词注入为何能被确定性边界兜底,也是论文承认'策略边界非特权边界'这一局限的关键论据。
GUI/屏幕操作智能体
让模型直接看屏幕截图并输出点击、滑动、输入等手势来操作任意应用的 agent 范式,如 CogAgent、AppAgent、UI-TARS;与走 API 的工具调用互补,能覆盖银行、政务等无 API 的应用。AndroidWorld、OSWorld、MemGUI-Bench 是其常用评测。
nanoMuse 的 Hands 是一截图一动作的屏幕操作循环,是它与全部竞品拉开差距、也是唯一具备手机屏的系统。
MCP(Model Context Protocol)
2024年11月出现的开放标准,为模型定义统一的工具与上下文接入协议,使 agent 能以一致方式发现并调用外部工具服务器。nanoMuse 的 Hands 梯子最低档(技能、CLI、MCP 服务器)就建立在这类结构化接入之上。
理解梯子策略——优先结构化工具、屏幕操作只是最后手段——需要知道 MCP 所代表的'给模型标准工具'路线。
提示词注入(Prompt Injection)
攻击者把恶意指令藏进模型会读取的外部内容(网页、邮件、文档),诱导 agent 执行非用户意愿的动作。防御分概率层(训练、分类器集成)与确定性层(污点、代理凭据、审批边界),后者保证'即使被说服也做不成坏事'。
Muse 的安全架构与 nanoMuse 的 Sentinel 都以注入威胁为设计原点,是第三节解读 Muse 的主线。
研究动机
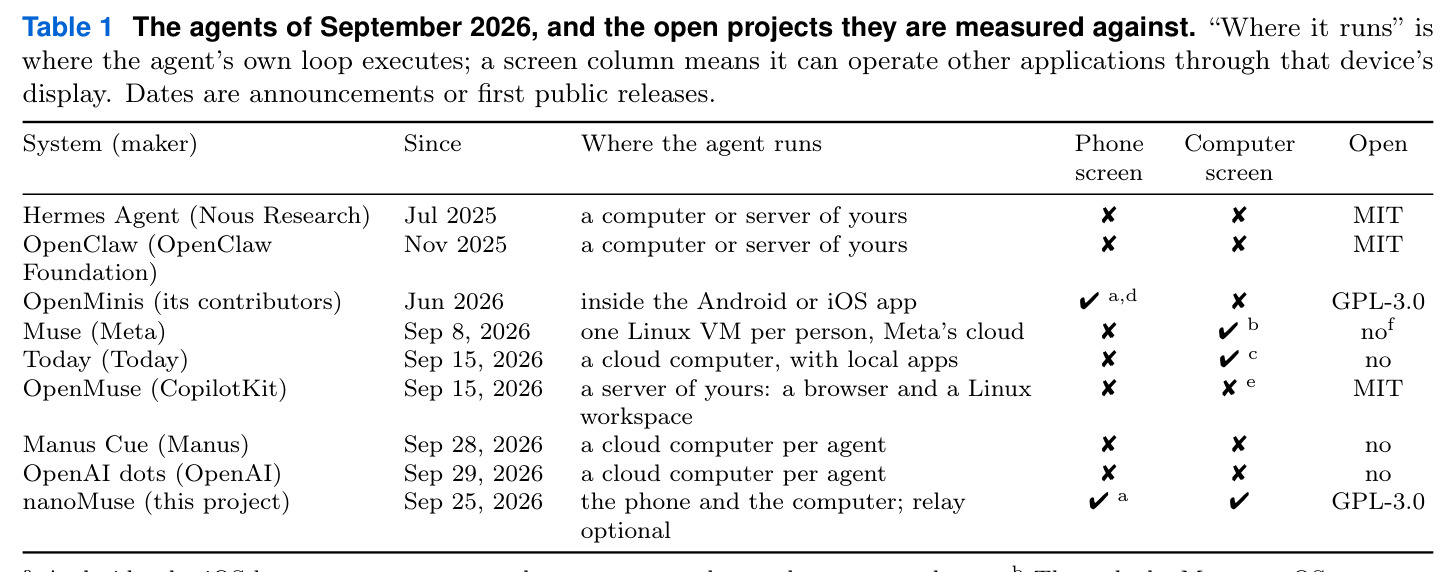
2026年9月8日 Meta 发布 Muse,三周内 Today(9月15日)、Manus Cue(9月28日)、OpenAI dots(9月29日)相继跟进,形成同一架构:每人一台厂商云里的 Linux 虚拟机,作为文件、记忆、凭据与对话的记录系统,用户设备上只剩薄客户端,模型由厂商训练。Muse 仅在美国销售,除10月2日开放的 Apache-2.0 配件 SDK 外全部闭源。问题在于:个人智能体会掌握一个人最完整的记录——记忆、凭据、支付——它运行在哪、被谁审视,不是部署细节而是产品本身;同时云端架构只能到达有 API 或网页的服务,银行、政务等无 API 的本地手机应用够不到。而当时这个品类没有开源对应物:Hermes Agent 与 OpenClaw 无屏幕操作,OpenMinis 只在单个 App 内。
本文的目标是论文有三重目标。其一是概念上把'个人智能体'定义清楚:一个为一人服务、在其账户与设备上代其行动、跨周记忆、值得时先开口、并对其所为负责的程序,并提出五个问题(知道什么/在哪行动/向谁负责/如何学习/如何付费与治理)与三个时间视野。其二是从 Meta 的公开文档与一份生产系统提示词副本出发,逐条注明出处(documented/prompt/observed/inferred)地解读 Muse 究竟如何构成。其三是给出开源对应物 nanoMuse(GPL-3.0,2026年9月25日首发,报告对应 v0.1.40):Android、iOS、macOS/Windows/Linux 桌面与 Web 五端,每台设备一个完整智能体、屏幕之手、Sentinel 门控、文件式记忆、可选开源中继,并给出体积与成本数字及社区路线图。
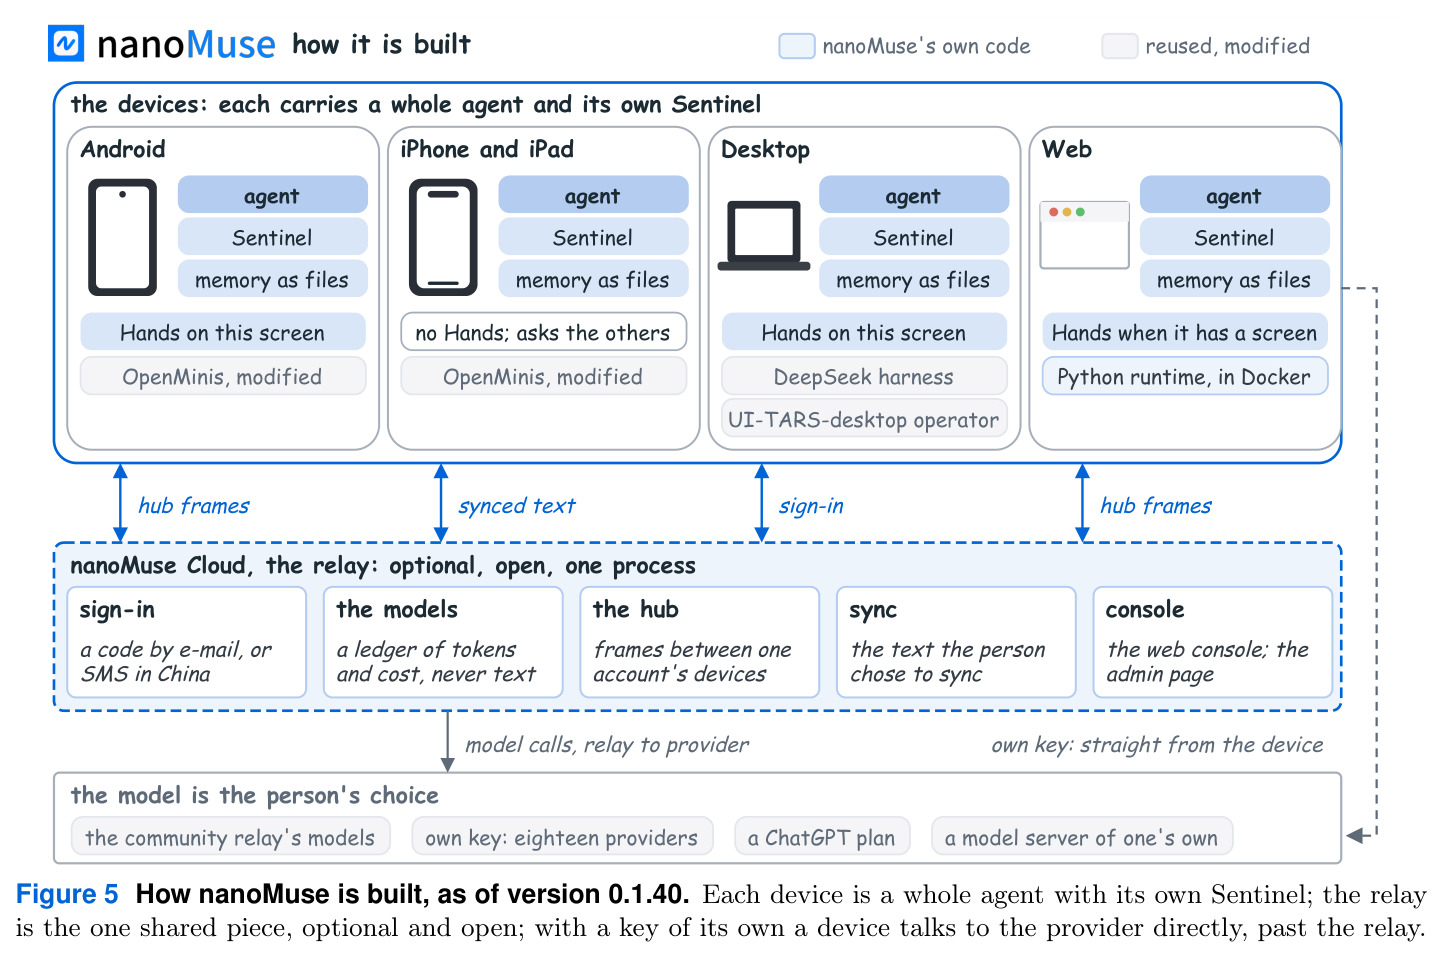
与已有工作不同的是,本文的独特切入是把'谁运行这个程序'当作一等设计约束。已有开源项目各缺一角:Hermes Agent(2025年7月)与 OpenClaw(2025年11月,MIT)跑在用户自己的电脑或服务器上、能跨会话记忆、经由聊天 App 触达,但都没有屏幕;OpenMinis(2026年6月,GPL-3.0)是 Android App 内的完整智能体,却没有跨设备等'个人'其余部分;CopilotKit 的 OpenMuse(9月15日,MIT)虽开源但本质是'带持久浏览器的服务器',图形桌面列为未来工作。nanoMuse 反其道:不是把设备做成云端大脑的窗口,而是把整个智能体放进每台设备成为对等节点,中继压缩到一个 Python 进程加一个 SQLite 文件(空闲约85MB内存),使'一人多设备一个对话'在自托管预算内成立。
核心方法
直觉:一个人的智能体应该是每台设备上的完整程序,彼此共享同一段对话,而不是共用一个云端大脑。技术路线(v0.1.40)分四层。设备层:Android 端修改自 OpenMinis,App 内含沙箱化 Alpine Linux、shell、浏览器、MCP 服务器、技能与定时任务;桌面端是 Electron 壳包 DeepSeek harness 加 nanoMuse 插件,内置 Python runtime,同一 runtime 也从用户自己的电脑服务 Web 端;iOS 因系统禁止 App 操作其他 App 而没有 Hands。中继层:nanoMuse Cloud 为可选开源单进程(Python + SQLite),承担登录、模型调用账本(只记 token 数与成本、从不存内容)、hub 帧转发与用户选择同步的对话文本。模型层:18 家 provider 目录、可用 ChatGPT 套餐经 OpenAI Codex 授权流接入(覆盖聊天与手、不含图像视频)、或指向自己的模型服务器。安全层:每设备各自带一个 Sentinel,所有工具调用过闸。
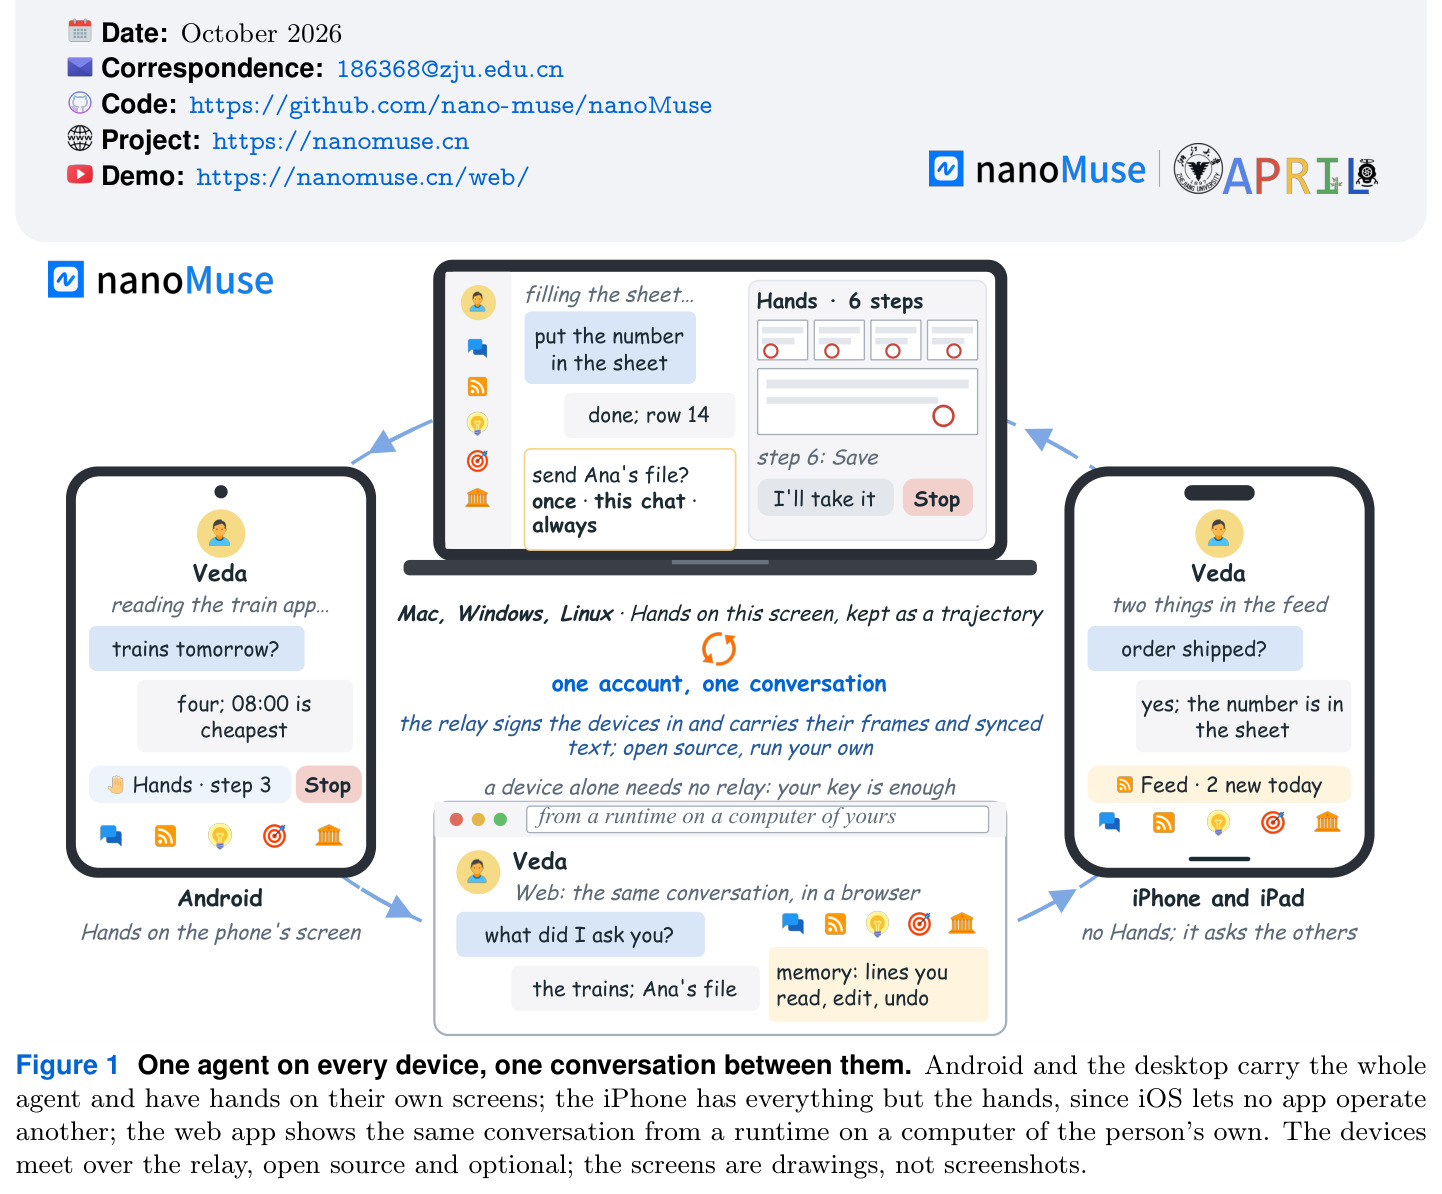
核心创新有三。一是对等架构:任何设备的智能体都能把其他设备当工具,'在手机上找订单号、填进 Mac 的表格'是一段对话;被委托执行的任务运行在执行设备自己的 Sentinel 下,请求方无法外借自己没有的权限。二是 Hands 屏幕操作走'梯子':技能/CLI/MCP → 带用户登录抓取页面 → 浏览器 → 最后才是设备屏幕,最后一档默认关闭;一截图一动作,模型看到单张截图、目标、每步一句话历史与无障碍元素,回答一个思考、一句用用户语言写的'我要做什么'和一个手势——关键在于让确定性策略判定模型说出的句子而非图片本身,出现提交性词汇(确认支付、转账、下单、发送、删除)即每次都需审批。三是 Sentinel 的固定决策顺序与作用域授权:拒绝表→用户规则→always-allow/ask 清单→污点→工具风险对模式→若干任何模式都不能豁免的警告;带警告的调用只批一次,因此支付与密码永远不会被记住。
方法步骤详情
完整流程:用户下达目标后,智能体从梯子最低档起选最先可行的一档。若落到 Hands:每步把当前截图、目标、该步一句话历史与设备报告的无障碍元素拼成输入交给模型,模型输出思考、一句人话预告(如'把数字填进表格')与一个手势;Android 上还会读取落指处的无障碍文本,与标签取更严格者判定敏感性;禁止输入密码、PIN、卡号与一次性验证码写进算子提示词。判定通过后执行动作,整个 run 以轨迹形式留在聊天里——每步截图叠加动作标注——用户可点 'I'll take it' 接管鼠标。记忆侧:手机端是用户可打开的 Markdown 文件(SOUL.md 记智能体、USER.md 记用户、GLOBAL.md 记跨对话事实、HEARTBEAT.md 记例程,加日期日记);桌面端每条记忆带变更日志与撤销,整理 pass 只提议合并、绝不删除用户亲写内容;Feed/Ideas/Goals 由智能体在隐藏对话中写、由人读。
技术新颖性
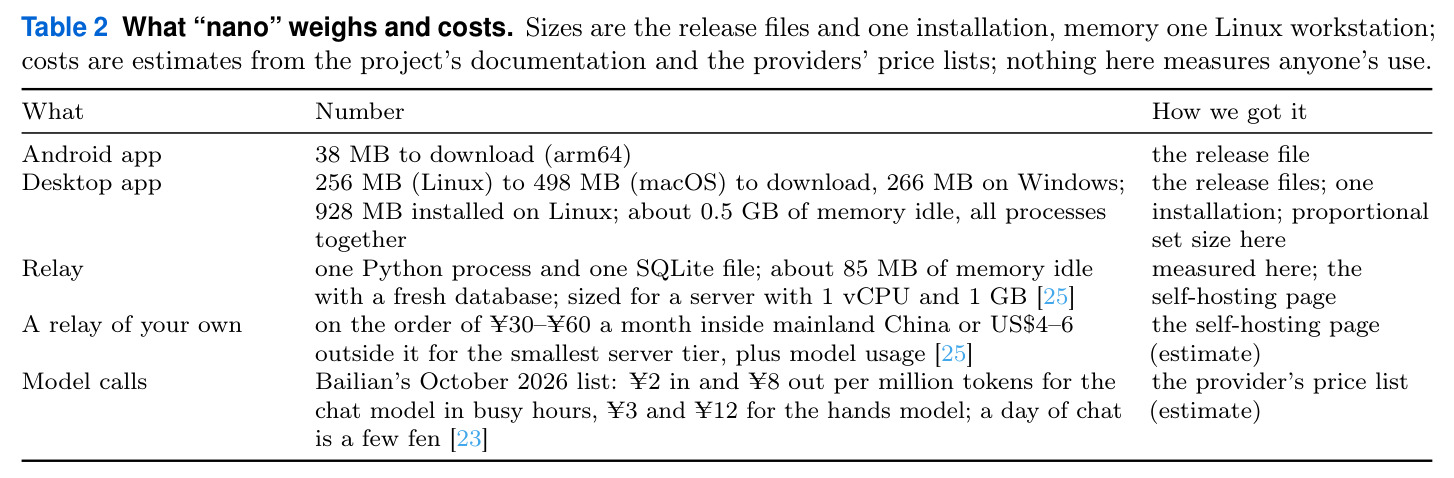
与 Muse 的本质区别在于诚实的安全模型:Muse 把每个安全机制放在智能体够不到的主机侧——内核级污点跟踪、网络边界换入的真实凭据、作为'唯一权限当局'的 Sentinel broker——这要求每人一台 VM;nanoMuse 承认单设备上 Sentinel 只是同信任域内的策略边界,转而用可读性与语言治理补偿:模型必须用人话预告动作,确定性行为只对文字做规则判定。与 OpenMinis 相比补齐了从脸、Feed 到中继的全部个人要素;与 OpenMuse 相比把智能体放回设备,从而获得手机屏幕与零服务器运行。代价被明码标出:Table 2 给出 Android app 38MB、桌面安装后 928MB(Linux)、中继 85MB 空闲内存;自托管约 ¥30–60/月(国内)或 $4–6/月,按 $C = c_{in} n_{in} + c_{out} n_{out}$ 与 Bailian 牌价(chat 每百万 token ¥2 入/¥8 出,hands 模型 ¥3/¥12)估算,一天聊天只要几分钱。
实验结果
本文是系统报告而非实验论文,作者明言无成功率可报、也不愿估算,因此核心'结果'是端到端完整可用的系统与量化清单。Table 2:Android app 下载 38MB;桌面 app 下载 256MB(Linux)至 498MB(macOS)、Windows 266MB,Linux 安装后 928MB,全部进程空闲合计约 0.5GB 内存;中继是单个 Python 进程加一个 SQLite 文件,空库空闲约 85MB,适配 1 vCPU/1GB 服务器;自托管成本估 ¥30–60/月(国内)或 $4–6/月(海外);模型调用按 Bailian 2026年10月牌价 chat 模型 ¥2/¥8、hands 模型 ¥3/¥12(每百万 token 输入/输出),一天聊天只要几分钱。Table 1 的定位结论:Muse、Today、Manus Cue、dots 都无手机屏且闭源;nanoMuse 是表中唯一同时具备手机屏与电脑屏且 GPL-3.0 全开源的系统;评测套件(AndroidWorld、OSWorld、MemGUI-Bench、OS-Harm)列为下一步而非已跑分数。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 个人智能体部署形态 | 运行位置与屏幕控制(Table 1) | 智能体在设备本机运行,手机屏+电脑屏双支持,中继可选,GPL-3.0 | Muse(每人物理级隔离的云端 Linux VM)、Today、Manus Cue、OpenAI dots 均无手机屏且闭源 | 表中唯一同时具备手机屏与电脑屏的全开源系统 |
| 中继自托管资源 | 空闲内存 / 最低服务器规格 | 单 Python 进程 + SQLite,空库空闲约 85MB,1 vCPU/1GB 即可 | Muse 每人一台厂商云 Linux VM(约每小时更换、家目录持久化) | 从专用 VM 降到约 ¥30–60/月(国内)或 $4–6/月(海外)的最小服务器档 |
| 模型调用成本 | 每百万 token 价格(Bailian 2026年10月牌价) | chat 模型 ¥2 入 / ¥8 出;hands 模型 ¥3 入 / ¥12 出;一天聊天几分钱 | 厂商订阅制(Muse 等闭源产品未公开单价) | 成本公式 $C = c_{in} n_{in} + c_{out} n_{out}$ 完全透明、可自选 18 家 provider 或本地模型 |
| Hands 屏幕操作可靠性 | 成功率 / 人工接管次数 | 未测量,作者明确拒绝估算(无公开数字) | 无(竞品同样未公开该数字) | 作者把'评测套件 + 每版打分'列为路线图 Next 阶段第一优先级 |
局限与改进
作者承认的局限:其一,策略边界不是特权边界——单设备上 Sentinel 与智能体同处一个信任域,没有持有真实凭据的宿主,设备被攻破即智能体被攻破,决策顺序、污点规则与 Linux 沙箱只是缓解而非解决;其二,Hands 只靠模型的话来治理且未被测量——纯图标无标签按钮两个信号都失效,密集专业界面连找到按钮都无解,用户盯着的红圈是最后防线,Linux 仅支持 X11;其三,记忆不知道自己是谁写的——没有记录哪个模型、何时、多大置信度,也没有复查旧条目的规则;其四,中继保存用户选择同步的明文对话,社区中继只是项目运营的一台机器上的一个进程;其五,'帮助改进模型'开关对新账户默认开启,是作者自称最不确定的选择;其六,对 Muse 的解读基于四份公开文档与出处无法验证的提示词副本,会随部署漂移。
独立分析的弱点
独立看有四个弱点。一是零定量评测:连作者自建的失败轨迹评测套件都还是'下一格',任何关于 Hands 可靠性的说法目前无法检验,改进方向是每个 release 附 AndroidWorld/OSWorld 分数与人工接管率。二是多对等节点的记忆一致性问题被回避:每台设备各持 SOUL.md/USER.md,同一事实在手机与 Mac 上被不同模型改写后如何合并、冲突如何裁决,论文未给出机制,方向是中心化记忆库加版本向量同步。三是语言判定的对抗面:模型完全可能用无害措辞描述危险动作(用'确认表单'代替'转账')绕过提交性词汇表,需要把判定从词表扩展到动作语义分级或交由本地小分类器复核。四是污点只升不降导致过度打扰:会话一旦读过私人数据,之后所有外发调用都要审批,长任务的审批疲劳反而会训练用户无脑点确认,可引入作用域化污点过期与按目标的细粒度白名单。
未来方向
作者路线图按 Fig. 6 的五条泳道×三个距离展开:Now 追平 Muse——记忆能主动浮现且遗忘可见、各客户端同一张脸、Hands 减少失败并从意外对话框恢复、中继与 Web runtime 合并成一条命令自托管;Next 做两件事——用累积的失败轨迹建评测套件,与 AndroidWorld(手机)、OSWorld(桌面)、MemGUI-Bench(跨 App 记忆)、OS-Harm(该拒绝的命令)并行打分,然后用自愿贡献的轨迹训练小型开源 Hands 模型(手法类似 MobileForge 的自我采集适配),让最敏感的循环不依赖厂商;Later 抬头看——hub 帧已带 look/act/ask,摄像头、家电、机械臂作为新设备接入同一审批与日志体系,最终目标是能延续数年的记忆与身份。可延伸方向还包括作者许诺的逐行 provenance(哪个模型、何时、多确信写入)与旧记忆复查规则,以及把人在环接管率作为一等公开指标。
复现评估
复现条件非常宽松。代码以 GPL-3.0 完全开源(github.com/nano-muse/nanoMuse),项目页 nanomuse.cn 提供在线 demo,报告对应 v0.1.40 且有 changelog。硬件上:单设备模式只需在 App 里填自己的 API key,无账户无服务器即可完整运行(含聊天与 Hands);多设备模式用社区中继,邮箱或中国大陆手机号登录;自托管中继是 Docker 单容器加一个 TLS 脚本,最低 1 vCPU/1GB 服务器(中继空闲仅约 85MB 内存),月成本约 ¥30–60(国内)或 $4–6(海外)。模型可接 18 家 provider 或本地模型服务器,无训练算力门槛。难点不在资源而在验证:论文未提供任何基准分数或失败轨迹数据集,复现者需自建评测(AndroidWorld 等)才能检验 Hands 声明;对 Muse 的 prompt 解读部分也无法独立复核,因其出处不可验证。
论文图表
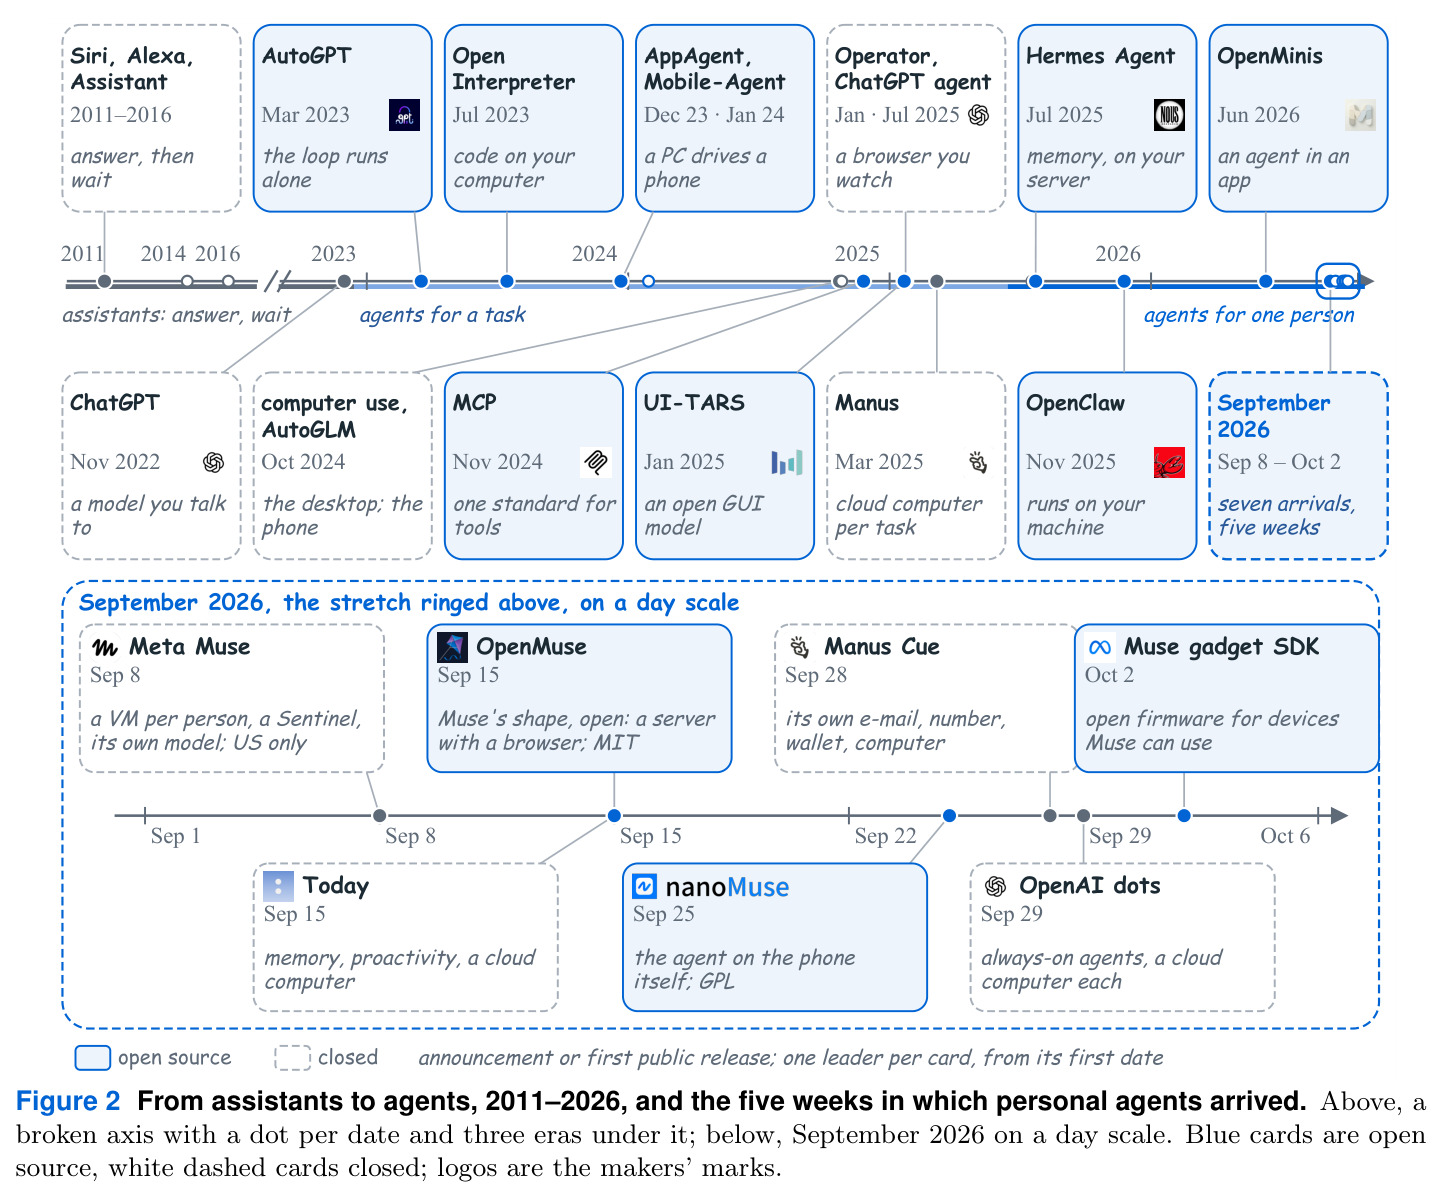
上半部是断轴时间线,分三时代:Siri/Alexa/Google Assistant(2011–2016,答完就等)、AutoGPT 与 Open Interpreter(2023)、AppAgent/Mobile-Agent(2023末–2024初)、Operator/ChatGPT agent(2025)、Hermes Agent(2025年7月)、OpenMinis(2026年6月);下半部把 2026年9–10月的五周放到天尺度:Muse(9月8)、Today 与 OpenMuse(9月15)、Manus Cue(9月28)、OpenAI dots(9月29)、Muse 配件 SDK(10月2)。
定位论文的历史坐标与'为什么是现在',蓝色卡片为开源、白虚线为闭源,一眼看出个人智能体赛道的拥挤与开源空白。
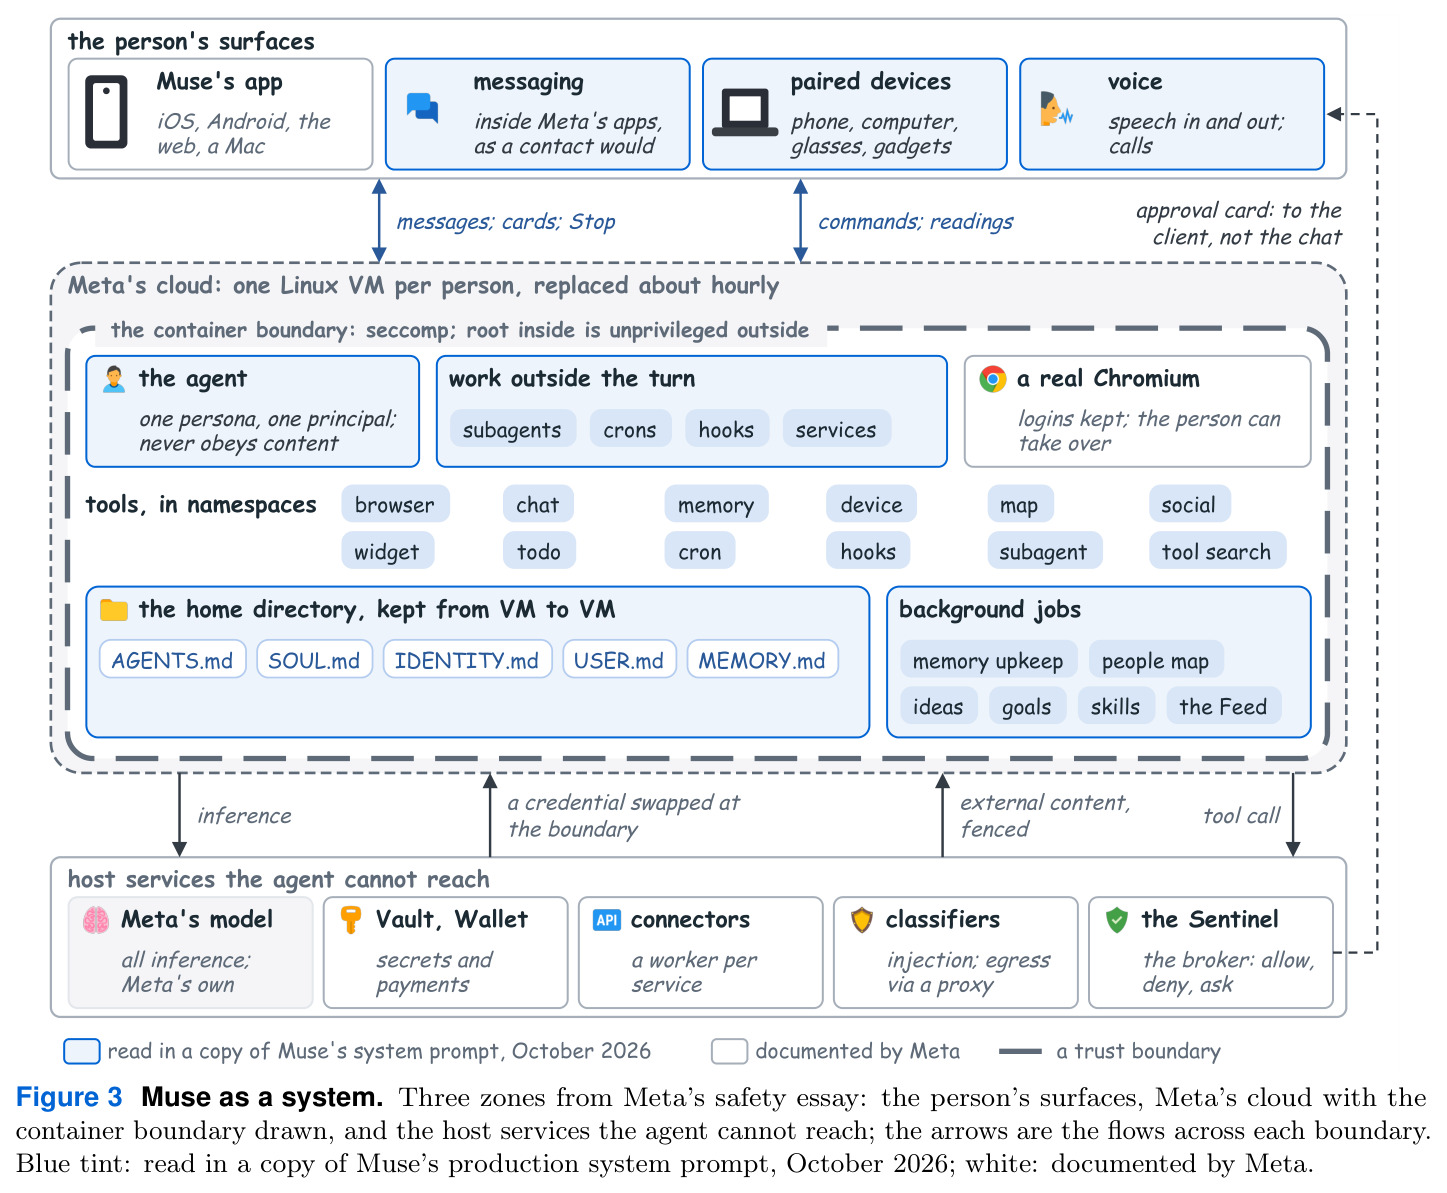
按 Meta 安全文章画出三个信任区:人的表面(App、消息、配对设备、语音)、Meta 云(每人的 Linux VM、seccomp 容器边界、保留登录态的真实 Chromium、子代理/cron/hook/服务、跨 VM 持久化的家目录)、智能体够不到的主机服务(模型、Vault/钱包、连接器 worker、分类器、Sentinel broker)。蓝色注记来自生产提示词副本,白色为官方文档。
论文对 Muse 的逐条解读都挂在这张图上,是理解'特权边界'设计及其为何无法被开源方案平移的关键。
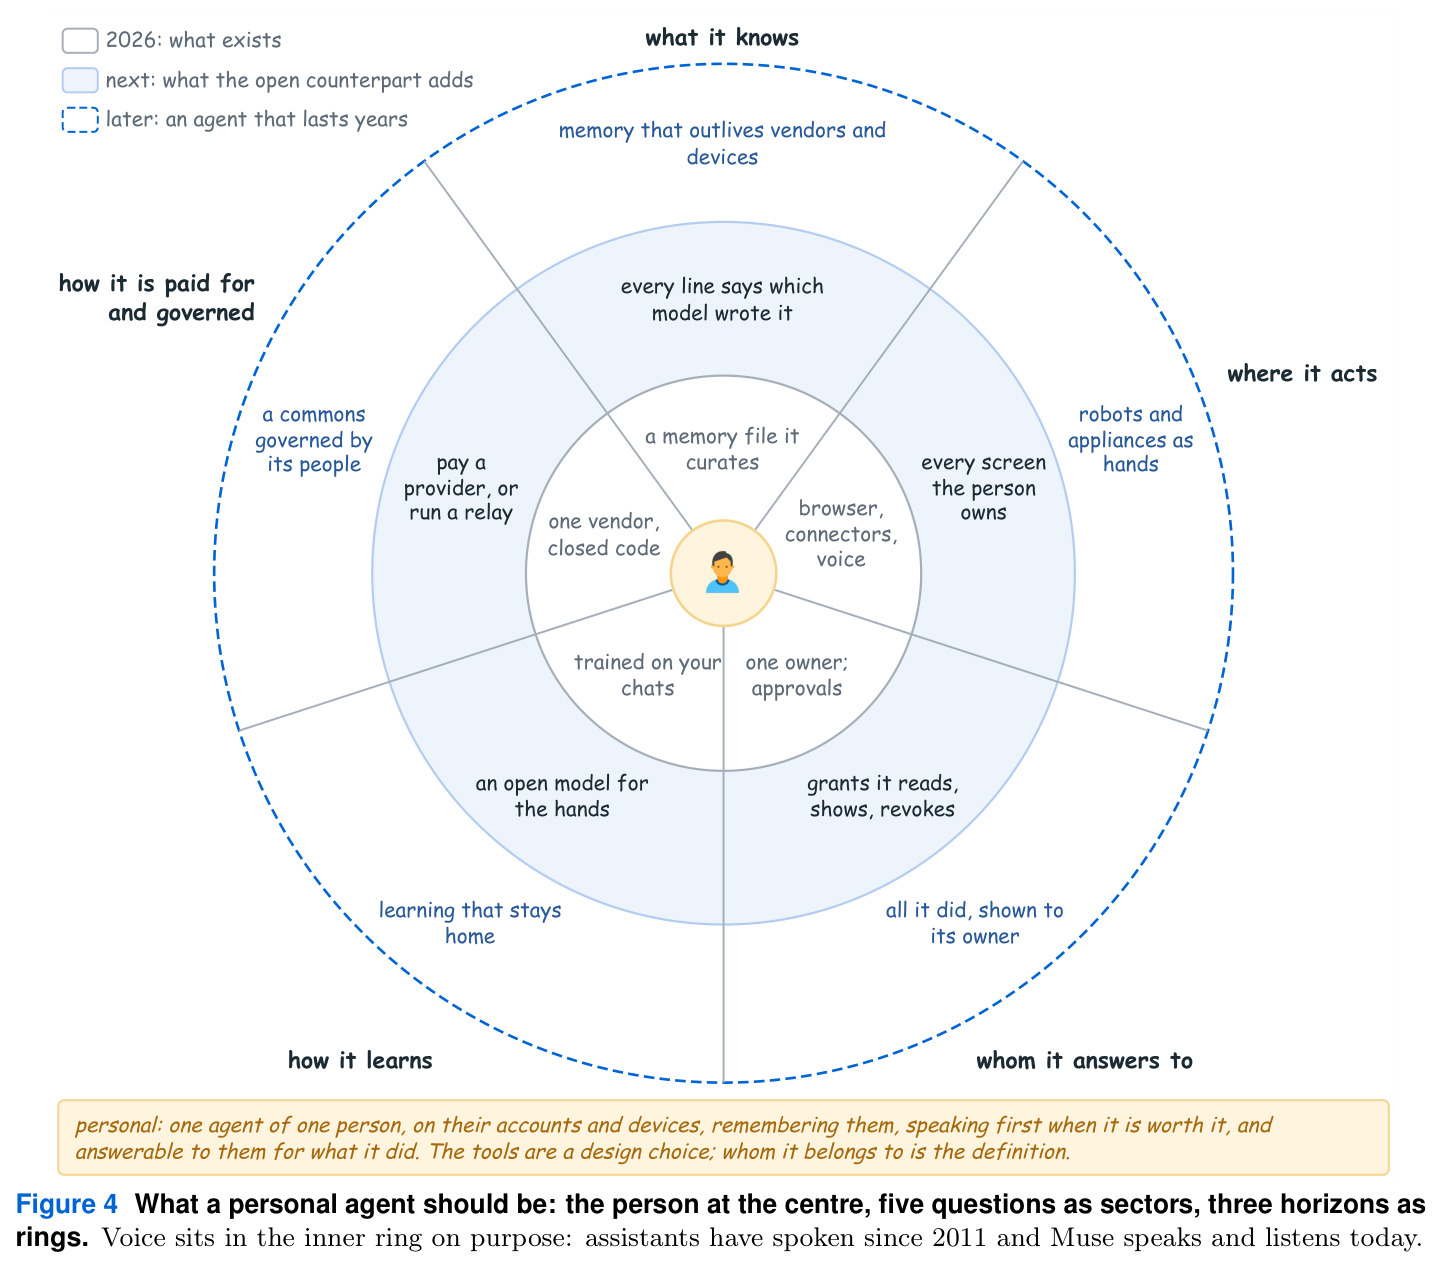
以人为圆心的扇形-环形图:五个扇区是知道什么(可读、可改、可带走的记忆)、在哪行动(一个智能体多双手)、向谁负责(作为信任语法的审批)、如何学习(公开且有同意地学)、如何付费与治理(小到能跑在家里);三个同心环是 2026 现状、开源对应物应补的下一步、能延续数年的智能体。
这是作者提出的规范性框架,第四节全部论述与第六节路线图都按它组织,是理解论文立场的钥匙。
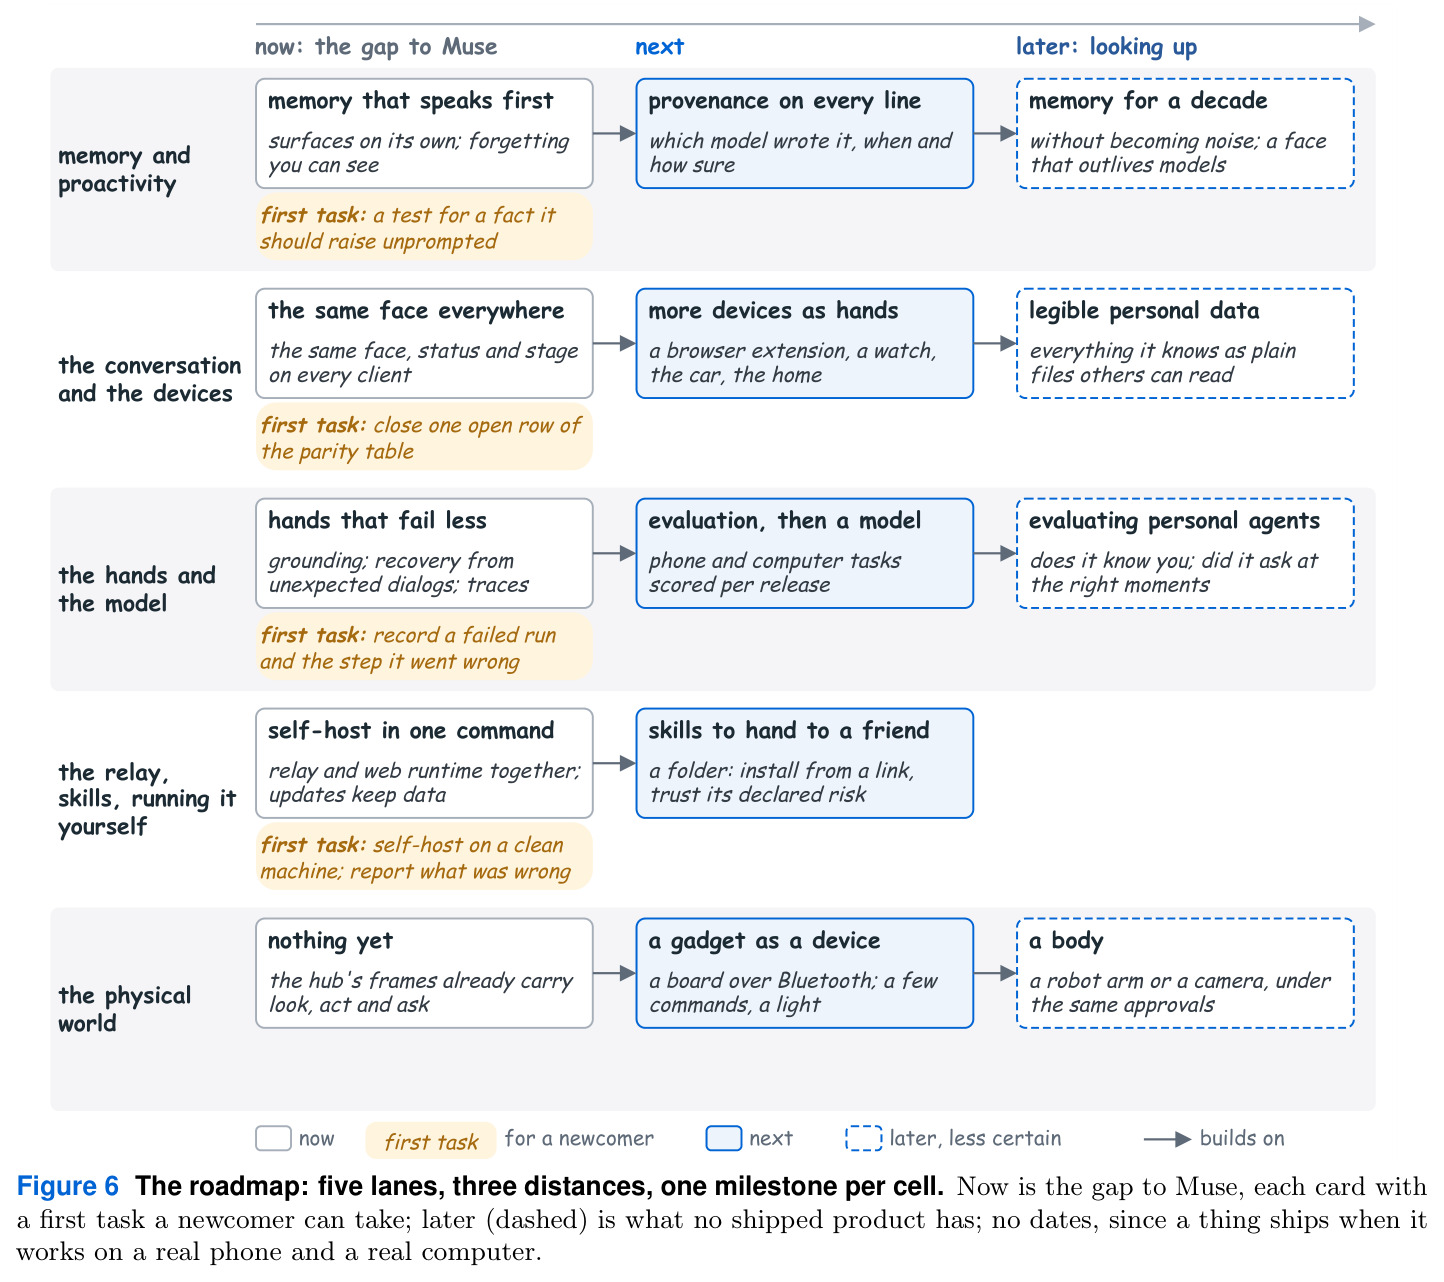
路线图五条泳道(记忆与主动性、对话与设备、手与模型、中继/技能/自托管、物理世界)×三个距离(Now=与 Muse 的差距、Next=评测与自研手模型、Later=物理世界与十年记忆),每张 Now 卡附一个新人可接手的 first task;虚线卡片表示尚无任何产品做到。
读完全文后的行动指南,也直观暴露了系统当前未完成的部分,与第七节局限性互为补充。