OpenMobile-2:以可扩展环境与应用原生工具构建通用移动智能体 OpenMobile-2: Building Versatile Mobile Agents with Scalable Environments and App-Native Tools
开源移动智能体全栈:110+应用环境、1.2万轨迹与2千可验证RL任务,融合GUI与工具调用。
前置知识
移动 GUI 智能体
以视觉语言模型(VLM)为核心的智能体,通过截图感知手机屏幕,输出点击、长按、滑动、输入文本等动作来完成任务。动作空间通常封装为一个 mobile_use 工具,每轮生成一段 Thought 推理加一次工具调用,环境返回新截图,循环直至调用 terminate 结束。
OpenMobile-2 就是这样一对 9B/27B 端到端模型,论文的环境、数据、训练和评测全部围绕它展开,不理解这个基本交互回路就无法理解后续设计。
Android 模拟器 vs 模拟环境
模拟器(emulator)运行真实 Android 系统和真实应用,交互真实但存在登录摩擦、副作用不可逆、重置昂贵、难以并行的问题;模拟环境(simulator)在浏览器里重建应用客户端,状态可序列化、可确定性重置、可轻量并行,但应用往往数量少、深度浅。
本文的核心命题就是用工程化配方在模拟环境里同时拿到两头的优点,理解这条权衡线才能看懂 MobileGym++ 的设计动机和与 AndroidWorld、SPA-Bench 的本质差异。
SFT 行为克隆与轨迹数据
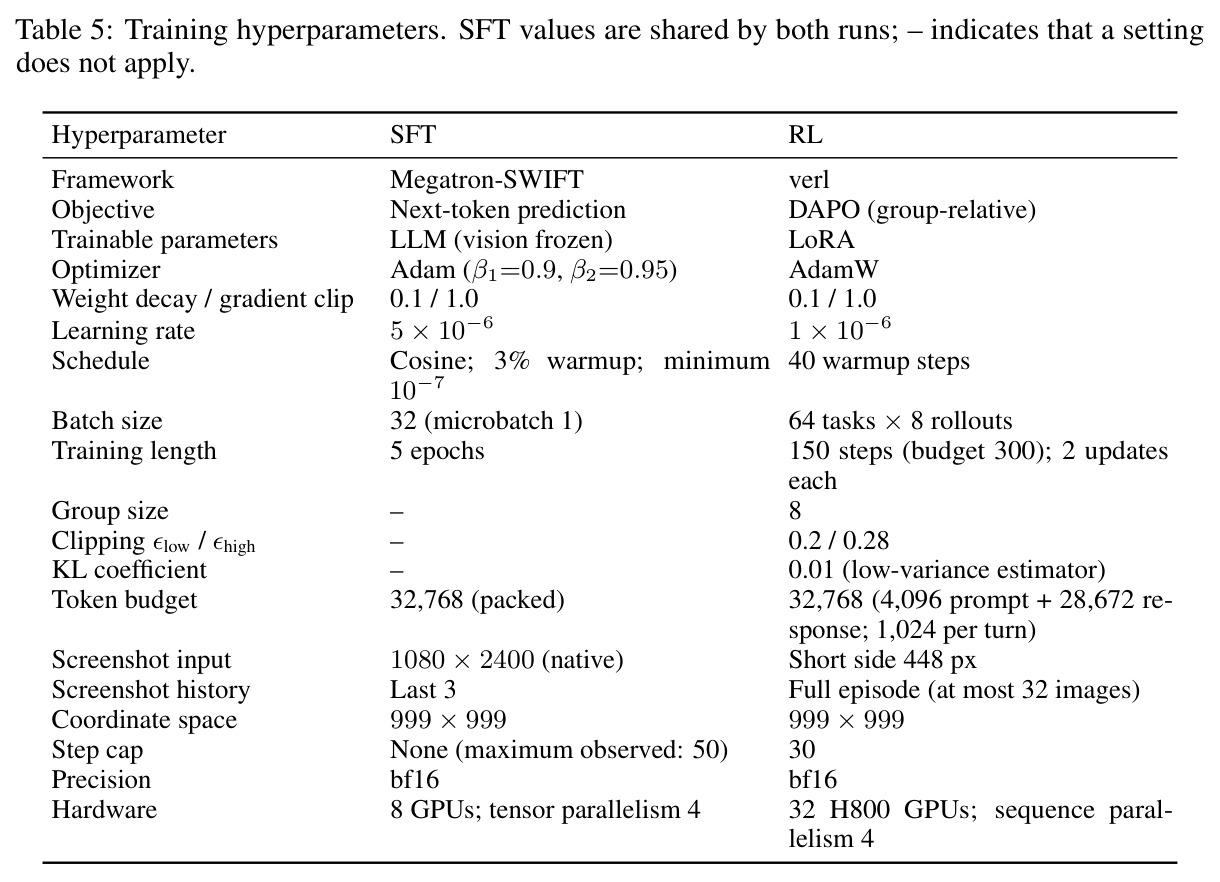
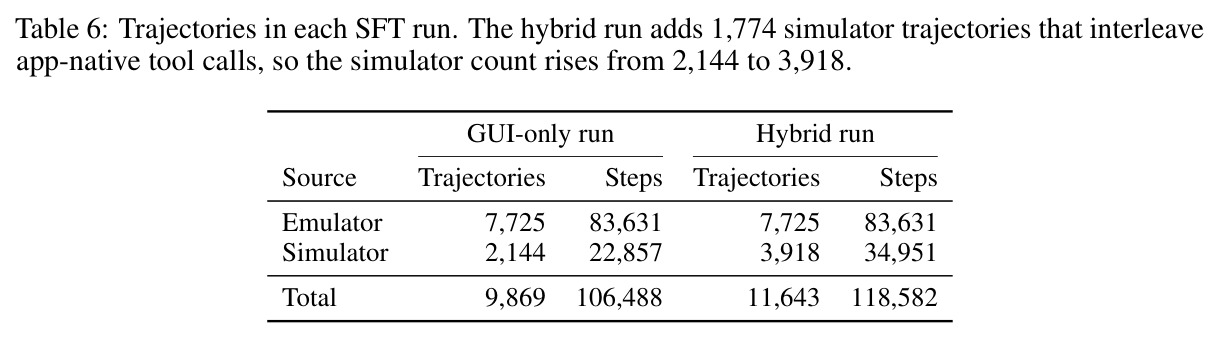
监督微调把成功轨迹转成训练样本:每一步生成一个样本,包含任务指令、交互历史、最近 3 张截图,目标是 Thought 段落加一次动作调用。本文混合运行共 11,643 条轨迹、118,582 个步级样本,训练 5 个 epoch,学习率 $5\times10^{-6}$。
SFT 是本文性能提升的主要来源(9B 在 AndroidWorld 上 +18.5 分),也是理解 GUI-only 与 Hybrid 两个训练分支差异的基础。
GRPO/DAPO 组相对强化学习
一种无需价值网络的策略梯度方法:对每个任务采样一组 rollout(本文 8 条),以组内平均奖励为基线计算相对优势,再用 DAPO 的非对称裁剪($\epsilon_{low}=0.2,\ \epsilon_{high}=0.28$)限制策略偏移,配合 KL 正则(系数 0.01)防止遗忘。奖励由程序化验证器给出。
本文在 2,475 个可执行任务中采样 512 个做 RL,奖励公式为 $r = v\cdot m_{\text{tool}}\cdot\ell - 0.2\,n_{\text{fmt}} - 0.2\,f_{\text{succ}}$,理解组相对优势和奖励塑形是读懂 RL 实验的前提。
App-native 工具与 MCP 式结构化接口
应用把自身内部功能(如淘宝的搜索、加购)暴露为带类型签名的函数调用,和 GUI 操作并存。与外挂 MCP 服务器的关键区别在于:本文工具处理器与可见 GUI 读写同一个应用状态存储,工具调用等价于对应的 GUI 操作序列。
混合 GUI 与 app-native 工具是本文的实验性核心设定(300+ 工具、50+ 应用),论文最重要的分析结论——'工具通道需要混合训练来解锁'——完全建立在这个设定上。
程序化验证器
不依赖模型裁判、不检查轨迹和截图,而是直接对比任务执行前后应用业务状态(订单、购物车、便签等)的 diff,检查智能体是否写入了目标变更。通常分宽松验证器(目标达成且额外变更无害)和严格验证器(还要求状态干净)。
它是 MobileGym++ Bench 的评分标准和 RL 奖励的来源,保证 GUI 动作和工具调用被同一把尺子衡量,也让大规模自动评奖成为可能。
研究动机
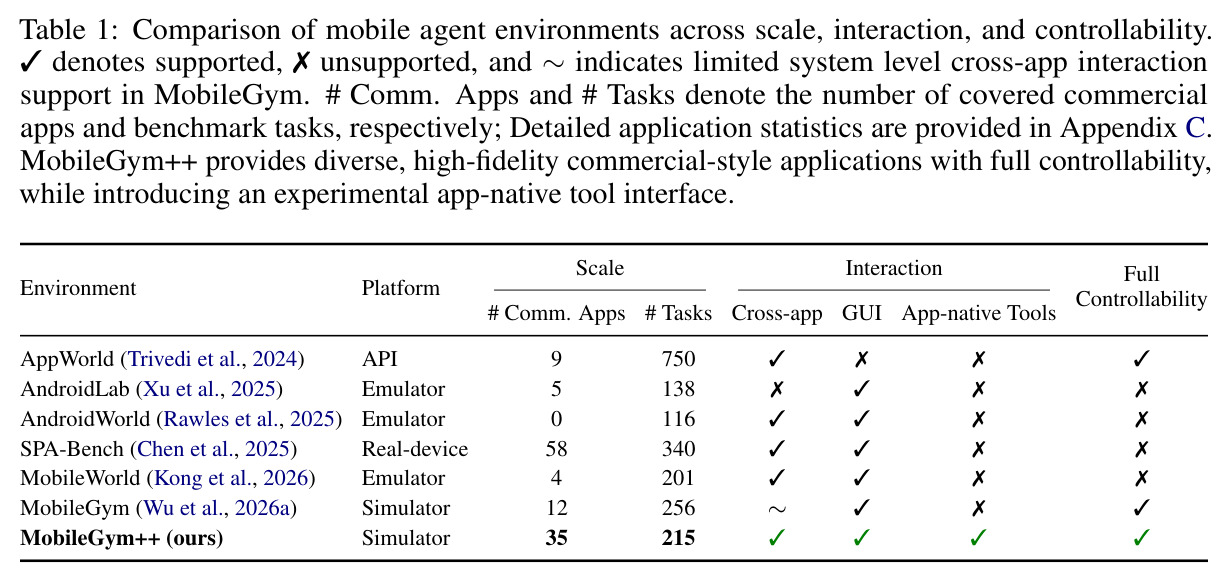
移动智能体的能力高度依赖大规模交互经验——覆盖多样任务、应用和环境的轨迹数据——但高质量交互数据基本被闭源公司垄断,开源社区缺乏训练资源,开源模型明显落后。要在不做昂贵人工标注的前提下扩展交互经验,就需要一个多样且可控的手机环境,而这恰是瓶颈。现有两条路线各有硬伤:其一,Android 模拟器或真机路线(如 AndroidWorld、MobileWorld、SPA-Bench)虽然交互真实,但第三方应用缺乏可靠重置机制,存在登录摩擦、不可逆副作用和昂贵的重置流程,难以支撑大规模 rollout 和强化学习——SPA-Bench 覆盖 58 个真实商业应用却完全无法批量重置,AndroidWorld 的 20 个应用里商业应用数量为 0;其二,模拟应用路线(如 MobileGym、AppWorld)虽然重置廉价、可并行、能直接读状态,但应用数量少且浅:MobileGym 只有 12 个商业应用,AppWorld 只有 9 个纯 API 应用甚至没有手机 GUI,而且没有可扩展的应用构建配方。结果是智能体几乎没有机会在真实商业工作流——比如携程订旅行、淘宝下单这类长时程、跨应用、依赖持久用户状态的任务——上练习和被评估。
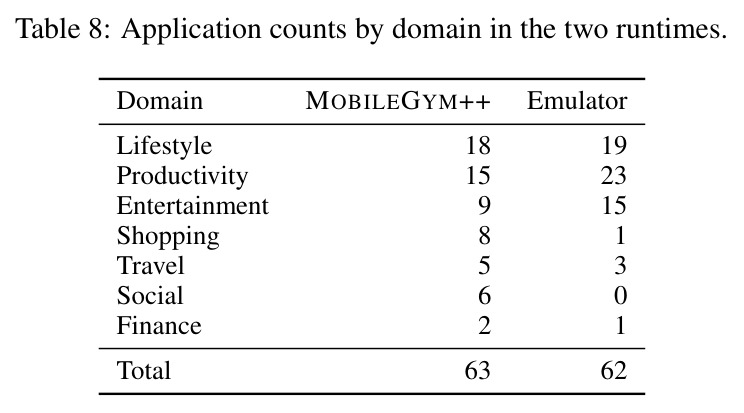
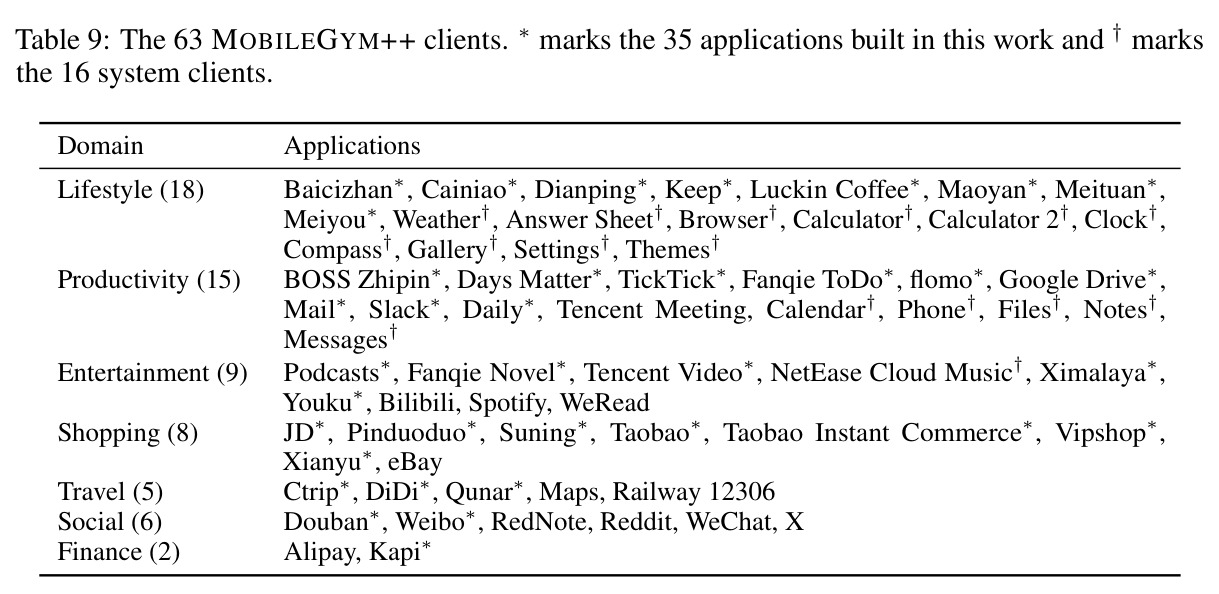
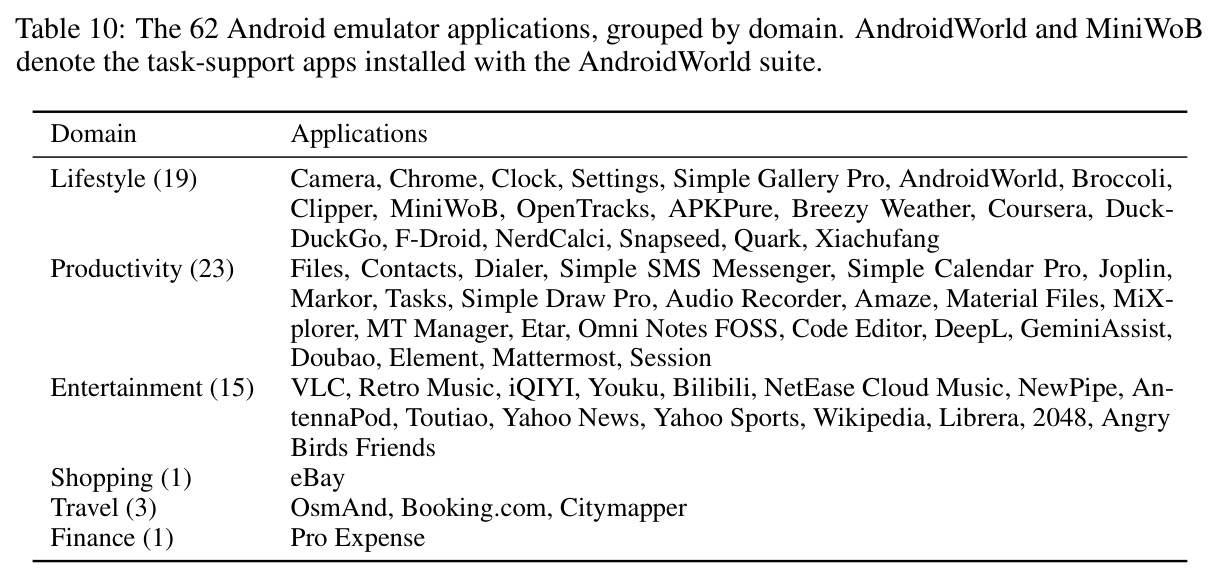
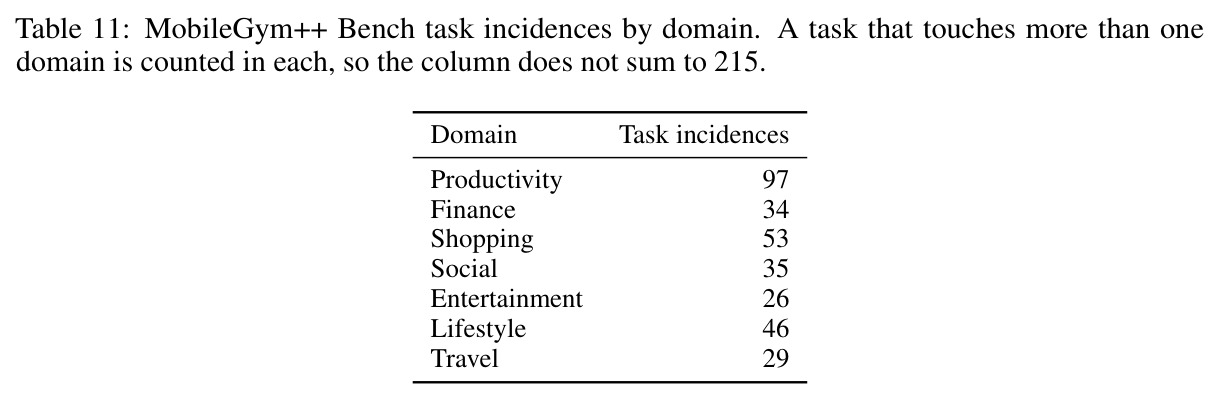
本文的目标是本文的目标是构建一套完全开源的'环境—数据—训练配方—模型'全栈,把环境规模化真正落地。具体分四层:(1) 环境:构建 MobileGym++,高保真复刻 35 个商业风格应用(覆盖旅行、购物、金融、内容、社交、办公、本地生活七大领域),同时保留模拟环境的完全可控性——状态可序列化、可确定性重置、可程序化验证——并支持剪贴板传递、应用间分享、支付重定向、媒体选择等原生跨应用交互;加上新配置的 Android 模拟器应用,形成 110+ 应用的多样化训练场。(2) 数据:基于该环境生产近 1.2 万条(11,643 条)SFT 演示轨迹和超过 2K(2,475 个)带自动奖励的可执行 RL 任务,每个任务配有可靠验证器。(3) 交互接口:探索混合移动使用设定,让应用在 GUI 之外选择性地暴露 300+ 个 app-native 工具,智能体可以在同一个任务内交替使用 GUI 动作与工具调用。(4) 评测:发布 MobileGym++ Bench,包含 215 个长时程跨应用任务,同一任务套件同时支持 GUI-only 与混合两种模式的受控评估。
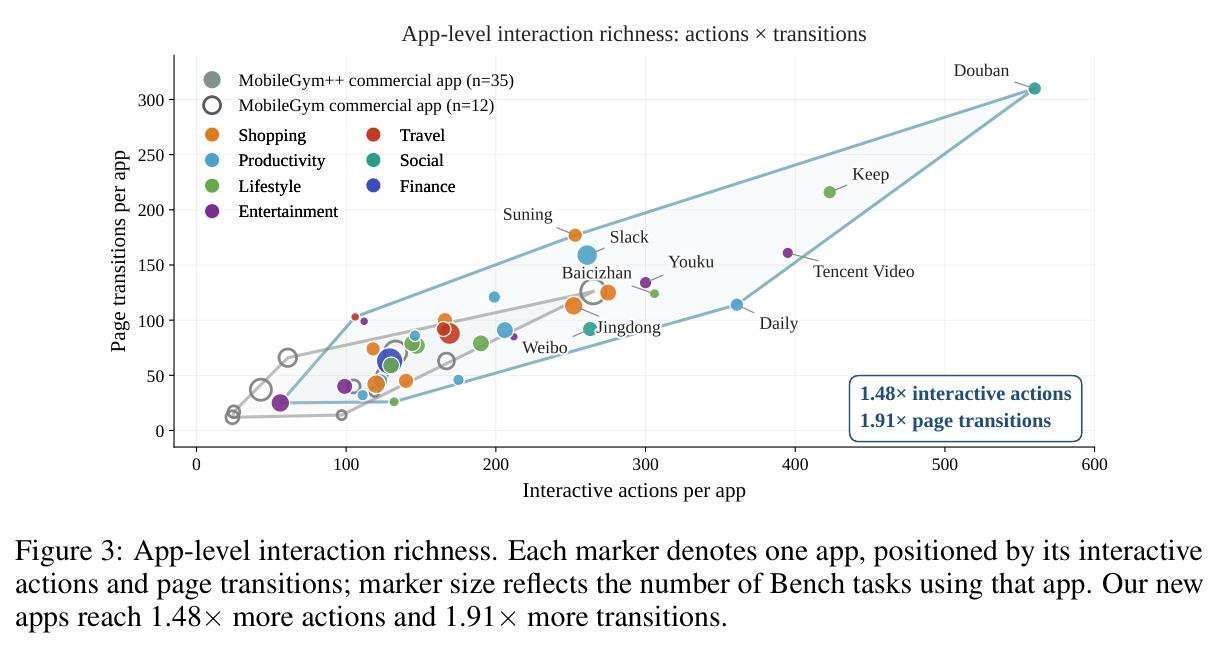
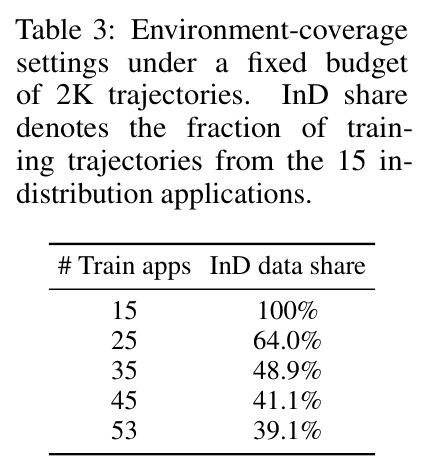
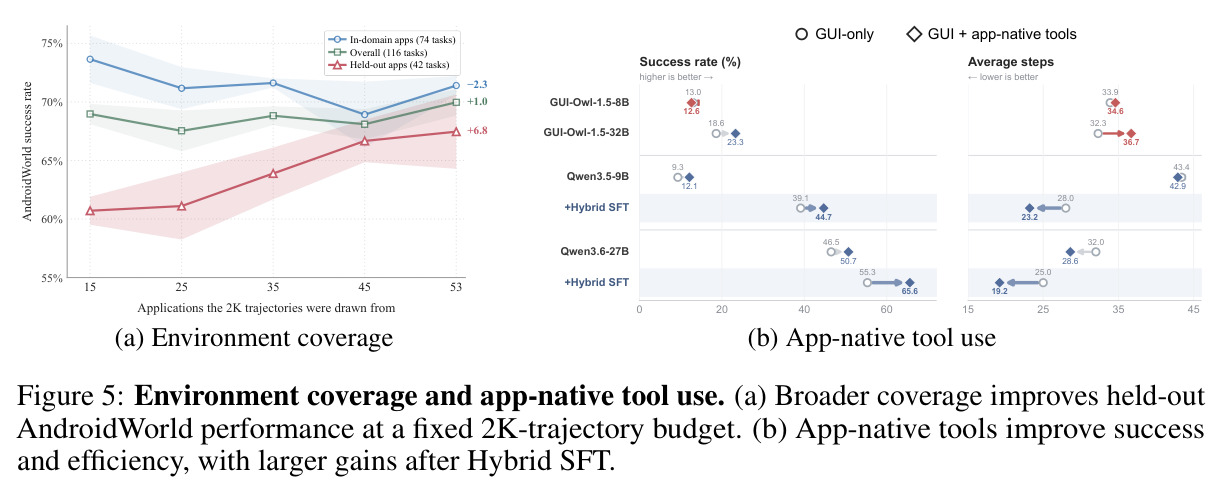
与已有工作不同的是,本文的独特切入角度有三。第一,把'应用覆盖多样性'而非'算法创新'当作首要杠杆:作者用控制变量实验证明,在固定 2K 轨迹预算下把训练应用从 15 个扩到 53 个,对未见应用的迁移性能(Pass@1)从 60.7 提升到 67.5,而已见应用性能仅从 73.7 微降到 71.4,说明环境规模化本身就能买到泛化能力。第二,工具不是外挂的:以往移动混合方案把外部 MCP 服务器或系统级接口附加到 GUI 智能体上,工具与应用状态脱节;本文的 app-native 工具由应用自身暴露,与 GUI 操作读写同一业务状态、通过同一终态条件判定,语义等价,从而第一次能在完全相同的任务、初始状态和检查器下对 GUI-only 与混合两种交互做受控比较。第三,复刻而非抽象:35 个应用从源应用的数据 schema 和交互图出发构建,业务状态丰富度和导航深度是架构属性——中位数每应用 37 条路由、166 个交互动作、86 次页面转换、距首页交互深度 3——比旧 MobileGym 的 12 个应用多出 1.48 倍交互动作和 1.91 倍页面转换。
核心方法
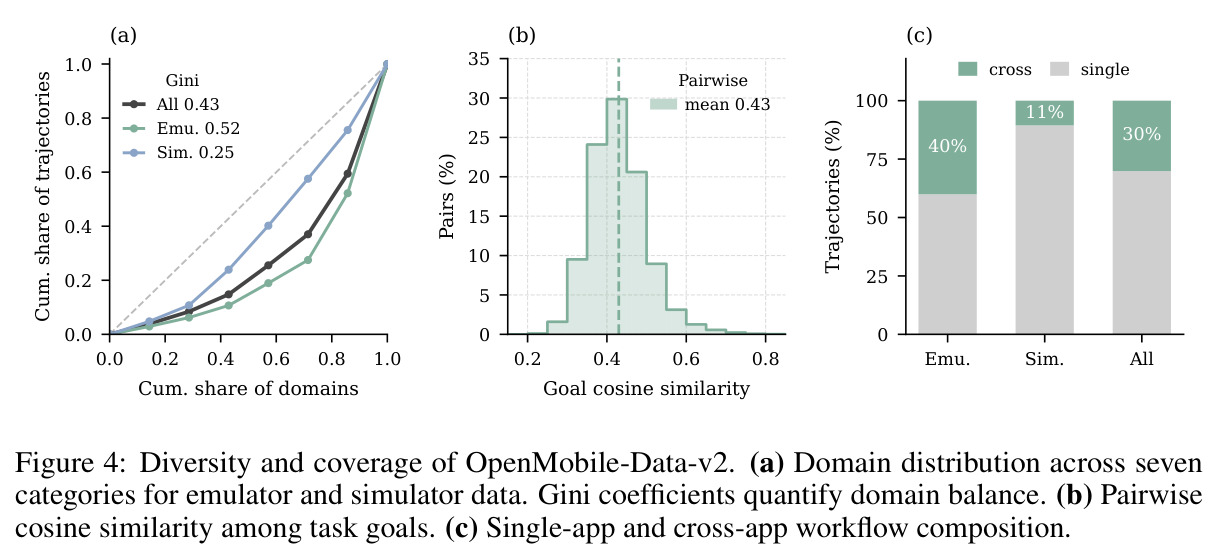
直觉上,这篇工作像'给智能体建一所设备齐全的驾校,再自己编写教材和考卷'。技术路线分三步。第一步是环境:在 MobileGym 模拟框架上构建 MobileGym++,每个新应用先从源应用的数据 schema 与交互图写起(先定业务状态再画界面),由人工标注者对照真实应用迭代打磨功能与视觉,交付前做覆盖检查(声明的交互都有实现绑定)和核心流程回放检查(状态转换产生声明的状态变更);所有应用运行在一台可序列化、可确定性重置的共享设备上,观察只有原始屏幕像素,没有 accessibility tree,智能体无法直接读取业务状态。第二步是数据:为每个应用构建状态-动作转移图(全局视图概括功能布局、局部视图列出当前状态可达的动作),用 Gemini-3.1-Pro-Preview 生成真实可执行的用户指令并做质量与多样性过滤;再让同一模型作为教师逐步执行任务,只保留通过验证器的成功轨迹并做步级清洗,得到 OpenMobile-Data-v2:11,643 条 SFT 轨迹(7,725 条来自模拟器、3,918 条来自模拟环境,其中 1,774 条为混合工具轨迹,合计 118,582 个步级样本)和 2,475 个 RL 任务。第三步是训练:从 Qwen3.5-9B / Qwen3.6-27B 出发,先分别做 GUI-only 与 Hybrid 两个 5 epoch 的 SFT,再用 DAPO 目标在 512 个采样任务上做强化学习。
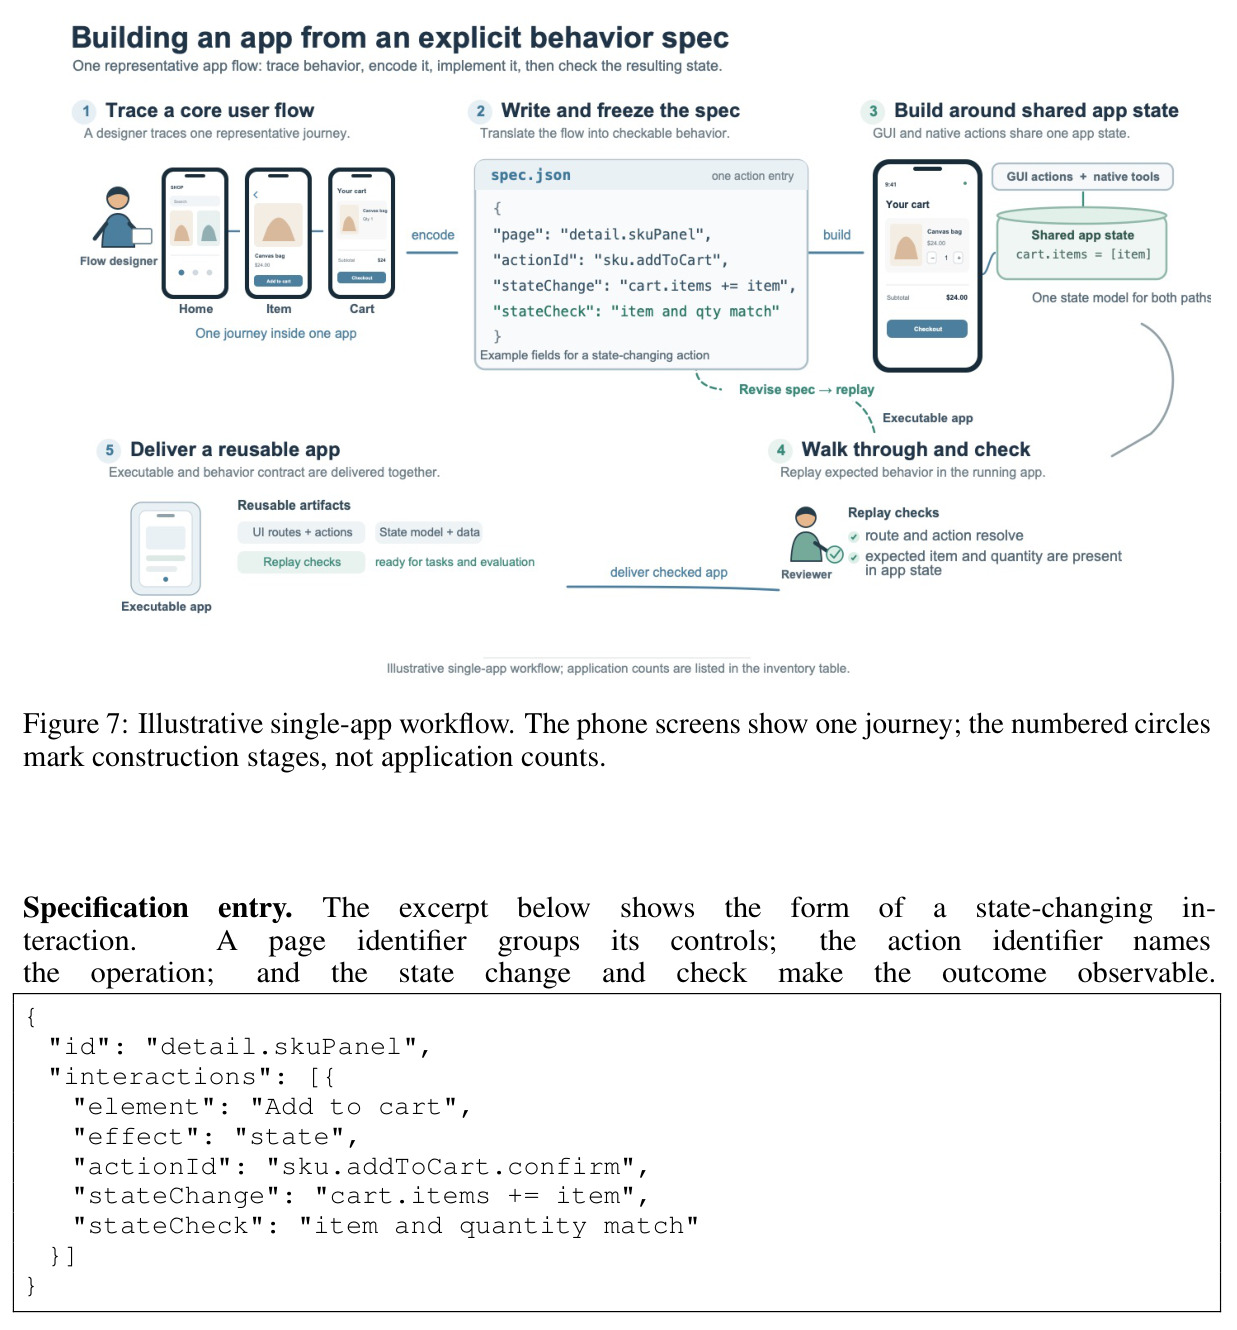
核心创新是'结构忠实且状态可验证的商业应用复刻'加上'与 GUI 语义等价的应用原生工具'。与已有方法的本质区别在于:真实应用环境(AndroidWorld、MobileWorld、SPA-Bench)胜在真实却无法干净重置、难以并行;模拟环境(MobileGym、AppWorld)胜在可控却应用少、领域窄。MobileGym++ 用工程化配方同时拿到两头的好处——业务状态在实现之前就由行为规范固定下来(页面节点、状态变更交互、状态检查三元组),每个应用维护自己的业务对象(订单、预算、行程),随交互演化并可被程序化校验,因此大规模 rollout 时重置廉价、奖励可靠。工具侧的关键设计是'app-native':工具处理器和可见 GUI 使用同一个状态存储(如淘宝的 useTaobaoStore),taobao__add_to_cart 更新的正是 GUI 渲染的购物车,工具调用与其 GUI 对应操作修改同样的持久状态、由同样的终态条件评估。再加上所有 Bench 任务都被设计为可以纯 GUI 完成,就能在同一任务套件上干净地度量'工具这个补充动作通道到底值多少分'——这是以往外挂 MCP 方案做不到的受控比较。
方法步骤详情
第一步,环境构建。输入是源应用的功能范围,输出是 35 个高保真模拟客户端:先写行为规范,把核心工作流表示为页面节点和有意义 UI 状态构成的图,每个改变状态的交互都指明 UI 元素、动作 ID、预期状态效果(如 stateChange: cart.items += item)和状态检查;再按规范实现路由与动作;交付前执行两项检查——覆盖检查把声明的交互 ID 映射到实现绑定,回放检查确认代表性转换产生声明的状态变化。第二步,任务与数据合成。对模拟器应用通过探索发现屏幕、动作与转换(感知相似的截图合并为代表状态),对模拟应用直接从后端规范导出全局/局部视图;Gemini-3.1-Pro-Preview 基于视图生成以用户目标措辞的指令(不点名控件、工具或验证器字段),过滤低质与高相似任务;教师模型逐任务执行,模拟器侧用视觉语言裁判判成败,模拟环境侧用程序化验证器;成功轨迹再做步级过滤,删除无意义动作循环和状态不变的动作。第三步,SFT:GUI-only run 用 9,869 条轨迹(106,488 步),Hybrid run 用 11,643 条(118,582 步,含 1,774 条混合轨迹);每步一个样本(指令+历史+最近 3 张截图+Thought+单次工具调用),截图以 1080×2400 原生分辨率输入,坐标归一化到 999×999 空间,共训 5 个 epoch,学习率 $5\times10^{-6}$,视觉塔冻结,8 卡 GPU。第四步,RL:从 Hybrid SFT 检查点出发,在 MobileGym++ 的 512 个任务上训练,每组 8 条 rollout,DAPO 非对称裁剪 $\epsilon_{low}=0.2,\ \epsilon_{high}=0.28$,KL 系数 0.01,LoRA rank-64(视觉塔冻结),32 张 H800 跑 150 步;奖励 $r = v\cdot m_{\text{tool}}\cdot\ell - 0.2\,n_{\text{fmt}} - 0.2\,f_{\text{succ}}$,其中 $v\in\{0,1\}$ 是宽松状态验证器,$m_{\text{tool}}=2$ 当轨迹含至少一次 app-native 工具调用否则为 1,$\ell$ 是长度因子(12,000 token 内为 1,至 28,672 线性降到 0.5),$n_{\text{fmt}}$ 是格式错误轮数,$f_{\text{succ}}$ 标记虚报成功。
技术新颖性
技术新颖性体现在四个方面。(1) 应用构建配方:以往模拟环境要么从 API 出发(AppWorld,9 个应用、无手机 GUI),要么应用少且无扩展方法(MobileGym 仅 12 个商业应用);本文给出'规范先行—实现—双重检查'的可复制流程,让商业应用复刻可以规模化,新应用达到旧应用 1.48 倍交互动作与 1.91 倍页面转换。(2) 状态级验证:不同于 AndroidWorld 等依赖设备级信号或模型裁判的方案,MobileGym++ Bench 检查应用业务对象的前后 diff,不检查轨迹与截图,判分确定且对 GUI 动作与工具调用一视同仁,这对 RL 训练尤为关键——奖励信号必须是可靠且不可被策略钻空子的。(3) App-native 工具与受控比较:300+ 工具覆盖 50+ 应用,与应用共享状态;同一套 215 个任务、相同初始状态和检查器同时用于 GUI-only 与混合评估,这是移动领域第一个能干净度量'GUI 之外工具通道增益'的设定,此前的 MAS-Bench 用快捷方式、MobileWorld 用外部 MCP,都无法保证语义等价。(4) 全栈开源:环境、11.6K 轨迹、2,475 个可执行 RL 任务、完整超参配方与 9B/27B 模型全部开放,而开源权重竞品(UI-Venus-1.5、GUI-Owl-1.5、MAI-UI)普遍不开训练环境和数据生产管线。
实验结果
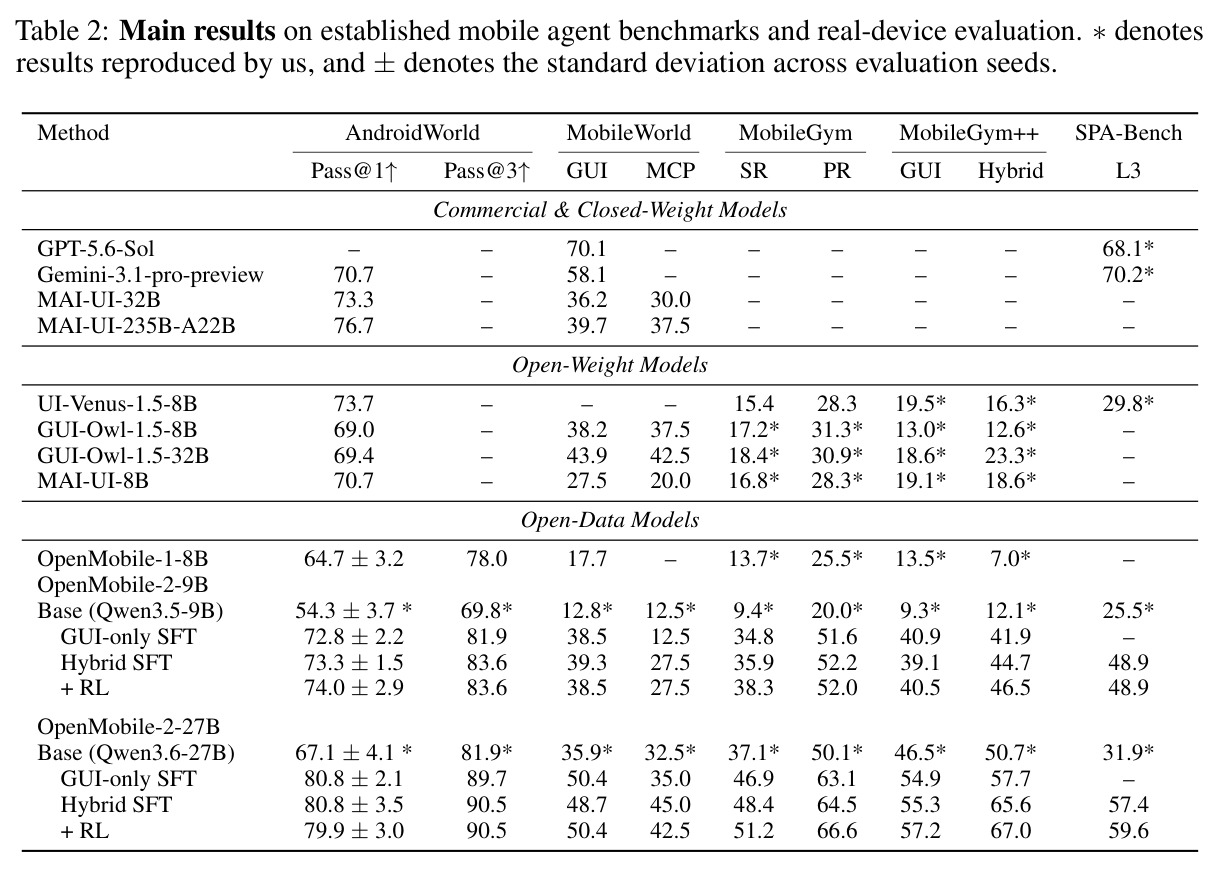
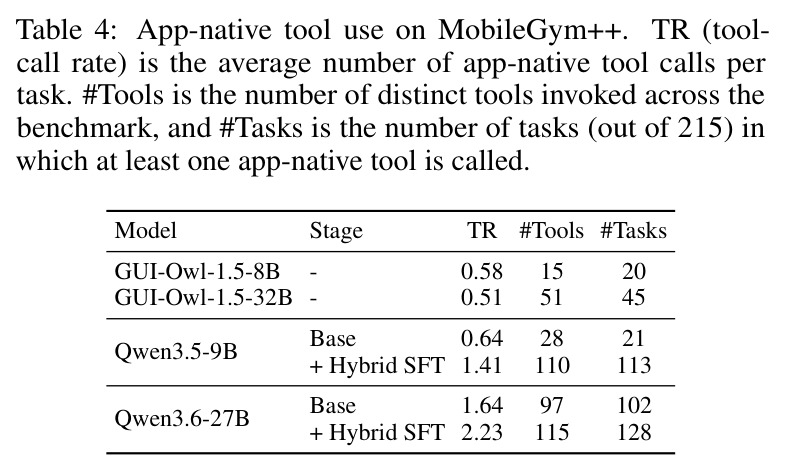
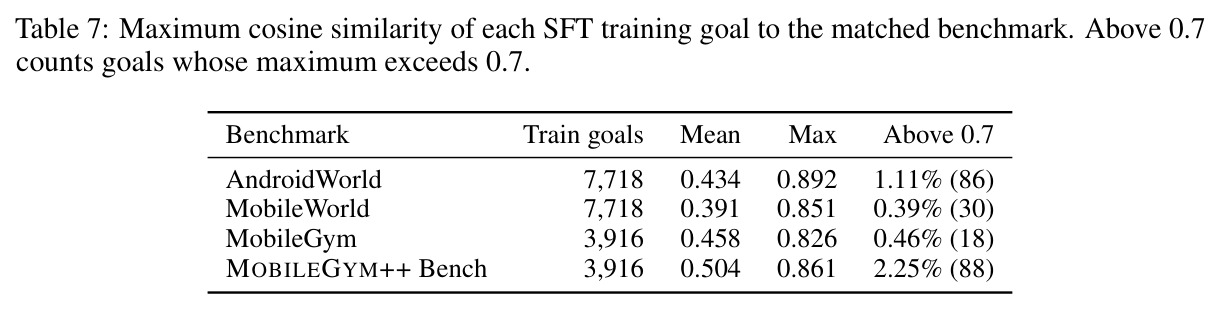
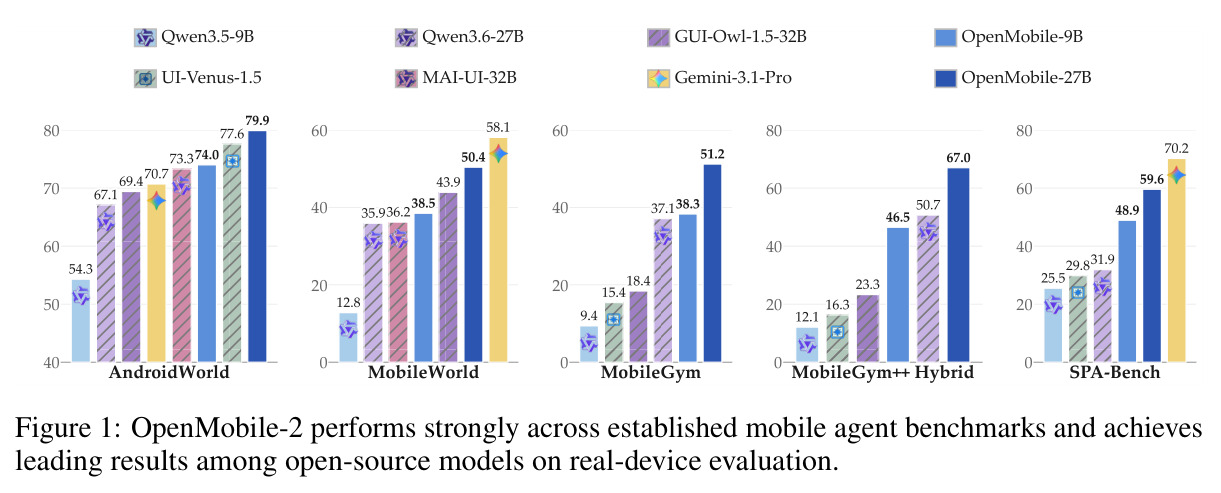
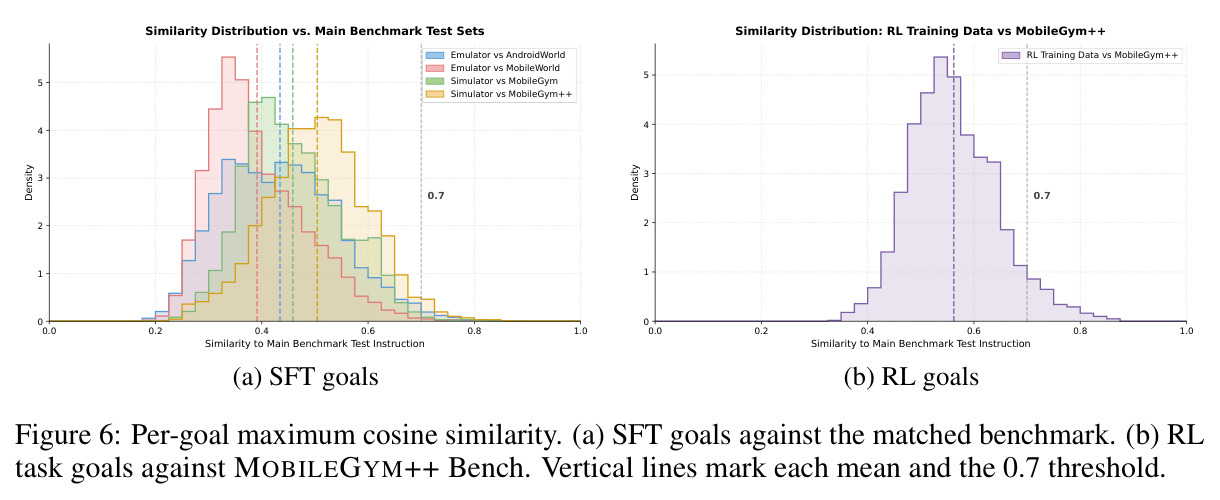
逐一分析核心实验。第一,主结果(Table 2):SFT 带来最大增益——9B 模型在 AndroidWorld 上从基座 54.3 升到 RL 后 74.0(+19.7),27B 从 67.1 升到 79.9(+12.8);MobileWorld GUI 上 27B 达 50.4,超过所有开源权重模型(MAI-UI-235B-A22B 为 39.7),但落后闭源 GPT-5.6-Sol(70.1)和 Gemini-3.1-Pro(58.1);MobileGym 成功率 27B 从基座 37.1 提到 51.2;MobileGym++ Bench 混合评估 27B 达 67.0。第二,真机迁移:SPA-Bench L3 上 27B 从基座 31.9 提到 59.6,近乎翻倍,9B 从 25.5 提到 48.9,大幅超过开源对手 UI-Venus-1.5-8B(29.8),证明模拟环境中练出的能力能迁移到物理设备。第三,RL 的收益有明确边界:它主要提升与训练环境对齐的 MobileGym(9B 35.9→38.3,27B 48.4→51.2)和 SPA-Bench(27B 57.4→59.6),对 AndroidWorld 基本无增益甚至微降(80.8→79.9),作者坦言 RL 红利依赖训练与评估场景的对齐。第四,工具通道需要训练解锁:基座模型几乎不会用工具——9B 基座只在 215 个任务中的 21 个里调用过 28 种工具(调用率 0.64),直接给工具仅带来 2.8-4.2 分收益,GUI-Owl-1.5 甚至退化;Hybrid SFT 后 9B 在 113 个任务里用到 110 种工具(调用率 1.41),27B 在 128 个任务里用到 115 种(调用率 2.23),工具增益升到 5.6 和 10.3 分,且轨迹平均缩短 4.8 和 5.8 步。第五,工具使用可泛化:在训练中未见过的 MobileWorld MCP 工具上,Hybrid SFT 27B 达 45.0,比 GUI-only SFT 的 35.0 高 10 分,说明学到的是通用工具使用策略而非记忆特定 API。第六,覆盖决定泛化:固定 2K 轨迹预算,训练应用从 15 扩到 53 个,held-out AndroidWorld Pass@1 从 60.7 升到 67.5,InD 数据占比从 100% 降到 39.1% 但 InD 性能基本稳定。第七,无数据泄漏:SFT 指令与各基准相似度超 0.7 的仅 0.39%-2.25%,无一超 0.9。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AndroidWorld(模拟器,116 任务 / 20 真实应用) | Pass@1 | 79.9(OpenMobile-2-27B,SFT+RL) | 基座 Qwen3.6-27B 67.1;最强开源权重 MAI-UI-235B-A22B 76.7;闭源 Gemini-3.1-Pro 70.7 | 较基座 +12.8,超过最强开源权重模型 +3.2 |
| MobileWorld GUI-only(201 个长时程跨应用任务) | 成功率 | 50.4(27B,GUI-only SFT 与 +RL 同分) | 基座 35.9;开源 MAI-UI-235B-A22B 39.7;闭源 GPT-5.6-Sol 70.1 | 较基座 +14.5,较最强开源 +10.7,仍落后闭源前沿约 20 分 |
| MobileGym(256 个模拟应用任务) | 成功率 SR(进度率 PR 66.6) | 51.2(27B,+RL) | 基座 37.1;GUI-Owl-1.5-32B 18.4;UI-Venus-1.5-8B 15.4 | 较基座 +14.1,较最强开源对手 +32.8 |
| MobileGym++ Bench 混合评估(215 任务,GUI+工具) | 成功率 | 67.0(27B,+RL) | 基座 50.7;GUI-only SFT 57.7;GUI-Owl-1.5-32B 23.3 | 较基座 +16.3,混合训练较 GUI-only SFT 再 +9.3 |
| SPA-Bench L3(真机评估) | 成功率 | 59.6(27B,+RL) | 基座 31.9;UI-Venus-1.5-8B 29.8;闭源 Gemini-3.1-Pro 70.2 | 较基座 +27.7(近翻倍),较最强开源 +29.8 |
| MobileWorld MCP(训练未见的工具接口) | 成功率 | 45.0(27B,Hybrid SFT) | GUI-only SFT 35.0;基座 32.5 | 混合训练带来 +10.0,证明工具使用策略可泛化到未见工具 |
局限与改进
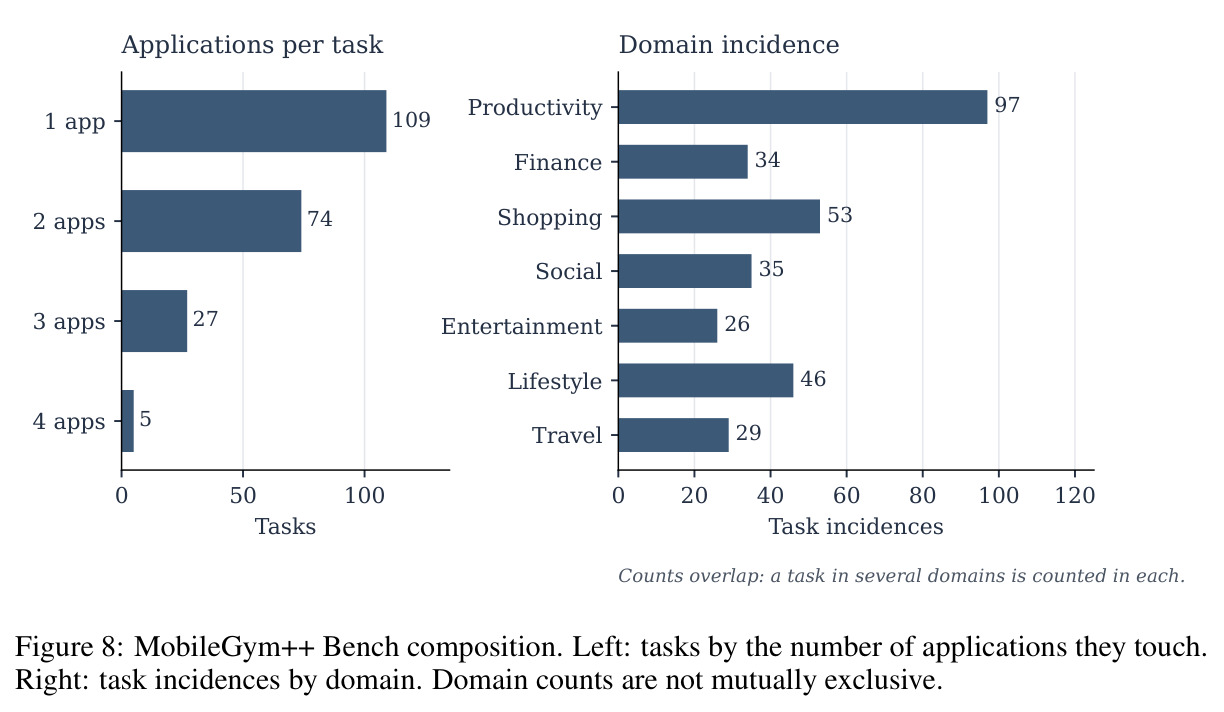
作者承认的局限:其一,RL 的增益局限于与训练环境对齐的场景,27B 在 AndroidWorld 上 RL 后从 80.8 微降到 79.9,MobileWorld 也基本持平,文中明确写道'RL benefits depend on the alignment between training environments and evaluation scenarios';其二,RL 只用了 2,475 个任务中随机采样的 512 个,规模有限;其三,与闭源前沿仍有差距(MobileWorld 上 GPT-5.6-Sol 70.1 vs 本文 50.4);其四,评估方差不可忽视,多个结果标注 ±1.5 到 ±4.1 的标准差。我自己观察到的局限:第一,模拟环境的'高保真'主要是结构和状态保真,真实应用的登录验证、动态推荐、广告位、网络延迟等长尾行为无法复刻,这可以部分解释真机 59.6 与模拟环境 67-80 之间的 sim-to-real 差距;第二,app-native 工具是作者自己实现的干净模拟 API,真实 MCP 生态的工具质量参差、有副作用与权限问题,混合策略在真实工具上的稳健性未经验证;第三,Bench 任务最多只跨 4 个应用(仅 5 个任务),真实工作流可能更长更复杂;第四,任务由 Gemini-3.1-Pro 生成、又由同一系模型执行采集轨迹,存在教师偏差,数据多样性受单一教师能力上限制约;第五,RL 奖励中 $m_{\text{tool}}=2$ 的工具加成是硬编码塑形,可能诱导不必要的工具调用而非真正学会'何时该用工具'。
独立分析的弱点
独立分析以下弱点。第一,工具奖励塑形可能学成'工具偏好'而非'工具判断':$m_{\text{tool}}=2$ 直接让含工具调用的轨迹奖励翻倍,智能体可能为了拿加成而滥用工具,尤其当工具调用更省事时。改进方向是把工具加成改为条件化的——只有当工具路径确实更短或更成功时给奖励,或在优势层面做小偏置而非奖励翻倍。第二,训练与评估的同源风险:Bench 的验证器、初始状态和 RL 任务出自同一套环境基础设施,虽然指令级相似度分析很干净(超 0.7 的仅 2.25%),但应用与业务对象的分布是重叠的,MobileGym++ 上 67.0 的数字可能高估真实泛化。改进是引入完全独立构建的第三方商业应用做 held-out 评估。第三,教师单一:数据生成与轨迹采集全靠 Gemini-3.1-Pro,其风格偏差和错误模式会被蒸馏进 1.2 万条轨迹。改进是多教师混合加一致性过滤。第四,真实部署链路缺失:论文没有展示在真机上接入真实 MCP 或无障碍服务工具的实验,'混合能力能否落地'仍是悬而未决的问题,可以在真机上用 MCP 桥接少量真实应用做小规模验证。第五,长时程与记忆:SFT 只保留最近 3 张截图(旧的替换为占位文本),RL 最多 32 张,多应用长任务中早期信息会丢失,而 4 应用任务只有 5 个,长时程能力未被充分压力测试,可以引入显式笔记/记忆机制并扩充深度跨应用任务。
未来方向
作者提出或暗示的方向:继续扩大应用覆盖与领域广度,因为'环境规模化提升泛化'已被控制变量实验证实;深化混合 GUI-工具设定,包括工具覆盖从 50+ 应用继续扩展。基于本文成果可以自然延伸的研究:(1) 把 RL 从 512 个任务扩展到全部 2,475 个并做多轮迭代,同时研究更精细的工具激励形式,例如比较'奖励塑形'与'代价感知'两种方案;(2) 把 app-native 工具推广到真实 MCP 生态,研究工具检索、工具可信度评估与副作用管理,让混合策略走出沙盒;(3) 跨平台迁移——把 Android 上学到的商业工作流经验迁到 iOS 或桌面 GUI,检验'工作流知识'是否平台无关;(4) 利用 MobileGym++ 的程序化验证器训练过程奖励模型(process reward model),摆脱稀疏的 0/1 结果奖励,给 RL 提供更稠密信号;(5) 显式研究 GUI 与工具的自动路由策略——何时该点、何时该调——当前完全靠模型从数据中隐式学习,可以引入显式决策头或开销感知规划;(6) 多智能体协作处理超长跨应用工作流,以及把用户偏好和持久记忆纳入环境状态。
复现评估
开源情况:论文声称所有资源都在 OpenMobile-2 链接开放——MobileGym++ 环境(63 个模拟客户端)、OpenMobile-Data-v2(11,643 条 SFT 轨迹 + 2,475 个 RL 任务)、MobileGym++ Bench(215 任务)、完整训练配方(含全部超参和系统提示词)以及 9B/27B 模型权重,开放程度在同类工作中属第一梯队(对比 UI-Venus、GUI-Owl 均不开环境与数据生产管线)。算力需求分两档:SFT 用 8 张 GPU(张量并行 4)、bf16、视觉塔冻结,单机即可复现;RL 是最重的部分,需要 32 张 H800(4 节点)、LoRA rank-64、150 步,中小团队难以原样复现,但可以把任务数从 512 缩到 128 左右降低门槛。环境是浏览器托管的模拟应用,每个节点跑一个模拟器实例、64 个并行浏览器页面,推理侧需要 vLLM 引擎;评估 AndroidWorld/MobileWorld 需要 Android 模拟器集群,SPA-Bench 需要物理真机。数据附带完整验证器,复现数据生产管线的主要依赖是 Gemini-3.1-Pro API(任务生成与教师执行)和人工对照校验。总体评估:结果复现容易(模型和 bench 齐备,评测脚本开源),训练复现中等偏难(RL 算力门槛),数据生产复现中等(需要教师模型 API 与标注人力)。
论文图表
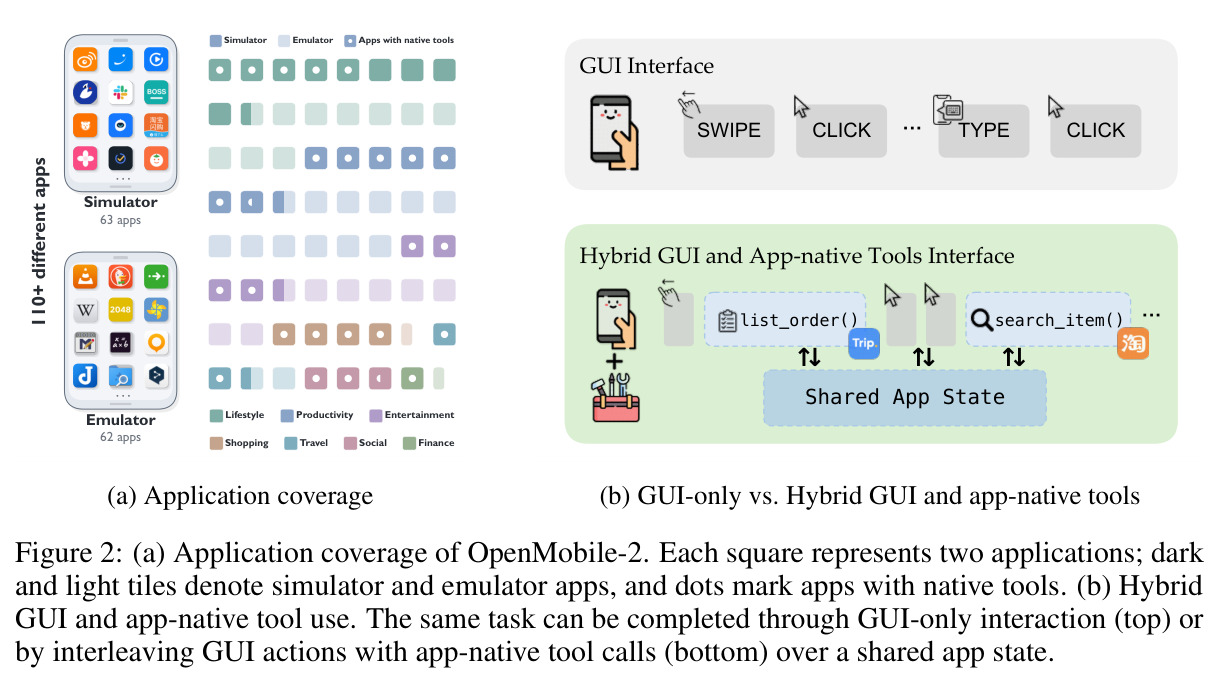
(a) 用方块图展示 110+ 应用覆盖:每个方块代表两个应用,深色为模拟器 63 应用、浅色为模拟环境 62 应用,圆点标记带原生工具的应用,按生活方式、效率、娱乐、购物、旅行、社交、金融七个领域排布;(b) 对比同一任务的两条完成路径:上方纯 GUI 操作序列(SWIPE、CLICK、TYPE、CLICK),下方在共享应用状态上交替使用 GUI 动作与 list_order()、search_item() 等原生工具调用。
同时呈现本文两大支柱——环境应用规模与混合交互设定,(b) 直观解释了'工具与 GUI 操作共享状态'这一核心设计。