Muse Glimmer 30B:面向消费级硬件的端侧智能体模型 Muse Glimmer 30B: An On-Device Agentic Model
Meta 开源的 30B 端侧智能体模型:蒸馏自前沿教师,4-bit 量化后单卡 32GB 可跑
前置知识
知识蒸馏与 Logit 蒸馏
知识蒸馏让小模型(学生)模仿大模型(教师)的输出分布。Logit 蒸馏直接对齐教师输出的 logits:损失常取 $\mathcal{L} = \mathrm{KL}(p_{\text{teacher}} \| p_{\text{student}})$,本文只保留教师 top-256 个 logit 以降低存储成本。相比只学 one-hot 标签的交叉熵,软标签携带教师的『犹豫程度』与替代答案信息,学生因此能继承远超自身规模的推理与工具使用能力。
Muse Glimmer 的预训练与后训练全流程都建立在从 Muse Spark 蒸馏之上,理解 KL 目标、top-k 截断偏差与 on-policy 蒸馏是读懂其方法设计与创新点的前提。
GQA 与 KV Cache
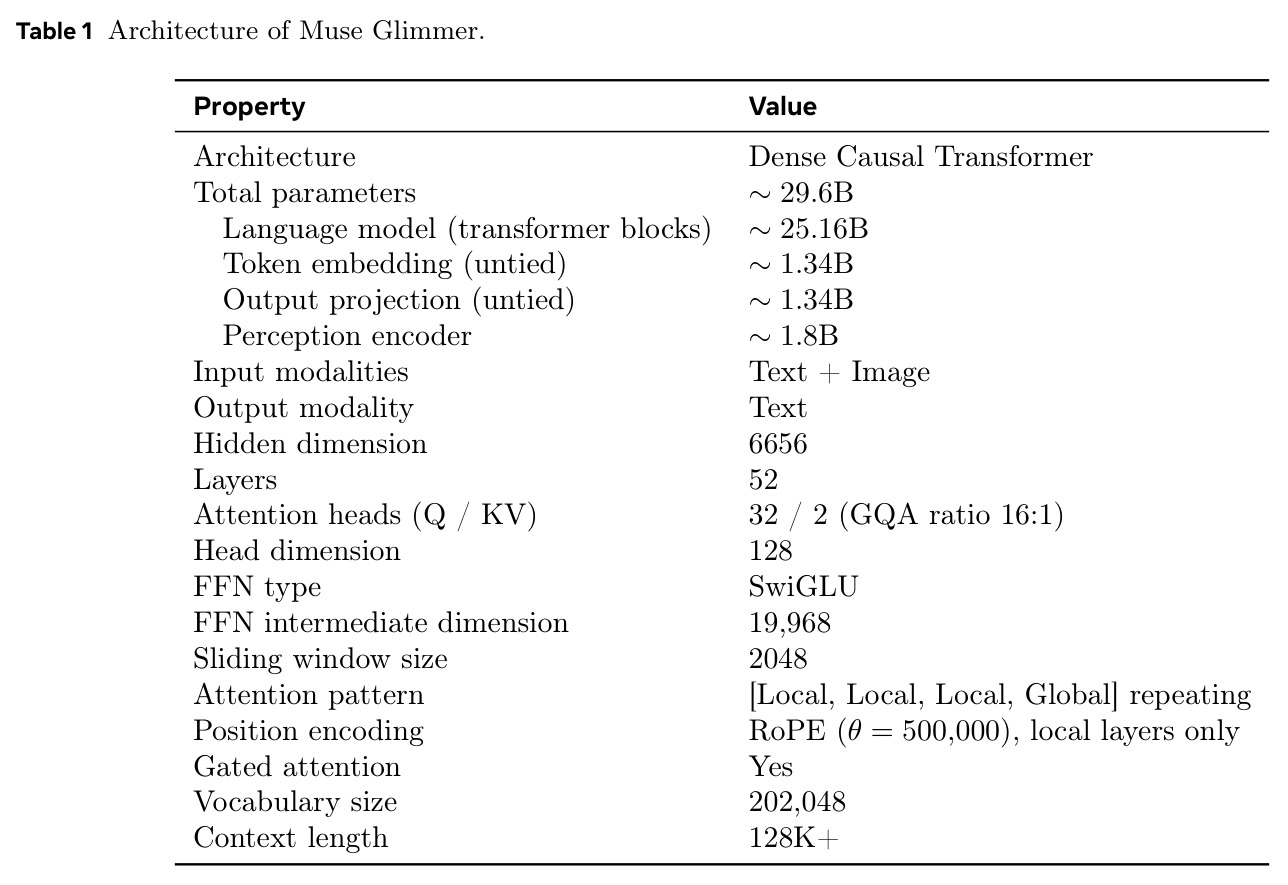
推断时每个已生成 token 的键值对会缓存为 KV cache,长程智能体会话中其显存占用甚至超过权重本身。分组查询注意力(GQA)让多个查询头共享一组 KV 头:本文用 32 个查询头对 2 个 KV 头(16:1),KV cache 直接缩小 16 倍。配合滑动窗口注意力(窗口 2048)与『3 局部 + 1 全局』循环模式,把每层 KV 上限绑定在窗口内。
32GB 显存是本文一切架构决策的出发点,GQA + 滑窗是控制长上下文智能体会话显存的关键手段;文中还报告了简化 MLA 替代方案在 RULER 上不敌 GQA 的负结果。
训练后量化(PTQ)
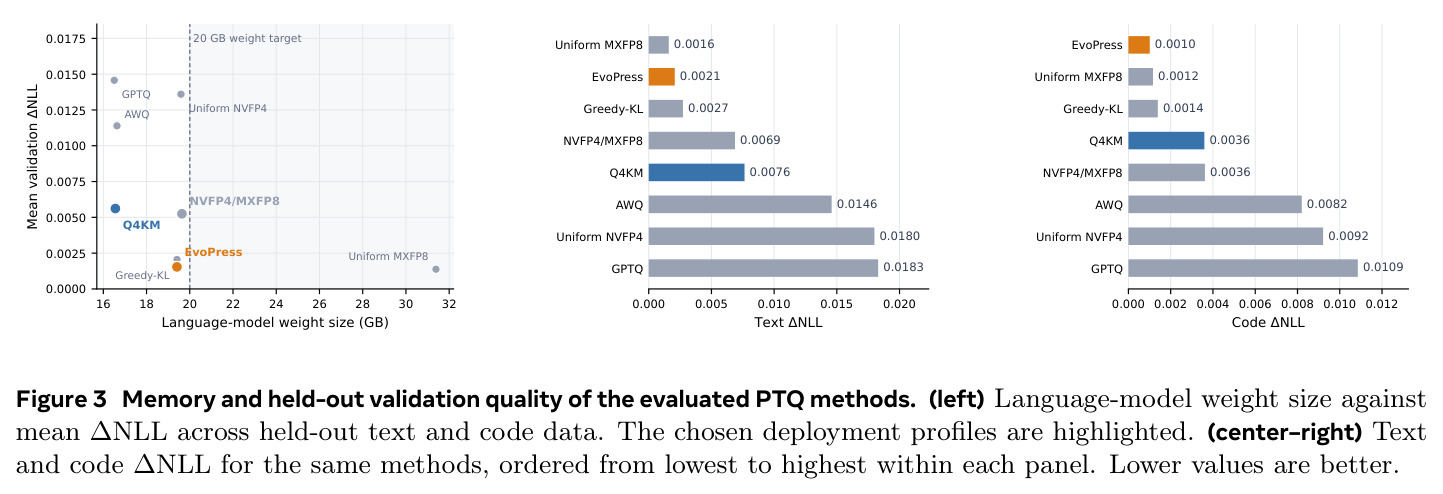
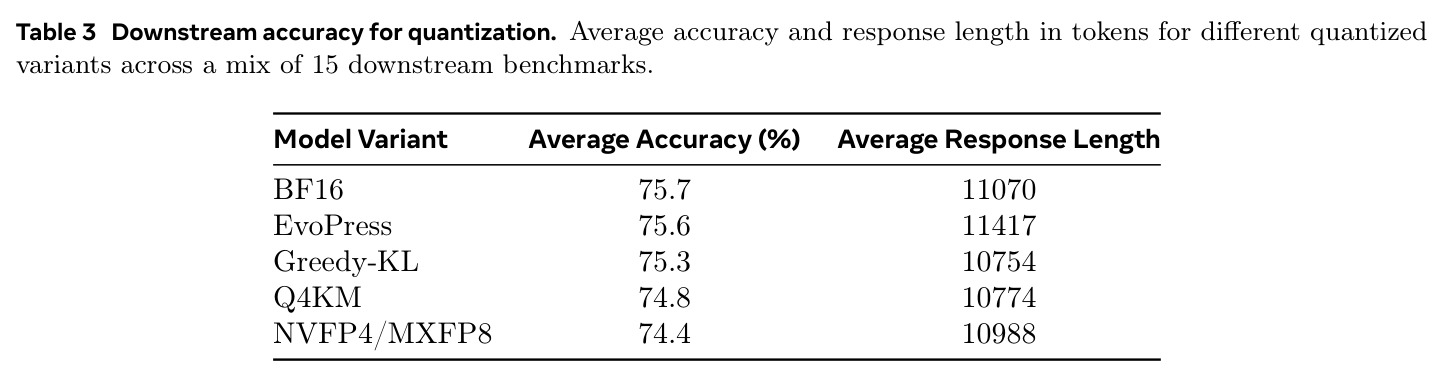
PTQ 在训练完成后把 BF16 权重映射到低比特格式,几乎不重训。常见做法是混合精度分配:敏感张量(如输出投影)用高比特,其余用 4-bit。本文用验证集负对数似然变化 $\Delta\mathrm{NLL}$ 作为筛选指标,比较了 GPTQ、AWQ、NVFP4/MXFP8 浮点格式以及搜索型方法 Greedy-KL 与 EvoPress(进化算法在 418 个权重单元上搜索精度分配)。
模型能否塞进 24/32GB 显存完全依赖量化方案;论文用整节比较各方案的 $\Delta\mathrm{NLL}$ 与 15 项下游任务准确率(BF16 75.7% vs EvoPress 75.6%),是部署结论的核心依据。
投机解码与 DFlash
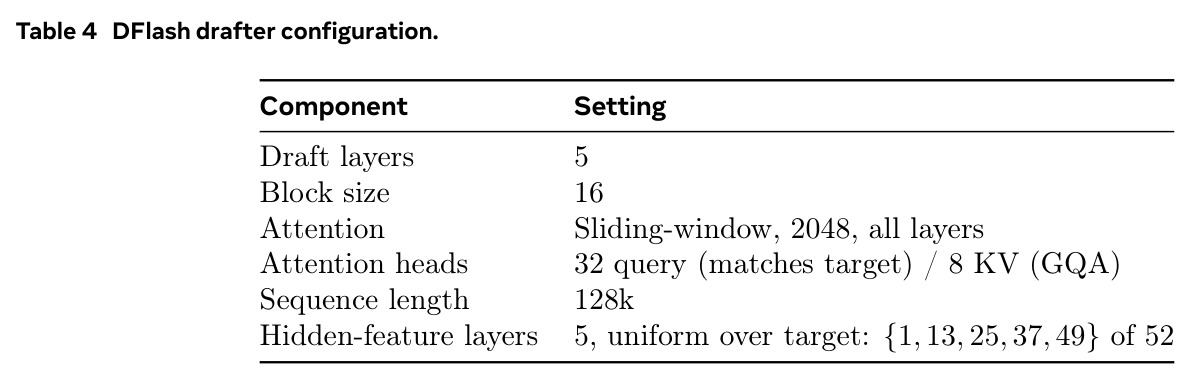
投机解码用一个廉价『草稿模型』快速猜出一段候选 token,再由大模型一次前向验证,接受的部分直接采纳,在不改变输出分布的前提下加速生成。DFlash 用一个 5 层的块扩散(block-diffusion)草稿模型,单次前向预测整块 16 个 token 的边缘分布并独立采样成草稿块,同时从目标模型第 {1,13,25,37,49} 层抽取隐藏特征做条件。
端侧『可用速度』来自 4-bit 量化 + DFlash 投机解码的组合,作者称可在单张 RTX 5090 上达到实用速度且质量几乎无损,这是论文的核心卖点之一,DFlash 头也随权重一起开源。
上下文完整性(Contextual Integrity)
Nissenbaum 提出的隐私理论:信息是否『该分享』取决于交换发生的语境——发送者、接收者、信息类型与传输原则。例如向医生披露病史是恰当的,转发给同事则不是。它把隐私保护从『敏感字段一律打码』升级为『按语境判断信息流是否恰当』,兼顾不过度泄露(violation)与必要分享(coverage)。
本文把 CI 理论直接训练进权重:SFT 注入合成隐私轨迹、RL 惩罚过度分享,并用 CIMemories 基准(violation/coverage 双指标)评估。这是本文区别于一般小模型技术报告的特色章节。
On-Policy 蒸馏
传统蒸馏用教师自己的输出当训练数据(off-policy),学生实际推理时的分布早已漂移。on-policy 蒸馏让学生自己采样 rollout,教师在学生实际走过的每个前缀上提供逐 token 的分布目标作为稠密反馈,直接解决训练-推理分布漂移,教会模型从自己生成的错误路径中恢复。
论文发现 SFT → on-policy 蒸馏 → RL 的三段流水线一致优于直接 SFT → RL,这个中间层是后训练配方的关键一环,也是与 DeepSeek-R1、Qwen3 等蒸馏方案对比时的核心话题。
研究动机
开源社区里能在消费级硬件上运行的模型(如 Gemma4-31B、Qwen3.6-27B)大多按通用目标训练,缺乏可靠自主智能体所需的三种专门能力:持续的多步推理、稳健的工具调用与参数模式遵从、以及对用户私有上下文的规范处理。与此同时,真正具备这些能力的系统都是云端托管的专有模型,本地开发者要么忍受能力差距,要么把敏感数据送上云——对于要替用户读写邮件、日历、代码仓库的个人智能体,后者是不可接受的。论文指出这中间存在一个未被填补的空白:32GB 显存是消费级硬件的实际天花板,如何在这个硬约束下做出能支撑长程智能体会话(128K 上下文、截图/文档多模态输入、多语言、可信赖的隐私与安全行为)的模型,此前没有系统性答案。
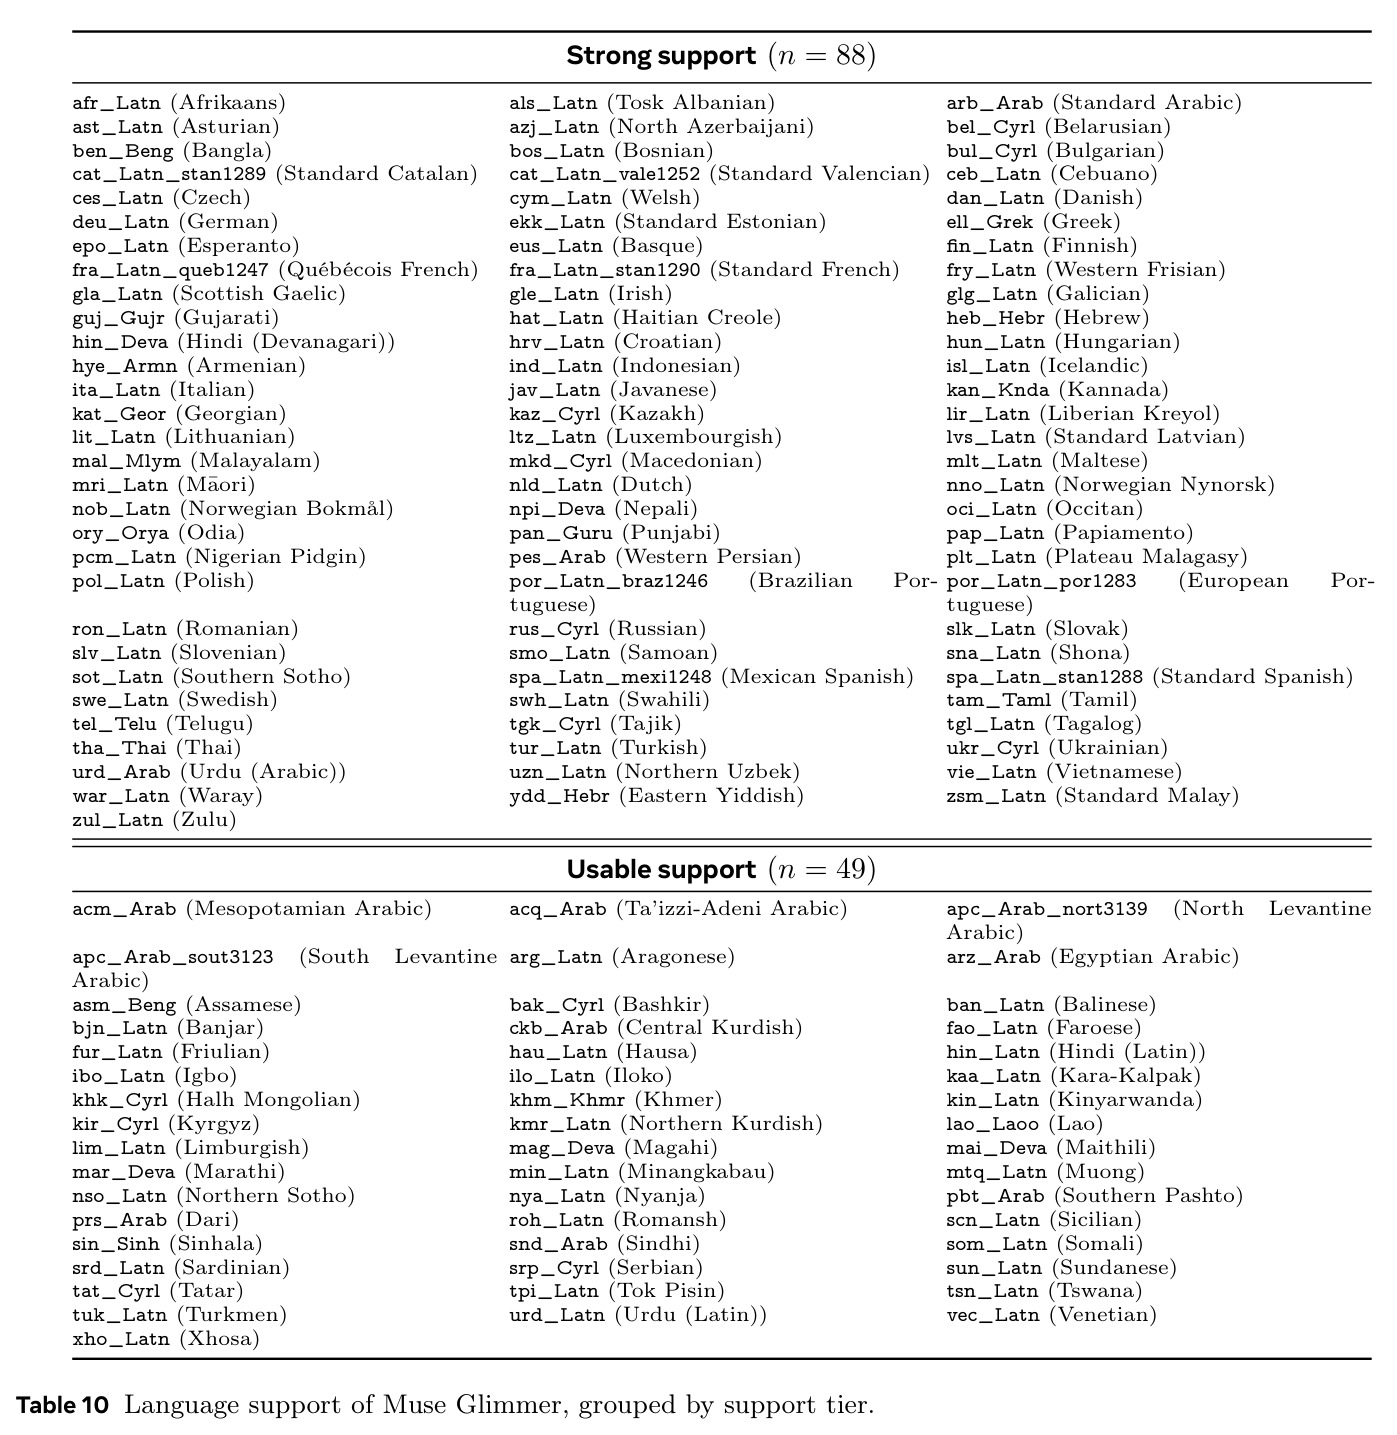
本文的目标是本文的目标是训练并开源一个专门面向自主智能体任务的 30B 模型 Muse Glimmer:接受文本 + 图像输入、支持约 140 种语言、经约 4-bit 量化后在单张 32GB 显存的消费级 GPU 上以实用速度推理,且质量相对全精度几乎无损。具体包括四点:其一,在工具使用、多步规划与智能体任务完成上达到同尺寸级(Gemma4-31B、Qwen3.6-27B)最强水平;其二,把隐私(基于上下文完整性理论)与安全(抗间接提示注入、拒绝层级、不可逆操作确认)行为直接训练进权重,而非依赖易被覆盖的系统提示;其三,验证稠密架构在该内存约束下优于混合专家;其四,以 Apache 2.0 发布 BF16 全精度权重(55.7GB)、4-bit 量化权重和 DFlash 投机解码头,让社区能在本地部署、微调和扩展。
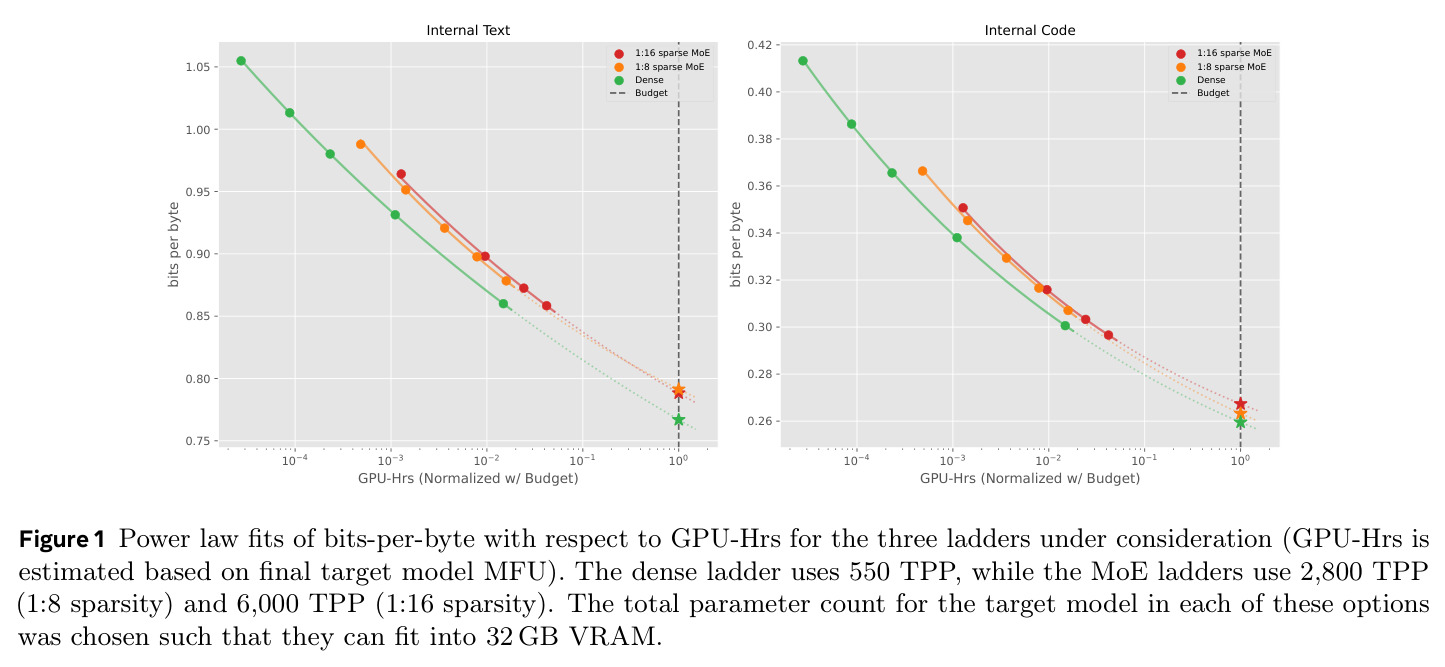
与已有工作不同的是,独特切入有三点。其一,作者不做通用小模型再改造,而是把『端侧智能体』作为第一性目标:从教师 Muse Spark 预训练起就记录其 top-256 logits 做共同蒸馏(co-distillation),mid-training 阶段专门注入智能体轨迹数据,而不是拿通用基座做事后微调。其二,在固定 32GB 内存约束下用缩放阶梯系统比较 dense 与两种 MoE 配置(1:8、1:16 稀疏路由),发现 dense 的计算效率高 2–2.5 倍,从而逆当前 MoE 潮流选择了稠密架构。其三,借鉴 Agents Research Environments 的设计,用合成『数字人生』宇宙(persona + 10–14 位联系人 + 数周邮件/日历/消息历史)批量生成可验证的智能体训练数据,并基于上下文完整性理论把恰当信息流与对抗鲁棒性通过合成轨迹加 RL 奖惩直接写进模型权重。
核心方法
直觉上,这是一条『从前沿教师完整继承智能体能力,再压缩进 32GB 显存』的流水线。技术路线四段:(1) 架构选型先实验:在等推理内存约束下训练 dense 与 MoE(1:8、1:16 稀疏)缩放阶梯,拟合 bits-per-byte 对 GPU-hours 的幂律,dense 胜出后确定 52 层、隐藏维 6656、GQA 16:1、『3 局部 + 1 全局』滑窗循环注意力、128K 上下文的稠密 Transformer,外加 1.8B 冻结的 Perception Encoder 处理图像。(2) 预训练两段式 logit 蒸馏:前 95% 训练只用 $\mathrm{KL}(p_{\text{teacher}}\|p_{\text{student}})$ 对齐教师 top-256 logits,最后 5% 切纯交叉熵以修正截断偏差,再做检查点平均。(3) 两段 mid-training 先注入合成推理与领域数据,再把上下文从 32K 扩到 128K 并混入智能体轨迹。(4) 后训练按 SFT → on-policy 蒸馏 → 多目标 RL 推进,训练出四档推理强度;部署端用 EvoPress/Q4KM 混合精度量化把 55.7GB 权重压到约 20GB,配 5 层 DFlash 块扩散草稿模型做投机解码。
核心创新是把『蒸馏』从单一的预训练技巧升级为贯穿全流程的能力转移机制,并叠加『智能体原教旨主义』的数据设计。与以往只在 SFT 阶段使用教师数据的做法不同:预训练阶段做共同蒸馏——在教师 Muse Spark 预训练的同时记录 top-256 logits,学生前 95% 训练只用 KL 散度、最后 5% 改为纯交叉熵,因为 top-k 截断天然丢弃长尾质量,末段 CE 能消除这一系统性偏置;后训练阶段再做 on-policy 蒸馏,学生自己采样 rollout、教师在学生实际经过的前缀上给出逐 token 分布目标,从机制上解决训练-推理分布漂移,作者实测这一中间层一致提升后续 RL 效果。另一个本质区别是数据:管线批量生成带完整数字人生的模拟宇宙(persona、10–14 位联系人、数周往来记录、依赖序物化的工具状态、可验证 rubric),隐私遵循上下文完整性理论(惩罚过度分享、奖励必要分享),安全采用章程感知(charter-aware)的拒绝采样;这与把通用模型靠提示词包装成 agent 的路线有本质区别。
方法步骤详情
(1) 分词器沿用 Llama 4 BPE,词表 202,048(20 万基础 + 2048 特殊),基础词表按 35% 代码、35% 多语言、15% 数学、15% 英文训练。(2) 预训练以 Muse Spark 为教师做 logit 蒸馏:前 95% 仅 KL 散度、最后 5% 仅交叉熵;数据覆盖网页、代码、STEM、多语言与图像,知识截止 2026-01-04。(3) 检查点平均:最后 5% 训练每 200 步存一次(共 84 个),最终取最后 1 个加 3 个相距 600 步的检查点均匀平均。(4) Mid-training Phase 1 注入合成推理轨迹与结构化解题示范,学习率低于预训练峰值;Phase 2 把上下文从 32K 扩到 128K、混入工具使用与智能体轨迹,因分布漂移改用交叉熵。(5) SFT 约一个 epoch,覆盖推理、代码、数学、指令遵循与智能体脚手架。(6) 从 Muse Spark 的 RL/RLHF 运行抽取教师轨迹(按奖励阈值筛选、偏向后期检查点),清洗后转统一对话格式。(7) on-policy 蒸馏 + 多目标 RL,RL 中按推理强度分组施加长度惩罚,部分 prompt 只路由到高档强度。(8) 同步注入安全 SFT、安全 RL 与基于 CI 的信息流训练。(9) 量化:以 $\Delta\mathrm{NLL}$ 筛选,EvoPress 配置(418 个权重单元按 51/130/237 分配到 Q4/Q5/Q6_K,共 19.65GB)用于 32GB 机型,Q4KM 用于 24GB。(10) 训练 5 层 DFlash 草稿模型(块大小 16、D-PACE 目标、锚点采样率 1/16)做投机解码。
技术新颖性
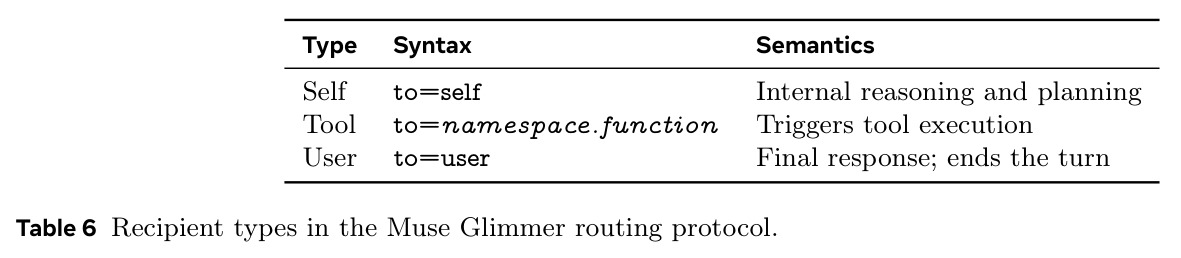
新颖性体现在五处。(1) 等内存约束下的 dense-vs-MoE 缩放阶梯决策:以固定推理内存为基准,按 GPU-hours 与估计 MFU 反推 target tokens-per-parameter(dense 550 TPP,MoE 为 2,800/6,000 TPP),用幂律证明 dense 在此预算下效率高 2–2.5 倍——为『小内存不一定选 MoE』提供实证。(2) top-256 logits KL + 末段 CE 的两段式蒸馏目标,显式处理 top-k 截断偏差,同类报告少有如此明确的配方。(3) 检查点 souping 的系统化消融(均匀/WMA/EMA × 窗口 × 步距),给出可复用配方。(4) 简化 MLA 在全局层的负结果:减半 KV 与加倍头数两种配置都在 RULER 上不敌 GQA,作者保留 GQA——负结果罕见且有社区价值。(5) 把隐私(CI 理论)与抗注入能力直接训进权重,工具返回用 Security Notice 与 EXTERNAL_UNTRUSTED_CONTENT 哨兵包裹;配合 ATEM XML 工具调用与 to=self/tool/user 路由协议,把私有思考与对外输出在 token 层面显式分离。
实验结果
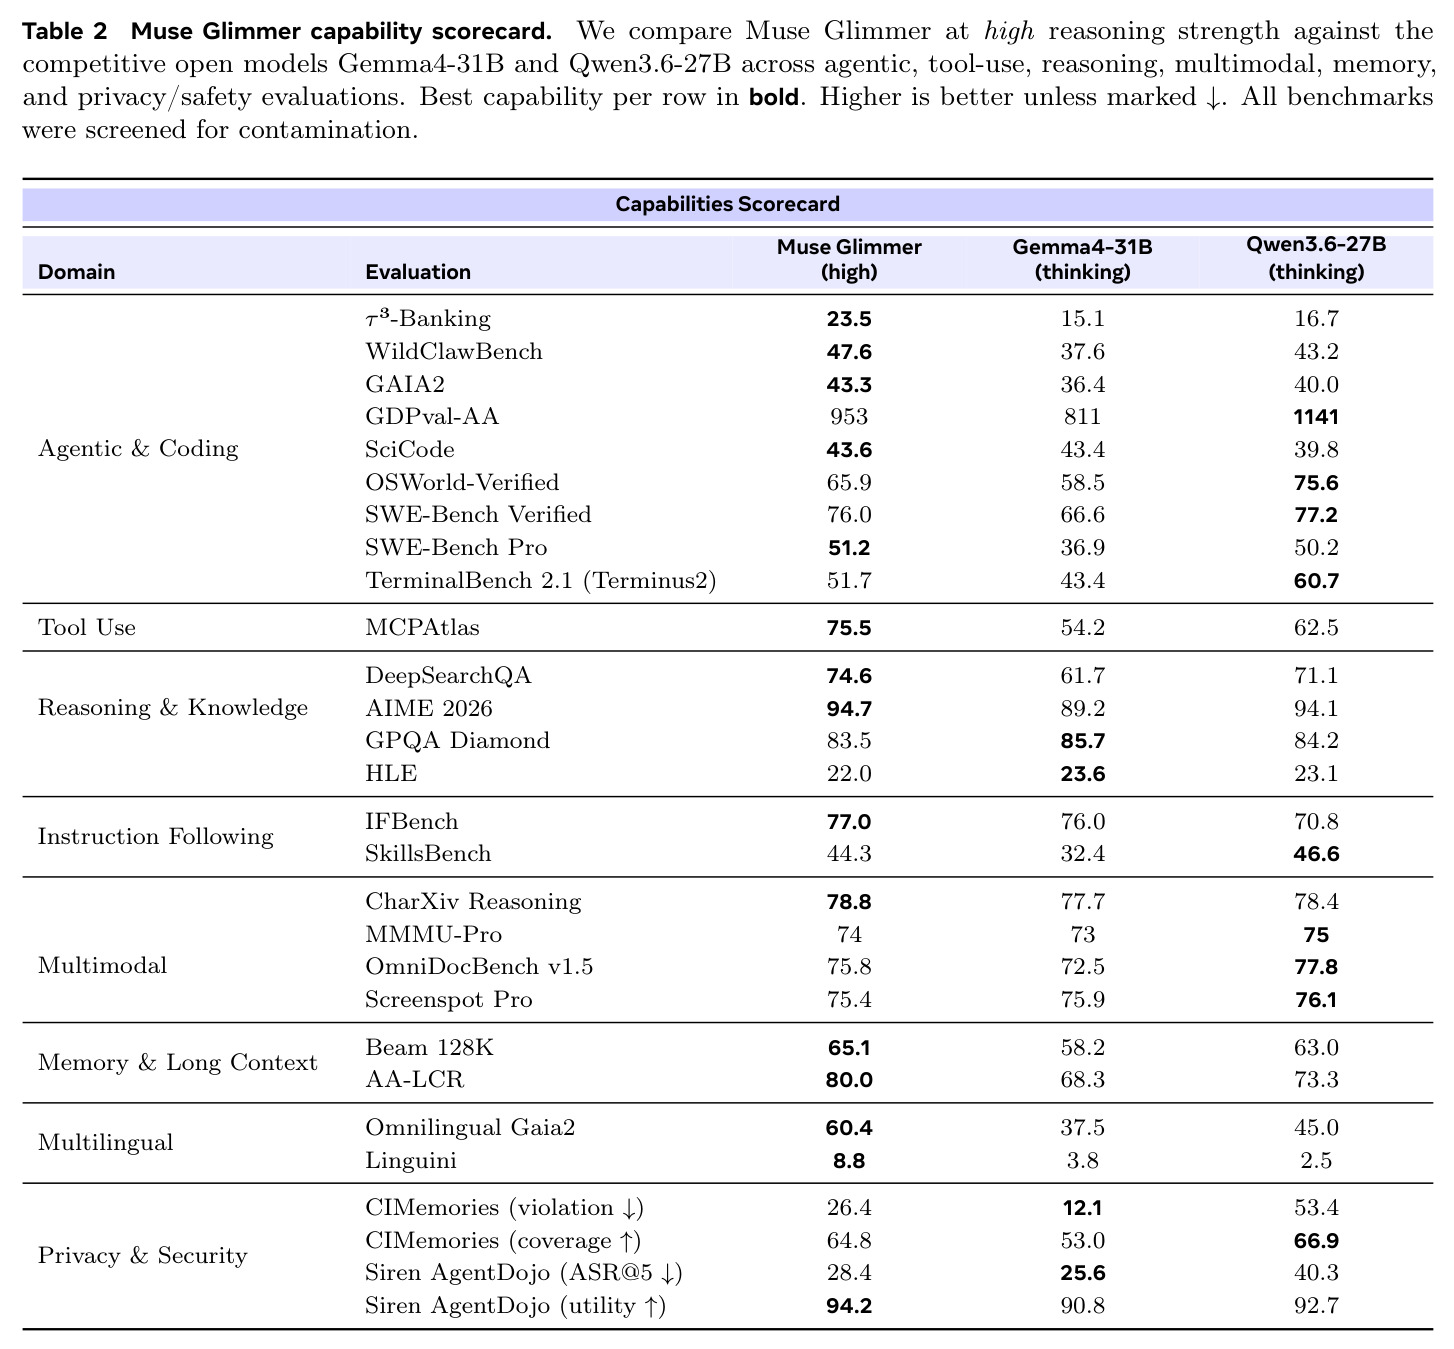
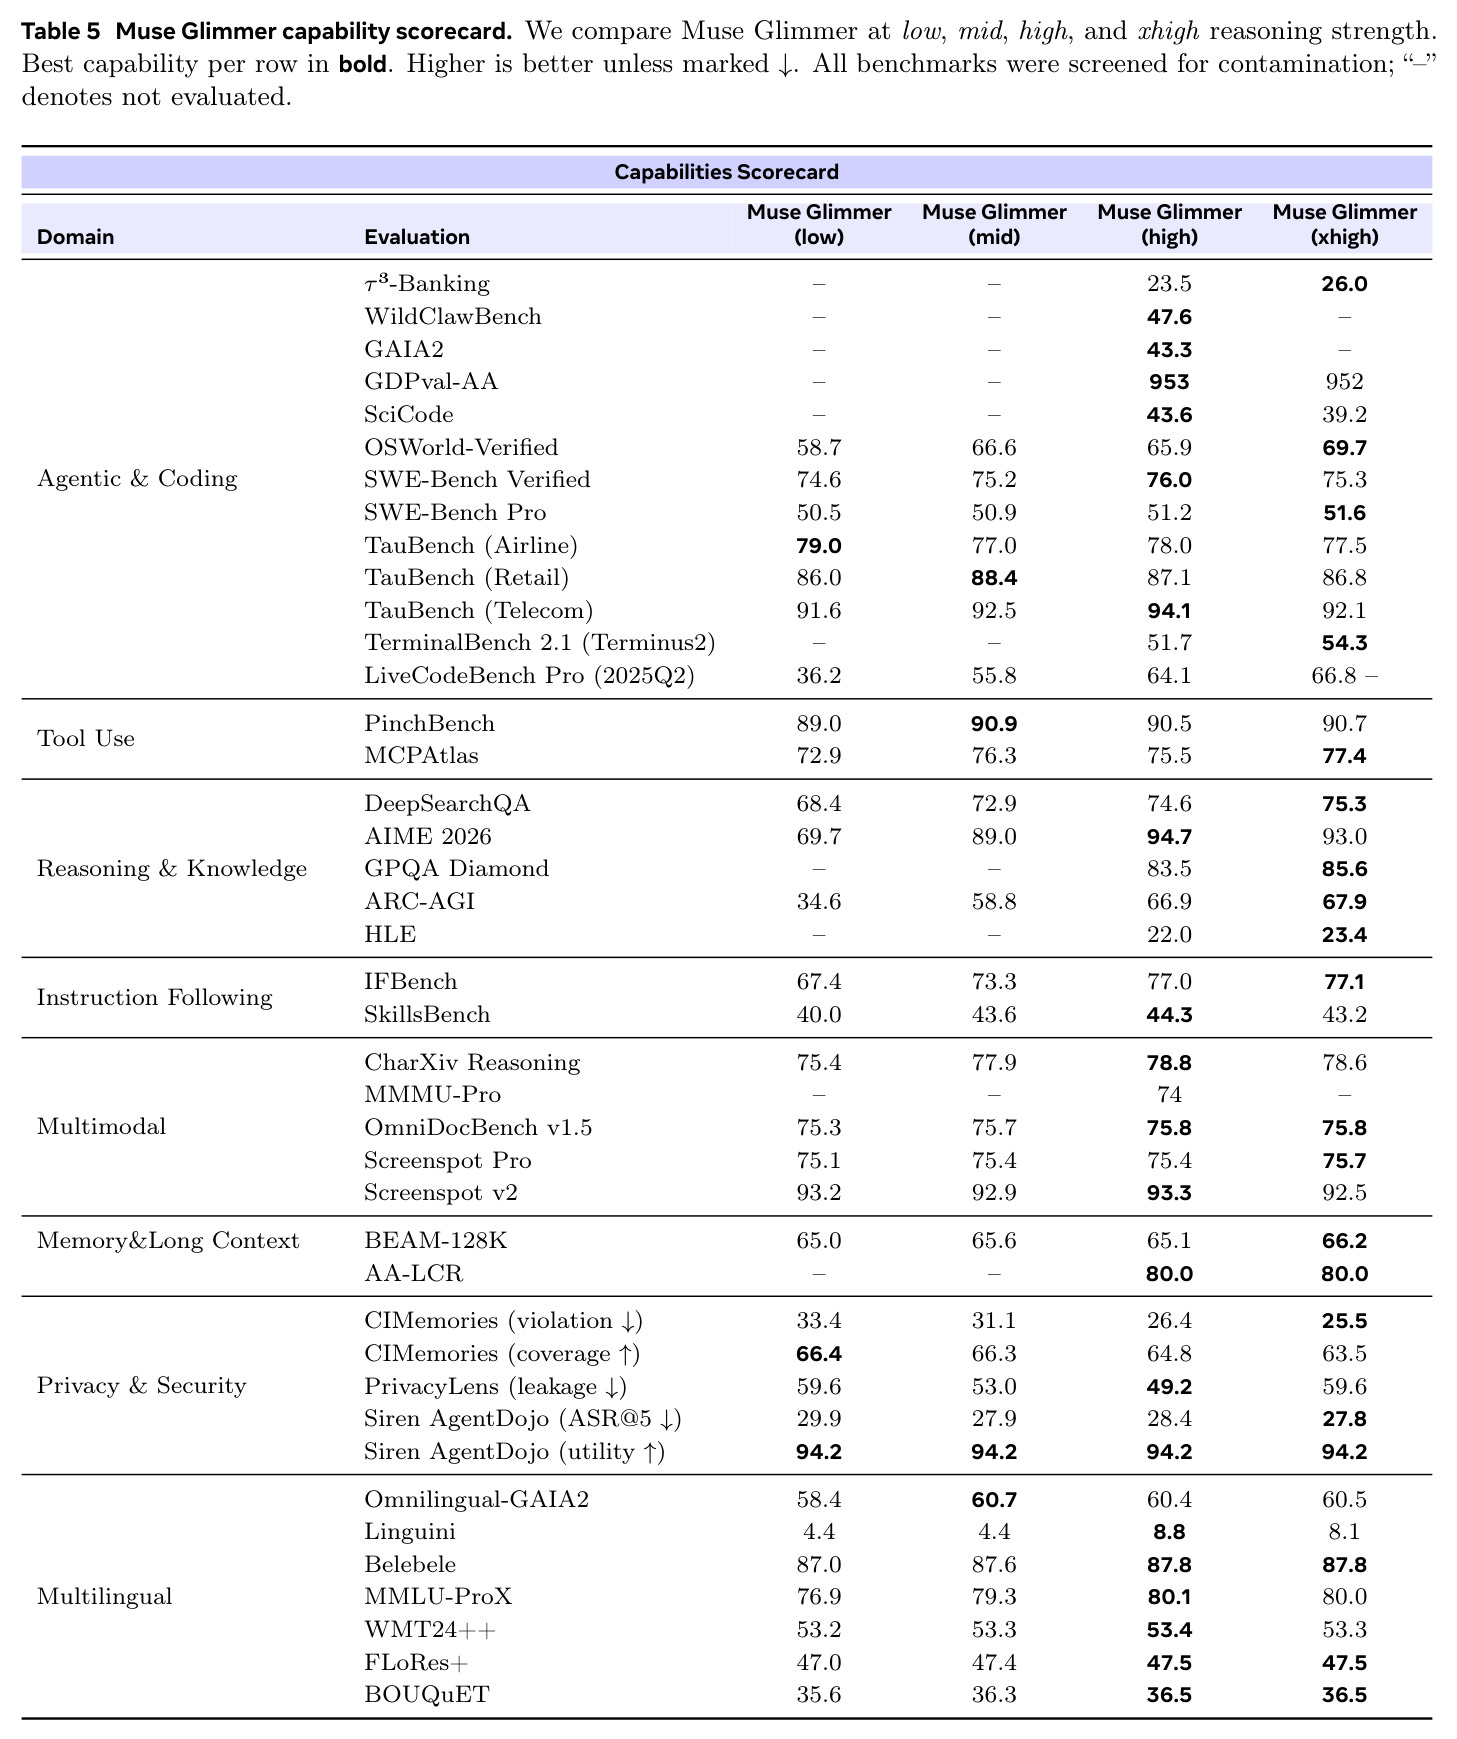
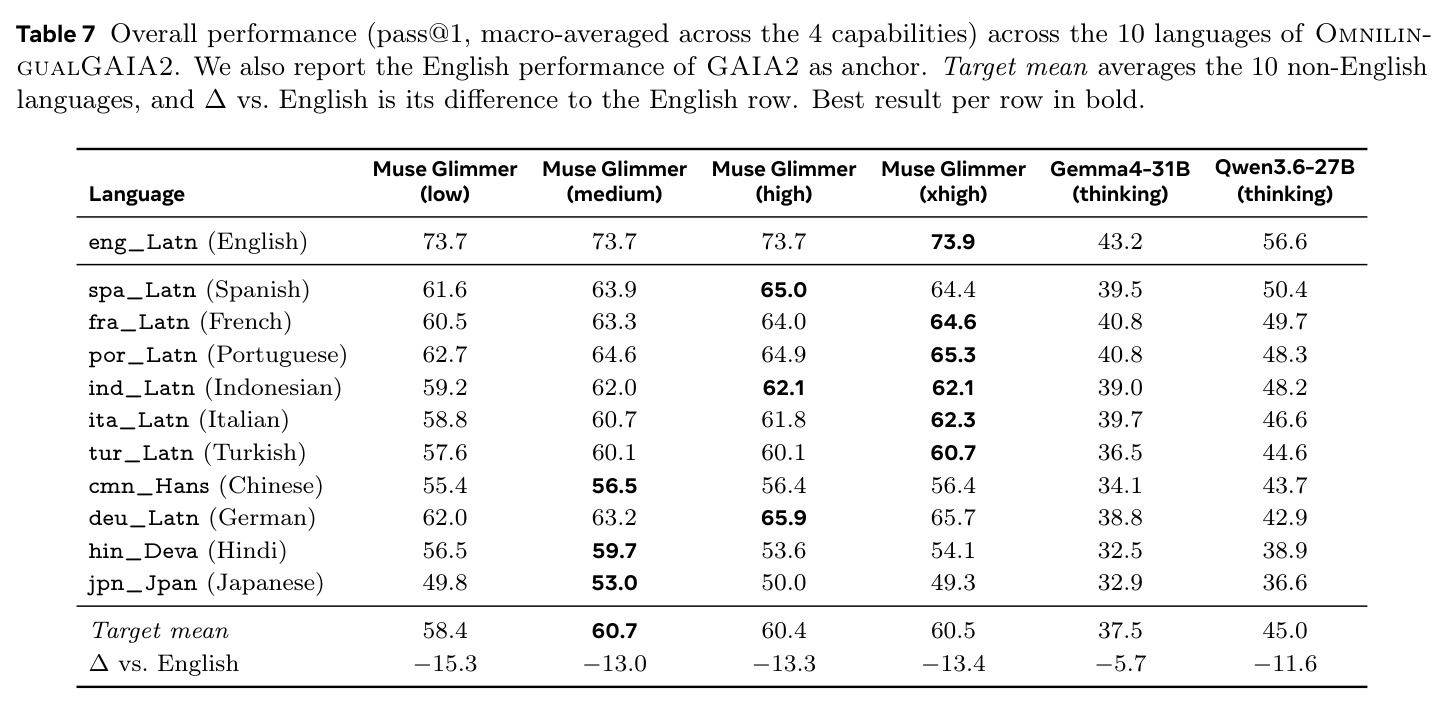
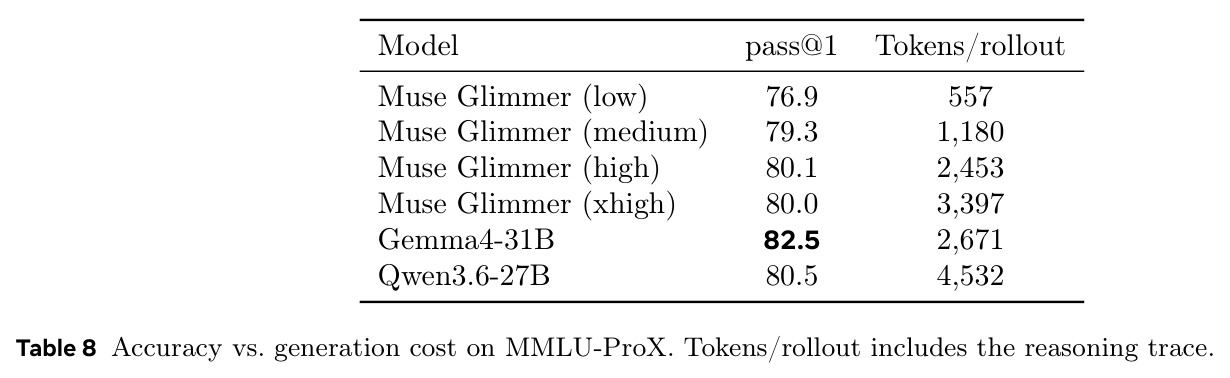
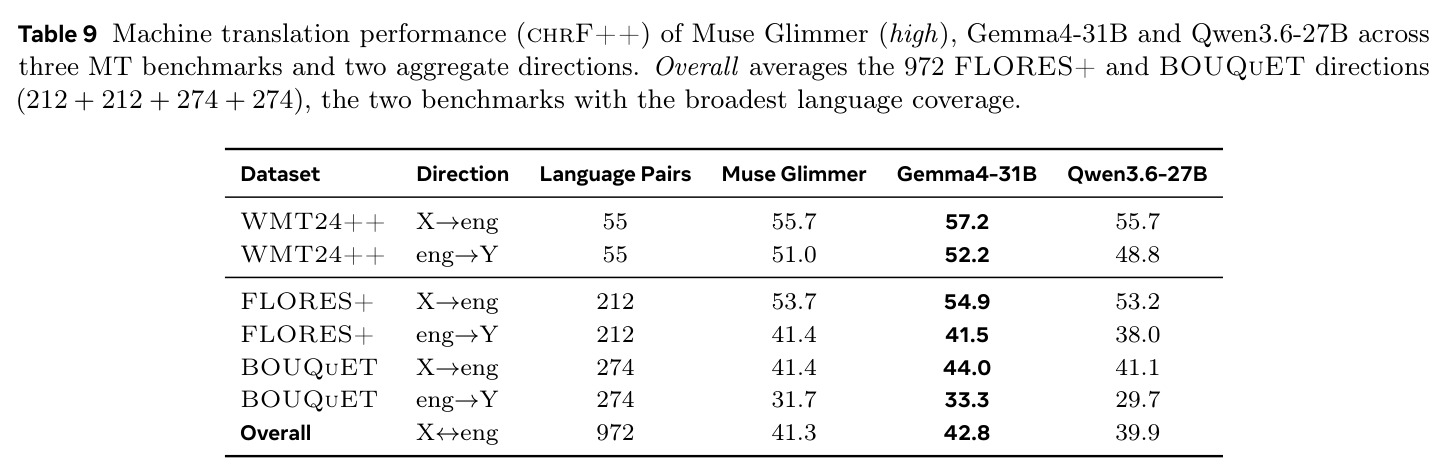
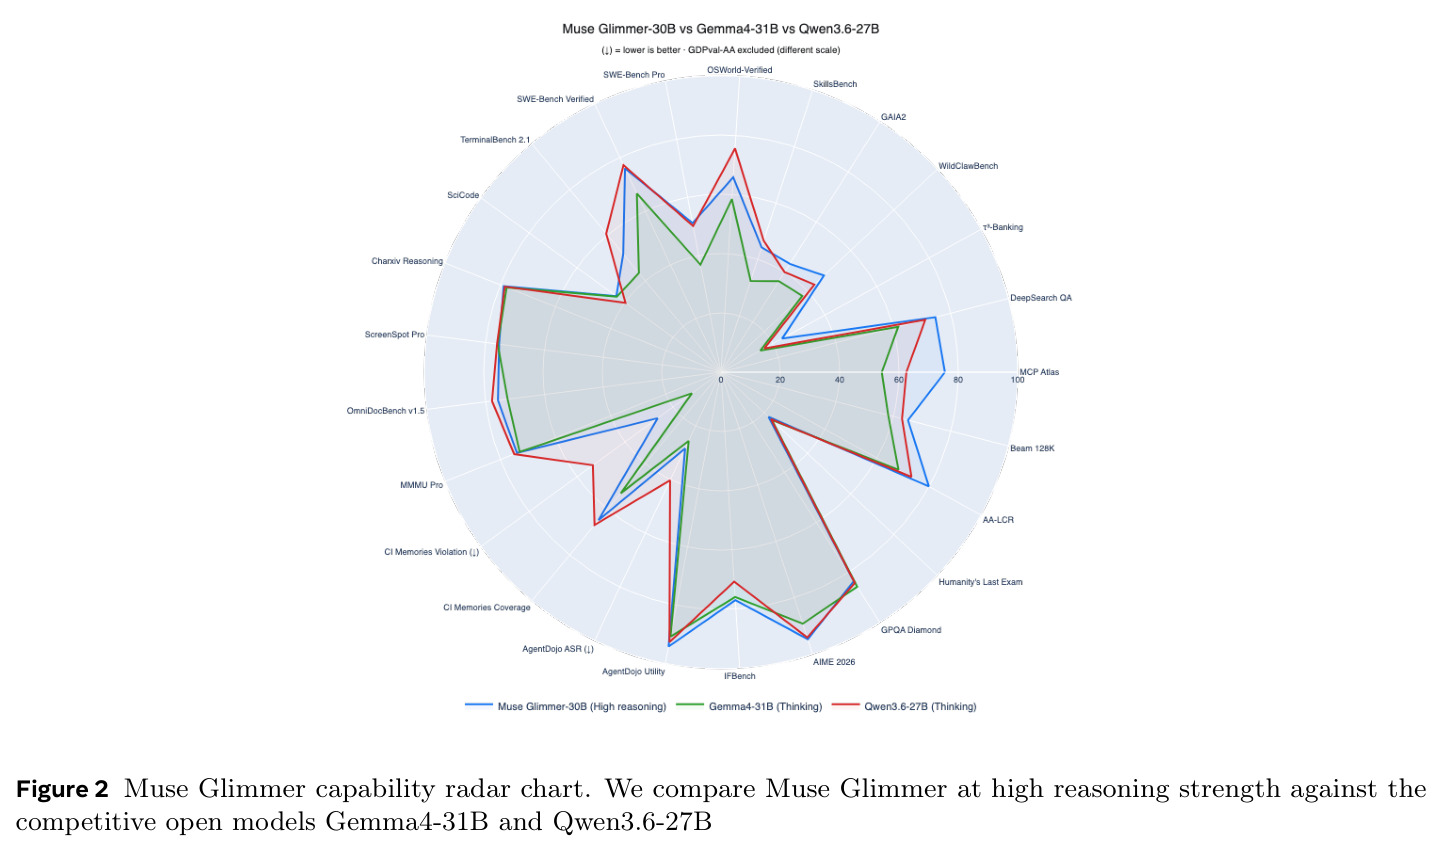
核心结果(Table 2,high 档,对比 Gemma4-31B / Qwen3.6-27B):智能体与编码上全面领先或持平——τ³-Banking 23.5 vs 15.1/16.7,WildClawBench 47.6 vs 37.6/43.2,GAIA2 43.3 vs 36.4/40.0,SWE-Bench Pro 51.2 vs 36.9/50.2;工具使用 MCPAtlas 75.5 领先 Gemma 21.3 分,DeepSearchQA 74.6 领先 12.9 分;AIME 2026 达 94.7 为三者最高。但最难编码与桌面操控被 Qwen3.6-27B 反超:OSWorld-Verified 65.9 vs 75.6,TerminalBench 2.1 51.7 vs 60.7,SWE-Bench Verified 76.0 vs 77.2。长上下文记忆优势明显:AA-LCR 80.0 vs 68.3/73.3,BEAM-128K 65.1 vs 58.2/63.0。多语言是最大亮点:OmnilingualGAIA2 均值 60.4,领先 Gemma(37.5)22.9 分、Qwen(45.0)15.4 分,且全部 10 语言 × 4 档强度均第一;Linguini 全题精确匹配 8.8,是 Gemma(3.8)的 2.3 倍。量化(Table 3)显示精度几乎无损:BF16 75.7%,EvoPress 75.6%(19.65GB),Q4KM 74.8%,思维链长度无显著变化。隐私安全喜忧参半:Siren AgentDojo 实用率 94.2 三者最高,但 ASR@5 28.4 高于 Gemma 的 25.6,CIMemories 违规率 26.4 也高于 Gemma 的 12.1(远低于 Qwen 的 53.4)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MCPAtlas(20+ MCP 工具服务器多轮智能体) | mean pass rate | 75.5 | Gemma4-31B 54.2 / Qwen3.6-27B 62.5 | +21.3 vs 最强基线 |
| WildClawBench(60 项长程真实任务) | 任务均分(3 次运行平均) | 47.6 | Gemma4-31B 37.6 / Qwen3.6-27B 43.2 | +10.0 vs 最强基线 |
| GAIA2(状态化模拟宇宙智能体,800 任务) | 平均成功率 | 43.3 | Gemma4-31B 36.4 / Qwen3.6-27B 40.0 | +3.3 vs 最强基线 |
| SWE-Bench Pro(731 项复杂编码任务) | pass rate(4 次平均) | 51.2 | Gemma4-31B 36.9 / Qwen3.6-27B 50.2 | +1.0 vs 最强基线 |
| τ³-Banking(RAG 客服智能体) | 任务成功率 | 23.5 | Gemma4-31B 15.1 / Qwen3.6-27B 16.7 | +6.8 vs 最强基线 |
| AIME 2026(竞赛数学) | pass@1(10 次平均) | 94.7 | Gemma4-31B 89.2 / Qwen3.6-27B 94.1 | +0.6 vs 最强基线,三者最高 |
| OmnilingualGAIA2(10 语言智能体) | pass@1(10 语言均值) | 60.4 | Gemma4-31B 37.5 / Qwen3.6-27B 45.0 | +15.4 vs 最强基线,全部 10 语言 × 4 档强度均第一 |
| AA-LCR(长文档跨文档推理) | 准确率 | 80.0 | Gemma4-31B 68.3 / Qwen3.6-27B 73.3 | +6.7 vs 最强基线 |
| OSWorld-Verified(GUI 桌面操控,361 任务) | mean per-task reward(4 次平均) | 65.9 | Qwen3.6-27B 75.6 / Gemma4-31B 58.5 | -9.7 落后 Qwen3.6-27B |
| SWE-Bench Verified(500 项真实 GitHub 修复) | pass rate | 76.0 | Qwen3.6-27B 77.2 / Gemma4-31B 66.6 | -1.2 落后 Qwen3.6-27B |
| EvoPress 量化后 15 项任务平均 | 平均准确率 | 75.6%(权重 19.65GB) | BF16 75.7%(权重 55.7GB) | -0.1pp 精度换 64% 体积缩减 |
局限与改进
第一,纯编码与桌面操控不敌 Qwen3.6-27B:OSWorld-Verified 差 9.7 分(65.9 vs 75.6)、TerminalBench 2.1 差 9.0(51.7 vs 60.7)、SWE-Bench Verified 76.0 vs 77.2、SkillsBench 44.3 vs 46.6、GDPval-AA 953 vs 1141、OmniDocBench 与 MMMU-Pro 也略落后,说明蒸馏学生在最难的真实软件工程与 GUI 操作上仍低于同级强化学习强者,多模态文档理解未拉开优势。第二,多语言智能体从英语外流明显:high 档英语 73.7 → 日语 50.0(-23.7),10 语言平均降 13.3;且中文、印地语、日语在 medium 达峰,继续加推理强度反而伤害 search(印地语 81.8→69.9,日语 77.8→68.5)——『更多思考更好』并不普遍成立。第三,隐私安全权衡:CIMemories 违规率 26.4 高于 Gemma 的 12.1(作者称是违规率与覆盖率 64.8 vs 53.0 的权衡结果),Siren ASR@5 28.4 也高于 25.6。第四,视频只按帧输入、未专门优化;感知编码器全程冻结限制视觉适配。第五,报告层面:训练总算力、数据配比、教师轨迹规模未披露,评测混合自报数字、Artificial Analysis 第三方结果与内部运行,可核验性有限。
独立分析的弱点
独立分析出的弱点及改进方向。(1) 高档推理强度在部分语言非单调回退(印地语/日语 search 从 81.8→69.9、77.8→68.5),暴露推理强度子组训练在低资源语言上的分布失配:可为语言或能力单独标定长度惩罚,或训练能力感知的强度路由器。(2) 桌面操控短板可能源于感知编码器冻结与放弃动态切图的单一 resize:高分辨率 UI 截图每个视觉 token 仅对应 28×28 像素,小图标难辨认,可解冻编码器或引入缩放裁剪增强 grounding(ScreenSpot 已用迭代裁剪,说明作者意识到瓶颈)。(3) 合成宇宙数据与现实用户环境存在模拟差距,可验证 rubric 偏好可判定任务,或有隐性分布偏置:建议发布真实任务回放校准集。(4) 评测口径混杂(自报 + 第三方 + 内部运行)削弱可比性:应统一第三方复测并公布脚手架细节。(5) 端侧推理只定性说 practical speeds,未给 tokens/s 与首 token 延迟绝对数字:应补 RTX 5090/Apple Silicon 吞吐基准。(6) CI 隐私训练信号仍粗:可在 RL 中引入属性级判别器做细粒度惩罚。(7) 202,048 词表对 137 种语言的编码效率差异未披露,低资源语言每 token 字节数偏高会放大端侧时延。
未来方向
作者提出或可延伸的方向。(1) 推理强度路由优化:10 种语言中 7 种在 high/xhigh 达峰而中/日/印地语在 medium 达峰,可训练语言与任务条件化的强度选择器,把思考预算花在刀刃上。(2) KV cache 压缩:简化 MLA 失败后保留 GQA,但更精细的潜变量压缩或 KV 量化可与滑窗正交叠加,进一步压低长会话显存。(3) 视频与时序多模态:当前按帧输入,处理屏幕录像或视频会议需要时序编码与跨帧记忆。(4) 端侧个性化:Apache 2.0 发布 4-bit 权重与 DFlash 头后,社区可探索量化权重上的 LoRA、本地记忆与本地偏好对齐。(5) 蒸馏科学:top-256 截断 + 末段 CE 可系统消融(top-k 大小、切换时机、与 on-policy 蒸馏配比),形成小型模型蒸馏 scaling 定律。(6) 合成宇宙管线(persona、universes、scenarios、rubric)可作为开源数据集与基准发布,降低社区复现 agentic 后训练的门槛。(7) 安全纵深:把章程感知拒绝采样扩展到长程任务中的权限升级检测,以及针对工具返回中间接注入的持续红队演进。
复现评估
复现难度:推理复现容易,训练复现几乎不可能。开源情况:BF16 全精度权重(55.7GB)、4-bit 量化权重与 DFlash 投机解码头以 Apache 2.0 发布在 HuggingFace(meta-models/Muse-Glimmer-30B),配套 ExecuTorch/MLX 部署路径与 llama.cpp 兼容的 Q4_K_M 量化,基准定义见附录 A。硬件要求:32GB 显存单卡(如 RTX 5090)跑 EvoPress 配置(权重 19.65GB + KV cache + 编码器 + 草稿模型),24GB 机型用 Q4KM;文本 + 图像输入即可复现绝大多数基准。不可复现部分:教师 Muse Spark 权重未公开,top-256 蒸馏日志、预训练数据配比、合成宇宙管线、RL 奖励模型与安全章程均未放出,无法重训;部分评测依赖 Artificial Analysis 收费口径与 GPT-5.4/Claude 系列商业 judge,WildClawBench 等为内部运行结果。总体评估:作为使用者,下载量化权重配 OpenClaw/ExecuTorch 即可搭本地智能体,门槛低、许可宽松;作为研究者,只能在其权重上做微调、评测与部署研究,训练管线属于『黑箱报告』。
论文图表