MC-Sparse:解构并弥合扩散Transformer中的稠密-稀疏注意力鸿沟 MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers
以token级KV选择加锚点缓存残差补偿,免训练实现视频/3D扩散生成2.32倍提速且画质无损
前置知识
扩散Transformer(DiT)
用Transformer替换U-Net作为扩散模型去噪骨干的架构,把视频帧块或3D几何体编码为长token序列,每步去噪都对全序列做自注意力。分辨率与时长增长使token可达数万至数十万,注意力平方复杂度成为推理延迟的主要来源,代表模型有HunyuanVideo、Wan2.1与MiniMax-H3。
本文加速的对象正是DiT中的注意力层,只有理解token序列规模与平方复杂度,才能理解稀疏化的动机、收益上限以及匹配密度实验的设计。
块稀疏注意力(BSA)
把查询与KV按GPU计算tile大小分块,为每组查询挑选整块KV参与计算、其余用掩码置 $-\infty$。常见实现用均值池化后的 $\bar{q}_g^\top\bar{k}_r/\sqrt{d}$ 打分,结构规整、可复用FlashAttention式内核,但块内无关KV被捆绑保留,限制精度上限。
论文以均值池化的vanilla BSA为分析基线和消融起点,全部诊断与改进都围绕它的三类误差来源展开。
FlashAttention与tile对齐
一种IO感知的精确注意力实现:将Q、K、V切成适配GPU片上内存的tile,在线计算softmax并分块累加,避免物化 $N\times N$ 注意力矩阵。高效内核假设查询以固定tile粒度成批处理,分组大小不齐就得padding填充,浪费算力。
MC-Sparse的等大小组设计、tile对齐约束和自研token稀疏内核,全部为贴合这类内核的执行模型而服务。
PDDP主方向分裂划分
一种递归二分聚类:把数据投影到方差最大的主方向上按中位数切开,逐层分裂直到组数达标,天然产出大小均衡的组。本文将其GPU化(批处理幂迭代求主方向、层间只传查询索引数组),称Fast PDDP,把相似查询聚成恰好 $C$ 个一组。
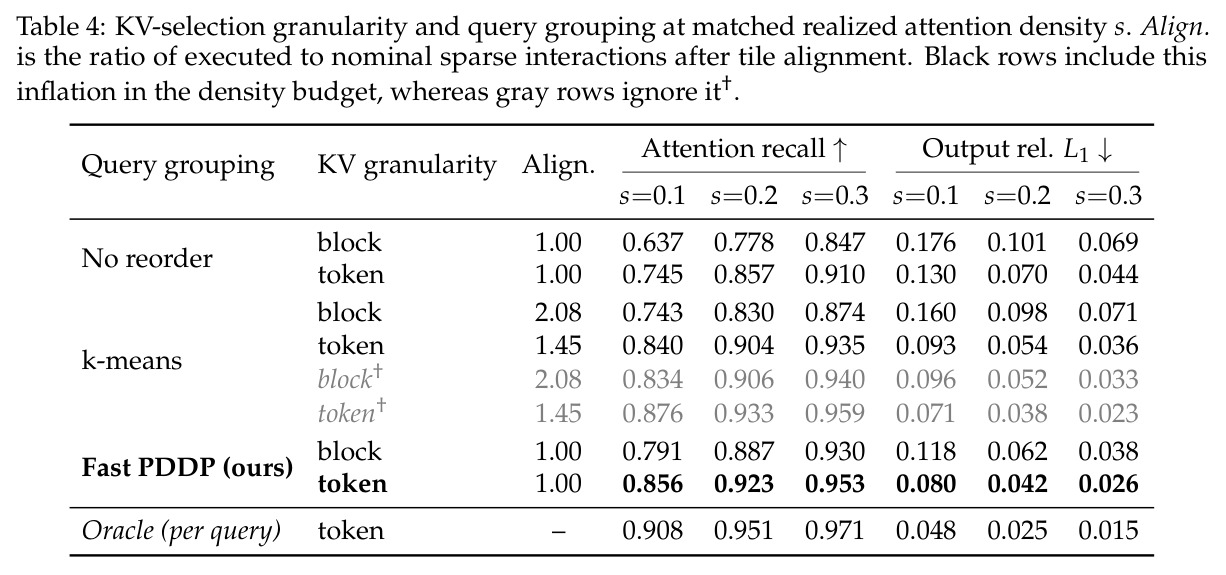
它是同时满足组内相似与tile对齐这两个互斥目标的关键组件,消融表4中胜过k-means正源于此。
注意力密度
稀疏注意力实际保留的query–key交互占全部交互的比例,记作 $s$。密度 $s$ 意味着只计算 $sN^2$ 量级的交互,理论加速上界约为 $1/s$,它是公平比较不同稀疏方法的核心变量。
论文的oracle对照、消融、内核效率全部在匹配密度下进行,不理解 $s$ 与 $1/s$ 的关系就读不懂实验结论。
跨去噪步时间冗余
扩散采样中相邻去噪步的注意力模式高度相似这一经验性质。它允许把某一步算出的查询分组、KV选择乃至稠密-稀疏输出残差缓存下来,供后续若干步复用,是扩散缓存类加速方法的共同基础。
MC-Sparse把昂贵的精确选择、分组与残差计算摊销到锚点步,复用步只做轻量计算,整套设计建立在这个性质之上。
研究动机
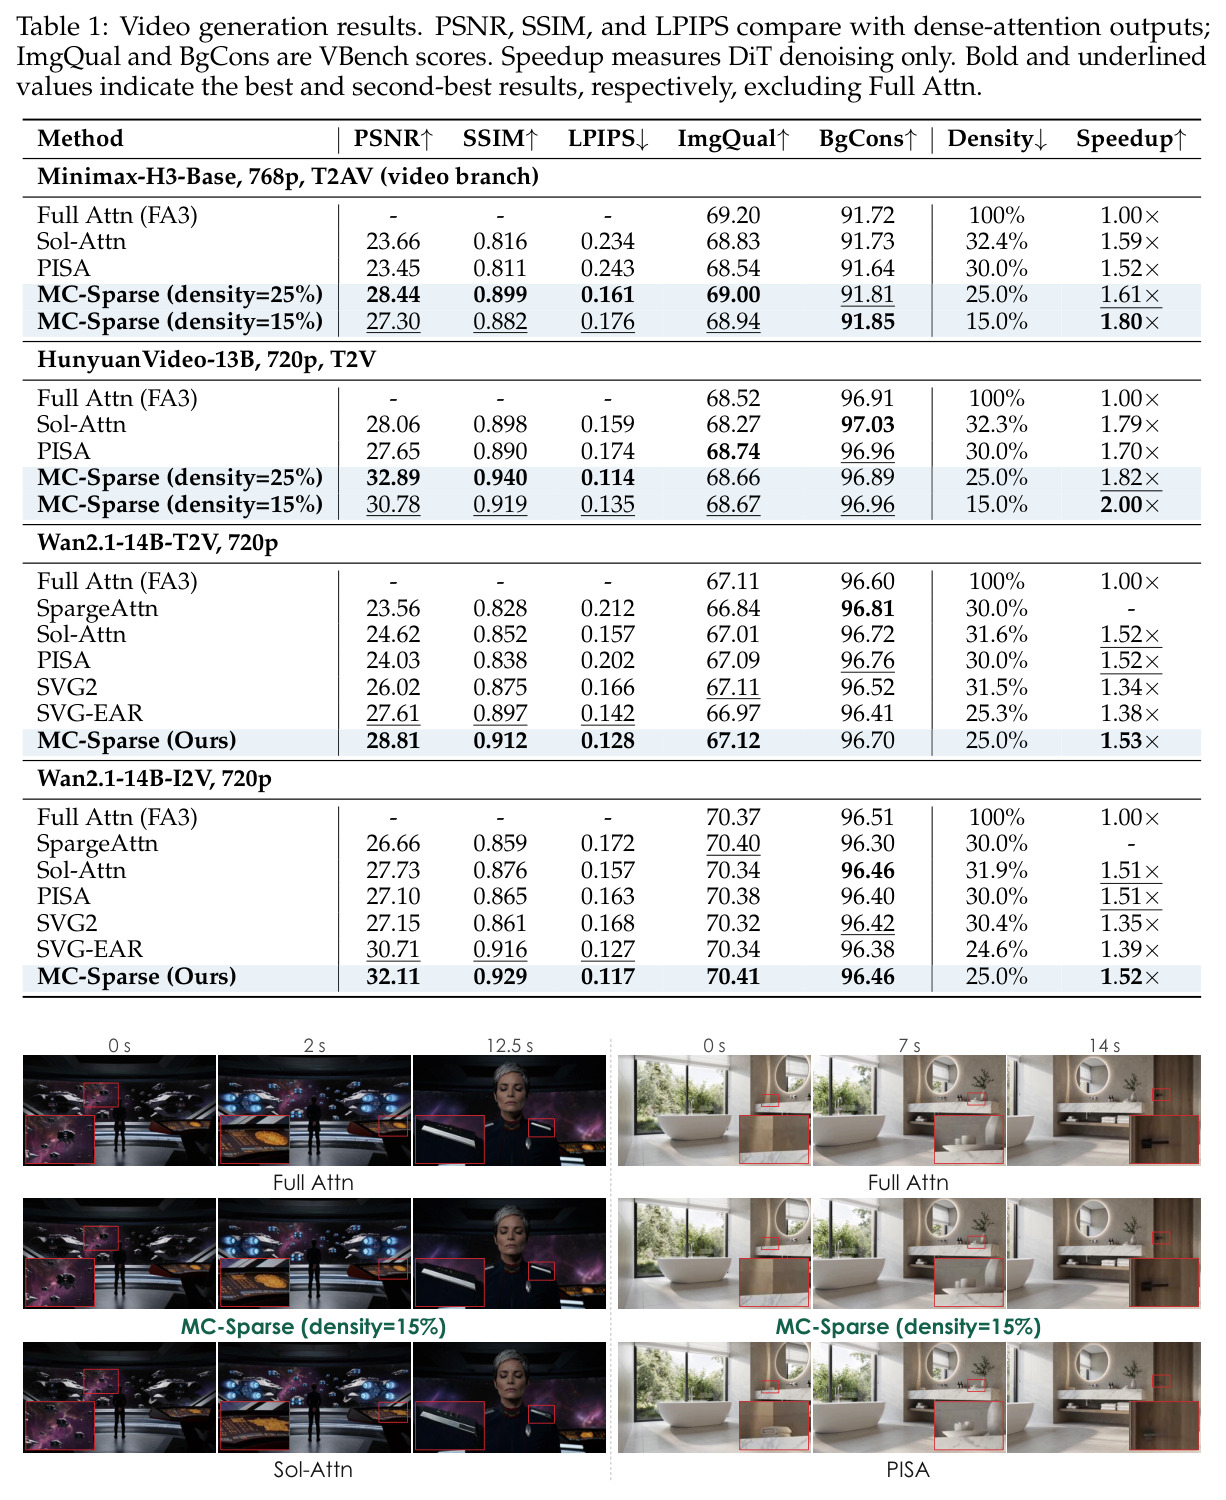
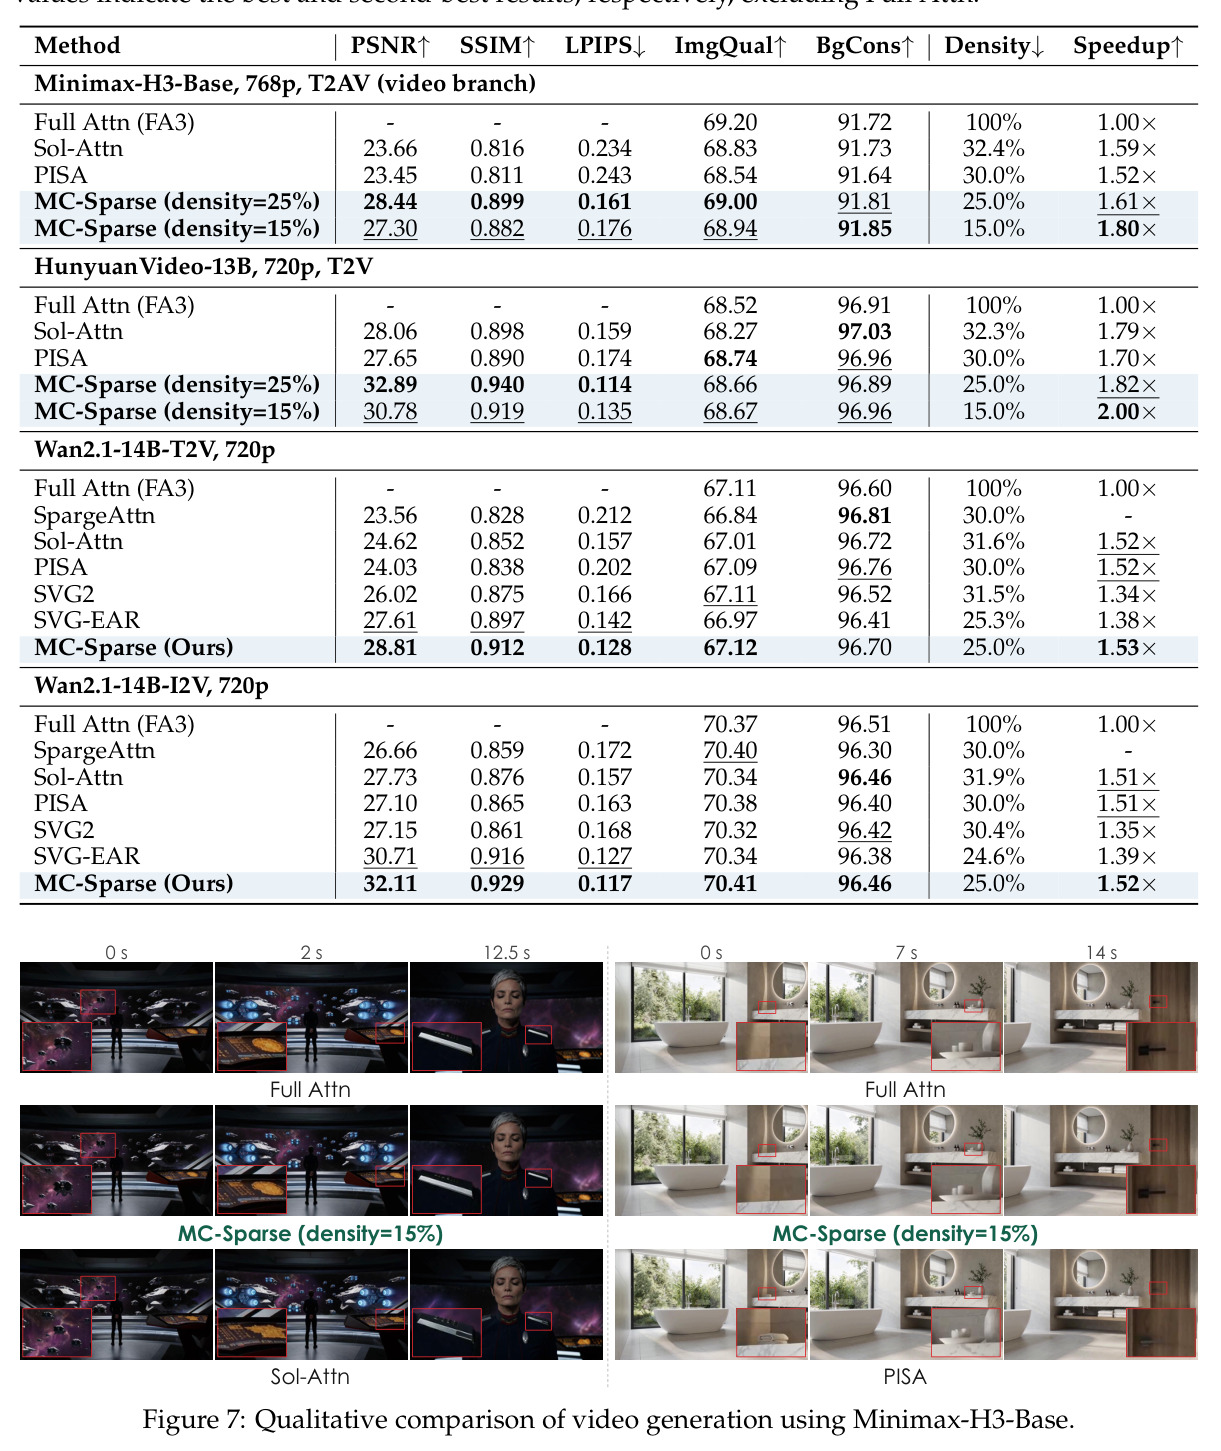
扩散Transformer(DiT)已成为视频与3D资产生成的主流骨干,但序列长度随分辨率和时长暴涨——720p/768p视频的时空token可达7.5万量级,自注意力的二次方代价成为推理瓶颈。稀疏注意力是自然的加速手段,然而现有方法在高稀疏度下明显损伤生成质量:在Wan2.1-14B上SpargeAttn用30%密度只有23.56 dB PSNR,Sol-Attn要靠31.6%密度才达到24.62 dB,PISA用30%密度也只有24.03 dB,各家普遍需要约30%–36%的密度才能维持画质,加速被锁死在1.5×上下。更根本的问题是,块稀疏注意力(BSA)把两种误差纠缠在一起:用于挑块的近似打分(均值池化的 $\bar{q}_g^\top\bar{k}_r/\sqrt{d}$ 并不等于组内平均注意力概率 $\frac{1}{|G_g|}\sum_i A_{ij}$,公式(2))与块级粗粒度布局本身相互耦合,让人分不清质量损失究竟来自选择器不准、块结构限制,还是被丢弃token固有的非零注意力质量,改进方向因此无从下手。
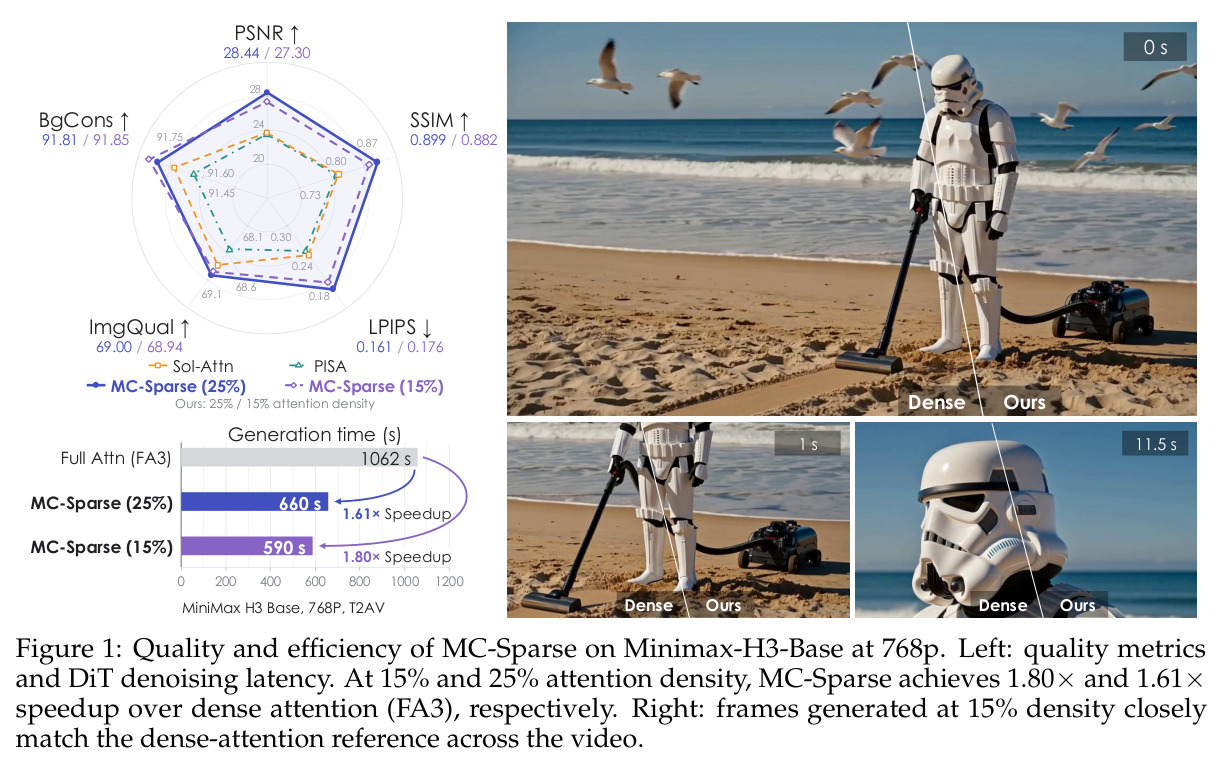
本文的目标是本文目标分两层。第一层是诊断:通过在相同注意力密度下的受控oracle对照实验,把稠密-稀疏注意力质量差距精确分解为三个可量化的来源——结构绑定误差(KV按块捆绑、组内查询共享一次选择)、选择误差(近似打分选不准关键交互)、丢弃尾部误差(被丢弃token仍携带非零注意力质量),并量化各自的影响大小。第二层是工程:基于诊断结论设计免训练的稀疏注意力框架MC-Sparse,同时落实三条设计原则——token级细粒度选择、精确的注意力打分、对被丢弃贡献的补偿——并且不牺牲GPU执行效率,最终在视频生成(Minimax-H3-Base、HunyuanVideo-13B、Wan2.1-14B-T2V/I2V)与3D资产生成(HY3D-Internal)上,做到比稠密注意力更高保真、1.80×(视频)/2.32×(3D)的去噪加速且画质无可感知退化。
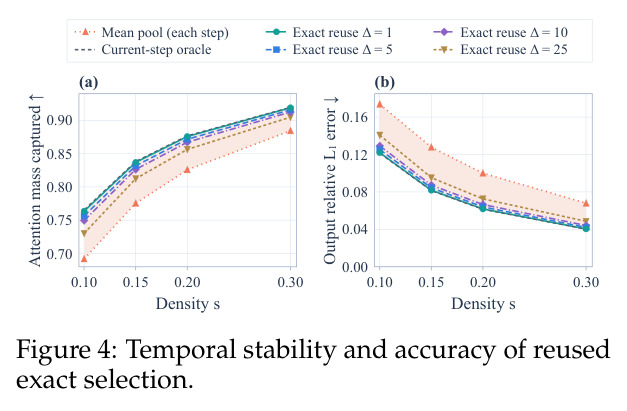
与已有工作不同的是,本文的独特切入角度是用oracle阶梯做归因实验:构造块oracle、token oracle(共享Q块)、逐查询oracle三种使用精确稠密注意力概率 $A_{ij}$、只在不同选择粒度上动作的上界方法,与vanilla BSA在匹配密度下逐一对比,首次把质量差距干净地拆成结构绑定、选择、丢弃尾部三个正交成分,而不是笼统归咎于近似不准。在解决方案上,与SVG2、SVOO、AdaCluster等语义聚类路线不同(它们产生变长分组,与内核tile错位导致部分填充tile的隐性浪费),MC-Sparse坚持分组必须对齐硬件tile,用Fast PDDP产出等大小查询组;与PISA等块统计补偿不同,token级选择把块结构切碎、无法复用块摘要,它转而在时间轴上缓存稠密-稀疏输出残差来补偿不规则丢弃;并首次实证复用历史步的精确选择优于每步重算的均值池化选择(图4)。
核心方法
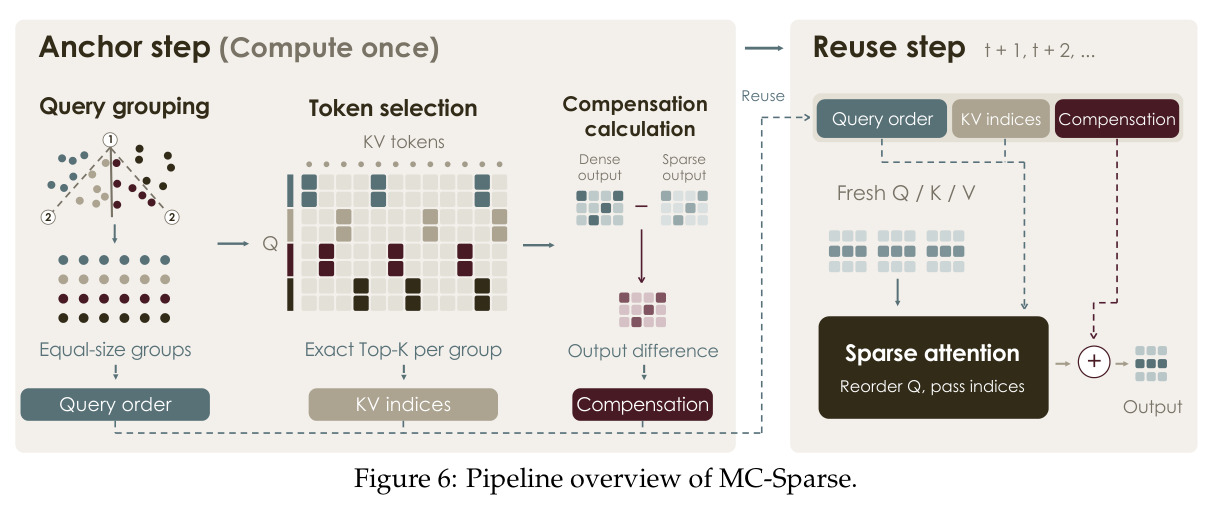
MC-Sparse是training-free的稀疏注意力框架,核心直觉是:注意力在相邻去噪步之间高度稳定,精确但昂贵的选择只需偶尔做一次,其余步骤复用结果并叠加缓存残差即可。方法把去噪过程交替划分为锚点步与复用步。锚点步(warm-up或刷新段最后一步)先跑完整稠密注意力得到 $O^{\text{full}}_t$,再用Fast PDDP把相似查询聚成恰好 $C$ 个一组的等大小组 $G_t$,随后两遍式精确选择得到每组top-$K$ KV索引 $S_t$,并缓存残差 $R_t = O^{\text{full}}_t - O^{\text{sparse}}_t$。复用步只重算当前 $Q_t,K_t,V_t$,按缓存的 $G_\tau,S_\tau$ 执行token稀疏注意力,输出 $\hat{O}_t = \text{SparseAttn}(Q_t,K_t,V_t;G_\tau,S_\tau)+R_\tau$。系统层面配套CuTeDSL实现的token稀疏内核、缓存offload与逐层预取,实测总开销折合密度仅+5%–6%。
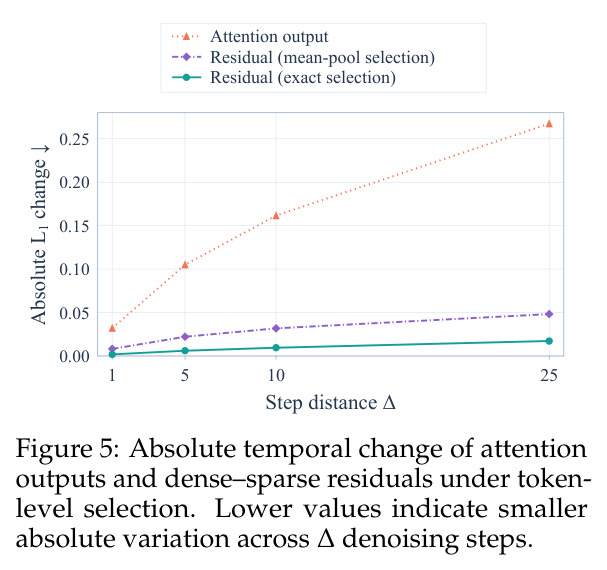
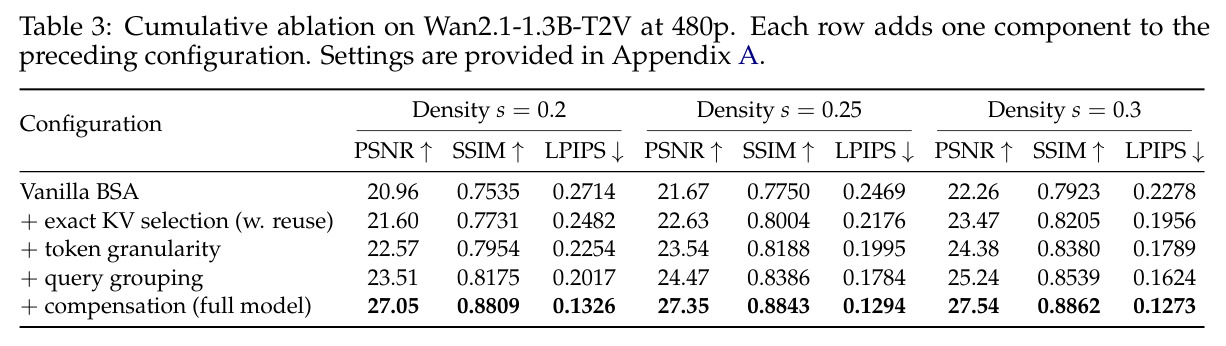
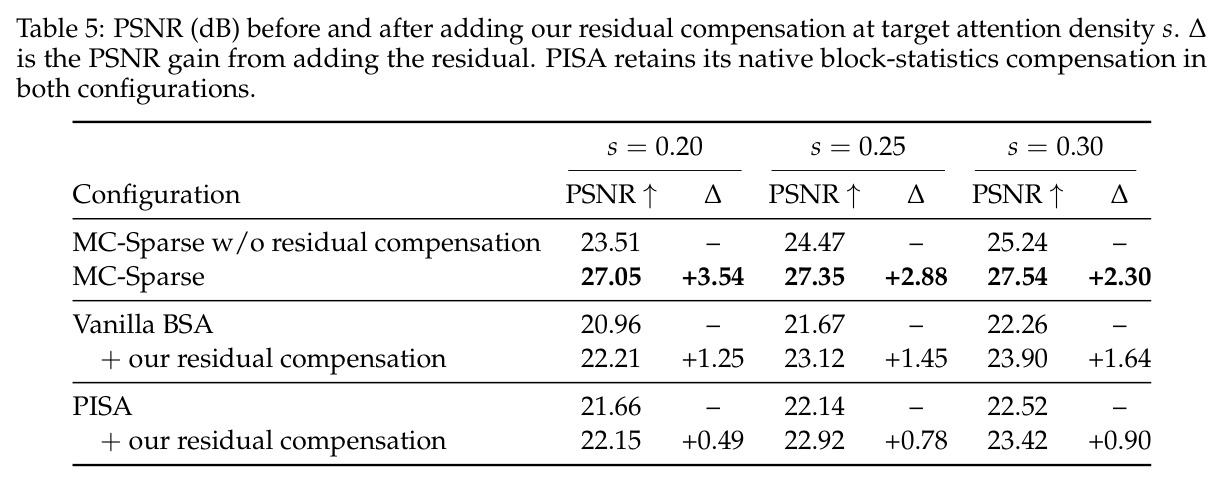
核心创新是把稀疏注意力的三大误差源用三个机制一一对应地消除。其一,token级KV选择替代块选择:每组查询跨块边界挑选单个KV token,内核在线按索引gather键值,从根上消除KV绑定;配合Fast PDDP把模式相似的查询聚成tile对齐等大小组共享一次选择,缓解查询绑定且无padding浪费——与所有先选块后执行的BSA方法有本质区别。其二,打分弃用池化近似,直接最大化组内累计稠密注意力质量 $S_g^* = \arg\max_{|S|=K}\sum_{i\in G_g}\sum_{j\in S} A_{ij}$,并利用时间稳定性只在锚点步计算、跨步复用——Δ=25步的复用仍胜过每步重算的均值池化(图4)。其三,残差补偿:token级选择切碎了块结构,无法沿用块统计补偿,改在时间轴上缓存 $R_\tau = O^{\text{full}}_\tau - O^{\text{sparse}}_\tau$,实测残差随步距变化远小于注意力输出本身(图5),加性补偿带来最大单项增益:Wan2.1-1.3B在 $s=0.2$ 时PSNR从23.51升至27.05 dB(+3.54 dB)。
方法步骤详情
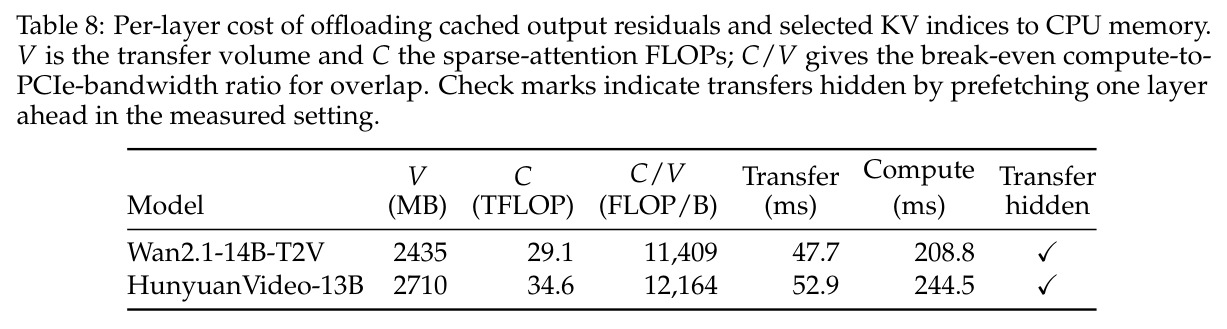
第一步,锚点判定:前若干步跑稠密warm-up,每个刷新段最后一步为锚点。第二步,查询分组:输入锚点步查询 $Q_t$,Fast PDDP用批处理幂迭代求主方向、按中位数递归二分,直到每组恰好 $C$ 个查询。第三步,两遍式精确选择:FlashAttention不暴露注意力logits,第一遍做QK-only计算,按 $\sum_{i\in G_{\tau,g}} A_{ij}$ 排序取每组top-$K$,输出KV索引 $S_\tau$。第四步,残差缓存:再跑一次稀疏注意力,计算并缓存 $R_\tau = O^{\text{full}}_\tau - O^{\text{sparse}}_\tau$,打包 $\mathcal{C}=(G_\tau,S_\tau,R_\tau)$。第五步,复用步执行:重算 $Q_t,K_t,V_t$,按缓存分组重排查询、按索引gather KV做稀疏注意力,输出 $\hat{O}_t = O^{\text{sparse}}_t + R_\tau$。第六步,系统优化:显存不足时把 $R$ 与 $S$ offload到CPU并提前一层预取,实测每层传输47.7 ms、稀疏计算208.8 ms,传输被完全隐藏。
技术新颖性
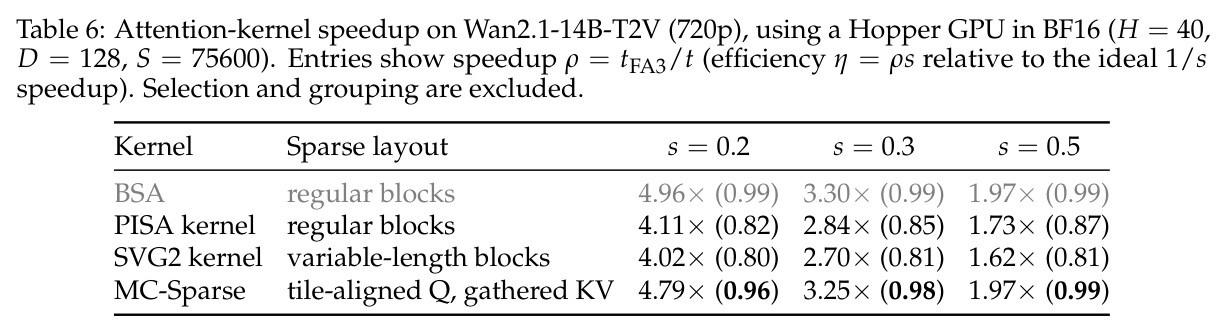
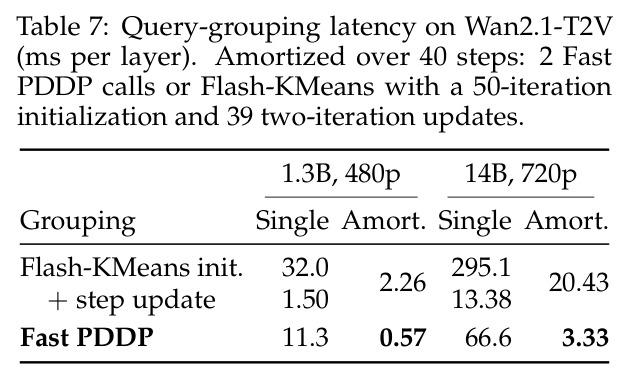
技术新颖性体现在四方面。第一,归因方法学:块oracle→token oracle→逐查询oracle的阶梯对照(图2显示密度0.2下质量捕获从BSA约0.78、token oracle 0.86到逐查询oracle 0.91)首次把差距分解为三个可测成分。第二,精度与效率解耦:此前语义聚类(SVG2/SVOO/AdaCluster)追求组内相似但产生变长组,与内核tile错位造成隐性浪费;MC-Sparse用Fast PDDP同时满足组内相似与组等大两个互斥目标,摊销分组成本比Flash-KMeans低3.96×–6.14×,内核效率达理想加速的96%–99%(SVG2仅80%–81%)。第三,残差机制的时间轴迁移:把DiTFastAttn式加性残差与token级精确选择组合,并证明该组合收益(+3.54 dB)远大于同一补偿用在vanilla BSA(+1.25 dB)或PISA上(+0.49 dB),揭示补偿效果与选择质量协同而非独立。第四,工程完整度:两遍式选择、CuTeDSL内核、offload加逐层预取构成全栈方案,锚点与warm-up重叠后总开销折合密度仅+5%–6%。
实验结果
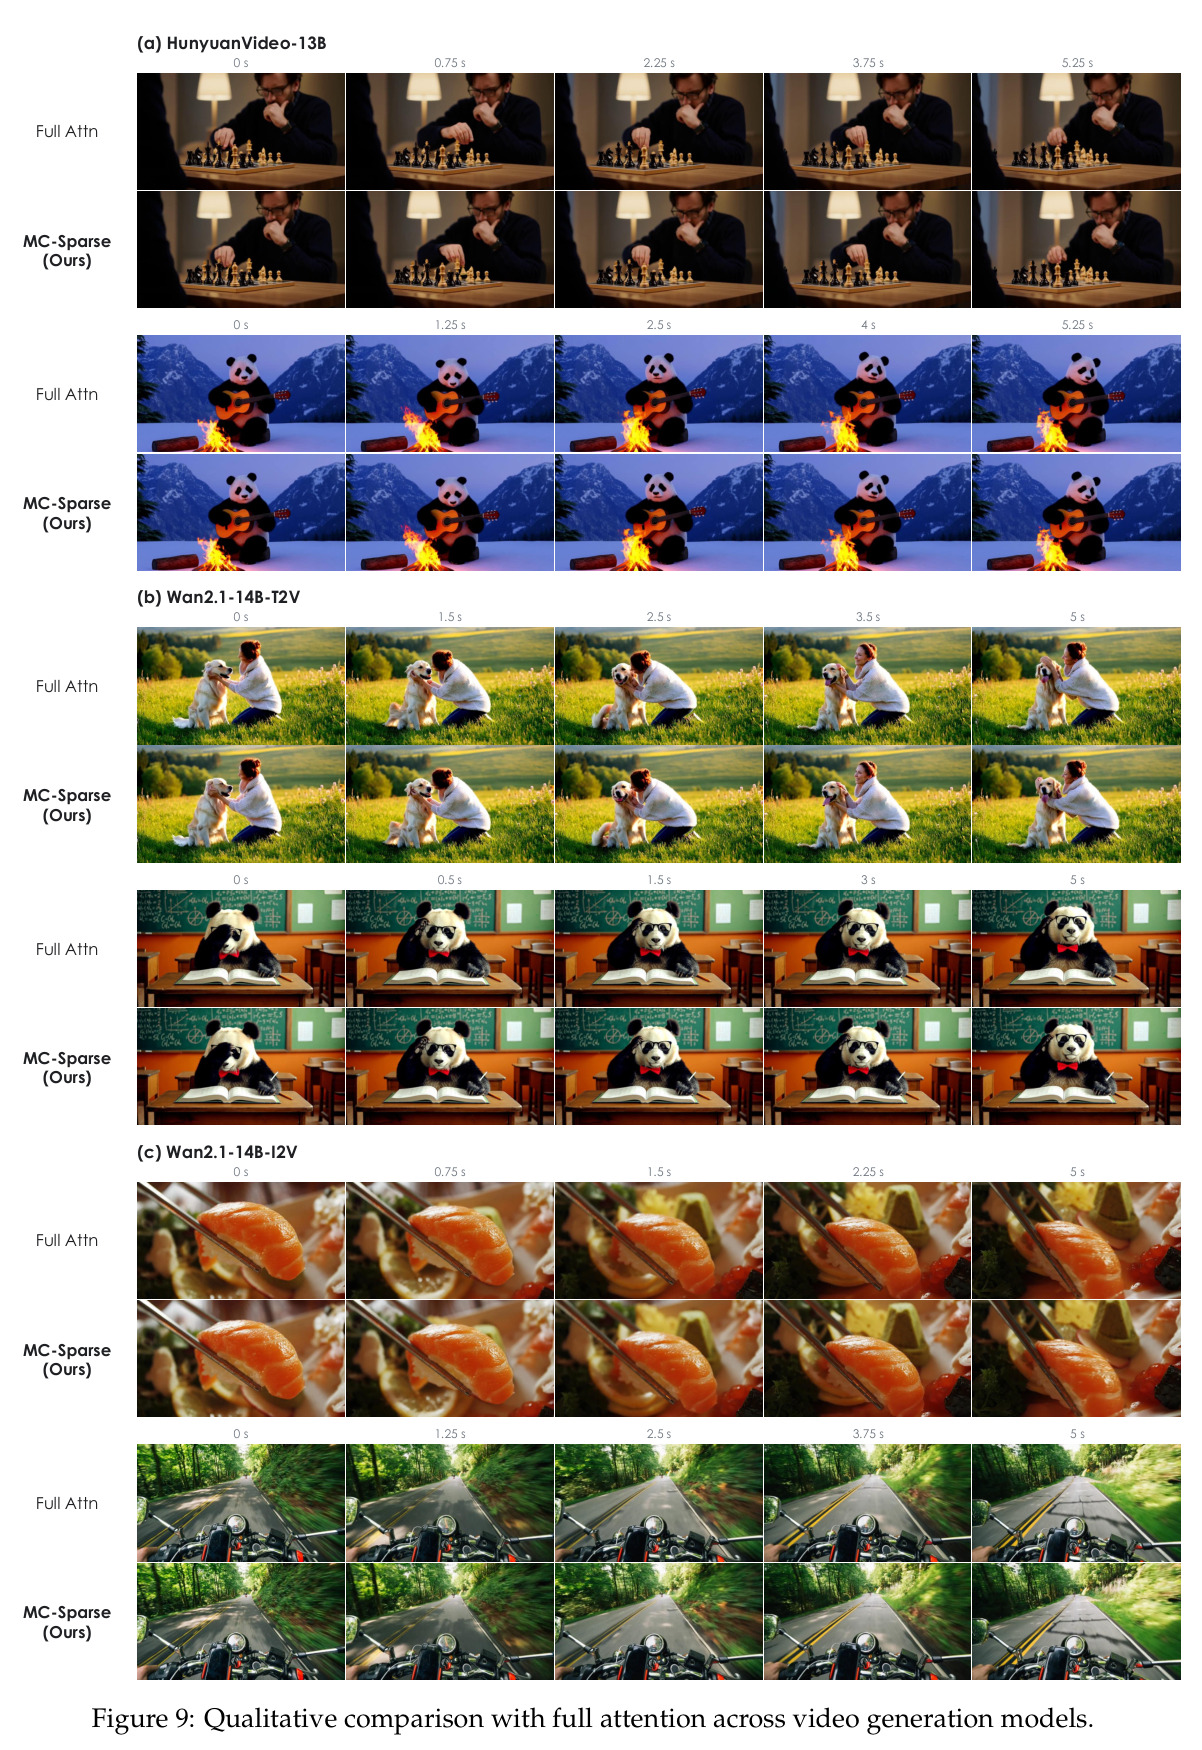
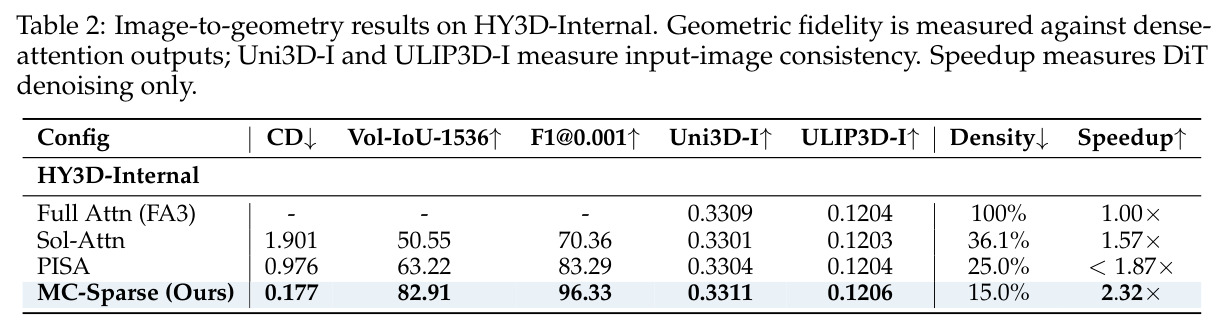
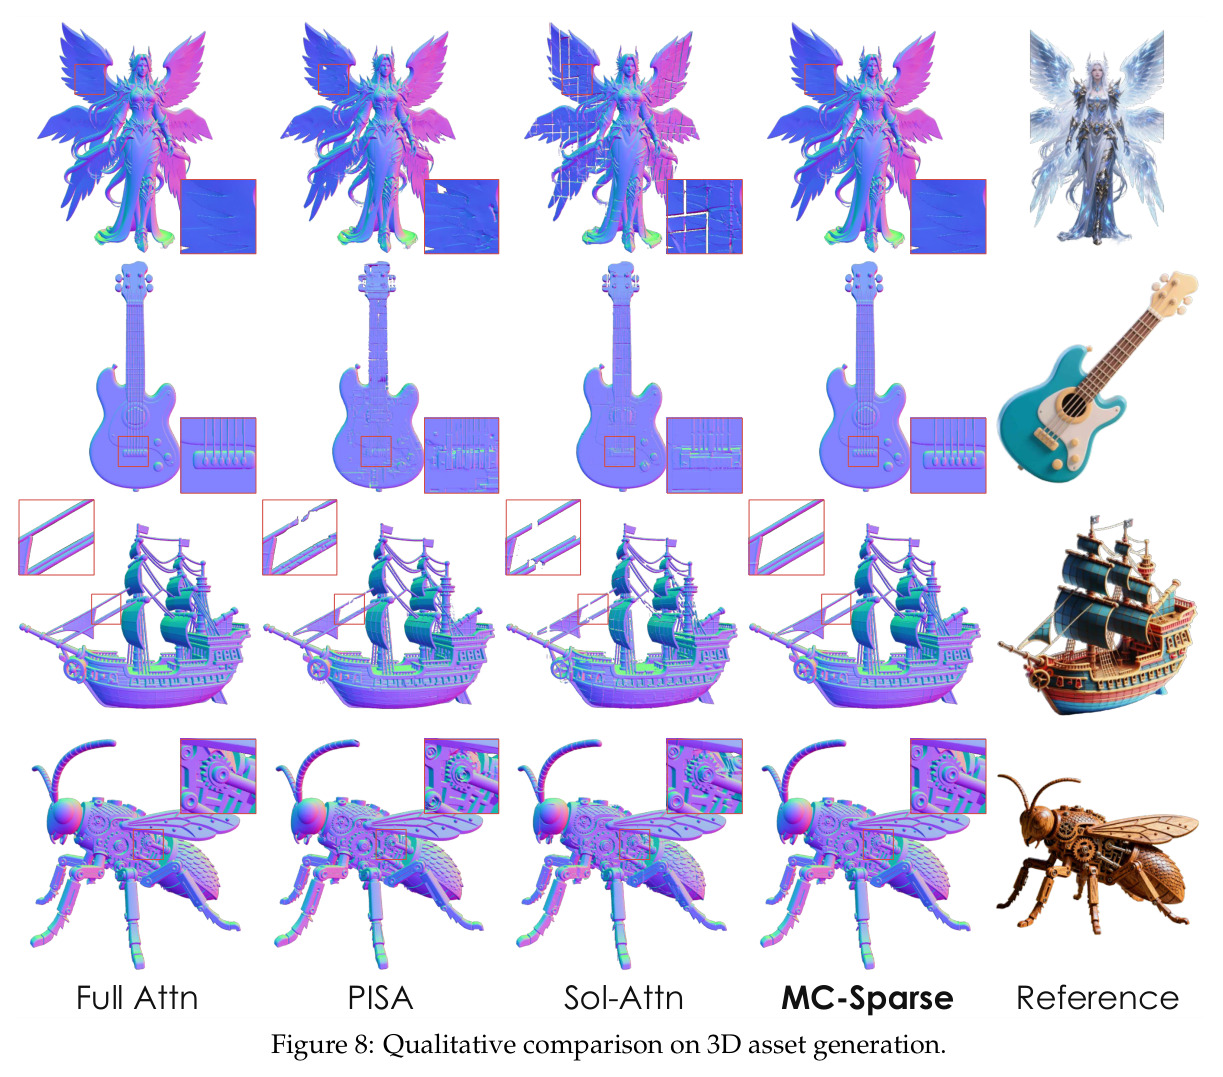
论文在三个视频模型与一个3D模型上验证方法。Minimax-H3-Base(768p T2AV)上,MC-Sparse以25%密度取得28.44 dB PSNR并获1.61×去噪加速,15%密度下仍有27.30 dB与1.80×加速,而Sol-Attn用32.4%密度仅23.66 dB/1.59×;HunyuanVideo-13B上25%密度达32.89 dB、1.82×;Wan2.1-14B-T2V达28.81 dB/1.53×,比最强的SVG-EAR(27.61 dB/1.38×)高1.2 dB且更快,I2V同样领先(32.11 dB/1.52×)。3D生成(HY3D-Internal)上15%密度把CD从PISA的0.976压到0.177,F1@0.001 96.33,加速2.32×为全场最高。消融逐级累加:vanilla BSA 20.96 dB→+精确选择复用21.60→+token粒度22.57→+查询分组23.51→+残差补偿27.05 dB($s=0.2$),残差补偿贡献最大。系统实验显示token稀疏内核达理想加速的96%–99%(SVG2仅80%–81%),offload传输被稀疏计算完全隐藏,锚点总开销折合密度仅+5%–6%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视频生成(Minimax-H3-Base,768p T2AV) | PSNR↑ / 注意力密度↓ / 去噪加速↑ | 25%密度:28.44 dB、1.61×;15%密度:27.30 dB、1.80× | Sol-Attn:32.4%密度23.66 dB、1.59×;PISA:30%密度23.45 dB、1.52× | 密度降低5–17个百分点的同时PSNR提升约3.8 dB,加速提升至1.80× |
| 视频生成(HunyuanVideo-13B,720p T2V) | PSNR↑ / 去噪加速↑ | 25%密度32.89 dB、1.82×;15%密度30.78 dB、2.00× | Sol-Attn:32.3%密度28.06 dB、1.79× | PSNR +4.83 dB,加速最高达2.00×且密度更低 |
| 视频生成(Wan2.1-14B-T2V,720p) | PSNR↑ / LPIPS↓ / 去噪加速↑ | 28.81 dB / 0.128 / 1.53×(25%密度) | SVG-EAR:27.61 dB / 0.142 / 1.38×(25.3%密度);Sol-Attn:24.62 dB / 0.157 / 1.52× | PSNR +1.20 dB、加速+0.15×,保真与速度全面领先全部稀疏基线 |
| 视频生成(Wan2.1-14B-I2V,720p) | PSNR↑ / 去噪加速↑ | 32.11 dB、1.52×(25%密度) | SVG-EAR:30.71 dB、1.39×(24.6%密度) | PSNR +1.40 dB,加速+0.13× |
| 3D资产生成(HY3D-Internal,图生几何) | Chamfer Distance↓ / F1@0.001↑ / 去噪加速↑ | CD 0.177、F1 96.33、2.32×(15%密度) | PISA:CD 0.976、F1 83.29、<1.87×(25%密度);Sol-Attn:CD 1.901、1.57×(36.1%密度) | CD降低约82%,加速2.32×为全场最高,几何保真与输入一致性(Uni3D-I 0.3311)同时最佳 |
| 注意力内核效率(Wan2.1-14B 720p,Hopper BF16) | 相对理想 $1/s$ 加速的效率 | 96%–99%($s=0.2$ 时4.79×) | SVG2:80%–81%(4.02×);PISA:82%–87%(4.11×) | token级gather内核几乎达到规则块稀疏的理论加速上限 |
局限与改进
作者承认的局限主要在开销与假设层面:锚点步的稠密注意力与两遍式选择带来约5%–6%的等效密度开销,使加速比低于理想 $1/s$;方法依赖注意力模式跨步稳定这一经验观察,若去噪轨迹上模式变化较快,复用间隔 $L$ 与KV预算 $K$ 需要重新调参,论文未给出二者的敏感性分析;评测集中于DiT视频/3D生成,未验证到图像DiT、文本等其他架构。我的补充观察:其一,残差补偿是最大增益来源(+3.54 dB),但它是无条件加性修正,等价于对上一步误差做一阶保持外推,若某些步注意力输出本身剧变,缓存残差可能引入系统性偏移,论文只展示了平均意义上的稳定性;其二,CPU offload的可行性依赖PCIe带宽与计算的overlap(C/V约11409–12164 FLOP/B),在带宽更紧张的消费级GPU上未必成立;其三,缓存 $G,S,R$ 的每层传输量达2.4–2.7 GB,多卡与超长序列场景的显存/带宽压力不小;其四,与量化、扩散缓存等其他加速路线的叠加兼容性未讨论,3D侧HY3D-Internal为内部模型,外部研究者难以对齐复现。
独立分析的弱点
第一个弱点是超参数缺乏自适应:复用间隔 $L$ 与KV预算 $K$ 全局固定,而不同层、不同步的注意力熵差异巨大,固定配置必然对部分层过稀、对另一部分层过密。改进方向:以每层缓存残差范数 $\|R_\tau\|$ 为信号在线调节刷新频率,做成误差预算驱动的自适应调度。第二个弱点是残差补偿的被动性:加性残差只是上一步误差的零阶保持,丢弃质量大时误差仍会累积,且残差与索引缓存体积高达每层2.4–2.7 GB;可对残差做低秩分解或量化压缩,或借鉴PISA的块统计思想用丢弃token的均值KV做一阶修正。第三个弱点是评估维度单一:保真指标全部相对稠密输出,缺少VBench之外的下游任务细分评测(如3D的PBR纹理、视频时序一致性分项),也未与训练型稀疏方法(VSA、VMoBA)和线性注意力(SANA、MHLA)正面对比。第四个弱点是硬件可移植性:CuTeDSL内核针对Hopper设计(H=40、D=128、S=75600实测),Ampere/Ada架构与GQA变体的支持情况不明,且两遍式选择使锚点步无法享受完全融合的FlashAttention,工程迁移成本被低估。
未来方向
作者在结论中提出继续平衡近似质量与执行效率,可自然延伸出:把oracle阶梯诊断扩展到线性注意力、混合注意力(SLA/SLA2)等更广的加速谱系,检验结构绑定/选择/尾部三分法在其他机制下是否成立;研究锚点调度的理论刻画,把残差范数变化率与最优刷新间隔 $L$ 联系起来,形成误差可控的自适应版本。基于本文成果可延伸的方向:其一,与扩散缓存、低比特量化正交叠加,构建系统级联合加速——残差缓存天然适合与量化共存;其二,把tile对齐语义分组作为结构先验蒸馏进训练过程,突破training-free的精度上界;其三,探索KV选择与残差的跨层共享或分层压缩,缓解每层GB级offload压力;其四,迁移到长上下文LLM推理的KV稀疏化——两遍式选择、残差补偿与跨请求复用的组合在自回归解码中有直接对应物;其五,在更 extreme 的场景(超长视频、4K分辨率)验证时间稳定假设的边界。
复现评估
复现评估:论文正文与附录给出了较完整的实现细节——Algorithm 1伪代码、oracle实验设置(附录A)、两遍式选择与CuTeDSL内核设计(附录A.2)、分组与offload开销细分(表7、表8),理论复现路径清晰,并附项目主页(dodododddo.github.io/mcsparse-project-page)。但截至阅读本文时未见到明确的开源代码链接,而方法深度依赖自定义CuTeDSL内核与Fast PDDP实现,这两块自研工作量大且细节敏感(幂迭代显存优化、索引层间传递、预取流水线),无源码情况下第三方复现需数周级工程投入。评测资源方面:Penguin Benchmark与VBench提示集公开可得;MiniMax-H3-Base、HunyuanVideo-13B、Wan2.1-14B为公开权重,但HY3D-Internal是内部模型不可得,需用Hunyuan3D等替代;推理需要Hopper级GPU(BF16、H=40、S=75600),单张H100/H800可跑主要实验,四个模型全量复现估算需数百GPU小时。综合判断:思路与消融结论可复现,数字级复现强烈依赖开源。
论文图表
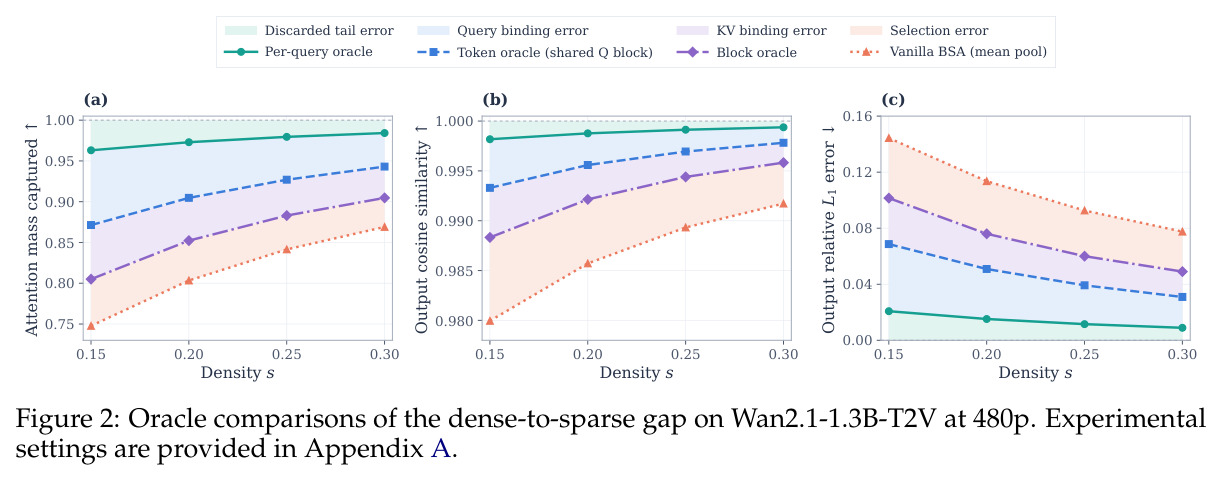
在Wan2.1-1.3B-T2V 480p上以密度 $s$(0.15–0.30)为横轴,对比vanilla BSA(均值池化)、块oracle、token oracle(共享Q块)、逐查询oracle的注意力质量捕获(约0.75→0.85→0.95)、输出cosine相似度与相对L1误差,曲线间的阶梯差即三类误差的相对大小。
论文归因实验的核心图,直接支撑三类误差的诊断结论,是整个方法设计的逻辑起点。
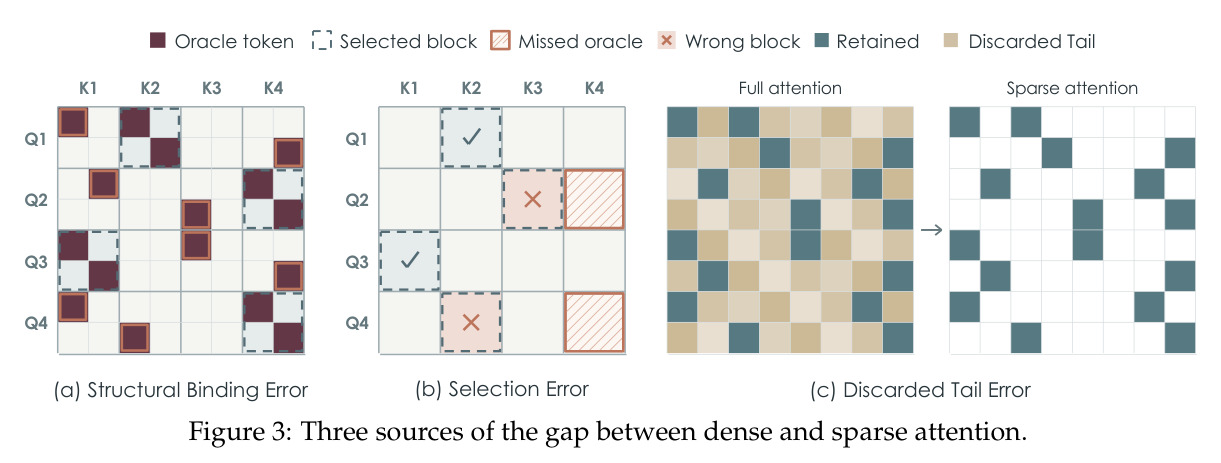
用4查询×4键的注意力矩阵示意三类误差机理:(a)结构绑定误差——KV按块捆绑与组内查询共享选择导致错选;(b)选择误差——选中块与oracle token集合偏离;(c)丢弃尾部误差——被丢弃token仍携带非零注意力质量(Missed oracle与Discarded Tail)。
以最小直觉图解释三个抽象误差概念,与图2的定量结果配合,帮助读者建立差距来源的物理图像。