稀疏度应由输出决定:视频扩散Transformer块稀疏注意力的免训练分配 Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers
以最终视频误差标定各层各步的稀疏敏感度,在延迟预算下联合求解密度分配表
前置知识
扩散 Transformer (DiT) 与迭代去噪
扩散模型通过几十步迭代去噪生成视频:每步在前一状态上按递减的噪声水平预测并更新,视频 DiT(Wan、HunyuanVideo)用 Transformer 的每一层做时空联合注意力。去噪过程天然形成(层,步)网格——本文把每个(层 ℓ, 步 s)对称作一个 cell,稀疏化即在这数千个 cell 上分配不同的注意力密度 b。
论文的核心对象就是(层,步)单元的敏感度差异与密度分配,不理解迭代去噪的层×步结构,就无法理解 cell、warm-up、轨迹增益这些关键概念。
3D 全注意力与块稀疏注意力
视频 DiT 对全部时空 token 做 3D 注意力,计算量随 token 数平方增长,是生成耗时大头(Wan2.1-14B 生成 720p×81 帧约 1 小时,注意力占一半以上)。块稀疏注意力把 query/key 分成小块,先为每个 query–key 块对打分排序,只对选中的块对做精确注意力,并配合 FlashInfer 等块稀疏核真正提速。
ALLOT 不发明新核,只在块稀疏框架里回答"每层每步保留多少块";所有实验都构建在 XAttention、SpargeAttn、SVOO、Radial 等已有块稀疏流水线之上。
选择策略与密度 (density)
选择策略指决定保留哪些块的打分排序规则(如 XAttention 的反对角分数、SVOO 的聚类分数、mean-pooled top-k)。密度 b 指每个 cell 保留的块(或 key token)比例,b=1 即完全稠密。阈值类策略的阈值隐含了一种密度分配,ALLOT 用显式密度表替换这个截断规则。
ALLOT 对现有流水线的全部改动就是"把每 cell 的截断改为查表得到的密度",必须理解密度这一统一接口才能看懂它的集成方式与适用边界。
速度预测、CFG 与 teacher forcing
流匹配类扩散模型每步预测速度场 v;分类器无关引导(CFG)把有/无条件两个分支的输出组合成最终预测。teacher forcing 指在稠密参考轨迹的状态上加噪后只跑单步前向,对比稀疏与稠密模型的速度预测 MSE,从而一次前向即可测出一个层的单步注入误差。
ALLOT 的单元探针(cell probe)正是基于 teacher-forced 单步速度误差测得的,主实验均在 CFG=5、UniPC 采样器、50 步设置下进行。
PSNR / LPIPS / VBench 与配对判定
PSNR/SSIM/LPIPS 度量稀疏输出与同提示同种子稠密参考的差异(保真度而非绝对生成质量),VBench 从六个维度加权评价感知质量。论文的判定规则要求配对 95% 置信区间:PSNR 差值区间下界为正且 LPIPS 均值更低才算 win,其余算 tie。
论文几乎所有结论都以配对 PSNR 差值(dB)表述,理解"对稠密参考的保真"这一定位与 win/tie 判定规则,才能正确解读各张表格。
拉格朗日松弛与二分搜索
把带预算约束的优化 $\min \sum \hat{S}$ s.t. $\sum r \le C$ 转化为每个单元独立最小化 $\hat{S}+\lambda r$,λ 是预算的影子价格;对 λ 二分直至总成本逼近预算 C。依据 Everett 定理可证明所得解是离散问题在所达预算下的精确最优,无需凸性假设。
这是 ALLOT 求解器(算法 1)的全部数学基础,也是论文中"warm-up 长度与稠密层集合从解中自然涌现"这一卖点的原因。
研究动机
视频扩散 Transformer(Wan、HunyuanVideo 等)的 3D 全注意力计算量随 token 数平方增长:单卡上 Wan2.1-14B 生成一段 720p×81 帧视频约需 1 小时,其中注意力占端到端时间的一半以上。块稀疏注意力通过只计算选中的 query–key 块来降本,但现有方法在"每个层、每个去噪步保留多少稀疏度"这一分配问题上,要么依赖启发式规则(如固定第一层稠密、前 10–30% 去噪步稠密),要么依赖注意力质量、Hellinger 距离、单步输出误差等局部代理指标。作者实测发现:这些代理指标的层敏感度排序与基于最终视频误差的排序严重不符——在 HunyuanVideo 上 Spearman 相关甚至为负(−0.26 至 −0.51),按它们分配可能比均匀基线保真更低。同时层间敏感度差异极大:最敏感层的单步误差可达中位层的 154 倍(Wan2.1-14B)、53 倍(1.3B)、35 倍(HunyuanVideo),且最敏感层随模型而变,"第一层保持稠密"这类固定规则无法跨模型、跨策略迁移;步间差异更夸张,首末 5 步窗口的最终视频 MSE 之比高达 463×(1.3B)、186×(14B),而单步误差只显示 6.4×、2.4×,在 Wan2.2 上甚至颠倒排序。
本文的目标是本文把"稀疏度分配"本身升级为一个可优化问题:以(层,步)对为基本单元(cell),直接以"该单元稀疏化到密度 b 后最终视频相对稠密参考的退化"定义敏感度 $S(\ell,s;b)$,在实测延迟预算约束下联合求解全部单元的最优密度,使同一条稀疏注意力流水线在相同或更短挂钟时间内获得更高的对稠密输出的保真。方法必须是免训练、即插即用的:保留现有块选择策略的打分排序与稀疏注意力核,只替换其中的分配组件;并且由于敏感度排序跨输入几乎不变,昂贵的最终视频测量只需离线做一次,即可对所有提示词复用,换延迟预算只需在 CPU 上花约 4 秒重解一张密度表。
与已有工作不同的是,已有工作主要回答"哪些块参与计算"和"如何在核层面高效执行",把分配交给阈值或启发式规则;显式分配方法(HEART 的逐头阈值整数规划、Efficient-vDiT 的逐层密度、DiTFastAttn 的贪心误差上限、FAST 的参数化保真曲面、PASA 的局部变化率等)仍依赖局部代理指标或手工形状。本文的独特切入是"以输出定稀疏"(allocated by output):单步误差无法刻画跨步误差放大,作者便用窗口化稀疏实测最终视频误差,标定出每步的轨迹增益 $w(s)$,把一阶传播分析 $\delta\approx\sum_s P_s\epsilon_s$ 中无法解析确定的部分交给实测校准;再利用敏感度排序跨输入几乎不变(中位 Spearman 0.80–1.00)这一观察,把逐提示的敏感度测量变成可离线复用的模型属性;最后用拉格朗日松弛在实测延迟表约束下全局联合求解所有 cell 的密度,让 warm-up 长度、哪些层保持稠密、密度随步数的形状全部从解中涌现,而非任何手工规则。
核心方法
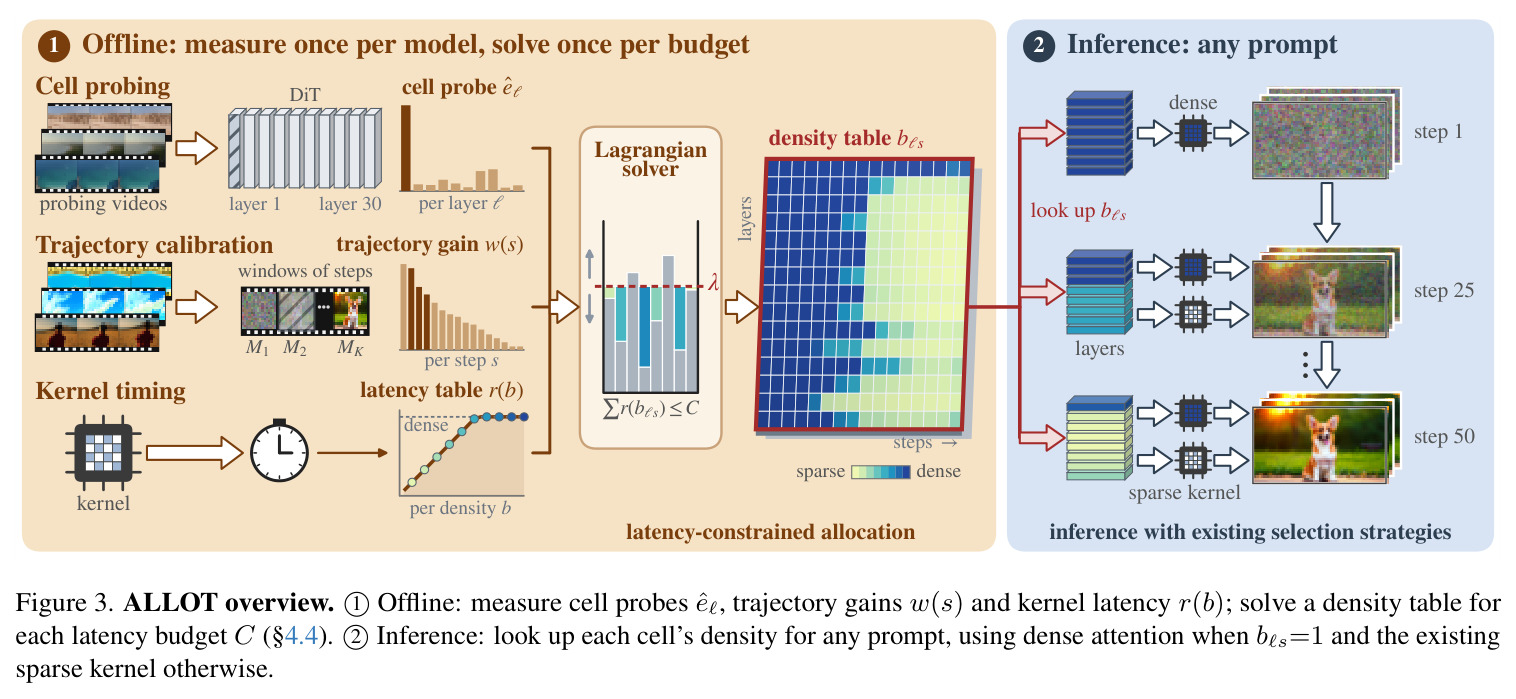
直觉上,不同(层,步)单元稀疏化对最终画面的伤害天差地别,且伤害 ≈ 单步注入的误差 × 后续去噪步对该误差的放大。ALLOT 据此把敏感度估计分解为两个可测因子 $\hat{S}(\ell,s;b)=w(s)\,\hat{e}_\ell(t_s,b)$:单元探针 $\hat{e}_\ell(t,b)$ 在真实视频加噪后的一次 teacher-forced 前向中只稀疏化层 ℓ,度量该步速度预测相对稠密模型的 MSE,负责区分同一步内的层与候选密度;轨迹增益 $w(s)$ 由窗口实验标定——50 步分成 10 个 5 步窗口,每次只把一个窗口的所有层稀疏化到固定密度 $b_0=0.30$ 生成完整视频,用其像素 MSE $M_k$ 除以该窗口探针之和 $E_k$,负责把不同步放到同一最终误差尺度上。再配一张实测核延迟表 $r(b)$(密度 b 下单次注意力调用相对稠密 FlashAttention 的时间,剪裁到不超过 1),然后用拉格朗日松弛求解 $\min\sum \hat{S}(\ell,s;b_{\ell s})$ s.t. $\sum r(b_{\ell s})\le C$:每个单元独立选 $\arg\min_b\,\hat{S}(\ell,s;b)+\lambda r(b)$,对 λ 二分约 80 次。命题 1 保证所得密度表是所达预算下离散目标的精确最优。推理时逐查表执行:b=1 走稠密注意力,其余 cell 由原有选择策略在该密度下截断并交给原核。
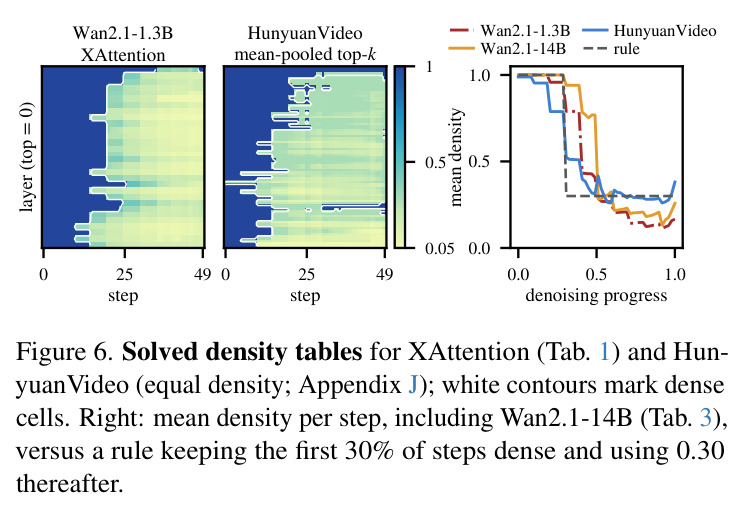
核心创新是把稀疏度分配从启发式规则升级为以最终视频误差为目标的约束优化,与已有方法的本质区别有三点。其一,度量对象不同:不用注意力质量、Hellinger 距离或单步误差等局部代理,而是用"单步探针 × 实测轨迹增益"捕捉跨步误差放大——Observation 2 显示首末窗口最终 MSE 之比可达 463×,单步误差只显示 6.4×,Wan2.2 上单步误差比值仅 0.18× 且排序颠倒,轨迹标定正是补上这一缺失的放大项。其二,求解方式不同:所有(层,步)单元在一个实测延迟预算下联合优化,warm-up 步数、稠密层集合、密度随步数的衰减形状全部由解给出(例如解出的表让前几层和某些深层保持稠密最久、密度在多个中间步逐渐下降,而非在某一步突然切换);而 HEART 等仍是逐头阈值或参数化形状规则。其三,工程接口不同:完全不改动选择策略的打分排序和稀疏核,只替换"保留多少"的截断规则,因此可与 SVOO、SVG2、SpargeAttn、Radial、XAttention、VSA mean-pooled top-k 等任何支持密度控制的策略即插即用组合。
方法步骤详情
离线阶段(每个"模型+选择策略"组合做一次)。第一步单元探针:取 4 条 OpenVid 真实视频的 VAE 潜变量,在 9 档噪声水平 t(0.85–0.05)加噪,只把层 ℓ 稀疏化到 8 档密度 b(0.05–0.60),跑一次 teacher-forced 前向,度量速度预测与稠密模型的 MSE 得 $\hat{e}_\ell(t,b)$,随后在 log b–log ê 空间插值。第二步轨迹标定:50 步分成 10 个 5 步窗口,用 8 条 VBench 提示,每条提示只把一个窗口的全部层稀疏到 $b_0=0.30$ 生成视频,与稠密参考的像素 MSE 为 $M_k$,除以该窗口所有 cell 探针之和 $E_k$ 得 $w(s)=M_k/E_k$(窗口内共享)。第三步核延迟表:在部署所用分辨率与核上实测单次注意力调用时间 $r(b)$,剪裁到 ≤1,超过"交叉密度"的候选一律按稠密处理。第四步求解(算法 1):候选密度集 B 取 200 个均匀点加 b=1,探针插值到 B 与各步噪声水平后乘以 $w(s)$;每单元独立最小化 $\hat{S}+\lambda r$,λ 二分 80 次直到总成本贴近预算 C。推理阶段:任一提示按噪声水平查表,b=1 的 cell 走稠密 SDPA/原核,其余 cell 由原选择策略在该密度下截断;换预算或步数只需重解一张表(CPU 约 4 秒)。
技术新颖性
技术新颖性体现在四点。其一,"输出级"敏感度定义与两因子分解:把无法直接测量的最终视频敏感度分解为可单次前向测量的单元探针与可一次生成测量的轨迹增益之积,以一阶扰动分析 $\delta\approx\sum_s P_s\epsilon_s$ 为理论支撑,附加可加性与可分离性两个近似,并用 oracle 实验验证——把真实稀疏误差换成随机符号或高斯扰动后,6 个设置全部 PSNR 大幅回升(如 10.71→29.57 dB),证明必须用真实稀疏路径的误差做标定。其二,离散情形的精确最优性:命题 1 依据 Everett 定理证明逐单元独立最小化在所达预算下恰为离散目标精确最优,无需凸性。其三,实测延迟表:揭示 $r(b)$ 并非与密度成正比,稀疏核只在交叉密度以下才比稠密快,按密度或 FLOPs 计价会高估稀疏收益(消融中按密度计价的表均值密度 0.48、延迟表成本却为 0.73)。其四,"排序跨输入稳定"(层排序中位 Spearman 0.80–1.00,窗口排序 leave-one-out 中位 0.95–1.00)把敏感度从逐提示量变成模型属性,是整个免训练方案得以离线化的前提。
实验结果
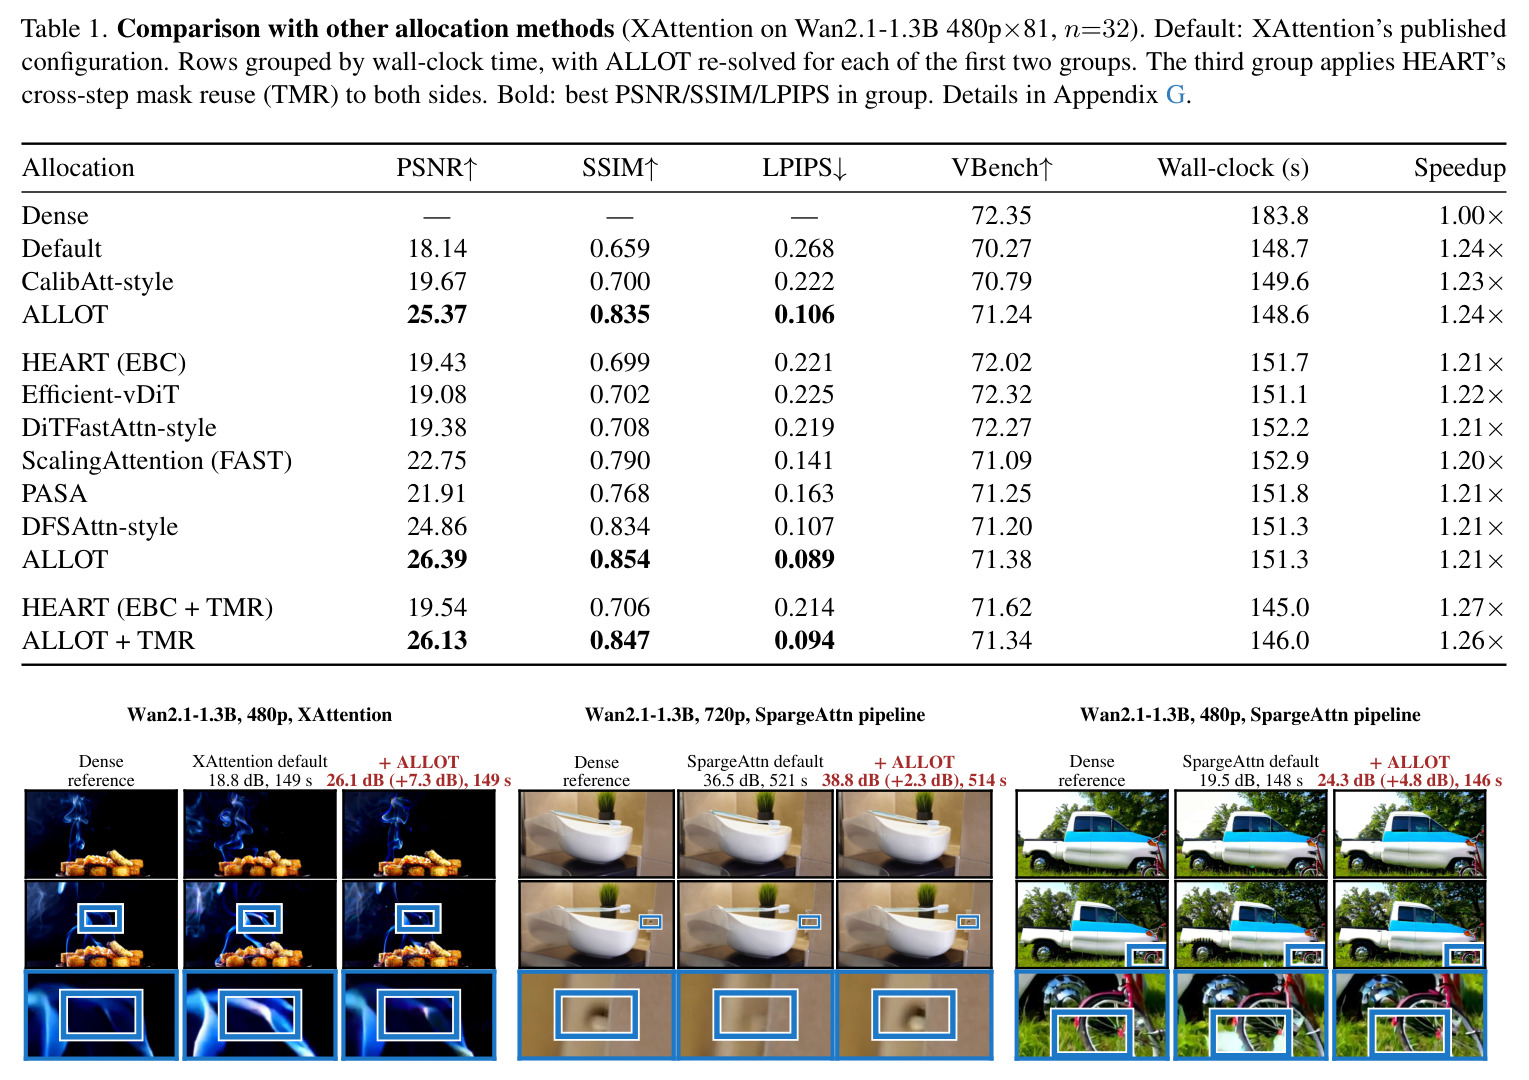
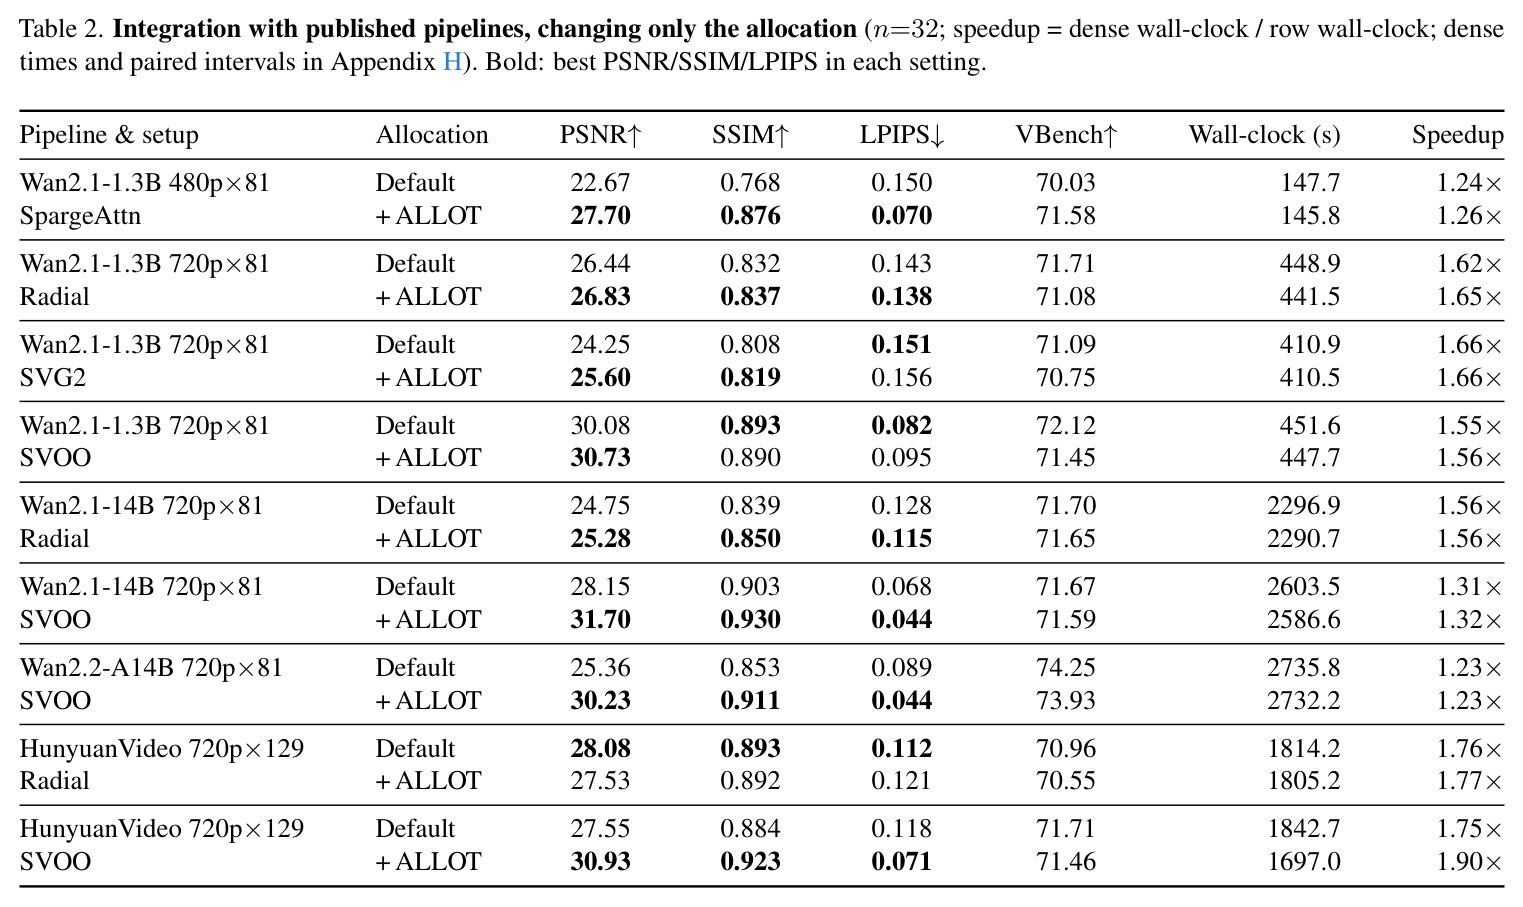
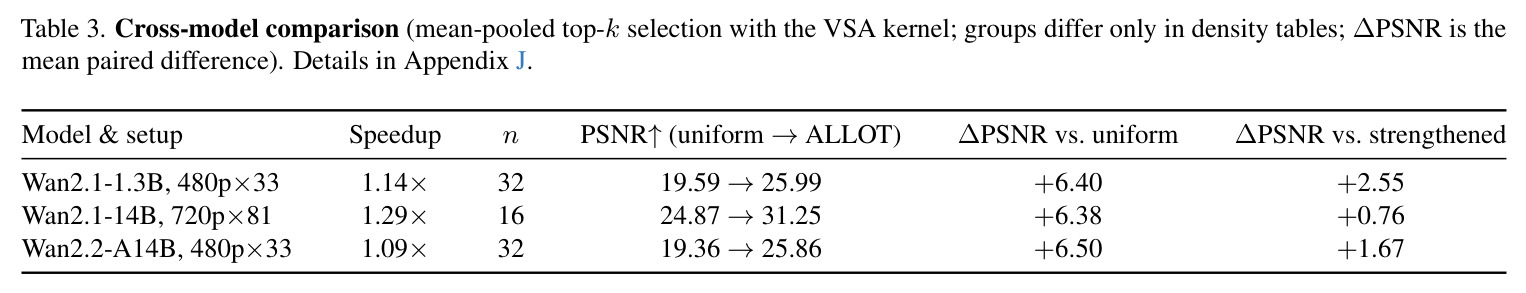
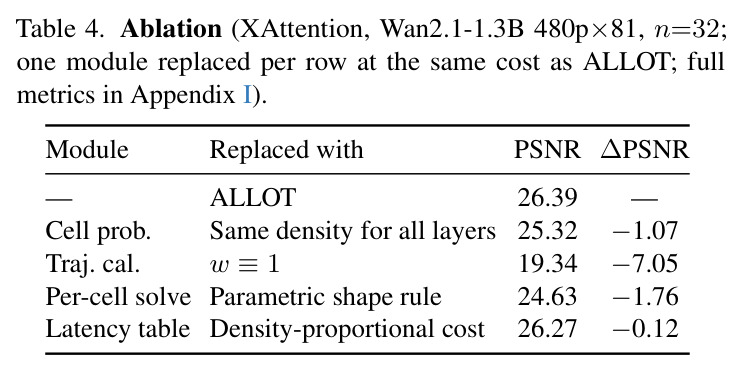
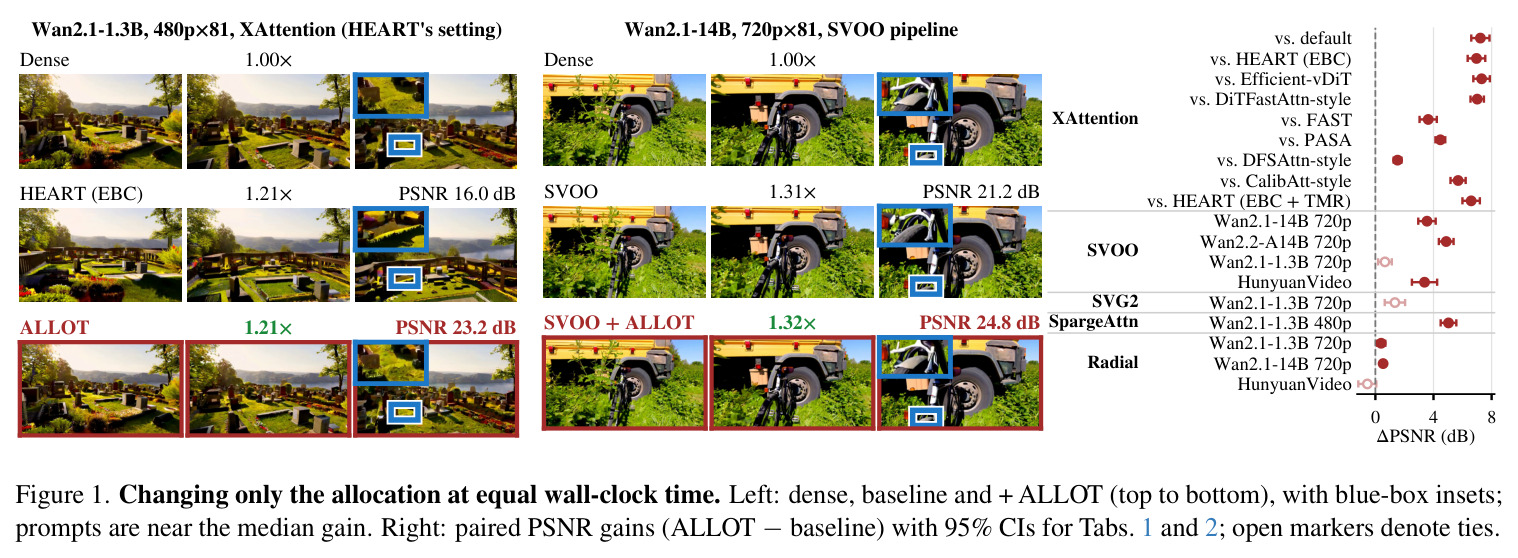
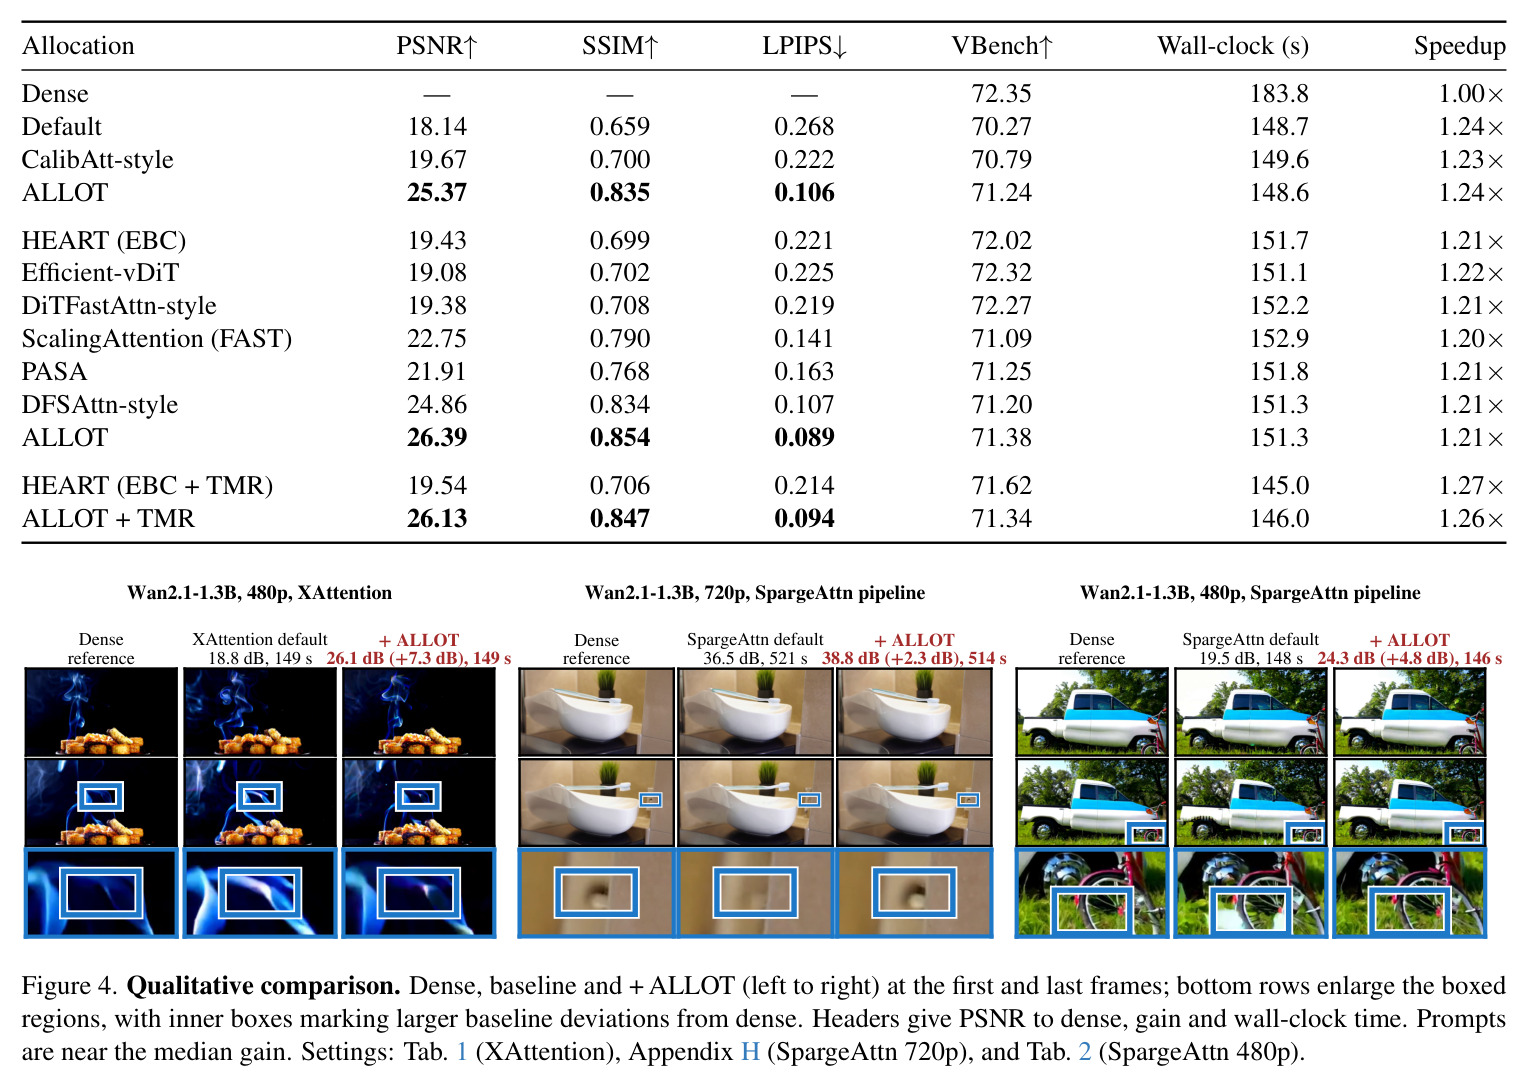
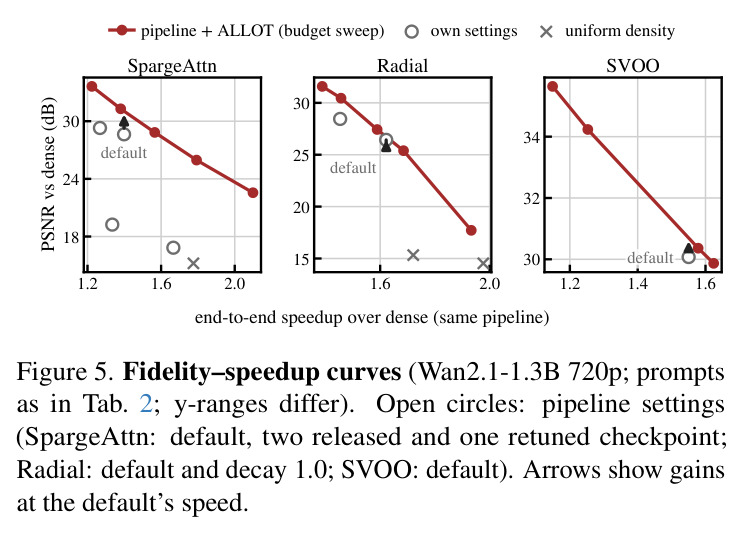
实验覆盖 Wan2.1-1.3B/14B、Wan2.2-A14B、HunyuanVideo 四个模型、6 种选择策略、32 条 VBench 提示。(1) 固定 XAttention 只换分配(Table 1,1.3B 480p×81):ALLOT 在默认挂钟时间 25.37 dB(默认 18.14,+7.23 dB),同速组 26.39 dB,胜过全部 10 个分配基线 1.53–7.31 dB;扩展到 HunyuanVideo 480p×129 时比默认高 11.84 dB(15.65→27.49)——即摘要所称的 11.8 dB 增益,720p 设置下也比默认高 6.35 dB。(2) 接入已发布流水线(Table 2):9 个设置 6 胜 3 平,最高 +5.03 dB(SpargeAttn 480p,22.67→27.70);HunyuanVideo+SVOO 提升 PSNR 3.38 dB(27.55→30.93)的同时把端到端加速从 1.75× 提到 1.90×(1842.7→1697.0 s);Wan2.2+SVOO +4.87 dB、14B+SVOO +3.55 dB。(3) 跨模型统一 top-k(Table 3):对均匀基线 +6.38~+6.50 dB,对加强基线(首层+前 20 步稠密且步数重搜)仍 +0.76~+2.55 dB。(4) 消融(Table 4):轨迹标定是主导成分,$w\equiv1$ 掉 7.05 dB;层间共用密度掉 1.07 dB;参数化形状规则掉 1.76 dB;按密度计价无显著差异。(5) 验证与鲁棒性:80 张表的加性预测与实测排序 pooled Kendall τ=0.83(R²=0.90);同密度重排实验中反向分配掉 18.05 dB;校准在 30 步、CFG 7.5、Euler 采样器下免重测仍赢 5.93–7.18 dB;离线成本每模型约 6–23 GPU 时(Wan2.2 两专家 >30),一次标定多处复用。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 分配方法对比(XAttention,Wan2.1-1.3B 480p×81) | PSNR | ALLOT 25.37 dB(默认时间)/ 26.39 dB(同速组) | XAttention 默认 18.14 dB;HEART (EBC) 19.43 dB | +7.23 dB / +6.96 dB(32/0 全胜) |
| 分配方法对比(XAttention,HunyuanVideo 480p×129) | PSNR | ALLOT 27.49 dB | 默认 15.65 dB;FAST 20.33 dB | +11.84 dB / +7.16 dB |
| 流水线集成(SVOO,HunyuanVideo 720p×129) | PSNR / 端到端加速 | 30.93 dB,1.90×(1697.0 s) | SVOO 默认 27.55 dB,1.75×(1842.7 s) | +3.38 dB 且加速更快 |
| 流水线集成(SVOO,Wan2.2-A14B 720p×81) | PSNR | 30.23 dB | 默认 25.36 dB | +4.87 dB |
| 流水线集成(SpargeAttn,1.3B 480p×81) | PSNR | 27.70 dB | 默认 22.67 dB | +5.03 dB |
| 跨模型等预算对比(mean-pooled top-k,Wan2.1-14B 720p×81) | PSNR | 31.25 dB | 均匀基线 24.87 dB;加强基线 30.49 dB | +6.38 dB / +0.76 dB |
| 消融:轨迹增益置 1(XAttention,1.3B 480p×81) | PSNR | ALLOT 26.39 dB | w≡1 时 19.34 dB | +7.05 dB(轨迹标定为主导成分) |
局限与改进
作者承认的限制:需要离线标定,且换选择策略必须重新测单元探针;加性、层可分离的估计对"排序"比对"误差量级"可靠得多——Table E.1 显示量级被系统性压缩(1.3B 预测 9.3× 实测 4.8×,HunyuanVideo 预测 286× 实测 30×);统一的密度接口取代了原生阈值自适应,密度截断对 SVOO 有害(保留其默认密度仅改截断就掉 3.00 dB),对 XAttention 有利(+4.50 dB);单元间交互未建模(相邻窗口同时稀疏有 1.16–1.36× 超加性)。我的补充观察:所有保真指标都以同提示同种子稠密输出为参考,衡量的是一致性而非绝对质量,部分设置的 VBench 略降(SVG2 71.09→70.75,SVOO 1.3B 720p 72.12→71.45,区间含 0);Radial 在 HunyuanVideo 上仅 −0.55 dB(tie),对固定掩码策略收益有限;HunyuanVideo 走 FlexAttention 时等延迟预算几乎无可分配,只能等密度比较,削弱结论普适性;oracle 诊断只覆盖 Wan2.1 的 6 个设置,未验证 Wan2.2 与 HunyuanVideo;10 窗口、$b_0=0.30$、4 条探针视频等标定超参本身也是手工选择的(尽管附录 K 显示相当鲁棒);teacher-forced 探针与全稀疏部署上下文的不一致在模型间方向相反,作者只能放弃统一修正。
独立分析的弱点
(1) 轨迹标定把 50 步硬性切成 10 个 5 步窗口且窗口内 $w(s)$ 为常数、窗口密度固定 0.30,无法刻画窗口内部的敏感度变化;改进方向是自适应窗口划分或多密度、多窗口的联合标定。(2) 敏感度估计假设误差可加、正交、层可分离,超加性(最高 1.36×)与层间交互被 $w(s)$ 平均吸收;在更稀疏的上下文中,孤立探针的加性预测与在上下文实测的排序相关只有 0.36–0.77,说明往更激进稀疏度外推时估计会退化;改进方向是加入二阶交互项,或采用"解表→在上下文中复测→重解"的迭代自举流程。(3) 探针在"其余层稠密"下测量,与部署时全稀疏上下文不一致;in-context 修正系数 κ 在 Wan2.1-1.3B 上为 1.9–15.5、在 Wan2.2 高噪专家上仅 0.09–0.44,统一修正反而在 1.3B 上掉 6.09 dB,作者最终放弃修正;改进方向是直接在目标稀疏上下文中测探针,或按模型自动决定是否修正。(4) 密度表按"模型+策略+预算"一张、全提示共享,忽略了逐提示幅度差异(首末窗口 MSE 比的单提示中位 363×);虽然排序稳定,逐提示轻量缩放仍有空间。(5) 只优化注意力组件,VAE 解码、文本编码不动;且收益受核实现制约(HunyuanVideo 的 FlexAttention 路径几乎无加速空间);改进方向是把延迟表扩展到非注意力组件,或与缓存、量化联合分配预算。
未来方向
作者明确提出的方向:建模单元间交互(超越加性假设)、保留自适应阈值接口(在密度表与原生逐头阈值间取得兼容)。基于其成果可延伸的方向:(1) 把轨迹增益 $w(s)$ 作为先验指导训练式稀疏注意力(如 VSA 类方法的蒸馏/微调),让训练与免训练两条线共享同一输出级敏感度度量;(2) 扩展到图像 DiT、MM-DiT 双流/单流混合结构以及 few-step 蒸馏模型(SVG2 已用 5 步 warm-up,步数更少时步间放大结构会更陡,轨迹标定可能更关键);(3) 在线校准:利用推理时真实产生的稀疏误差信号微调 $w(s)$ 与探针,适应分布外提示;(4) 与步数蒸馏、特征缓存、量化在同一延迟预算下联合分配,形成跨加速维度的全局预算优化器;(5) 理论上放松可分离性近似,研究层间误差二阶矩结构可估计时的最优分配,并解释"输出误差敏感度排序为何跨输入几乎不变"这一经验规律;(6) 把 11.8 dB 量级的保真提升转化为更激进的速度——在 ALLOT 曲线上反推等保真所能换取的最大加速比。
复现评估
复现评估:论文为 KlingAI 实习成果(UCAS/CASIA/PKU 合作),所读文本中未给出开源代码链接,需自行实现。好消息是所有依赖均开源:四个模型权重(Wan2.1-1.3B/14B、Wan2.2-A14B、HunyuanVideo)、各稀疏流水线官方代码(SVOO/SVG2/SpargeAttn/Radial/XAttention/FlashInfer/VSA 核)、4 条 OpenVid 探针视频与 32 条 VBench 提示均可公开获取。算力门槛低:离线标定每模型约 6–23 GPU 时(13B 级别;Wan2.2 两个专家 >30 GPU 时),单卡即可完成;重解密度表仅 CPU 4 秒;主要开销在评测端 720p 生成(14B 稠密约 3400 s/视频)。算法本身(两个测量 + 拉格朗日二分)实现简单,附录 F 给出了完整网格(8 密度×9 噪声、4 视频、10 窗口×8 提示)与算法伪代码。真正的难点有二:一是公平复现十余个基线——作者大量重实现(HEART EBC、FAST、PASA、DiTFastAttn、CalibAtt、DFSAttn 等),附录 G/H 提供了细致的实现细节与偏差说明,照着做工作量大;二是延迟表与硬件、分辨率、核绑定,换 GPU 需重新计时。总体而言,只需复用某一条流水线并替换分配组件的中等规模团队,数天内可在单模型上复现核心结论。
论文图表
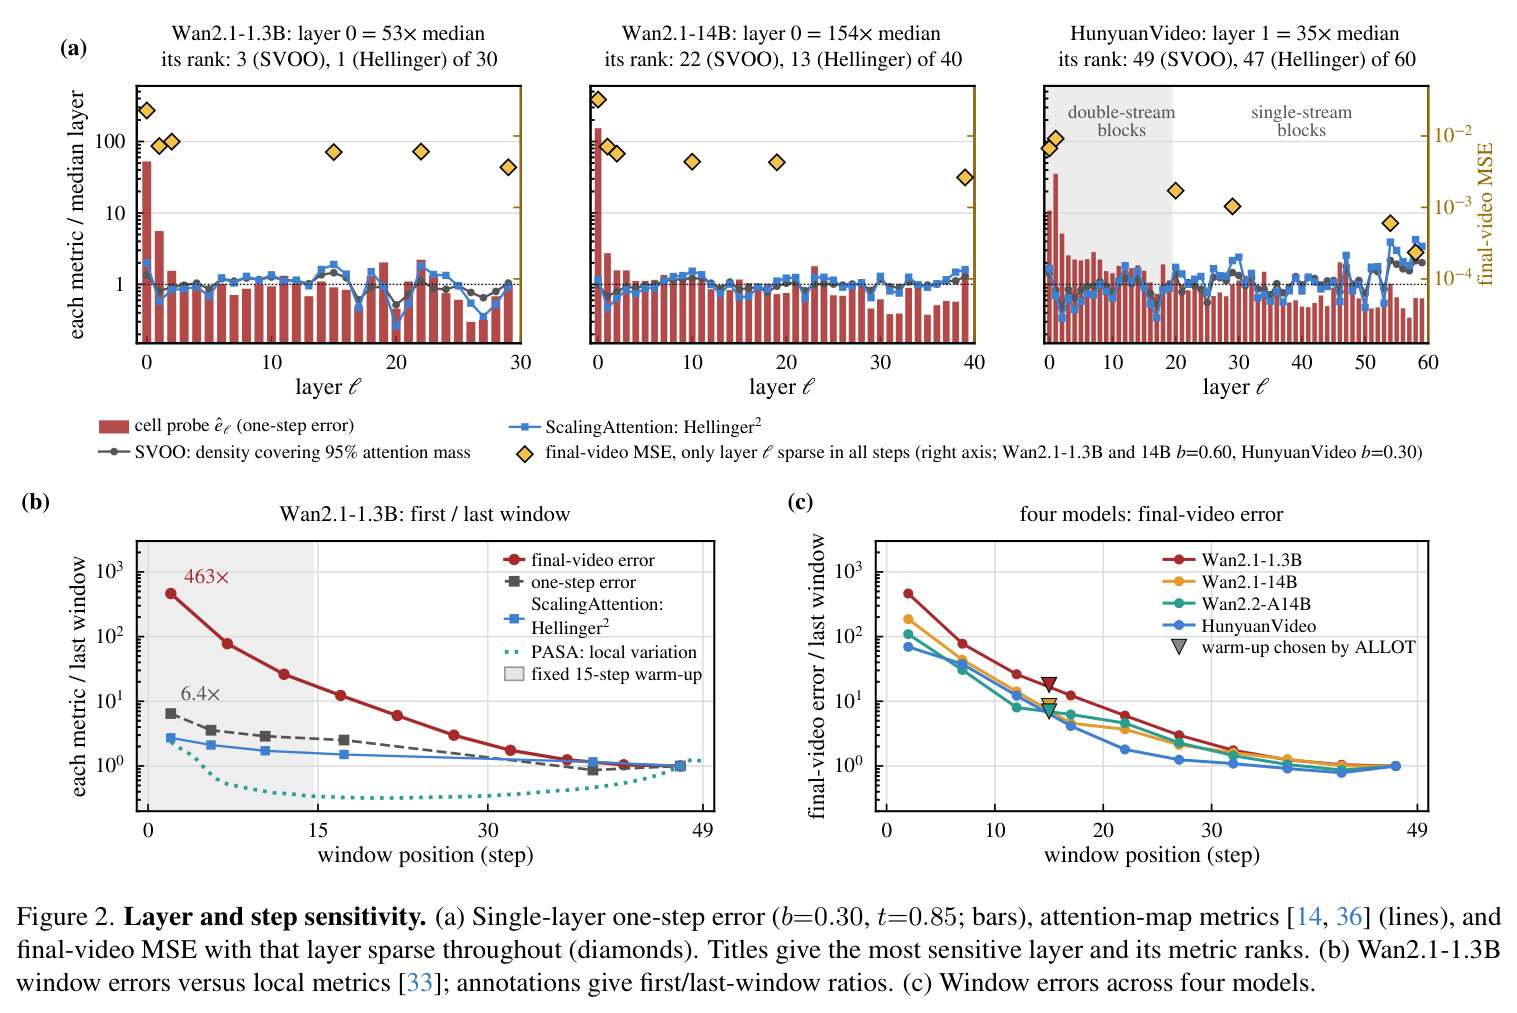
三个面板分别支撑三条观察:(a) 各层单步误差柱状图(首层达中位层 53×/154×/35×)叠加注意力质量与 Hellinger 指标曲线和整层稀疏的最终视频 MSE 菱形点,显示代理指标排序与真实排序错位;(b) 1.3B 各窗口最终误差与局部指标对比,标注首末窗口比 463× 对 6.4×;(c) 四个模型的窗口误差,首末比 463×/186×/109×/69×。
这是动机章节的核心证据图:层间、步间敏感度差异巨大且局部指标失真,直接引出"必须用最终输出标定敏感度"的方法设计。
对比 SVOO 官方发布的逐层覆盖密度与其单元探针:1.3B 上两者 Spearman 仅 +0.59(去掉前两层后 +0.53),14B 上为 −0.14(层 2+ 为 −0.22);探针认为最敏感的层 0 在 SVOO 排序中仅列 5/40 或 1/30。
用真实发布的分配方案做对照,说明现有方法的隐式分配与输出级敏感度严重脱节,是动机的有力补充证据。
四个模型的窗口误差跨输入箱线图(leave-one-out 中位 Spearman 0.95–1.00),以及逐视频层探针分布与排序一致性(t=0.85 时层 0 最敏感在 1.3B 为 32/32、14B 为 64/64)。
支撑 Observation 3——敏感度排序跨输入稳定,这是"离线测一次、全提示复用"整个方案合法性的前提。
把 80 张合成表(解的凸组合、随机表、抖动表)的加性预测误差与实测最终视频 MSE 画成散点,按预算着色:整体 pooled Kendall τ=0.83、R²=0.90,但距已解表越远的表族(随机表 τ=0.72,log-log 斜率 0.26–0.44)预测越不准。
量化敏感度估计在什么范围内可信,帮助读者判断该方法的外推边界,是理解估计器可靠性的关键图。
各流水线稀疏核的实测延迟曲线 r(b):并非密度线性,存在"交叉密度"——低于它稀疏才比稠密快,曲线随核与实现(FlashInfer BSR、SpargeAttn int8、SVOO 路径拟合)明显不同;VSA 核则在不同分辨率与头数下几乎重合。
解释为什么必须实测延迟表而非按 FLOPs 折算,否则求解器会把预算浪费在不产生真实加速的密度上。
mean-pooled top-k/VSA 设置下的 PSNR–加速曲线:ALLOT(红)在扫描的各预算点都高于同墙钟的均匀基线(灰)与加强基线(菱形),14B 上 1.05–1.40× 加速范围内保持约数 dB 领先。
补充跨模型、统一选择策略下的预算扫描证据,说明结论不依赖特定流水线。
三个模型、三个噪声水平下最敏感层及其探针倍数(53×/154×/35× 等),并给出覆盖密度、Hellinger² 的排名与探针的 Spearman 相关:1.3B 上弱正相关(+0.29–0.45),14B 上近零,HunyuanVideo 上为负(−0.20 至 −0.51)。
为 Observation 1 提供完整数据:注意力图类代理指标不仅量级失真(1.36–1.84× 对 53×),排序也可能相反,证明探针才是可靠的层间信号。
四个模型、10 个 5 步窗口逐窗口稀疏的 PSNR/MSE 表:窗口 1(步 0–4)的最终 MSE 相对窗口 10 高达 463×/186×/109×/69×,且步 15–49 内相邻窗口仍有 4.6–12.3× 的最大/最小比;对应单步误差比只有 6.4×/2.4×/31×/0.18×。
Observation 2 的原始数据:跨步敏感度相差两个数量级且单步误差严重低估,是轨迹增益标定必要性的直接证据。
逐项检验可分离性与可加性:单层整段稀疏的排序预测在 1.3B/HunyuanVideo 完全一致(Spearman 1.00)、14B 0.94,但幅度被压缩(预测 9.3× 实测 4.8× 等);层组能量比在 1.25–2.17× 之间;两窗口同稀的超加性 0.83–1.36×;80 张任意表的预测 Kendall τ=0.83。
系统界定估计器的适用范围:排序可信、量级近似,直接支撑论文对自身方法边界的诚实陈述。
保持密度多重集与总成本不变、只打乱归属:步内乱层 −3.40 dB、层内乱步 −12.23 dB、完全随机 −15.78/−16.17 dB、按估计反向分配 −18.05 dB,全部 0/32;加性模型对排序的预测(Kendall τ=1.0)与实测完全一致。
漂亮的对照实验:同样的"稀疏预算",给错地方就损失最高 18 dB,直观展示分配本身蕴含的巨大价值。
把窗口内的真实稀疏误差替换成保幅值的随机符号或高斯噪声后,6 个设置的 PSNR 全部大幅回升(如 1.3B top-k 窗口 1:10.71→29.57/25.68 dB),8 个提示全数如此。
证明最终视频误差依赖误差的具体模式而非仅其能量,论证轨迹标定必须用真实稀疏路径实测,而不能用解析扰动代替。
各模型离线标定成本:单元探针 2.8–18.9 GPU 时、轨迹增益 3.1–6.5 GPU 时、延迟表仅数分钟;Wan2.1-1.3B 约 17、14B 约 6、HunyuanVideo 约 23(Wan2.2 双专家 >30)。
给出方法的实际部署成本,说明"一次标定、长期复用"的性价比,是复现者最关心的数字之一。
四模型等预算完整对比:14B 720p 31.25、1.3B 480p 25.99、14B 480p 27.85、Wan2.2 25.86、HunyuanVideo 28.42 dB;对加强基线 +0.60~+2.55 dB(HunyuanVideo 因等密度比较为 +0.96),对均匀基线 +0.60~+8.65 dB。
跨模型结论的完整数字来源,包括 HunyuanVideo 这一等密度特殊设置的细节。
标定后不重测、只改一个推理设置:30 步 +5.93 dB、CFG 7.5 +6.80 dB、Euler 采样器 +7.18 dB,均 32/0 全胜且墙钟时间持平,与原设置的 +7.23 dB 相当。
证明一次标定的迁移能力覆盖步数、引导强度与采样器的常见变化,大幅降低实际使用的重标定负担。