AB-Attention:面向视频扩散Transformer加速的精准块注意力 AB-Attention: Accurate Block Attention for Accelerating Video Diffusion Transformers
块内聚类选块加逆概率加权采样,单次稀疏注意力无偏估计稠密注意力,加速至2.23倍
前置知识
3D 全注意力(视频 DiT)
视频扩散 Transformer 把视频的时空 token 拼成一条长序列做自注意力,即 $O=\mathrm{softmax}(QK^\top/\sqrt{d})V$。序列长度等于帧数乘以每帧 token 数,720p、81 帧时可达数万 token,计算量 $O(n^2 d)$ 且要在每个 transformer 层、每个去噪步反复执行,是视频生成的主要推理瓶颈。
本文加速对象就是它,理解其成本结构(层数×步数×平方复杂度)才能明白稀疏化的收益来源和 2 倍级加速的意义。
块稀疏注意力
把查询与 key/value 各切成固定大小的块,注意力掩码 $M\in\{-\infty,0\}^{n\times n}$ 在块粒度上取值,保留的块对用稠密矩阵乘(对齐 tensor-core tile)执行。块大小是核心权衡:大块硬件利用率高但选择粗糙,小块选择精细但单独执行效率低。FlashInfer 的 FlashAttention-3 块稀疏后端是此类方法的常见执行底座。
本文的关键主张之一是打破『选择粒度=执行 tile』的行业惯例,必须先理解这个权衡才能领会其选择/执行 co-design 的价值。
Horvitz–Thompson 估计与逆包含概率加权
抽样调查中的经典无偏估计:总体总量 $\sum_j y_j$ 可用样本估计量 $\hat{Y}=\sum_{j\in J} y_j/\pi_j$ 估计,其中 $\pi_j$ 是单元 $j$ 被抽入样本的包含概率。只要每个单元抽中概率非零,该估计量在固定总体下无偏;当抽样概率正比于 $y_j$ 本身时方差最小。系统抽样是一种恰好抽出固定样本量且满足各单元包含概率的实现方式。
这是 SIP 组件的数学根基:把『丢弃未选块』换成『带权抽样估计』,是本文与所有 top-k/阈值类方法的本质分界线。
FlashAttention 与在线 softmax
FlashAttention 把注意力按 tile 分块计算,在片上显存中维护 running softmax 统计量(分子累加器与分母和),避免物化 $n\times n$ 注意力矩阵,降低显存搬运。AB-Attention 的 fused kernel 在此骨架上加入按索引 gather 小块、对块施加 $-\log\pi_{ij}$ 的 logit 偏移等改动,一遍完成加权估计。
理解逆概率加权为何能以 logit 偏移形式嵌入标准注意力 kernel、以及为何无需 token 重排,都需要在线 softmax 的机制知识。
研究动机
视频扩散 Transformer(如 Wan2.1、HunyuanVideo)依赖 3D 全注意力建模时空依赖,计算量随序列长度平方增长;在 720p、81/129 帧、50 个去噪步的设定下,注意力在多层多步反复执行,成为推理瓶颈(稠密 14B 模型单视频约 4743.5 秒)。现有动态块稀疏注意力只计算从当前激活选出的关键 key/value 块,但存在三个设计缺陷:其一,重要性估计粗糙或昂贵——把一个块平均池化成单一代表会混合注意力偏好不同的 token,导致块排序错误(Figure 2b 显示 b=4 时 mean-pool 与 oracle top-k 的 recall 差距为 0.060);全局 k-means 聚类虽忠实但要跨全序列聚类并重排 token,对长序列代价高昂。其二,top-k 选择是截断而非估计——被丢弃的块从注意力分子和 softmax 分母中同时消失,这部分损失无法靠更好的打分恢复;即使 oracle top-k 用 10.8% 的 key 也只能保留约 69% 的注意力质量,长尾必然丢。其三,选择粒度绑定执行 tile——128 token 的 tile 被整块保留或丢弃,即使其中只有少数几个 key 重要。
本文的目标是目标是在训练无关(training-free)前提下,在约 90% 的极高稀疏度上仍精确逼近稠密注意力,同时不牺牲 tensor-core 执行效率。具体拆成三件事:用低开销打分器忠实估计每个小块的重要性(块内聚类而非全局聚类或粗暴池化);让被丢弃的注意力质量能被统计校正回来,一次稀疏注意力 pass 无偏估计分子与分母,不加额外校正分支;把选择粒度从执行 tile 解耦,允许 4 token 级细粒度选块而不增加 tensor-core 工作量。量化目标为:在 Wan2.1-T2V-1.3B/14B 与 HunyuanVideo-T2V-13B 三个模型、600 条 Penguin Benchmark 提示词上,相对稠密参考取得所有方法中最高的 PSNR/SSIM/LPIPS,同时端到端加速最高。最终达成:跳过 89.16%(Wan2.1)与 92.35%(HunyuanVideo)的注意力计算,端到端加速 1.84–2.23 倍,PSNR 比最强基线高 1.6–4.4 dB。
与已有工作不同的是,已有工作把稀疏注意力理解为『选出一批块、其余丢弃』:静态掩码(Radial Attention 的能量衰减、Sliding Tile Attention 的局部 3D 窗口)无法适应不同 prompt、头和去噪步的注意力变化,为保重要交互必须多留块;动态 top-k(SpargeAttention、XAttention、DFSAttn)靠更聪明的打分减少选错,但截断误差仍在;校正类方法(Rectified SpaAttn、PISA、SVG-EAR)为近似被丢弃块另设一条近似分支,增加计算。本文的独特切入是把注意力计算重新表述为抽样估计问题:引入统计学中成熟的 Horvitz–Thompson 逆包含概率加权,让每个块都有非零概率被抽中,抽中的块按 $1/\pi$ 加权即无偏估计稠密注意力的分子与分母——『选择』与『估计』在一次稀疏注意力 pass 中同时完成,无需校正分支。另一个被忽视的点是选择粒度与执行粒度可解耦:kernel 按索引 gather 小块并在线打包成完整 tensor-core tile,不用重排任何 token。这两个视角的组合是本文的差异化位置。
核心方法
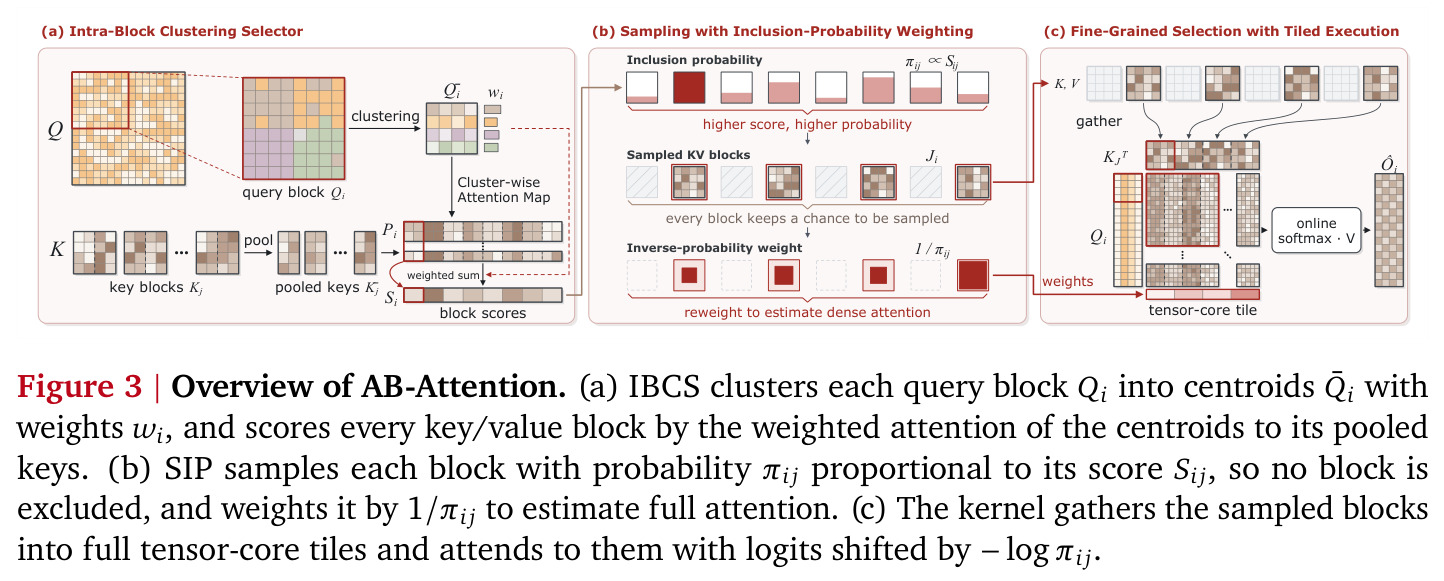
直觉上,与其像 top-k 那样『赌哪块重要然后扔掉其余』,不如做一次带权的抽样调查:重要块大概率被抽中,没抽中的块由抽中的『代表』按抽中概率的倒数补偿,一次计算就能还原整体。技术路线分三步。第一步 IBCS(块内聚类选择器):查询按执行 tile 分块($B_q=128$),在每个查询块内部做一次 k-means 迭代得到 $R=8$ 个质心 $\bar{q}_{ir}$ 与权重 $w_{ir}$;key/value 切成 4 token 小块并仅做相邻均值池化得 $\bar{K}_j$;块得分 $S_{ij}$ 是各质心按 $w_{ir}$ 加权后对块 $j$ 池化 key 的 softmax 注意力质量。第二步 SIP(逆包含概率加权抽样):按 $\pi_{ij}=\min(1,\lambda_i S_{ij})$(约束 $\sum_j \pi_{ij}=s$,$s$ 为预算)做系统抽样抽出 $s$ 个块,kernel 内以 $-\log\pi_{ij}$ 的 logit 偏移执行,等价于按 $1/\pi$ 加权。第三步细粒度 tiled 执行:fused kernel 按索引把抽中的小块 gather 成完整 tensor-core tile,在线 softmax 一遍算完。抽样计划每 $C=4$ 步重建,注意力本身每步都从当前激活重算。最终在 Wan2.1/HunyuanVideo 上跳过 89–92% 注意力,端到端加速 1.84–2.23 倍,PSNR 比最强基线高 1.6–4.4 dB。
核心创新有两点,与已有方法有本质区别。第一,把稀疏注意力从『截断』变成『无偏估计』:top-k、阈值和静态掩码都把未选块从分子 $\sum_j A_{ij}V_j$ 与分母 $\sum_j D_{ij}$ 中删掉,误差无法靠打分弥补;SIP 则令 $\pi_{ij}\propto S_{ij}$ 且每块都有被抽中的机会,抽中块按 $1/\pi_{ij}$ 加权后构成 Horvitz–Thompson 估计量,对固定激活是无偏的。实现上极为巧妙:$\hat{O}_i=\mathrm{softmax}(Q_iK_{J_i}^\top/\sqrt{d}-\log\pi_{iJ_i})V_{J_i}$,即标准 softmax 中的 logit 偏移,一次块稀疏注意力 pass 即可完成,不需要 Rectified SpaAttn/PISA/SVG-EAR 那样的额外校正分支;分数越正比于真实注意力质量,方差越小。第二,IBCS 把聚类从全序列搬进查询块内部:SVG2 需要全序列 k-means 并重排 token,IBCS 只在每个 128-token 查询块内做一次 k-means 迭代得 8 个质心,用『质心对池化 key 的注意力』打分,token 顺序完全不动。再叠加 4-token 细粒度选块(oracle top-k 在 b=128 到 b=4 时保留质量从 59% 升到 69%)与 kernel 打包执行,三者叠加使同一预算下注意力误差比 oracle top-k 还低 41%。
方法步骤详情
完整流程见论文算法 1(单个头、单个去噪步 $t$)。输入:$Q,K,V\in\mathbb{R}^{n\times d}$、块大小 $B_q=128$ 与 $b=4$、簇数 $R=8$、预算 $s$、计划周期 $C=4$。阶段一(每 $C=4$ 步一次的计划重建):(1) 对每个 key 块均值池化得 $\bar{K}_j$;(2) 对每个查询块 $Q_i$ 做块内 k-means——从 $R$ 个相距最远的查询出发、单次迭代分配,输出质心矩阵 $\bar{Q}_i$ 与权重 $w_i$(各簇成员占比);(3) 按 $S_{ij}=\sum_r w_{ir}\cdot\frac{\sum_{\bar{k}\in\bar{K}_j}\exp(\bar{q}_{ir}\bar{k}^\top/\sqrt{d})}{\sum_{\bar{k}\in\bar{K}}\exp(\bar{q}_{ir}\bar{k}^\top/\sqrt{d})}$ 打分;(4) 归一化出 $\pi_{ij}=\min(1,\lambda_i S_{ij})$、$\sum_j\pi_{ij}=s$,高分块 $\pi=1$ 恒选;(5) 用系统抽样抽出恰好 $s$ 个不同块得样本 $J_i$,实际抽中概率等于 $\pi_{ij}$。阶段二(每个去噪步执行):fused kernel 按索引 gather $K_{J_i},V_{J_i}$ 并在线打包成完整 tensor-core tile,计算 $\hat{O}_i=\mathrm{softmax}(Q_iK_{J_i}^\top/\sqrt{d}-\log\pi_{iJ_i})V_{J_i}$,在线 softmax 一遍完成,输出 $\hat{O}$。同一查询块内所有 token 共享 $J_i$,保证执行仍是块稀疏注意力;计划重建步之间只复用抽样计划,注意力用当前激活重算。
技术新颖性
新颖性可从三个层面评估。(1) 估计论视角的引入是首创:此前没有工作把系统抽样加逆包含概率加权用于扩散模型注意力加速——校正类方法(Rectified SpaAttn 的池化注意力恢复、PISA 的块级 Taylor 展开、SVG-EAR 的质心补偿)都需要为近似被丢弃块增设额外计算分支,而 SIP 的 $-\log\pi$ logit 偏移实现让『估计』完全融入标准注意力 kernel,零额外注意力计算,分子分母同时无偏。(2) 打分器设计:与 SVG2 的全序列 k-means 加 token 重排、DFSAttn 的 3D Hilbert 曲线重排加层级子块打分相比,IBCS 只做块内单次 k-means、不移动 token,把 b=4 时与 oracle top-k 的 recall 差距从 mean-pool 的 0.060 减半到 0.029(Figure 2b)。(3) 系统 co-design:选择用 4-token 小块、执行仍用 128 tile,kernel 在线 gather/pack 免重排免物化,使细粒度选择在固定预算下不增加 tensor-core 工作量。消融(Table 2)显示三个组件在同预算下各自贡献 0.91–7.25 dB PSNR,且没有任何单一替代版本能在全部指标上追平完整方法,证明设计是必要而非堆料。
实验结果
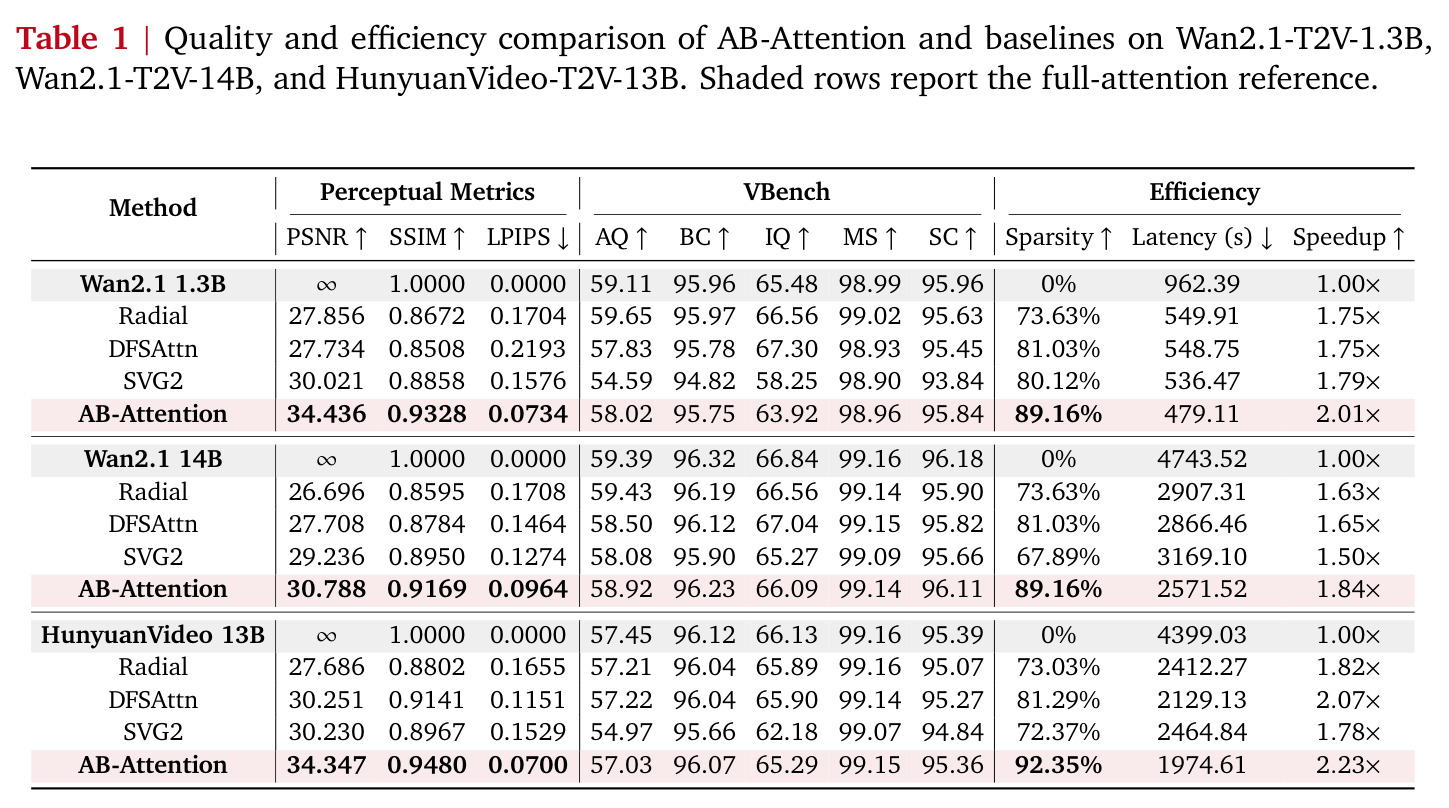
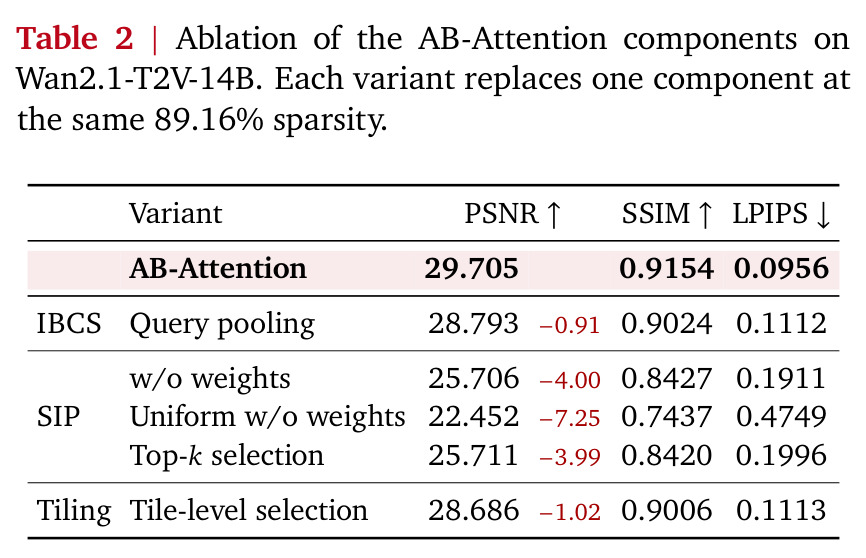
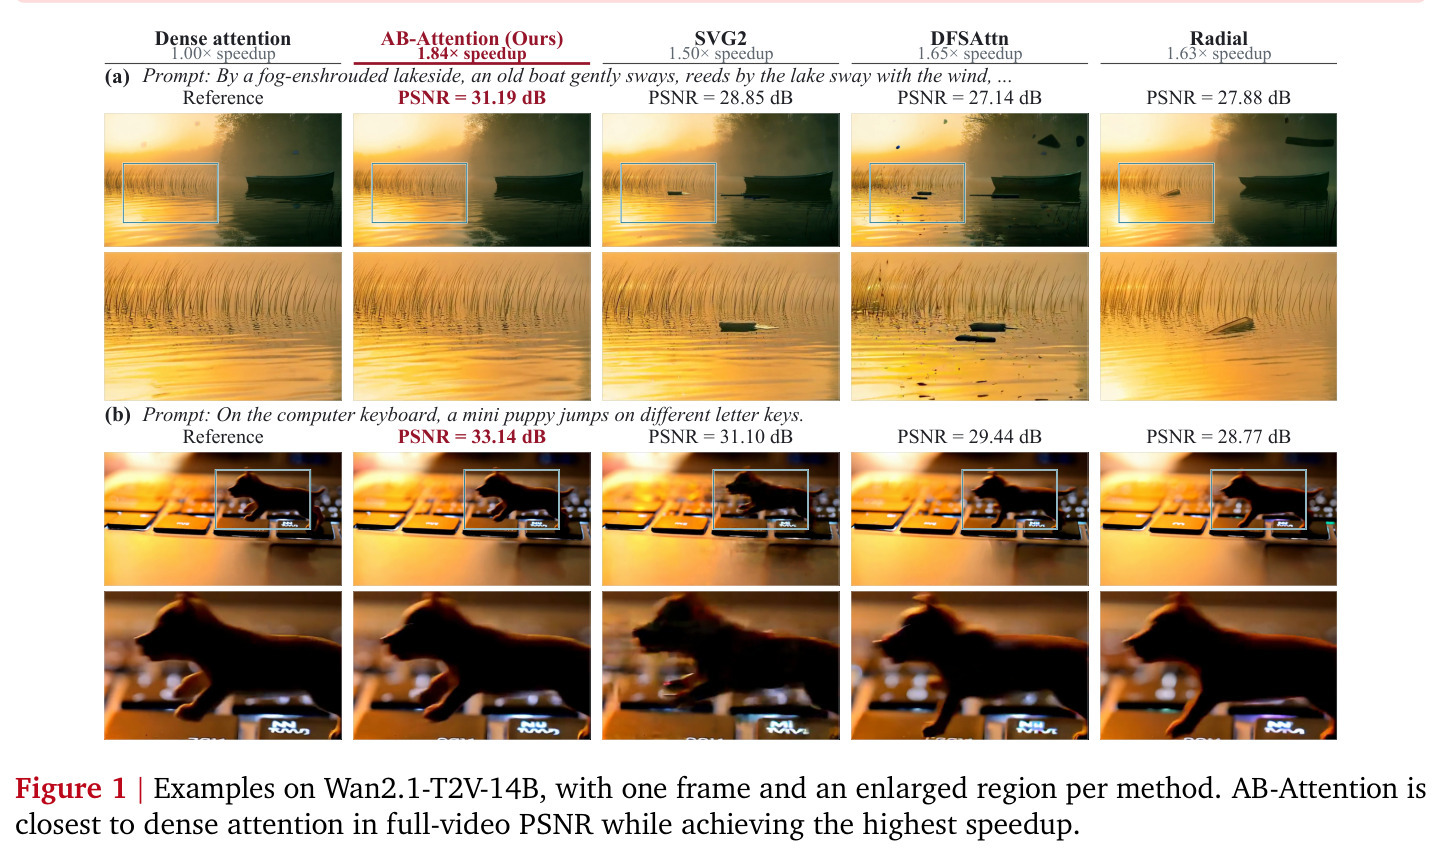
主实验(Table 1)在 Wan2.1-T2V-1.3B/14B 与 HunyuanVideo-T2V-13B 上进行:720p、81/129 帧、Penguin Benchmark 600 条提示、H20 GPU、BF16。AB-Attention 在三个模型上同时取得最高保真与最高加速:Wan2.1-1.3B 上 PSNR 34.436、SSIM 0.9328、LPIPS 0.0734,89.16% 稀疏度下加速 2.01×(962.4s→479.1s);Wan2.1-14B 上 PSNR 30.788、SSIM 0.9169、LPIPS 0.0964,加速 1.84×(4743.5s→2571.5s);HunyuanVideo 上 PSNR 34.347、SSIM 0.9480、LPIPS 0.0700,92.35% 稀疏度下加速 2.23×(4399.0s→1974.6s)。相比之下所有基线多算 1.8–3.6 倍注意力仍全面落后:14B 上 SVG2 仅 67.89% 稀疏、1.50× 加速、PSNR 29.236;最强的 DFSAttn 在 HunyuanVideo 达 2.07× 加速但计算了 2.4 倍注意力(18.71% vs 7.65%)。VBench 五维均贴近稠密参考(如 HunyuanVideo 的 SC 95.36 vs 95.39),说明整体视觉质量未受损。消融(Table 2,14B,100 条提示,89.16% 稀疏)证明每个组件都必要:均匀采样无权重 22.452(−7.25 dB,LPIPS 翻倍到 0.4749)、按分采样无权重 25.706(−4.00 dB)、top-k 25.711(−3.99 dB)、tile 级选择 28.686(−1.02 dB)、查询池化替代聚类 28.793(−0.91 dB),完整方法 29.705。Figure 5 显示选块从 128 缩到 4 token 时 PSNR 单调上升 +1.019 dB,且因 kernel 打包不增加 tensor-core 开销。
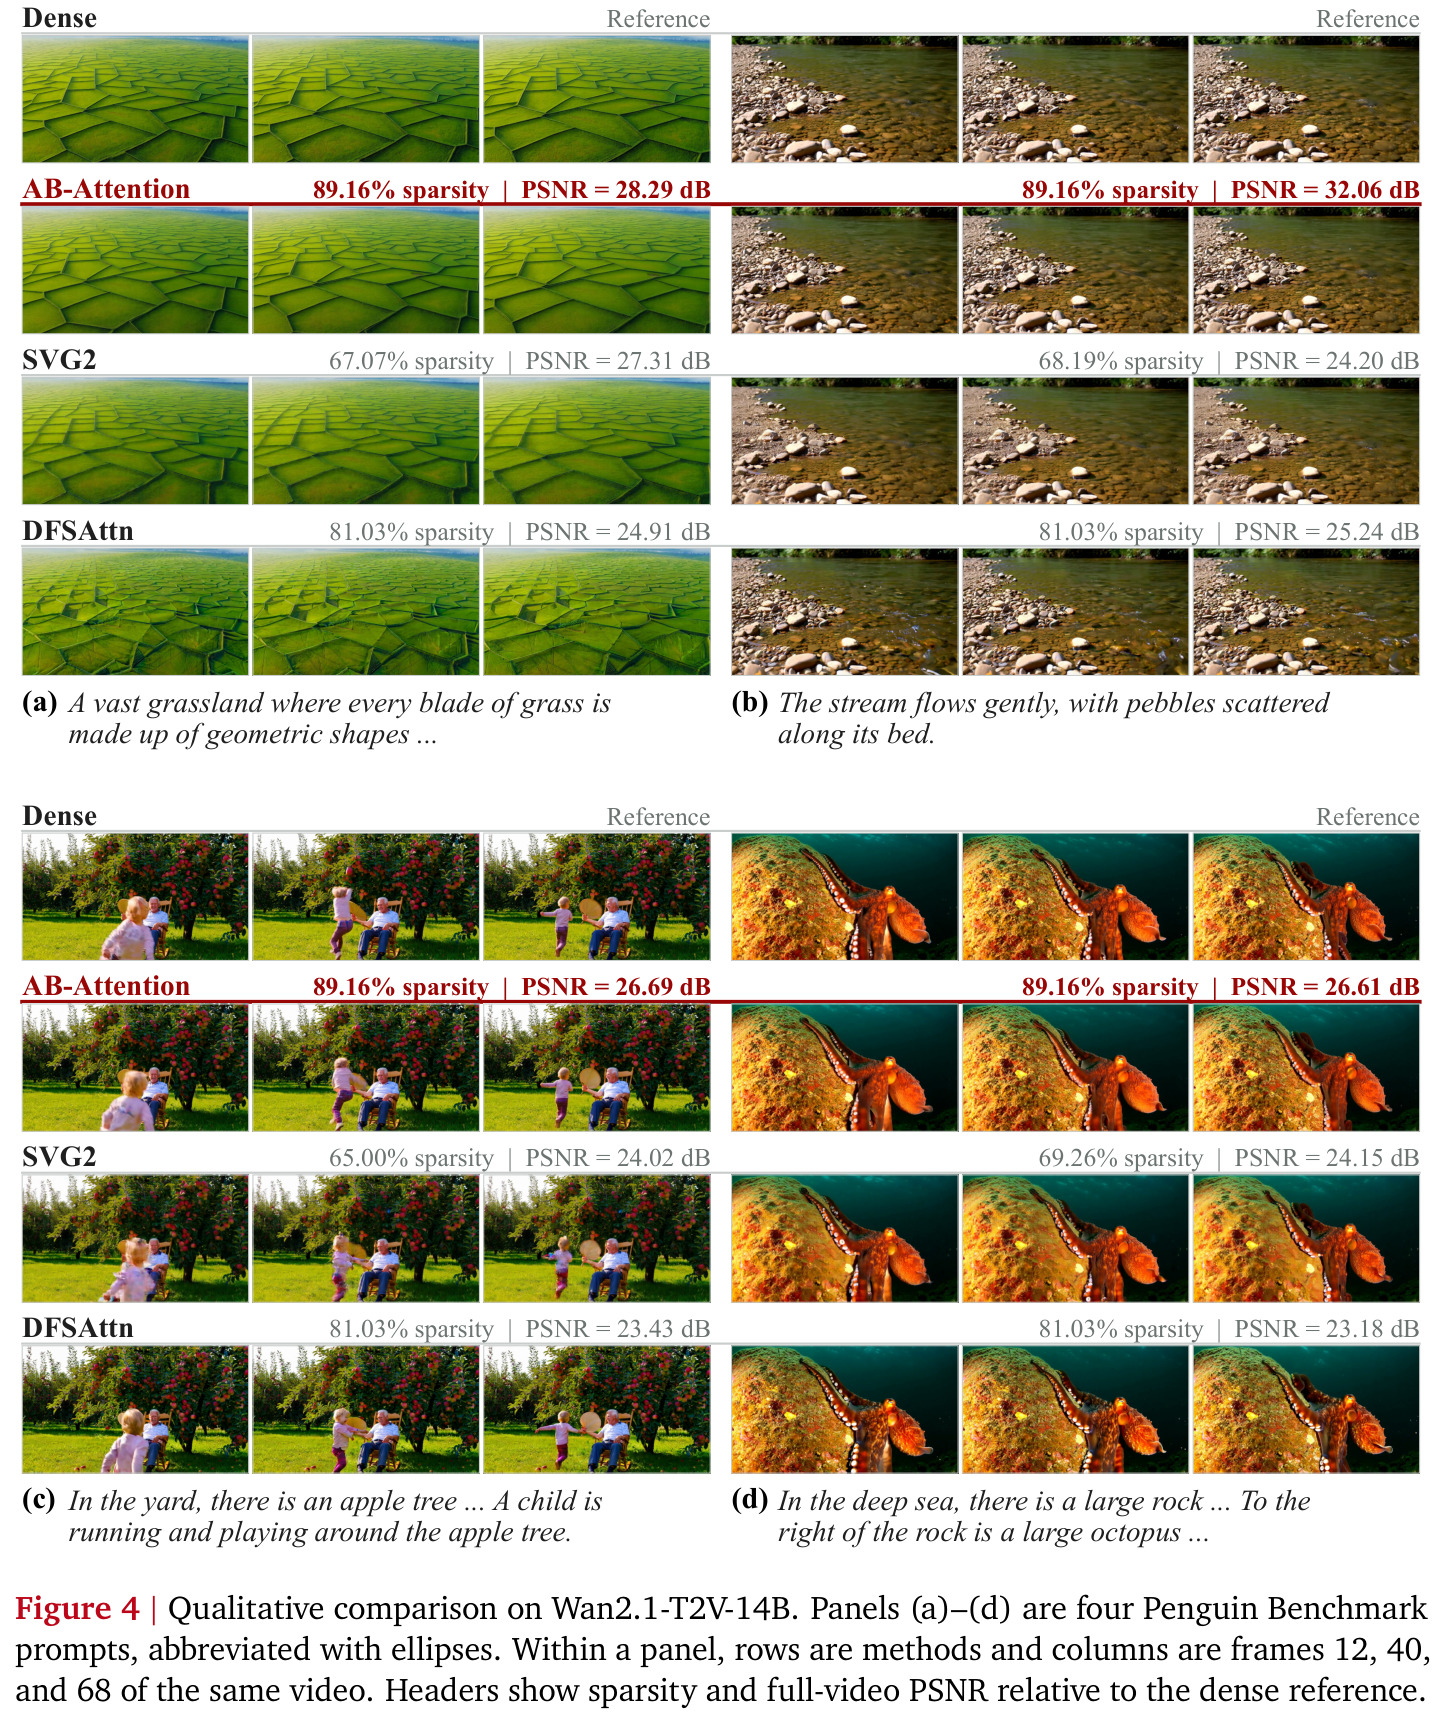
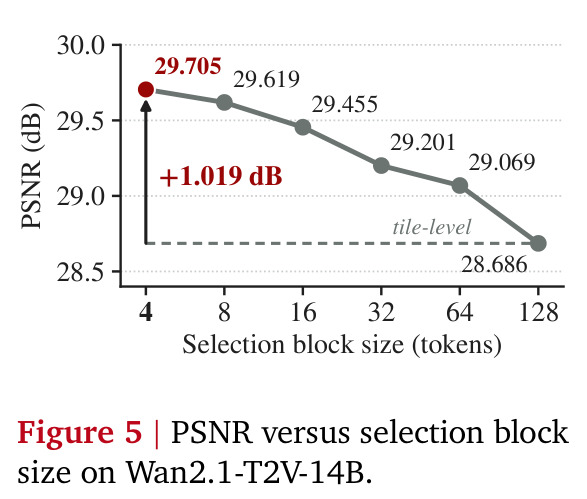
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生视频(Wan2.1-T2V-1.3B,720p/81帧) | PSNR(对稠密参考)/ 端到端加速 | 34.436 dB / 2.01×(89.16% 稀疏) | SVG2 30.021 dB / 1.79×;DFSAttn 27.734 dB / 1.75×;Radial 27.856 dB / 1.75× | 较最强基线 SVG2 +4.42 dB、加速 +0.22×,注意力计算量仅为基线的约 1/2 |
| 文生视频(Wan2.1-T2V-14B,720p/81帧) | PSNR / 端到端加速 | 30.788 dB / 1.84×(89.16% 稀疏,4743.5s→2571.5s) | DFSAttn 27.708 dB / 1.65×(81.03% 稀疏);SVG2 29.236 dB / 1.50× | 较最强基线 +1.55 dB、加速 +0.19×,且稀疏度高出 8.1 个百分点 |
| 文生视频(HunyuanVideo-T2V-13B,720p/129帧) | PSNR / 端到端加速 | 34.347 dB / 2.23×(92.35% 稀疏,4399.0s→1974.6s) | DFSAttn 30.251 dB / 2.07×(81.29% 稀疏);Radial 27.686 dB / 1.82× | 较最强基线 +4.10 dB、加速 +0.16×;DFSAttn 需多算 2.4 倍注意力才达 2.07× |
| 生成视频质量(HunyuanVideo,VBench 无参考指标) | VBench 主观一致性 SC / 动作平滑 MS | SC 95.36 / MS 99.15 | 稠密参考 SC 95.39 / MS 99.16 | 在 92.35% 稀疏度下与稠密几乎无损(差距 0.03/0.01) |
| 组件消融(Wan2.1-14B,100 提示,89.16% 稀疏) | PSNR | 完整 AB-Attention 29.705 dB | top-k 25.711;按分采样无权重 25.706;均匀采样无权重 22.452;tile 级选择 28.686;查询池化 28.793 | SIP 贡献 3.99–7.25 dB,细粒度选择 1.02 dB,块内聚类 0.91 dB |
局限与改进
作者承认的局限:自研 kernel 目前只为实验所用的 H20 GPU 构建,仅支持前向推理,尚无法在 AB-Attention 下做训练或微调;评估局限于三个文生视频扩散 Transformer(Wan2.1-1.3B/14B、HunyuanVideo)。我补充观察:其一,无偏性是『对固定激活』而言的——稀疏输出会改变后续去噪步的激活分布,误差可能在 50 步中累积漂移,论文未做长程误差传播分析;其二,比值估计量 $\hat{O}_i=\hat{N}_i/\hat{D}_i$ 本身一般是有偏的,论文只论证分子分母无偏,且低方差依赖『分数正比于注意力质量』这一由 IBCS 近似保证的理想条件;其三,抽样计划每 4 步复用、前 10 步与首个块保持稠密等超参对其他模型或步数配置的鲁棒性未验证;其四,效率数字高度依赖自研 kernel 与 FlashAttention-3/FlashInfer 后端,在其他硬件上的可用性存疑;其五,与步数蒸馏、cache 复用等正交加速手段的组合只在 related work 提及,未实验验证。
独立分析的弱点
独立分析几个弱点。(1) 方差控制依赖打分质量:IBCS 的质心加池化 key 只是注意力质量的粗代理,当注意力高度集中于极少数 token 或 prompt 语义复杂时,$\pi_{ij}$ 偏离真实质量会放大 Horvitz–Thompson 估计的方差;改进方向是对高方差查询块自适应提高预算 $s$,或按头/层做分层抽样。(2) 无偏不等于误差不累积:每个去噪步的估计误差会进入下一步的激活,50 步长序列下可能漂移,论文只用端到端 PSNR 度量;可研究步间误差监控与自动回退稠密计算的触发机制。(3) 打分开销非零:块内 k-means 与质心-池化 key 矩阵乘要在计划重建步执行,候选块数 $M=n/4$ 随分辨率线性增长;可探索先 tile 级粗筛再块内细筛的两级筛选。(4) 硬件与训练支持缺失:只有 H20 前向 kernel,社区难以直接用于 LoRA 微调或消费级 GPU;可基于 Triton/CUTLASS 做可移植实现并补 backward。(5) $\pi=1$ 的头部块恒选机制在分数分布平坦时接近均匀采样,预算利用率可能下降,需要更聪明的预算分配。
未来方向
作者提出的方向:扩展 kernel 支持更多硬件;在更广泛的模型上评估(文生视频之外还包括图像生成、编辑等);实现可训练版本与 backward 支持,使模型能在 AB-Attention 下微调。基于本文成果可延伸的研究:(1) 把 SIP 的抽样估计框架与步数蒸馏、TeaCache 类 cache 复用叠加,量化误差是否可加、能否相互补偿;(2) 将包含概率的构造从全局分数比例推广为按层、头、去噪阶段自适应的预算分配——结构形成期多采样、细节精修期少采样;(3) 研究 IBCS 块内聚类与跨头/跨层共享抽样计划的结合,进一步摊薄打分开销;(4) 把逆包含概率加权迁移到长上下文 LLM 的 KV cache 压缩与稀疏注意力——那里同样存在『丢弃即永久丢失质量』的问题,SIP 提供了免训练的校正思路;(5) 理论上给出比值估计量 $\hat{O}$ 的偏差阶与去噪步间误差传播界,把稀疏度-质量权衡显式化,指导预算 $s$ 的自动设定。
复现评估
复现条件较好。代码已开源(https://github.com/InfRec-Cardinal/AB-Attention),附录 B 给出全部关键超参(KV 块 4、查询块 128、8 簇、计划每 4 步重建、前 10/50 步与首个 transformer 块稠密、FlashAttention-3 稠密与 FlashInfer 块稀疏后端),附录 A 给出抽样与估计的完整推导(质心/池化、系统抽样、加权估计),附录 C 给出延迟测量协议,评估集为公开的 Penguin Benchmark 600 条提示,基线均用官方代码与默认超参并统一到同一 FA3 块稀疏后端,对比公平。硬件门槛是主要障碍:端到端数字来自 NVIDIA H20 GPU、BF16、PyTorch 2.6 + CUDA 12.4,且依赖自研 fused kernel;没有 H20 级设备时只能复现质量指标或跑 1.3B 模型(稠密单视频约 962 秒)。整体难度评估:跑通官方代码复现 Table 1 属中等难度(主要成本是 GPU 时间),从零重实现 kernel(gather 小块、$-\log\pi$ 偏移、在线打包)属高难度工程。
论文图表
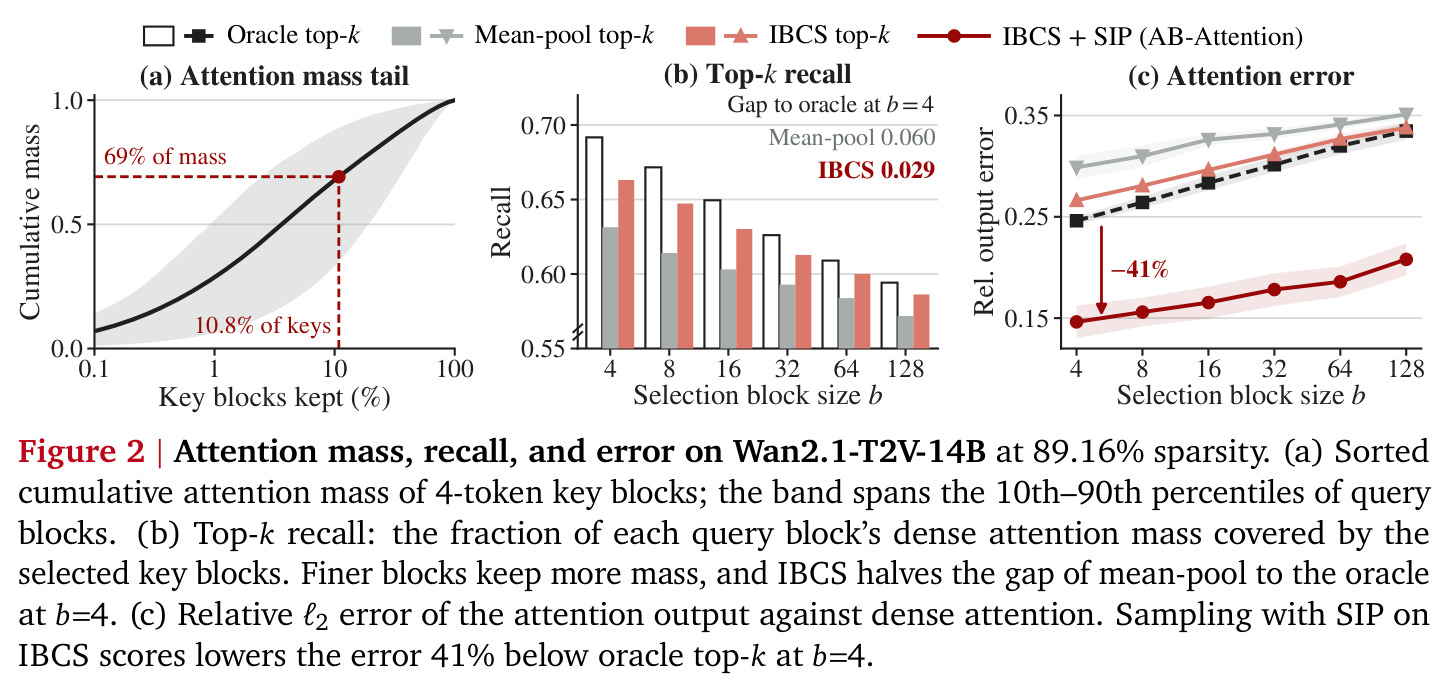
三张定量分析图:(a) 4-token key 块按注意力质量排序的累积分布(10–90 分位带),10.8% 的 key 携带约 69% 的注意力质量,说明长尾不可忽略;(b) top-k recall 随选块粒度 b 从 128 缩到 4 的变化,b=4 时 IBCS 把 mean-pool 与 oracle 的差距从 0.060 减半到 0.029;(c) 注意力输出的相对 ℓ2 误差,在 IBCS 分数上做 SIP 比同粒度 oracle top-k 低 41%。
这是全文动机与三个组件有效性的核心定量证据,直接支撑『细粒度选块、块内聚类、加权估计』三个设计决策。