面向扩散语言模型的表示空间MMD后训练方法 Representation-Space MMD for Diffusion Language Models
在冻结DLM的特征空间里做MMD后训练,让扩散语言模型少步生成质量与并行解码效率兼得
前置知识
MMD(最大均值差异)
衡量两个分布差异的核方法统计量:$\mathrm{MMD}^2_k(P,Q)$ 在再生核希尔伯特空间中比较两分布的核均值嵌入,展开为项内相似度之和减两倍的交叉相似度。配合特征核(如 RBF 核)时 MMD 为零当且仅当两分布相同;只需各采一批样本即可无偏估计。
本文的训练目标就是把生成文本与真实文本在冻结 DLM 特征空间中的分布做 MMD 最小化,损失构造、无偏估计与防坍缩机制全部围绕它展开,不理解 MMD 就无法理解方法本身。
扩散语言模型(DLM)
通过迭代去噪生成文本的模型:离散模型在 token 空间加噪——掩码扩散把 token 换成 $[\mathrm{MASK}]$(MDLM),均匀扩散换成随机词,DMax 兼顾两者;连续模型(ELF)在冻结编码器潜空间用流匹配去噪。推理时从纯噪声出发多步并行解码,步数越少质量越难保证。
本文同时对离散(MDLM、DMax)与连续(ELF)两类 DLM 做后训练,必须理解它们的加噪-去噪框架以及少步采样质量崩塌这一核心瓶颈,才能看懂方法设计与实验动机。
REINFORCE 与 leave-one-out 基线
离散采样不可导时的策略梯度方法:把负 MMD 作为整批序列的奖励 $r$,用 $\nabla_\theta\sum\log q_\theta(x)$ 加权更新。为降方差,对同一输入抽 $G$ 批,用组内均值作基线 $A_g=r_g-\frac{1}{G-1}\sum_{h\neq g}r_h$。
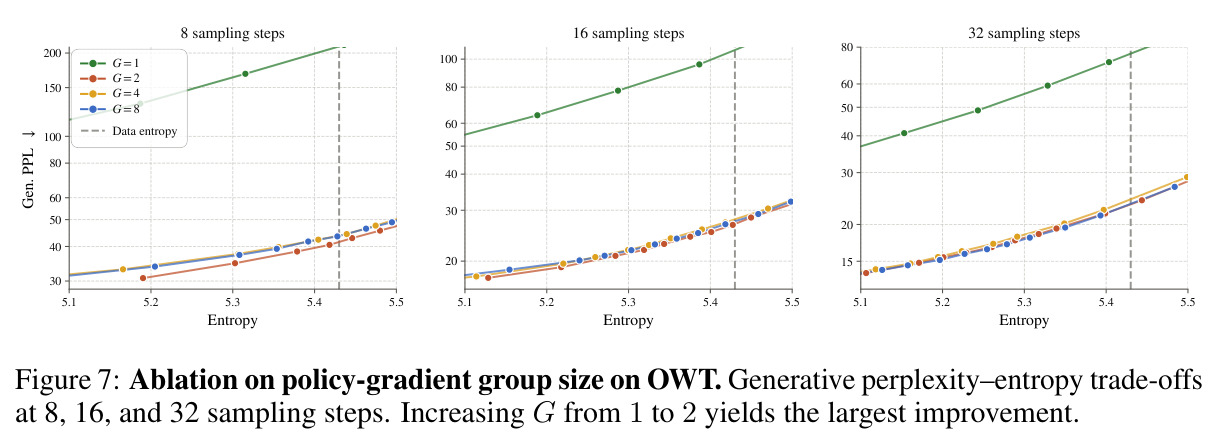
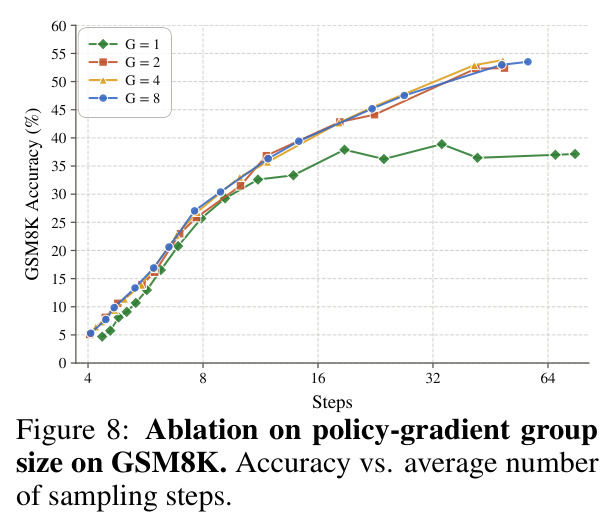
离散 DLM 的 MMD 奖励无法直接反传,必须经策略梯度优化;组大小 $G$ 与 leave-one-out 基线的设计直接决定训练是否可行(论文默认 $G=4$,且发现 $G$ 从 1 到 2 的提升最大)。
Self-conditioning(自条件)
去噪网络把上一轮对干净输出的预测 $\hat{x}$ 作为额外输入,与噪声 $z$、时间 $t$ 一起送入网络,即 $G_\theta(z,\,t,\,\mathrm{SC}{=}\hat{x})$;没有可用估计时输入 0。推理时反复把当前预测喂回网络,就能用同一个网络实现多步迭代精化采样。
连续版 ELF-MMD 的一步生成器正是靠自条件迭代精化扩展为多步采样($K$ 步精化加 1 次解码);训练中的 bootstrap 阶段也是为了让模型提前见过这些自条件输入,缓解训练-推理错配。
RBF 核与核均值嵌入
高斯 RBF 核 $k(a,b)=\exp(-\|a-b\|_2^2/2\sigma^2)$ 是特征核:MMD 为零可推出分布相同,带宽 $\sigma$ 决定比较尺度。把序列各位置的 token 特征视为样本集,序列间相似度取所有位置对核值的平均 $\kappa_\phi$,即经验核均值嵌入的内积。
本文采用 token 级 RBF 核而非只匹配均值的线性核,消融实验证明这是效果最好的关键设计;带宽 $\sigma$ 也是必须逐个设定调节的核心超参(跨实验从 10 到 3330 不等)。
生成困惑度与熵的权衡
生成困惑度(Gen PPL)用冻结的预训练模型(如 GPT-2 Large)给生成文本打分,越低越流畅;unigram 熵衡量采样多样性。只压 PPL 会导致重复坍缩(熵骤降),故论文以数据熵 $H\approx 5.43$ 为参照,在匹配熵下比较 PPL。
OpenWebText 无条件生成实验的主指标就是 PPL-熵权衡曲线;不理解这个权衡就会误读 Figure 2 与 Table 2/3 中的灰色标记(熵偏离数据熵的基线)以及「更低 PPL」结论的适用范围。
研究动机
扩散语言模型(DLM)的常规训练目标是逐 token 的:离散模型用交叉熵拟合条件 token 边际分布,连续模型用平方误差估计干净潜变量的条件均值。这些条件估计虽能指导迭代采样,但在极少采样步数(few-step)下并不能保证样本质量——并行几步解码出的文本往往明显退化。已有加速手段分两类:一是蒸馏,让学生网络复现教师的多步去噪(如 SDTT、ELF-PD、CDLM),依赖教师生成的轨迹目标;二是分布匹配,需要联合训练辅助模型来提供分布级梯度——DiDi-Instruct 训练密度比判别器并用策略梯度更新,IDLM 与 D-MMD 训练辅助去噪器并对其软 token 预测求导。这两类方法都带来额外开销:要么需要完整采样轨迹,要么要训练并存储额外的网络,增加训练复杂度、显存占用与不稳定性;在 16B 规模上重训判别器或辅助去噪器的代价尤其高昂。而直接从「生成样本对比真实样本」计算的分布差异信号,此前在语言上只有线性核、单向量特征匹配(如 EBFT)这类弱形式。
本文的目标是本文的目标是:不依赖教师采样轨迹、不联合训练任何辅助模型,仅凭一个冻结的预训练 DLM 自身提取的特征,构造可以直接从生成样本与参考样本计算的分布匹配训练信号,用于后训练离散与连续两类扩散语言模型。具体要达成三件事:其一,让离散 DLM(掩码扩散 MDLM、混合掩码-均匀扩散 DMax)在少量采样步数下生成更流畅的文本,并在 16B 规模上提升解码并行度(每步生成 token 数 TPF)而不损失精度;其二,让连续 DLM(ELF)的一步/少步生成在生成困惑度与 GSM8K 数学准确率上超过渐进蒸馏与流映射等强基线;其三,方法本身必须计算高效——一次前向传播即可得到足够统计量,后训练只需数百到数千步、几个 GPU 小时以内。
与已有工作不同的是,本文的独特切入在于「比较空间」与「观测粒度」的选择。MMD 早在 2015 年就被用于训练隐式生成器,视觉领域也已有 SwD 等在预训练扩散特征上做 patch 级 MMD 蒸馏的成功先例,但在语言上,此前要么匹配池化后的单一序列向量(EBFT 的线性核本质上是均值匹配),要么在原始 token 空间做离散 MMD(D-MMD)。作者的关键观察是:冻结的预训练 DLM 的中间层上下文 token 特征是理想的比较空间——它天然描述每个 token 在上下文中的语义,一次前向就能得到 $L$ 个特征观测,且无需外部训练特征器;token 级 RBF 核保留位置间相互作用,具备特征核的分布识别能力。再配合对序列内特征相关性的无偏处理(剔除同序列对)与吸引-排斥项的平衡,这构成了首个统一服务离散(策略梯度)与连续(可微潜变量)两条路线、并验证到 16B 规模的表示空间 MMD 后训练方案。
核心方法
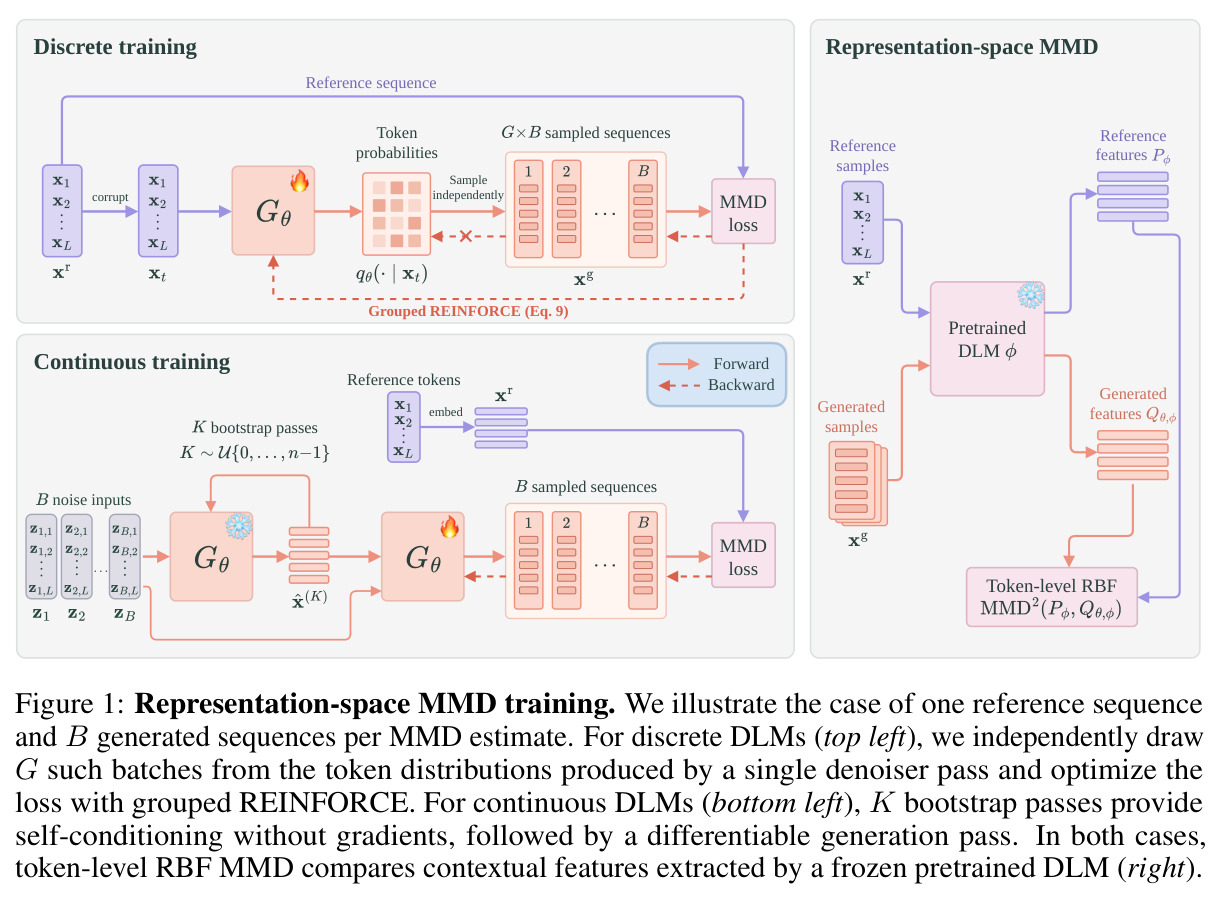
直觉:让模型生成的文本「在预训练 DLM 眼里看起来像真文本」。做法上,用冻结预训练 DLM 提取参考与生成序列在计分位置集合 $S$ 上的中间层上下文特征 $\phi(x)$,以 token 级 RBF 核定义序列核 $\kappa_\phi$(所有位置对核值平均),按标准 MMD 组合成损失 $\mathcal{L}_{\mathrm{MMD}}(\theta)=\mathbb{E}_c\,\mathrm{MMD}^2_k(P_\phi(\cdot\mid c),\,Q_{\theta,\phi}(\cdot\mid c))$。离散实现(MDLM-MMD、DMax-MMD)从单次去噪前向的 token 分布独立抽 $B$ 条序列,用分组 REINFORCE($G$ 组、leave-one-out 基线)优化负 MMD 奖励。连续实现(ELF-MMD)从 ELF 初始化一步潜生成器,MMD 梯度直接穿过冻结提取器与生成的潜变量反传。推理时用自条件迭代精化把一步生成扩展为 $K+1$ 次网络评估,并可用 IRD(迭代精化蒸馏)把多步轨迹蒸馏回单步。
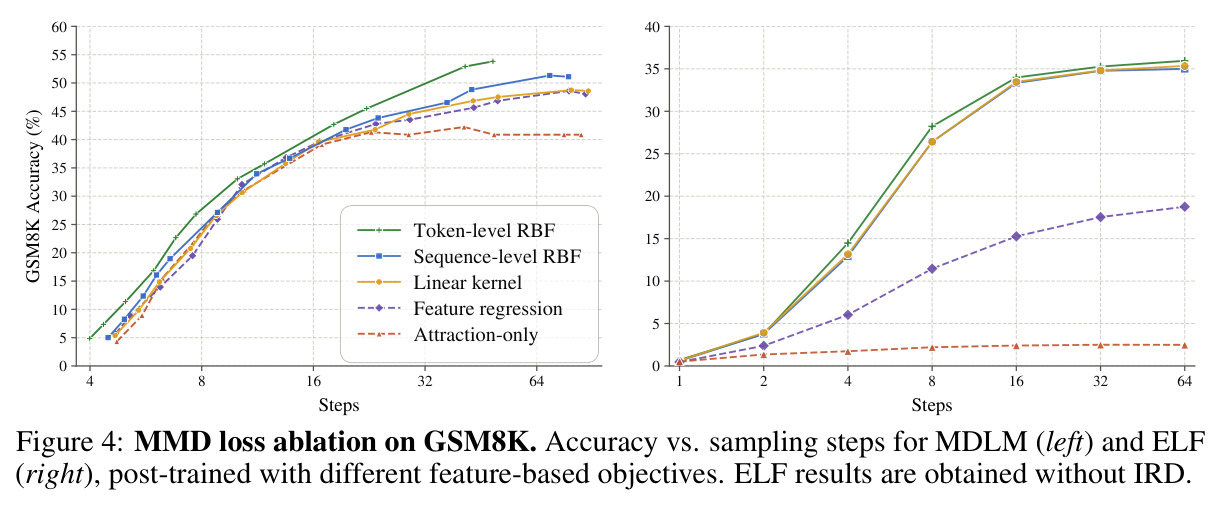
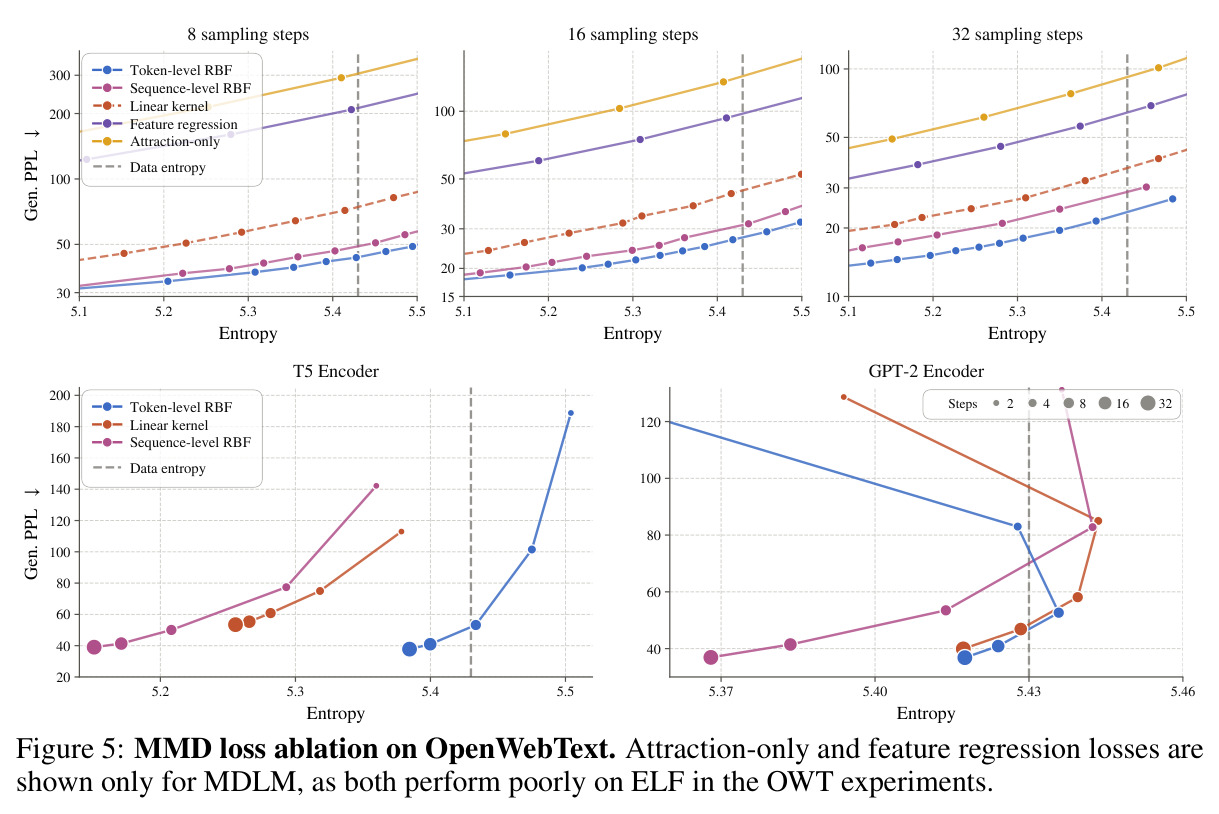
核心创新有三点。其一,「token 即样本」:不做序列池化,而是保留每个计分位置的上下文特征,一条序列一次前向就贡献 $|S|$ 个 MMD 观测;又因为优化中不需要估计真实-真实项(它与 $\theta$ 无关),条件生成时仅需一条参考序列即可估计条件 MMD。其二,序列核的构造与无偏估计:$\kappa_\phi$ 是经验核均值嵌入的内积,为序列级正定核;估计 MMD 时排除同序列对(求和中 $b\neq b'$),避免序列内特征相关性引入偏差——$B$ 条序列贡献 $B|S|$ 个特征观测但只按 $B$ 个独立抽取处理。其三,吸引-排斥平衡:真实-生成交叉项吸引生成特征靠近参考分布,生成-生成项惩罚生成样本彼此过于相似、防止模式坍缩;消融显示去掉排斥项(attraction-only)会让连续模型迅速崩溃,线性核均值匹配也明显更差。与已有方法的本质区别在于:不需要教师轨迹(对比各类蒸馏),不需要联合训练判别器或辅助去噪器(对比 DiDi-Instruct、IDLM、D-MMD),训练信号直接从冻结特征一步算出。
方法步骤详情
流程分四步。① 特征提取:选冻结 DLM 的单个中间层(逐模型选层,如第 4–10 层),对干净输入提特征;计分位置视任务取全部、回应或被掩码位置。② 损失估计:对每个条件取 1 条参考 $x_r$ 与 $B\geq 2$ 条独立生成序列,计算 $\hat{\mathcal{L}}_{train}=\frac{1}{B(B-1)}\sum_{b\neq b'}\kappa_\phi(x_g^b,x_g^{b'})-\frac{2}{B^2}\sum_b\kappa_\phi(x_r,x_g^b)$,期望为条件 MMD 平方加常数。③ 优化:离散情形以奖励 $r_g=-\hat{\mathcal{L}}_{train}$ 配合批内 $\sum\log q_\theta$ 做分组策略梯度(默认 $G=4$);MDLM-MMD 只计掩码位置,DMax-MMD 对掩码与自身预测两路损失都加 MMD。连续情形一步生成 $x_g=G_\theta(z,t{=}0,\mathrm{SC}{=}0)$,特征取 $\phi_{\mathrm{ELF}}(x,t{=}1,\mathrm{SC}{=}x)$ 直接反传,用无梯度 bootstrap 缓解训练-推理错配。④ 推理:自条件迭代精化 $K$ 步加一次解码共 $K+1$ 次评估;可选 IRD 以 MSE 蒸馏教师 $K$ 步轨迹。
技术新颖性
技术新颖性可从四个维度评估。(1)目标函数层面:把视觉领域 patch 级 MMD 蒸馏(SwD)的思想系统移植到语言扩散模型,并用「token 特征的分布」而非「序列单向量」定义分布,使 RBF 特征核的识别性(MMD 为零当且仅当分布相同)真正发挥作用;与 EBFT 的关系被明确指出——其未白化目标等价于条件线性核 MMD(只匹配一阶矩),而 token 级 RBF 严格更丰富,消融中全面占优。(2)估计层面:给出了序列内特征相关条件下的无偏 MMD 估计(剔除同序列对),并论证序列核 $\kappa_\phi$ 的正定性,这是把 token 级特征正确用于 MMD 的关键理论细节。(3)优化层面:为离散采样设计了「单次去噪前向加分组 REINFORCE 加 LOO 基线」的低成本方案,奖励评估不需要完整采样轨迹,也不需要辅助网络。(4)规模层面:首次在 16B 混合扩散模型(DMax-LLaDA2.0)上验证 MMD 后训练——仅 400 步、约 2 GPU 小时就改善了精度-并行度权衡,展示了极低的后训练成本与即插即用特性。
实验结果
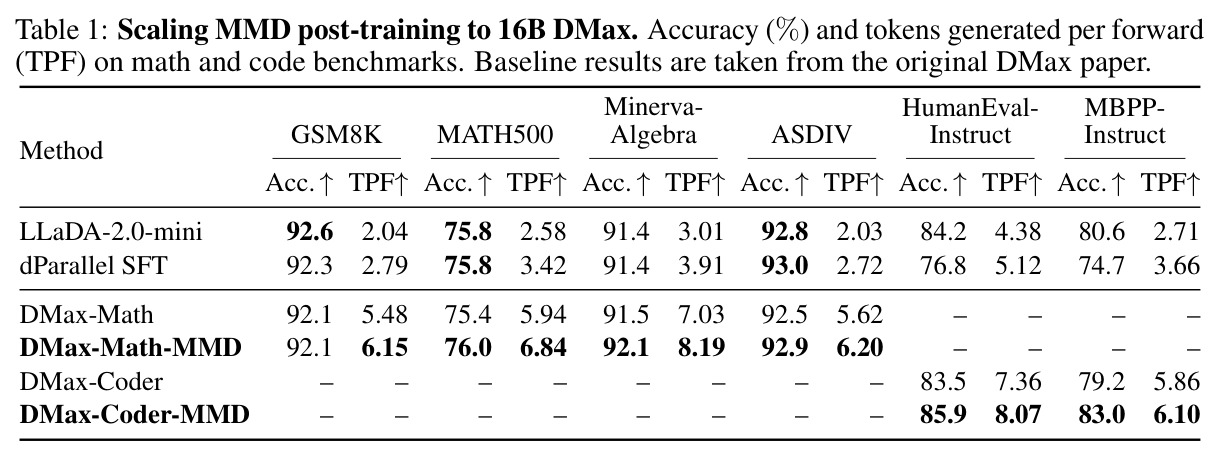
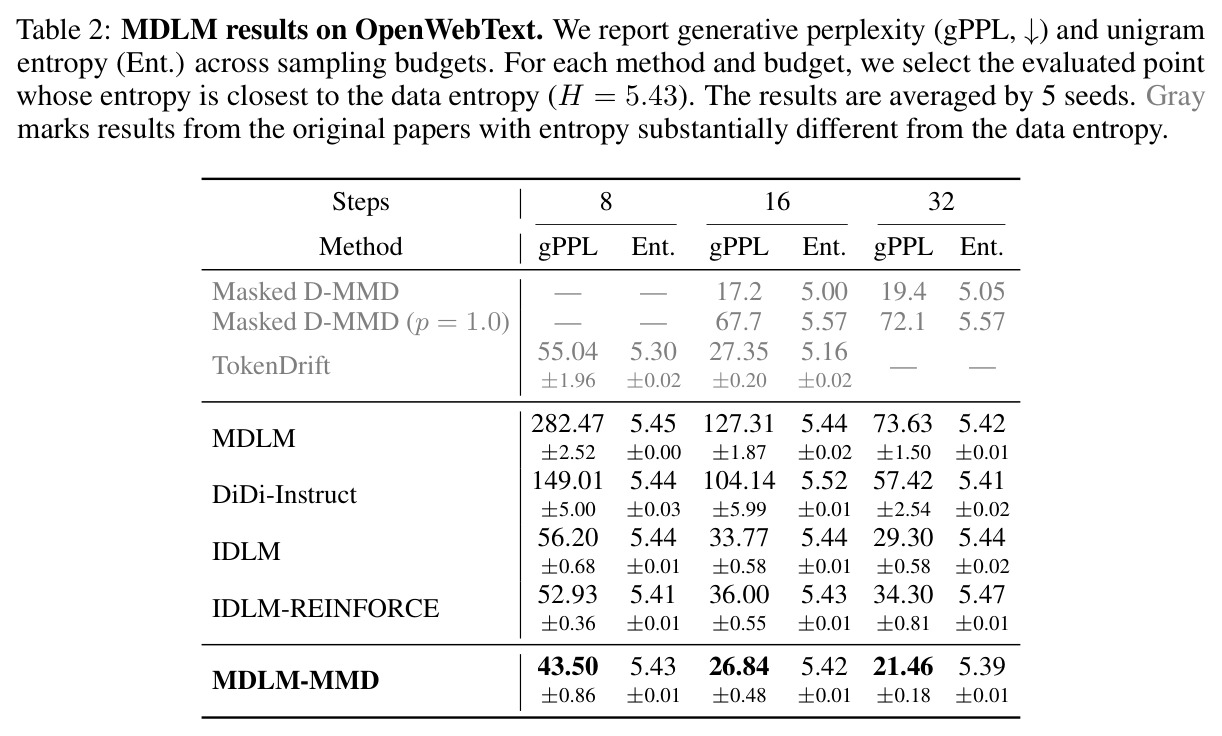
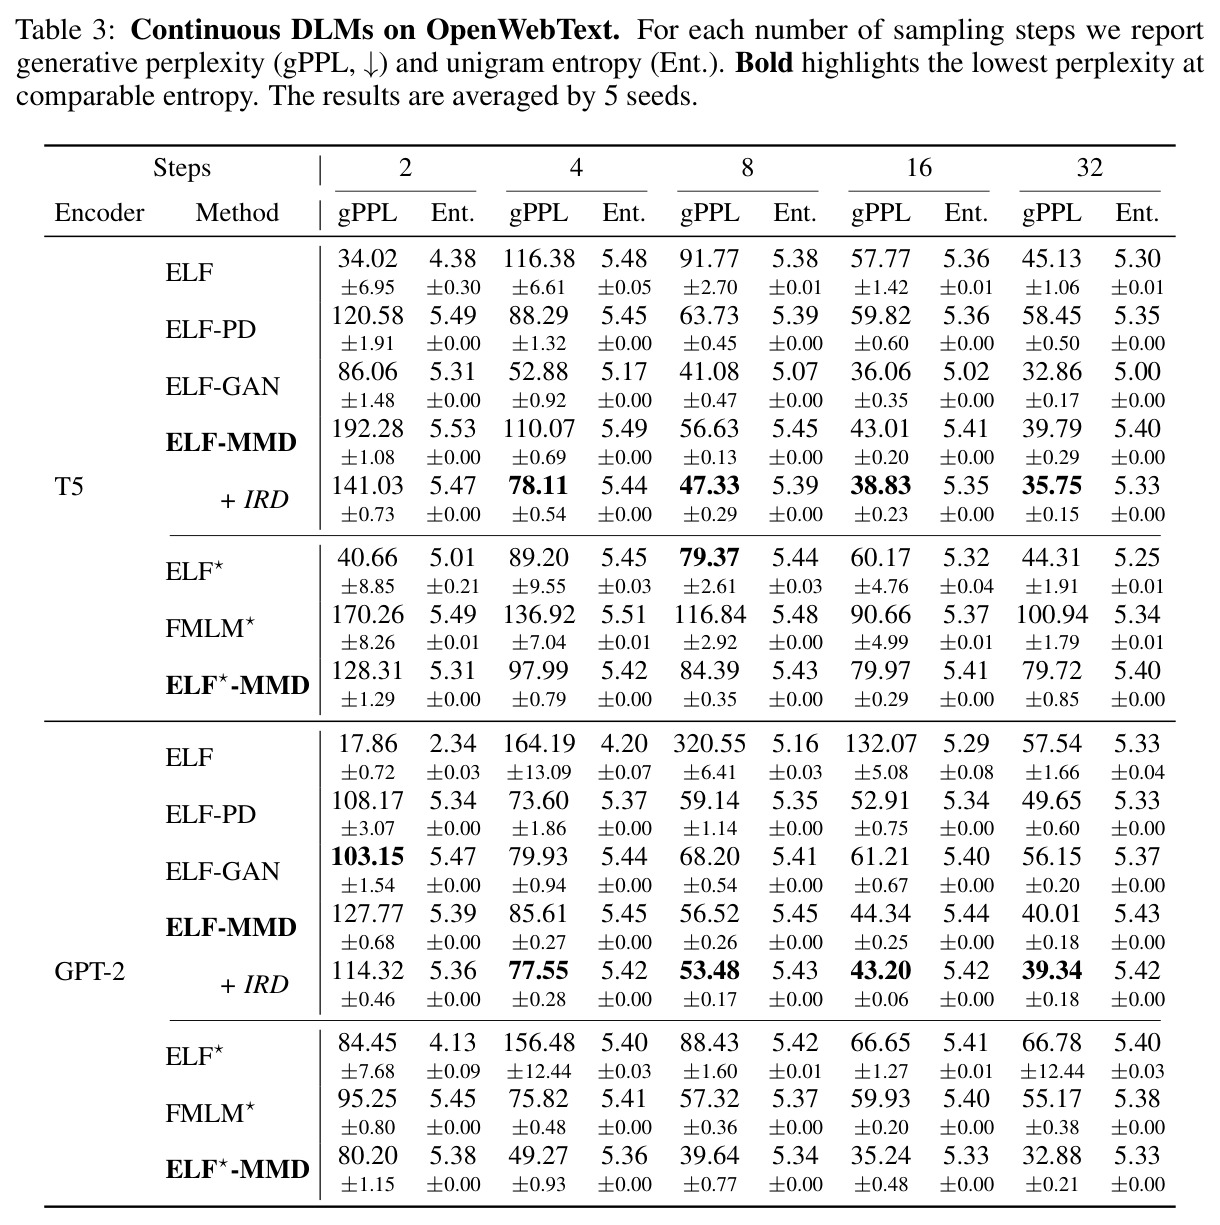
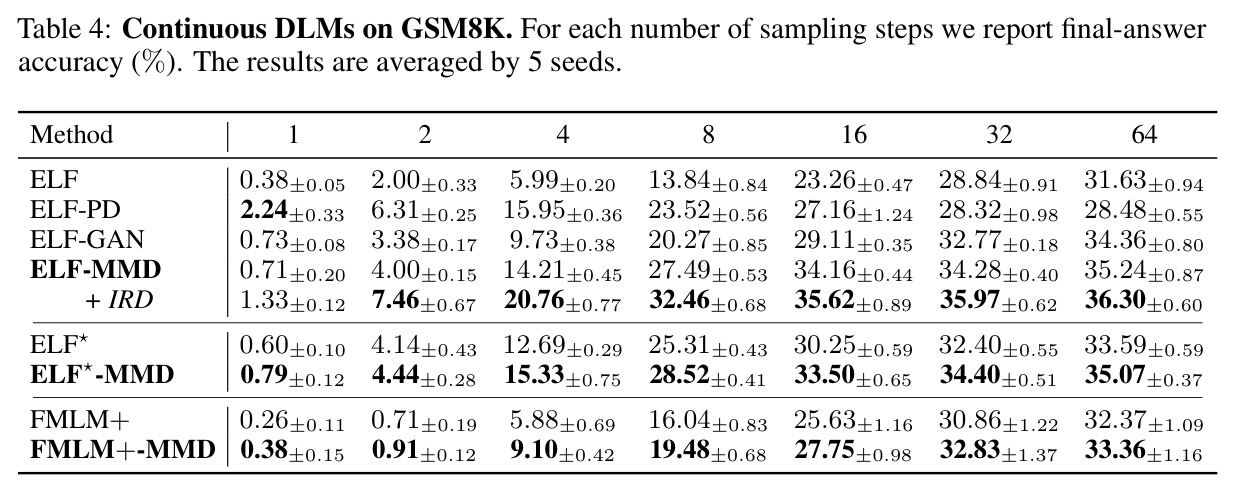
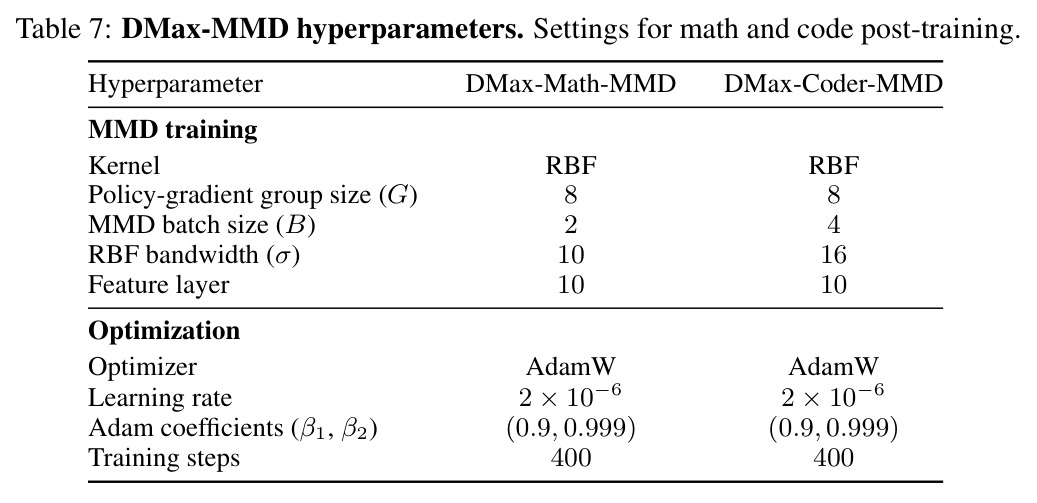
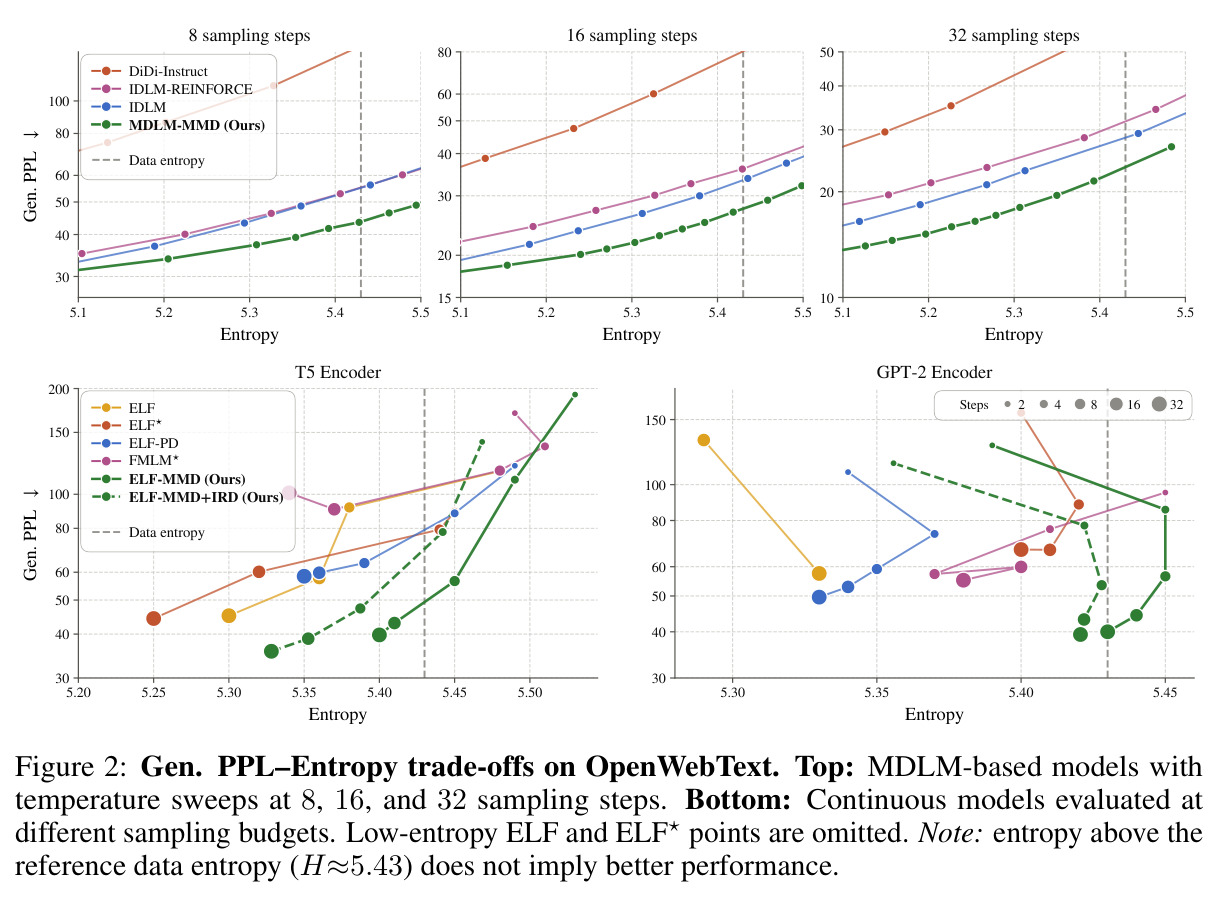
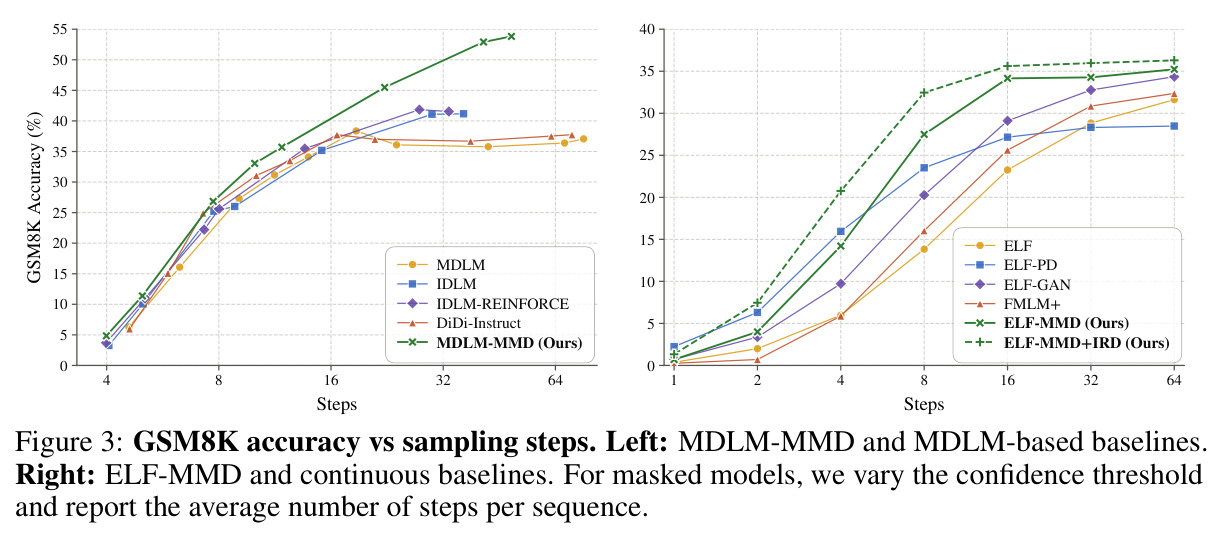
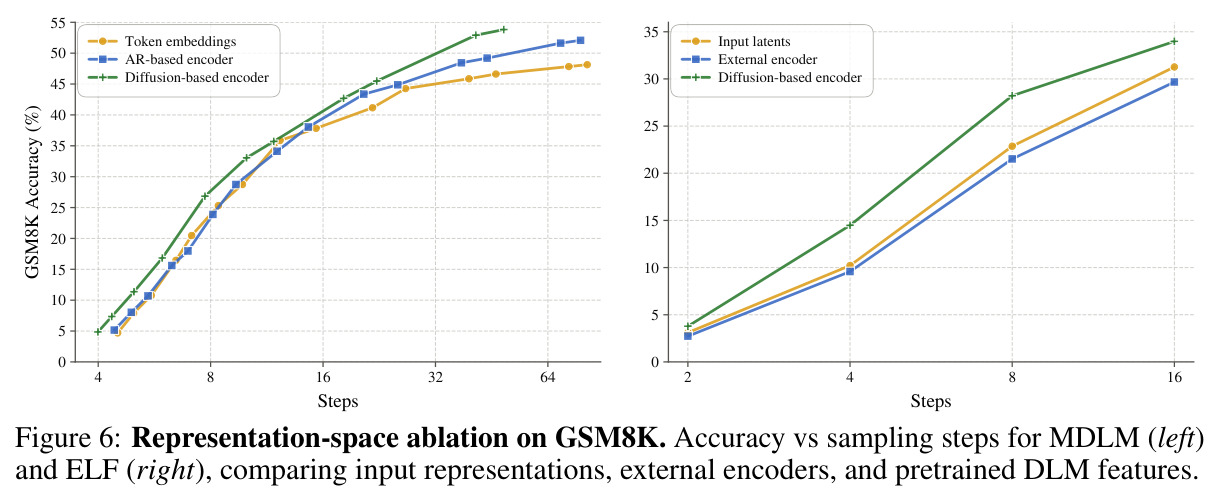
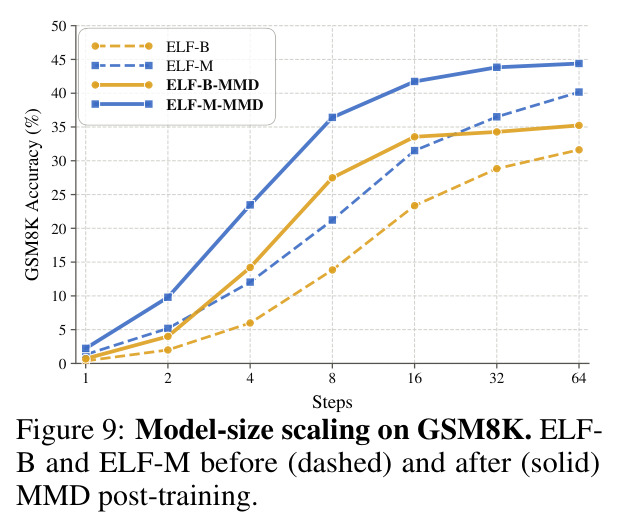
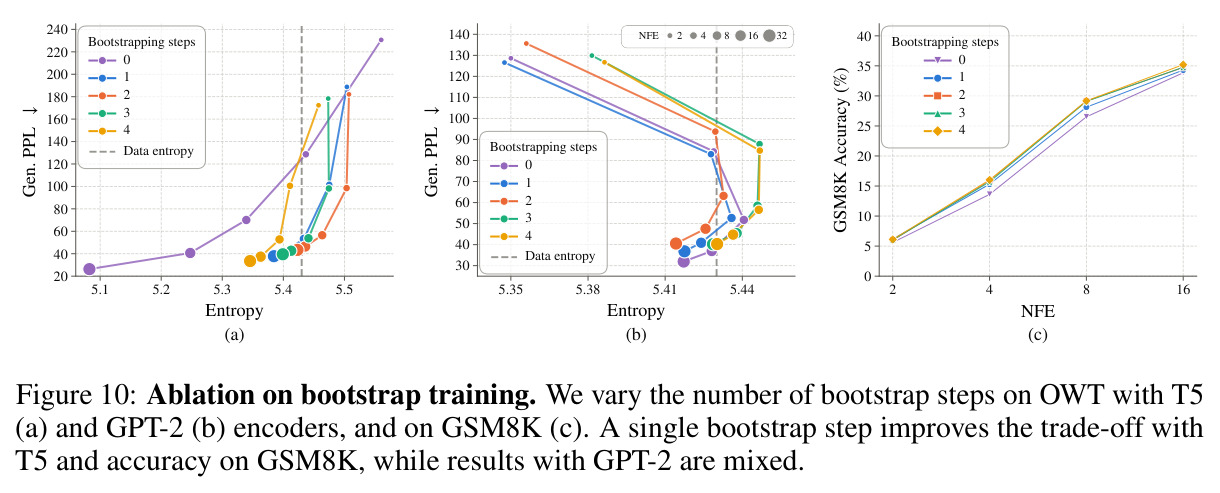
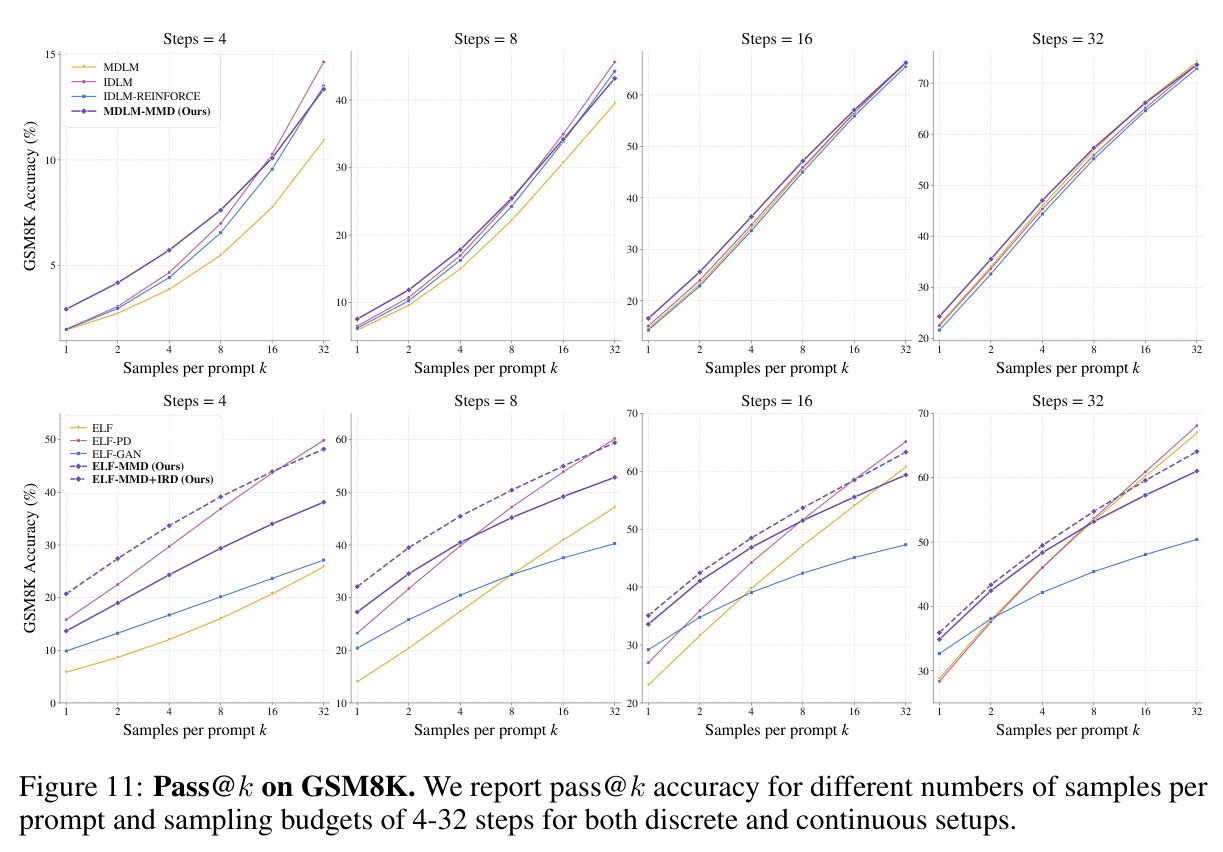
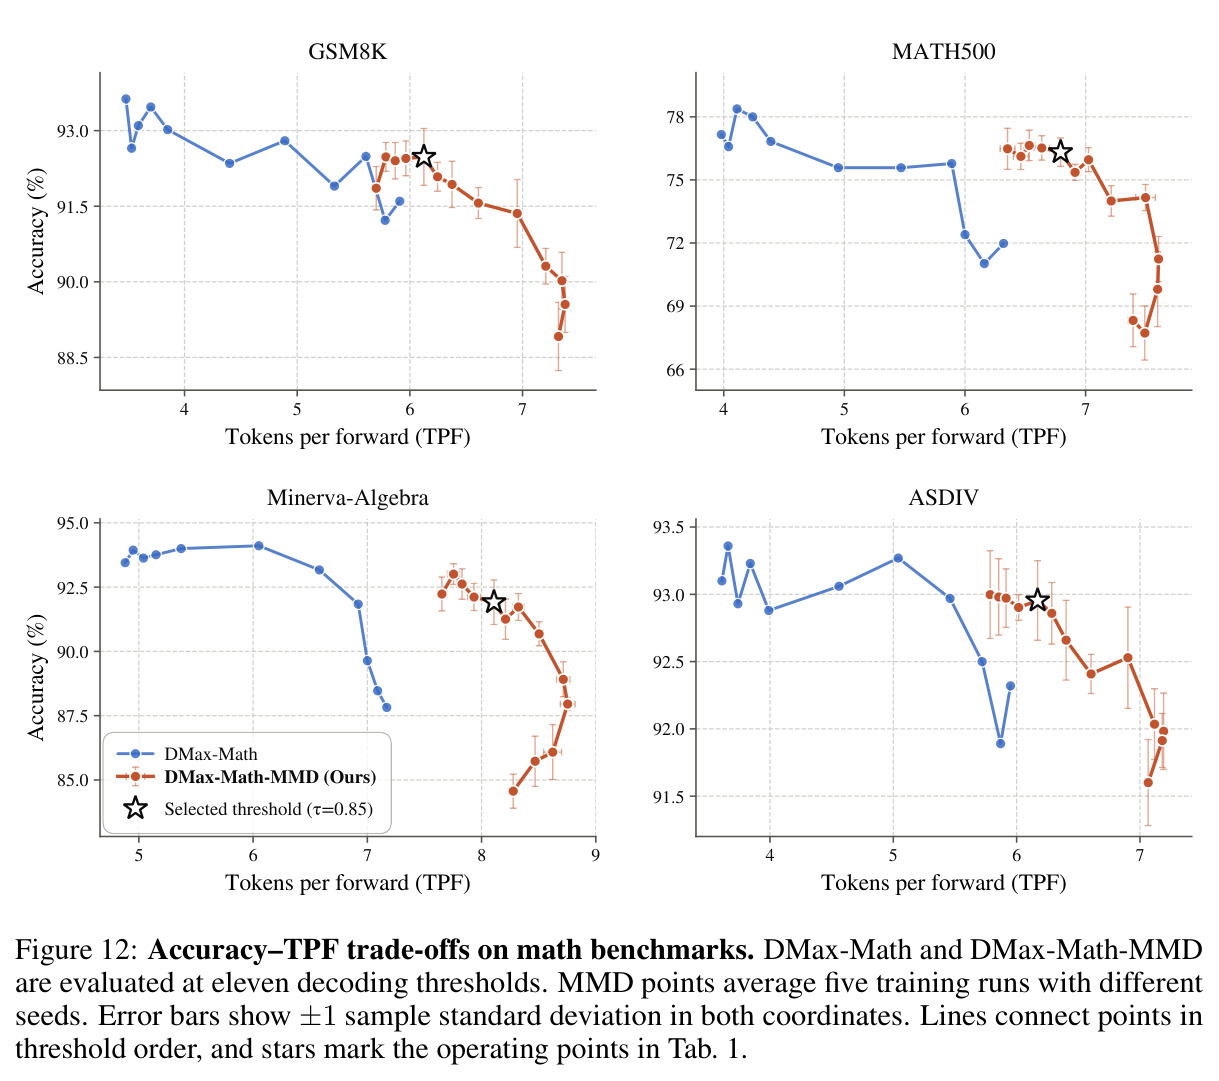
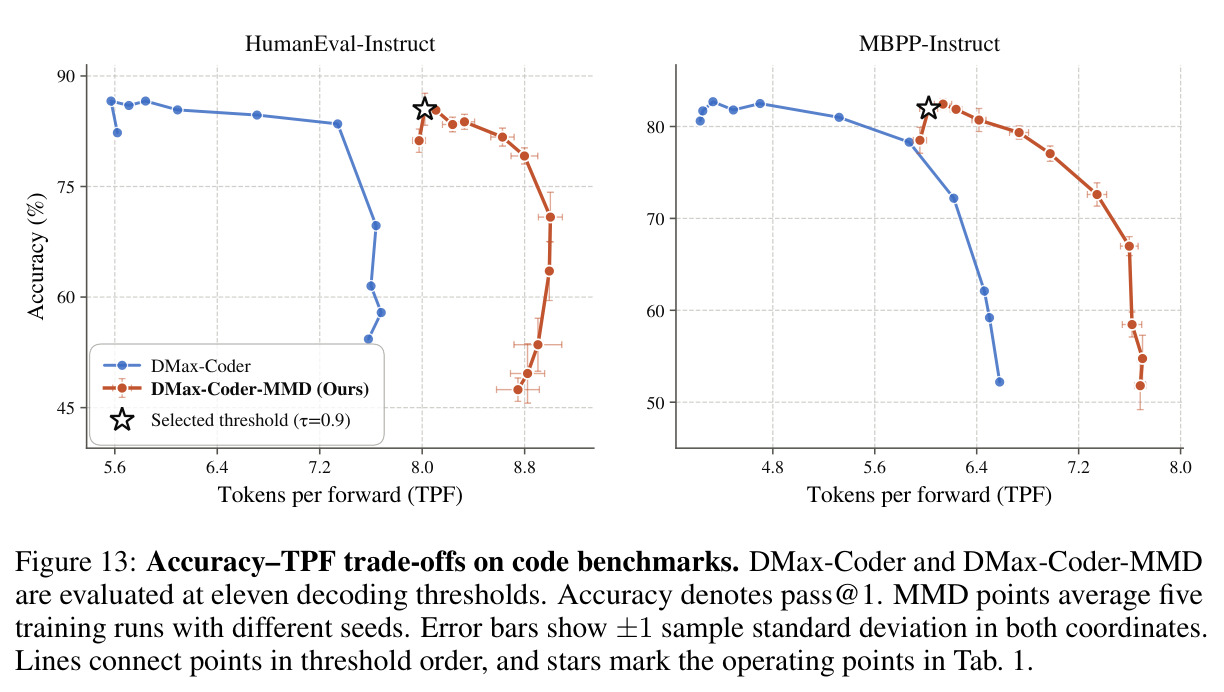
(1)OWT 无条件生成(离散):MDLM-MMD 在 8/16/32 步、匹配数据熵 $H\approx 5.43$ 下 gPPL 全面最低,比 IDLM 低约 17–21%(如 8 步 43.50 对 56.20,32 步 21.46 对 29.30;MDLM 本身为 282.47)。(2)OWT(连续):ELF-MMD 多数预算优于 ELF 与 ELF-PD,加 IRD 后 4 步 gPPL 再降约 30/10 点(T5 110.07 降至 78.11);ELF⋆-MMD(GPT-2)8 步 39.64 为同族最佳。(3)GSM8K:离散 MDLM-MMD 在中高预算占优,约 49 步达约 54%;连续 ELF-MMD+IRD 4/8 步从 14.2%/27.5% 升至 20.8%/32.5%(ELF-PD 仅 15.9%/23.5%),64 步 36.3%(ELF 31.6%);ELF⋆-MMD、FMLM+-MMD 亦全面超各自基线。(4)16B DMax:仅 400 步(8×H100 约 1.7–2.5 GPU 小时),数学四基准 TPF 提升 10.3–16.5% 且精度持平或略升(如 GSM8K TPF 5.48 升至 6.15),代码 HumanEval-Instruct 83.5 升至 85.9(+2.4pp)、MBPP-Instruct 79.2 升至 83.0(+3.8pp)且 TPF 同升。消融:token 级 RBF 最优、DLM 自身特征优于外部编码器、$G$ 从 1 到 2 提升最大。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OWT 无条件生成(离散 MDLM,8 步) | 生成困惑度 gPPL(匹配熵约 5.43,越低越好) | 43.50 | IDLM 56.20 / IDLM-REINFORCE 52.93 | 比 IDLM 降低约 22.6% |
| OWT 无条件生成(离散 MDLM,32 步) | 生成困惑度 gPPL(越低越好) | 21.46 | IDLM 29.30 | 降低约 26.8%(三个预算下平均约 17–21%) |
| GSM8K(连续 ELF-B,64 步) | 最终答案准确率(%) | 36.3(ELF-MMD+IRD) | ELF 31.6 / ELF-PD 28.5 | 比 ELF 高 4.7 个百分点 |
| GSM8K(连续 ELF-B,8 步) | 最终答案准确率(%) | 32.5(ELF-MMD+IRD) | ELF-PD 23.5 / ELF 13.8 | 比 ELF-PD 高 9.0 个百分点 |
| GSM8K(16B DMax-Math) | 准确率(%)/ TPF(每前向生成 token 数) | 92.1 / 6.15 | DMax-Math 92.1 / 5.48 | 精度持平,TPF 提升 12.2% |
| HumanEval-Instruct(16B DMax-Coder) | pass@1(%)/ TPF | 85.9 / 8.07 | DMax-Coder 83.5 / 7.36 | 准确率 +2.4pp,TPF +9.6% |
| MBPP-Instruct(16B DMax-Coder) | pass@1(%)/ TPF | 83.0 / 6.10 | DMax-Coder 79.2 / 5.86 | 准确率 +3.8pp,TPF +4.1% |
局限与改进
作者承认:性能依赖 RBF 带宽与表示空间选择($\sigma$ 跨实验从 10 到 3330),表示设计留作未来方向;且只用单层、干净输入特征。特征核的分布识别性依赖特征映射单射,作者引用 causal transformer 的单射性结果但声明不能保证匹配 token 特征分布即唯一确定序列分布。我的补充:(1)离散路线依赖 REINFORCE,方差未根除,需 $G\geq 2$ 分组采样;(2)与最强离散基线对比有灰色地带——Masked D-MMD 在 16/32 步的 gPPL(17.2/19.4)其实低于 MDLM-MMD(26.84/21.46),只因熵(5.00/5.05)偏离数据熵 5.43 被标灰,在允许牺牲多样性时本文并非全面最优;(3)gPPL 与 unigram 熵是间接指标,与真实可用性不完全相关;(4)小模型 GSM8K 绝对准确率仅约 36%,TinyGSM 为合成算术数据,更难数学的泛化未验证;(5)连续模型在 $B=1$ 或无排斥项时崩溃,目标对超参敏感;(6)DMax 的解码阈值 0.85/0.9 是挑选后的操作点,五种子平均与单点报告略有出入。
独立分析的弱点
独立分析以下弱点。其一,超参敏感且无自动选择机制:带宽 $\sigma$ 从 10 到 3330、特征层从 4 到 10 都需逐设定手调,可引入中值启发式、可学习带宽或多尺度核。其二,离散奖励方差瓶颈:$G$ 从 1 到 2 收益最大但再往上无益,方差未根除;可探索 Gumbel-softmax/直通估计、软 token 可微 MMD 或更强控制变量。其三,特征空间单一:仅单层干净特征,跨层组合、多噪声级或提取器集成可能提供互补信号。其四,token 可交换性:序列核把所有位置对平均,弱化位置与篇章结构,长文本全局一致性欠约束,可用位置加权核或块级结构核。其五,评测范围有限:除 16B 外主要是亿级小模型与合成数学数据,未测指令遵循、开放域生成及 LLaDA 全尺寸等更大掩码模型。其六,与 D-MMD、TokenDrift 的对比只能引用原文数字(无开源实现)且熵设定不匹配。其七,IRD 需额外教师轨迹与蒸馏阶段,可研究把轨迹监督并入 MMD 主训练。
未来方向
作者提出的方向:一是表示设计——组合跨层/跨噪声级特征、使用提取器集成,以获得更丰富的比较空间;二是把 MMD 与其他训练目标组合用于离散 DLM,连续设定中 IRD 带来的增益暗示混合目标有价值;三是把目标推广到不使用自条件的连续 DLM 变体,改用一致性采样等多步方案。基于本文成果还可延伸:(1)把 token 级 RBF-MMD 推广到自回归 LLM 的微调,与 EBFT 统一成「线性核到特征核」的方法谱系并检验识别性带来的增益;(2)在 LLaDA-8B、DiffusionGemma 等更大掩码模型上做同款「400 步级」轻量后训练,作为发布前的 last-mile 优化手段;(3)理论侧建立「上下文 token 特征加特征核」下序列分布可识别的充分条件,刻画哪一层、哪种核最接近单射;(4)把 MMD 奖励与 RLHF/偏好优化结合——它天然无需训练奖励模型;(5)自适应带宽与多尺度核以消除逐设定调参;(6)回到 Diffusion-LM 的原始动机,在受控生成(情感、长度、句法约束)任务上验证 MMD 约束的分布匹配能力。
复现评估
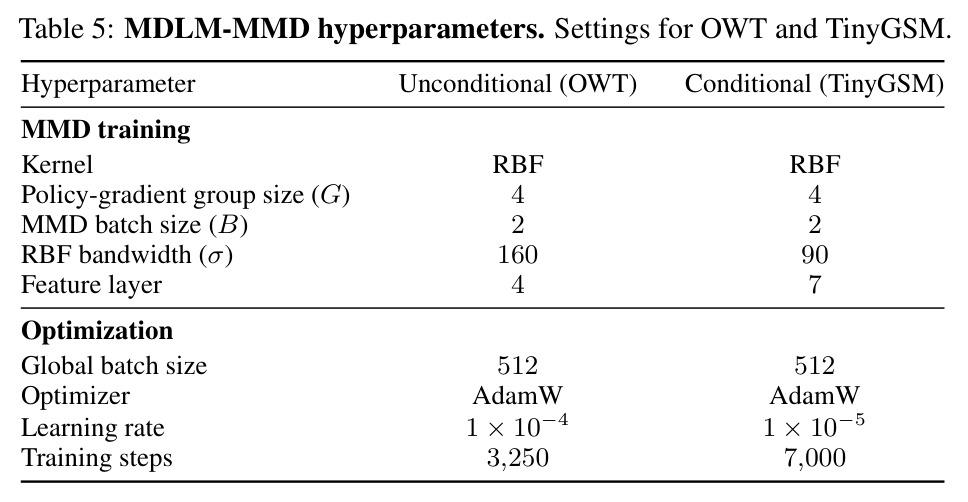
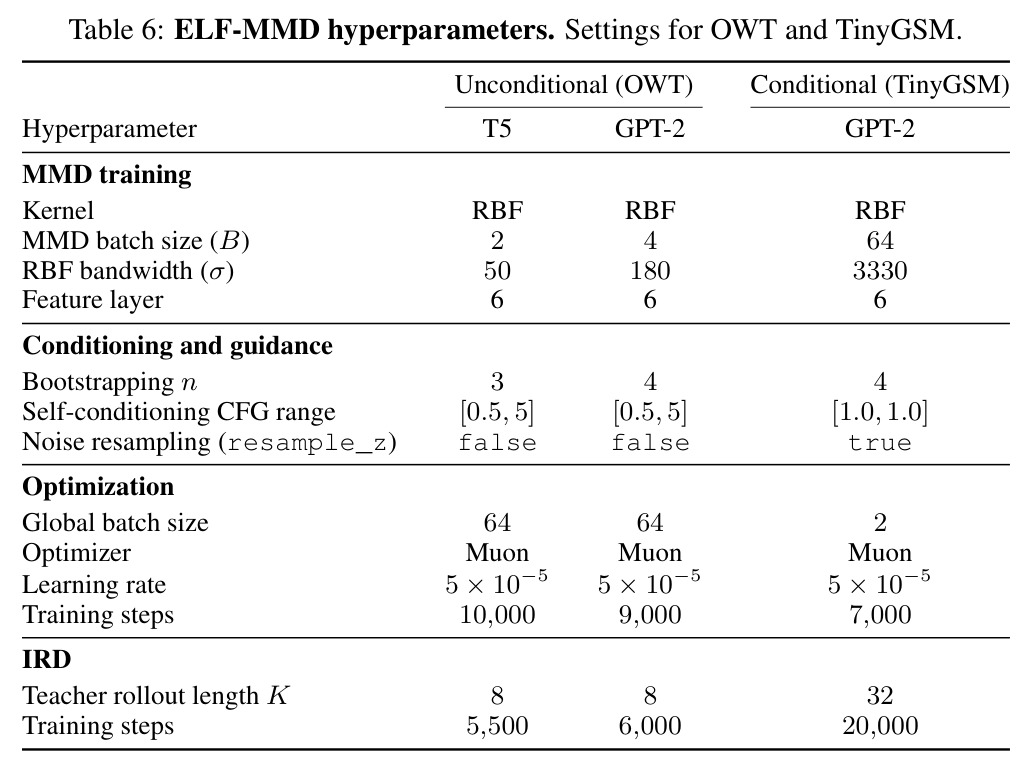
复现条件较好。代码已开源(yandex-research/dlm-mmd);起点均为公开检查点与数据:MDLM、ELF/ELF⋆、16B DMax-Math/Coder 及其训练数据,OWT/TinyGSM/GSM8K 均公开。算力:MDLM-MMD 训练 3250 步(OWT,全局 batch 512,AdamW 1e-4)或 7000 步(TinyGSM);ELF-MMD 约 9000–10000 步(Muon 5e-5);最贵的 16B DMax 后训练仅 400 步,8×H100 上约 13–19 分钟(1.7–2.5 GPU 小时),门槛集中在 16B 评测(dInfer 加 Soft Parallel Decoding)。论文附完整超参表(Tables 5–7,含带宽、特征层、$G$、$B$)与三段伪代码(Algorithm 1–3),主表为 5 种子平均附标准差。注意 D-MMD、TokenDrift 无开源实现只能引用原文,DiDi-Instruct 的 TinyGSM 版需自行改造代码。总体难度中等:小模型部分单机多卡可复现,16B 需 H100 级集群。
论文图表