ViRDM:面向少步因果视频生成的表示分布匹配后训练方法 ViRDM: Taming Representation Distribution Matching for Few-Step Causal Video Generation
用免教师免评论家的表示分布匹配,把少步因果视频后训练成本从176 GPU时降到16
前置知识
少步视频扩散蒸馏
把需要数十步迭代去噪的预训练视频扩散模型压缩成 1~4 步即可出片的生成器。主流做法是后训练(post-training):让学生生成器在极少量去噪步内逼近教师模型的输出分布,同时保留因果/流式推理接口,以支撑低延迟实时视频应用。
本文正是这一范式的产物,理解其动机(降步数、保质量、可流式)才能明白 ViRDM 要替代的现有流程及其价值。
DMD(分布匹配蒸馏)
主流后训练目标:把学生生成的样本重新加噪到随机噪声级,用冻结教师分布分数与在线评论家分布分数之差近似'学生分布 vs 目标分布'的梯度。终端分布差异不直接评估,而是经噪声条件化的分数间接推断。代价是训练时教师、评论家、生成器三网络共存,显存与算力开销巨大。
ViRDM 的全部卖点都相对 DMD 基线衡量(峰值显存 77.1→48.3 GB、训练 176→16 GPU 时),必须理解 DMD 才知道它到底省掉了什么。
MMD 与 RDM
最大均值差异(MMD)用核函数比较两组样本在再生核希尔伯特空间中的均值嵌入距离;表示分布匹配(RDM)把 MMD 施加在冻结视觉编码器的特征上,让生成样本的表示分布贴近离线编码好的参考分布,不需要任何扩散分数教师或在线评论家即可产生训练信号。
这是 ViRDM 的目标函数本体(论文公式 3),全文的显存工程和配方研究都围绕让这个目标在多步视频展开上可行。
自回归因果视频生成
把视频按帧块(chunk)分解,按时间顺序逐块生成,已完成的内容经 KV 缓存条件化未来块,天然支持流式输出。每个块内部仍做多步扩散去噪,这个多步采样正是实时性的瓶颈,也是后训练蒸馏的对象。
ViRDM 的梯度路径分析、随机出口机制、KV 缓存与随机性 trace 回放,全部建立在块状因果展开这一机制之上。
VJP(向量-雅可比积)
反向传播的基本算子:给定某模块输出上的梯度 $g$,VJP 计算 $J_f^\top g$ 而无需显式构造雅可比矩阵 $J_f$。对冻结模块(如 VAE 解码器、表征编码器),参数虽不更新,但为把梯度传回上游生成器,其激活反向图仍需驻留显存,构成主要开销。
ViRDM 的分阶段 VJP 方案让三个冻结/生成器模块的反向图错峰'算完即释放',是把显存从 OOM 降到 48.3 GB 的关键。
VBench 基准
视频生成的综合评测协议,输出 Total、Quality、Semantic 三大分数,并包含 Dynamic Degree、Temporal Flickering、Subject/Background Consistency 等十余个细粒度维度,是少步视频生成方向论文的标准对比口径。
本文的核心结论(Total 84.87、Dynamic Degree 72.02 等)都以 VBench 度量,理解分数构成(如 Dynamic Degree 隶属 Quality)才能正确解读实验。
研究动机
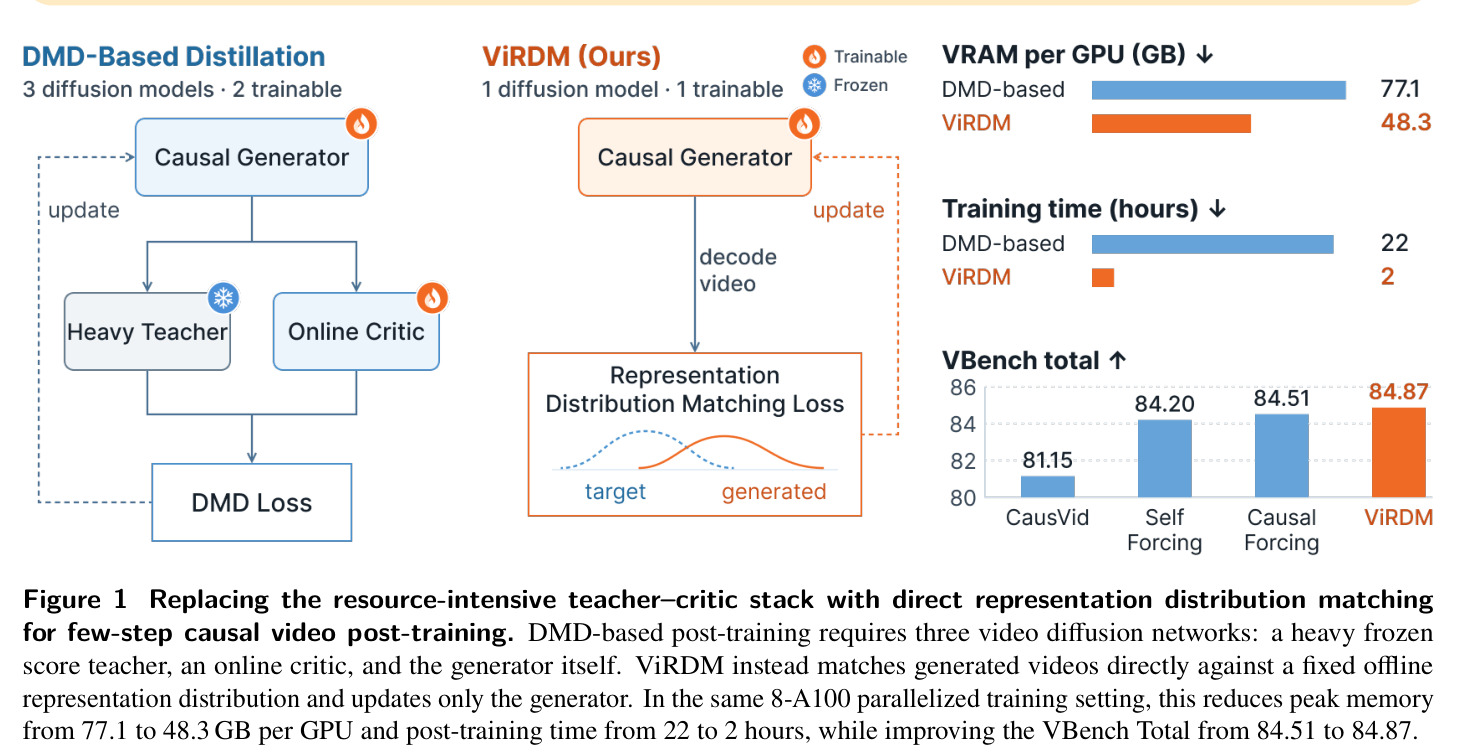
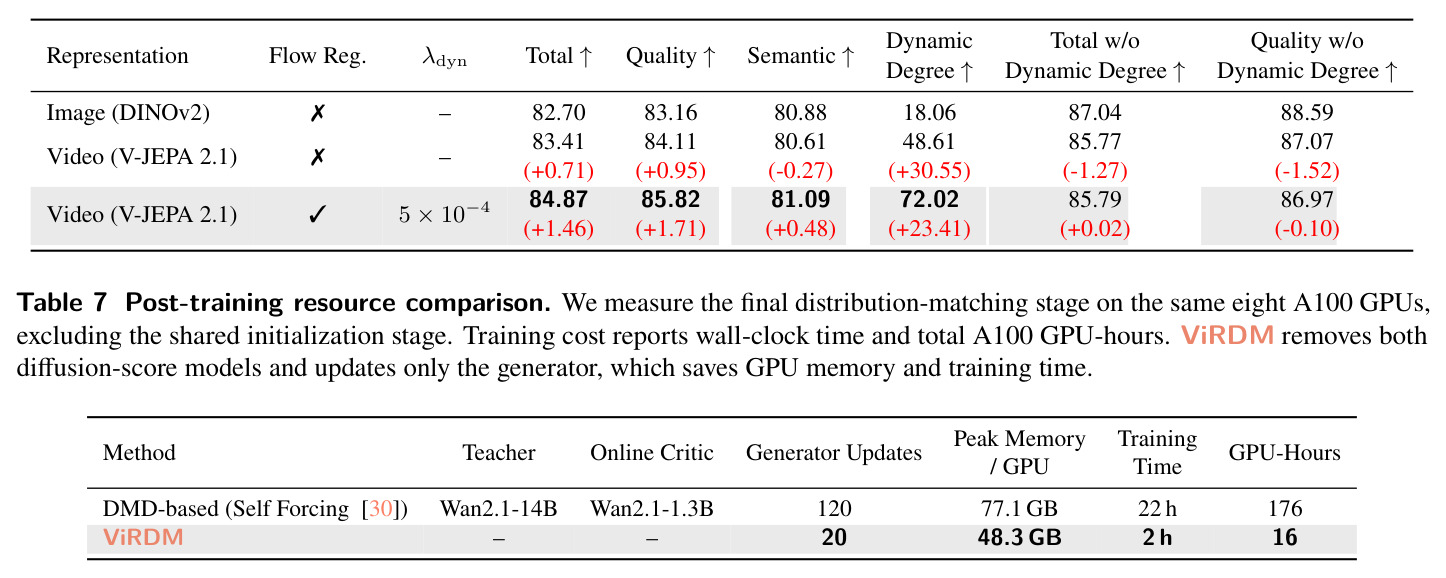
主流少步自回归(AR)视频扩散后训练都建立在分布匹配蒸馏(DMD)之上,以 Self Forcing 和 Causal Forcing 为代表。DMD 不直接评估终态分布差异,而是把生成视频重新加噪,再用教师分布分数与在线评论家分布分数之差间接估计,因此每次训练更新都要同时驻留三个视频扩散网络:例如蒸馏 Wan2.1 1.3B 生成器时,还需一个冻结的 14B 教师和一个在线 1.3B 评论家。这带来昂贵的计算与显存开销:Self Forcing 需要 120 次生成器更新、峰值显存 77.1 GB/GPU、22 小时(合计 176 A100 GPU 时)。另两个隐患同样致命:其一,图像领域的 RDM 配方要求 2048 条以上新鲜样本的大批量,直接搬到视频端到端反传会立即 OOM;其二,全局池化的表征分布主要捕捉外观与语义,对时间动态约束不足,蒸馏出的视频动态偏弱。
本文的目标是本文要回答的核心问题是:能否彻底砍掉'教师—评论家'双网络栈,只对生成器做后训练,使其直接匹配一个预先离线编码好的目标表示分布?为此需要把图像一步生成中的表示分布匹配(RDM)系统性迁移到少步因果视频生成,并依次攻克三个障碍:(1) 跨越多步 AR 展开、重型 Wan VAE 解码器与冻结表征编码器的端到端梯度路径显存不可行;(2) 图像 RDM 的优化配方(数千级新鲜样本、可直接从双向模型初始化)在视频上不成立;(3) 表征分布对时间动态的监督不足。最终目标是在官方 VBench 上超越此前最佳少步因果基线,同时把后训练成本从 176 GPU 时压缩到 16 GPU 时、峰值显存从 77.1 GB 降到 48.3 GB。
与已有工作不同的是,本文的独特切入在于换了评估分布差异的'坐标系':DMD 通过噪声条件化的扩散分数间接推断分布梯度,而 ViRDM 直接在冻结视觉编码器的特征空间中,用核均值嵌入(MMD)度量生成分布与固定离线参考分布的距离,训练信号只流回生成器,教师与评论家整体消失。与图像一步生成中的 RDM/FD loss 不同,这是首个把表示分布匹配系统迁移到'多步因果展开 + 流式生成'视频场景的工作:作者不止于套用,而是逐一诊断出显存、优化机制、动态约束三个视频特有的失败模式,并给出对应解法,把'三网络蒸馏'改写为'仅生成器'的后训练范式,同时把收敛预算压到 20 次生成器更新的量级。
核心方法
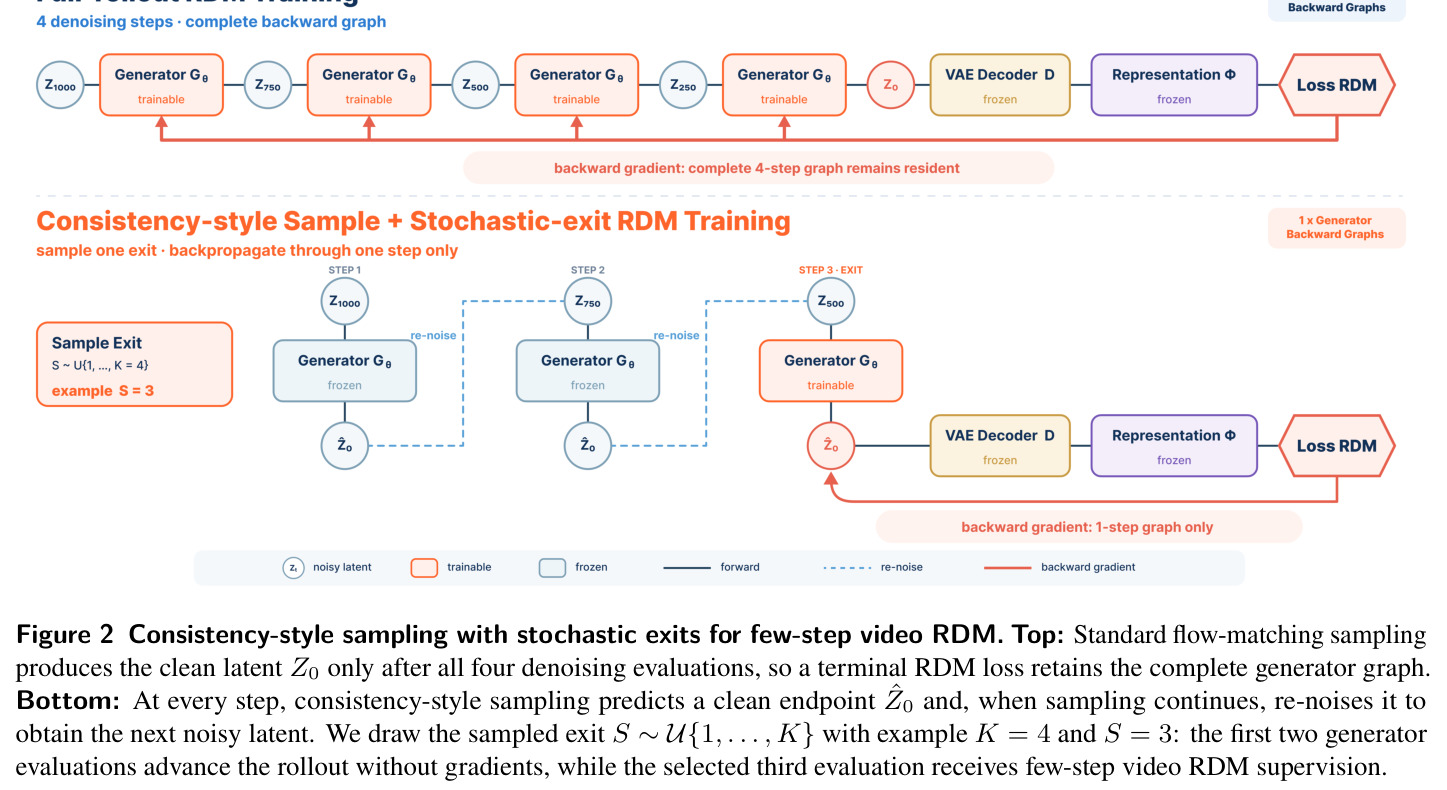
直觉上,DMD 需要两个扩散分数网络的差值来近似分布梯度,而 RDM 直接把生成视频经冻结编码器映射到特征空间,与离线参考特征做核均值嵌入匹配(MMD),梯度只回传给生成器,教师与评论家全部退场。技术路线分四层:(1) 监督点:RDM 匹配干净端点预测 $\hat z_0$ 的分布,天然兼容一致性式采样——每步去噪都输出一个 $\hat z_0$;每次更新随机抽一个出口 $S\sim\mathcal U\{1,\dots,K\}$ 施加 RDM 损失,其余步无梯度推进。(2) 反传:把链式法则拆成分阶段 VJP,梯度依次经冻结编码器 $\Phi$、解码器 $D$ 传回生成器 $G_\theta$,三个反向图不同时驻留显存。(3) 用轻量 TAEW2.1 解码器替换重型 Wan VAE——解码器只是把 latent 暴露给表征编码器的可微桥梁。(4) 配方:确立 $B=64$ 新鲜视频总体与因果 ODE 初始化,叠加单边 flow 正则 $\mathcal L_{dyn}=[\tau-s(\hat v)]_+$。整套流程 20 次更新、8×A100 上 2 小时完成。
核心创新是把分布匹配后训练从'分数空间'搬到'表示空间'。DMD 用教师分数减在线评论家分数近似分布梯度,训练时三网络共存(Self Forcing 配置 77.1 GB/GPU、176 GPU 时);ViRDM 用固定的离线参考分布——6,505 对视频-文本经 V-JEPA 2.1(全局池化 1024 维)与 SigLIP2(1152 维 $\ell_2$ 归一化)编码成 2176 维联合表示,配合中值启发式带宽的高斯 RBF 核计算经验 MMD²,训练时只需生成器本身(48.3 GB/GPU、16 GPU 时)。本质区别有三:(1) RDM 作用于干净端点而非指定轨迹,与一致性式采样和随机出口组合后,每个去噪步都可作为监督点;(2) 分阶段 VJP 把 $\nabla_{\hat h}\ell \to J_\Phi^\top g_h \to J_D^\top g_v \to \nabla_\theta$ 显式拆开,冻结模块的反向图用完即释放;(3) 三条视频特有规律——8~64 条新鲜视频即够、必须因果化初始化、表征对动态的响应非线性需 flow 正则补足——均为首次系统刻画。
方法步骤详情
第一步(离线参考):冻结的 V-JEPA 2.1 ViT-L/16 对视频做全局平均池化得 1024 维特征,SigLIP2 文本塔输出 1152 维并 $\ell_2$ 归一化,把 6,505 对参考视频-文本一次性编码为 $\mathcal H^\star$,按中值距离确定带宽 $\sigma_v,\sigma_t$ 与比例 $\beta=\sigma_v/\sigma_t$。第二步(随机出口因果展开):以因果 ODE 初始化的 Wan2.1 1.3B 块状生成 81 帧 832×480 视频(每块 3 个 latent 帧、4 步去噪);每个 microbatch 采样出口 $S$,前 $S-1$ 步无梯度推进并维护 KV 缓存,第 $S$ 步的 $\hat z_0$ 带梯度。第三步(损失):各块出口预测拼成完整视频,经轻量 TAEW2.1 解码为像素,计算 $\mathcal L=\mathcal L_{RDM}+\lambda_{dyn}\mathcal L_{dyn}$,$\lambda_{dyn}=5\times10^{-4}$。第四步(分阶段反传):依次算 $\nabla_{\hat h}\ell$、编码器 VJP 得 $g_v$、解码器 VJP 得 $g_z$,最后经生成器图更新 $\theta$。全程 20 次更新、$B=64$、AdamW 学习率 $2\times10^{-6}$。
技术新颖性
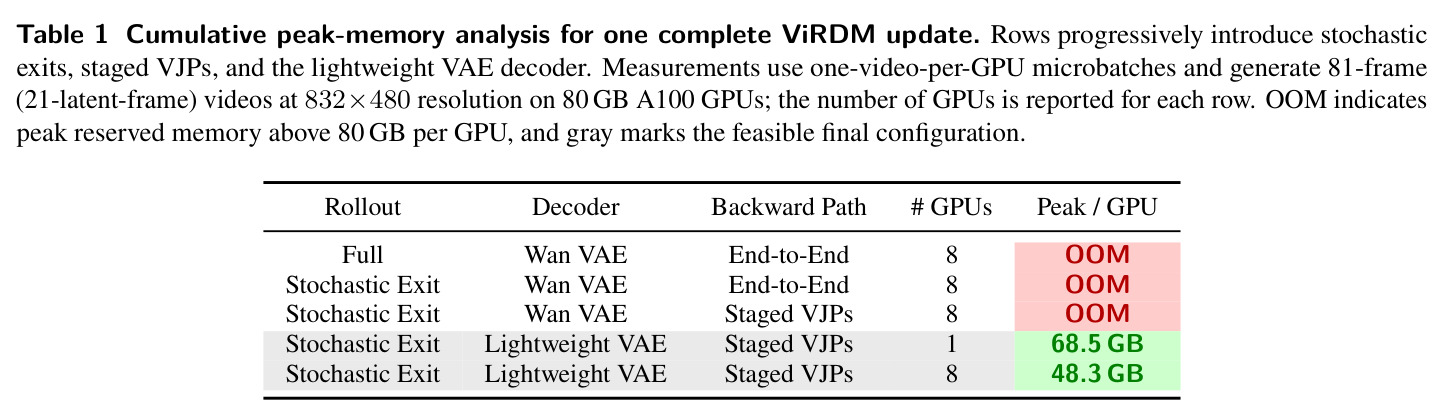
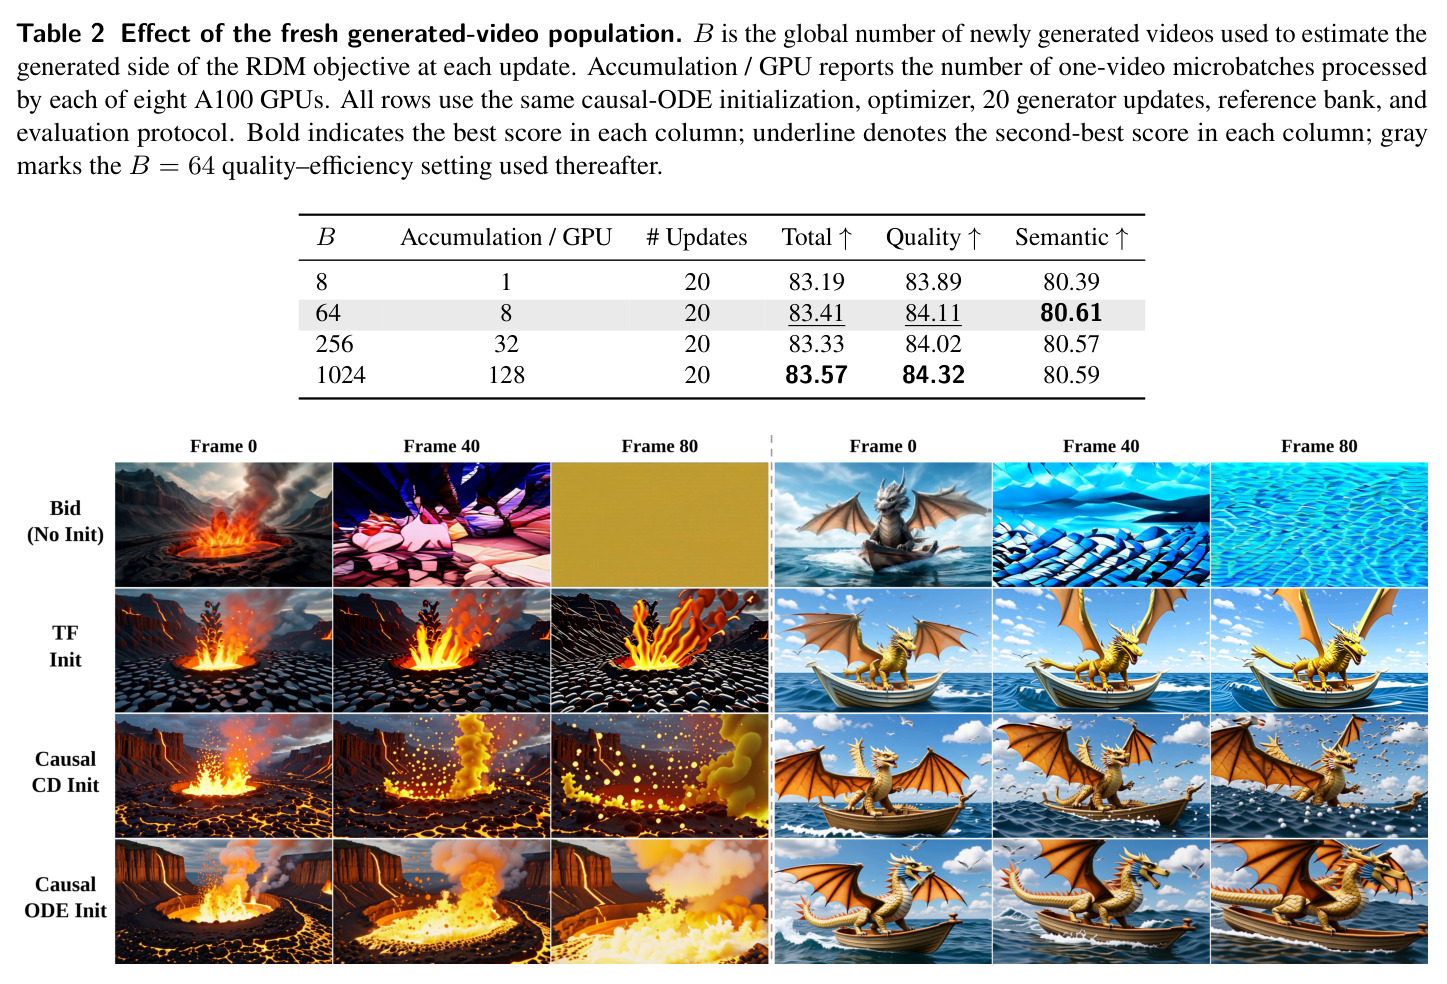
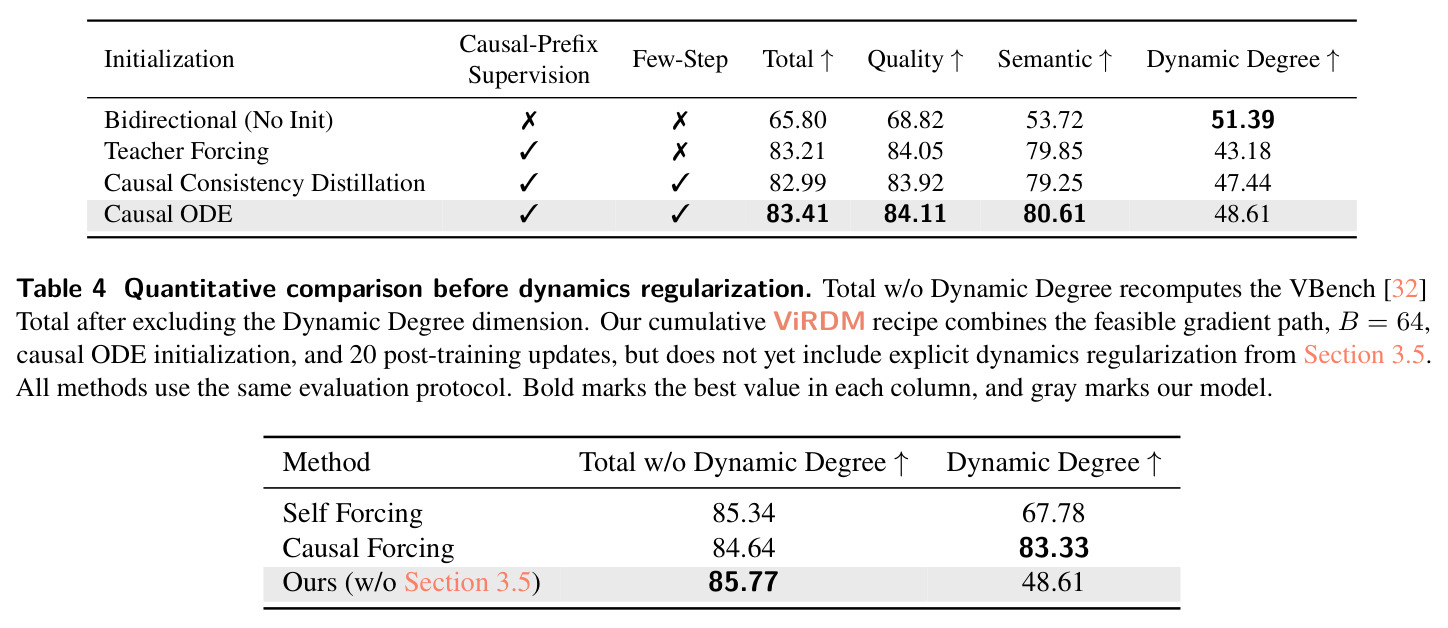
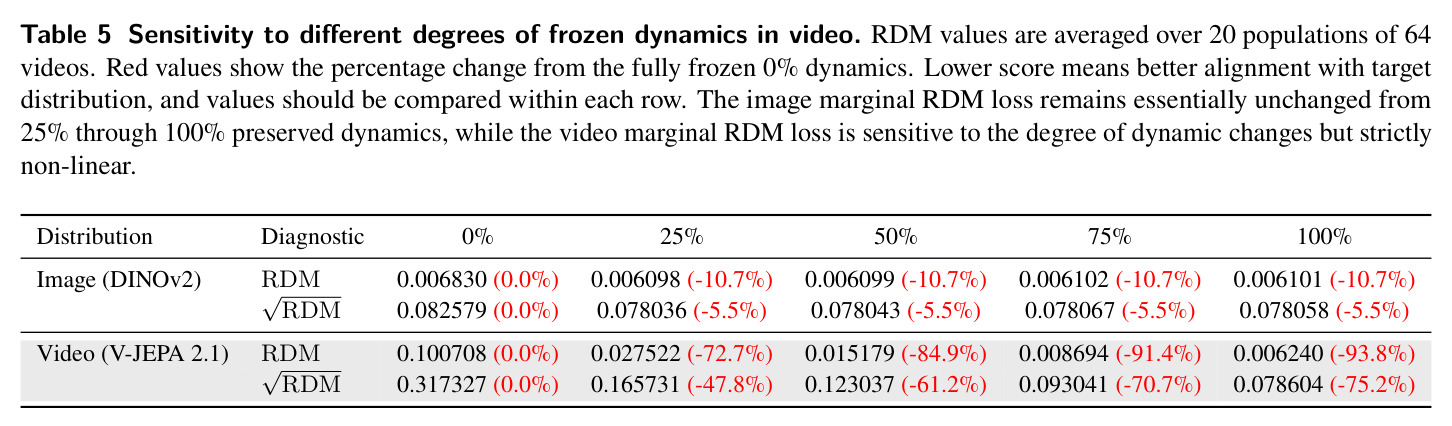
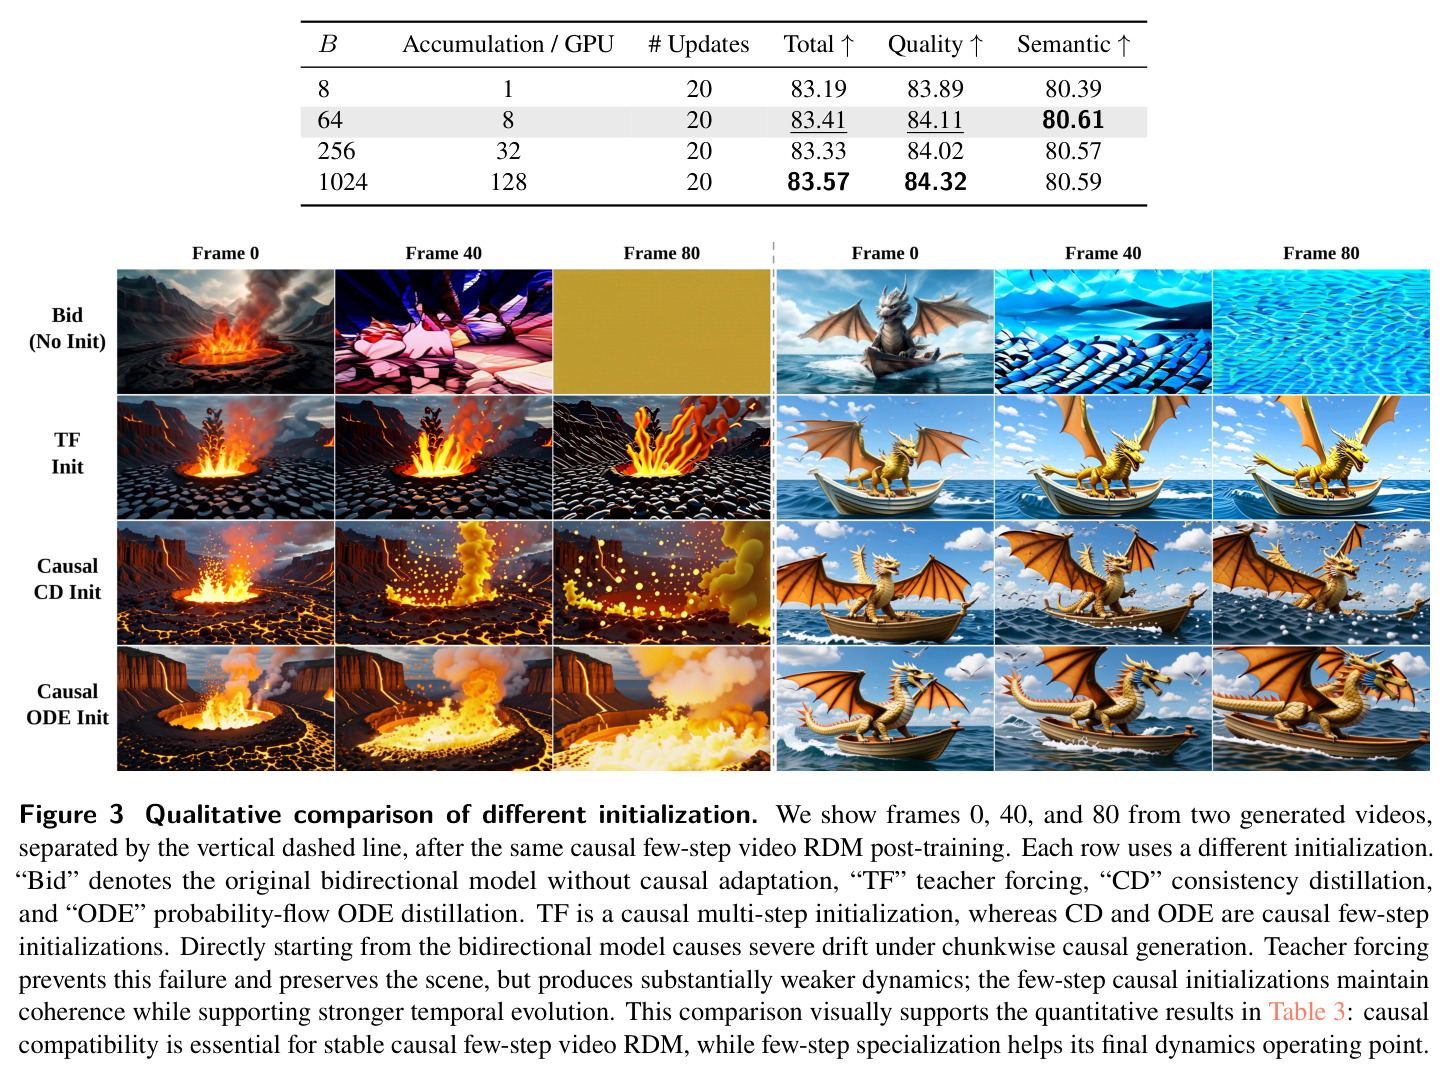
新颖性体现在四个层面。(1) 任务:首次把表示分布匹配从一步文生图扩展到少步因果视频生成,证明 RDM 可施加在一致性式采样的任意中间干净端点上,使多步采样与表示匹配目标兼容。(2) 系统:分阶段 VJP 是显式的显存工程——把 $\Phi$、$D$、$G_\theta$ 的反向图按时序解耦,配合轻量 TAEW2.1 解码器,把端到端 OOM 的路径降到 48.3 GB/GPU(Table 1 的累计消融展示了每步贡献)。(3) 实证:三条视频特有规律首次被量化——新鲜总体从图像 RDM 的 2048+ 降到 8~64 即饱和($B=64$ 与 $B=1024$ 仅差 0.16 Total);双向初始化直接失败(65.80)而因果 ODE 初始化有效(83.41);DINOv2 图像边缘分布对动态几乎不敏感(帧保留率 25%~100% 下 RDM 仅变化 -10.7%),V-JEPA 敏感但非线性(0%→100% 达 -93.8%)。(4) 目标:用单边 flow 阈值正则 $[\tau-s(\hat v)]_+$ 补足表征目标的动态盲区,仅作训练期纠偏、不影响推理成本。
实验结果
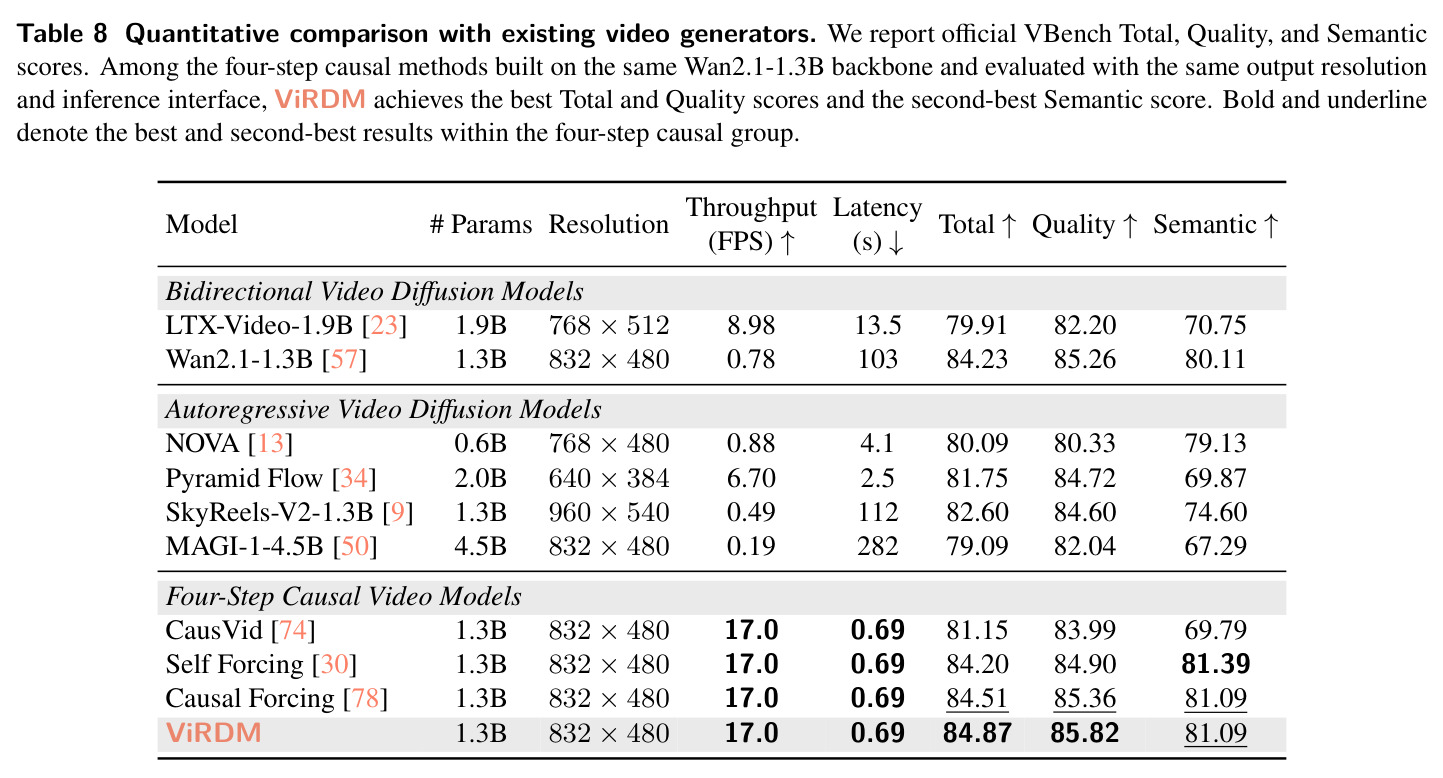
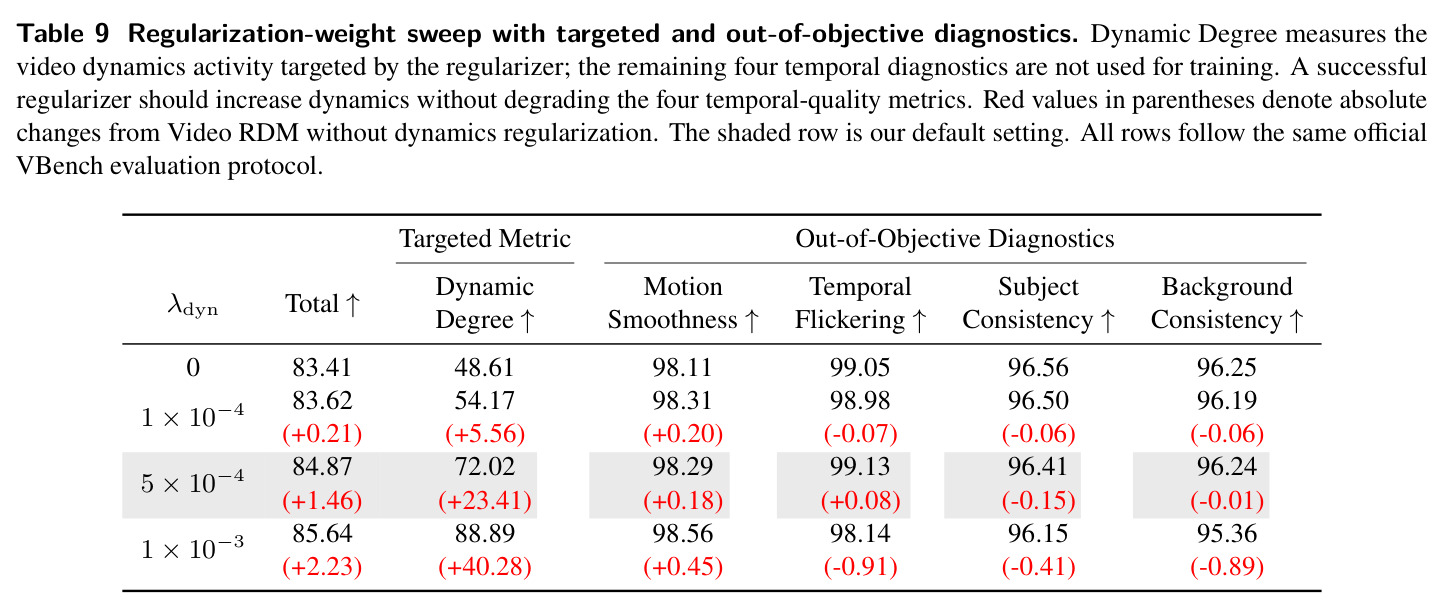
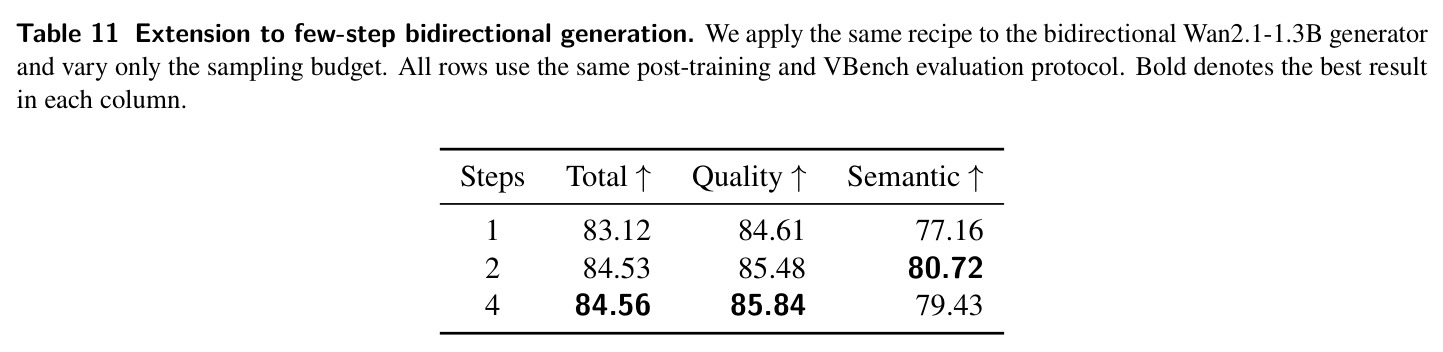
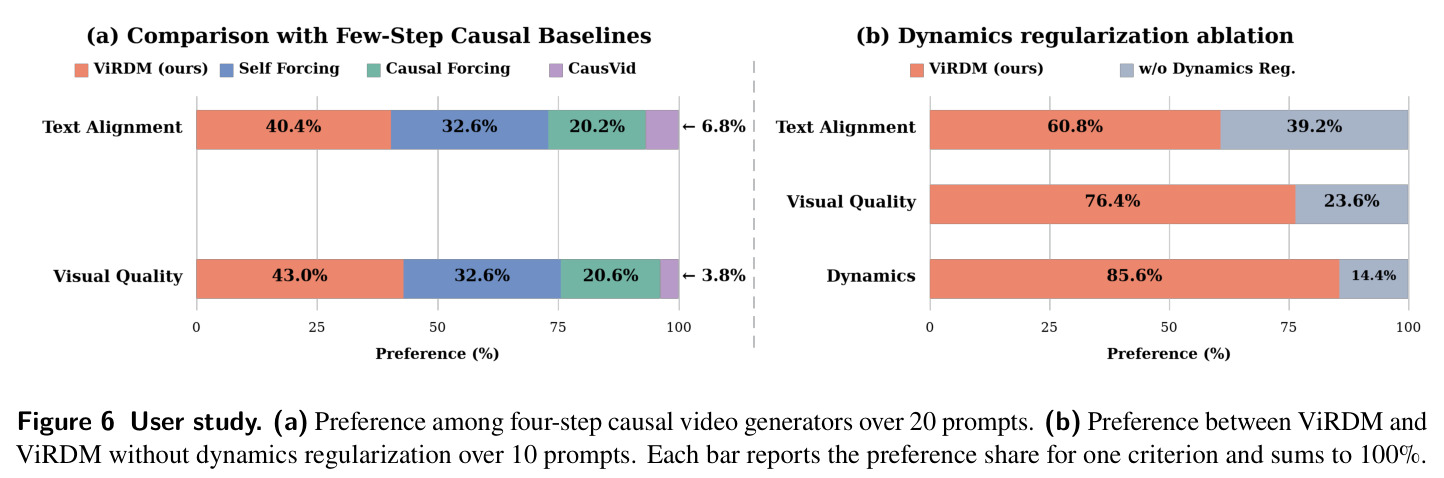
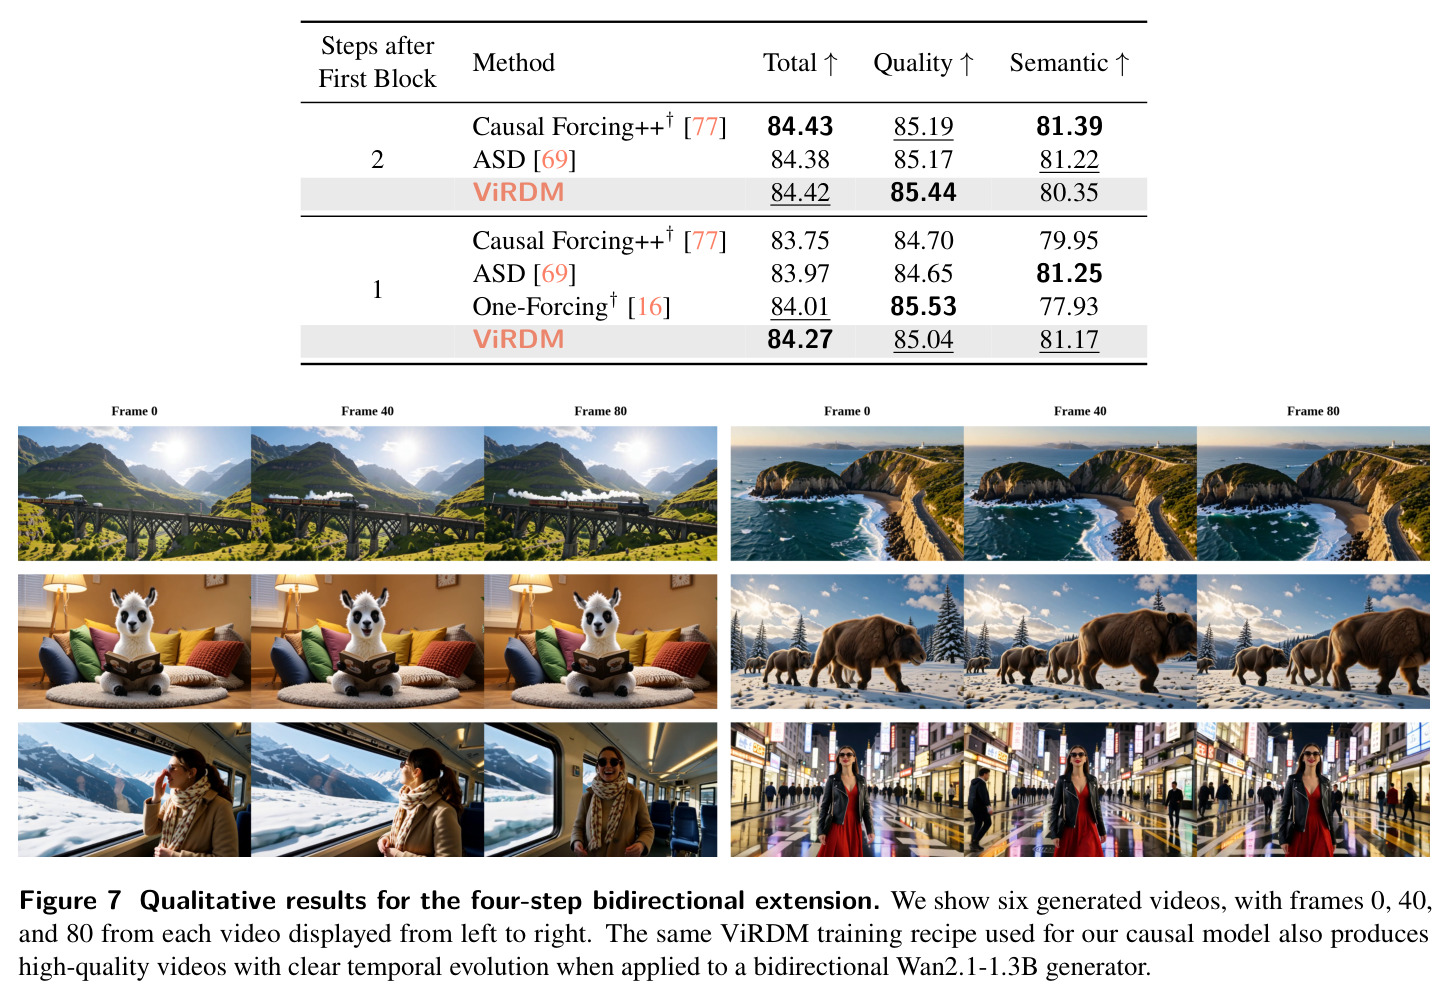
五个核心发现。(1) 主结果(Table 8):官方 VBench 上 ViRDM 达 Total 84.87、Quality 85.82、Semantic 81.09,比此前最佳四步因果基线 Causal Forcing(84.51)高 0.36,Quality 组内最佳、Semantic 次佳,吞吐 17.0 FPS、首帧延迟 0.69 秒。(2) 效率(Table 7):相对 Self Forcing 的 120 次更新、77.1 GB、22 小时(176 GPU 时),ViRDM 只需 20 次更新、48.3 GB、2 小时(16 GPU 时),时间省约 91%,单卡 80GB A100 梯度累积也可行。(3) 消融(Table 2/3/6):$B=64$ 是平衡点(83.41,$B=1024$ 仅 +0.16);因果 ODE 初始化最佳(83.41),双向 No Init 崩到 65.80;V-JEPA 比 DINOv2 高 30.55 Dynamic Degree(18.06→48.61),flow 正则再 +23.41 至 72.02,Total 同步 +1.46。(4) 正则有效性(Table 9 + 人评):$\lambda_{dyn}=5\times10^{-4}$ 时样本外时序诊断变化 ≤0.18,25 人盲评 85.6% 偏好其动态。(5) 扩展(Table 10/11):两步因果 Quality 85.44 最佳;一步因果 Total 84.27 组内最佳;双向四步 Total 84.56。
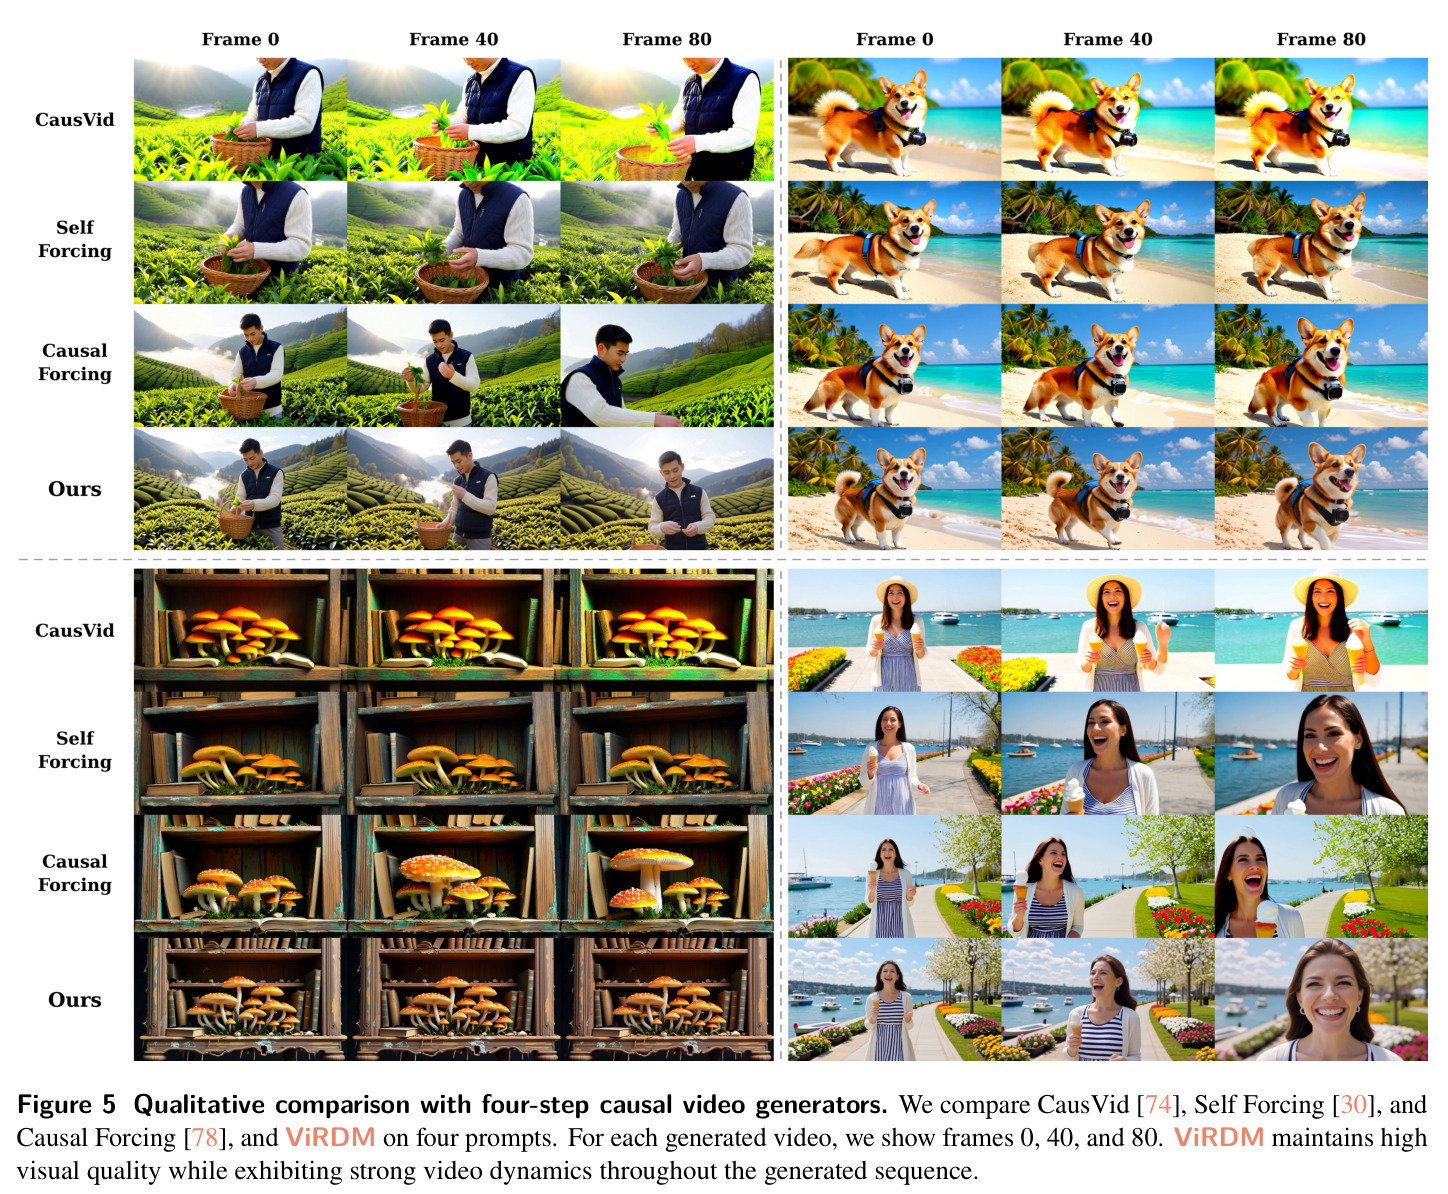
局限与改进
作者承认的局限:(1) ViRDM 是后训练配方而非因果预训练替代——初始化研究(Table 3)表明短程表示分布后训练无法把双向模型转成因果生成器(No Init 仅 65.80 且严重漂移);(2) 继承冻结表征编码器(V-JEPA 2.1)与固定参考总体(6,505 对)的归纳偏置;(3) 主实验仅覆盖 Wan2.1-1.3B、81 帧、832×480。我的补充观察:(1) 加正则后 Dynamic Degree 72.02 仍低于 Causal Forcing 的 83.33,说明表征匹配与强动态之间仍有张力;(2) $\lambda_{dyn}$ 选择敏感——$1\times10^{-3}$ 时 Dynamic Degree 达 88.89 但 Temporal Flickering、Subject/Background Consistency 分别回退 0.91/0.41/0.89,阈值 $\tau$ 依赖人工调参;(3) MMD 受参考分布质量上限制约,覆盖不足会把生成器拉向参考盲区,且 MMD 只有总体级信号、无样本级判别力,难以定位失败个案。
独立分析的弱点
独立分析出四个弱点。(1) 静态参考分布:6,505 对参考一次性离线编码后全程固定,若其在风格或运动类型覆盖上有缺口,MMD 会系统性地把生成器拉向参考流形,压缩输出多样性;改进方向是滚动刷新参考集,或在表示空间做聚类/子空间加权以覆盖长尾。(2) 动态正则依赖代理指标:$[\tau-s(\hat v)]_+$ 用 RAFT 光流幅度衡量动态,但 flow 大不等于运动语义正确——高频抖动、纹理噪声也会产生大光流;改进方向是引入语义级运动目标(如时空 token 级 MMD、运动描述对齐)或对光流做频域与区域分解后再约束。(3) 随机出口的低效性:每次更新仅一个去噪步被直接监督,20 次更新只有 20 个出口参与反传,其余步靠参数共享间接受益;改进方向是按出口端点误差或预测不确定性加权采样 $S$,或并行多出口微批次提高每更新监督密度。(4) 规模未验证:staged VJP 与轻量解码器的收益在 1.3B 上成立,但 14B 级生成器、更长时域 KV 缓存下是否保持尚不清楚,需要针对性的显存剖析实验。
未来方向
作者提出的方向:把配方推广到更大模型规模、更高分辨率与更长时域;深化一步/两步因果与一、二、四步双向生成这些目前仅 exploratory 的结果。基于本文成果可延伸的方向:(1) 可更新/可条件化的参考分布——把固定 $\mathcal H^\star$ 换成随训练滚动刷新或按类别分组的参考银行,缓解静态参考的覆盖盲区;(2) 时间感知更强的表征目标,例如对时空 token 序列而非全局池化向量做 MMD,或匹配运动特征,从根上消除对启发式 flow 正则的依赖;(3) 出口选择策略化,用每步端点预测误差指导 $S$ 的采样分布,提高单位算力的监督效率;(4) RDM 与少量 DMD 步骤的混合后训练,用极低预算专门修复 Dynamic Degree 的残余差距;(5) 依托其流式、低延迟特性(17.0 FPS、0.69 秒首帧)接入世界模型、游戏模拟与具身智能等交互场景,作为在线策略视频生成的骨干模型。
复现评估
复现门槛在同类工作中相当低,细节披露较充分:骨干 Wan2.1-T2V-1.3B;4 步去噪、时间步 {1, 0.9375, 0.8333, 0.625}、偏移 5;每块 3 个 latent 帧、81 帧 832×480;AdamW 学习率 $2\times10^{-6}$、$(\beta_1,\beta_2)=(0.9,0.95)$;20 次更新、$B=64$、$\lambda_{dyn}=5\times10^{-4}$。算力:8×A100 约 2 小时(16 GPU 时、峰值 48.3 GB),单卡 80GB A100 梯度累积即可(68.5 GB),属于学生可负担级别。外部组件均公开可得:V-JEPA 2.1、SigLIP2、TAEW2.1 解码器、RAFT、VBench、Wan2.1;因果 ODE 初始化 checkpoint 来自 Causal Forcing。风险点:项目页 neu-vi.github.io/ViRDM/ 未明确承诺开源代码与预计算参考特征;分阶段 VJP 的工程实现(随机性 trace 记录与回放、跨卡出口同步)是主要复现难点,综合评估为中等难度。
论文图表
四种初始化对比:双向 No Init 65.80 Total / 51.39 Dynamic Degree(漂移导致的高动态无意义);教师强迫 83.21 / 43.18;因果一致性蒸馏 82.99 / 47.44;因果 ODE 83.41 / 48.61(最佳,作为默认)。
证明表示分布匹配能精炼已有因果传输但不能凭空创造,初始化选择是配方的必要组成部分。
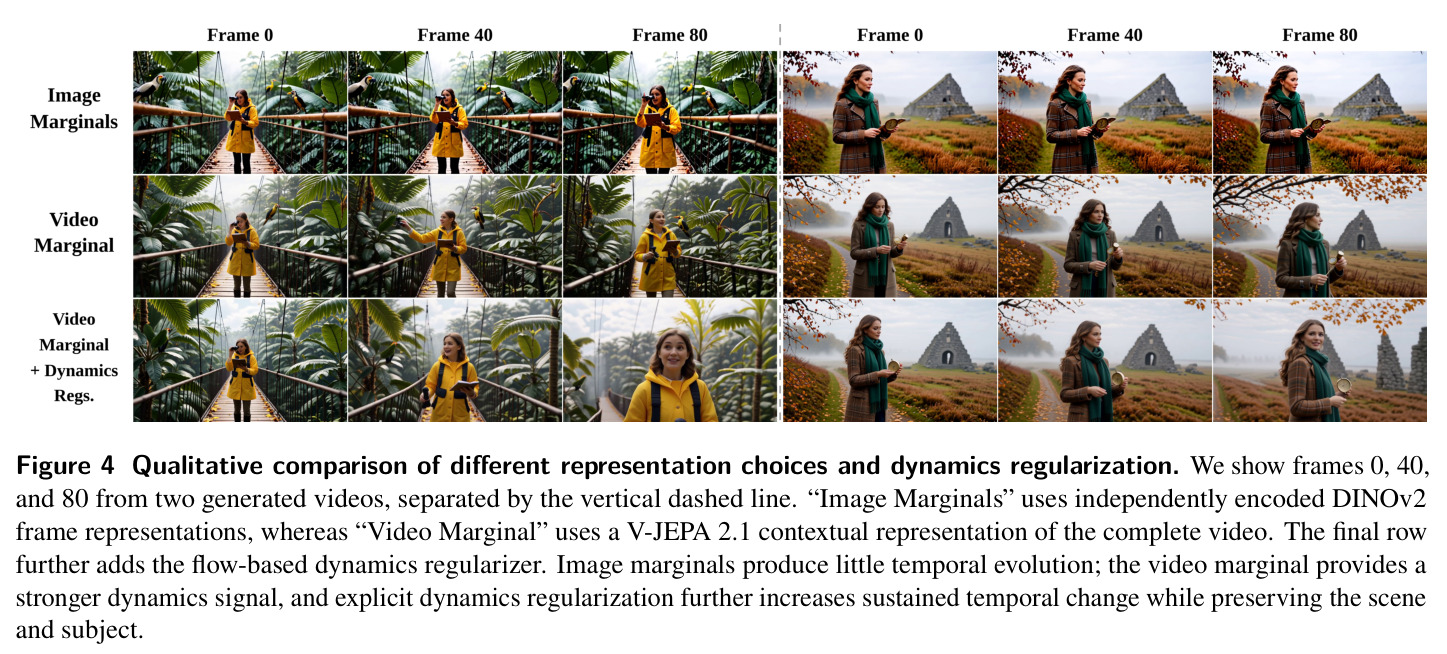
控制变量对比:DINOv2 图像表征 82.70 Total / 18.06 Dynamic Degree;换 V-JEPA 2.1 后 83.41 / 48.61(DD +30.55);再加 flow 正则(λ=5e-4)后 84.87 / 72.02(DD 再 +23.41,Total +1.46)。诊断列显示去除 Dynamic Degree 后 Quality 仅变 -0.10、Total 仅 +0.02。
一次性厘清表征选择与动态正则各自贡献,并证明正则提升几乎全部来自 Dynamic Degree 本身而非其他维度退化。
按 ASD 的首块增强策略(首块 4 步、后续块 1 或 2 步):两步设置 ViRDM Quality 85.44 组内最佳、Total 84.42 仅比 Causal Forcing++ 低 0.01;一步设置 Total 84.27 组内最佳(超过 One-Forcing 84.01、ASD 83.97)。
证明配方对更激进的因果采样预算同样有效,扩展了方法的适用范围。