GraphDecisionBench:图任务上系统一模型的基准测试 GraphDecisionBench: Benchmarking System One Models on Graph Tasks
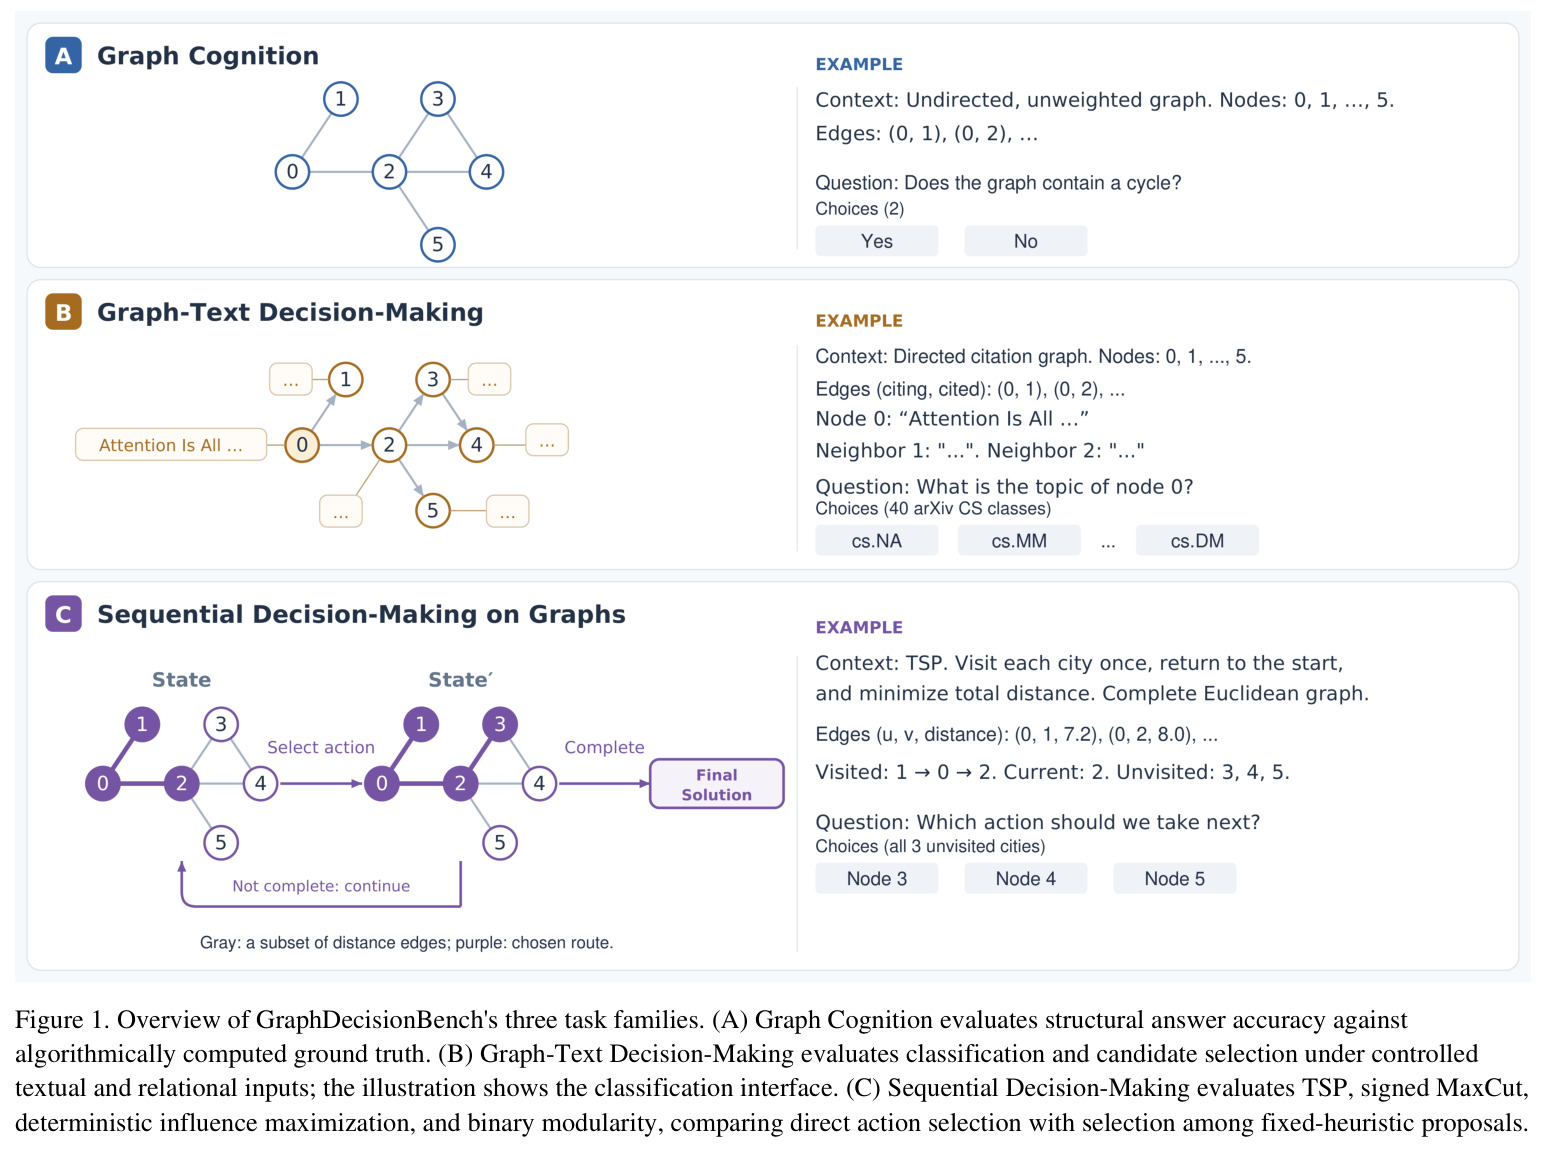
面向选项选择式模型的图决策诊断基准,覆盖结构认知、图文融合与序列构造
前置知识
系统一模型与选项选择接口
指像 Jev 这样直接从给定候选选项中选择并返回概率、不经过显式深思推理阶段的决策模型。"系统一"借自心理学的快思考概念,评测时采用操作性定义:有选择接口、无推理设置、低延迟,三者是相互独立的属性。
本文的评测对象正是这类模型,理解其界定方式才能明白基准为何强调"评估决策质量而非内部机制",以及 GPT-5.4 仅凭 reasoning_effort="none" 为何被归入此组。
割点与图结构判断
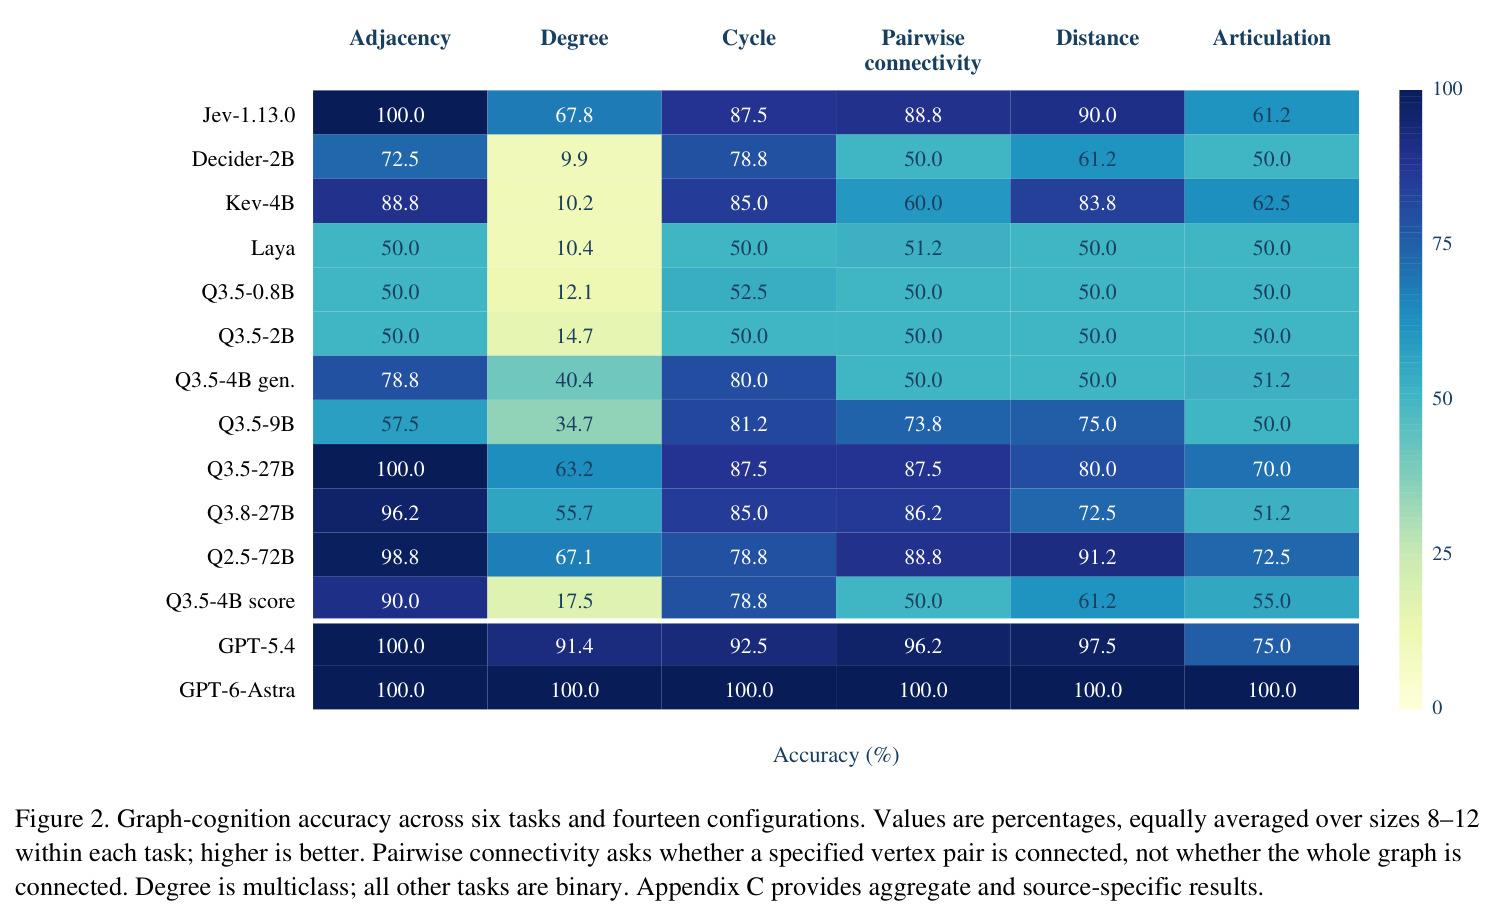
割点是移除后会使连通分量数目增加的顶点,需要邻居聚合式的全局结构推理。RQ1 共六类查询:邻接、精确度数、环存在性、成对连通性、距离阈值与割点,标准答案由独立图算法计算。
RQ1 的核心发现是 Jev 邻接判断 100% 正确但割点仅 61.25%,只有理解割点这类任务为何更难,才能读懂"局部识别不等于结构能力"这一结论。
匹配输入对照与差值指标
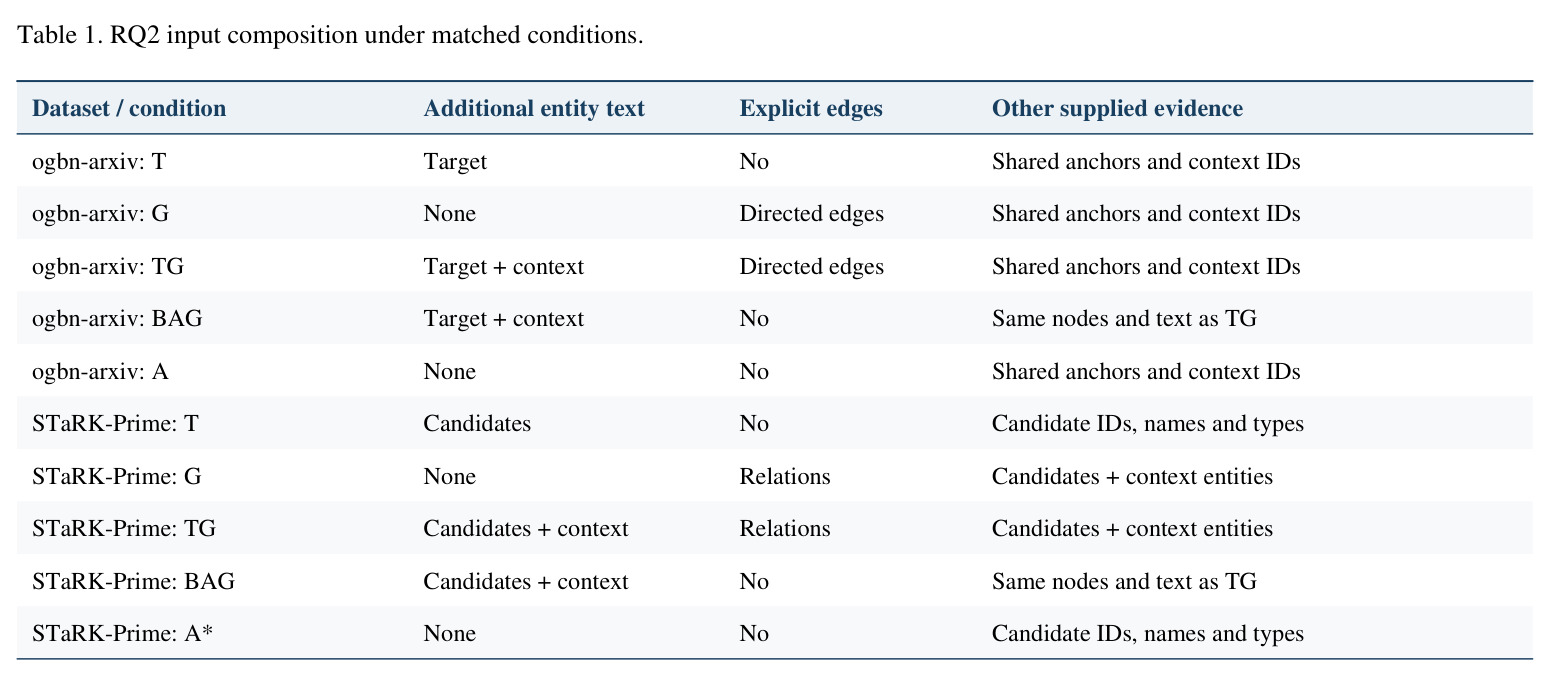
通过成对差值 $\Delta_{edge}=S(TG)-S(BAG)$ 与 $\Delta_{relation}=S(G)-S(C_0)$(单位为百分点),在固定其余证据的前提下量化某一输入组件的边际贡献,并用保留条件间配对结构的 95% bootstrap 区间评估不确定性。
RQ2 的所有结论(如联合输入无一致增益)都建立在这些对照差值上而非绝对准确率,不理解对照设计就无法区分"联合准确率高"与"边真有用"。
参考间隙(reference gap)
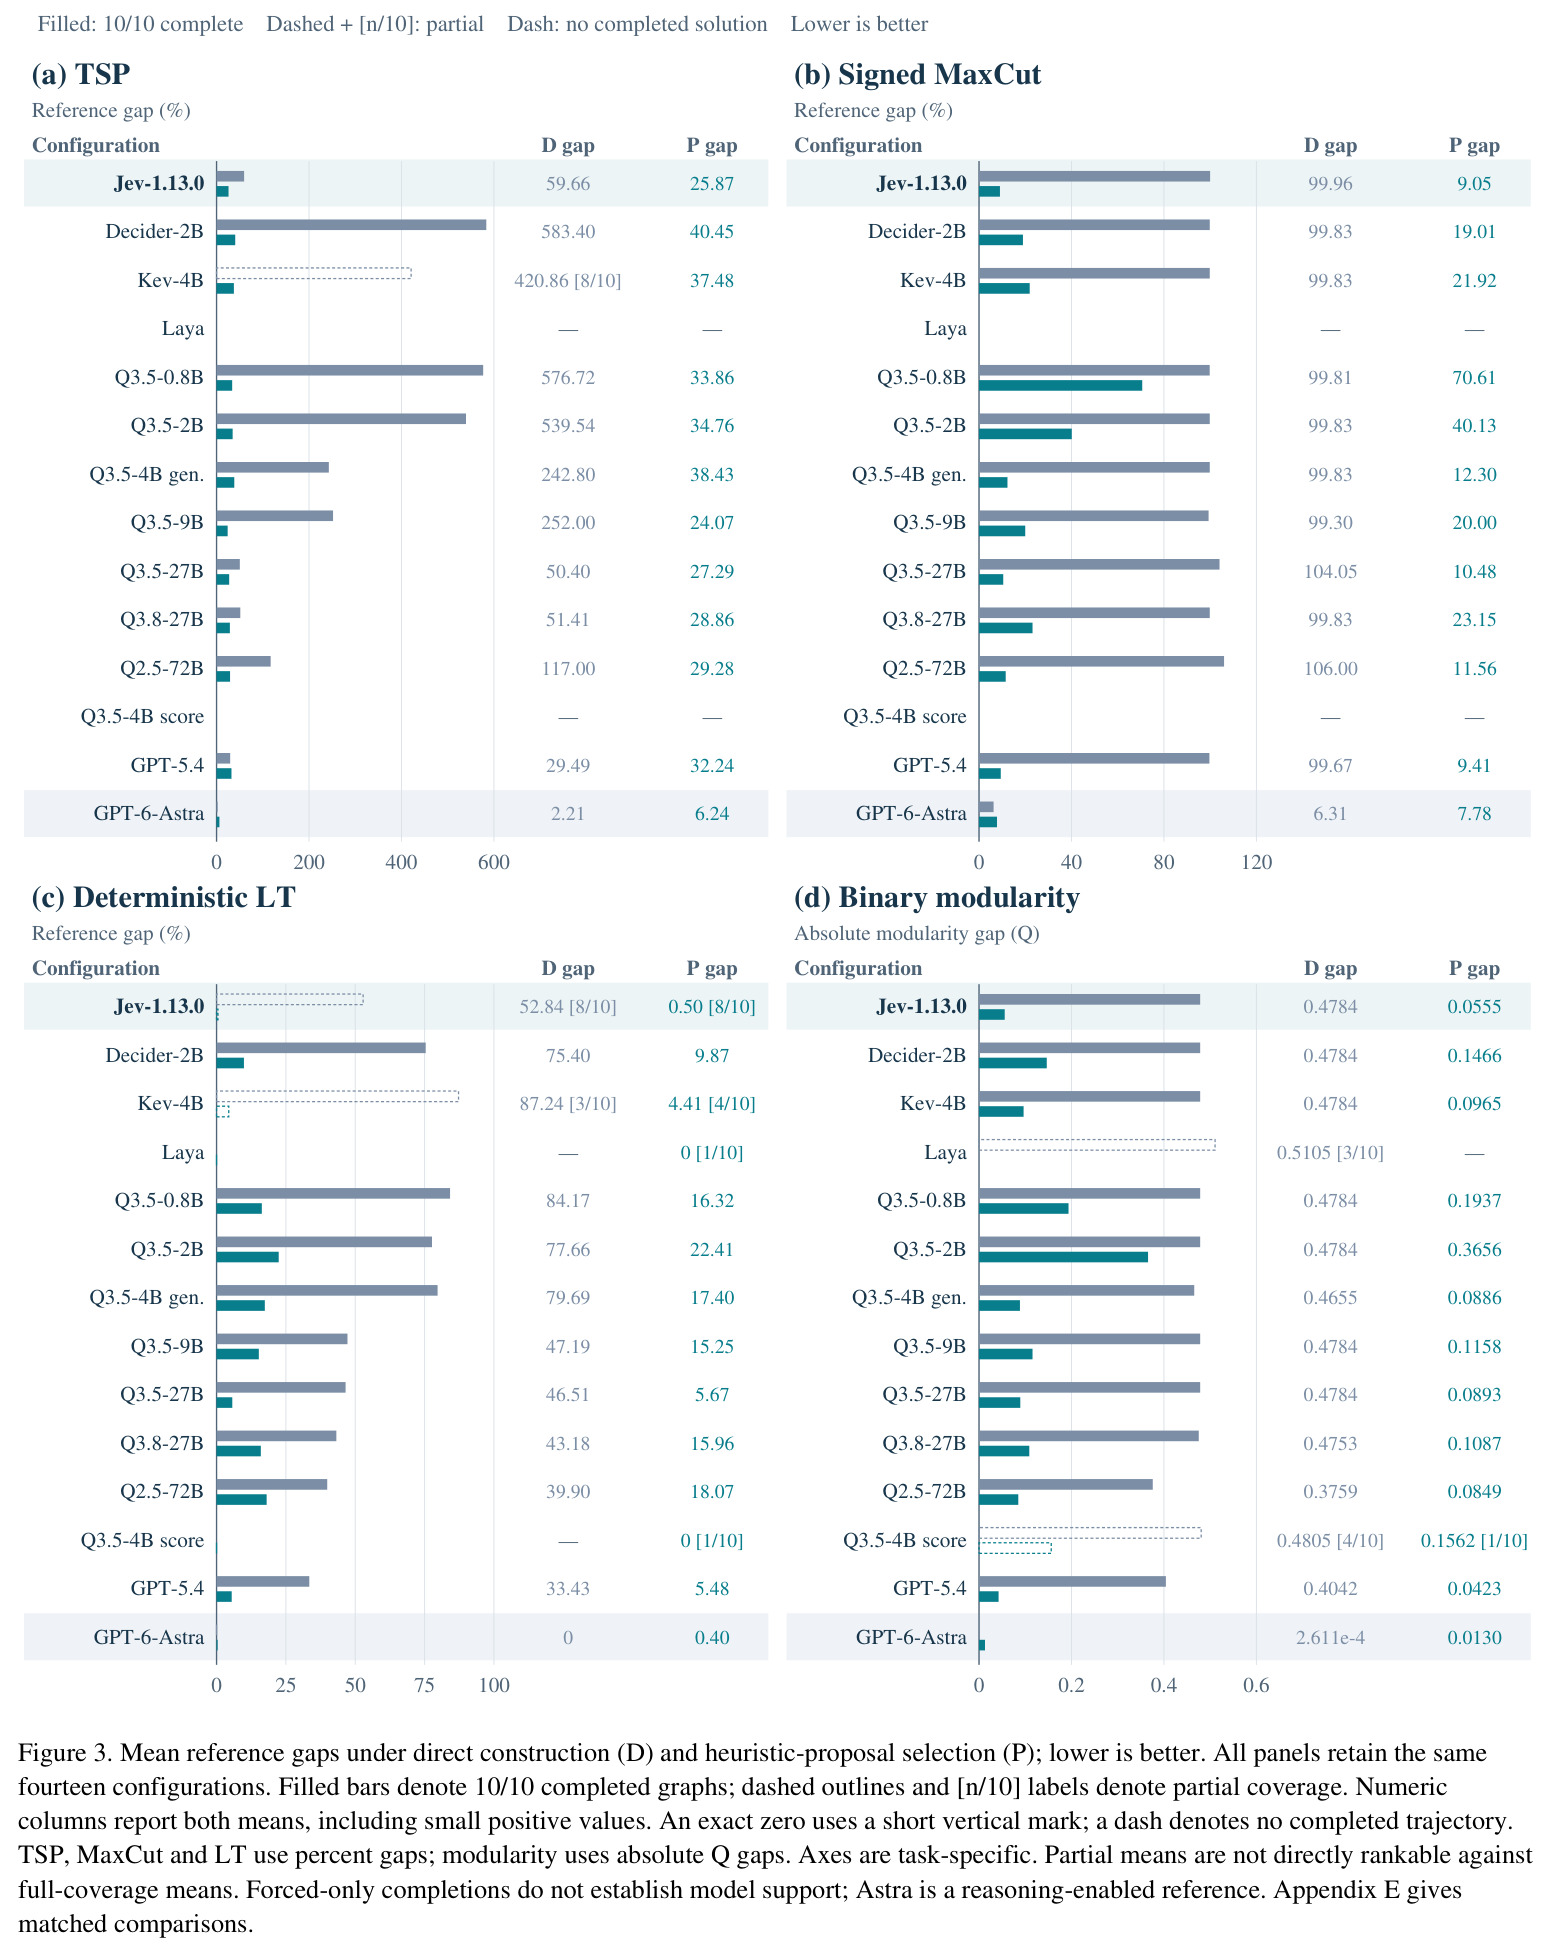
衡量构造解质量的指标:对完成实例 $i$,TSP/符号 MaxCut/确定性 LT 用相对偏差 $\Delta_i=|f_i-R_i|/R_i\times100\%$,二元模块度用绝对差 $Q_i^\star-Q_i$,其中 $R_i$ 为精确或历史最优参考值,越低越好且跨任务不可比。
RQ3 所有结果(如 Jev TSP 直接构造间隙 59.66%)均以该指标呈现,同时还需区分完成覆盖率与完成子集上的平均间隙 $\mu_{gap}$。
启发式提案选择
序列构造的一种模式:不让模型从全部合法动作中直接选,而是由四条固定启发式规则提名候选动作,模型仅在提案池中挑选,同时获得数值特征与规则身份,用于评估"模型选择的增值"相对"外部引导本身的收益"。
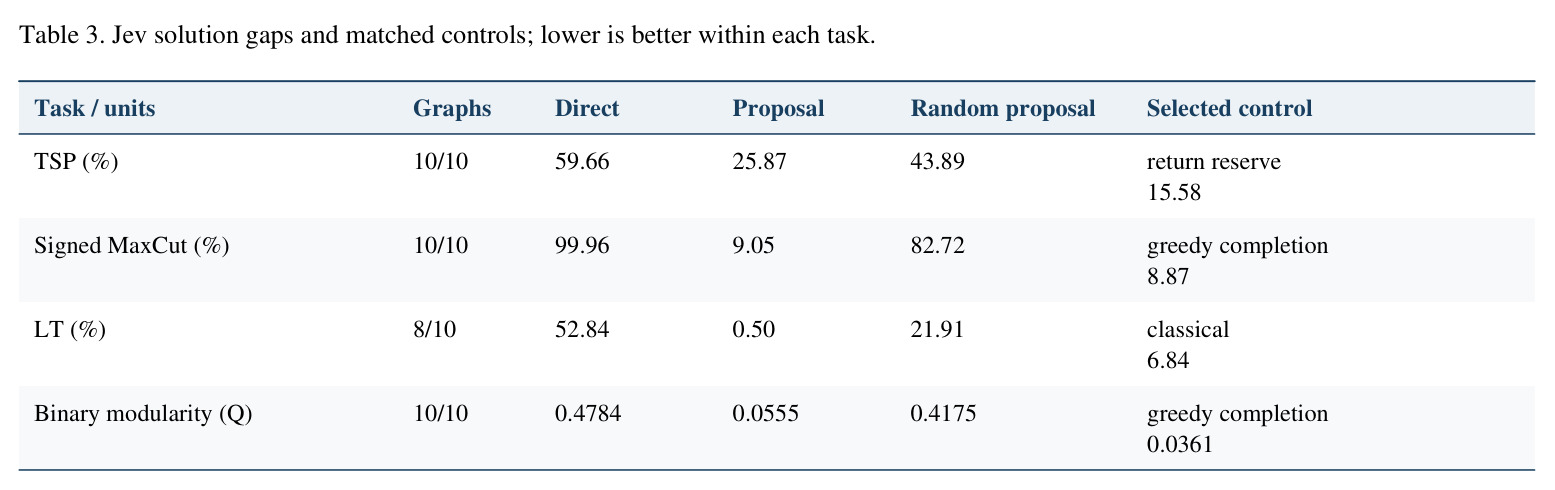
它是 RQ3 区分完成能力与优化质量的关键设计:Jev 在此模式下 TSP 间隙从 59.66% 降至 25.87%,但仍不敌 return reserve 规则的 15.58%。
研究动机
大语言模型正被广泛尝试用于图理解与优化决策,而以 Jev 为代表的"系统一"模型能直接从给定选项中选择并返回概率,天然适合路线构造这类需要反复决策的序列应用。但这类模型在图任务上的真实能力并不清楚:把模型放进现有图任务算一个总体准确率或最终目标值,会掩盖三个关键问题——某一结构操作上的成功能否迁移到其他操作、某个输入组件是否真带来超越伴随证据的价值、辅助产生的解究竟反映模型选择能力还是外部启发式的强度。例如答对邻接判断(识别一条明确列出的边)并不能保证准确的邻居聚合或割点识别;联合图文输入下准确率高,也不等于显式边信息真被有效利用,可能只是文本证据本身够强。
本文的目标是本文要构建一个模型无关的诊断型基准 GraphDecisionBench,围绕三个互补的研究问题组织评测:RQ1 图认知——模型对邻接、精确度数、环存在性、成对连通性、距离阈值、割点六类结构判断的准确性如何;RQ2 图文决策——在文本(T)、关系(G)、联合(TG)、去边消融(BAG)与对照(A/A*)五种匹配条件下,关系证据对 ogbn-arxiv 节点分类与 STaRK-Prime 实体选择的边际贡献有多大;RQ3 图上序列决策——模型的连续选择能否构造完整可行的解,其质量与经典方法和固定规则相比处于什么位置。任务定义、候选接口与评分规则完全独立于 Jev,可移植到未来的任何决策模型。
与已有工作不同的是,与 NLGraph、GraphArena 等整体评分式基准不同,本文的独特切入是"诊断式对比"而非排位赛:一是结构任务画像,按六类操作与图规模分别计分,暴露能力不均衡而非给出单一总分;二是匹配图文输入对照,用 TG−BAG 只移除显式边、G−A* 只加入关系,在共享锚点或含金候选池下分离组件贡献;三是候选池控制,用提案池内随机选择(如 TSP 的 43.89%)和最强固定规则(如 return reserve 的 15.58%)作参照,把"模型选择的增值"从"提案机制本身的收益"中剥离。三个诊断通过统一的选择接口相连,明确反对把三大任务族压缩成一个能力分数。
核心方法
基准将任务规范与模型执行解耦:图实例、答案空间、参考评估器与评分规则定义基准本身,模型适配器只负责供给决策——每次调用给定输入 $x$ 与候选集 $\mathcal{A}$ 并返回一个选择,适配器必须保持候选身份与条件证据,把标准答案、目标评估与状态更新留给评估器;原生选择、受限生成、候选打分被视为同一任务的不同读出方式,不支持的请求记为 unsupported 而非悄悄缩小答案空间。RQ1 用 800 个查询(度数 400、其余各 80,四个数据源各 200);RQ2 每数据集 100 个目标/查询、五种匹配条件;RQ3 四个优化任务各 10 个实例、直接构造与提案选择两种模式,共 80 条轨迹。评测单元分别为查询、目标-条件对与轨迹尝试,覆盖十四种模型-接口配置。
核心创新是把三个常被混为一谈的问题拆开并各自配上受控对照。其一,任务画像:按六类结构操作分别计分,让"邻接 100% 但度数仅 67.8%"这类不均衡可见;其二,图文对照:TG−BAG 只去掉显式边而保留其余文本与锚点,G−A* 只加入关系,从而隔离组件的边际贡献,配对 bootstrap 区间保留每个目标的条件配对;其三,提案池控制:随机提案对照回答"选择是否胜过乱选"(TSP 随机 43.89%),固定规则对照回答"选择是否胜过死规则"(TSP return reserve 15.58%)。任务定义与评估器完全独立于 Jev,Jev 只是主实证案例,任何决策模型都可以通过适配器接入同一套契约。
方法步骤详情
第一步 RQ1:从 Facebook、ca-GrQc、Power Grid、Human PPI 抽取 8–12 顶点的诱导子图,按来源、规模和答案分层抽样出 800 个查询(二元任务平衡 yes/no,度数任务平衡各度数),模型从给定图(含孤立点)作答,独立图算法计算标准答案,主指标为五个图规模等权的任务准确率。第二步 RQ2:ogbn-arxiv 上 40 类节点分类与 STaRK-Prime 上含金候选(每池 40 个候选且至少一个正确答案)的实体选择,各设 T/G/TG/BAG/A(A*) 五种匹配条件,报告准确率、macro-F1 与 Hit@1,主对比为成对差值 $\Delta_{edge}=S(TG)-S(BAG)$ 与 $\Delta_{relation}=S(G)-S(C_0)$(百分点),附配对 95% bootstrap 区间。第三步 RQ3:状态经 $a_t=D_\theta(x_t,\mathcal{A}_t)$、$s_{t+1}=\mathcal{F}(s_t,a_t)$ 逐步推进直至完成或失败;TSP(TSPLIB 76–225 城)、符号 MaxCut(125 顶点 375 边)、确定性 LT 影响最大化(选 2 个种子)、二元模块度各 10 实例,质量用 $\Delta_i=|f_i-R_i|/R_i\times100$(模块度为 $Q_i^\star-Q_i$),同时报告覆盖率与完成轨迹平均间隙 $\mu_{gap}$,固定规则与池内随机选择作对照。
技术新颖性
新颖性体现在评测协议而非新任务或新模型。首先,它是首个针对系统一选择式模型的图决策基准:十四种配置统一到"输入+候选集→选择"接口,选择式模型与无思维链的语言模型基线同台,另设带推理的 GPT-6-Astra 作强参照。其次,RQ2 的 BAG 是输入消融而非 Build-a-Graph 提示,且各条件共享图选上下文身份与训练标签锚点,避免了"纯文本基线"的常见混淆;STaRK-Prime 评测含金池内选择而非端到端检索,边界表述清晰。再次,RQ3 严格区分完成覆盖率与完成子集平均间隙,模式比较使用相同完成实例的配对子集——如 Kev 的 TSP 改进以同八图配对改进 384.23 个百分点报告,而非不同子集均值相减;模块度残差保留符号不截断。这些细节共同保证了差值结论的因果可解释边界。
实验结果
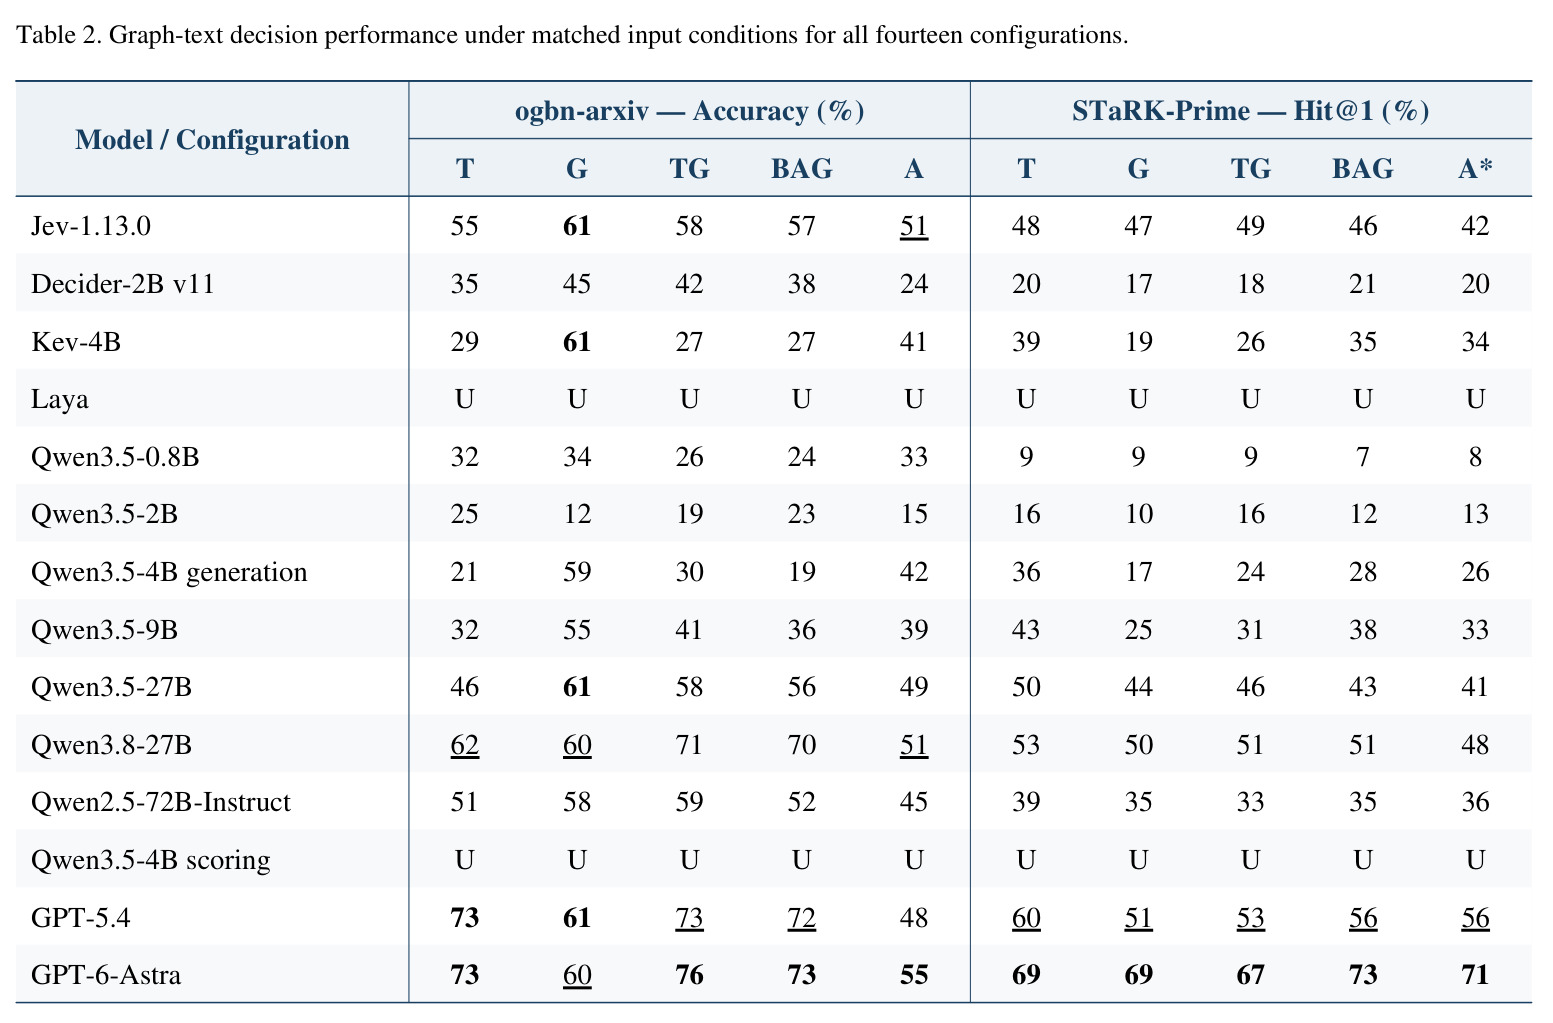
三大任务族给出一致的"能力不均衡"图景。RQ1 上 Jev 邻接 100%、距离 90.0%、成对连通 88.8%、环 87.5%,但精确度数仅 67.8%、割点 61.25%;Decider 与 Kev 度数准确率只有 9.9%/10.2%,Laya 二元任务约 50%;Qwen2.5-72B 在距离(91.2%)与割点(72.5%)上强于 Jev,GPT-5.4 度数 91.4%,GPT-6-Astra 全部 100%。RQ2 上 Jev 的关系增益 $G-A=+10$ pp [+3,+18],但 TG−BAG 仅 +1 pp [−4,+7];Kev 从 G 的 61% 跌到 TG 的 27%,Decider 从 45% 到 42%;Jev TG 准确率 58% 而 macro-F1 仅 24.81%。STaRK-Prime 上 Jev 的 TG−BAG=+3 [−6,+12]、G−A*=+5 [−5,+14],区间均含零,且没有任何受支持配置的 TG−BAG 区间严格为正。RQ3 上 Jev 直接构造完成 38/40 个实例但质量差:TSP 间隙 59.66%、MaxCut 99.96%(目标均值零)、模块度 0.4784(Q=0)、LT 52.84%;提案选择全面改善至 TSP 25.87%、MaxCut 9.05%、LT 0.50%、模块度 0.0555,但仍不敌最强固定规则(TSP return reserve 15.58%、MaxCut 贪心补全 8.87%、模块度贪心 0.0361),唯 LT 0.50% 同时低于随机提案 21.91% 与经典控制 6.84%。Astra 直接构造 TSP 间隙仅 2.21%、LT 精确命中参考值。1120 个 RQ3 单元中 951 个可行完成、165 个不支持、4 个失败(均为 Jev LT)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图认知 RQ1(六任务、800 查询、8–12 顶点) | 任务-规模宏平均准确率 (%) | Jev:邻接 100.0、距离 90.0、成对连通 88.8、环 87.5、度数 67.8、割点 61.25 | Decider-2B/Kev-4B 度数仅 9.9/10.2;GPT-5.4 度数 91.4、割点 75.0;GPT-6-Astra 全任务 100 | Jev 在六项中五项领先其他选择式模型,但割点略低于 Kev(61.25 vs 62.5),不构成一致支配 |
| ogbn-arxiv 40 类节点分类 RQ2(100 目标) | 准确率 / macro-F1 (%) | Jev:G 61、TG 58、BAG 57、T 55、A 51;TG macro-F1 仅 24.81 | Qwen3.8-27B TG 71;GPT-6-Astra TG 76;GPT-5.4 T/TG 73 | 关系增益 G−A=+10pp [+3,+18],但 TG−BAG=+1pp [−4,+7],联合输入无一致增益 |
| STaRK-Prime 生物医学实体选择 RQ2(100 查询、40 候选池) | Hit@1 (%) | Jev:TG 49、T 48、G 47、BAG 46、A* 42 | GPT-6-Astra T 69、BAG 73;GPT-5.4 T 60 | TG−BAG=+3pp [−6,+12] 区间含零,无受支持配置该区间严格为正 |
| TSP 序列构造 RQ3(TSPLIB,10 实例) | 相对参考间隙 (%),越低越好 | Jev 直接 59.66 → 提案 25.87 | 池内随机提案 43.89、return reserve 规则 15.58、GPT-5.4 直接 29.49、GPT-6-Astra 直接 2.21 | 提案模式较直接构造降 33.79pp,但与最近规则 25.86% 几乎持平且不敌 return reserve |
| 符号 MaxCut RQ3(OPTSICOM Set2,10 实例) | 相对参考间隙 (%) | Jev 直接 99.96(目标均值零)→ 提案 9.05 | 随机提案 82.72、贪心补全规则 8.87、GPT-6-Astra 直接 6.31 | 提案模式大幅改善 90.91pp,但仍略逊于贪心补全固定规则 |
| 确定性 LT 影响最大化 RQ3(email-Eu-core,8/10 完成) | 相对参考间隙 (%)(穷举最优为参考) | Jev 直接 52.84 → 提案 0.50(配对八图) | 随机提案 21.91、经典控制 6.84、GPT-6-Astra 直接 0 | 唯一同时击败随机提案与固定规则的任务,但其中一次完成为零模型调用的强制转移 |
| 二元模块度最大化 RQ3(ca-GrQc,10 实例) | 绝对模块度间隙 $Q^\star-Q$(MILP 认证最优为参考) | Jev 直接 0.4784(Q=0)→ 提案 0.0555 | 随机提案 0.4175、贪心补全 0.0361、GPT-6-Astra 直接 2.611e-4 | 提案模式改善明显,但仍高于贪心补全固定规则 0.0194 |
局限与改进
作者明确承认:基准只覆盖有限的公开实例与小规模图认知输入(8–12 顶点子图),结论不能外推到大图或动态图;ogbn-arxiv 的共享上下文与标签锚点导致目标间存在依赖;STaRK-Prime 评测的是含金候选池内的选择而非端到端检索;补充的 200 目标图文评测使用独立队列与模型设置,不与主估计合并;比较针对模型-接口配置,无法分离架构、规模或推理的因果贡献——Astra 是带推理的参照,其优势不能归因于推理本身;提案辅助同时改变候选动作、数值特征、强制转移与后续历史,机制无法单独识别;单次执行无法估计实例内随机变异,配对 bootstrap 区间是逐点的、未经多重比较校正。我的补充观察是:RQ1 每个二元任务仅 80 个查询、RQ2 主面板仅 100 个目标,多个关键对照区间横跨零(如 TG−BAG=+1 [−4,+7]),统计功效有限;RQ3 每任务仅 10 实例且各配置覆盖率不一(LT 仅 8/10),配对比较进一步缩水样本。
独立分析的弱点
第一,统计功效不足:RQ2 每条件仅 100 目标,多个关键结论的 95% 区间含零(如 Jev 的 TG−BAG=+1 [−4,+7]、STaRK 的 +3 [−6,+12]),"显式边无一致增益"这类否定性结论在百级样本下难以坐实,改进方向是把主面板扩到数百目标并做多校正。第二,"系统一"界定依赖表面特征:GPT-5.4 仅凭 reasoning_effort="none" 入组,Astra 的"中等推理"靠响应元数据观测,分类与模型实际计算过程无必然联系,可补推理预算扫描作为敏感性分析。第三,RQ3 实例少且覆盖不一致:LT 仅 8/10 完成,Laya 与 Q3.5-4B scoring 大量 unsupported,覆盖率差异迫使跨模型比较退到配对子集,样本进一步缩水,且零调用的强制完成(如 Laya LT 的 0 间隙)与真实选择混在同一列,应单列。第四,候选池设计可能限制上限:TSP 上 return reserve 固定规则 15.58% 好于所有受测模型的提案模式,说明四条规则的池本身偏弱或偏强,可加入学习型提案器与池大小消融。第五,MaxCut 直接构造下多数模型目标均值为零,天花板效应使二值分配任务区分度不足,可引入部分得分梯度或过程级奖励提高分辨率。
未来方向
作者提出的方向包括:借助模型无关的适配器契约,把同一评测移植到未来的决策模型;扩展到更大规模与动态图。基于本文成果可进一步延伸:其一,针对"邻接强、聚合弱"的诊断模式设计训练干预,例如在度数聚合与割点类合成任务上微调选择式模型并复测迁移;其二,RQ2 显示图文联合收益高度依赖配置,可研究自适应输入路由,按模型-任务对动态决定是否注入边证据;其三,提案选择的价值与池设计强相关(Jev LT 0.50% 优于经典控制 6.84%,但 TSP 不敌 return reserve),可系统刻画哪类任务结构更能发挥选择式模型的提案利用能力,并研究学习型提案生成器与选择器的联合优化;其四,补齐多次运行方差、置信区间多重校正与可变推理预算对照,使"系统一 vs 深思"的因果比较更干净;其五,把基准扩展到端到端检索与更大候选池,检验含金池内结论的外推性。
复现评估
复现条件较好:代码与聚合结果已开源(https://github.com/VictorYXL/GraphDecisionBench),所有图实例来自公开数据(TSPLIB、OPTSICOM、SNAP、OGB、STaRK),参考值来源明确——TSP 用已发表精确最优、LT 用种子对穷举、二元模块度用 MILP 求解器认证、MaxCut 用 2016 年历史最好值,附录 A/B/G 给出实例规范与逐步计算。十四个配置中,Qwen 系列、Decider-2B、Kev-4B、Laya 等开源权重模型可本地部署,附录 F.1 给出 GPU 候选打分实现;但 GPT-5.4 与 GPT-6-Astra 依赖商业 API,且推理配置(reasoning_effort、由元数据观测的 medium reasoning)可能随服务更新漂移,是最不可控的复现环节。主要算力开销在 RQ3:每配置 80 条轨迹、每条多次调用,估计数万次推理调用;RQ1/RQ2 每配置约一千次调用,规模适中。总体难度中等:有 GPU 与 API 预算的团队可在数天内复现主表,闭源模型行为漂移是最大不确定性来源。
论文图表