动态脚手架搜索:基于预测的按查询多智能体系统构建 Dynamic Harness Search: Building Multi-Agent Systems Per-Query via Prediction
训练小型本地模型预测脚手架效用,让MCTS无需执行即可为每个查询定制多智能体系统
前置知识
智能体脚手架(Agent Harness)
脚手架指用 LLM 解题时系统的完整规格:有哪些智能体及角色分工、每个智能体遵循的指令(directives)、各自可调用哪些工具、以及智能体之间的信息传递结构(谁把输出交给谁、是否存在验证反馈环)。它既可以是单个推理智能体,也可以是带规划器、验证器和 Python 执行的多智能体工作流。本文进一步把脚手架形式化为有向可执行图 $G=(V,E)$:每个智能体节点有角色 $\rho_v$、指令列表 $D_v$、工具集 $T_v$,边传递输出,反馈边允许下游打回重做。
本文的核心问题是「为每个查询自动设计脚手架」。理解脚手架由结构、指令、工具三要素构成且互相作用,才能看懂 SHIFT 的 40 个动作构成的动作空间、搜索目标,以及为什么消融显示只调其中一要素会损失精度。
蒙特卡洛树搜索(MCTS)
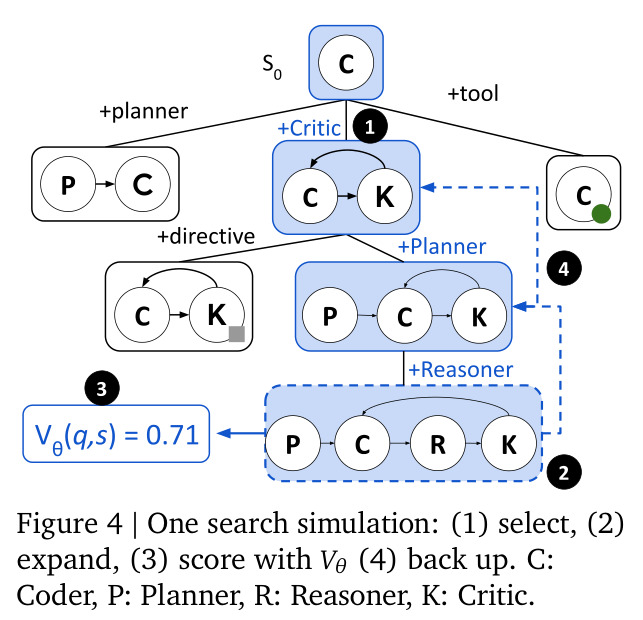
一种在树形决策空间中反复模拟「选择—扩展—评估—回传」的搜索算法:选择子节点时用 PUCT 规则 $a^\star=\arg\max[\tilde{Q}(s,a)+c_{puct}P(a|s)\sqrt{\tilde{N}(s)}/(1+\tilde{N}(s,a))]$ 平衡已验证的高价值动作(利用)和访问少的动作(探索),访问计数 $N$ 和均值价值 $Q$ 随回传不断更新。AlphaGo/AlphaZero 用它在围棋状态空间中搜索。
SHIFT 把搭脚手架建模成一棵树:节点是部分构建的脚手架,边是构建动作(加智能体/加指令/授工具),用 MCTS 做前瞻搜索。算法 1、公式 (3) 和虚拟损失等细节都建立在 MCTS 之上,不熟悉它就读不懂搜索如何运转。
策略-价值网络与 AlphaZero 式自举
一个神经网络同时输出两个头:策略头给出各动作的概率分布,价值头估计当前状态的最终效用(如胜率或回报)。训练时用搜索过程产生的访问分布作为策略目标、用真实结局作为价值目标,搜索与学习交替进行、互相增强——搜索靠更好的网络变得更准,网络靠更准的搜索得到更好的监督信号,这就是 AlphaGo/AlphaZero 的自举训练范式。相比纯强化学习,它把「探索」交给树搜索、把「泛化」交给网络,适合动作组合爆炸但转移规则已知的决策问题。
SHIFT 的「架构师」正是一个 AlphaZero 式 policy-value 网络(Gemma 小模型 + 两个线性头),只是「对局结果」换成了真实执行得到的准确率-成本效用,且推理期搜索完全不用执行器。理解这一范式才能明白训练目标(公式 4-5)为何这样设计。
LoRA 低秩适配微调
LoRA(低秩适配)冻结预训练模型的全部原始权重,只在注意力层注入一对低秩矩阵(秩 $r$ 远小于原维度,本文取 16),训练时只更新这些小矩阵,推理时可合并回原权重、零额外延迟。它把可训练参数量压缩几个数量级,显存与算力需求大幅下降,效果通常接近全量微调,是「小模型 + 少量数据快速定制」的标准做法。正因参数极少,本文才能在每个基准上用数千次执行便宜地训练专用架构师,这是「本地小模型替代执行器调用」成立的工程前提。
SHIFT 的架构师是冻结主干的 Gemma 4 E2B 小模型,只训练 LoRA 适配器(rank 16)和两个线性头(Table 8)。正因为只有极少参数被训练,每个基准训练一个架构师的成本才可控,整套「本地小模型替代执行器调用」的故事才成立。
成本感知效用与奖励塑形
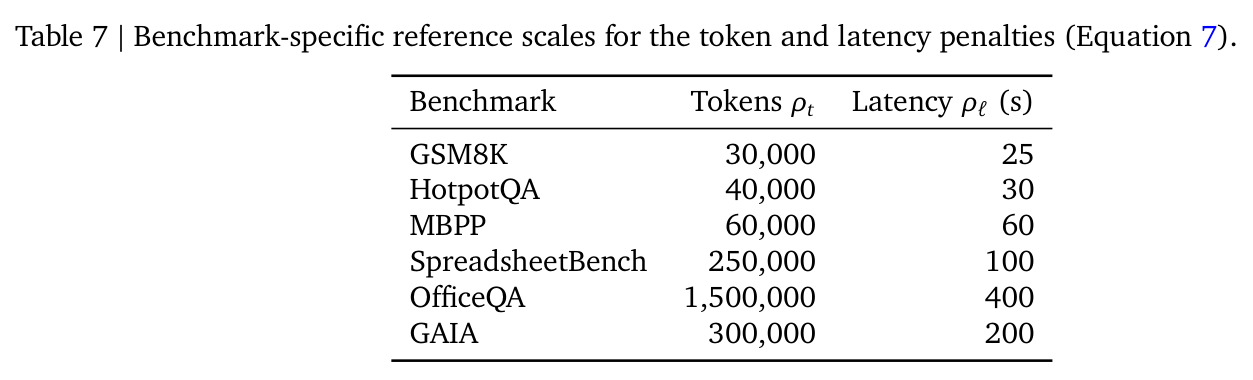
把任务成功与否和执行开销(token、延迟、工具数、智能体数、超时)加权组合成一个标量效用,各惩罚项用基准相关的参考尺度归一化(如 GSM8K 参考 3 万 token、OfficeQA 参考 150 万 token),使相差两个数量级的域落在同一标尺上。SHIFT 的效用为 $z=\frac{clip(R,-1,1)+1}{2}$,其中 $R=\alpha u - b - \sum_x \gamma_x r_x$。
架构师价值头学习的预测目标正是这个效用(公式 7-8)。它决定了搜索「偏爱能解题的最便宜脚手架」的行为:惩罚总和上限 0.58 保证成功脚手架效用至少 0.71、失败至多 0.25——成功永远优先,成功者中更便宜者胜出。这也是 SHIFT-value 省 32% token 的根源。
研究动机
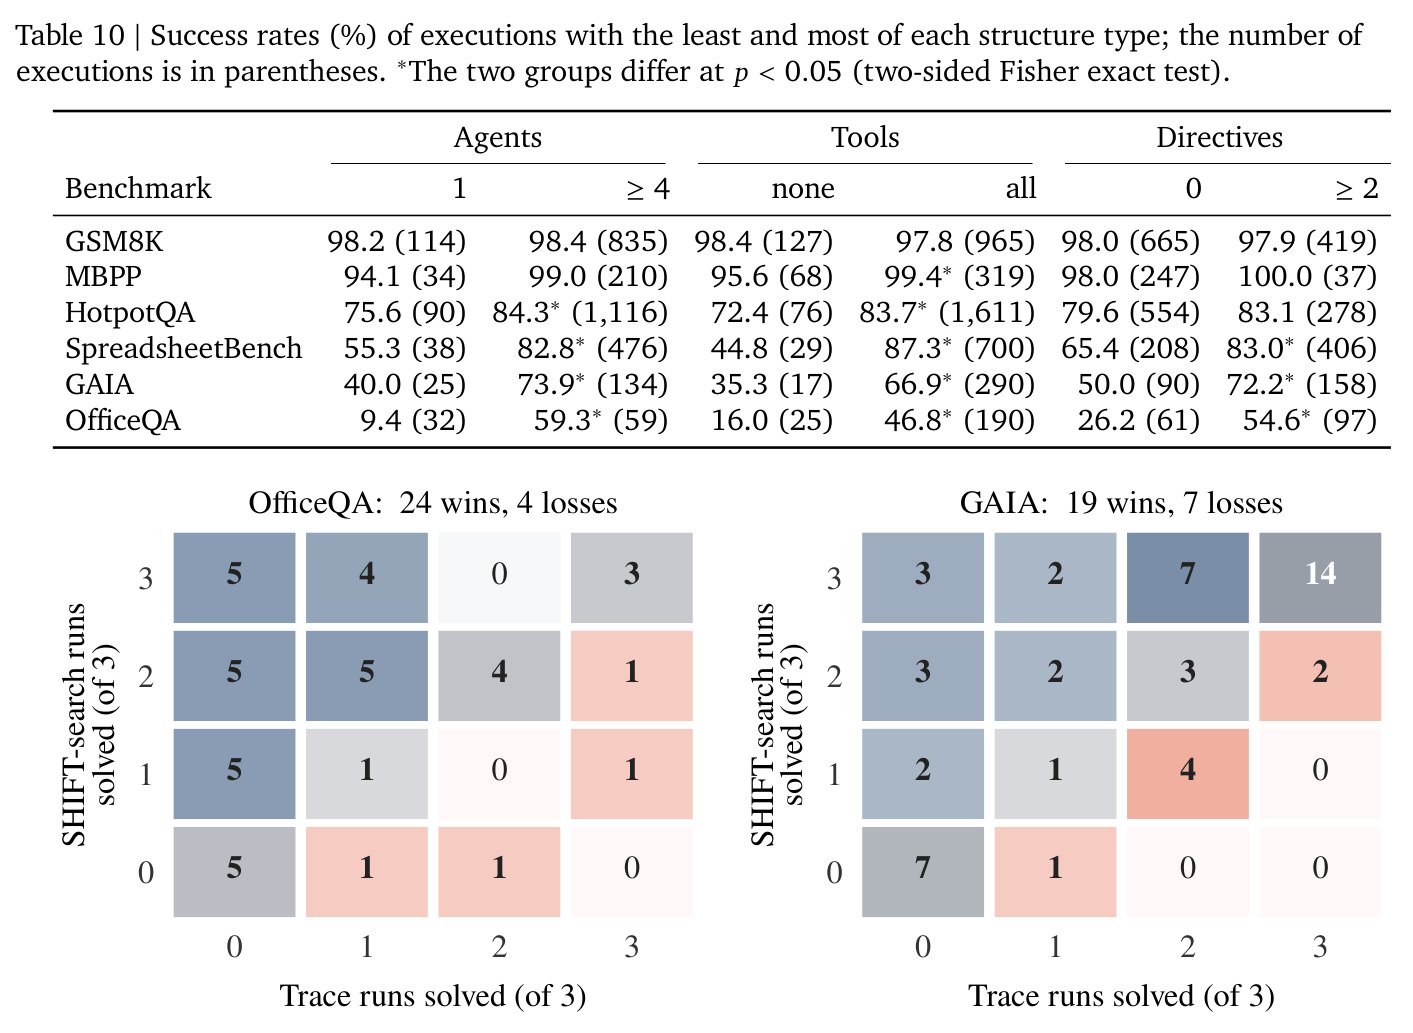
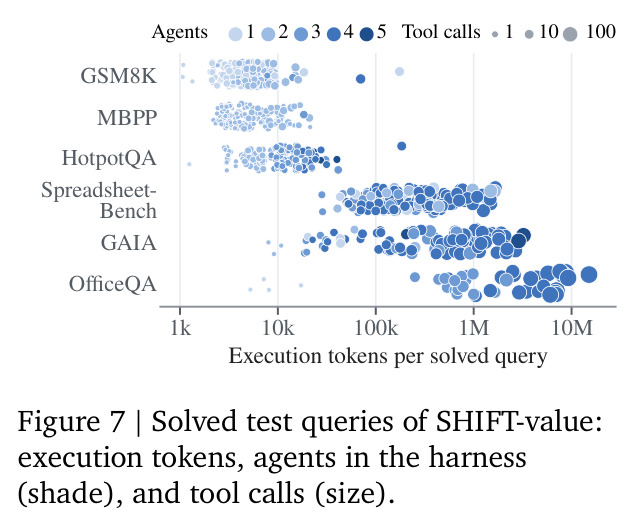
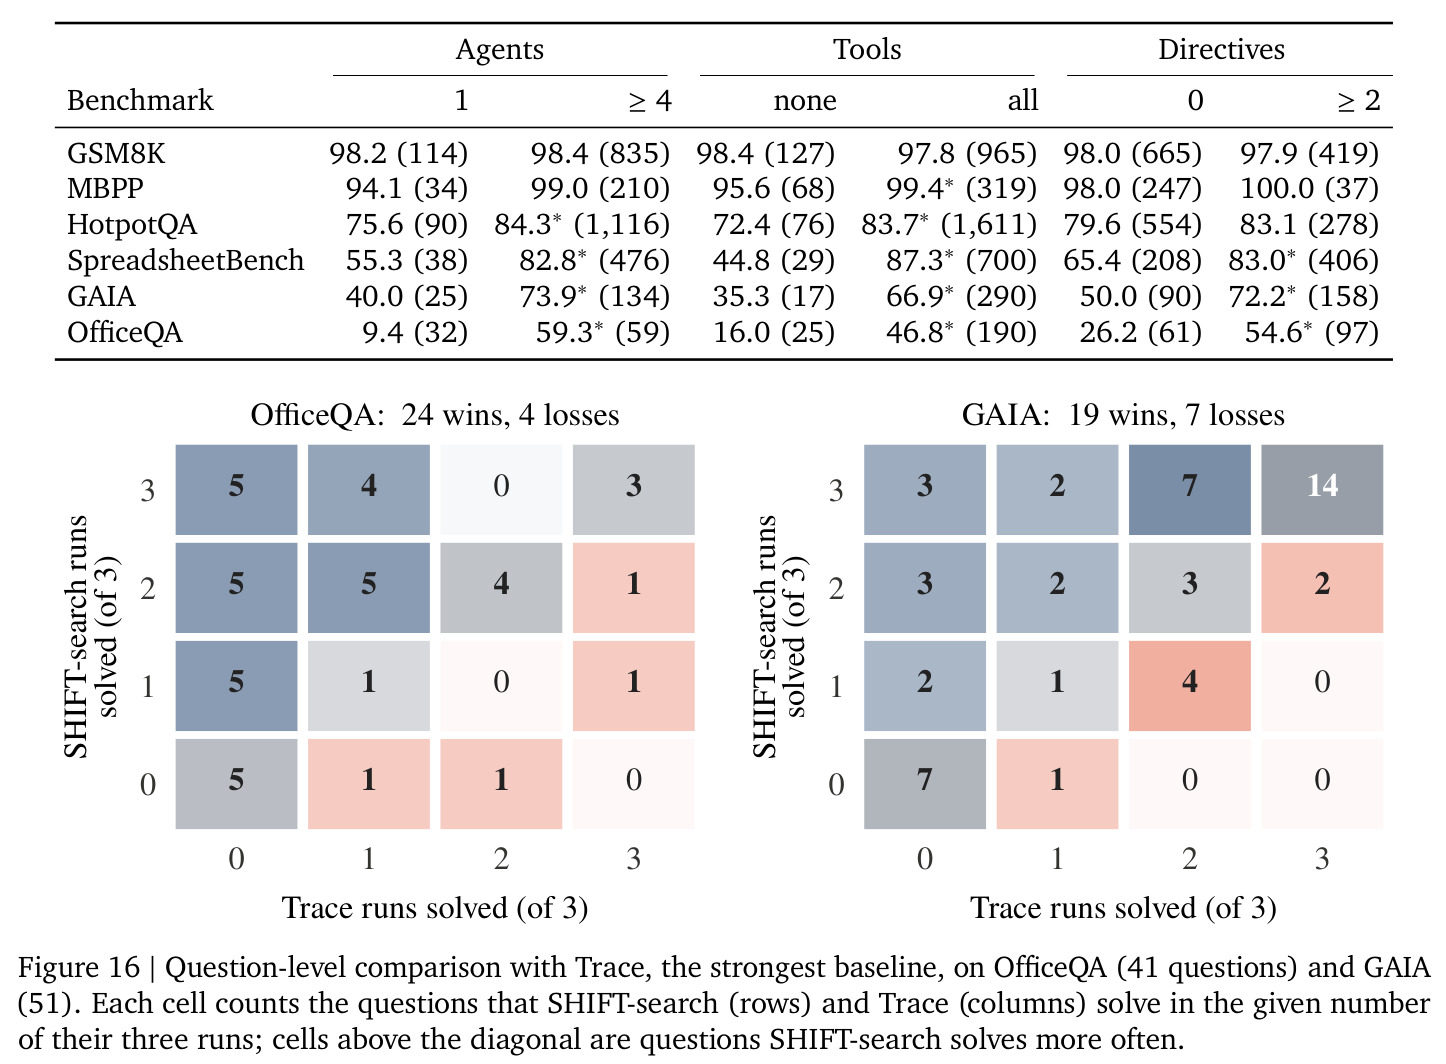
现有做法在「每查询定制」上陷入两难。要么所有查询共用一套人工设计的脚手架:这在两端都吃亏——在 OfficeQA 财务文档问答上,单智能体执行成功率仅 9.4%,而四个以上智能体的脚手架可达 59.3%,相差约 50 个百分点;反过来在 GSM8K 算术题上,多智能体脚手架要多花约 19 倍执行 token 却几乎不提升准确率(0%−0.09 效用)。要么在推理时真实执行多个候选设计再挑选:OfficeQA 或 GAIA 上单个多智能体脚手架执行就要消耗约 100 万至 800 万 token,每试一个设计就把这笔钱再付一遍。更麻烦的是组件之间强交互:验证器是否有用取决于求解器的输出和检查指令,工具有没有用取决于智能体是否会用,所以任一组件的价值同时依赖于查询和脚手架的其余部分,人工设计无法枚举这些组合,执行评估又贵得离谱。
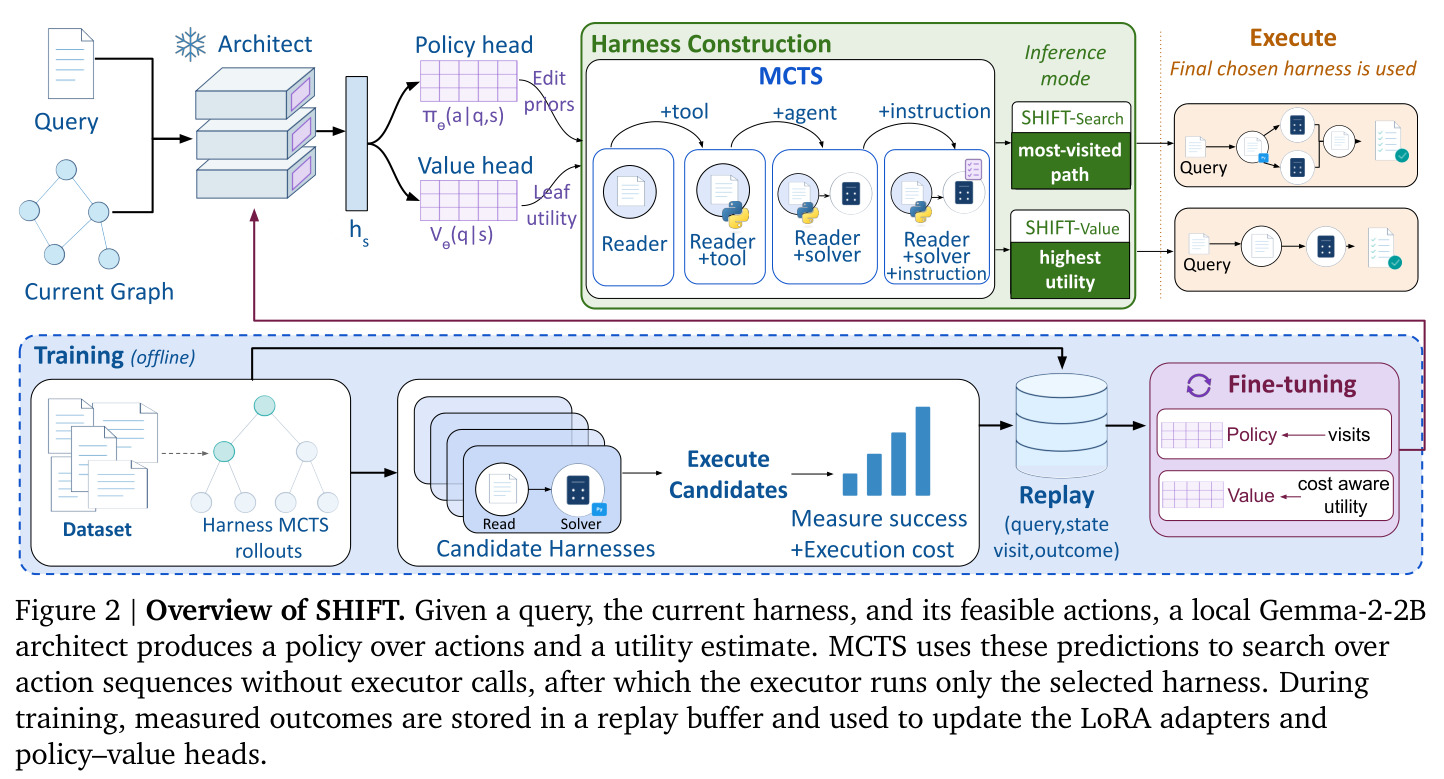
本文的目标是本文的目标是构建一个按查询定制脚手架的框架 SHIFT:给定任一查询,从极简种子脚手架(单 Coder、无工具)出发,联合决定添加哪些智能体、给它们什么指令、授予哪些工具,使最终脚手架在准确率与执行成本之间取得最优平衡。硬约束是:搜索过程不得执行任何候选脚手架——候选的取舍全部由学习到的预测完成,推理时只执行最终选中的那一个脚手架;设计开销压缩到本地小模型的几次前向推理(单 GPU 上每查询不到 1 秒);训练成本一次付清、摊销到之后的全部查询。
与已有工作不同的是,已有工作的切入点各有局限:工作流优化(AFlow、GPTSwarm、Trace)离线为整个基准搜一个可复用结构,无法随查询变化;提示优化(DSPy、MIPROv2、GEPA)在固定程序内只调指令;查询自适应控制器(MaAS 等)按查询生成算子组合,但候选评估仍靠真实执行;AgentSquare 虽引入 LLM 性能预测器,但新演化出的模块仍要在任务环境中执行评价;模型/工作流路由器只能在预定义选项间挑选。SHIFT 的独特切入:把结构、指令、工具三要素作为统一的联合搜索对象,训练一个基于真实执行结果的本地效用预测器,用它的预测(而非执行)驱动每个查询的 MCTS 前瞻搜索——在约 $1.5\times10^7$ 个候选脚手架中不执行任何候选就挑出一个,前瞻还能考虑「当前动作与后续动作的组合效应」。
核心方法
直觉上,搭脚手架就像下棋:每加一个智能体、一条指令或一个工具是一步棋,棋盘是当前的可执行图,赢法是终局「既准又便宜」的脚手架。技术路线分四步。第一,把脚手架表示为有向图 $G=(V,E)$:每个智能体 $v$ 有角色 $\rho_v$、有序指令列表 $D_v$、工具集 $T_v\subseteq K_d$,边 $(u,v)$ 把 $u$ 的输出传给 $v$,反馈边让下游智能体打回结果重做;每个中间状态都可执行,使搜索能比较不同构建阶段的设计。第二,一个本地小模型「架构师」(Gemma 4 E2B,冻结主干 + LoRA)读入查询、可用工具、可行动作和当前图的文本序列化(上限 2,048 token),末 token 隐状态 $h_\theta(q,s)$ 经两个线性头输出动作 logits 和价值 logit。第三,MCTS 用策略先验扩展节点、用预测价值回传,64 次模拟全程不调用执行器。第四,训练与 AlphaZero 同构:访问分布监督策略头,实测效用监督价值头,搜索与学习交替迭代。推理时只执行被选中的一个脚手架。
核心创新是把「执行」彻底移出按查询的搜索循环。以往要么执行候选(贵且无法摊销),要么放弃按查询定制。SHIFT 让架构师一次前向同时回答「下一步怎么搭」(策略 $\pi_\theta$)和「这样搭下去值不值」(价值 $V_\theta$),MCTS 的全部前瞻来自预测而非执行;由于图变换 $M$ 确定且无需运行,候选脚手架可以纯文本构造出来打分。训练上采用 AlphaZero 式自举——搜索访问计数 $p_i(a)=N(s_i,a)/\sum_b N(s_i,b)$ 作为策略目标、实测效用 $z_i$ 作为价值目标——并用一个成本感知效用 $R=\alpha u - b - \sum_x \gamma_x r_x$($\alpha=1.5$,$b=0.5$,五项惩罚分别对应 token、延迟、工具、智能体数、超时)作为价值头的学习目标。由于惩罚总和上限 0.58,成功脚手架效用至少 0.71、失败至多 0.25:成功永远压倒成本,成功者中更便宜者优先。这与 AgentSquare「预测器只辅助、新模块仍需执行」的路线有本质区别。
方法步骤详情
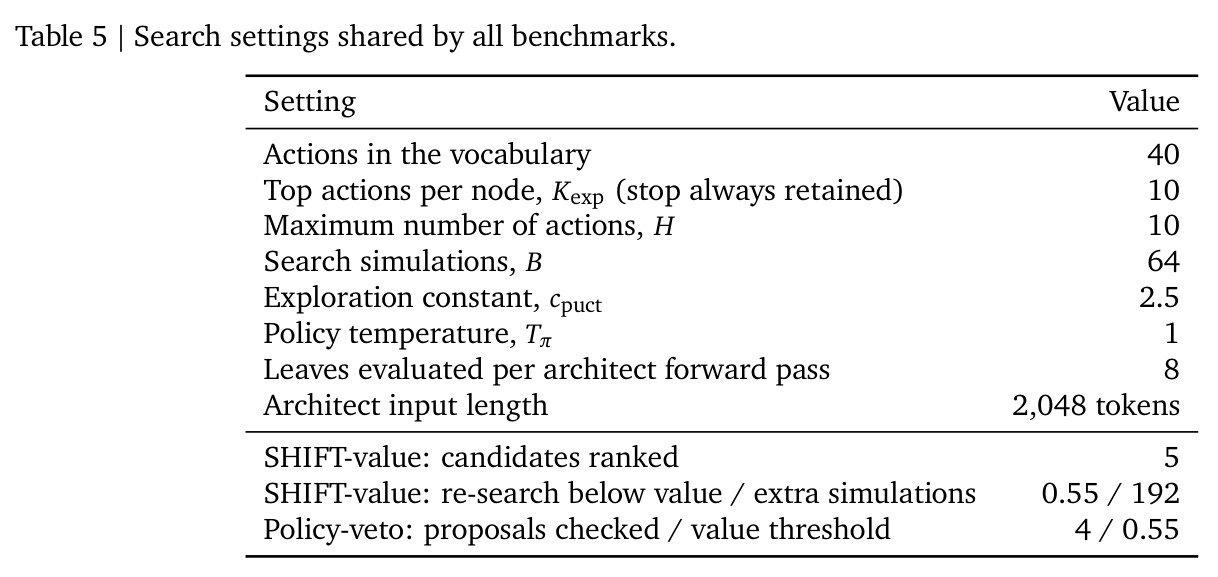
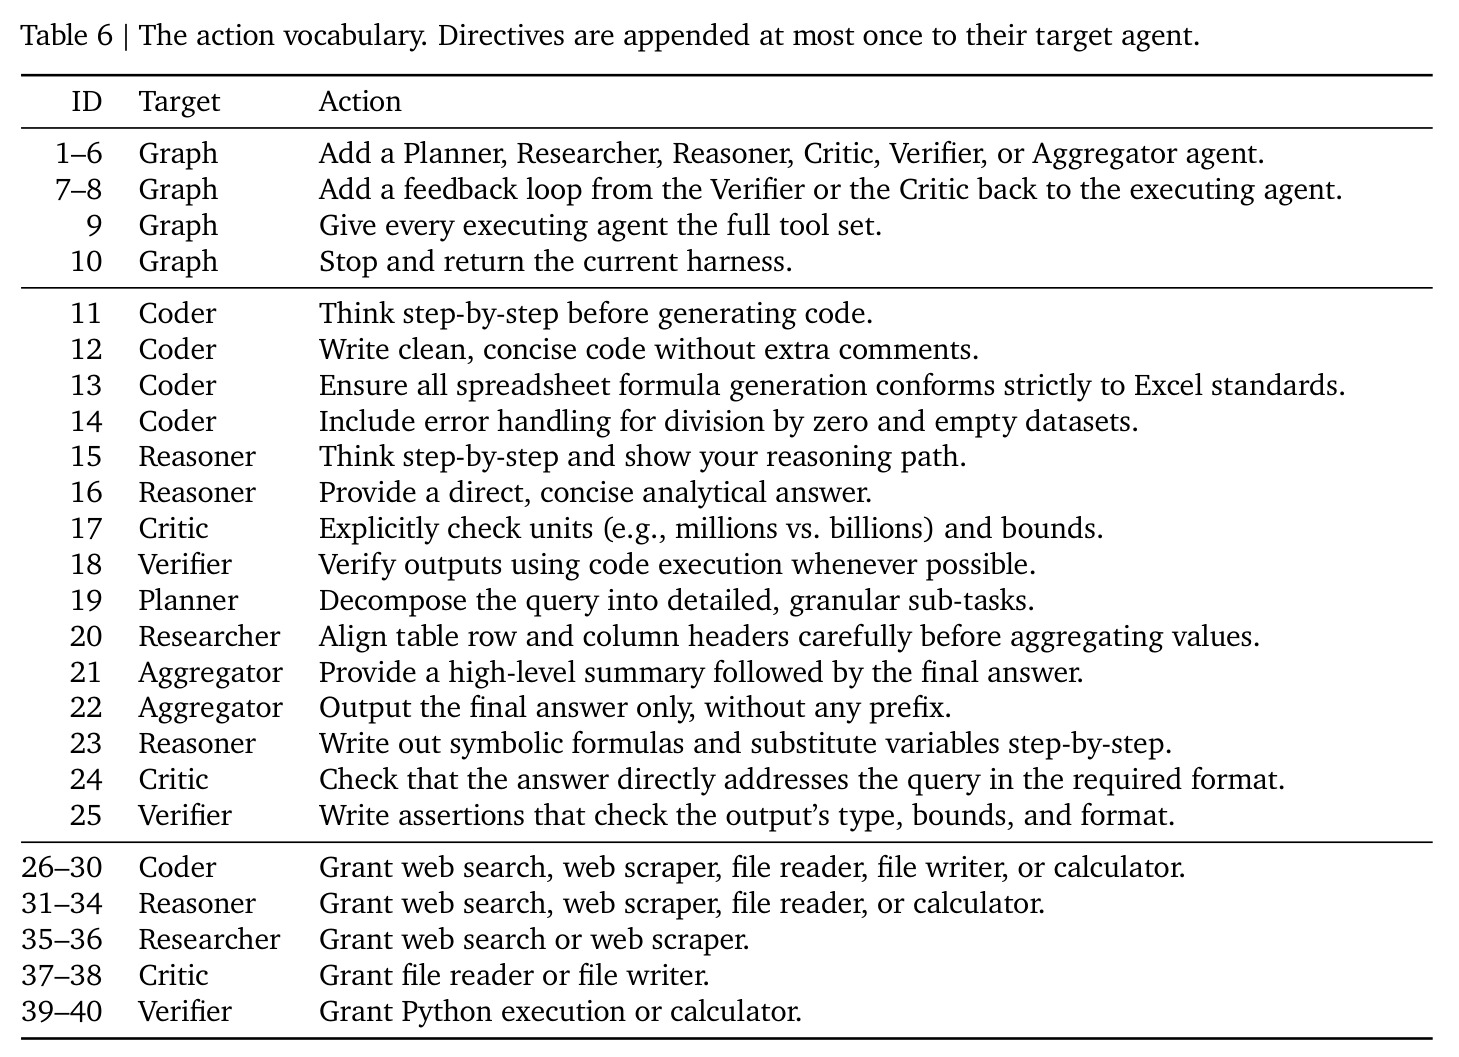
第一步,从种子 $s_0$(单个无工具 Coder)出发,动作库 40 个(Table 6):10 个结构动作(六种角色、反馈环、全工具集、停止)、15 条指令、15 个工具授予,至多 10 步。第二步,架构师读入查询、工具、可行动作与图的序列化(≤2,048 token),输出动作策略 $\pi_\theta$ 与价值 $V_\theta$。第三步,MCTS 跑 64 次模拟:按 PUCT 规则($c_{puct}=2.5$,每节点扩展 top-10 动作)下行,并行用虚拟损失防扎堆,预测价值回传更新统计量,零执行器调用。第四步,解码:SHIFT-search 执行访问最多路径末端;SHIFT-value 在 5 个候选中选预测价值最高者,低于 0.55 则以 192 次模拟再搜。第五步,训练 4 个 epoch:每个查询加 Dirichlet 根噪声搜索、按访问数采样路径,执行末端及至多 4 个候选,按成本感知效用(公式 7-8)存入优先回放缓冲;以访问分布交叉熵+熵正则+价值 BCE 更新,每 epoch 末加同查询排序 hinge 损失;只训 LoRA 与两个头。
技术新颖性
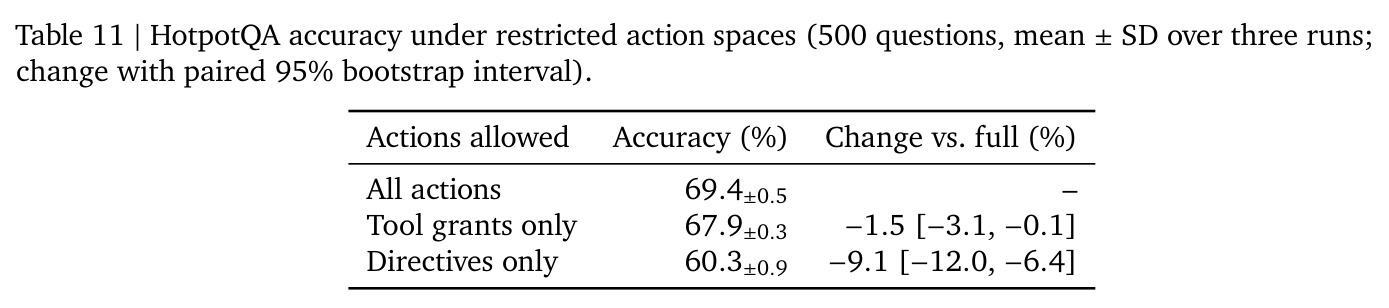
新颖性有四点。其一,搜索对象是可执行图本身:结构、指令、工具以单一动作空间联合搜索,而消融证明必须联合——HotpotQA 上只许加指令掉 9.1 个百分点、只许授工具掉 1.5 个百分点,指令决定「做什么」、工具决定「能做什么」、智能体决定「谁来做」,三者只有组合起来才产生增益。其二,免执行的多步前瞻:工作流优化的评估成本可以摊销到后续查询,而按查询设计不能,SHIFT 用确定性图变换 + 学习到的价值预测替代执行评估,把设计开销降到亚秒级本地推理,这在按查询场景是关键差异。其三,AlphaZero 式策略-价值自举首次用于脚手架合成,且策略监督信号与搜索过程同源(访问分布),训练中策略损失下降 35%–52%,说明策略越来越能预判自己搜索的走向。其四,成本感知效用设计:用基准相关参考尺度 $\rho_t$、$\rho_\ell$(GSM8K 3 万 token 对 OfficeQA 150 万 token)把相差两个数量级的域放到同一标尺,工具惩罚只按工具种类计、并对基准必需工具(如 OfficeQA 的文件读取器)豁免,让一个价值头同时学会「选对」和「选省」。
实验结果
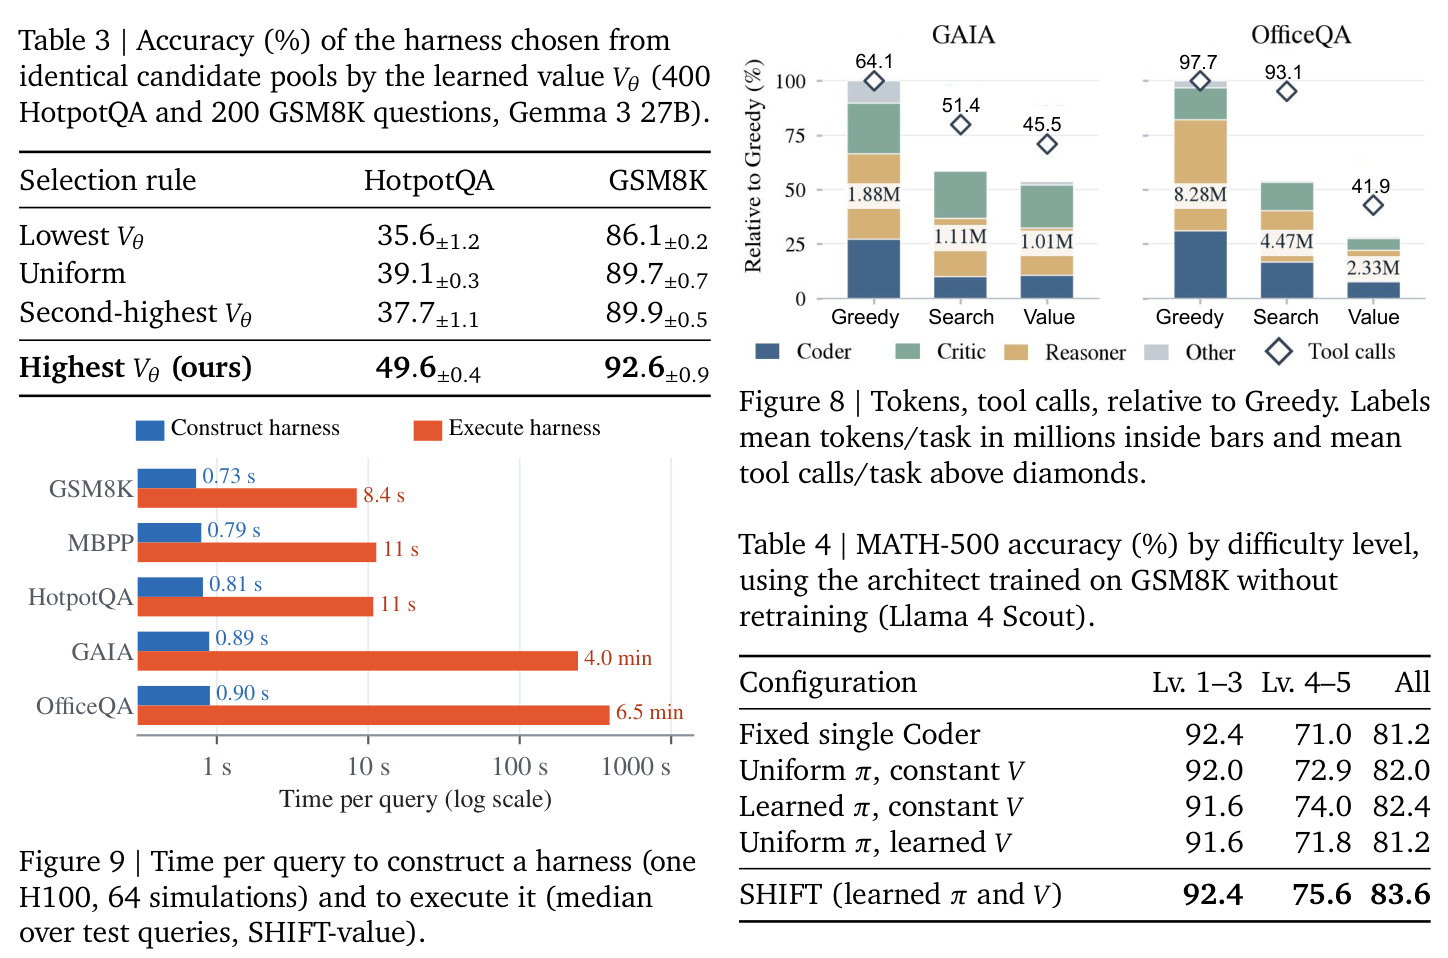
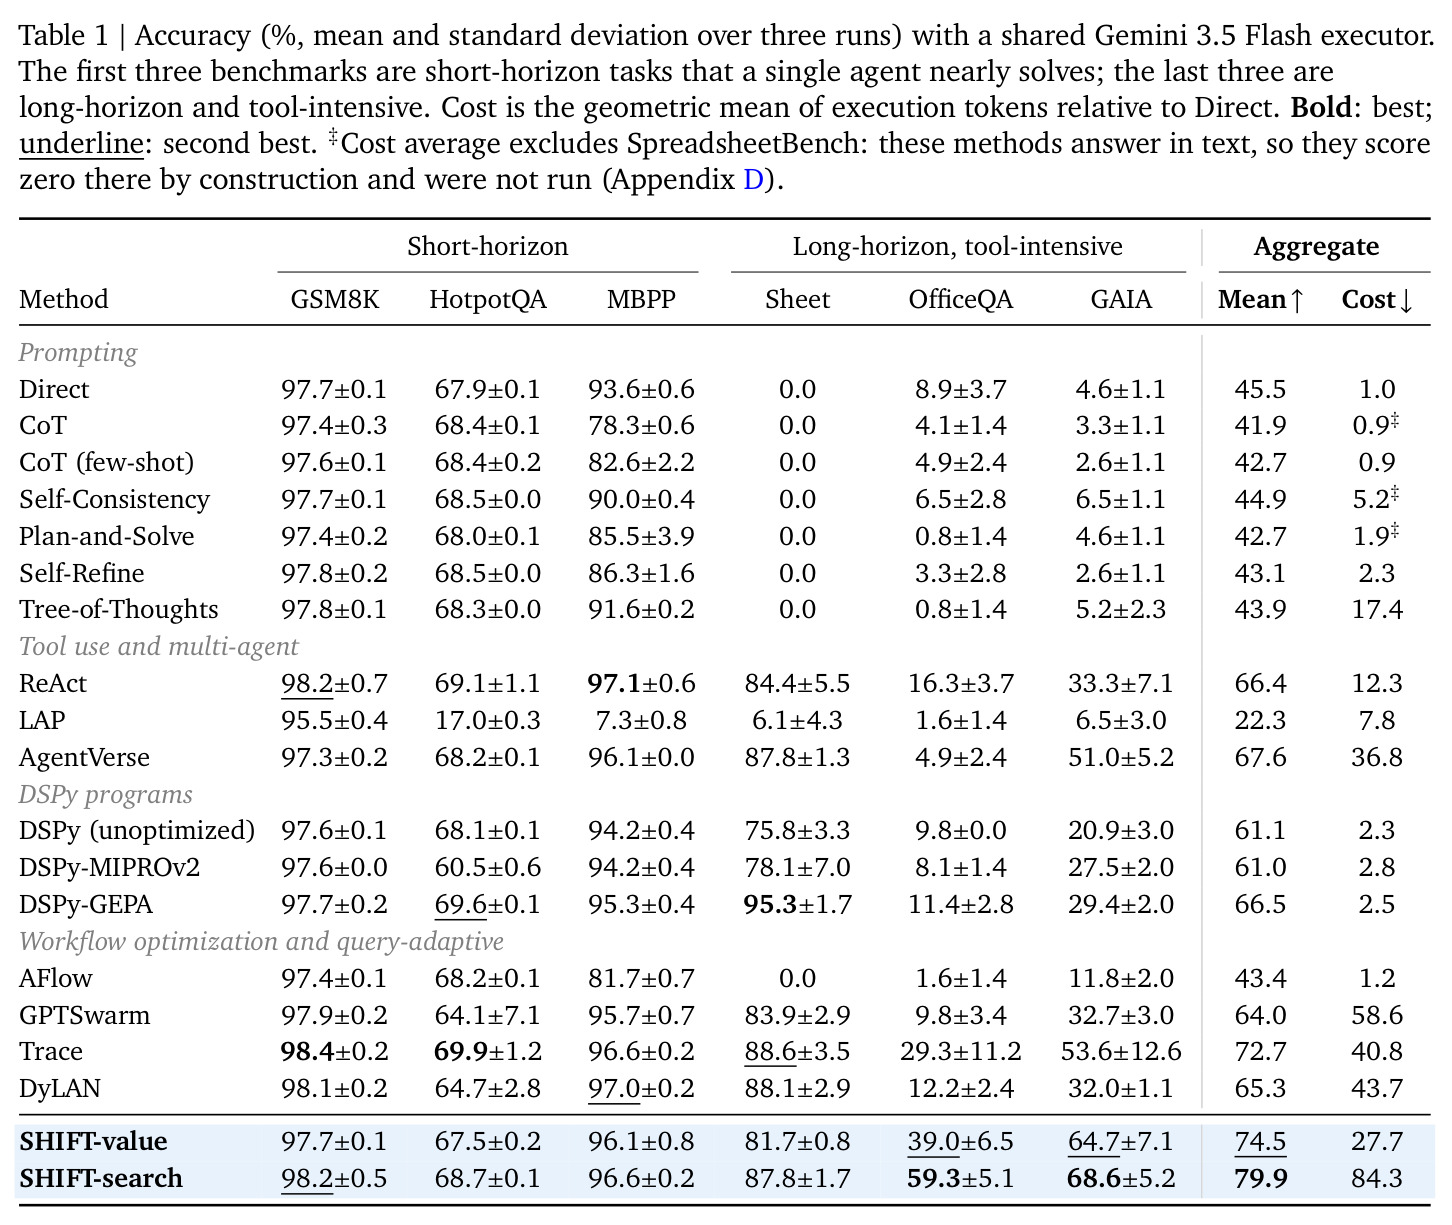
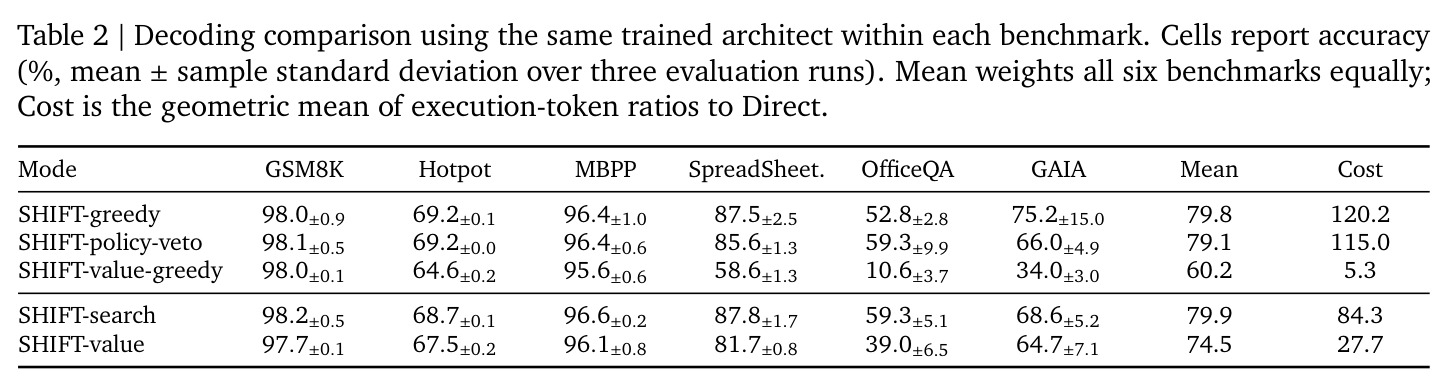
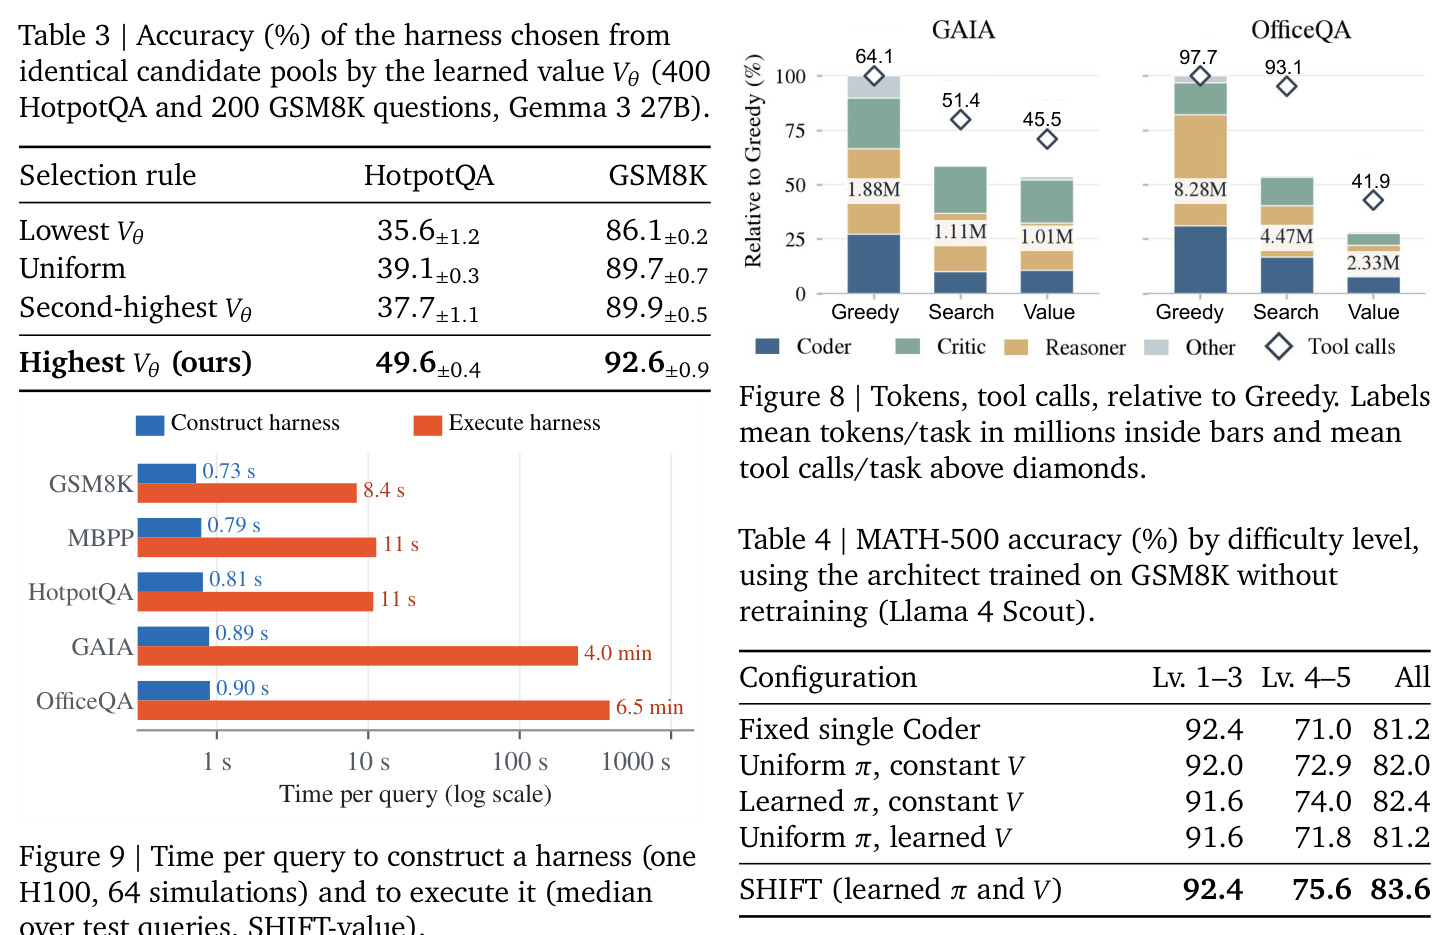
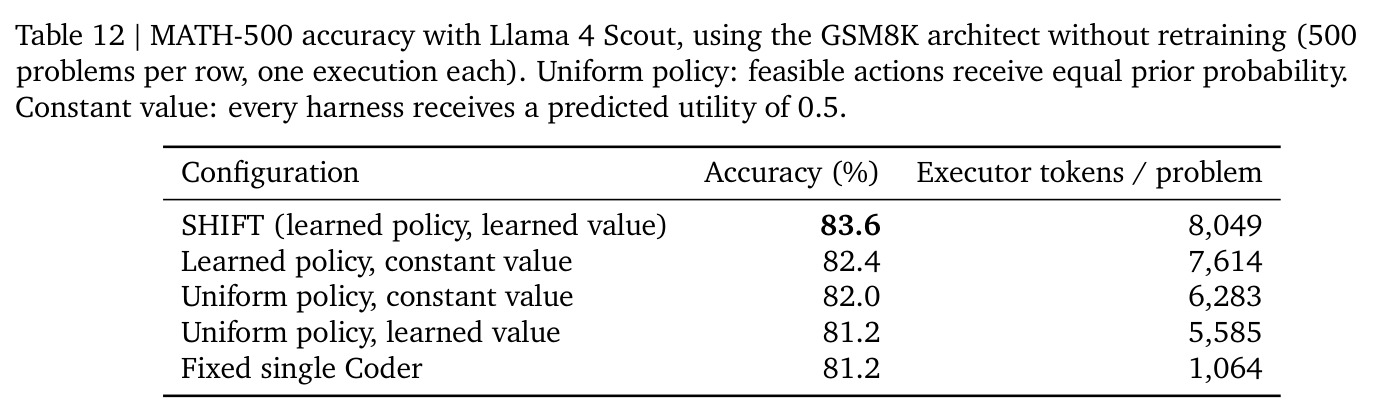
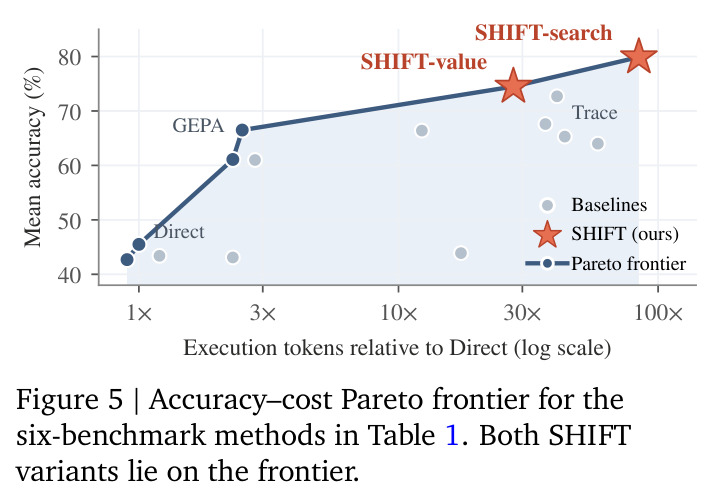
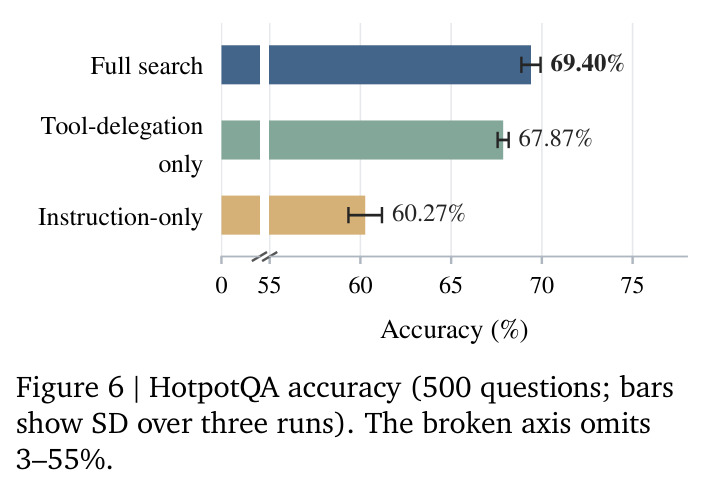
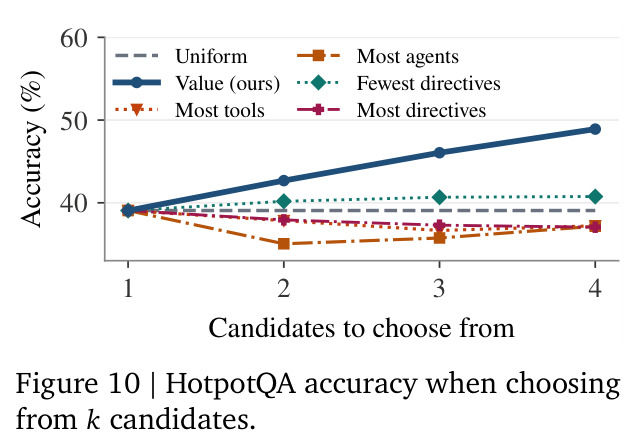
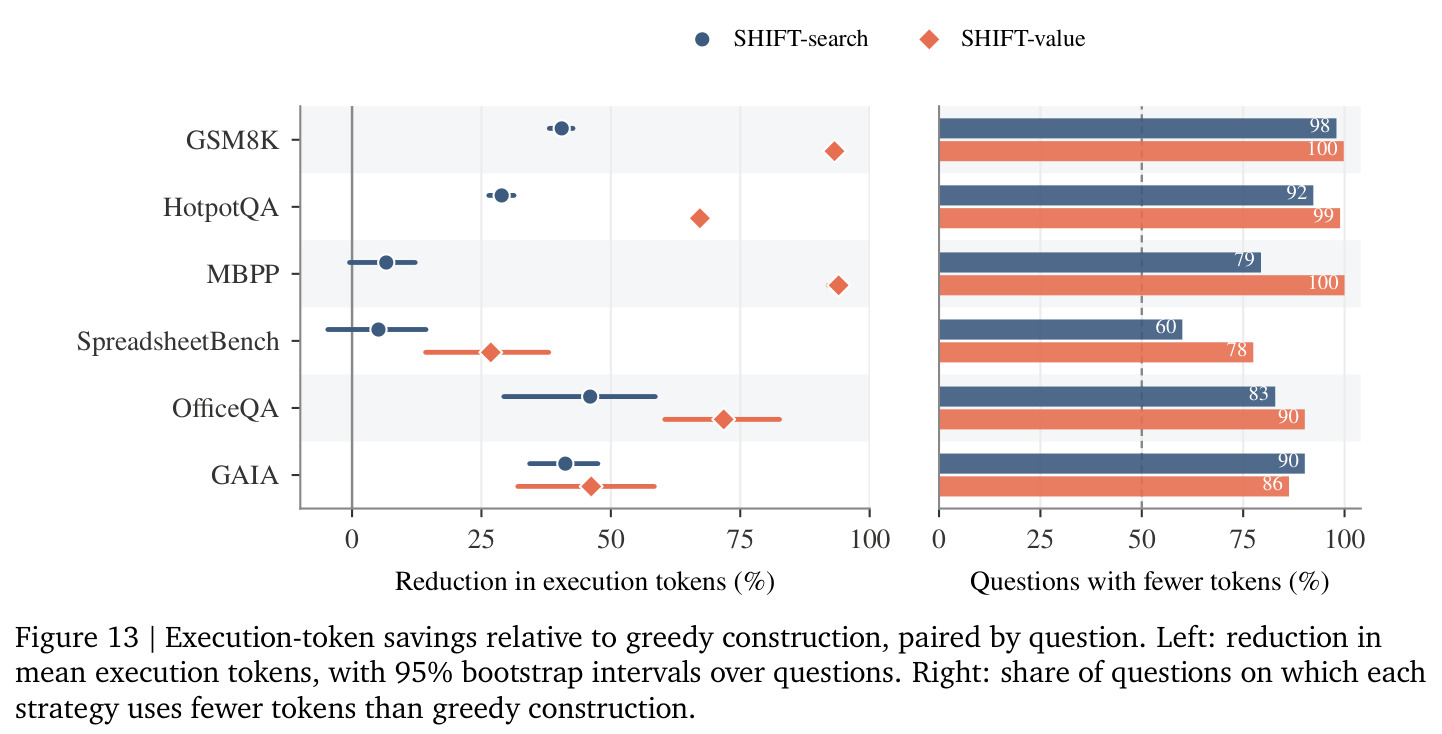
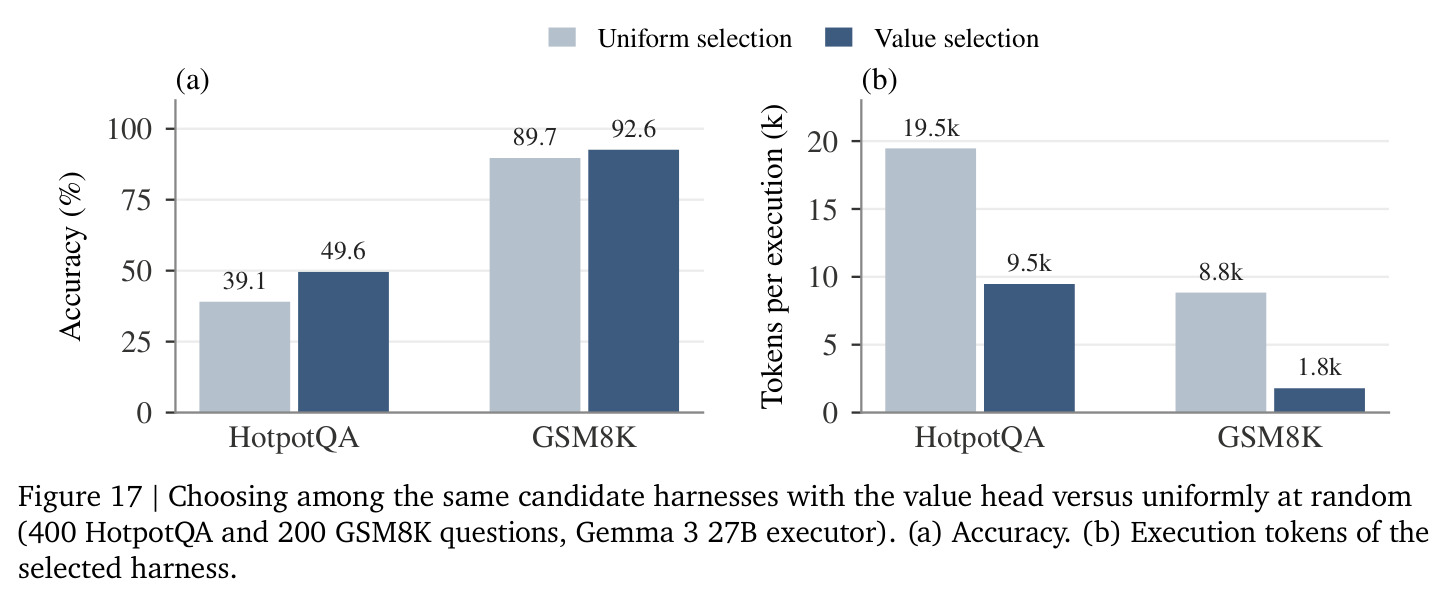
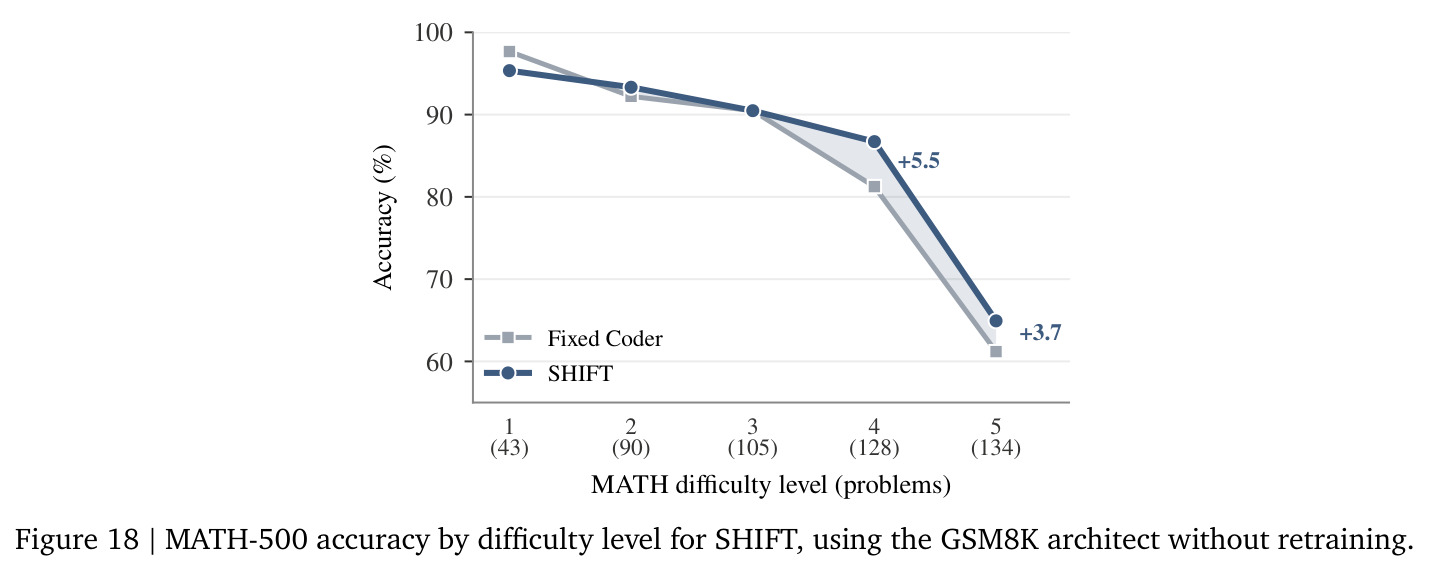
在 9,193 任务、6 基准、17 基线(共享 Gemini 3.5 Flash 执行器)下:(1)SHIFT-search 平均 79.9%,超最强基线 Trace(72.7%)7.2 个百分点,增益集中在长程工具密集任务——OfficeQA 59.3% 对 29.3%、GAIA 68.6% 对 53.6%,其余四基准差距 ≤1.2 个百分点。(2)SHIFT-value 平均 74.5% 仍超全部基线,token 比 Trace 少 32%(27.7 对 40.8)。(3)动作消融(500 题):全动作 69.4%、仅工具 67.9%、仅指令 60.3%,三要素联合选择是收益来源。(4)解码对比:搜索与贪心同精度但 token 少约 30%,纯价值贪心跌至 60.2%。(5)价值排序较均匀选择:HotpotQA +10.5% 且 token 减半、GSM8K +2.9% 且仅 1/5 token。(6)迁移:GSM8K 架构师免重训用于 MATH-500 达 83.6% 对 81.2%,Lv4–5 上 75.6% 对 71.0%。(7)构建每查询仅 0.73–0.90 秒。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六基准平均(GSM8K/HotpotQA/MBPP/SpreadsheetBench/OfficeQA/GAIA,9,193 任务) | 平均准确率(%) | SHIFT-search 79.9 | Trace 72.7(最强基线) | +7.2 个百分点(95% CI [4.4, 9.9]) |
| OfficeQA Pro 财务文档问答 | 准确率(%) | 59.3 | Trace 29.3(所有基线 < 30%) | +30.0 个百分点 |
| GAIA 通用助理任务 | 准确率(%) | 68.6 | Trace 53.6 | +15.0 个百分点 |
| 六基准平均(低成本档) | 平均准确率(%)与执行 token 成本(相对 Direct 的几何均值) | SHIFT-value 74.5%,成本 27.7 | Trace 72.7%,成本 40.8 | +1.8 个百分点且 token 少 32% |
| HotpotQA 动作空间消融(500 题) | 准确率(%) | 全动作 69.4 | 仅指令 60.3 / 仅工具 67.9 | 联合选择比仅指令高 9.1 个百分点 |
| 价值排序直接评测(400 HotpotQA + 200 GSM8K 题,Gemma 3 27B 执行器) | 所选候选准确率(%)与执行 token | 最高 $V_\theta$ 选择:49.6 / 92.6,token 9.5k / 1.8k | 均匀随机选择:39.1 / 89.7,token 19.5k / 8.8k | +10.5 / +2.9 个百分点,token 减半至 1/5 |
| MATH-500 迁移(GSM8K 架构师免重训,Llama 4 Scout) | 准确率(%) | 83.6(Lv4–5:75.6) | 固定单 Coder 81.2(Lv4–5:71.0) | 全体 +2.4,最难题目 +4.6 个百分点 |
局限与改进
作者承认:每个「基准 × 执行器」组合都要单独训练一个架构师,前期执行成本不低(OfficeQA 1,092 次执行、GSM8K/HotpotQA 各约 9,400 次,折合 440–6,200 次 SHIFT-search 答题的 token);价值头只用单次执行估计效用,噪声未做平均,作者提出未来用多次执行均值改进。我的补充观察:其一,SHIFT-search 自身执行成本很高(成本指标 84.3,约为 Direct 的 84 倍),高精度档只适合成本不敏感场景;其二,奖励权重(0.15/0.10/0.10/0.08/0.15)与逐基准参考尺度(Table 7)均为手工设定,换域需重调;其三,Figure 3 的结构敏感性来自搜索执行样本的观察性比较,只能说明结构与成功相关而非因果;其四,OfficeQA/GAIA 测试集仅 41/51 题,标准差达 ±5.1、±5.2,统计力有限;其五,动作库(6 角色、15 指令)是人工策划的,搜索上限受库质量约束;其六,架构师输入截断到 2,048 token,超长查询与大图信息不足。
独立分析的弱点
第一,逐基准重训:迁移实验只覆盖同域近邻(GSM8K→MATH-500),换执行器或任务族需整套重训,可混训多域数据得到以域描述和工具集为条件的通用架构师。第二,高精度档 token 开销 84.3×:成本敏感的线上服务不可用,可做自适应搜索预算(价值置信高就减模拟数)或把搜索策略蒸馏成单次前向的端到端脚手架生成器。第三,单次执行标签噪声:GAIA 等随机性大的任务上一次执行估效用方差大(SHIFT-value ±7.1),可对同一脚手架做 2–3 次执行平均或给价值头加不确定性惩罚。第四,小测试集统计力不足:OfficeQA/GAIA 仅 41/51 题,±5 个百分点的波动难以支撑细粒度结论,应扩充任务或多划分重复实验。第五,动作库封闭:角色与指令模板人工写死(Table 6),架构师无法发明新组件,可让其在文本空间自生成新角色/新指令并纳入动作空间。第六,奖励手工塑形:五项权重与参考尺度需按基准调,可用成本-准确率帕累托数据自动标定。第七,价值-贪心仅 60.2% 暴露价值头对延迟收益建模不足,可尝试多步回报式价值目标。
未来方向
作者明确提出两个方向:开发能跨数据集、跨执行器泛化的架构师,免去每个基准×执行器重复训练的成本;用同一脚手架多次执行的平均结果改进价值估计。基于本文成果还可延伸:把架构师与执行器协同进化——执行器升级后只需少量新执行数据微调 LoRA 即可适配;把「预测式前瞻」推广到其他每查询设计问题,如 RAG 流水线组装、数据库查询计划、微调超参推荐;从理论上刻画搜索预算与精度-成本的关系,回答「何时前瞻物超所值」;开放动作库让架构师自生成角色与指令;给价值头加不确定性估计以支持风险敏感选择;以及把训练-搜索循环改造为在线持续学习,当部署中出现新查询类型时自动扩展动作库与策略。
复现评估
论文未提及开源代码(版权页 © 2026 Google),复现依赖附录的详尽规格:动作库逐条列出(Table 6)、搜索配置完整(Table 5:64 模拟、$K_{exp}=10$、$H=10$、$c_{puct}=2.5$、每批 8 叶子、2,048 token 输入)、训练超参齐全(Table 8:LoRA rank 16、AdamW lr $10^{-4}$、4 epochs、回放缓冲 256、$K_{exec}=4$)、奖励公式与逐基准参考尺度(Table 7)。数据全部公开(GSM8K、HotpotQA、MBPP、SpreadsheetBench、OfficeQA Pro、GAIA、MATH-500),但三个基准的 55/15/30 随机划分需按论文给出的各 split 大小自行复刻。算力:推理搜索只需一张 H100 跑 Gemma 4 E2B;训练每基准需 1,092–9,400 次 Gemini 3.5 Flash 执行加 4 epoch LoRA 训练。总体难度中等偏上:算法细节完整,但工程量大,无官方代码是最大门槛。
论文图表
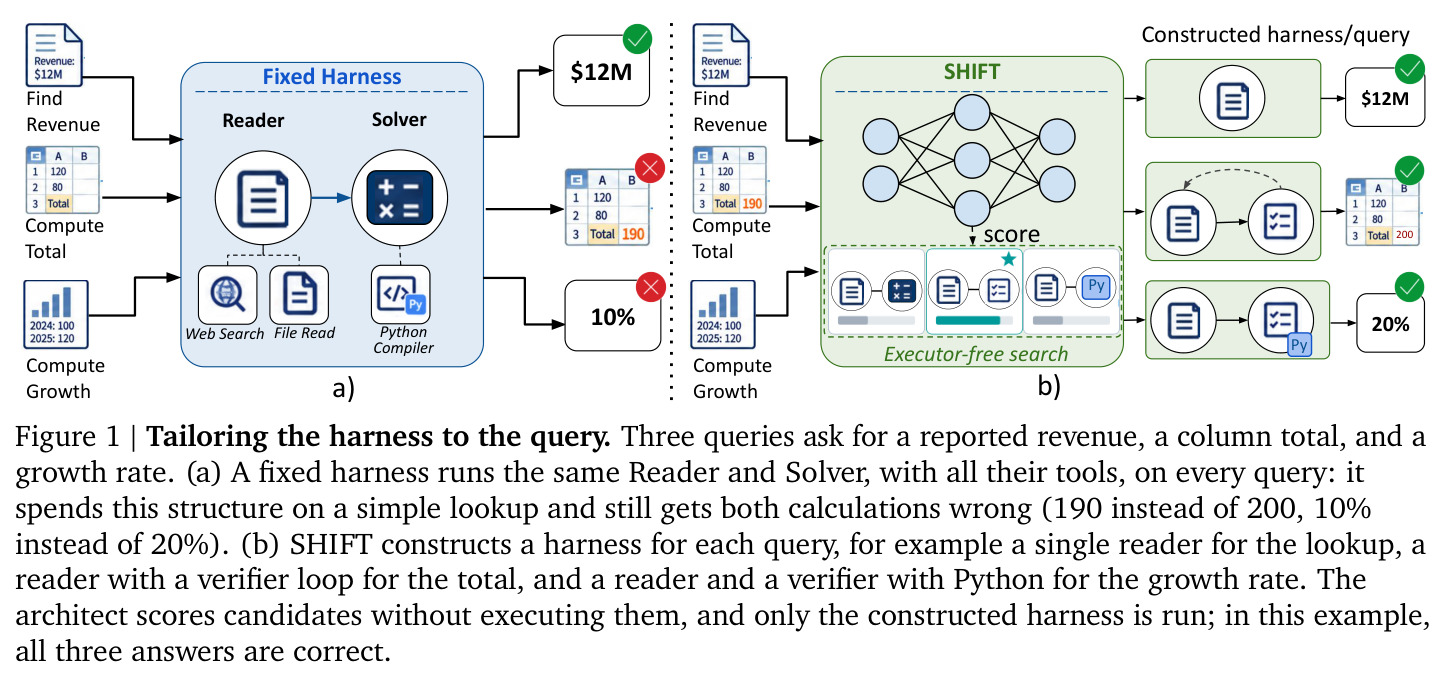
三个查询的对比示例:查报告中的营收数字、算列总和、算增长率。(a) 固定脚手架对三个查询一律跑 Reader+Solver 及全部工具,简单查数也被套上复杂结构,且两个计算都算错(190 而非 200、10% 而非 20%);(b) SHIFT 按查询构建——查数用单个 Reader,求和用 Reader 加验证环,增长率用 Reader+Verifier 加 Python——三个答案全对。架构师不执行候选即可打分,只有最终构建的脚手架被运行。
一图道明论文动机:正确的脚手架随查询而变,固定结构两头吃亏;同时预告了核心机制——预测式免执行搜索。
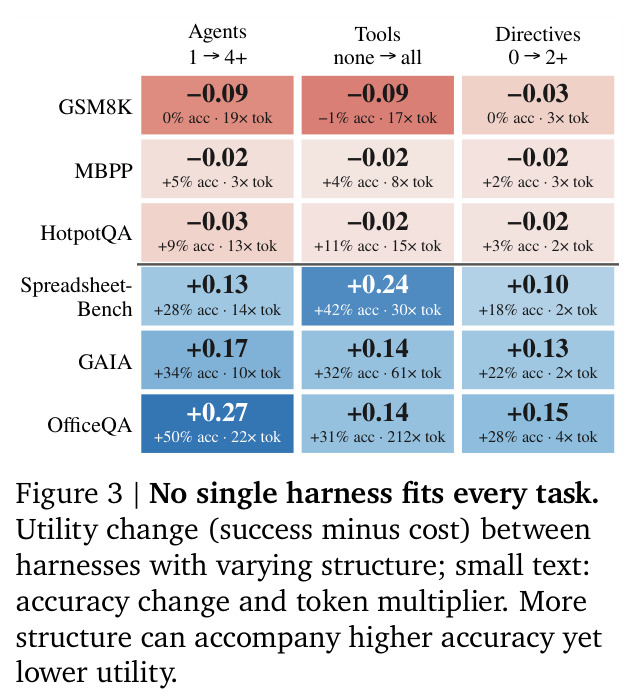
在五个基准上把脚手架按结构量分组(智能体 1→4+、工具 none→all、指令 0→2+),报告效用变化(成功减成本),小字标注准确率变化与 token 倍数:OfficeQA 加到 4+ 智能体准确率 +50% 但 22× token;GSM8K 加智能体效用 −0.09、19× token 且几乎无收益;SpreadsheetBench 上工具最关键(+42% 准确率、30× token),OfficeQA 上智能体最关键。
用数据量化「结构价值随任务剧变」,是按查询定制这一全文前提的直接证据。