MILO:基于编排式多智能体进化的智能体框架自动发现 MILO: Automated Harness Discovery via Orchestrated Multi-Agent Evolution
自进化的多智能体搜索自动重写智能体 harness,三大基准全面刷新 SoTA
前置知识
Harness(智能体框架/脚手架)
Harness 是包裹 LLM 的软件层,负责控制流与环境交互:执行模型提出的动作、管理提示词、工具、上下文与记忆,并处理派生子智能体、拦截工具调用、验证输出、决定何时停止等脚手架逻辑。它与模型权重完全解耦,通常是一个带 build_agent 入口的可运行 Python 程序。论文把智能体形式化为 $A = \langle M, h \rangle$,即模型 $M$ 加 harness $h$,$h$ 的空间是可数无限的。
本文全部目标是自动发现更优的 $h^\star$:只有理解 harness 与模型的边界,才能理解搜索空间 $\mathcal{H}$ 的定义、变异器作用的对象,以及“禁止任务特化硬编码”这一通用性约束 $\mathcal{C}$ 的含义。
LLM 驱动的进化搜索(ES)
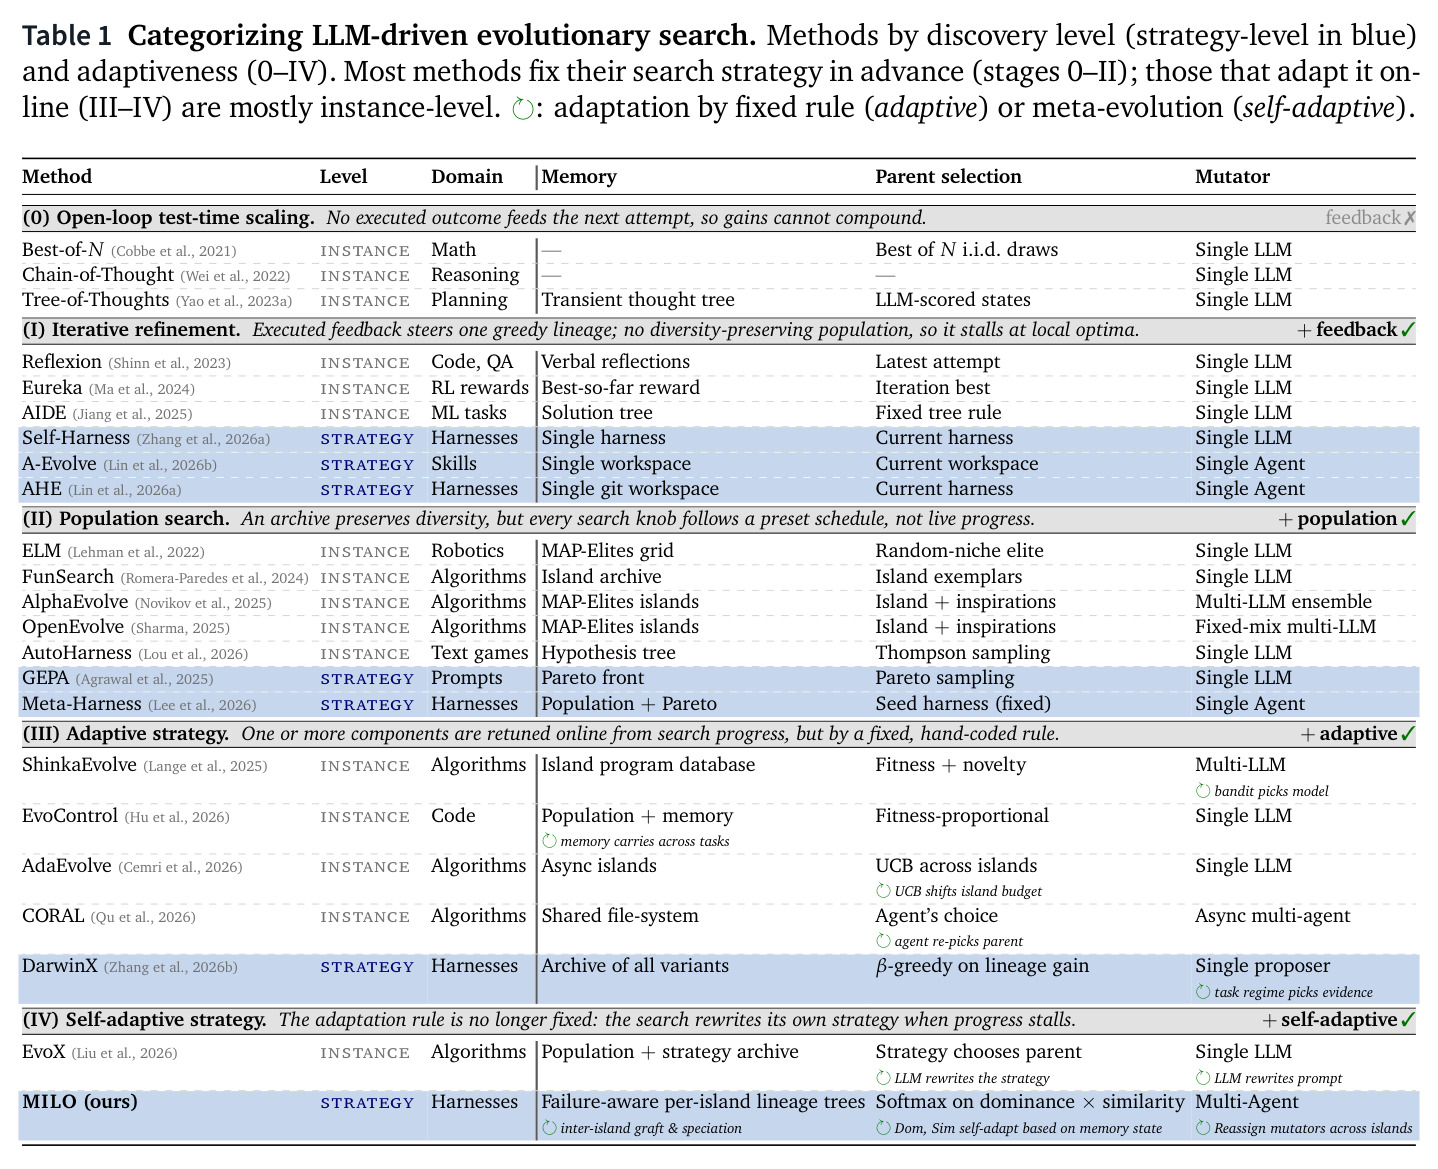
以进化算法为骨架、以 LLM 为变异器的搜索范式:变异器提出新候选,oracle 评分,结果引导下一轮。按优化对象分实例级(FunSearch、AlphaEvolve 为单个任务找更优解)与策略级(优化求解器本身,须跨任务分布泛化,AHD 属于后者)。按适应性又分 0–IV 五阶段:开环缩放、迭代精炼、种群搜索、按固定规则适应、以及由 LLM 重写策略的自适应。
论文用这套分类学(Tab. 1)定位自己与六条基线(GEPA、Meta-Harness、EvoX、OpenEvolve 等)的本质差异:MILO 是策略级且达到 Stage IV 自适应的搜索,理解该坐标系才能读懂其贡献声明。
岛屿模型与谱系记忆
岛屿模型把种群划分为多个孤立进化的子群(岛),各自维持独立谱系,仅偶尔交换个体,以抑制过早收敛、保留多样性。MILO 把每个岛的谱系存成节点/边带标签的树:节点记录 harness 的精度、成本、失败证据与接纳判定,边记录源代码补丁 $\delta_e$ 及其带来的 $\Delta\mathrm{acc}$、$\Delta\mathrm{cost}$;记忆只增不删,连被拒绝的候选也保留为负证据。
谱系树是 MILO 变异器的“全局视野”,是失败剪枝和“最弱种子长出最佳 harness”现象的载体;不理解其 append-only 结构就无法理解方法的核心卖点。
Pareto 支配与超体积(Hypervolume)
多目标优化中,若候选 $h$ 精度超过 $h'$ 超出容差 $\epsilon$,或两者在 $\epsilon$ 内持平而 $h$ 在所有成本轴(token、时延)上更优,则称 $h$ 支配 $h'$;非被支配集合构成 Pareto 前沿。超体积 HV 度量前沿覆盖的目标空间体积,新增候选的 $\Delta\mathrm{HV}>0$ 表示它扩大了被支配区域,即对前沿有正贡献。
MILO 的子代接纳准则就是 $\Delta\mathrm{HV}_j(h)>0$(式 7),父代选择分数 $\eta(h_1) = -\sum_{h_2} \mathrm{Dom}_{h_1 h_2}\mathrm{Sim}_{h_1 h_2}$ 也建立在支配矩阵与行为相似度上,是读懂算法五阶段的前提。
pass@k / PR@k / RR@k 评测指标
对 $N$ 个任务各跑 $k$ 次的智能体评测指标族:pass@k 只要某任务在任一次尝试中完全解出即计分;PR@k(pass rate)对所有尝试给部分得分均值;RR@k(resolution rate)统计完全解出的比例。误差条为任务聚类 95% 置信区间。长程基准如 Terminal-Bench 2.1(89 个命令行任务)以隐藏测试打分,超时按已达状态给部分分。
论文所有主表与提升数字(如 +12.0% RR@5、PR@k +14.8)都用这套指标定义,且“部分分”概念直接催生了 MILO 最佳 harness 的“脚手架地板”机制。
研究动机
现代智能体 = 模型 + harness,而 harness 工程仍是手工作坊:工程师靠人工检查失败、调整启发式,在组合爆炸的设计空间里迭代少数几个方案;Claude Code、Codex 这类生产级 harness 需要团队数月打磨,开源的 mini-SWE-agent、DeepAgents 也要持续维护。harness 的影响与模型本身相当——在 Terminal-Bench 上 GPT-5 配 Terminus-2 只解出 35.2%,配 Codex 达 49.6% 且少耗 35% tokens;且 harness 与模型强耦合,模型一升级就必须重新调参。已有的自动化尝试(AHD)依赖 LLM 进化搜索,但存在四个系统性缺陷:(1) LLM 变异器利用远多于探索,搜索多样性衰减、塌缩到少数设计变体,而长任务上的增益恰恰主要来自全局结构变异而非局部微调;(2) 失败盲视——OpenEvolve、AlphaEvolve 等只保留幸存者,失败方向被反复重试,而评估一个 harness 需数小时,每次评估都必须值回票价;(3) 搜索策略(父代选择、变异方式、保留规则)几乎全部事先固定,陷入局部最优无法逃逸,连最自适应的 EvoX 也只改父代选择这一环;(4) 几乎所有方法只优化精度,忽略 token 成本与时延,漂移向昂贵 harness——仅 EvoFlow 与 Meta-Harness 考虑 token,无一考虑时延。
本文的目标是给定黑盒模型 $M$(仅有推理接口)、初始 harness $h$ 与可选种子集 $\mathcal{H}_{init}$、按任务分布采样的基准 $\mathcal{B} = \mathcal{B}_{search} \sqcup \mathcal{B}_{val}$,MILO 要在预算 $R$(72 小时墙钟)内,于满足约束 $\mathcal{C}$ 的可数无限 harness 空间 $\mathcal{H}_\mathcal{C}$ 中搜索,输出最推进精度–成本 Pareto 前沿的 $h^\star$。约束要求候选可运行(validity)且通用(generality,禁止针对单个任务硬编码逻辑)。定量目标是在 Terminal-Bench 2.1、PaperBench-CodeDev、DeepSWE 三个长程基准上同时超越八个专家设计的 SoTA harness(Cline、OpenHands、Terminus-2 等)与六种 SoTA 进化搜索方法,覆盖前沿闭源(Opus 4.8)与开放权重(gpt-oss-120b)两种骨干,并在开放数学问题上刷新人类最好已知界,最终指向无需重训模型即可获得更强、更省、可复用智能体的愿景。
与已有工作不同的是,论文的独特切入点是“元进化”:不只进化 harness,还把搜索策略本身(谱系记忆、变异器分配、评测课程)作为进化对象,在已知 ES 中适应范围最广。三个具体设计前所未有:(1) 岛屿谱系森林以 append-only 方式保留包括被拒绝候选在内的全部历史,把失败变成负证据,反过来推动更大胆的结构重写——而 FunSearch/AlphaEvolve/OpenEvolve/GEPA 只存幸存者;(2) 各岛分配互不相同的变异器智能体(Claude Code、Codex、DeepAgents 变体共六个),把单个 LLM 的利用偏置隔离在本岛内、岛屿间只共享成功思想而从不竞争生存——实验显示最弱的种子岛反而长出全场最佳 harness(39.2% 种子→59.9%);(3) 引入 orchestrator 智能体,在岛屿停滞时诊断四类瓶颈(干涸变异器、耗尽谱系、被挤出的小生境、整体平台期)并执行 Reassign/Graft/Speciate/Curriculum 四种干预。按论文的适应性分类学,这是首个在策略级 harness 发现中达到 Stage IV 自适应的框架。
核心方法
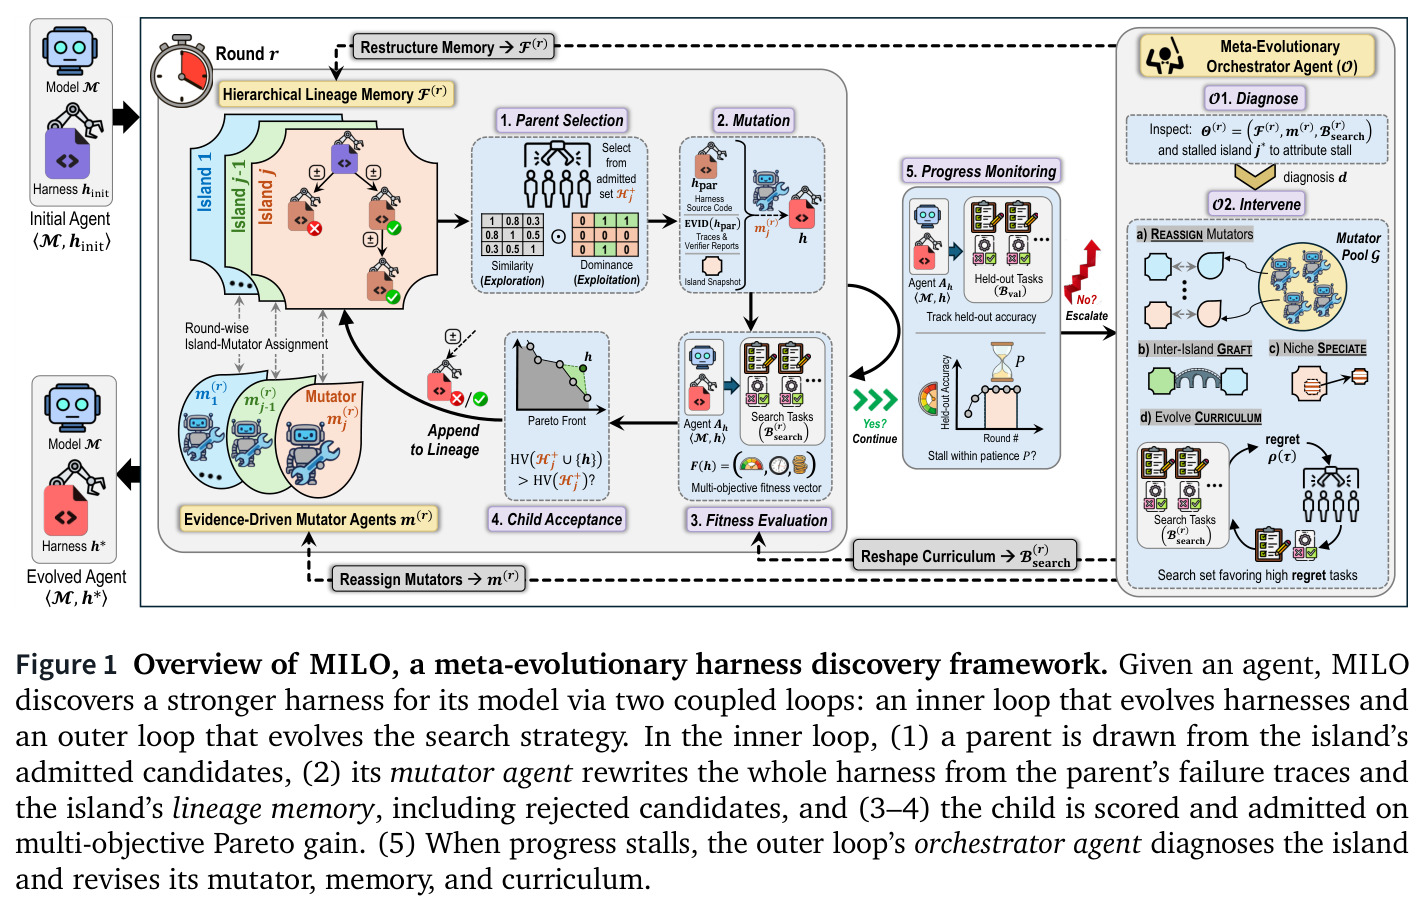
直觉:把 harness 工程当作可自动搜索的程序合成问题,但搜索器本身也要会学习。MILO 由内外双循环构成(图 1)。内循环是逐轮进化的主循环:$K=3$ 个岛各自从行为最不相似的三个专家种子 harness(B10 子智能体角色、B11 计划-求解门、B12 先复现-评分门)出发独立生长,每轮经历五阶段——按“支配×行为相似度”软最大采样父代、证据驱动的变异器智能体重写整个 harness、在搜索集上跑 $k=3$ 次 rollout 评估多目标适应度、以正超体积贡献 $\Delta\mathrm{HV}>0$ 决定是否接纳子代、在 held-out 验证集上监控进展并维护停滞计数器。外循环是元进化:当某岛连续 $P=3$ 轮无验证集增益,orchestrator 智能体接管,先诊断瓶颈类型(诊断 $d \leftarrow \mathcal{O}_1(\Theta^{(r)}, j^\star)$),再执行至多两种干预($\omega \leftarrow \mathcal{O}_2(d)$),从机制上改写搜索配置 $\Theta^{(r)} = (\mathcal{F}^{(r)}, m^{(r)}, \mathcal{B}^{(r)}_{search})$。整个系统在一台 192 vCPU 的纯 CPU 机器上运行,模型推理全部走远程 API(Amazon Bedrock),单次搜索预算 72 小时,与所有基线相同。
核心创新是“失败也是证据”与“搜索策略可进化”两点。其一,与只存幸存者的既有方法不同,MILO 的谱系记忆 append-only:每次变异的补丁 $\delta_e$ 及其导致的 $\Delta\mathrm{acc}$、$\Delta\mathrm{cost}$ 都记在树边上,被拒绝的子代带 $\mathrm{Adm}(h)=0$ 留在树里。变异器由此知道哪条路已死——论文最佳 harness 的注释里就写着“向验证器提示词追加 2777 字符、得分 -0.044 被拒,此路不通”,从而避免重复失败、敢于做结构性重写而非局部润色。其二,进化搜索的策略参数通常手工固定;MILO 让 orchestrator 智能体在停滞时重写 $\Theta^{(r)}$:诊断四种瓶颈(干涸变异器→换变异器 Reassign;耗尽谱系→从强岛嫁接 Graft;小生境被挤出→物种分化 Speciate;整体平台期→换高遗憾值任务课程 Curriculum),其中遗憾值 $\rho(\tau) = \max_{h\in\mathcal{H}^+}\mathrm{Acc}(h,\tau) - \mathrm{mean}_{h\in\mathcal{H}^+}\mathrm{Acc}(h,\tau)$ 在“少数 harness 能解、多数不能”的前沿任务上最大。这把 ES 的自适应从硬编码规则(Stage III)提升为 LLM 元推理(Stage IV),也是消融中贡献最大的组件(RR@5 从 80.5% 提到 86.1%)。
方法步骤详情
每轮每岛按式 (4) $h \leftarrow m_j^{(r)}(h_{par}, \mathrm{Evid}(h_{par}, \mathcal{B}^{(r)}_{search}), \mathcal{L}^{(r)}_j)$ 执行五阶段。(1) 初始化:从种子集按行为向量 $b(h) \in [0,1]^{|\mathcal{B}_{search}|}$ 选最不相似的 $K=3$ 个 harness 各建一岛,从六个变异器的池 $\mathcal{G}$ 中随机分配;(2) 父代选择:对岛内已接纳集合 $\mathcal{H}_j^+$ 按 $\eta(h_1) = -\sum_{h_2} \mathrm{Dom}_{h_1 h_2}\mathrm{Sim}_{h_1 h_2}$ 打分、温度 $T=1$ 软最大采样——被支配次数少(利用)且行为独特(探索)者更易当选;(3) 变异:变异器是多轮编码智能体,输入为父代源码、父代失败轨迹与岛谱系的缩进树快照(含每条边的补丁与增益标签),先诊断失败模式,再从局部修补到控制流重写任选其一行动,产出满足约束 $\mathcal{C}$ 的子代,每次变异限时 45 分钟;(4) 评估:子代在搜索集每个任务跑 $k=3$ 次,记录精度、成本与证据,构造适应度向量 $F(h)$(精度 + 各成本轴经济性 $1-\mathrm{Cost}_i/c_i$,成本上限 $c_i$ 为 20M token、7200 秒);(5) 接纳:仅当 $\mathrm{Adm}(h) = \mathbf{1}[\Delta\mathrm{HV}_j(h)>0]$($\epsilon=0.02$ 容差、精度优先)才入树,否则以负证据身份入树;(6) 监控与编排:被接纳者重测 $\mathcal{B}_{val}$,$P=3$ 轮无提升即触发 orchestrator 诊断-干预(每次至多两种动作),并复位全部停滞计数器。
技术新颖性
与已有方法的本质区别可从四轴看。搜索空间:GEPA 只改提示词、A-Evolve 只改技能/记忆文件,MILO 重写整个 harness 文件;实验中只改提示词/评分表的方法(GEPA、ShinkaEvolve、EvoX 的最佳 harness 与种子只差提示与评分表)最多 +3.6% RR@5,而 MILO 的最佳 harness 直接重写控制流(先产出最小可用交付物、临近截止期分流、独立验证后才停止),+12.0%。证据利用:OpenEvolve/ShinkaEvolve/EvoX 只暴露父代源码加少量精英;Meta-Harness 无父代选择——所有候选都编辑根节点,连谱系树都无法形成;MILO 是唯一组合谱系历史与执行反馈的。适应性:EvoX 虽属 Stage IV 但只重写实例级策略,课程、变异器皆固定;DarwinX、ShinkaEvolve 的适应靠硬编码规则;MILO 在策略级同时重写记忆(Graft/Speciate)、变异器(Reassign)与课程(Curriculum),且 Graft 被拒后仍作为负证据留存。目标函数:仅 EvoFlow 与 Meta-Harness 考虑 token,无一考虑时延;MILO 把精度、token、时延统一进 Pareto 接纳,最终以 0.74× tokens 换 +12.0% RR@5,是唯一“又强又省”的搜索。
实验结果
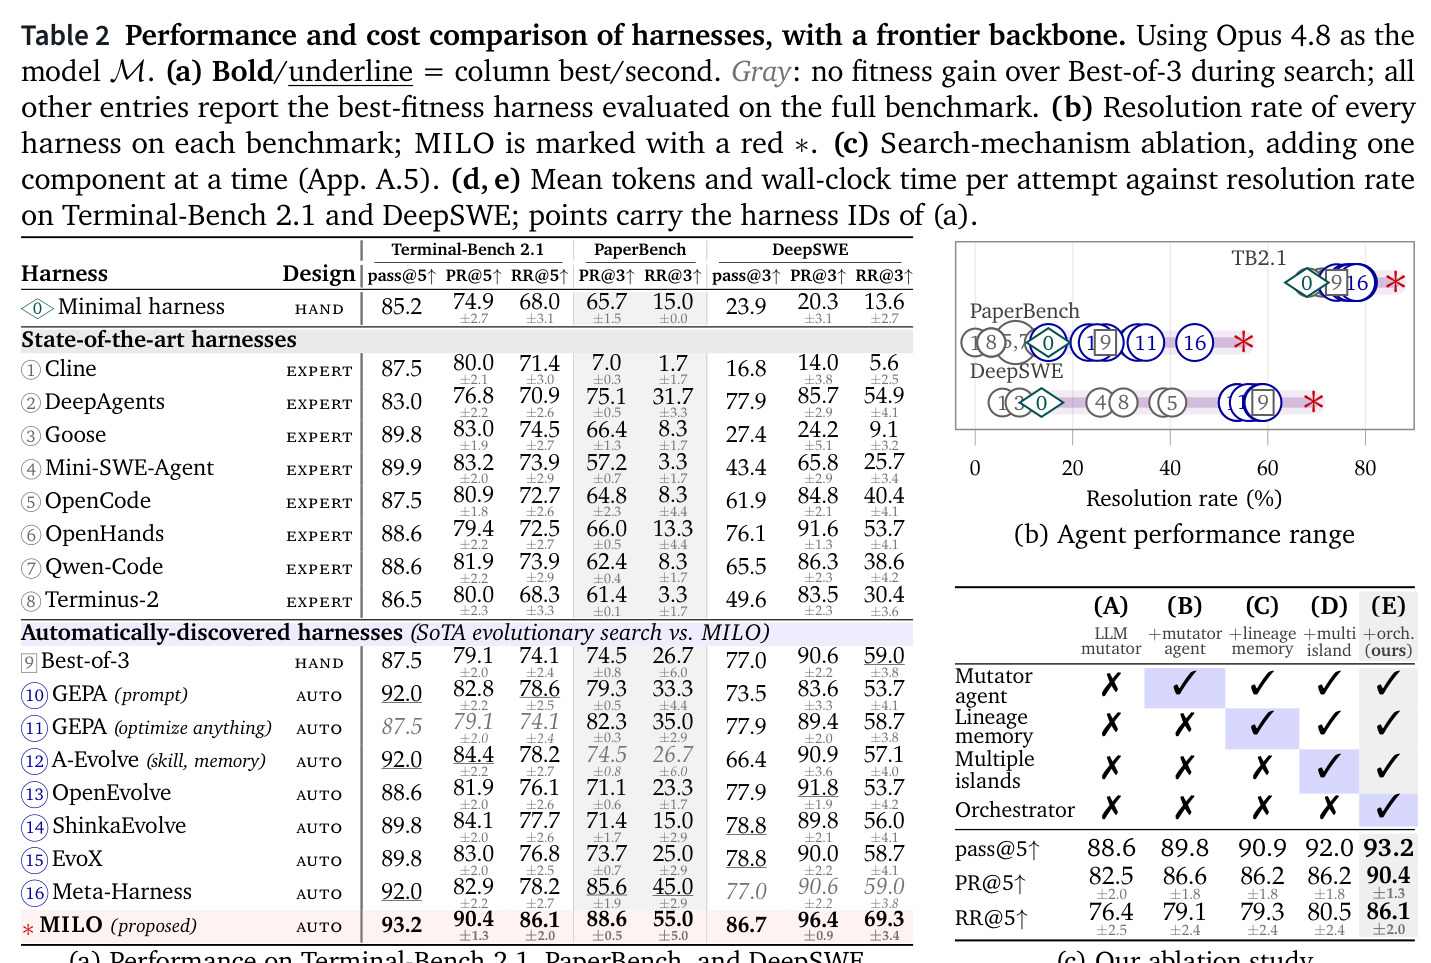
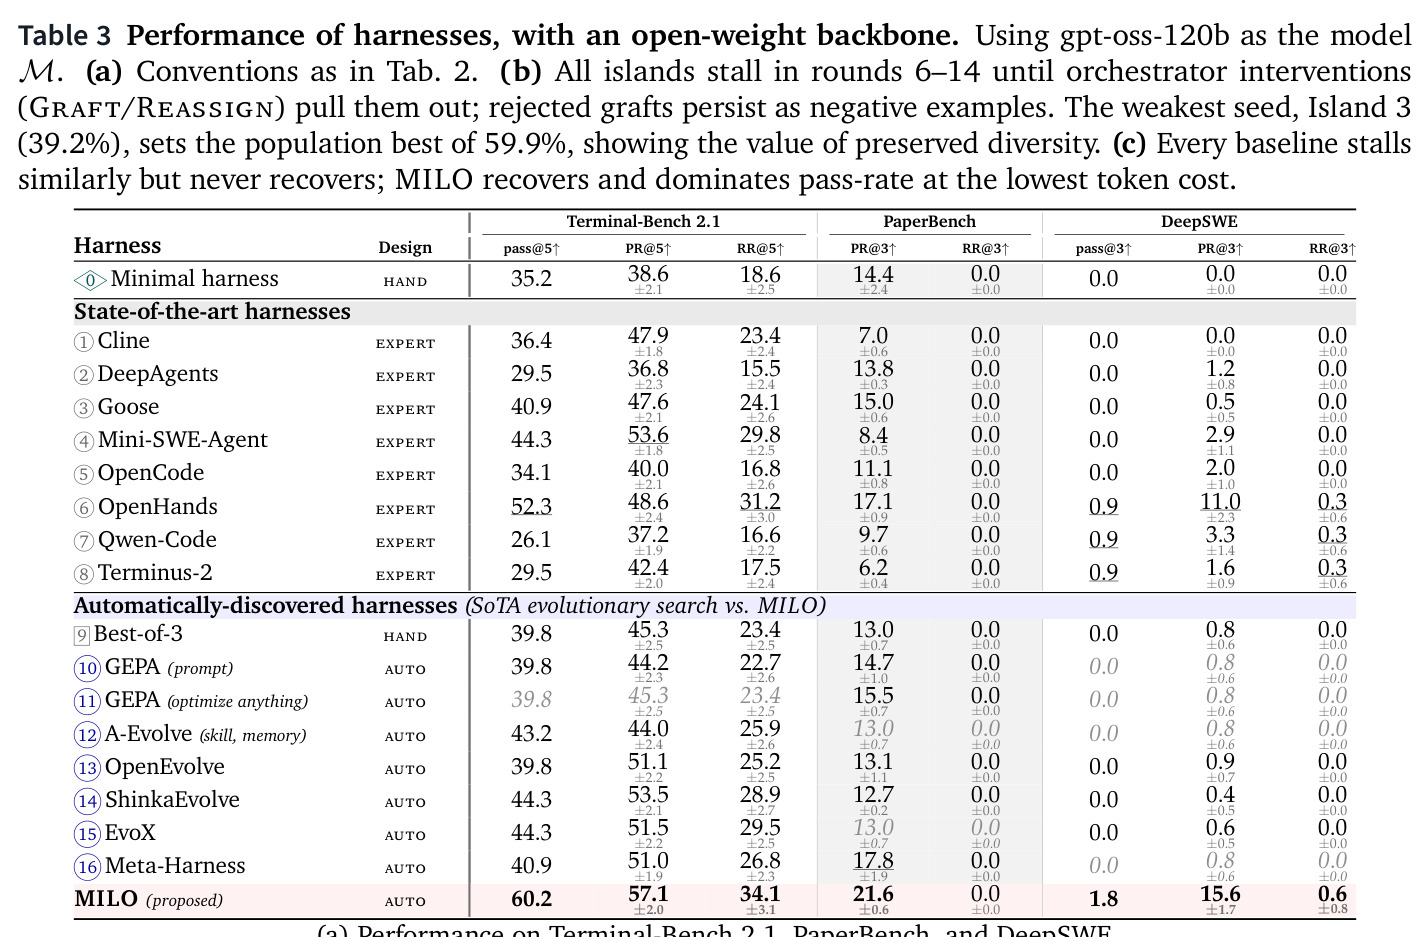
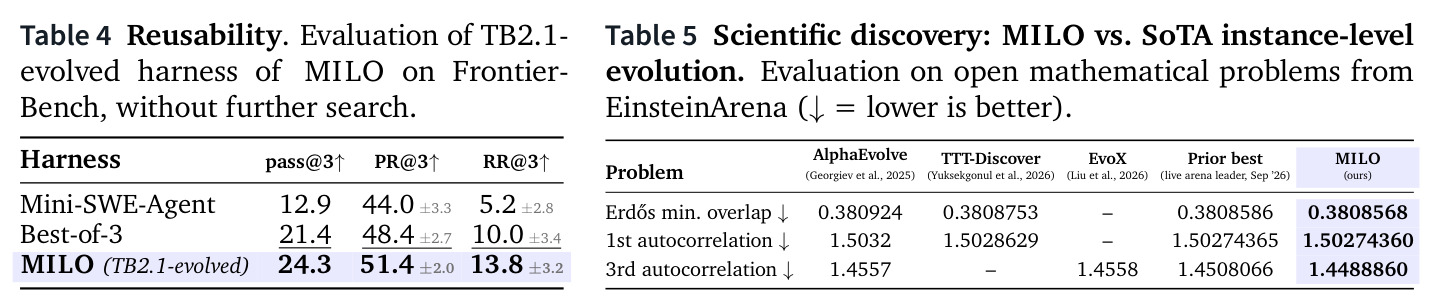
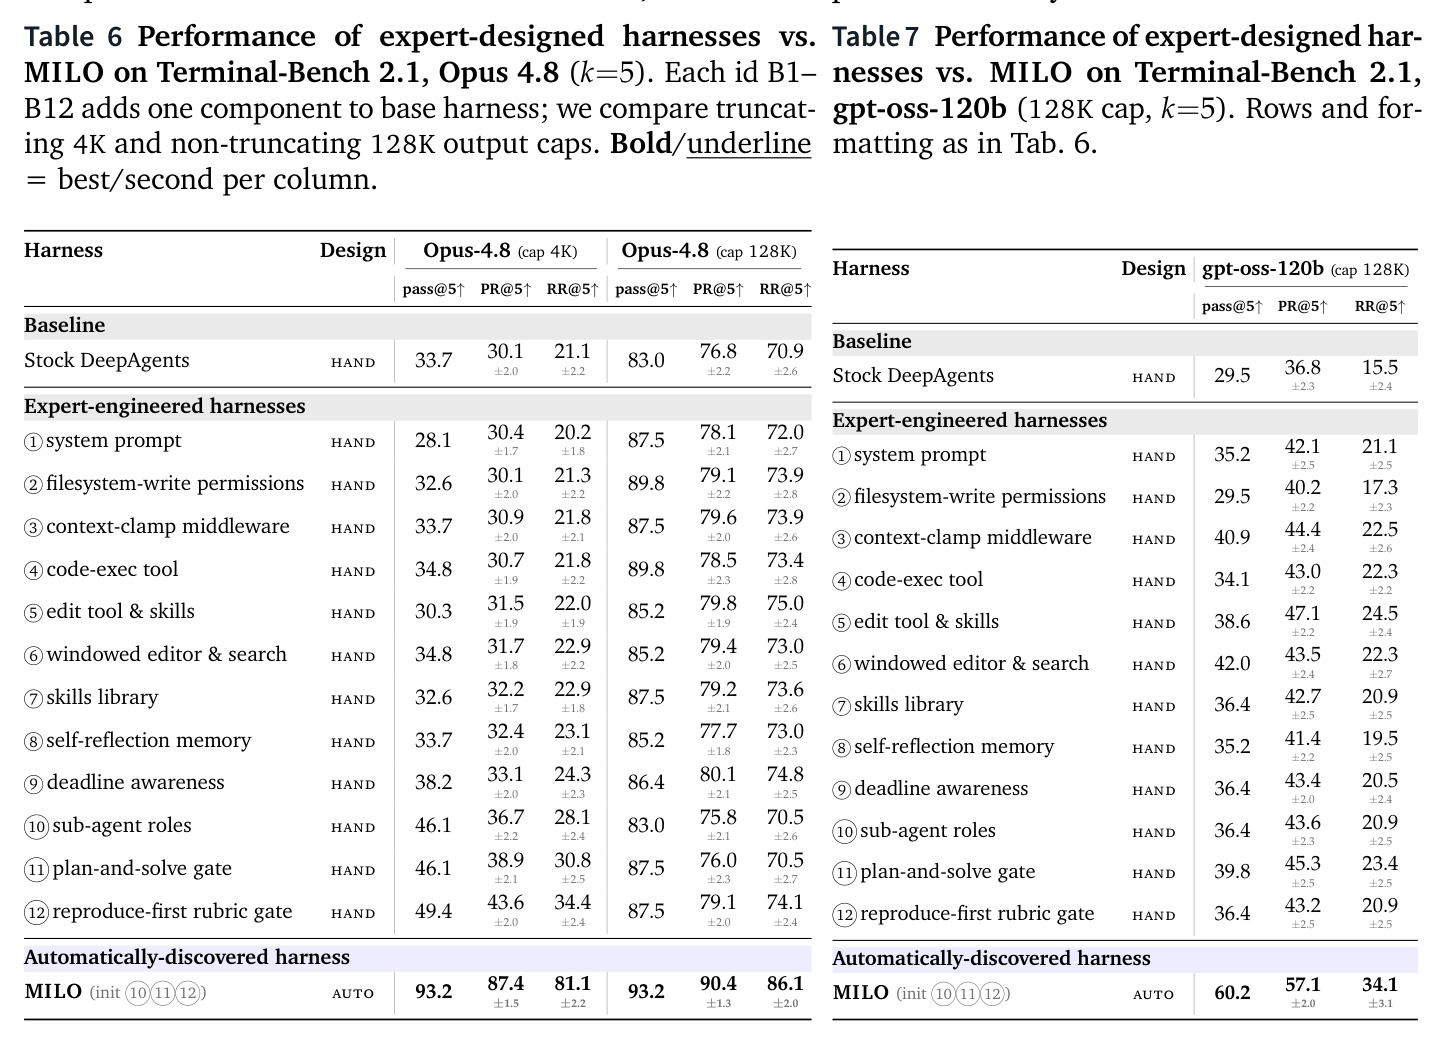
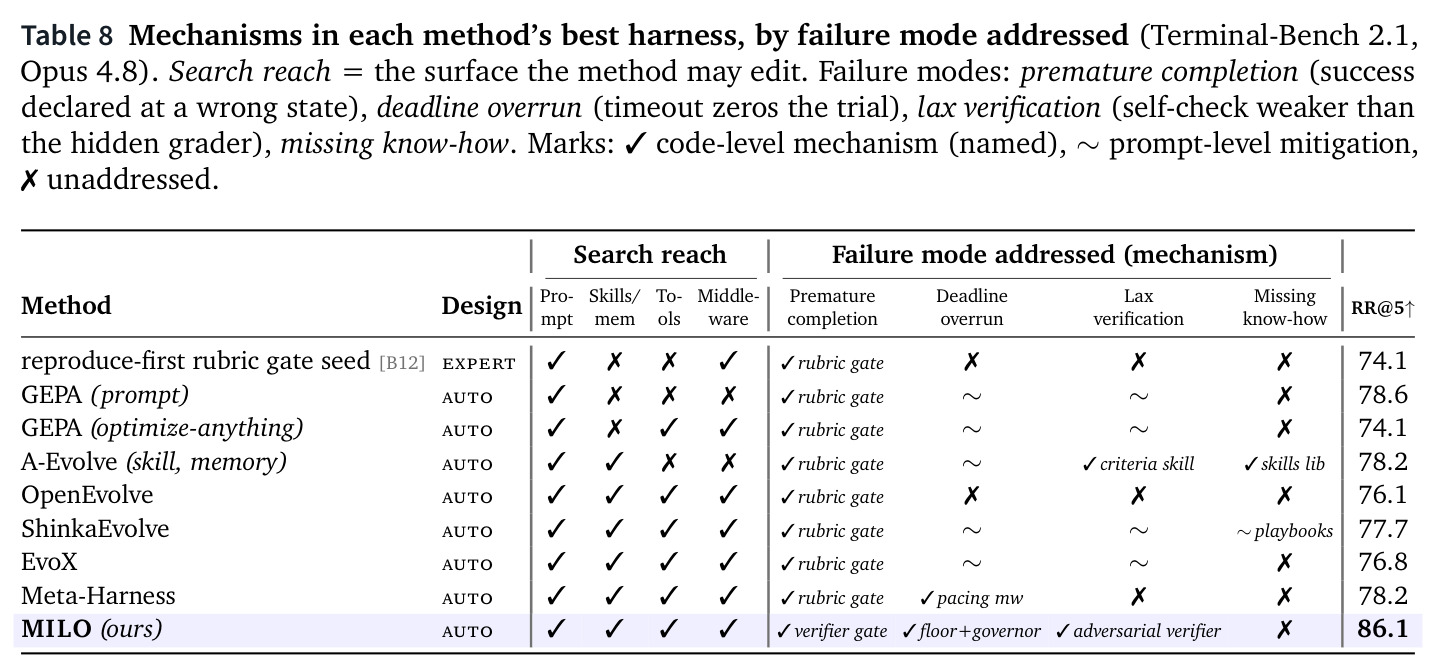
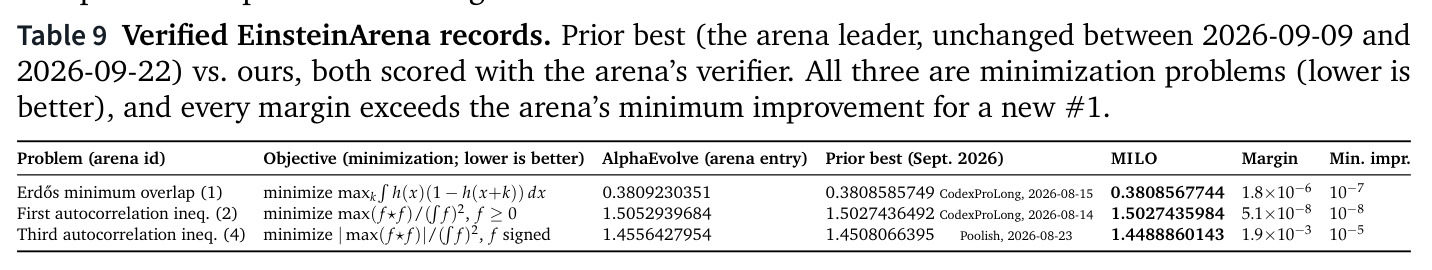
(1) 主结果:Opus 4.8 骨干下,MILO 相对 Best-of-3 种子在 TB2.1/PaperBench/DeepSWE 的分辨率率分别 +12.0%(74.1%→86.1%±2.0)、+28.3%(26.7%→55.0%±5.0)、+10.3%(59.0%→69.3%±3.4);此前最佳搜索仅 +4.5%(GEPA)、+18.3%(Meta-Harness)与 0%(无提升)。TB2.1 的 86.1±2.0 超过官方排行榜榜首 83.8±2.3,且只耗初始 harness 74% 的 tokens。gpt-oss-120b 下 MILO 的 PR@k 分别 +11.8/+8.6/+14.8 个百分点,DeepSWE 达 15.6%,约为初始 harness 的 20 倍,而所有基线 <1%;所有对比方法的最佳 harness 都比种子更耗 token(EvoX 1.46× 只换 +6.1% RR@5),MILO 却以 0.70× tokens 拿到 +10.7%。(2) 消融(Tab. 2c):LLM 单次变异 76.4 → +变异器智能体 79.1 → +谱系记忆 79.3 → +多岛 80.5 → +orchestrator 86.1(RR@5),orchestrator 贡献最大单项 +5.6。(3) 迁移:TB2.1 上进化的 harness 免搜索直接用于更难的 Frontier-Bench,RR@3 13.8%±3.2,对 Best-of-3 10.0%、对最强 SoTA Mini-SWE-Agent 5.2%。(4) 鲁棒性:4K 输出上限使 12 个专家 harness 的 RR@5 从 70.5–75.0(128K)跌至 20.2–34.4,MILO 同条件仍进化出 81.1%,pass@5 93.2% 与 128K 持平,说明强 harness 能补偿模型弱点。(5) 机制分析(Tab. 8):≥14/21 个失败任务死于超时归零(0 测试通过),MILO 的最佳 harness 以脚手架地板、截止期治理器、对抗验证器门三个代码级机制同时覆盖提前完工、超时、松弛验证三类失败模式,是唯一做到的搜索方法。(6) 开放数学:EinsteinArena 上刷新三个记录——Erdős 最小重叠 0.3808586→0.3808568,第一自相关不等式 1.50274365→1.50274360,第三自相关 1.45081→1.44889,全部经 arena 官方验证器复核,超越 AlphaEvolve、TTT-Discover、EvoX 的已知界。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 2.1(89 个命令行长程任务) | RR@5 分辨率率 | 86.1%±2.0(pass@5 93.2%,PR@5 90.4%),超官方榜首 83.8%±2.3 | Best-of-3 种子 74.1%;最佳先前搜索 Meta-Harness 78.2% | +12.0%(相对最佳基线 +7.9 个百分点),tokens 降至 0.74× |
| PaperBench-CodeDev(复现 20 篇 ICML 2024 论文) | RR@3 分辨率率 | 55.0%±5.0(PR@3 88.6%±0.5) | Best-of-3 26.7%±6.0;最佳先前搜索 Meta-Harness 45.0%±2.9 | +28.3 个百分点(相对最佳基线 +10.0) |
| DeepSWE(113 个多文件软件工程任务) | RR@3 分辨率率 | 69.3%±3.4 | Best-of-3 59.0%±3.8;GEPA/EvoX 58.7% | +10.3 个百分点 |
| Terminal-Bench 2.1(开放权重骨干 gpt-oss-120b) | PR@5 / RR@5 | 57.1%±2.0 / 34.1%±3.1,tokens 0.70× | Best-of-3 45.3% / 23.4%;最佳先前搜索 EvoX 51.5% / 29.5%(且 1.46× tokens) | PR +11.8 个百分点;RR +4.6 且成本反降 30% |
| DeepSWE(gpt-oss-120b) | PR@3 部分得分率 | 15.6%±1.7 | Best-of-3 0.8%±0.6;所有进化基线 <1% | 约 20 倍 |
| Frontier-Bench(更难的 70 个任务,零搜索直接迁移) | RR@3 分辨率率 | 13.8%±3.2 | Best-of-3 10.0%±3.4;Mini-SWE-Agent 5.2%±2.8 | +3.8 / +8.6 个百分点 |
| 搜索机制消融(TB2.1,Opus 4.8) | RR@5 | 完整 MILO 86.1% | 无 orchestrator 80.5%;单岛 79.3%;平坦记忆 79.1%;LLM 单次变异 76.4% | orchestrator +5.6 个百分点(最大单项) |
| EinsteinArena 开放数学问题(实例级变体,Opus 5) | 目标函数值(越小越好) | Erdős 最小重叠 0.3808568;第一自相关 1.5027435984;第三自相关 1.4488860 | 此前最优 0.3808586 / 1.5027436492 / 1.4508066395;AlphaEvolve 0.380924、EvoX 第三自相关 1.4558 | 三项全部刷新最好已知界(第三自相关改进 1.9×10⁻³),经 arena 官方验证器确认 |
局限与改进
作者承认的:(1) 评估一个 harness 需在整个基准上跑多次 rollout,代价高昂,搜索规模受 72 小时墙钟与单机并发(每岛最多 8 个并发任务)限制,发现本身并不便宜;(2) 泛化只在与 TB2.1 同分布的 Frontier-Bench 上验证,向 PaperBench、DeepSWE 这类异域分布的迁移未测;(3) held-out 验证集最终也参与最终 harness 选型,防过拟合手段只有这一层。我自己的观察:(1) 变异器池与 orchestrator 全部依赖前沿商业编码智能体(Claude Code+Opus 4.8、Codex+GPT-5.5 及 DeepAgents 变体),发现成本隐含大量前沿模型 API 调用,在弱模型/低预算场景是否划算存疑;(2) 三个种子均属 DeepAgents 家族、搜索空间锚定在单一框架的 Python 单文件上,对 YAML 配置、多文件或跨仓库 harness 只有论证没有实验;(3) orchestrator 的诊断与“瓶颈→干预”映射靠提示词约定,误诊时缺乏纠偏或反事实验证回路;(4) gpt-oss-120b 上绝对水平仍低(TB2.1 RR@5 34.1%),说明 harness 搜索无法替代模型能力本身;(5) EinsteinArena 三项记录中两项的改进量仅 $1.8\times10^{-6}$ 与 $5.1\times10^{-8}$,虽超过 arena 的最小改进门槛,但实际科学意义有限,第三自相关的 $1.9\times10^{-3}$ 才更实质。
独立分析的弱点
弱点一:样本经济学仍然昂贵——每个候选要在搜索集全部任务上跑 $k=3$ 次 rollout,89 个 TB 任务意味着单候选数百次容器化执行;改进方向是学习廉价代理评分器或对明显劣势候选早停,把完整 rollout 留给前沿候选。弱点二:失败证据以原始轨迹形式进入变异器上下文,长任务轨迹易撑爆上下文或引入噪声,论文未报告变异器误判频率;可探索轨迹摘要器或失败聚类的结构化证据库。弱点三:岛屿数 $K=3$、耐心 $P=3$、温度 $T=1$ 等超参固定,Speciate 只增不减、岛屿数量本身未自适应伸缩,大规模运行时缺乏资源分配策略;可引入多臂老虎机动态增减岛屿预算。弱点四:Graft 的共父选择与四类瓶颈判定都由单个 orchestrator LLM 一步完成,没有诊断正确性的验证回路;可让 orchestrator 先做小规模反事实试探(如短暂换变异器试一轮)再决定干预。弱点五:课程仅按遗憾值 $\rho(\tau)$ 采样,忽略任务间相似度、评分方差与训练边际价值;可用任务嵌入做主动学习式采样,避免重复评测已收敛任务。弱点六:对 Qwen3-Coder-480B 这类弱变异器模型的角色没有单独分析,池中六个变异器的贡献分解缺失。
未来方向
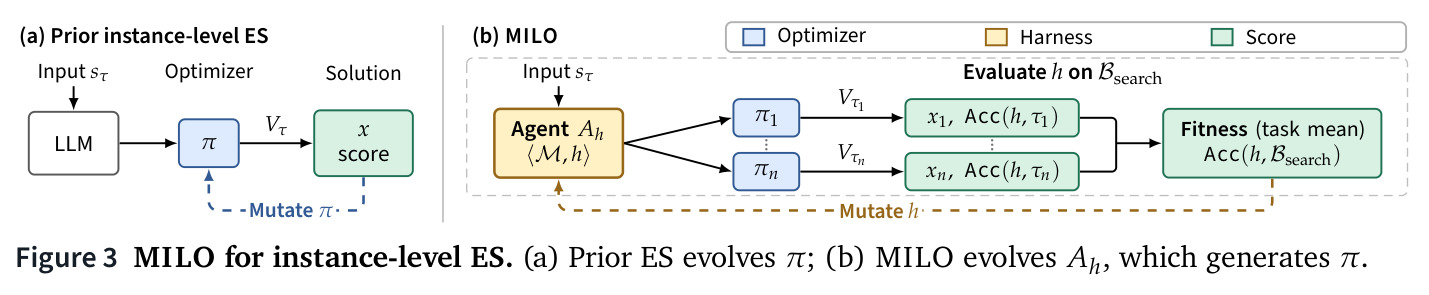
作者提出的方向:(1) 递归自我改进——让智能体持续改进自己的 harness,AHD 是迈向该愿景的第一步;(2) 把策略级发现推广到其他求解器家族,如偏好优化算法与设计启发式;(3) 实例级变体(图 3):进化“写优化器的智能体”本身,已在 EinsteinArena 初步验证并打破三项记录。基于其成果可延伸的:(1) 跨模型 harness 迁移——把强模型上发现的机制库(验证器门、脚手架地板、截止期治理器)固化为弱模型的初始种子,降低重复搜索成本,这与其 4K 输出上限实验(强 harness 补偿模型弱点)一脉相承;(2) harness 中间件组件库:谱系树中反复被独立发现的机制可沉淀为标准件,形成可复用的脚手架生态;(3) 编排策略的离线学习:积累多次 AHD 运行的(诊断,干预,结果)三元组,训练专门的编排模型替代逐次 prompt;(4) 将多目标从(精度,token,时延)扩展到安全性、可解释性、内存等轴,并研究约束 Pareto 搜索的收敛性质;(5) 遗憾值课程与课程学习/主动学习理论的联系值得形式化;(6) 在推理时缩放与 harness 搜索之间建立统一的算力分配理论。
复现评估
开源情况:正文列出 Project Page 占位但未给出明确代码开源承诺;不过论文复现材料极为详尽——变异器与 orchestrator 的完整提示词(Listing 6/7)、12 个种子 harness 与最小 harness 全文(Listing 1–5)、六条基线的 pinned 版本号与逐方法配置(App. A.3,含对 GEPA 反思小批量从 3 调到 12 这类关键细节)、MILO 最佳 harness 的完整 diff(Listing 14,RR@5 86.1)与 EinsteinArena 最优优化器代码节选(Listing 15)。硬件门槛低:单台 192 vCPU 纯 CPU 实例(1.5 TiB 内存、1 TB SSD、Docker 25),所有模型推理走 Amazon Bedrock 远程 API,无 GPU 需求。真正的门槛是预算:72 小时墙钟 × 三个基准 × 两条骨干,每岛 8 并发任务、搜索集 $k=3$ rollouts,且六个变异器与 orchestrator 全是前沿商业模型调用,粗估单次完整复现的 API 开销在数千美元量级。综合评级:中高难度——算法与工程细节披露充分、理论上一台 CPU 机器加 API key 即可复跑,但软最大采样与 orchestrator LLM 引入的随机性使逐位复现不现实,且排行榜对比数字(83.8±2.3)会随时间漂移。
论文图表
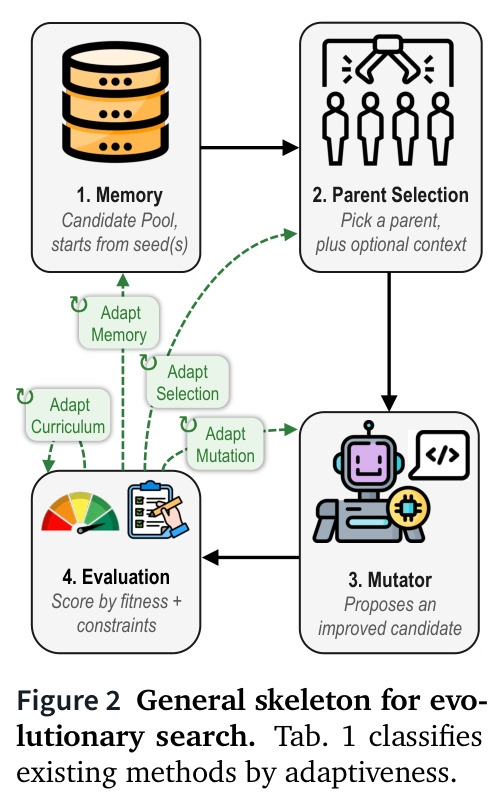
把 LLM 驱动进化搜索抽象为四个组件:记忆、父代选择、变异器、评估,并标注哪些方法在哪些组件上引入了“↻ Adapt”在线适应箭头,对应适应性阶段 0–IV。
它提供了论文的分类坐标系,直观呈现“绝大多数方法把搜索策略写死、MILO 在所有组件上自适 应”这一贡献定位,是读懂相关工作与 Tab. 1 的钥匙。
把在 Terminal-Bench 2.1 上进化的 harness 原封不动用于更难的 Frontier-Bench(70 个无 GPU 任务):pass@3 24.3、PR@3 51.4、RR@3 13.8,对比 Mini-SWE-Agent(12.9/44.0/5.2)与 Best-of-3(21.4/48.4/10.0)。
证明进化的 harness 没有过拟合单一基准、携带的是通用机制,回应“自动搜索是否只会记题”的天然质疑。
同样的专家 harness 梯队在开放权重 gpt-oss-120b 上的成绩:各专家 harness RR@5 仅 15.5–23.4,MILO 进化出 34.1,显著领先。
补充表 6 的骨干泛化维度,说明 harness 设计结论并非 Opus 4.8 特有。