基于脚手架-策略协同优化的自进化编码智能体 Self-Evolving Coding Agents via Harness-Policy Optimization
让智能体策略自己提出脚手架改进方案,交替优化脚手架与策略,实现递归自我提升
前置知识
Agent Harness(脚手架)
编码智能体由策略模型(LLM 本体)和脚手架两部分组成。脚手架是包裹模型的外部程序,决定模型每一步看到什么上下文、工具命令如何执行、收到什么反馈、回合何时终止。例如 mini-SWE-agent 就是一个极简脚手架,循环执行「查询模型→执行命令→回传结果」。同一个模型配不同脚手架,解题成功率可能相差数个百分点。
全文的核心优化对象就是脚手架,理解它如何介入模型与环境的交互,才能读懂 H-step 到底在改什么。
RLVR 与 GRPO
RLVR 指可验证奖励的强化学习,用可执行测试等二值结果信号(任务解决记 1、否则 0)训练模型。GRPO(组相对策略优化)对每个任务采样一组轨迹,用组内奖励的相对优势更新策略,无需价值网络。BAR(平衡自适应采样)自适应地补采轨迹、构造奖励有对比的组,缓解稀疏奖励下大量全零组无法提供梯度的问题。
P-step 就是用 GRPO+BAR 做策略训练,是 Self-HPO 交替循环的一半,不懂 RLVR 读不了实验部分。
SWE-Bench 与 resolve rate
SWE-Bench 系列是软件工程基准:给模型一个真实 GitHub 仓库和 issue,要求生成能通过仓库测试的补丁。resolve rate(解决率)指生成补丁通过基准验证器的任务比例。本文用 SWE-Bench Verified(500 个人工校验任务)做主基准,Multilingual(300 任务、覆盖 9 种非 Python 语言)和 Pro 公开 V2(642 任务)做分布外评测。
论文所有主实验和消融都以这三个基准的解决率为指标,必须先知道它衡量什么、怎么判定成功。
pass@k
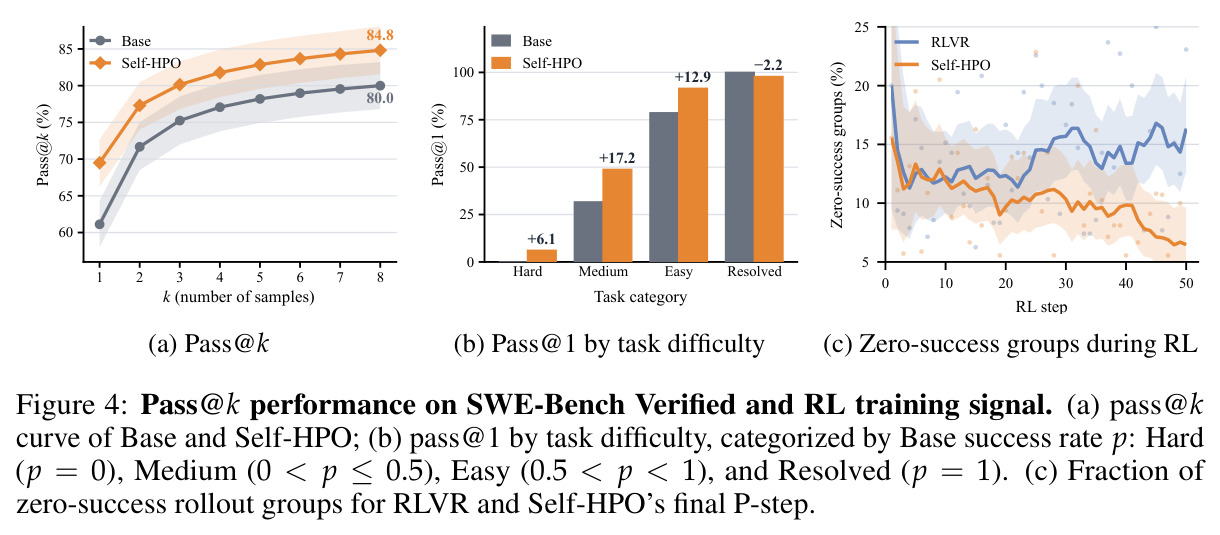
对每个任务独立采样 k 次的通过率估计,反映模型的能力边界:pass@1 衡量单次尝试的可靠性,pass@k 随 k 增大逼近「至少一次成功」的上限。若某方法只提升 pass@1 而 pass@k 不变,说明只是变得更稳定;若 pass@k 也提升,说明解开了原本完全不会的任务。
论文用 pass@1 和 pass@8 的对比来区分「可靠性提升」和「能力边界扩张」两类不同性质的增益。
Self-proposer(自提出者)
自我改进指系统不依赖外部教师、用自身产出的信号驱动迭代提升。Self-proposer 特指让当前策略模型自己充当脚手架的提出者:分析自己的失败轨迹、生成脚手架修改候选。这与用 Opus 等更强外部模型做 proposer 的设定相对,是「不靠外援的自进化」,也是 Self-HPO 名字的由来。
这是本文与 WHALE、Meta-Harness 等依赖外部 proposer 方法的本质分界线,是全文设定的关键。
研究动机
提升编码智能体有两条主流路线,但各自都有天花板。脚手架优化(如 Self-Harness、Meta-Harness)冻结策略模型,只搜索提示词、工作流或智能体代码:它无法提升模型本身,而且为某个 checkpoint 调好的脚手架,在模型更新后未必命中新的失败模式。策略优化(如 RLVR、SFT)冻结脚手架,用可验证奖励更新模型:模型只能从固定脚手架诱发出的轨迹中学习,脚手架没有覆盖到的行为永远学不到。以 Qwen3.5-35B-A3B 加 mini-SWE-agent 为例,Base 在三个基准的平均解决率只有 57.8%,单侧优化最多到 61.9%(RLVR)或 60.1%(Self-Harness)。已有的联合优化工作(如 WHALE、Evo2)则依赖冻结的外部 proposer 或单独训练的 proposer,随着策略演化其优化目标会漂移(moving target),自驱动的脚手架-策略协同进化仍是空白。
本文的目标是本文目标是构建一个递归自我提升框架 Self-HPO,让编码智能体不依赖任何外部 proposer,自行交替完成脚手架优化与策略优化,且让脚手架搜索始终对准策略当前演化出的失败模式。量化目标:在 SWE-Bench Verified、Multilingual、Pro 三个基准上,将 Qwen3.5-35B-A3B 的平均解决率从 57.8% 显著提升,并超越只优化单侧的 RLVR(61.9%)和 Self-Harness(60.1%)基线;同时验证增益能泛化到九种非 Python 语言的分布外任务,并区分可靠性(pass@1)与能力边界(pass@k)两类收益。
与已有工作不同的是,独特切入角度有两个。第一,自提出者:训练中的策略本身充当下一轮脚手架搜索的 proposer——它读自己的失败轨迹、针对自身失败模式提出脚手架修订,无需 Opus 这类外部强模型;作者证明这只比外部 proposer 版本低 2.1 个百分点(69.5% vs 71.6%)。第二,演化搜索集:脚手架搜索不用固定的初始任务集,而是把上一轮 RL 中从未解决的难任务收集起来作为下一轮 H-step 的搜索集,使脚手架优化跟随策略的失败模式迁移,消融显示固定搜索集会损失 1.5 个百分点。这两个机制共同解决了联合优化中「为旧策略找的脚手架不适合新策略」的目标漂移问题。
核心方法
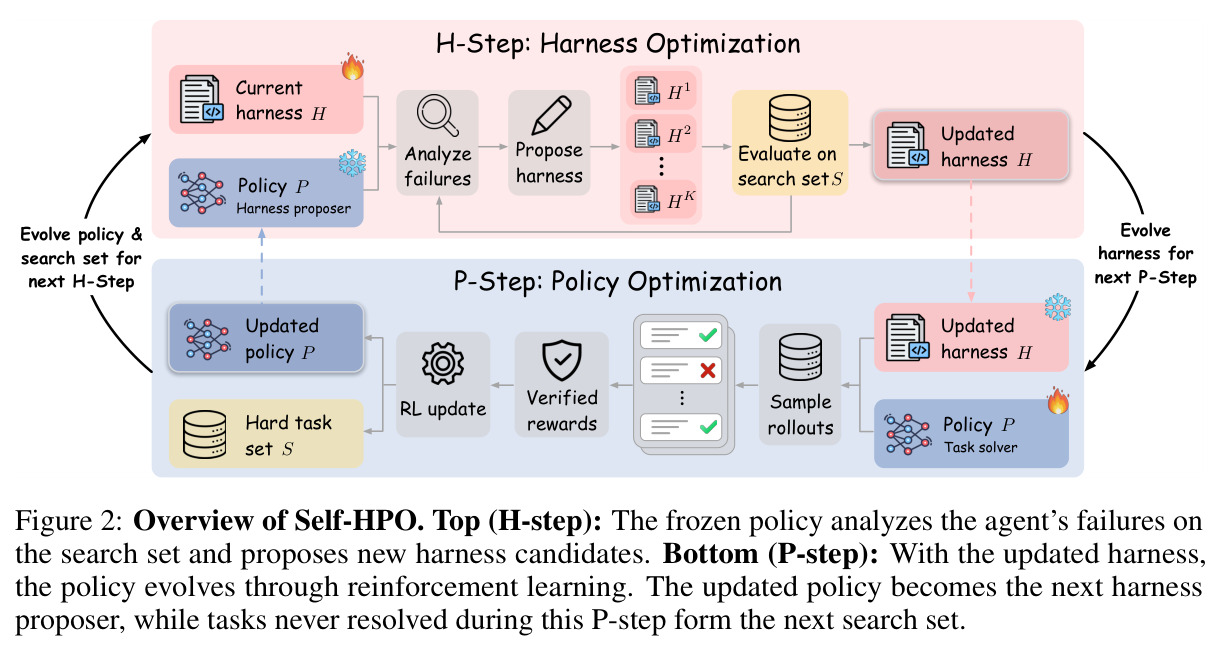
直觉上,这像运动员和教练同步成长:教练(脚手架)根据运动员(策略)当前的弱点调整训练器械和比赛策略,运动员再用新器械苦练变强,变强后暴露新的短板,教练又据此再调整,如此螺旋上升。技术路线上,Self-HPO 把智能体表现形式化为脚手架-策略对的期望解决率 $J(H,P)=\mathbb{E}_{x\sim D}\,\mathbb{E}_{\tau\sim\pi_{H,P}(\cdot|x)}[y(x,\tau)]$,其中 $y$ 是可执行验证器给出的二值奖励。整个框架是一个交替循环:H-step 冻结当前策略 $P_t$,以它为 proposer 生成 $K=6$ 个脚手架候选并在搜索集 $S_t$ 上评估选优,得到 $H_{t+1}$;P-step 冻结 $H_{t+1}$,用 GRPO+BAR 在 2,484 个训练任务上做 50 步 RL 得到 $P_{t+1}$,并把训练中从未解决的难任务汇成 $S_{t+1}$ 交给下一轮。实验完整执行了两轮循环。
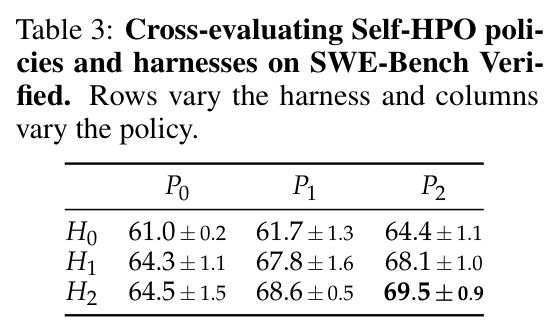
核心创新是「策略作为自己的脚手架提出者」加上「搜索集随失败模式演化」的双机制闭环。与已有方法的本质区别在于:WHALE 依赖冻结的外部 proposer,Evo2 需为冻结的求解器单独训练一个 proposer,HASE 把脚手架编辑放进 RL 动作空间但在固定任务集上搜索;而 Self-HPO 让 P-step 训练出的新策略直接成为下一轮 H-step 的 proposer,脚手架修改建议天然条件化于「当前策略刚暴露的失败轨迹」,无需任何外部模型。同时,下一轮搜索集取自 RL 过程中所有 rollout 都失败的任务,使脚手架搜索追踪策略演化后仍然解决不了的任务,而不是反复在最初那批任务上打转。交叉评估(Table 3)证明两者互补:$H_2$ 配 Base 策略提 3.5 点,$P_2$ 配种子脚手架提 3.4 点,联合提升 8.5 点超过两者之和 1.6 点。
方法步骤详情
按 Algorithm 1 展开:初始化种子脚手架 $H_0$(mini-SWE-agent)、基础策略 $P_0$(Qwen3.5-35B-A3B)、训练集 $D$(2,484 任务),并从 $D$ 随机采样搜索集 $S_0$。第 $t$ 轮 H-step:先用 $(H_t,P_t)$ 在 $S_t$ 上跑轨迹记为基线分 $v_0$;然后 proposer 检查失败轨迹,参考已评估脚手架的经验池 $\mathcal{E}$,迭代生成 $K=6$ 个候选 $H_t^k$(可改提示词也可改可执行运行时逻辑),每个候选都在同一 $S_t$ 上评估,保留最高分者为 $H_{t+1}$。第 $t$ 轮 P-step:冻结 $H_{t+1}$,在 $D$ 上以 GRPO+BAR 做 50 次 RL 更新得到 $P_{t+1}$,BAR 通过自适应补采构造奖励均衡组、减少零方差组。随后从本轮训练轨迹中筛出从未被任何 rollout 解决的任务构成 $S_{t+1}$。重复两轮,直到难任务集在轮间趋于稳定即停止。
技术新颖性
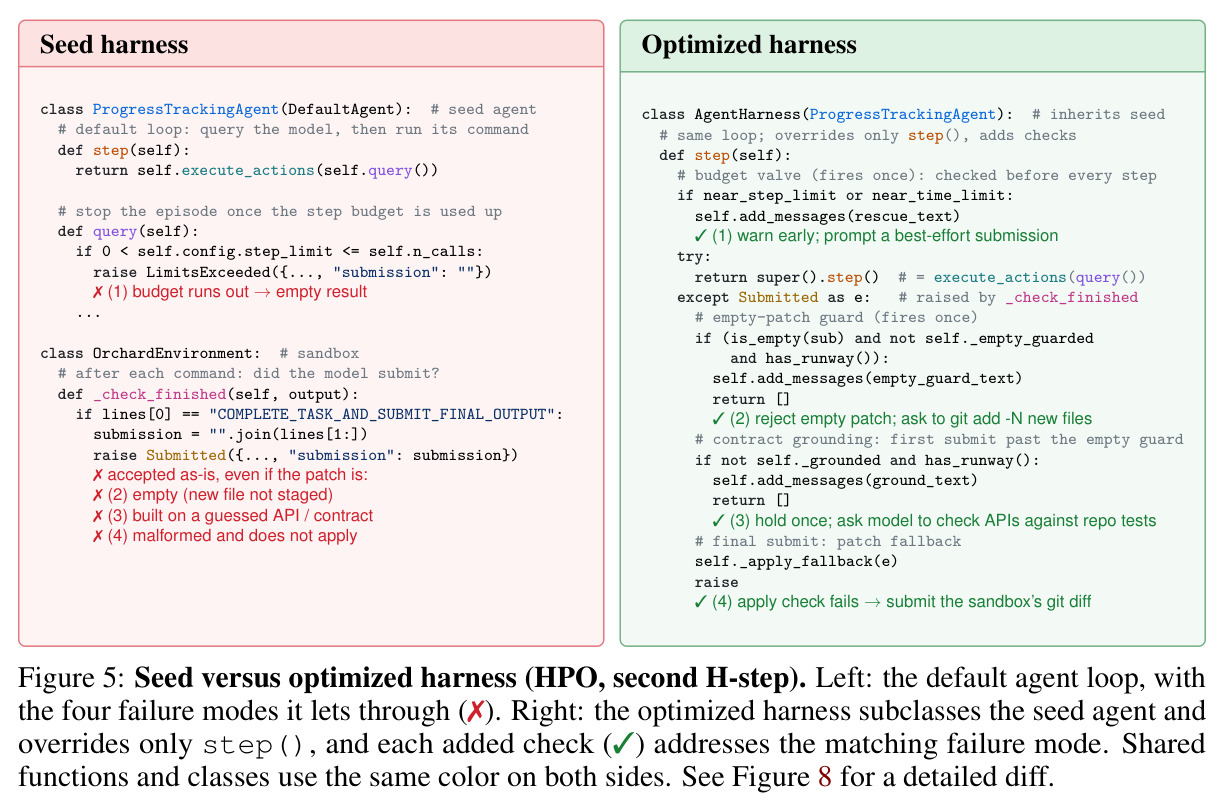
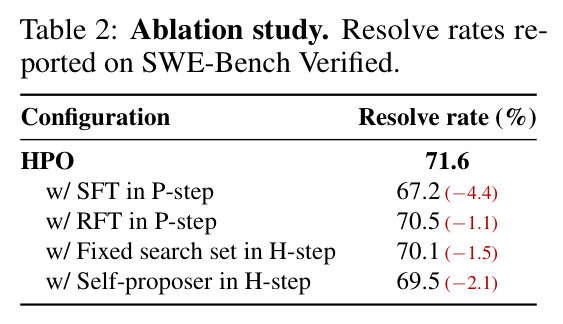
技术新颖性体现在四个层面。其一,proposer 来源:首个让演化中策略自任脚手架 proposer 的交替 HPO 框架,消融显示自提出仅比 Opus 4.8 外部提出低 2.1 点(69.5% vs 71.6%),证明不靠外援的自进化可行。其二,搜索集机制:用 RL 未解决任务动态刷新脚手架搜索集,是与 WHALE、Evo2、HASE 等固定任务集搜索的关键差异,消融贡献 1.5 点。其三,脚手架搜索空间:候选不只是改提示词,还包括可执行运行时逻辑(重写 agent 的 step() 方法、加预算预警、空补丁守卫、git diff 兜底),案例研究展示了真实演化出的四类干预。其四,策略更新方式:消融证明 RL 优于 SFT(67.2%,−4.4)和 RFT(70.5%,−1.1),且 BAR 采样把零成功组比例从 RLVR 的 11–17% 降到 6.5%,缓解了奖励稀疏。
实验结果
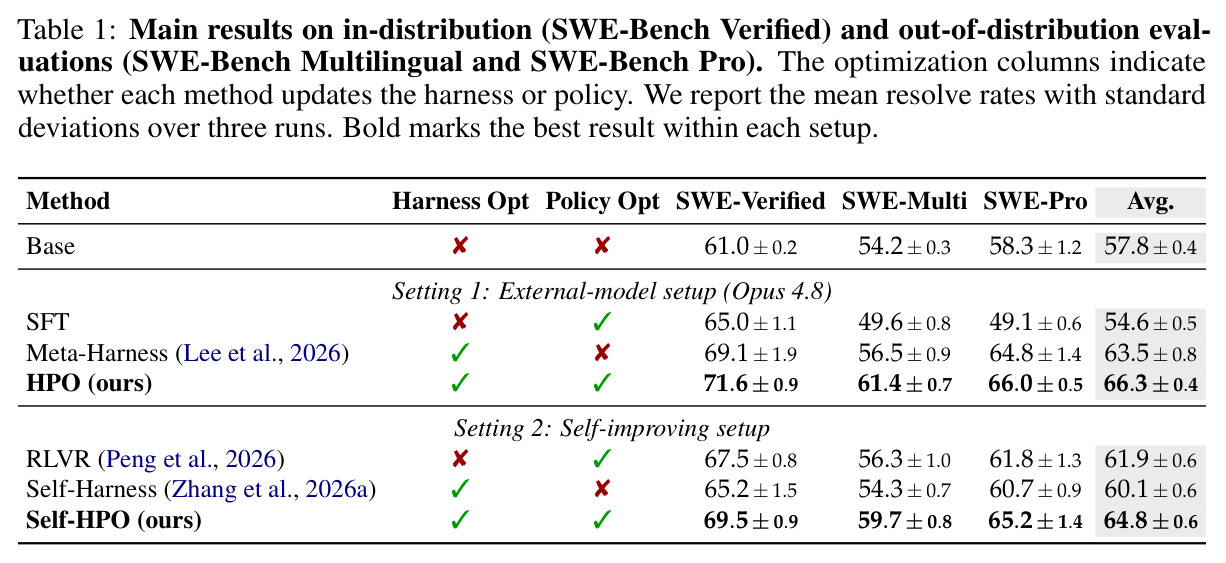
主实验(Table 1,avg@3)给出三层结论。自进化设定下,Self-HPO 在 SWE-Verified 达 69.5%,比 RLVR(67.5%)高 2.0 点、比 Self-Harness(65.2%)高 4.3 点;三基准平均从 Base 的 57.8% 升至 64.8%,超 RLVR 2.9 点。外部模型设定下,HPO 达 71.6%/61.4%/66.0%,平均 66.3%,比 Meta-Harness 高 2.8 点;而 SFT 蒸馏在分布外反而低于 Base(Multilingual 49.6% vs 54.2%)。分布外泛化显著:训练只用 Python 任务,但 Self-HPO 在 Multilingual 上 59.7%(+5.5)、Pro 上 65.2%(+6.9),均超 RLVR 3.4 点。交叉评估(Table 3)显示组件互补:$H_2\times P_2$=69.5% 超过单独增益之和(6.9 点)1.6 点。消融(Table 2)确认 RL 优于 SFT(−4.4)与 RFT(−1.1),演化搜索集优于固定集(−1.5)。可靠性方面(Figure 4),pass@8 从 80.0% 升至 84.8%;pass@1 在 Medium/Easy/Hard 分别 +17.2/+12.9/+6.1 点,但 Resolved 组 −2.2 点;零成功组比例从 RLVR 的 11–17% 降至 6.5%。
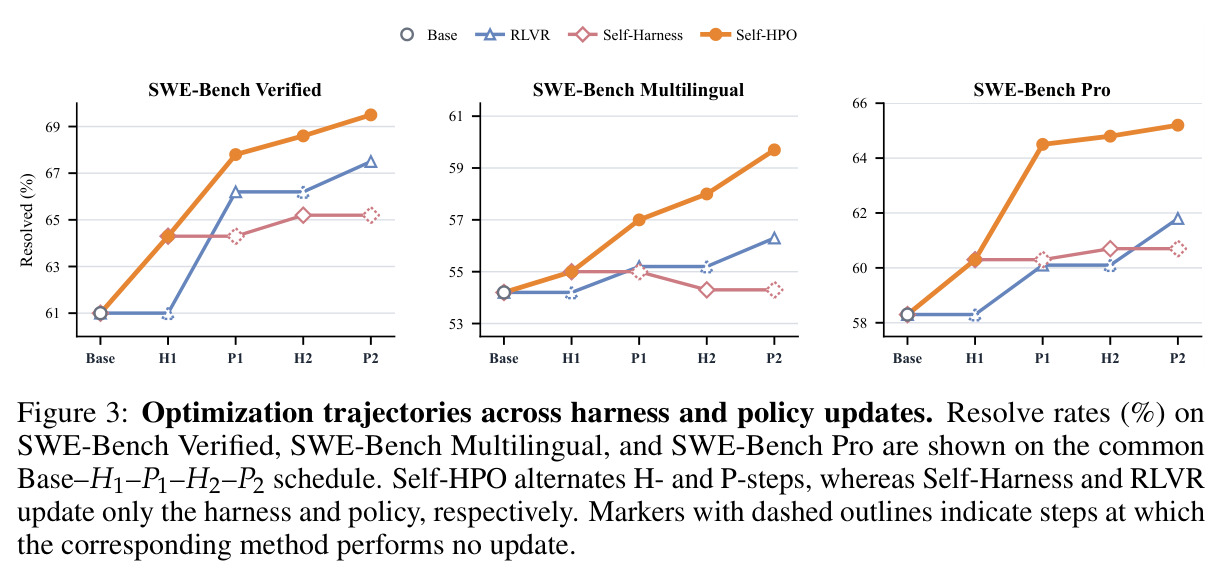
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-Bench Verified(分布内主基准,500 任务) | resolve rate (avg@3) | Self-HPO 69.5%;外部 proposer 版 HPO 71.6% | Base 61.0%;RLVR 67.5%;Self-Harness 65.2%;Meta-Harness 69.1% | 较 Base +8.5 点;较最强单侧自进化基线 RLVR +2.0 点 |
| SWE-Bench Multilingual(分布外,300 任务、9 种语言) | resolve rate (avg@3) | Self-HPO 59.7%;HPO 61.4% | Base 54.2%;RLVR 56.3%;Self-Harness 54.3% | 较 Base +5.5 点、较 RLVR +3.4 点(Self-Harness 仅 +0.1) |
| SWE-Bench Pro 公开 V2(分布外,642 任务) | resolve rate (avg@3) | Self-HPO 65.2%;HPO 66.0% | Base 58.3%;RLVR 61.8%;Self-Harness 60.7% | 较 Base +6.9 点、较 RLVR +3.4 点 |
| 三基准平均(Verified + Multilingual + Pro) | 平均 resolve rate (avg@3) | Self-HPO 64.8%;HPO 66.3% | Base 57.8%;RLVR 61.9%;Self-Harness 60.1%;Meta-Harness 63.5% | 自进化设定 +7.0 点,超最强单侧基线 RLVR 2.9 点 |
| SWE-Bench Verified 能力边界 | pass@8(每任务 8 次采样) | 84.8% | Base 80.0% | +4.8 点,且 pass@1 至 pass@8 全程高于 Base |
局限与改进
作者承认的局限:其一,Resolved 组 pass@1 下降 2.2 点,说明改进不均匀,策略在原本稳定解决的问题上出现回退;其二,自提出者比外部 Opus 4.8 proposer 低 2.1 点,纯自进化仍留有性能空间;其三,只在 Qwen3.5-35B-A3B 一个基座上验证,未报告其他模型或规模。我的独立观察:其一,整个循环计算开销巨大——每轮 H-step 要评估 6 个候选各跑一遍搜索集,P-step 要做 50 次 35B 模型的 RL 更新,两轮循环成本远超单侧基线,论文未给出算力与耗时数据;其二,「难任务集趋于稳定」这一停止准则缺乏形式化定义,实际操作可能依赖人工判断;其三,所有基准都是带可执行验证器的软件工程任务,二值结果奖励框架难以直接迁移到无 verifier 的领域;其四,训练任务来自 SWE-rebench 等与评测基准同源的抓取管道,尽管有 OOD 实验,分布重叠风险仍无法完全排除。
独立分析的弱点
第一,难任务定义过粗:$S_{t+1}$ 取「所有 rollout 全失败」的任务,这些任务在二值奖励下没有任何正样本,下一轮策略训练几乎无法从它们身上学到东西,难任务可能永远堆积。改进方向:对难任务引入课程式提示,或用更强 proposer 的演示轨迹作为脚手架先验。第二,脚手架候选只用小搜索集评估,容易过拟合 $S_t$ 的几百个任务,泛化靠运气。改进方向:加入保留集验证,或以平均步数、token 成本等多指标正则防止「为搜索单点调参」。第三,样本效率低:$K=6$ 候选 × 搜索集评估 × 50 步 RL × 2 轮,成本是单侧基线的数倍,中小团队难以负担。改进方向:用候选间轨迹重合度等代理指标提前剪枝低潜候选,减少全量评估。第四,脚手架演化只见过 mini-SWE-agent 这一个种子,搜索空间受限于其代码结构,复杂多智能体工作流能否被自发演化存疑。改进方向:从多个异构种子脚手架出发并行进化再择优融合。
未来方向
作者展示的延伸方向:换更强外部 proposer(Opus 4.8 把 Verified 推到 71.6%),说明框架收益随 proposer 能力扩展;运行更多轮循环、观察增益是否持续也值得探索。基于成果可延伸的方向:其一,把 HPO 循环搬到 web 导航、computer use 等其他智能体域,只要有可执行验证器即可套用;其二,系统研究脚手架-策略对的迁移性——Table 3 已显示 $H_2$ 能把 Base 策略从 61.0% 提到 64.5%,「好脚手架跨策略、跨模型的可移植性」有很高实用价值;其三,将演化出的脚手架加策略蒸馏到小模型,降低部署成本;其四,把 BAR 自适应补采减少零方差组的思想推广到其他稀疏奖励 RL 场景;其五,扩展到多智能体协作脚手架的搜索空间,并加入安全性维度的协同进化,防止脚手架优化无意间绕过安全护栏。
复现评估
开源情况:论文给出 GitHub 仓库(MSR-Orchard/Self-HPO)和 HuggingFace 主页(self-hpo),组件均有开源基础——基座 Qwen3.5-35B-A3B 是开放权重的 MoE 模型,种子脚手架 mini-SWE-agent 开源,训练数据来自公开的 SWE-rebench、SWE-rebench V2 和 Scale-SWE(共 2,484 任务),三个 SWE-Bench 评测基准全部公开。主要门槛在算力:35B 级模型(A3B 激活约 3B 参数)的 RL 训练需要多卡集群,每轮含 50 次 GRPO+BAR 更新,加上每轮 6 个脚手架候选 × 搜索集的推理评估和三基准 avg@3 评测,估计需要数十张高端 GPU 运行数天。沙箱环境与可执行验证器的搭建也是工程难点。复现难度评级:高。资源有限者可退而复现「只跑 H-step、冻结策略」的 Self-Harness 式部分,用 API 模型做 proposer 验证脚手架搜索机制。
论文图表
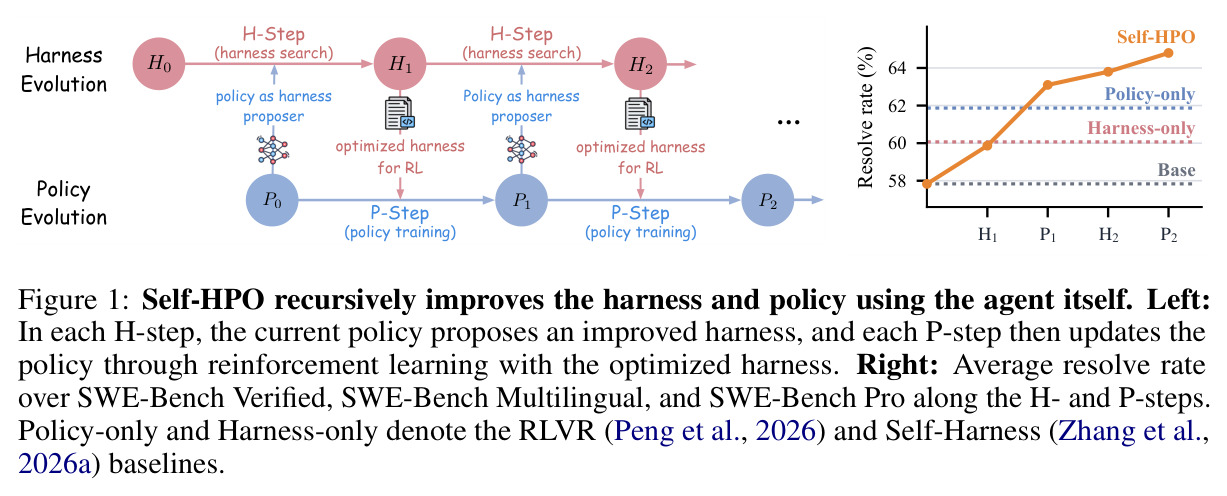
左图展示 H-step(脚手架搜索)与 P-step(策略训练)交替的演化示意,策略同时作为脚手架提出者,从 $H_0,P_0$ 出发产出 $H_1,P_1,H_2,P_2$;右图为三个基准平均解决率沿优化步的曲线,Self-HPO 从 57.8% 升至 64.8%,持续高于 Policy-only(RLVR)与 Harness-only(Self-Harness)基线。
一张图同时讲清框架的循环结构和最核心的结果走势,是理解全文的入口。