4DCodeBench:面向动态场景逆图形学的智能体代码生成基准 4DCodeBench: Benchmarking Agents on Inverse Graphics of Dynamic Scenes
让智能体把视频写成可执行4D图形代码:200个场景、18个模型评测,动力学重建是普遍短板
前置知识
逆图形学
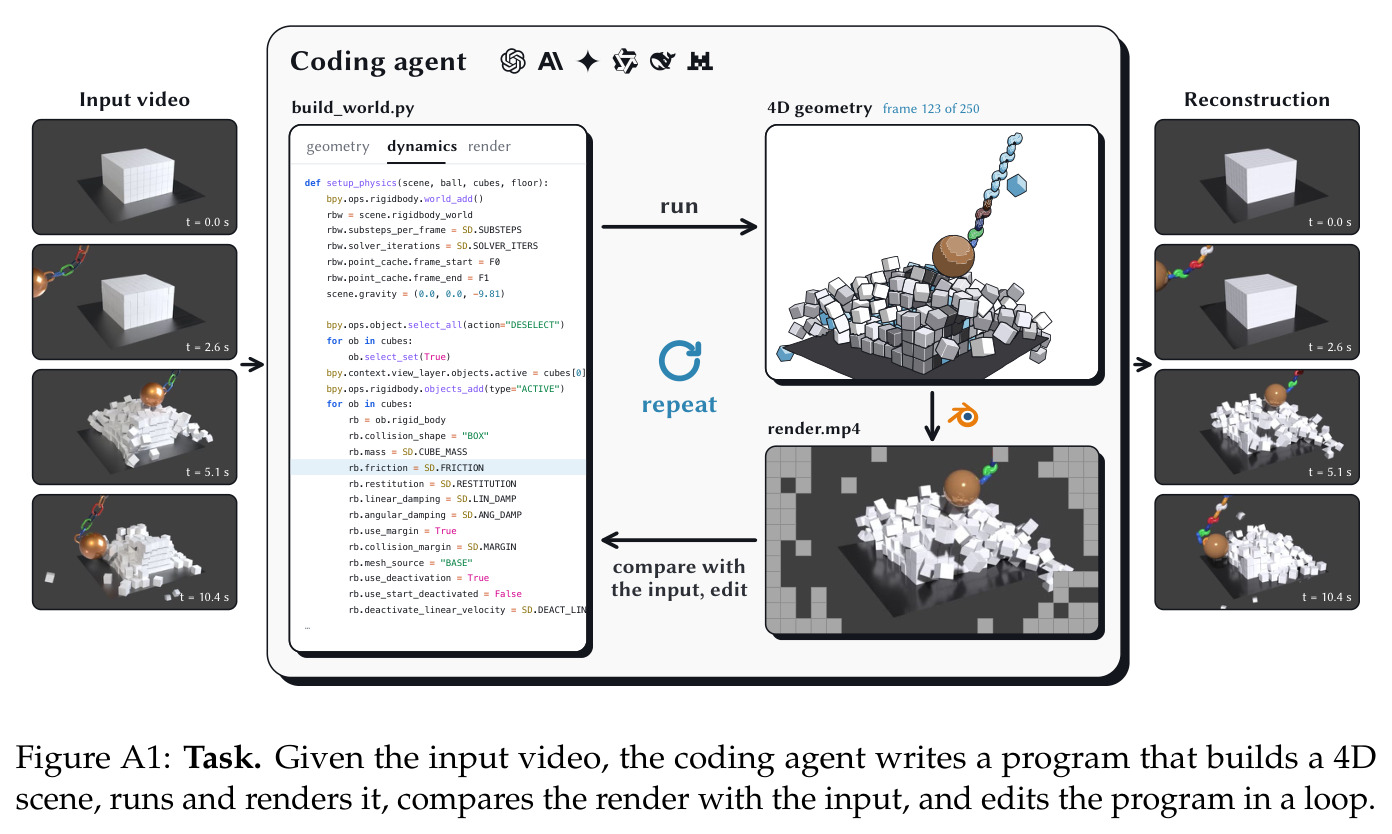
逆图形学是从视觉观测反推场景底层描述的任务:给定图像或视频,恢复几何、材质、光照与相机参数,使前向渲染结果能与观测一致。传统做法是把一个预设的参数化模型拟合到观测数据上;而代码化的做法让模型直接写出可执行的图形程序,把「选什么表示、怎么建模」本身变成推理问题的一部分。
本文基准的任务定义正是逆图形学的代码化版本,理解它才能明白为什么要求智能体输出可执行程序,而不是一段静态重建网格或文字描述。
4D 场景(三维几何 + 时间)
4D 场景是在三维空间几何之上叠加时间维度的动态世界状态:既包含每个时刻的场景几何 $s(t)$,也包含几何随时间的演化。重建 4D 意味着不止恢复静态外形,还要恢复形变、流动、断裂等动力学行为,通常表示为逐帧几何加上动态物质的时间对应关系。
论文的「4D 逆图形学」要求同时恢复几何与动力学,基准刻意把静态与动态分数分开评测,这一设计是读懂「静态强、动态弱」结论的前提。
Bradley–Terry 模型与 Elo 评分
Bradley–Terry 模型从成对比较数据中估计对象相对强度:对象 $i$ 胜过 $j$ 的概率为 $P(i\succ j)=\frac{e^{\theta_i}}{e^{\theta_i}+e^{\theta_j}}$。把大量「A 比 B 好」的主观判断按此模型聚合,即可换算成 Elo 等级分,得到模型层面可比较、可排序的分数。
本文的人类偏好研究与 VLM 裁判都用该框架把逐对比较聚合成模型 Elo,排行榜以及「自动评测与人类对齐」的分析都建立在这个基础之上。
Chamfer 距离
Chamfer 距离度量两组点云或表面采样点的差异:对每组中的每个点,在另一组中找最近邻并取距离,再对两个方向分别聚合。它不需要点与点之间的一一对应,因此常用于比较重建网格与真值网格的静态几何精度,是 3D 重建评测的经典指标。
合成场景的 3D Geometry 分数就是在配准对齐后,用 Chamfer 距离衡量第 0 帧的静态表面误差,是理解模型「静态几何强」这一结论的关键依据。
拉格朗日与欧拉视角的运动度量
拉格朗日视角跟着每一份物质走,沿持久的 3D 轨迹比较运动(如用 DTW 动态时间规整对齐两条轨迹再量误差);欧拉视角固定在空间位置上,不追踪对应关系,转而比较每一帧位移的分布(如用 EMD 推土机距离)。两种视角互补,缺一不可。
本文 3D Dynamics 分数由 Trajectory DTW(拉格朗日)与 EMD step(欧拉)两个互补指标构成,理解它们才能读懂动力学评分到底在衡量什么。
研究动机
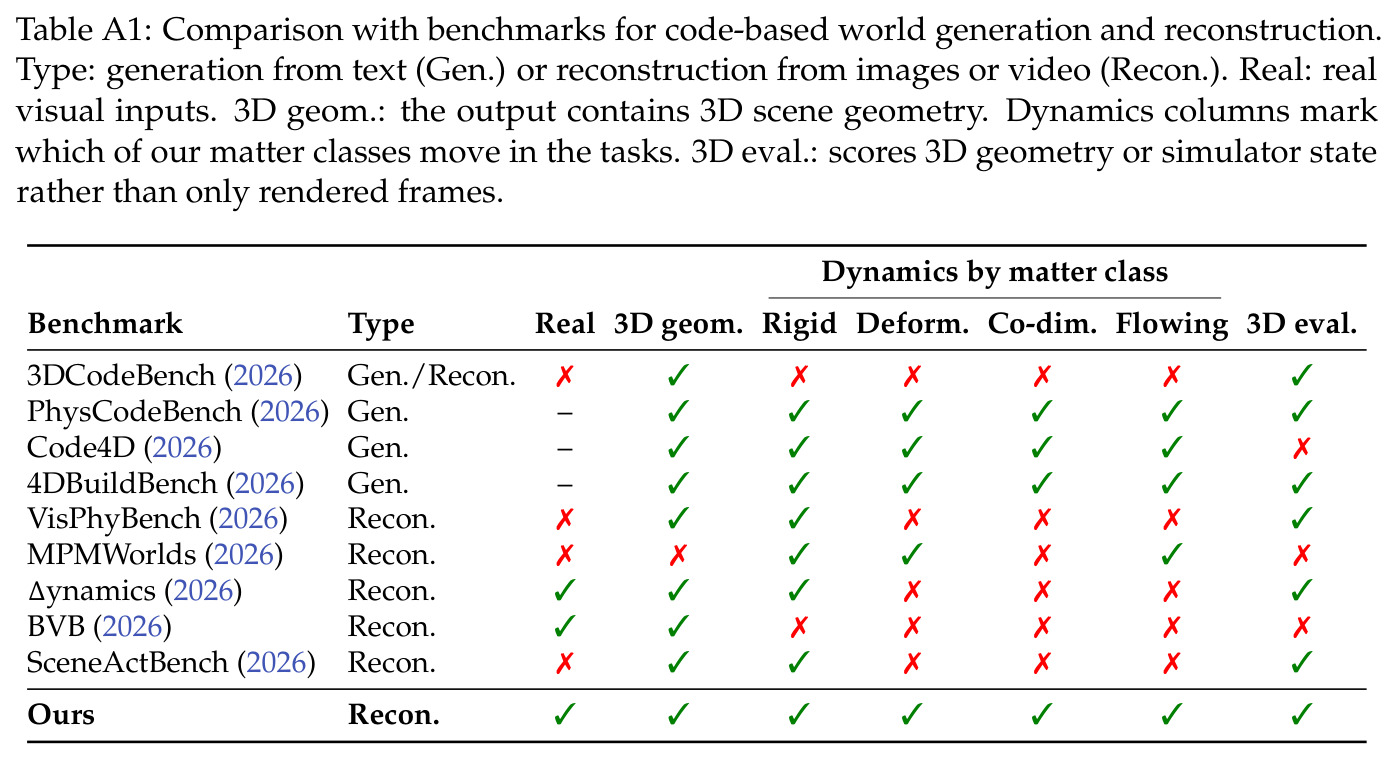
现有基准把智能体的空间与物理能力切成了互不衔接的碎片。3DCodeBench 只要求从文本或图像为静态 3D 物体建模,PhysCodeBench 只要求按文字描述写出可执行的物理仿真,两者都绕开了「从真实视觉观测反推世界」这一步。VisPhyWorld 虽让智能体从视频重建仿真器代码,但只用合成视频;MPMWorlds 同样基于合成视频且局限在 2D 的形变与拓扑变化;BVB 主要面向移动相机下的静态室内场景。结果是:前沿多模态模型在静态重建上表现很强,但强静态能力能否迁移到复杂动力学——流体、断裂、织物、多物体耦合——完全没有被系统测量过;也没有评测能同时提供真实与合成数据、带 4D 真值、覆盖多种物质,并直接在三维空间而非图像空间里打分。
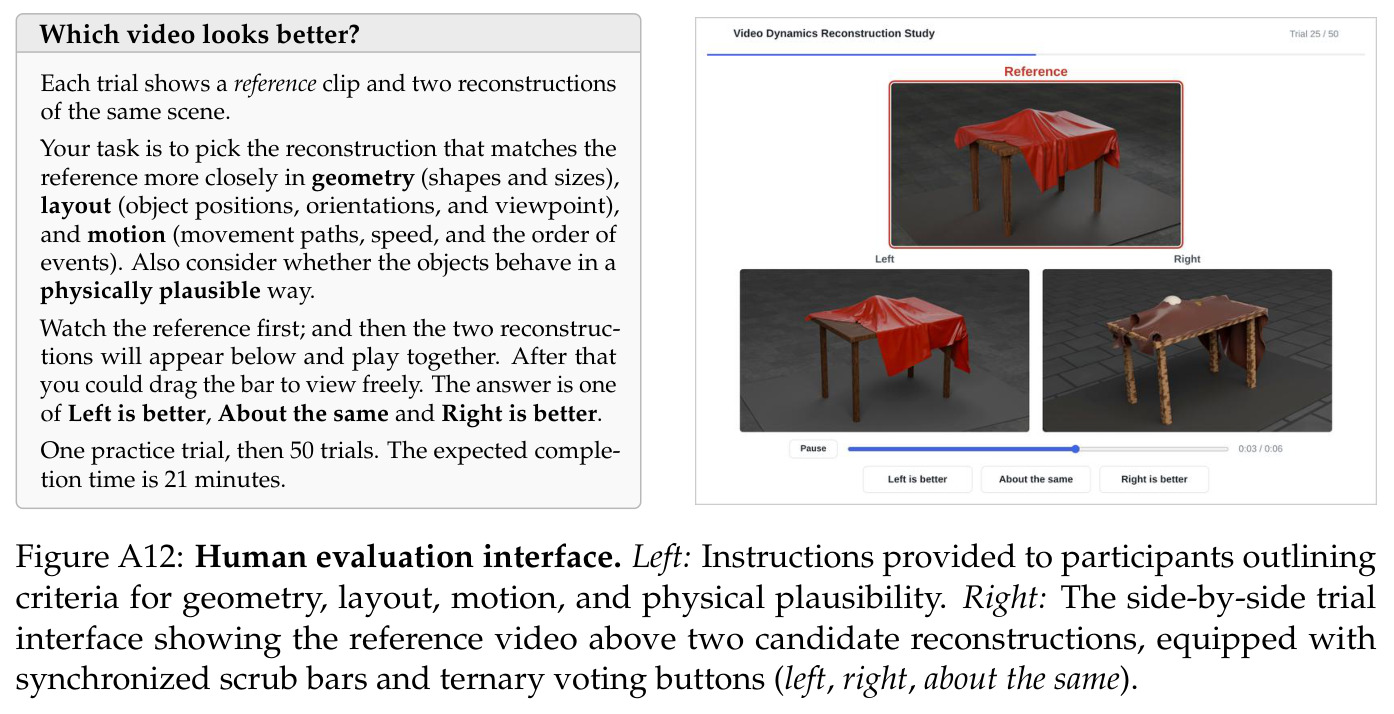
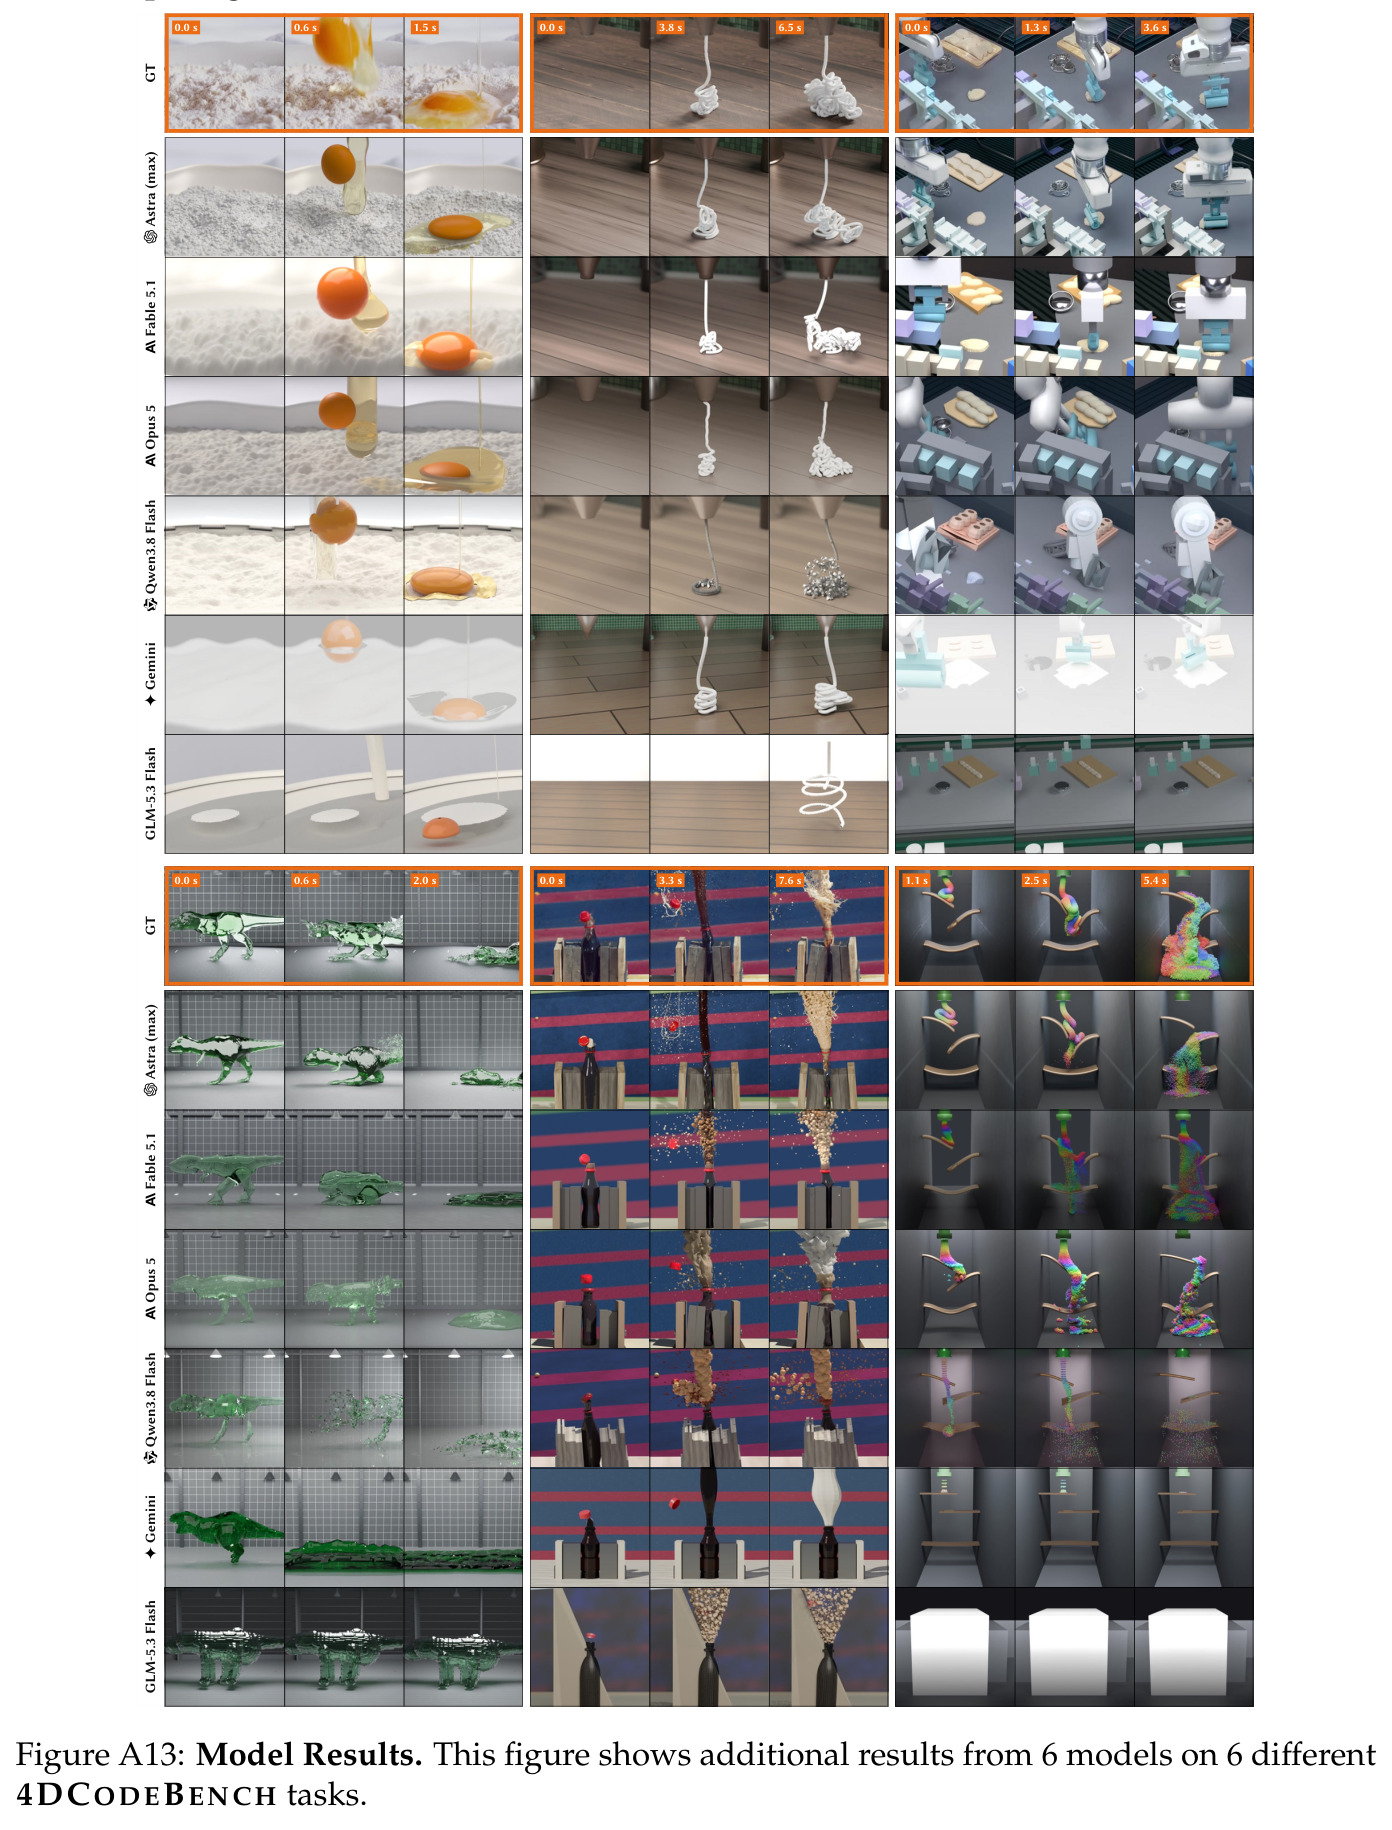
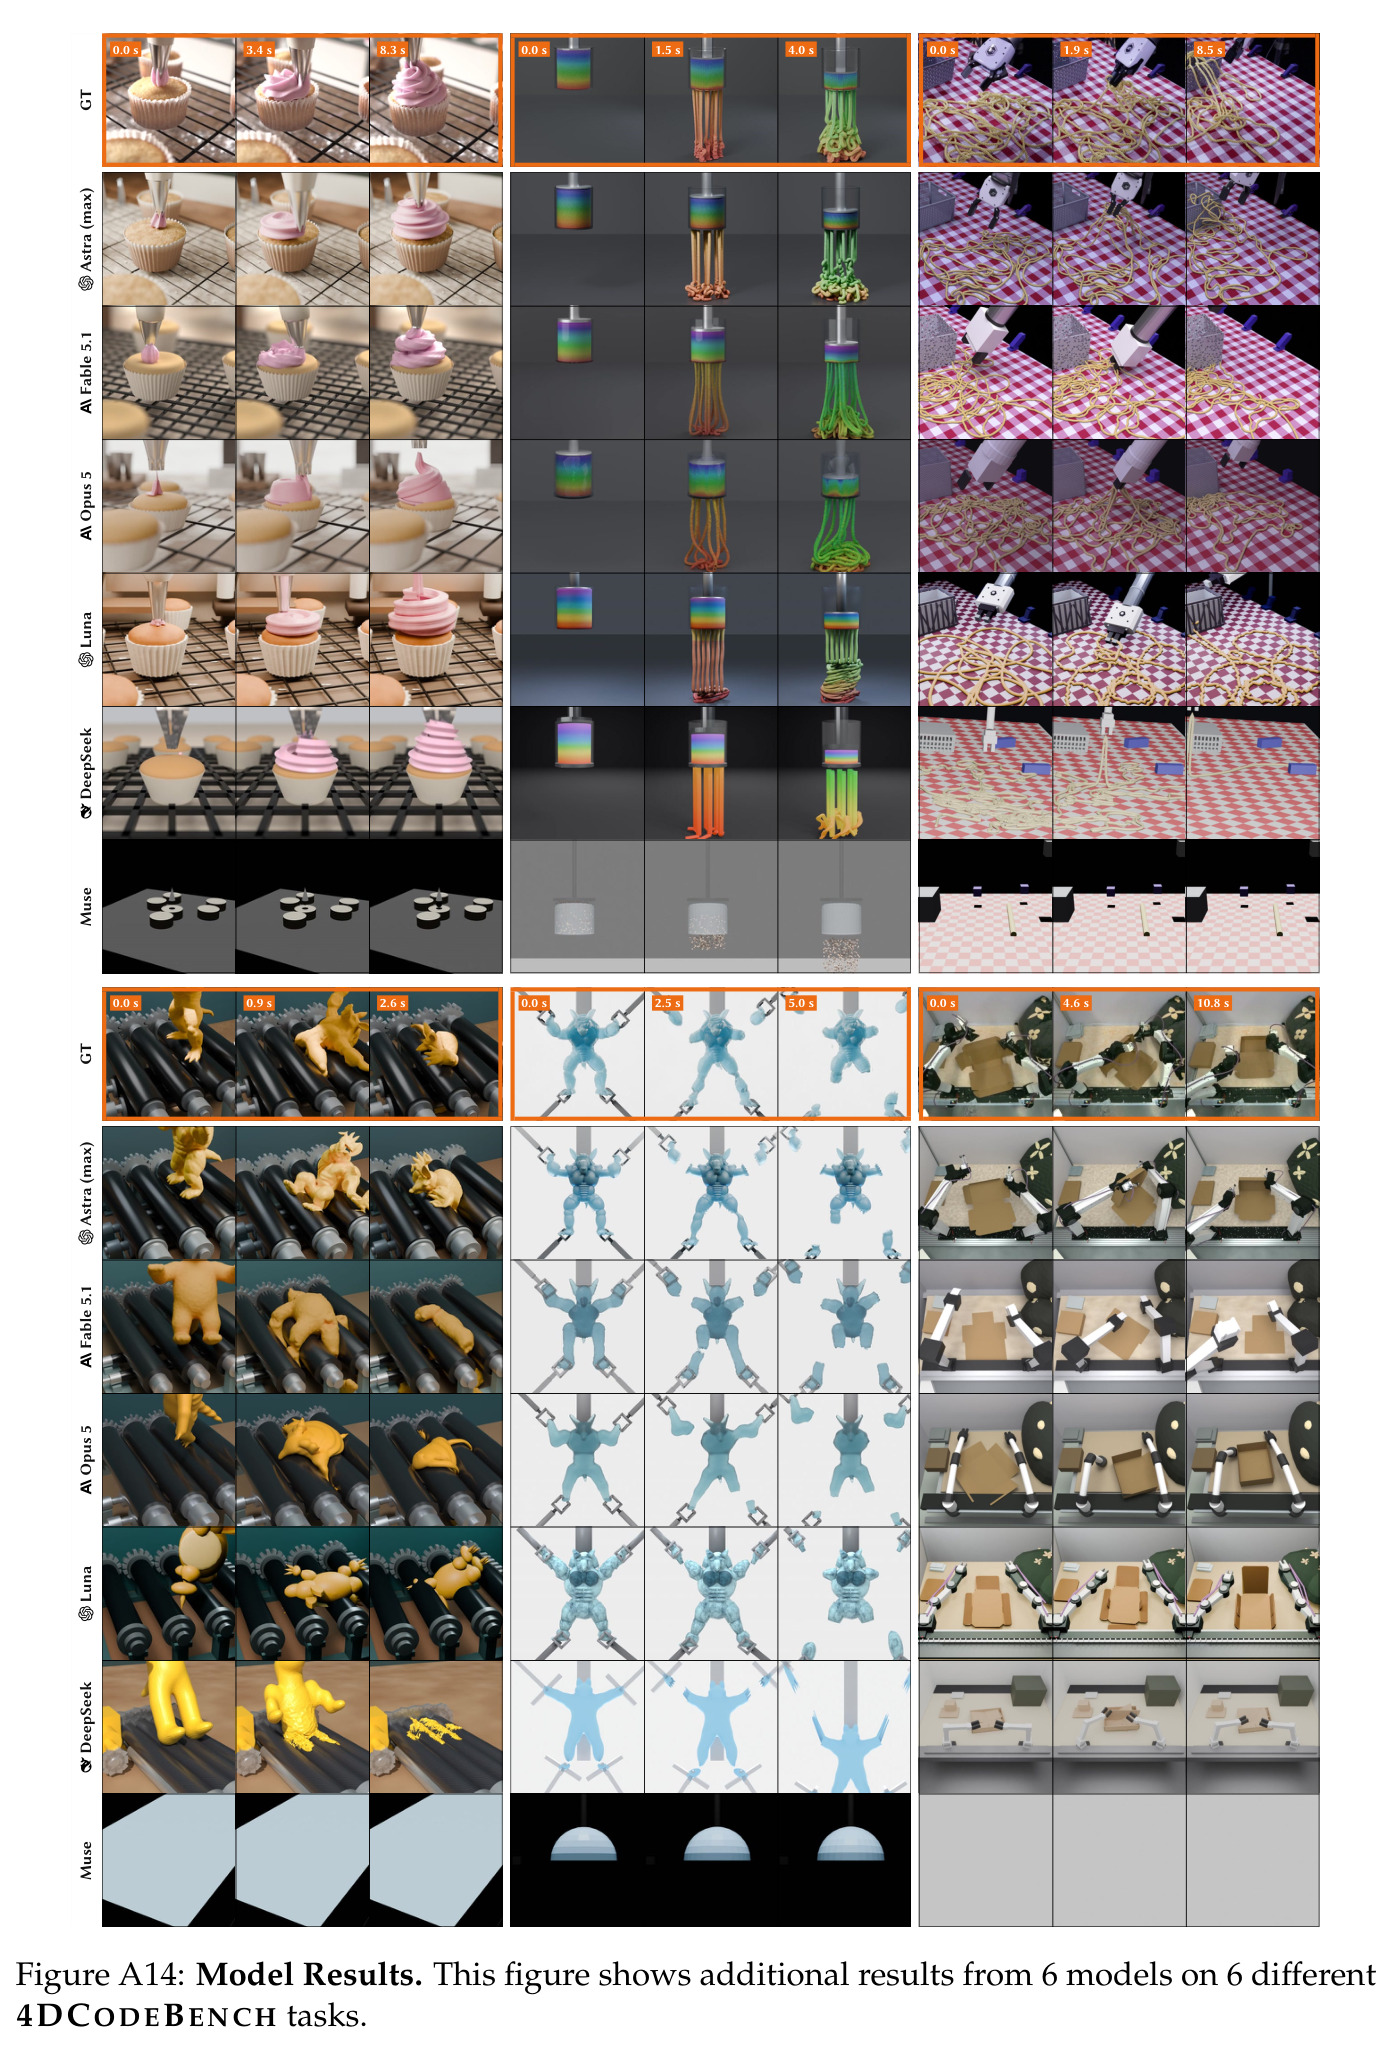
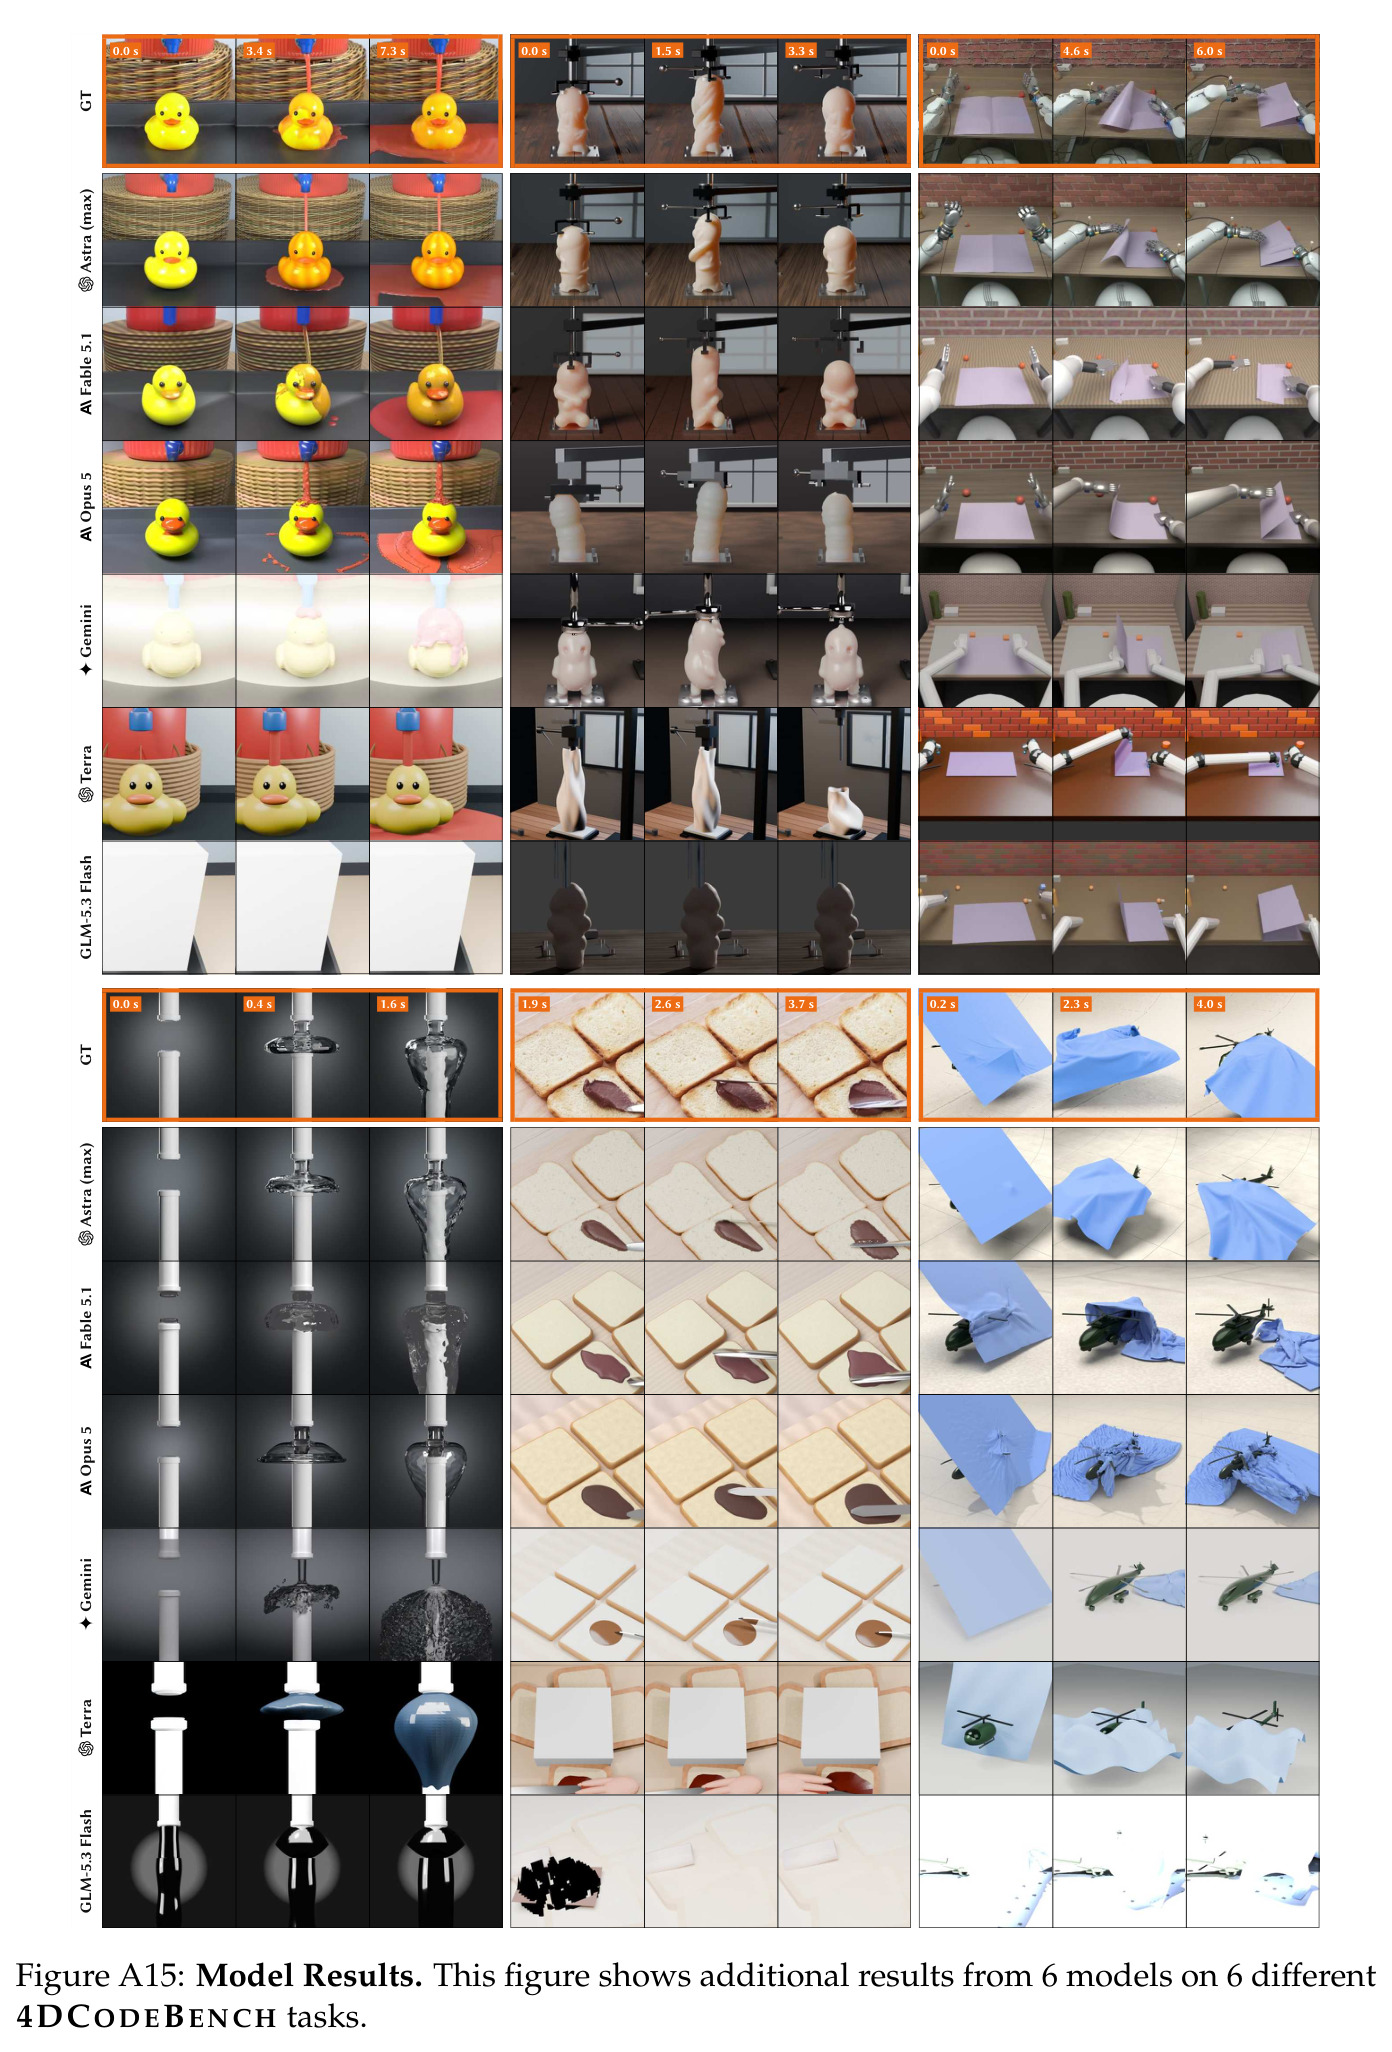
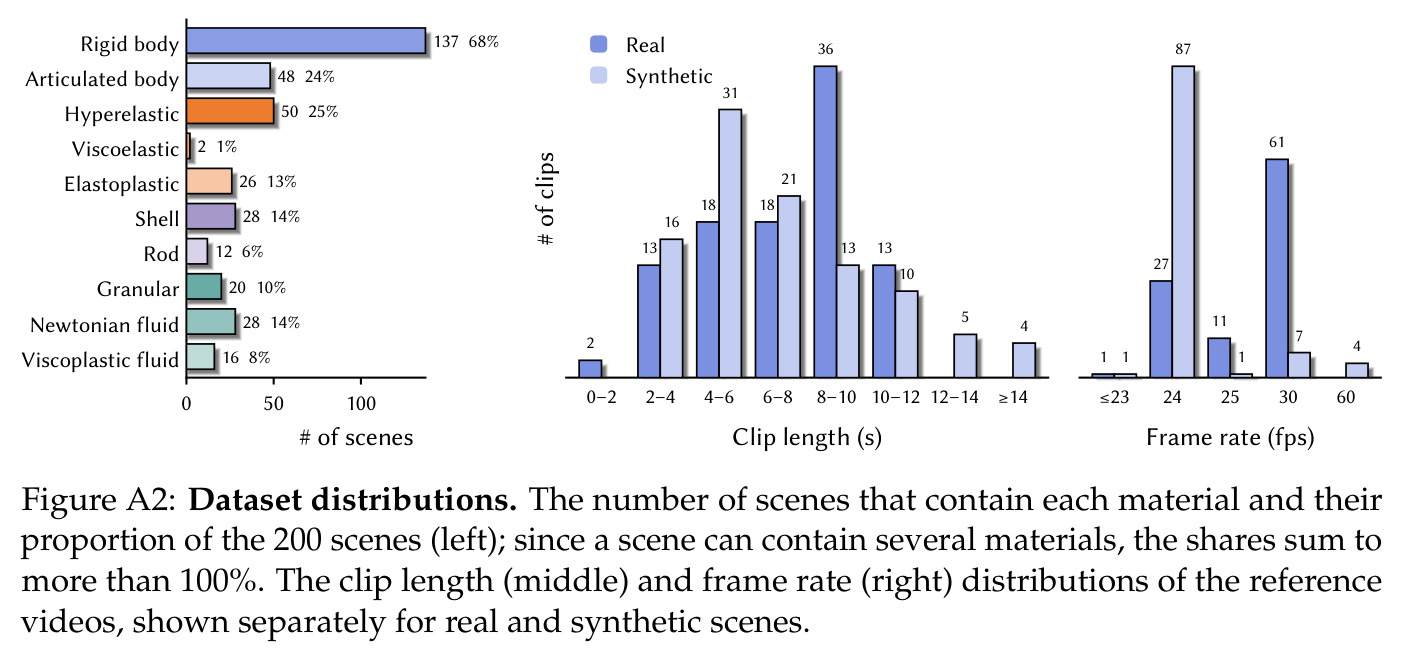
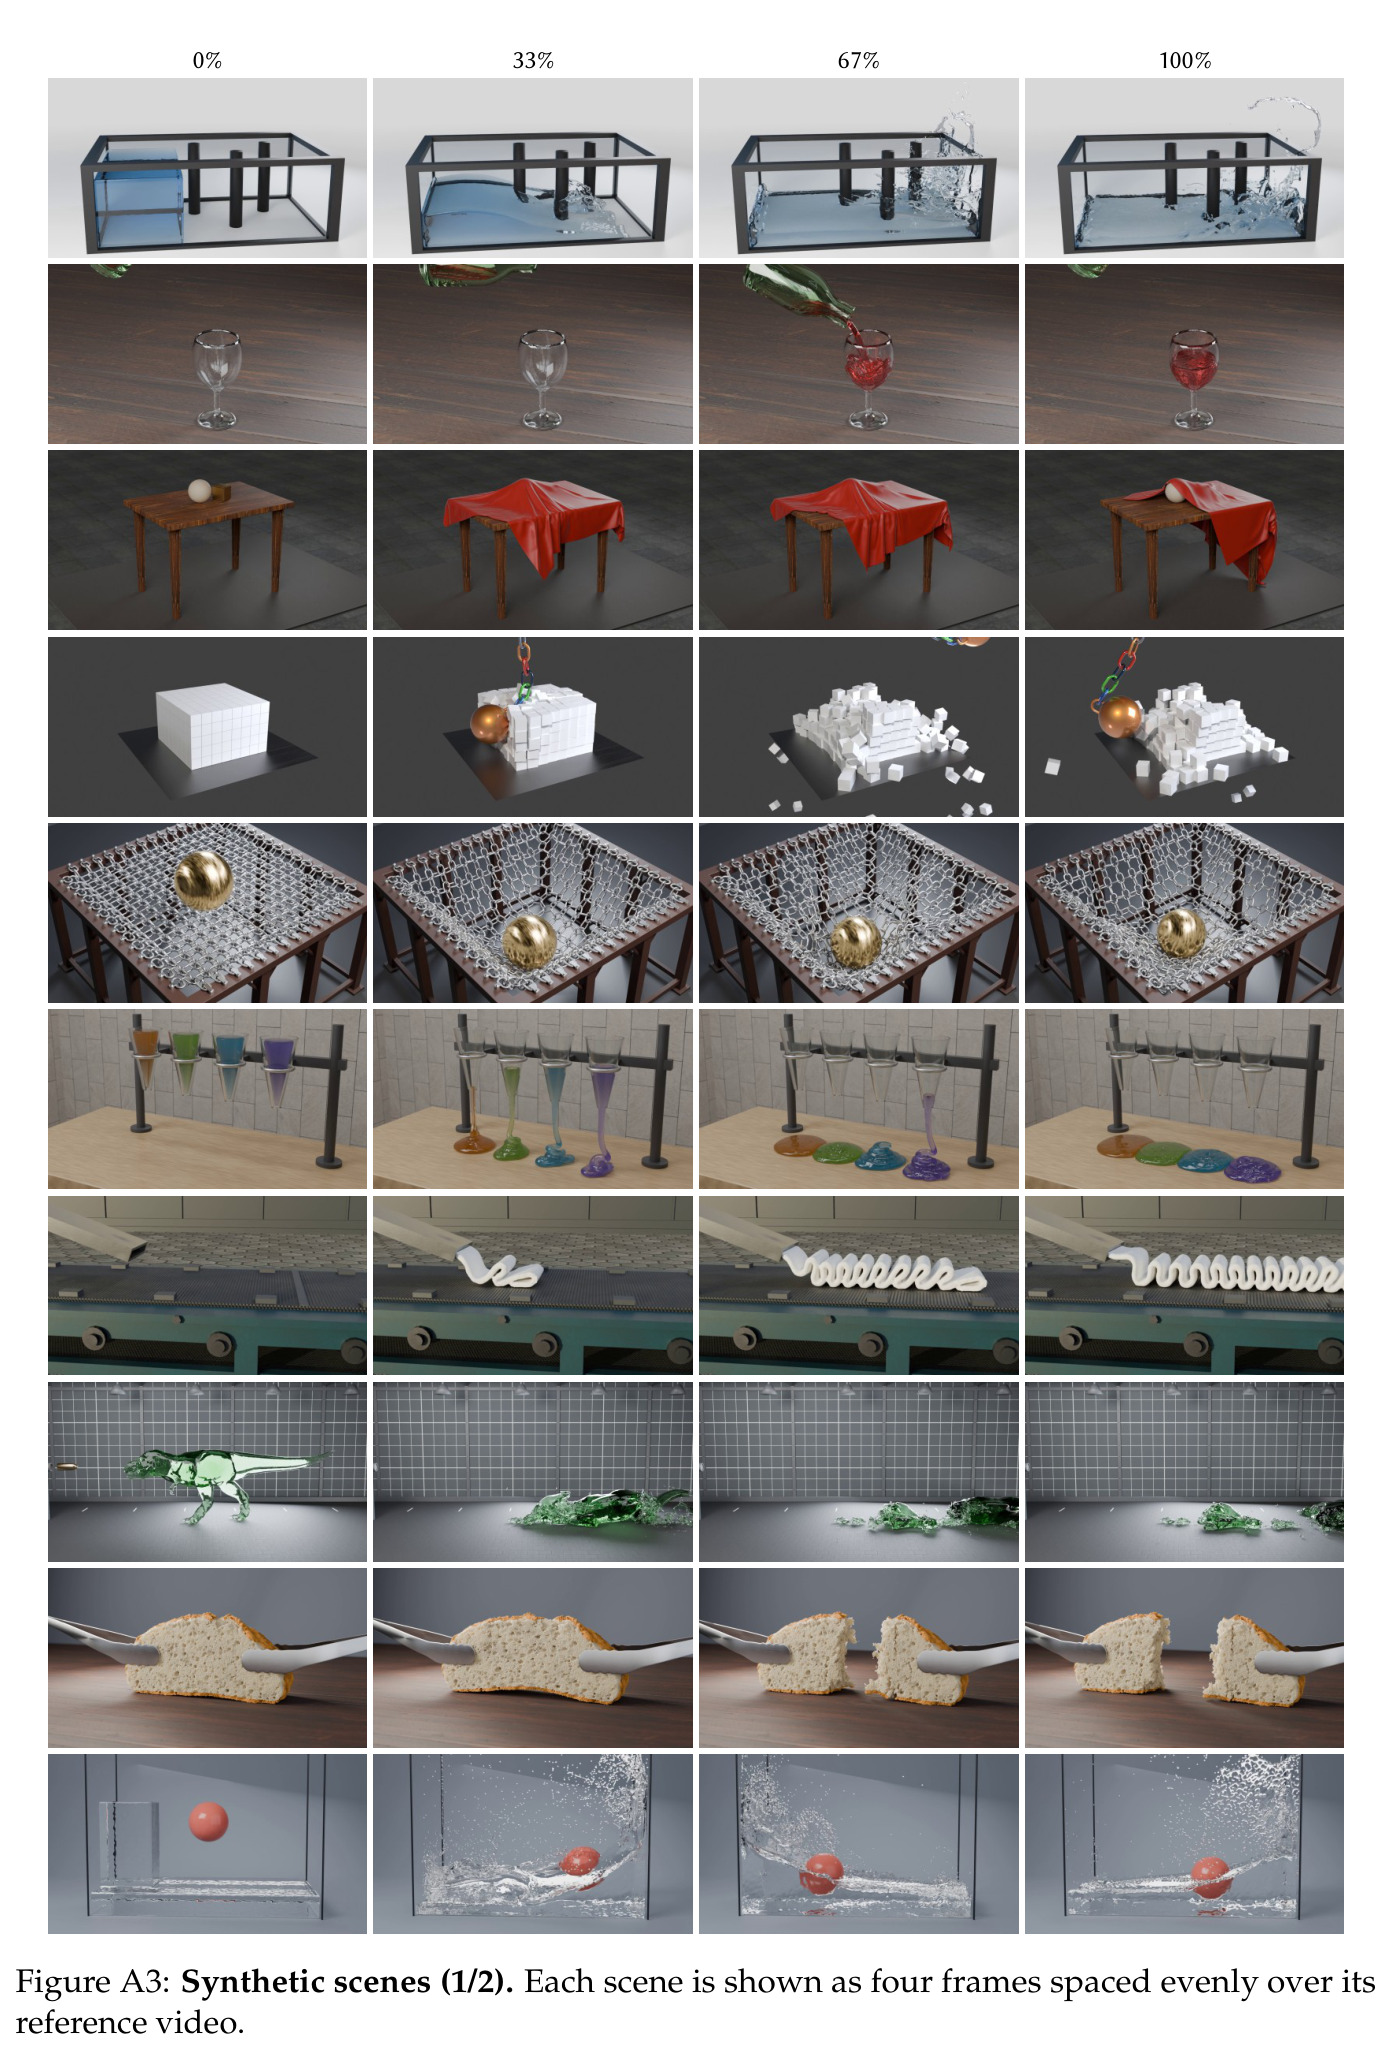
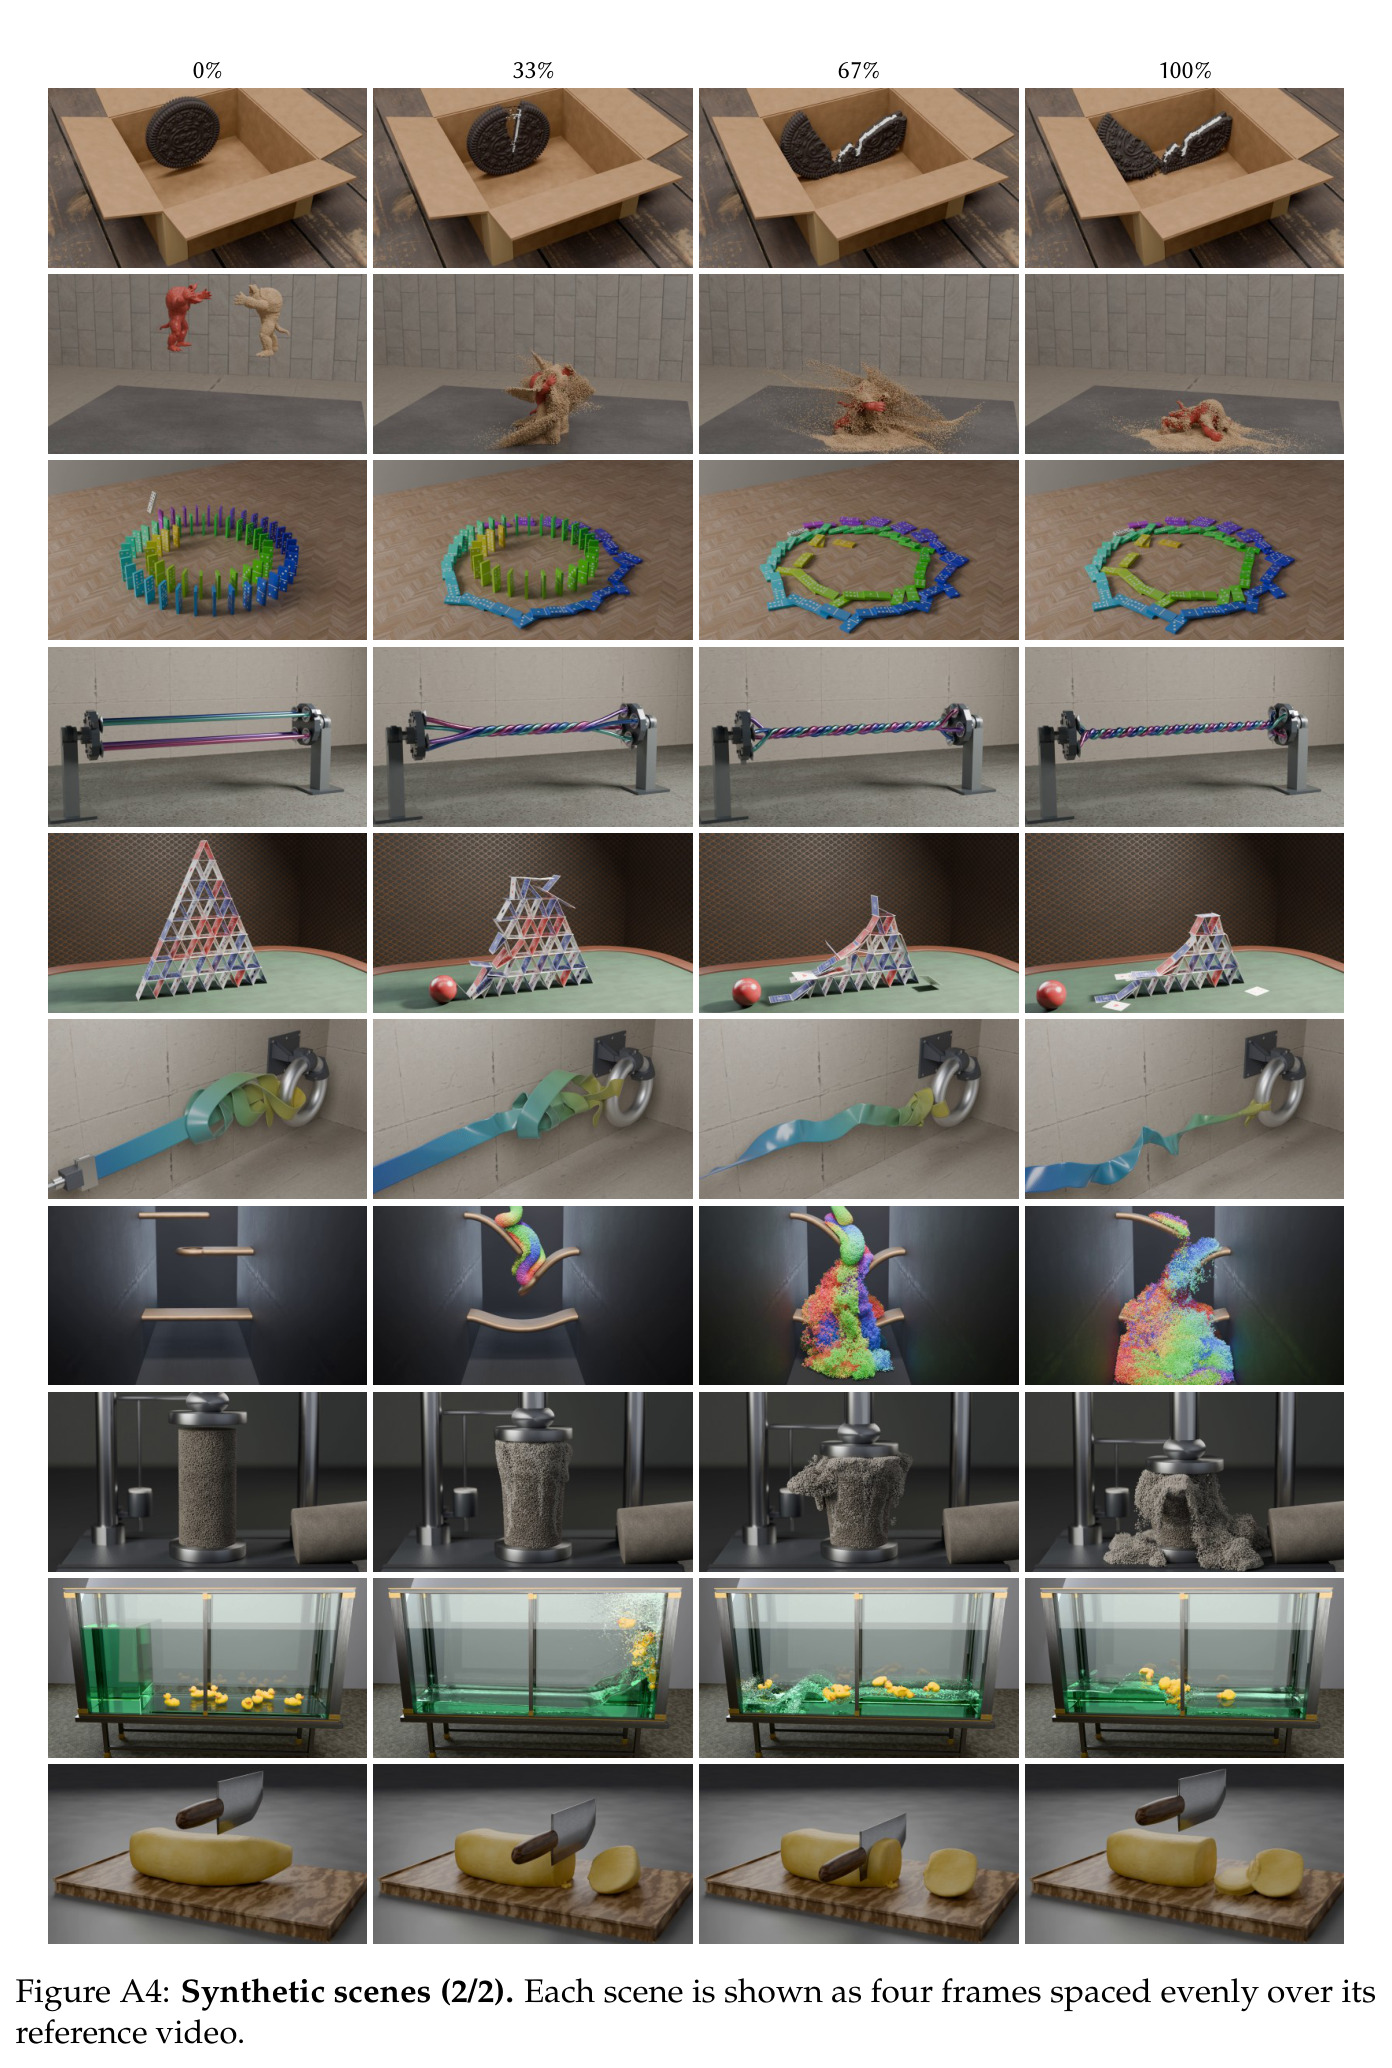
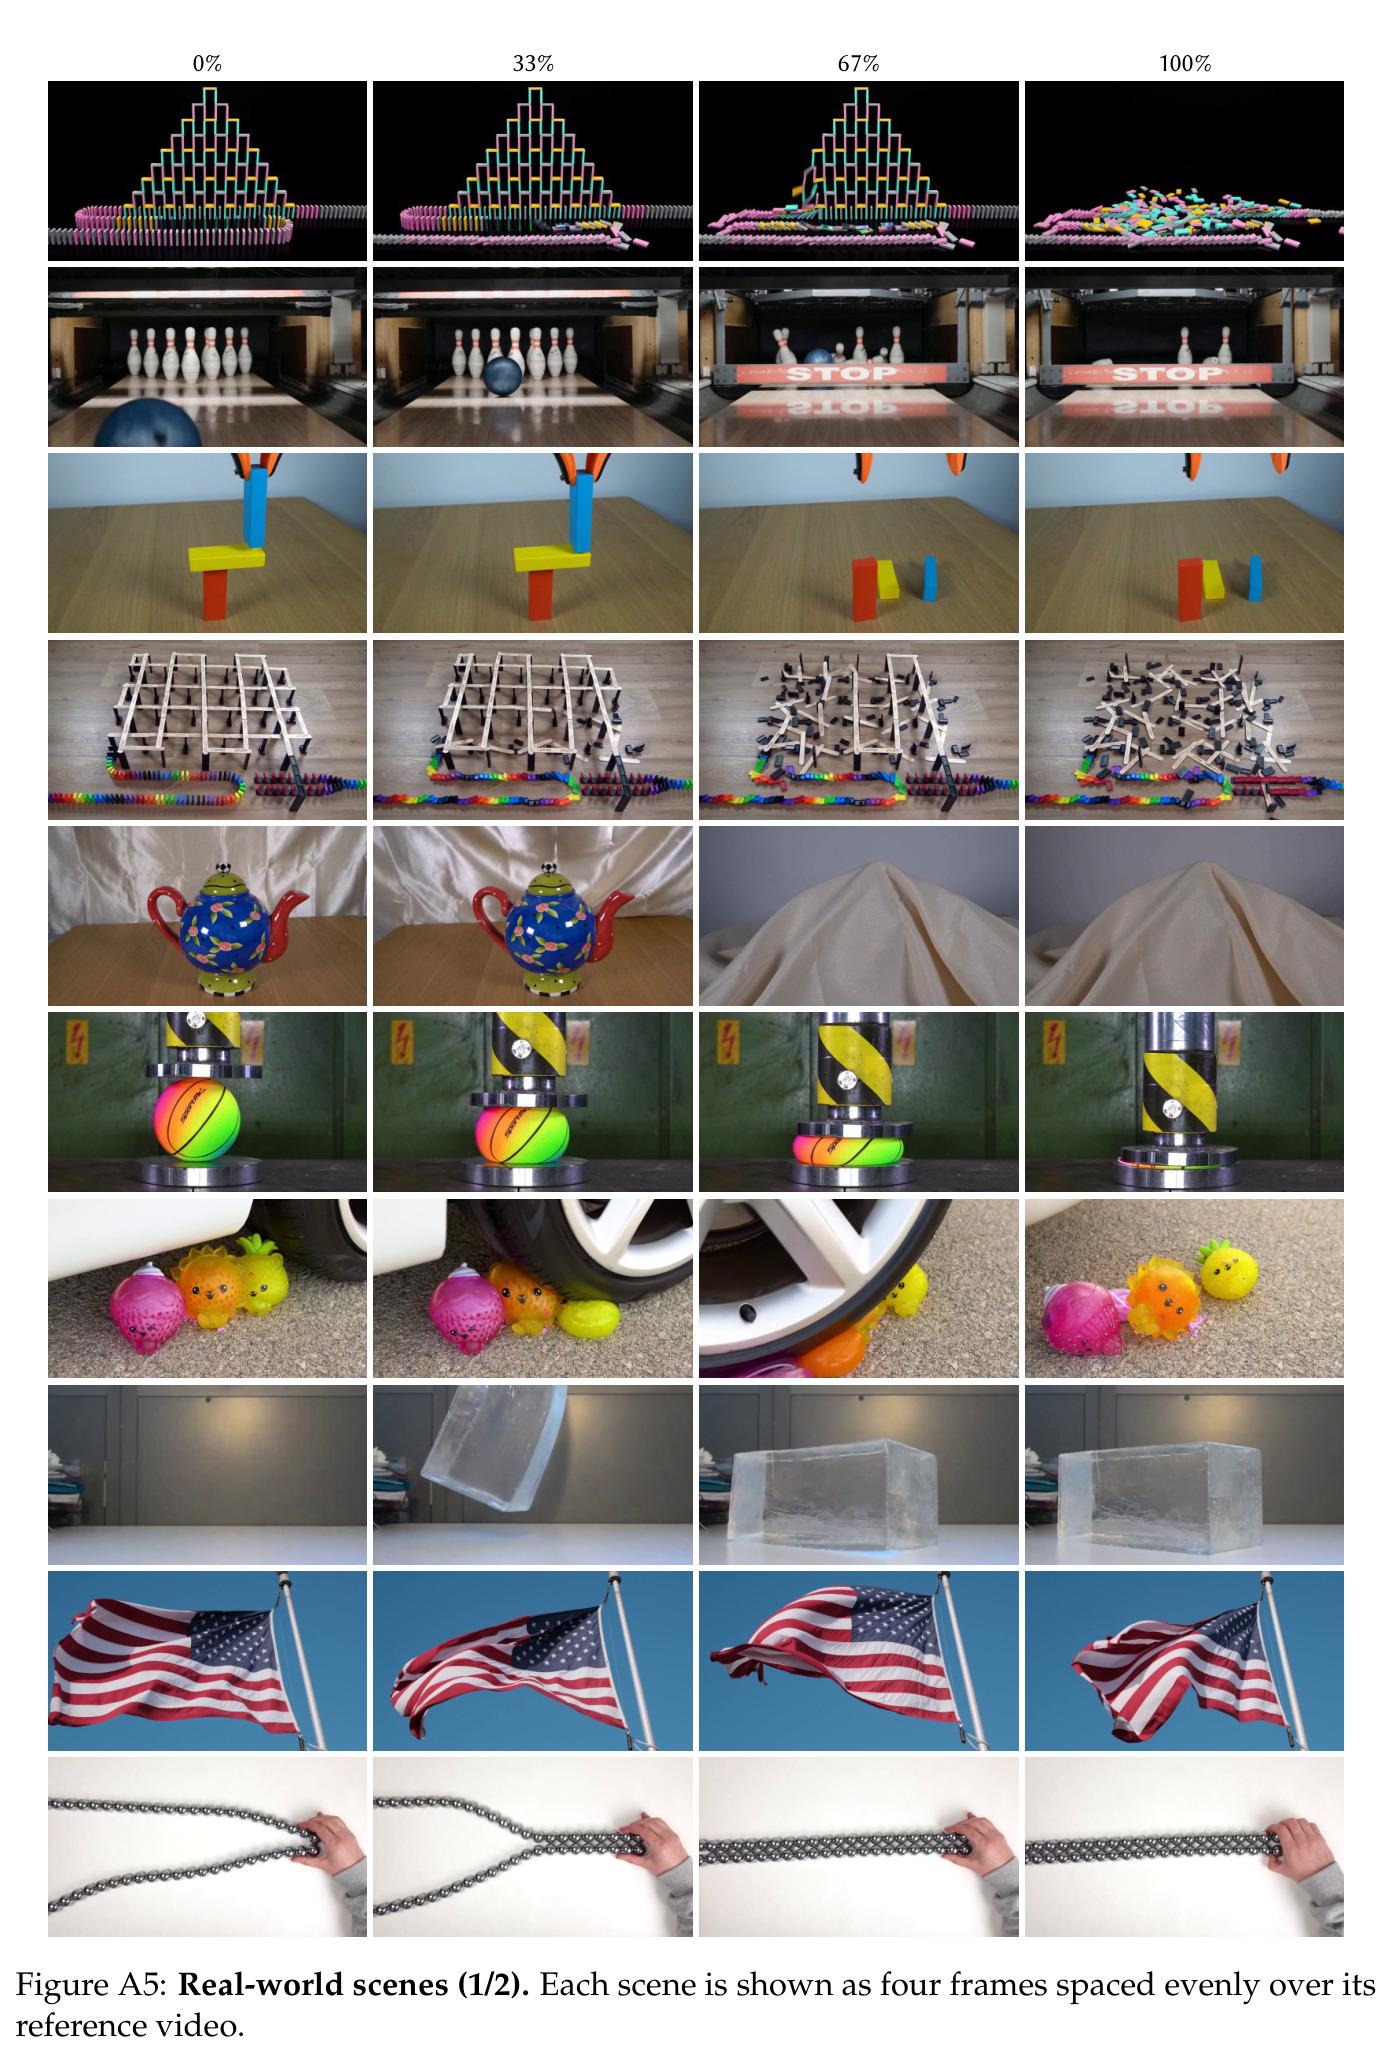
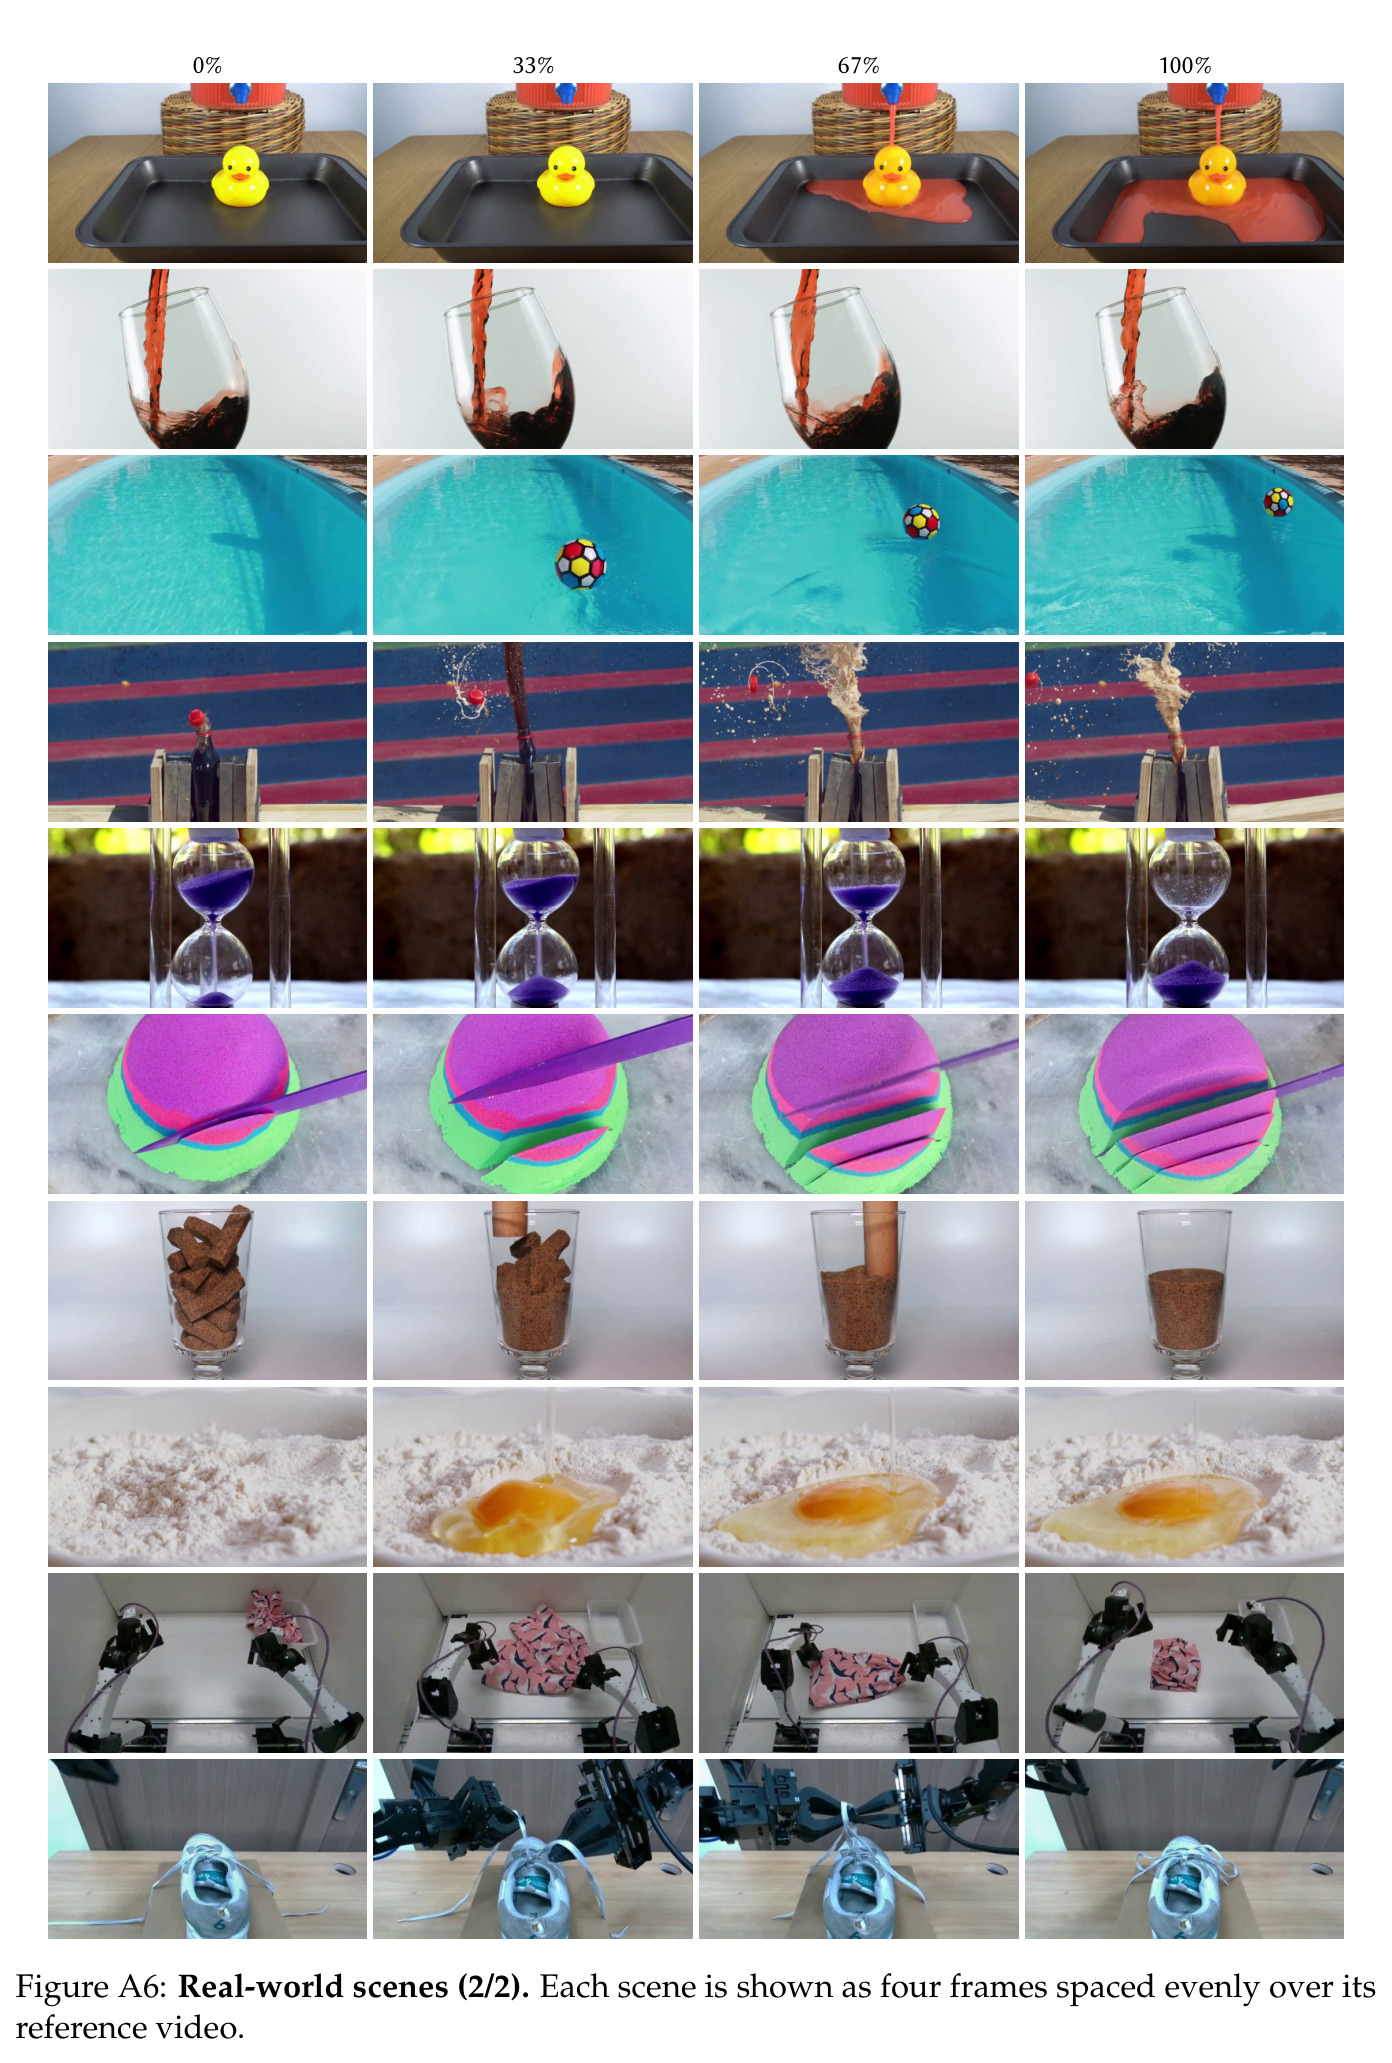
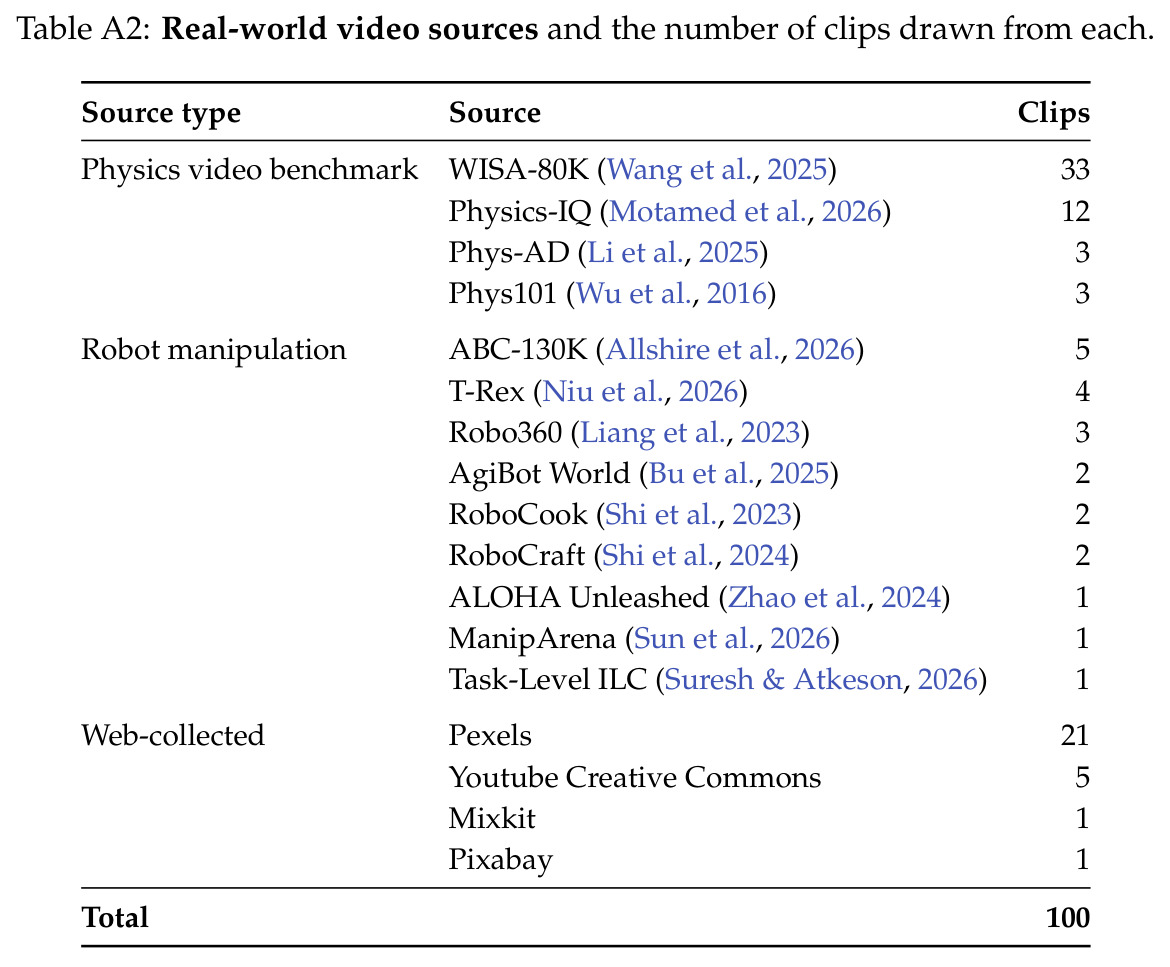
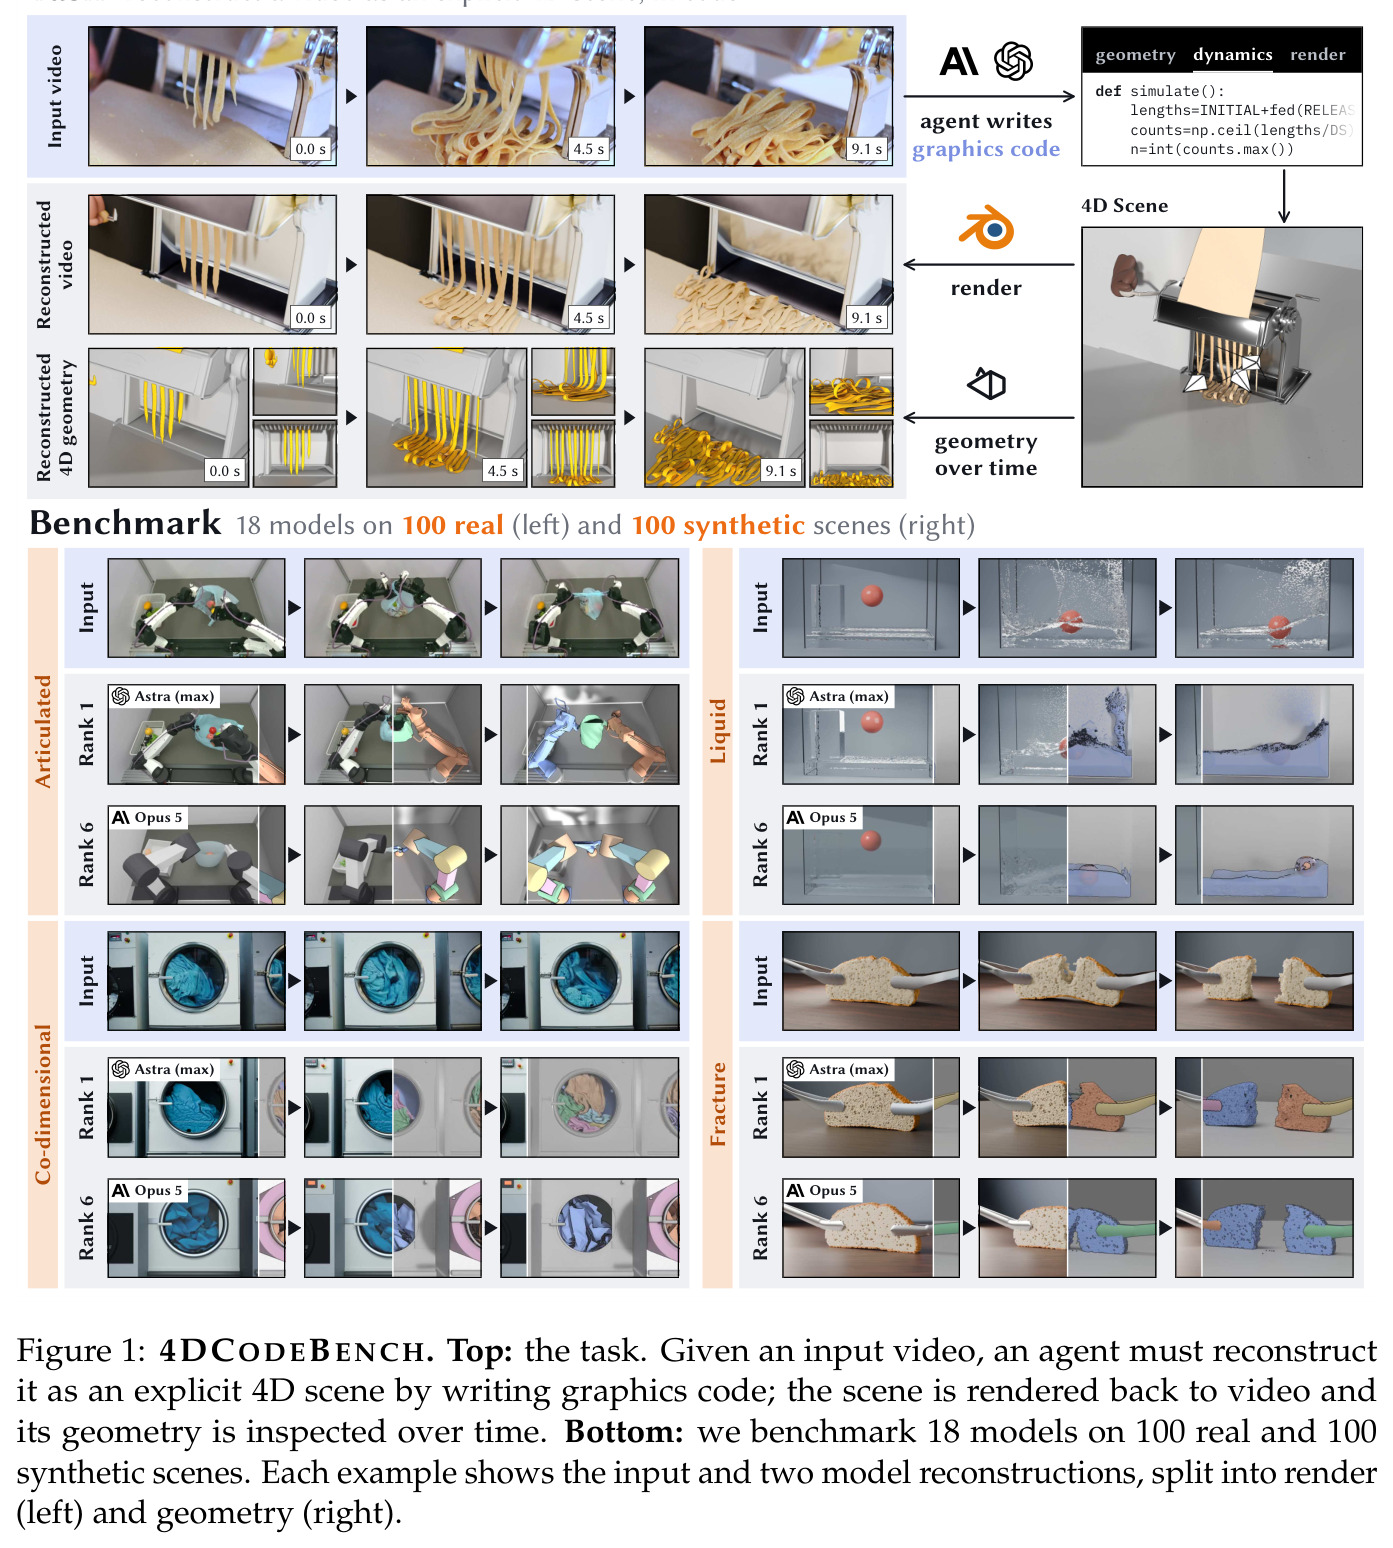
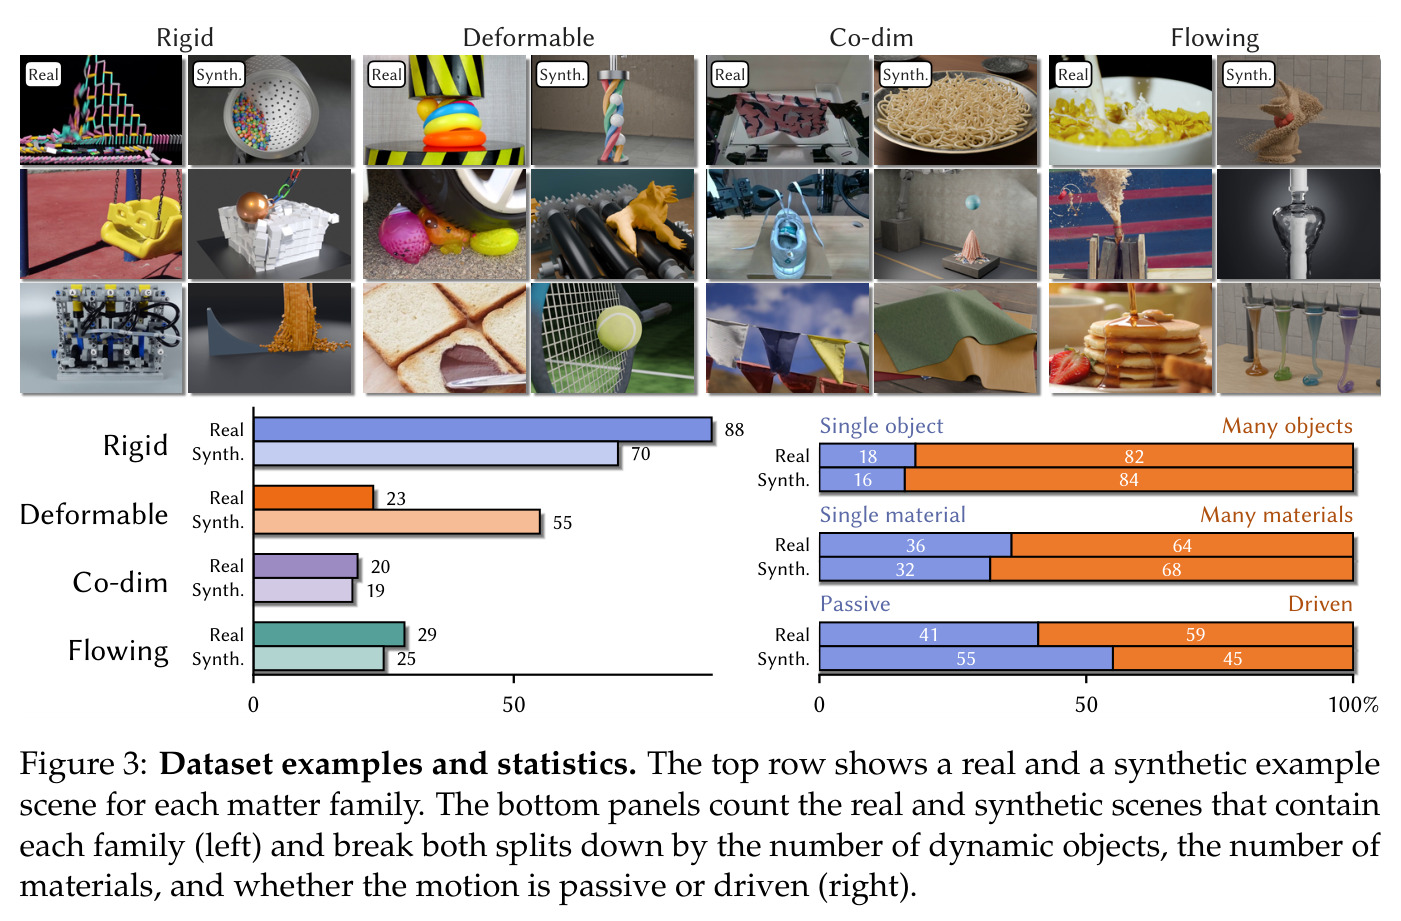
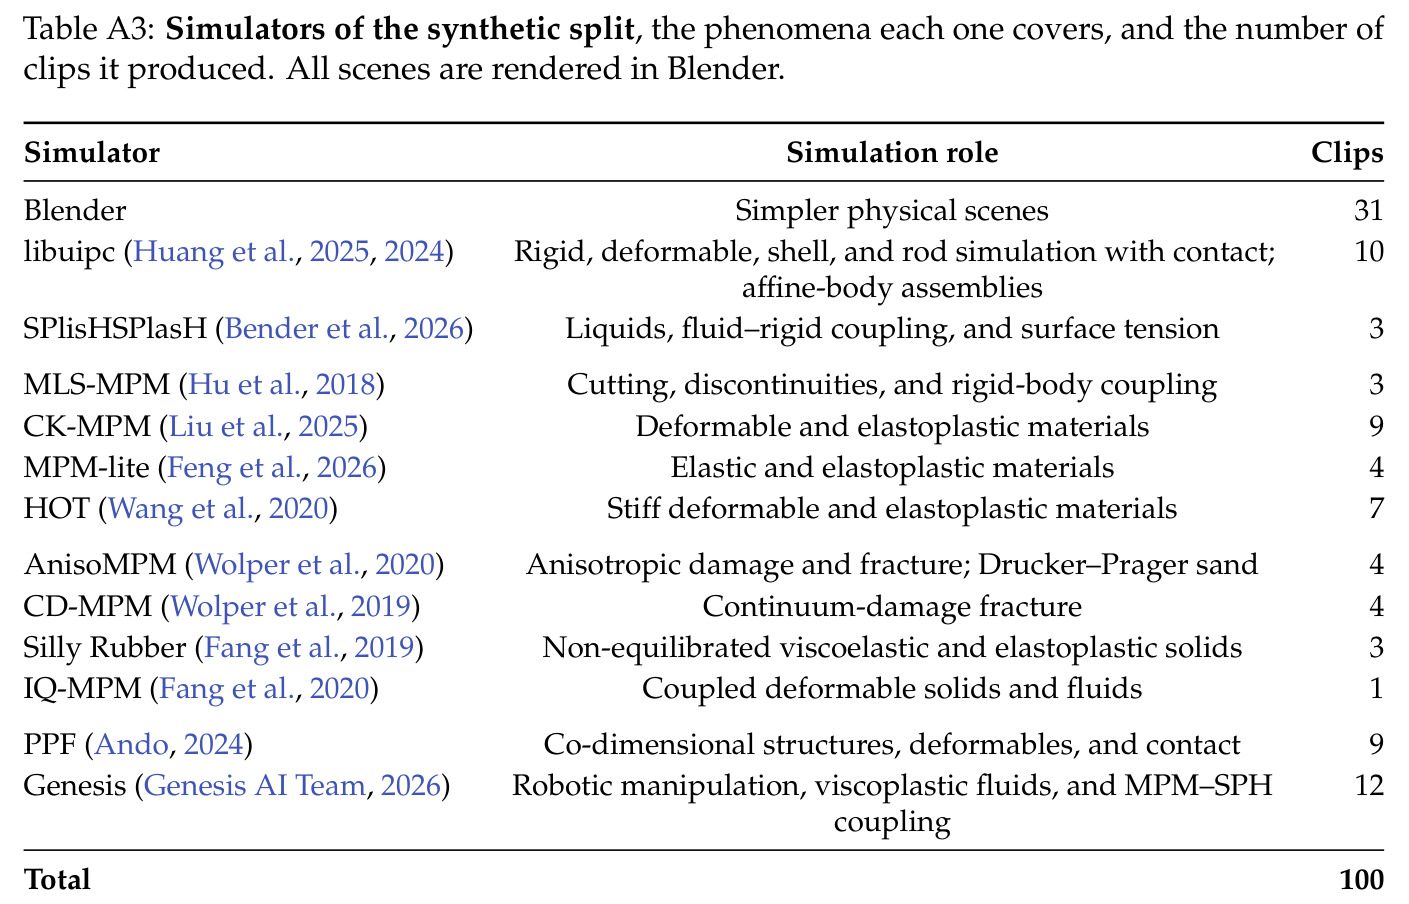
本文的目标是本文要建立 4DCODEBENCH,系统回答「多模态编码智能体能否通过写代码理解动态世界的动力学」。具体分三件事:其一,构建 200 个动态场景——100 个从物理理解、视频生成、机器人数据集与网络来源精选的真实视频,加 100 个用物理仿真器生成、带逐帧 4D 真值的合成场景,覆盖刚体/铰接、可变形体、织物绳索等共维结构、颗粒与流体四大物质族,83% 场景含多个动态物体、66% 含多种材料;其二,设计分层评估协议:对渲染外观(Perceptual)、2D 运动、2.5D 深度几何、3D 静态几何与 3D 动力学五个指标族分别打分,辅以 VLM 问答与成对比较 Elo;其三,在统一隔离执行环境中评测 18 个前沿与开源权重模型,并用 76 人、3,587 次判断的人类偏好研究验证自动指标与人类判断对齐。
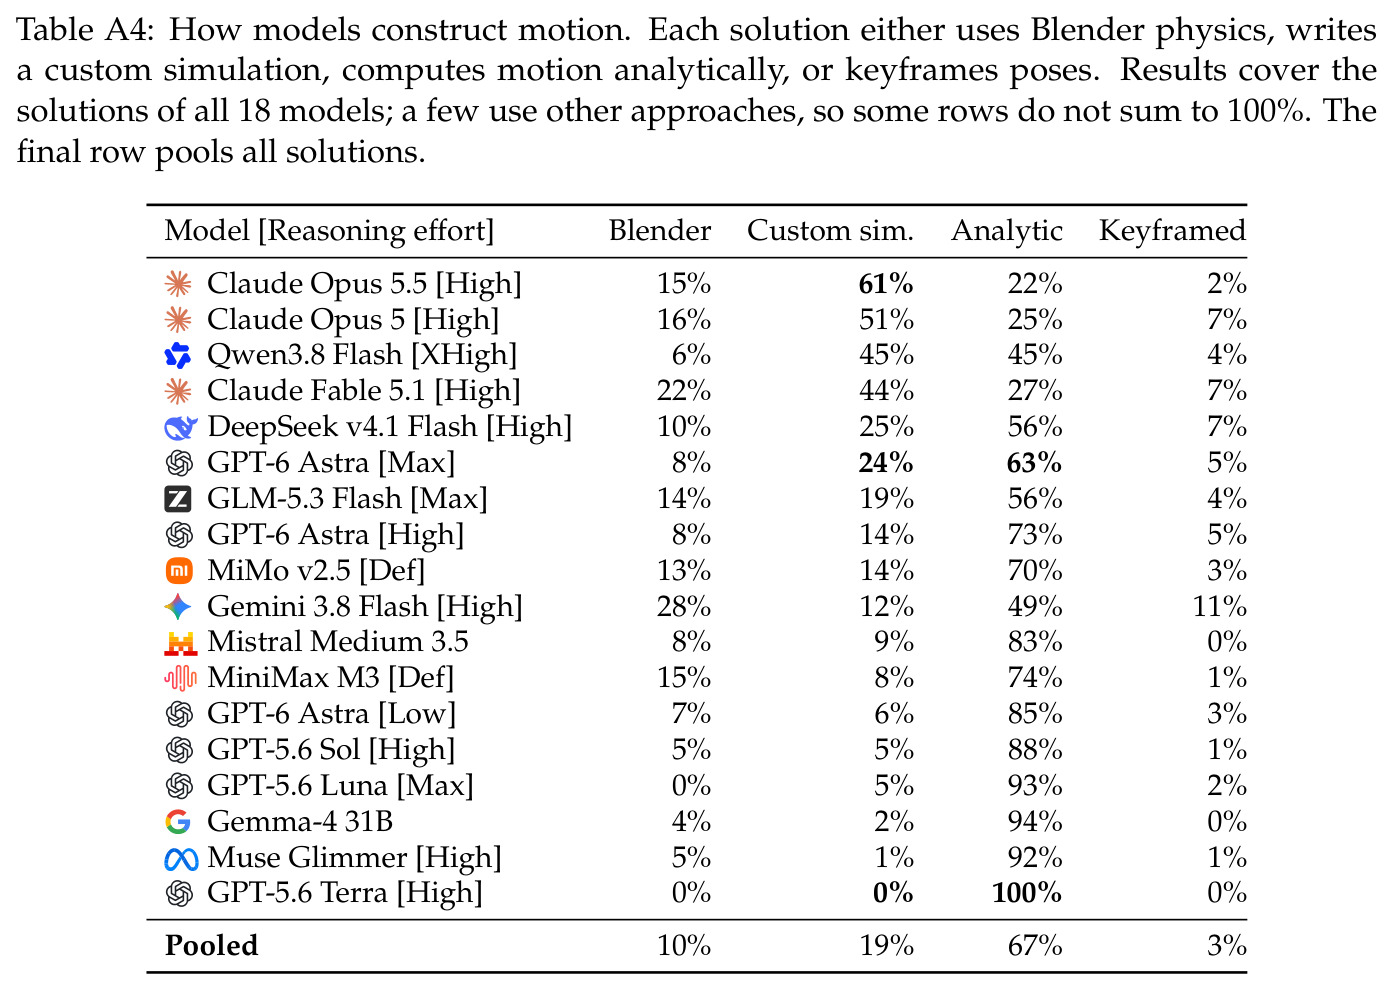
与已有工作不同的是,本文的独特切入是把 4D 逆图形学完全形式化为代码生成:智能体只拿到参考视频和固定任务提示,不给场景名、物体清单或任何语义先验,必须自己决定用解析运动、自定义仿真、Blender 物理还是关键帧来实现动力学——实现方式本身成为研究对象,而非被协议固定。这把「选什么抽象」从工程预设移入了推理问题,使不同模型的建模策略差异第一次变得可测量(后文统计出 67% 解析运动、19% 自定义仿真等悬殊分布)。与已有工作不同,本文坚持真实与合成双源互补:真实视频保证外观与动力学的真实性,合成场景提供逐帧几何真值,使评估可以直接在 3D/4D 空间进行;同时刻意选取固定相机、无剪辑、少遮挡的片段,把难点聚焦在场景自身的几何变化与物理运动上。
核心方法
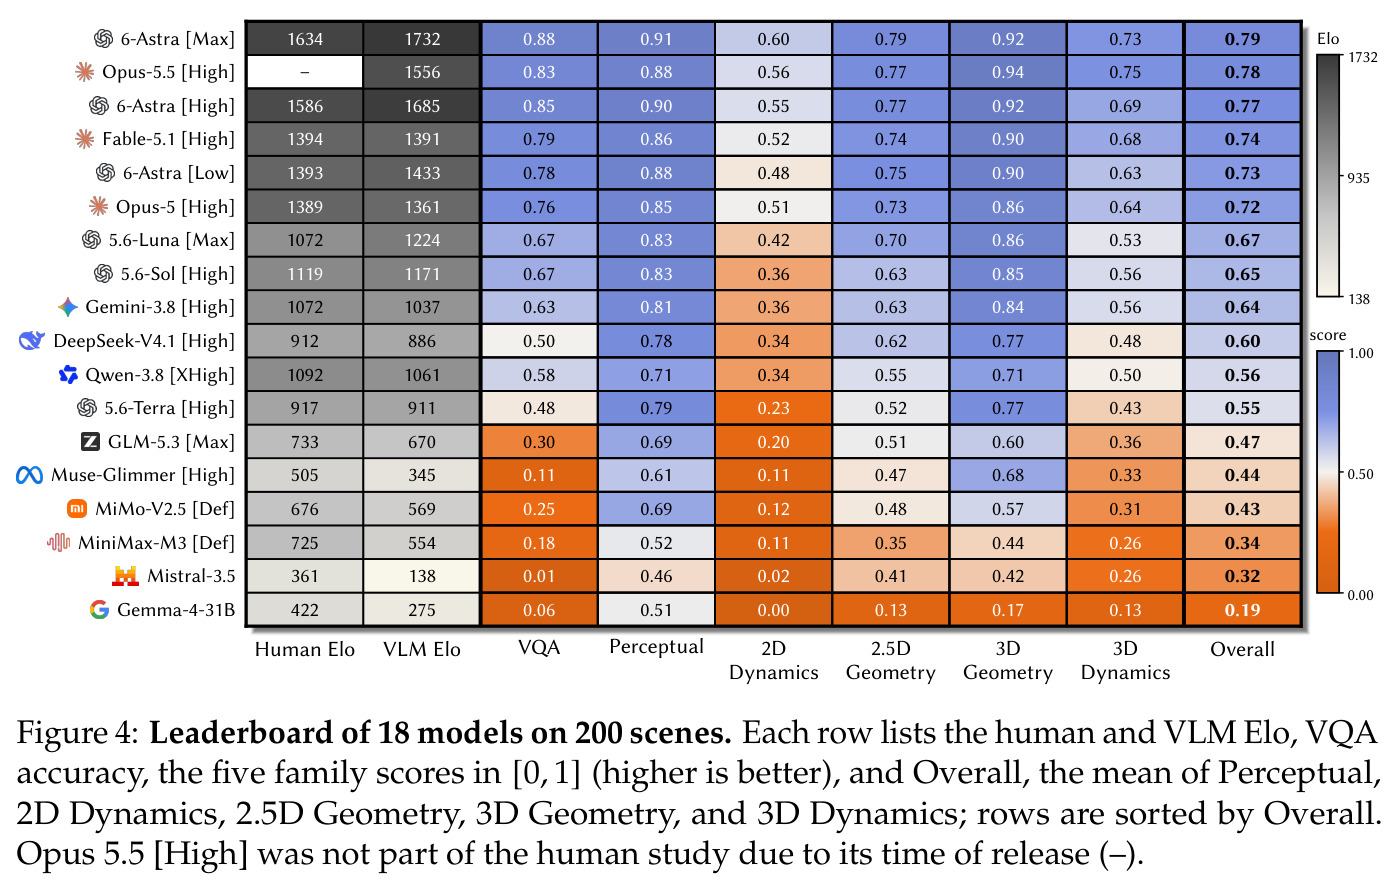
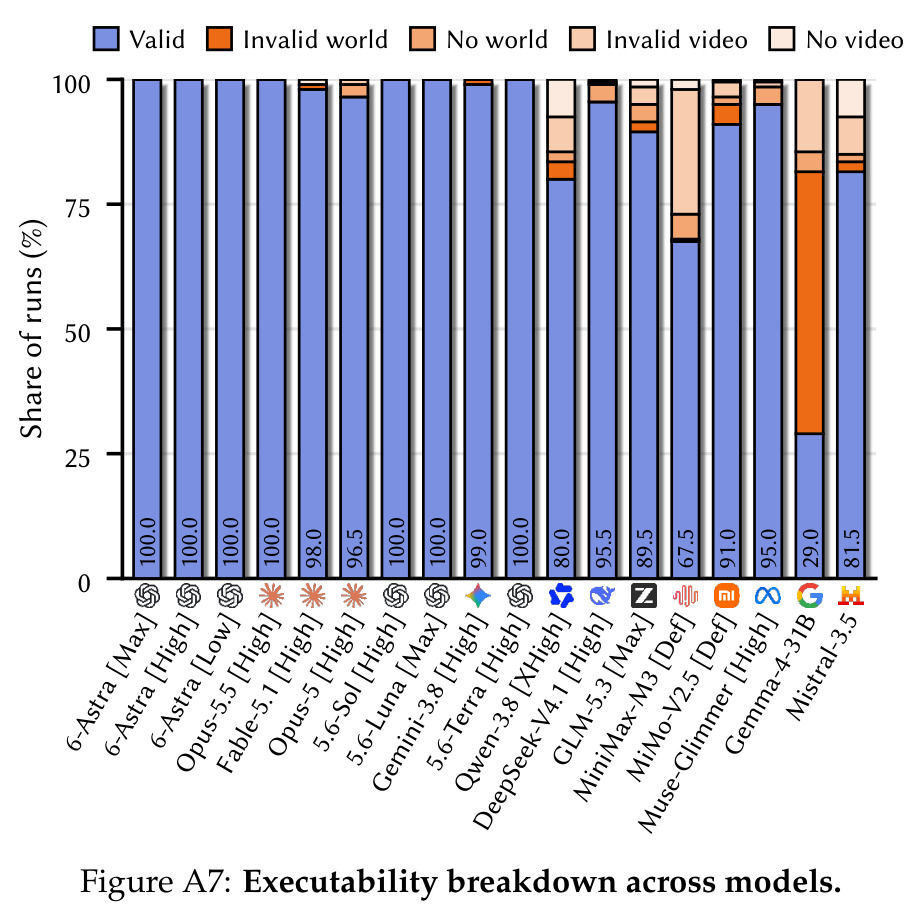
任务形式化为:给定参考视频 $x_{\text{ref}}=(x_0,\dots,x_{T-1})$,智能体 $A$ 产出可执行图形程序 $\Gamma=(\gamma_1,\dots,\gamma_m)$;执行 $\Gamma$ 必须在每个被评估时刻暴露几何状态 $s_\Gamma(t)$,并经渲染过程 $R_\Gamma$ 在 Blender 中得到 $\hat{x}_k = R_\Gamma(s_\Gamma(k/r))$,其中 $r$ 为参考帧率,$k=0,\dots,T-1$。渲染输出须匹配参考的分辨率、帧数与帧率,且程序执行时不得访问参考视频。动力学实现完全开放:可用 Blender 动画、Taichi/Warp 等仿真库或自写代码。交付物包括可执行程序、渲染视频、相机参数、逐帧几何与动态物质的时间对应。Overall 分数是五个指标族(Perceptual、2D Dynamics、2.5D Geometry、3D Geometry、3D Dynamics)的均值;未能产出有效输出的失败运行在相应指标记最差分,整体 90.1% 的提交完全可执行。
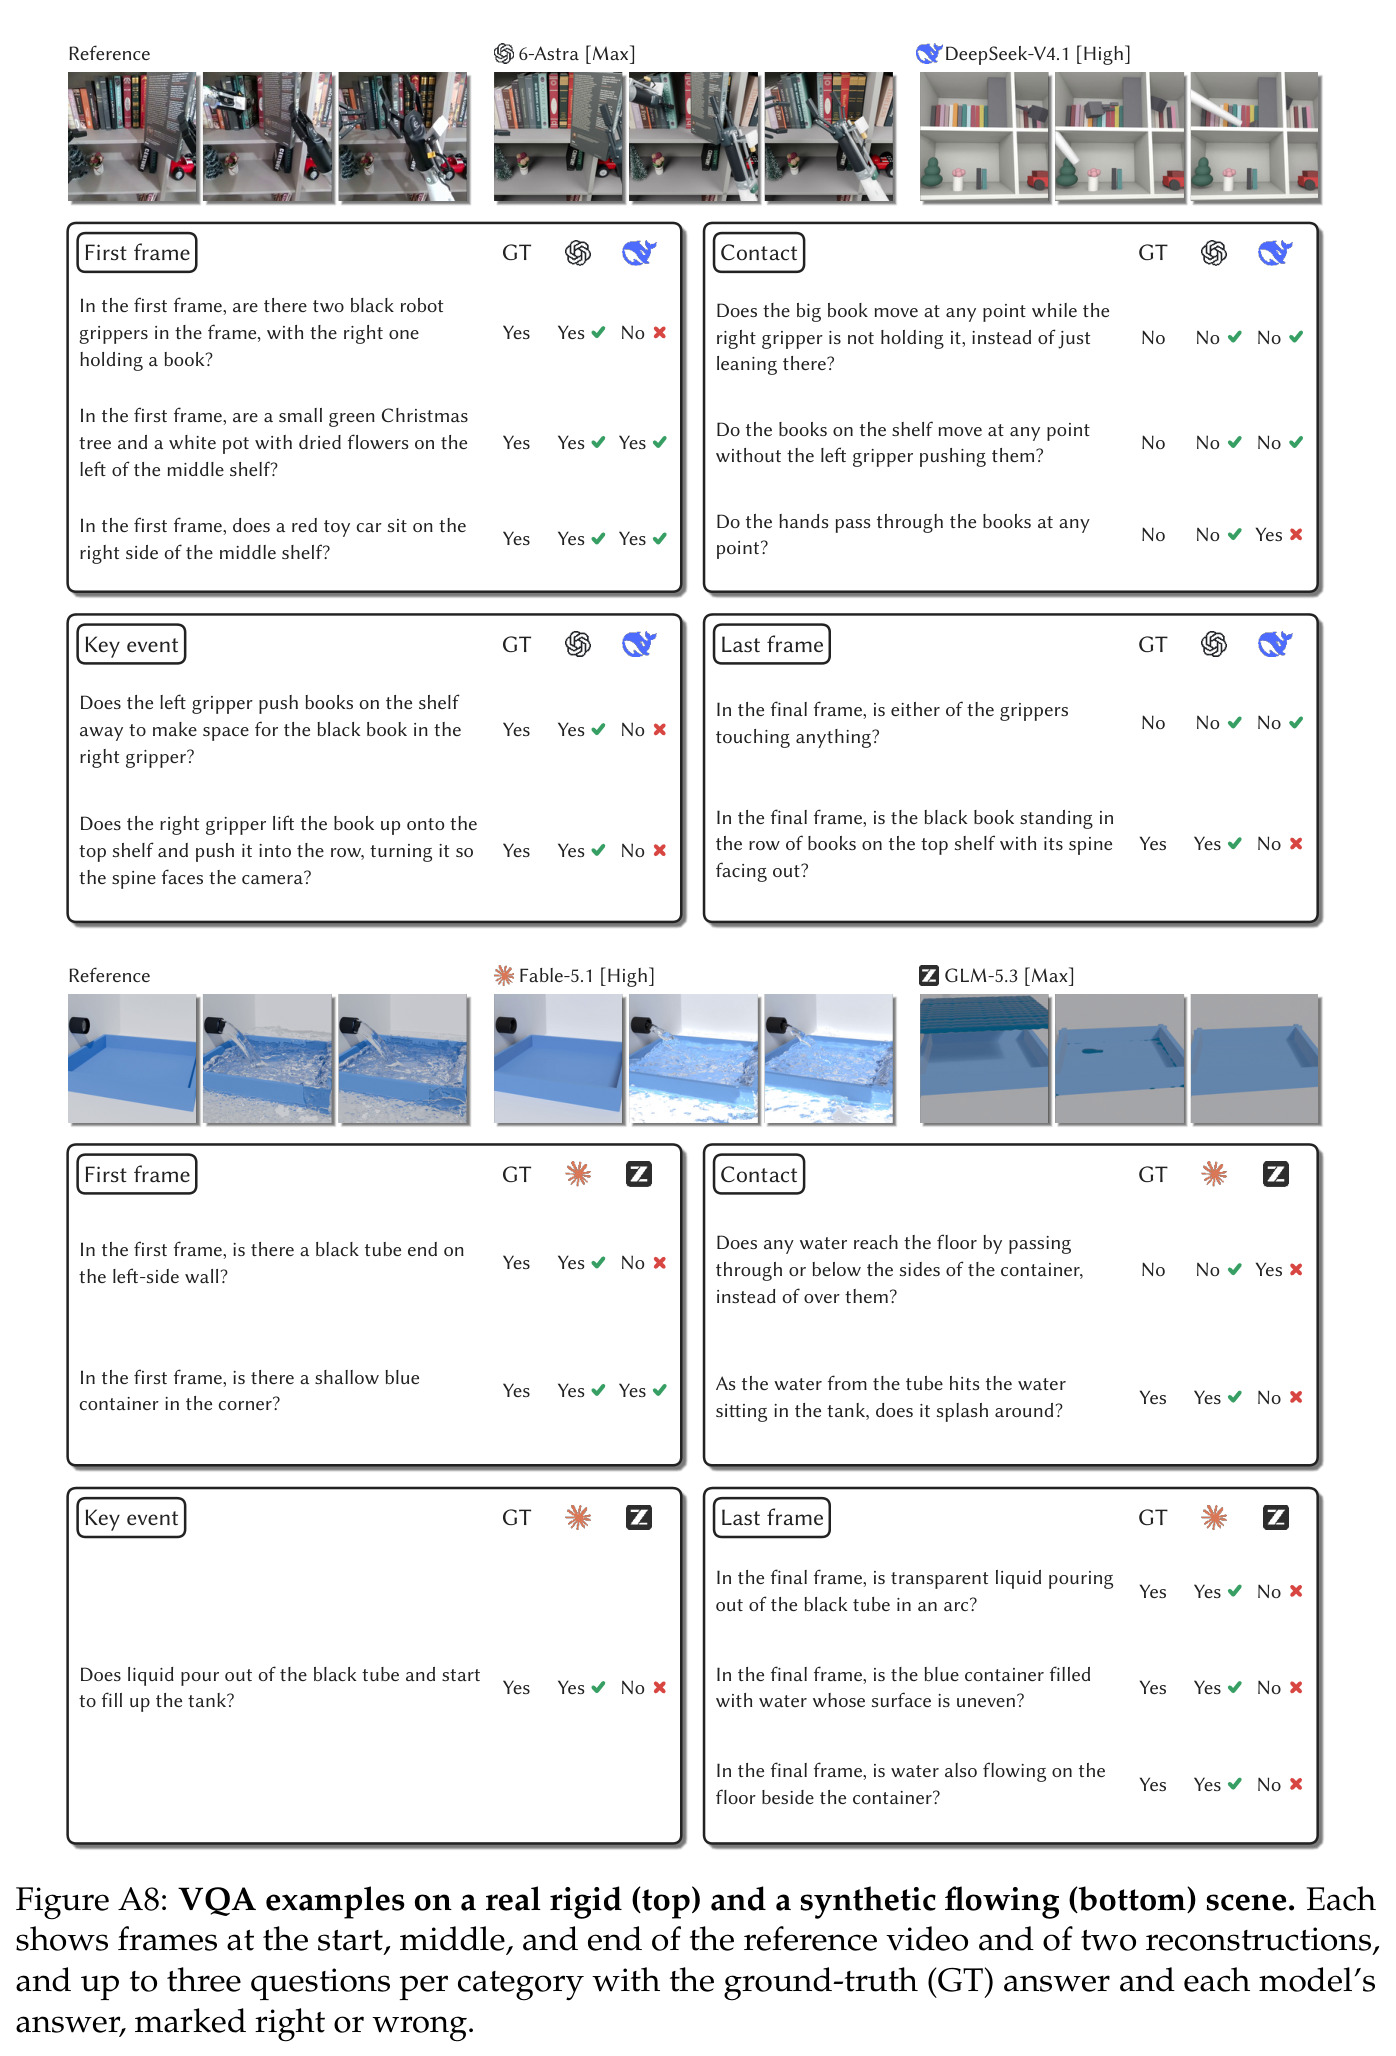
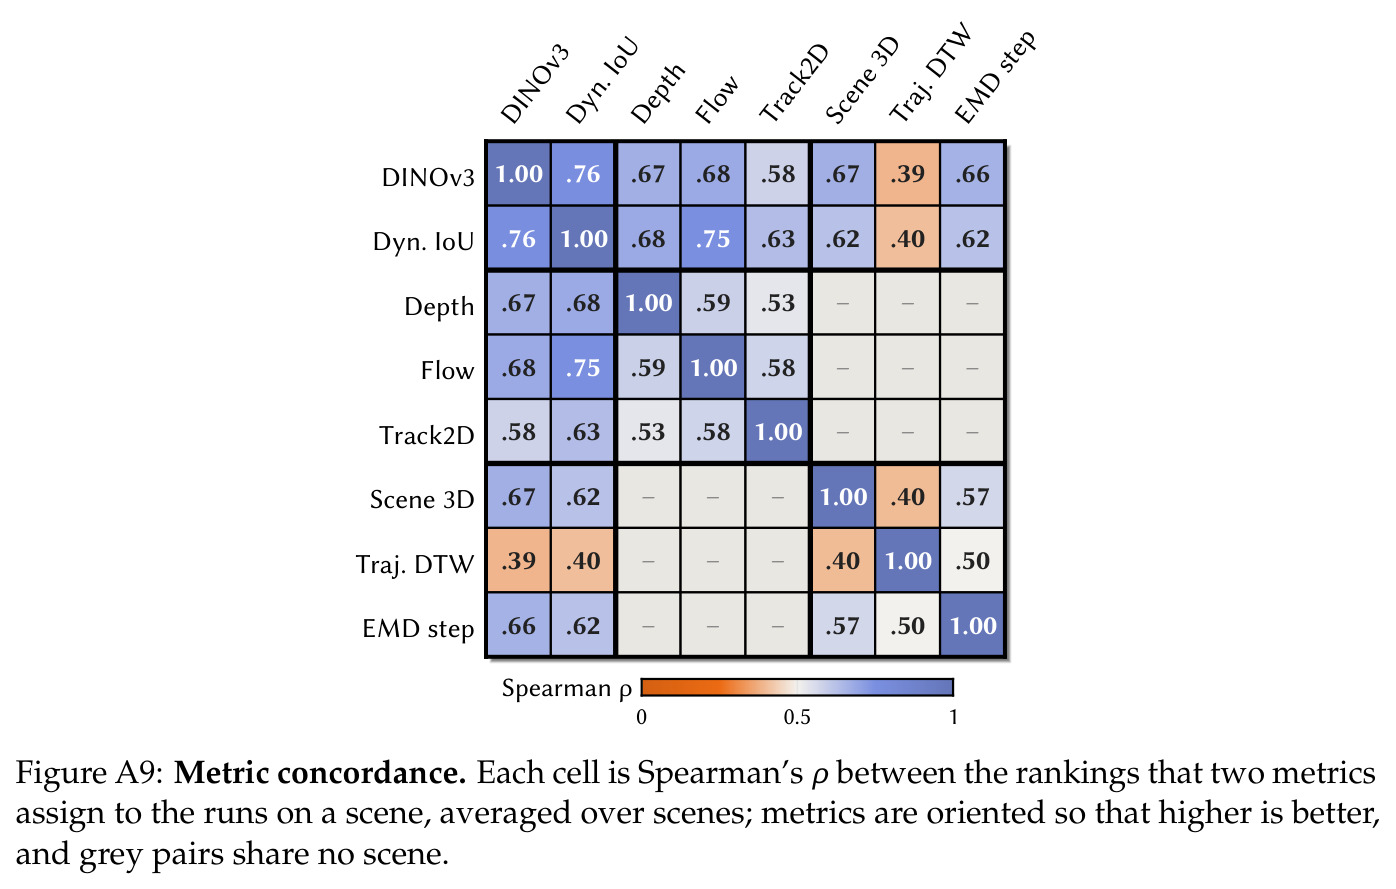
核心创新有三层。第一,把「怎么实现动力学」完全交给智能体:不指定仿真器、表示或运动方案,于是解析运动、自定义仿真、Blender 物理、关键帧各被使用 67%、19%、10%、3%,策略差异本身成为可测量的研究对象——Opus 5.5 [High] 有 61% 的解用自定义仿真,Terra [High] 则 100% 用解析运动。第二,评估按「看得见的外观」与「看不见的动力学」解耦:全部 200 个场景用 DINOv3 相似度评 Perceptual、Dynamic IoU 评运动覆盖;真实场景用现成视觉模型从参考视频估计光流、点轨迹与深度,与从 4D 世界解析计算出的对应量比对;合成场景在配准后用 Chamfer 距离评第 0 帧静态几何,用轨迹 DTW 与逐帧位移分布的 EMD 评动力学,静态与动态短板因此被精确定位。第三,评估锚定人类:VQA 按初态、末态、关键事件、接触四类提问并用破坏所问属性的干扰渲染把关;成对比较经 Bradley–Terry 聚合为人类 Elo 与 VLM Elo 双排行榜。
方法步骤详情
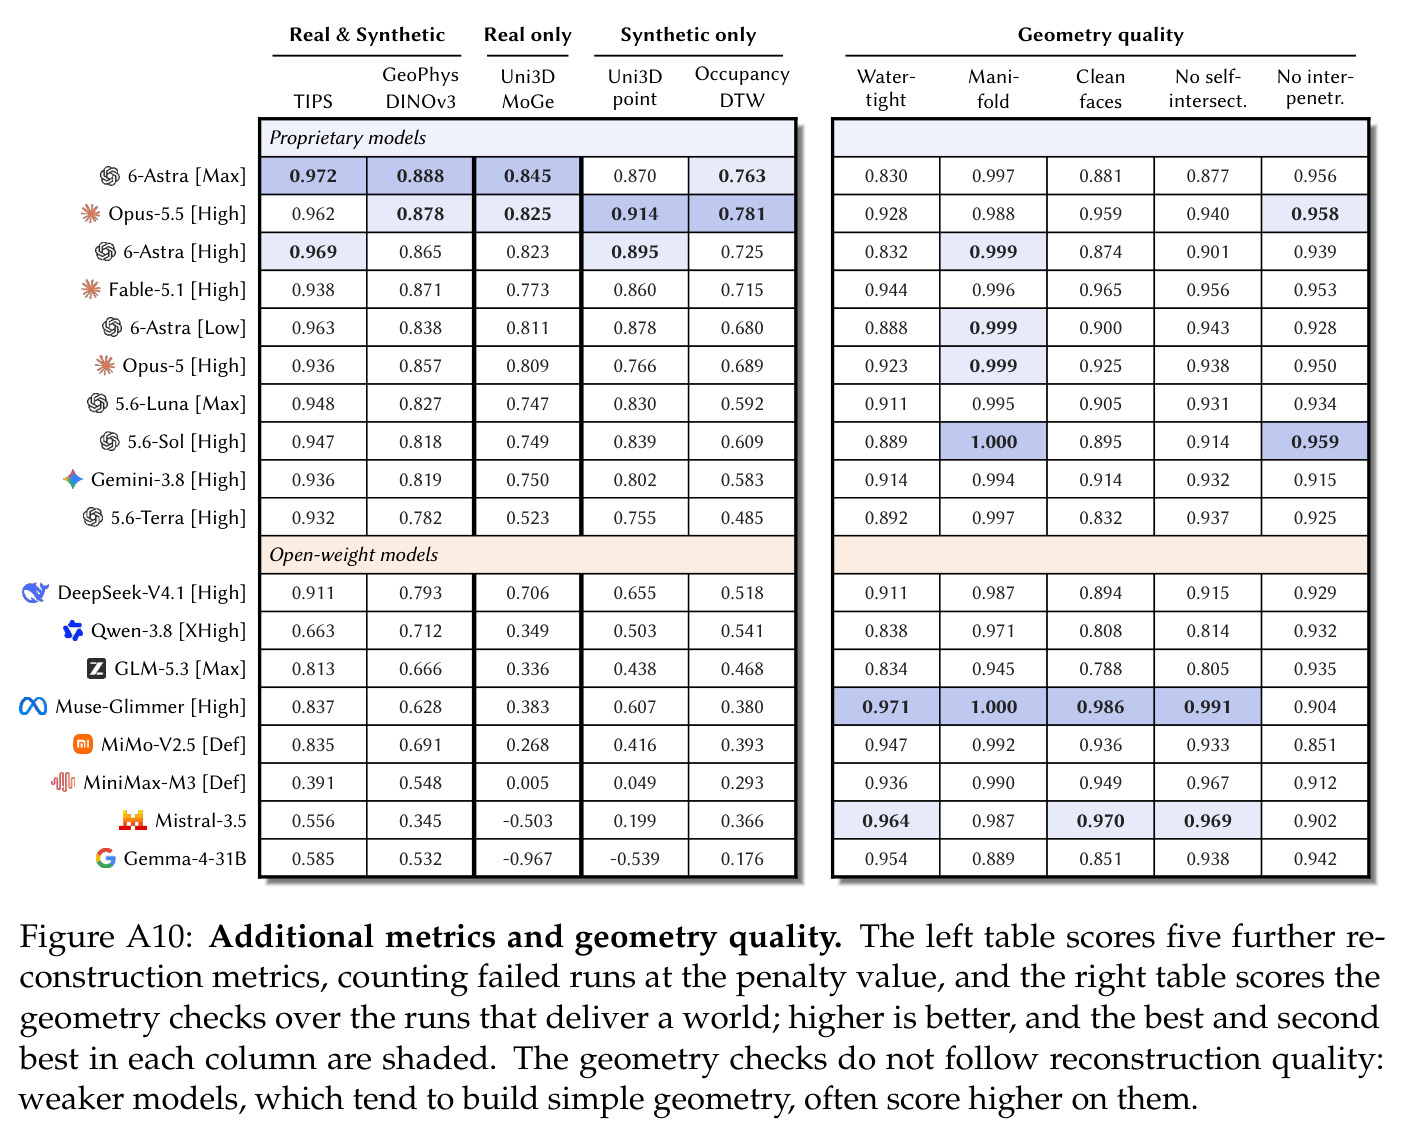
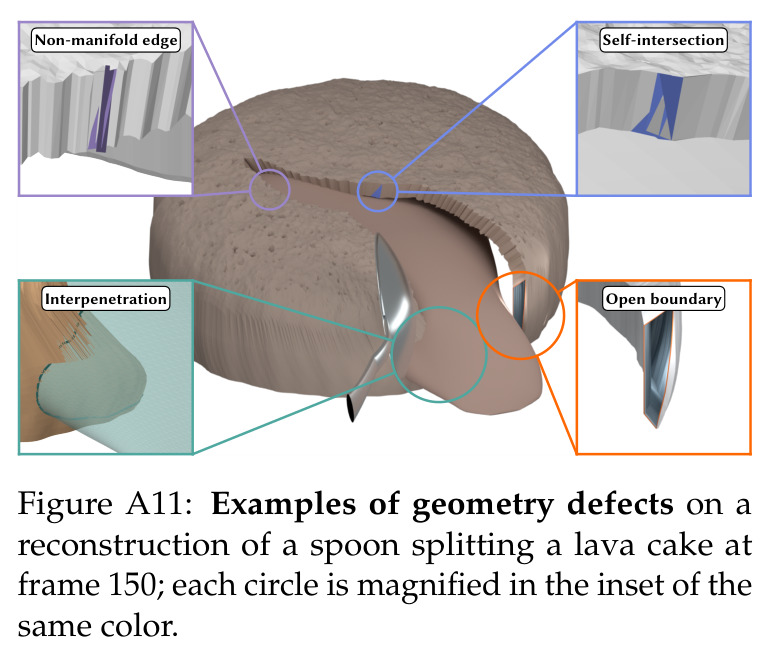
构建与评测分四步。第一步数据构建:真实视频从物理理解、视频生成与机器人数据集及网络来源精选,要求固定相机、遮挡少、无剪辑,排除人与动物并尽量避开手,逐条人工审核画质与时间连续性,真实片段上限 300 帧,所有视频帧率不超过 60fps(更高帧率做时间下采样);合成场景由有物理仿真经验的作者按物质选型仿真器(必要时扩展其实现),结合程序化几何与 Stanford bunny、armadillo 等公开网格搭建,并逐场景排查数值不稳定、非预期穿模等仿真伪影。第二步智能体执行:每个模型只拿到 RGB 视频与固定任务提示,在隔离容器(单 GPU、空白工作区、任务文件只读)中运行;专有模型用厂商原生 agent CLI,开源模型用开源 Stirrup harness,环境提供 Blender、常用数值与仿真库及离线 API 文档。第三步交付验证:程序须能从零再生成渲染视频、相机参数、逐帧几何与时间对应。第四步评估:计算五个指标族并取均值得 Overall,另做开口边界、非流形边、退化面、自交与互穿等网格质量诊断,作为不计入总分的结构性检查。
技术新颖性
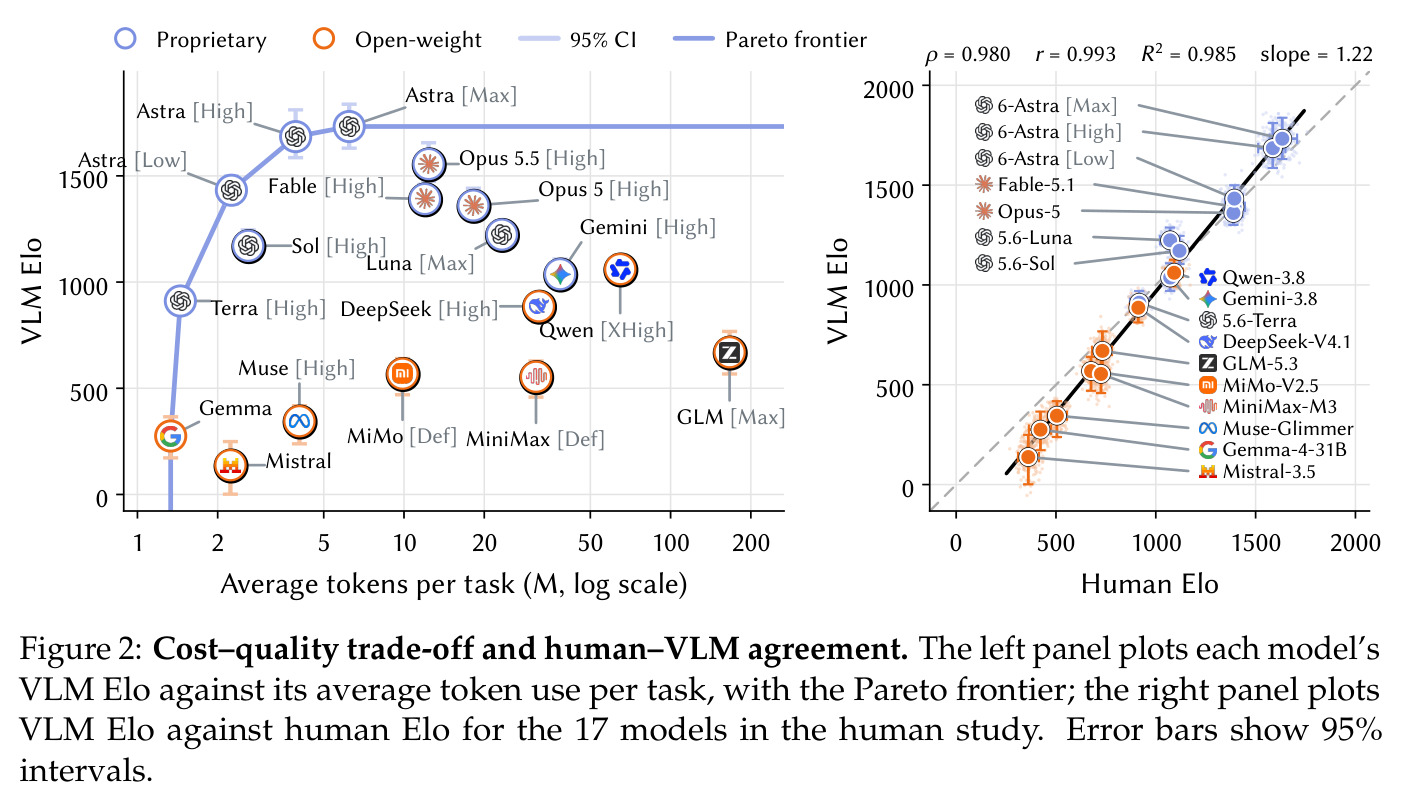
与最近的空间/物理类基准相比,本文定位差异清晰:3DCodeBench 测从文本或图像对静态 3D 物体建模,PhysCodeBench 测按文字写可执行仿真,都绕开了「从视频反推」;VisPhyWorld 只给合成物理视频,MPMWorlds 局限 2D 形变与拓扑事件,BVB 面向移动相机下的静态室内。4DCODEBENCH 同时做到了此前无人兼具的几点:真实与合成双源互补且合成侧有逐帧 4D 真值,支持在三维空间直接评估;最小化相机运动以聚焦物体动力学;动力学同时用拉格朗日(轨迹 DTW)与欧拉(EMD step)两种视角度量;成对偏好用 Bradley–Terry 聚合,并经 76 人、3,587 次判断验证(人类与 VLM Elo 的 Spearman $\rho=0.980$)。「任务自由 + 度量分层 + 人类锚定」这一组合在已有基准中尚属首次。
实验结果
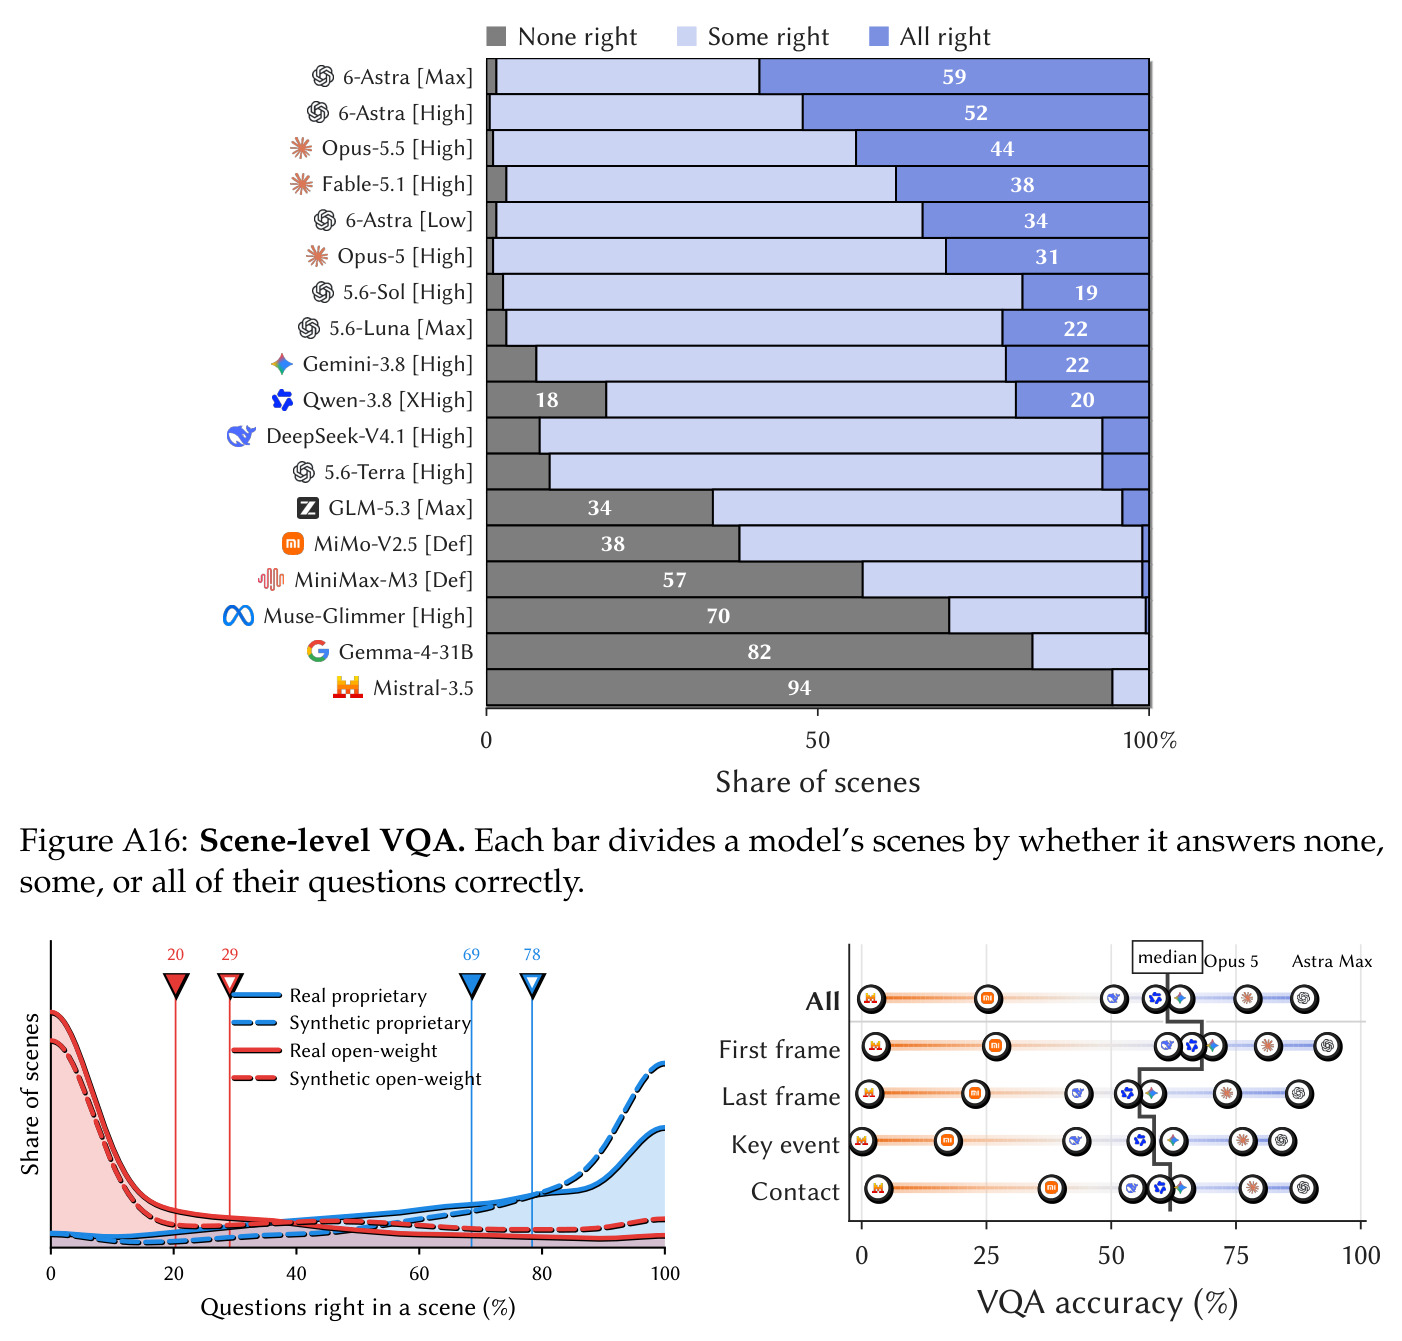
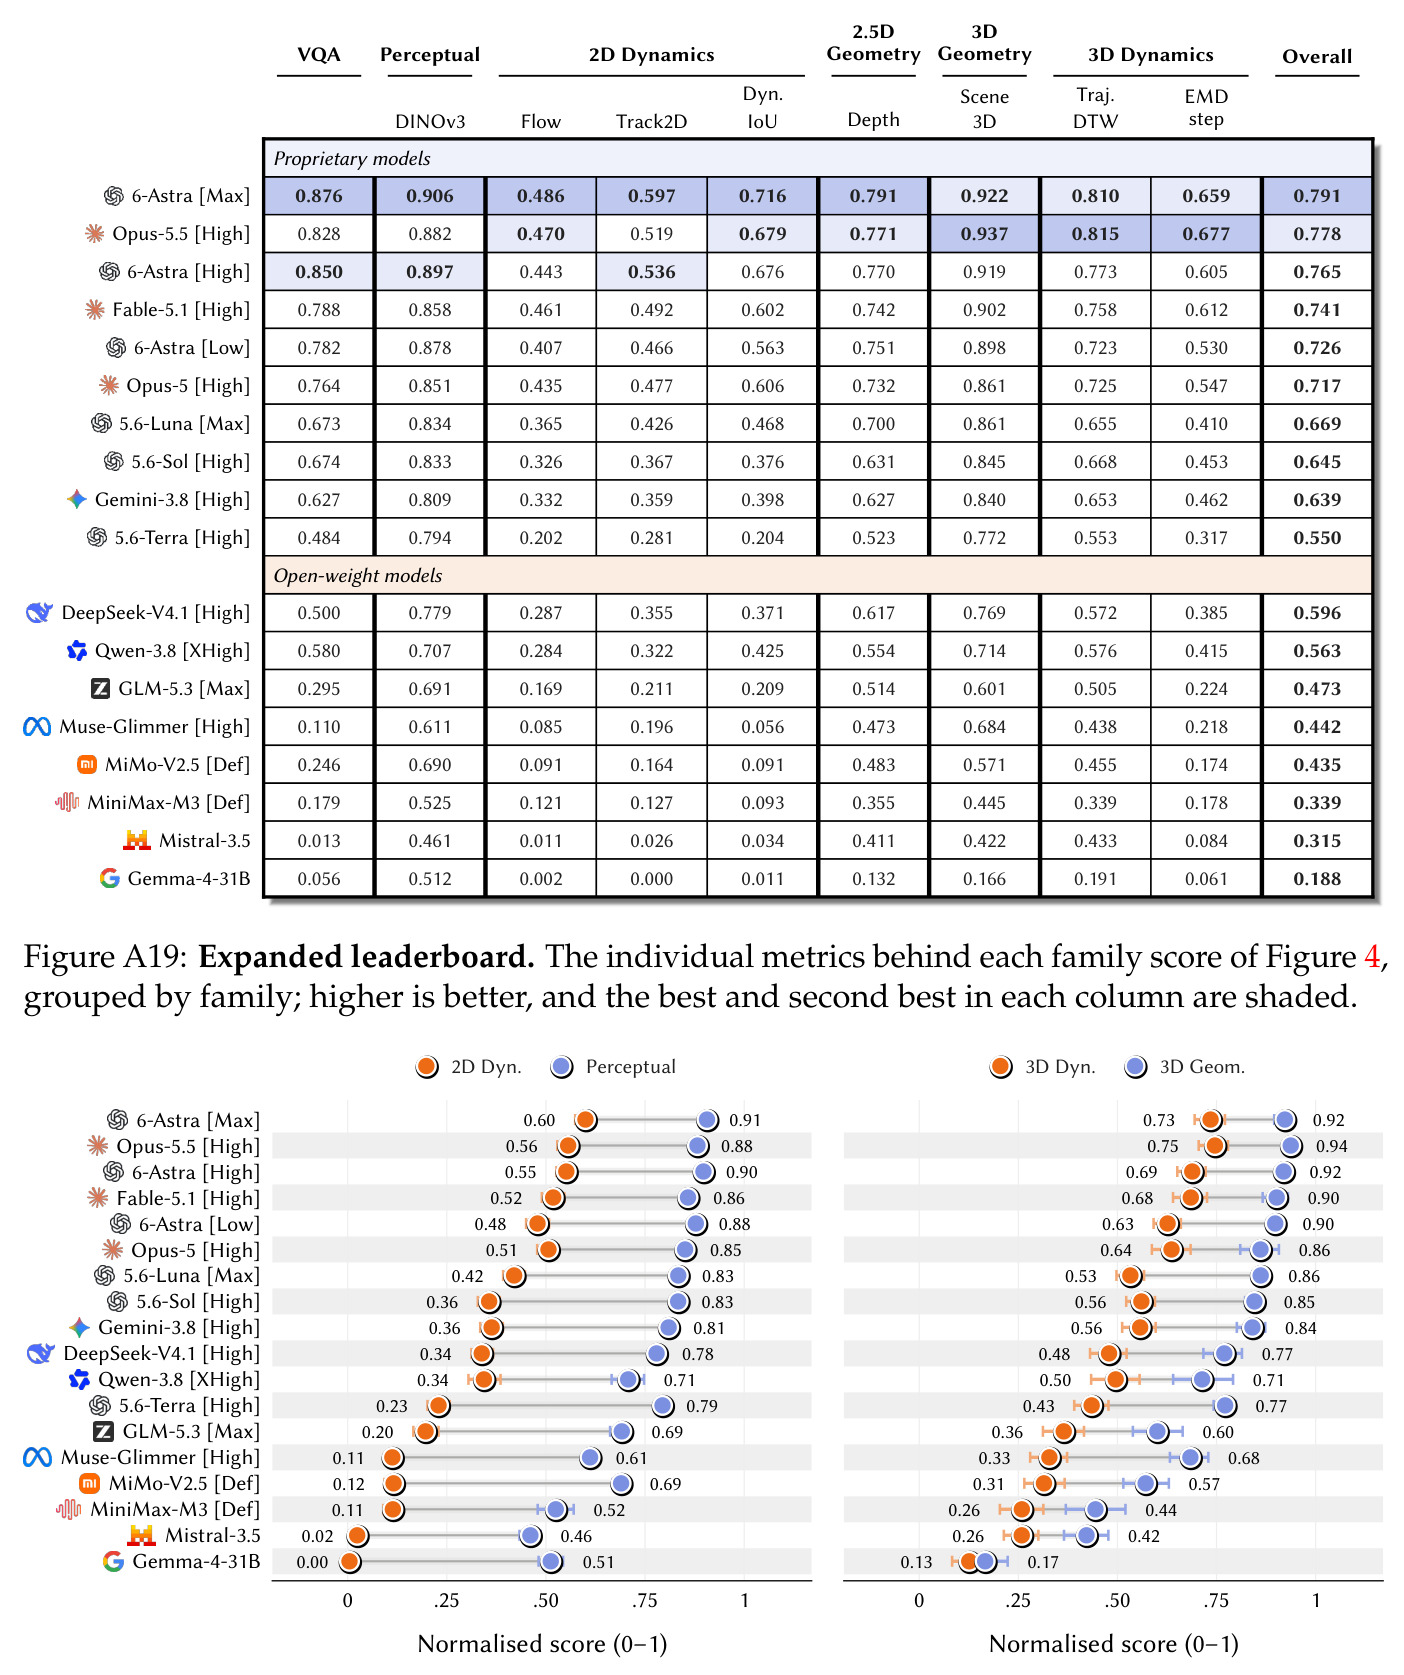
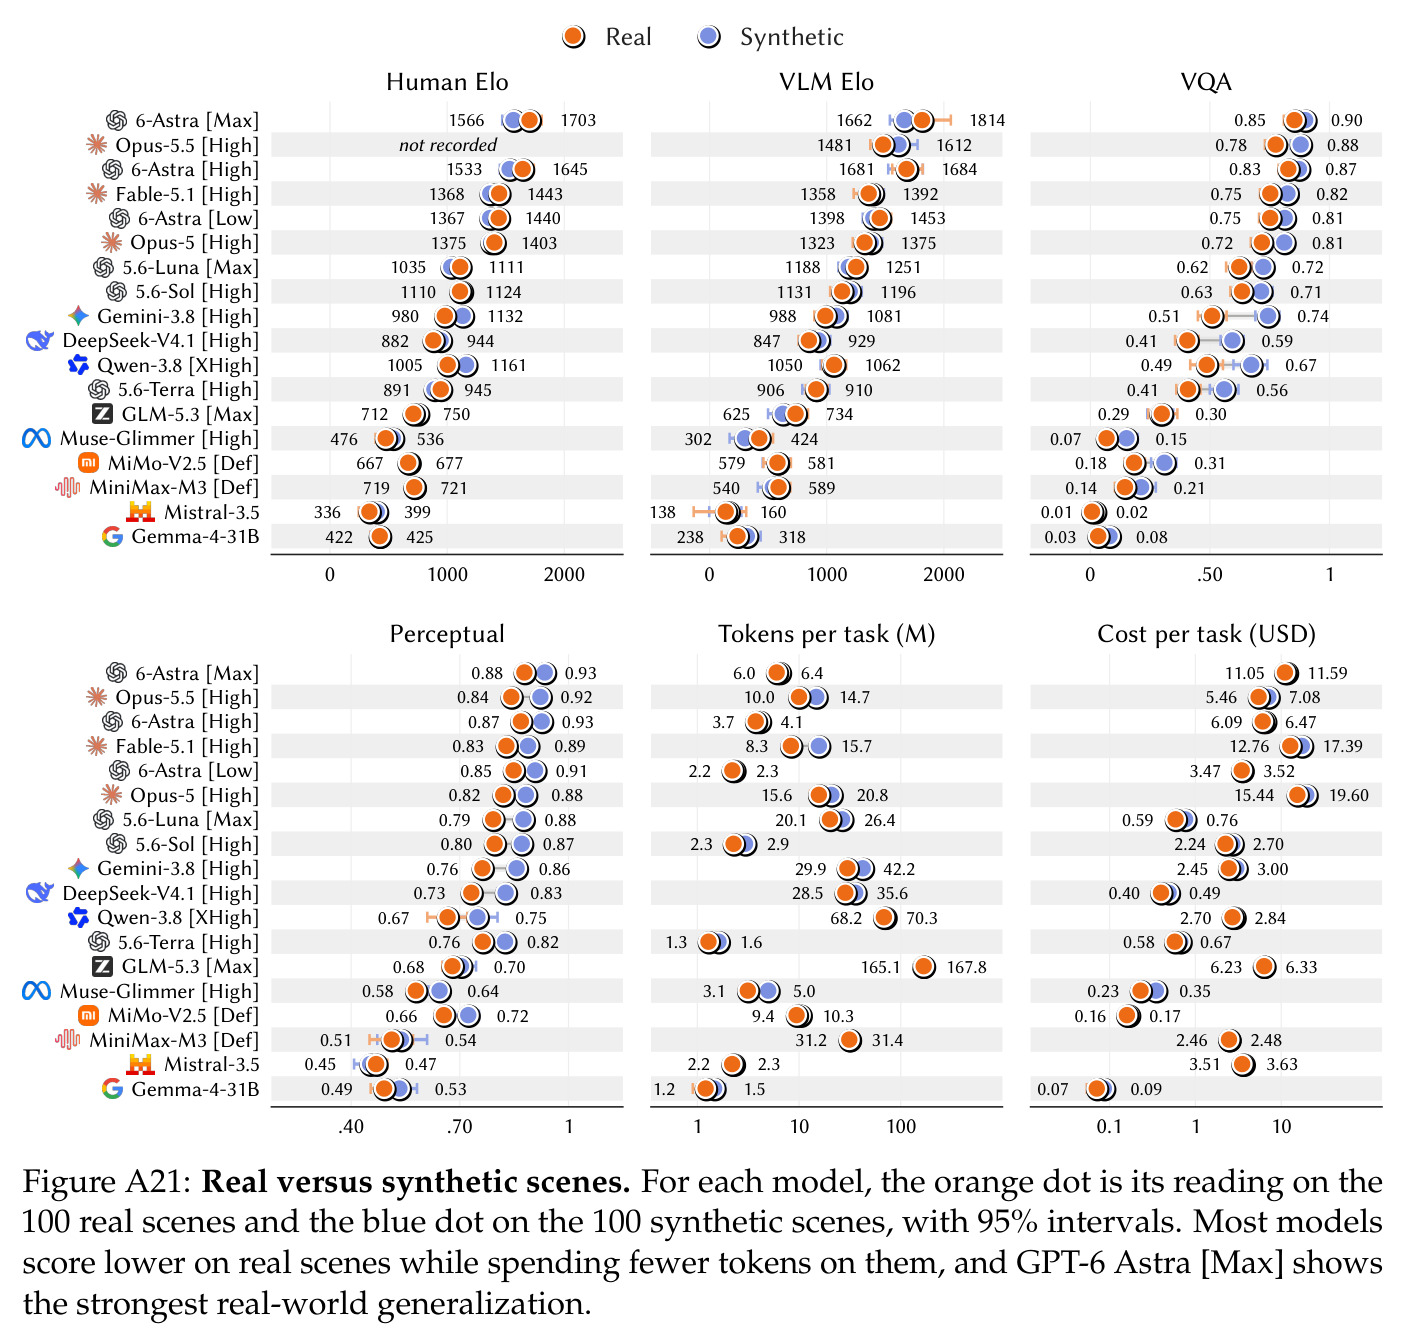
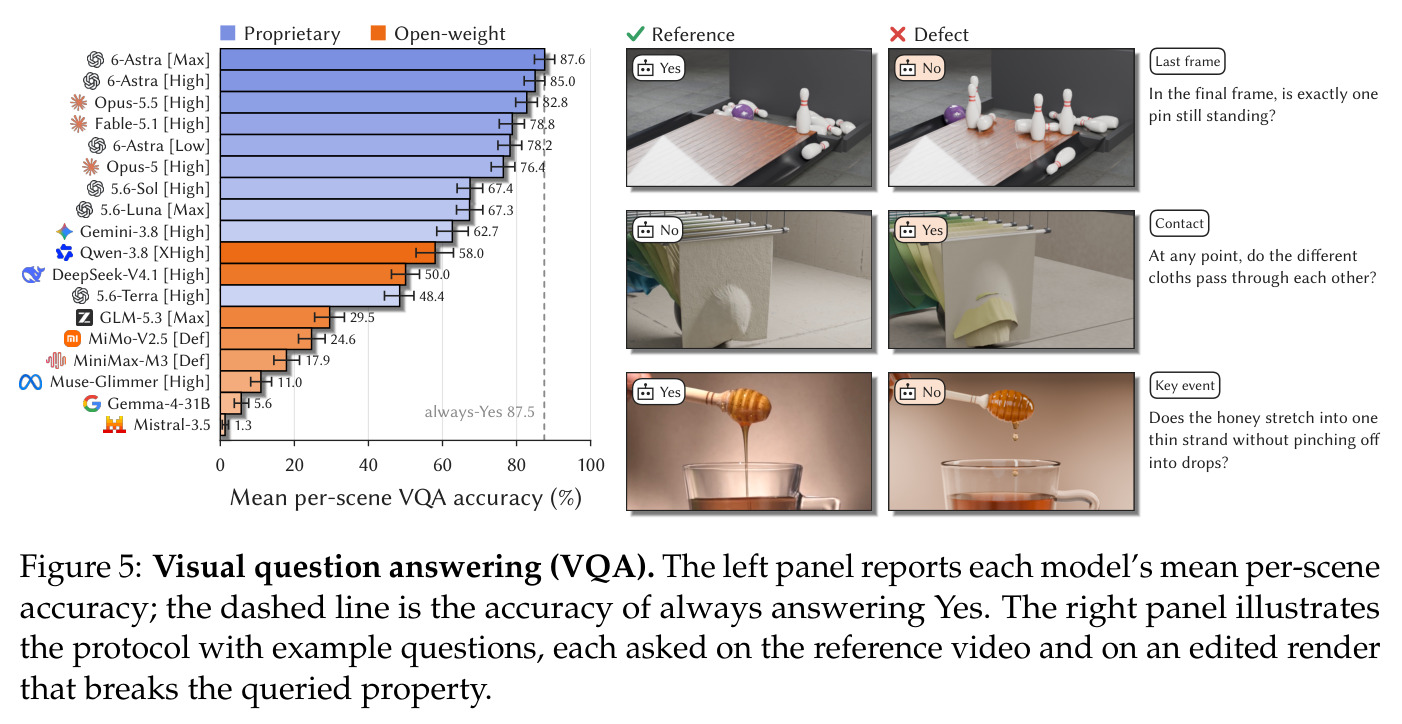
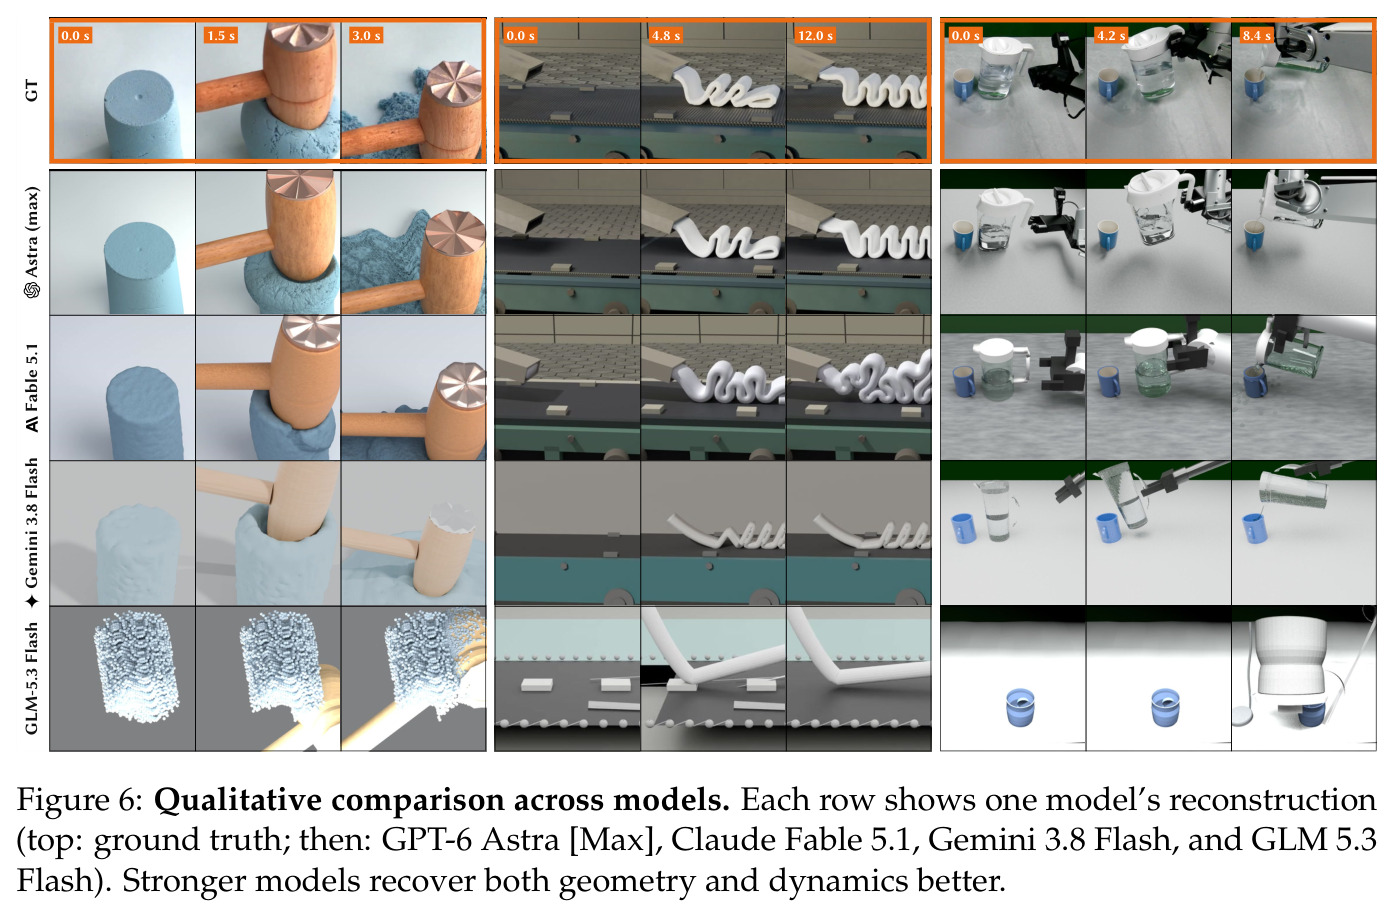
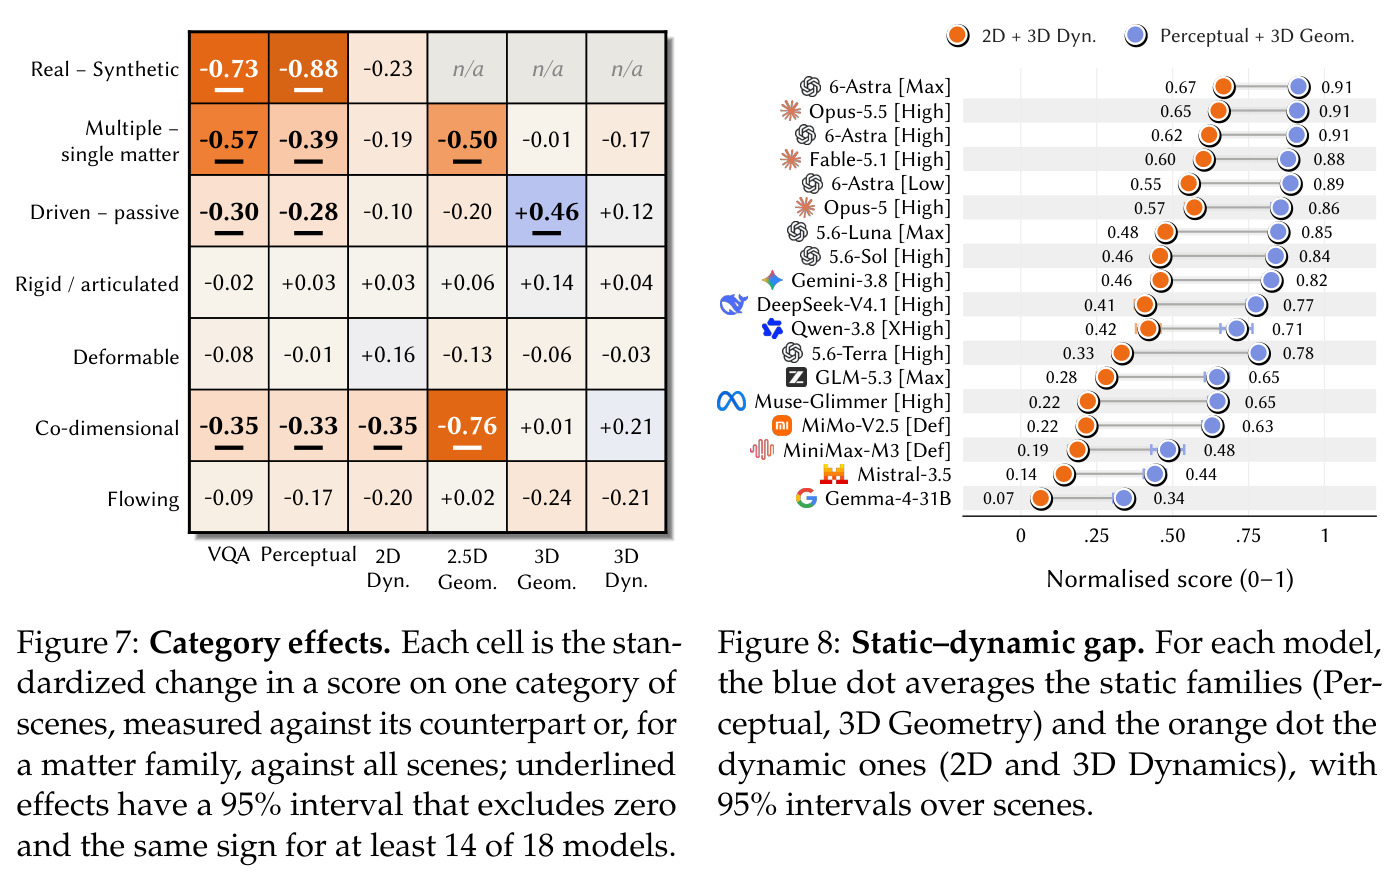
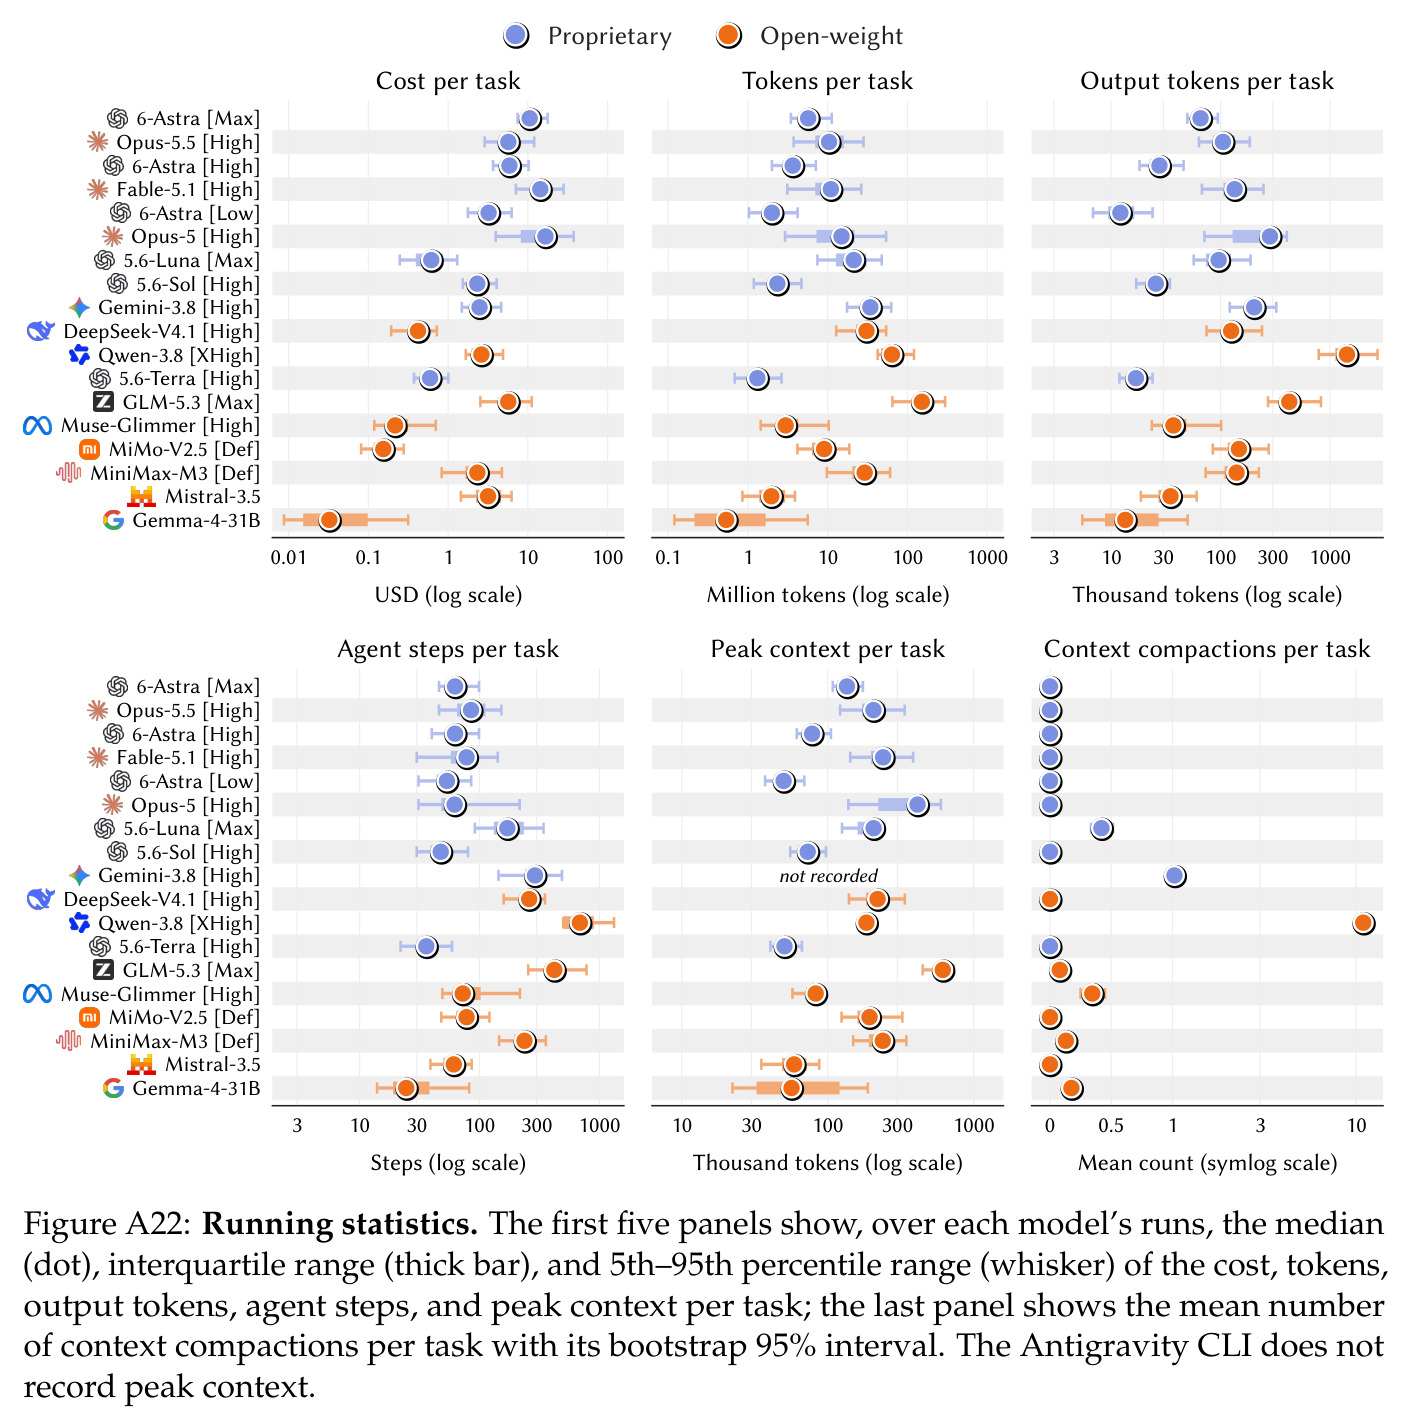
排行榜上 GPT-6 Astra [Max] 以 Overall 0.79、VLM Elo 1732 居首,其后为 Opus 5.5 [High](0.78)、Fable 5.1 [High](0.74);最佳开源的 DeepSeek-V4.1 [High] 为 0.60。人类研究(3,587 次判断)验证了自动评测:VLM 与人类 Elo 的 $\rho=0.980$,916 个共享比较一致率 89.3%。核心发现是静态—动态鸿沟:18 个模型无一例外,动态族分数显著低于静态族,连 Astra [Max] 也是静态 0.91 对动态 0.67。VQA 上 Astra [Max] 达 87.6%,Mistral 仅 1.3%。跨模型看 token 用量与 Elo 无一致相关;同一模型内提升推理努力则稳定有效:Astra Low→High→Max,Overall 0.73→0.79,2D Dynamics 0.48→0.60。真实、多物质与织物类共维场景系统性拉低分数:真实比合成 VQA 低 0.73,共维场景 2.5D Geometry 低 0.76。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 4D 逆图形学综合重建(200 场景) | Overall(五个指标族均值,0–1) | Astra [Max]:0.79(VLM Elo 1732) | 最佳开源模型 DeepSeek-V4.1 [High]:0.60;闭源次优 Opus 5.5 [High]:0.78 | 较最佳开源 +0.19;较闭源次优 +0.01 |
| 静态 vs 动态重建能力 | 静态族(Perceptual+3D Geometry)与动态族(2D+3D Dynamics)均值 | Astra [Max]:静态 0.91 / 动态 0.67 | 全部 18 个模型均呈动态显著低于静态 | 无模型幸免:动态普遍落后约 0.2–0.4,为最大短板 |
| 自动评测与人类偏好一致性 | 共享比较一致率 / 模型级 Spearman ρ | 一致率 89.3%(κ=0.761);ρ=0.980 | 人类标注者之间一致率 92.1%(κ=0.816) | 达到人类间一致性的约 97%,证明 VLM 裁判可用于后续模型评测 |
| 场景级视觉问答(VQA) | 平均每场景准确率 | Astra [Max]:87.6% | Fable 5.1 [High]:78.8%;GLM [Max]:29.5%;Mistral-3.5:1.3% | 较次优(Opus 5.5,82.8%)+4.8 个百分点 |
| 推理努力的作用(Astra Low/High/Max) | Overall 与 2D Dynamics | Overall 0.73→0.77→0.79;2D Dynamics 0.48→0.55→0.60 | 跨不同模型比较时 token 用量与 Elo 无一致相关 | 同一模型内增加推理稳定有效;跨模型堆 token 无效 |
局限与改进
作者明确承认两点局限:其一,评测只衡量重建保真度,背后的物理机制欠约束——按参考视频硬编码轨迹(prescribed trajectory)也能拿高分,而仿真带来的泛化收益完全未被检验;其二,只评估最终提交,不追踪中间的渲染-比对迭代,因此不知道质量如何随迭代次数与 token 消耗提升、何时饱和。我补充几点:真实场景侧没有 4D 真值,光流、点轨迹与深度都靠现成视觉模型估计,指标不可避免继承这些估计器的偏差;VLM 裁判在个体比较层面可靠性有限——Elo 差 50 分以内接近随机,132 分才到 75% 一致,排位接近的模型难以区分;所有运行都基于 Blender 单一渲染器与固定提示词,换环境或换提示的表现未知;每个模型每个场景只跑一次,缺少多次采样的方差估计;此外排除人/动物并要求固定相机的取材标准虽然聚焦了动力学,但也限制了对真实拍摄条件的代表性。
独立分析的弱点
第一个弱点是动力学重建的系统性短板:即便最强的 Astra [Max],动态分数(0.67)也远低于静态(0.91),织物绳索类共维场景尤其差(2.5D Geometry 低 0.76),改进方向是把物理先验与仿真工具的使用显式纳入智能体训练,例如以渲染误差为奖励做强化学习。第二个弱点是 67% 的解用解析运动,本质是「从视频读出轨迹再回放」,对未见的初始条件缺乏泛化,可在评测中加入初始条件扰动或外力干预来强制可迁移的物理理解。第三,VLM 裁判对相近模型几乎失灵(Elo 差 50 内近随机),且 VQA 的 always-Yes 基线即达 87.5%,存在裁判走捷径的风险,需要更对抗性的问题设计与多裁判集成。第四,真实侧指标依赖估计的光流与深度,估计误差会被记在重建头上,可引入不确定性加权或人工校验子集。第五,token 花费与质量脱钩,说明盲目加大算力无效,应研究更早形成正确物理假设、减少渲染-比对轮次的推理策略。
未来方向
作者提出的方向包括:引入对初始条件与外力的干预实验以及长时程预测,以检验可迁移的物理理解而非记忆式回放;约束或要求使用物理仿真,观察相对排名是否保持;跟踪中间重建,刻画质量随迭代与 token 消耗的演化与饱和点;研究何时仿真真正优于解析运动。在此基础上还可以延伸:把 4D 代码重建与视频生成/世界模型结合,用重建误差作为世界模型的训练信号;将本基准的渲染-反馈闭环用于强化学习微调多模态智能体的物理直觉;向更长的多镜头、含人的真实视频扩展;以及把拉格朗日/欧拉双视角的动力学度量推广到 4D 生成与编辑任务的评测。由于排行榜与人类判断高度一致($\rho=0.980$),该协议有潜力成为后续模型的常态化试金石。
复现评估
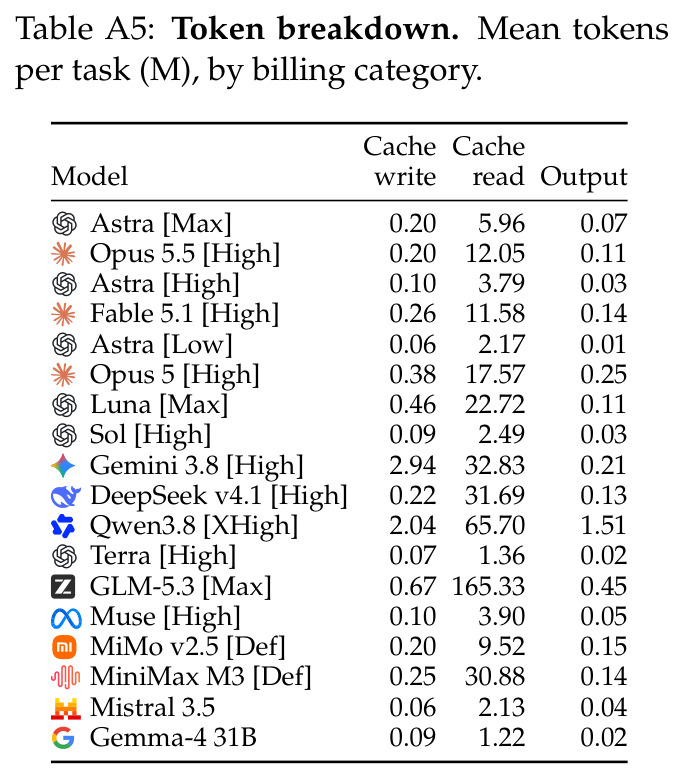
复现条件较好:基准代码与数据已在 github.com/4DCodeBench/4DCodeBench 开源,项目页 4DCodeBench.com 提供更多样例;完整任务提示(附录 G.2)、执行环境(单 GPU 隔离容器、Blender、常用数值/仿真库与离线 API 文档)、文件结构、坐标约定与验证要求(附录 G.3)均有详细说明,开源模型统一用公开的 Stirrup harness 运行。评估侧需要 DINOv3、光流/轨迹/深度估计模型与 VLM 裁判,合成场景的 4D 真值随基准发布。主要成本在算力与调用量:18 个模型 × 200 个场景,图 2 显示每任务平均 token 用量最高约 200M(对数轴),全量复测一个前沿模型是相当可观的 API 开销;VLM 成对评测与人类研究也需额外投入。自行扩充数据集则需具备物理仿真经验的作者逐一审核场景。总体而言,单卡复现推理环境容易,复现完整评测管线工作量中等,数据构建最难复制。
论文图表