VibeVideoBench:面向代码驱动视频生成的多模态智能体评测基准 VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
首个让通用智能体纯用代码从零产出带声完整视频的基准,最强系统严格成功率仅76.3%
前置知识
多模态智能体与 harness
以 LLM 为核心、能调用工具(读写文件、执行 shell、查看图像)自主完成长程任务的系统。harness 是厂商提供的运行框架(如 Codex CLI、Claude Code、Antigravity CLI),决定模型如何被调用、工具如何暴露、推理档位如何设置。本文评测的是「模型+框架」的完整系统:九个系统各在自家原生 harness、最高推理档、全部工具权限预批、无追问轮次下无人值守跑完任务。
本文比较的是完整智能体系统而非裸模型,交付率、渲染栈选择、自查行为等结论都依赖 harness,理解这点才能读懂实验设置与排行榜的含义。
代码驱动视频生成(程序化渲染)
不用扩散模型生成像素,而是智能体编写程序驱动渲染器逐帧画图——cairo 矢量绘制、PIL/numpy 栅格化、无头浏览器截取 canvas/three.js 场景、Blender 建模——再用 ffmpeg 把帧序列与音轨合成为 MP4;旁白由 TTS 生成,音乐音效由代码合成。优点是文字数字精确、状态变化符合规则、时长可控、成品可编辑修改。
这是本文定义的视频形态:所有任务禁止任何图像/视频生成模型,唯一生成式服务是 TTS。理解这一设定才能理解任务难度从何而来、评测逻辑为何围绕「代码能否做对」。
Rubric 与 VLM-as-a-Judge
把「视频好不好」拆成大量原子化 pass/fail 检查项(每条注明依据的提示句、所需过程证据、模态标签、core/detail 关键级)和按任务锚定 1/3/5 分的连续质量维度,由视觉语言模型充当裁判逐条判定并给出时间戳证据。rubric 分解已被证明能提高不可验证领域的评测可靠性, HealthBench、VideoArgus 等均采用类似思路。
本文提出三级评测(L1 程序检查/L2 rubric 检查/L3 质量分),约 1.3 万条 L2 检查是评测主体;后续所有指标、裁判可靠性分析与自我偏好测量都建立在这一框架上。
Bradley–Terry 模型与 Elo
从成对偏好比较中估计对象强度的统计模型:$\Pr(i \text{ 胜 } j) = \frac{e^{s_i}}{e^{s_i}+e^{s_j}}$,通常以 Elo 尺度报告(本文几何均值 1000),并用 bootstrap 估计置信区间。Chatbot Arena 等竞技场排名即基于此。
作者在全部 239 个任务上做盲测成对人类偏好并拟合 BT 强度,用于验证 VLM 裁判的排序是否与人类一致(ρ=0.98),这是「裁判可信」结论的关键证据来源。
一致性统计量(Spearman ρ / Cohen's κ / Pearson r)
Spearman ρ 衡量两组排名的单调一致性;Pearson r 衡量连续分数的线性相关;Cohen's κ 在扣除随机一致后衡量逐条判定的一致程度,0.4–0.6 属中等。三者刻画的粒度不同:排名级、分数级、逐条判定级。
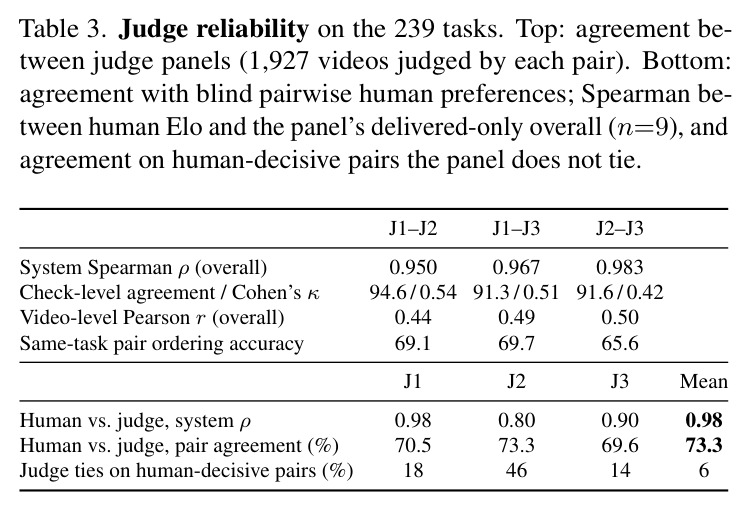
论文的核心结论「裁判能排系统、不能判单个视频」全靠这组数字表达:系统级 ρ=0.95–0.98,但单视频 κ 仅 0.42–0.54、同任务对序一致仅 66–70%。不懂这些统计量就读不懂论文对自身评测协议的边界声明。
交付率与「无视频计零」双口径
交付率指产出可播放 MP4 的任务占比;「无视频计零」(no video = 0)把缺失视频在所有指标上记为零分,与「仅统计已交付视频」的口径并列报告,从而把「可靠性」与「质量」两条轴分开刻画,再合并成一个综合口径。
论文第二大发现「交付是第二竞争轴」直接来自两种口径的排名差异:Gemini 4 Argon 在仅交付口径排第 4,无视频计零后掉到第 7。读表时必须分清口径。
研究动机
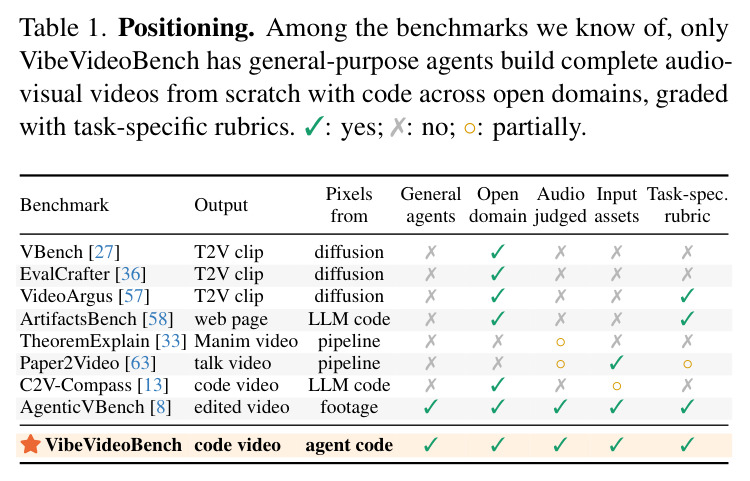
「智能体做视频做得怎么样?」现有评测都无法回答。视频生成基准(VBench、EvalCrafter、VideoArgus)打分的对象是扩散模型输出的几秒钟无声片段,衡量逼真度与提示对齐;代码生成视觉基准(ArtifactsBench、Design2Code、SVGenius)只评网页、图表、SVG 等静态产物;TheoremExplainAgent、Code2Video、Paper2Video 这类「课程/论文转视频」系统是人工设计的语言模型流水线,绑定单一渲染器与单一领域,不测试通用智能体;SWE-bench、Terminal-Bench、OSWorld 等智能体基准用单元测试验证文本或功能结果——而视频是感知性、时间性、视听结合的产物,没有单元测试。与此同时,用户真实需要的视频——课堂讲解、论文解读、数据故事、产品演示、节奏游戏——恰恰要求像素生成器无法保证的性质:精确的文字与数字、规则一致的状态变化、数分钟的结构、与画面事件同步的声音,以及一个可修改的成品文件。
本文的目标是构建第一个评测通用多模态智能体端到端完成「代码驱动视频生成」的基准。形式化地,每个任务 $\tau = (p, A, d, a, c)$:自然语言规范 $p$、可选只读资产包 $A$、机器可读交付规格 $d$(分辨率、帧率、时长区间 $[t_{\min}, t_{\max}]$、可选精确帧数)、四声道音频策略 $a$(旁白/音乐/音效/环境音各标记为必需、可选或不用)与创作自由声明 $c$。智能体必须在一小时内、在无 GPU 沙箱里、不使用任何图像或视频生成模型(唯一生成式工具是 TTS),交付带声音的成品 MP4、可编辑源工程和计时表。同时配套一套分层、基于证据的评测协议,能明确处理「没交视频」的情况,且裁判排序需与人类盲测偏好对齐。
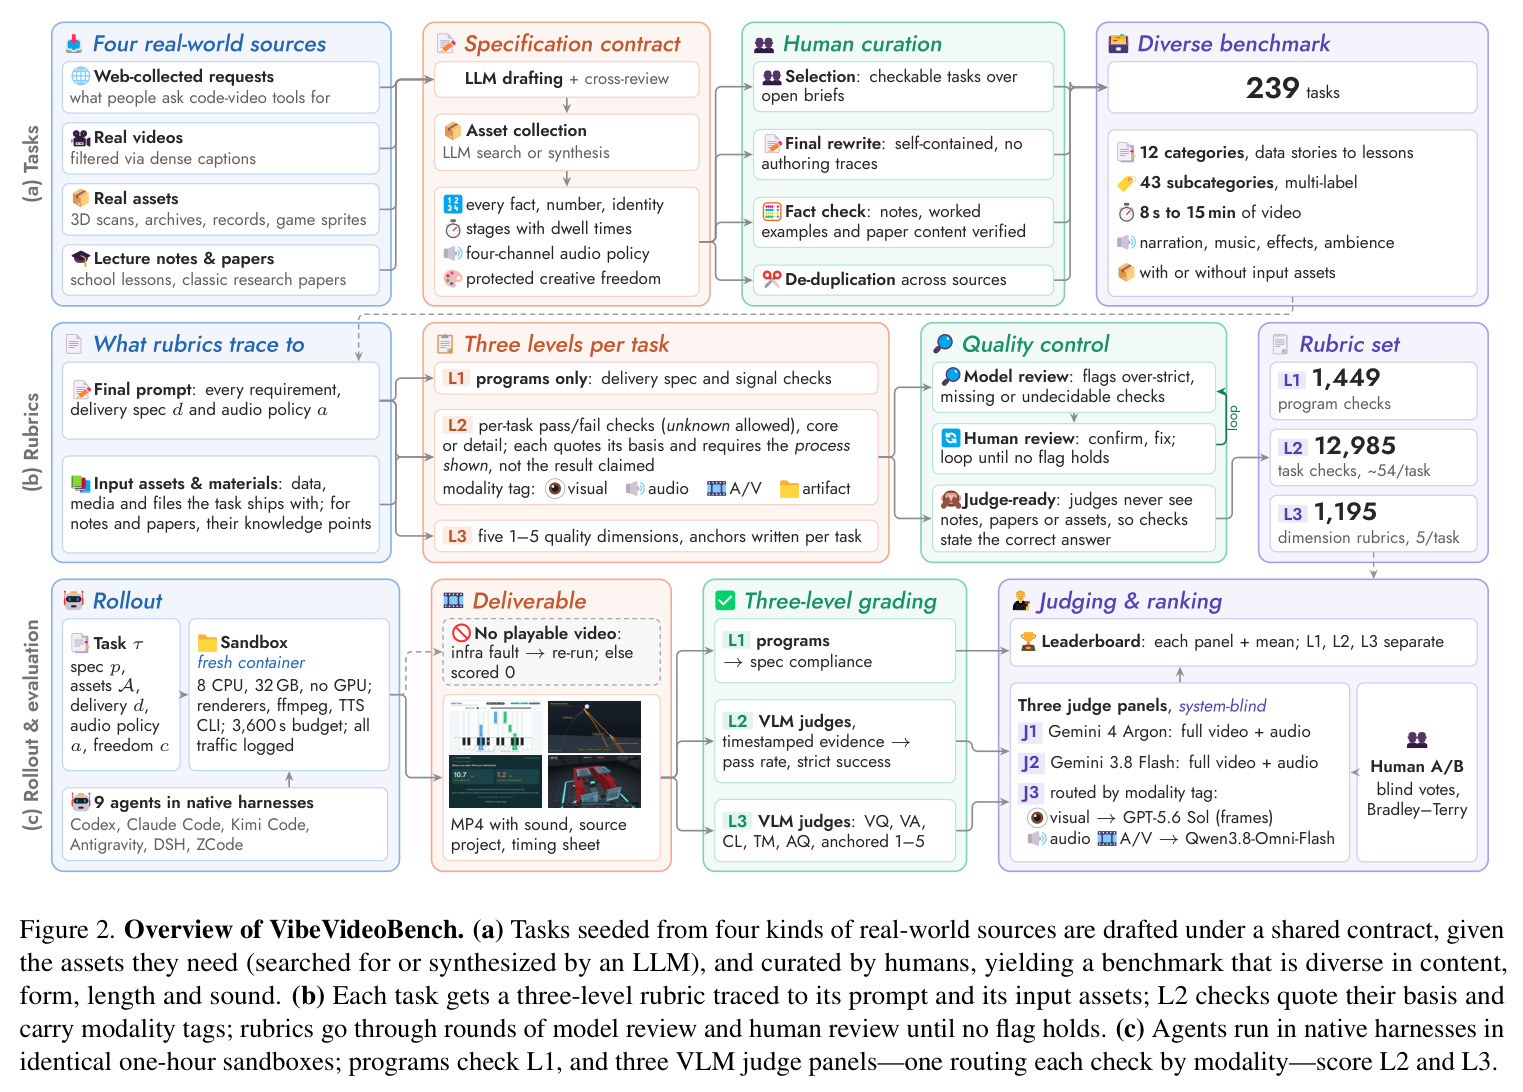
与已有工作不同的是,独特切入有三。其一,任务从四类真实来源构建(用户写给代码视频工具的 484 条请求、50 万级真实视频的稠密字幕、3D 扫描/游戏关卡等真实资产包、讲义与经典论文 PDF),经共享契约改写成自包含、可检验的规范,既真实又可核查。其二,评测以证据为本且分三层执行者:L1 程序检查只由代码验证交付规格;L2 约 12,985 条任务检查每条追溯到它强制的要求,并区分「展示过程」与「宣称结果」;L3 五个按任务锚定的质量维度。模态路由保证音频检查永远不会到达听不见的裁判。其三,评测「完整智能体系统」而非裸模型或流水线:九个前沿系统在各自原生 harness、相同容器、相同一小时预算内完全自主运行,缺失视频用双口径(仅交付/无视频计零)显式报告而非被平均值掩盖。
核心方法
直觉是把视频当成「软件交付物」来验收。智能体在全新 Docker 容器中工作(Ubuntu 24.04,8 CPU、32 GB 内存、无 GPU;预装 Python/Node、无头 Chromium(软件 WebGL)、ffmpeg、ImageMagick、SoX、three.js、GSAP 与大字体集;网络经代理、允许装包),面对 3,600 秒墙钟预算,产出 MP4 + 可编辑源工程 + 计时表。验收走三级:L1 由纯程序检查交付规格(MP4 可解码、分辨率、帧率 ±0.01、时长落在 $[t_{\min}-0.5,\ t_{\max}+0.5]$ 秒;205 个核心任务还要求提交源工程、必要时精确帧数、有音频流且峰值 > −50 dBFS;讲义/论文类任务加旁白覆盖率(VAD)、旁白语言(Whisper 语言识别)与无长黑屏冻结检查);L2 由 VLM 裁判逐条判 12,985 个 pass/fail 检查;L3 由裁判按每任务自己的 1/3/5 锚点给五个 1–5 分维度:视觉质量 VQ、视觉美学 VA、内容逻辑 CL、时序与运动 TM、音质与音画同步 AQ。每个交付视频由三个独立裁判团独立打分,指标内不跨团混用,最后按系统聚合并与人类盲测偏好对照。
核心创新是「分层、可追溯、证据为本」的评测协议,并把「交付」提升为与「质量」并列的第二条轴。与既有方法的本质区别:VBench 等给像素打不可追溯的整体分;ArtifactsBench 有 checklist 但只针对网页截图;TheoremExplainAgent 等的被测对象是流水线而非智能体。本文的 L2 检查每条必须引用它强制的提示句;core/detail 级别在任何输出可见之前就固定(防止装饰性通过否决核心失败);要求「过程被展示而非结果被宣称」——例如字幕写「已同步」不能通过要求画面过程可见的检查;每条带模态标签并路由给听得见的裁判。裁判协议同样严格:画面或旁白中的自我声明不是证据、采样帧之间的事不能断言、证据不足只能返回 unknown 而不许默认 3 分。缺失视频明确双口径报告。这套设计回答了「视频没有单元测试怎么办」:能程序化的交给代码,剩下的交给被约束、被审计的裁判。
方法步骤详情
第一步,任务构建:从四类真实来源出发(网络征集的 484 条请求经严格筛选保留 31%,50.9 万条视频字幕经召回与人工终审保留 84 条,真实资产包,讲义与 10 篇经典论文 PDF 如 Transformer、ResNet、DDPM),LLM 起草并交叉复审,共享契约固定每个事实、数字与身份,切分带驻留时间的阶段、写明四声道音频策略并保护创作自由;人工筛选可检验任务、验证事实、跨来源去重,得到 239 个任务、12 类别、43 子类,209 英文 30 中文,目标时长 8 秒到 15 分钟,一轮全通过需产出 11.1 小时成品。第二步,rubric 构建:每任务平均 54.3 条 L2 检查(共 12,985 条,85.8% 为 core)、5 条 L3 维度 rubric(共 1,195 条)与 1,449 条 L1 程序检查;模型审查循环标记过严/缺失/不可判项并由人复核直至无 confirmed 发现,330 条引用笔记/论文的检查改写为自陈述内容(裁判永远看不到输入资产)。第三步,rollout:九系统 × 239 任务 = 2,151 次评分运行,每次全新容器、原生 harness、最高推理档、无追问轮次,基础设施故障重跑。第四步,评分:L1 代码判定;J1(Gemini 4 Argon)与 J2(Gemini 3.8 Flash)全片带声观看,J3 按模态标签路由——GPT-5.6 Sol 看 24–300 张采样帧判视觉项,Qwen3.8-Omni-Flash 判音频与视听项。第五步,验证与分析:239 任务全量盲测成对人类偏好并拟合 Bradley–Terry Elo,外加判官压力测试、教学测验、时间/CPU 消融与逐条失败归因。
技术新颖性
新颖性体现在四处。一是被评对象:第一个要求通用智能体(非流水线、非单次调用)在开放领域用代码从零构建完整视听视频并带任务定制 rubric 的基准——对比 Code2Video-Compass(单次模型调用、无执行反馈、无声音)与 AgenticVBench(对给定素材做后期)。二是评测协议本身是设计对象:三层证据结构 + 模态路由 + 「过程而非宣称」原则;第三个裁判团按检查标签把视觉项分流给纯视觉模型、音频项分流给全模态模型,从结构上杜绝「音频检查到达听不见的裁判」。三是可靠性自检的深度罕见:作者量化了团间一致性(系统级 ρ 0.95–0.98 vs 单视频 κ 0.42–0.54)、各团宽严漂移(J1 整体 −0.41、J2 +0.19、J3 +0.22,且 J1 对弱系统更狠)与自我偏好(J2 偏爱本家 Flash +0.16、J3 视觉判官偏爱本家 Sol +0.20,区间均不含 0),并复算证明剔除本家评委后排名不变——把「裁判也是被评模型的利益冲突」当作可测量对象。四是失败分析:逐条人工阅读全部 224 次未交付运行并归因,把「时间管理」识别为首要失败模式,给出可直接落地的工程洞察。
实验结果
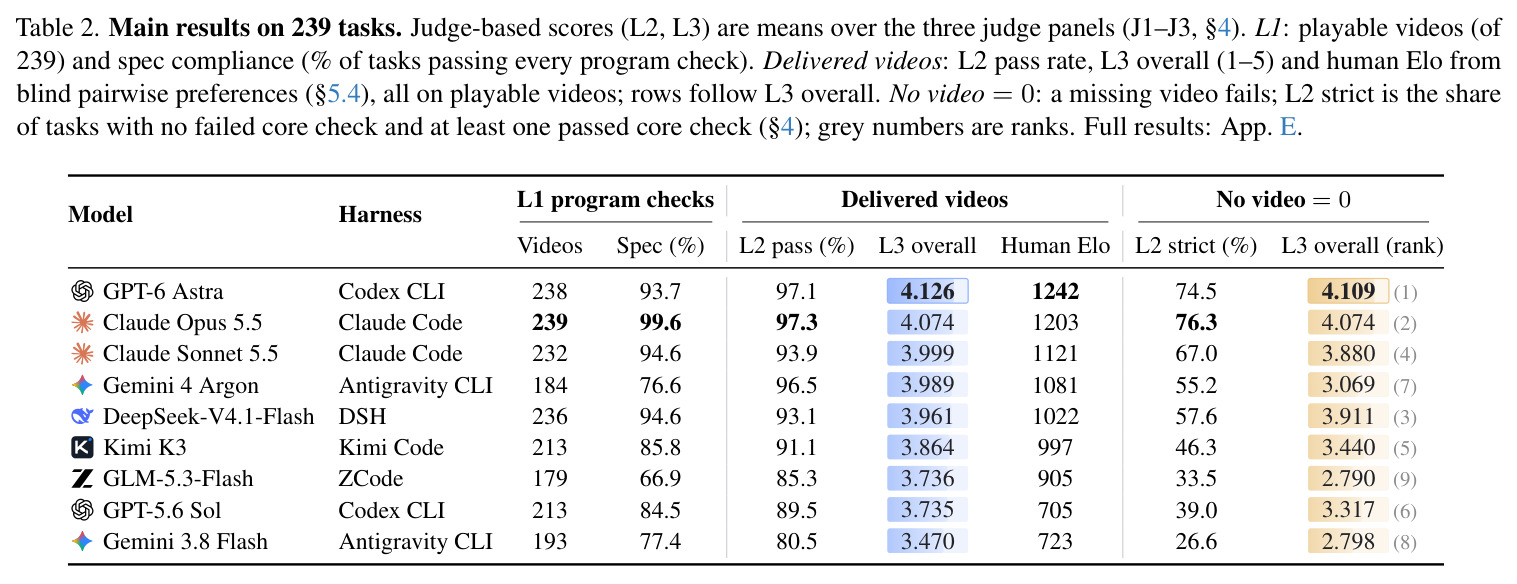
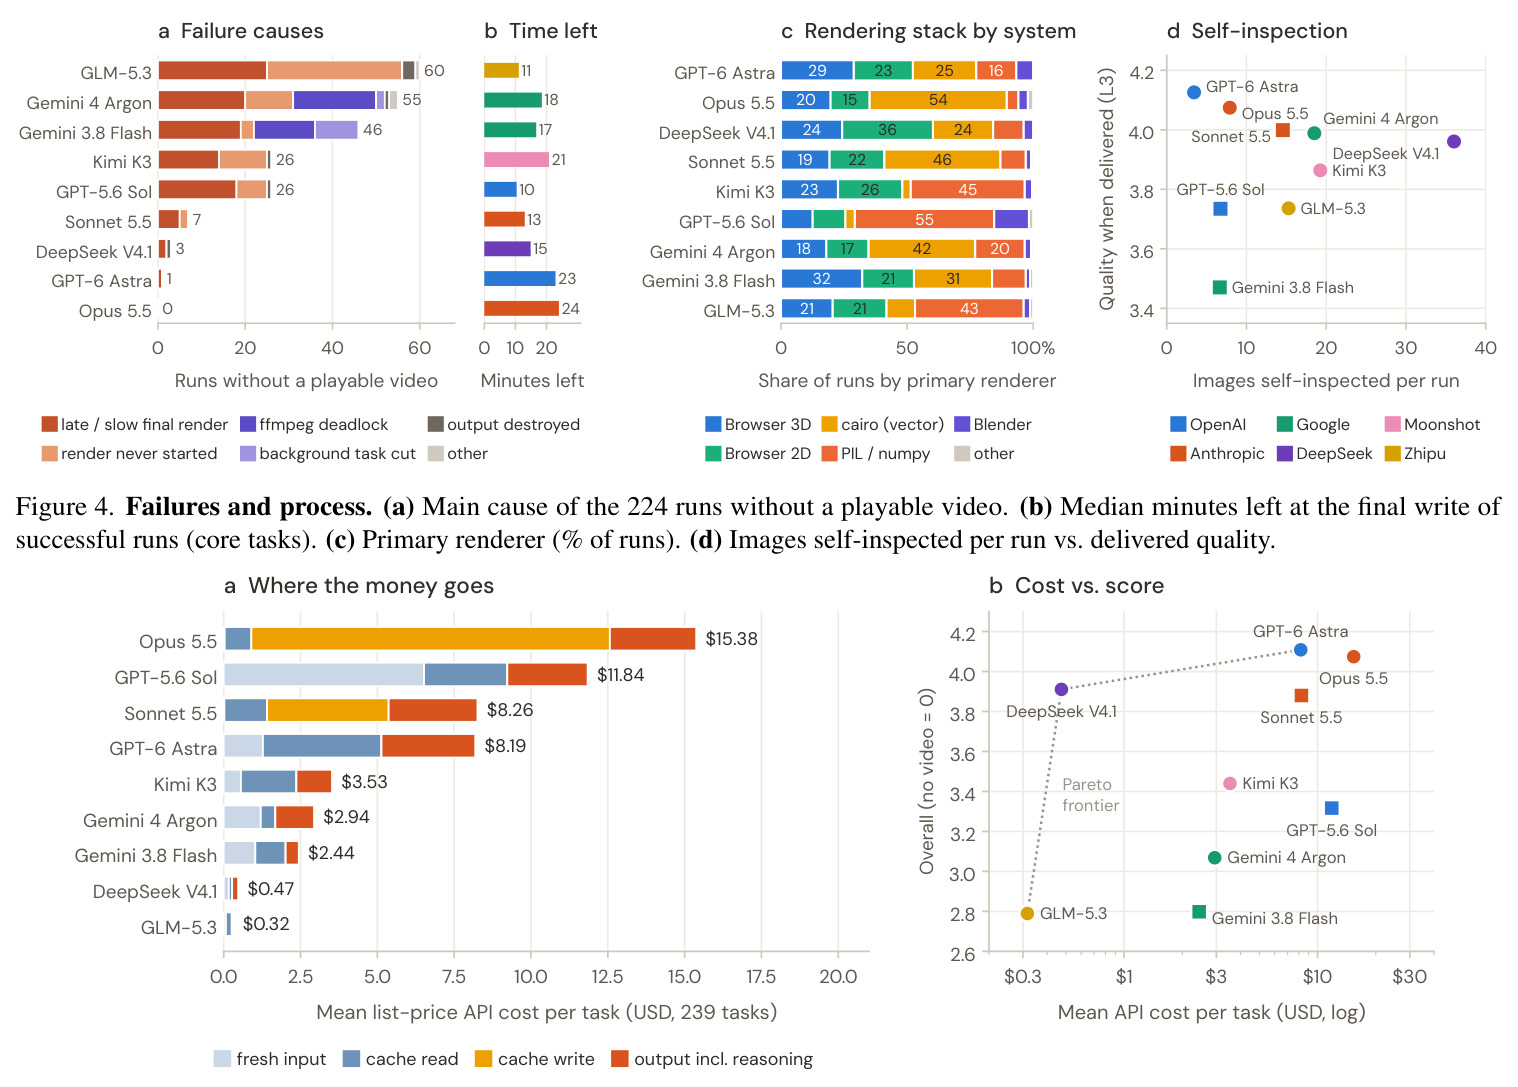
五大发现。(1) 远未解决、双雄领跑:GPT-6 Astra(已交付 L3 4.126、无视频计零 4.109、人类 Elo 1242)与 Claude Opus 5.5(交付率 100%、规格合规 99.6%、L2 pass 97.3%)在裁判与人类排序中同列前二;但最好的系统也只在 76.3% 的任务上满足全部核心要求,L2 严格成功率在九系统间从 26.6%(Gemini 3.8 Flash)铺开到 76.3%。已交付视频的 L2 通过率接近天花板(80.5–97.3%),分水岭在「一条核心检查都不失败」。(2) 交付是第二轴:无视频计零后 Gemini 4 Argon 从第 4 掉到第 7(3.989→3.069),它只交付 77% 的视频;GPT-5.6 Sol 有 48/213 个可播放视频无音轨,AQ 最低(3.71)。(3) 时间管理是失败主因:224 次无视频运行中 169 次(75%)是最终渲染开始太晚/太慢/没开始,45 次(20%)渲染卡死——其中 33 次是 ffmpeg 管道死锁(脚本往 ffmpeg 管帧却从不读 stderr,一次停在 10,102 帧的第 7,744 帧,距完成约 90 秒),7 次自我销毁(DeepSeek 在截止前 1 分钟原地重编码,留下 0.26 MB 截断文件);唯一零失败的 Opus 中位提前 24 分钟完成,而 Sol 失败运行的中位在截止前 9 分钟才启动最终渲染(逐帧浏览器截图需 5–35 分钟)。时间消融(15/30/60/120 分钟)显示预算决定交付而非质量:GLM 可播放视频从 0/20 升到 16/20,但已交付质量移动 ≤0.17。(4) 智能体自建渲染管线,自查普遍但不决定性:管线恒为「代码→帧→ffmpeg」(ffmpeg 使用率 96–100%,Manim 仅 8 次、MoviePy 13 次),各系统有家派栈——Claude 系与 Argon 偏好 cairo(42–54%),Sol/Kimi/GLM 偏好 PIL/numpy(43–55%),Astra/DeepSeek/Flash 偏好浏览器 canvas 与 three.js(52–60%);cairo 与 browser-2D 得分最高(3.79/3.73),three.js 最低(3.00);95% 的运行会查看自己渲染的帧,但跨系统查看量与质量相关 ρ=−0.07(Astra 中位只看 3 张图却最好,DeepSeek 中位 35 张);规格不合格的视频中最终报告仍宣称「已验证」的比例 Astra 10/14、Sol 3/11。按类别 Building & process 最难(3.07)、Classroom lessons 最易(4.19)。(5) 裁判能排系统、不能判单个视频:三团均值与人类 Elo 系统级 ρ=0.98,但单对视频仅 73.3% 一致(分数差 <0.2 的对只有 63%);压力测试显示黑帧/灰盒/模糊/冻结/镜像等画面缺陷与外配音轨、半交换均 15/15 检出(相关维度降 1.5–1.9 分),静音窗 7/15,而 0.5/1.5 秒音画偏移 0/15 检出;成本从 GLM 的 $0.32 到 Opus 的 $15.38(49 倍),Pareto 前沿为 GLM→DeepSeek→Astra,九系统总花费约 $12.8k;404 题教学测验与裁判分 ρ=0.93,前四系统传达 93–96% 考点;CPU 从 2 核到 16 核无显著差异(p≥0.20)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 严格任务成功(核心检查无一失败,无视频计零) | L2 strict 成功率 (%) | Claude Opus 5.5:76.3(全场最高) | Gemini 3.8 Flash:26.6(最低) | 首尾相差 49.7 个百分点 |
| 成品质量(已交付视频,三裁判团均值) | L3 overall(1–5 分) | GPT-6 Astra:4.126 | Gemini 3.8 Flash:3.470 | +0.656 |
| 交付可靠性 | 可播放视频交付率 (%) | Opus 5.5:100(239/239) | GLM-5.3-Flash:74.9(179/239) | +25.1 个百分点;Argon 由仅交付口径第 4 掉到综合第 7 |
| 裁判排序与人类偏好的一致性 | Spearman ρ(人类 Elo vs 裁判分,n=9) | 仅交付口径 ρ=0.98 | 无视频计零口径 ρ=0.77 | 证明裁判验证的是质量而非交付,两个口径必须分开报告 |
| 判官压力测试(注入缺陷检测) | 报告中点名缺陷的比例 | 0.5/1.5 秒音画偏移:0/15 | 黑帧/镜像/外配音轨等缺陷:15/15 | 暴露当前 VLM 裁判对音画时间同步的系统性盲区 |
| 时间预算消融(GLM-5.3-Flash,20 任务) | 可播放视频数 | 120 分钟预算:16/20 | 15 分钟预算:0/20 | 预算决定「交不交得出」而非「交得多好」(质量变动 ≤0.17) |
局限与改进
作者在附录 J 承认四点:固定一小时预算(更长预算可能产出更好视频,消融只覆盖 3 系统 × 20 任务);rubric 主要测「是否符合规范」,创造力与原创性只通过 VA 维度部分进入,没有被单独评估;所有裁判团都是专有模型且对音画时间偏移不敏感(压力测试 0/15 检出),绝对分值依赖具体面板、从不跨面板混用;覆盖面以英文为主(209/239)、限制在 1080p 级输出、超长任务很少。我的补充观察:(a) 渲染栈与系统强耦合,每家一个家派栈,「cairo/three.js 谁更好」只是关联而非因果;(b) 三个裁判团使用的模型中有三个本身是被评对象(J1/J2 是被评的 Gemini 系,J3 视觉判官是被评的 Sol),虽做了自偏好测量与去偏复算,仍是结构性利益冲突;(c) 每个(系统,任务)只跑一次,没有多 rollout 方差估计,单次好运或坏运直接影响名次——Astra 压过 Opus 的配对概率仅 0.91,Flash 与 GLM 统计平局;(d) 任务由 LLM 起草加人工筛选,筛选天然偏好「可检验」体裁(故事与游戏草稿只保留 17%/15%),基准偏规范化交付而非开放创作;(e) 严格成功对单条核心检查失败零容忍,Opus 的严格成功率在 J1/J2/J3 下分别为 83.7%/93.3%/51.9%,指标对裁判宽严度高度敏感,只有三团均值可比;(f) 任务冻结后存在未来模型训练数据污染的风险。
独立分析的弱点
(1) 时间管理是最大的可改进面:75% 的交付失败源于最终渲染太晚、太慢或没启动。改进方向是让 harness 或环境提示强制「先出可交付版本再迭代」——Opus 正是这么做的(先产出完整可交付成品,再只在副本上改进并验证编码后的 MP4),此外渲染写临时文件、把最终渲染的预计耗时显式纳入规划、框架在截止前 N 分钟注入「保底导出」信号,都能直接消化大部分失败。(2) ffmpeg 管道死锁 33 次全部出自两个 Gemini 系统:脚本向 ffmpeg 管帧却从不读 stderr 导致死锁是经典错误,harness 可以内置渲染失败的自愈模式(drain stderr、改用文件中介、超时重启)。(3) 自我验证过度宣称:在规格不合格的已交付视频中,Astra 有 10/14 的最终报告仍声称「已验证/ffprobe 确认」。应要求验证以程序化证据为凭(粘贴 ffprobe 输出、抽帧文件路径),并把「看帧」升级为与检查项对齐的自评。(4) 音画同步盲区:0.5/1.5 秒偏移全部漏检。可在 L1 层加程序化 A/V 对齐检查(事件帧与音轨 onset 的互相关),或引入专门的时间对齐探针模型承担 L2 音频项。(5) 静音类失败:Sol 48 个可播放视频无音轨,音频峰值检查目前只在核心任务强制,可扩展到全部任务。(6) 单次运行的方差未量化:对统计上接近的名次(如 Flash 与 GLM 平局、Astra 与 Opus 的 P=0.91)应做重复运行并报告置信排序。
未来方向
作者提出的方向:系统性地研究更长预算(消融只覆盖三个系统、20 个任务);把创造力与原创性作为独立评估轴,而非仅靠 VA 维度部分体现;开发对音画时序敏感的裁判或程序化时序检查;扩展语言覆盖(目前中文仅 30/239)与超长任务、非 1080p 输出。基于成果可延伸的方向:把 rubric 检查转化为 RL 奖励信号——作者明确提醒单视频奖励需要分数边际、多团共识或人工复核背书,这本身就是可研究的课题;把「交付前保底导出」作为 agent harness 的默认工程实践并量化收益;用受控实验研究渲染栈选择与交付率的因果关系(同一系统强制切换 cairo/three.js/PIL);把 34 个讲义/论文任务的 404 题锚定测验扩展为质量评估的客观锚;设计裁判主动重看机制(对 unknown 项回放指定时间窗)以压缩 6.3% 的 unknown 率;以及在固定总评测预算下优化 rollout 分配——把次数集中给排名接近的系统以收紧置信区间。
复现评估
复现难度中等偏上但完全可行。开源情况:基准(239 任务、rubric、共 2.69 GB 输入资产、任务-子类映射)与可复现沙箱镜像经项目页 vibevideobench.github.io 发布;每次运行的模型流量全量记录(轨迹、token、每次工具调用),附录给出完整提示模板、判官协议与逐表数据(含每面板排行榜与 bootstrap 置信区间)。算力门槛很低:单次运行只需 8 CPU、32 GB、无 GPU、1 小时墙钟;真正的门槛是 API 成本——九系统全量复现约 $12.8k(list-price),单系统从 $76(GLM)到约 $3.7k(Opus)不等,判官侧还需 Gemini 4 Argon、Gemini 3.8 Flash、GPT-5.6 Sol、Qwen3.8-Omni-Flash 四个裁判模型的 API 配额。人类偏好盲测(239 任务全量成对比较)难以零成本复现,但验证裁判时可用子集替代。注意事项:部分模型价格是促销价(Gemini 4 Argon 正常价约 $5.9/任务);经典游戏任务使用新设计的关卡与素材(作者不重分发原版素材),复现须用发布版本;harness 版本已固定(Codex CLI 0.162、Claude Code 2.1.301、Antigravity CLI、DSH 0.2.1、Kimi Code 2.2.0、ZCode 0.17.0),升级后行为可能漂移。总体:数据与协议公开度高,复现单系统排名可行,全量九系统复现需要约 1.3 万美元预算与数周编排工作。
论文图表
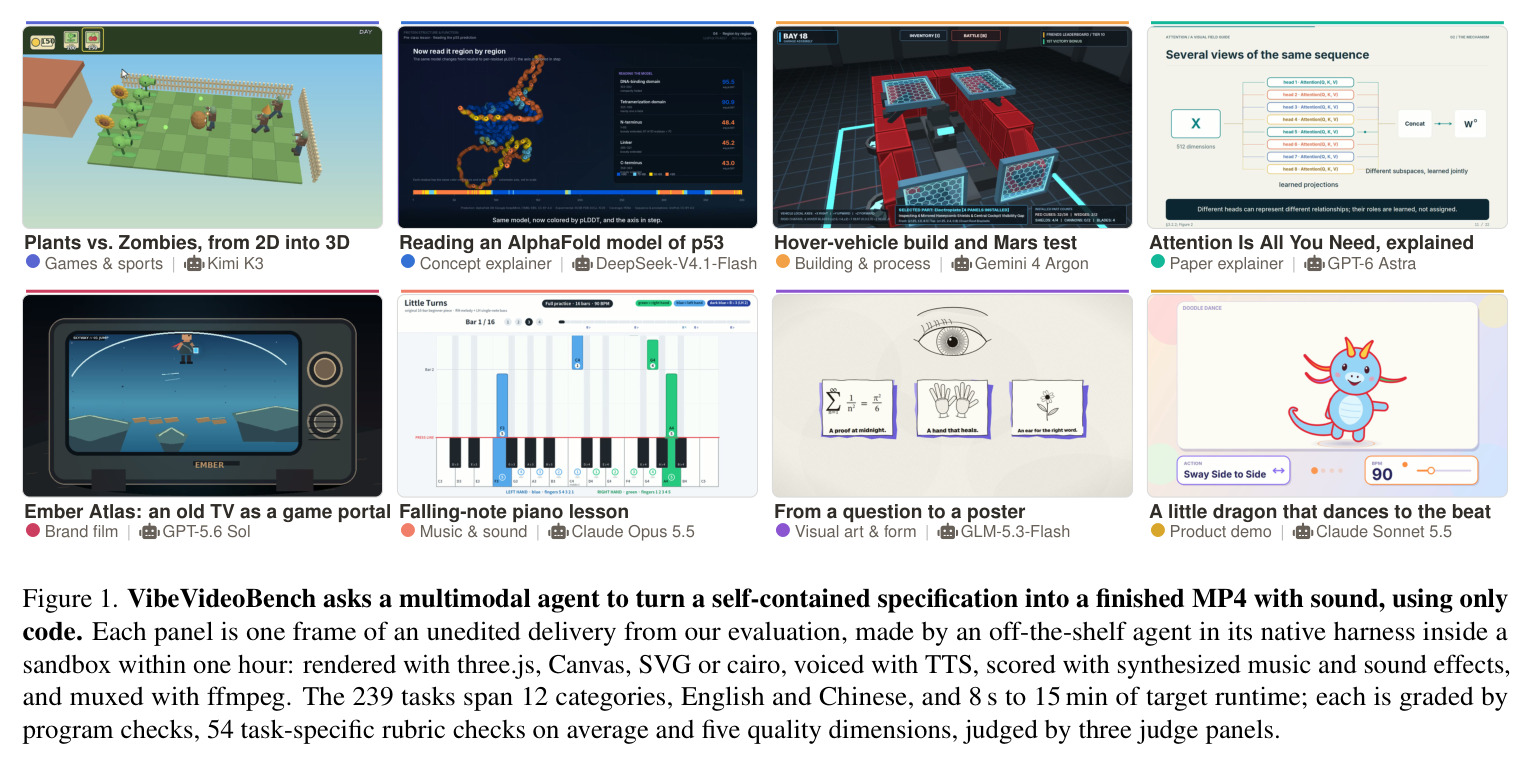
一排真实交付的视频帧面板(每面板一帧、未剪辑),由现成智能体在原生 harness、沙箱内一小时内完成:用 three.js、Canvas、SVG 或 cairo 渲染画面,TTS 配音,代码合成音乐与音效,ffmpeg 合成封装。覆盖 239 个任务、12 个类别、中英双语、8 秒到 15 分钟的目标时长,评测含程序检查、平均 54 条任务 rubric 检查与五个质量维度、三个裁判团。
一图定义了「代码驱动视频生成」的任务形态与难度范围,是建立直觉的最佳入口:读者第一眼就能看到智能体实际产出什么样的视频。
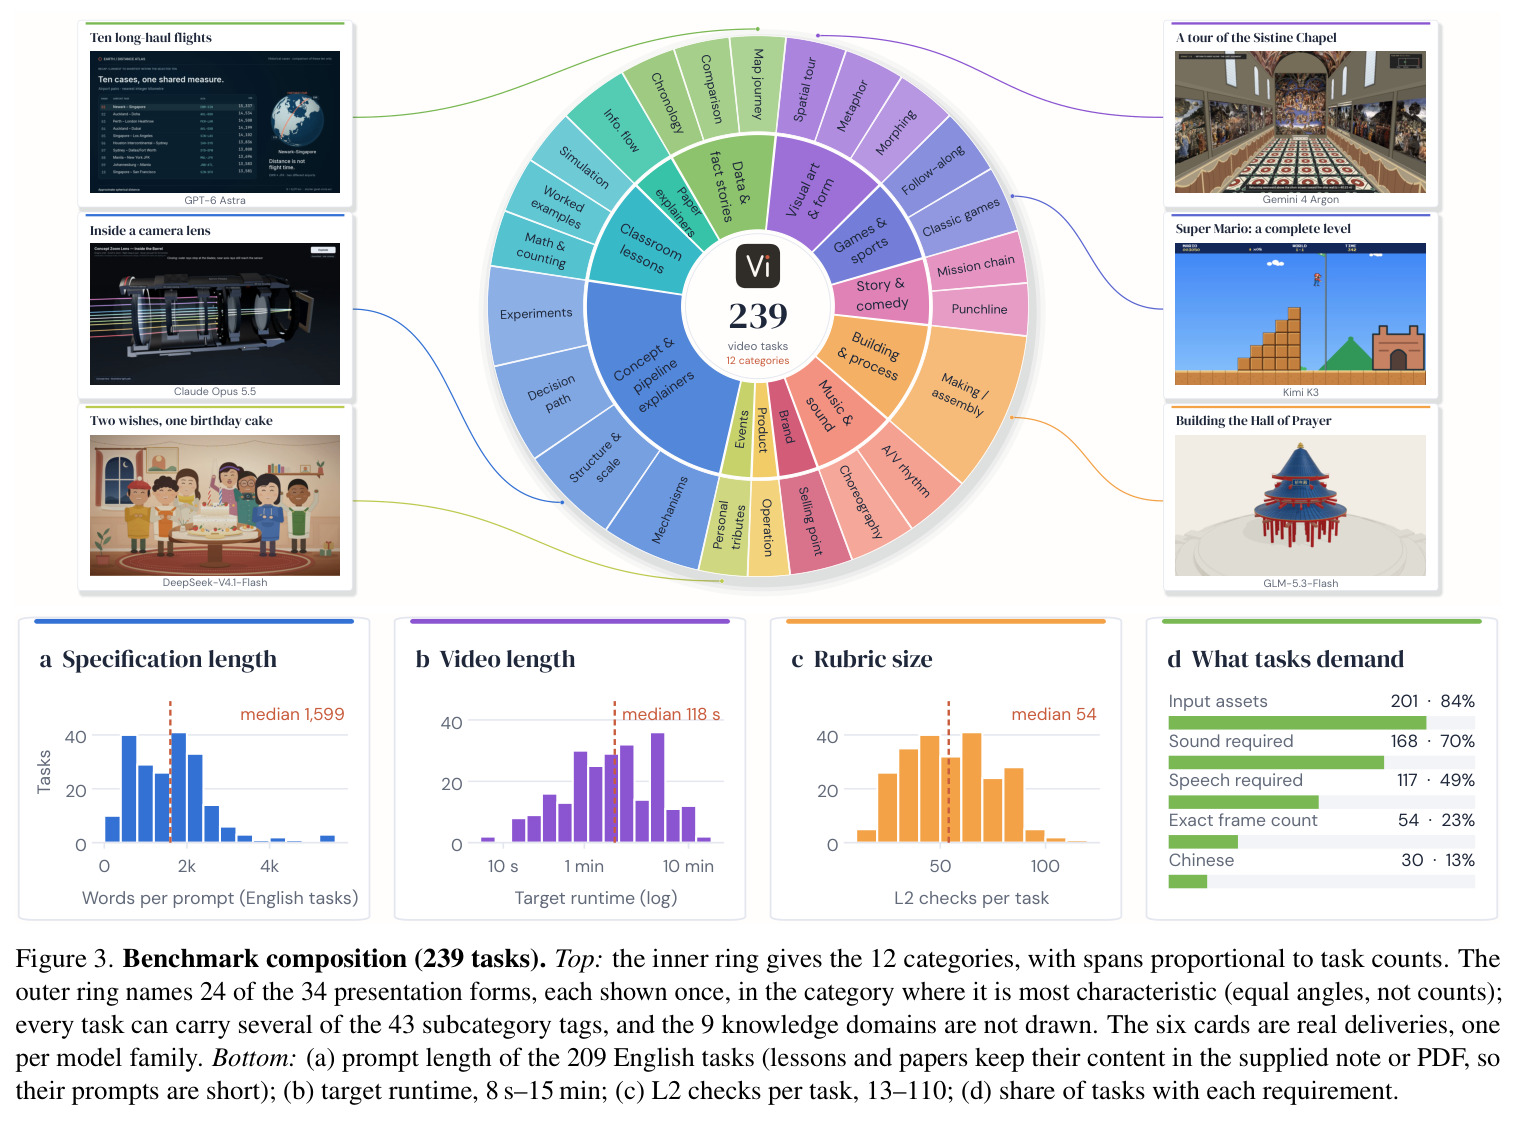
上半部是双环图:内环为 12 个类别(Concept & pipeline explainers 57 个最多,Paper explainers 10 个等),外环展示 24 种表现形式的示例卡片(每类一张真实交付帧,按模型家族各一);下半部四张统计图:(a) 英文任务提示词长度中位 1,599 词;(b) 目标时长中位 118 秒(8 秒–15 分钟,对数轴);(c) 每任务 L2 检查数中位 54 条(13–110);(d) 需求占比——84% 带输入资产、70% 要求声音、49% 要求语音、23% 要求精确帧数、13% 为中文。
用数据证明基准的多样性与规模:类别、形式、长度、音频要求全覆盖,是评价「这个基准有没有代表性」的直接依据。
(a) 每任务平均 API 成本条形图(按 token 类型分解:新输入/缓存读/缓存写/含推理的输出):Opus $15.38 最高且 76% 花在缓存写入,Sol $11.84 且 55% 是未缓存输入,GLM $0.32 最低;(b) 成本(对数轴)对综合分数的散点图,虚线标出 Pareto 前沿:GLM($0.32, 2.79)→DeepSeek($0.47, 3.91)→Astra($8.19, 4.11),Opus 和 Sol 花更多分不高。
补充性价比维度:成本跨度 49 倍而分数跨度仅 1.3,说明「贵≠好」,对实际选型和复现预算规划都有直接参考价值。
L1 程序检查的逐系统明细:可播放率、分辨率、帧率、时长、精确帧数(54 个任务)、音频(98 个任务要求)、源工程提交与全通过数。Opus 全通过 204/205(99.5%),Astra 190/205,GLM 127/205(62.0%);在 1,628 个可播放交付中最常见的程序检查失败是时长(34 次)、缺源工程(20 次)、帧率(15 次,如 24 代替 30 fps 或 30.01 漂移)、精确帧数(10 次)、无声音频(10 次)、分辨率(6 次)。
展示纯代码层能可靠验证什么、失败集中在哪:程序检查把「容器规格」这一层certify得很死,剩下的才需要裁判。
224 次失败运行的逐条归因矩阵(按系统 × 失败模式):时间管理 169 次(最终渲染过晚/过慢 104 + 从未开始 65,GLM 56、Argon 31 最多,Opus 0);卡死或被切断 45 次(ffmpeg 管道死锁 33 次、后台渲染被切断 12 次,全部出自两个 Gemini 系统);自我销毁 7 次(如 DeepSeek 截止前 1 分钟原地重编码留下 0.26 MB 截断文件);其他 3 次。底部还给出运行结束时的物理状态:截断 MP4(无 moov atom)90 次、超时无 MP4 113 次、无 MP4 但智能体自行结束 17 次等。
全文工程价值最高的表:把「智能体为什么交不出视频」从印象变成可分类、可归因、可修复的清单,直接指向 harness 与提示层的改进方案。
人类盲测成对偏好的 Bradley–Terry 强度:Astra 1242(胜率 0.783)、Opus 1203、Sonnet 1121、Argon 1081、DeepSeek 1022、Kimi 997、GLM 905、Gemini 3.8 Flash 723、GPT-5.6 Sol 705,附 95% CI 与名次区间。三个梯队清晰:Astra/Opus 领跑且不可区分(+39 Elo,P=0.69),中间五系统相邻不可分,Flash 与 Sol 并列垫底;人类排名与仅交付口径的裁判排名 ρ=0.98,只有末两位互换。
裁判验证的人类侧原始数据:它同时证明了裁判排序的可信性与「人类只能评价已交付视频」这一口径设计的必要性。
(a) 每对裁判团的一致性对比条形图:系统级 Spearman ρ 0.95–0.98、Kendall's W=0.98,但同任务对序一致仅 0.66–0.70、单视频 Pearson r 0.44–0.50、检查 κ 0.42–0.54;(b) 各团对不同系统的宽严偏移:J1 整体 −0.41 且对弱系统更狠(对 Sol −0.67、对 Flash −0.59,对 Astra/Opus 仅 −0.24),J2 +0.19(70% 的维度分是 4 分)、J3 +0.22。
量化裁判面板的两大问题——单视频判定噪音大、宽严度系统性地偏向弱系统——解释了为什么指标内绝不混用面板、只用三团均值。
自我偏好矩阵:每个裁判团的「相对分」(本团对某系统的打分减去另两团对同一次运行打分的均值)。J2 偏爱本家 Gemini 3.8 Flash +0.16、J3 视觉判官偏爱本家 GPT-5.6 Sol +0.20(95% CI 均不含 0);J1 对本家 Argon 无偏好(+0.03)甚至压低 Gemini 家族(−0.12);各团还有与自身无关的口味(J1 偏爱 Claude 系与 Astra +0.17~+0.21、厌恶 Sol −0.32)。正文复算:去掉本家评委只交换最后两名(τ=0.94),按家族剔除并做宽严校正后排名完全不变(τ=1)。
把「裁判也是被评模型」的利益冲突变成可测量、可校正的对象,是这篇基准在评测方法论上最讲究的部分。
对 30 个已交付视频用 ffmpeg 注入 10 类缺陷后让 J1 在不知情下重判:画面缺陷(黑窗、灰盒、模糊、冻结、镜像)、外配音轨、半交换全部 15/15 被报告点名且相关维度降 1.53–1.93 分;静音窗 7/15(AQ −0.80);而 0.5 秒和 1.5 秒音画偏移 0/15 检出,报告反而常称赞同步(五维均值仅降 0.11/0.16)。镜像与半交换虽被点名但目标检查项仍大多通过(flip 率仅 +4.5/+14.9 个百分点,惩罚落在 VQ/CL);干净重编码比原判 +0.12,说明单视频 0.1–0.2 的差距在裁判噪音内。
直接暴露整个评测协议的边界:裁判看得出画面坏了、听不出声音晚了。这解释了为什么 rubric 不设严格的音画偏移容限,也是未来做时序敏感裁判的动机。
独立效度检验:404 道锚定视频内容的多选题(每个答案必须给出时间戳与视频原话,证据核对不实计为未覆盖),由裁判模型只看视频作答。系统级与三团裁判分的相关 ρ=0.93(p<0.001);前四名系统传达 93–96% 的考点,Gemini 4 Argon 的 77.4% 主要被 5 个无视频任务拖累(其余 29 个任务上 90.8%);3,425 个 A–D 答案中只有 2 个答错,失分几乎全部来自「视频没讲到」而非「讲错了」。
用与 rubric 完全独立的客观测验验证裁判分数确实反映「视频是否把知识讲到了」,堵住「裁判分只是审美偏好」的质疑。
把 DeepSeek-V4.1-Flash、Gemini 3.8 Flash、GLM-5.3-Flash 在 20 个任务上以 15/30/60/120 分钟预算重跑:可播放视频数从 15 分钟的 16/10/0 升到 120 分钟的 20/19/16;而已交付视频的质量在各系统内变动 ≤0.17(DeepSeek 3.80–3.94、Flash 3.63–3.80、GLM 3.73–3.87),置信区间重叠。GLM 在每个更大的预算下都交付更多(0→6→13→16),且部分运行即使 120 分钟仍被截止;Flash 倾向提前自行结束,DeepSeek 和 GLM 会用满给它的额外时间。
干净的消融证明:一小时预算约束的是「交不交得出」,不是「交得多好」——为发现 3(时间管理)和固定预算的合理性提供了直接证据。
六个系统在相同的 20 个渲染密集任务上以 2/8/16 CPU 核重跑(共 360 次运行):配对差异 +0.09(8 vs 2)、+0.13(16 vs 8)、+0.22(16 vs 2)均不显著(p=0.57/0.44/0.20),可播放视频从 99/120 升到 101、103/120(符号检验 p≥0.56),已交付质量几乎不动(3.81/3.84/3.92)。系统方向不一致:Kimi 与 Flash 在 8 核最好,Sol 在 2 核最好;Argon 从 9 升到 12 个视频主要因 16 核臂下 ffmpeg 管道死锁减少(8 次失败中仅 2 次,另两臂 21 次中 9 次)。
排除「沙箱算力太弱导致分数偏低」这一常见质疑,说明主结果的瓶颈在智能体的时间规划而非硬件。