会下棋并能解释自己走法的语言模型 Language Models that Play Chess and Explain Their Moves
4B 模型经专家编码器桥接与贝尔曼式迭代自蒸馏,棋力达特级大师水平并能解释走法
前置知识
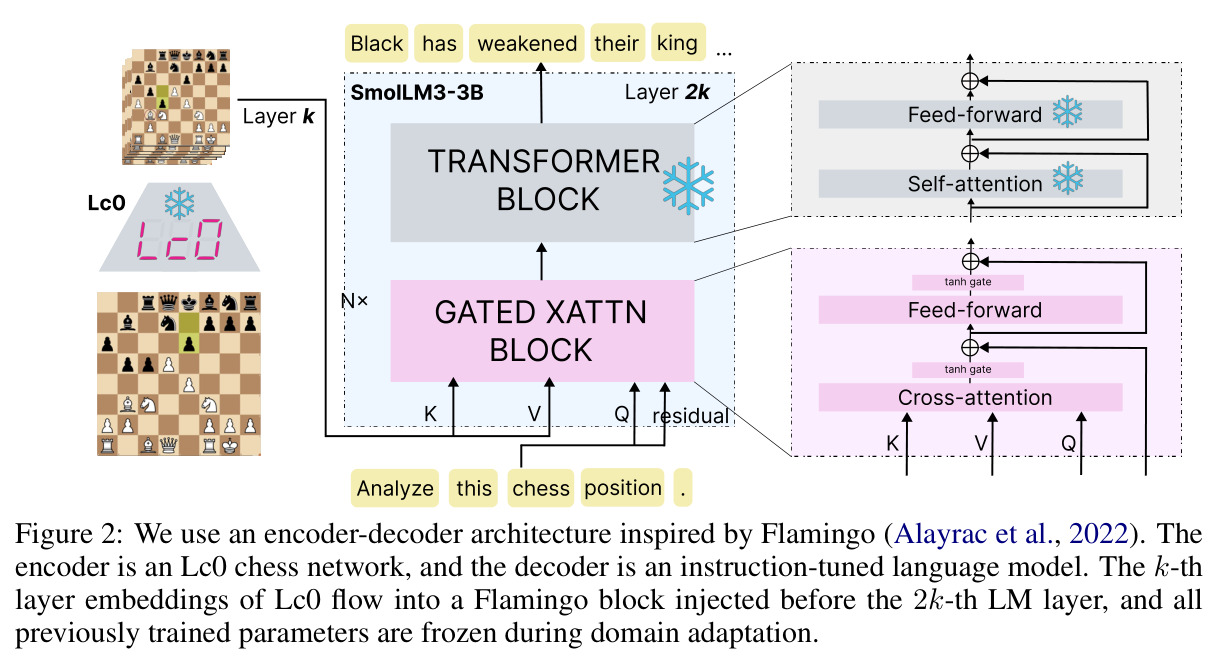
门控交叉注意力(Flamingo 桥接)
编码器-解码器架构中连接两个模态的机制:交叉注意力层的 Key/Value 来自编码器隐状态、Query 来自解码器隐状态,输出经 $\tanh(\alpha)$ 门控标量加进解码器残差流,$\alpha$ 初始化为 0 使桥接从恒等映射起步、随训练逐渐打开。Flamingo 用它把视觉特征注入语言模型。
QUEEN 的核心架构就是把 Lc0 棋编码器按此方式桥接到 SmolLM3 解码器,不理解门控交叉注意力就无法看懂 Figure 2 和训练哪些参数。
Elo 等级分
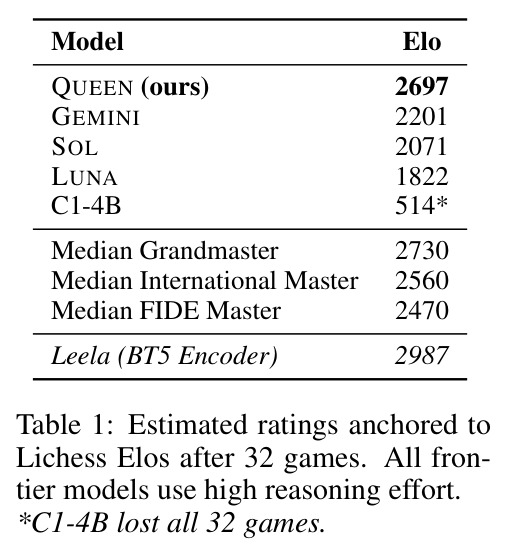
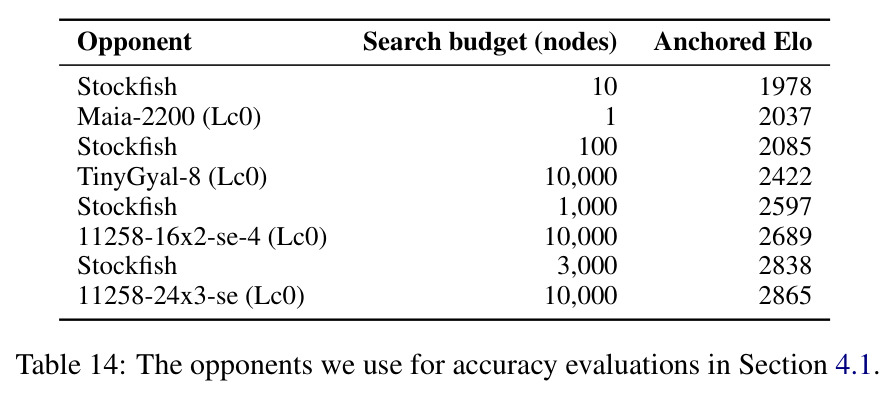
国际象棋通用的实力评级体系:分差 400 对应约 91% 的预期得分。本文让模型与 8 个已知棋力的引擎各下若干局(共 32 局),把结果锚定到 Lichess Elo 尺度估算棋力,例如中位特级大师闪电战约 2730、中位国际大师约 2560。
Elo 是本文最主要的准确性指标,论文所有棋力结论(2697 对 2071 等)都以它表述,需理解分差与胜率的换算才能体会提升幅度。
主变(PV)与引擎评估、失误定义
国际象棋引擎对局面输出以厘兵(centipawn,兵价值的 1/100)为单位的评估并可换算为期望胜率,同时给出双方最佳应对序列即主变(PV)。本文把'失误'定义为某步走法使期望胜率相对 Stockfish 最优解下降 10% 以上,并以此过滤训练数据和评测 PV 质量。
QUEEN 生成的解释由最佳走法、PV 和散文三部分组成,NMR/FNMR 指标与迭代蒸馏的过滤规则全部建立在这些概念之上。
贝尔曼方程与价值迭代
动态规划中的核心递归 $V(s) = \max_{a} \mathbb{E}[r + \gamma V(s')]$:父状态的价值由子状态的价值组合而来。AlphaZero 用 MCTS 产生更优估计再蒸馏回网络;把 MCTS 换成 alpha-beta 剪枝就得到简化的价值迭代形式。
本文最大的创新是把贝尔曼更新搬进自然语言空间——用子局面的解释组合出父局面的解释——读懂这层类比是理解方法的关键。
SFT 与知识蒸馏
监督微调(SFT)指在标注好的输入-输出对上继续训练语言模型;知识蒸馏指让小模型模仿更强教师模型的输出以获得其能力。二者结合即用教师生成的文本做 SFT,本文播种阶段用 GPT-5.6-Sol(low) 生成解释数据,迭代阶段则用模型自身产出自蒸馏。
从 PAWN-1 的播种到七轮迭代训练,每一步都是 SFT,理解蒸馏的'教师-学生'关系才能明白为何迭代能超越初始教师的质量。
FEN 与棋盘状态编码
FEN(Forsyth-Edwards 记法)是用一行字符串即可完整编码国际象棋局面的标准格式。本文的输入是 (FEN, 文本) 对:Lc0 编码器把棋盘读成固定 64 个 token(每格一个)的序列,前人已证明其中间层编码了棋子位置、合法走法与战术延续等概念。
整个方法的前提是'专家编码器的表征里已经含有需要解释的概念',域适应课程本质上是训练 LM 从这些表征中读出信息。
研究动机
现代国际象棋引擎是'沉默的专家':Stockfish 与基于 Transformer 的 Leela Chess Zero(Lc0)已达到超人棋力(本文用的 BT5 编码器不经搜索即约 2987 Elo),却只输出走法概率与胜率,无法用自然语言说明理由。另一边,语言模型虽能生成看似合理的解说,但棋力薄弱:早期工作多在孤立的战术谜题上训练和评测,选点经常出错;同尺寸的先前模型 C1-4B 在与 8 个引擎的全局对弈中 32 局全败(估算 Elo 仅 514)。前沿模型有所改善——GPT-5.6-Sol(high) 约 2071、Gemini-3.1-Pro 约 2201,但仍远低于中位特级大师的闪电战等级分(约 2730)——且推理成本高昂:与 GPT-5.6-Sol(high) 下棋每局常超过 15 美元。解释的质量受限于走法的质量,弱棋力使现有解释的实用价值大打折扣,而强引擎的零解释能力又让棋手无从学习。
本文的目标是本文目标是构建一个约 4B 参数的棋语模型 QUEEN(QUality Explanation and Evaluation Network),同时满足两个此前不可兼得的要求:其一,棋力达到典型特级大师水平(约 2697 Elo),保证被解释的走法本身接近最优;其二,能对任意局面生成结构化解释——由最佳走法推荐、预测主变(PV)和自然语言散文分析三部分组成,说明为什么选该走法、备选走法差在哪里。作者还希望整条流水线是领域无关的配方:专家编码器桥接架构加迭代自蒸馏训练,可推广到机器人、计算机操作等存在'沉默专家'的领域;并配套建立准确性(accuracy)、论证性(substantiation)、连贯性(coherence)三维评测框架,系统比较本文模型与前沿 LM 及先前工作。
与已有工作不同的是,本文切入点的独特之处在于拒绝让 LM 从专家轨迹中'学会下棋'。专家数据只有状态-动作对而没有语言解释,直接微调 LM 的棋力提升已被证明有限。作者反过来利用可解释性研究的发现——Lc0 的中间层表征已经编码了棋子布局、合法走法和战术延续——于是把 LM '直接桥接'到一个表征中已含这些概念的静默专家编码器上:域适应阶段冻结两个大模型、只训练桥接参数,教 LM 从编码器隐状态中读出棋概念。第二个独特设计是把 AlphaZero 式'搜索-蒸馏'循环搬到语言空间:不依赖更强的教师,而是让模型分析三个候选走法之后的孩子局面,把子节点解释整合成父节点解释再蒸馏回自身——贝尔曼更新的自然语言版本,让解释质量随迭代自我提升。
核心方法
直觉上,解释质量的上限由被解释走法的质量决定,所以先解决'棋力'再解决'讲解'。QUEEN 是编码器-解码器模型:编码器为 Lc0 家族的 BT5 网络(240M 参数、15 层、隐藏维 1024,输入固定 64 个格子 token,无搜索即近超人棋力),解码器为指令微调的 SmolLM3-3B(36 层、隐藏维 2048)。仿照 Flamingo,在解码器每隔一层(第 0, 2, …, 30 层前)插入 16 个门控交叉注意力块:第 $i$ 层编码器隐状态 $e_i$ 与第 $2i$ 层解码器状态配对,K/V 投影自 $e_i$、Q 来自解码器,输出经 $\tanh(\alpha)$ 门($\alpha$ 初始化为 0)加进残差流。训练全程冻结编码器和解码器,只训练约 470M 桥接参数与新增 token 嵌入。训练分两阶段:先用四阶段问答课程把 SmolLM3 改造成能读懂棋盘表征的 PAWN;再用 GPT-5.6-Sol(low) 生成的解释做种子 SFT 得 PAWN-1,随后跑七轮'采样-生成-递归-整合-训练'的迭代搜索蒸馏,第 8 个检查点即 QUEEN。
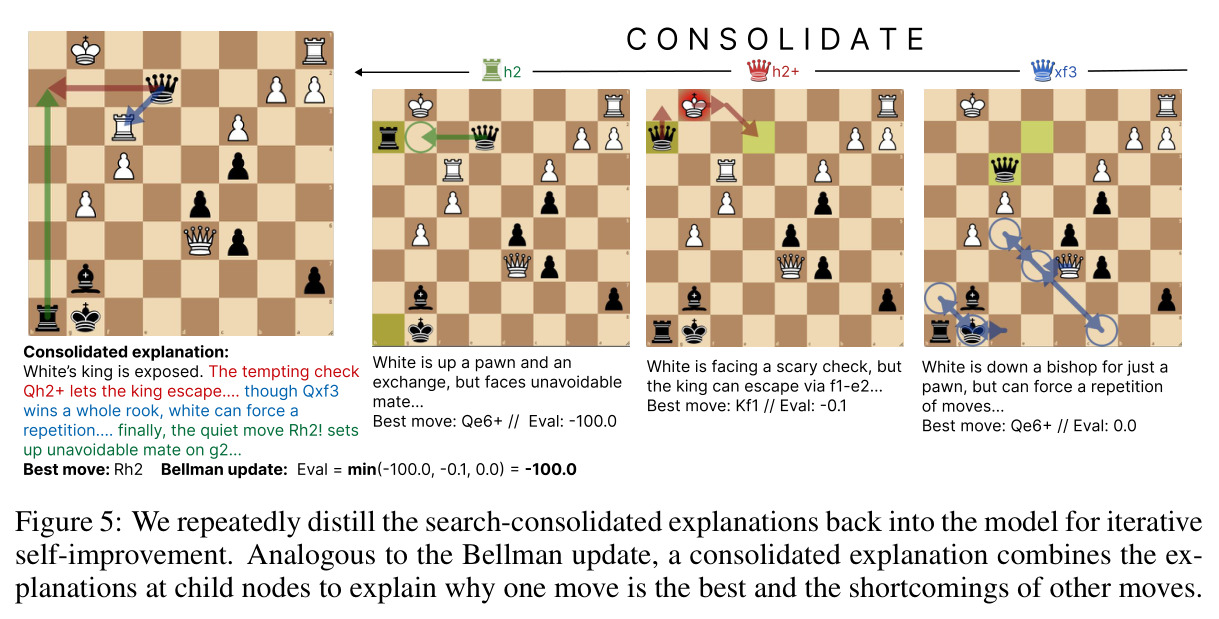
核心创新是'自然语言版贝尔曼更新'。AlphaZero 反复用 MCTS 产生更好的价值估计并蒸馏回网络,使模型无需搜索也能复现搜索结果;作者把 MCTS 换成经 alpha-beta 简化的价值迭代 $V(s)=\max_{a}[r+\gamma V(s')]$,但被组合的不是标量价值而是子节点的完整解释:对根局面取三个候选走法,让模型分别解释走完后的三个孩子局面(该走法为什么好/坏、后续如何应对),再用一个指令 LM(Qwen3.8-27B,被严格要求不得引入新内容)把三份子解释整合成对根局面的解释——为什么最佳走法最好、其他走法差在哪——最后经 Stockfish 过滤并 SFT 蒸馏回模型。与从更强教师蒸馏的本质区别在于:改进信号来自模型自己'多看一层',相当于把隐式搜索树逐轮压进权重,同时提升棋力与前瞻论证能力。
方法步骤详情
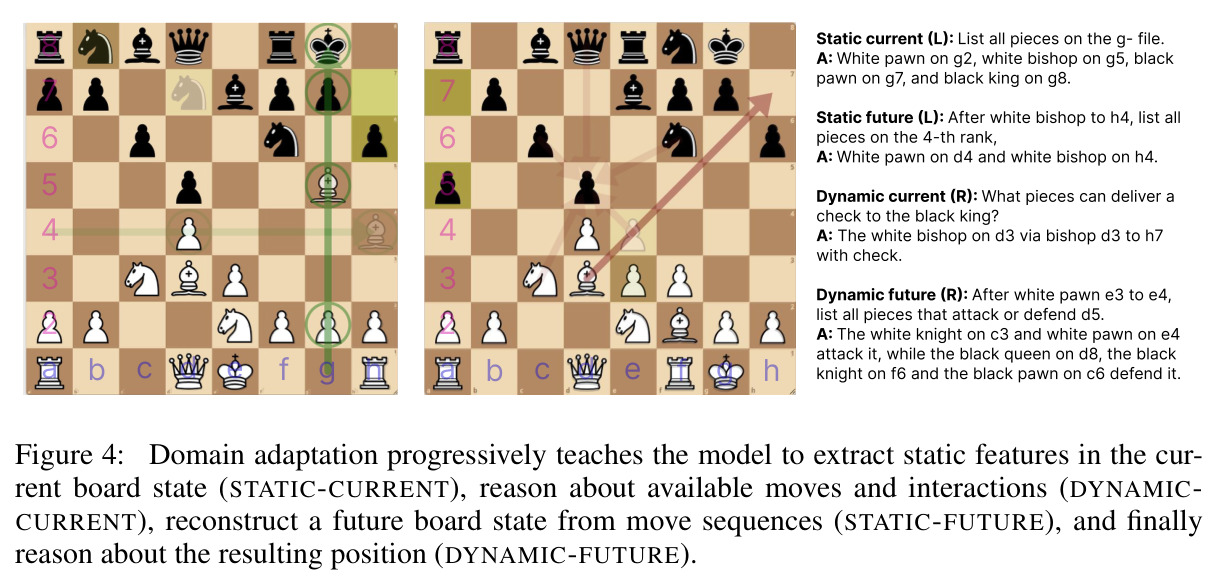
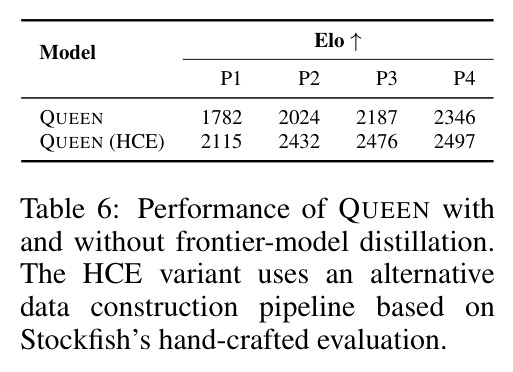
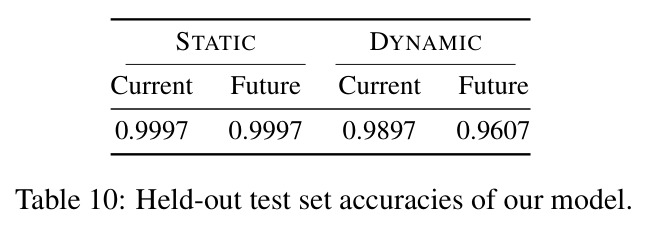
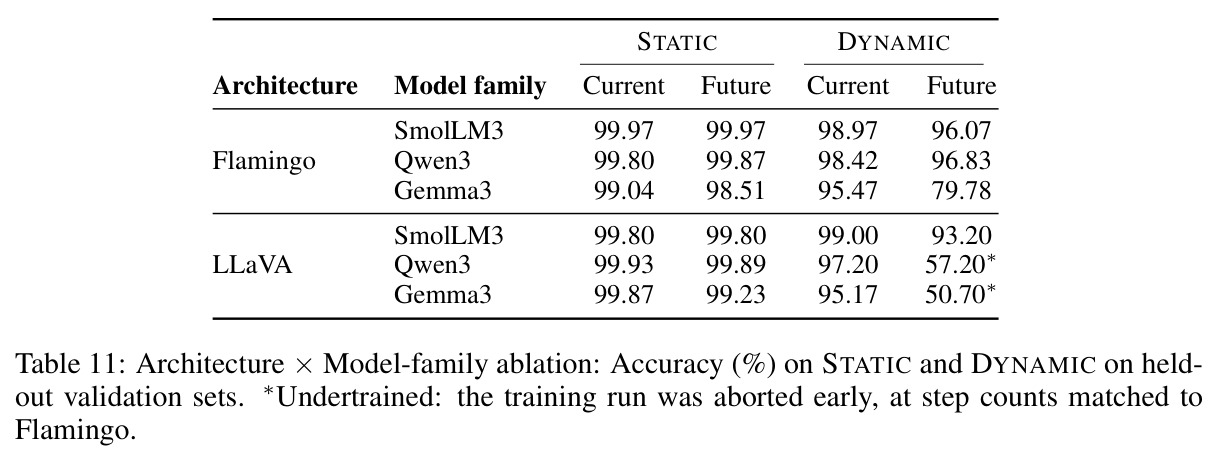
第一阶段(域适应,产出 PAWN):为 64 个格子和 12 种棋子加专用 token,按静态当前→动态当前→静态未来→动态未来四阶段课程训练桥接参数(各阶段 50K/60K/30K/100K 步,旧阶段数据低比例回放防遗忘),held-out 准确率达静态 99.97%、动态未来 96.07%。第二阶段(播种):从 Lichess 取 15,000 个局面,用 GPT-5.6-Sol(low) 生成含最佳走法、PV、候选走法、评值与散文的解释(花费 652.35 美元),经 Stockfish(100K 节点) 过滤后余 8,602 条,SFT 得 PAWN-1(1782 Elo)。第三阶段每轮迭代:(1) 采样约 40 万根局面(实战、谜题、人机对弈混杂);(2) 模型对每根生成三个候选走法的解释,若全是失误则用引擎最优替换最差者;(3) 对三个孩子局面独立解释,任一孩子首着失误就以它为新根递归(至多 5 次);(4) 用 Qwen3.8-27B 整合三份子解释,评值覆写为引擎真值;(5) 与原 PV 在首次分歧处比较,更差则丢弃,余约 15 万–28.3 万条数据 SFT 出下一轮。七轮后 Elo 从 1782 升至 2697。
技术新颖性
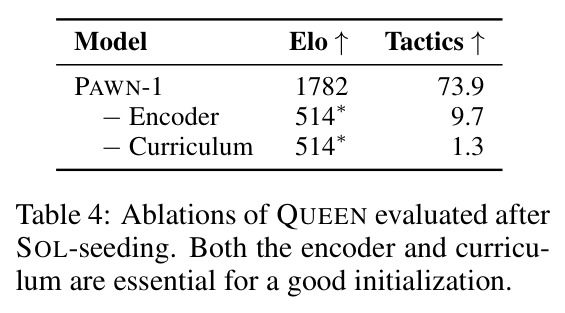
技术新颖性体现在四点。(1) 多层编码器注入:Flamingo 原版只用视觉编码器最后的隐状态,本文将第 $i$ 层编码器状态配给第 $2i$ 层解码器,让多尺度棋盘特征渐进流入残差流;消融显示去掉编码器后模型 32 局全败(Elo 514、战术 FNMR 仅 9.7%),去掉课程更跌至 1.3%。(2) 语言空间的贝尔曼自蒸馏:此前棋类 LM 依赖模仿更强引擎或大师(如 C1-4B 的 master distillation),本文证明模型可以通过'子解释→父解释'的自举获得超越初始教师水平的前瞻能力,7 轮净增 915 Elo。(3) 域适应与讲解训练解耦:先教会'读编码器'再教'写解释',两阶段各自可独立检验与复用。(4) 去前沿化路径:用 Stockfish 手工评估特征加 Maia-1100 模拟人类失误构造模板解释替代 GPT 播种(QUEEN-HCE),四轮即达 2497 Elo 且起点更高(2115 对 1782),说明该配方不依赖昂贵的前沿模型标注。
实验结果
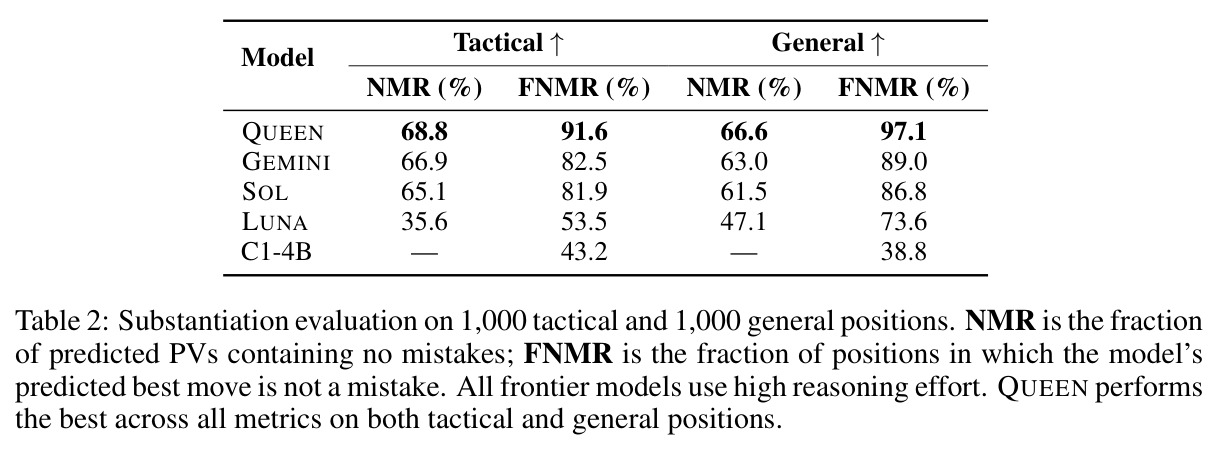
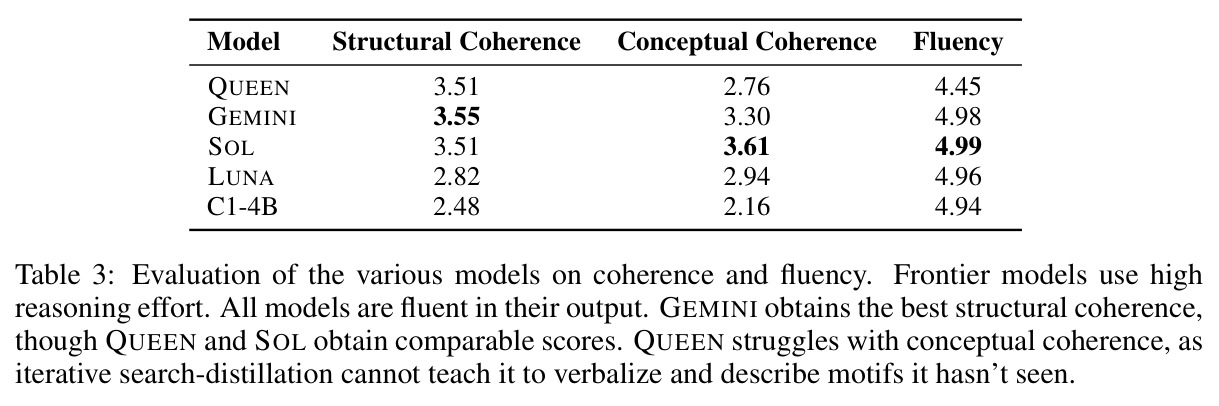
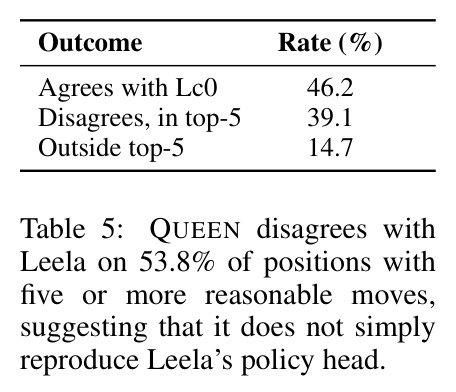
准确性(Table 1,32 局 × 8 引擎锚定 Elo):QUEEN 达 2697,超 GPT-5.6-Sol(high) 626 分(预期胜率 97.4%)、Gemini-3.1-Pro 496 分(94.6%),参数量少约三个数量级;同尺寸基线 C1-4B 全败(514);距编码器 Leela(2987)有 290 分'言语化债务'。七轮迭代 Elo 轨迹 1782→2024→2187→2346→2539→2434→2559→2697,共 +915。论证性(Table 2):1,000 道 Lichess 战术题上 QUEEN 的 NMR 68.8%、FNMR 91.6%,领先 Gemini(66.9/82.5)与 Sol(65.1/81.9);实战局面上 FNMR 达 97.1%(Gemini 89.0%)。连贯性(Table 3):结构连贯 3.51 与 Sol 持平、接近 Gemini 的 3.55;流畅性 4.45 略低于其他模型;概念连贯仅 2.76,明显落后于 Sol 的 3.61。分析实验:在 1,000 个多解局面上 QUEEN 有 53.8% 与 Leela 首选不一致,说明不是复读策略头;去前沿播种的 QUEEN-HCE 四轮达 2497,起点更高(2115 对 1782)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全局对弈棋力(32 局 × 8 引擎) | Lichess 锚定 Elo | 2697 | GPT-5.6-Sol(high):2071 | +626(预期胜率 97.4%) |
| 全局对弈棋力 | Lichess 锚定 Elo | 2697 | Gemini-3.1-Pro(high):2201 | +496(预期胜率 94.6%) |
| 1,000 道 Lichess 战术谜题 | NMR(整条 PV 无失误率) | 68.8% | Gemini-3.1-Pro:66.9% | +1.9 个百分点 |
| 1,000 道 Lichess 战术谜题 | FNMR(首着无误率) | 91.6% | Gemini-3.1-Pro:82.5% | +9.1 个百分点 |
| 1,000 个人类实战局面 | FNMR(首着无误率) | 97.1% | Gemini-3.1-Pro:89.0% | +8.1 个百分点 |
| 解释连贯性(LM 评判,1–5 分) | 结构连贯(Structural) | 3.51 | GPT-5.6-Sol(high):3.51;Gemini-3.1-Pro:3.55 | 与 Sol 持平,距 Gemini 差 0.04 |
| 解释连贯性(LM 评判,1–5 分) | 概念连贯(Conceptual) | 2.76 | GPT-5.6-Sol(high):3.61;Gemini-3.1-Pro:3.30 | 落后 0.85 / 0.54(本文承认的短板) |
| 迭代自蒸馏(7 轮) | Elo 提升幅度 | 1782 → 2697(+915) | 播种后起点 1782 | 净增 915 Elo |
| 去前沿播种变体 QUEEN-HCE(4 轮) | Elo | 2115 → 2497 | 标准 QUEEN 前四轮 1782 → 2346 | 起点高 333,轨迹相当,证明可摆脱前沿教师 |
局限与改进
作者承认的局限:(1) 概念连贯性低(2.76)——迭代蒸馏能提升结构连贯,却教不会模型'说出'编码器表征之外的战术母题,幻觉可能经整合步骤传播并被固化进权重;(2) 与 Leela 之间 290 Elo 的'言语化债务'表明隐式专家知识难以完全转化为语言。我的补充观察:(1) 连贯性评判用的是 GPT-5.6-Sol(high),与基线 Sol 同家族,存在自我偏好风险,且每个模型只下 32 局,棋力估计的置信区间不小;(2) 训练全程依赖 Stockfish 真值做过滤、评测也以引擎为金标准,'解释好'基本被引擎定义,缺少人类棋手的盲测或教学效果验证;(3) 第五轮 Elo 从 2539 回落至 2434,说明自蒸馏并非单调稳定,对数据质量和过滤阈值敏感;(4) 每个根局面固定展开三个候选分支、递归至多 5 层,搜索宽度僵化,难以覆盖长程强制线;(5) 流畅性 4.45 与前沿模型 4.9+ 的差距意味着散文可读性仍有可感差异。
独立分析的弱点
独立分析的弱点与改进方向:(1) 概念幻觉会沿整合链传播——整合器虽被禁止新增内容,但若子解释中已有'这是一步牵制'的错误断言,会被原样搬入父解释并经 SFT 固化;可在整合前加入基于探针的概念校验器(对编码器表征做 fork/pin/outpost 探针)做事实核查。(2) 自我分布窄化——每轮训练数据都来自上一轮模型的对弈与选点,七轮后可能过拟合自身风格;可逐步提高引擎对弈局面占比,或引入按 Stockfish 胜率增益加权的 RL 目标,替代纯 SFT。(3) 搜索宽度固定为 3、递归深度上限 5,对长程强制线无能为力;可让模型学会'哪里值得多看一步'的自适应分支。(4) 论证性只以失误计数衡量,不衡量解释对人类学习的实际帮助,应补充面向不同水平棋手的人类实验。(5) 仅在棋类这一有完美先知引擎的领域验证,机器人等缺乏低成本真值评估器的领域如何获得过滤信号仍属未知。(6) 前沿基线对局成本高(每局超 15 美元)限制了评测规模,置信区间较宽。
未来方向
作者展望:将'静默专家编码器 + LM 解码器 + 迭代搜索蒸馏'的配方推广到任何存在专家 Transformer 编码器且树搜索(MCTS、alpha-beta)能带来增益的状态环境,包括其他游戏、机器人操作与计算机使用(GUI 智能体)——由专家模型提供领域表征与评估信号,语言模型把信号转成人类可读解释与后续推理素材。基于本文成果可延伸:(1) 关闭言语化债务——用 AlphaZero 概念探针构建概念瓶颈监督,直接教模型命名编码器已编码的战术母题,拉高概念连贯分;(2) 推理时显式搜索——让 QUEEN 在解码阶段展开解释树再整合,等于把训练期的贝尔曼更新搬到测试期,可能进一步提升棋力与论证深度;(3) 把 QUEEN-HCE 的'引擎特征→模板解释'路径做成跨领域自动化生成器,彻底摆脱前沿教师;(4) 用连贯性判分做 RLAIF 替代纯 SFT,同时优化散文质量与走法正确性;(5) 结合 Maia 式人类对齐,按用户水平个性化解释的详略与表述。
复现评估
复现条件相当友好。编码器(Lc0 BT5)与解码器(SmolLM3-3B)均公开,训练数据来自公开的 Lichess 对局数据库与谜题集,前沿播种成本仅 652.35 美元,迭代自蒸馏数据全部自产;论文页眉标注了模型、代码与网站链接,附录给出四阶段课程的完整问题模板(Table 7)、数据配比(Table 8)、全部超参(Tables 9/12/13)、数据挖掘伪代码(Algorithm 1)与整合/评判 prompt(附录 F)。算力方面:总参数约 4B 但域适应只训练约 470M 桥接参数,SFT batch 32–256、序列长 2048、bf16,单节点多卡(如 8×A100)即可承受;七轮迭代的主要开销在数据生成与 Stockfish 评估(每根局面需数百次引擎调用)。难点在工程整合:递归数据挖掘、多引擎编排、防评测集污染的去重需要仔细实现;评测端跑前沿基线较贵。总体属于中等偏易的研究复现,完整复现 QUEEN 级别的棋力估计需数周工程投入。
论文图表
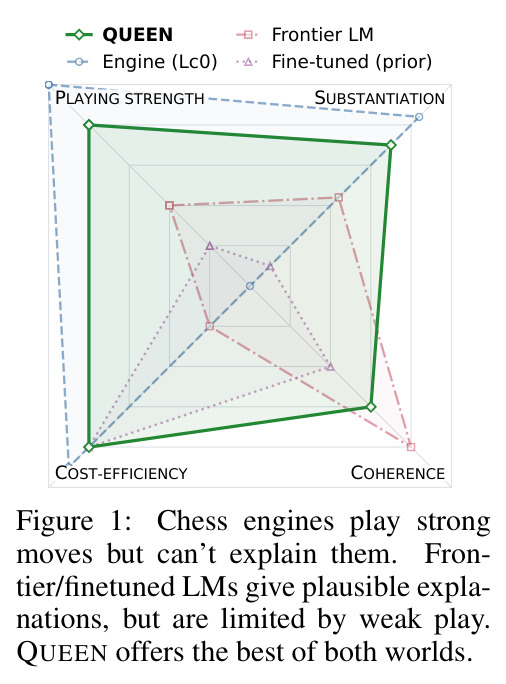
概览图:左侧是下棋能力——引擎(Lc0)棋力极强但不解释,QUEEN 兼具强棋力与解释能力;右侧是解释质量——前沿/微调 LM 能生成貌似合理的解释但受限于弱棋力,QUEEN 在论证性与成本效率/连贯性上兼得。
一张图讲清论文动机:现有两类方法各占一端,QUEEN 的定位是同时拿下'下得强'与'讲得清',是理解全文贡献地图的入口。
一个真实输出示例:QUEEN 面对一个尖锐不平衡的残局,先给出自然语言散文分析(黑方王翼已被削弱、d1Q+ 立即升变、白方吃后后黑方 Kxe3 吃车等),随后输出结构化字段 BEST_MOVE: d1Q+、PRINCIPAL_VARIATION、PROMISING_MOVES 和约 +5.22 兵的 EVALUATION。
直观展示论文任务的输出格式——散文 + 最佳走法 + 主变 + 候选 + 评估五要素,是理解评测指标(NMR/FNMR/连贯性)针对什么的样本。