大语言模型对序列结构的理解:推理与生成的受控研究 Do LLMs Understand Sequential Structure? A Controlled Study of Inference and Generation
受控实验揭示LLM难以恢复并执行高阶条件序列结构,表面分布匹配会掩盖错误的生成机制
前置知识
马尔可夫链与 n-gram 模型
马尔可夫模型假设下一状态只依赖最近的历史:一阶过程 $P(x_t \mid x_{t-1})$ 只看上一个符号,n-gram 过程则条件于前 $n$ 个符号 $P(x_t \mid x_{t-n:t-1})$。它显式地刻画了'未来依赖历史'的条件结构,是序列建模的经典基线。
本文把 LLM 是否真正'理解'序列结构,定义为能否从观测轨迹中恢复并持续执行这类条件转移规则,整个评测框架就是围绕马尔可夫阶数与联合状态条件化展开的。
边际分布匹配 vs 条件规则执行
边际分布匹配指生成动作的总体频率接近目标(如 R:P:S 各占 1/3);条件规则执行指在每个具体历史状态下都按正确转移规则行动。两条轨迹可以边际分布几乎相同(TV 距离极小),却由完全不同的潜在机制生成。
论文的核心论点是:行为相似不等于机制正确。本文全部实验设计就是为了把这两种能力拆开分别测量,避免 agent 评测中的表面保真假象。
教师强制(Teacher Forcing)
评测生成模型的一种诊断手段:每一步都把真实历史(ground-truth prefix)喂给模型,只让它预测下一个动作,从而避免自由生成时早期错误不断累积传播。自由生成与教师强制的性能差可以定位错误来源。
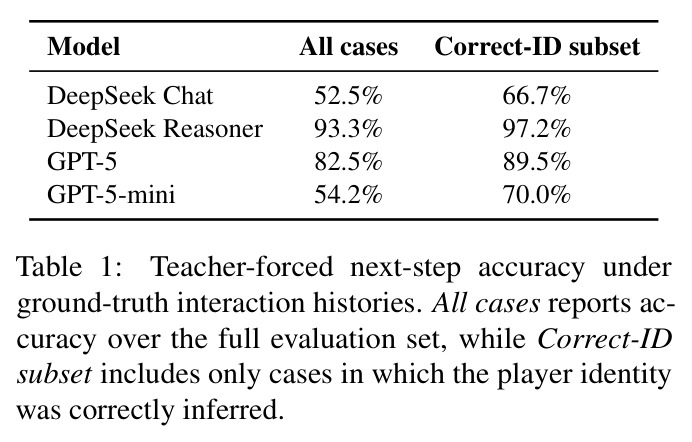
论文用教师强制把'局部规则应用失败'与'长程维持失败'解耦:DeepSeek Reasoner 教师强制达 93.3% 却在自由生成中退化,说明是长程维持问题;而 DeepSeek Chat 仅 52.5%,连局部执行都困难。
Jensen-Shannon 散度与加权版本 $W_{\mathrm{JS}}$
JS 散度衡量两个概率分布的相似度,是对称且总有界的。本文用状态频率加权的 JS 散度 $W_{\mathrm{JS}}=\sum_s w_s\,\mathrm{JS}(q(\cdot\mid s),\hat q(\cdot\mid s))$,按每个 n-gram 历史状态 $s$ 的出现频率 $w_s$ 平均模型恢复的转移分布与真实分布的差异。
n-gram 续写任务的目标过程是随机的,精确匹配不适用,必须用 CCLG 和 $W_{\mathrm{JS}}$ 这类分布级指标来度量模型对条件转移结构的恢复质量。
上下文条件似然增益(CCLG)
CCLG 衡量模型在给定历史状态条件下预测下一动作的对数似然,相对 unigram(无历史)基线的提升幅度。若 CCLG 为正,说明模型确实在利用上下文历史而非只匹配边际频率。
它是单人 n-gram 实验的核心指标之一:论文发现阶数 $n\le 4$ 时 CCLG 为正,$n=8$ 时骤降,直接证明高阶条件依赖是上下文利用的瓶颈。
研究动机
LLM 正被大规模用作交互智能体与人类行为模拟器,这要求模型不仅能产生'看起来像'的动作,还要能推断历史中的潜在策略并在后续轮次中一致行动。但观测行为并不能唯一确定其生成过程:论文图 1 展示了两条动作比例同为 R:P:S = 1:1:1 的轨迹,一条来自独立采样的统计型玩家,另一条却依赖历史的马尔可夫型玩家——表面统计完全相同,机制截然不同。已有的游戏化评测(GameBench、重复博弈、对手建模)主要把胜率或'能否识别对手'当作终点,把边际分布匹配、策略识别和条件规则执行三种能力混为一谈,因此即使 LLM 在这些评测中表现良好,也无法回答一个根本问题:它究竟恢复了产生轨迹的序列机制,还是只复刻了频率?
本文的目标是本文要构建一个潜在生成过程完全已知、可逐能力归因的受控评测框架,把'行为保真'分解为三个可分别度量的层次:(1) 潜在策略识别——给定轨迹 $\tau_{1:T}$ 能否说出两个玩家各自的策略;(2) 分布保真——生成的动作边际分布是否接近目标;(3) 条件规则执行——自由生成时能否在每个历史状态下都执行正确的转移规则。实验载体包括双人石头剪刀布(RPS)下的三个递进实验(纯识别、一阶马尔可夫推理-模拟、联合状态/二阶复杂规则),以及剥离玩家归属和 RPS 语义的单人随机 n-gram 续写任务(阶数从 1 到 8),最终定位 LLM 序列生成能力的关键瓶颈。
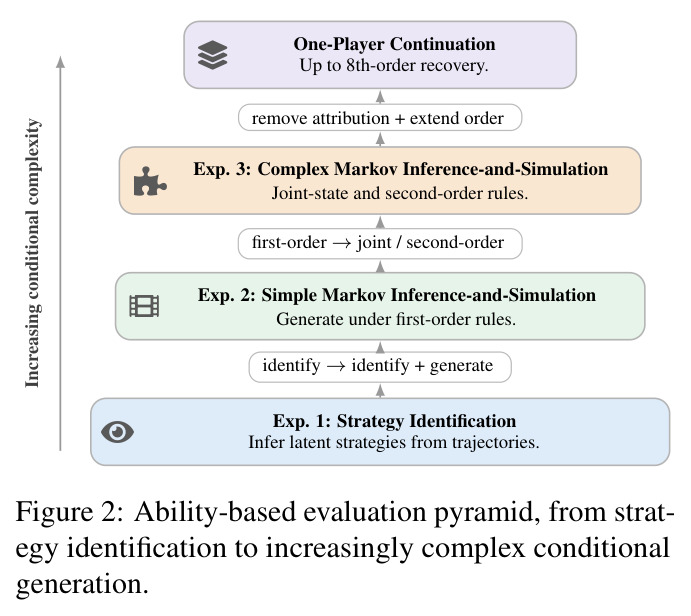
与已有工作不同的是,本文的独特切入有三点。其一,评测对象是'能力'而非'表现':不同于把游戏胜负当指标的工作,它把识别与生成、边际与条件彻底拆开打分,构成图 2 所示的能力金字塔。其二,设置了非 LLM 的最大似然(MLE)识别基线:在同样的封闭候选池下,MLE 在所有上下文长度(100 到 1000 轮)都达到 100% 识别准确率,从而把 LLM 的失败明确归因于模型自身提取结构的能力缺陷,而非轨迹信息不足。其三,用教师强制、正确/错误身份条件分组、rule-given 提示消融等层层诊断手段,把'识别了但不会执行''生成了也不影响识别''联合状态不是瓶颈、高阶依赖才是'这些结论一一钉死,而不是停留在整体准确率的粗粒度比较。
核心方法
直觉:与其问 LLM '会不会玩游戏',不如在生成过程完全已知的极简环境里逐层测量能力。技术路线:双人 RPS 中每个玩家由未观测策略 $\pi_i$ 驱动,轨迹为 $\tau_{1:T}=\{(a_t^1,a_t^2)\}_{t=1}^T$,动作空间 $A=\{R,P,S\}$。玩家分两类——统计型(固定动作,或从 16 个类别分布 $p\in\Delta(A)$ 独立采样)测边际统计恢复;马尔可夫型(按确定性规则 $a_t^i=f_i(h_t)$ 行动,$h_t$ 可含对手上一动作、联合状态或二阶历史)测历史条件策略恢复。三个实验递进:Exp1 纯识别($T\in\{100,200,500,1000\}$,每长度 150 对);Exp2 识别+无身份生成(每对类型 60 样本,生成 1000 轮);Exp3 联合状态与二阶规则。最后用单人随机 n-gram 续写(词表 {A,B,C},$n\in\{1,2,4,8\}$,前缀 256–2048)剥离归属与语义。模型覆盖 DeepSeek-V4-Flash(chat/reasoner)、GPT-5、GPT-5-mini、GPT-4.1、Gemini 3 Flash、Qwen3-8B 共 7 种配置。
核心创新是把'行为保真'分解为可分别测量的能力金字塔(图 2):策略识别 → 一阶生成 → 联合/二阶生成,每层配独立指标。识别层用精确匹配准确率,Markov 与 Non-Markov 分组报告,差值即检验历史依赖策略是否更难识别;生成层对马尔可夫玩家用规则重叠率 $\mathrm{Overlap}_{i,k}=\frac{1}{|E_{i,k}|}\sum_t \mathbb{I}[\hat a_t^i=f_i(\hat h_t)]$、严格规则匹配(窗口内全部可评估动作均正确)和累计严格匹配,且规则在模型自己生成的历史 $\hat h_t$ 上在线求值;统计型用分布 MSE 与相对差距 $\Delta_{\mathrm{MSE}}$;随机 n-gram 过程用上下文条件似然增益 CCLG 和状态频率加权散度 $W_{\mathrm{JS}}=\sum_s w_s\,\mathrm{JS}(q(\cdot\mid s),\hat q(\cdot\mid s))$。这与只看游戏胜负或单一准确率的已有评测有本质区别:任何一层能力都可以独立失败且被单独检测。
方法步骤详情
流程分六步。(1) 数据生成:按已知策略采样双人轨迹,Exp1 每个长度 $T\in\{100,200,500,1000\}$ 各 150 对,Exp2/Exp3 每种规则对 60 个样本。(2) 提示模型:给定 $\tau_{1:T}$,识别任务输出预测策略对 $(\hat\pi_1,\hat\pi_2)$ 及分布 $\hat p_i$;生成任务再续写 $\hat\tau_{T+1:T+M}$($M=1000$ 轮),不告知玩家身份。(3) 评分:识别用精确匹配;生成按窗口计算规则重叠率与严格规则匹配,规则 $f_i(\hat h_t)$ 在模型自生成历史上求值,早期错误会传导。(4) 统计型比较分布 MSE 与 $\Delta_{\mathrm{MSE}}$。(5) 教师强制诊断:每步给真实历史、只预测下一动作,分离局部规则应用与长程维持(表 1)。(6) 单人 n-gram:从转移表 $P(x_t\mid x_{t-n:t-1})$ 生成前缀,设 prefix-only(自行推断规则)与 rule-given(直接给转移规则)两种提示,用 CCLG 与 $W_{\mathrm{JS}}$ 评测,并以仅用前缀的 MLE 估计作为可恢复性下界。
技术新颖性
本文没有提出新模型,其新颖性在于评测结构的'因果式'设计。第一,封闭候选策略池 + MLE 基线的组合极具说服力:既然最大似然估计能在所有长度下 100% 识别,LLM 的失败就只能归因于'提取与维持决策规则'的能力缺陷,这比单纯报告低准确率强得多。第二,Markov/Non-Markov 分组与显著性检验使'历史依赖策略更难识别'成为可证伪命题,结果是 6/7 模型在 $p<.001$ 水平显著。第三,诊断链条环环相扣:正确/错误身份条件分组揭示'错误身份不是随机错误';教师强制分离两类失败模式;rule-given 消融证明'即使给出转移规则,高阶执行仍失败';单人 n-gram 剥离玩家归属后退化依旧,把瓶颈干净地定位到高阶条件结构的维持本身。第四,CCLG/$W_{\mathrm{JS}}$ 这类分布级指标让随机过程的评测摆脱精确匹配的局限,可推广到其他 agent 评测。
实验结果
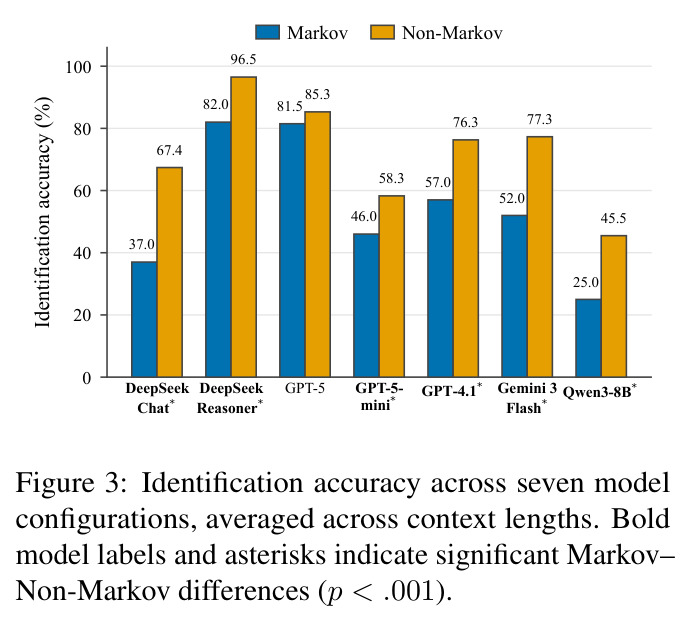
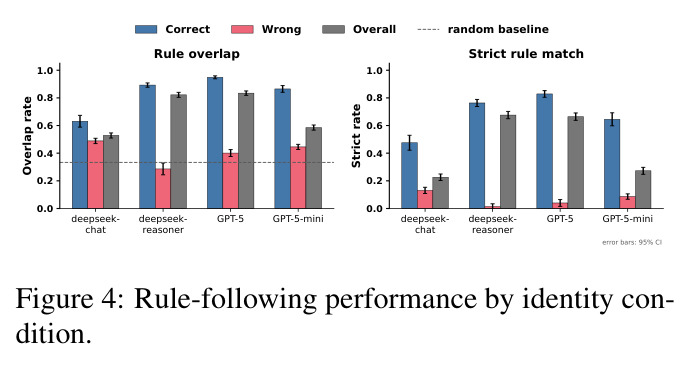
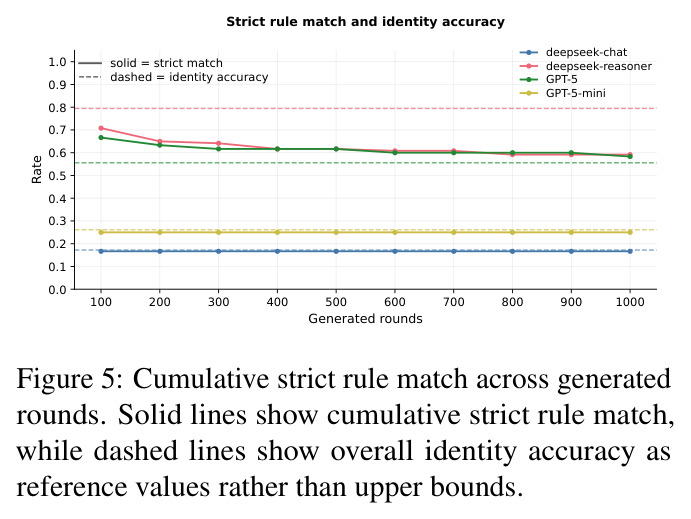
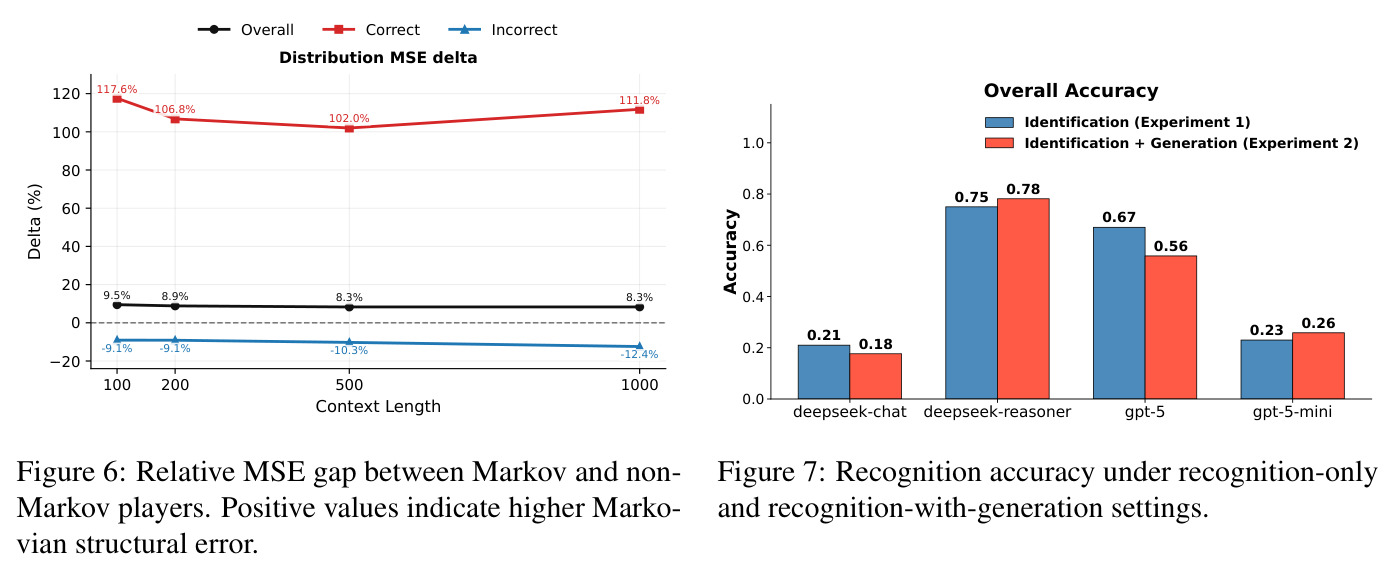
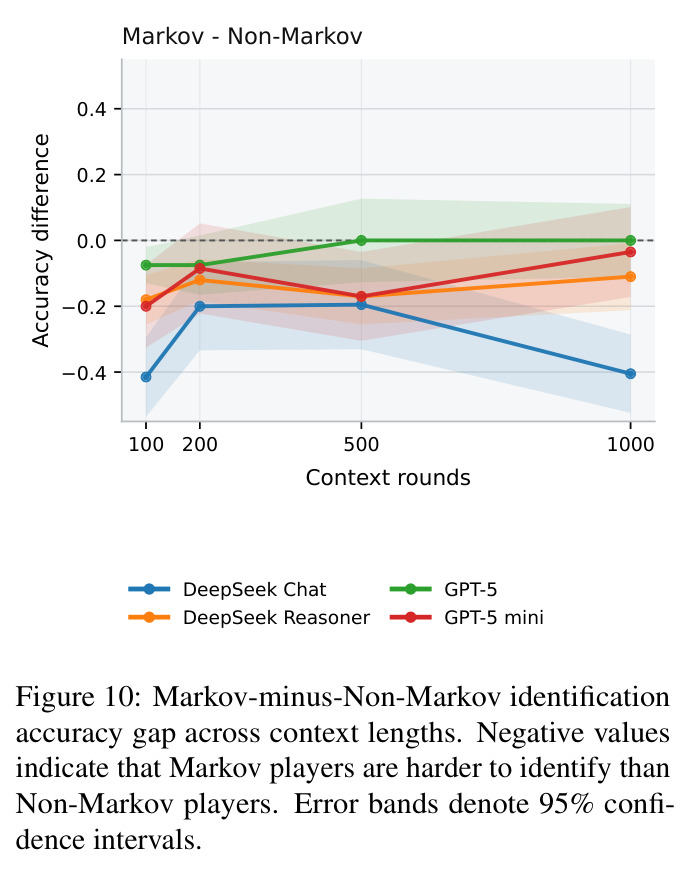
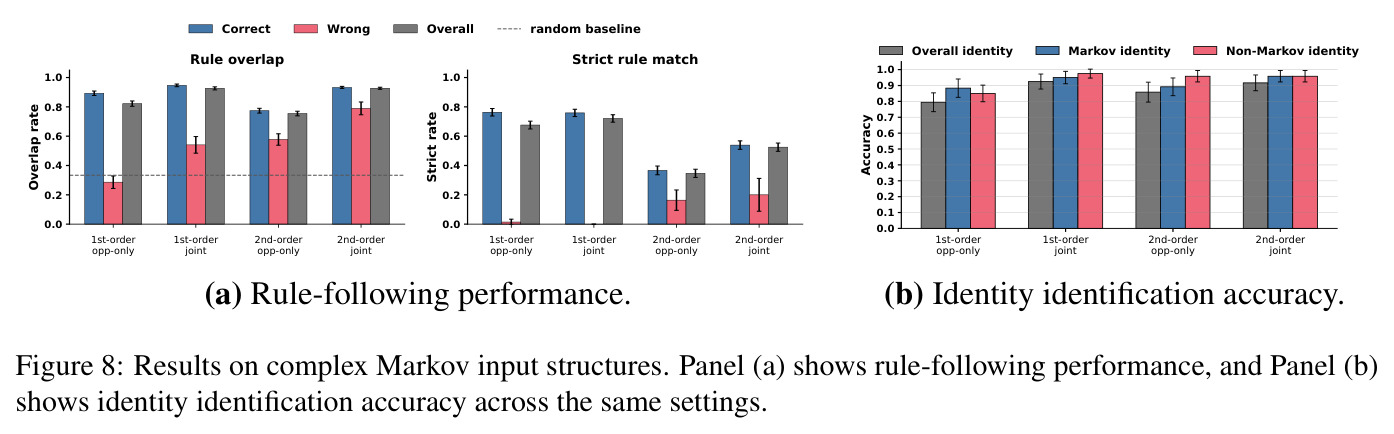
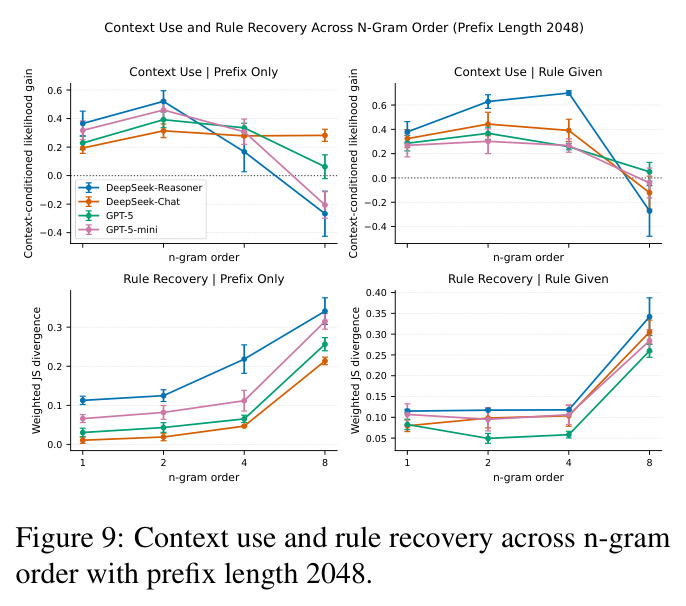
识别(Exp1,图 3):七种配置的 Markov 识别准确率全面低于 Non-Markov——DeepSeek-Chat 37.0% vs 67.4%,DeepSeek-Reasoner 58.3% vs 85.3%,GPT-5 46.0% vs 76.3%,GPT-5-mini 45.5% vs 77.3%,GPT-4.1 52.0% vs 82.0%,Gemini 3 Flash 57.0% vs 96.5%,Qwen3-8B 25.0% vs 81.5%;6/7 差异显著($p<.001$),GPT-5 例外($p=.095$)。上下文从 100 增至 1000 轮不但无益反而常有害,而 MLE 基线在封闭候选池下达 100%,证明问题在模型而非信息。模拟(图 4-6):正确身份下规则遵循显著更好,但错误身份行为非随机,overlap 仍高于随机基线;Markov 的 MSE 整体高 8.3–9.5%,正确身份子集高出 102.0–117.6%,错误身份子集反而为 −9.1% 至 −12.4%;282 个错误恢复的策略中 41.8% 满足 $\mathrm{TV}\le 0.02$、62.1% 满足 $\mathrm{TV}\le 0.10$——表面分布保真普遍掩盖机制错误。身份准确率并非严格规则匹配的上界(图 5),且规则遵循质量在生成早期即定型。教师强制(表 1):DeepSeek-Reasoner 93.3%(正确身份 97.2%)、GPT-5 82.5%(89.5%)表现强,失败源于长程维持;DeepSeek-Chat 52.5%(66.7%)、GPT-5-mini 54.2%(70.0%)在真实历史上仍挣扎,局部规则应用即瓶颈。生成不改变识别(图 7,差异均不显著)。复杂结构(图 8):联合状态几乎不伤性能,二阶规则使严格规则匹配大降而身份识别仍高。单人 n-gram(图 9):$n\le 4$ 时 CCLG 为正,$n=8$ 骤降且 $W_{\mathrm{JS}}$ 上升;前缀 256→2048 或直接给出转移规则均无法消除高阶退化,而前缀 MLE 基线在高阶仍稳定。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 潜在策略识别(Exp1,双人 RPS) | 精确匹配准确率(Markov 玩家组,跨上下文长度平均) | LLM 七种配置为 25.0%(Qwen3-8B)至 58.3%(DeepSeek-Reasoner),Non-Markov 组为 67.4%–96.5%,6/7 差异 $p<.001$ | 最大似然(MLE)非 LLM 基线在相同封闭候选池下 100% 准确 | MLE 基线全面碾压所有 LLM,证明失败源于结构提取能力而非轨迹信息不足 |
| 规则遵循生成(Exp2,一阶马尔可夫) | 严格规则匹配 / 规则重叠率(按身份正确性分组) | 正确身份条件下各模型 overlap 与 strict match 显著最高;错误身份下 overlap 仍高于随机基线 | 随机基线(random baseline) | 错误身份行为具有结构性而非随机性,模型会选中规则相似的'错误'玩家 |
| 分布模拟(统计型玩家) | 相对 MSE 差距 $\Delta_{\mathrm{MSE}}$(Markov 相对 Non-Markov) | 整体 8.3%–9.5%(各上下文长度);正确身份子集 102.0%–117.6%;错误身份子集 −9.1% 至 −12.4% | Non-Markov 玩家模拟误差 | 正确识别时马尔可夫结构误差翻倍以上;分布相似度不能作为规则执行的代理指标 |
| 教师强制下一步预测 | 下一动作预测准确率(全部样本 / 正确身份子集) | DeepSeek-Reasoner 93.3%/97.2%,GPT-5 82.5%/89.5%,GPT-5-mini 54.2%/70.0%,DeepSeek-Chat 52.5%/66.7% | 各模型自身自由生成时的严格规则匹配 | 区分两类失败:强模型败于长程维持,弱模型败于局部规则应用 |
| 单人随机 n-gram 续写($n\in\{1,2,4,8\}$,前缀 256–2048) | CCLG(上下文条件似然增益)与 $W_{\mathrm{JS}}$(加权 JS 散度) | $n\le 4$ 时 CCLG 多为正,$n=8$ 骤降、$W_{\mathrm{JS}}$ 上升;rule-given 与更长前缀均无法挽回 | 仅用前缀的 n-gram MLE 估计器,高阶下保持稳定 | MLE 稳定而 LLM 崩溃,锁定高阶条件结构维持为核心瓶颈 |
局限与改进
作者承认的局限:(1) 玩家来自预定义候选策略集 $\Pi$,适合受控诊断但无法覆盖开放式策略发现,模型面对无封闭候选池的行为结构时表现未知;(2) 轨迹采用符号化表示、输出经约束格式与解析规则评测,虽保证了规则级评测的可靠性,但无法保证所选提示、表示、输出 schema 与解码设置是最优的(附录 H 做了原始轨迹 vs 行式表格的消融)。我自己的观察:(3) Exp3 与 n-gram 实验只用了 deepseek-reasoner 一个模型,'二阶依赖是瓶颈''高阶退化无法靠规则直给挽救'这两个关键结论能否推广到 GPT-5 或 Gemini 尚不清楚;(4) 双人 RPS 中的马尔可夫规则均为确定性规则(n-gram 部分除外),而真实人类行为更接近随机转移,确定性查表式执行与随机策略模拟难度不同;(5) 论文停留在诊断层面,没有尝试任何干预手段(微调、思维链、外部状态追踪)来缓解高阶退化;(6) 闭源模型占比高,结果会随 API 版本漂移,长期可复现性受限。
独立分析的弱点
(1) 封闭候选池使识别退化为'选择题':模型只需在已知集合里对号入座,与真实 agent 面对未知对手的开放式逆推差距很大——改进方向是引入参数化或学习型策略空间,用分布距离而非精确匹配评分。(2) 结构分析单薄:Exp3 和 n-gram 只在 deepseek-reasoner 上做,而它恰好是识别准确率最高的模型,弱模型上二阶规则的行为可能更糟——应在至少三个不同家族的强模型上重复。(3) 缺乏机制层解释:论文观察到高阶失败但未回答'为什么',可结合 induction heads 等机制可解释性工具,分析注意力头如何在上下文中聚合 $n$ 阶历史状态。(4) 评测依赖输出解析,格式失败与能力失败未分开报告,部分低分可能源于格式不合规——应报告解析失败率并做格式无关评测。(5) 生成评测固定 1000 轮、窗口粒度较粗,早期错误传播的动力学刻画不足——可按轮记录首个错误发生时间与错误类型分布。(6) 未测试任何缓解手段,诊断结论无法直接转化为改进方案。
未来方向
作者提出的方向:把框架扩展到更大或学习型策略空间,让模型在没有封闭候选池的情况下发现行为结构。基于本文成果可延伸:(1) 训练干预——利用这套可控环境构造课程化数据做微调或强化学习,直接检验'高阶条件结构维持'是否可训练提升,并观察是否会迁移到真实 agent 任务;(2) 混合架构——把转移结构外置给符号状态追踪器或检索模块,LLM 负责语义层,验证外置记忆能否消除 $n=8$ 处的崩溃;(3) 把 CCLG 与 $W_{\mathrm{JS}}$ 推广为通用 agent 评测的'行为保真'诊断指标,与现有胜率类指标并行报告;(4) 机制可解释性——研究高阶 n-gram 状态在 Transformer 中的表示与衰减方式,定位失败电路;(5) 研究生成过程中的自校正:既然规则遵循质量早期定型,能否在生成早期插入校验点检测规则漂移。
复现评估
可复现性中等偏上。任务与数据全部程序化生成:统计玩家的 16 个类别分布在附录 A.1,马尔可夫规则集在附录 M,完整提示在附录 A,模型与 API 信息在附录 B,样本量与生成设置在附录 C——规则与流程描述相当完整。算力方面无需训练,成本为 API 调用:Exp1 为 7 配置 × 4 长度 × 150 对,Exp2/3 为数千次含 1000 轮续写的生成,加上 n-gram 实验多前缀长度 × 双提示设置,估计在数千美元量级。风险点:论文未明确声明开源代码,轨迹生成器、解析器与指标计算需自行实现;主力结论依赖 GPT-5、Gemini 3、DeepSeek 等闭源 API,存在版本漂移风险(若干模型带 * 号即为特定快照版本);教师强制与 n-gram 指标实现细节需要按公式(2)–(4)自行对齐。总体而言,一名工程师按附录可在几天内复现核心管线,但精确对齐数值结果有一定难度。
论文图表
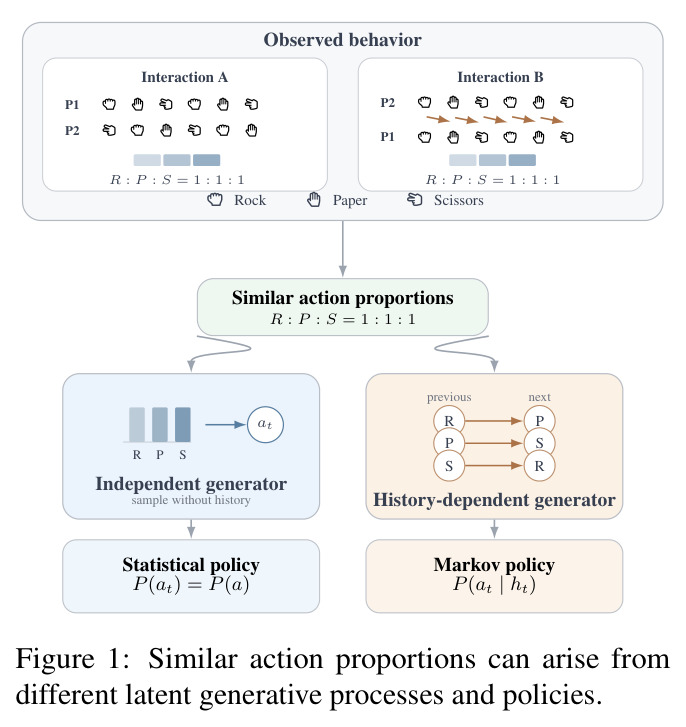
对比两条动作比例同为 R:P:S = 1:1:1 的轨迹:一条来自独立采样(历史无关的统计型策略),另一条来自依赖历史的马尔可夫型策略(上一动作决定下一步),并标注 $P(a_t)$ 与 $P(a_t\mid h_t)$ 两种生成机制。表面统计相似但潜在机制不同。
这是全文的问题陈述图:它直观展示了'边际分布匹配不能证明结构理解'这一核心动机,所有后续实验设计都是为了区分这两种机制。