语言与非语言智能体的协作:潜状态内化范式与LLAMIA模型 Exploring Collaboration between a language and a non-language agent
把棋类引擎的内部表示直接投影成LLM可读的连续token,首次量化并消除语言化瓶颈。
前置知识
子智能体编排与工具调用
LLM作为编排器,通过系统提示中声明的函数接口(如Hermes格式)调用外部工具或专用子智能体,接收文本结果后继续推理。典型接口包括读取环境状态、执行动作、查询专家评估等。Claude Code subagents、Codex subagents、AutoGen都是这一范式。
本文的全部实验都建立在LLM通过get_policy等工具接口与棋类引擎协作的设置之上,只有理解工具调用机制,才能理解『语言化工具』与『潜token内化』两种接口的本质差异。
语言化瓶颈(Verbalization Bottleneck)
把连续的内部表示(策略分布、价值估计、隐层特征)序列化成稀疏文本摘要再喂给LLM。典型输出只有top-k着法加先验概率和评估值,丢掉了完整合法着法分布、候选续着的价值地形、以及可解释性研究在引擎隐层发现的子力协同、王安全、前瞻结构等语义特征。
本文的中心命题Verbalization Debt(语言化债)就是对这一瓶颈代价的首次受控量化,论文的全部对比实验(LLAMIA vs LLAMIA-Verb)都在回答『语言化到底损失多少』。
棋类神经引擎的潜表示
Lc0/AlphaZero类引擎是策略+价值网络:单次前向输出每个合法着法的先验概率π(s)和价值估计V(s)。其倒数第二层激活(Lc0-BT4为1024维)被可解释性研究证明编码了局面特征、子力价值几何和前瞻到动作的结构,是比最终输出头更丰富的信息源。
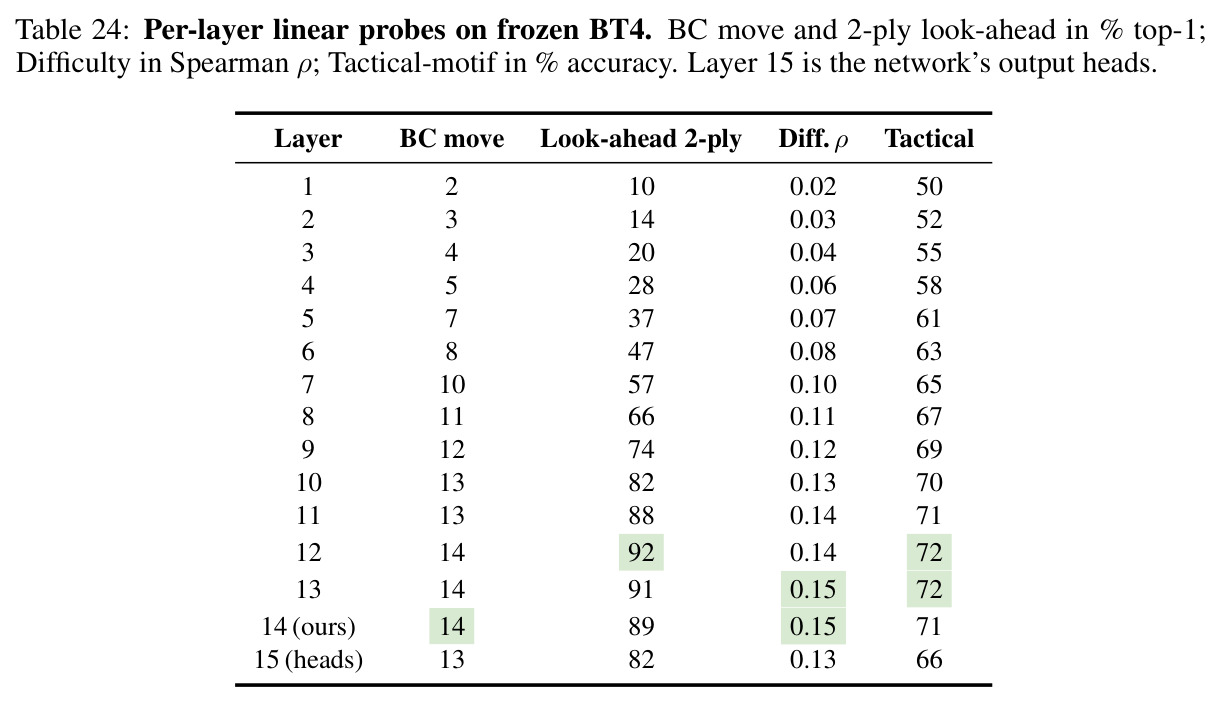
LatentBridge投影的正是这些倒数第二层激活(第14/15层),层的选择依据和激活中包含的内容直接决定了内化的上限,论文用逐层线性探针(Table 24)验证了这一选择。
跨模态投影器与软token注入
LLaVA、PaLM-E式的做法:用小型MLP把另一种模态或另一个模型的表示映射到LLM的词嵌入空间,作为连续软token插入输入序列。LLM的注意力像处理普通token一样处理它们,但它们携带的是连续向量而非离散词表中的词。
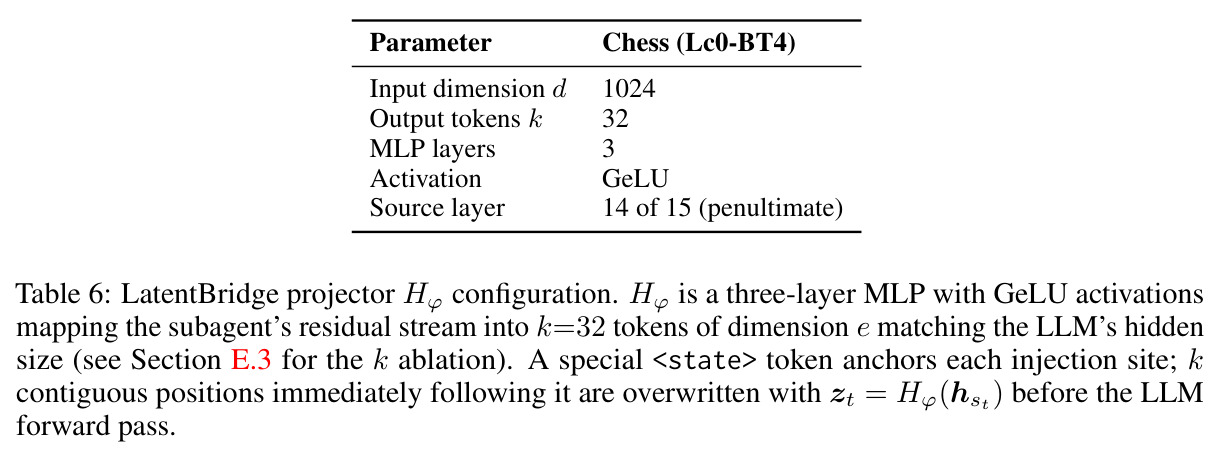
LatentBridge就是一个3层GeLU MLP投影器,把引擎1024维状态变成k=32个与LLM隐藏层同维的连续token,理解这一机制是读懂方法部分的前提。
DAPO(组相对策略优化的RL算法)
GRPO的变体:对同一提示采样G条完整轨迹,用组内归一化优势$\hat{A}_t=(R(\tau)-\mu_G)/\sigma_G$代替价值网络,并使用非对称裁剪边界$\varepsilon_l \le \varepsilon_h$(本文取0.2/0.28)在稳定更新的同时鼓励探索。
LLAMIA第二阶段用DAPO联合微调LLM与投影器,是RL收益(尤其在多步任务上)的来源;理解它才能看懂训练公式(Eq. 6)和梯度掩码等实现细节。
行为克隆与Maia
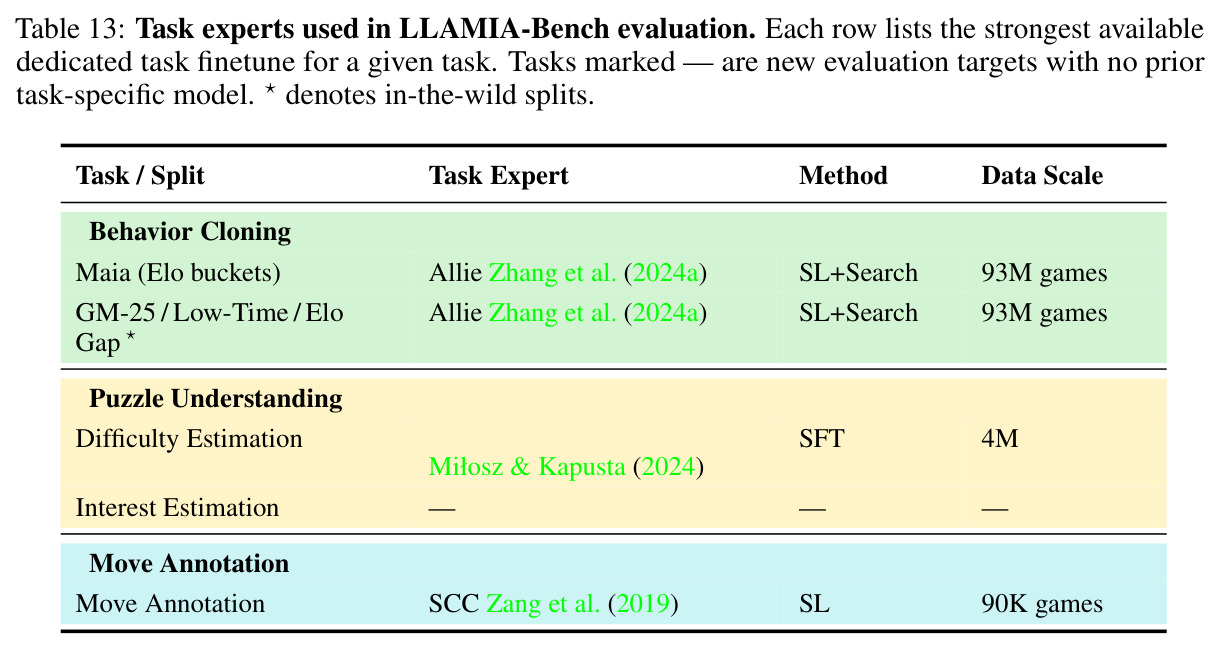
行为克隆指模仿指定水平人类棋手真实走法的任务(而非下出最强着法),评价指标是top-1着法匹配率。Maia是在数千万局Lichess对局上按Elo桶(1100-1900)分别训练的人类模仿CNN,是该任务的专用专家代表。
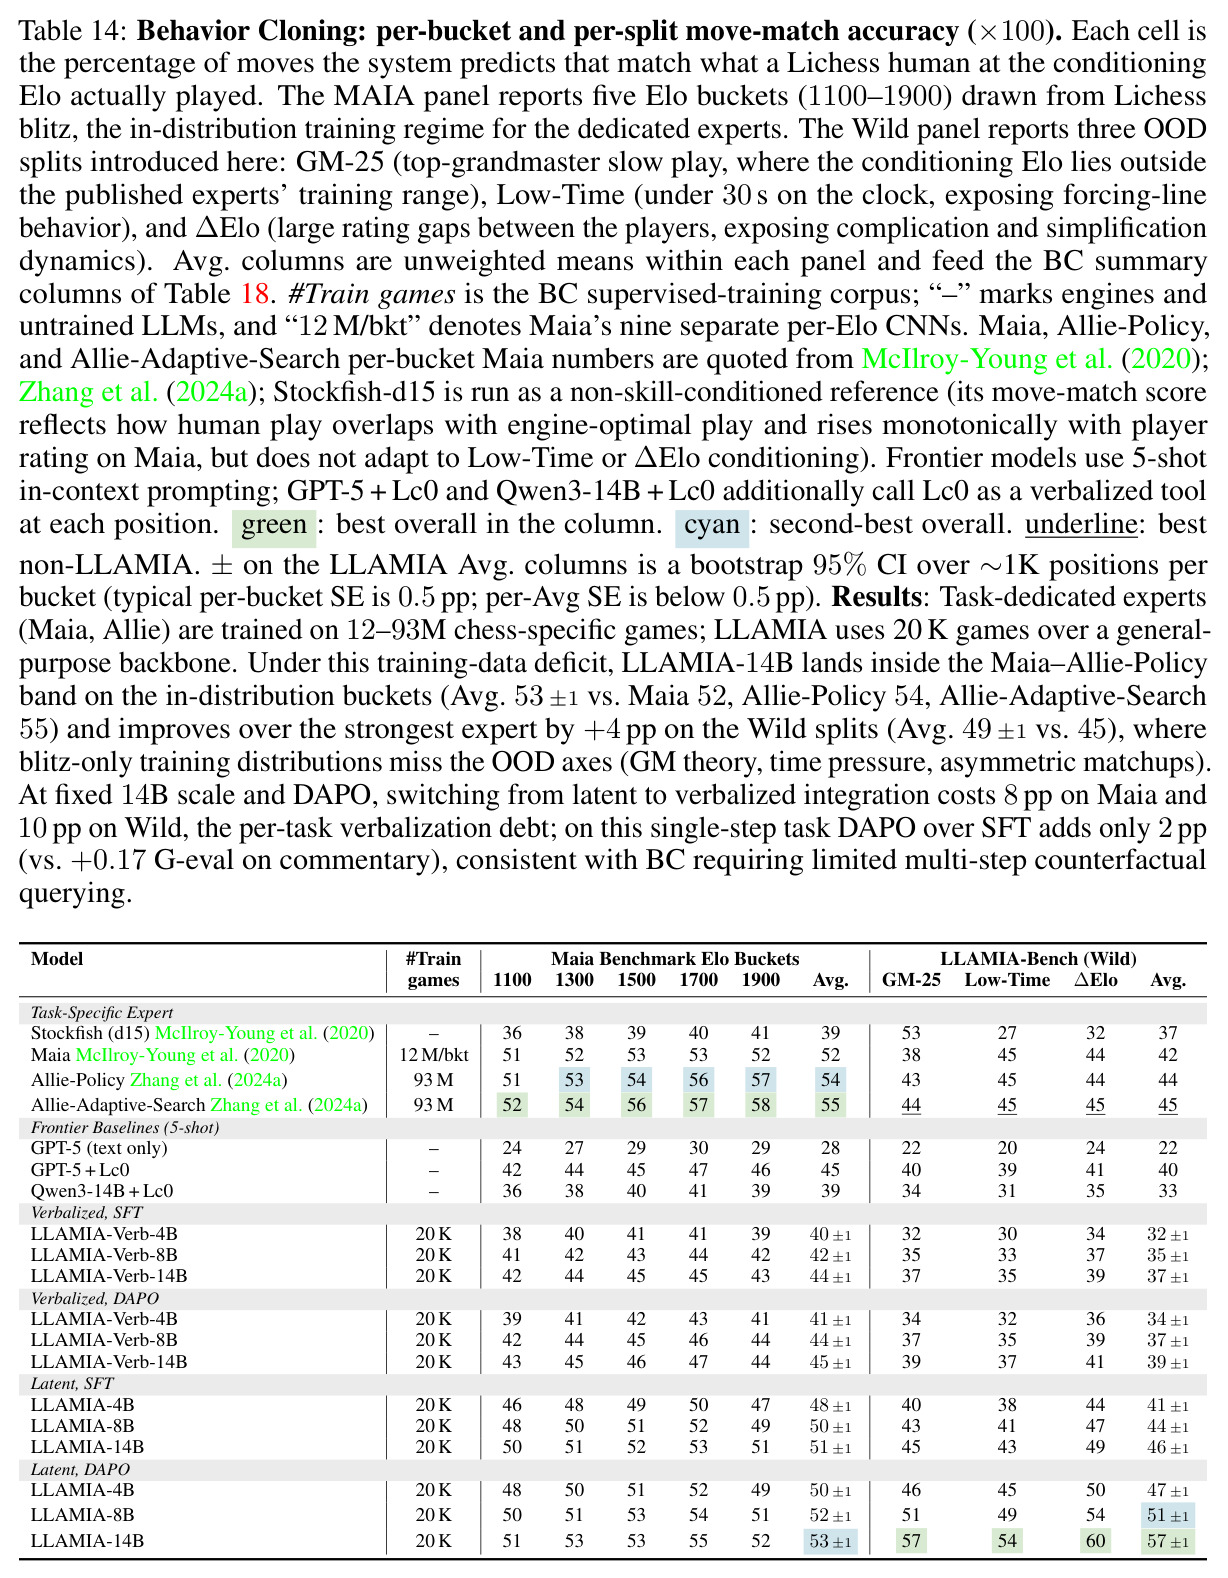
LLAMIA-BENCH六大任务中行为克隆是核心之一,LLAMIA仅用20K局就在分布外Wild切分上超过用12-93M局训练的Maia/Allie专家,是论文最有说服力的结果之一。
研究动机
LLM正被大规模部署为编排器,通过自然语言协调专用子智能体完成复杂任务(Claude Code subagents、Codex subagents、AutoGen、HuggingGPT等)。这一协作范式默认双方都是语言模型——子智能体能用文字报告自己的状态。但在游戏、机器人、自动驾驶等重要领域,最强的可用智能体并不是语言模型:AlphaZero、Lc0、RT-1的专长编码在连续潜状态(策略分布、价值估计、学到的特征表示)中,与LLM的输入空间存在根本错配。现行桥接方式是『语言化』:每次交互把引擎输出压缩成稀疏文本摘要(如『Nc2: P=0.34, +0.12』)。这带来两个具体问题。其一,语言化是有损瓶颈:完整合法着法分布、候选续着的价值地形、可解释性研究(Jenner et al. 2024)在引擎隐层定位到的前瞻结构都无法忠实转成文字。其二,误差在多步交互中复合:每轮交换都剥离细节,推理步数越长损失越大。以国际象棋为具体场景:LLM读过的棋类文献比任何人类专家一生读的都多,棋力却远逊于现代引擎和专家;而引擎早在Deep Blue时代(2002)就超越人类特级大师,却无法解释着法背后的道理、无法按人类意图制定策略。游戏解说、针对性备赛、趣味谜题设计等应用需要引擎的局势理解与LLM的人类意图推理结合,但语言化接口让协作收益大打折扣。
本文的目标是本文要回答一个基础问题:LLM如何与非语言子智能体有效协作、联合推理?目标分三层。第一层是科学问题:语言化是否构成瓶颈?作者提出Verbalization Debt(语言化债)概念——在同一LLM骨干、同一子智能体、同一训练配方下,潜通道集成与文本通道集成之间的性能差距——并在受控的异构LLM-智能体协作中首次给出实证测量,证明该差距随训练扩大到2-3倍、随模型从4B扩展到14B依然存在。第二层是方法贡献:提出潜状态内化(latent state internalization)范式,让LLM在一条由语言token(思维链)、动作token(推进环境的着法)和潜状态token(子智能体倒数第二层激活的投影)交织的单条推理链上工作,随环境状态演化动态重编码,并用两阶段训练(投影器对齐+DAPO强化学习)得到单一模型LLAMIA。第三层是应用目标:LLAMIA-14B在六项协作任务上匹配或超越任务专用微调模型和GPT-5.1等带工具访问的前沿模型,且能作为桥接器让闭源模型间接获得对非语言智能体的忠实访问,使真实应用(有依据的游戏解说、针对特定对手的备赛)无需重训闭源模型即可部署。
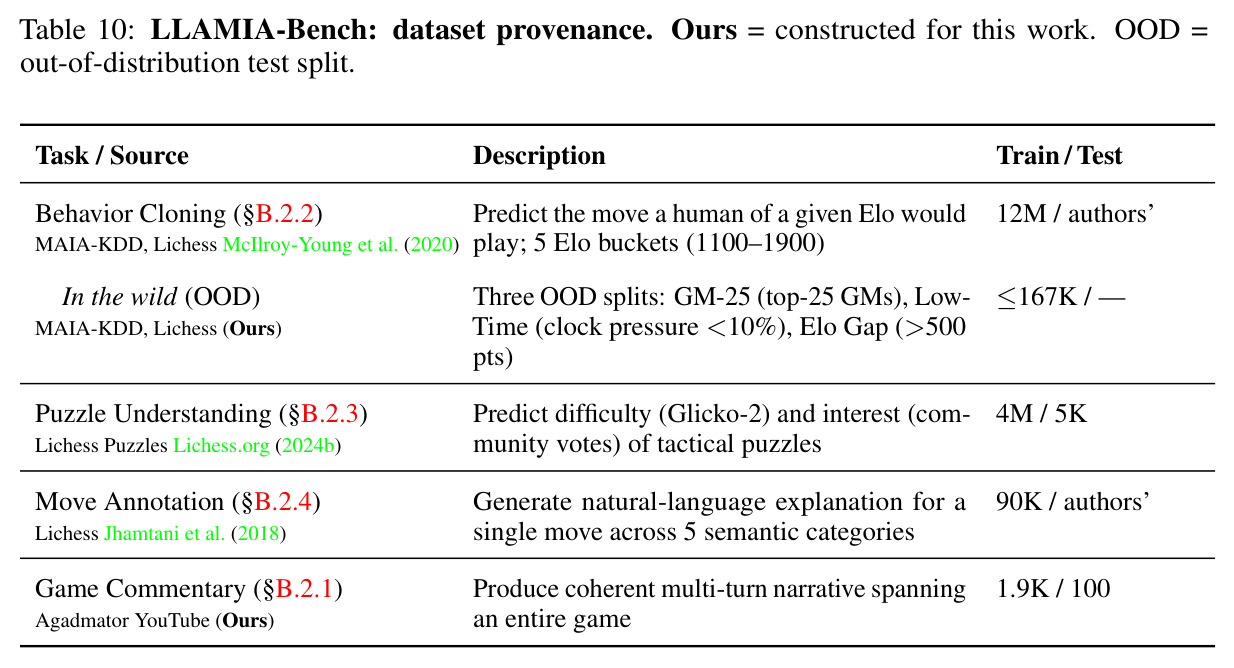
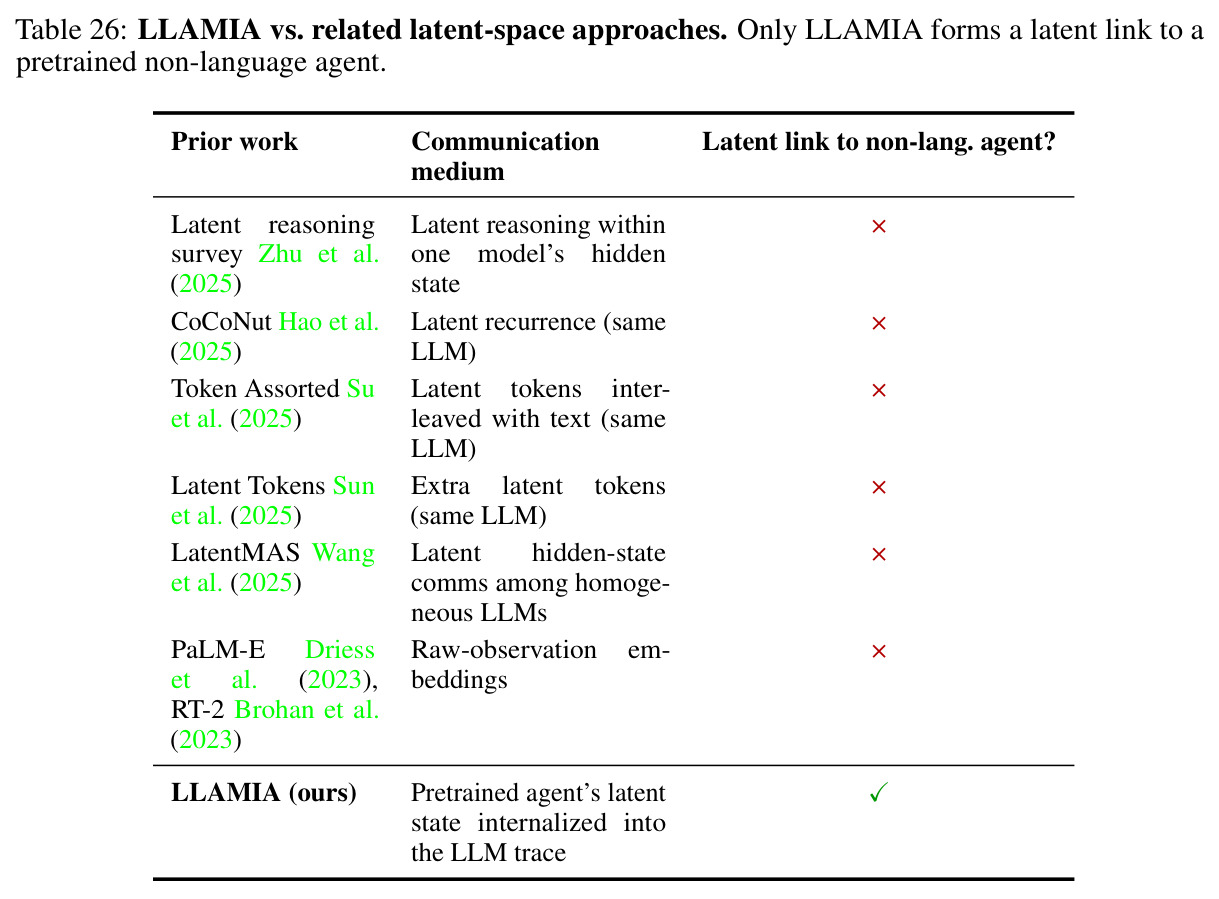
与已有工作不同的是,现有LLM-子智能体协作全部经过符号/文本中转,可分为三支且各有盲区。第一支是文本桥接:早期工作在着法和价值估计的文本描述上微调语言模型(Zang 2019的SCC、Lee 2022),近期依赖in-context工具调用(Toolformer、ReAct、AutoGen)——它们共享一个从未被检验的假设:子智能体的专长可以被忠实语言化。第二支是单模型潜推理:CoCoNut、Token Assorted、latent tokens等在模型自身的隐状态中穿插潜token增加计算深度,但操作对象是同一个模型,不涉及异构专家。第三支是潜空间多智能体:LatentMAS研究同质LLM间的纯潜协作,多智能体RL(Sukhbaatar 2016、TarMAC)假设联合训练的同质群体;PaLM-E/RT-2虽做跨模态注入但注入的是原始感知观测,而非预训练专家已加工的策略/价值表示。没有任何工作把冻结的异构非语言专家的内部状态直接内化进冻结LLM的推理轨迹(Table 26系统对比了这一点)。本文的独特切入:选国际象棋作试验台(有可解释性研究背书、开源最强引擎Lc0-BT4、Lichess大规模公开数据、成熟的专用专家基线),引入LLAMIA-BENCH六任务基准,并用LLAMIA-Verb对照把『积分接口』设为唯一变量,首次受控量化语言化债。
核心方法
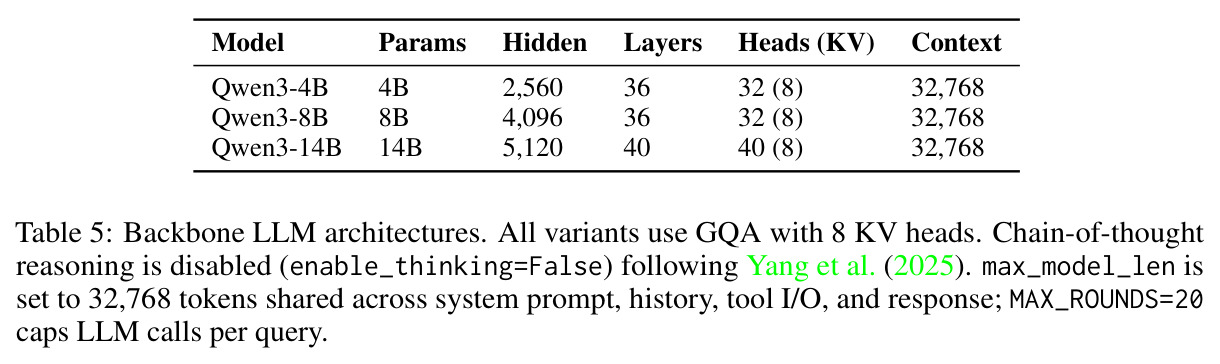
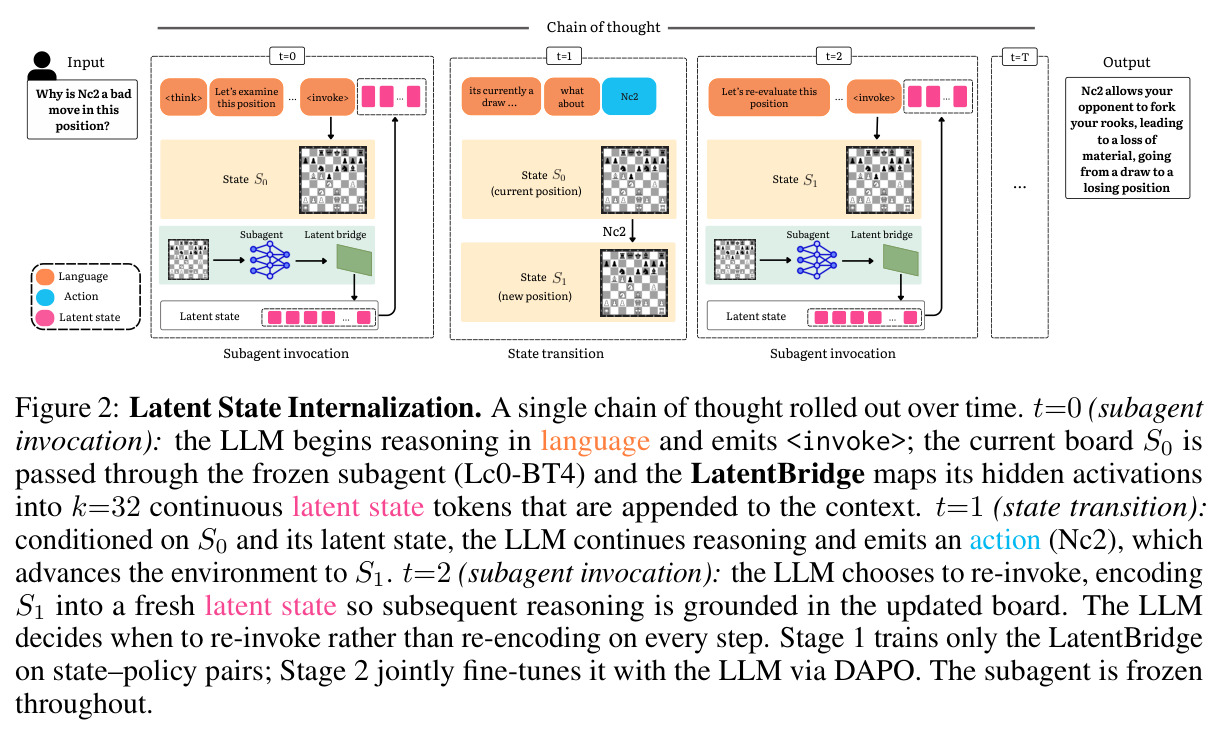
直觉上,本文把非语言引擎从『问答机』升格为LLM的『感知器官』:不是让引擎用文字汇报结论,而是把它的内部状态变成LLM能直接『看见』的连续输入。技术路线是一条由三类token交织的推理链:语言token(LLM的思维链)、动作token(推进环境状态的着法,包括思维链中的反事实着法)和潜状态token(引擎编码器输出的投影)。形式化地,预训练子智能体编码器$G_\psi: S \to \mathbb{R}^d$把状态映射为$h_s$,学习到的投影器$H_\phi: \mathbb{R}^d \to \mathbb{R}^{k \times e}$输出$z_t = H_\phi(G_\psi(s_t))$,与文本一起构成轨迹$\tau = (z_{1:k_0}, w_{1:j_1}, a_1, z_{1:k_1}, \ldots, w_{final})$。LLM通过get_policy工具自主决定何时查询——查询对象可以是当前局面$s_t$,也可以是某候选着法到达的反事实局面。每次调用时引擎对(新)局面编码,激活被投影成k=32个连续token追加到推理轨迹。训练分两阶段:Stage 1冻结LLM只训练投影器做自监督对齐;Stage 2用DAPO强化学习联合微调LLM与投影器,子智能体全程冻结。最终模型LLAMIA(Large Language and Action Models with Internal Agents,Qwen3骨干4B/8B/14B)在六项任务上全部第一。
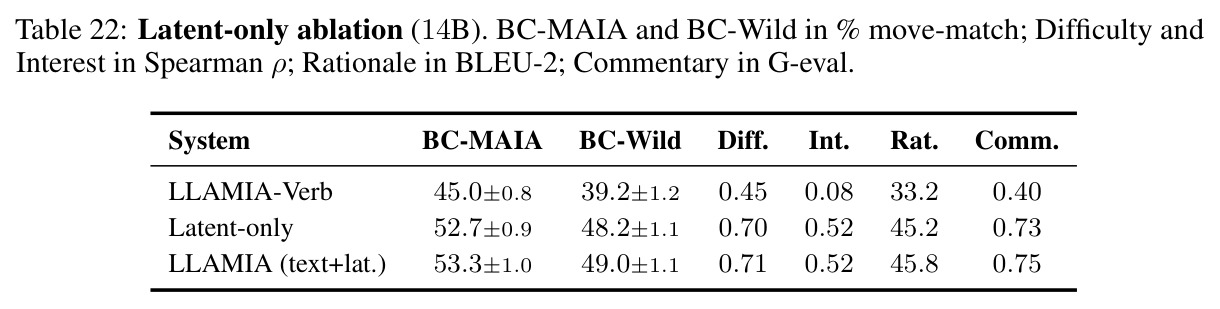
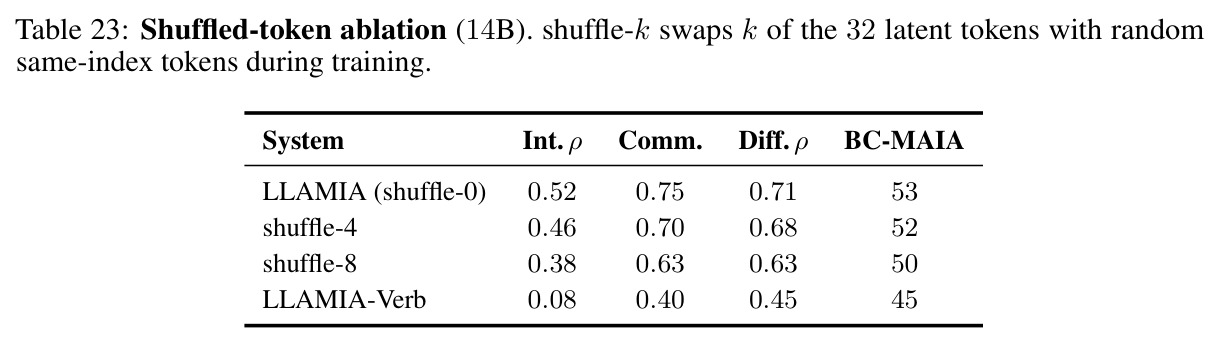
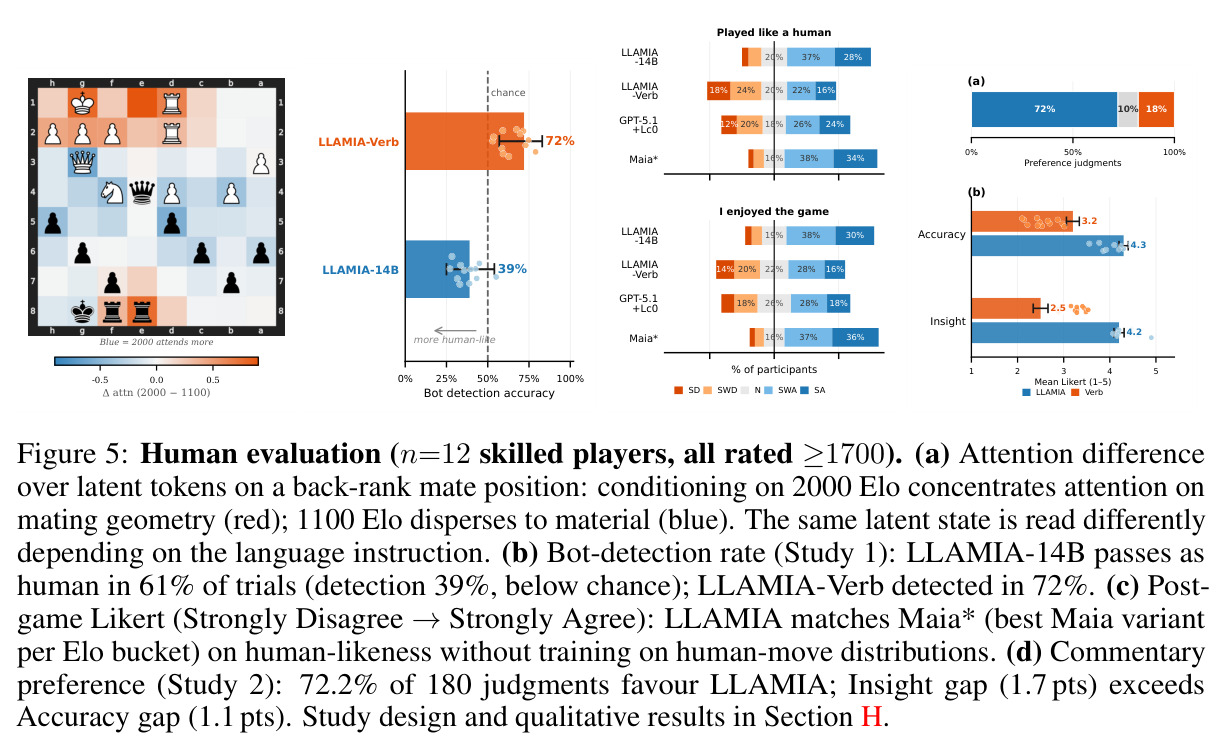
核心创新是『潜状态内化』这一接口本身,它与语言化的本质区别在于赋予LLM的代理权不同。语言化通道无论模型怎样查询,返回的都是同一种压缩摘要——引擎的『标题结论』(top-k着法、先验概率、评估值),模型只有『提问权』(何时调用、是否采纳);潜token则让LLM的注意力在每一步推理中选择性读取表示的不同侧面,获得『解读权』——论文给出直接证据(Figure 5a):同一个32-token状态,在2000 Elo指令下注意力集中于将杀几何,在1100 Elo指令下分散到子力,说明投影状态是受任务语境调制的感知输入而非静态特征向量。与已有工作的本质区别:PaLM-E/RT-2注入原始传感器观测,这里注入的是预训练专家『加工过的』策略/价值表示,相当于把专家整个感知-理解管线移植给LLM;CoCoNut/Token Assorted是单模型内部潜推理,这里是冻结专家与冻结LLM之间经一个轻量3层MLP建立的异构潜通道,不要求联合训练。更关键的设计是投影器$H_\phi$与LLM在RL中联合优化:梯度从任务奖励流回投影器,接口本身被端到端塑形——投影器学会呈现什么表示,LLM学会如何读取、何时调用(调用动作本身在策略的动作空间内)。消融证明收益来自Lc0潜状态的内容而非额外容量:同样32个槽位填原始棋盘编码器(ChessCLIP)或打乱自身token,性能都退化到语言化水平。
方法步骤详情
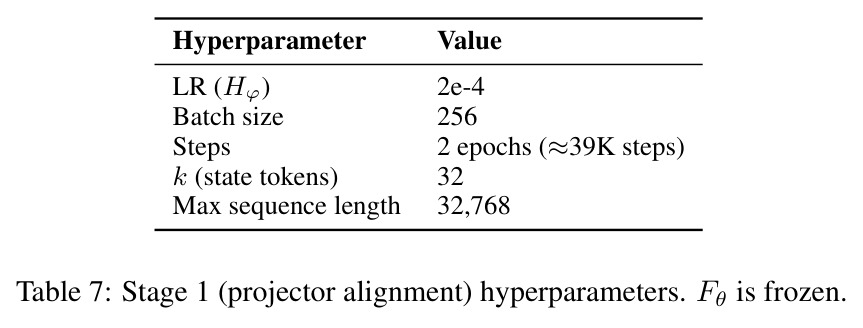
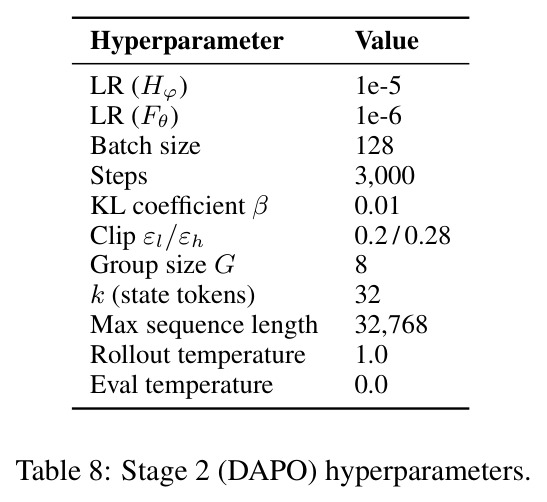
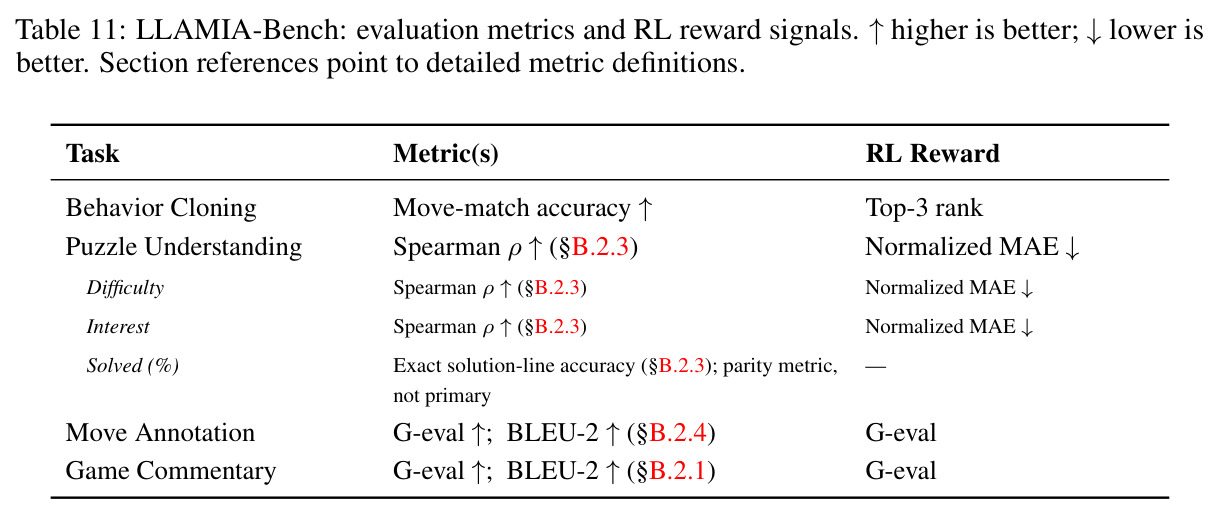
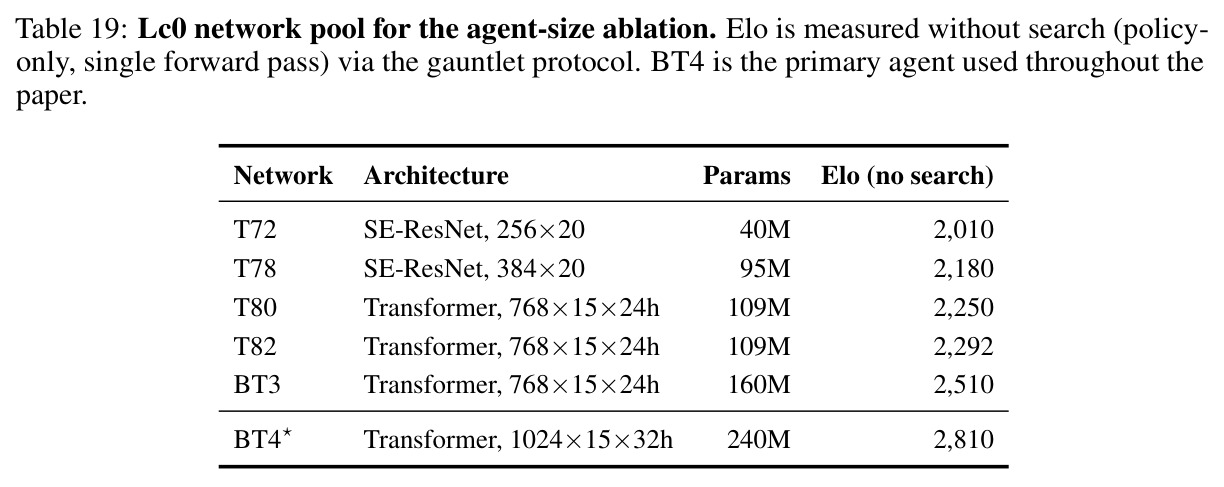
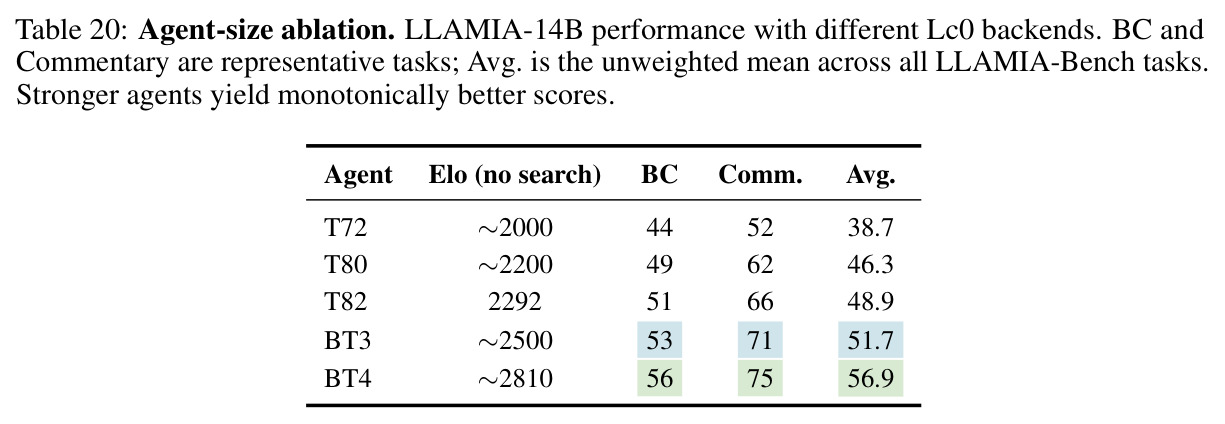
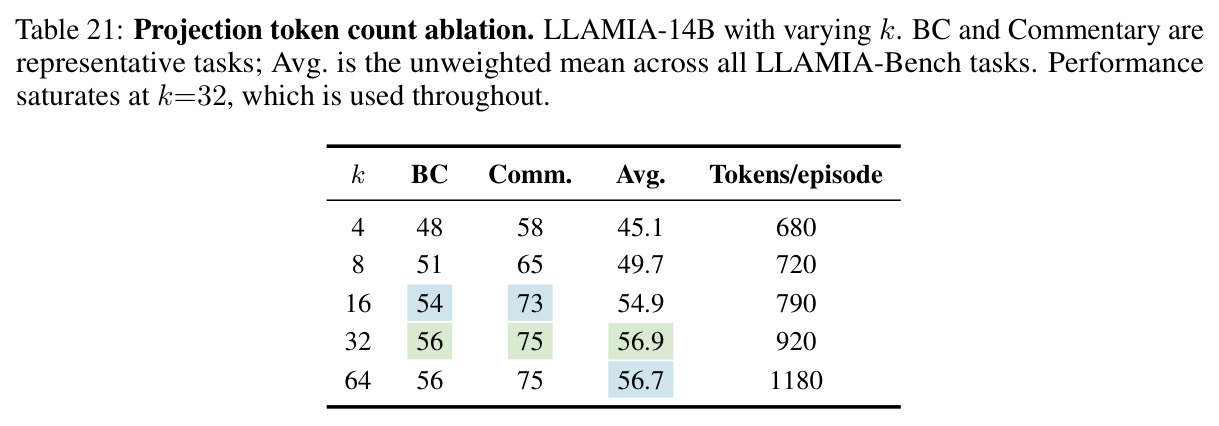
Step 0 组件选型:子智能体为Lc0-BT4(15层Transformer、240M参数、1024维隐状态、无搜索约2810 Elo、千节点MCTS约3300 Elo),取第14/15层(倒数第二层)激活——该层Stage-1验证损失在所有层中最低,且可解释性研究在此定位value/square/look-ahead特征;LLM为Qwen3(4B/8B/14B),经Hermes格式系统提示获得六工具状态化API(get_position、make_move、undo_move、reset_position、analyze、get_policy),输出以占位符锚定注入点。Step 1 投影器构建:LatentBridge为3层GeLU MLP,把1024维激活映射为k=32个与LLM隐藏层同维(如14B为5120维)的连续嵌入;k由扫描{4,8,16,32,64}确定——k=32时六任务平均56.9分,k=64无增益(Table 21)。Step 2 Stage-1投影器对齐:从Lichess评估库采样500万个(状态,策略)对(按对局ID切分4.5M训练/250K验证/250K测试防泄漏),冻结LLM,用交叉熵$\mathcal{L}=-\mathbb{E}_{(s,\pi(s))}\log \pi_\theta(\pi(s) \mid z_s, \text{prompt})$只训练投影器(学习率2e-4、batch 256、2个epoch约39K步);四种问题类型(局面评估、主变、合法着法、简述)均匀采样防止过拟合单一格式。Step 3 Stage-2强化学习:解冻LLM与投影器,DAPO联合优化约850K任务样本(BC 500K、谜题200K、注解100K、解说50K),组大小G=8、非对称裁剪$\varepsilon_l/\varepsilon_h=0.2/0.28$、KL系数0.01、3000步;重要性采样比按接口分别定义(Eq. 4/5),策略梯度只算在LLM生成的语言/动作token位置($I_{gen}=I_L \cup I_A$),状态token位置用梯度掩码排除;每任务定义标量结果奖励——BC用top-3排名奖励(top-1得1.0、top-2得0.5、top-3得0.25),因为top-1精确匹配作为奖励信号太稀疏会导致训练崩溃;谜题用归一化MAE,生成任务用G-eval。Step 4 推理协议:LLM发出后,harness对当前FEN跑一次BT4前向并把32个新状态token注入下一轮;棋盘变更类调用(make_move/undo_move/reset_position)触发重编码,只读调用不触发;反事实查询即『走一步假设着法→重编码→比较两个潜状态』,由RL自发习得而非提示工程规定。
技术新颖性
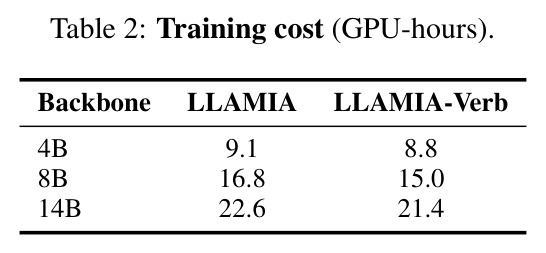
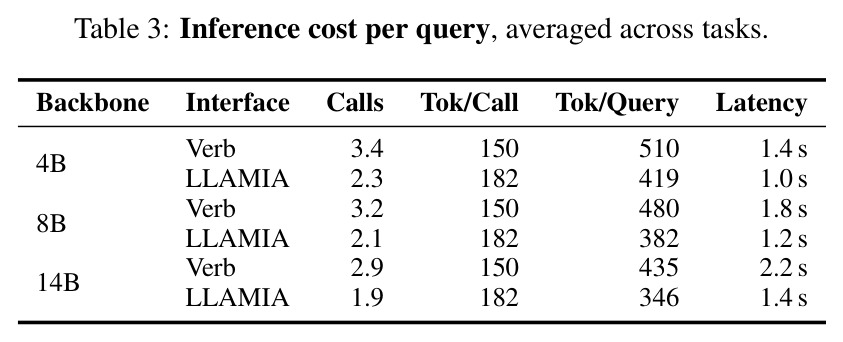
技术新颖性体现在四个层面。问题层面:首次在异构LLM-非语言智能体协作中定义并受控量化Verbalization Debt——通过LLAMIA与LLAMIA-Verb的唯一变量对照(同骨干、同引擎、同DAPO配方、同提示与奖励),把『积分接口』从规模、算力等混杂因素中干净地剥离,这是以往工具调用与多智能体文献都未提供过的证据形式。范式层面:潜状态内化不是又一个多模态投影——与PaLM-E/RT-2注入原始感知不同,这里注入的是预训练专家加工后的策略/价值表示;与LatentMAS等同质潜协作不同,这里兼容任意『开源引擎+开源LLM』组合且两者都冻结,实用性大增。机制发现层面:论文证明接口决定可学习的协作结构而非性能上限——RL在潜通道上自发涌现出反事实查询(走假设着法再重编码比较)和多步前瞻(链式两三个反事实序列)等任务特定策略,而同样的RL在语言化通道上只会收敛到『跟随引擎』这一种模式,这一涌现差异是全新的经验发现。工程层面:内化几乎零成本——Stage-1只增加1-2 GPU小时,总训练开销不超过语言化管线的6%;且LLAMIA学会更少调用子智能体(14B下1.9次/查询 vs 2.9次),每次调用多32个token但总token/查询反而更低(346 vs 435),延迟也更低(1.4s vs 2.2s),打破了『更强集成必然更贵』的直觉。
实验结果
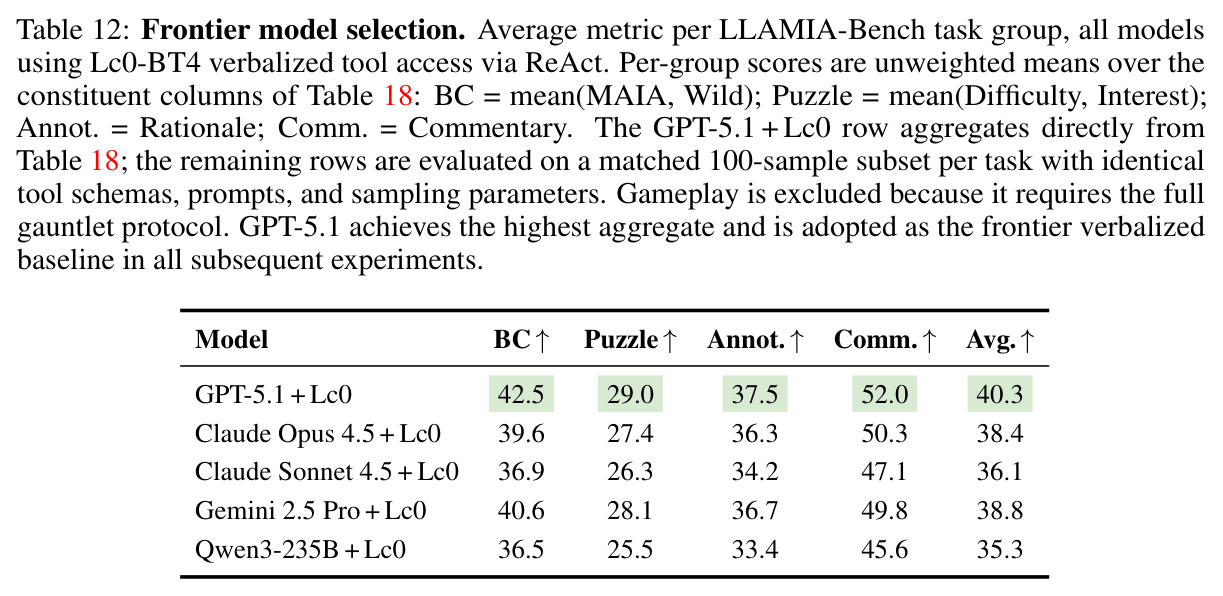
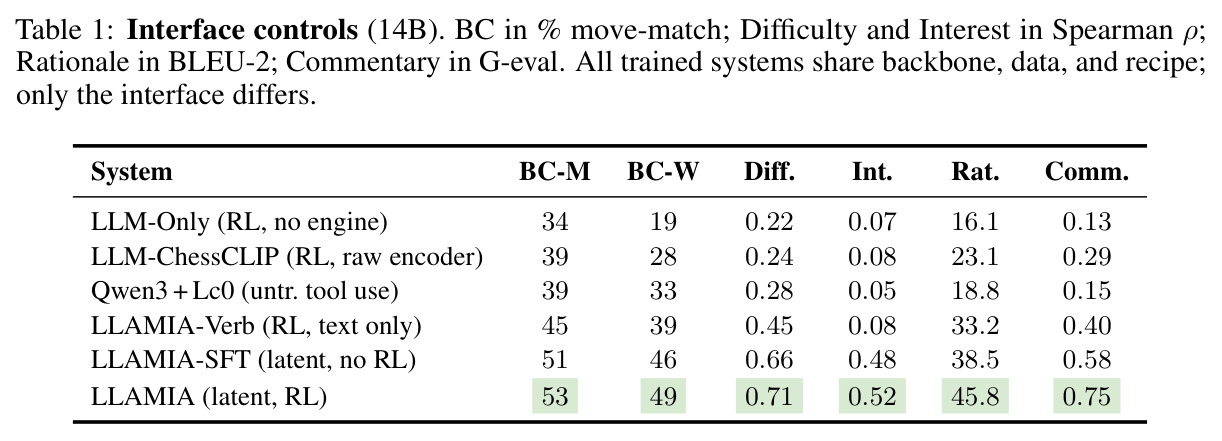
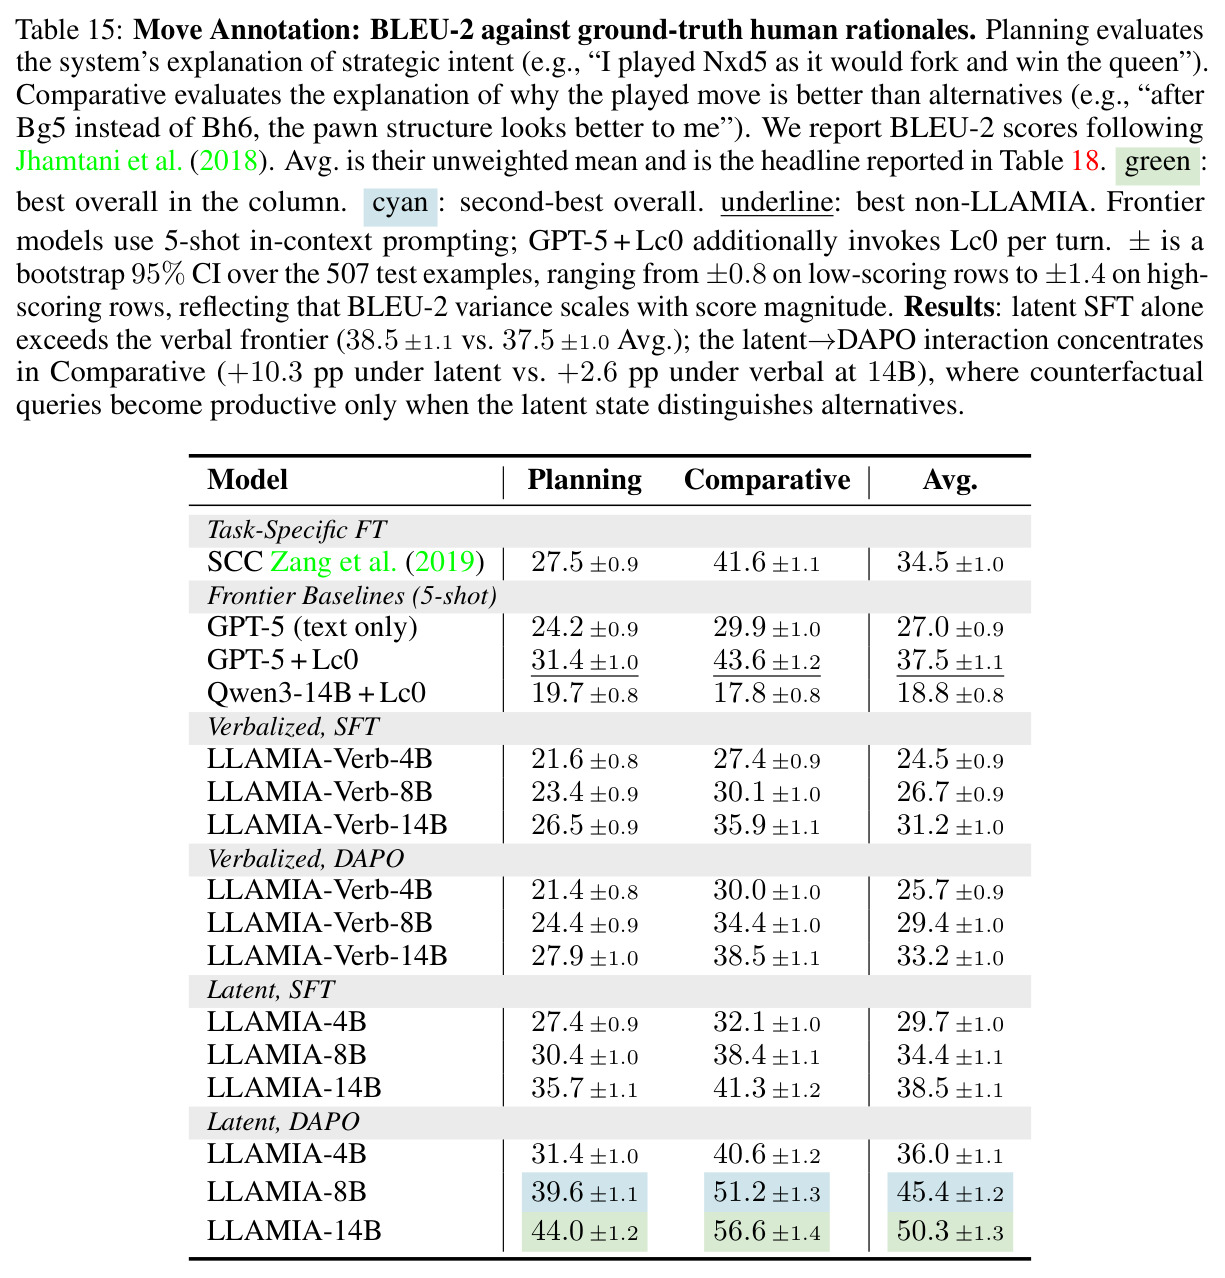
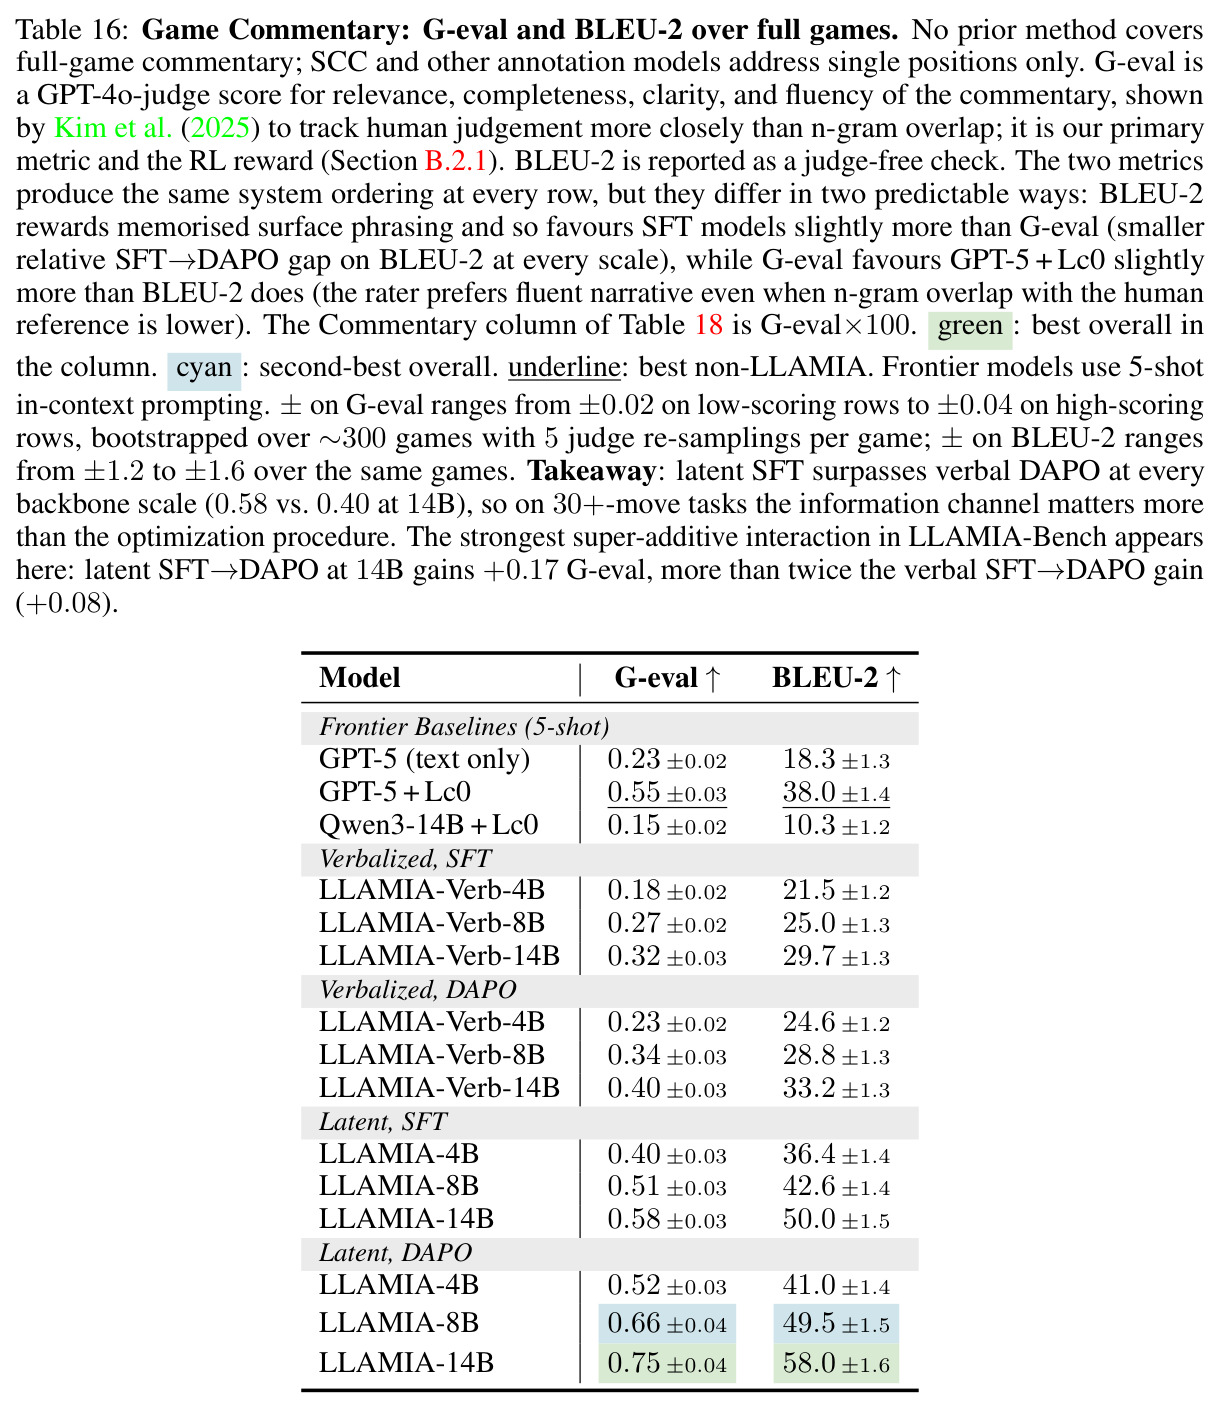
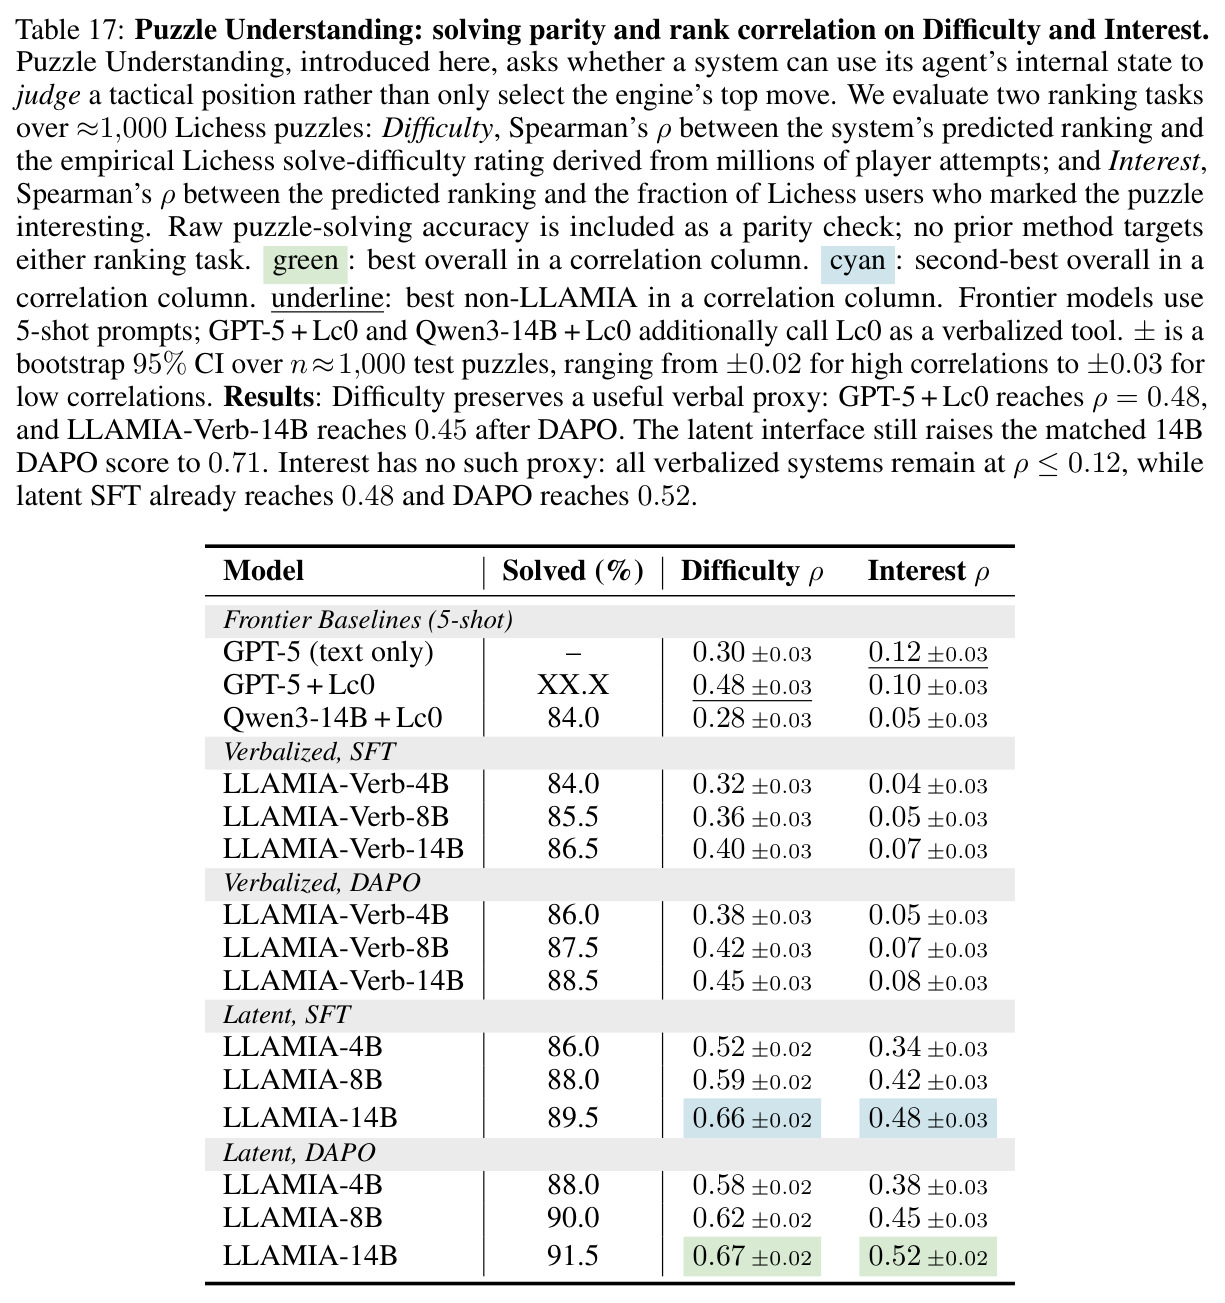
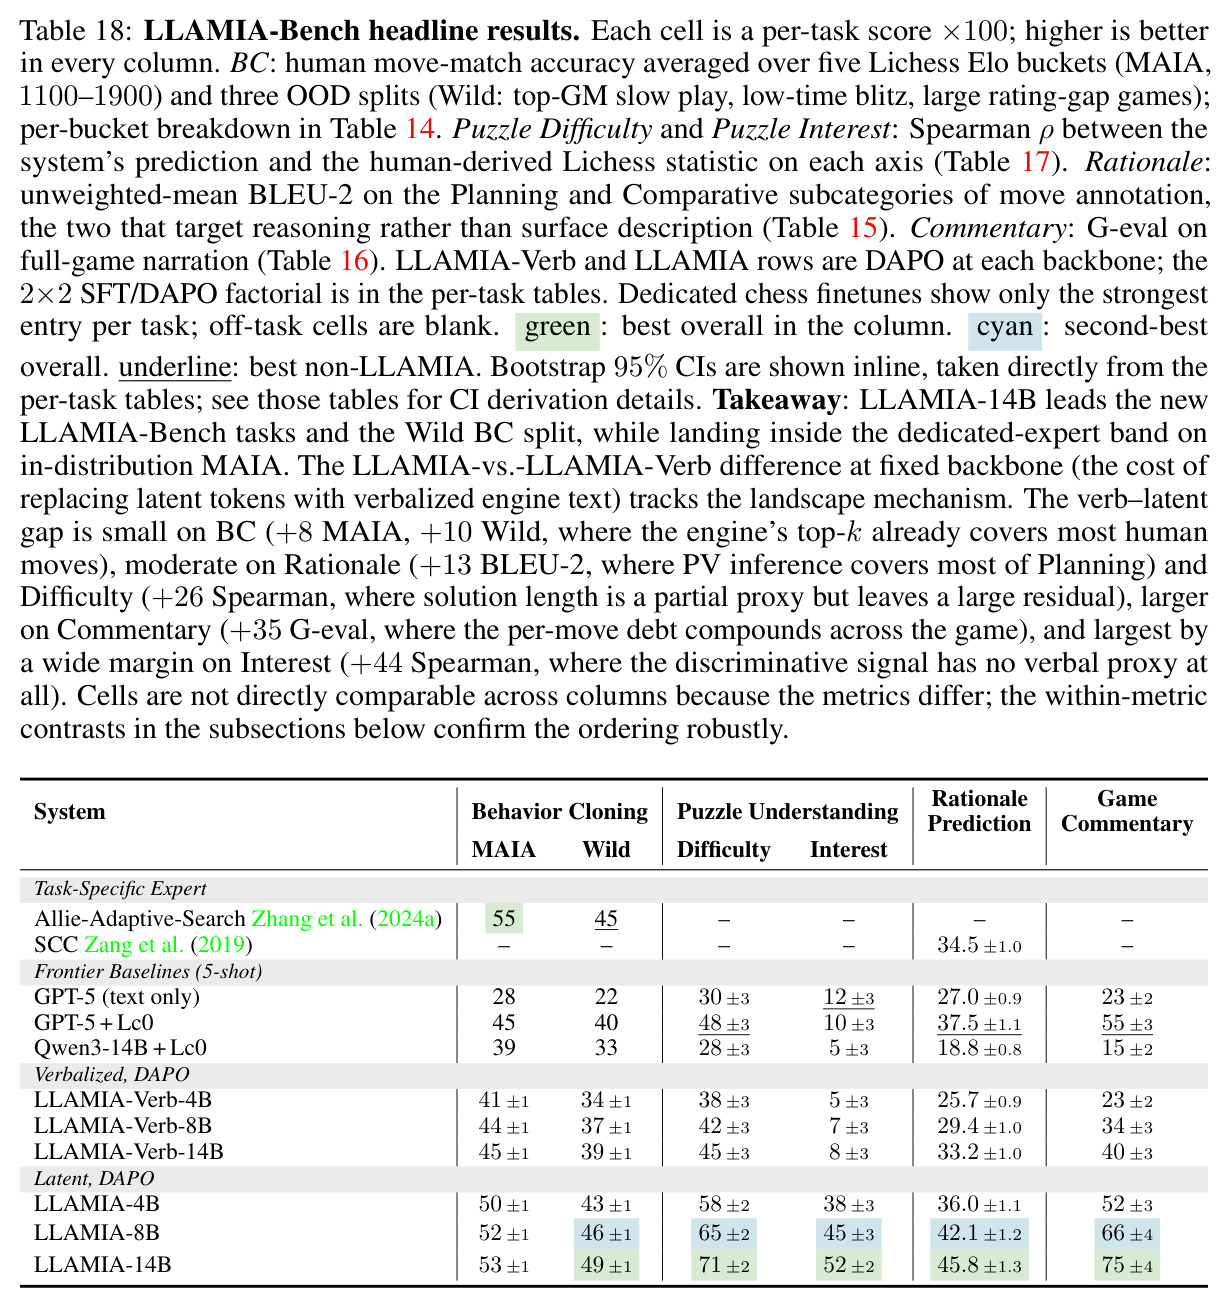
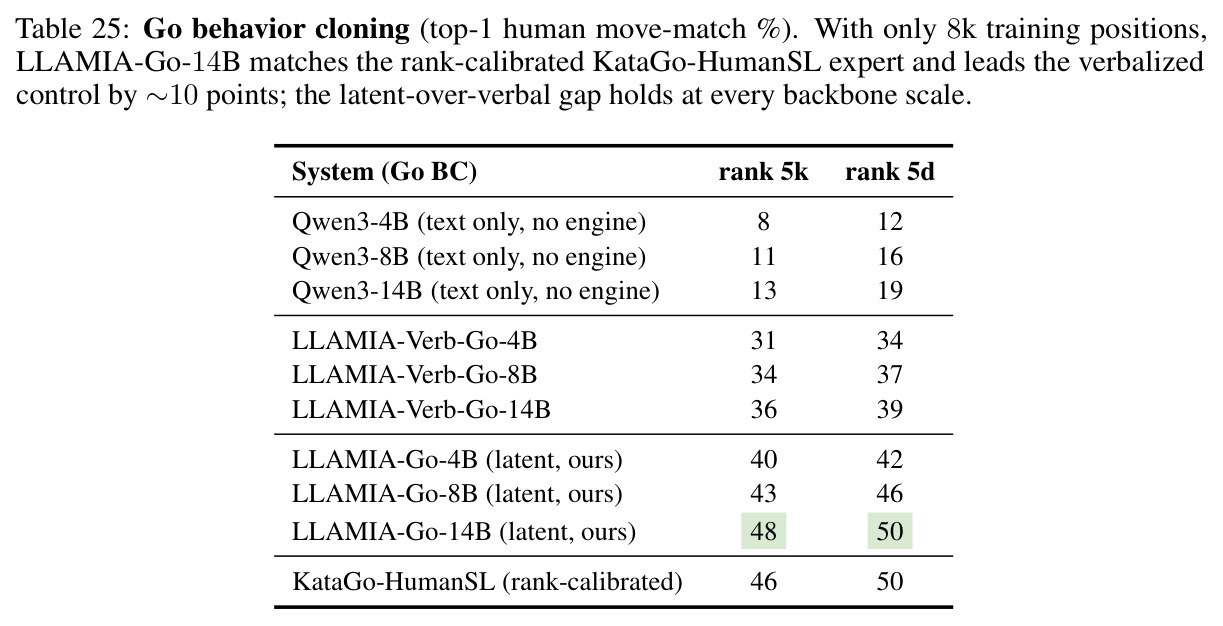
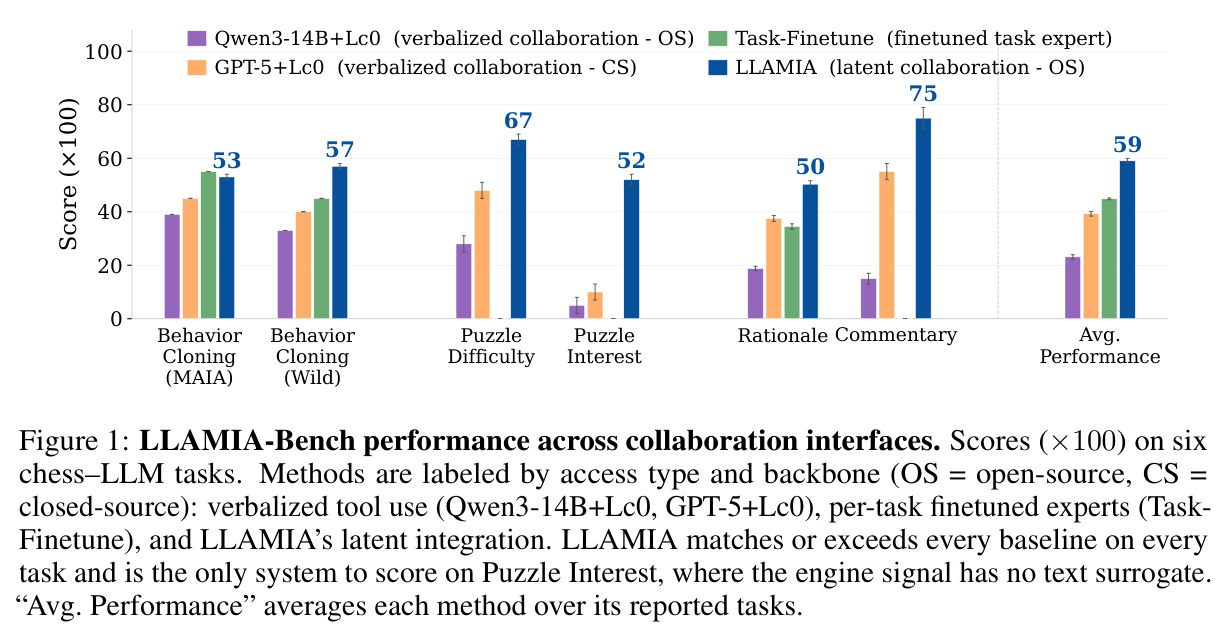
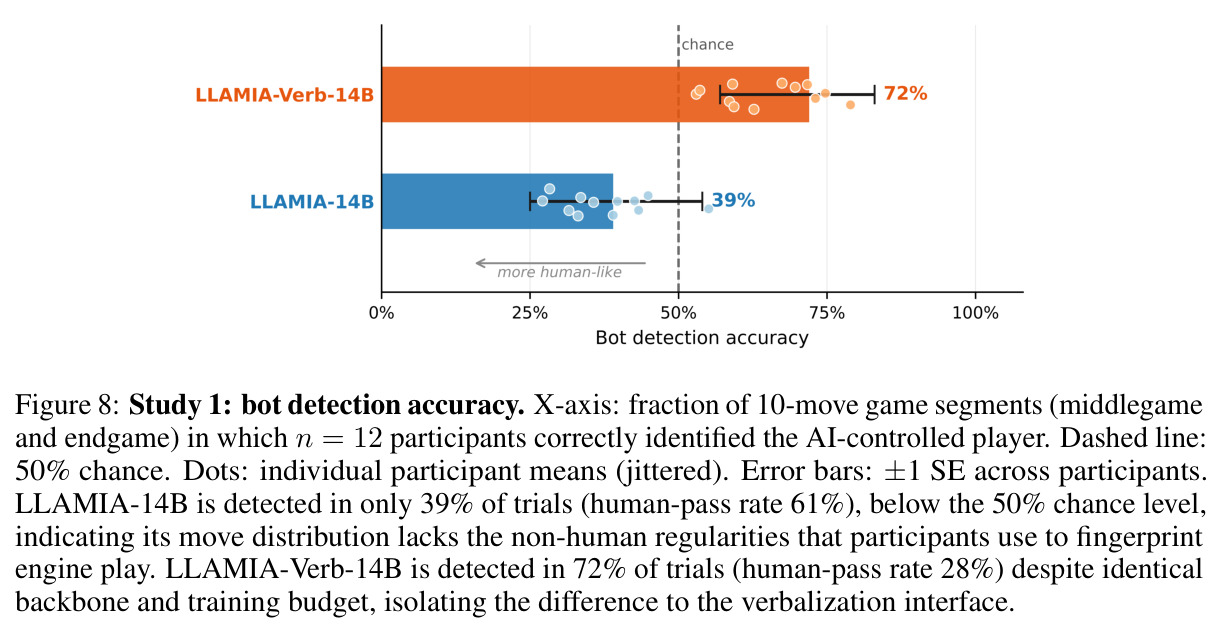
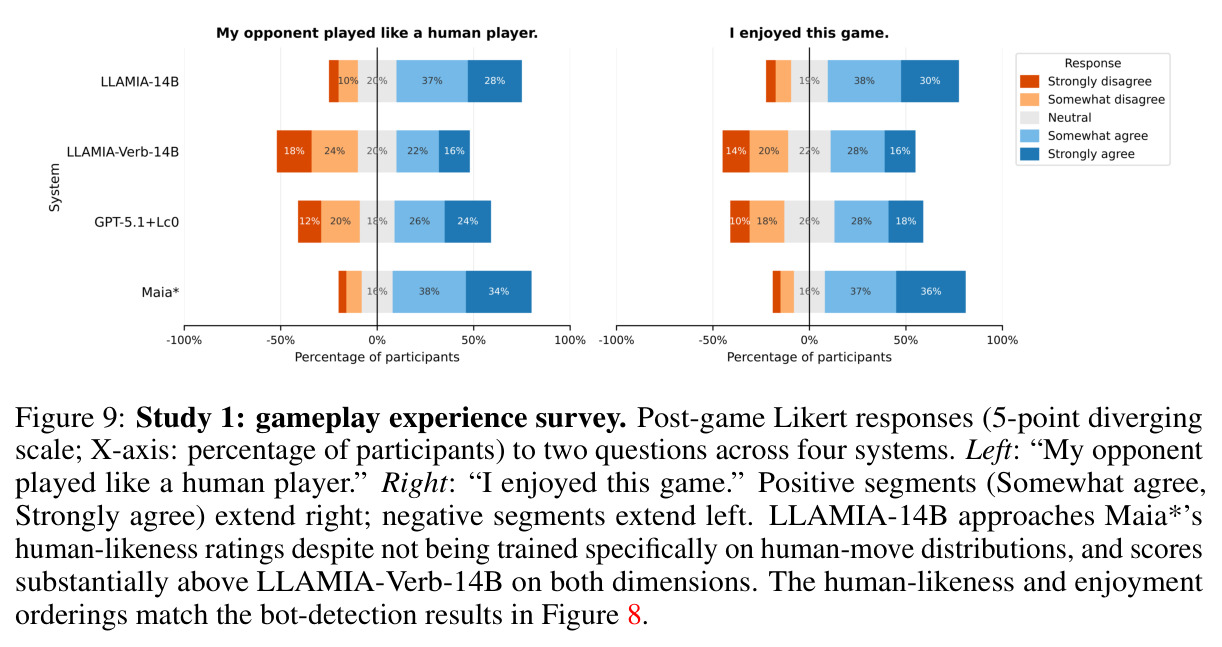
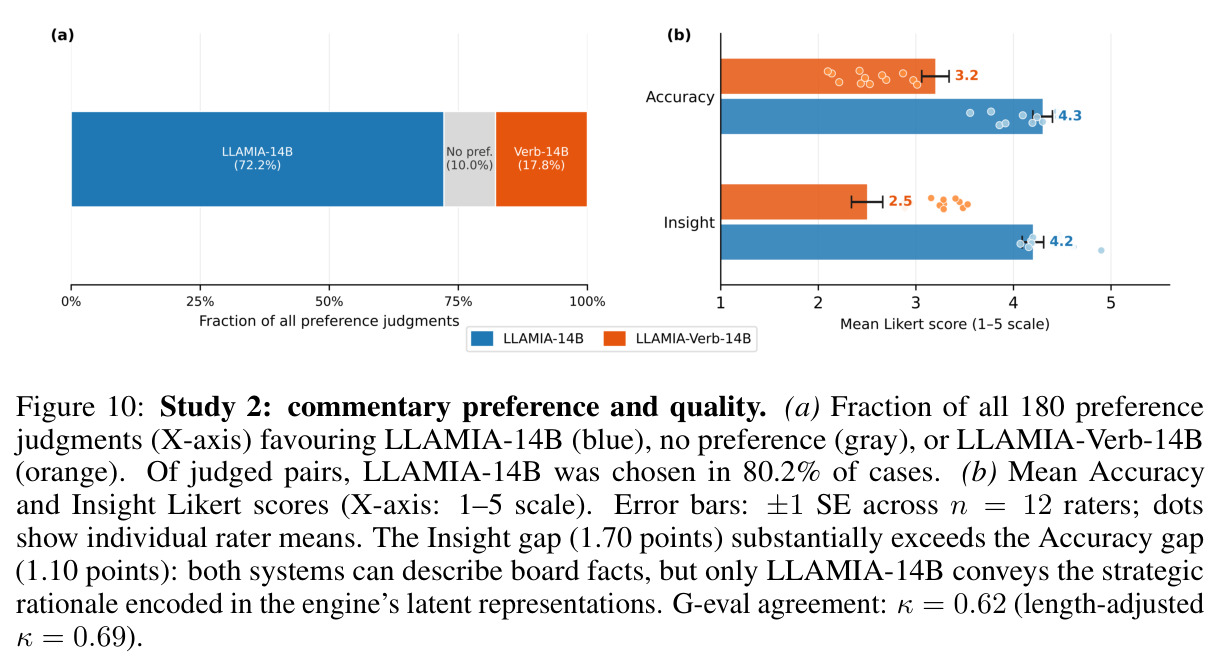
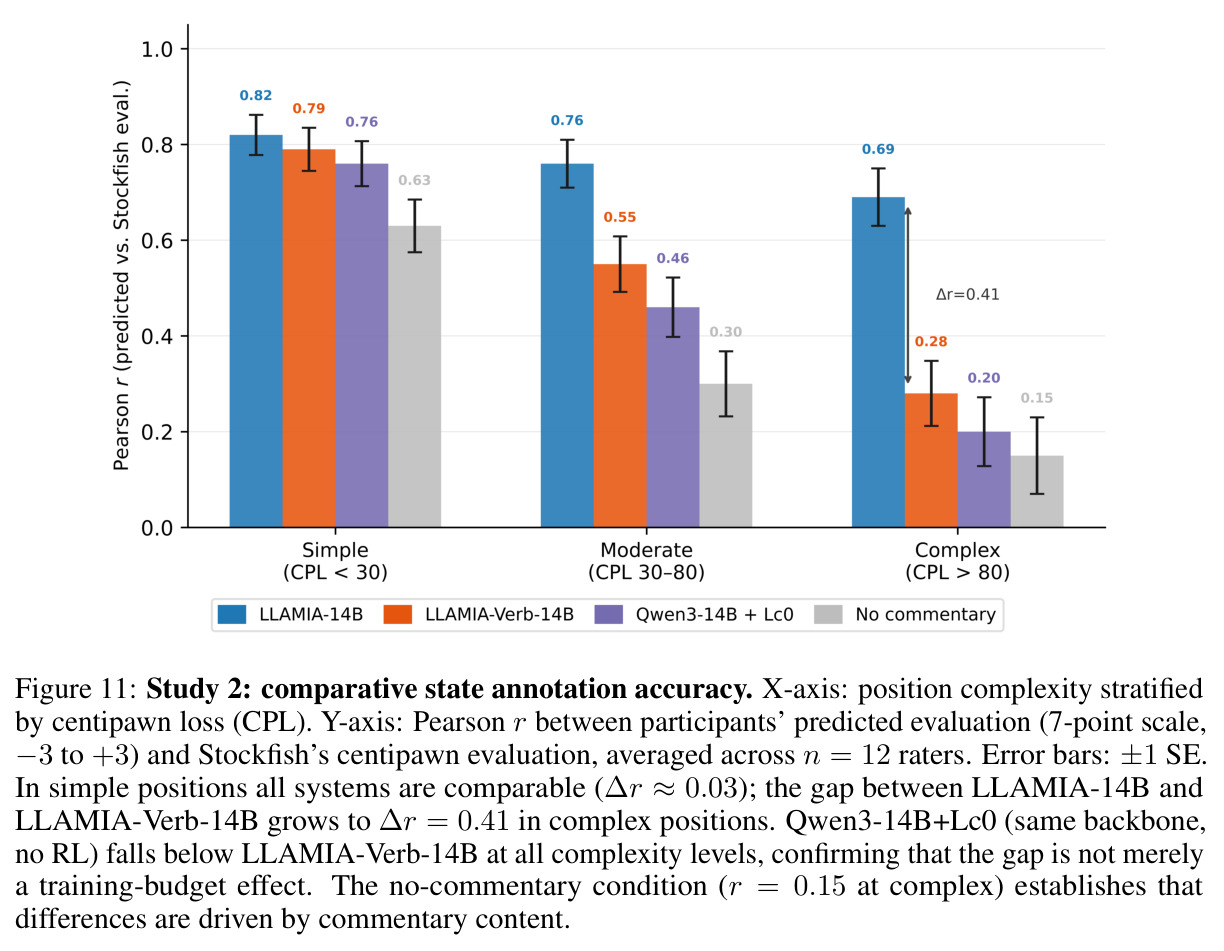
核心结果一(Table 18):LLAMIA-14B在全部六个任务上第一。行为克隆MAIA切分53±1(语言化对照LLAMIA-Verb-14B为45、GPT-5+Lc0为45;专用专家Maia为52、Allie-Adaptive-Search为55——但专家用了每个Elo桶1200万局或9300万局训练,LLAMIA只用2万局);行为克隆Wild分布外切分(GM-25/Low-Time/ΔElo)49±1,超最强专家4个百分点,说明对引擎策略与价值结构的潜访问比在更窄分布上的直接监督泛化更可靠。谜题难度Spearman ρ=0.71(GPT-5+Lc0为0.48、Verb-14B为0.45);谜题趣味性ρ=0.52,而所有语言化系统不论规模或前沿程度都不超过0.12(6.5倍差距)——趣味性取决于引擎策略分布与价值梯度,没有任何文本代理。着法解说BLEU-2为45.8(GPT-5+Lc0为37.5,任务专用SCC为34.5);整局解说G-eval为0.75(GPT-5+Lc0为0.55)。核心结果二(Figure 3):语言化债随训练扩大到2-3倍且4B→14B不闭合——Interest任务上Verb-14B只得8分而LLAMIA-4B已有38分。核心结果三(Table 1消融):纯LLM+RL无引擎仅BC-M/W=34/19,RL加错误内容的32槽(ChessCLIP原始编码器)39/28,证明收益来自Lc0潜状态的内容而非RL或容量;latent-SFT已达51/46/0.66/0.48/38.5/0.58,其中解说0.58已超verbal-DAPO的0.40——在30+步任务上信息通道比优化方法更重要。核心结果四(Figure 4/6):LLAMIA按任务分化协作策略(对局65%跟随引擎、BC 48%先问后否、解说40%反事实查询;策略熵H=1.53达最大值ln5的95%),Verb在所有任务塌缩为跟随引擎62-76%(H=0.93,任务间JSD仅0.012 vs 0.12)。核心结果五(Figure 8-11人类研究,n=12名≥1700 Elo棋手):LLAMIA机器人检测率39%低于50%随机线(61%通过为人类),Verb被72%识破;解说偏好72.2%(判定对中80.2%),Insight差距1.70分大于Accuracy差距1.10分;复杂局面(CPL>80)下读者局面评估相关性r=0.69 vs Verb的0.28。核心结果六(Table 25围棋迁移):仅8K训练位置达48/50 top-1人类着法匹配(rank 5k/5d),追平rank校准专家KataGo-HumanSL(46/50),超语言化对照约10分,且差距在4B/8B/14B均成立。
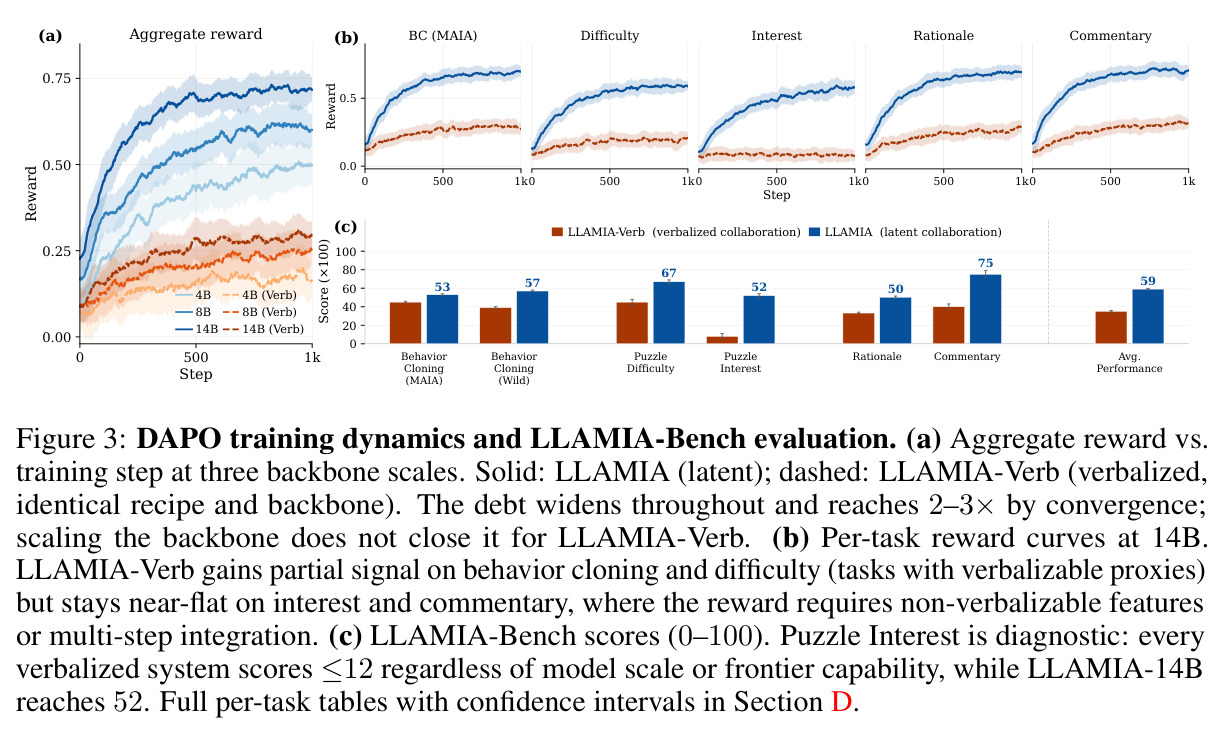
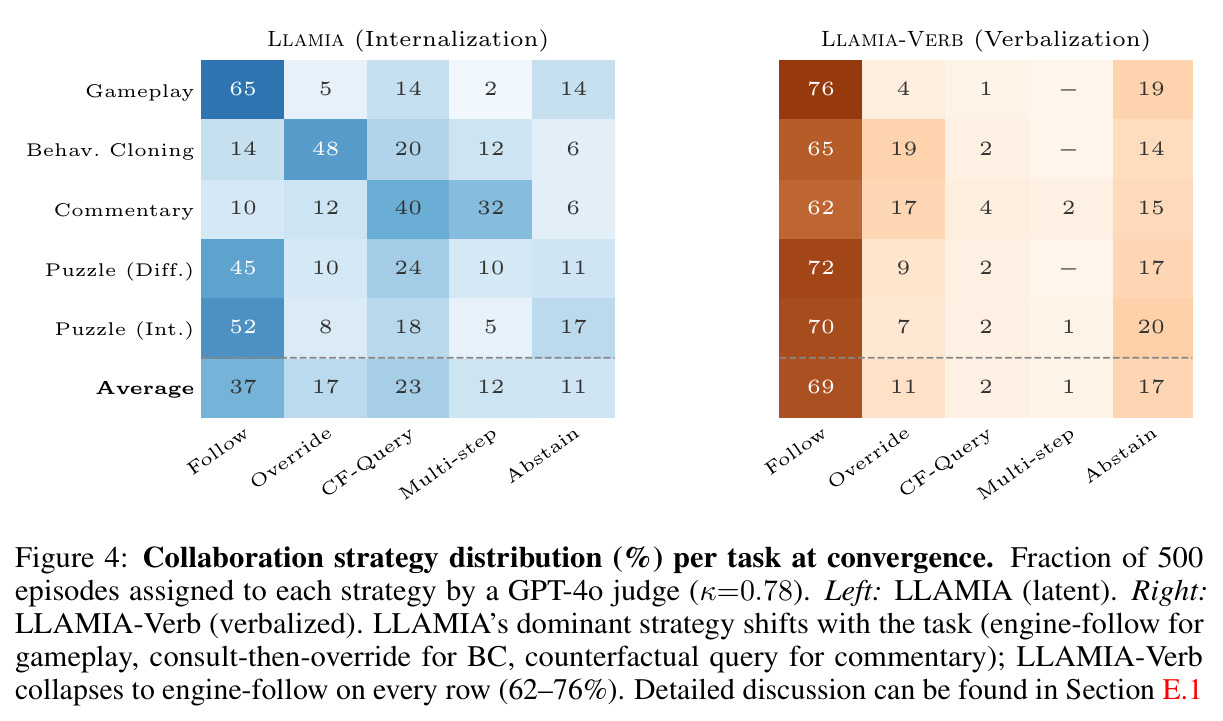
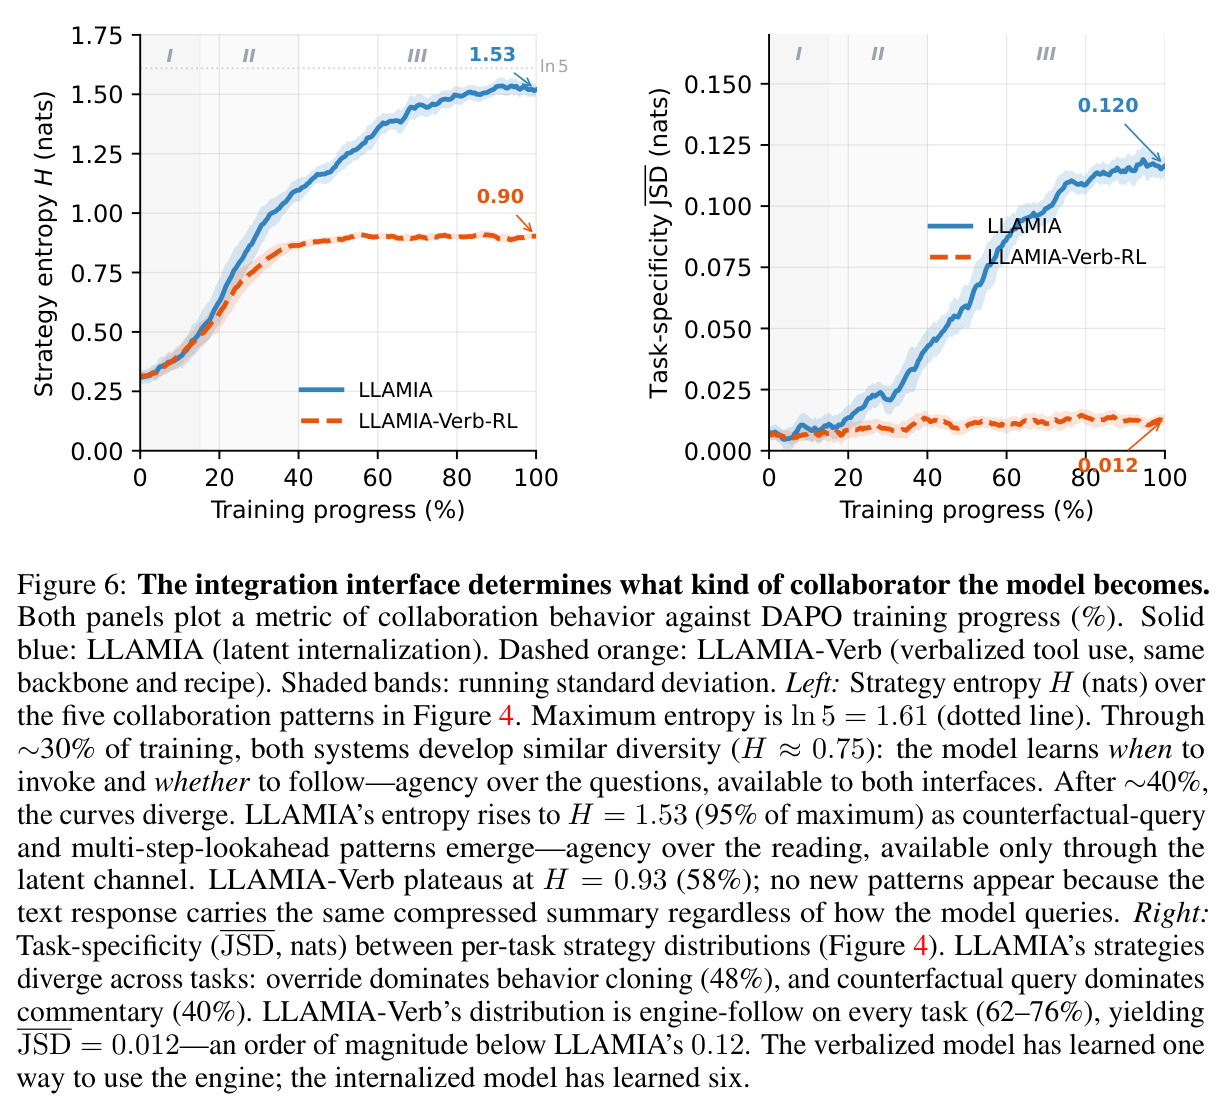
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 行为克隆(MAIA,5个Elo桶1100-1900平均) | top-1着法匹配率(×100) | 53±1(LLAMIA-14B,DAPO) | 最强专用专家Allie-Adaptive-Search 55(9300万局训练);GPT-5+Lc0 45;LLAMIA-Verb-14B 45 | 落在专家带内(差最强专家2pp),但训练数据仅2万局vs专家12-93M局;超GPT-5+Lc0 8pp |
| 行为克隆(Wild分布外:GM-25/Low-Time/ΔElo) | top-1着法匹配率(×100) | 49±1(57/54/60) | Allie-Adaptive-Search 45;Maia 42;GPT-5+Lc0 40 | +4pp超最强专用专家(其blitz-only训练分布缺失GM理论、时间压力、不对称对局三个OOD轴) |
| 谜题难度排序(约1000道Lichess谜题) | Spearman ρ | 0.71±0.02 | GPT-5+Lc0 0.48;LLAMIA-Verb-14B 0.45 | +0.23(vs最强前沿语言化系统);相对Verb +0.26 |
| 谜题趣味性排序(社区『有趣』标记比例) | Spearman ρ | 0.52±0.02 | 所有语言化系统≤0.12(GPT-5纯文本0.12、GPT-5+Lc0仅0.10、Verb-14B 0.08) | +0.40(约6.5倍)——唯一有信号的接口,因为趣味性信号只存在于策略分布与价值梯度中 |
| 着法解说(Rationale:Planning+Comparative) | BLEU-2 | 45.8±1.3(Comparative子类56.6) | GPT-5+Lc0 37.5;任务专用SCC 34.5;LLAMIA-Verb-14B 33.2 | +8.3 vs GPT-5+Lc0;latent-SFT(38.5)已超verbal-DAPO(33.2),DAPO在latent下Comparative增益+10.3pp而verbal下仅+2.6pp |
| 整局解说(Agadmator-2K,100局测试) | G-eval(×100) | 75±4(BLEU-2为58.0) | GPT-5+Lc0 55;LLAMIA-Verb-14B 40 | +20 vs前沿语言化;+35 vs匹配配方的语言化对照(语言化债在长程多步任务上最大之一) |
| 人类机器人检测(Study 1,n=12名≥1700 Elo棋手) | AI检测率 | 39%(低于50%随机线,61%对局被认作人类) | LLAMIA-Verb-14B被72%识破 | -33pp检测率;后测『像人』评分与Maia*持平,而LLAMIA从未接受人类着法分布的监督 |
| 解说人类偏好(Study 2,180次判定) | 偏好率 / Likert评分 | LLAMIA-14B获72.2%偏好(判定对中80.2%);Accuracy 4.30、Insight 4.20 | LLAMIA-Verb-14B:Accuracy 3.20、Insight 2.50 | Insight差距1.70分大于Accuracy差距1.10分——解说的事实层语言化尚可保留,战略洞见层不能 |
| 围棋行为克隆(KataGo-b18子智能体) | top-1人类着法匹配%(rank 5k/5d) | 48/50(LLAMIA-Go-14B,仅8K训练位置) | KataGo-HumanSL专用专家46/50;LLAMIA-Verb-Go-14B 36/39 | 追平专用专家,超语言化对照约10分;潜通道优势在4B/8B/14B全部成立 |
局限与改进
作者承认的局限:证据主要来自国际象棋——虽然六种Lc0网络(T72/T78/T80/T82/BT3/BT4,覆盖SE-ResNet与Transformer两族)和围棋BC支持泛化性,但完整的围棋多任务套件尚未构建;内化需要访问智能体的内部激活,闭源智能体无法直接应用,只能通过LLAMIA做语言中介桥接(引入额外一跳);子智能体架构结论存在三重混淆(架构、规模、投影器兼容性),作者明确说需要匹配参数量的受控实验才能下因果结论。我自己的观察:第一,生成类任务(注解/解说)的DAPO奖励与主指标同为G-eval(GPT-4o裁判),而参评系统本身是LLM——存在奖励过拟合裁判偏见的循环风险,论文自己测得G-eval有长度偏见(长度校正后κ从0.62升到0.69),『超过GPT-5』的结论在这两个任务上独立性打折扣;第二,国际象棋是完全信息、确定性、规则固定的双人零和博弈,且Lc0的隐层语义已被可解释性研究充分绘制——在部分可观测、含随机性的环境(机器人、驾驶)中『该投影哪一层、哪些激活有语义』未必如此清晰;第三,Agadmator-2K仅1900局、测试仅100局,用『按观看量切分』做防污染代理只是启发式而非保证;第四,人类研究n=12且全部来自大学棋社(≥1700 Elo),样本量小、水平偏高,对普通用户场景的外推有限;第五,k=32固定带宽对所有任务一视同仁,论文未探索按任务难度自适应调整token预算与调用频率。
独立分析的弱点
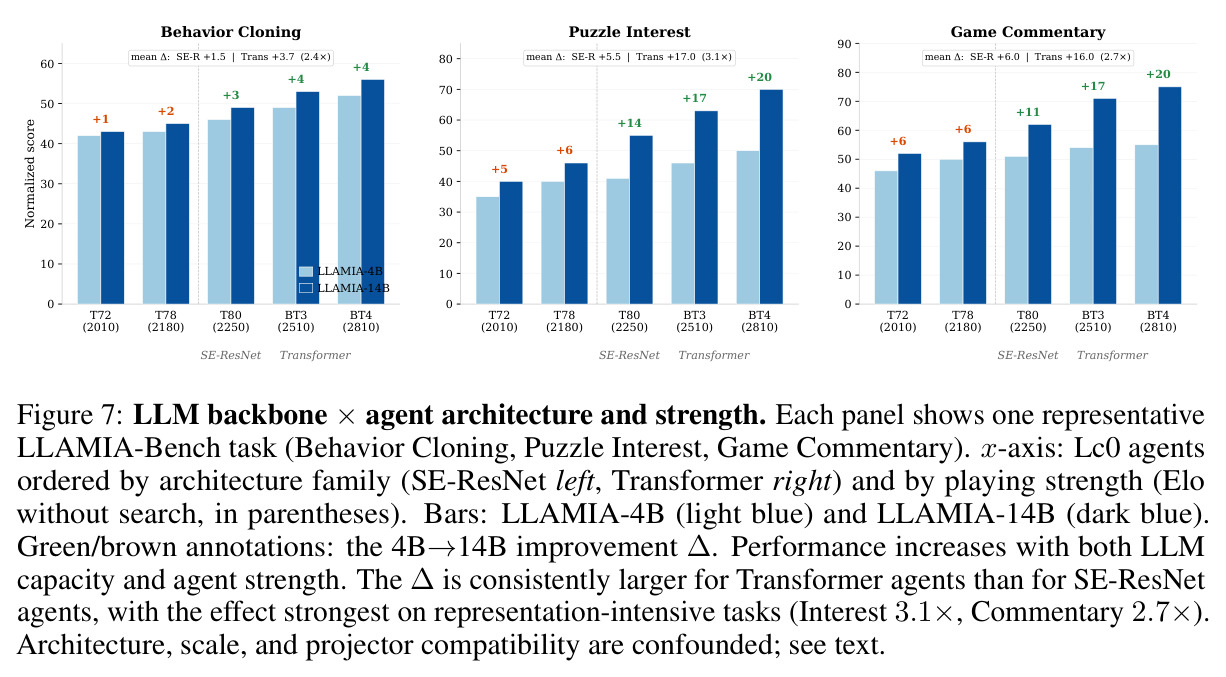
弱点一:白盒依赖与每智能体重训成本。LatentBridge需要读取引擎倒数第二层激活,且agent-size消融显示换一个智能体就要『从头重训投影器』——面对大量异构专家(不同引擎、不同机器人策略)时工程成本线性增长。改进方向:学习智能体无关的通用投影接口,或用少量探测查询自动搜索可迁移层与投影初始化,实现『即插即用』内化。弱点二:裁判奖励循环。解说与注解任务的RL奖励和评测指标都是G-eval(GPT-4o打分),模型在DAPO中可能学出迎合裁判的策略(如措辞流畅但内容空洞),人类研究虽部分缓解但仅12名评审。改进方向:用人类偏好对训练独立奖励模型,或引入可验证的引擎一致性信号(如解说断言与引擎分析的自动比对)做奖励正则。弱点三:领域窄且依赖表征先验。国际象棋的层选择有可解释性研究背书(第14层定位前瞻特征),其他领域缺乏这种先验,仅凭Stage-1对齐损失选层是否可靠未知。改进方向:自动逐层搜索+多层投影聚合,或对比学习式的层选择。弱点四:架构混淆未解。Transformer架构智能体从4B→14B获得的提升是SE-ResNet的2.4-3.1倍(Interest上3.1倍),但架构、规模、投影器兼容性三者混杂——若MLP投影器天然偏爱transformer特征,机器人领域常见的CNN主干策略网络收益可能打折。改进方向:匹配参数量的跨架构对照实验、注意力式或归一化更强的投影器设计。弱点五:闭源LLM只能二跳桥接。内化要求改模型权重,闭源模型只能通过LLAMIA做语言中介,论文未量化这一中介链自身的损耗。改进方向:研究中介链的误差预算,或探索对闭源模型 API的软提示注入等替代通道。
未来方向
作者明确提出的方向:把围棋从单一BC任务扩展为完整的LLAMIA-BENCH-Go多任务套件(含解说、局面评估等协作任务);做匹配参数量的架构对照实验,回答『子智能体架构在原始强度之外是否独立影响内化』;向更多领域推广——论文点名机器人(RT-1类策略)与自动驾驶,即把任意预训练控制网络的潜状态内化进LLM。基于本文成果可自然延伸的方向:其一,多专家同时内化——让一个LLM同时内化Lc0+KataGo+Stockfish等多个异构引擎,研究跨专家的『第二意见』组合推理与分歧检测;其二,潜通道与搜索结合——目前内化的是单次前向表示(无搜索的2810 Elo),能否内化MCTS搜索后的改进策略或候选着法的价值地形差分,把搜索预算也搬进token;其三,自适应带宽——按任务难度动态决定k值与调用频率,进一步压低推理成本并测试更小k在简单任务上的下限;其四,把Verbalization Debt理论化——将『哪些信号存在文本代理、哪些没有』形式化为信息论量,用于预测任意任务的债务上界并指导接口选型;其五,反事实查询策略的蒸馏与迁移——LLAMIA在RL中自发学到的『走假设着法→重编码→比较』是通用的规划原语,可显式蒸馏后迁移到棋类之外的长期规划任务;其六,科学计算协作——内化分子动力学、天气预测等科学网络的潜状态,让LLM在物理一致性约束下做假设推理。
复现评估
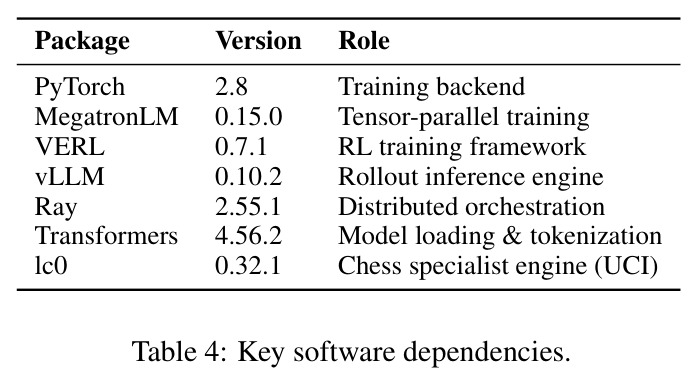
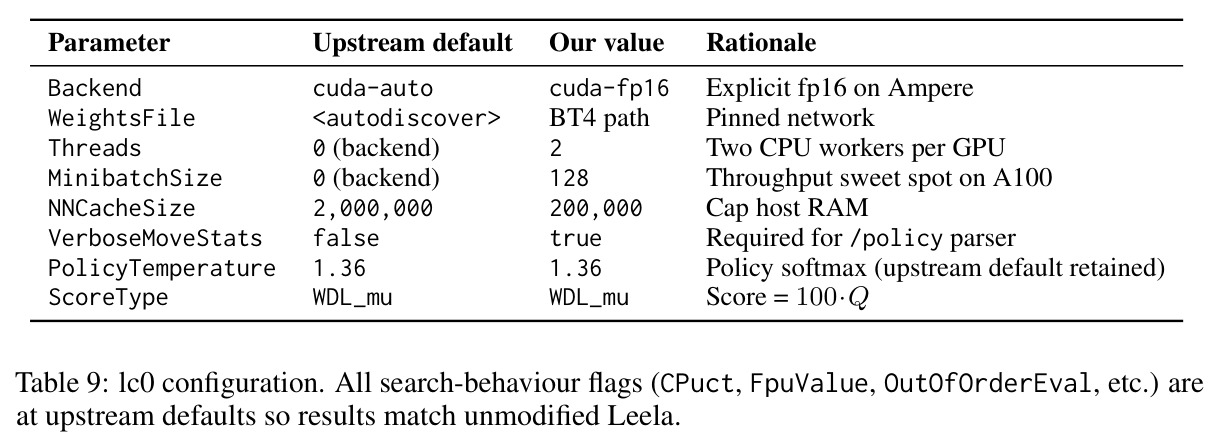
开源程度较高。代码、数据与示例在项目页(behavior-in-the-wild.github.io/llamia.html)公开;LLM骨干Qwen3(4B/8B/14B)为开源权重;子智能体Lc0-BT4网络给出直接下载链接(fp16约2.9GB);数据基本来自公开源——Lichess评估库与谜题库、MAIA-KDD基准、GameKnot与Lichess注解语料、Caissabase,自建的Agadmator-2K(1900局约500小时YouTube解说)依赖Whisper-v3-large转录+滑窗着法对齐+GPT-4o标注的四步管线,文中给出了完整流程。算力门槛温和且账目透明:4节点×8张A100-80GB(32卡,FSDP+Ray协同,vLLM rollout与lc0服务集群共存同卡、每卡预留3GiB),14B全程训练仅22.6 GPU小时(语言化对照21.4,差距约6%),Stage-1在500万对上约39K步、Stage-2 DAPO仅3000步。软件栈版本逐一列明(PyTorch 2.8、MegatronLM 0.15.0、VERL 0.7.1、vLLM 0.10.2、Ray 2.55.1、lc0 0.32.1)。附录A/J给出全部超参与系统提示模板,数据按对局ID切分防泄漏。复现的主要摩擦点:一是RL基建工程量(多节点FSDP+rollout+引擎服务同卡部署需要经验);二是G-eval奖励依赖GPT-4o API,成本与打分方差会引入噪声;三是Agadmator测试集按观看量切分的防污染只是启发式,严格复现分数可能有出入。总体属于复现可行性较好的『投影+RL』工作,有RL工程经验的团队预计数周量级可完成。
论文图表