PointWAM:面向灵巧机器人操作的3D世界动作模型 PointWAM: 3D World Action Modeling for Dexterous Robotic Manipulation
把场景与双手统一表示为共享时空坐标系中的3D点轨迹联合预测,再将手部轨迹重定向为机器人动作
前置知识
世界动作模型(World Action Model, WAM)
一类同时学习'预测世界将如何变化'与'预测机器人应执行什么动作'的模型。与惯例的 VLA 直接把观测映射为电机指令不同,WAM 把世界预测(未来视频帧、隐状态或几何)与动作预测联合训练,让学到的世界动态内在地指导动作生成,从而显式建模手—环境之间的因果关系。
PointWAM 就是一个 WAM,但它把'世界'表示为 3D 点轨迹而非 RGB 或隐特征;理解这一概念才能看清它与 VLA、视频生成式 WAM 的本质差异以及实验设计的对照逻辑。
点轨迹表示(3D point trajectories)
把观测与动作统一为三维点的位移序列:场景用点云中每个点的未来位移 $u^{(i)}_{t,\tau}=p^{(i)}_{t+\tau}-p^{(i)}_t$ 表示,手部用 $K$ 个语义关键点的位移 $v^{(k)}_{t,\tau}$ 表示。人与机器人手都被映射为同一组每手 10 个关键点(6 掌部点 + 4 指尖点),因此人类视频与机器人数据可共用完全相同的监督格式。
这是全文的核心表示:人类视频预训练的可行性、无需任务特定选点、动作重定向都建立在'一切皆 3D 点轨迹'之上。
动作重定向(action retargeting)
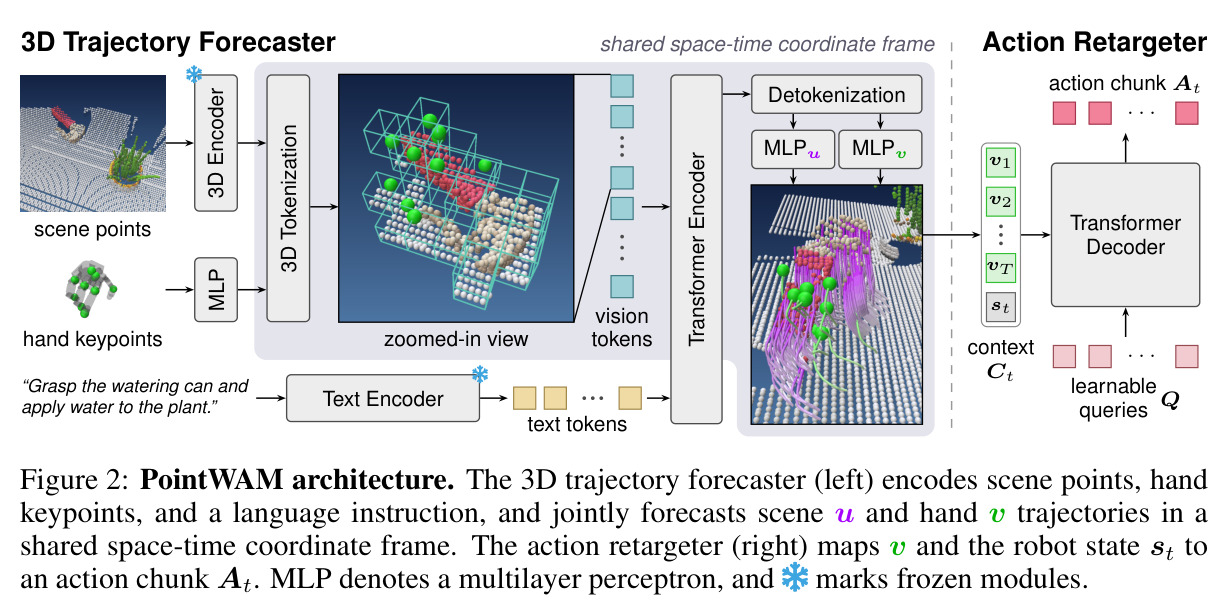
把预测的手部关键点轨迹转换为具体机器人动作的过程。本文不求解逆运动学,而是训练一个小型 transformer 解码器:以每步手部位移特征加步嵌入、再拼上机器人状态嵌入作为上下文 $C_t$,用可学习动作查询 $Q\in\mathbb{R}^{T\times d_r}$ 自注意力加交叉注意力,并行解码出 30 步动作块(末端位姿 + 手指关节目标)。
PointWAM 把动作预测与轨迹预测解耦,重定向器是连接'本体无关的手部运动'与'具体机器人控制'的桥梁,也是它能跨 embodiment 迁移(如换成平行夹爪)的关键组件。
体素 Tokenization(Volt 风格)
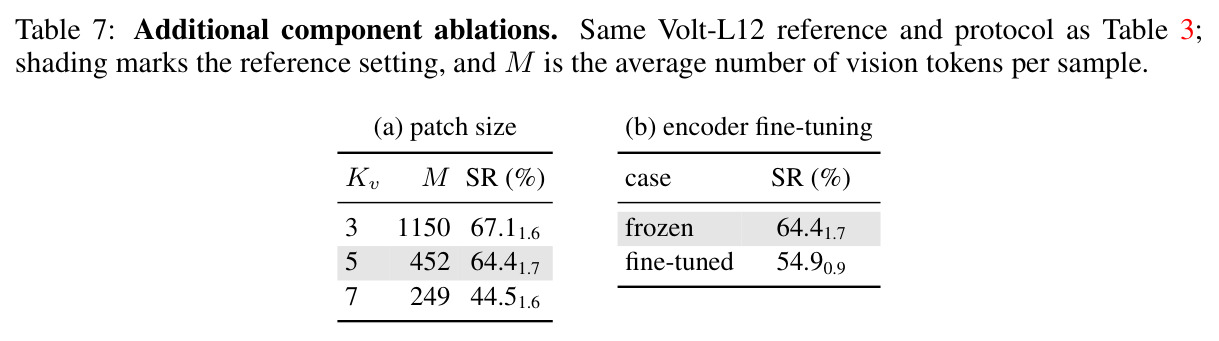
将点云放到 1cm 体素网格上,先用稀疏卷积 stem(3³ 卷积 + 两个残差块)为每个占据体素提取局部特征,再把每个非空 patch($K_v{=}5$,即 5cm 见方)内的体素特征按固定空间顺序拼接、线性投影为一个视觉 token,送入带轴向 3D 旋转位置编码的全局自注意力 transformer;解码时用保存的映射把 token 特征还原回每个点。
理解输入如何从无序点云变成 token 序列、输出又如何经 detokenizer 还原为逐点特征,是读懂 3D 轨迹预测器架构与消融(体素大小、patch 大小)的前提。
视频点跟踪 + 单目深度提升
从人类视频自动提取 3D 轨迹监督的流水线:用 CoTracker3 在 640×360 帧上每隔一个像素放置查询点做稠密 2D 点跟踪;用 VGGT-Ω 预测仅有尺度不确定性的单目深度,再以 ARKit 手部标注深度的中位比值恢复度量尺度,把 2D 轨迹提升为世界系 3D 轨迹,最后在 1.5cm 网格去重并最多保留 12000 点。
本文 1.15M 条人类演示的场景轨迹监督全部由此自动产出、无需人工标注,这是其大规模预训练数据引擎的核心,也是理解预训练为什么有效的关键。
研究动机
灵巧操作要求多根手指在物体表面精确协调三维运动,是机器人学习中最难的开放问题之一。现有方法各有结构性短板:传统 VLA(如 π0.5、GR00T N1.6)把观测直接映射为电机指令,不显式预测场景如何演化;已有世界动作模型多基于视频生成骨干,把世界表示为 RGB 帧或隐特征,难以捕捉物理交互最关键的 3D 空间结构与手—环境因果接触;点基策略(Point Policy、Dexterous Point Policy)虽预测 3D 关键点轨迹,却不建模环境演化,还依赖人工或外部分割模型挑选任务相关物体;动作条件 3D 世界模型(PointWorld、PointZero)虽预测稠密场景轨迹,却把机器人动作当作输入而非预测目标,需要额外规划器。其后果是基准成功率极低:DexJoCo 的双手 assembly 任务此前没有任何策略超过 5.3% 成功率。
本文的目标是本文要构建一个 3D 世界动作模型 PointWAM,在统一框架内同时回答'世界将如何变化'与'机器人该做什么'。具体目标:给定语言指令、彩色点云与机器人状态,模型在共享时空坐标系中同时预测场景中每个点与双手 20 个关键点的未来 3D 位移轨迹,再把预测手部轨迹重定向为 30 步机器人动作块。作者还设定了三项能力目标:一是可直接在 115 万条人类演示视频(EgoDex 与 VITRA)上预训练,因为人类视频与机器人数据可表达为完全相同的'场景+手部点轨迹'格式;二是无需预先挑选任务物体或关键点,场景预测覆盖全部观测点;三是预测的手部运动与场景解耦,可重定向到不同灵巧手甚至平行夹爪。
与已有工作不同的是,本文的独特切入点是'分解 + 统一':把世界显式分解为场景(环境)与手(actor),并用同一种 3D 点轨迹语言在共享时空坐标系中描述二者,让模型通过学习两组点的共演化来捕捉手—环境因果关系。与最近工作的区别在于:EgoWAM 虽联合学习场景预测与动作预测,但把人手映射为平行夹爪的 6-DoF 位姿加开合指令,丢失了手指运动;PointWorld/PointZero 预测场景运动却不预测动作,依赖单独的规划器或根本不做控制;3PoinTr 从人类视频预测场景轨迹但需另训一个策略来出动作。PointWAM 用单个骨干网络预测全部场景点与手部关键点轨迹,重定向器直接把预测轨迹变成动作,且以 3D 原生 Mosaic3D 特征而非提升的 2D 图像特征编码场景。
核心方法
直觉上,'看懂手该怎么动'的最好方式是先'看懂世界会怎么动':若模型能预测场景每个点与手指关键点在 3D 空间中的共同演化,手部轨迹就天然携带接触与抓取的几何信息,再翻译成机器人指令即可。技术路线:输入为 RGBD 点云 $P_t$、每手 10 个关键点 $Q_t$ 与语言指令 $\ell$。冻结的 Mosaic3D 编码器为每个场景点提取几何+语义特征,MLP 把关键点索引 one-hot 加手部 ID 映射为同维特征;所有特征放到 1cm 体素网格,经稀疏卷积 stem 与 Volt 式 patch tokenize 成视觉 token,与冻结 Recap-CLIP 的指令 token 拼接后进入带轴向 3D 旋转位置编码的 transformer。输出经 detokenizer 还原为逐点特征并与 stem 特征残差融合,再由两个 MLP 头分别预测场景位移 $U_t$ 与手部位移 $V_t$,即 $(U_t, V_t) = f(P_t, Q_t, \ell)$;最后由动作重定向器把预测轨迹与状态映射为动作块 $A_t = g(V_t, s_t)$。
核心创新是把世界建模与动作建模统一到同一种 3D 点轨迹表示,并通过显式分解场景与手实现人类视频预训练。三个关键点:其一,人与机器人手都映射为语义对应的 10 关键点(6 掌部点 + 4 指尖点,人手按 $q^{(k)}_t = o_t + B_t d^{(k)}$ 把机器人掌部偏移放到人手掌坐标系),使 EgoDex/VITRA 的人类演示与 DexJoCo 机器人演示具有完全相同的监督格式,预训练不需要任何机器人数据;其二,场景轨迹为每个观测点预测未来位移,无需人工或外部模型挑选任务物体,且场景监督(仅训练用,不进重定向器)迫使共享骨干学习手与场景如何共演化——这比单纯'3D 观测'多带来 10.9 个百分点成功率;其三,预测的手部轨迹是本体无关的中间动作表示,轻量 transformer 解码器即可重定向为不同机器人的动作,换本体时轨迹预测器完全不动。
方法步骤详情
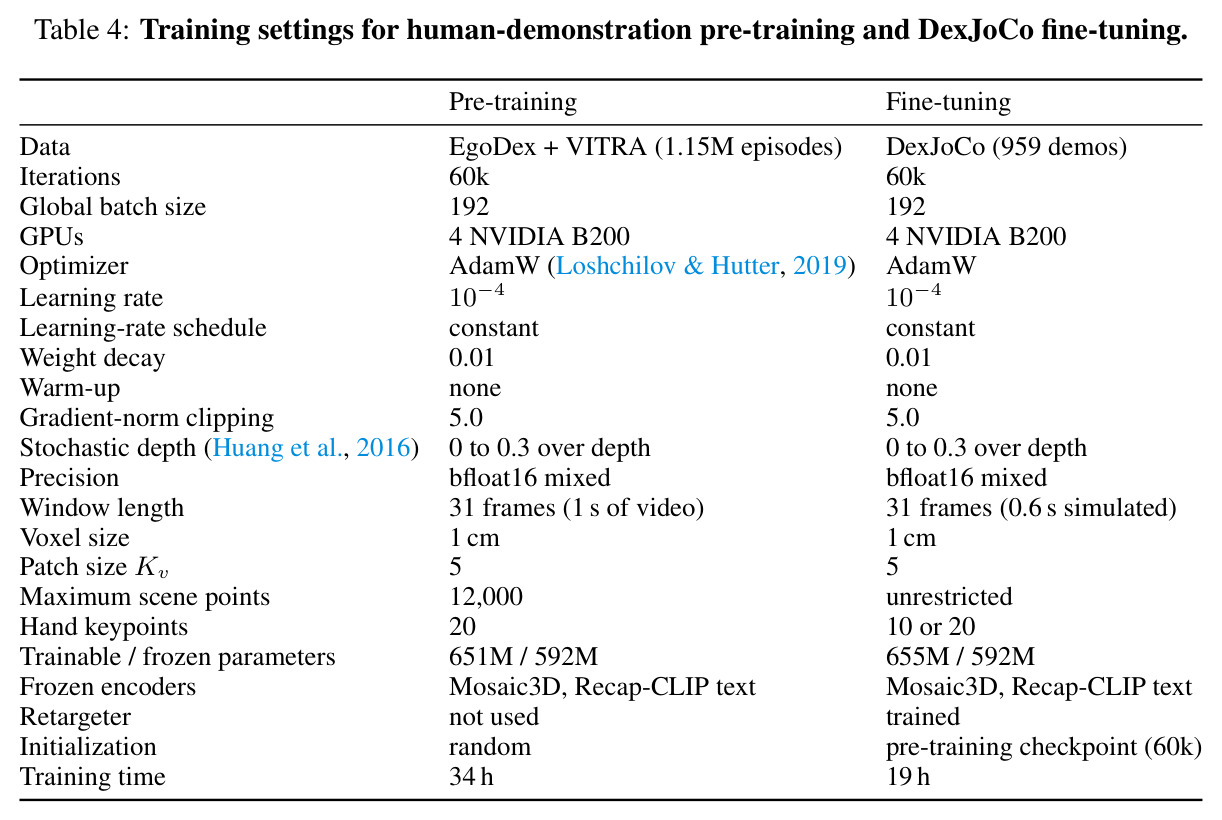
训练分两阶段。第一步人类视频预训练:把 EgoDex 与 VITRA 标注/重建的人手映射为机器人手的 10 关键点——6 个掌部偏移按 $q^{(k)}_t = o_t + B_t d^{(k)}$ 放入人手掌坐标系、4 个指尖取自跟踪的指尖位置;场景轨迹用 CoTracker3 做稠密 2D 跟踪,经 VGGT-Ω 单目深度(以手部标注恢复尺度)提升到 3D;视频切成 1 秒 31 帧片段,共得 1,148,324 条 episode。第二步机器人微调:手部轨迹来自正运动学,场景轨迹来自重放 DexJoCo 演示;损失为 $\mathcal{L}_{robot} = \mathcal{L}_{traj} + \lambda\|A_t - A^*_t\|_1$($\lambda{=}1$),场景用按运动加权的 MSE、手部用 MSE。主模型 Volt-H(32 层、6.55 亿可训练参数)在 4 块 B200 上预训练与微调各 6 万步。重定向器为 2 层 transformer 解码器,并行输出 30 步动作,每臂 22 维(末端位姿 + 16 指关节)。
技术新颖性
技术新颖性体现在四个层面。表示层面:现有 WAM 预测 RGB 帧、隐特征或 2D 点轨迹(FLARE、Track2Act 等),PointWAM 首次把'场景全点 + 手部关键点'的 3D 位移轨迹作为世界与动作的统一语言,并在同一时空坐标系中联合预测二者的共演化。数据层面:与 Point Policy/Dexterous Point Policy 依赖人工选点或外部分割不同,其场景监督覆盖全部观测点,由 CoTracker3+VGGT-Ω 全自动产出,首次在百万级人类视频上完成无任务特定标注的 3D 世界动作预训练。结构层面:3D 原生 Mosaic3D 特征经体素 tokenize 进入 transformer,消融显示比提升的 DINOv3 特征高 5.4 个百分点,说明 3D 结构必须编码进特征本身而非只写在坐标里。解耦层面:场景头仅作训练监督信号不进控制器,手部轨迹作为本体无关的中间动作表示,重定向器仅约 460 万参数,可跨 embodiment 复用——在平行夹爪的 RoboDojo-Precision 上仅改关键点布局与动作维度即完成迁移。
实验结果
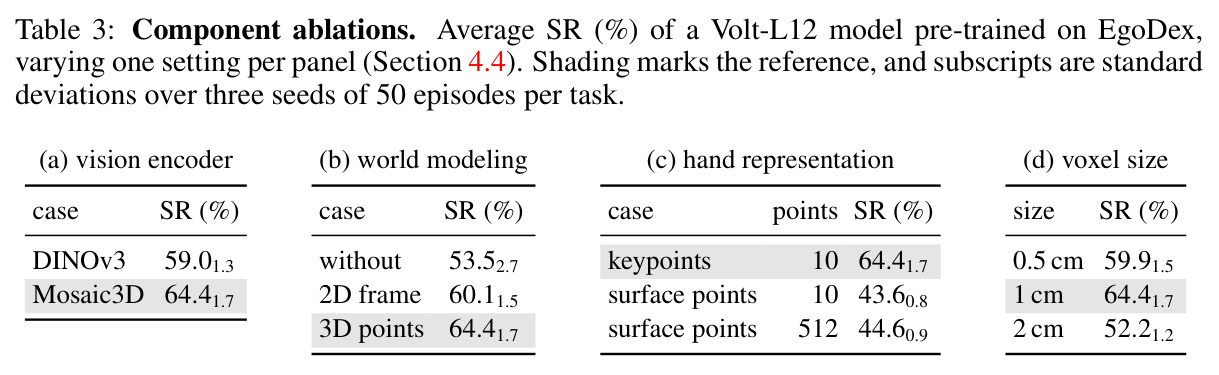
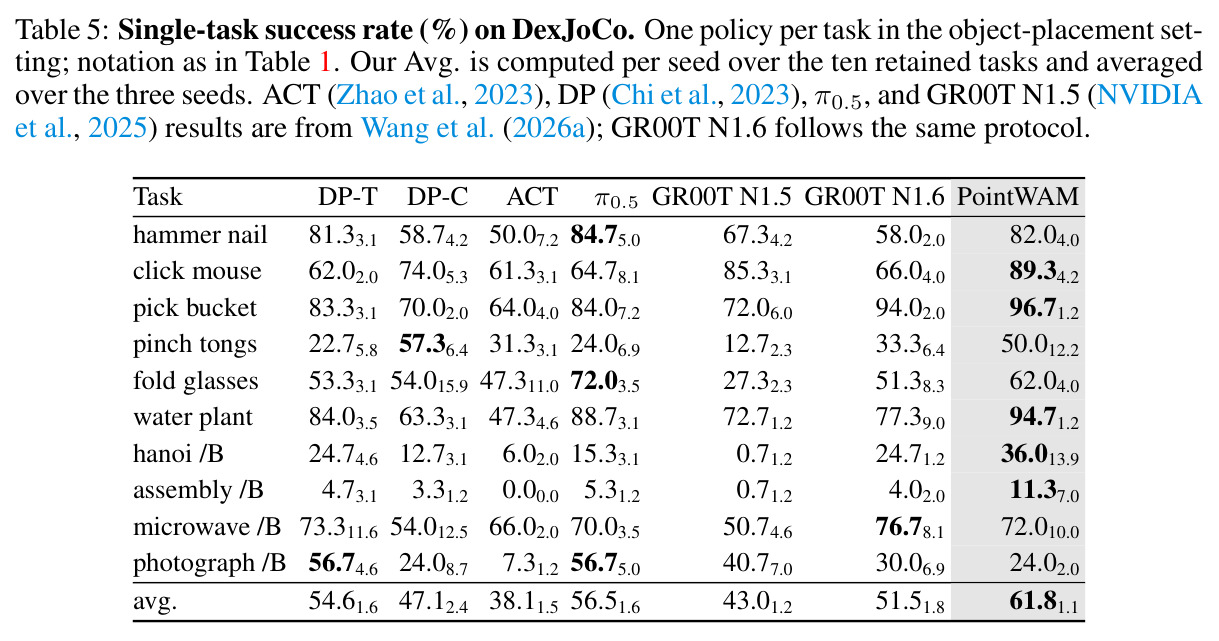
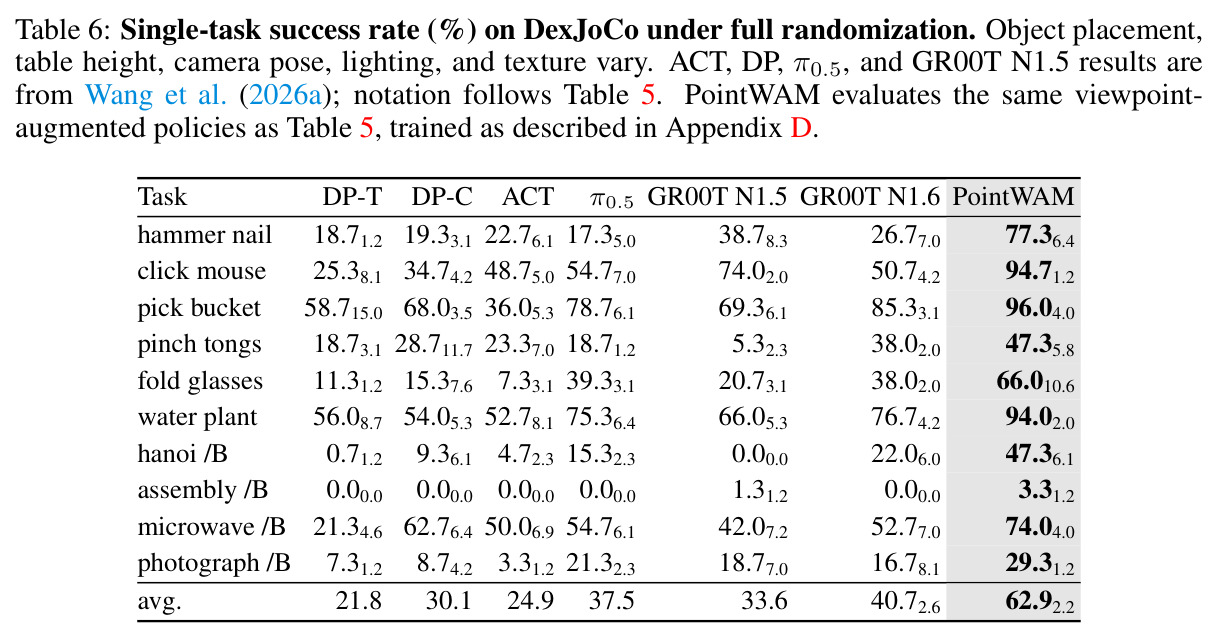
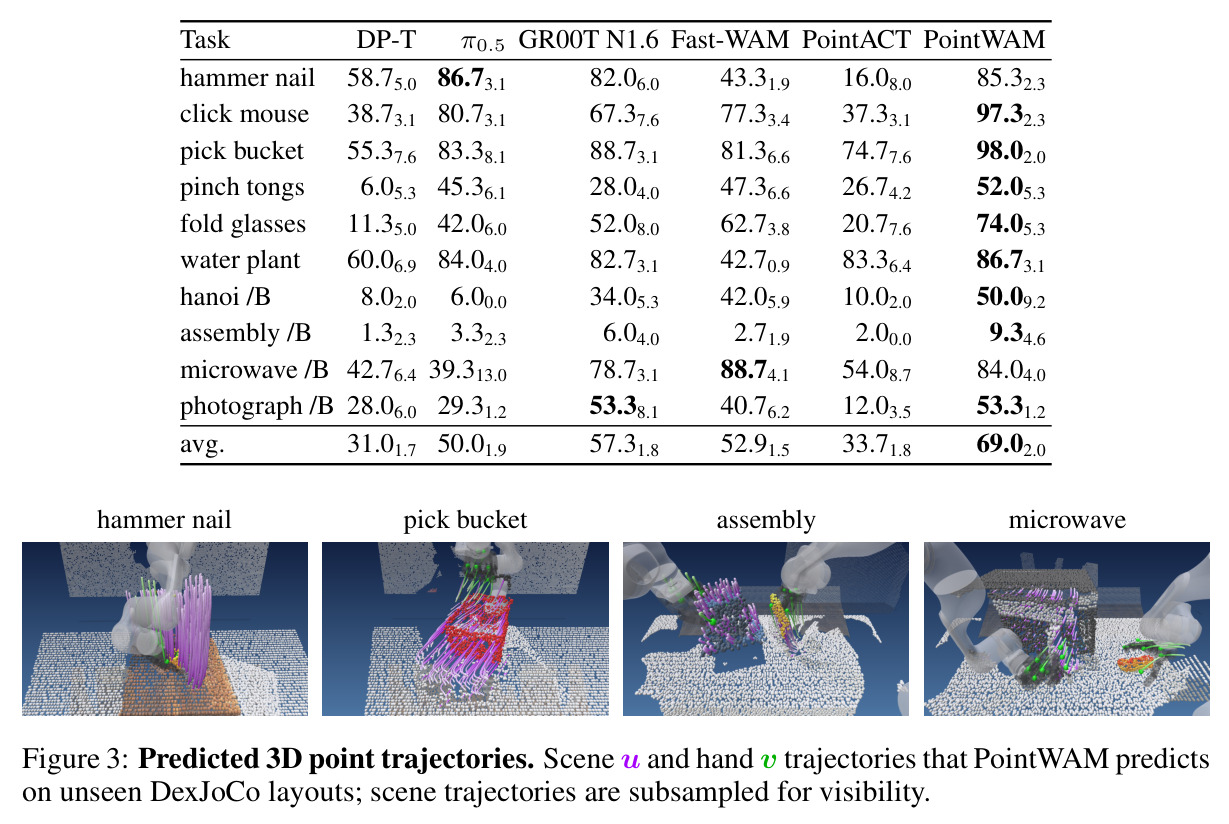
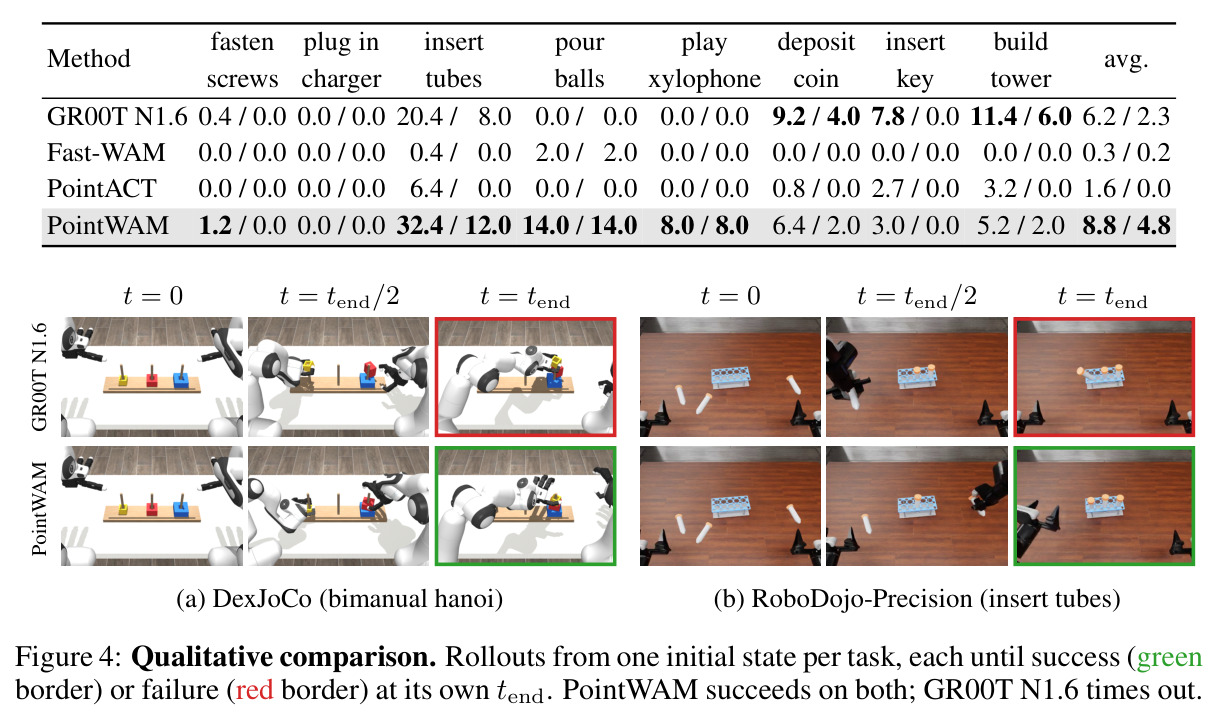
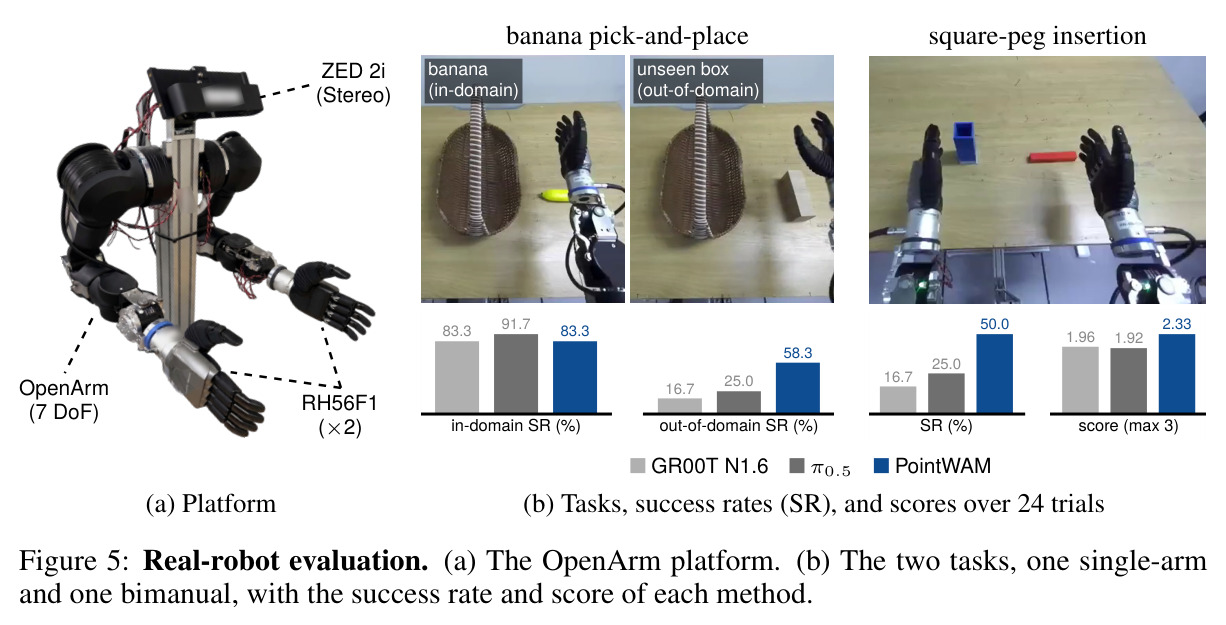
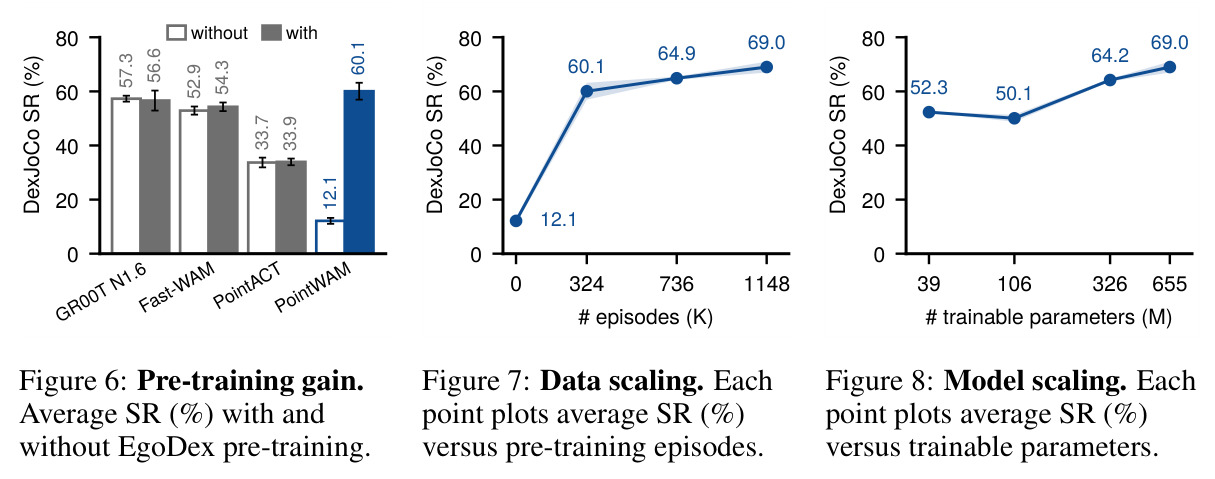
主实验回答三个问题。第一,与最强方法对比:DexJoCo 十任务多任务协议下 PointWAM 平均成功率 69.0%,领先最强基线 GR00T N1.6(57.3%)11.7 分、π0.5(50.0%)19 分,十个任务中八个第一;完全随机化下单任务平均 62.9% 且十任务全第一,基线掉 9.4–32.8 分。第二,预训练价值:从零训练仅 12.1%,经 115 万条人类视频预训练升至 69.0%(+56.9 分);基线几乎不受益(变化不超过 1.4 分);数据 324K→1.15M 时成功率 60.1→69.0%,参数 39M→655M 时 52.3→69.0%。第三,3D 世界建模的必要性:去掉场景轨迹监督从 64.4% 降至 53.5%(−10.9 分),2D 隐特征预测仅 60.1%;10 关键点手表示(64.4%)远优于表面采样点(43.6/44.6%)。真机上域外香蕉盒抓放 58.3% 对 π0.5 25.0%,方形插销 50.0% 对 25.0%/16.7%;平行夹爪基准上得 8.8 分/4.8%,仍高于 GR00T N1.6 的 6.2/2.3%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DexJoCo 十任务多任务策略 | 成功率 SR (%) | 69.0 | GR00T N1.6 57.3(最强基线);Fast-WAM 52.9;π0.5 50.0;PointACT 33.7;DP-T 31.0 | +11.7 pp(对最强基线) |
| DexJoCo 单任务 + 完全随机化 | 成功率 SR (%) | 62.9 | GR00T N1.6 40.7 | +22.2 pp,十个任务全部第一 |
| RoboDojo-Precision 八任务(平行夹爪跨本体) | 进度分 / 成功率 (%) | 8.8 / 4.8 | GR00T N1.6 6.2 / 2.3;PointACT 1.6 / 0.0;Fast-WAM 0.3 / 0.2 | +2.6 分 / +2.5 pp |
| 真机香蕉抓放(域外颜色相近的未见盒子) | 成功率 SR (%) | 58.3 | π0.5 25.0;GR00T N1.6 16.7 | +33.3 pp(对 π0.5) |
| 真机方形插销插入(双臂精密协作) | 成功率 SR (%) / 进度分(满分3) | 50.0 / 2.33 | π0.5 25.0 / 1.92;GR00T N1.6 16.7 / 1.96 | +25.0 pp(对 π0.5) |
| 人类演示预训练增益(DexJoCo 平均) | 成功率 SR (%) | 12.1 → 69.0(EgoDex+VITRA 预训练) | GR00T N1.6 57.3→56.6;Fast-WAM 52.9→54.3;PointACT 33.7→33.9 | +56.9 pp,基线最多 ±1.4 pp |
| 场景轨迹监督消融(Volt-L12) | 成功率 SR (%) | 64.4(3D 点轨迹世界建模) | 无场景监督 53.5;FLARE 式 2D 帧预测 60.1 | +10.9 pp / +4.3 pp |
| 3D 编码器消融 | 成功率 SR (%) | 64.4(Mosaic3D 原生 3D 特征) | DINOv3 提升至 3D 点的 2D 特征 59.0 | +5.4 pp |
局限与改进
作者承认的局限:模型只通过点感知世界,会漏掉比点间距更细的细节(如物体上印刷的文字),也无法感知深度传感器拍不到的透明表面;体素粗于 1cm 会模糊接触几何(2cm 时 SR 从 64.4% 掉到 52.2%)。我的补充观察:其一,重定向器纯靠模仿学习,不施加显式关节限位与碰撞约束,分布外的手部轨迹可能诱导不可行动作;其二,双手 assembly 成功率仍只有 9.3%,长时程精密双臂协作远未解决,bimanual photograph 单任务仅 24.0% 落后于多个基线;其三,人类数据的场景轨迹依赖 CoTracker3 跟踪与单目深度估计,跟踪/深度误差会直接进入监督信号,且点对应只在 1 秒片段内有效;其四,推断延迟不小(Volt-L12 单次前向 55ms,其中冻结编码器占 37ms),在 DexJoCo 异步评测协议下会影响实际执行行为;其五,预训练需 4 块 B200 训练 34 小时,复现门槛高;此外基准还剔除了重放即失败的 bimanual unlock iPad 任务(100 条演示中 42 条重放失败)。
独立分析的弱点
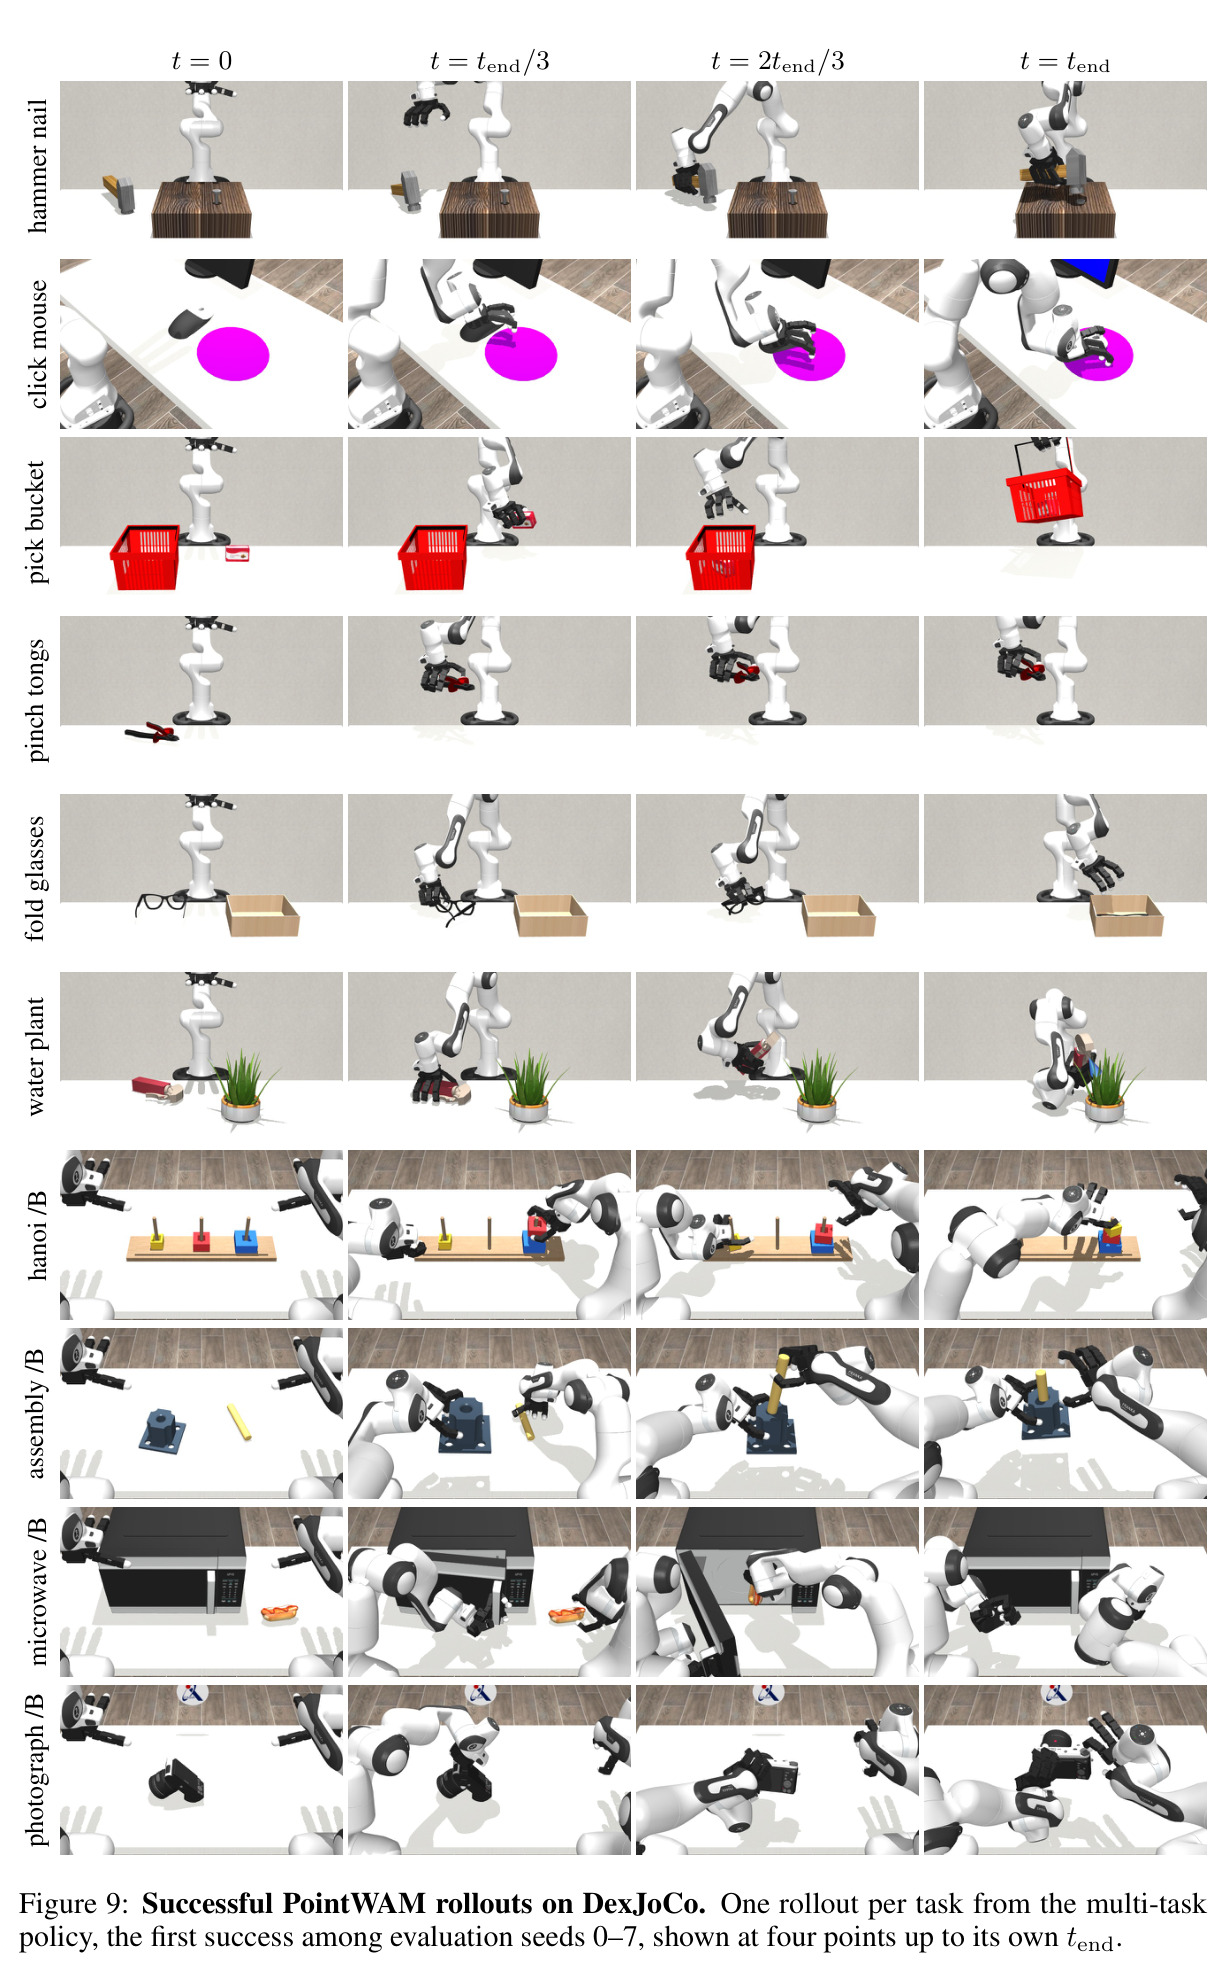
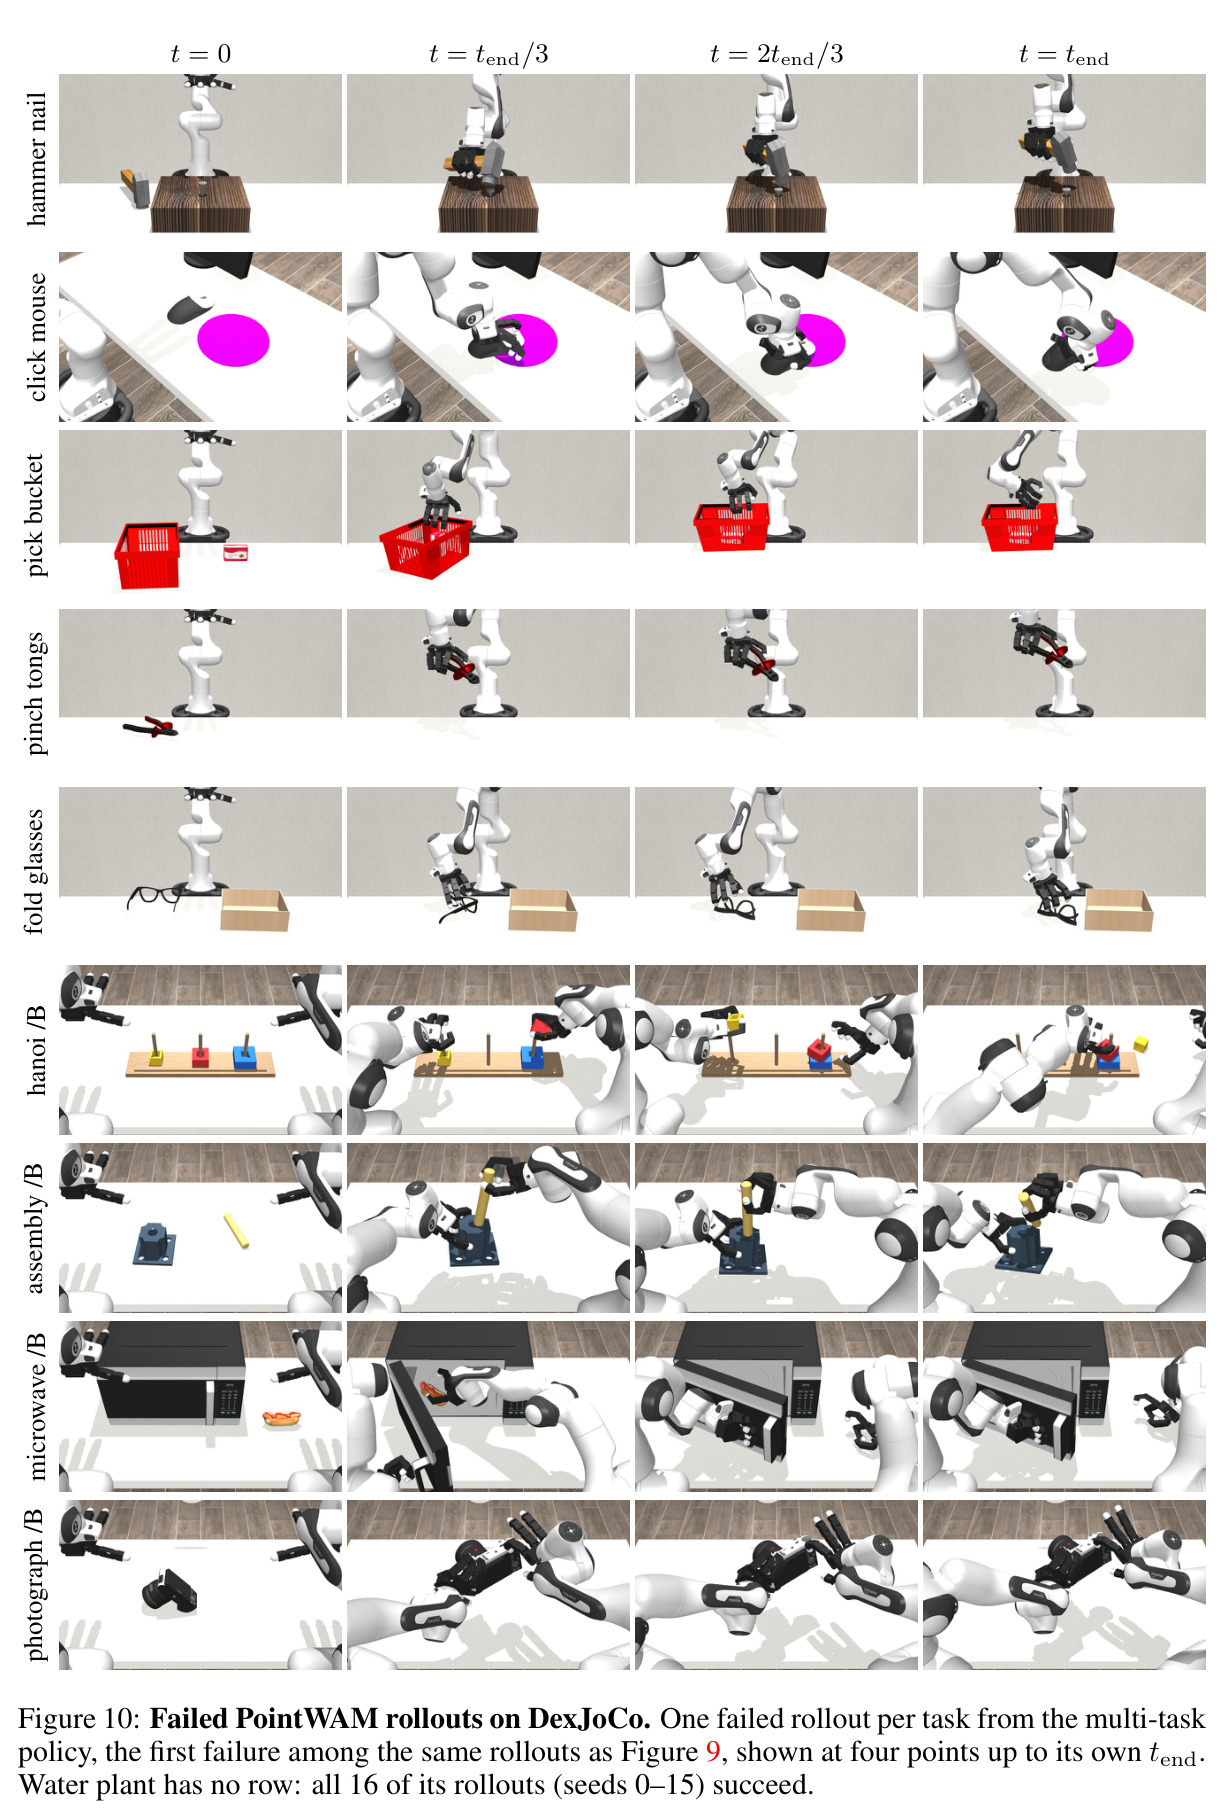
独立分析的弱点与改进方向:1)点表示的分辨率瓶颈——224×224 深度输入加 1cm 体素限制了可感知的最小几何细节,透明/反光物体直接失效;可引入多视角深度融合或隐式表面表示(SDF/高斯泼溅)作为点云的补充。2)重定向器的模仿局限——它学习的只是演示中记录的动作分布,没有动力学约束,遇到与演示差异大的预测轨迹可能输出抖动或超限动作;可加入可微运动学限位与碰撞损失,或蒸馏一个 IK 求解器。3)场景监督质量链过长——CoTracker3 跟踪→VGGT-Ω 深度→尺度恢复的每一步都有误差并被当作真值监督;可用跟踪置信度加权或多跟踪器一致性过滤。4)模型 Scaling 非单调——Volt-B(106M)50.1% 反而低于 Volt-S(39M)52.3%,暗示中等规模训练不稳定或容量与数据量不匹配,值得研究正则化与数据配比。5)失败模式集中于'最后一步'——多数失败是抓住了物体却停在最后动作前(锤子悬在钉上、插销停在孔旁),说明缺乏接触力反馈与目标达成验证机制,可引入触觉或基于预测轨迹的达标检查。
未来方向
作者明确提出的方向:把每个点携带的信息从外观扩展到质量、摩擦等物理属性,因为它们决定物体在接触下如何运动。基于本文成果可延伸的研究:1)把人类视频预训练语料从 115 万条扩展到互联网级并研究课程学习——数据 Scaling 曲线(60.1→69.0%)尚未饱和;2)让预测的 3D 轨迹在推理时发挥作用,例如用于模型预测控制、轨迹筛选或反事实推演,而不仅作为训练监督;3)与触觉/力传感融合,弥补纯几何点无法感知接触力的缺陷,直击'最后一步'失败模式;4)扩展到非刚性物体、流体与更长时程的工具使用任务;5)统一灵巧手与夹爪的动作空间,训练单一模型跨 embodiment 服务;6)在 3D 点轨迹空间引入生成式建模(如扩散头),支持多模态策略与不确定性感知的规划。
复现评估
复现披露非常充分:附录 B 给出人类/机器人数据预处理全部公式(人手关键点映射 $q^{(k)}_t = o_t + B_t d^{(k)}$、损失加权 $sigmoid(5(\delta/0.005-1))$ 等),Table 4 列出完整超参(AdamW、lr $10^{-4}$、batch 192、bfloat16 等),附录 C 提供三个基线的复现配置并附 GR00T/Fast-WAM/PointACT 官方代码链接;所用数据集 EgoDex、VITRA、DexJoCo、RoboDojo 均公开。算力门槛较高:主模型(Volt-H,6.55 亿可训练参数)预训练加微调共需 4 块 NVIDIA B200 约 53 小时,消融矩阵还需多轮 Volt-L12(1.75 亿参数)训练。项目页 chrockey.github.io/PointWAM 提供可视化与视频,论文文本未明确声明代码开源。总体评估:复现难度中高——拥有 GPU 集群的团队可以复现主结果,但数据预处理流水线(点跟踪、深度提升、仿真重放生成场景轨迹)环节多、工程量大,是最耗时的部分。
论文图表
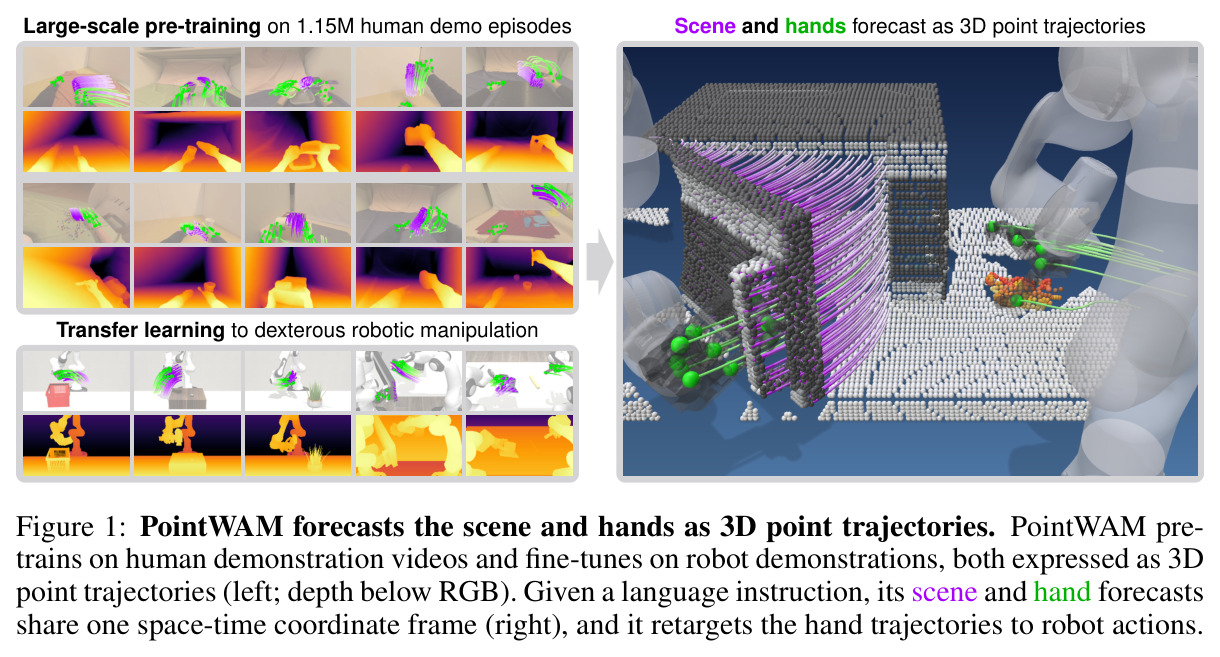
概览图。左侧展示模型先在 115 万条人类演示视频(RGB+深度)上预训练、再在机器人演示上微调,两种数据都以相同的'场景+手部 3D 点轨迹'格式表达;右侧给出推理流程:给定语言指令,场景与手部的预测共享同一时空坐标系,预测的手部轨迹最终被重定向为机器人动作。
一图概括论文的核心表示(场景与手统一为 3D 点轨迹)、数据来源(大规模人类视频)与两阶段训练—推理流程,是理解全文逻辑的入口。
DexJoCo 十任务多任务策略成功率主表:PointWAM 平均 69.0%,在八个任务上第一(hammer nail 85.3%、click mouse 97.3%、pick bucket 98.0%、pinch tongs 52.0%、fold glasses 74.0%、water plant 86.7%、hanoi 50.0%、microwave 84.0%);对比 DP-T 31.0%、π0.5 50.0%、GR00T N1.6 57.3%、Fast-WAM 52.9%、PointACT 33.7%。
核心主结果表,量化'领先最强基线 11.7 个百分点'的主张,并展示各任务上的具体强弱分布。
平行夹爪 embodiment 的八个精密任务结果(进度分/成功率):PointWAM 平均 8.8 分/4.8%,GR00T N1.6 为 6.2/2.3%,PointACT 1.6/0.0%,Fast-WAM 0.3/0.2%;PointWAM 在 insert tubes(32.4/12.0)、pour balls(14.0/14.0)、play xylophone(8.0/8.0)等任务上明显领先。
证明点轨迹表示可跨本体迁移:仅用人类手预训练的模型在平行夹爪上仍胜过用大规模机器人数据预训练的 GR00T N1.6,且深度输入本身不能解释其优势。