AffordanceWAM:面向机器人操作的可供性感知世界-动作联合建模 AffordanceWAM: Affordance-Aware Joint World-Action Modeling for Robot Manipulation
以可供性为共享交互表征,让无动作标注的人类视频促进机器人操作学习
前置知识
世界动作模型
一类在统一框架内同时预测未来观测与机器人动作的生成模型。与先建视频模型再接策略的两段式方案不同,WAM 用共享主干联合建模场景演化与控制信号,使无动作标注的视频也能通过世界预测分支参与训练。现有设计包括耦合的视频-动作扩散模型和视觉/动作 token 自回归模型,近期工作多基于预训练视频骨干或大规模因果视频-动作预训练。
AffordanceWAM 是 WAM 的直接扩展,理解其「共享世界预测 + 动作生成」框架是读懂本文双专家架构与掩码联合注意力的前提。
流匹配
一种生成建模方法:学习一个速度场,把高斯噪声连续输运到数据分布。给定干净目标 $y_0$、噪声 $\epsilon$ 和流时间 $\tau\in[0,1]$,线性插值 $y_\tau=(1-\tau)y_0+\tau\epsilon$,训练速度预测器拟合目标速度 $u=\epsilon-y_0$,生成时从 $\tau=1$ 积分回 $\tau=0$。相比扩散模型的随机过程更简洁,采样步数可控。
本文未来世界的三个流(RGB、Scalar Affordance、Affordance Heatmap)和连续动作块全部用流匹配训练与采样,总损失、两阶段课程与推理的「联合生成+精修」流程都建立在这一公式之上。
可供性
源自 Gibson 的生态心理学,指物体向智能体提供的交互可能性。在机器人操作中通常表示为接触点、交互轨迹或密集场:给定语言指令,标出应该碰哪里、往哪里动。它只描述任务相关的交互结构,不绑定具体本体的运动指令,因此人类和机器人可以共享同一套可供性语义,天然适合做跨本体的中间表征。
可供性是本文的核心表征:Scalar Affordance 和 Affordance Heatmap 是被生成的「未来世界」的组成部分,也是人类-机器人迁移得以成立的桥梁,消融证明没有它人类数据反而有害。
扩散 Transformer
以 Transformer 为骨架的扩散/流匹配生成模型,通过堆叠的自注意力块对噪声化 latent 迭代去噪。视频 DiT 在大规模视频上预训练后具备强大的时序动态与外观先验,常作为世界模型的初始化骨干,可显著降低训练成本并提升生成质量。
本文 World Expert 从预训练视频 DiT Wan2.2-TI2V-5B 初始化,Action Expert 是同层数(30 层)的 DiT;两个专家的耦合发生在对应 Transformer 层的联合注意力中,层间特征交换是方法的关键机制。
跨本体迁移
让在一个本体(如人手)上获得的经验帮助另一个本体(如机械臂)学习的问题。核心困难在于动作空间、形态和视角的差异:直接把人类运动重定向为机器人动作,要求高质量的动作恢复与形态匹配,例如 EgoScale 仍依赖重定向的手腕与手部动作加人机对齐中训练,误差会随任务复杂度放大。
本文的动机就是把迁移从「动作空间」挪到「交互空间」:人类视频不提供任何动作标签或伪动作,只通过共享可供性监督塑造世界表示,这是与重定向路线的本质分野。
RoboCasa 与 CALVIN 基准
机器人操作的两个标准仿真基准。RoboCasa 评估多样化家庭环境中的任务特定操作,本文用 24 个任务、每任务 300 条演示做下游适配并报告平均成功率;CALVIN ABC→D 在环境 A/B/C 上训练、在未见的环境 D 上测试,报告连续完成 1 到 5 个任务的成功率及平均完成序列长度,衡量跨环境长时程泛化。
论文的主实验、2×2 消融和数据扩展实验都基于这两个基准,理解其评测协议才能正确解读 69.4% 成功率和 4.22 平均序列长度这些数字的含义与量级。
研究动机
机器人操作学习面临尖锐的数据矛盾:动作标注的机器人演示(遥操作采集)能直接监督控制,但成本高、多样性有限;人类第一视角视频覆盖多样的物体、环境和任务,却缺少机器人动作标签,且视角、外观、本体结构都与机器人不同。早期的动作级迁移方法依赖视角、速度和行为的精确对齐,论文指出一旦缺乏这种桥梁,人类数据反而会降低性能。另一方面,现有世界动作模型(WAM)预测的未来世界表示多为 RGB 帧或视觉隐变量,只建模外观、背景运动和视角变化,把交互结构隐含在视觉特征里,语义上与动作生成目标错位,难以为跨本体迁移提供共享接口。
本文的目标是本文要构建一个可供性感知的生成式世界动作模型 AffordanceWAM,在生成的未来世界中显式表征以物体为中心的时空可供性——由 Scalar Affordance(指出任务相关交互区域的标量场)和 Affordance Heatmap(把交互区域与视觉上下文关联的热图)两个互补分量组成——使视觉预测锚定在与任务相关的物体和交互区域上,为动作生成提供语义接口。由于人类与机器人视频共享这三个未来世界流的监督目标,机器人轨迹才额外提供动作监督,从而实现无需人类动作标注、无需重定向的迁移。核心可验证假设是:可供性表征是人类交互经验转化为机器人控制能力的关键桥梁,且收益随人类数据规模增长。
与已有工作不同的是,已有工作的切入角度分三类:动作级迁移路线(如 EgoScale 依赖重定向的手腕/手部动作加对齐中训练,受人类动作恢复质量制约);RGB 或隐变量形式的 WAM(如 UWM、UVA 等只重建外观,交互结构隐式);可供性感知 VLA(把可供性当作策略输入或中间预测,而非生成世界的组成部分)。本文的独特之处在于把随时间演化的 Scalar Affordance 与 Affordance Heatmap 作为生成未来世界三个流中的两个,与 RGB 在同一流匹配目标下联合建模,让人机和器人数据在「交互空间」而非「动作空间」相遇;再配合掩码联合自注意力实现单向耦合,首次把结构化可供性预测用作世界-动作模型的中间监督与跨本体接口。
核心方法
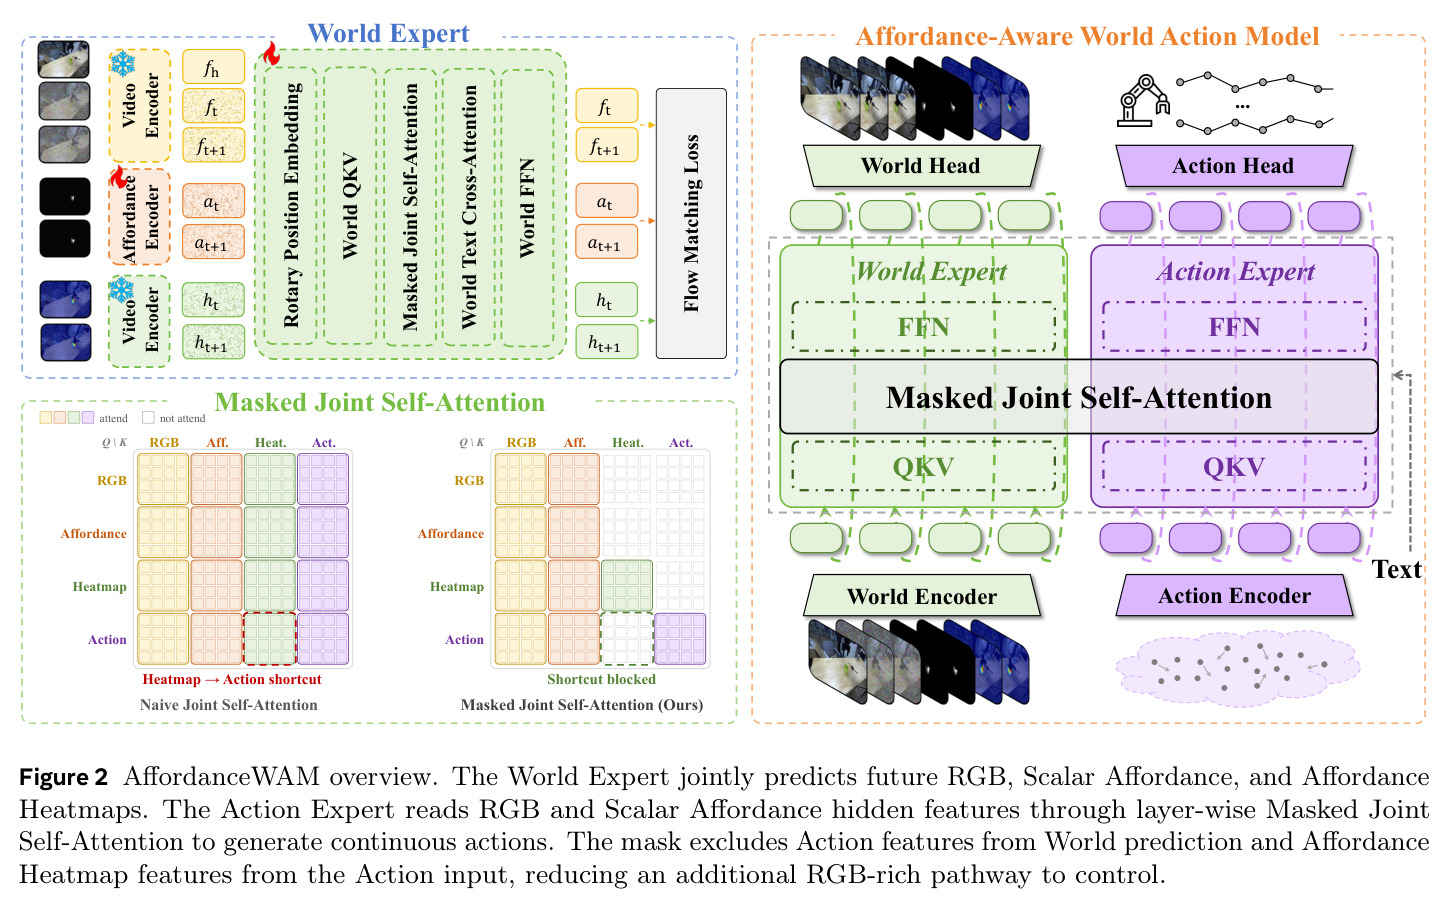
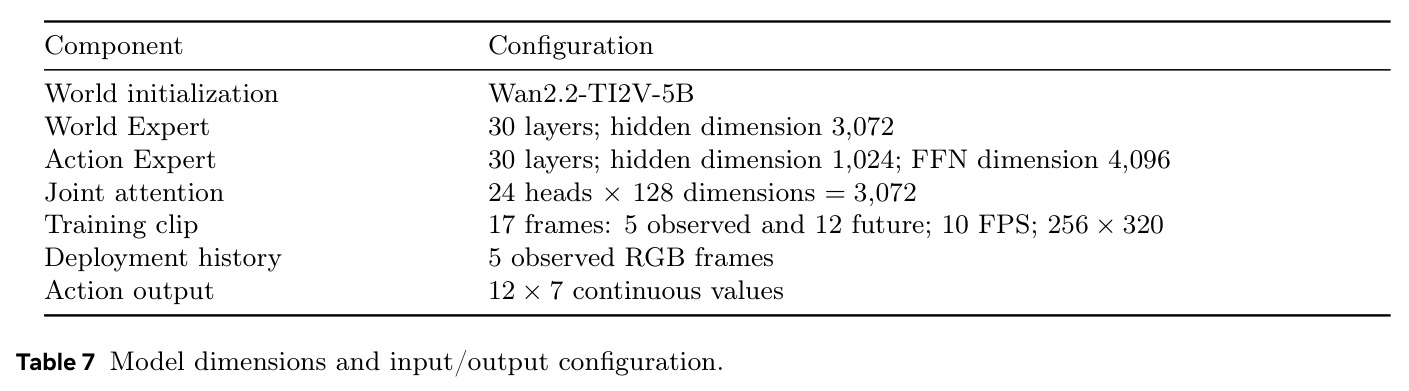
直觉上,要让无动作标签的人类视频帮到机器人,两边必须在任务相关的交互结构上共享监督,而不是在外观或动作上对齐。技术路线是双专家扩散 Transformer:World Expert 从预训练视频 DiT(Wan2.2-TI2V-5B,30 层、隐藏维 3072)初始化,以流匹配目标联合预测未来 RGB、Scalar Affordance、Affordance Heatmap 三个隐变量流;Action Expert(30 层、隐藏维 1024、FFN 4096)从每层演化的 RGB 与 Scalar Affordance 隐特征出发生成 12×7 维连续动作块。两专家在统一流匹配损失 $\mathcal{L}_{FM}=\mathbb{E}\tfrac{1}{n}\|v_\theta(y_\tau,\tau;c)-(\epsilon-y_0)\|_2^2$ 下训练,训练片段为 17 帧(5 观测+12 未来,10 FPS,256×320)。关键在于非对称监督:人类片段只更新 World Expert,机器人轨迹才额外训练 Action Expert。
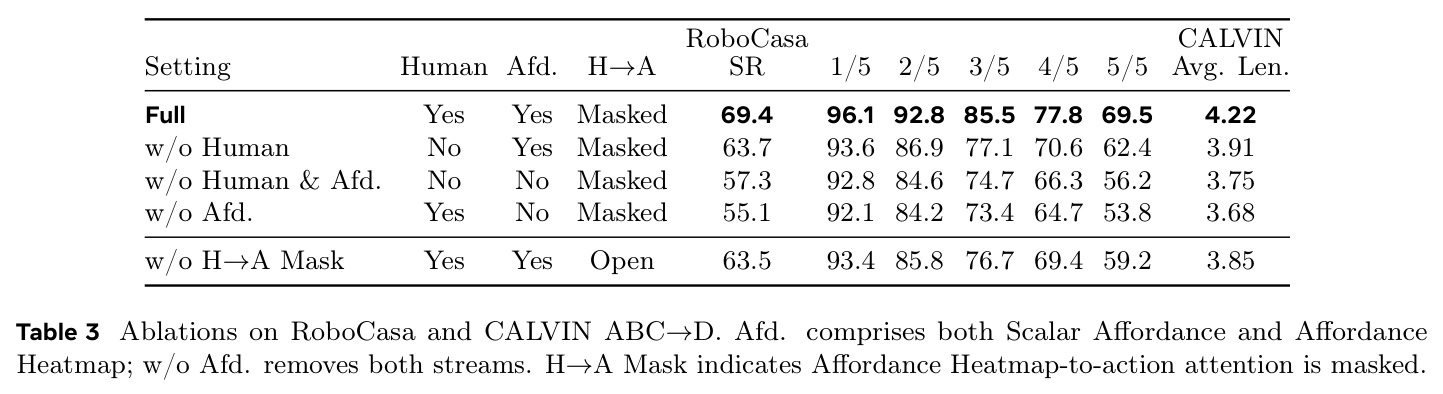
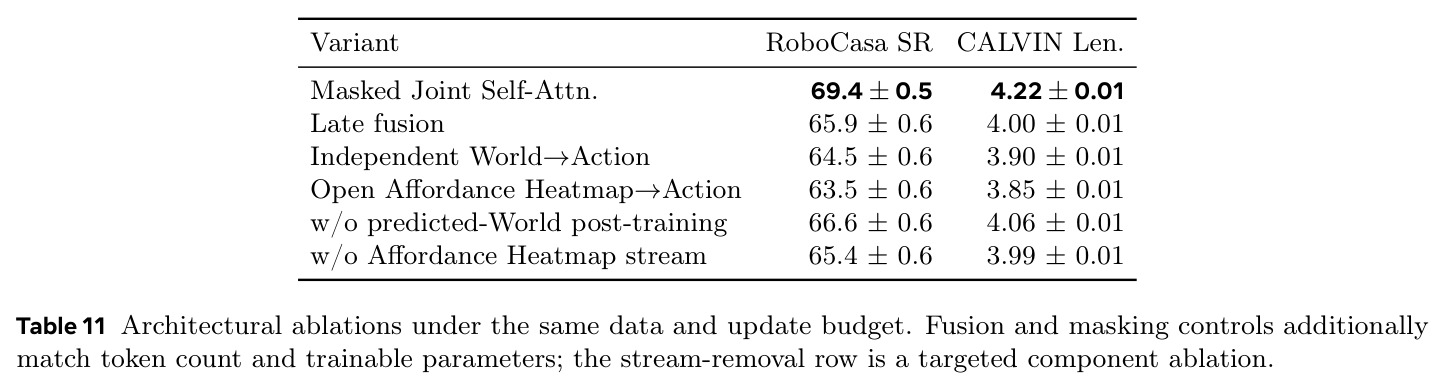
核心创新是「可供性作为世界表示 + 掩码联合自注意力」的组合。Scalar Affordance 是每帧 $F_t\in[0,1]^{H\times W}$ 的标量场,指出在何处交互但不规定本体相关运动指令,人机数据共享同一语义;Affordance Heatmap 用固定渲染函数 $M_t=\mathcal{R}(I_t,F_t)$ 把标量场叠加到对应 RGB 帧上,补充外观上下文。掩码规定:动作 token 只能读取 RGB、Scalar Affordance 和自身,不能影响世界预测,也被禁止访问 Heatmap 特征(包括经由中间特征的间接通路)——Heatmap 富含 RGB 信息,开放它形成外观捷径,实验中打开该通路使 RoboCasa 从 69.4% 跌到 63.5%、CALVIN 从 4.22 跌到 3.85。这种有向耦合让人类数据经由共享世界表示惠及控制,全程不构造任何动作 token 或伪动作目标。
方法步骤详情
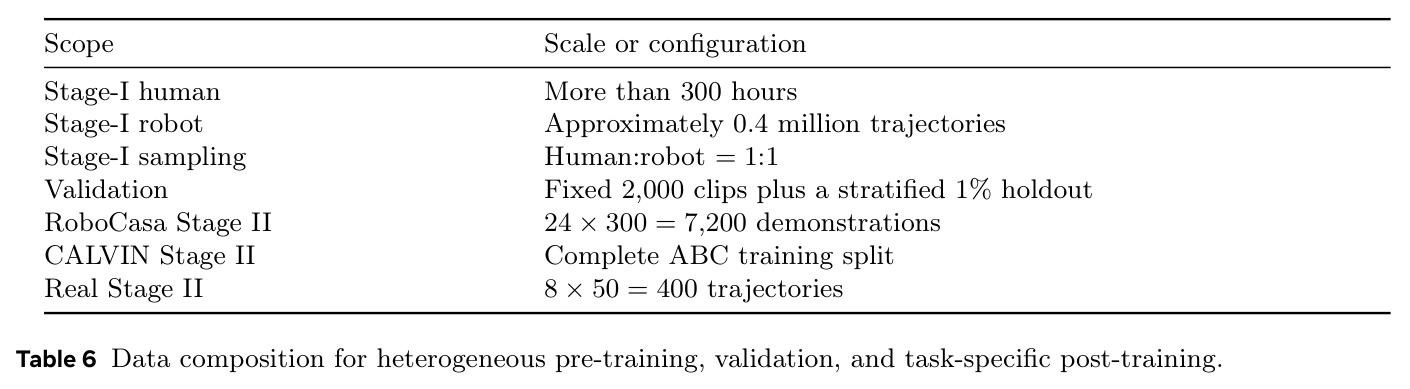
Stage I 异构联合预训练:先用源数据集的物体与交互标注高斯光栅化构造 $F_t$(缺失标注插值至多两帧),再经固定渲染得到 Heatmap;数据含 300+ 小时人类视频(Ego4D-FHO、EPIC-KITCHENS VISOR 等)与约 40 万条机器人轨迹(DROID、RH20T 等),1:1 采样。总损失 $\mathcal{L}_W=\mathcal{L}_{rgb}+\lambda_{afd}\mathcal{L}_{afd}+\lambda_{heat}\mathcal{L}_{heat}+\lambda_{rec}\mathcal{L}_{rec}$(权重 0.2/0.5/0.1),机器人另加 $\lambda_A\mathcal{L}_A=1$。课程从 World-only 预热开始,动作损失权重从 0 渐增至 1,联合路径逐步主导。Stage II 冻结完整 World 路径,仅训 Action Expert 一万步(lr $10^{-5}$),批内 75% 用随机时刻噪声世界特征、25% 用完成的预测世界。推理为 35 步联合生成加 8 步强度 0.25 的动作精修。全程 64 张 H200、BF16。
技术新颖性
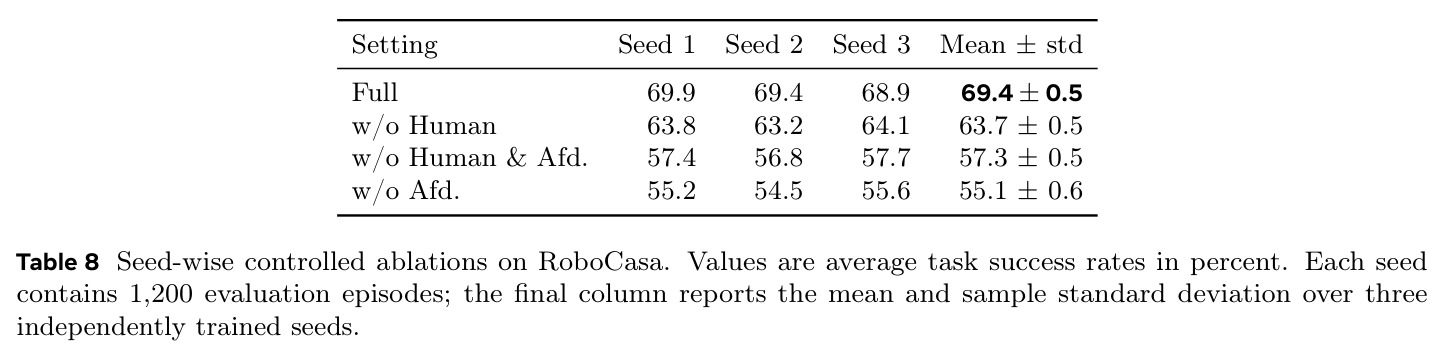
与已有方法相比有三层区别。表示层面:以往 WAM(UWM、UVA、Cosmos Policy 等)重建 RGB 或视觉隐变量,可供性研究多把交互线索当作 VLA 的输入或辅助预测;本文把时空演化的双分量可供性当作生成世界的显式组成部分,交互结构从隐式特征变成预测目标。监督层面:人类视频监督全部三个世界流但不构造动作,其收益只能通过 World 表示与动作生成的耦合传导,2×2 消融显示该机制造成符号反转(无可供性时人类数据有害:57.3%→55.1%;有可供性时有益:63.7%→69.4%)。架构层面:双专家在对应层共享注意力空间但用独立 QKV 投影,掩码同时切断动作→世界信息流和 Heatmap→动作旁路,消融显示优于 late fusion(65.9%/4.00)与独立级联(64.5%/3.90)两种融合设计。
实验结果
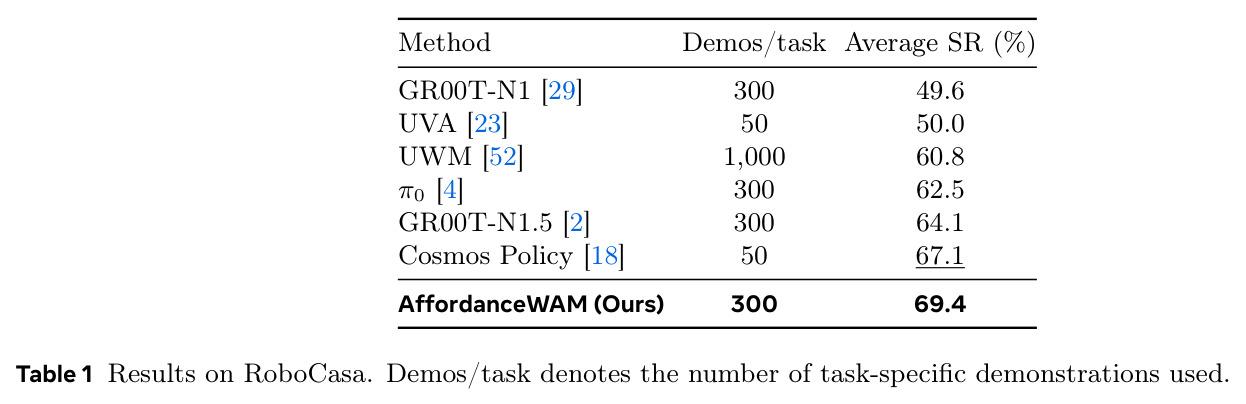
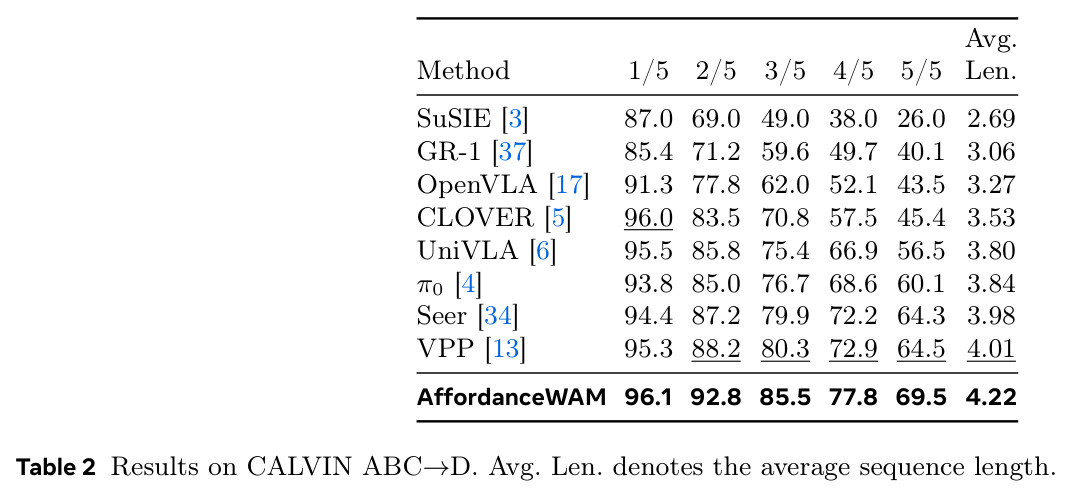
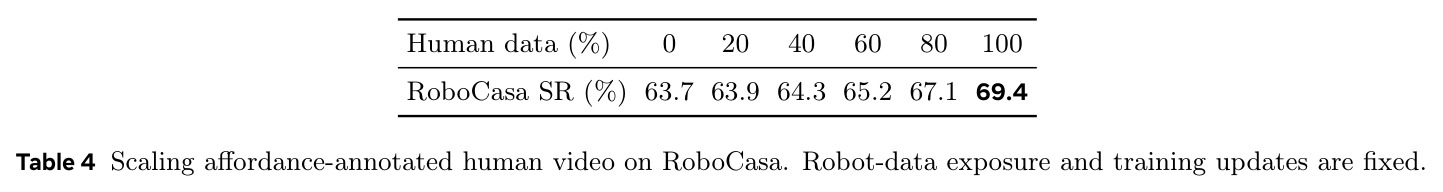
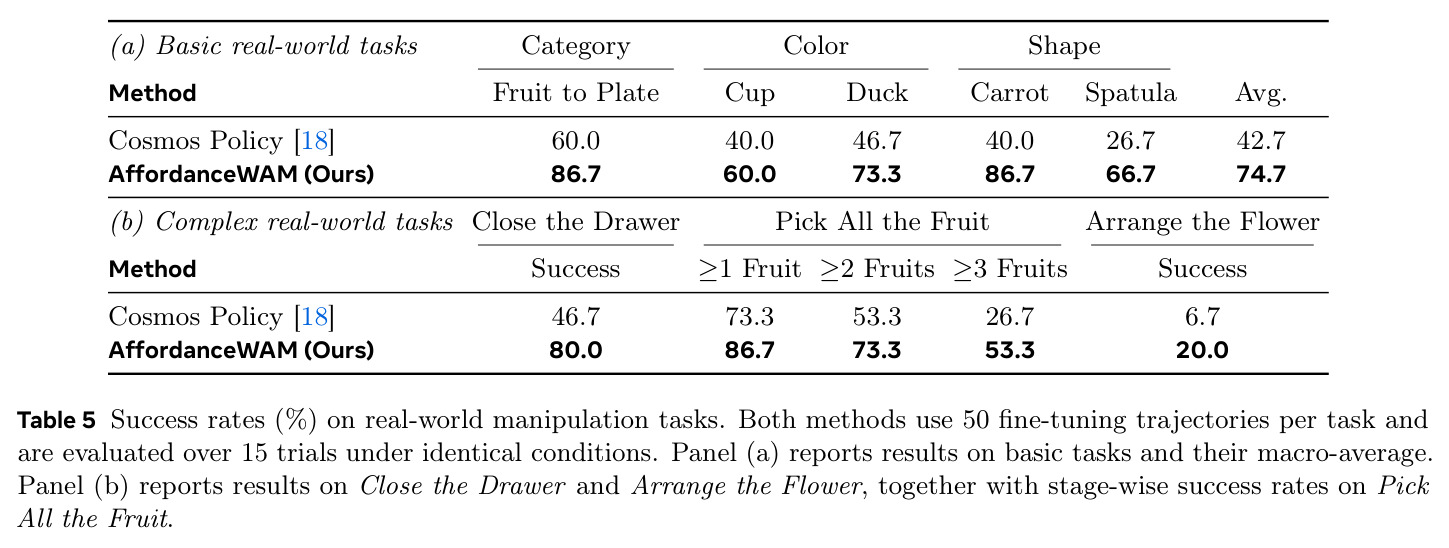
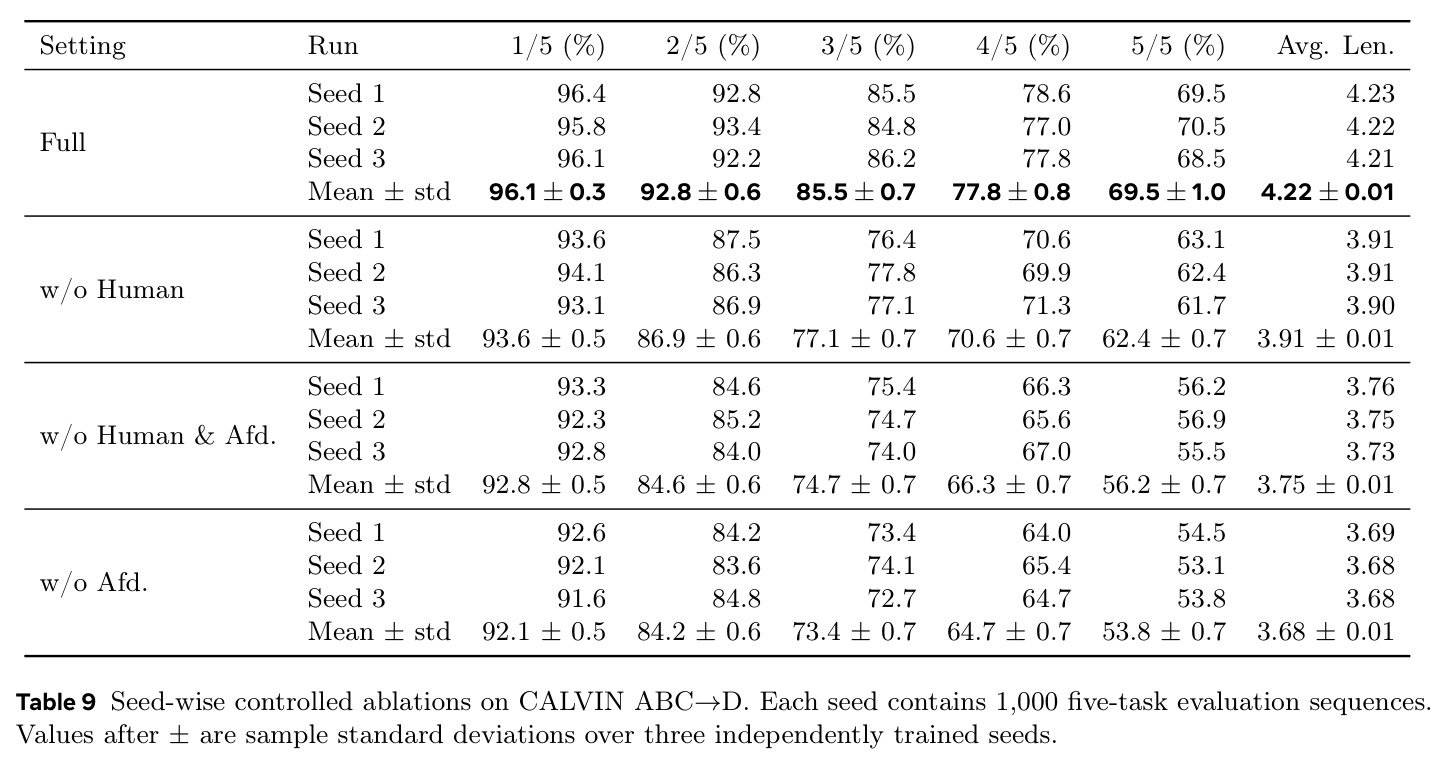
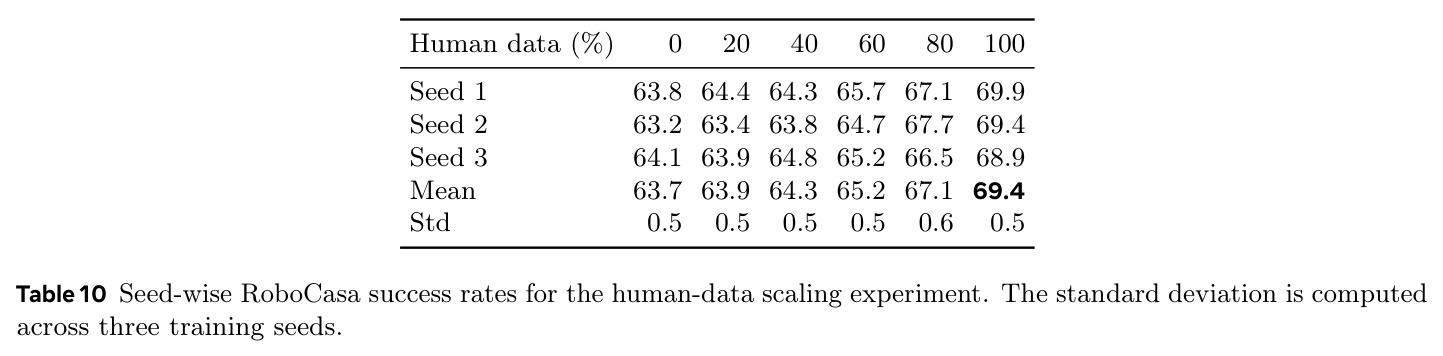
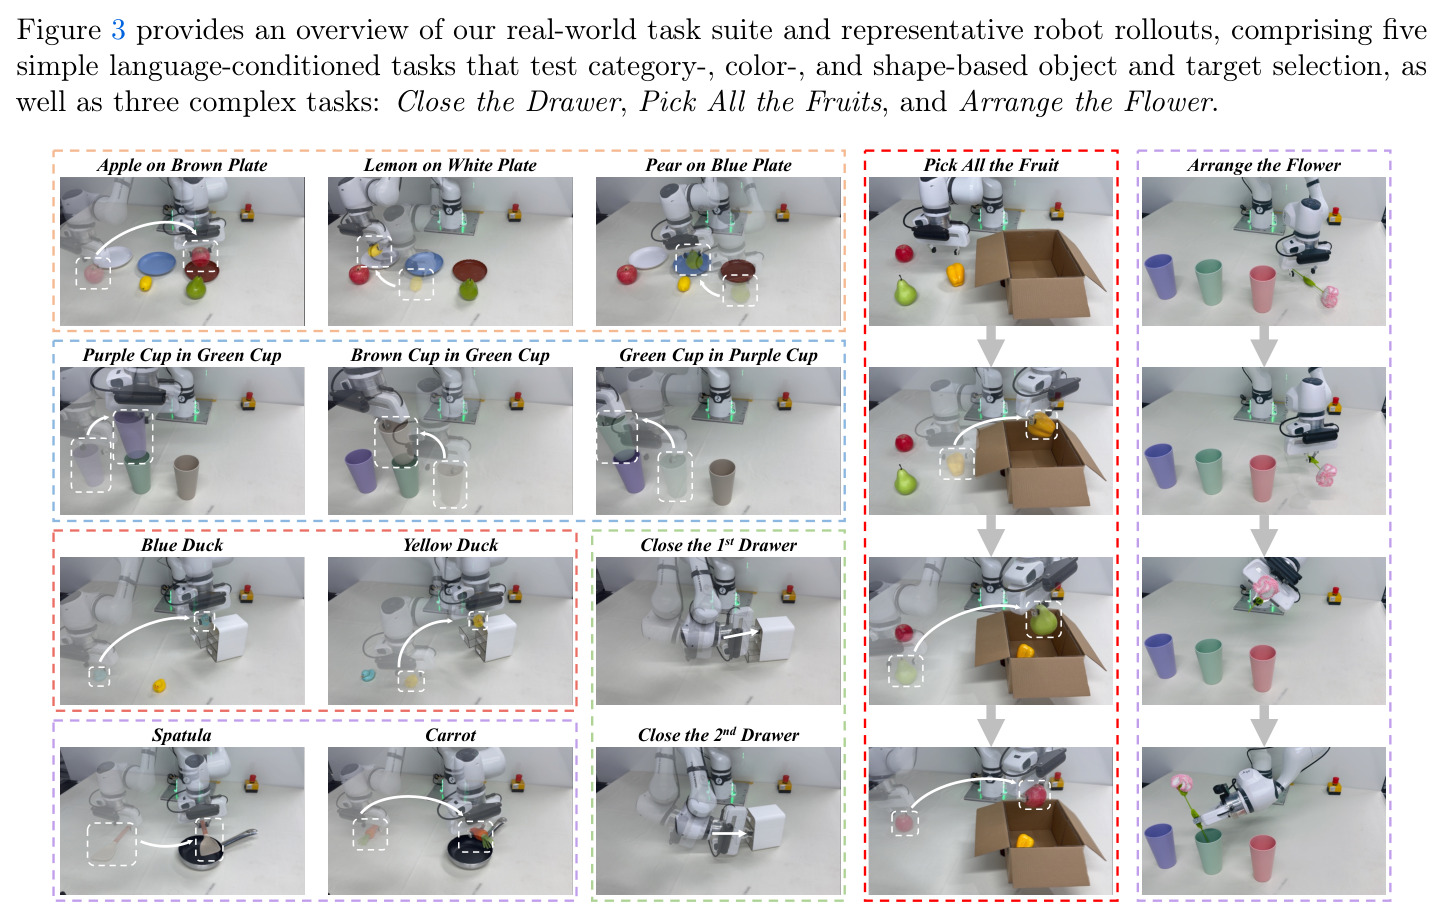
核心结果有五组。其一,RoboCasa 24 任务平均成功率 69.4%(300 演示/任务),超过 Cosmos Policy(67.1%,仅 50 演示)、GR00T-N1.5(64.1%)、π0(62.5%)。其二,CALVIN ABC→D 平均序列长度 4.22,1/5 到 5/5 成功率 96.1%/92.8%/85.5%/77.8%/69.5%,全面超过 VPP(4.01)、Seer(3.98)、π0(3.84)。其三,2×2 消融揭示符号反转:仅机器人数据时有可供性 63.7%、无则 57.3%;加入人类数据后有可供性升至 69.4%,无则跌至 55.1%,CALVIN 对应 3.75→3.91→4.22 与 3.68,交互效应达 7.9 个百分点。其四,人类数据扩展呈阈值效应:0→60% 仅提升 1.5 点,60→100% 贡献 4.2 点(约占总收益 74%)。其五,真实世界 8 任务、每任务 50 轨迹:简单任务宏平均 74.7% 对 42.7%,关抽屉 80.0% 对 46.7%,三果全捡 53.3% 对 26.7%,插花 20.0% 对 6.7%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboCasa 家庭操作(24 任务) | 平均成功率(每任务 300 演示适配) | 69.4%(3 种子,每设置 3600 次评测) | Cosmos Policy 67.1%(50 演示)、GR00T-N1.5 64.1%、π0 62.5%、UWM 60.8%(1000 演示) | 较最强基线 +2.3 个百分点;较自身去掉可供性 +5.7 个百分点 |
| CALVIN ABC→D 跨环境泛化 | 平均完成序列长度 / 五任务全成功率 | 4.22 / 69.5% | VPP 4.01、Seer 3.98、π0 3.84、UniVLA 3.80 | 序列长度 +0.21(对最强基线),1/5-5/5 各项均为最佳 |
| 真实世界 5 个简单任务(水果-盘子、杯子插入、选物、工具放置) | 宏平均成功率(每任务 50 轨迹微调、15 次试验) | 74.7% | Cosmos Policy 42.7% | +32.0 个百分点,所有简单任务均胜出 |
| 真实世界复杂任务(关抽屉/捡全部水果/插花) | 成功率 / 三果全捡成功率 / 插花成功率 | 80.0% / 53.3% / 20.0% | Cosmos Policy 46.7% / 26.7% / 6.7% | 分别 +33.3、+26.6、+13.3 个百分点 |
| 人类数据规模扩展(RoboCasa,机器人数据固定) | 平均成功率随可供性标注人类视频比例变化 | 0%→63.7%,60%→65.2%,100%→69.4%(单调、阈值型) | 0% 人类数据(仅机器人训练带可供性)63.7% | 总提升 5.7 点,其中后 40% 数据贡献 4.2 点(约 74%) |
局限与改进
作者在定性分析中承认的失败模式有三类:空间漂移(预测的交互区域偏离对应物体但 RGB 看似合理)、RGB 复制坍塌(外观结构主导 Heatmap 预测、削弱交互定位)、错误物体定位(紧凑预测选错指令所指物体),另有「世界预测正确但控制执行失败」和长时程上定位质量逐组退化两类诊断。我的补充观察:其一,可供性目标依赖源数据集已有的物体/交互标注,需光栅化与插值流水线,制约了可用数据源的规模;其二,真实世界最难的插花任务最高仅 20% 成功率,长时程复杂任务仍远未解决;其三,预训练需要 64 张 H200、40 万条机器人轨迹和 300+ 小时人类视频,门槛极高;其四,系统引入多个损失权重($\lambda_{afd}=0.2$、$\lambda_{heat}=0.5$、$\lambda_{rec}=0.1$)与课程调度超参,对噪声标注的鲁棒性未系统评估;其五,动作为 12×7 的固定机械臂末端块,未涉及灵巧手。
独立分析的弱点
弱点一:可供性目标构造依赖源数据集的人工交互标注(高斯光栅化、最多两帧插值、遮挡过滤),对无标注的互联网规模第一视角视频不可用,这与「利用大规模人类数据扩展」的愿景矛盾,改进方向是用视觉-语言模型自动伪标注或自监督可供性学习。弱点二:Affordance Heatmap 由 RGB 与标量场经固定函数确定性渲染而来,信息上高度冗余,却仍以 $\lambda_{heat}=0.5$ 训练为独立生成流,可研究让 Heatmap 只作辅助判别约束而非完整生成目标以节省容量。弱点三:训练课程复杂——联合/固定世界两条路径、时间步同步比例、固定世界条件从干净目标到模型预测渐变,多个调度叠加导致复现与调参困难,可探索单目标替代。弱点四:掩码设计的动机(防 RGB 捷径)虽被消融支持,但缺乏对 Action Expert 内部注意力的机制性归因,未直接证明 Scalar Affordance 真的被动作生成使用,可用注意力归因或特征擦除实验补足。
未来方向
作者提出的方向:把可供性接口推广为视觉-语言-动作学习与人机迁移的通用机制,论文结论明确指出可供性是两者的有效接口。基于成果可延伸:其一,把标量场从 2D 热图扩展到 3D 或 6D 交互位姿流,配合 3D 世界模型缓解视角变化下的定位漂移;其二,在伪标注帮助下吸收互联网第一视角视频,检验阈值效应的拐点是否随覆盖广度继续右移(实验显示 60%→100% 才贡献约 74% 收益);其三,把预测可供性的质量当作不确定性信号——空间漂移可提前暴露执行风险,用于滚动控制中的失败检测与重规划;其四,推广到灵巧手与多指接触预测,检验 12×7 末端动作块之外的可供性表达;其五,研究 Heatmap 流的更轻注入方式(如判别器或特征蒸馏),降低生成开销。
复现评估
代码在 GitHub(Skywalker-yqz/AffordanceWAM)开源并附项目页,世界模型底座 Wan2.2-TI2V-5B 公开可得,这是有利条件。但全量预训练需要 64 张 NVIDIA H200、BF16 训练,数据含 300+ 小时人类视频(Ego4D-FHO、EPIC-KITCHENS VISOR、HOI4D、H2O、MECCANO)与约 40 万条机器人轨迹(DROID、RH20T、BridgeData V2、InternData-A1、RoboCasa365),部分数据集需申请许可,且可供性标注需按论文 A.2 节流程自行光栅化构造。下游适配相对轻量:RoboCasa 每任务 300 条共 7200 条演示,真实世界每任务仅 50 条,Stage II 只训 Action Expert 一万步、lr $10^{-5}$。评测规范性强:主消融均有 3 个独立训练种子,RoboCasa 每设置 3600 次评测并报告均值与样本标准差(如 69.4±0.5)。整体复现难度高:全量预训练超出多数实验室算力,但在开源权重可用时做 Stage II 微调是可行的。
论文图表
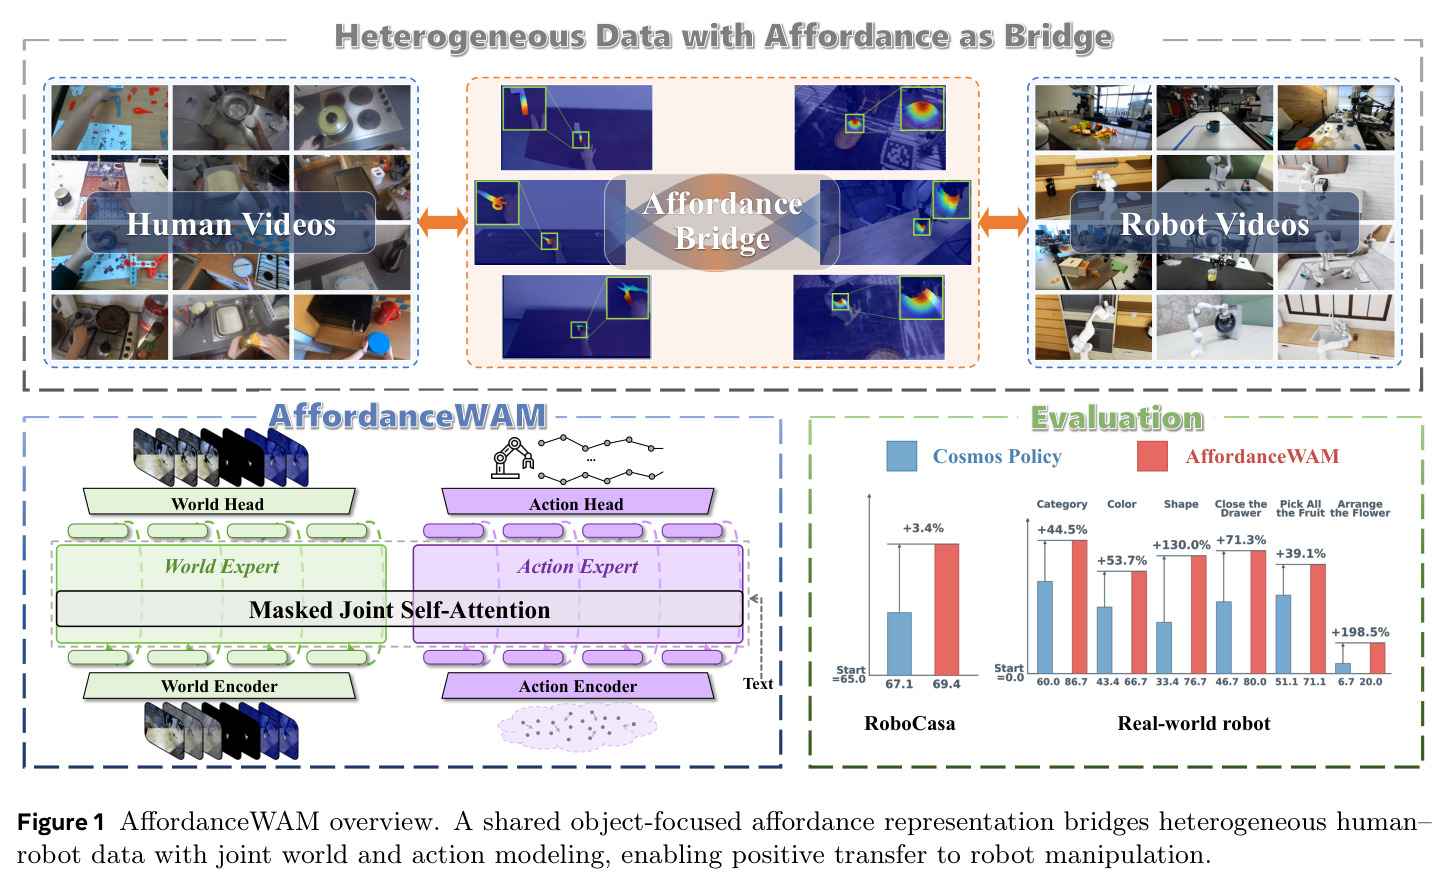
总览图:左侧人类视频与右侧机器人视频作为两类输入,经过共享的以物体为中心的可供性表征(中间桥梁)进入 World Head 与 Action Head;World Expert 经掩码联合自注意力与 Action Expert 耦合,输出预测的未来世界与 Cosmos Policy 对比的机器人操作结果,下方展示 RoboCasa 与真实机器人场景。
一图概括论文核心命题:人类视频与机器人视频不在动作空间对齐,而是在可供性定义的交互空间相遇。理解这张图就理解了论文的动机与整体框架。
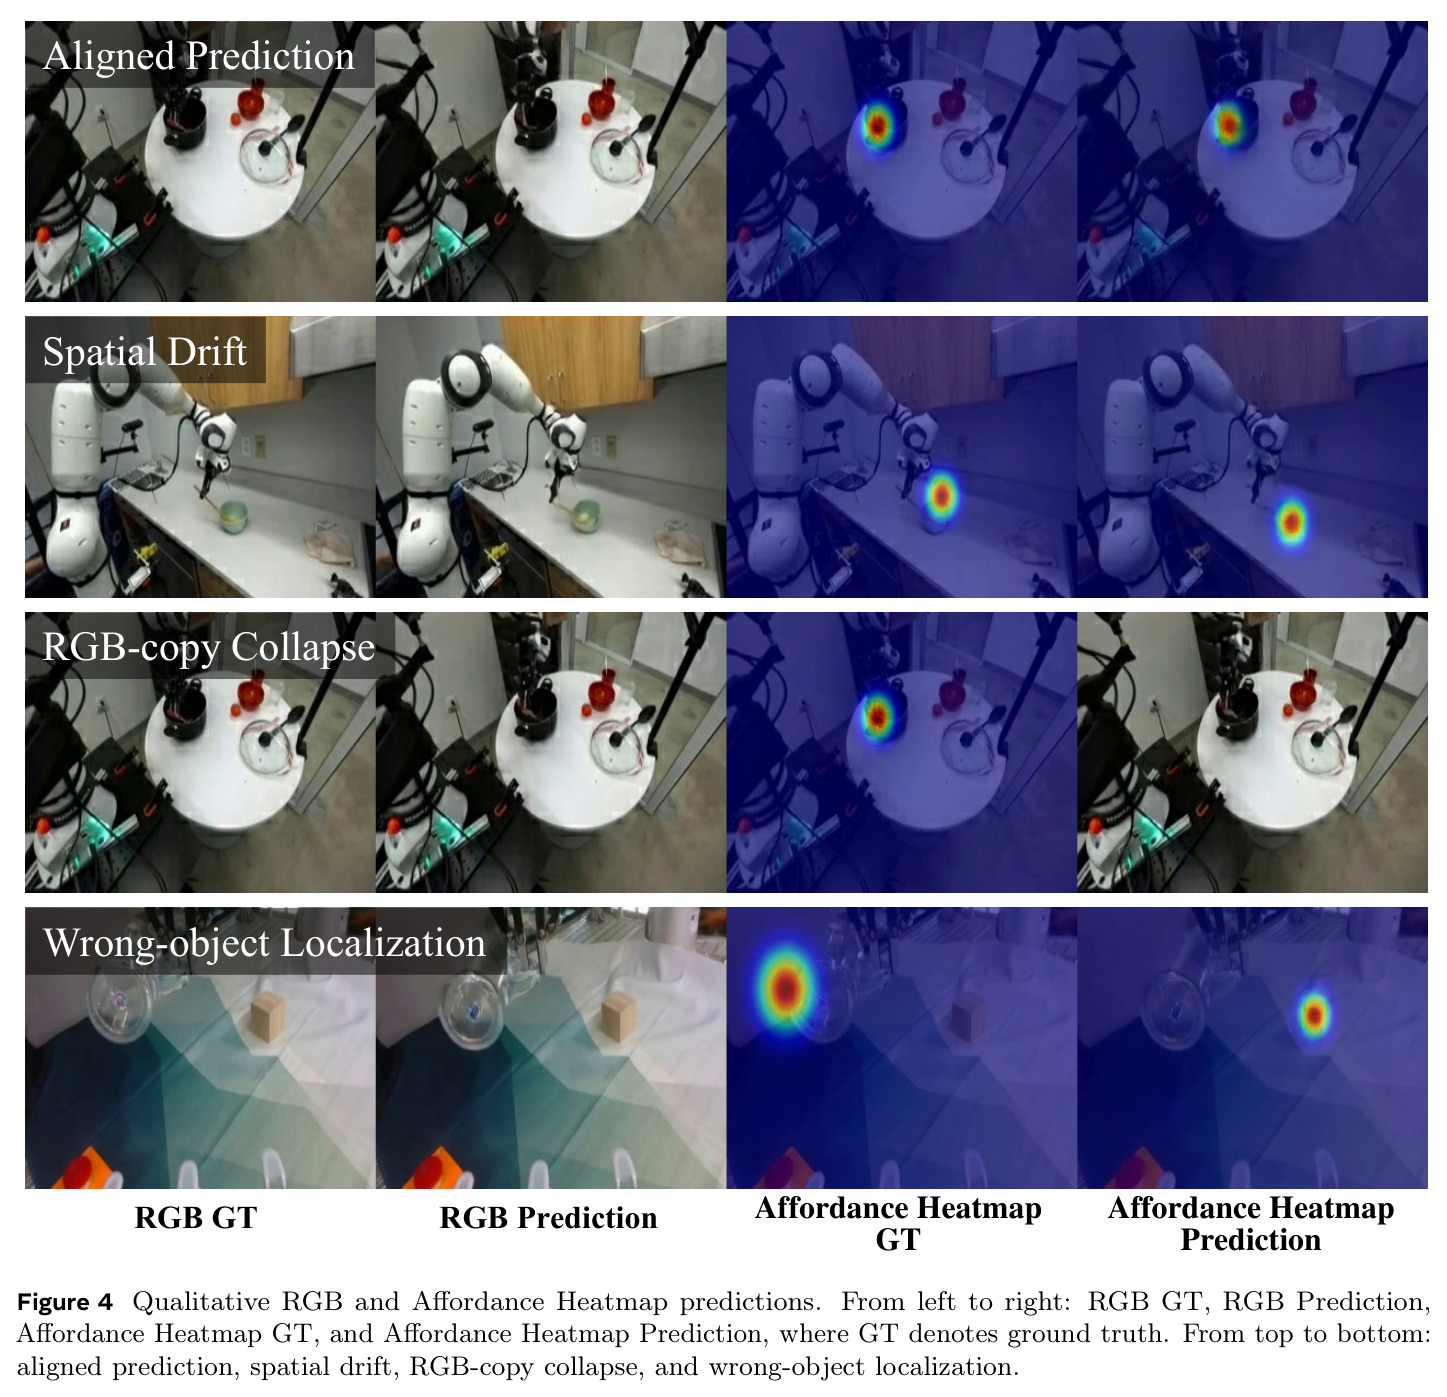
定性结果:四列分别为 RGB 真值、RGB 预测、Heatmap 真值、Heatmap 预测;四行从上到下依次为对齐正确的预测、空间漂移(交互区域偏离物体)、RGB 复制坍塌(外观主导 Heatmap、交互定位被稀释)、错误物体定位(预测聚焦到指令无关物体)。
直观展示了可供性预测的三类失败模式,支撑论文对两个可供性流互补性的论证,也是判断该表征在什么条件下会失效的实证依据,最适合放在局限性讨论中。