世界编辑:对可执行世界的深度递增干预 World Editing: Intervening on Executable Worlds at Increasing Depth
以游戏模组定义世界编辑与干预深度,发现前沿编程agent可靠性随深度显著下降
前置知识
世界模型(World Model)
学习环境的表示、生成或模拟的 AI 系统,使智能体能够预测未来状态并随时间交互。近年代表工作包括 Genie 系列、GameNGen、MineWorld、Solaris 等,多数把“生成世界”建模为随时间的视觉观测预测或合成,并支持在其中行动(gameplay)。本文把研究版图从“生成世界”与“在世界中行动”扩展出第三种关系:刻意编辑一个已存在、可执行的世界,同时保持无关属性不变。
本文的全部问题定义与相关工作对比都建立在“生成/行动/编辑”三分法之上,理解世界模型研究的现状,才能看清本文“世界编辑是与生成、交互并列的一等能力”这一定位的独特之处。
游戏模组(Game Modding)
Mod 是用户对现有游戏的修改,可改变或扩展游戏的素材、内容、机制或系统。Minecraft 通过 Fabric 生态(mod 加载器+Gradle 构建+Java 21)注册新物品、实体与机制,Terraria 通过 tModLoader(C#/.NET 8.0)实现同类能力;开发遵循“编辑代码→编译打包→游戏加载运行”的工作流。这两个生态成熟且文档完善,游戏状态可通过 RCON、bot 等接口程序化查询与操纵。
IGMWorld 测试台与 IGMBench 基准完全建立在 Fabric 与 tModLoader 之上:agent 的交付物是一个能构建、加载、正确运行的 mod 仓库,不懂 modding 就无法理解任务的输入输出与评估方式。
编程智能体(Coding Agent)
以 LLM 为骨干、在真实代码仓库中自主工作的系统:读代码与文档、编辑文件、调用构建与测试工具、根据运行日志迭代修复,典型代表有 SWE-agent、Claude Code、Codex-CLI、Gemini-CLI 等,评测通常按仓库级任务解决率衡量。本文刻意以“完整 agent 配置(模型+编码 harness)”而非裸模型作为比较单位。
本文的实验对象正是 7 个前沿 agent 配置(GPT-5.6 Sol/Luna、Claude Opus 4.8、Gemini 3.5 Flash、DeepSeek-V4-Pro、Kimi-K3、GLM-5.3),它们的成功率、失败阶段与工具使用策略是论文所有核心发现的来源。
干预深度(Intervention Depth)
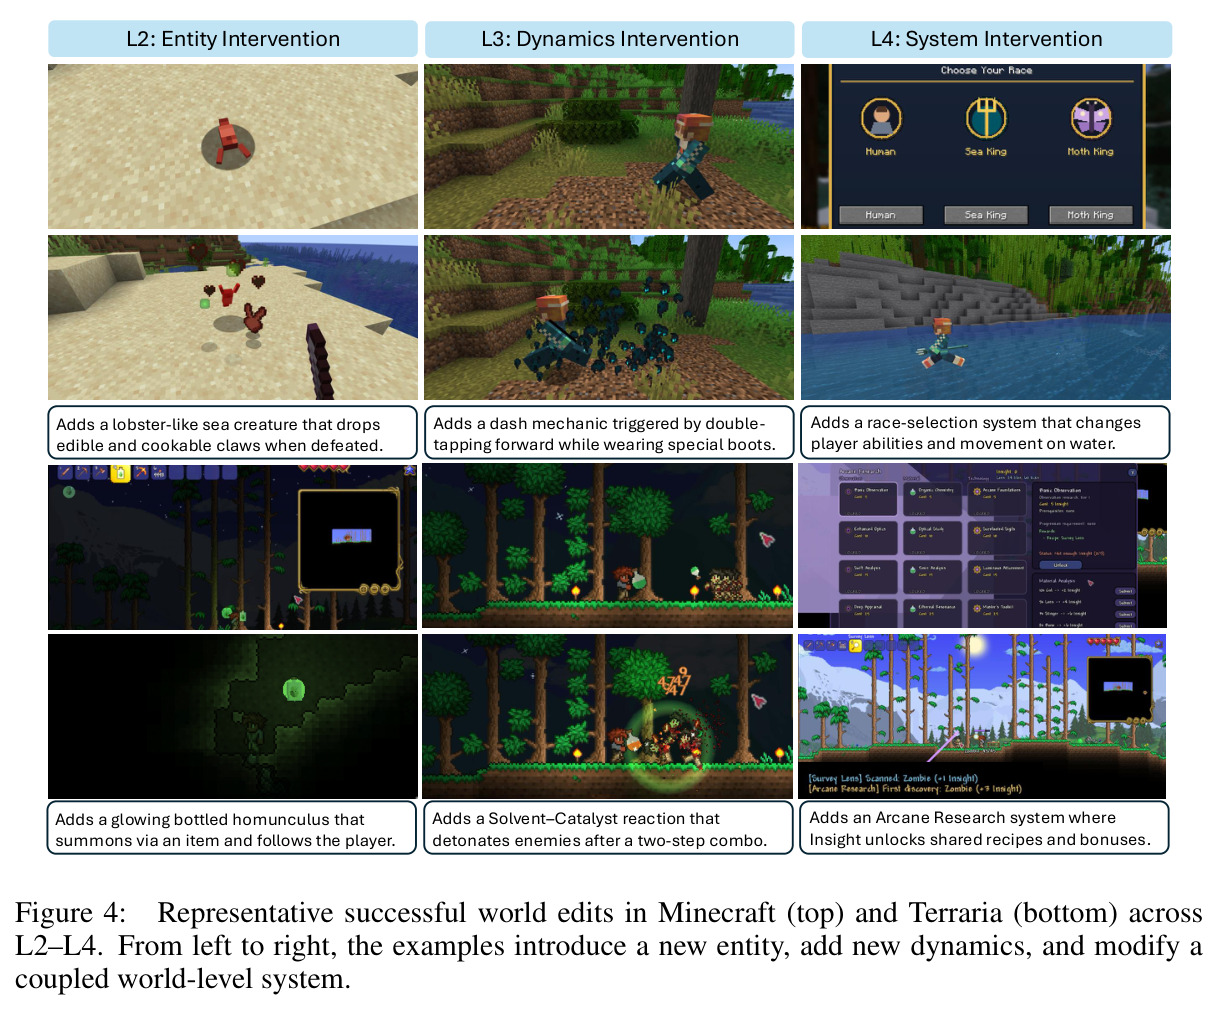
本文提出的核心概念:按一次编辑所需协调的世界组件耦合程度分级——L1 属性干预(改参数或外观,不改身份与行为,如提高武器伤害)、L2 实体干预(新增内容并顺应现有机制,如加配方或怪物)、L3 动力学干预(修改支配实体行为与交互的规则,如加冲刺机制)、L4 系统干预(修改多个耦合子系统构成的世界级系统,如技能树或经济重构)。深度衡量“协调强度”而非代码量:系统级编辑可以实现很小,却需要多个组件保持一致。
这是全文的分析主轴:“可靠性是否随干预深度下降、且不可还原为判据条数”是论文最重要的实证结论,四级定义也是理解基准任务设计与所有分层结果的前提。
TPIPS 与感知相似度度量
LPIPS 是用深度特征衡量两图像感知差异的学习型度量;TPIPS 是其文本条件扩展:给定文本因子 $f$(如物体类别或 art style),在对应语义维度下衡量相似度。本文定义类别条件分数 $S_f(x;c)=\frac{1}{k}\sum_{r_i\in\mathrm{kNN}(x,I_c;f)}\mathrm{TPIPS}(x,r_i;f)$,并用原生素材留一法分布的 $\alpha$ 分位阈值 $\tau_{c,f}$ 判定通过(主实验取 $\alpha=0.15, k=5$)。
论文第三阶段评估(视觉一致性)完全建立在该度量与校准协议上;不理解 TPIPS 与留一法阈值,就无法解读表 4 中“原生素材 0.80/0.78、而所有 agent 配置低于 0.50”的结论及其可信度边界。
研究动机
当前 AI 与交互世界的研究几乎全部聚焦在两件事上:生成世界与在世界中行动。世界模型主线(Genie、GameNGen、MineWorld 等)把“生成”建模为预测或合成随时间的视觉观测;agent 主线(MineDojo、Voyager 等)研究在既有环境中行动。相比之下,“刻意编辑一个已存在的可执行世界”——改变其实体、行为或底层系统、同时保持无关属性不变——几乎没有被系统研究。已有论文中的 world editing(如 Yume 系列)只指对生成场景的视觉或几何修改,不触碰可执行世界的实体、动力学与交互系统;SWE-bench 类软件工程基准虽评测仓库修改,但通过单元测试在代码层面判分,不需要真实系统跑起来且行为正确;游戏生成工作(GameCraft-Bench、GameDevBench 等)则是从零构建游戏而非改造现有世界。因此,社区缺乏一个能定量刻画“编辑现有世界”这一能力的任务定义、分类学与测量工具。
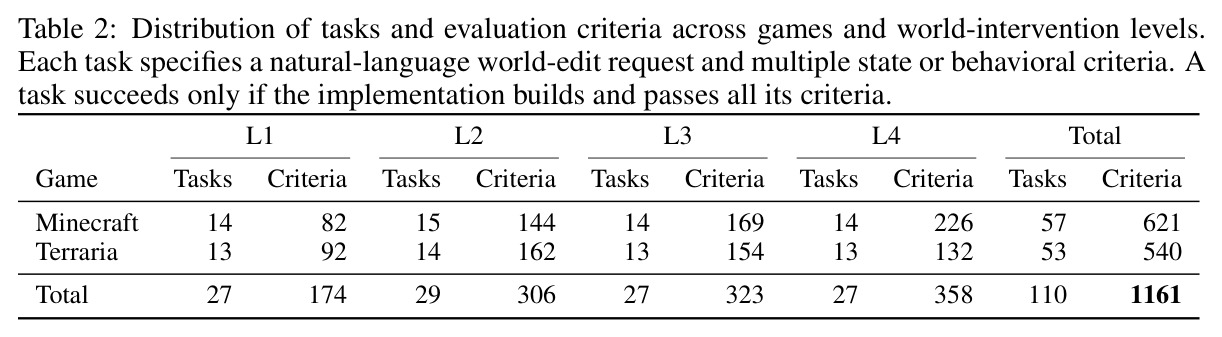
本文的目标是本文要把“世界编辑”确立为与生成、交互并列的一等能力,并给出可度量的科学刻画。形式化地,把世界表示为 $W=(S,T,R,\ldots)$,其中 $S$ 是实体与状态空间、$T$ 是转移动力学、$R$ 是支配交互的规则与系统;给定自然语言编辑指令,世界编辑智能体执行干预 $W \xrightarrow{\Delta_k} W' = f(W,\Delta_k)$,$k\in\{\text{property, entity, dynamics, system}\}$,要求 $W'$ 实现请求的改动、同时保持 $W$ 的无关属性不变。具体目标有三:(1) 用干预深度(L1 属性/L2 实体/L3 动力学/L4 系统)刻画一次编辑耦合世界组件的强度;(2) 构建工业级游戏模组环境 IGMWorld 与基准 IGMBench——跨 Minecraft 与 Terraria 的 110 个任务、1161 条可执行状态/行为判据,加上回归与视觉验证;(3) 用它系统刻画前沿 agent,回答“深层干预是否更难、失败发生在哪一阶段”。
与已有工作不同的是,独特切入角度有三点。其一,测试台选在商业游戏的原生 modding 生态(Fabric、tModLoader)而非自建沙盒:成熟游戏的世界既复杂又可执行,modding 暴露的是对“已存在世界”的干预接口而非从零构造,正确性最终在能构建、加载、运行的世界中判定。其二,提出“干预深度”这一耦合维度并与需求条数显式解耦——深度衡量一次编辑需要协调多少世界组件保持一致,而不是需要写多少代码,一个系统级编辑可能实现很小但仍需多组件联动;这直接引出论文的核心科学问题:深层干预更难是因为“要协调更多”还是仅仅“要求更多”。其三,评估哲学不同:验证器评估的是可观测的世界行为(查询运行时状态、执行受控游戏内动作、比对状态转移),不同实现只要行为等价即可通过,这与以代码结构或单元测试为中心的软件工程评测有本质区别。
核心方法
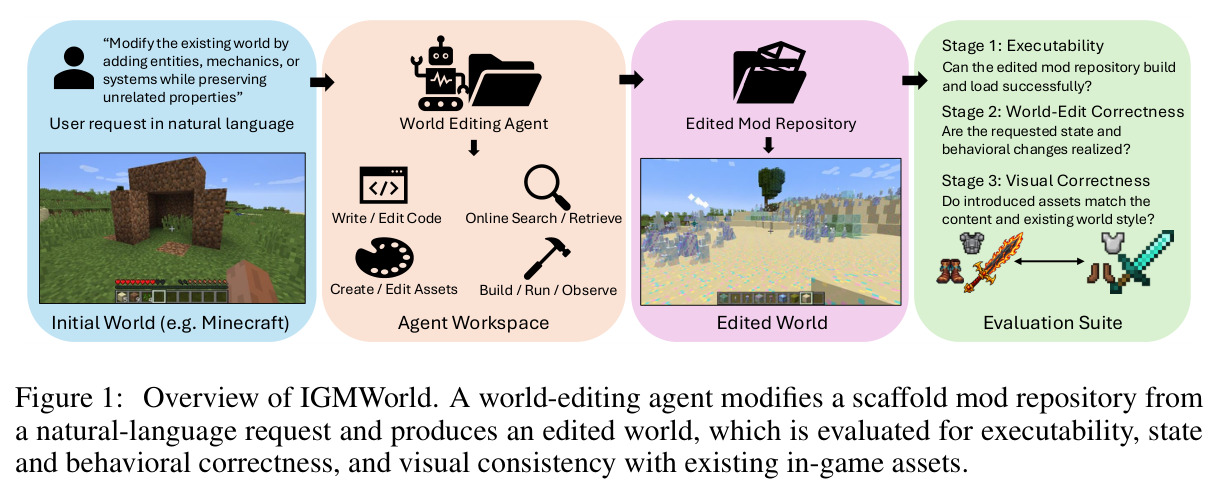
直觉上,本文让 AI 扮演一名资深 mod 作者:接到一句自然语言需求后,在现有游戏的 mod 脚手架仓库里阅读源码与素材、修改代码、调用原生工具链编译、启动游戏服务器、读日志,必要时联网查文档或生成贴图,迭代修复直到交付一个能加载且行为正确的 mod;评分不在代码层面,而是在运行的游戏世界里查状态、跑行为、比外观。技术上,IGMWorld 把每个任务组织为可复现的 edit→build→run→observe 循环:agent 获得 $T=3600$ 秒固定预算,输入包括请求、自然语言要求、项目路径、构建命令、通用构建加载脚本与不可变元数据约束,可自主使用网络搜索与可选图像生成工具(gpt-image 或 nano-banana),任务专属评估逻辑对 agent 隐藏。环境全部钉死:Minecraft 1.21.1+Fabric loader 0.19.3+Gradle 8.12+Java 21;tModLoader v2026.05.3.0+.NET 8.0。完成后在独立验证环境按三阶段评估:可执行性、世界编辑正确性、视觉一致性。
核心创新是把“对已实例化世界的刻意干预”立为一等研究对象,并给出干预深度这个组织轴。与已有工作的本质区别:(1) 相比世界模型生成(Genie、GameNGen、HunyuanWorld),本文不学习或推断世界表征,而是干预一个已经存在的可执行世界;(2) 相比代码世界模型(WorldCoder、Code World Models),后者构建或推断可执行表征,本文修改已有实现并要求保持无关属性,干预与保持并重;(3) 相比 agentic 游戏开发基准(GameDevBench、GameCraft-Bench、OpenGame),它们从零造游戏,本文是改造现成商业游戏,且用回归检查显式验证“不该变的没变”;(4) 相比最接近的 StarCharM(Stardew Valley 模组的 HCI 案例研究),本文有系统性的可执行评估。干预深度衡量组件耦合而非实现规模,这是与“按需求数量衡量难度”的根本分野,也是论文最重要实证结论(可靠性随深度下降且不可还原为判据条数)的概念基础。
方法步骤详情
第一步,基准构建:11 名有模组经验的标注者按四级定义撰写全新任务,经清晰性、可行性与层级一致性审查得到 110 个任务(Minecraft 57、Terraria 53,四级各约 27–29 个),共 1161 条判据,每任务编译为 agent 可见的指令视图(描述+自然语言状态/行为要求)与评估专用的验证视图(可执行检查,agent 不可见)。第二步,agent 执行:在 3600 秒内迭代“读源码/素材→改代码→构建→启动游戏→读日志”,可用搜索与图像生成工具。第三步,可执行性门控:mod 必须编译成合法包并在目标游戏加载不崩溃。第四步,世界编辑正确性:状态检查查询运行中游戏的实体属性、物品统计、配方与注册项;行为检查执行受控游戏内动作并验证状态转移——每条行为用 actor/action/subject/provenance/context/timing/outcome 七字段描述,测试由 fixture、trigger、measurement、acceptance rule、prerequisite gates 五部分组成,随机机制用蒙特卡洛采样、参数直读、两点边界测试或有界枚举验证;另有 225 条成对回归检查(模组世界 vs 无模组世界,覆盖 30 个任务、集中于 L1)验证无关属性不变。第五步,视觉一致性:对引入素材的任务,用类别条件 TPIPS 分数 $S_f(x;c)$ 与留一法阈值 $\tau_{c,f}$ 分别判定风格与语义一致性。
技术新颖性
技术新颖性体现在四点。第一,评测对象是“运行中的世界”而非代码:验证器只评估可观测行为,行为等价的任意实现均可通过,这与以补丁结构或单元测试为中心的 SWE-bench 式评测有本质差别,也使“部分正确”(CPR 高但 WSR 低)成为可量化的中间状态。第二,1161 条确定性可执行判据包含对随机机制的四种测试法(蒙特卡洛重复采样、运行时参数直读、阈值两点边界测试、有界枚举加权期望),以及 Minecraft 上 RCON+Mineflayer+Fabric 客户端、Terraria 上 evaluator mod 的完整观测基础设施,能测 GUI 点击、按键、冷却、状态效果时长等细节。第三,视觉评估的校准协议:阈值取自原生素材留一法分布的 $\alpha$ 分位数,使原生素材按构造以 $1-\alpha=0.85$ 通过,为 agent 素材提供了内建参照;人类研究(9 人、40 张盲评)验证 $\alpha=0.15$ 最优,且 TPIPS 与人类风格判断的 AUC(0.66)优于 CSD(0.54)。第四,失败结构分析把失败定位到构建/加载/行为三阶段并按领域分解,首次量化“大多数失败发生在游戏跑起来之后”这一此前未被系统观察的现象。
实验结果
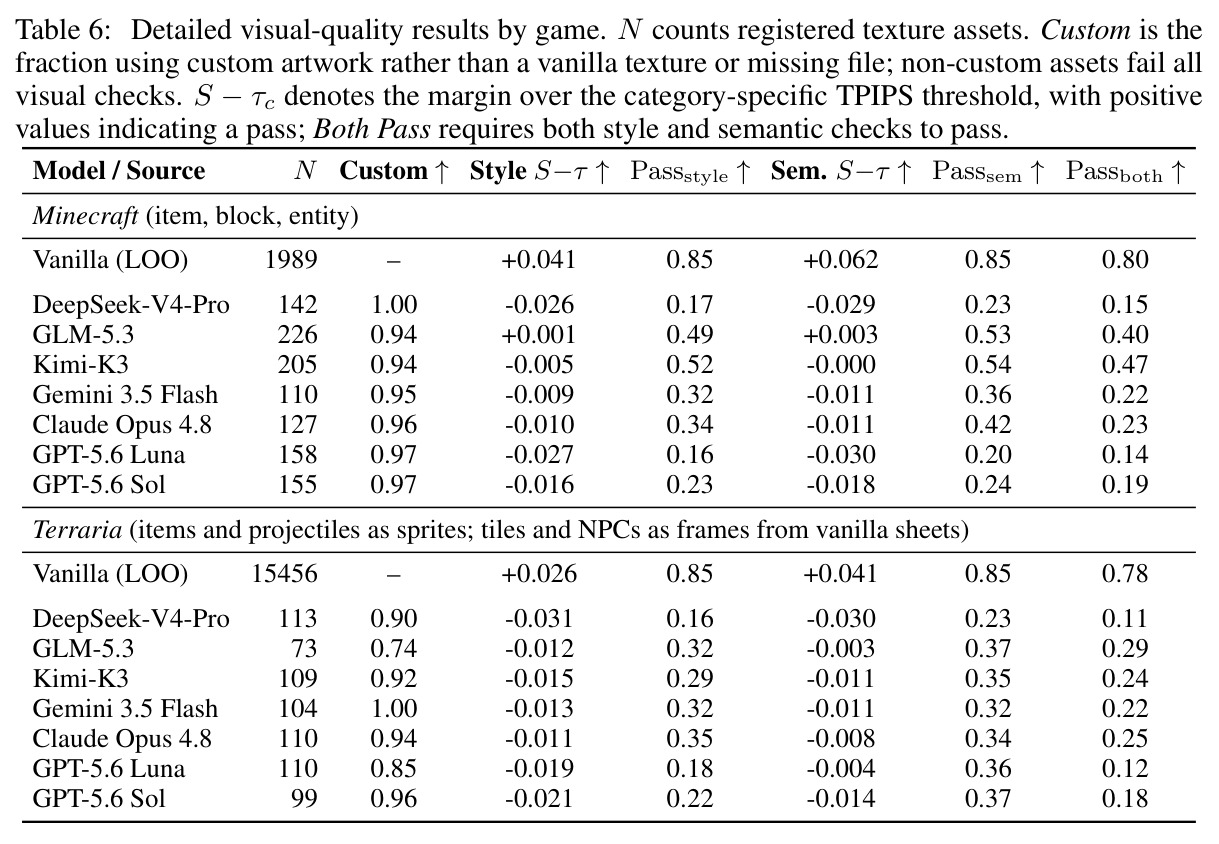
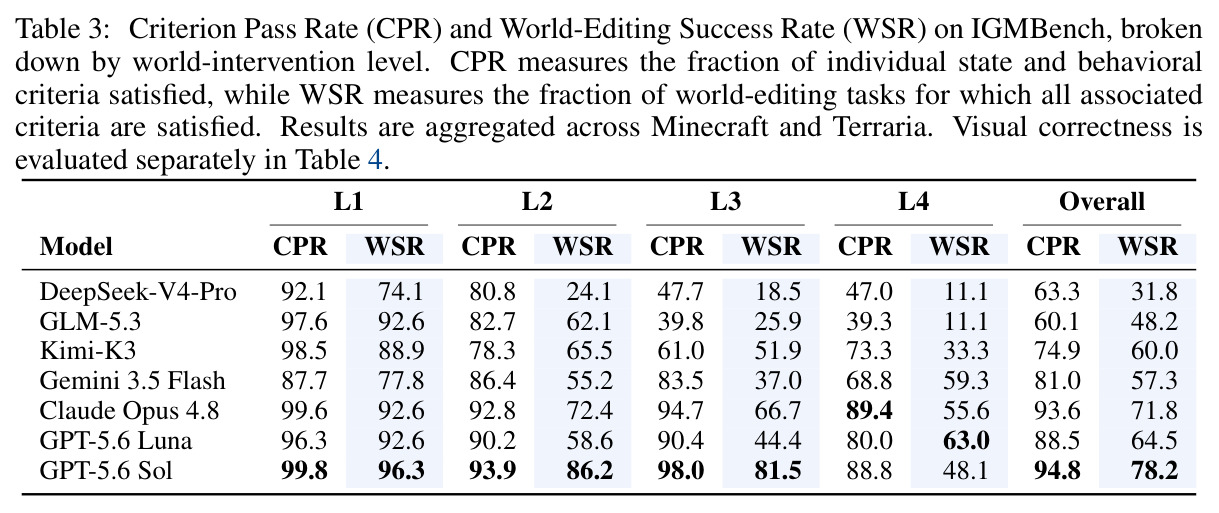
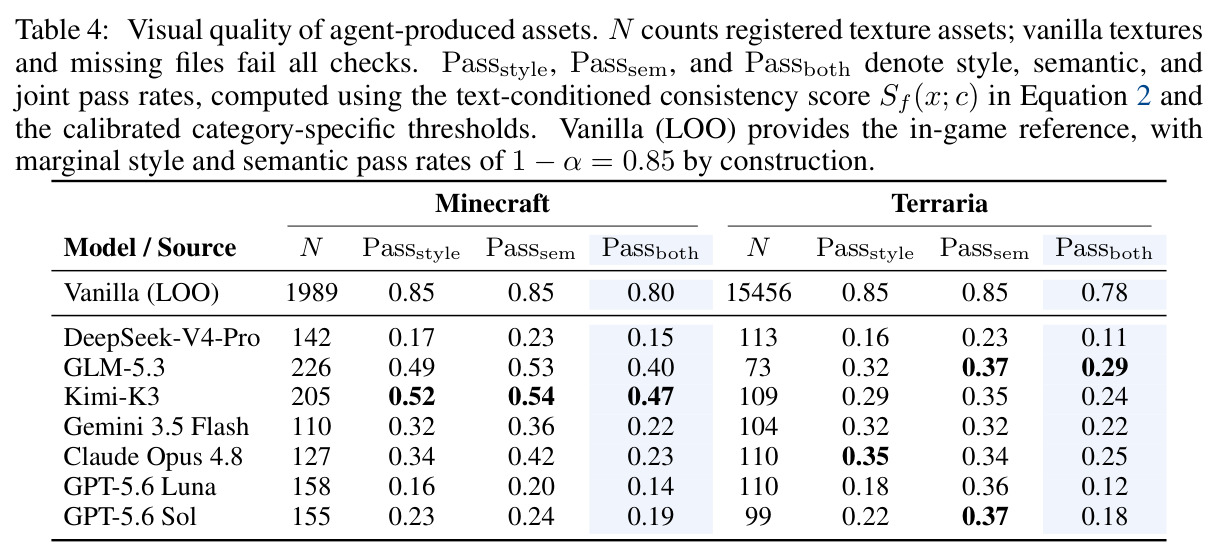
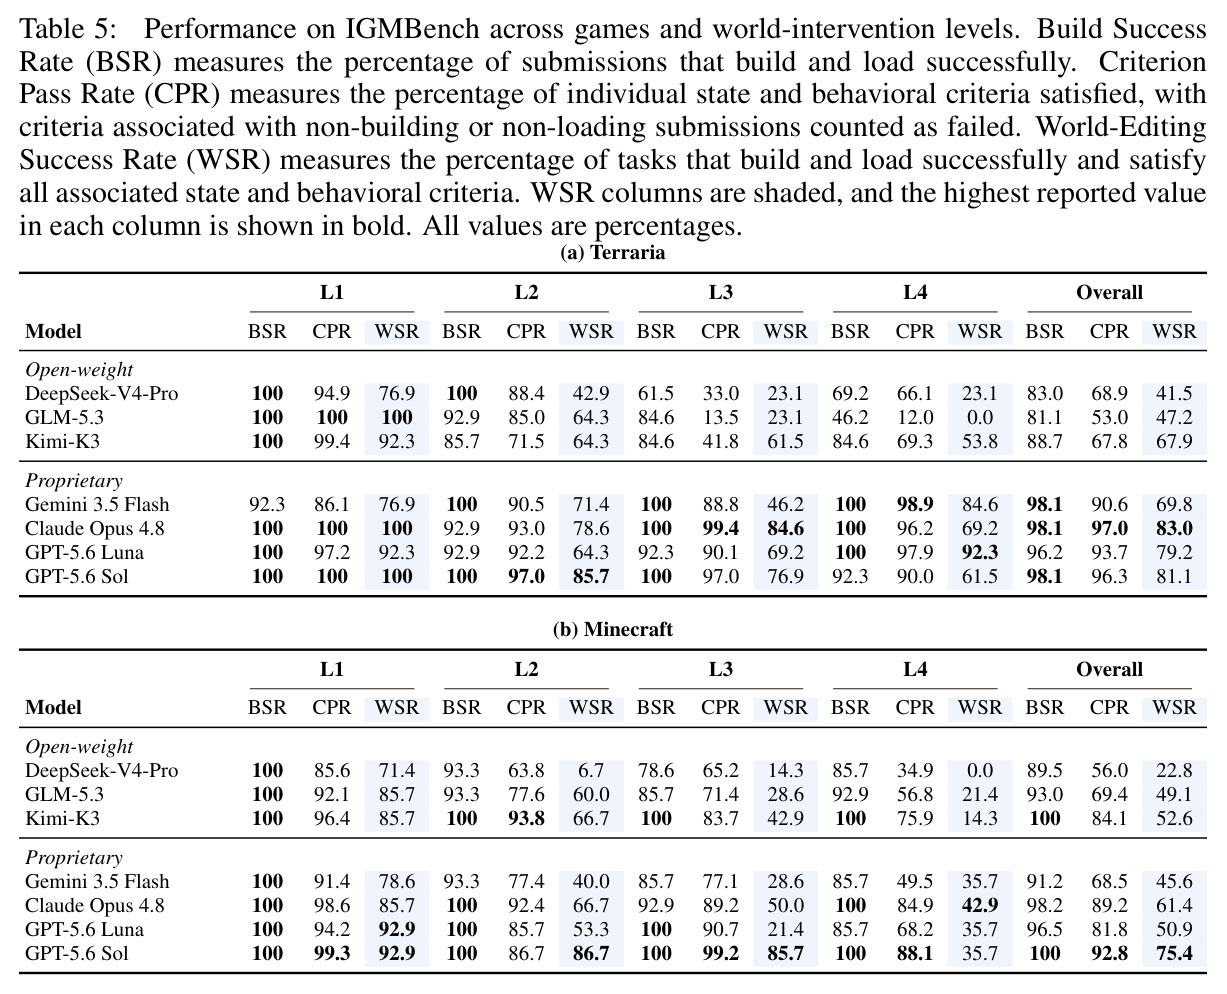
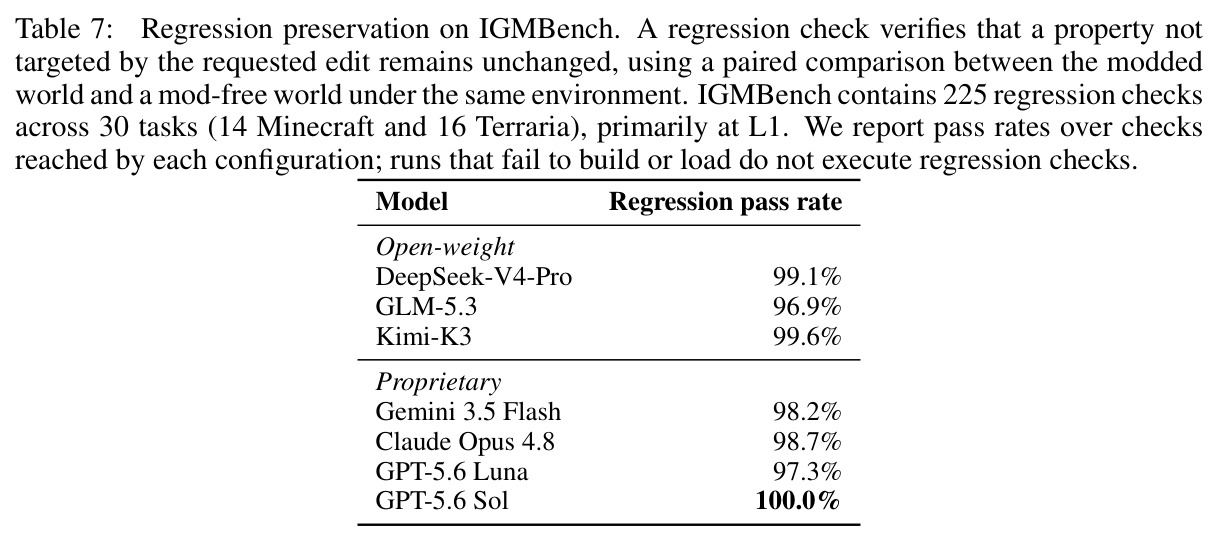
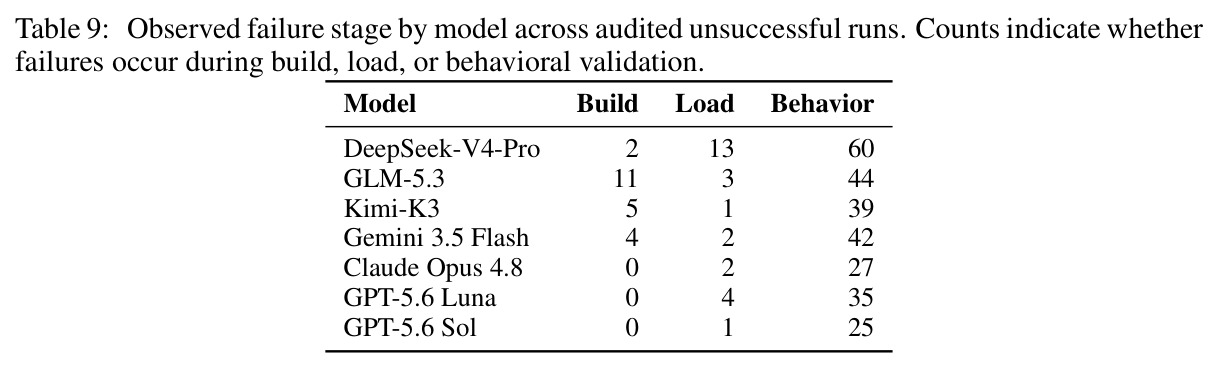
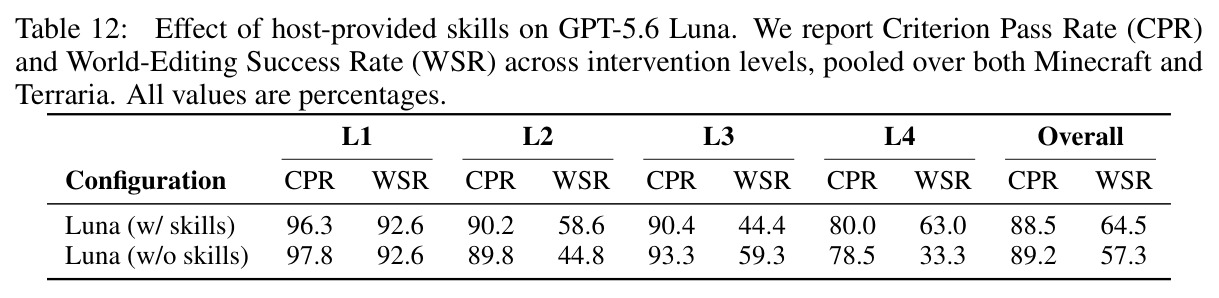
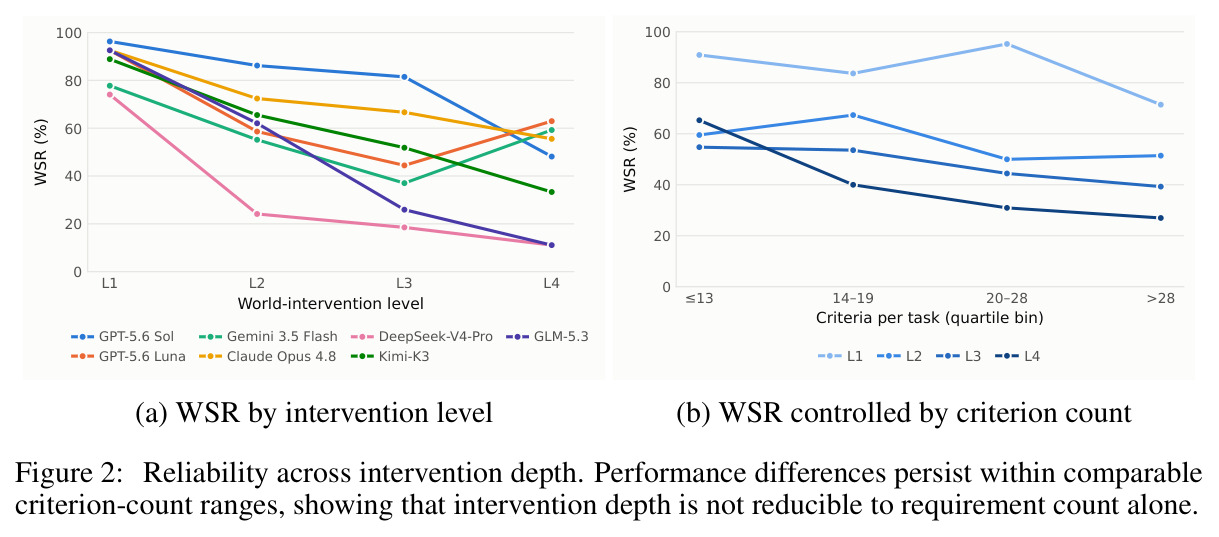
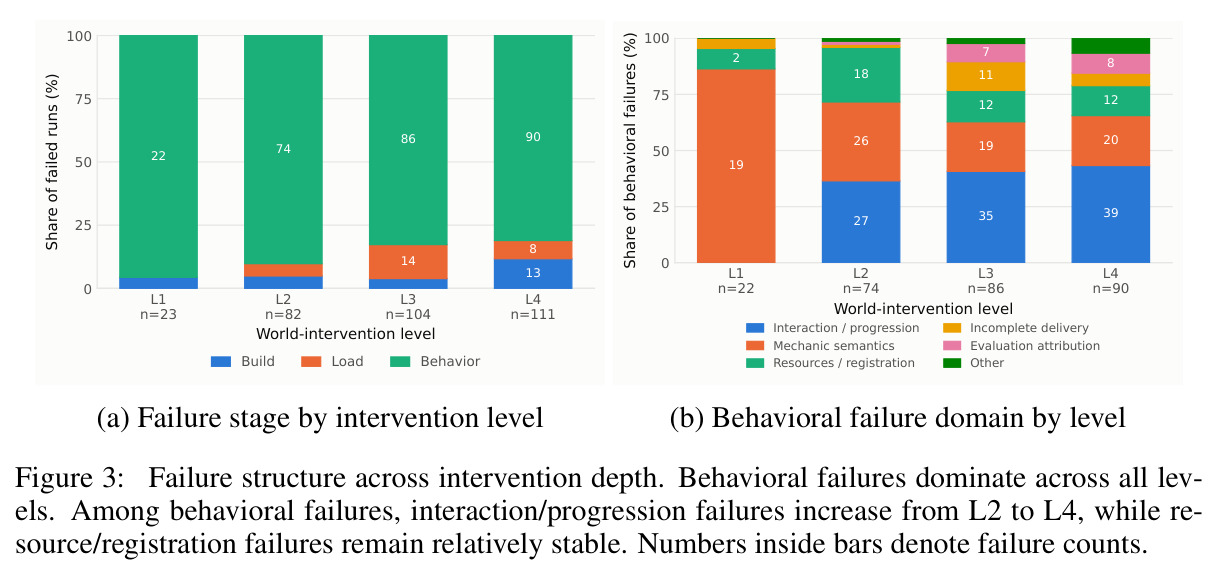
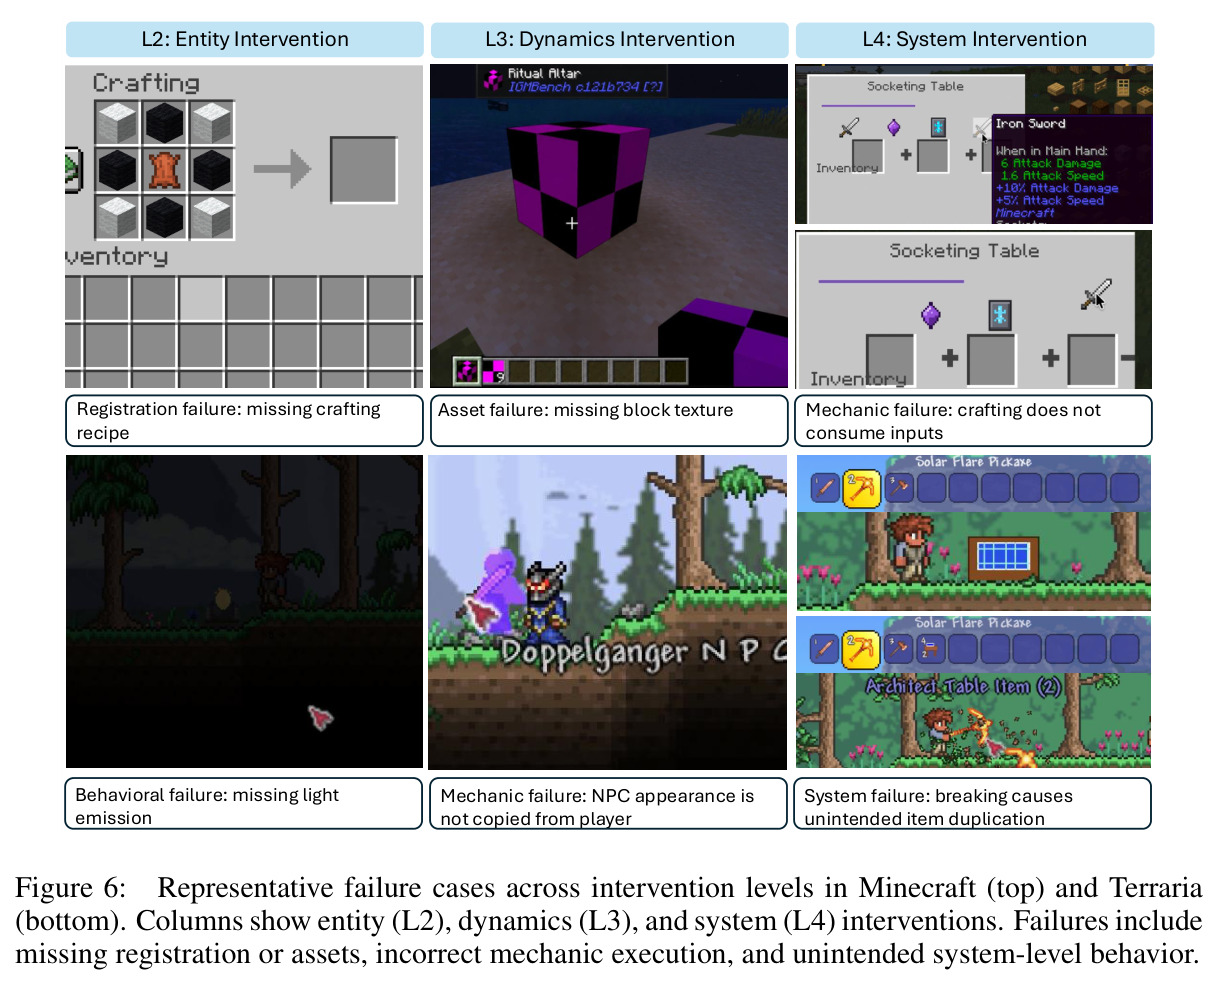
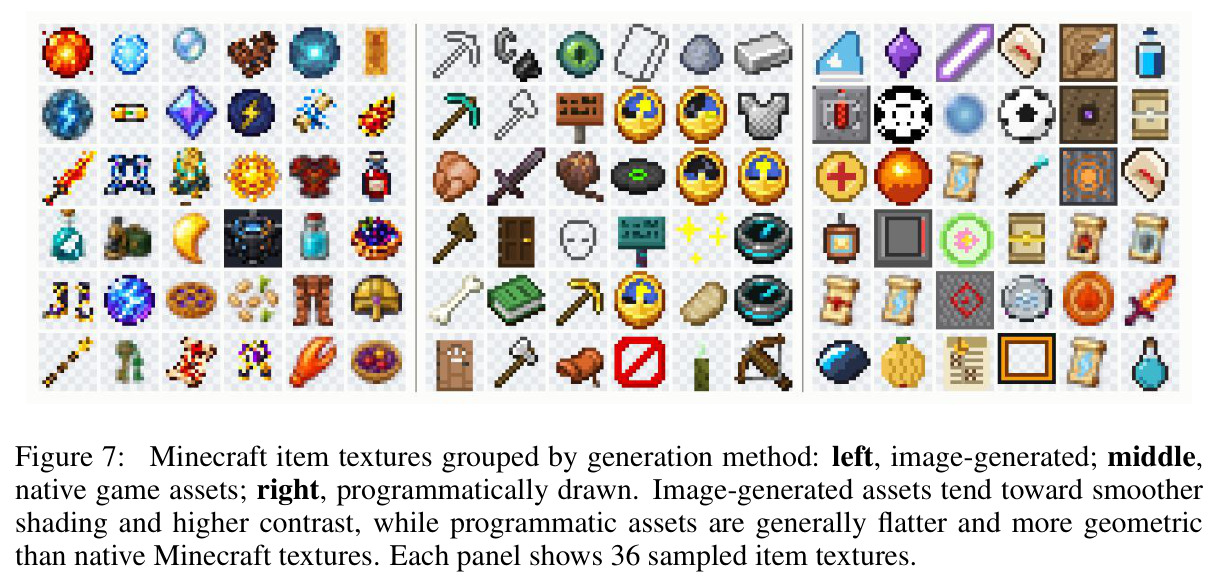
前沿 agent 已具备可观的世界编辑能力,但可靠性随干预深度系统下降。主结果(表 3,两游戏聚合):严格任务级 WSR 从 31.8%(DeepSeek-V4-Pro)到 78.2%(GPT-5.6 Sol);判据级 CPR 最高 94.8%(GPT-5.6 Sol),Claude Opus 4.8 达 CPR 93.6%/WSR 71.8%,开源配置明显落后(GLM-5.3 CPR 仅 60.1%)。层级趋势上,所有配置在 L1 取得最高 WSR:GPT-5.6 Sol 从 L1 的 96.3% 降至 L4 的 48.1%,Claude 从 92.6% 降至 55.6%;深层时 CPR 远高于 WSR,说明 agent 常满足多数判据却完不成整个编辑。图 2b 按判据数四分位分层后,同判据数区间内 L1 仍显著更可靠——干预深度不只是需求条数。失败结构(图 3、表 9):绝大多数失败发生在行为验证而非构建/加载,如 GPT-5.6 Sol 的 26 次失败中 25 次为行为失败、0 次构建失败;DeepSeek-V4-Pro 的 75 次失败中 60 次为行为失败。行为失败构成随深度变化(图 3b):L1 几乎全是机制语义错误(错值/公式),L2 起交互/进度类失败(新内容与现有系统接触时表现异常)成为主类并升至 L4 的 43%,而资源/注册失败稳定在 13–24% 不随深度增长。表 7:回归检查通过率 96.9–100%(GPT-5.6 Sol 100%),但覆盖集中于 L1。表 4:视觉是独立短板——原生素材联合通过率 Minecraft 0.80、Terraria 0.78,所有 agent 低于 0.50(最好 Kimi-K3 在 Minecraft 0.47、GLM-5.3 在 Terraria 0.29),且视觉排名与功能排名不对应。表 12 消融:modding 技能使 GPT-5.6 Luna 总 WSR 从 57.3% 升至 64.5%(L4 从 33.3% 到 63.0%),CPR 基本不变(88.5% vs 89.2%),视觉反而略降。表 11 的行为分析:GPT 与 Claude 在 91–99% 的 run 中读游戏源码,Gemini 则 72% 依赖网络搜索。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 世界编辑任务(全层级聚合,110 任务) | WSR(任务级全判据通过率) | 最强配置 GPT-5.6 Sol 78.2% | 最弱配置 DeepSeek-V4-Pro 31.8% | 配置间差距 46.4 个百分点 |
| 世界编辑任务(全层级聚合) | CPR(判据级通过率) | GPT-5.6 Sol 94.8% | DeepSeek-V4-Pro 63.3% | +31.5 个百分点 |
| L4 系统干预(最难层级) | WSR | GPT-5.6 Luna 63.0% | DeepSeek-V4-Pro / GLM-5.3 均为 11.1% | +51.9 个百分点 |
| 视觉风格+语义联合一致性(Minecraft 素材) | Passboth | 最佳 agent Kimi-K3 0.47 | 原生素材留一法参照 0.80 | −0.33(仍大幅落后原生基线,所有配置 <0.50) |
| 回归保持(30 任务、225 条检查) | 回归检查通过率 | GPT-5.6 Sol 100.0% | GLM-5.3 96.9%(最低配置) | +3.1 个百分点 |
| 视觉风格判定与人类多数票一致性(40 张盲评纹理) | AUC | TPIPS(art style 因子)0.66 | CSD 风格嵌入 0.54 | +0.12 |
局限与改进
作者承认的局限:(1) 任何有限评估器都无法穷尽验证开放式世界修改,深层多系统干预的副作用可能落在测试场景之外;回归检查仅 225 条且集中于 L1 的 30 个任务,深层保持性只被部分测试;(2) 定量评估仅覆盖 Minecraft(Fabric)与 Terraria(tModLoader),PEAK、Palworld、Starbound 只有定性示例,跨世界泛化未验证;(3) 只评状态、行为与视觉,音频、动画、叙事等模态未覆盖且难以用确定性检查捕捉;(4) 因原生游戏执行与多模态验证成本高,每个模型–任务对只评一次,结果刻画配置级表现而非任务级成功概率。我的补充观察:(1) 110 任务规模偏小,L4 每游戏仅 13–14 个任务,单任务涨跌约 ±7 个百分点,模型排序缺乏置信区间;(2) 视觉度量与人判断一致性有限(AUC 0.66,评分者间 Krippendorff's α 仅 0.25/0.20),视觉结论应谨慎解读;(3) 固定 3600 秒预算对不同 harness 可能不公平——表 8 显示各配置耗时差异巨大(Claude 在 Minecraft L1 中位 3 分钟 vs GLM-5.3 约 31 分钟),时间用得少未必代表能力弱;(4) 任务由人类标注者撰写,论文未讨论与模型预训练数据的潜在污染风险。
独立分析的弱点
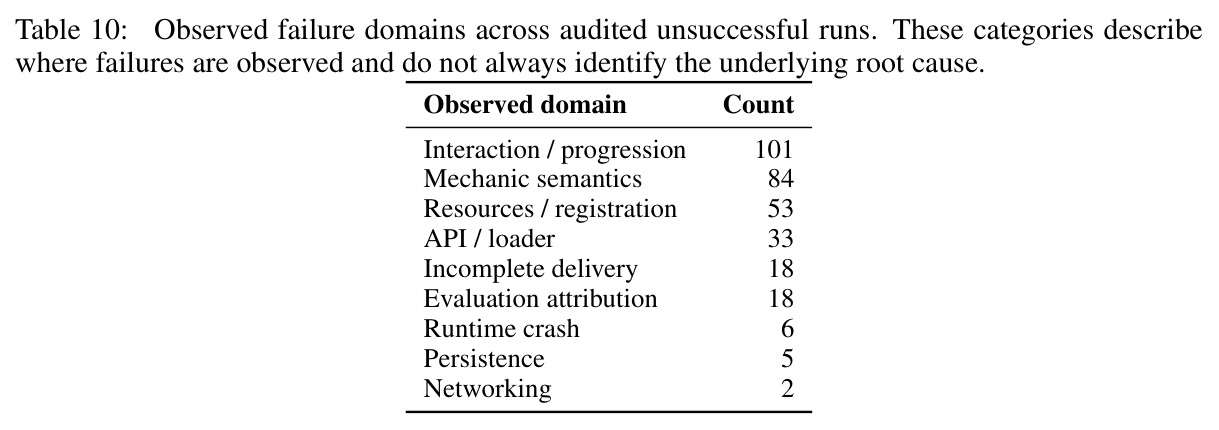
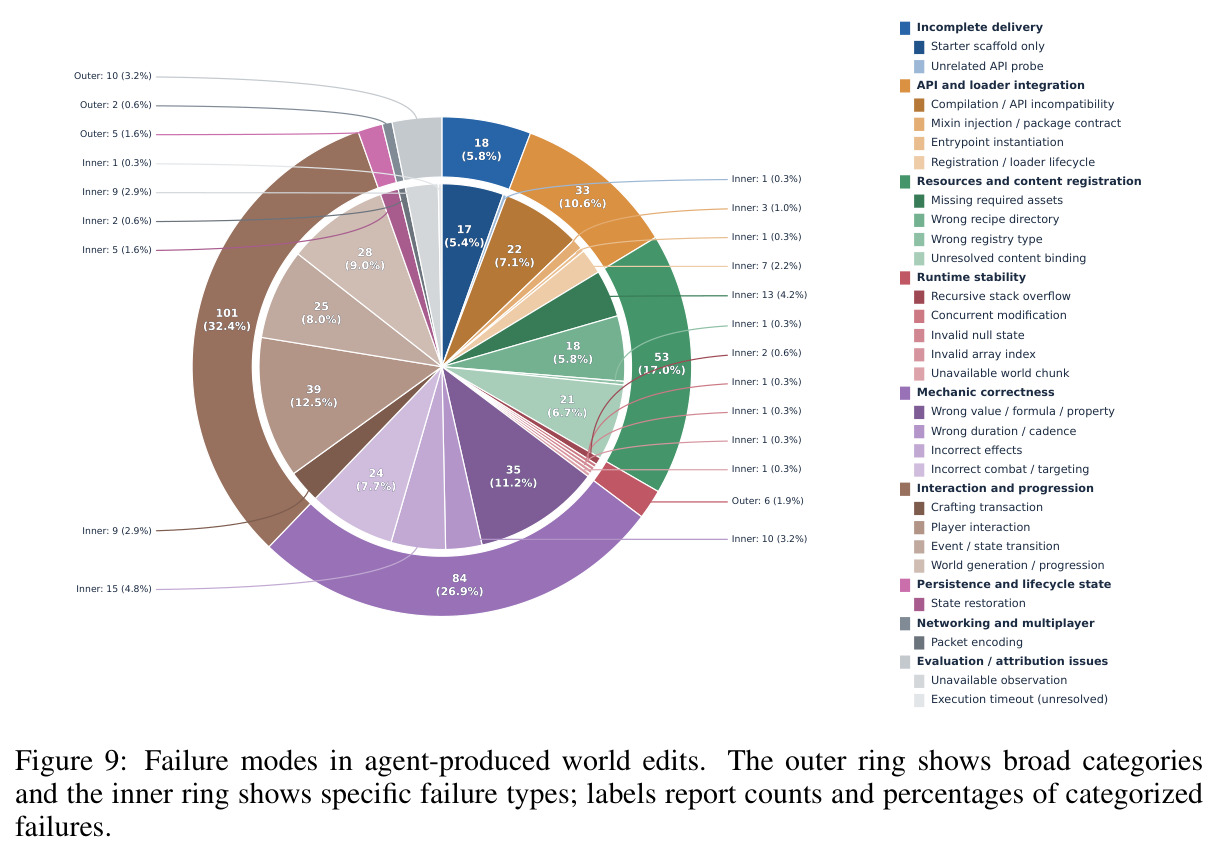
独立分析的主要弱点:其一,深层任务的保持性验证几乎缺失——225 条回归检查集中于 L1,意味着“系统干预不破坏现有系统”这一核心主张在 L4 基本未被测量,而这恰是 L4 最易出错之处(图 6 显示 L4 曾出现破坏性物品复制);改进方向是为 L3/L4 自动合成回归套件,对原世界状态空间采样快照并做差分比对。其二,视觉评估协议偏弱:TPIPS 与人类判断的 AUC 仅 0.66,人类校准样本只有 40 张且评分者一致性低(α≈0.2),对像素艺术这类低分辨率素材感知度量的可靠性存疑;可引入像素艺术专用度量或轻量判别器微调。其三,单次评测加固定时间预算带来高方差与 harness 偏差,个别配置在小样本层级上的排序(如 Gemini L4 WSR 59.3% 反超多数模型)可能受运气影响,应每任务多次重复并报告区间。其四,失败归因粒度粗:表 10 承认大量案例根因未定,“交互/进度失败”(101 例)只说明失败在哪里被观察到而非 agent 错在哪;可引入因果探针工具(差分日志、状态追踪、最小复现生成)辅助归因。其五,干预深度是单一标量轴,但 L4 任务间的耦合类型(状态耦合、时序耦合、界面耦合)差异很大,单一深度标签可能掩盖不同失败模式;可扩展为多维耦合标注。
未来方向
作者明确提出的方向:(1) 把干预深度作为组织轴,为未来世界模型与 agent 的训练、鲁棒性与泛化研究构建受控世界变体——在保留大部分结构的前提下做受控编辑来系统生成多样化环境(论文声明未评估这些下游用途);(2) 将定量评估扩展到更多可执行世界(PEAK、Palworld、Starbound 已定性验证分类法适用),尽管每个环境需要生态专属的执行与验证基础设施;(3) 把评估扩展到音频、动画、叙事等模态,需要模态专属的验证协议;(4) 增加长时程与多人场景的运行时覆盖以捕捉交互依赖型失败。基于本文成果可延伸的方向:(1) IGMBench 的确定性判据天然适合作为 RL 奖励信号,训练 agent 的深层编辑能力,把“可靠性随深度下降”从观测变成可优化目标;(2) 将世界编辑与世界模型生成结合,用编辑过的世界变体做结构化 domain randomization,服务 agent 训练数据的规模生产;(3) 研究“编辑–保持”权衡的自动化保障,例如由 LLM 自动生成回归测试套件作为编辑智能体的内建安全网;(4) 视觉与功能的联合优化——功能最强的配置视觉并不占优(GPT-5.6 Sol 联合通过率仅 0.19/0.18),提示需要风格适配专用模块(参考原生素材的调色板约束、少样本风格迁移);(5) 跨生态迁移研究:在 Fabric 上习得的编辑策略能否零样本迁移到 tModLoader 或其他引擎。
复现评估
复现条件总体友好。开源方面:论文声明 IGMWorld 源码、IGMBench 任务规格与评估脚本均为作者原创并随论文发布;不含游戏二进制与专有素材,用户需自行获得 Minecraft/Terraria 及兼容工具链(作者团队有 ImaGenWorld 等开源先例,可信度较高)。环境完全钉死:Minecraft 1.21.1/Fabric 0.19.3/Gradle 8.12/Java 21 与 tModLoader v2026.05.3.0/.NET 8.0,每任务提供初始脚手架、构建命令、固定种子世界与独立验证环境;附录 E 给出完整评估基础设施(RCON+Mineflayer+Fabric 客户端、tModLoader evaluator mod、行为七字段描述与五组件测试结构、概率机制四种测法)。算力与成本:评估端单任务 p95 约 508 秒(2×AMD EPYC 7302、32 核、503GiB 内存),5 个并行 worker 约 6 小时跑完全基准;agent 端主要是 API 成本,中位处理 token 从 0.1M 到 12.9M 不等,每 run 上限 3600 秒墙钟。难度评估:确定性验证部分(给定 mod 仓库判分)应可精确复现;但闭源模型版本漂移(GPT-5.6、Claude Opus 4.8 等持续更新)与单次评测的随机性会使主结果难以逐位复现,复现结论的量级与配置排序是更现实的目标。视觉部分依赖 TPIPS 模型与留一法校准协议,附录 E.4 的实现细节($\alpha$、$k$、敏感性与人类验证)较完整。
论文图表
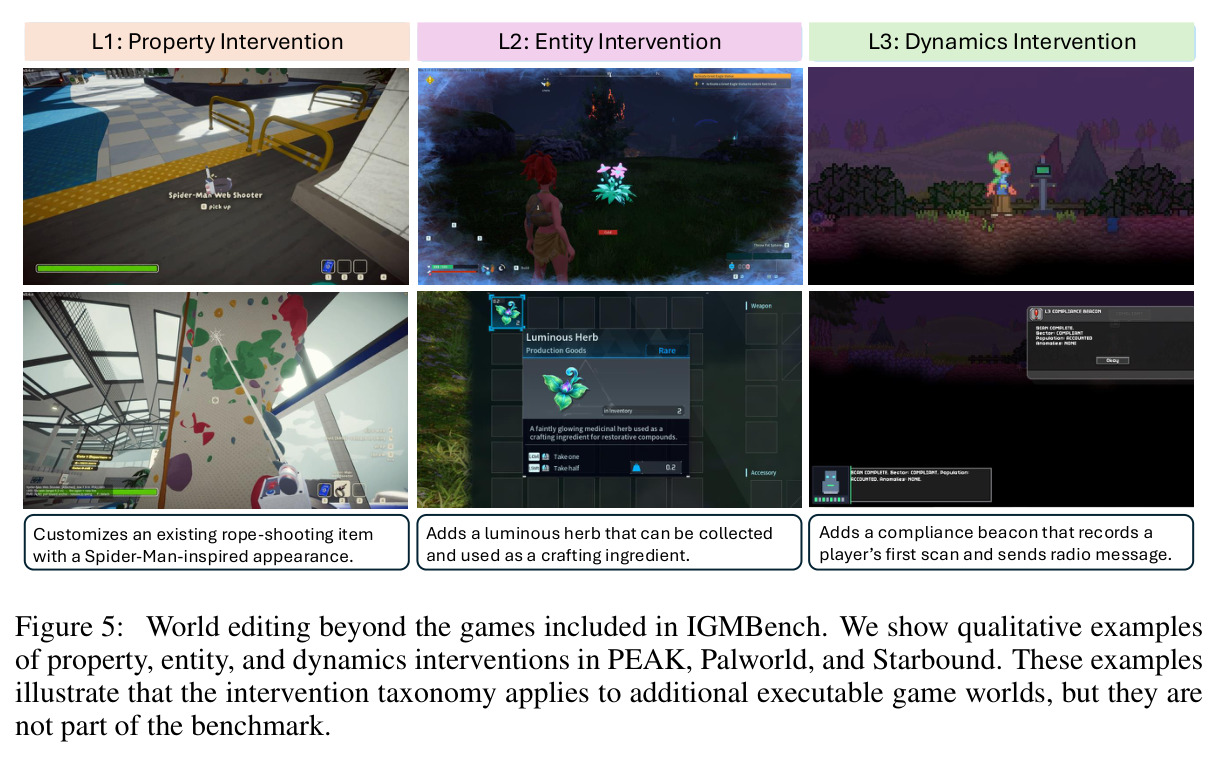
在 PEAK(蜘蛛侠风格绳索道具的 L1 属性编辑)、Palworld(可采集发光草药的 L2 实体编辑)、Starbound(记录首次扫描并发送无线电的合规信标 L3 动力学编辑)三个未入基准的游戏中的定性干预示例。
证明干预分类法与“世界编辑”框架不绑定于 Minecraft/Terraria,支持论文“世界编辑是关于可执行世界的一般能力、游戏只是可验证测试台”的核心主张。