EditAgent:通过扩展动作空间与观察空间重构智能体式图像编辑 EditAgent: Rethinking Agentic Image Editing
并行生成多方法候选,用验证记录武装现成VLM判官,无需微调即超越奖励模型。
前置知识
智能体式图像编辑(Agentic Image Editing)
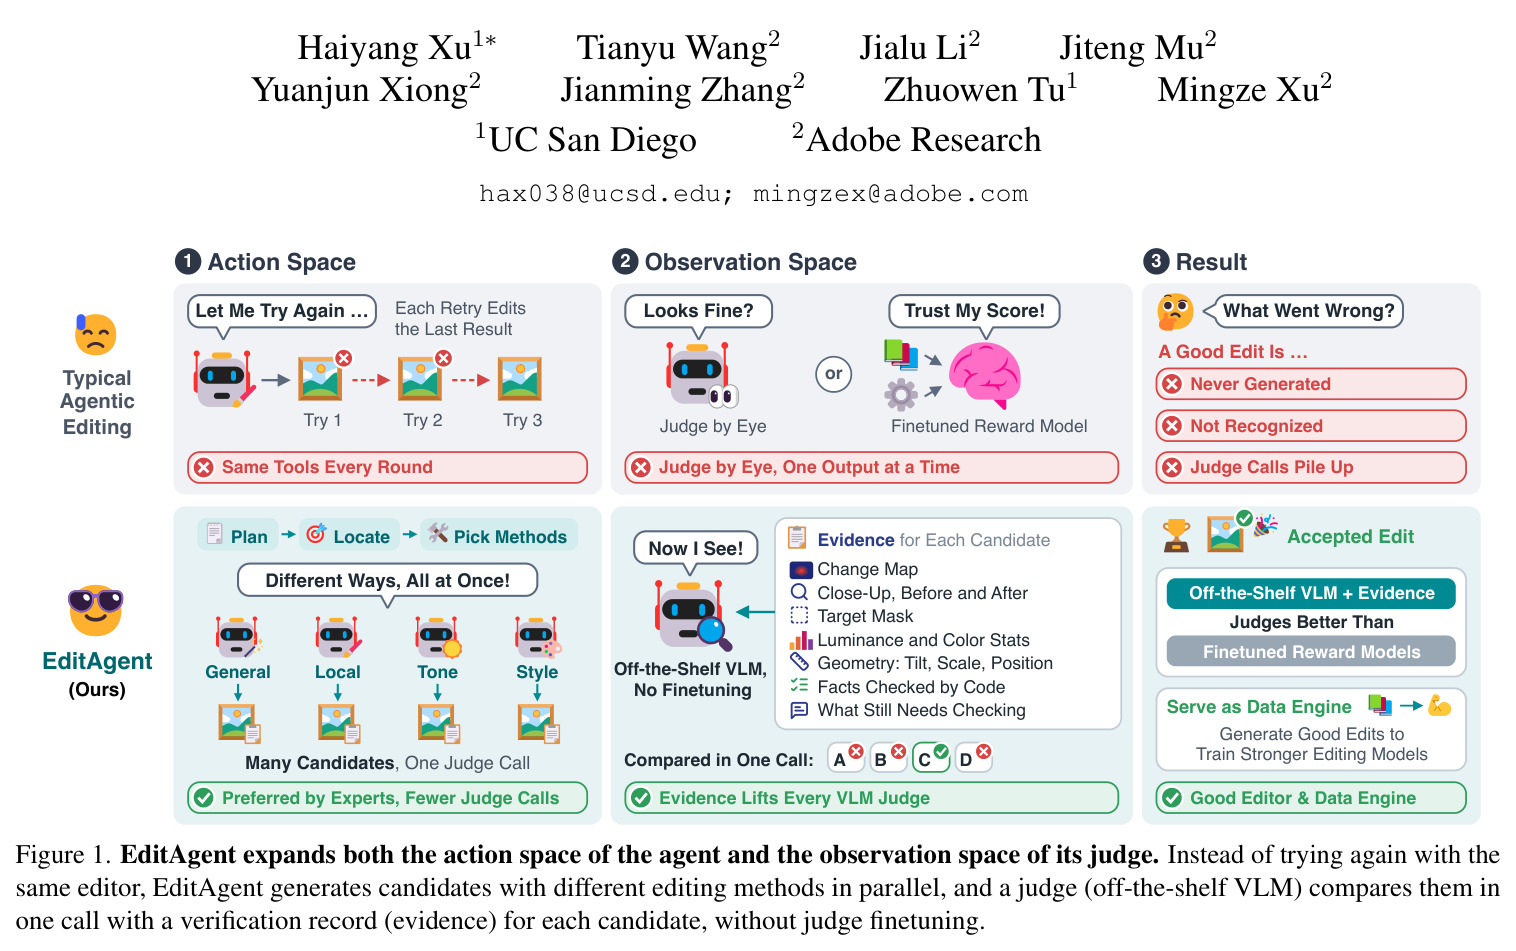
把一条复杂的图像编辑请求(如'把我移到左边、拉宽镜头、去掉路人、调成日落')交给一个由规划器、编辑器、评判器组成的系统:规划器把请求分解成有序步骤,每步调用图像编辑模型执行,再由视觉语言模型(VLM)检查结果是否合格,失败则重试或回滚。现有系统(IMAGAgent、RISE-Agent、GenArtist 等)大多每轮使用同一套工具重试,judge 逐张'凭眼睛'打分。
本文的全部论点建立在对这类系统的批评之上:它们的失败源于'动作空间'(agent 能做什么)和'观察空间'(judge 能看到什么)太窄,理解这两个概念才能理解 EditAgent 的改动方向。
Winner-Set Hit@1
本文为诊断基准设计的指标。五位专业 Photoshop 修图师对每个候选集(源图+指令+2~4个候选结果)标出所有'可用'候选,构成 winner set(获胜集)。judge 给候选打分后取其最高分候选,若该候选落在 winner set 内则命中;并列最高分时按并列者中 winner 的比例共享得分。随机基线约为 59.3%。
论文中关于 judge 好坏的所有结论(如证据让 VLM 提升 6.3~9.3 点)都用这个指标度量,不懂它就无法读懂第 3、4 节的实验数字。
Pointwise 与 Listwise 评判
Pointwise(逐点式)指 judge 每次只看一个候选,独立给出分数或 pass/fail 判定;Listwise(列表式)指 judge 在一次调用中同时看到所有候选及其证据,进行横向比较后选出最佳并给出完整排名。奖励模型因输入输出模板固定只能 pointwise,而现成 VLM 两者皆可。
这是本文观察空间扩展的核心手段:Table 1 显示 listwise 让现成 VLM 的准确率从约 72% 跳到 85% 以上,一次调用反超微调奖励模型,是全文最有冲击力的发现。
验证记录(Verification Record / Evidence)
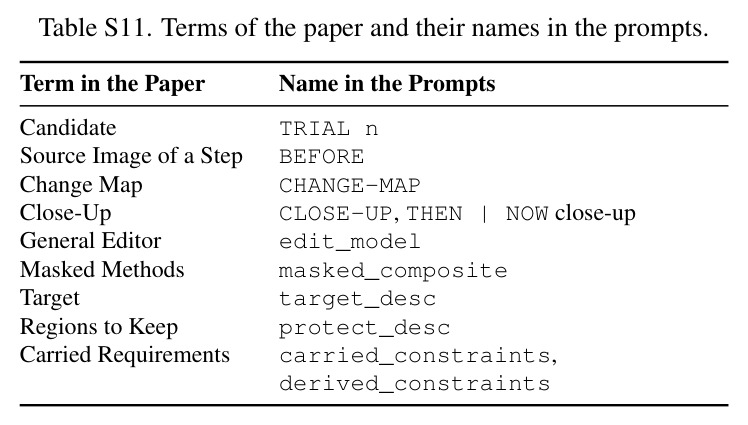
附在每个候选上交给 judge 的结构化证据包:逐像素色差变化图(change map)、局部编辑区域 448px 高的前后特写(close-up)、CIELAB 空间的量化统计(亮度 $L^*/100$、对比度、饱和度 $\sqrt{a^{*2}+b^{*2}}$、高光裁剪率、色彩偏移)、可见变化占比($\Delta E > 8$ 的像素比例),以及代码检查结论——代码能保证的列入 VERIFIED,必须目视判断的列入 TO JUDGE。
有了证据,judge 不再单凭眼睛:Photometric 和 Enhancement 组(正确结果与源图变化很小)的命中率从 47.2%/36.8% 恢复到 64.4%/80.3%,这是方法成立的关键。
编辑奖励模型(EditScore / EditReward)
在大规模人工偏好标注上微调的专用编辑质量评判模型,如 EditScore 系列(7B/32B/72B,基于 Qwen 微调)和 EditReward-7B。它们输出候选的绝对分数,用于 best-of-n 选择或在线强化学习的奖励信号,通常被认为是编辑质量评判的强基线(EditScore-72B 四次集成达 76.3%)。
本文最有争议也最有价值的结论是:不加任何微调,用验证记录武装的现成 VLM 在评判上全面超过这些专门训练的奖励模型——这直接挑战了'必须训练专用奖励模型'的路线。
研究动机
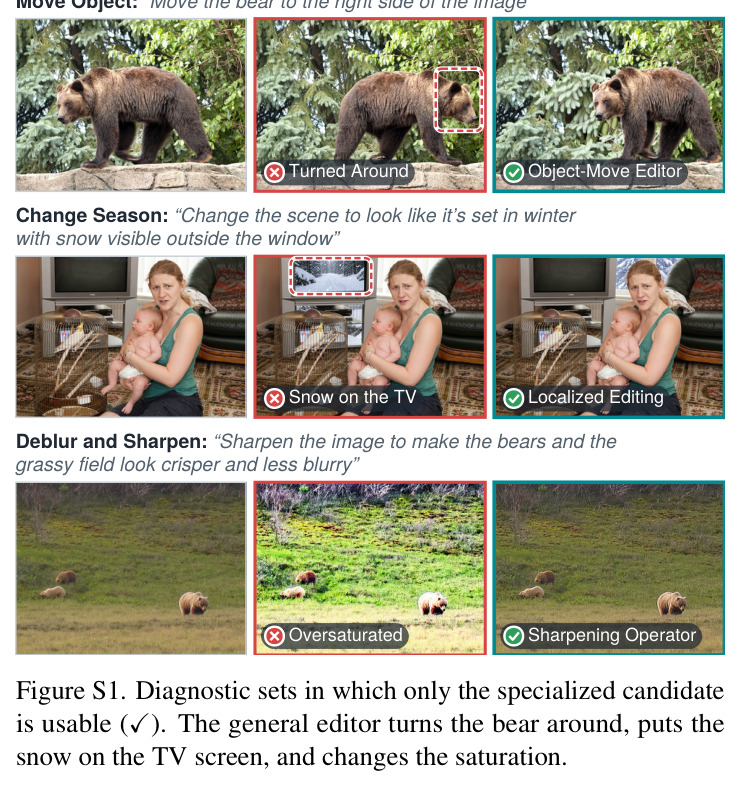
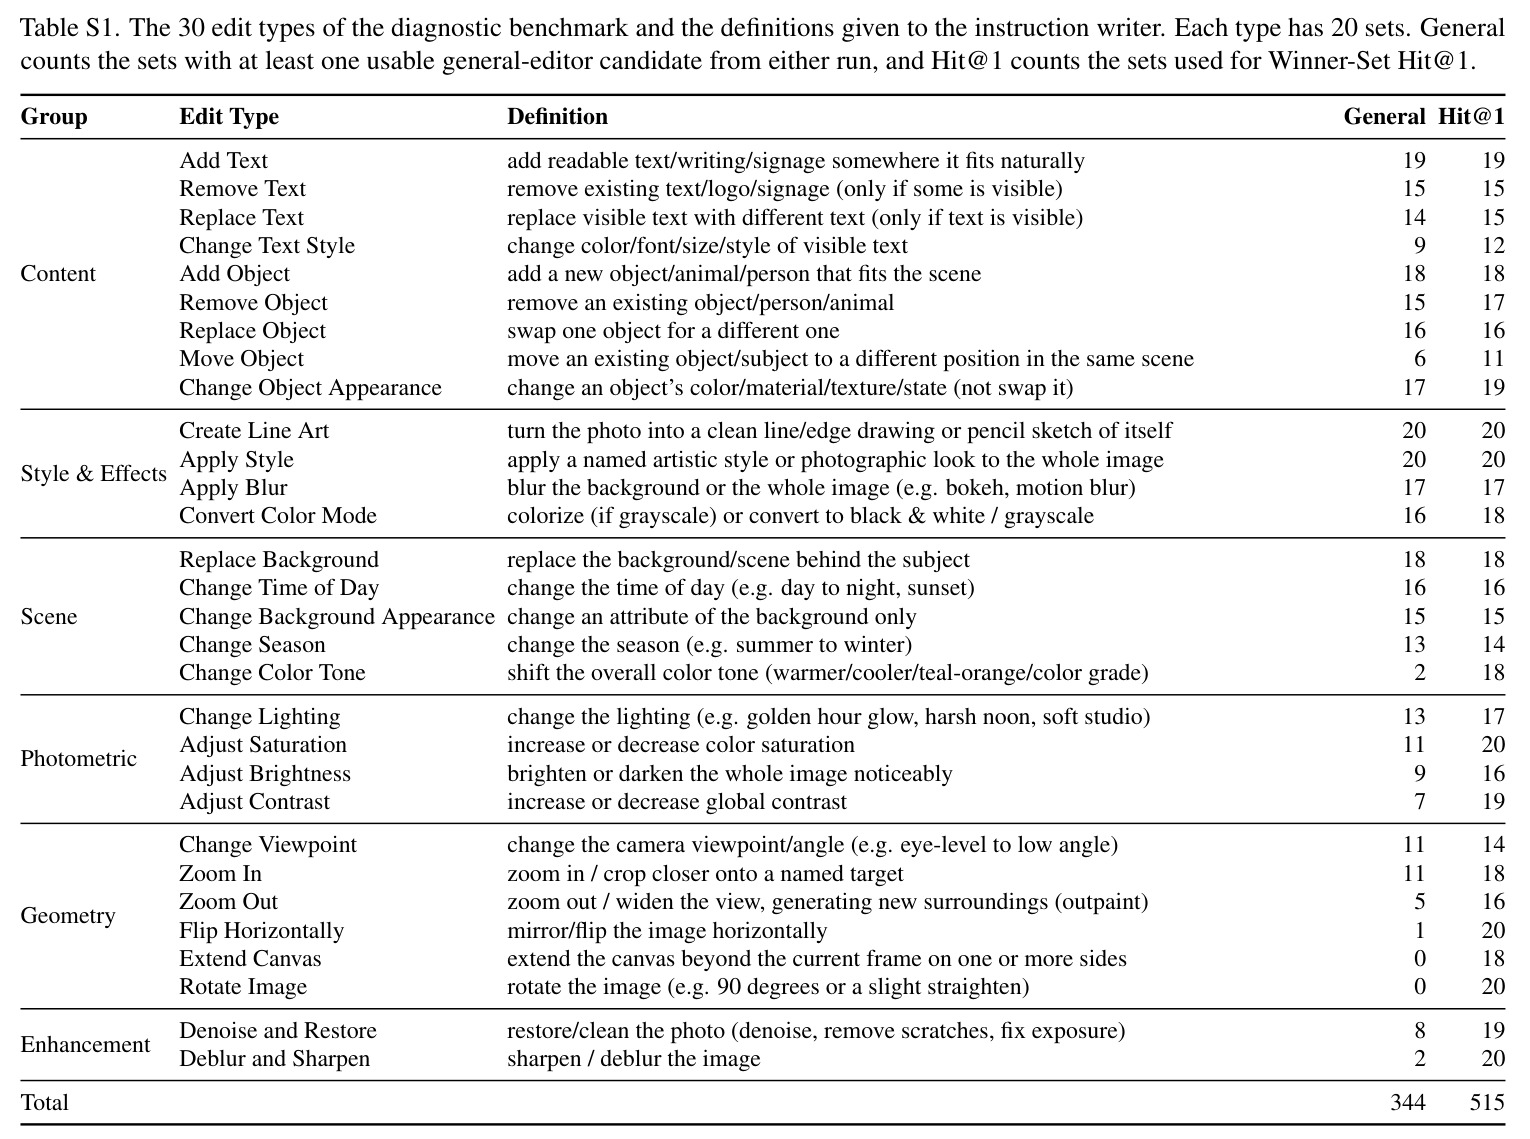
真实世界的编辑请求几乎从来不是单条指令:'把我移到画面左侧、拉宽镜头露出更多海滩、去掉身后走过的路人、调成日落氛围'这样的复合请求很常见,而当今的编辑模型往往完成其中一部分后悄悄丢掉其余部分。智能体式系统试图用'计划-编辑-评判'循环解决,但现有系统(IMAGAgent、RISE-Agent、GenArtist、EditThinker 等)受限于两个狭窄的空间:每一步失败时只用同一套工具重试通用编辑器,judge 只拿到源图、编辑图和指令就凭眼睛给单个输出打分。后果被本文新构建的专家诊断基准精确量化:在 600 个候选集(30 种编辑类型 × 20 组,5 位专业 Photoshop 修图师盲标)中,通用编辑器 FLUX.2-klein-9B 在 42.7%(256/600)的集合中产不出任何可用结果,失败集中在几何、色调和增强类编辑;同时没有任何一个被测 judge 在所有编辑组上最准——EditScore-72B 整体 Winner-Set Hit@1 最高(74.8%)却只在 Scene 组登顶,Qwen3.8-27B 在三个组最好但在 Photometric 组只比随机高 5.2 个百分点,CLIP-I 在 Photometric/Enhancement 最准却在需要明显变化的 Style & Effects 与 Geometry 组接近或低于随机。
本文的目标是本文的目标可以拆成三层。第一是诊断:构建一个由 5 位专业修图师盲标、覆盖 30 种细粒度编辑类型 600 个候选集的基准,分别量化'动作空间不够大'和'观察空间不够大'各自造成多少损失,并回答三个具体问题——通用编辑器是只需要更多采样还是需要更大的方法池(Sec 3.2)、固定预算下候选应该顺序精修还是并行生成(Sec 3.3)、逐张打分的 judge 能否选出合格编辑(Sec 3.4)。第二是构建:提出 EditAgent,把每一步路由到通用编辑器与专业方法(掩码局部编辑、物体移除/移动、光度算子、几何变换等)并行生成候选,给每个候选附上验证记录,让现成 VLM 在一次 listwise 调用中比较全部候选后接受或反馈。第三是复用:由于 EditAgent 只接受通过验证的编辑,其完整接受的会话可以作为高质量训练数据,微调出更强的独立编辑模型。
与已有工作不同的是,本文的独特切入角度有三处。其一,诊断框架本身:把智能体编辑的失败归因到'agent 的动作空间'与'judge 的观察空间'两个正交维度,并用同一批专家标注分别度量两者,这在以往的编辑智能体文献中没有人系统做过。其二,推翻了从文本到图像生成领域搬来的经验——在生成任务中顺序迭代精修已被证明能提升与文本的对齐,但本文发现在编辑任务中恰恰相反:因为编辑必须忠实于源图,顺序精修不断在自己上一轮的输出上继续编辑、误差累积,而并行搜索让每个候选都直接从源图生成;在 144 个 Complex-Edit 样本的盲评中,5 位专业修图师在 78.5% 的非平局比较中偏好并行搜索,且 VLM 调用次数不超过一半。其三,对 judge 的处理路线:不去训练专用奖励模型,而是证明'judge 看到什么'比'judge 怎么训练'更重要——把候选并列展示(listwise)加上验证记录,现成 VLM 不微调就能反超 EditScore-72B 的四次集成(85.2~86.1% 对 76.3%)。
核心方法
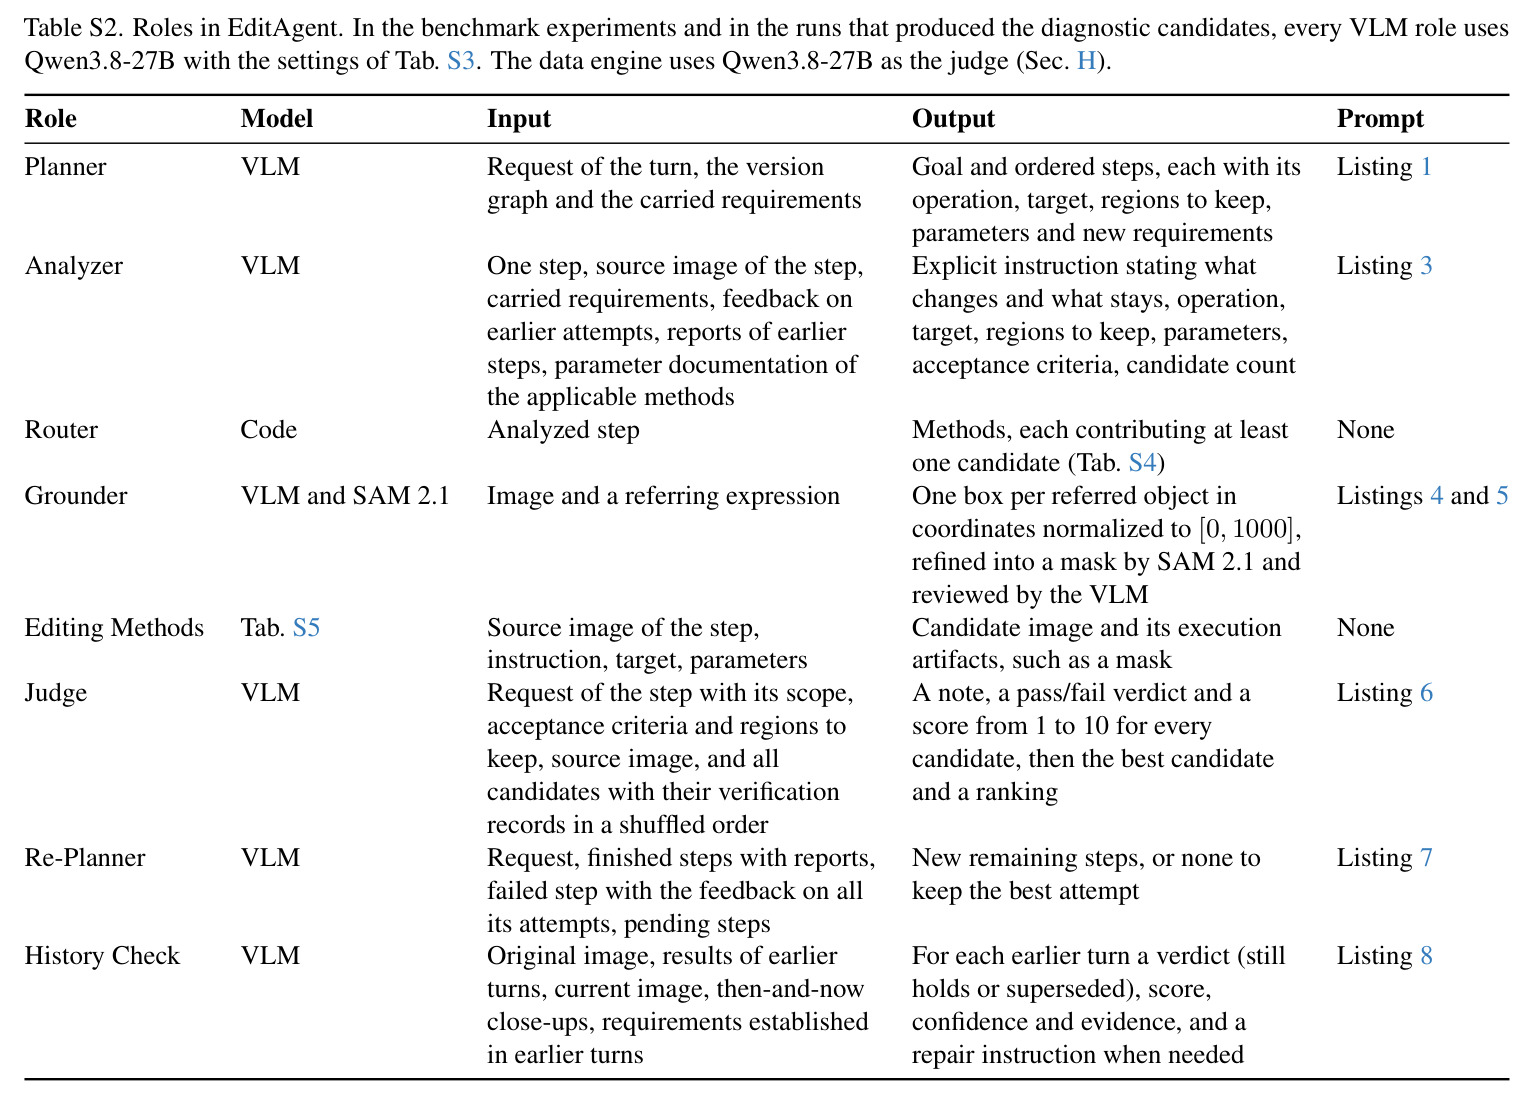
直觉来自专业修图师的工作方式:接到复合请求时,修图师会为每个部分挑选不同的工具,然后放大局部、对比前后图来检查结果,而不是拿同一个工具反复重试。EditAgent 把这个直觉工程化为一条三段式流水线(Figure 3):(A) 规划与路由——planner(Qwen3.8-27B)把用户请求分解成有序步骤并维护版本图,每个被接受的图像状态是不可变的节点,analyzer 把每步改写成显式指令(说明改什么、保什么、参数是什么),grounder 用 VLM 画框加 SAM 2.1 精炼掩码来定位目标,router 则是一段确定性代码,按操作类型从能力池中选出适用的方法;(B) 并行生成——所有被选中的方法从同一张源图并行生成候选,每次尝试最多 3 个、每个方法至少贡献 1 个,不同方法探索请求的不同实现方式,同方法不同种子(种子 $32+7a+j$)探索同一路线的变体;(C) 验证与比较——每个候选配上验证记录后,judge 在一次 listwise 调用中同时看到全部候选与证据,输出 pass/fail、1~10 分和完整排名,接受最佳候选或返回反馈触发下一轮尝试。每步最多 2 次重试,每轮最多 2 次重规划、1 次修复。
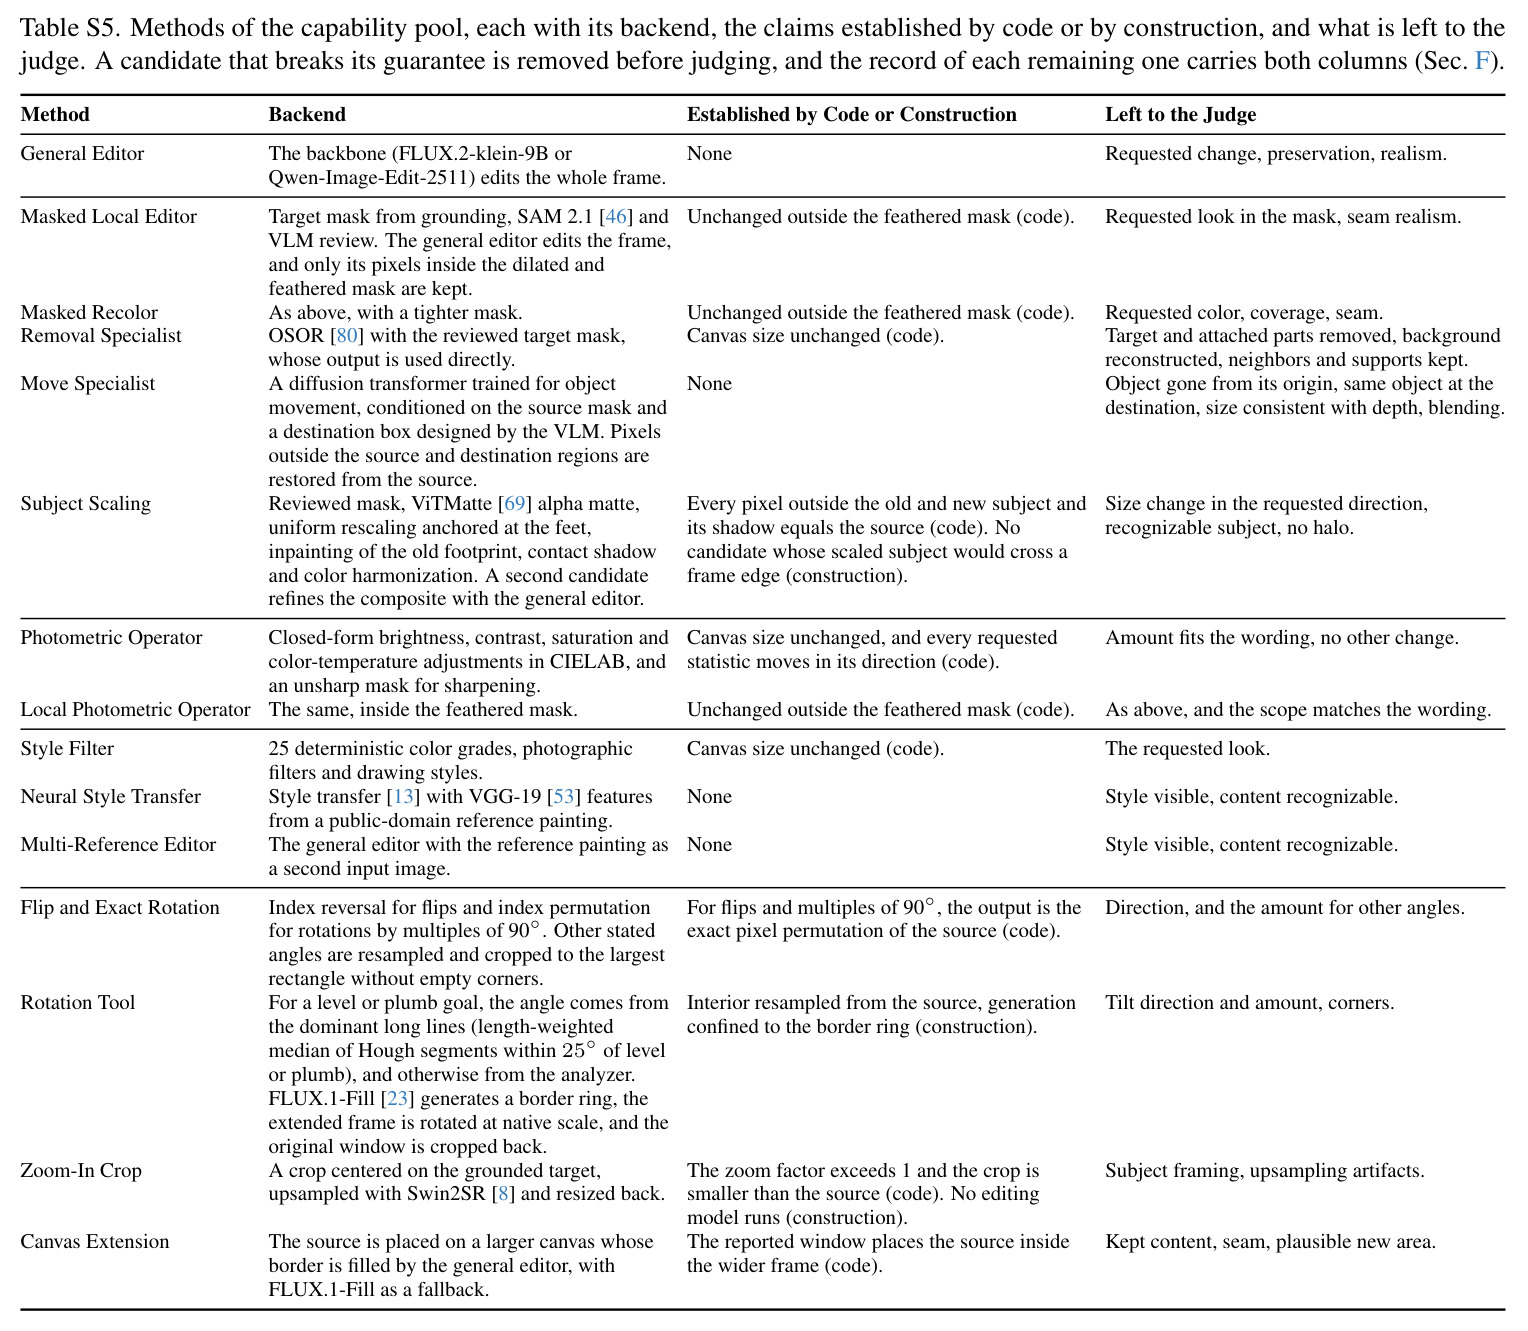
核心创新是'双空间扩展'及其耦合方式,与已有方法的本质区别在两处。动作空间上:现有智能体把每一步都交给同一个通用编辑器重试,EditAgent 则为每类编辑配置专门方法——掩码局部编辑/重上色(通用编辑器在 SAM 2.1 掩码内运行)、OSOR 物体移除、专用物体移动模型、基于 ViTMatte 的主体缩放、CIELAB 闭式解光度算子与 unsharp mask、风格滤镜与神经风格迁移、精确翻转/旋转与水平校正、Swin2SR 放大的放大裁剪与 FLUX.1-Fill 补全的画布扩展;消融证明这不是'更多采样'能替代的——把动作空间换成通用编辑器的 K 个副本(K=2/4/8),EdiVal-O 只恢复到 47.53/48.90/49.01,远低于真动作空间的 52.37。观察空间上:现有 judge 逐张凭眼打分,EditAgent 的 judge 拿到的是候选间的变化图、同位置同尺度的局部特写、量化光度统计,以及代码已验证事实与待目视判断事项的显式分离;关键在于代码检查会在评判前直接剔除违反自身保证的候选(如翻转不是精确像素置换、掩码外像素被改动的候选),judge 只在真正需要审美判断的地方做视觉决策。两者通过并行生成+一次 listwise 调用耦合,评审成本反而更低。
方法步骤详情
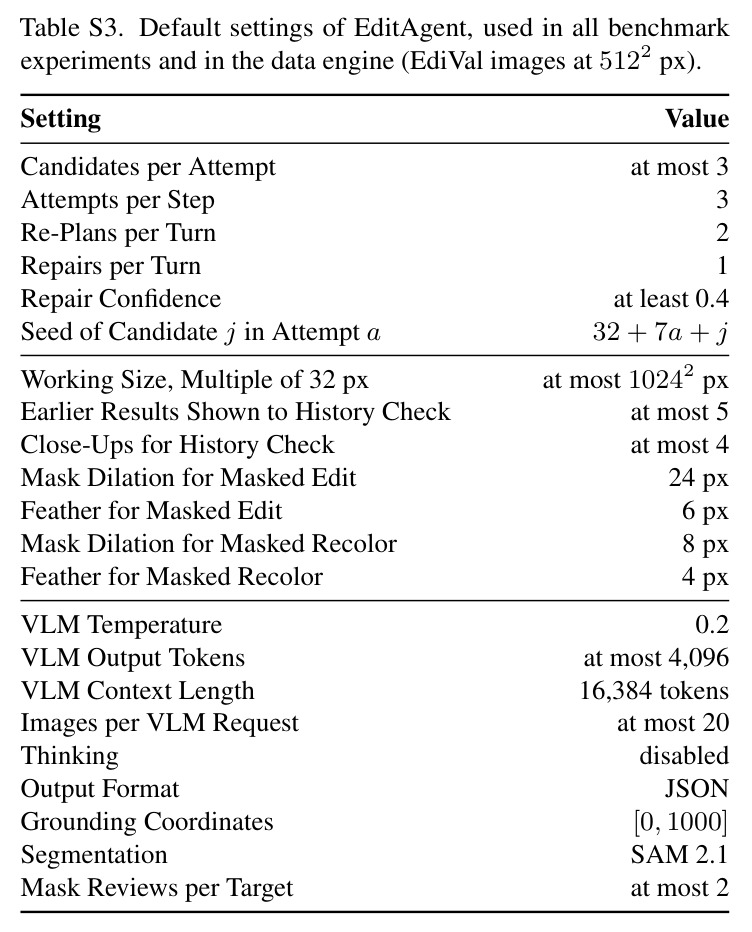
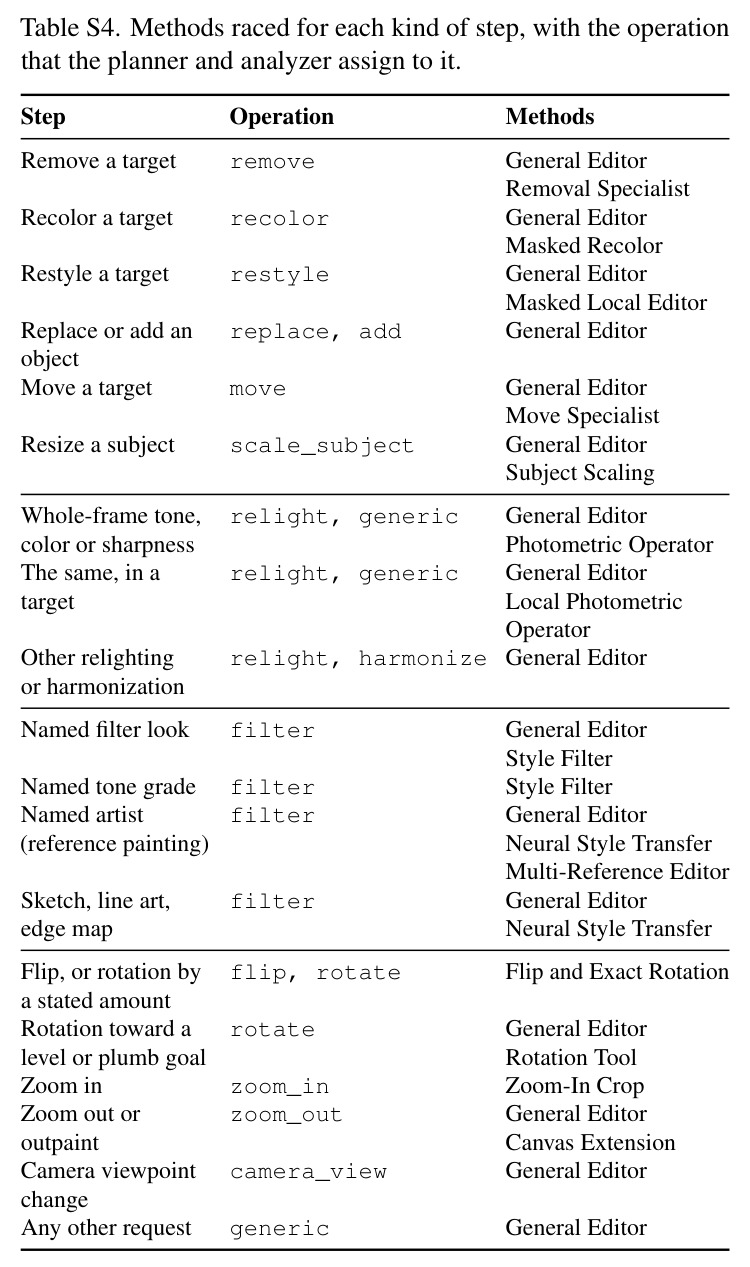
完整流程如下。第一步(规划):planner 读取用户请求、版本图和携带的需求(此前各轮确立的必须保持的约束),输出目标与有序步骤,每步含操作、目标、需保留区域、参数和新需求。第二步(分析):analyzer 把当前步骤连同源图、携带需求、此前尝试的反馈,改写成一条显式指令,明确'请求的改变'与'必须保持的内容',并给出候选数量建议。第三步(定位):grounder 对指令中提到的对象用 VLM 输出归一化到 $[0,1000]$ 的框,SAM 2.1 精炼成掩码,VLM 复核(每目标最多 2 次)。第四步(路由):router 按操作类型(remove/recolor/restyle/add/move/scale/relight/filter/flip/rotate/zoom 等)从方法表选出竞速的方法,每个掩码方法都与通用编辑器同场竞技以便回退。第五步(并行生成):各方法从同一源图生成候选并产出执行产物(如掩码)。第六步(验证记录):代码计算每个候选的可见变化占比(高斯模糊 $\sigma=1$px 后 $\Delta E>8$ 的像素比例)、变化图、局部特写(衬 30% 边距、高 448px、所有候选同位置同尺度)、操作相关统计(亮度/对比度/饱和度/裁剪率/色彩偏移、锐度比、噪声比、SSIM、方向相关、取景匹配),违反构造保证的候选被直接剔除。第七步(listwise 评判):judge 一次调用看到指令、源图、全部候选与记录(随机顺序),输出 JSON:每个候选的短评、pass/fail、1~10 分,然后最佳候选与完整排名;通过则候选成为新状态,不通过则短评回传给 analyzer 作为下次尝试的反馈。第八步(跨轮一致性):每轮结束后 history check 对比原图、此前各轮结果与当前图,逐一检查早期请求是否仍然成立(置信度 $\ge 0.4$ 视为确认违规),触发一次修复轮,且仅当步骤 judge 接受时才采纳;某步耗尽尝试时 re-planner 决定替换失败与待定步骤,或保留最佳尝试并标记需人工复核。
技术新颖性
技术新颖性体现在五个层面。第一,问题形式化新颖:'动作空间 × 观察空间'的双空间瓶颈分析是新的,且配套了首个由专业修图师共识盲标的诊断基准(600 集合、30 类型、1995 个候选),能分别归因两类短板——动作空间短板占 29.2%(仅专业方法可用)加 13.5%(全不可用),观察空间短板则由没有任何 judge 全组登顶的事实刻画。第二,并行搜索优于顺序精修的实证结论是新的且反直觉:先前文献(引用文献 [17])支持生成任务中的顺序迭代,本文用同一编辑器、同一 judge、同一 4 张图预算的受控对比加上盲评人因研究(102:28,78.5%)证明编辑任务中并行更优,机理是编辑的忠实性约束使误差累积成为主要风险。第三,zero-finetune judge 反超微调奖励模型:listwise 展示本身就把现成 VLM 从 71.7~73.8% 推到 85.2~86.1%,超过 EditScore-72B 四次集成的 76.3%,而 EditScore 因输出模板固定根本无法做 listwise 比较——这为'用任务定制观察格式替代任务定制训练'提供了有力证据。第四,验证记录的设计把'代码能验证的'与'必须目视的'显式分离,并用同一套流程对源图和候选统一计算,记录中不出现方法名,避免了 judge 对工具来源的偏置。第五,把通过验证的会话作为数据引擎是系统设计的自然延伸,且匹配输入对照实验证明其收益来自更高质量的监督而非更多样本。
实验结果
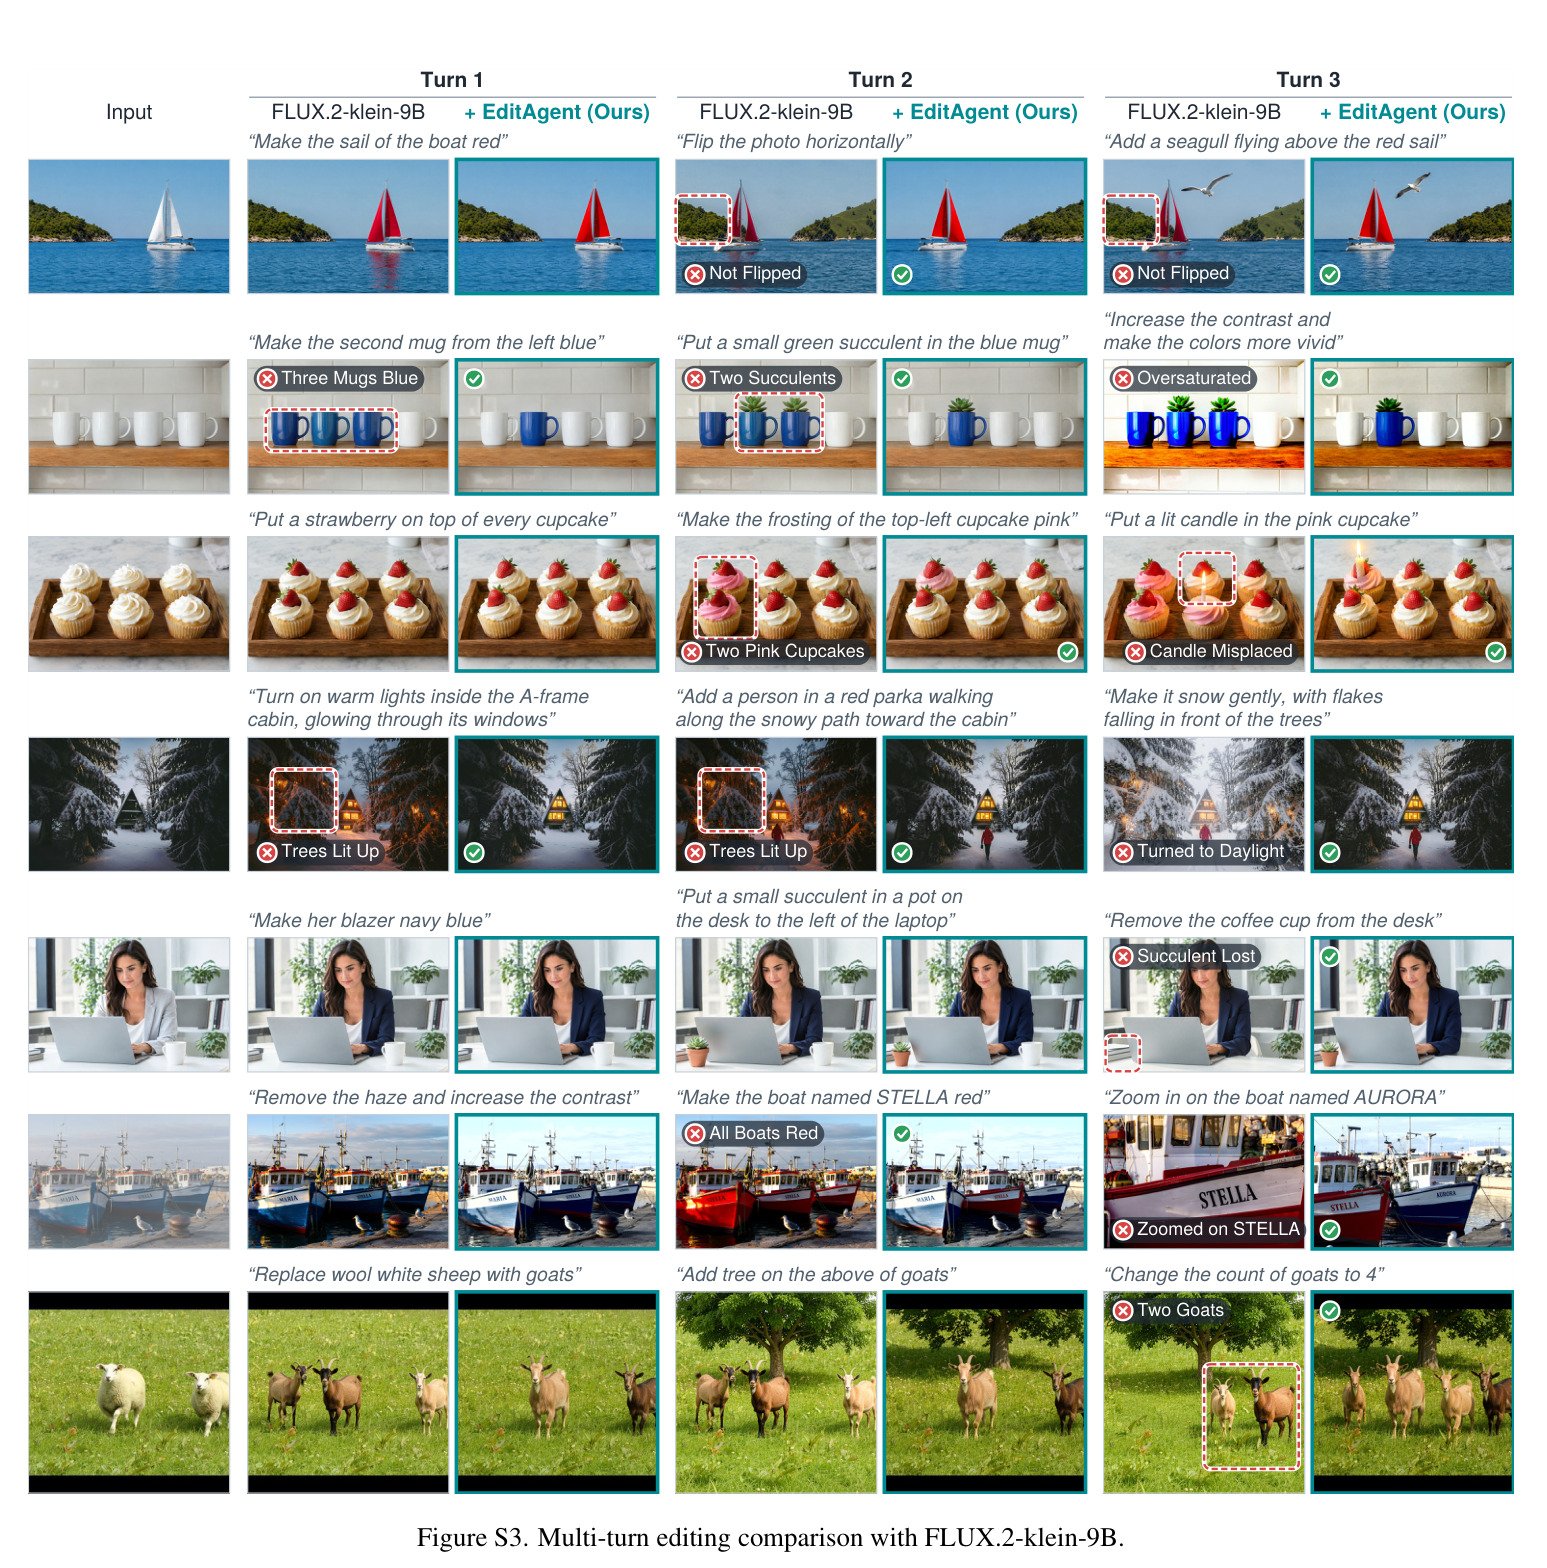
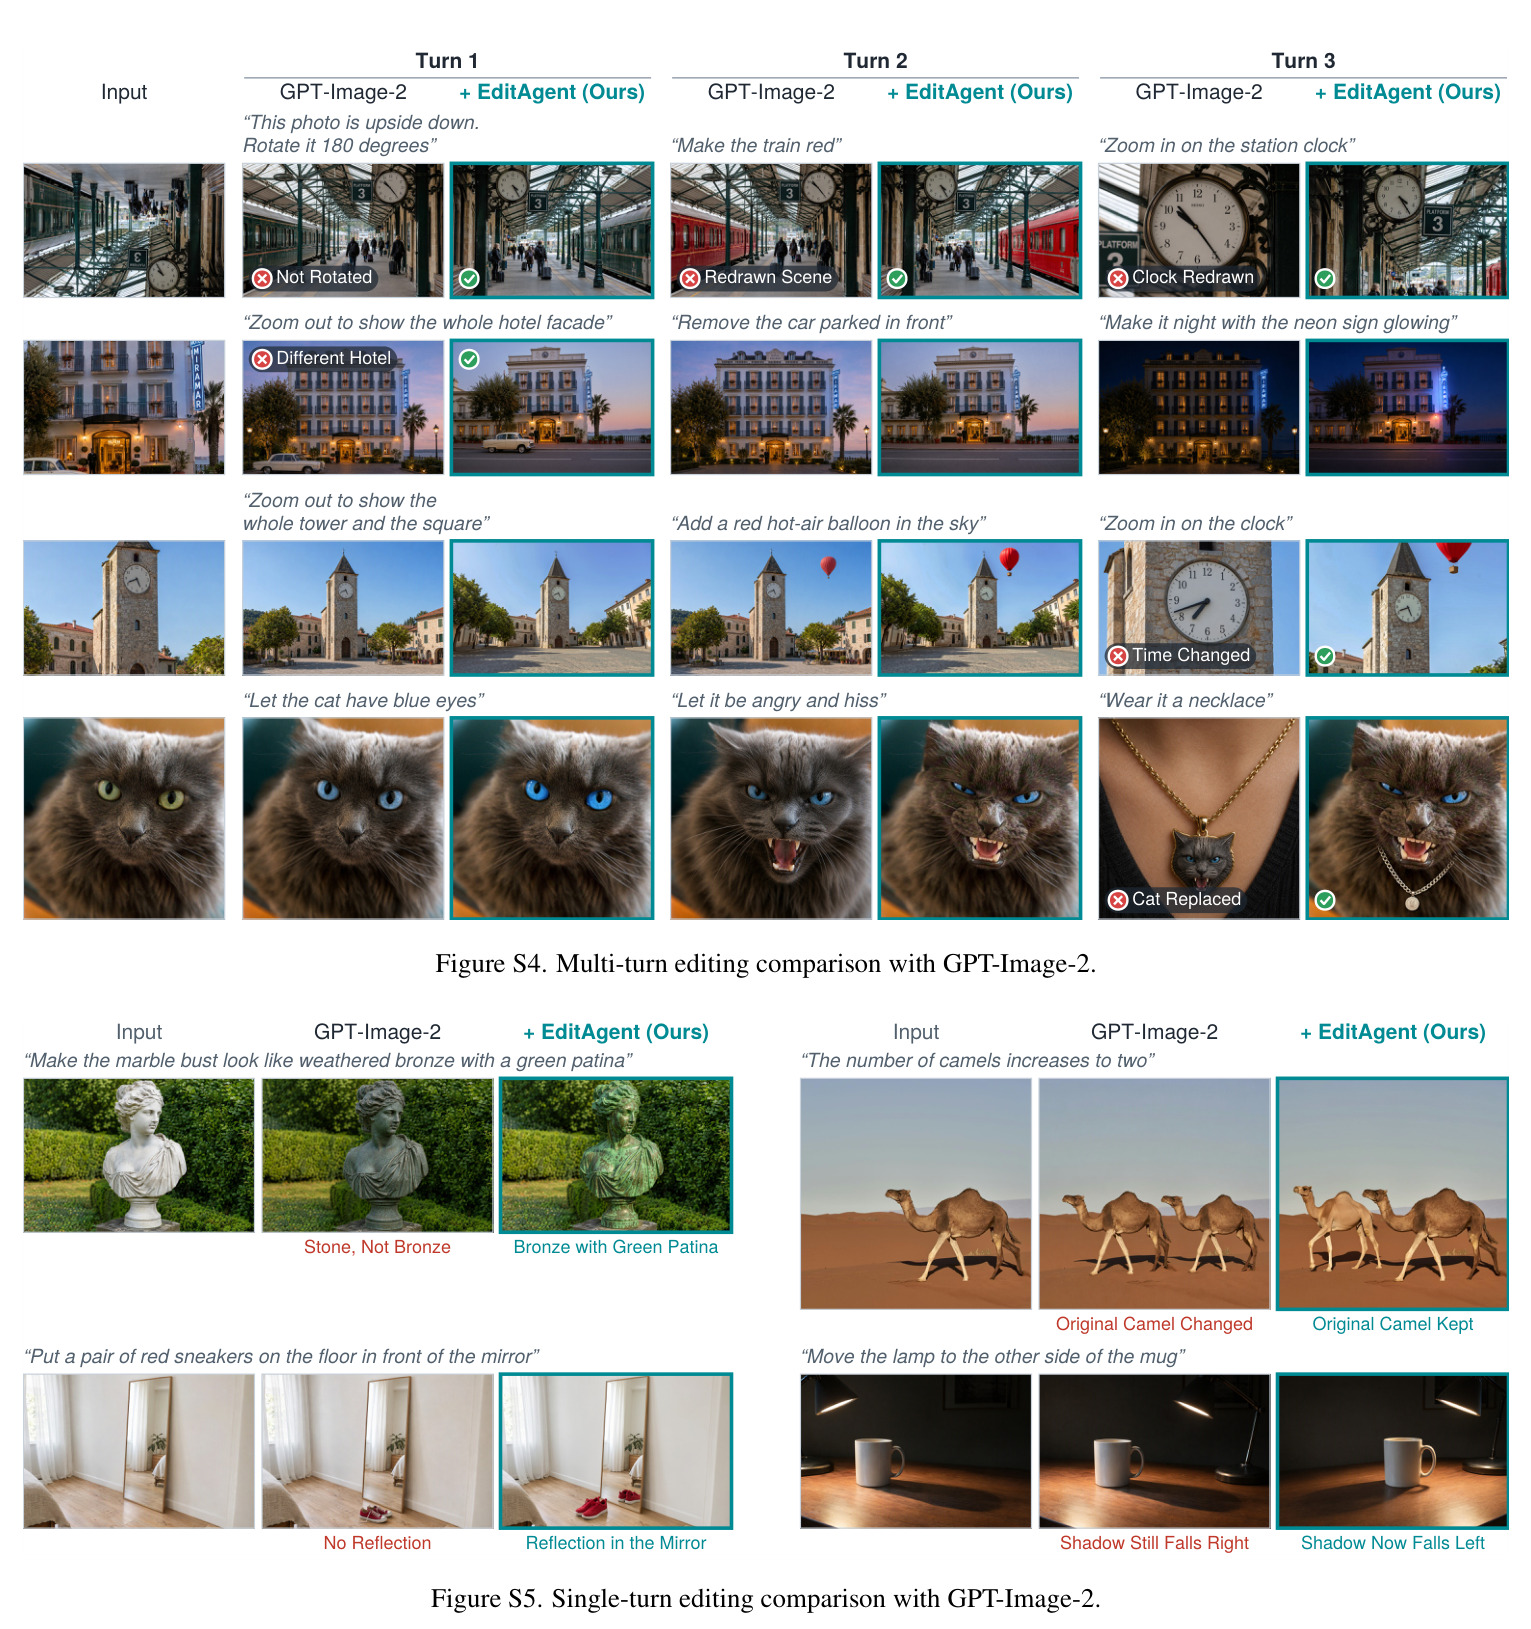
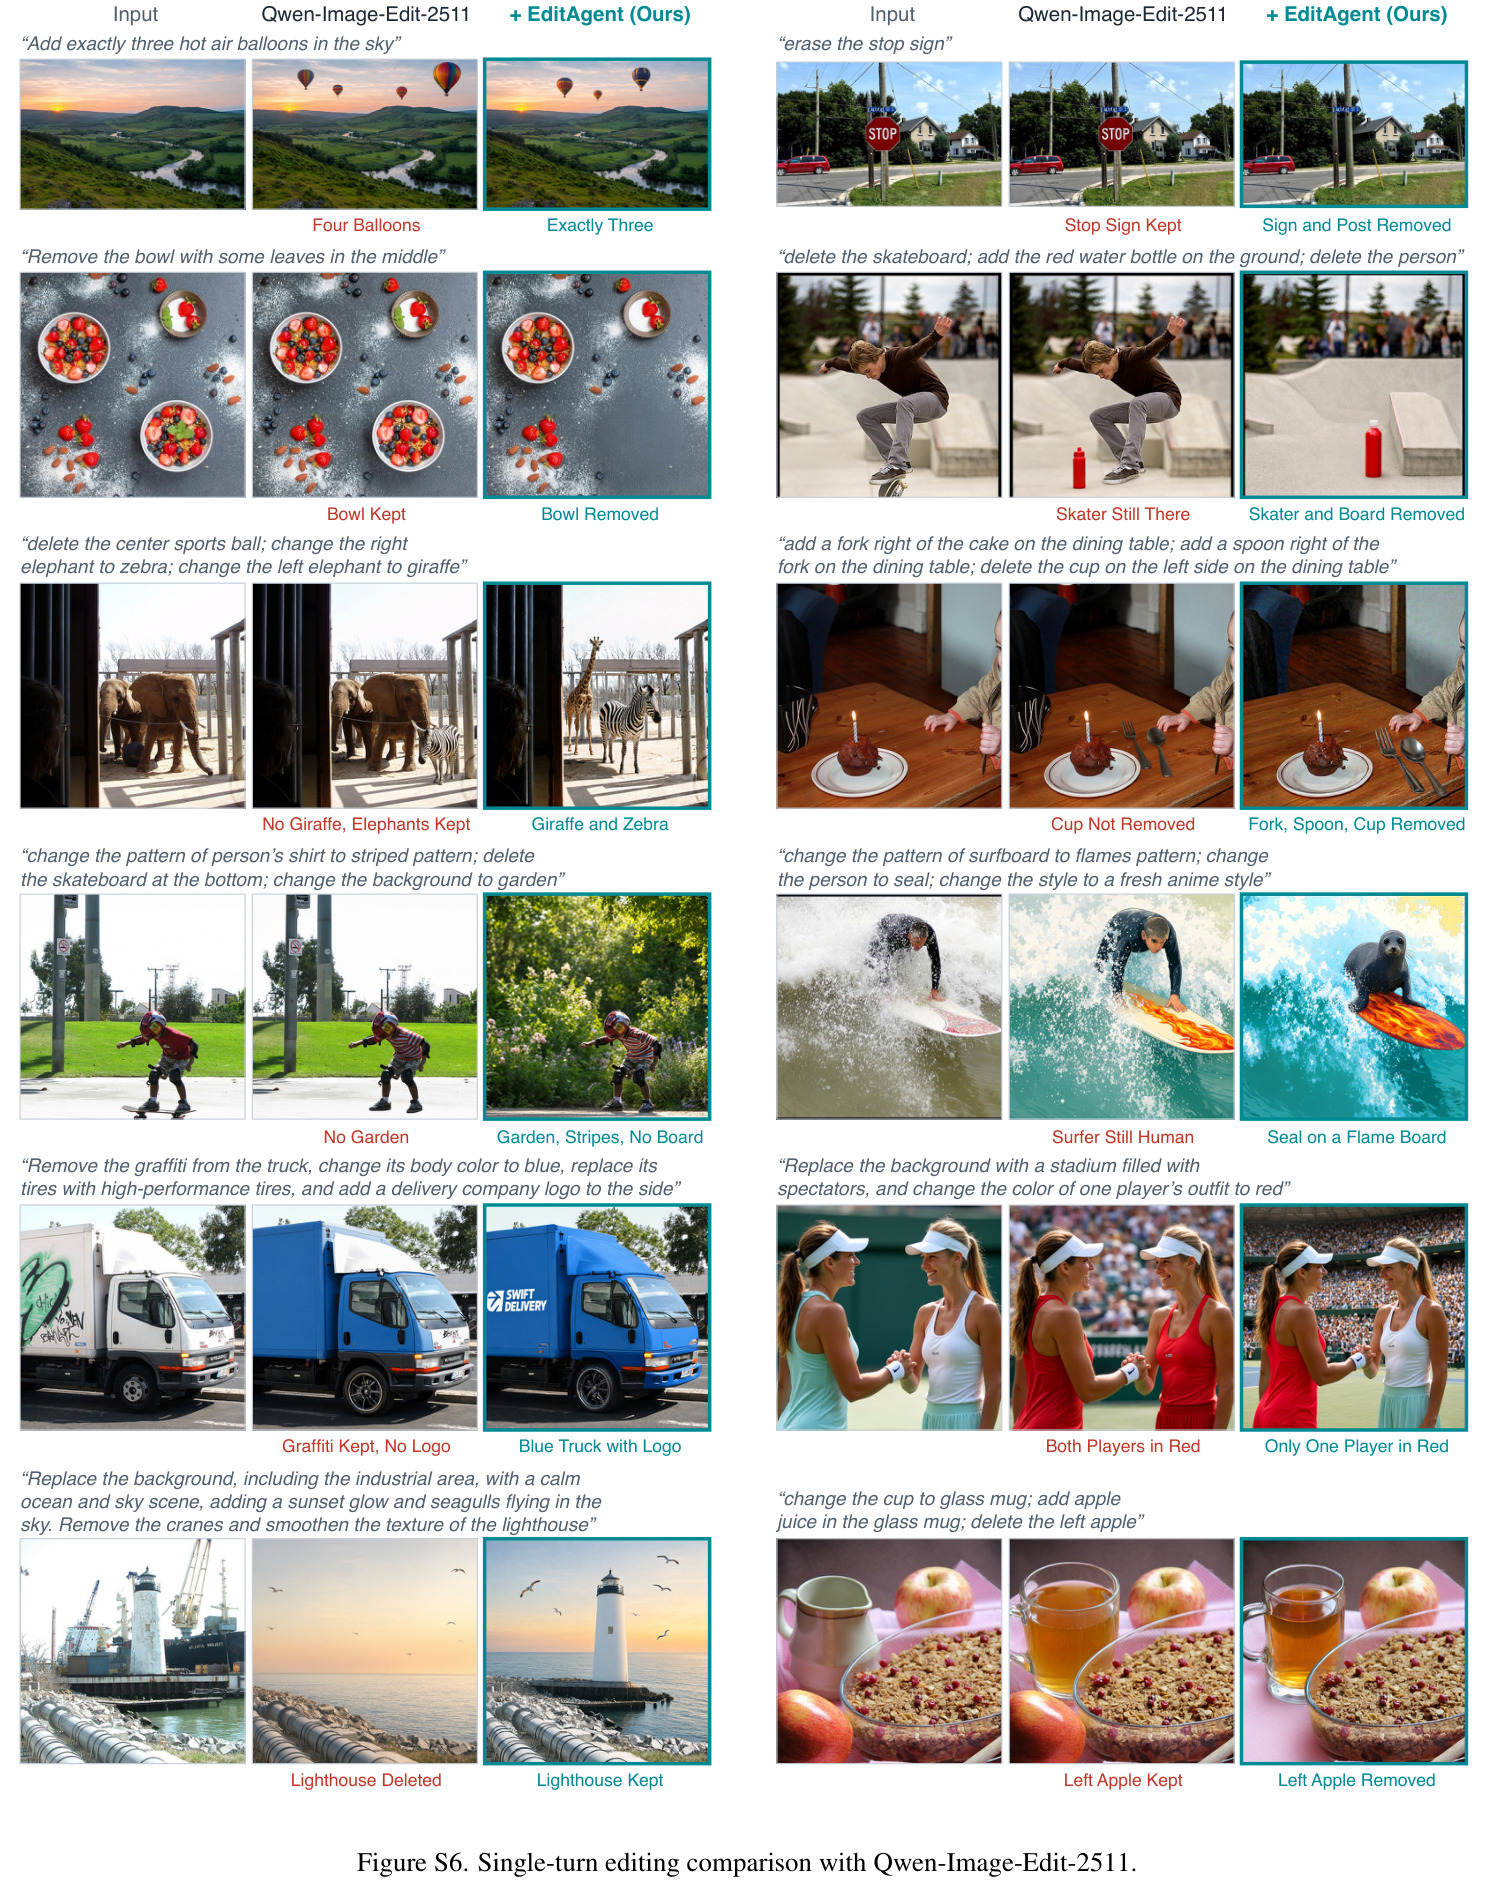
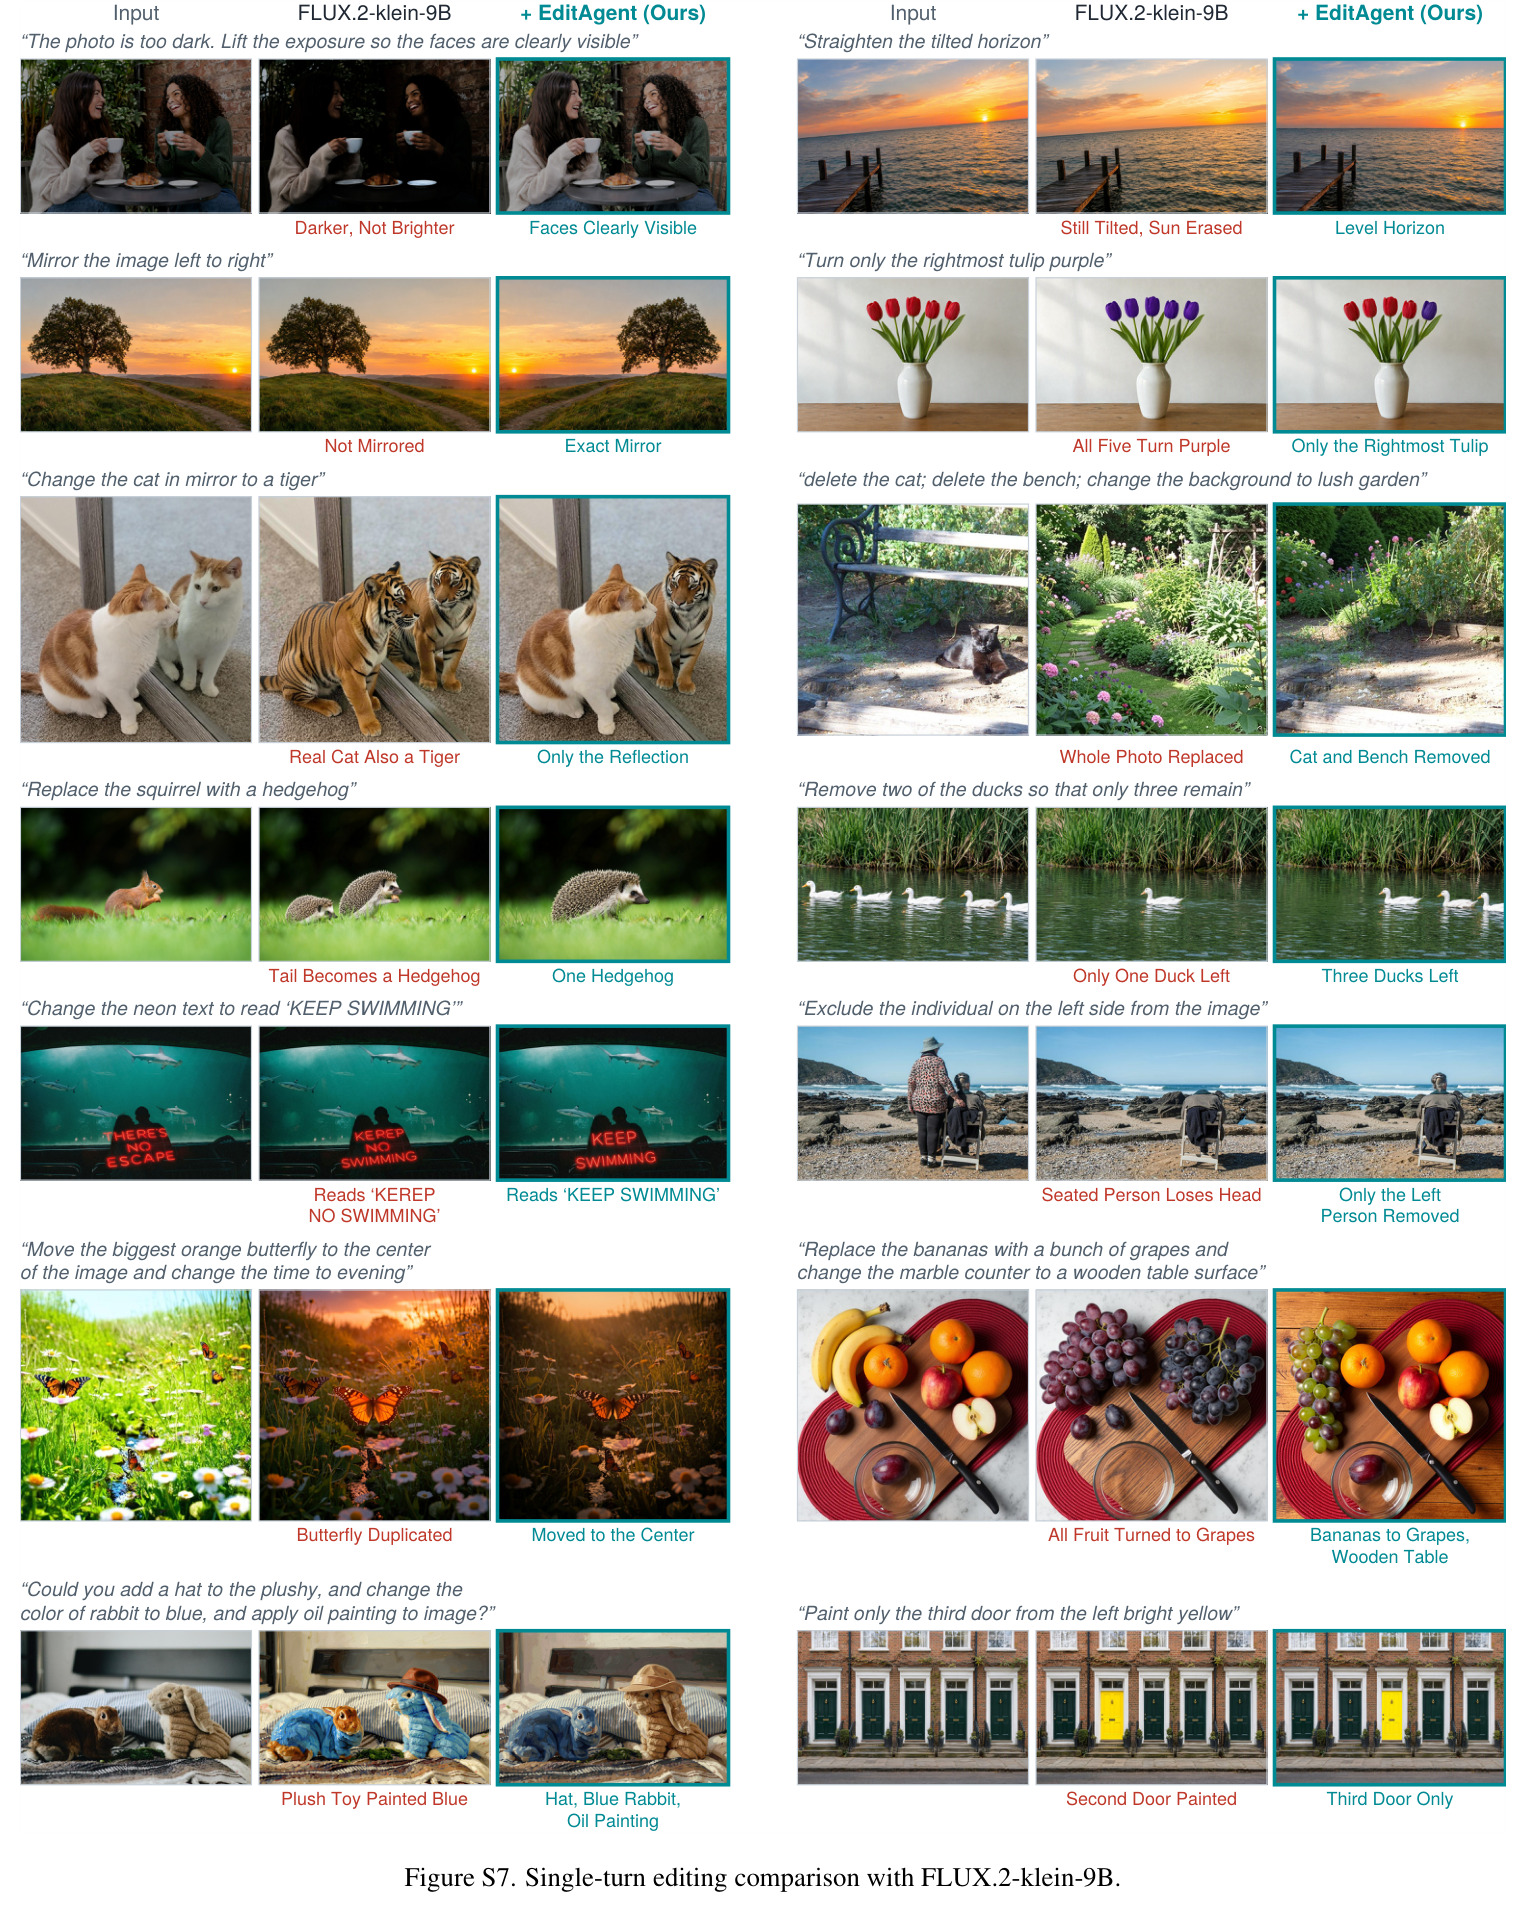
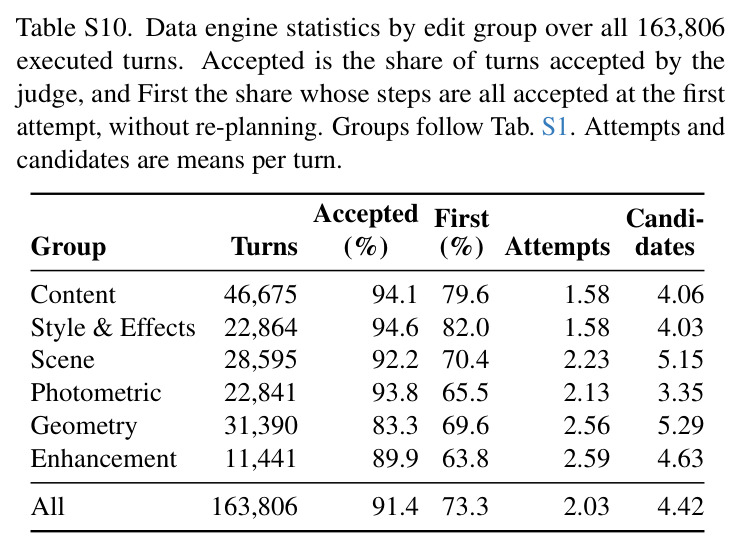
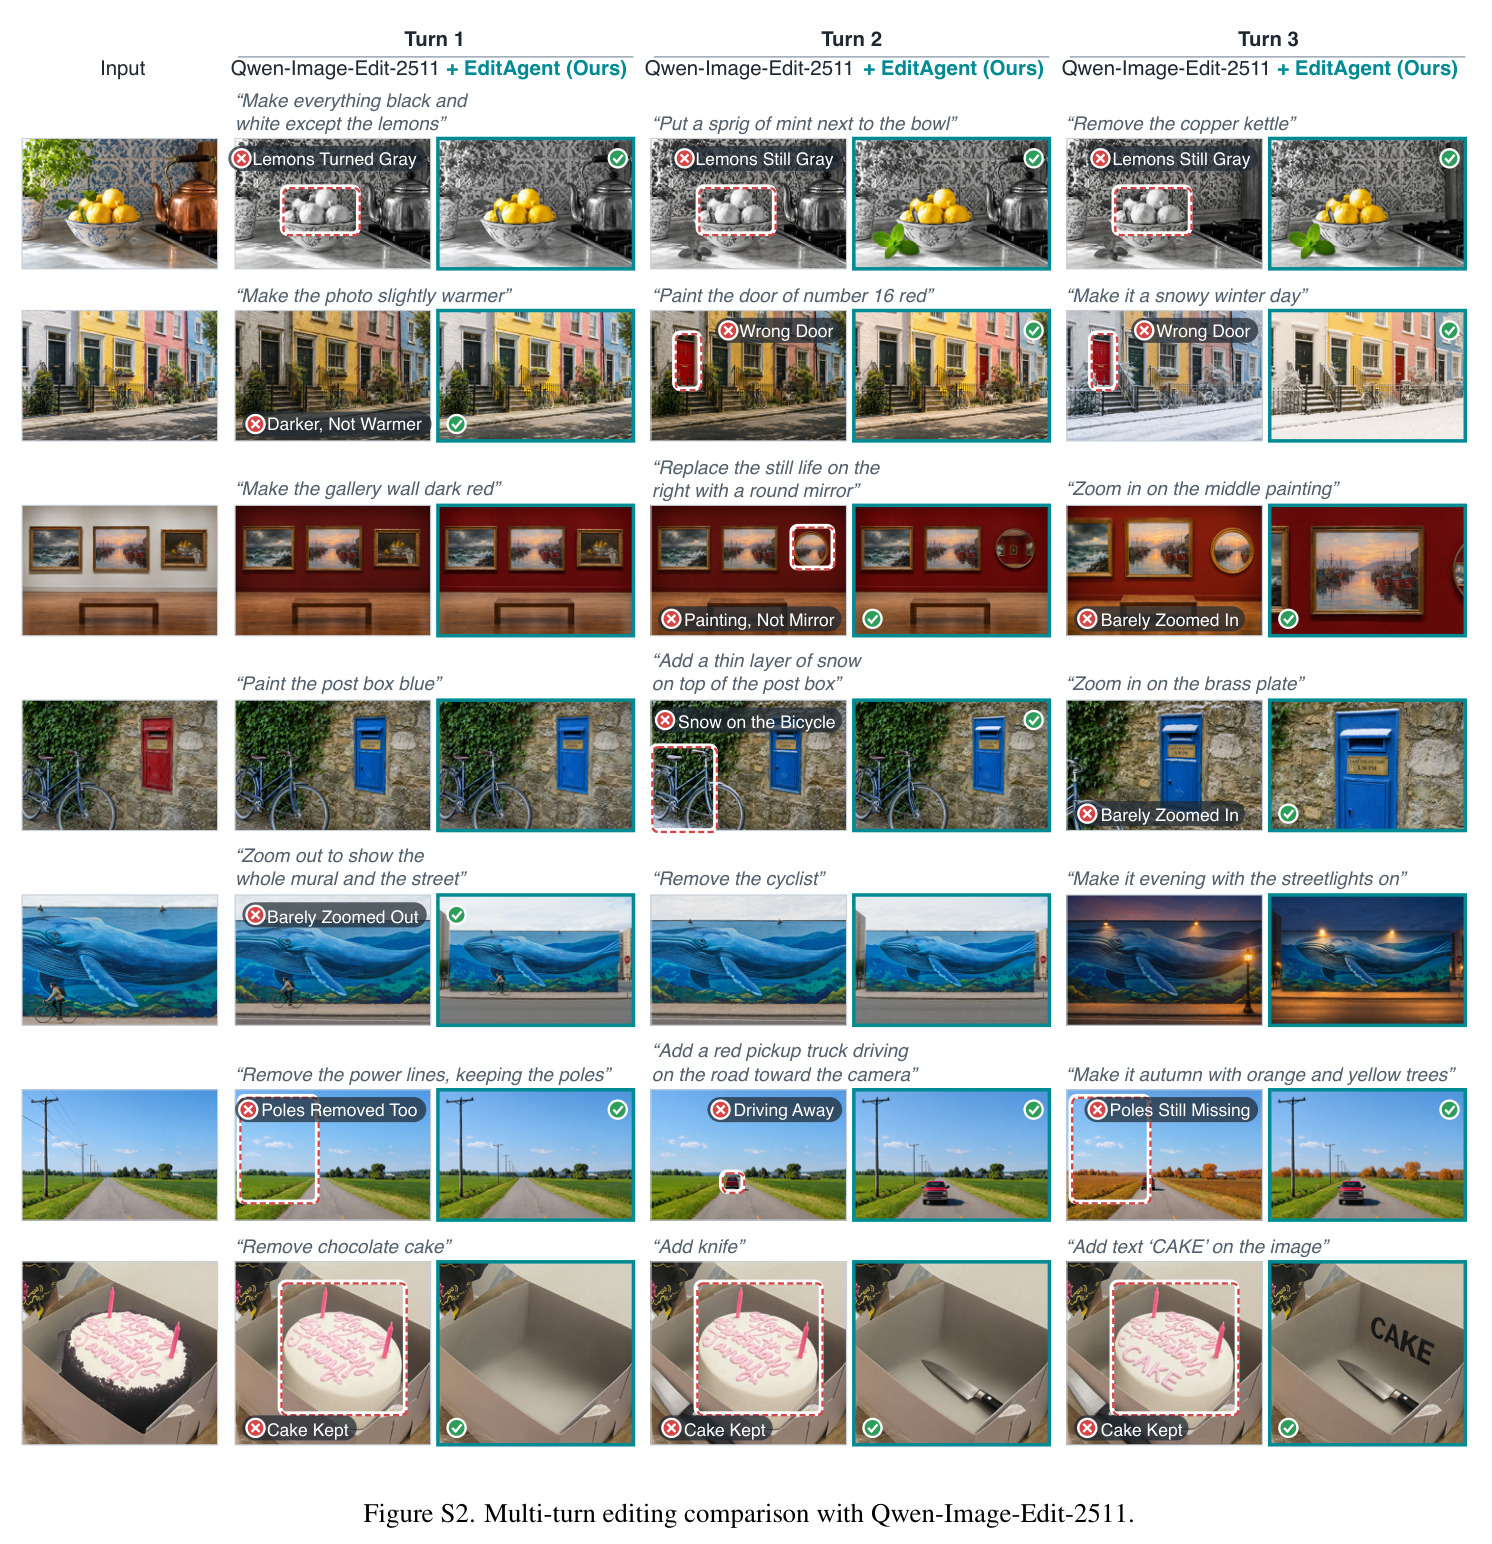
诊断基准(Figure 2):winner set 仅含通用编辑器候选的集合占 42.3%(254),仅含专业方法候选的占 29.2%(175),两者皆有的占 15.0%(90),无可用候选的占 13.5%(81);即通用编辑器在 42.7% 的集合失败,专业方法从中恢复 175 个。分组看,Style & Effects 有 73.8% 只需通用编辑器,而 Enhancement 和 Geometry 分别有 72.5% 和 66.7% 只能靠专业方法。更多采样救不了:通用编辑器池交付的可用编辑仅 45.2%,含专业方法的池达 68.2%,在恰好只有一个可用交付编辑的 296 个集合中 217 个来自专业方法池。并行 vs 顺序(Sec 3.3):同预算 4 张图,专业修图师盲评 144 个样本,并行搜索 102 胜、顺序精修 28 胜、14 平(78.5% 非平局胜率),VLM 调用至多 2 次 vs 固定 4 次。judge 研究(Table 1):EditReward-Bench 上 EditScore 系列 pointwise 65.9~70.3%(72B 集成@4 达 76.3%),现成 VLM pointwise 已达 71.7~73.8%,listwise 跃升至 85.2~86.1%(Qwen3.8-27B 72.1→85.9,+13.8)。完整系统(Tables 3-5):EdiVal 上 FLUX.2-klein-9B 的 EdiVal-O 三轮从 81.37/66.30/53.20 提至 84.46/71.10/59.45;Qwen-Image-Edit-2511@1024px 第三轮从 59.80 提至 62.58;对七种智能体基线全部三轮领先(最强 RISE-Agent 第三轮 52.10/58.42,EditAgent 为 55.46/59.45),代价 12.9 H100 GPU 时(独立编辑为 1.1)。ComplexBench-Edit 平均分 +6.43/+3.06(54.40→60.83、61.45→64.51),五组全升;Complex-Edit 总分 7.371→7.445、7.677→7.713。消融(Table 7):EdiVal-O 第三轮从 47.64(裸骨干)→49.43(规划/分析/历史检查)→52.37(动作空间)→53.18(并行比较)→55.46(验证记录),K 副本通用编辑器仅 47.53/48.90/49.01。judge 证据(Figure 5/Table 2):七个现成 VLM 全部提升 6.3~9.3 点(均值 71.17%→79.25%),全部超过四个微调奖励模型,Qwen3.8-Flash-Next 达 82.8%;Qwen3.8-27B 在诊断基准上 71.6%(逐张)→73.6%(listwise)→81.3%(加证据),Photometric 54.2→47.2→64.4、Enhancement 65.0→36.8→80.3,证据恰好补偿了比较评判在'变化很小'类编辑上的失灵。数据引擎(Table 6):40,726 个会话中 judge 接受 91.4% 的轮次、70.4% 会话全接受,产出 25,753 训练对(平均每对 3.9 次编辑,生成约 400 H100 GPU 时);微调后 Qwen-Image-Edit-2511 的 EdiVal-O 第三轮 49.66→51.61(直接生成的 FLUX.2 数据反而降到 48.51),FLUX.2-klein-base-9B 54.53→56.53(直接数据 52.83 同样为负收益),证明收益来自更高质量监督。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多轮编辑(EdiVal,FLUX.2-klein-9B 骨干) | EdiVal-O 第三轮(0-100) | 59.45 | 53.20(独立编辑) | +6.25 |
| 多轮编辑(EdiVal,Qwen-Image-Edit-2511@1024px) | EdiVal-O 第三轮(0-100) | 62.58 | 59.80(独立编辑) | +2.78 |
| 复杂指令编辑(ComplexBench-Edit,Qwen-Image-Edit-2511) | 五组平均(0-100) | 60.83 | 54.40(独立编辑) | +6.43 |
| 复杂指令编辑(ComplexBench-Edit,FLUX.2-klein-9B) | 五组平均(0-100) | 64.51 | 61.45(独立编辑) | +3.06 |
| 智能体间对比(EdiVal-O 第三轮,Qwen 骨干) | EdiVal-O 第三轮 | 55.46 | 52.10(最强基线 RISE-Agent) | +3.36 |
| 编辑评判(EditReward-Bench) | 总体准确率(%) | 85.9(Qwen3.8-27B,listwise) | 76.3(EditScore-72B 集成@4,pointwise) | +9.6,且零微调 |
| 诊断基准评判(515 个含可用候选的集合) | Winner-Set Hit@1(%) | 81.3(Qwen3.8-27B,listwise+证据) | 74.8(EditScore-72B) | +6.5 |
| 数据引擎(微调 FLUX.2-klein-base-9B) | EdiVal-O 第三轮 | 56.53(EditAgent 数据) | 52.83(同骨干直接生成数据) | +3.70,且直接数据相对不微调的 54.53 为负收益 |
局限与改进
作者明确承认两点:EditAgent 的推理时间约为独立编辑模型的 10 倍(智能体对比实验中 12.9 H100 GPU 时对独立编辑的 1.1),以及系统性能天然受限于底层编辑方法的能力——专业方法做不到的编辑(诊断基准中 13.5% 无任何可用候选)EditAgent 同样无解。我自己观察到更多:其一,观察空间扩展对'变化很小'类编辑的修复高度依赖证据(Photometric 组 listwise 单独使用时反而从 54.2% 掉到 47.2%),这意味着 judge 策略实际上需要按步骤类型自适应,论文虽用证据兜底但机制上是打补丁而非原则性解法;其二,路由表(Table S4/S5)是人工设计的确定性代码,30 种类型之外的请求全部回退到通用编辑器,扩展新工具需要人工接入,系统的'动作空间'本质上是封闭集合;其三,数据引擎用同一个 VLM 家族同时担任 judge 与评估基准,接受的会话会继承 judge 的偏好偏差,Table 6 中'EditAgent 数据好于直接生成数据'的结论在该偏差下需要谨慎解读(作者用 Gemma-4-31B 做内部 judge 复验了主结果,但数据引擎部分只用 Qwen3.8-27B);其四,诊断基准源图全部来自 COCO val2017、指令由 VLM 生成再由人标注,分布上偏自然照片场景,对文档、插画、截图等编辑场景的结论外推性未知;其五,最小的 Qwen3.5-35B-A3B 只提升 6.3 点,证据红利的规模与 judge 底座强相关,小模型/端侧部署的收益存疑。
独立分析的弱点
第一个弱点是计算成本:约 10 倍于独立编辑的推理时间(每步最多 3 候选 × 最多 3 次尝试,外加规划、定位、历史检查的多次 VLM 调用)使它难以用于交互式场景。改进方向:按步骤难度级联——先用单候选快评,只在低置信时扩展到多方法并行;或把验证记录蒸馏进小型 judge,减少对 27B 级 VLM 的依赖;利用 Table S10 中 73.3% 的轮次首轮即被接受的事实做早停。第二个弱点是 judge 偏差的自我强化回路:数据引擎只保留 judge 全盘接受的会话(70.4%),训练出的学生模型会拟合 judge 的审美与接受标准,长期迭代可能与人类偏好漂移。改进方向:引入人工校准子集做周期性偏移检测,或用多个异构 judge 的一致性做过滤,只保留多 judge 共识的会话。第三个弱点是封闭的动作空间:路由规则手工编码(Table S4),覆盖 30 类操作,目录之外的复杂请求(如'统一三个光源的方向')只能靠通用编辑器硬扛,而这恰是诊断基准显示失败率最高的区域。改进方向:让 analyzer 在运行时提议新工具组合,或从专家会话中自动挖掘工具-操作映射,形成可生长的工具库。第四个弱点是多轮修复的覆盖不全:history check 只在置信度 $\ge 0.4$ 时触发修复且每轮只修一次,低置信违规(如颜色基调被悄悄改变)会漏网进入最终交付。改进方向:对携带需求做分级——代码可验证的硬约束(掩码外像素不变)用程序断言,软约束用多次采样投票而非单次判定。
未来方向
作者提出的方向:把 EditAgent 作为数据引擎,微调出更强、更高效的独立编辑模型,从而摊薄智能体的计算成本——Table 6 已证明这条路可行(EditAgent 数据提升学生模型而同量直接生成数据反而是负收益)。基于本文成果可自然延伸的方向:其一,把 listwise+证据评判改造成强化学习的奖励信号——现成 VLM 判官零训练成本、可随底座升级,适合做 online RL 的 reward,替代昂贵的专用奖励模型训练;其二,验证记录作为过程监督信号训练编辑模型的自我验证能力,让模型学会'先看证据再交付';其三,把双空间框架搬到视频编辑——多轮时序一致性问题的结构与本文的多轮图像编辑高度同构,变化图与量化统计可直接复用;其四,动作空间的自动扩展:用 LLM 从失败案例中归纳缺失的能力并检索/组合开源工具接入路由表;其五,端侧蒸馏:Fig 5 显示证据红利在 3B 级激活模型上仍有 6.3 点,但绝对值最低,值得研究面向小 judge 的证据压缩格式(如只保留 TO JUDGE 项与关键统计)以保留大部分收益。
复现评估
复现条件总体友好但工程量大。组件全部公开:骨干编辑器 Qwen-Image-Edit-2511 与 FLUX.2-klein-9B 均为开放权重,SAM 2.1、OSOR、Swin2SR、FLUX.1-Fill、ViTMatte、DiffSynth-Studio、DeepSpeed ZeRO-3 皆开源,judge/规划器 Qwen3.8-27B 公开;论文附录异常详尽——Table S2 给出每个角色的输入输出,Table S3 列出全部默认超参(每尝试候选数 3、每步尝试 3 次、每轮重规划 2 次、掩码膨胀 24px、羽化 6px、VLM 温度 0.2、上下文 16384 token 等),Table S5 逐一说明每种方法的实现后端与代码保证,Sec J 给出全部 8 个 prompt 清单。难点在三处:一是算力——数据引擎生成 40,726 个会话约 400 H100 GPU 时(8×H200 节点 + DFlash2 投机解码),全参微调 9.1B/20.4B 模型需 8×H200 一个 epoch;二是标注——诊断基准的 winner set 需要五位专业 Photoshop 修图师共识标注,普通团队难以复制这个标注质量,但可以用众包近似;三是管线的多角色 VLM 编排(规划/分析/定位/评判/重规划/历史检查六个角色)工程复杂度不低。论文未说明代码是否开源,若不开源,依照附录从零搭建估计需要数周工程时间;若只复现核心结论(listwise+证据优于微调奖励模型),只需要 EditReward-Bench 公开数据加一个开源 VLM,一天内可验证。
论文图表
(a) 按六个编辑组(Style & Effects、Content、Scene、Photometric、Geometry、Enhancement)统计专家标注集合中 winner set 的来源构成:仅通用编辑器可用、仅专业方法可用、两者皆可、全不可用。Style & Effects 73.8% 仅需通用编辑器,Enhancement 72.5% 与 Geometry 66.7% 只能靠专业方法。(b) 四种 judge(EditScore-72B、EditReward-7B、CLIP-I、Qwen3.8-27B)的 Winner-Set Hit@1 与随机基线:EditScore-72B 总体最高 74.8% 但仅 Scene 组登顶,Qwen3.8-27B 在 Photometric 组仅 54.2%(随机 49.0%)。
这是论文诊断部分的全部证据:没有这张图,'动作空间不够大'和'观察空间不够大'只是口号;有了它,两个瓶颈的量化边界一目了然,也直接导出了方法设计的两个方向。