缺失的原语:诊断与修复大语言模型的数学推理 The Missing Primitive: Diagnosing and Repairing Mathematical Reasoning in Large Language Models
提出数学原语与PRIM基准诊断LLM数学理解,发现独立结构发现是瓶颈,并用ABSORB自蒸馏修复
前置知识
思维链(Chain-of-Thought, CoT)
一种提示与解码范式:让模型在给出最终答案前先生成中间推理步骤。本文的Generation与Execution维度均采用零样本CoT——只给题目(执行时额外附上原语),让模型自由展开推理后对最终答案做exact match判定。
理解生成维度的评测协议,以及ABSORB为何选择在学生自己的on-policy推理轨迹上逐步施加token级监督。
KL散度与反向KL(rKL)
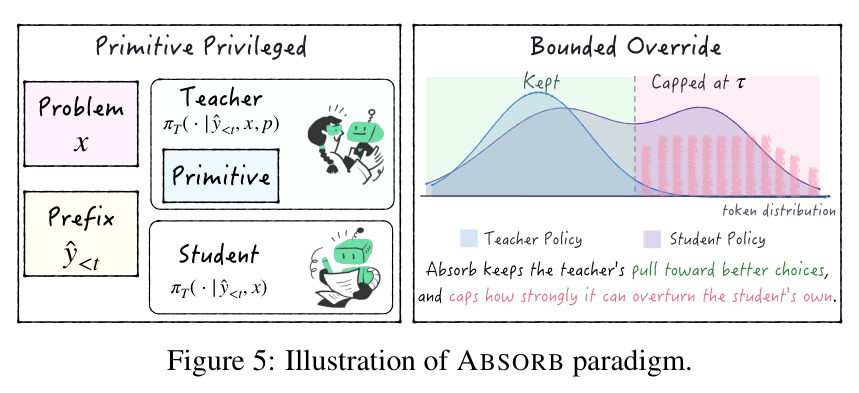
KL散度 $D_{KL}(Q\|P)$ 衡量两个概率分布的差异且不对称:正向KL促使学生覆盖教师全部模式,反向KL $D_{KL}(P\|Q)$ 只要求学生在教师也认可处放置概率,倾向模式寻求。ABSORB的核心是带单侧截断的反向KL:正向引导完整保留,对学生已有偏好的过度压制被封顶。
ABSORB的损失函数直接建立在rKL之上,不理解正反向KL的 asymmetry 就无法理解'有界覆盖'到底截断了什么。
在线策略自蒸馏(OPSD)
一种蒸馏设定:教师与学生初始化自同一基座模型,学生按自身策略采样生成推理轨迹(on-policy),教师额外以特权信息(如解答)为条件,在学生每个前缀 $\hat{y}_{<t}$ 上提供token级分布监督,最小化两分布间散度(KL/rKL/JSD),避免了离线蒸馏的分布偏移。
ABSORB就是OPSD的变体:只替换了特权信息的来源(原语替代完整解答)与转移机制(有界覆盖替代朴素散度)。
特权信息(Privileged Information)
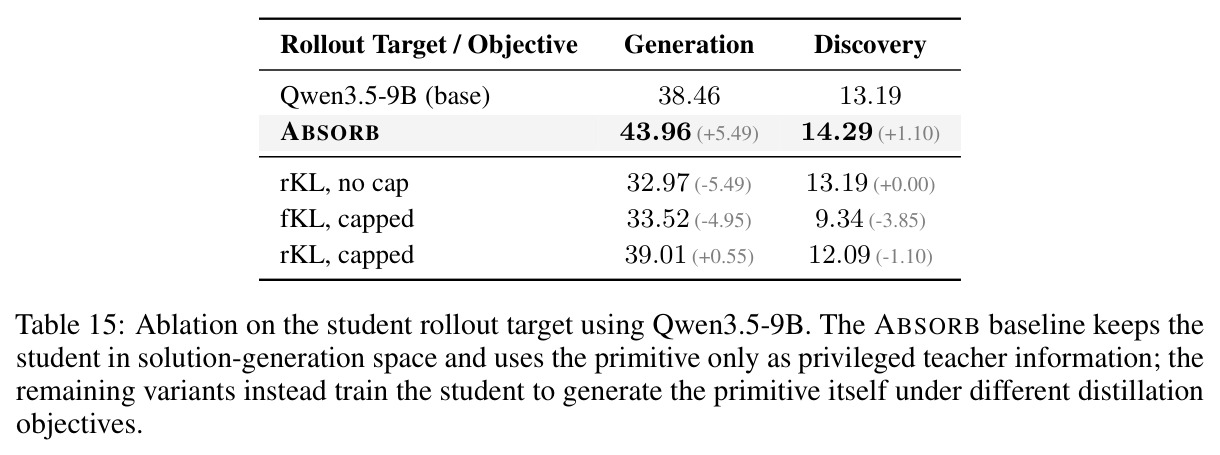
源自Vapnik的学习范式:训练时向教师提供测试时不可获得的额外信息。本文中数学原语就是特权信息——训练时教师模型能看到它,推理时学生完全不需要。目标是把'借助原语推理'的能力内化进模型参数,而不是教学生显式输出原语(后者被证明会灾难性损害发现能力,Discovery跌至2.75)。
这是理解ABSORB与Execution评测共享逻辑的关键:原语是训练期的脚手架,而非推理期的依赖。
LoRA低秩适配
参数高效微调方法:冻结原模型全部权重,只训练注入到各投影层的低秩分解矩阵 $BA$(秩 $r$ 远小于隐藏维度 $d$)。本文用秩64、$\alpha=128$,覆盖所有注意力与MLP投影(包括Qwen3.5的线性注意力投影),使27B模型的蒸馏训练在NVIDIA RTX 6000 Ada级GPU上即可完成。
论文全部后训练实验(SFT/OPSD/ABSORB)都基于LoRA,是评估复现算力门槛的基础。
Humanity's Last Exam(HLE)
由Center for AI Safety等机构发布的专家级学术难题基准。PRIM选取其数学、纯文本、自由作答子集,并从经社区校验的HLE-VERIFIED的Gold与Revision子集中抽样;专家复核中修正了15处官方答案错误,说明权威基准也有残余噪声。
PRIM的数据来源与'各模型在PRIM上绝对准确率明显高于完整HLE公开成绩'这一局限性都源于此。
pass@k
一种采样评价协议:对每道题独立采样 $k$ 条回答,只要有至少一条得到正确答案即判为通过。它衡量模型的'能力覆盖'而非单次稳定性,通常高于pass@1。本文在HMMT25与Omni-MATH这两个竞赛级基准上因题目极难而报告pass@4。
读结果表时必须知道竞赛基准的数字是pass@4,不能与常见pass@1成绩直接比较。
研究动机
现有对LLM数学能力的评估几乎完全依赖结果层面的指标——最终答案的exact match或形式化证明的可验证性。这带来两个具体问题。其一,答题正确不等于真正理解:模型可能通过看似合理实则漏洞的推导碰巧得到正确答案(Boye & Moell, 2025所指出的specious deductions),也可能恰恰相反——模型识别出正确的高层证明结构却在低层技术执行上失败(Lu et al., 2024; Qin et al., 2025)。其二,随着LLM生成的证明规模与复杂度不断增长(数百步合法推理链),即使证明正确,其背后的数学结构也难以辨认。Terence Tao在ICM 2026演讲中警告:若一味优化形式正确性,只会产出越来越多的'合法但不透明'的证明,而无相应的数学理解增长。换言之,社区无法回答一个根本问题:模型解题成功究竟是因为'发现了使问题可解的承重数学结构',还是仅仅'成功执行了一段推导'。现有的outcome级评测把这两种截然不同的成功(和失败)混为一谈。
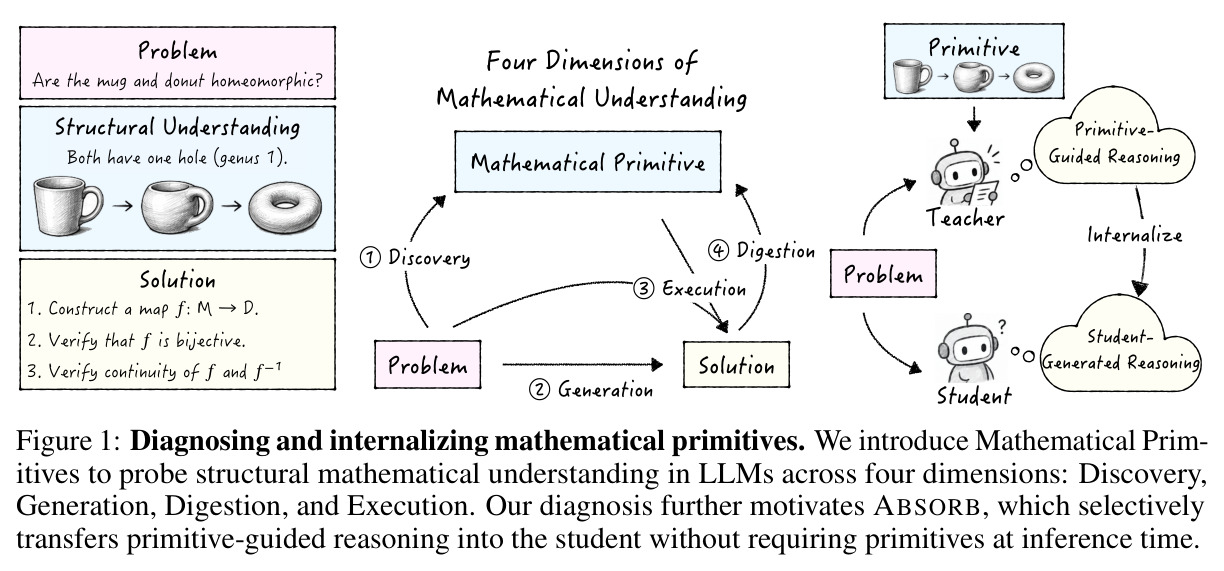
本文的目标是本文的目标是系统性地研究和提升LLM的'结构性数学理解',分三步走。第一步,给出可操作的定义:提出'数学原语'(Mathematical Primitive)概念——揭示问题为何可解的核心概念性观察,如一个不变量、定理适用条件、表示转换或归约;它必须简洁、针对具体问题且有解释力,既不是套路化建议(如'用归纳法'),也不是完整证明。第二步,构建PRIM基准,沿四个互补维度评测:发现(Discovery,仅凭题目独立找出原语)、生成(Generation,零样本CoT直接解题)、消化(Digestion,从完整正确解答中提取原语)、执行(Execution,给定原语后解题),并用182道经三位数学专家校验的HLE题目对横跨三个系列的12个主流模型做系统诊断。第三步,把诊断结论转化为训练方法:先证明'发现受限'的失败(D⁻E⁺)最容易被后训练修复,再据此提出ABSORB框架,把原语引导的推理内化进学生模型,在多个模型规模与挑战性基准上平均提升2.42–4.48分。
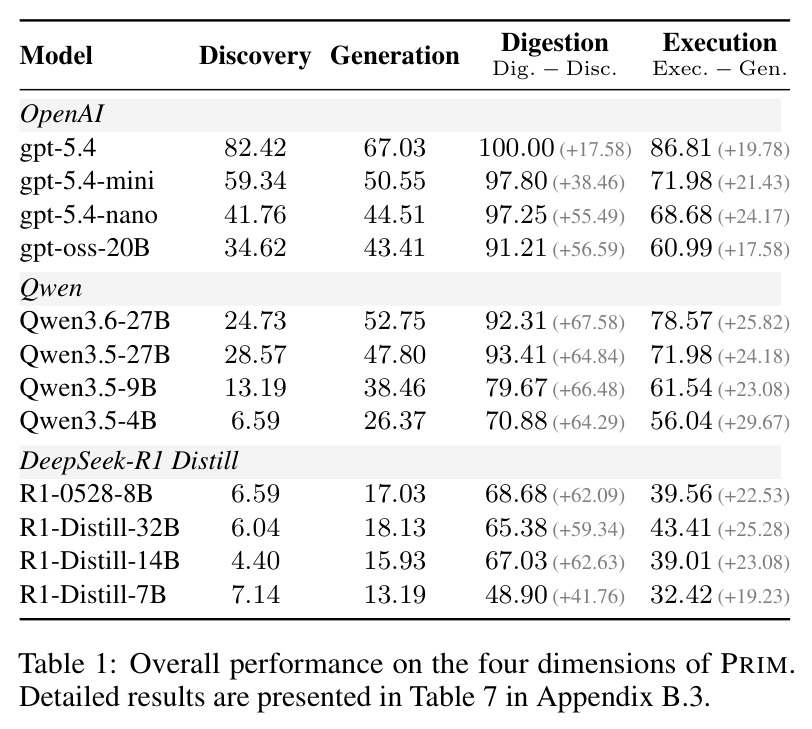
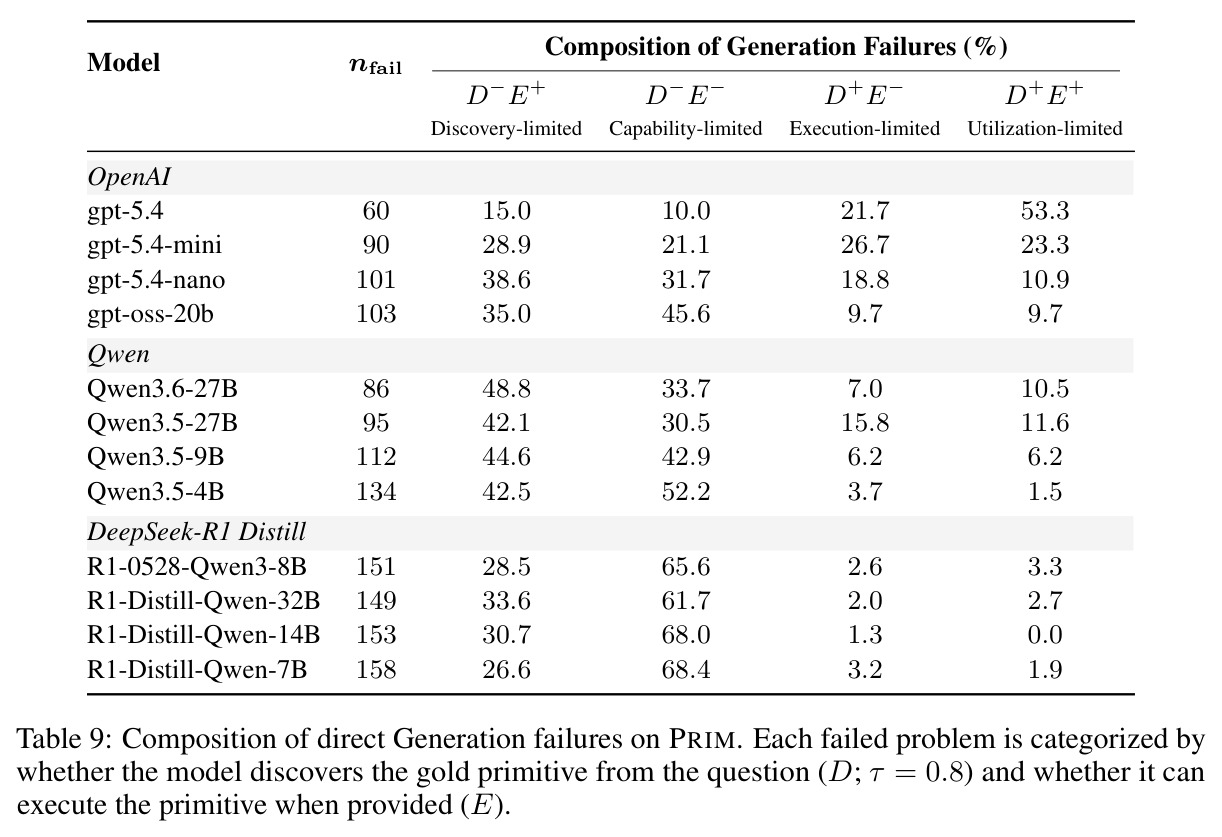
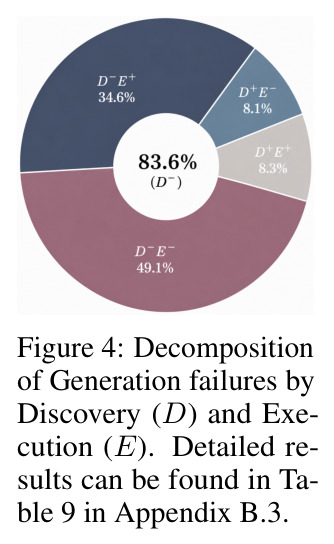
与已有工作不同的是,已有的过程导向评估与本文思路有本质区别。SMART(Hou et al., 2026)按人类认知过程分解解题步骤;ReasoningMath-Plus验证最小程序骨架;DeepInsightTheorem用证明梗概做中间监督;EFA(Khan et al., 2025)把数学结构表示成可执行的生成程序。这些工作仍围绕'如何做'(程序性、可执行的表示),而本文抓住的是'为何可解'——一个简洁、刻意非程序性的承重结构。独特切入有三:一是首次把'结构发现'与'程序执行'解耦为两个独立可测的维度,从而精确定位瓶颈(83.6%的失败落在D⁻区间);二是发现执行维度存在大量潜在能力——给定正确原语后12个模型的准确率暴涨17.58至29.67个百分点,说明瓶颈不在'会做'而在'想不到';三是方法上不把原语当作学生的预测目标,而是作为教师模型的特权信息,配合有界覆盖机制选择性蒸馏,绕开了直接监督原语生成导致的灾难性退化(原语SFT使Discovery从13.19跌至2.75)。
核心方法
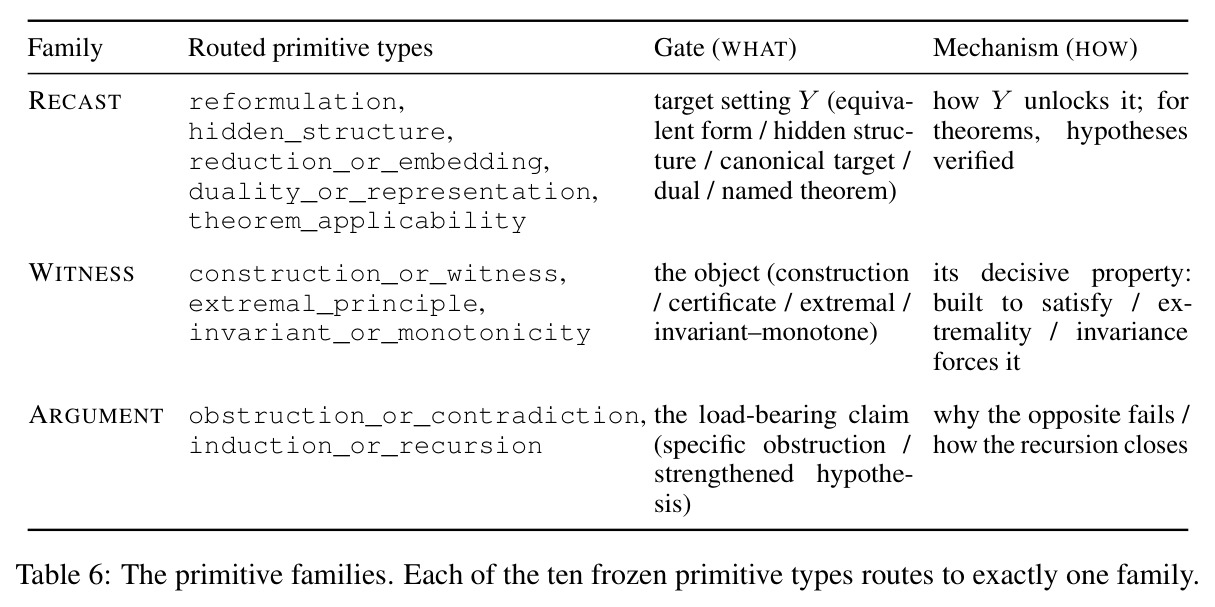
直觉上,数学证明在写下第一行之前就开始了:解题者先'看穿'题目背后的结构——比如意识到对象暗中构成一个群——然后才展开推导。本文把这种承重结构认识形式化为数学原语,并主张:会解题(生成)与理解为何可解(发现原语)是必须分开测量的两种能力。技术路线分三步。第一步构建PRIM基准:从HLE-VERIFIED的Gold与Revision子集随机抽200道纯文本数学题,GPT-5.4-High生成初始原语标注,三位专家逐一审核,剔除18题后得182题;评分按 $\text{Score}=V\cdot\sigma_{gate}\cdot(0.6+0.4\sigma_{mech})$,$V$ 判定是否真原语,$\sigma_{gate}$ 查关键结构(WHAT),$\sigma_{mech}$ 查其如何解锁解法(HOW),得分 $\ge 0.8$ 记为正确。第二步用四个维度对12个模型诊断,产出三大发现。第三步据此设计ABSORB:教师与学生共享同一基座,教师额外以原语 $p$ 为条件,在学生的on-policy轨迹上提供token级监督,损失为带单侧截断的反向KL,把原语引导的推理内化进学生,推理时无需任何原语。
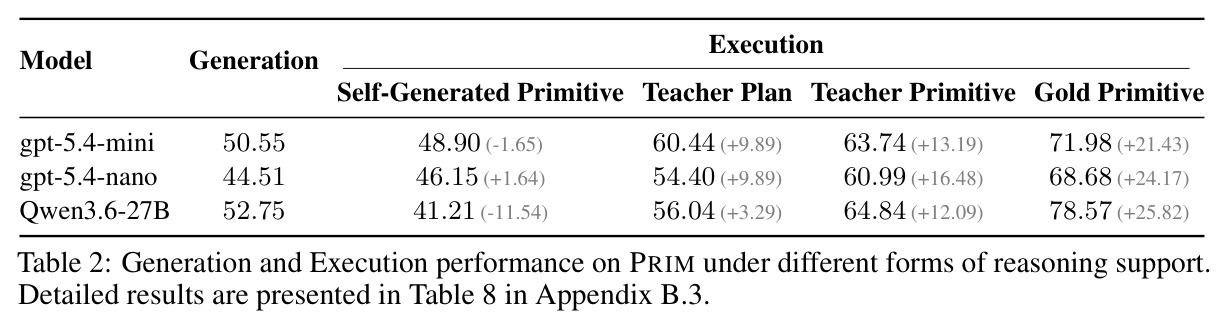
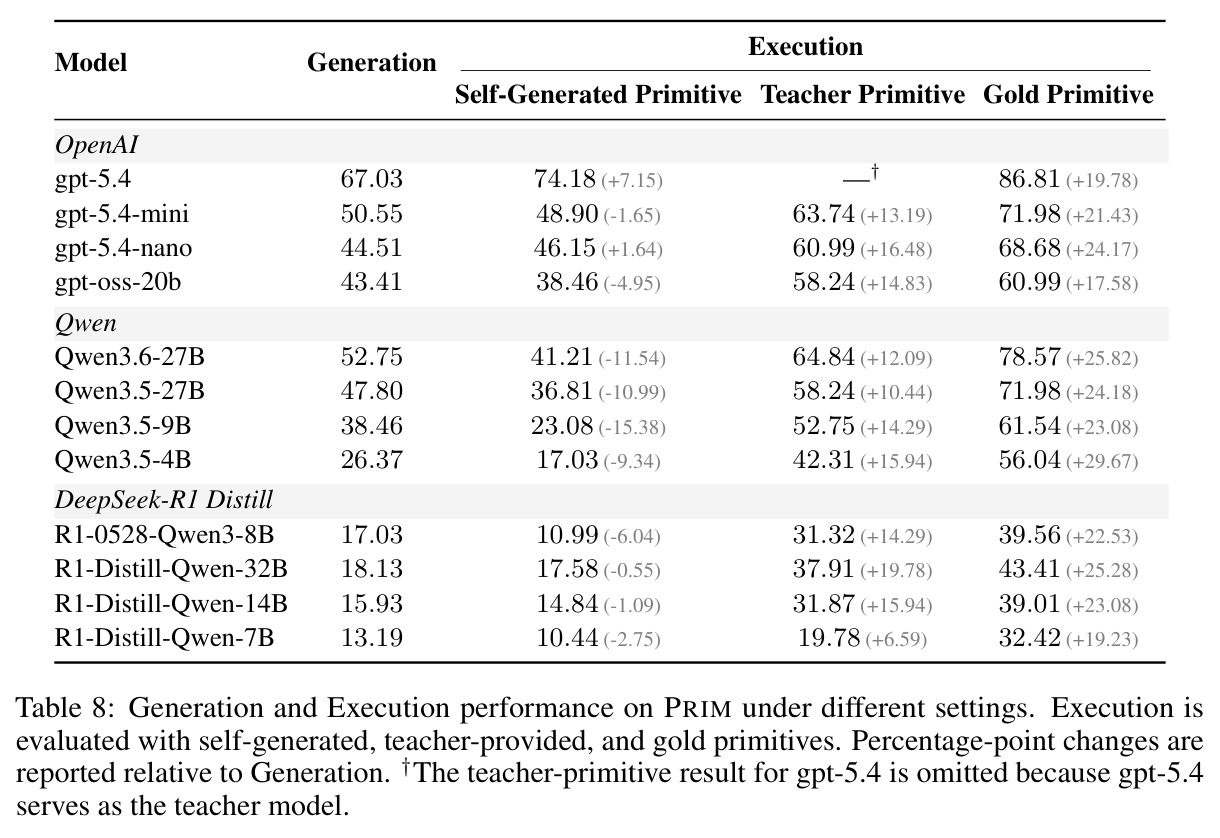
核心创新有两条。第一条是'原语作为特权信息':不是让学生学会输出原语,而是让教师(与学生同基座)在读题外额外看到原语 $p$,在学生的on-policy轨迹上逐步指出'此刻更好的选择'。这直接对应诊断发现——模型缺的是发现而非执行,所以监督应补给缺失的一环(结构),而非重复学生已会执行的步骤。对照实验证明这不同于通用提示:金标原语使执行提升17.58–29.67分,而强迫'先发现再执行'反而掉分(Qwen3.6-27B下降11.54分);同为GPT-5.4生成,Teacher Plan(+3.29~+9.89)也不如Teacher Primitive(+12.09~+16.48),排除任务分解的解释。第二条是'有界覆盖':朴素自蒸馏会把特权信息泄漏成捷径,令模型推翻自己已形成的正确偏好。ABSORB用带单侧截断的反向KL实现两条原则——教师偏好高于学生时正向引导完整传递;教师强烈压制学生偏好时压制被封顶,因为大幅分歧可能源于学生看不到的特权信息,而非学生自己能识别的错误。一句话:让原语精炼学生已有的推理空间,而非强迫它模仿只有特权视角才做得出的决策。
方法步骤详情
流程分四步。第一步,基准构建:从HLE-VERIFIED抽200道纯文本数学题,GPT-5.4-High生成结构化原语标注,三位专家复核剔除18题,得182题;每题归入RECAST/WITNESS/ARGUMENT三家族。第二步,四维评测:依次运行发现 $\pi(x)\to\hat p$、生成 $\pi(x)\to\hat y$(零样本CoT后exact match)、消化 $\pi(x,y)\to\hat p$、执行 $\pi(x,p)\to\hat y$;GPT-5.4-High温度0作裁判,与人类盲评一致率95.5%(κ=0.91)。第三步,后训练诊断:用709道数学博士资格考题,每题附从证明抽取的一句话原语,在Qwen3.5-{4B,9B,27B}上对比SFT与OPSD对D⁻E⁺与D⁻E⁻失败的修复率。第四步,ABSORB训练:学生温度1.0生成on-policy rollout,教师(同基座)以原语为条件,在top-K=128支撑集上优化带单侧截断($\tau=0.06$)的反向KL损失;LoRA秩64、学习率 $5\times10^{-6}$、bf16、单epoch共22–23步。
技术新颖性
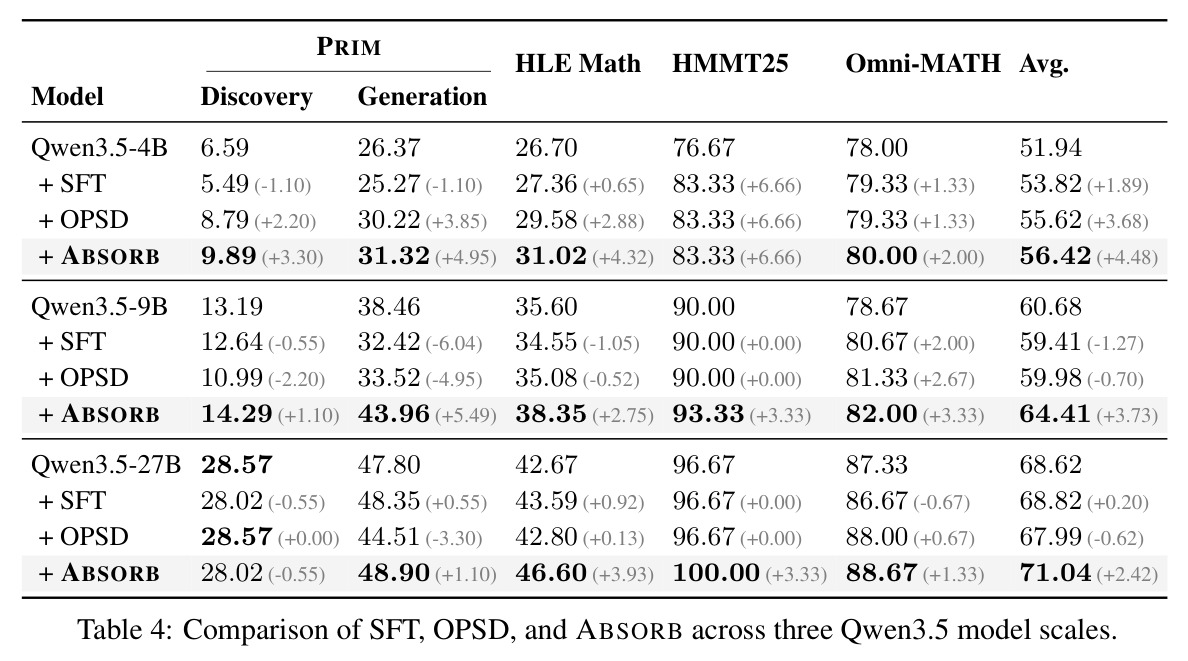
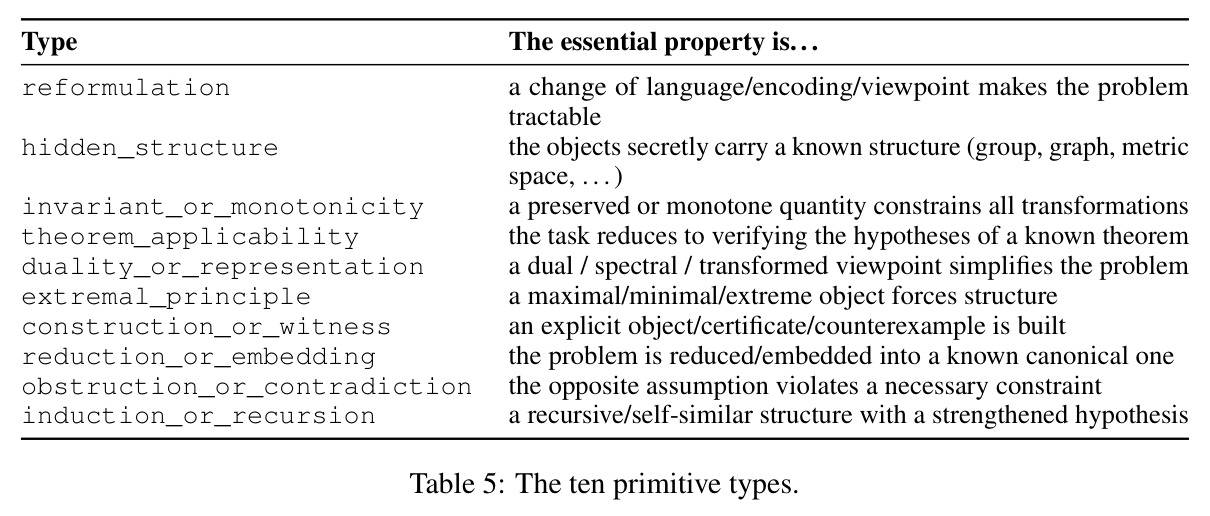
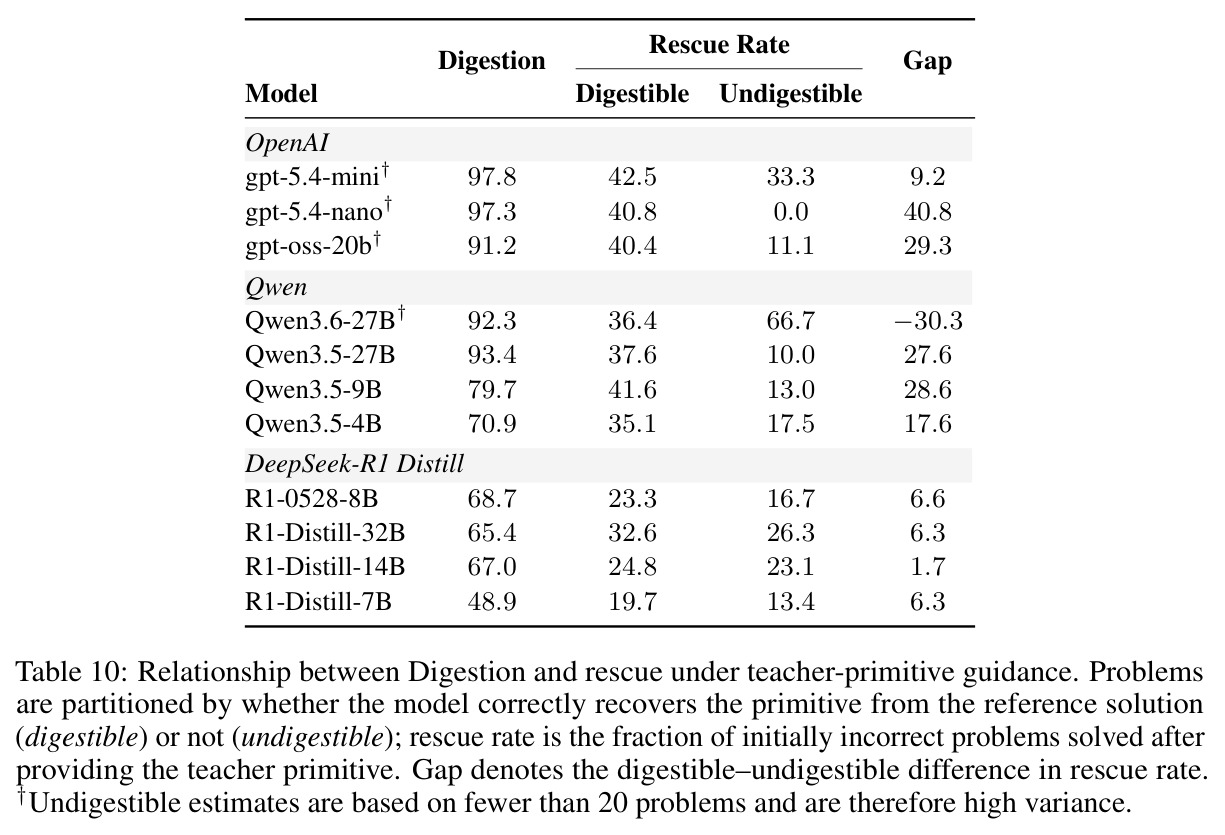
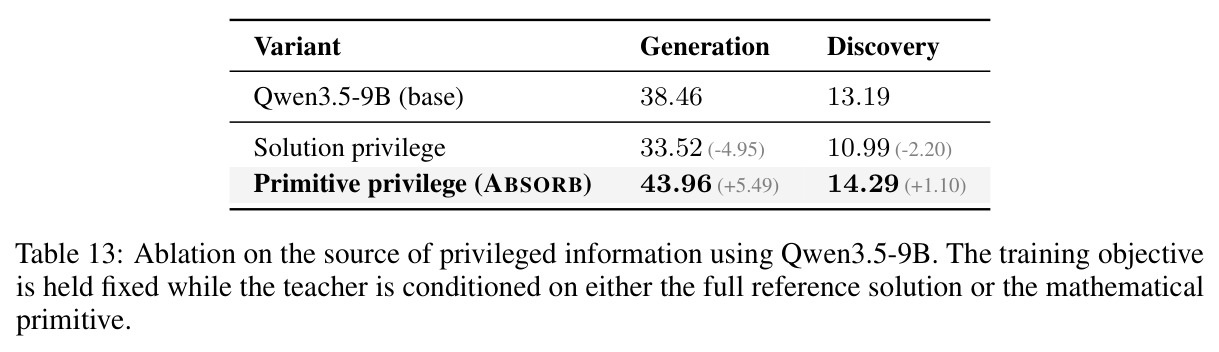
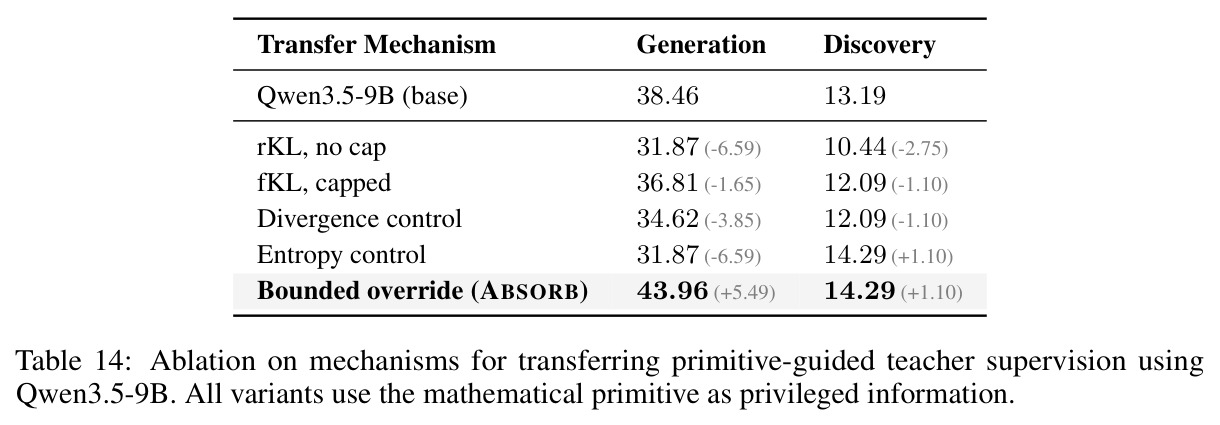
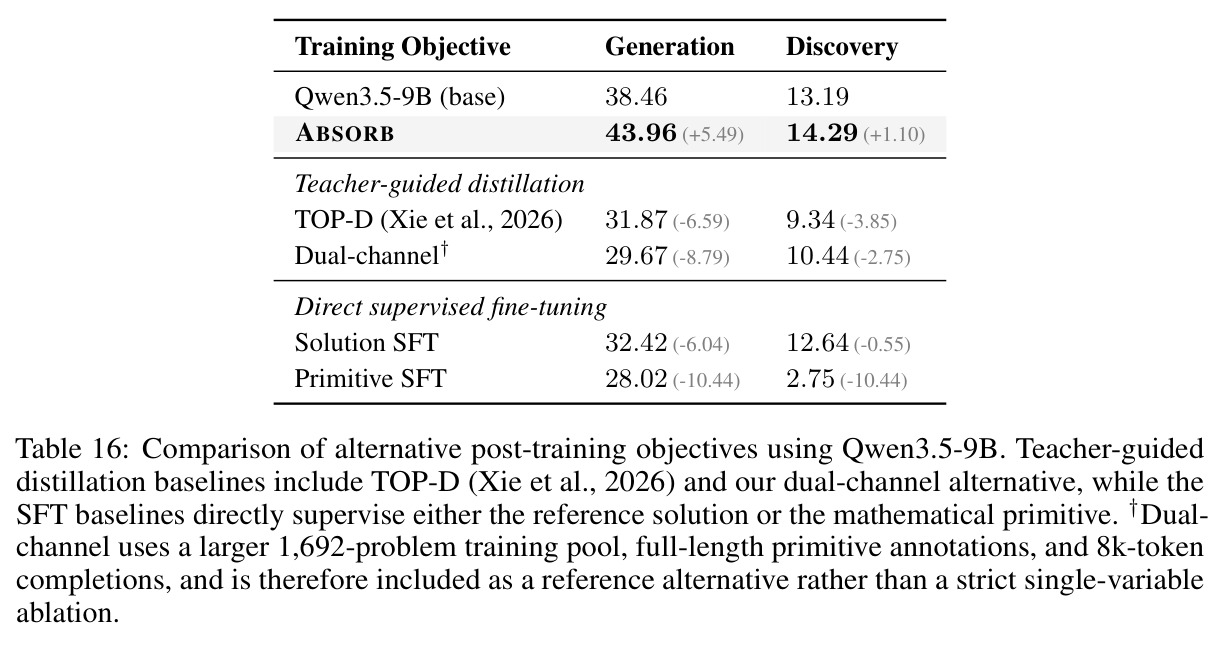
新颖性体现在四个层面。概念层面:'数学原语'是结构性数学理解的首个可操作化定义——区别于EFA的可执行程序表示,原语刻意非程序性(提示禁止任何计算与推导步骤),并配十类型三家族的冻结分类法与三判决评分协议($V,\sigma_{gate},\sigma_{mech}$),使主观概念可测可审计。诊断层面:四维分解首次把'回顾性识别'与'前瞻性发现'分开测量,揭示消化远高于发现的不对称(Qwen3.6-27B从24.73%到92.31%),并产出83.6%失败落在D⁻区间的可行动结论。方法层面:这是首个把'简短结构洞察'而非完整参考解答用作自蒸馏特权信号的工作——同目标函数下原语特权(43.96)领先解答特权(33.52)10.44分;单侧截断的rKL也不同于token级掩码方案(divergence/entropy control均失败),它在每个token分布内限制教师压制强度,而非对整个token做二元取舍。实证层面:证明'内化'可以不经'显式生成'——ABSORB使9B生成提升5.49分时发现仅升1.10分、27B甚至降0.55分,挑战了'必须先教会模型输出洞察才能用好洞察'的直觉。
实验结果
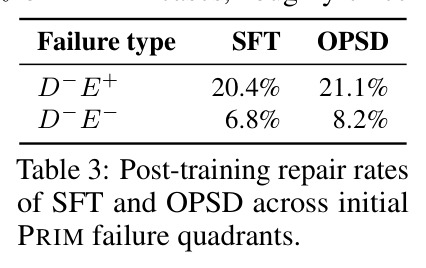
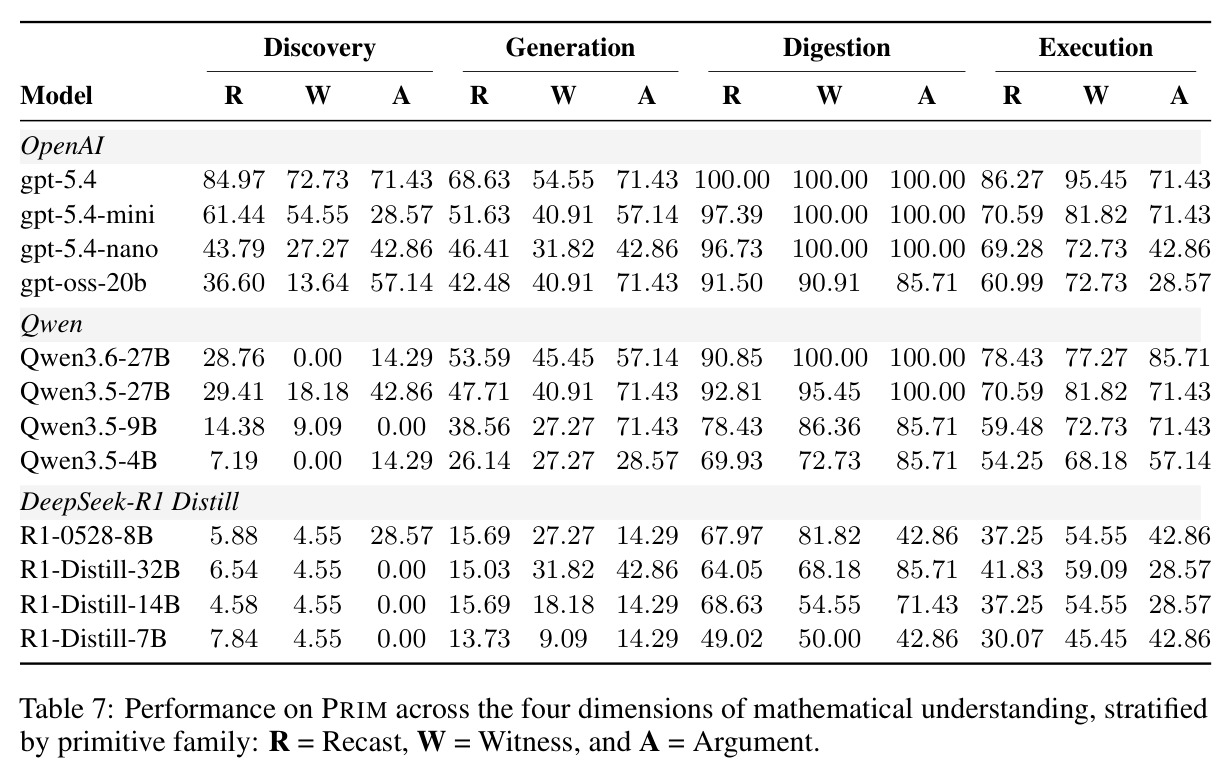
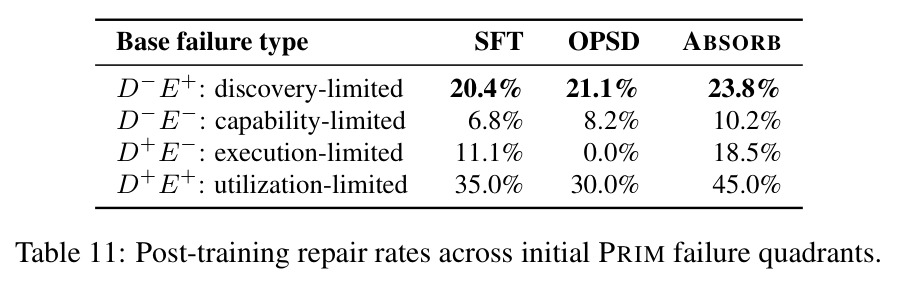
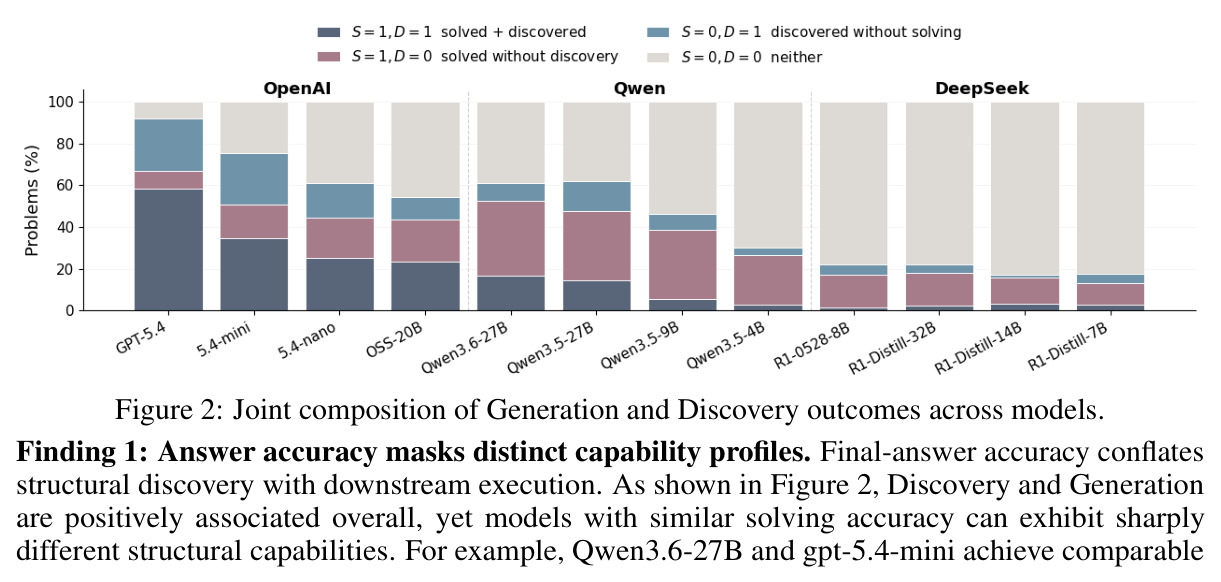
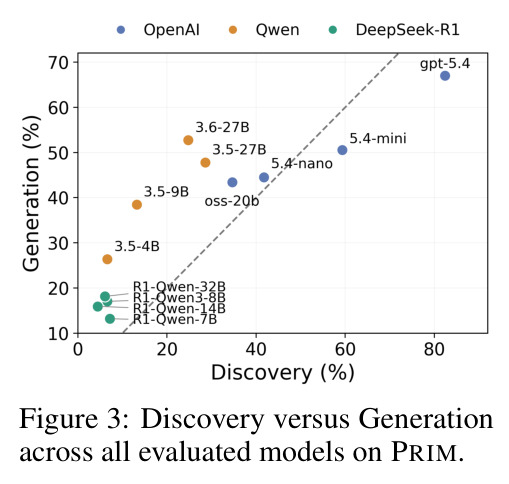
诊断(12模型×182题)有三大发现。发现一:答案正确率掩盖能力画像——Qwen3.6-27B与gpt-5.4-mini生成相当(52.75% vs 50.55%),发现却差30多个百分点(24.73% vs 59.34%);OpenAI系偏'原语先行',Qwen系偏'先硬算后开窍'。发现二:金标原语使全部12模型执行提升17.58~29.67个百分点(如27B达78.57%),解锁大量潜在执行能力;自我生成原语反而有害(-11.54分),Teacher Plan不敌Teacher Primitive。发现三:独立发现是主导瓶颈——消化远高于发现(R1-Distill-32B:6.04%→65.38%),83.6%的生成失败落在D⁻区间。后训练上,SFT/OPSD修复20.4%/21.1%的D⁻E⁺失败,约为能力受限失败的三倍,但对已会题目引入回归(9B生成掉6.04分)。ABSORB无回归地全面占优:9B生成+5.49、平均+3.73;4B平均+4.48;27B平均+2.42且HMMT25满分(pass@4);消融中原语特权43.96优于解答特权33.52,原语SFT使发现崩至2.75。
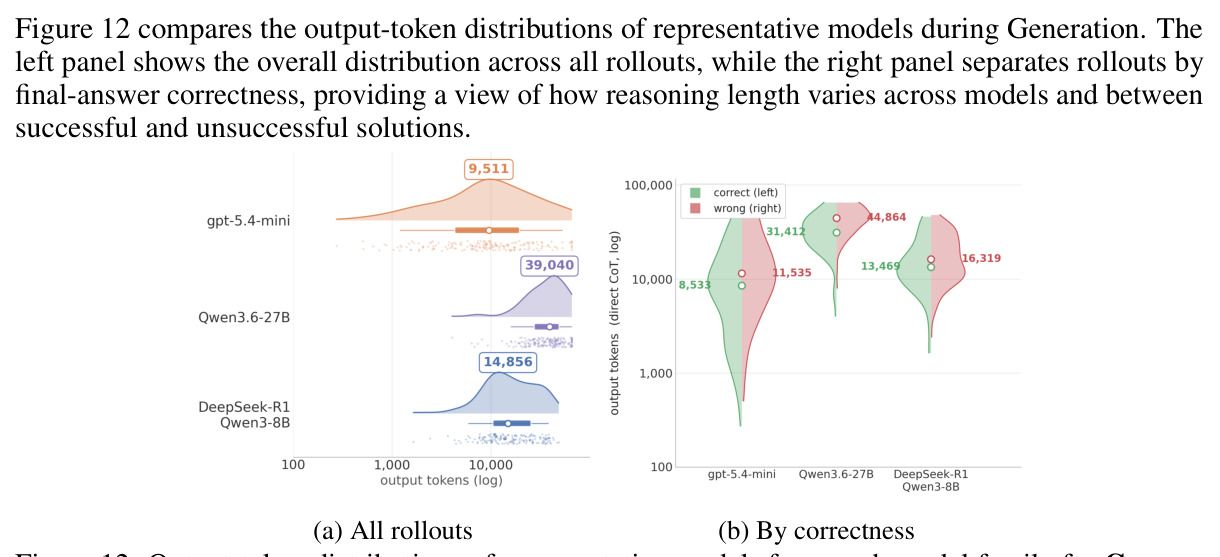
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PRIM Generation(Qwen3.5-9B) | 最终答案准确率(%) | 43.96(ABSORB) | 38.46(基座);SFT 32.42;OPSD 33.52 | 较基座+5.49,较OPSD+10.44 |
| PRIM Generation(Qwen3.5-27B / 4B) | 最终答案准确率(%) | 48.90 / 31.32(ABSORB) | 47.80 / 26.37(各自基座) | +1.10 / +4.95 |
| HLE-Verified数学全集(Qwen3.5-9B) | 准确率(%) | 46.60(ABSORB) | 42.67(基座);35.08(OPSD) | +3.93 / +11.52 |
| HMMT25(Qwen3.5-27B) | pass@4 (%) | 100.00(ABSORB) | 96.67(基座) | +3.33 |
| Omni-MATH(Qwen3.5-9B) | pass@4 (%) | 82.00(ABSORB) | 78.67(基座) | +3.33 |
| 四基准平均(Qwen3.5-4B / 9B / 27B) | 平均准确率(%) | 56.42 / 64.41 / 71.04(ABSORB) | 51.94 / 60.68 / 68.62(各自基座) | +4.48 / +3.73 / +2.42 |
| PRIM Execution(12模型,金标原语条件) | 相对无辅助生成的准确率提升(百分点) | 全部12个模型+17.58 ~ +29.67(最大:Qwen3.5-4B,26.37→56.04) | 无辅助直接生成 | 证明大量潜在执行能力被生成失败掩盖 |
| PRIM发现受限失败修复(D⁻E⁺,147例) | 修复率(%) | 23.8(ABSORB) | SFT 20.4;OPSD 21.1;对照D⁻E⁻仅6.8~10.2 | 约为能力受限失败的2.3~3.5倍 |
局限与改进
作者承认的局限:其一,PRIM仅182题且每题只有单个金标原语,按不同但有效的概念路线作答可能被低估——抽样审计发现100个'判错'原语中恰有1例(1%)是有效替代路线,gpt-5.4的32个判错案例中也仅1例,评分偏保守;其二,PRIM是精心清洗的子集,各模型绝对准确率明显高于完整HLE公开成绩,外推需谨慎;其三,修正官方答案后11个预测由错翻对,说明HLE-VERIFIED仍有残余噪声。我的观察:第一,ABSORB对发现能力改善微乎其微(9B仅+1.10,27B甚至−0.55)——它提升的是'借力推理'的输出质量,未触及论文自己诊断的根本瓶颈,叙事上略有错位;第二,后训练只在Qwen3.5家族验证、训练集仅709题且每模型22–23个优化步,对OpenAI系'原语先行'型模型(瓶颈更多在D⁺E⁻执行端)是否适用未知,而ABSORB的设计假设恰针对D⁻E⁺;第三,金标原语依赖GPT-5.4-High加三位数学专家,难以规模化;第四,竞赛基准用pass@4报告,与常见pass@1不可直接比较;第五,截断阈值 $\tau=0.06$、top-K=128只在9B上调过,跨规模敏感性未报告。
独立分析的弱点
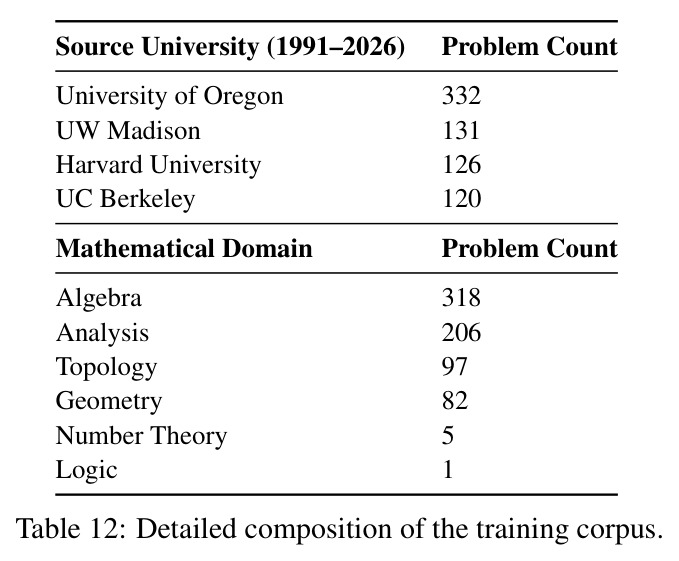
弱点一:诊断与修复之间有断层——论文证明发现是主导瓶颈,但ABSORB本质上是绕过而非解决它,发现能力几乎不动。改进方向:把原语特权蒸馏与RLVR或课程式发现训练结合,如引入'先产出结构假设再执行'的两阶段奖励,或用D⁻E⁺题目构造逐步撤除的发现脚手架。弱点二:单金标原语排斥多路线解法,约1%误判率在182题的小基准上不可忽略。改进方向:每题收集多条等价原语做多参考匹配,或训练对结构等价鲁棒的专用判别模型替代LLM裁判。弱点三:金标原语是GPT-5.4-High'看着完整解答'逆向写出的,可能引入后见之明偏差。改进方向:用仅看题目的专家或模型盲写原语,与看解答版本对比校准。弱点四:709道训练题集中于代数(318)与分析(206),数论仅5题、逻辑1题,稀疏领域效果存疑。改进方向:按领域分层训练并报告分域成绩。弱点五:有界覆盖只在token级约束教师压制强度,未处理轨迹级问题(如长程推理的累积漂移),dual-channel的失败也说明简单的'前512 token+自我怀疑分叉'切分不是答案。改进方向:在步级或论证级做选择性传递,如教师对学生的候选分叉做偏好排序而非逐token纠正。
未来方向
作者明确提出三个方向:一是把诊断框架推广到其他结构严谨的学科(理论物理、计算化学),那里同样存在可原语化的承重结构(对称性、守恒量、有效理论);二是基于发现—执行不对称性设计数学智能体架构,把'结构搜索'与'程序执行'显式分离并分别分配推理时算力——例如一个代理枚举候选原语,另一个执行代理负责验证;三是把数学原语与Lean等形式验证系统结合,用形式化检查打通'非正式结构推理→形式证明生成'的管道。基于本文成果还可延伸:其一,ABSORB与RLVR的组合——原语特权蒸馏做warm-up、可验证奖励做精调,有望同时改善发现与执行两端;其二,系统消融原语粒度(单句vs多原语分解vs完整梗概),dual-channel用全长标注反而更差的现象值得深挖;其三,用四维诊断追踪RLVR/长CoT训练过程中能力画像的演化,检验'grind-first'画像是否随训练范式改变;其四,构建自动原语生成与自一致校验流水线,把标注成本降一个量级,使该范式可扩展到十万题级别并覆盖更多学科。
复现评估
复现条件总体友好。模型与代码已在项目页公开(https://taco-group.github.io/Math-Primitive/2026)。基准侧:PRIM基于公开的HLE-VERIFIED(Gold+Revision子集),但重建金标原语需GPT-5.4-High API预算加三位数学专家人工复核;直接使用论文发布的182题则无额外成本。评测判定同样用GPT-5.4-High(温度0),与人类一致率95.5%(κ=0.91),复现评分需OpenAI API且有版本漂移风险。诊断侧需调用12个模型,每题最高120k生成token,推理开销不小。训练侧最易复现:709道资格考题及原语标注随论文提供,LoRA秩64、单epoch仅22–23个优化步,附录D给出全部超参(学习率 $5\times10^{-6}$、截断 $\tau=0.06$、top-K=128、bf16、种子42),硬件仅需RTX 6000 Ada级GPU配vLLM协同采样。主要风险:闭源教师与裁判的版本变化影响评分一致性;pass@4协议与采样细节需仔细对齐。综合评估:诊断结论数天内可抽查复验,训练一周内可完成,整体中等偏易。
论文图表
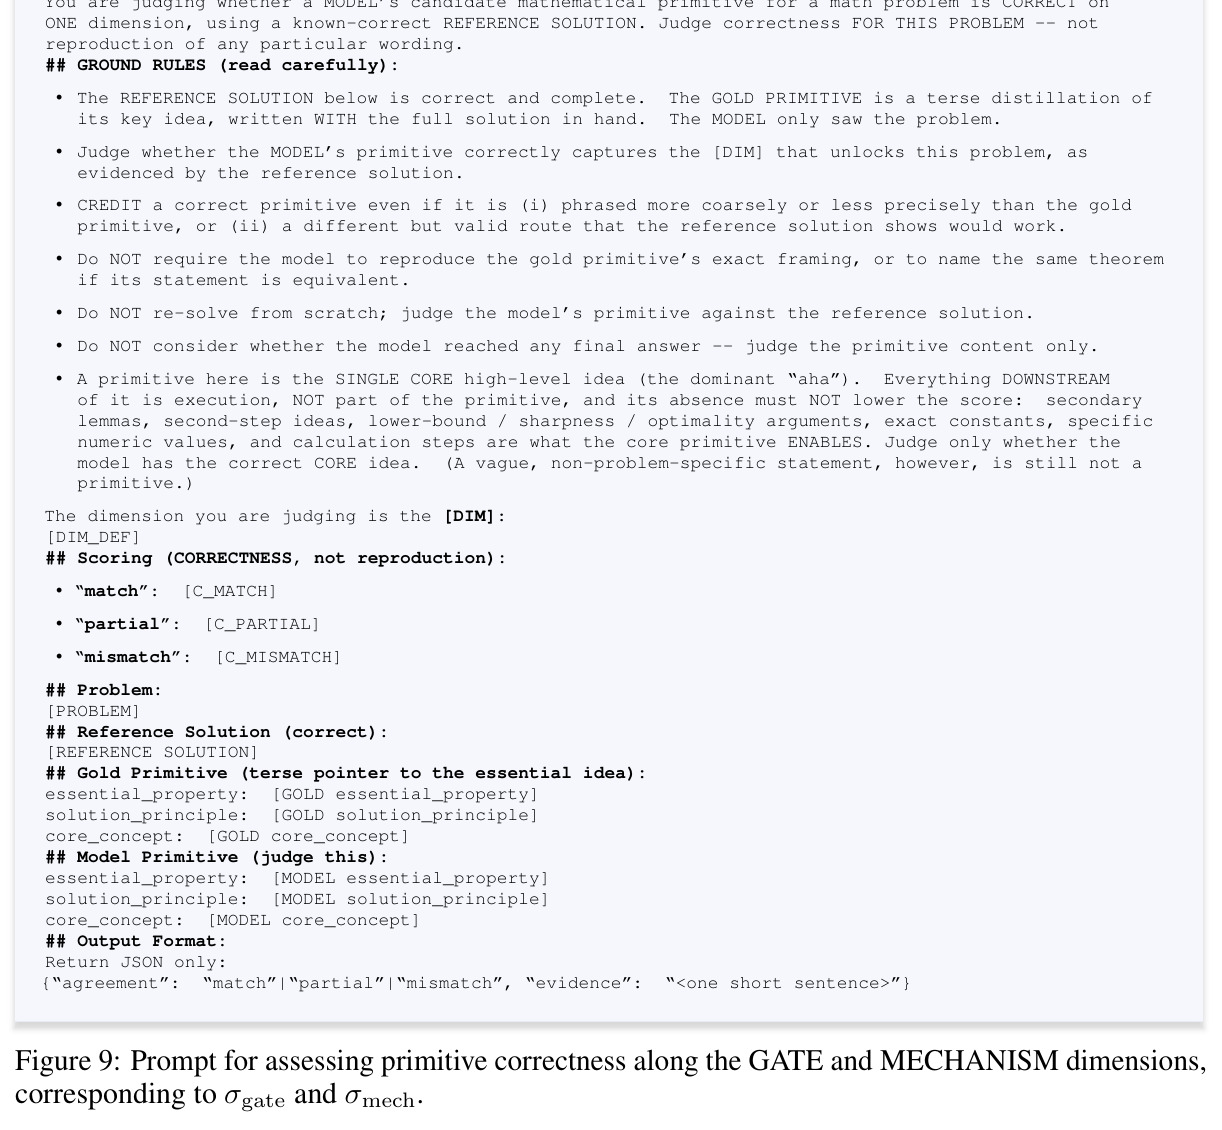
以'求 $L:=\mathbb{Q}(\sqrt{2}+\sqrt{3})$ 扩张的伽罗瓦群'为例对比完整解答与原语:完整rationale含三大步推导(证明扩张次数、构造自同构、判定群结构为四元数群 $Q_8$);而原语只有一句话核心概念——'追踪新增根在双二次基域上的平方类,平方类的保持给出提升,提升的阶与交换性共同锁定同构类型'。
这是理解'数学原语'这一全新概念最直观的材料:清楚展示了原语不是缩短的证明,而是使推导成为可能的结构性洞察。