面向大语言模型的通用文本教学 Universal Textual Teaching for LLMs
不更新参数,把师生知识差距蒸馏成可跨模型复用的自然语言教材Primer
前置知识
知识蒸馏 (Knowledge Distillation, KD)
让小模型(Student)从大模型(Teacher)学习能力的范式。经典做法是把 Teacher 的输出分布或生成文本当作监督信号,通过最小化 $F_{KD}$ 目标(如交叉熵、反向 KL)来更新 Student 参数。LLM 时代分化为两条路线:在 Teacher 思维链上做监督微调(SeqKD、Fine-tune-CoT),以及用 Teacher 评价驱动策略梯度的 on-policy 蒸馏(MiniLLM、GKD、LUFFY)。共同点是知识最终写进权重。
本文的出发点就是批判这条共识:知识必须绑定在 Student 参数上吗?UTT 把优化对象从参数换成文本,理解传统 KD 的两条路线才能体会这个转向的意义。
上下文学习 (In-Context Learning, ICL)
不修改模型权重、仅在输入前拼接指令或示例就能改变模型行为的能力,是 Transformer 涌现出的核心特性之一。提示中的示范、规则、策略文本都会被模型当作任务条件来吸收。这构成了『文本可以充当知识载体』的技术前提——只要知识被写成合适的自然语言,任何支持 ICL 的模型都能直接使用。
UTT 的 Primer 本质上是一份高度优化的上下文前缀。论文三大前提中的『LLM 能理解并遵循自然语言指令』『言语化的知识可被其他 LLM 直接使用』都依赖 ICL 能力成立。
自动提示优化 (Automatic Prompt Optimization, APO)
用搜索或迭代反馈代替人工设计 prompt 的方法族。APE 让模型生成并筛选候选指令;OPRO/ProTeGi 用文本形式的反馈和历史候选引导优化;MIPROv2 联合优化指令与示范;GEPA 用反思式进化优化复合 LLM 系统。它们的共同评价标准是目标任务分数,产物是绑定单一任务模型的 prompt。
UTT 是本文的主要对照组之一。需要分清 APO『为分数搜 prompt』与 UTT『为师生差距写教材』的区别,否则会误以为 UTT 只是又一次 APO。
KernelBench 与 Fast1 指标
KernelBench 要求模型为 PyTorch 算子写出正确且更快的自定义 CUDA kernel,是开放式代码生成基准:没有唯一参考实现,靠真实执行判定功能正确性,并在 GPU 上对比运行时效率。Fast1@5 表示每题 5 个采样中至少有 1 个『既正确又比 PyTorch 参考实现快』的题目比例,同时考察正确率与工程优化能力。
论文的一半实验在这个基准上。理解它的执行式评估和 Fast1 定义,才能读懂主结果表和『蒸馏子集/保留子集/前沿子集』划分实验的实际含义。
研究动机
当前 LLM 之间能力差距明显:开源模型受规模和训练算力限制(参见 Kaplan 缩放律),在推理和代码任务上普遍落后于闭源旗舰。知识蒸馏是缩小差距的主流手段,但现有方法几乎都走两条路:要么让 Student 在 Teacher 生成的答案或思维链上做监督微调(SeqKD、Fine-tune-CoT、Distilling Step-by-Step),要么用 Teacher 评价或任务奖励驱动偏好优化与强化学习(MiniLLM 的反向 KL、GKD 的分布匹配、LUFFY 的离线引导 RL)。它们的共同问题是:知识必须通过更新 Student 参数来存储。这带来三重束缚。其一,蒸馏产物绑定特定架构和 checkpoint,换一个模型就要重训一遍;其二,参数化的知识不可直接查看、编辑和审计,蒸馏失败时难以定位原因;其三,对纯 API 提供的闭源模型、量化后的小模型或训练成本高昂的模型,根本无法更新权重,蒸馏链条直接断裂。例如想让 27B 开源模型在 GPU kernel 生成上追平旗舰闭源模型,传统 KD 需要构造训练数据、申请多卡 GPU 并完成完整的 RL 训练,门槛极高。
本文的目标是本文提出一个核心问题:能否在不更新任何参数的前提下,把 Teacher 与 Student 之间的知识差距蒸馏成一种显式、可解释、可复用的自然语言表示?具体目标分四层:(1) 自动定位『Teacher 会做而 Student 不会做』的代表性样本,避免把冗余监督(Teacher 也做错的)或不可靠示范(Teacher 失败的)混进教学材料;(2) 通过多角色 LLM 交互,把失败案例转化为可复用的任务知识、推理策略和避坑指南,合成为一篇名为 Primer(取『入门教科书』本义)的文本;(3) 验证 Primer 不仅能提升合成它的源 Student,还能不加修改地迁移到未参与合成的其他 Student,甚至跨模型家族迁移;(4) 在 Omni-MATH-2 奥数和 KernelBench 代码生成两个高难基准上量化收益,目标是把 DeepSeek V4 Flash 的 KernelBench 准确率从 9.4% 拉到约 48.6%、数学从 27.6% 拉到约 51.7%,并超越代表性提示工程与参数化 KD 方法。
与已有工作不同的是,已有工作与『把 KD 变成文本』擦肩而过。自动提示优化(APE、OPRO、MIPROv2、GEPA、TextGrad)虽然也在优化自然语言,但它们直接以目标任务得分为搜索目标,没有『指定 Teacher 对指定 Student 的知识差距』概念,产物绑定单一任务模型,跨模型复用性从未被系统检验。经验积累类方法(ExpeL、Dynamic Cheatsheet、SkillGLoW、AutoManual、SkillX)从轨迹中总结规则或技能库,但教学内容由环境规则或通用技能驱动,同样不以配对的性能差距为依据。UTT 的独特切入是:把『该教什么』建立在严格的配对评估之上——只教 Teacher 真正比 Student 强的内容;把『怎么教』交给 Prompter 诊断与 Teacher 示范的分工;把『教得对不对』交给验证门控兜底;并把『学到的知识能不能给别人用』作为明确的科学问题来回答,首次系统验证了自然语言可以充当跨 LLM 的通用知识载体。
核心方法
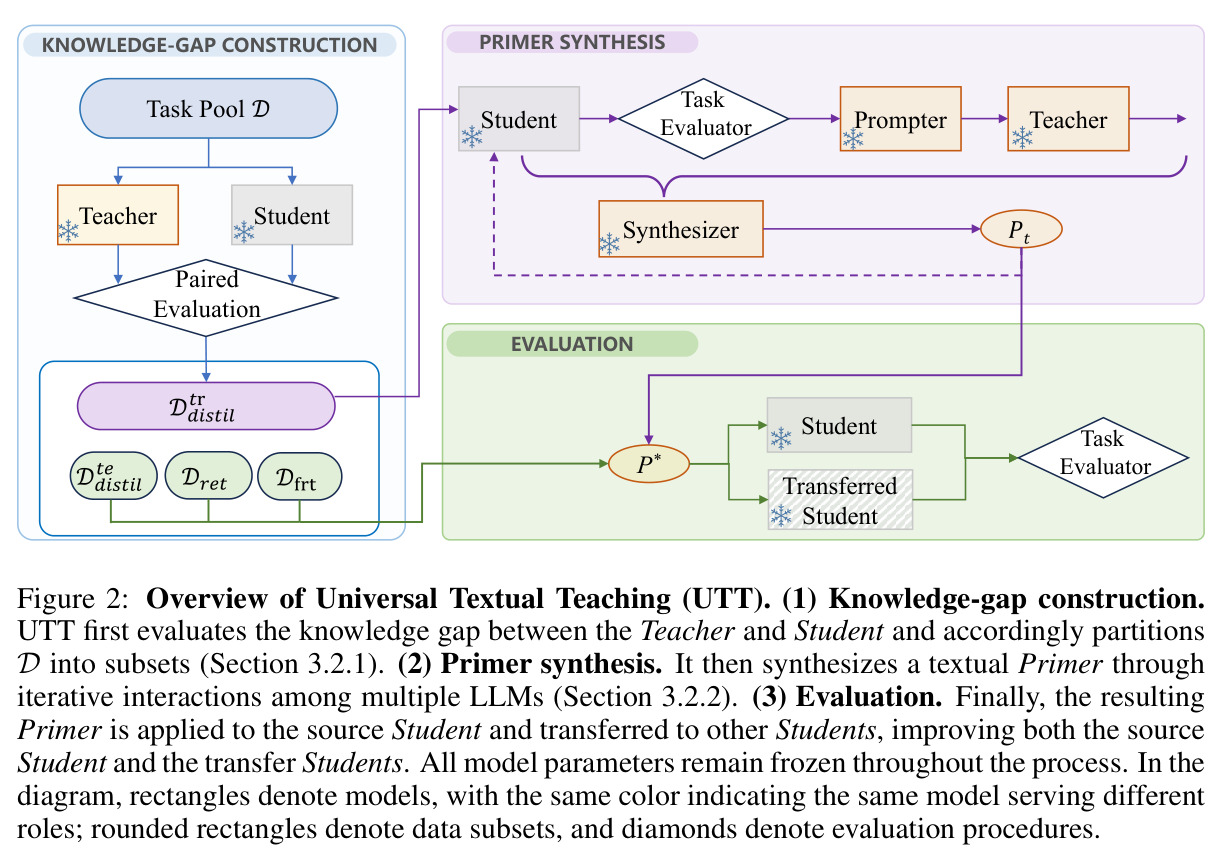
直觉上,UTT 把『老师反复辅导一个学生』改造成『老师给学生写一本通用入门书』:老师观察学生做题、诊断错因、给出针对性示范,再把验证过的经验写进不断修订的教材,之后任何学生都能拿书自学,所有模型权重一动不动。形式化上,传统参数化 KD 固定 Teacher 参数 $\theta_T$,优化 Student 参数 $\theta_S \in \mathbb{R}^{d_S}$:$\theta^*_S = \arg\min_{\theta_S} \mathbb{E}_{x \sim \mathcal{D}}[F_{KD}(M_{\theta_S}(x), K_{M_{\theta_T}}(x))]$,把知识写进权重。UTT 则固定 $\theta_T$ 与 $\theta_S$,转而在离散文本空间 $\mathcal{P}_{text} \subseteq V^*$(V 为词表)中优化 Primer $P$:$P^* = \arg\min_{P \in \mathcal{P}_{text}} \mathbb{E}_{x \sim \mathcal{D}}[F_{KD}(M_{\theta_S}(P \oplus x), K_{M_{\theta_T}}(x))]$,其中 $P \oplus x$ 表示把 Primer 拼在输入 $x$ 之前,$F_{KD}$ 是任务评估反馈。由于该目标在离散文本上不可求梯度,UTT 用『配对评估定位差距 → 多角色交互合成 → 验证门控筛选』的迭代闭环近似求解,全程只涉及 LLM 之间的调用,天然支持开源与 API-only 模型。
核心创新是把知识蒸馏的优化对象从实值参数换成离散自然语言,并让『教什么』由观测到的 Teacher-Student 性能差距决定。与普通 prompt 工程最本质的区别有三点。第一,训练数据不是全量任务,而是按经验准确率筛出的蒸馏子集:对每个样本 $x$ 计算 Teacher 与 Student 各 $K$ 次采样的准确率 $q_T(x)$ 与 $q_S(x)$,仅 $q_T(x) > q_S(x)$ 的样本进入教学;Student 已掌握的划入保留子集、双方都失败的划入前沿子集,分别检验能力保持与前沿扩展——保证 Primer 承载的是真正的『知识增量』而非冗余信息。第二,教学闭环带质量控制:只有 Teacher 示范本身通过评估($F^{corr}_{KD}(x_i, d_{t,i}) = 1$)的教学记录才进入合成器,防止错误知识污染教材。第三,每次更新都过验证门控:候选 Primer 必须在当前批次正确数不低于旧版才被接受,否则回退,从机制上杜绝『知识越攒越杂、学生越学越差』。这三条设计使 Primer 区别于随意的 prompt,也是它能跨模型迁移而几乎不损失效果的根本原因。
方法步骤详情
UTT 分两阶段。第一阶段知识差距构建:对每个样本 $x$,Teacher 与 Student 各生成 $K=5$ 次,计算经验准确率 $q_m(x) = \frac{1}{K}\sum_k F^{corr}_{KD}(x, y^{(k)}_{m,x})$;据此把 $\mathcal{D}$ 划分为蒸馏子集 $\mathcal{D}_{dist}$($q_T > q_S$,再按 7:3 切成合成训练集与评估测试集)、保留子集 $\mathcal{D}_{ret}$($q_T \le q_S$ 且 $q_S > 0$)、前沿子集 $\mathcal{D}_{frt}$($q_T = q_S = 0$)。第二阶段闭环合成:训练集按 batch 16 分批,初始化 $P_0$ 后逐批迭代五步。(1) Student 尝试:$z_{t,i} = M_{\theta_S}(P_{t-1} \oplus x_i)$;(2) 评估器返回反馈 $e_{t,i}$,答对即跳过;(3) 答错时 Prompter 依据题目与反馈诊断知识差距,产出教学指令 $a_{t,i} = M_{\theta_P}(x_i, e_{t,i})$;(4) Teacher 按指令生成示范 $d_{t,i} = M_{\theta_T}(x_i, a_{t,i})$,仅当示范通过评估才把记录 $r_{t,i} = (x_i, z_{t,i}, e_{t,i}, a_{t,i}, d_{t,i})$ 保留进 $R_t$;(5) Synthesizer 把 $R_t$ 整合进当前 Primer 得到候选 $\tilde{P}_t = M_{\theta_{Syn}}(P_{t-1}, R_t)$,要求合并去重、提炼可迁移原则、限 1000 词;最后验证门控要求 $N_{corr}(\tilde{P}_t; B_t) \ge N_{corr}(P_{t-1}; B_t)$ 才接受候选。全部批次结束得到 $P^*$,部署时直接作为前缀上下文,也可原样交给其他 Student。
技术新颖性
与参数化 KD(SeqKD、GKD、LUFFY)相比,UTT 的知识载体从权重变为文本,带来可审计、可编辑、可跨模型复用三重新性质,并首次把 API-only 闭源模型纳入蒸馏范围。与 APO(APE、MIPROv2、GEPA)相比,优化基准不是单一任务分数而是显式的师生差距,监督信号包含 Teacher 生成示范而非仅有评估反馈,并系统评估了跨 Student 迁移。与经验记忆类方法(ExpeL、Dynamic Cheatsheet、AutoManual、SkillX)相比,UTT 用配对评估定位教学内容、用验证门控保证更新不退化、并把跨模型复用作为核心检验指标。工程上,它把 Student/Prompter/Teacher/Synthesizer 四角色实例化为 LLM 函数调用(Teacher 兼任 Prompter 与 Synthesizer),零梯度、零本地 GPU。资源上(Table 6),Pro→Qwen 设置下 UTT 合成仅需 1.6 小时、281 次 API 调用、约 67.8 万输入 token 与 557 万输出 token;对照 LUFFY 需 8 块 RTX A6000 训练 22 小时,却在三项指标上全面落后。
实验结果
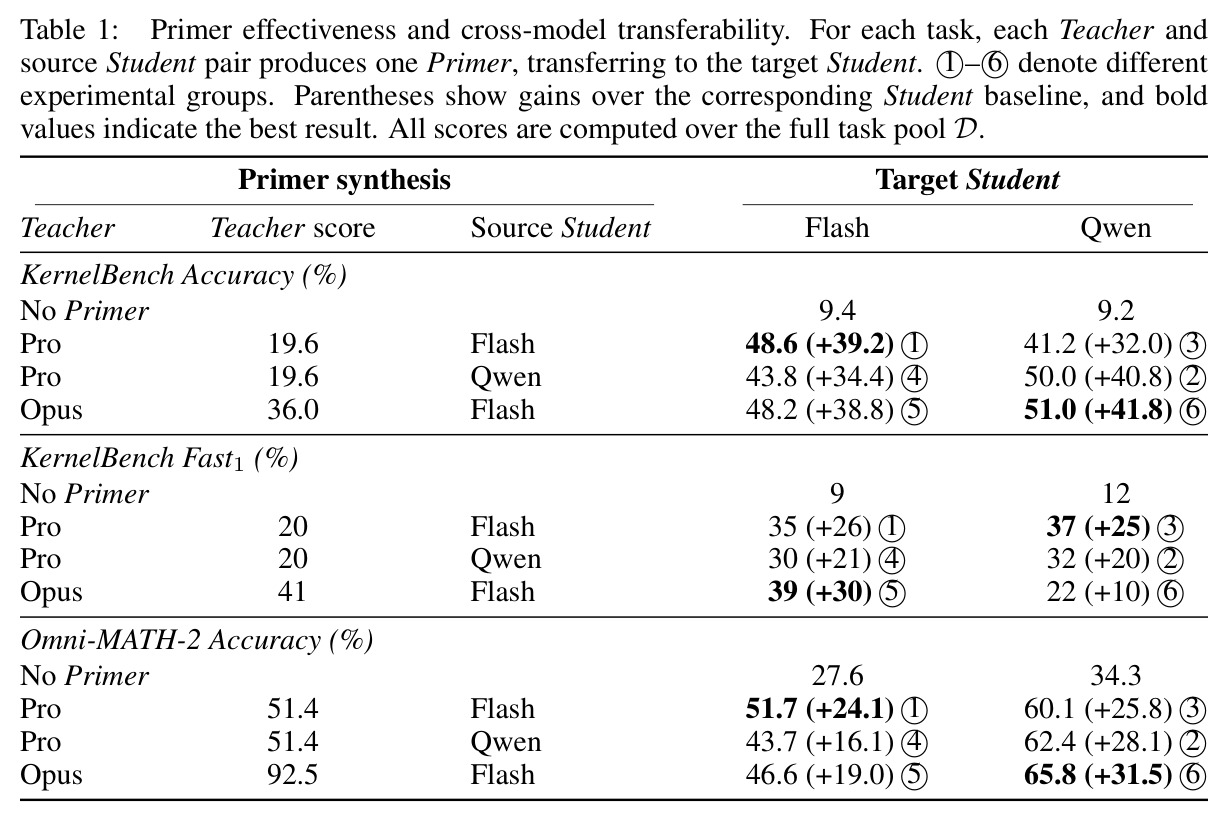
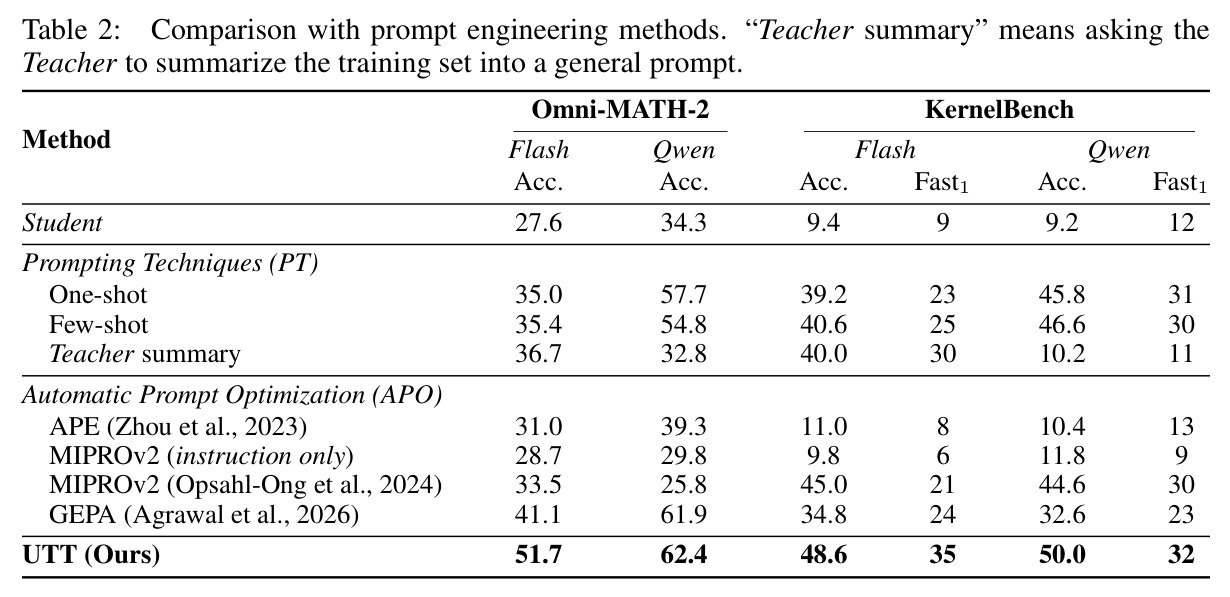
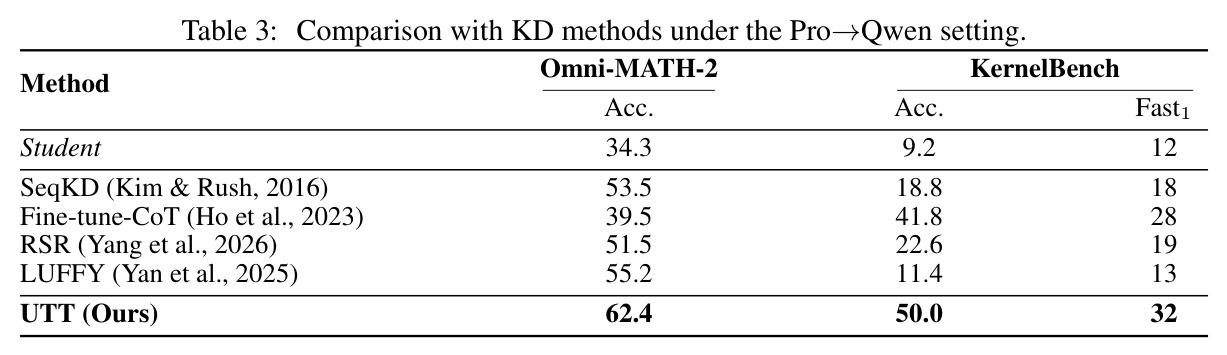
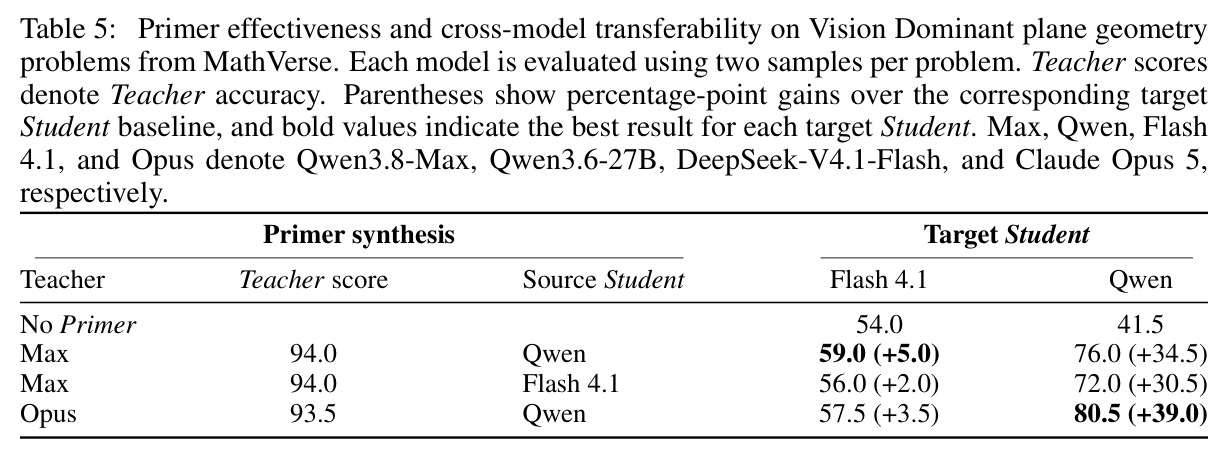
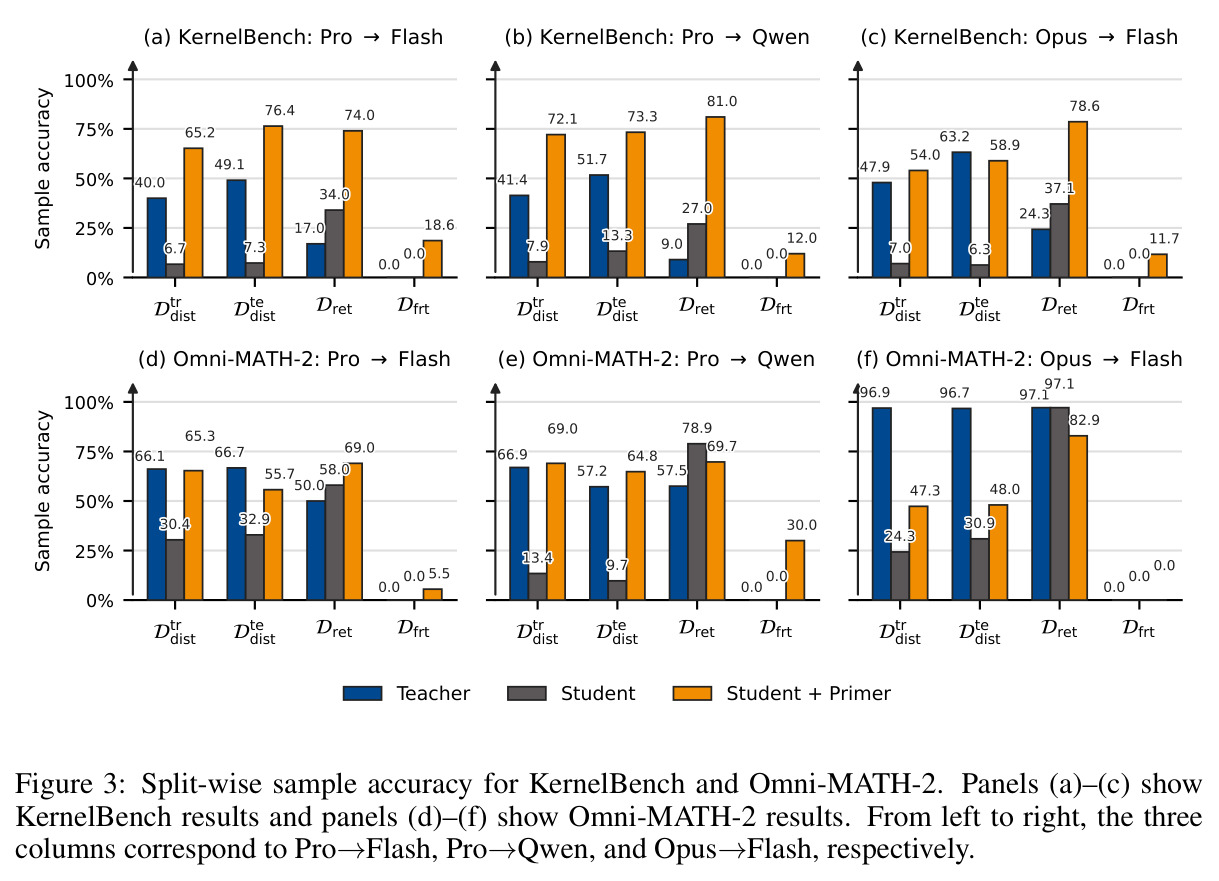
主实验(Table 1)覆盖 Pro→Flash、Pro→Qwen、Opus→Flash 三种师生配置。① 基础有效性:Pro→Flash 的 Primer 把 KernelBench 准确率从 9.4% 提到 48.6%(+39.2 pp),Fast1 从 9% 到 35%(+26 pp),Omni-MATH-2 从 27.6% 到 51.7%(+24.1 pp);为 Qwen 合成的 Primer 达 50.0%/32%/62.4%。② 跨 Student 迁移:两个 Pro 派生 Primer 互换后无需重合成,Flash 版提升 Qwen 32.0/25/25.8 pp,Qwen 版提升 Flash 34.4/21/16.1 pp。③ Teacher 替换与通用迁移:Opus→Flash 的 Primer 提升 Flash 38.8/30/19.0 pp;同一 Primer 原样用于未参与合成的 Qwen,仍得 51.0%/22%/65.8%(+41.8/+10/+31.5 pp)。④ 细粒度分析(Figure 3):蒸馏训练集上 Pro→Flash 的 KernelBench 6.7%→65.2%;蒸馏测试集上 Pro→Qwen 数学 9.7%→64.8%,证明泛化到未见题目;保留子集上 KernelBench 三配置不降反升(34.0→74.0、27.0→81.0、37.1→78.6),但数学上 Pro→Qwen 与 Opus→Flash 分别降 9.2 与 14.2 pp;前沿子集 6 配置中 5 个从 0 变非零(KernelBench 11.7–18.6%,数学最高 30.0%)。⑤ 对比:Table 2 中 UTT 在全部 6 个组合超过提示工程方法(数学 Flash 51.7 对 GEPA 41.1);Table 3 中超过最强 KD 基线:数学 62.4 对 LUFFY 55.2(+7.2)、KernelBench 50.0 对 Fine-tune-CoT 41.8(+8.2)、Fast1 32 对 28。⑥ 多模态(Table 5):Opus 的 Primer 把 MathVerse 上 Qwen 从 41.5% 提到 80.5%(+39.0)。⑦ 消融(Table 7):知识差距选择比随机选题高 9.7/6.0 pp;去 Prompter 后测试集 56.0→48.8;去验证门控后测试集 56.0→39.3。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| KernelBench(L1 GPU kernel 生成) | Accuracy | 48.6%(Pro→Flash) | 9.4%(Flash 无 Primer) | +39.2 个百分点 |
| KernelBench(L1 GPU kernel 生成) | Fast1@5 | 35%(Pro→Flash) | 9%(Flash 无 Primer) | +26 个百分点 |
| Omni-MATH-2(奥数推理) | Accuracy | 51.7%(Pro→Flash) | 27.6%(Flash 无 Primer) | +24.1 个百分点 |
| Omni-MATH-2 对比最强提示工程 | Accuracy(Flash) | 51.7%(UTT) | 41.1%(GEPA) | +10.6 个百分点 |
| 对比最强参数化 KD(Pro→Qwen) | KernelBench Accuracy | 50.0%(UTT,免训练) | 41.8%(Fine-tune-CoT,LoRA 微调) | +8.2 个百分点 |
| MathVerse 视觉几何(多模态) | Accuracy(Qwen 目标) | 80.5%(Opus→Qwen Primer) | 41.5%(Qwen 无 Primer) | +39.0 个百分点 |
| 迁移至未参与合成的模型 | Omni-MATH-2 Accuracy(Qwen) | 65.8% | 34.3% | +31.5 个百分点 |
局限与改进
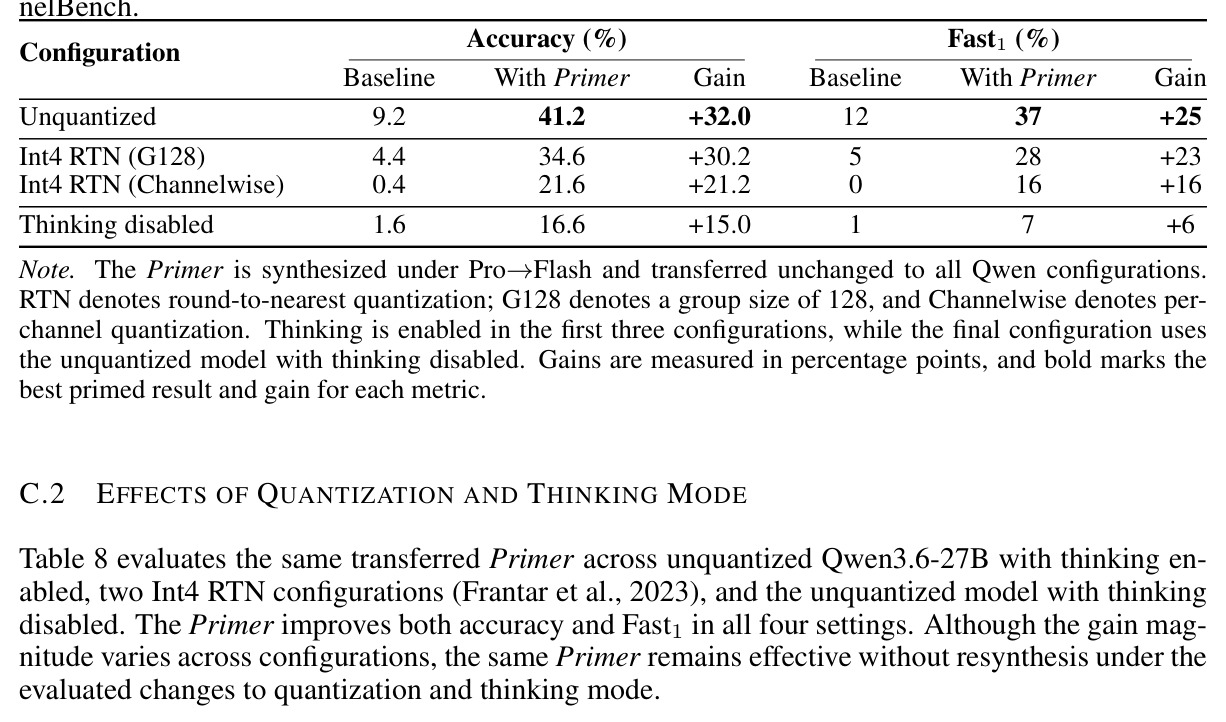
作者在附录 E 承认:Primer 前置到每个输入会显著增加推理 token 开销(默认 1000 词),建议未来用压缩或检索式选择缓解;Primer 由模型生成内容合成,论文明确说明未做事实校对,可能包含不准确或过拟合具体题目的表述(附录 D 原样保留展示)。我的补充观察:(1) Omni-MATH-2 上两个配置的保留子集分别下降 9.2 和 14.2 pp,说明『不伤已有能力』并非绝对,数学任务上 Primer 存在挤压效应;(2) 跨模型迁移增益方差大,如 Opus 派生 Primer 的 Fast1 迁到 Qwen 只剩 +10 pp(源 Student 上为 +30),不同 Student 对同一教材吸收率差异明显;(3) Teacher 接近饱和时蒸馏空间收窄——Opus 数学已达 92.5%,其 Primer 在 Flash 上数学增益(+19.0)反而低于 Pro(+24.1);(4) 方法依赖可判定的评估信号(数学有标准答案、kernel 可执行判优),开放式任务如何定义 $F_{KD}$ 未被回答;(5) 评估规模有限:KernelBench 仅 Level 1 的 100 题、数学 200 题,对 1-2 个百分点量级的结论支撑较弱。
独立分析的弱点
(1) 依赖可验证奖励:整个闭环由 $F_{KD}$ 的 0/1 判定驱动,数学和代码天然适配,但写作、咨询等开放式任务缺少客观判分,直接套用会让教学记录质量失控——可用 LLM-as-judge 或成对偏好比较替代硬判分,并在验证门控中引入多评审一致性投票。(2) 1000 词软上限造成容量瓶颈:复杂领域知识可能装不下,单一全局 Primer 也无法按题定制——可改为分层结构(索引+按需检索的章节),推理时只挂载相关小节,兼顾开销与针对性。(3) Teacher、Prompter、Synthesizer 同源,存在自我强化偏差:教师示范的风格化错误可能被同源 Synthesizer 照单全收——可引入异构模型交叉合成或多 Teacher 投票。(4) 迁移增益方差大(Table 1 中 +10 到 +41.8 pp),部署前无法预知目标 Student 收益——可先对目标 Student 做错误画像,再对 Primer 章节做轻量重排或筛选,把『教材适配学生』变成廉价的二次优化。(5) 免参数化是双刃剑:Student 内在推理模式未被改变,遇到 Primer 覆盖外的长尾问题仍回退到基线水平(前沿子集最高仅 30%)——长期需要文本到权重的二次蒸馏衔接,把验证过的教材固化为真实能力。
未来方向
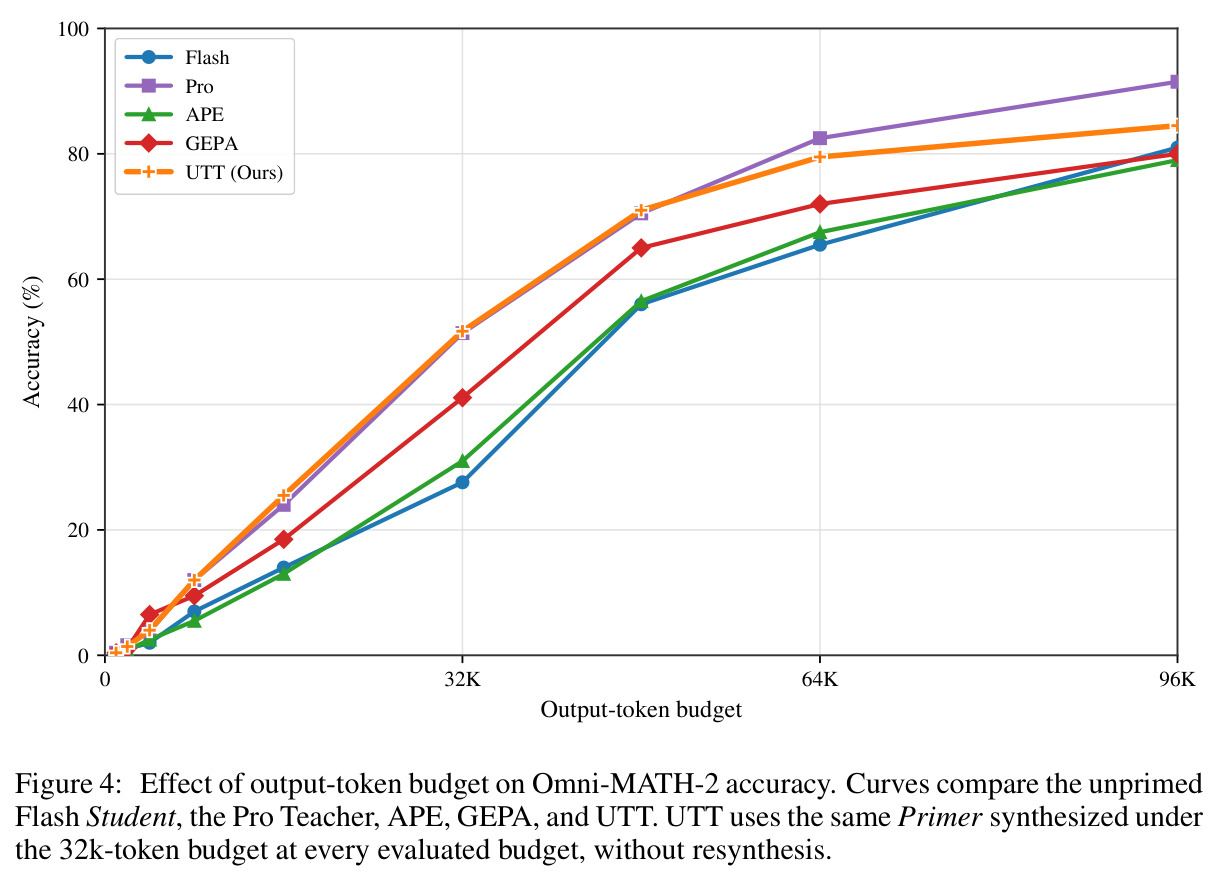
作者提出的方向:(1) Primer 压缩与检索式内容选择,削减每个请求的固定 token 开销;(2) 把 Primer 编码的知识通过后续训练写进模型权重,适合拥有权重和训练基建的机构,形成『文本先行验证、再固化到参数』的两阶段蒸馏。基于成果可延伸:(3) 在线持续教学——把部署后的新失败案例回流到合成闭环,实现教材自动迭代;(4) 多 Teacher 协同——各有专长的 Teacher 分别写 Primer 再合并去重;(5) 知识资产化——可审计、可版本管理的 Primer 可作为模型间的『教材』交易与共享;(6) 与量化/端侧部署结合——Table 8 显示 Int4 模型仍获 +21.2 至 +30.2 pp 增益,『小模型+好教材』是高性价比端侧路线;(7) 与 test-time scaling 结合——Figure 4 显示小 token 预算下 Primer 优势最大,可探索『教材+自适应推理长度』联合策略;(8) 理论刻画——哪些类型的知识差距能被自然语言承载、文本蒸馏与参数蒸馏的能力边界,值得形式化研究。
复现评估
复现门槛中等偏低。方法侧:UTT 全程为 LLM API 调用,无训练、无需本地 GPU;附录 A.3 公开四个角色的完整 system prompt 模板,附录 D 公开奥数、CUDA kernel、多模态几何三份完整 Primer 范例;算法(配对评估、$K=5$ 采样、7:3 切分、batch 16、验证门控、1000 词上限)足以直接实现。数据侧:KernelBench Level 1(100 题)、Omni-MATH-2(难度 5-10 选 200 题)、MathVerse 均为公开基准,Table 4 给出各配置子集样本数。成本侧:主实验需要 DeepSeek V4 Pro/Flash、Qwen3.6-27B、Claude Opus 5 的 API;单次合成官方开销为 1.6 小时、281 次调用、约 67.8 万输入 + 557 万输出 token,按主流 API 定价约几十美元,个人可负担。唯一需要本地硬件的是 KernelBench 执行评估(论文用单块 RTX A6000),消费级显卡可替代。风险点:结果依赖 API 服务版本稳定性与采样随机性(作者以每题 5 样本缓解);仅复现 KD 基线对比才需 4-8 块 A6000。预计一周内可完成核心复现。
论文图表
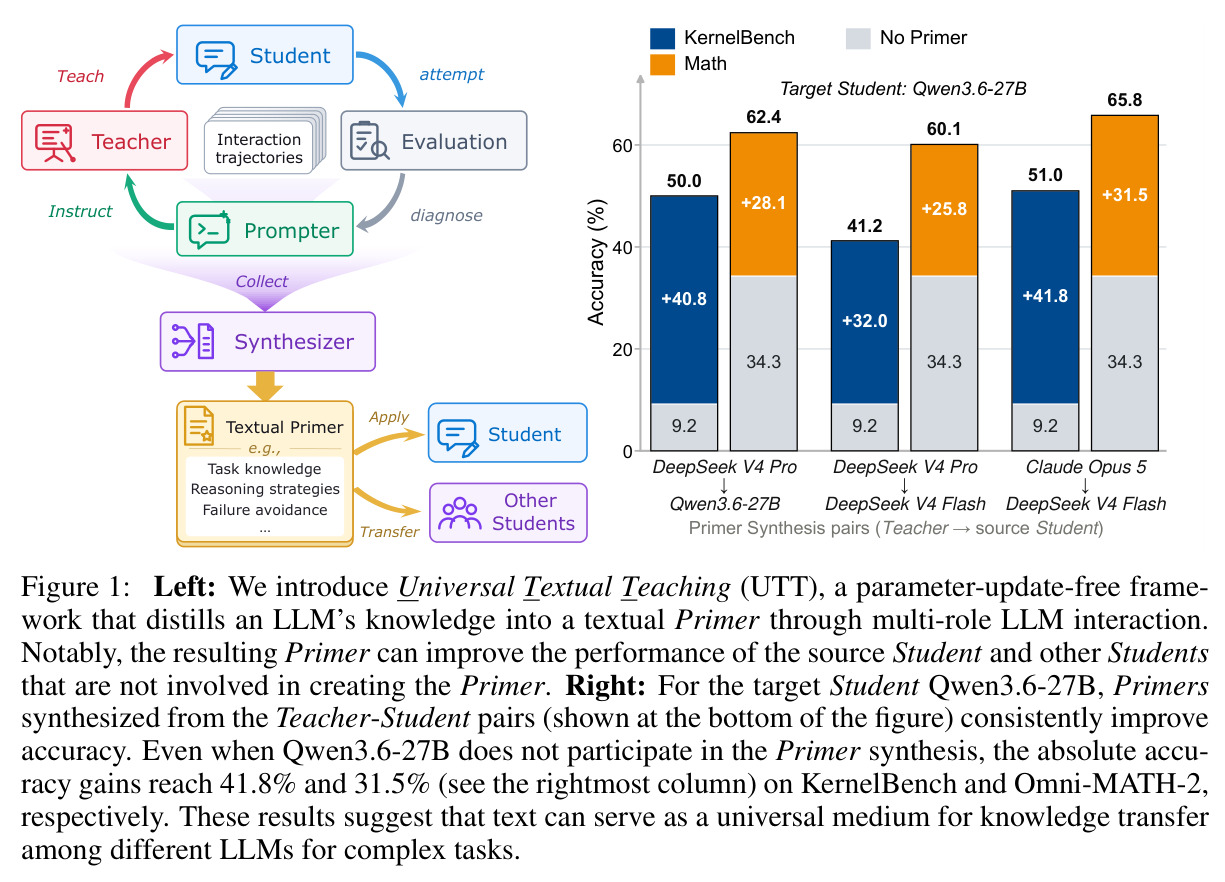
左半部分展示 UTT 的整体闭环:Teacher 与 Student 先做交互式教学,产生评估轨迹,经 Instruct(指令)、Synthesizer(合成)生成文本 Primer,再应用到 Student 上,内容涵盖任务知识、推理策略与避坑经验;右半部分是柱状图,显示不同师生组合合成的 Primer 应用于 Qwen3.6-27B 后,KernelBench 和 Omni-MATH-2 准确率的一致提升,其中未参与合成的迁移场景增益达 +41.8 和 +31.5 pp。
这是全文的『一图流』:同时传达了框架闭环结构和最核心的实证结论(文本可作跨模型知识载体),看懂这张图就掌握了论文的问题、方法和主结果。
资源对比表:参数化 KD 需要 4 块 A6000 训练 1.2-7.5 小时(LUFFY 需 8 块训 22 小时),而 UTT 仅用官方 API、1.6 小时、281 次模型调用、约 67.8 万输入 token 和 557 万输出 token(其中 Student 侧行为占输出 token 的绝大部分)完成 Primer 合成。
它量化了『免参数更新』的实际经济性,说明 UTT 把蒸馏成本从 GPU 训练转移到少量 API 调用,是工程落可行性的直接证据,也帮助读者估算自己的复现预算。
消融表:完整方法在四个子集上为 65.3/56.0/72.5/5.0。随机选题使训练/测试集降至 55.6/50.0;去掉 Prompter 训练集反升至 72.4 但测试集降至 48.8、保留子集降至 70.0;去掉验证门控测试集跌至 39.3 但保留子集升至 80.0;batch 8/32 均不如默认 16。
它逐一拆解了方法三个组件的贡献,尤其揭示了有趣的权衡:Prompter 短期拟合弱但促进泛化,验证门控以少量保留性能换取整体稳定性,是理解设计必然性的关键。