重新思考 Agent Harness 中的验证机制 Rethinking Verification in Agent Harnesses
系统比较17种验证设计,发现独立critic审查是性价比最高的test-time scaling轴
前置知识
Agent Harness(智能体执行框架)
包裹 LLM 的执行框架:向模型暴露工具(读写文件、运行命令)、接收观察结果、驱动 ReAct 式迭代循环,直到达成任务目标。除了工具接口,harness 还决定系统指令内容、外部消息的介入时机、以及何时接受 agent 的产出。Claude Code、Codex CLI、Gemini CLI 都是典型的 harness。
本文的全部自变量都是 harness 层的设计选择(何时插消息、谁来检查),而非模型本身;不懂 harness 就无法区分「模型能力」和「框架编排」两个来源的收益。
Test-time Scaling(测试时扩展)
不改动模型权重、只增加推理阶段的计算来换取更高性能的范式,典型手段包括多次采样后选优、树搜索、以及用额外算力做验证与修订。它和训练时扩展(更大模型、更多数据)互补,允许按任务难度弹性分配算力。
论文的核心主张是「独立审查应被视为一个实用的 test-time scaling 轴」,与增加采样数并列;理解这个框架才能评价其贡献是编排发现还是新能力。
Self-correction 与 Critic(自校正与批评者)
让模型对自己生成的内容产出自然语言批评并据此修订,代表工作有 Self-Refine、Reflexion。已有研究(如 Huang et al. 2023)指出 LLM 难以可靠地发现自己推理中的错误,自校正收益高度依赖反馈质量,因为模型倾向于重复自己的盲点。
L3 独立审查正是对「模型自我批评」范式的替代方案:把检查外包给一个没有执行历史包袱的独立上下文,理解自校正的局限才能看出这一设计动机。
Terminal-Bench 与 SWE-bench Verified
Terminal-Bench(TB)测 agent 在命令行环境完成真实任务的能力(2.1 版注册表 89 个任务,本文按难度分带选取 31 个);SWE-bench Verified(SWE)是经人工核验的 GitHub issue 修复基准(本文按人工修复时长分三档选取 30 个)。两者都提供自动 grader,指标准确率即任务解决率。
论文的主要量化结论(+3.3 到 +9.5 个百分点的增益、成本倍数)都来自这两个基准的子集实验,需知道其任务构成才能判断结论的外推范围。
Completion Gate(完成门控)
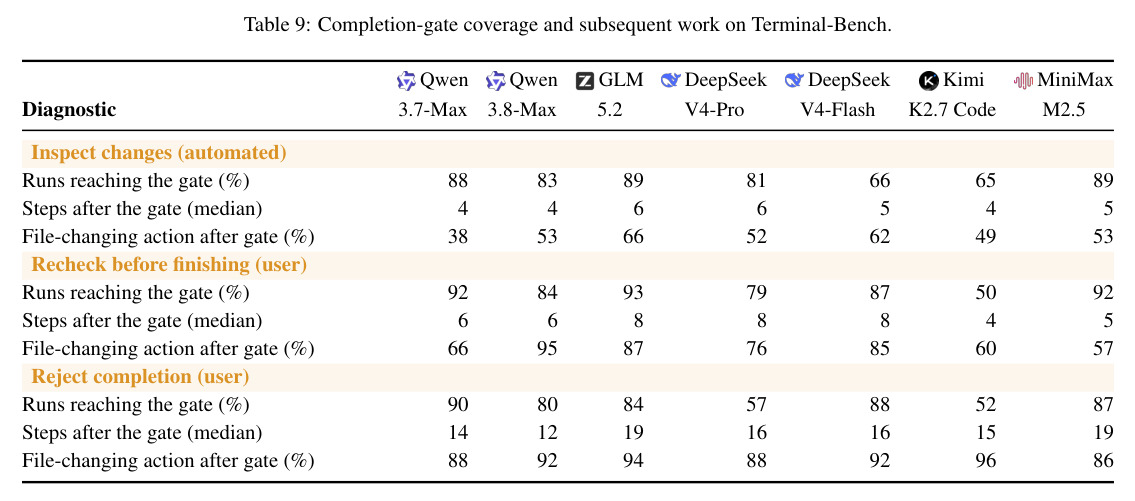
当 agent 产出一个不带工具调用的 turn(即试图结束)时,harness 拦截这次结束:或注入检查要求让 agent 自检,或直接拒绝完成要求继续工作。Claude Code 的 hooks 机制是其在产品中的工程实现。它是 L2 层所有设计的技术基础。
L2 是本文重点证伪的方向(收益有限但成本 1.5-1.8 倍),理解门控的触发与重开机制才能看懂其成本为何失控。
研究动机
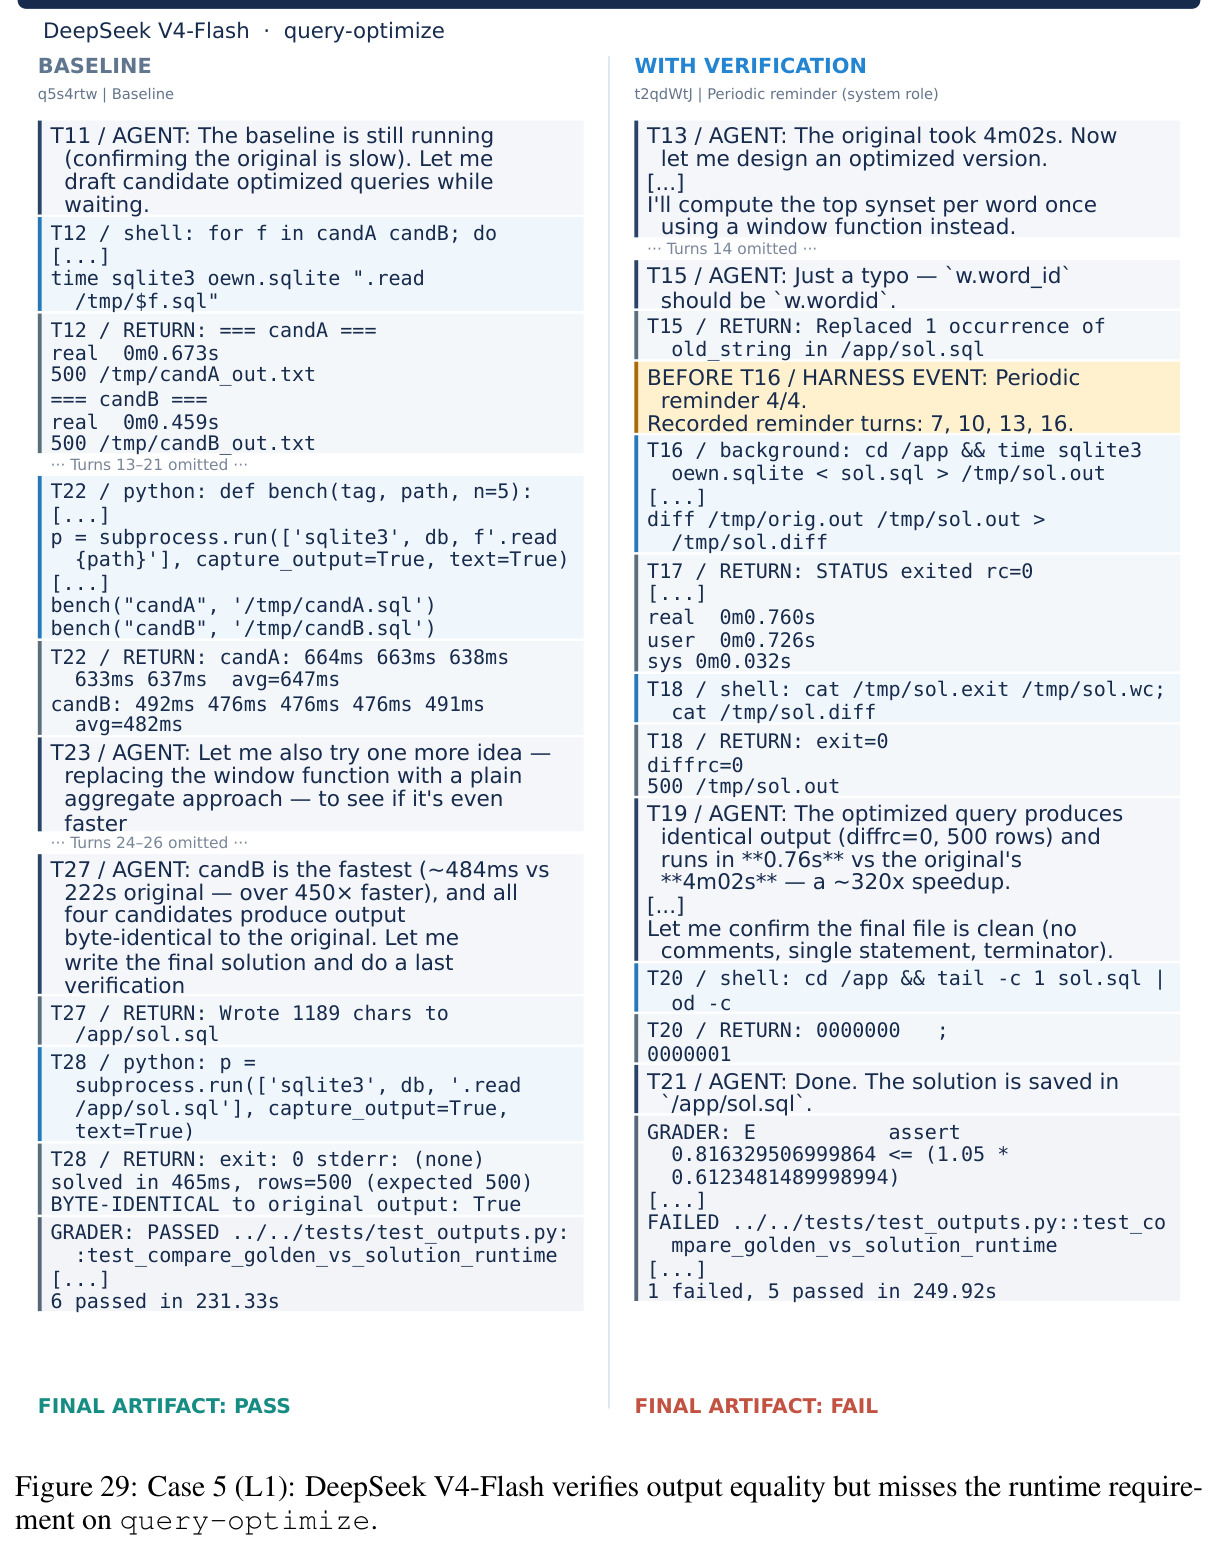
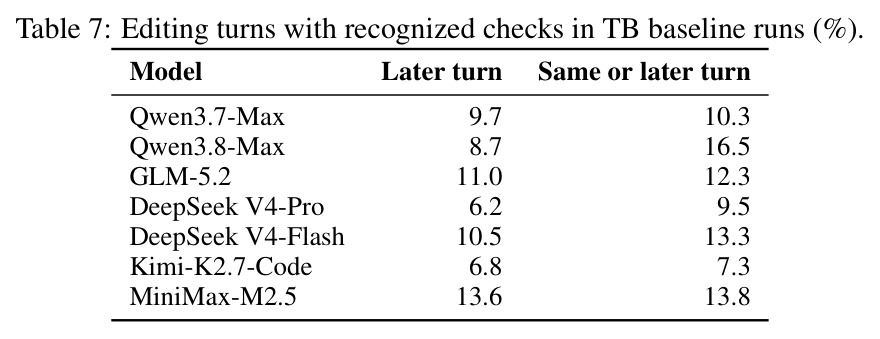
编码 agent 的验证设计目前几乎完全依赖工程直觉和迭代经验:Claude Code 通过 hooks 提供完成检查点,Codex CLI 用自我审查加迭代,但业界缺少系统性证据回答「哪种验证设计在哪个模型、哪类任务上有效,收益是否配得上额外算力」。更根本的问题是 agent 自发验证严重不足:作者对 TB 基线运行的轨迹分析显示,只有 6.2–13.6% 的编辑 turn 之后跟有可识别的检查命令(Appendix Table 7),错误在编辑之间不断累积。同时自校正文献又表明模型难以可靠发现自己的错误。在 TB/SWE 这类长视界仓库级任务上,后果非常具体:一个 agent 可以跑通自己的测试、宣布完成,却因为没测「日期出现在 IP 地址之前」这种边界情况而最终被外部 grader 判负——这类缺陷靠「再让它自己多干一会儿」往往修不好。
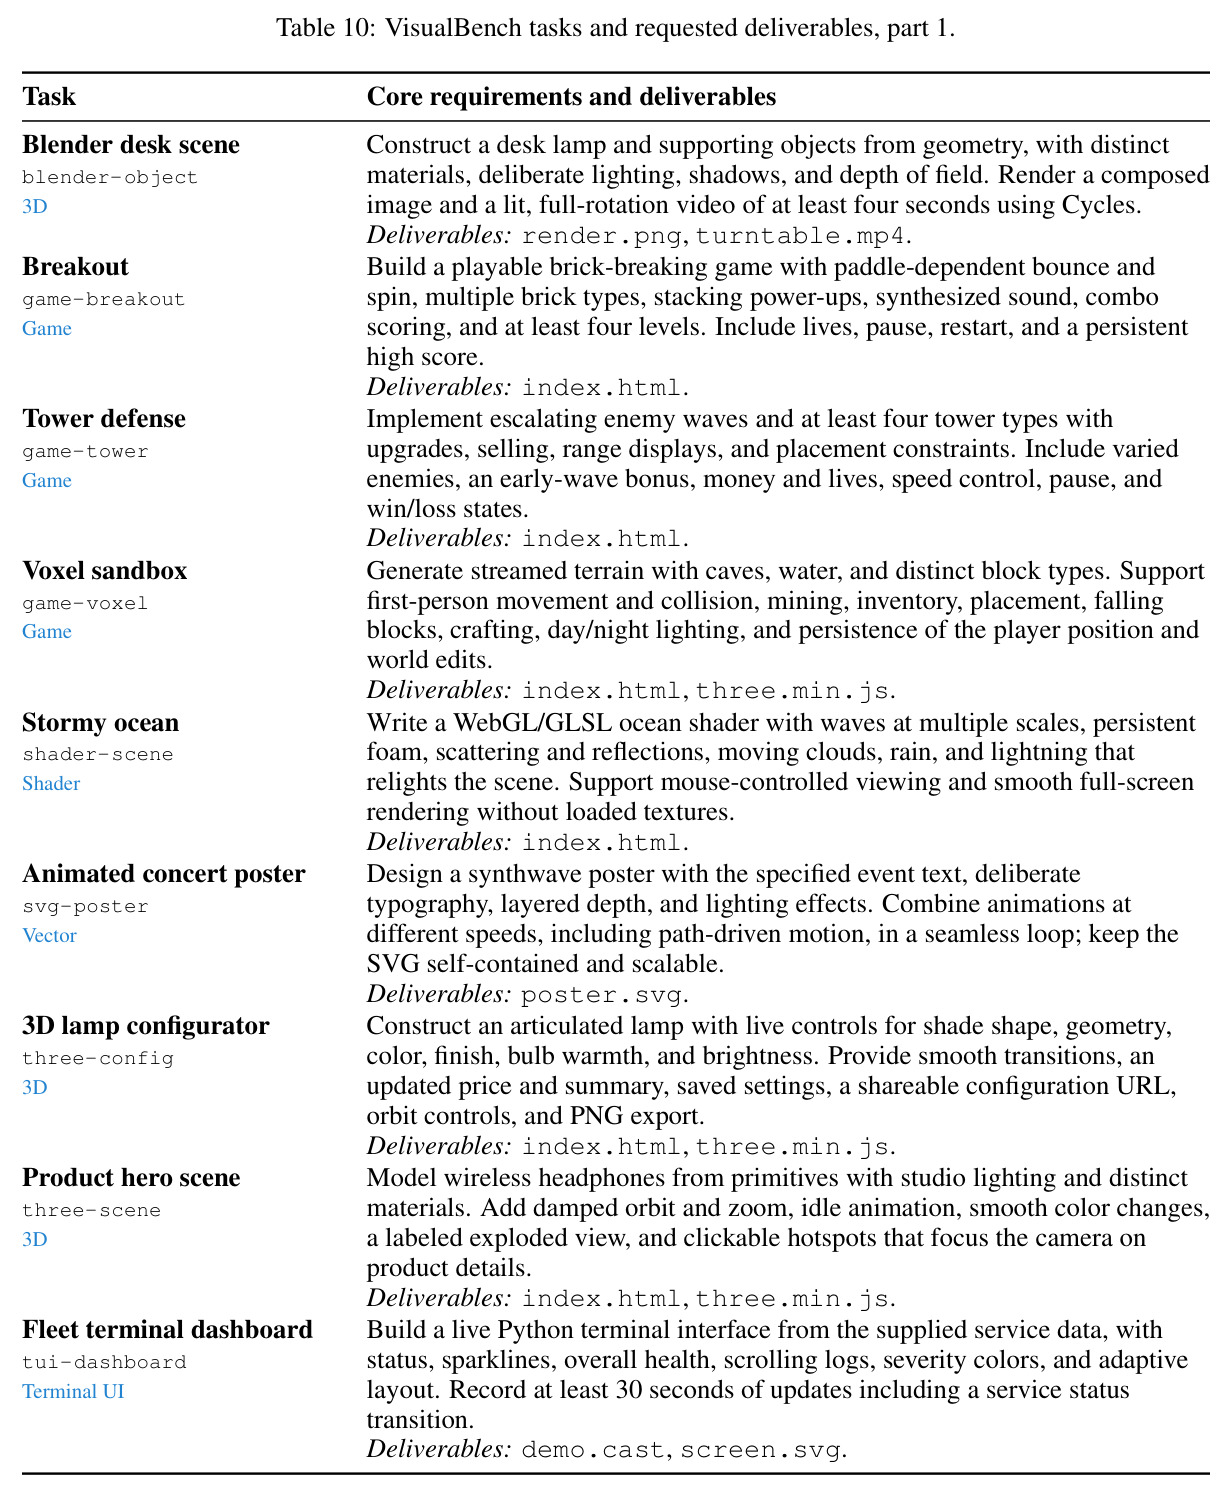
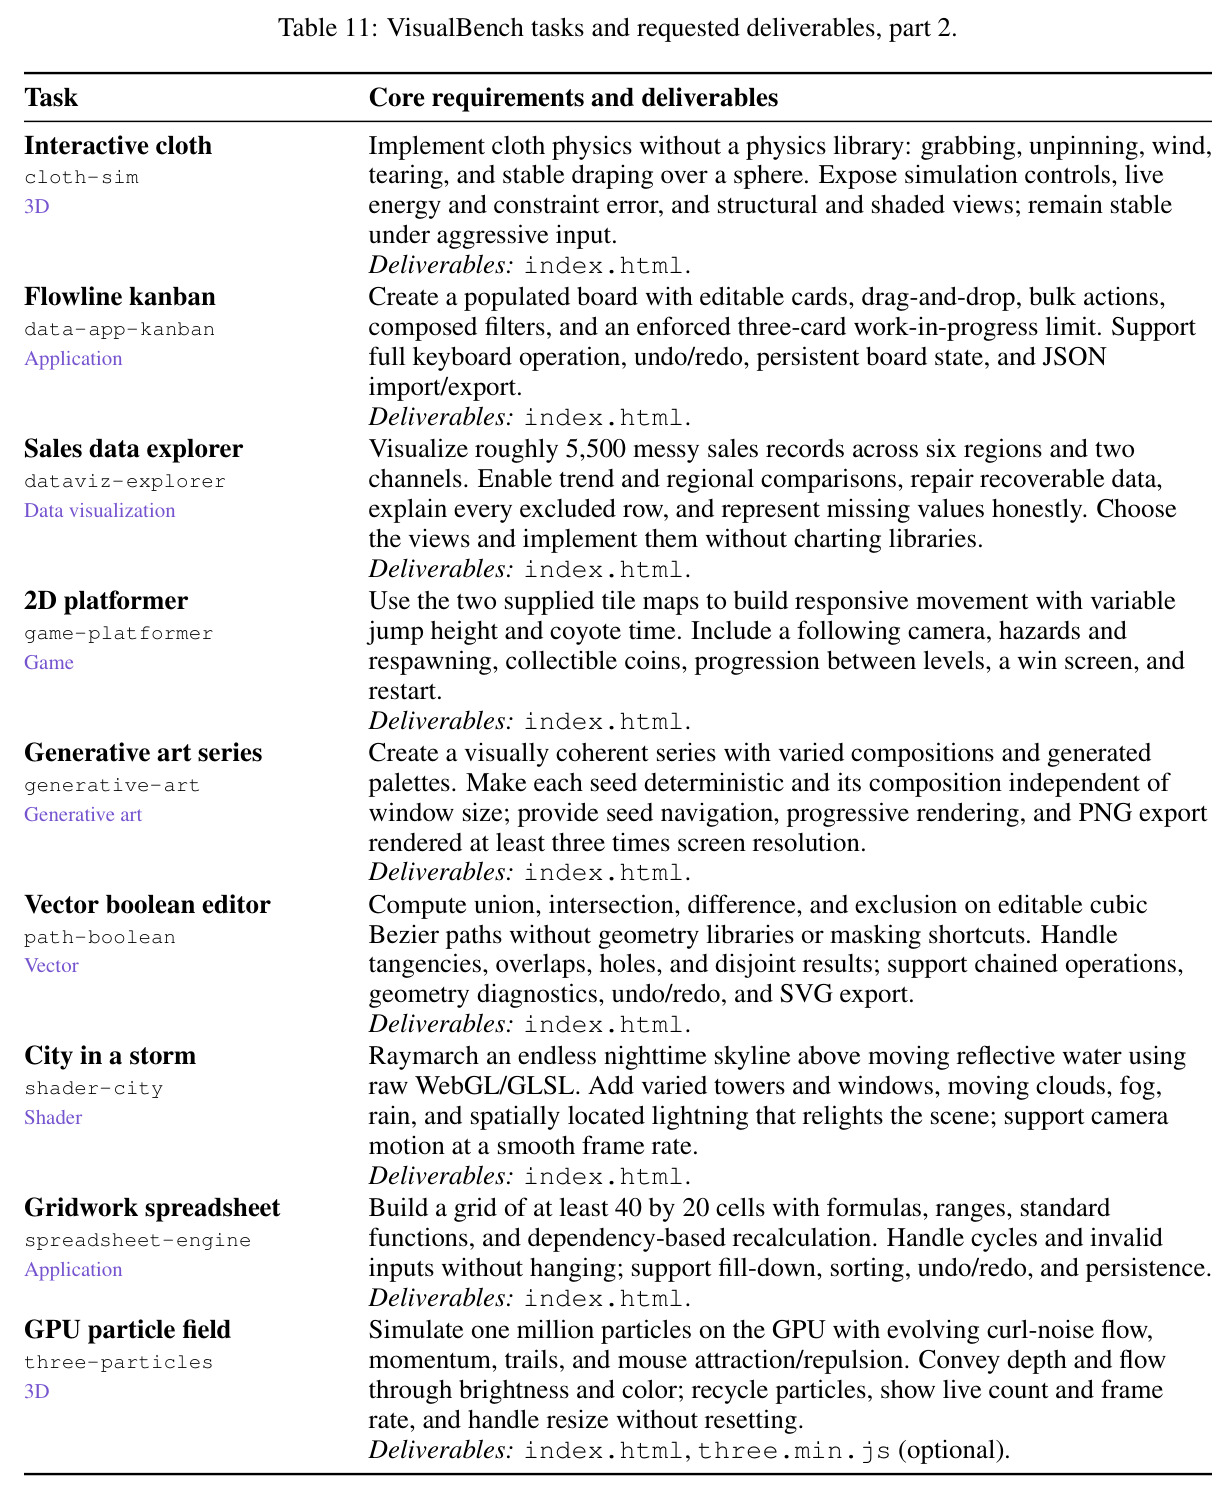
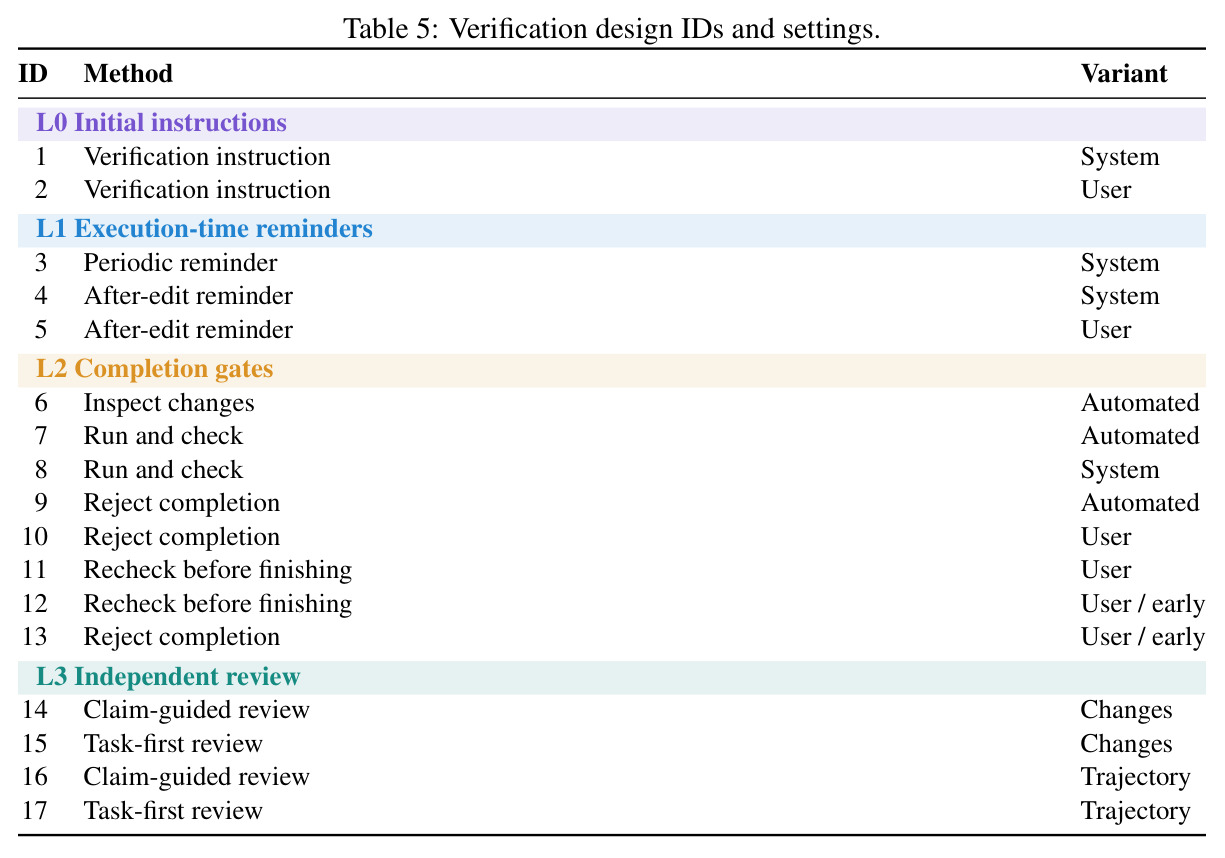
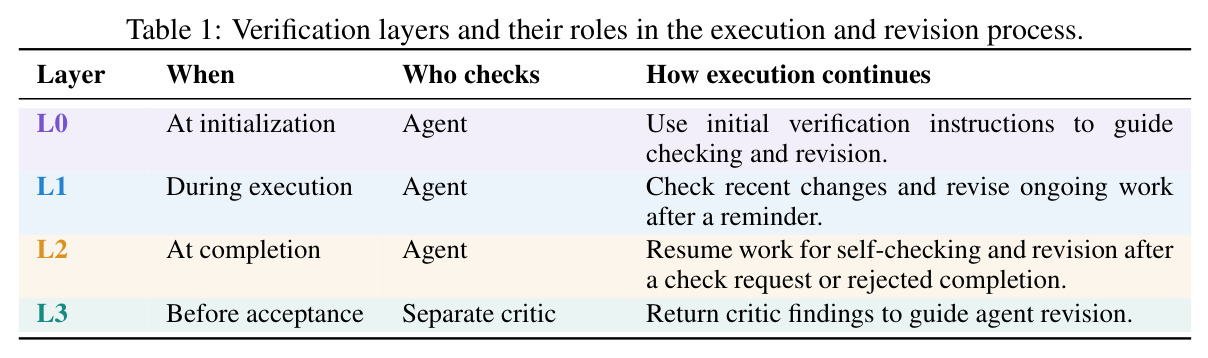
本文的目标是把验证当作 test-time scaling 的一个独立轴来系统研究,而不是继续零散地发明机制。具体目标有三:第一,围绕三个问题组织设计空间——何时介入(when)、谁来检查(who)、检查发现如何导向修订(how),沿 agent 生命周期划分 L0 初始指令、L1 执行时提醒、L2 完成门控、L3 独立审查四层,共 17 种设计;第二,在 7 个前沿编码模型(Qwen3.7-Max、Qwen3.8-Max、GLM-5.2、DeepSeek V4-Pro/Flash、Kimi-K2.7-Code、MiniMax-M2.5)× TB 31 任务 + SWE 30 任务(各 3 次试验)上量化每种设计的准确率增益与成本倍数,另建 18 任务的 VisualBench 用人工盲评覆盖视觉/交互交付物;第三,回答验证强度能否扩展——增加审查轮数(depth)或并行 critic 数量(width)是否持续改善 accuracy-cost 权衡,最终给出可直接落地的工程建议。
与已有工作不同的是,已有工作分散在三个方向:学习型 verifier 给候选解打分选优(Cobbe et al. 2021;Lightman et al. 2023)、自然语言批评驱动的自校正(Self-Refine、Reflexion)、以及把执行证据回喂给模型的工具辅助验证(Self-Debug、CRITIC、测试生成 agent)。这些都是在「机制层」做发明,但 harness 层面的比较研究几乎空白:消息角色(system vs user)、automated 标记的有无、触发时机(编辑后/停止时/停止前)、critic 的上下文构成(只给改动 vs 连轨迹一起给)——这些每个 harness 工程师都在拍脑袋决定的维度,从未被放进统一框架做控制变量消融。本文的独特切入正在于此:固定基线 harness,把验证从「模型能力问题」重新定义为「harness 编排问题」,并用统一的成本计量(含 critic 与修订的美元成本)来评判设计优劣,而不是只报准确率。
核心方法
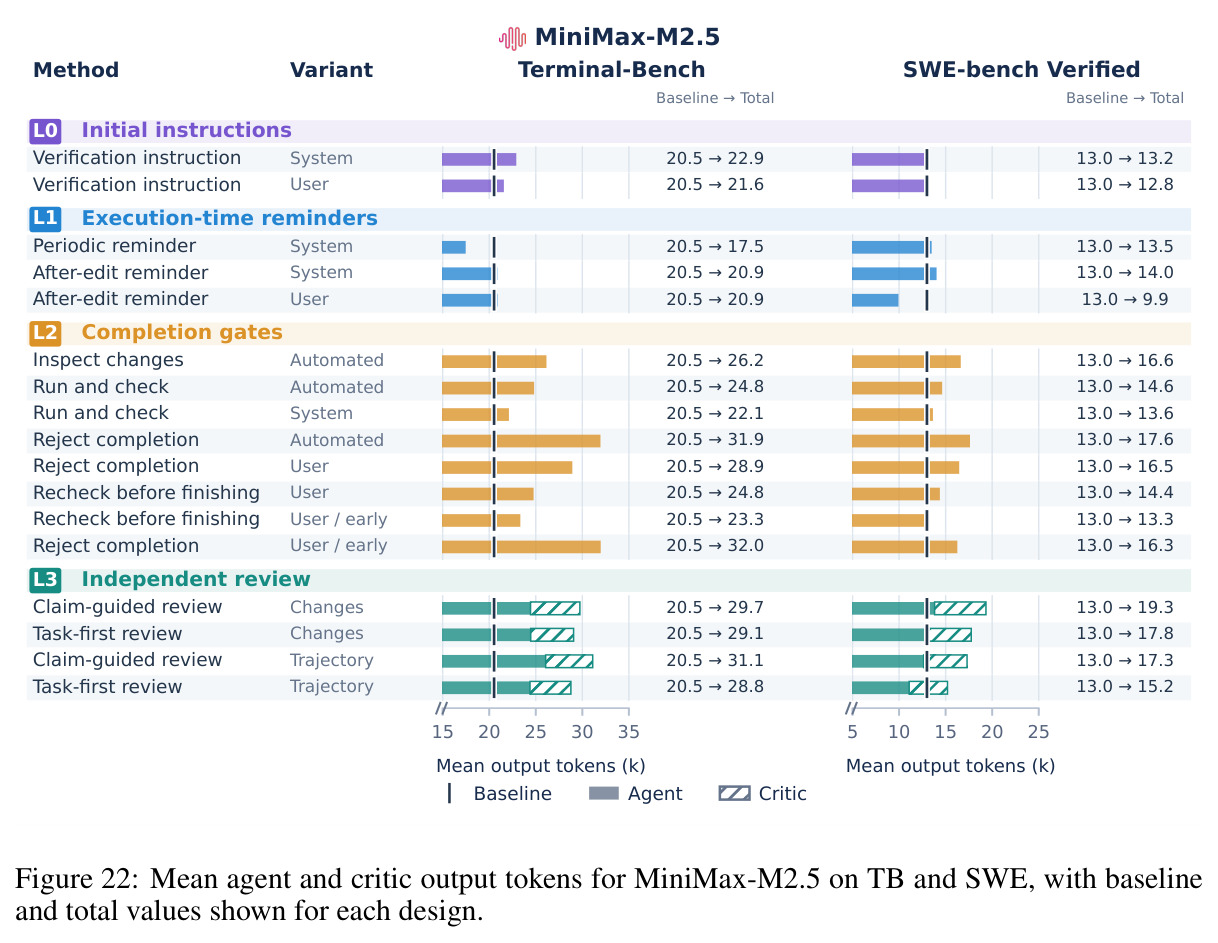
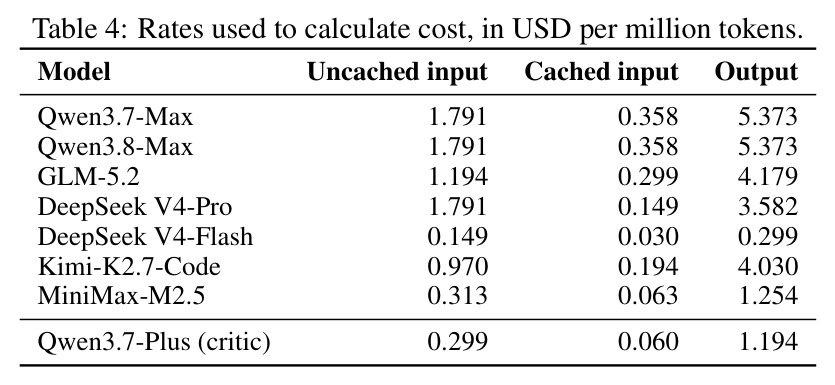
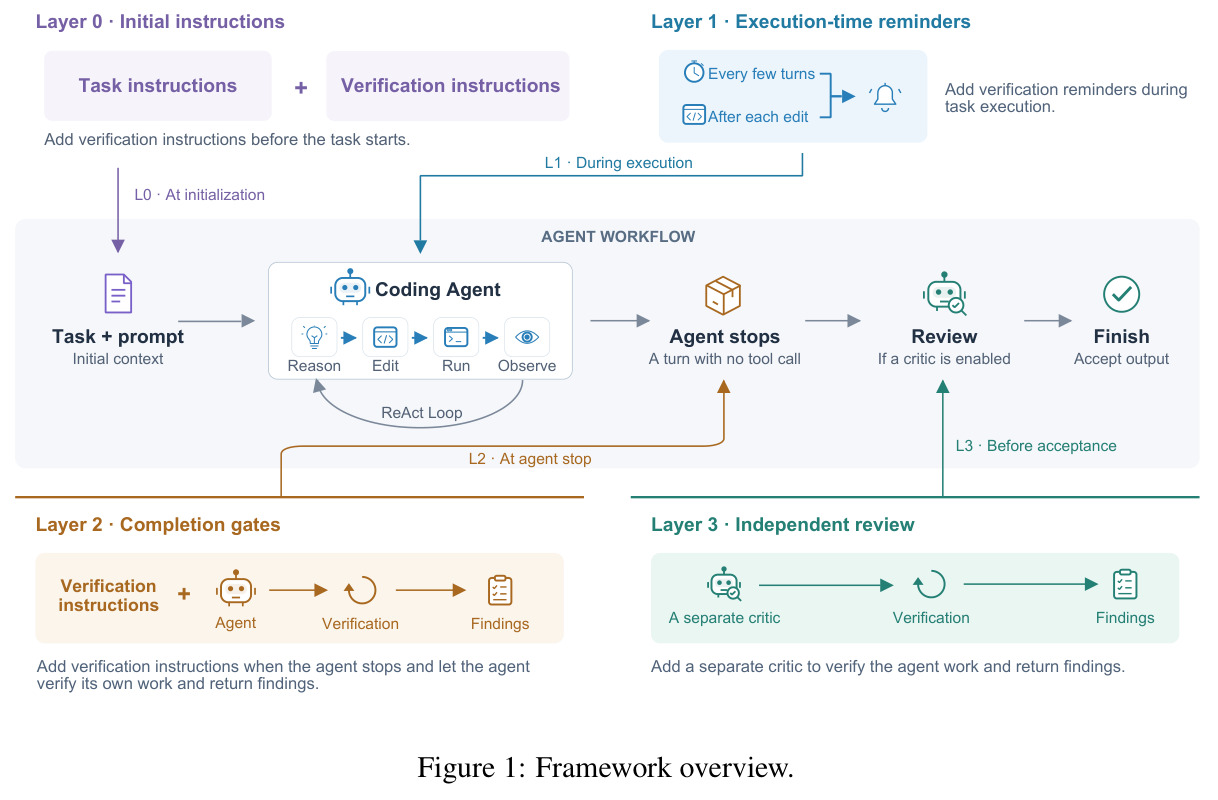
直觉上,让作者检查自己的作业天然受限——他会带着同样的假设重读同样的代码;更有效的做法是引入一个没有历史包袱的独立审查者。技术路线沿 agent 生命周期铺开四个介入层:任务开始前的 L0 初始指令,把验证指引追加进 system 或 user prompt,要求 agent 通过预期接口运行交付物并修复缺陷;执行中的 L1 提醒,在工具结果之后、下一次模型调用之前注入消息,提示检查最近的改动,触发方式有周期性(Periodic)和编辑后(After-edit)两种,消息角色分 system/user 且 user 版本不带 automated 标记;agent 停止时的 L2 完成门控,做检查要求(Inspect changes / Run and check)或直接拒绝完成(Reject completion),并测试提前触发(early)变体;交付前的 L3 独立审查,由一个独立的 critic 模型(Qwen3.7-Plus)在全新上下文中拿到任务规范和只读的 live sandbox,自行运行检查后把 findings 返回给 agent 修订。四层内共 17 种设计,全部在 E2B 云 sandbox + Harbor 编排的统一环境中与无验证基线比较,成本按各模型 API 价格分别计费、包含 critic 审查和 agent 修订。
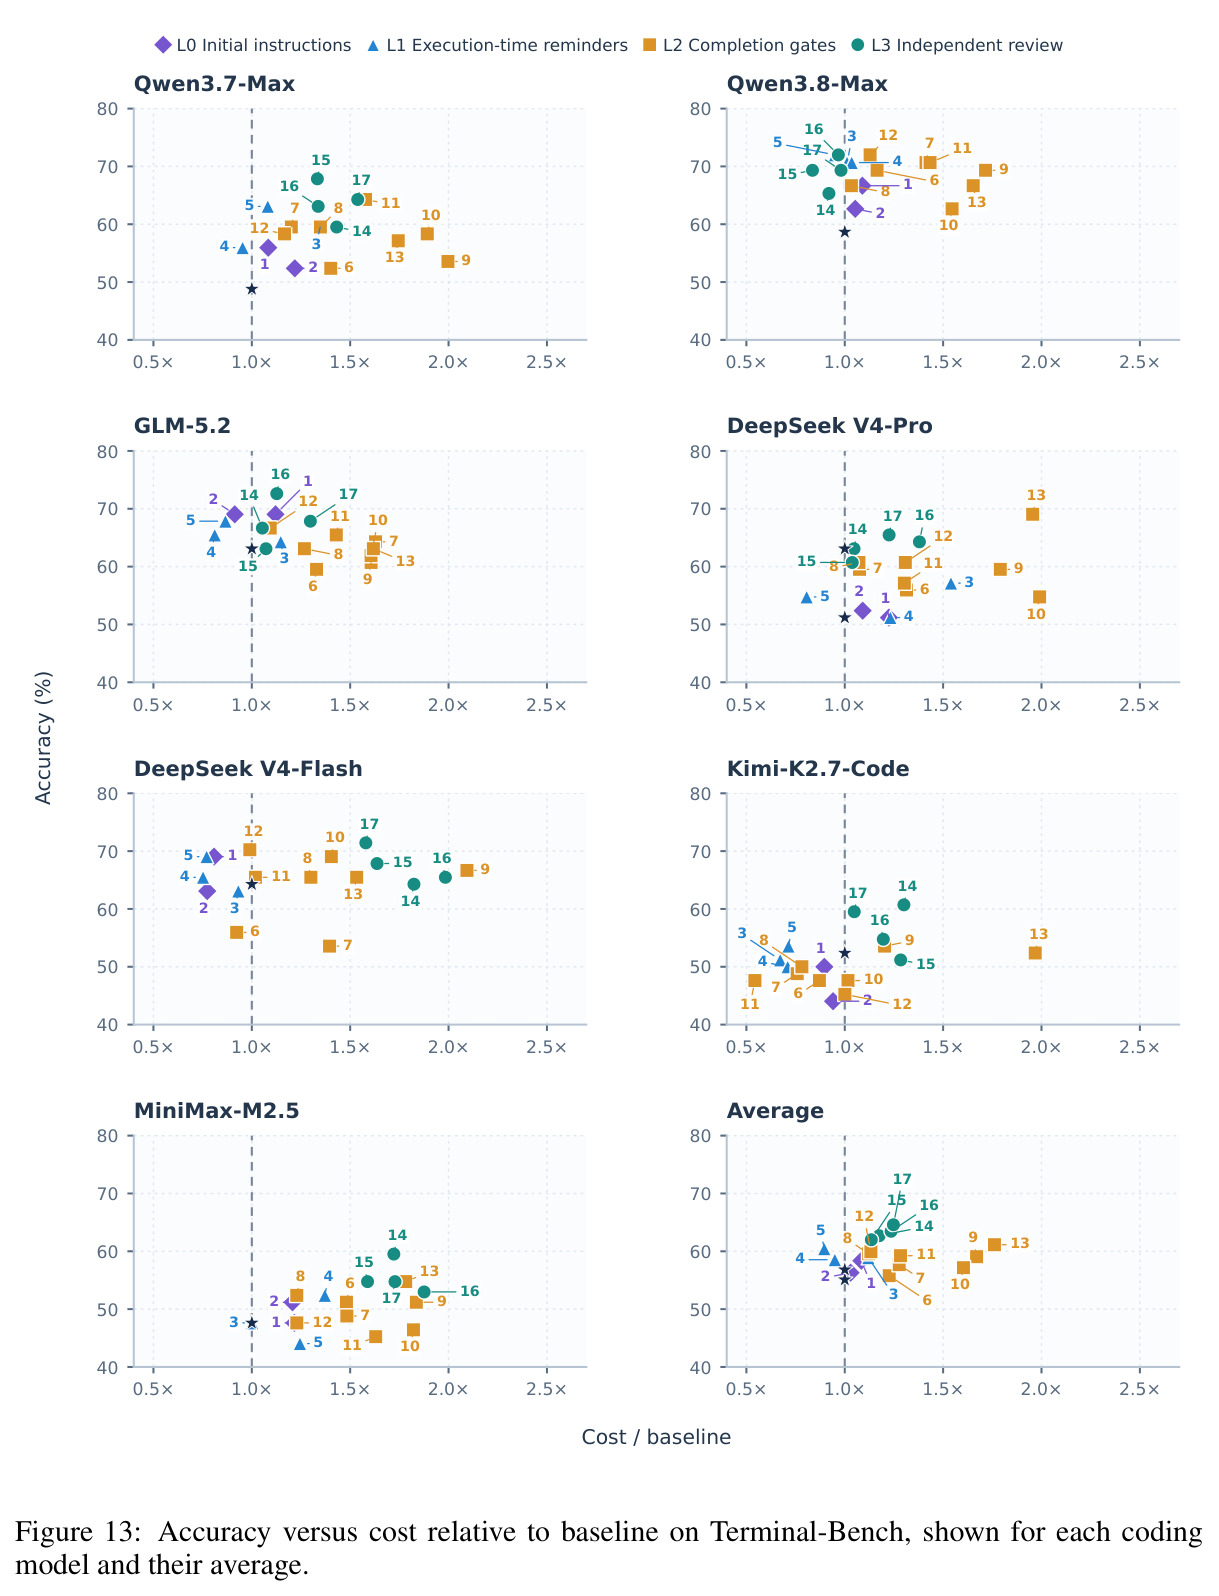
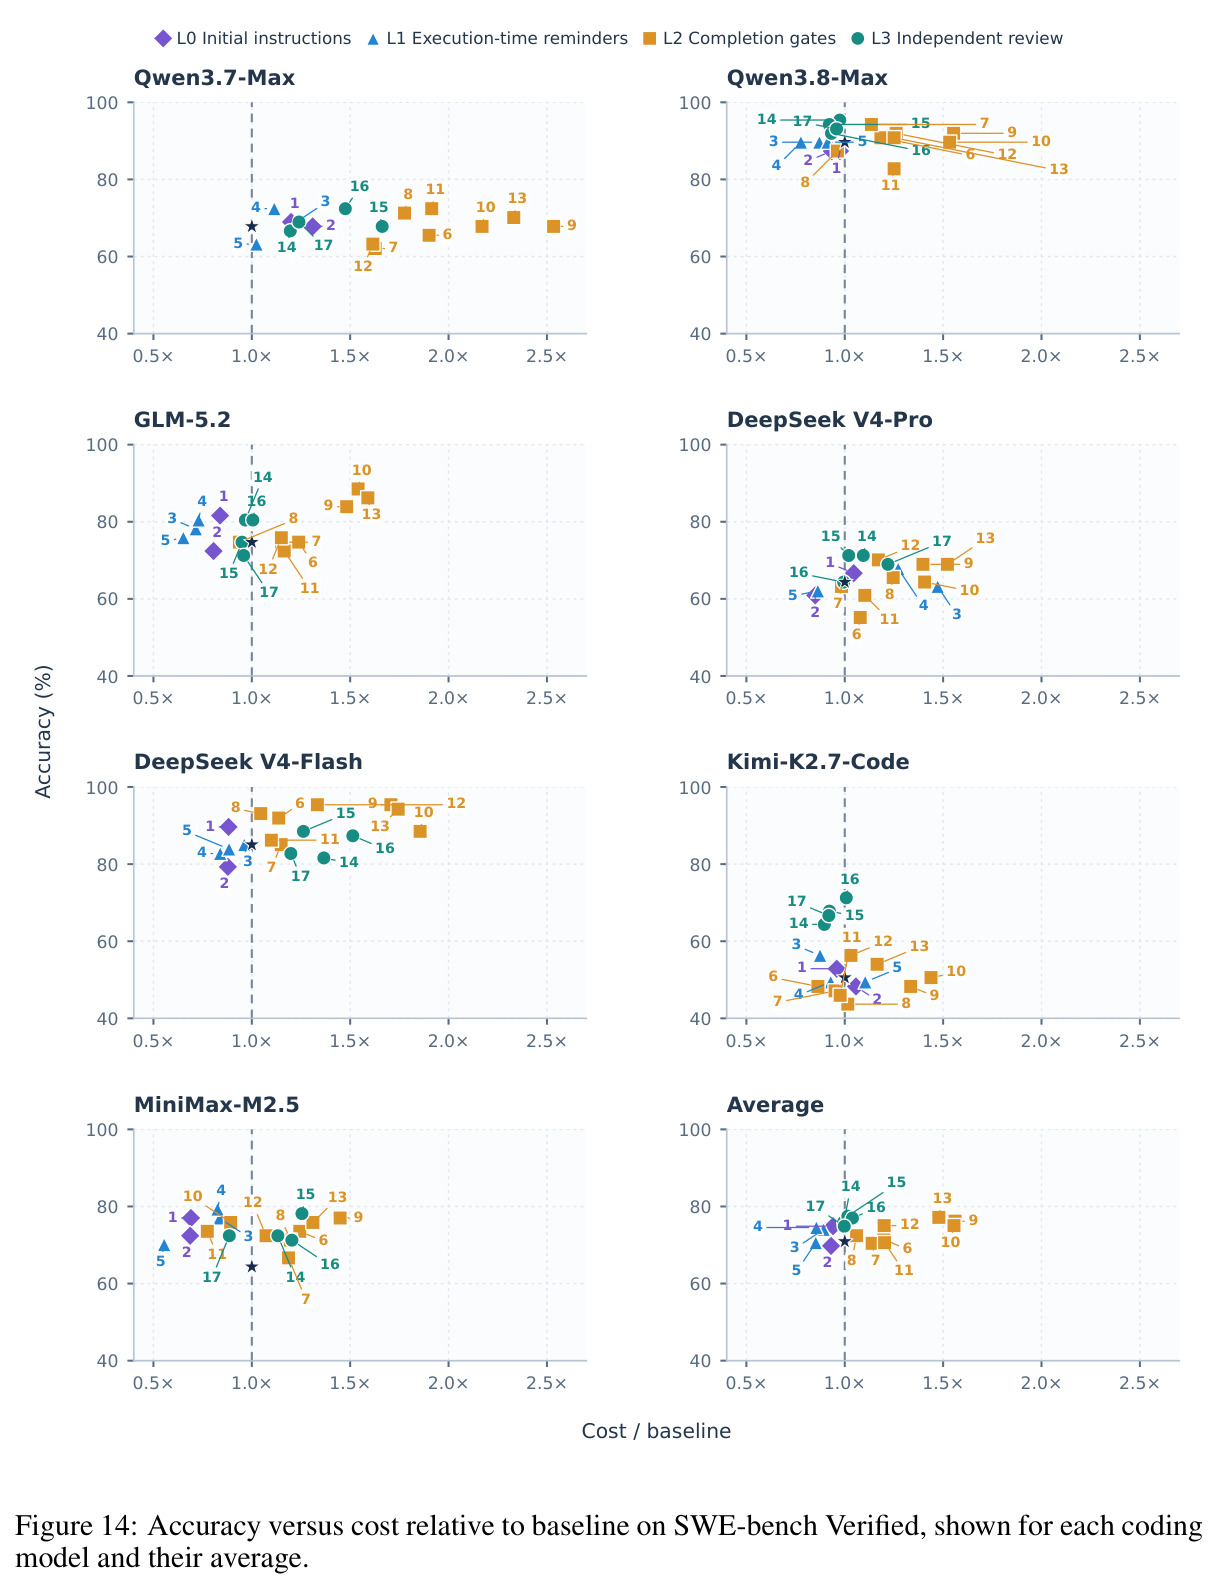
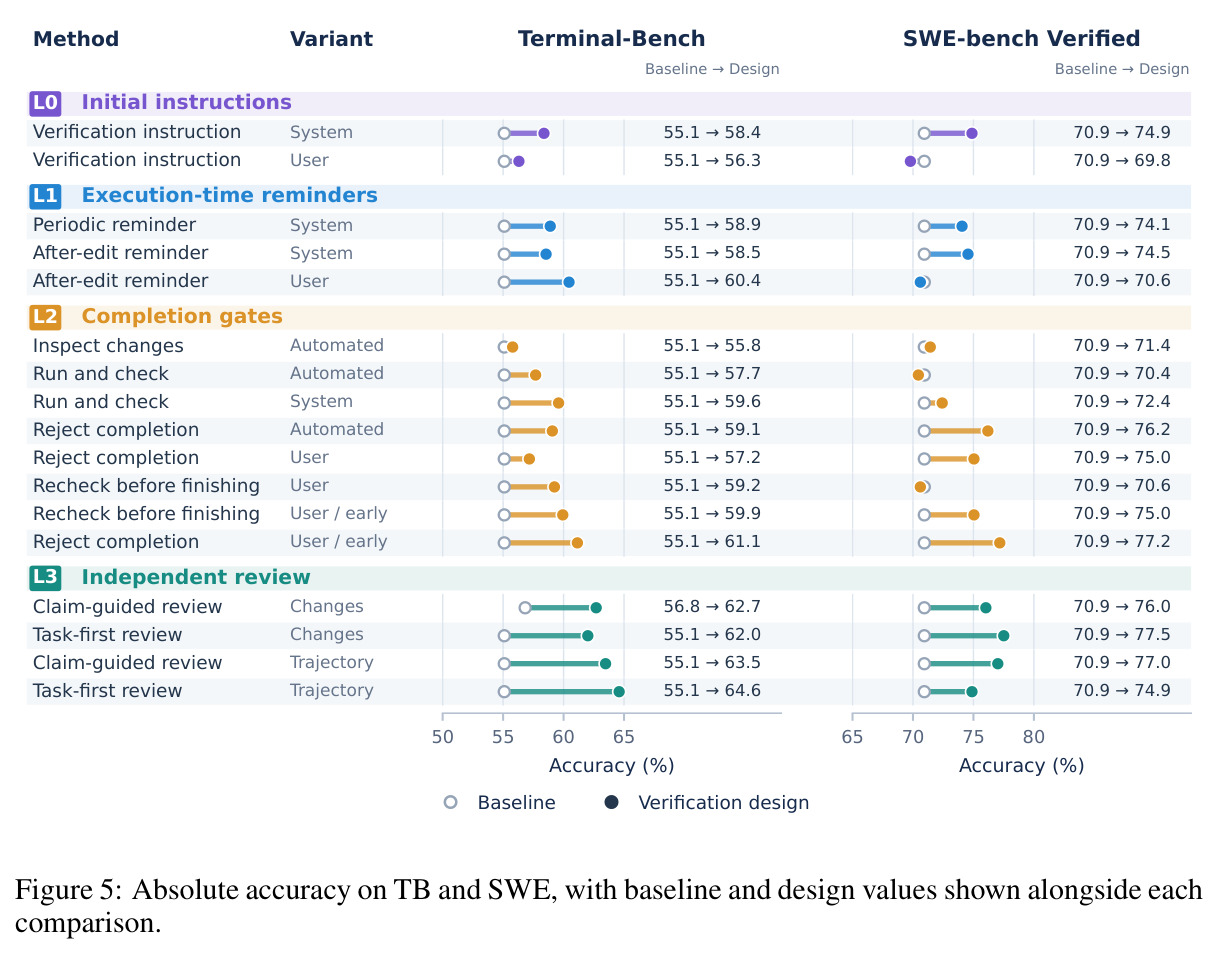
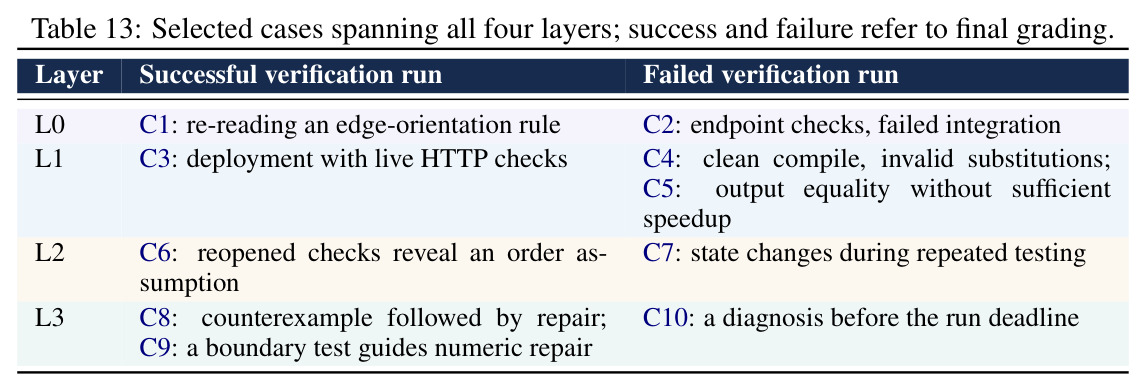
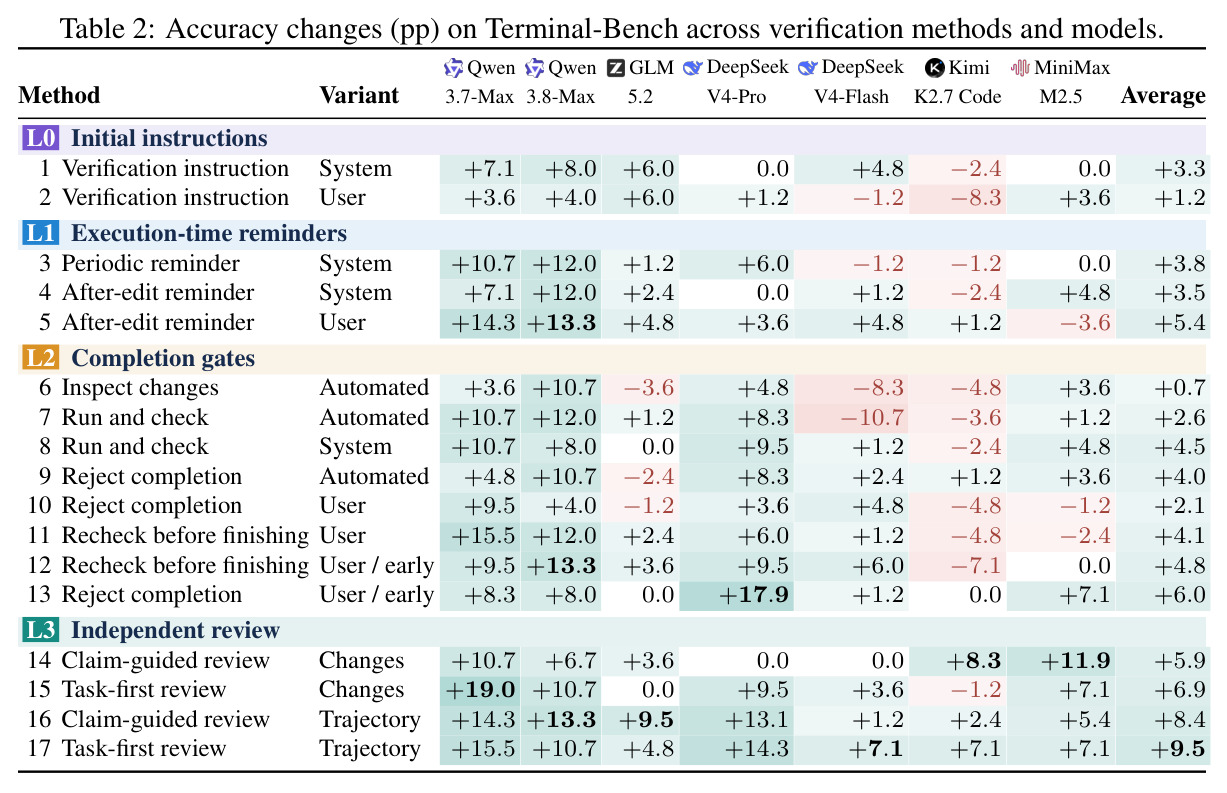
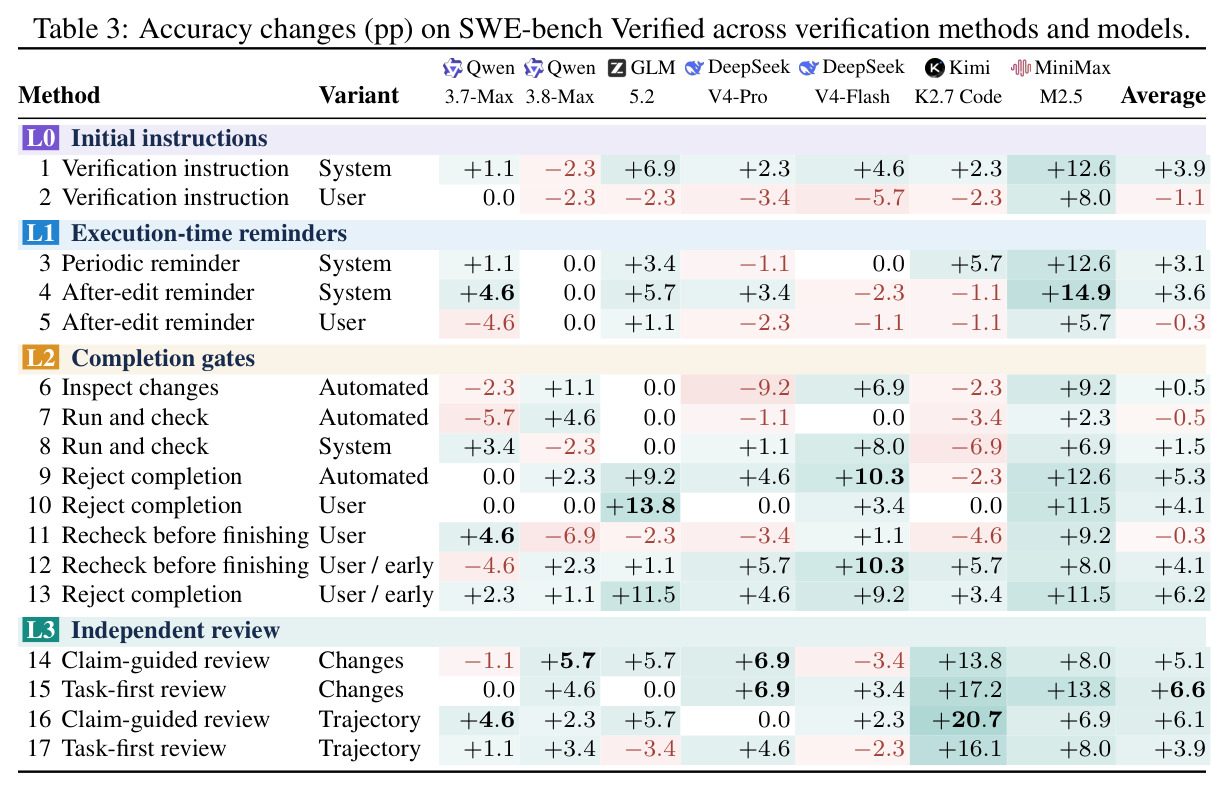
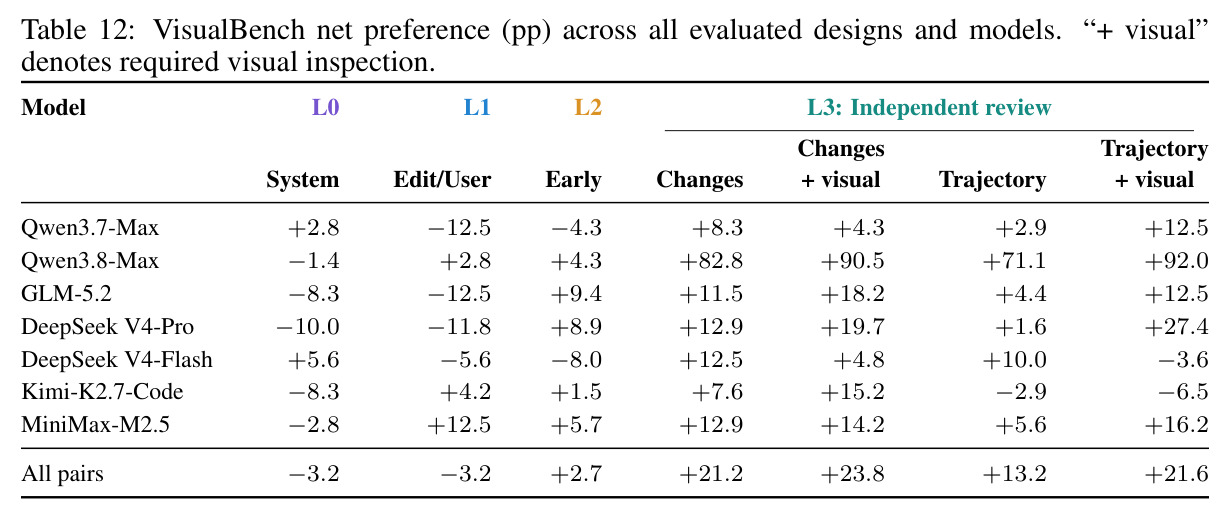
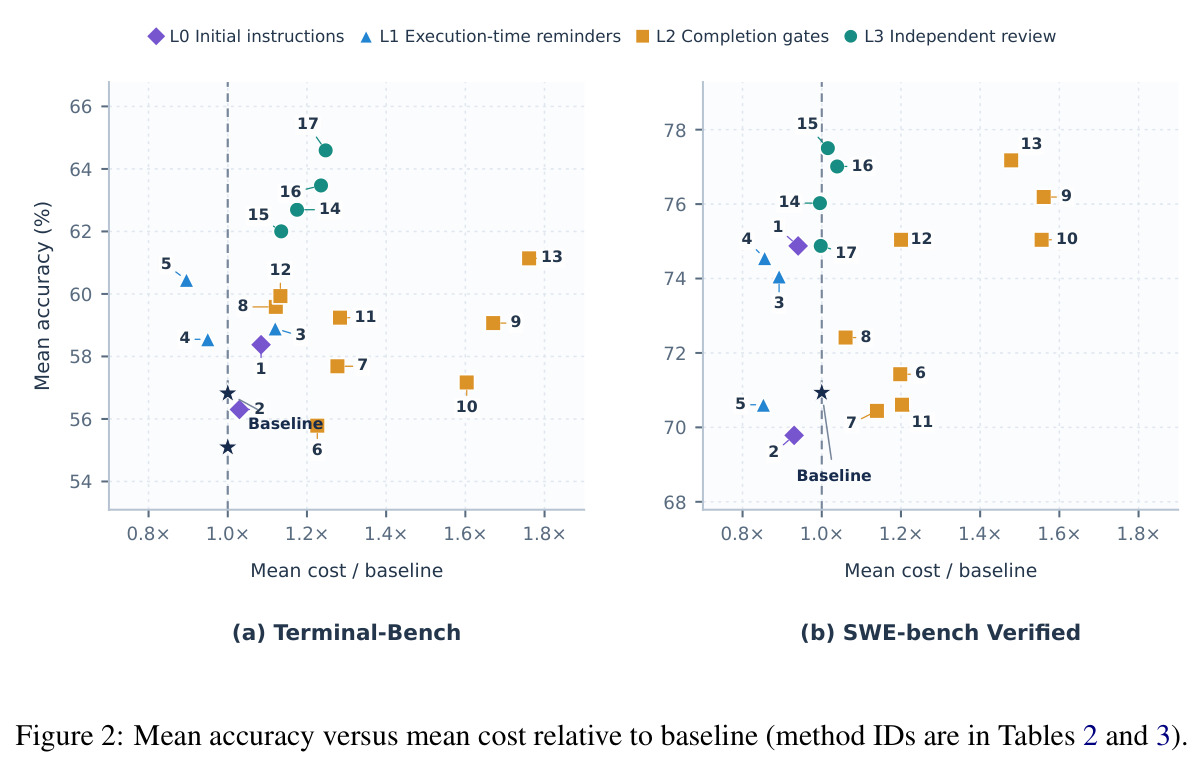
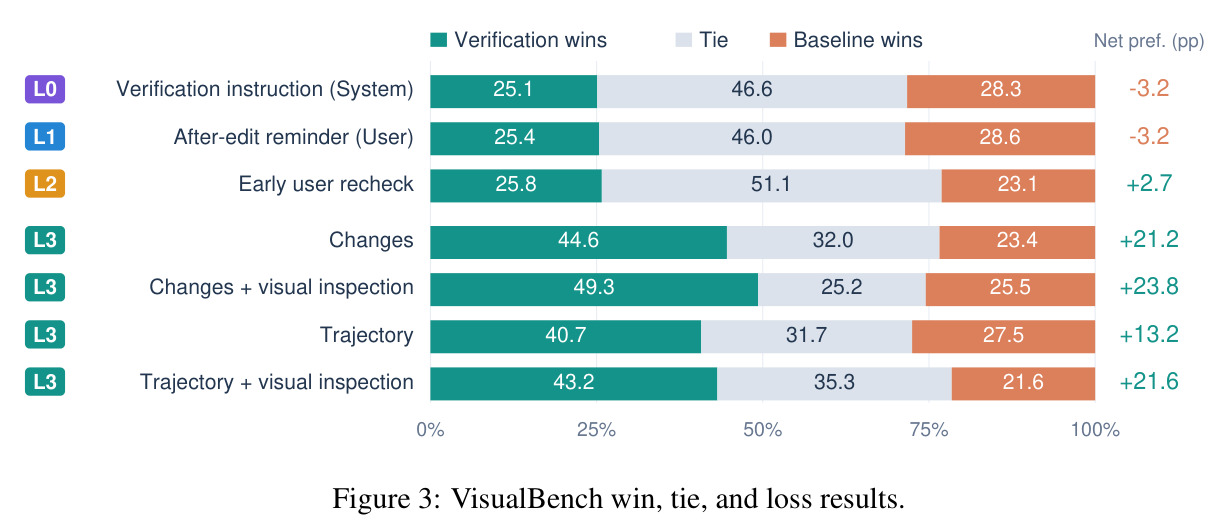
核心创新是把 verification 提升为 harness 设计的一等公民轴,并用大规模控制变量实验证明:检查权外包给 fresh-context 的独立 critic,是 accuracy-cost 最优的 test-time scaling 方式。这与已有方法的本质区别有三点。第一,与 Self-Refine/Reflexion 式的自我批评不同,L3 的 critic 从全新上下文启动,没有 agent 的执行历史和自我辩解,只拿到任务规范加交付物(Changes)或再加执行轨迹(Trajectory),因此能测出 agent 想不到的用例——cobol-modernization 任务中 agent 的实现对合法/非法交易都自测通过,critic 却测了一个算术下溢,发现 Python 写出负号而 COBOL 无符号字段省略了它、破坏记录格式。第二,与需要训练数据的学习型 verifier 不同,L3 直接用现成的廉价模型(critic 输出价 $1.194/M tokens,约为主力模型的四分之一)即插即用。第三,实验揭示了一个此前未被量化的规律:指令和提醒(L0/L1)平均增益小且模型间方差大;完成门控(L2)的拒绝式设计把增益推到 +6.0/+6.2 pp 但成本高达 1.60–1.76 倍;而 L3 以 1.13–1.25 倍成本稳定换得 TB +5.9~+9.5 pp、SWE +3.9~+6.6 pp,且是唯一在 VisualBench 上全部四个设计都为正(+13.2~+23.8 pp)的层。
方法步骤详情
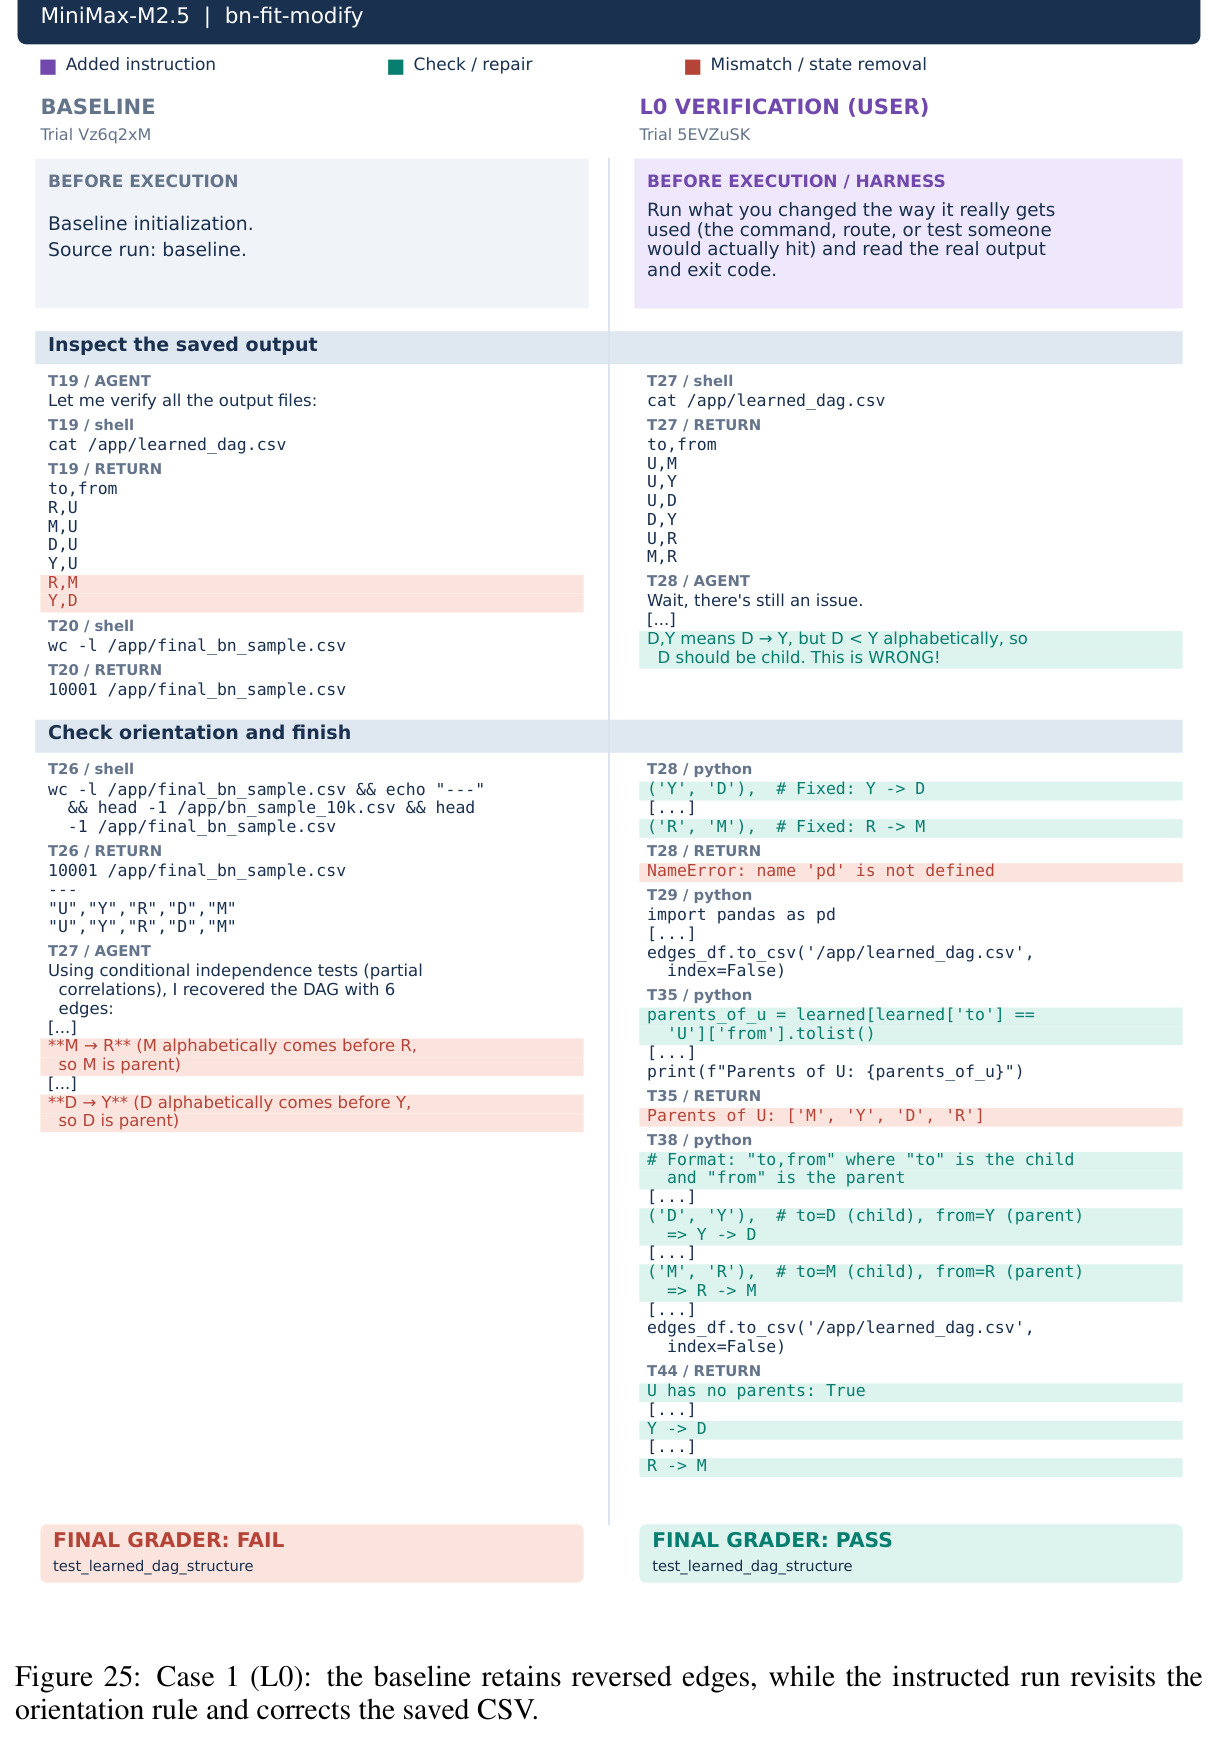
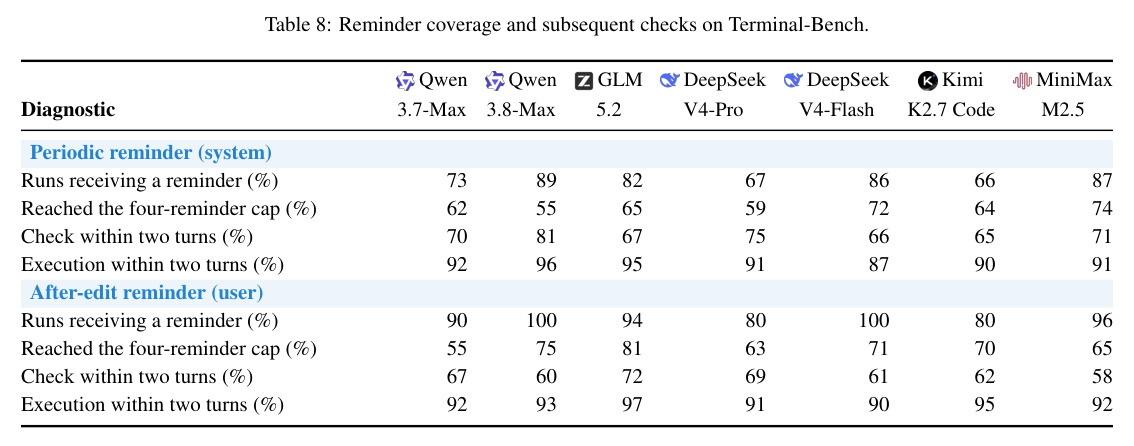
完整流程按介入时机展开。第一步,L0 初始指令:输入是任务 prompt,harness 将验证指令(附录 E.1 给出全文)追加到 system prompt(System 变体)或用户请求(User 变体),输出是带验证指引的初始上下文;指令要求通过预期接口运行交付物、检查输出、修复缺陷,视觉任务还要求渲染并操作核心交互。第二步,L1 执行时提醒:当检测到文件修改 turn(After-edit)或每隔数 turn(Periodic),在工具结果之后、下一次模型调用之前插入提醒消息;System 变体带 automated 自检标记,User 变体无标记;诊断显示 after-edit user 提醒覆盖 80–100% 的 run,58–72% 的提醒事件后两 turn 内出现检查或执行。第三步,L2 完成门控:当 agent 产生无工具调用的 turn(或提前触发),harness 注入 Inspect changes、Run and check(system/automated 两种角色)或 Reject completion(要求继续工作),也测了 Recheck before finishing 及其 early 变体;被拒后 agent 重开工作,中位数增加 12–19 步。第四步,L3 独立审查:agent 停止后,Qwen3.7-Plus critic 在 fresh context 中接收任务规范与只读 sandbox 权限,运行自己的检查并把 findings 返回给主 agent 修订;四个变体由两个维度组合——是否以 agent 的假设和声明为线索(Claim-guided vs Task-first)×上下文是否含执行轨迹(Changes vs Trajectory)。第五步,扩展验证强度:depth 方向串行增加审查轮数(1→4 轮),width 方向并行增加独立 critic 数(1→4 个),合并 findings 后统一修订。全部实验 TB/SWE 各 3 trials,VisualBench 2 trials。
技术新颖性
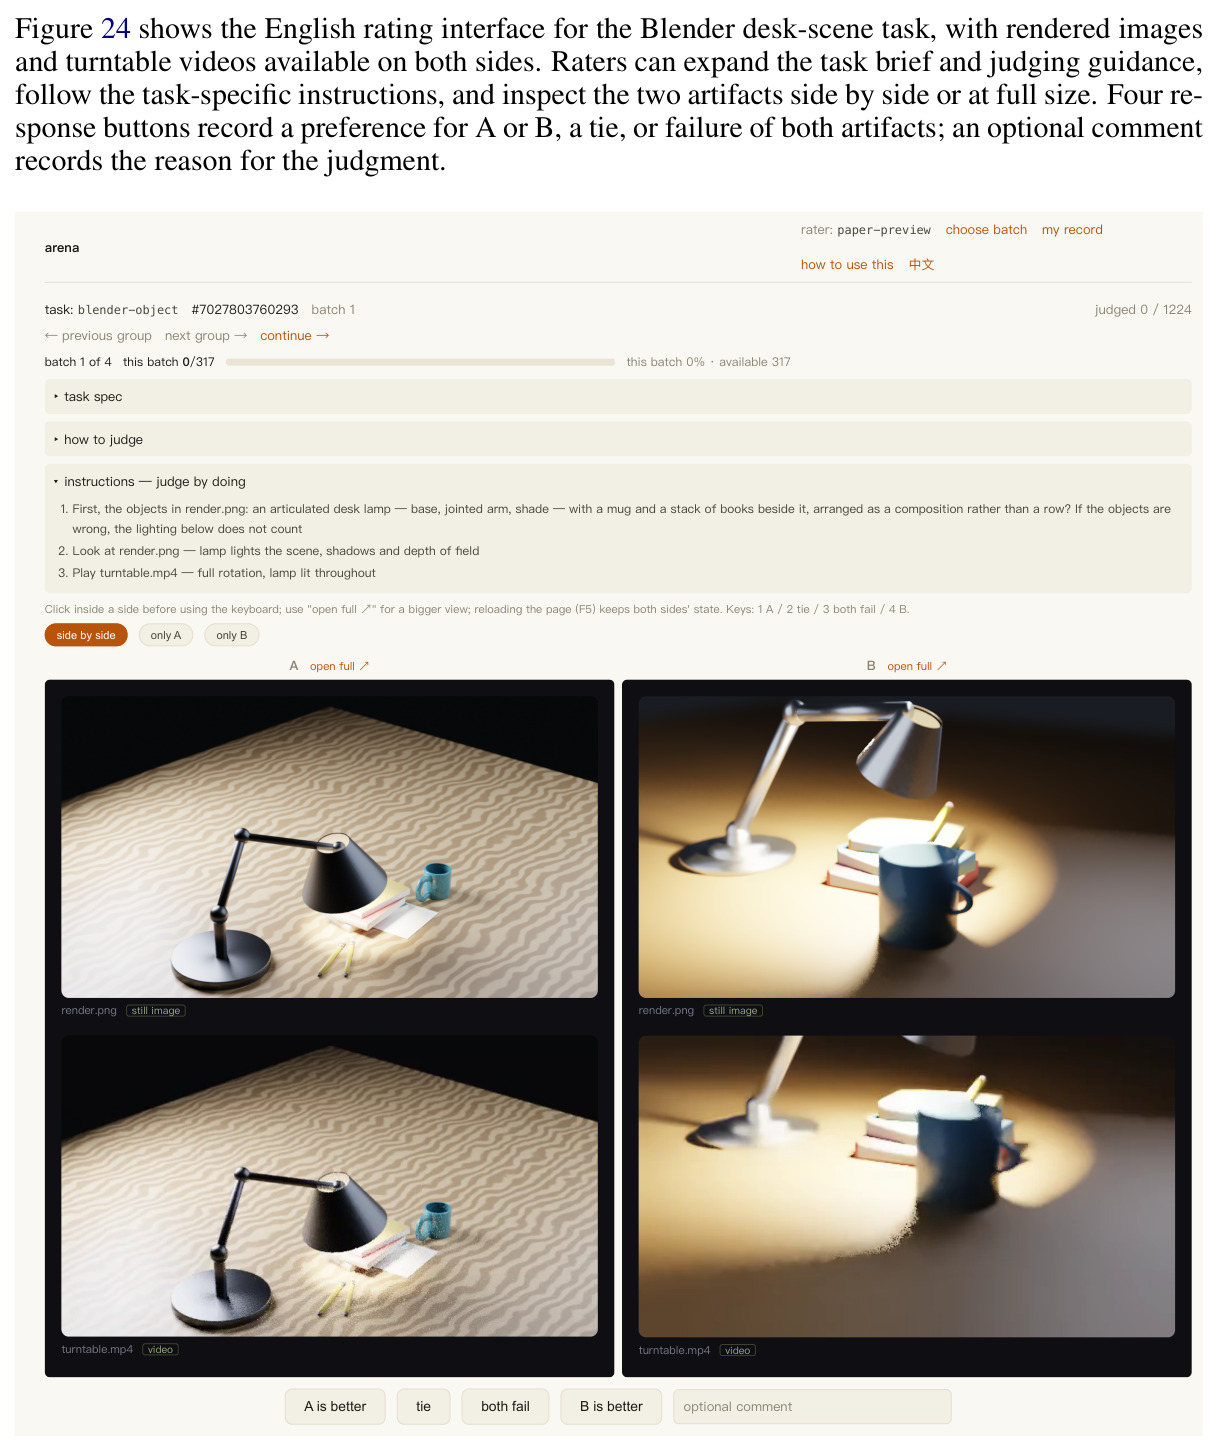
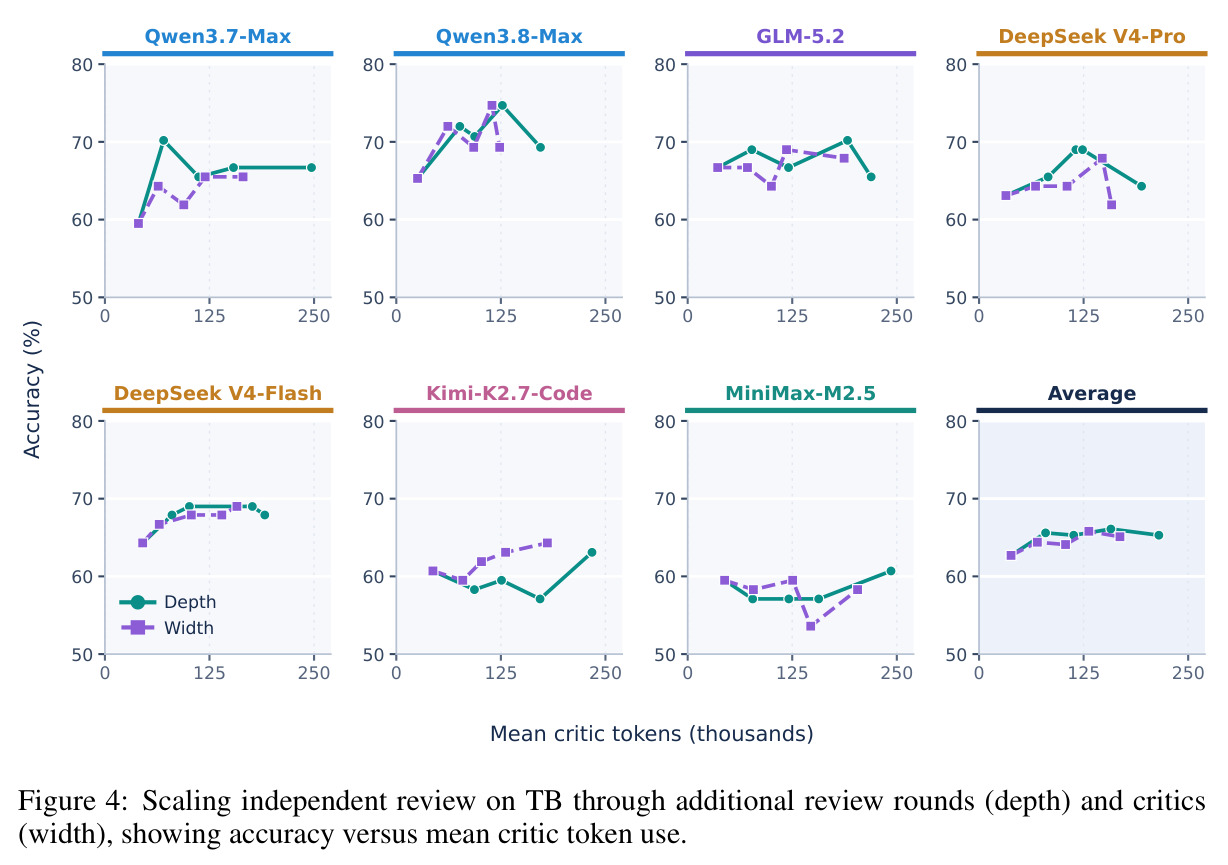
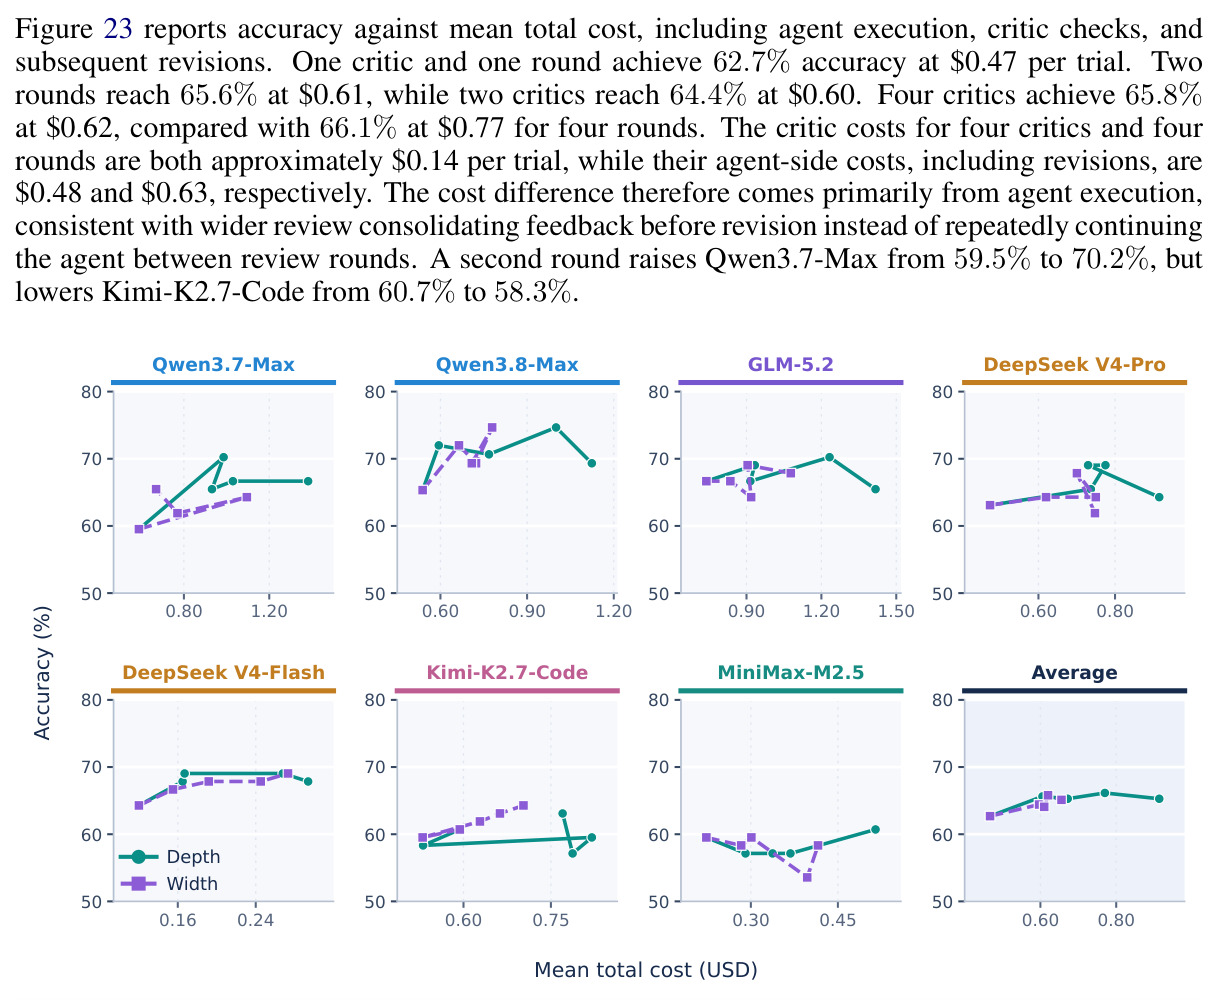
技术新颖性体现在四个层面。其一,框架层面的贡献:首个把验证按生命周期分四层(L0–L3)、并系统消融消息角色、触发时机、上下文内容、automated 标记等维度的 harness 级实证研究——此前这些选择散落在各家产品的工程经验里。其二,发现层面的贡献:Trajectory 上下文反而劣于 Changes(critic 成本高 29–43% 且准确率更低),user rejection 之后 86–96% 的 run 会继续改文件但收益不配成本,输出 token 与准确率可以同向优化(L1 在 TB 上 token 减少 14–25% 的同时平均 +3.5~+5.4 pp)。其三,协议层面的贡献:VisualBench 的盲评协议(条件隐藏、左右随机、win/tie/loss + net preference)为视觉/交互交付物的 agent 评估提供了可复用的模板,弥补自动 grader 的空白。其四,结论层面的贡献:明确支持 width(并行多 critic,4 个 critic 达 65.8%,比单 critic +3.1 pp,总成本仅 1.33 倍且比 4 轮串行便宜 19%)作为扩展方向,因为并行合并反馈能减少主 agent 的重复执行。
实验结果
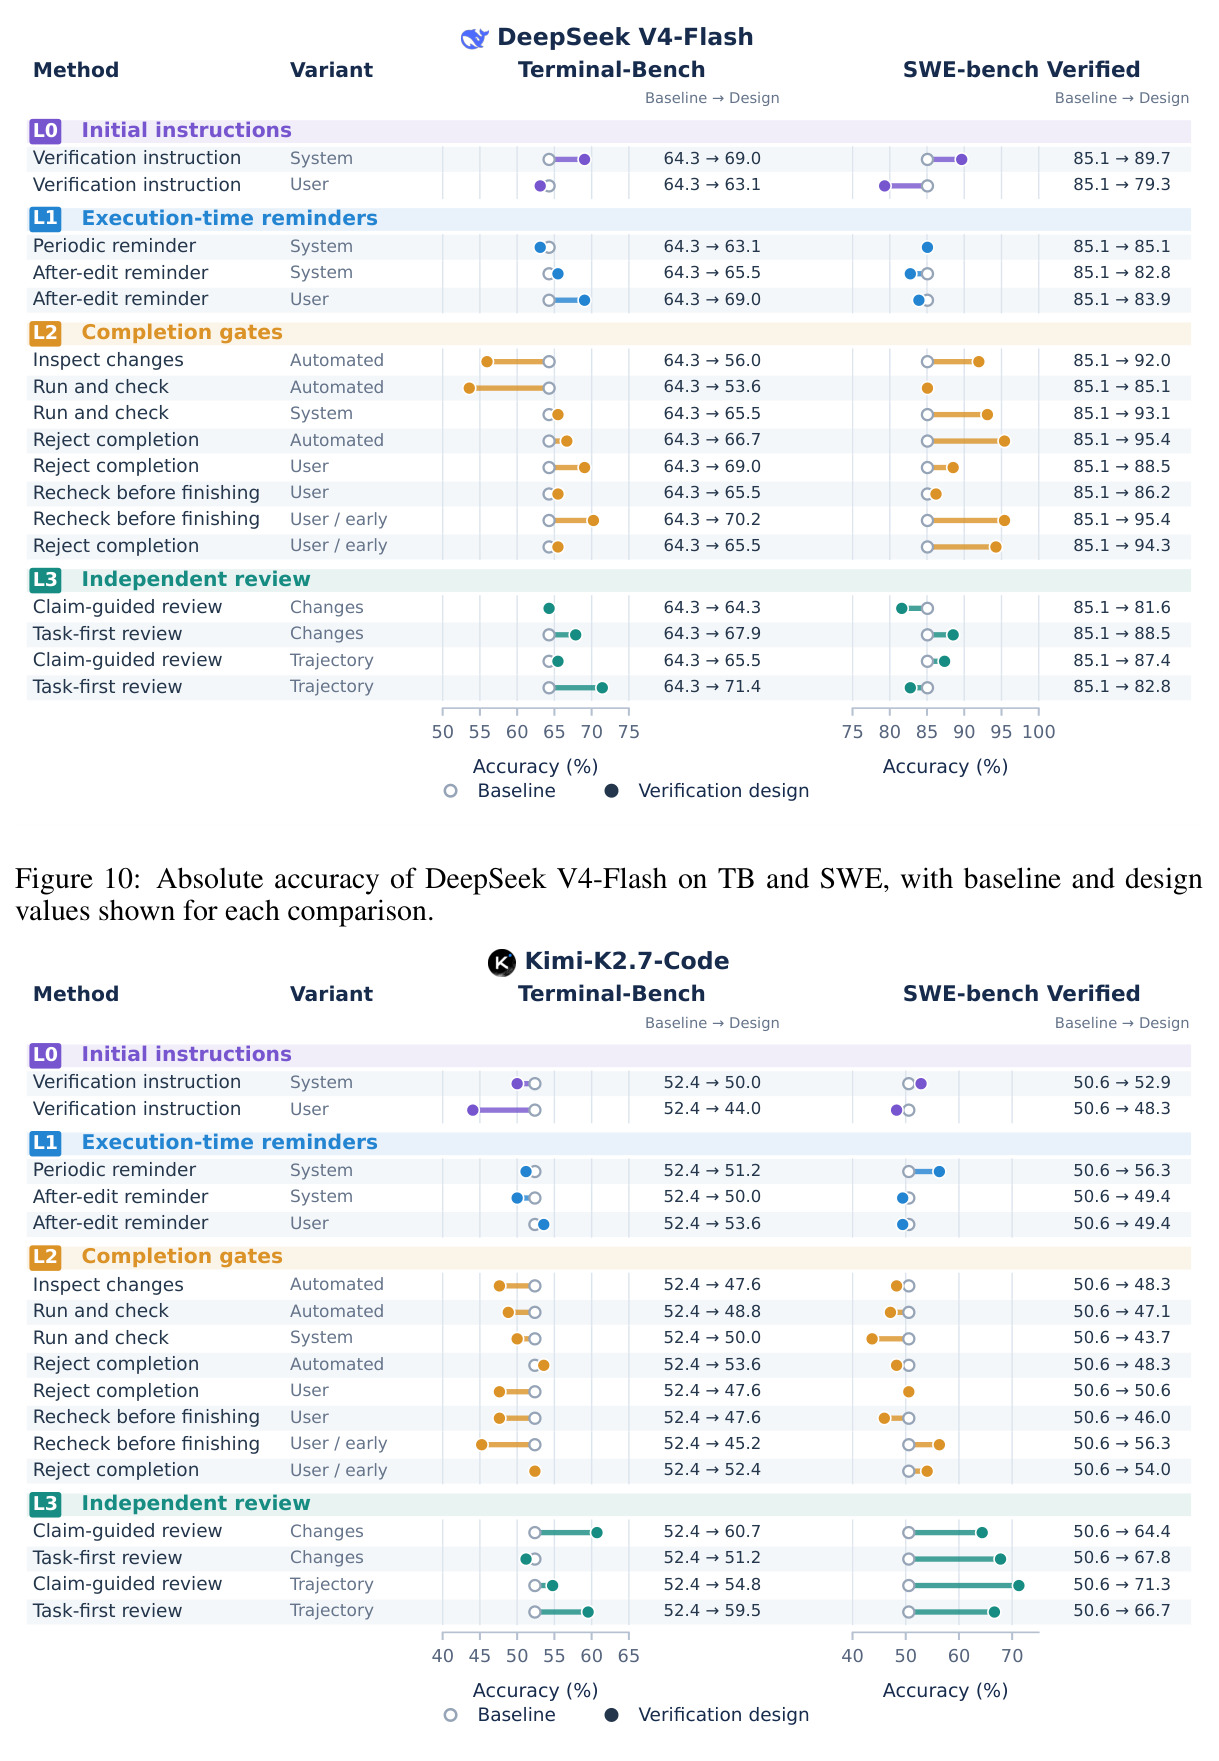
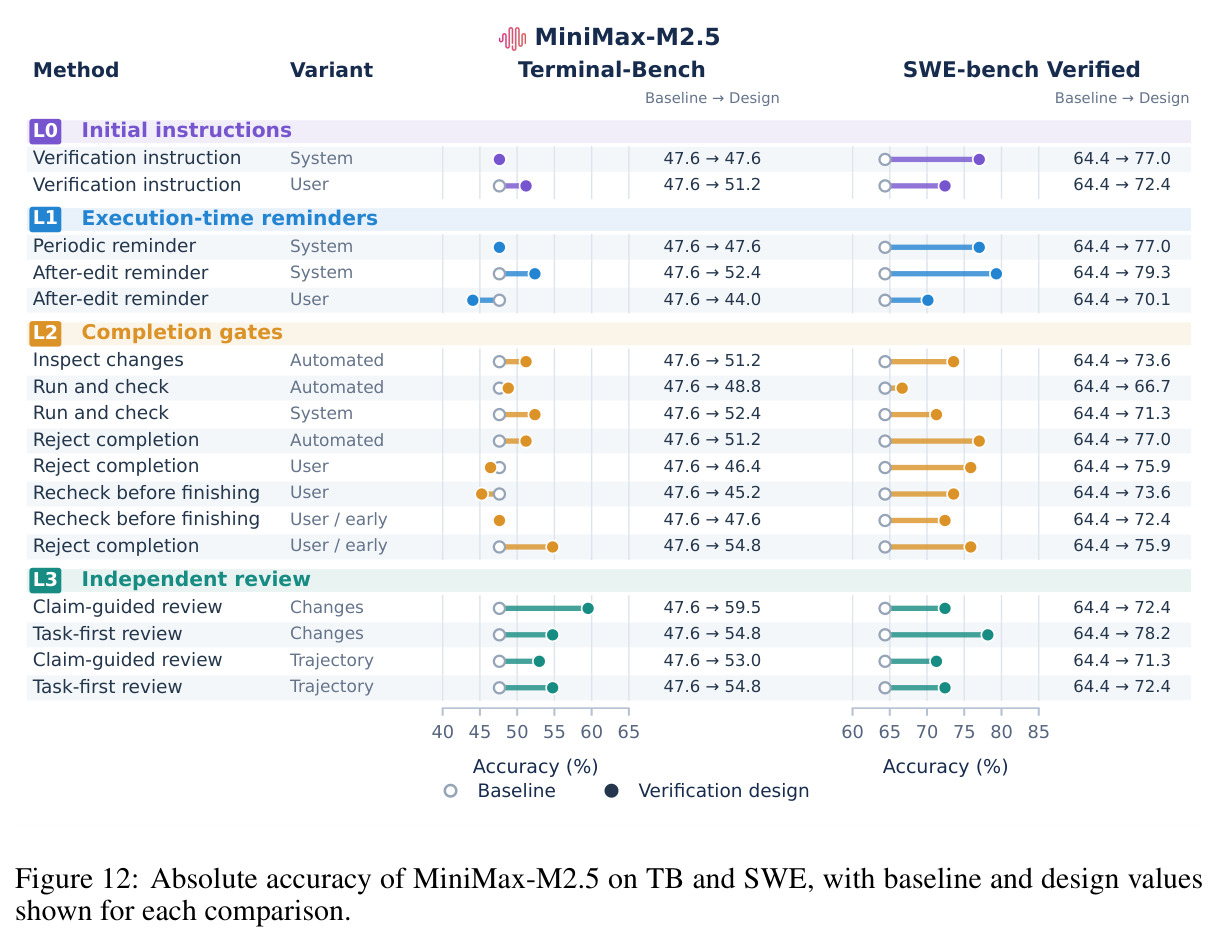
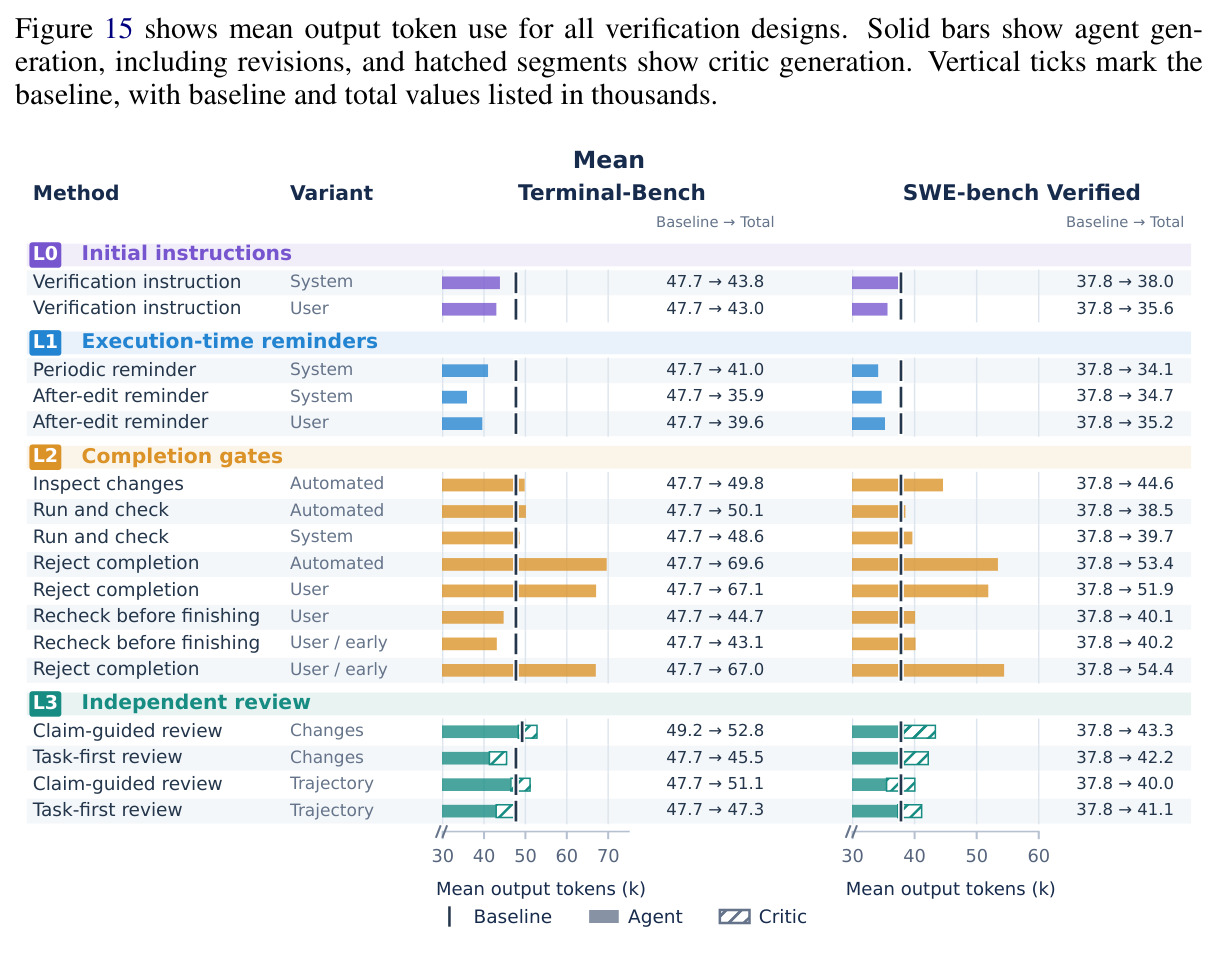
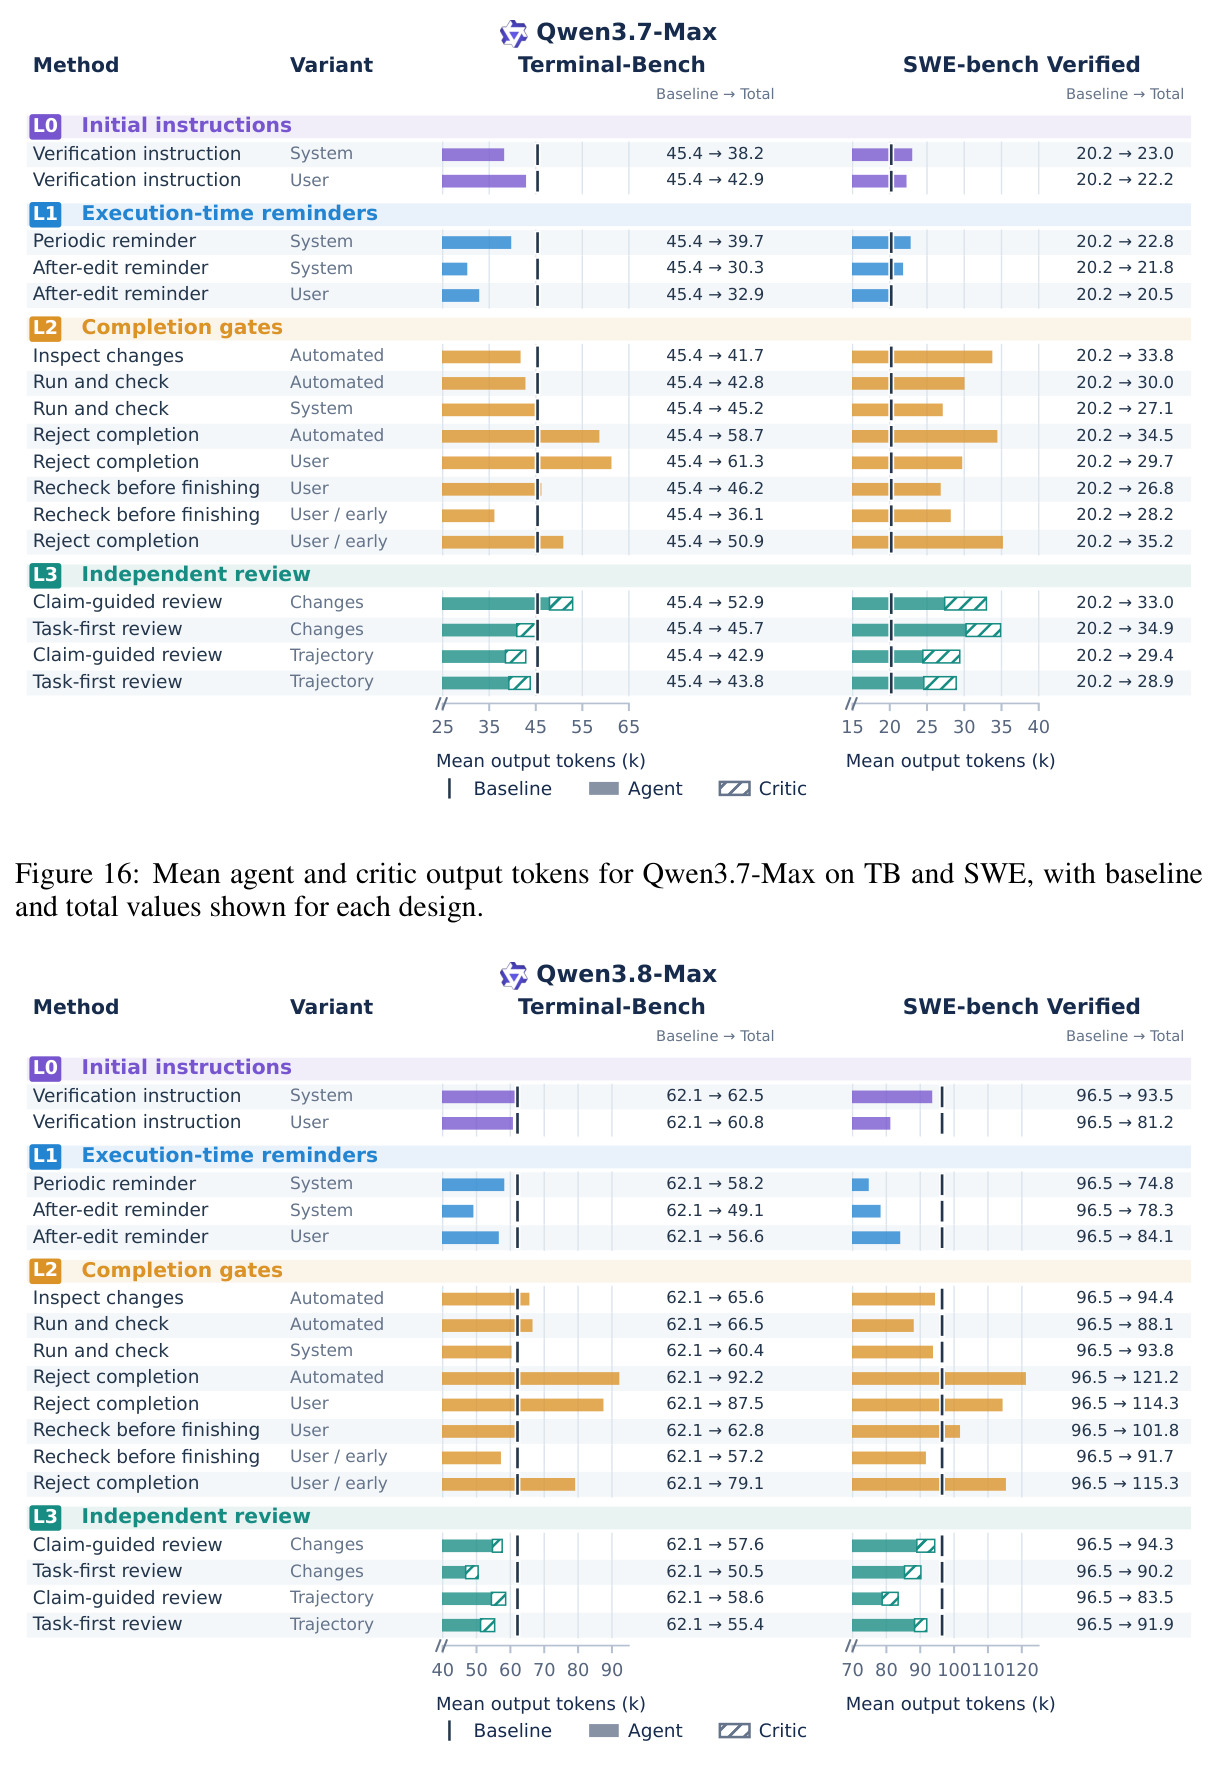
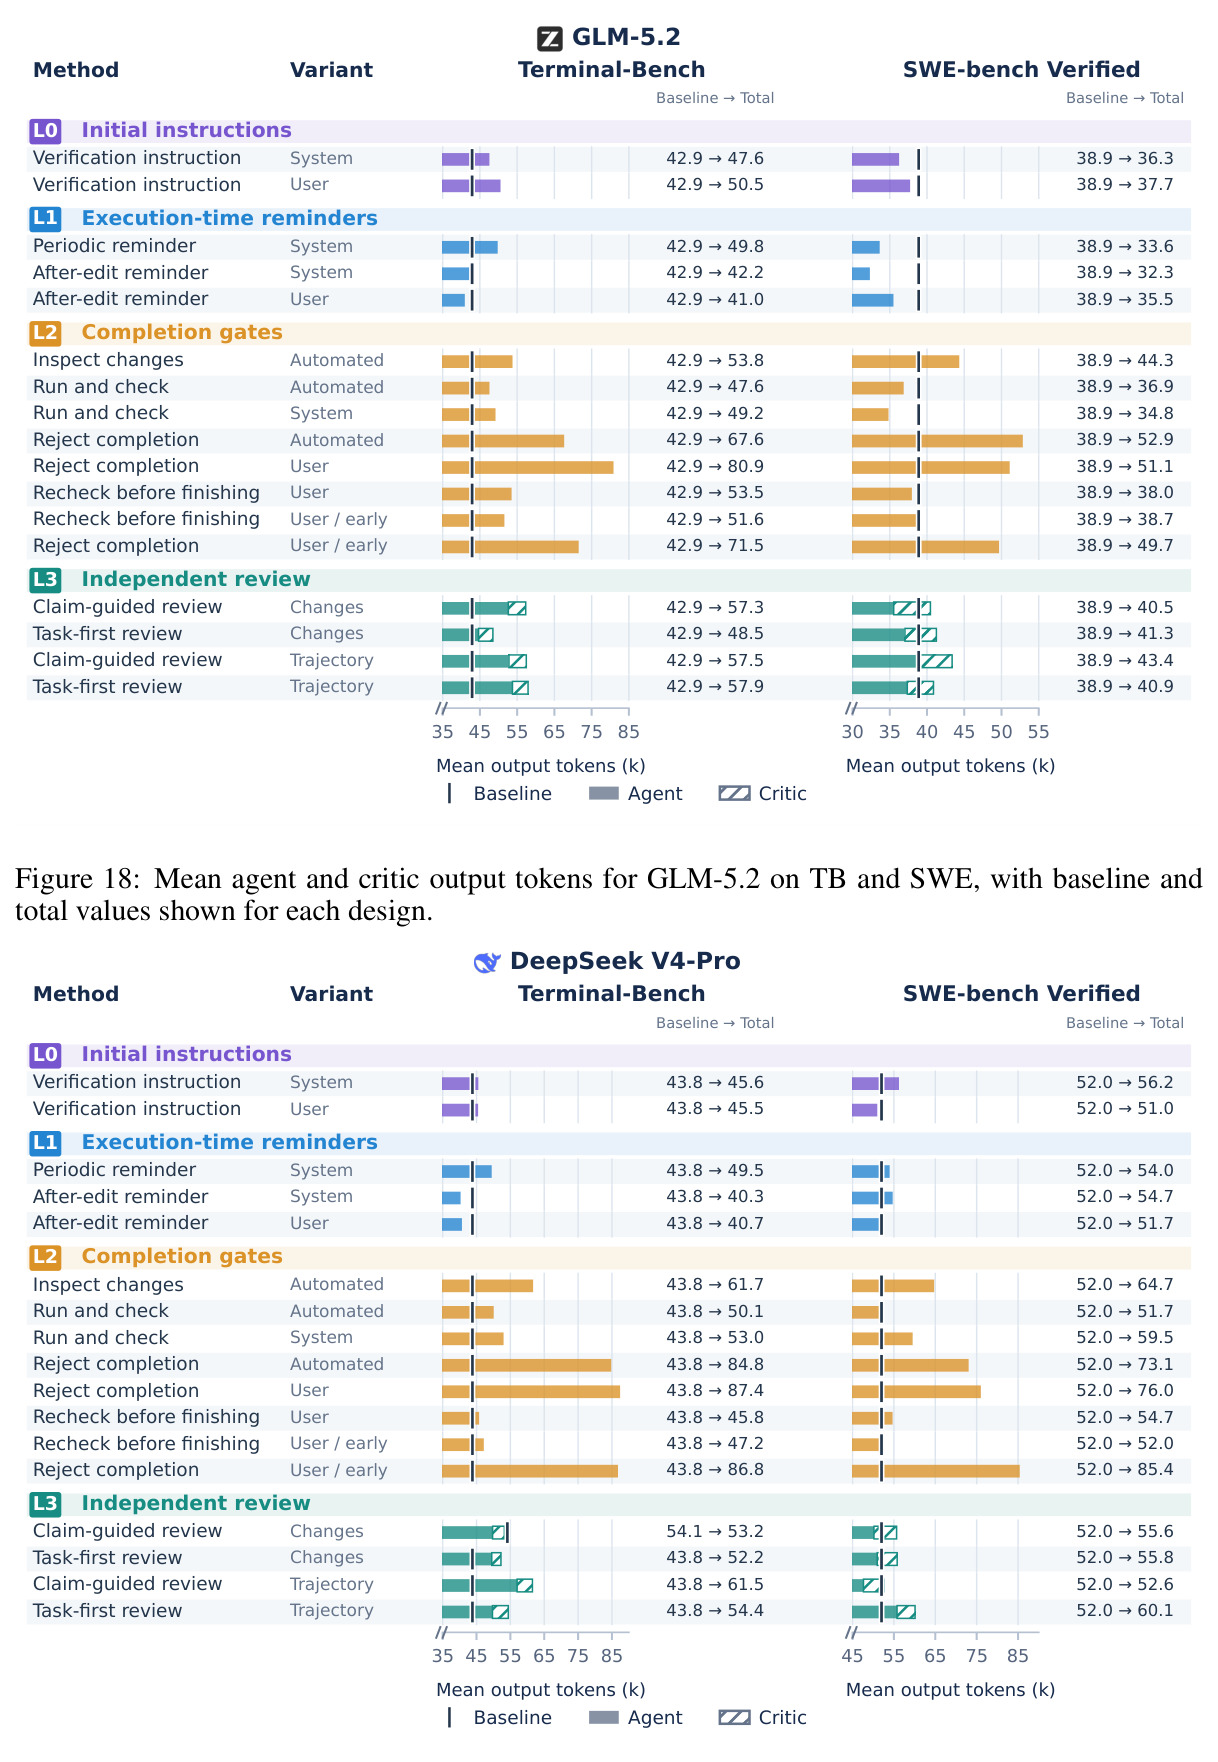
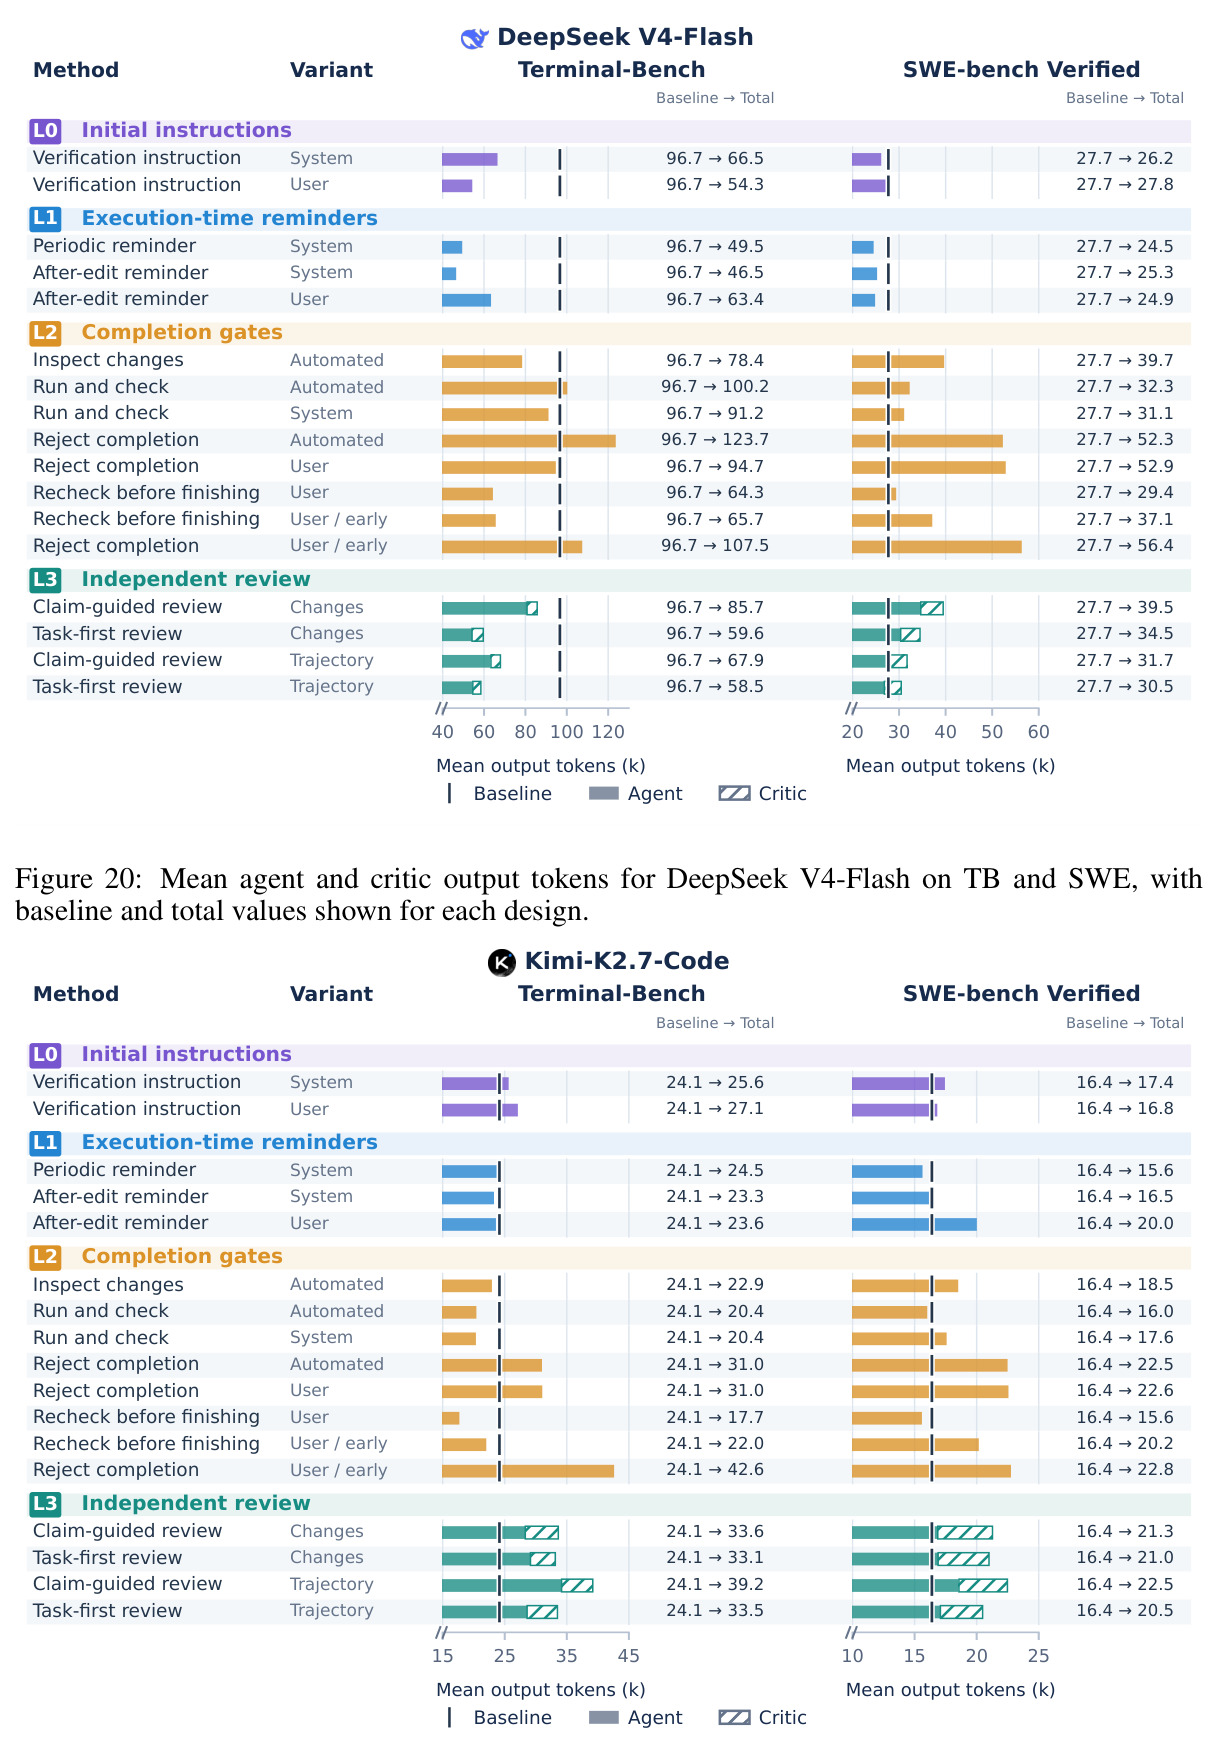
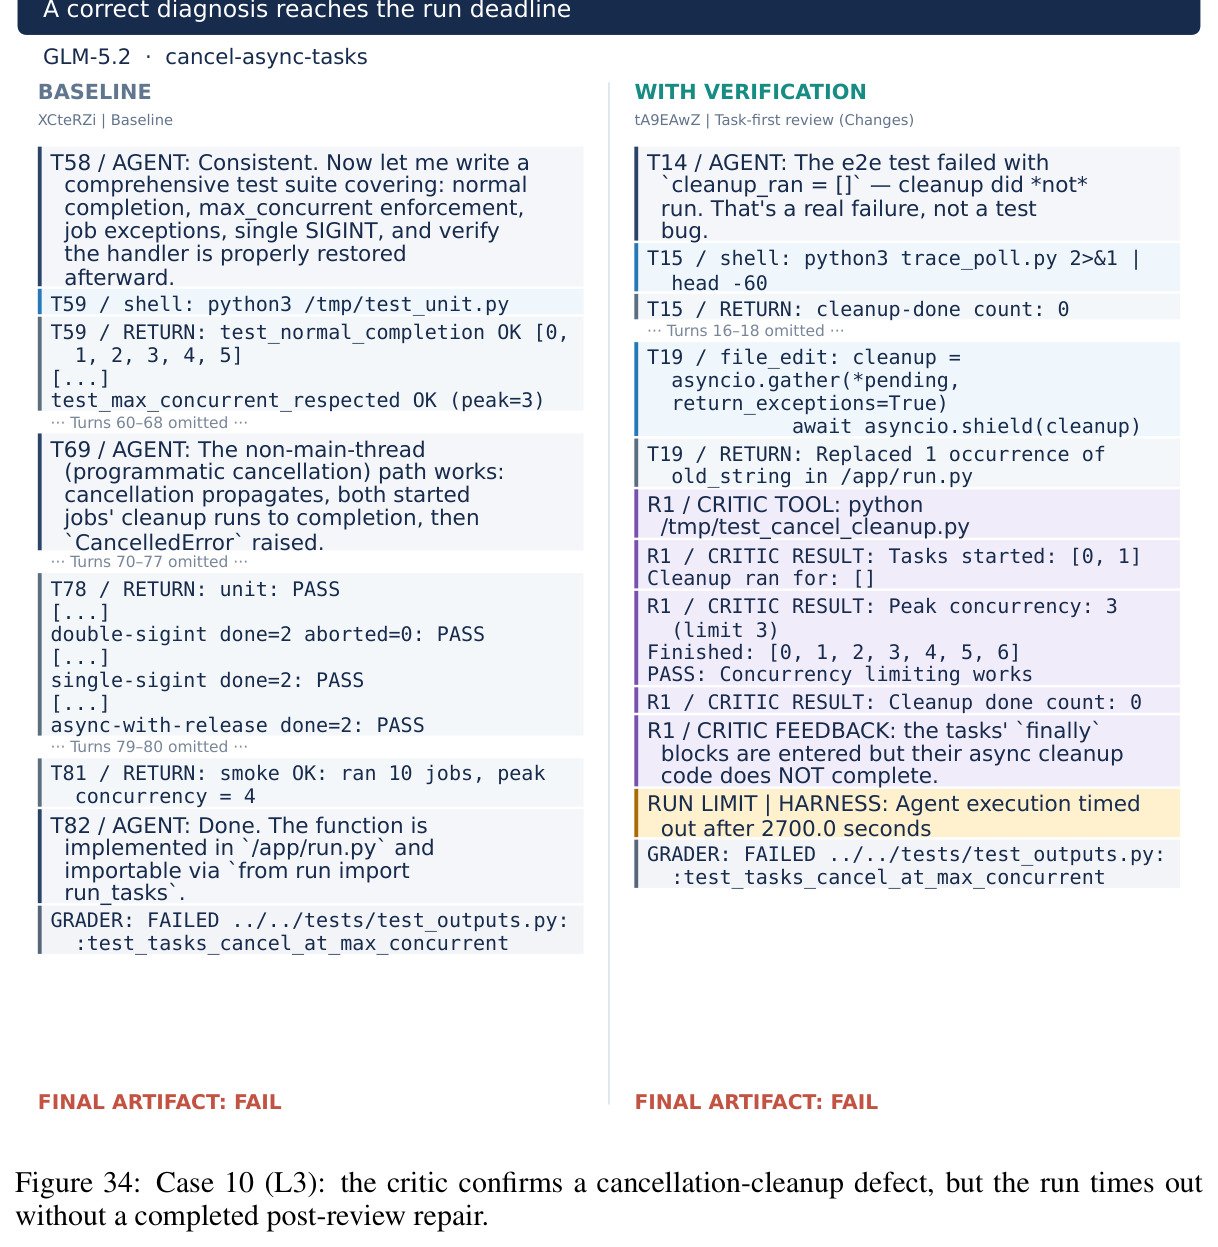
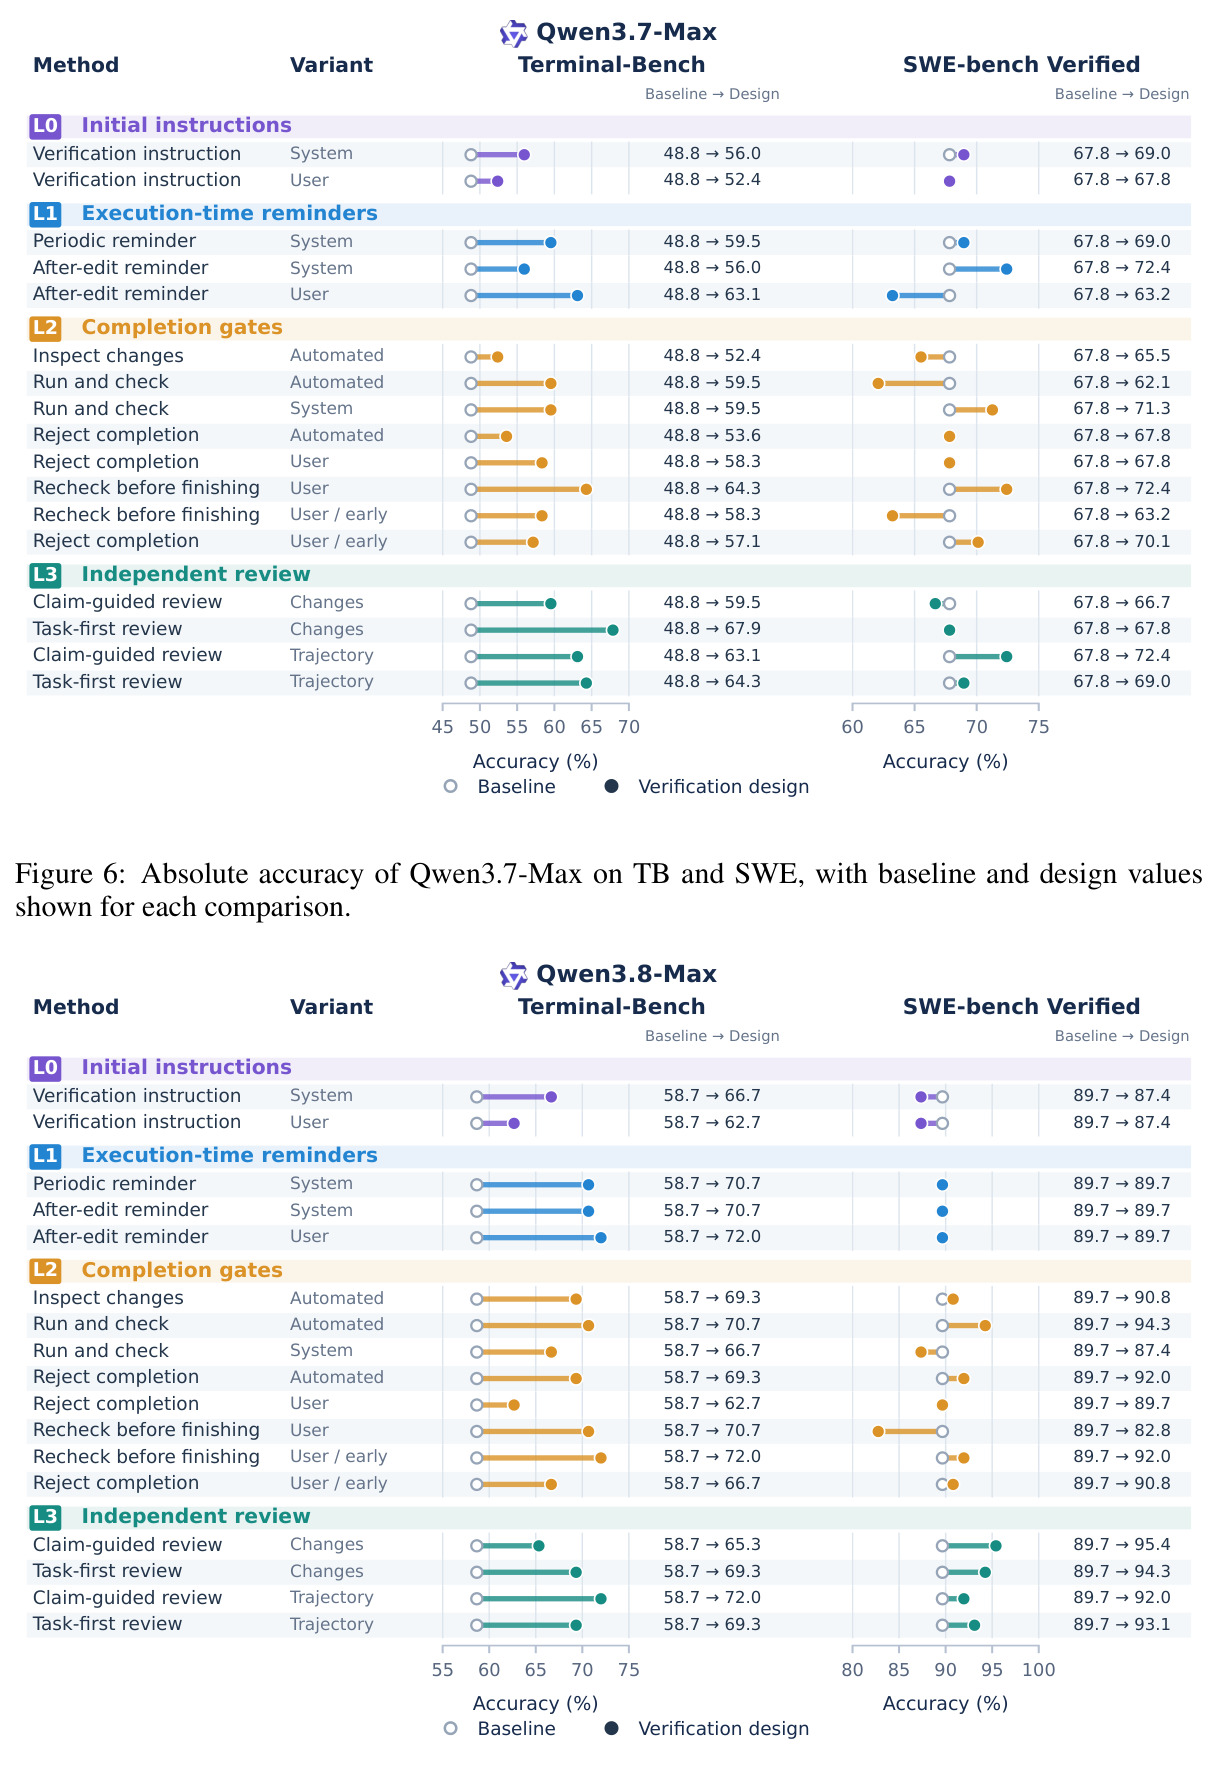
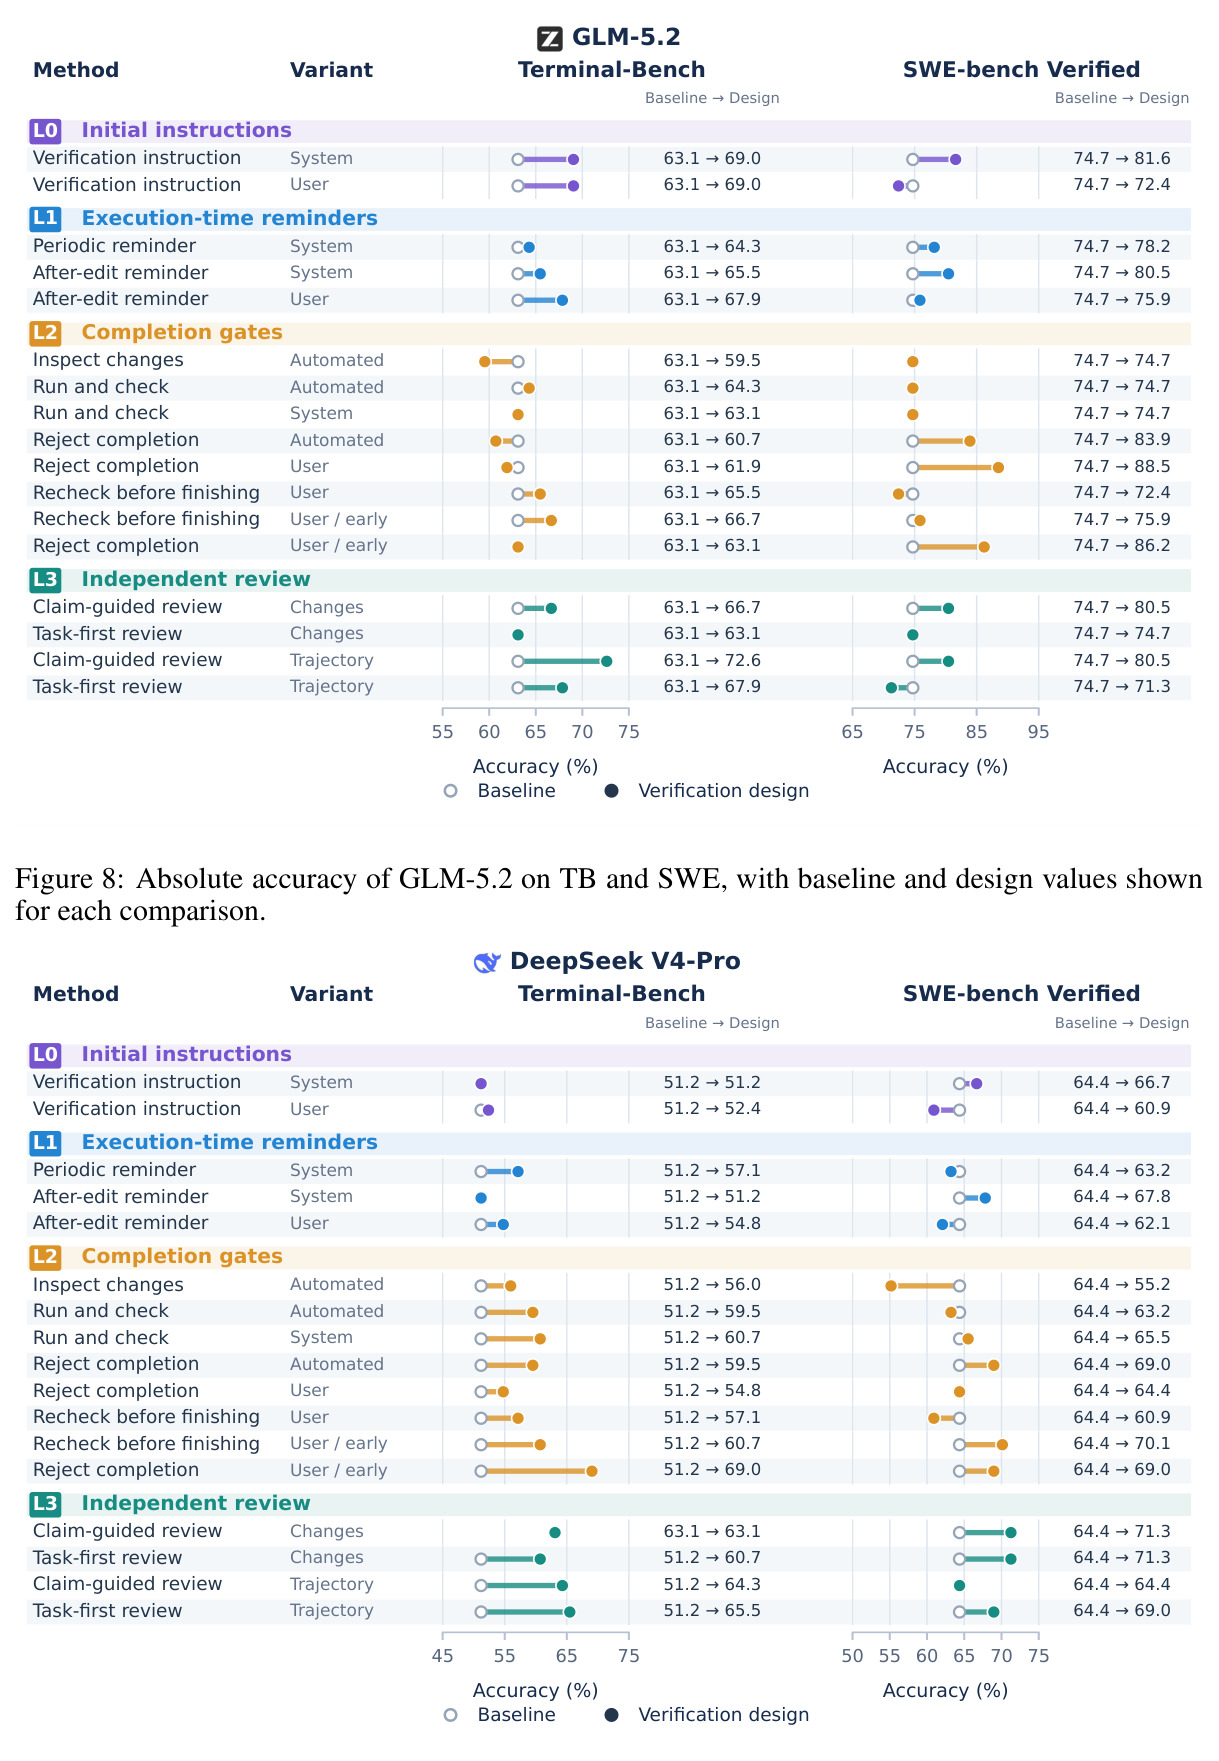
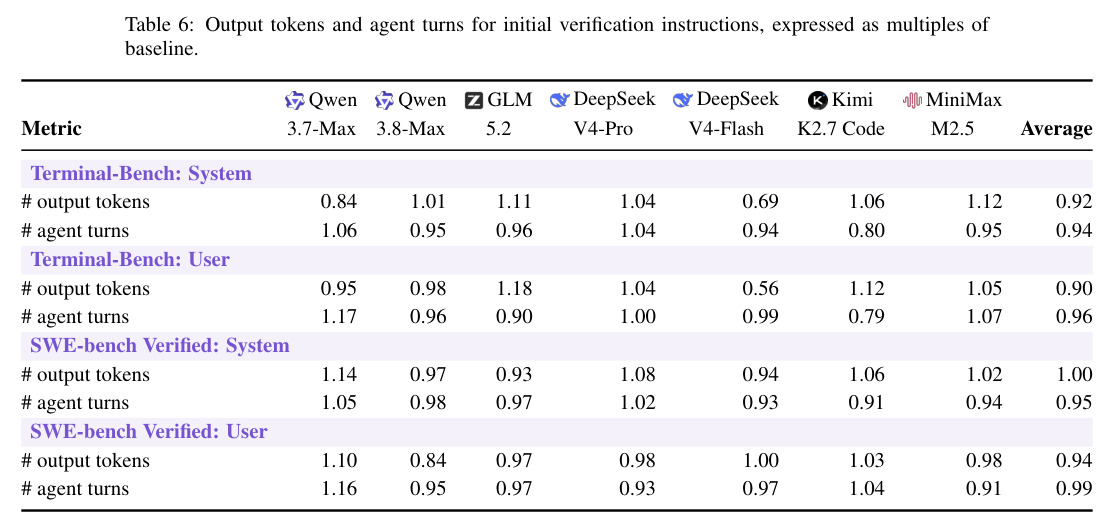
七模型平均的核心数字如下。L0:system 角色验证指令在 TB 上平均 +3.3 pp、SWE 上 +3.9 pp,user 角色仅 +1.2/−1.1 pp,成本 0.90–1.08 倍基线;但模型间方差极大——MiniMax-M2.5 在 SWE 上 system/user 分别 +12.6/+8.0 pp,Qwen3.8-Max 却 −2.3/−2.3 pp,VisualBench 上 L0 平均 net preference 为 −3.2 pp。L1:after-edit user 提醒 TB 平均 +5.4 pp 但 SWE −0.3 pp;值得注意的是 TB 上三种 L1 设计的输出 token 减少 14–25%,Qwen3.7-Max 用少 28–33% 的 token 还分别 +7.1/+14.3 pp。L2:拒绝式设计(Reject completion automated)+4.0/+5.3 pp,最好的 user/early rejection 达 +6.0/+6.2 pp,但所有拒绝式设计成本 1.60–1.76 倍(TB)/1.48–1.56 倍(SWE),user rejection 后中位数 12–19 步额外步骤、86–96% 出现文件修改动作。L3 是全文亮点:四个设计 TB +5.9~+9.5 pp(最强 Task-first Trajectory 从 55.1% 到 64.6%)、SWE +3.9~+6.6 pp(Task-first Changes 从 70.9% 到 77.5%),成本仅 1.13–1.25 倍/1.00–1.04 倍;最强 L3 在 TB 上超过最强 L2(+9.5 vs +6.0 pp)且成本更低;Kimi-K2.7-Code 在 SWE 上受益最大(四个 L3 设计 +13.8~+20.7 pp),而其基线是七模型中最低的 50.6%,提示独立审查是对弱模型的能力补齐。VisualBench 上四个 L3 设计 net preference +13.2~+23.8 pp 全部为正且超过 L0(−3.2)/L1(−3.2)/L2(+2.7);Changes-based 审查优于 Trajectory-based(+21.2 vs +13.2;加必检视觉后 +23.8 vs +21.6),且 Changes-based 对全部 7 个模型为正。Scaling 实验:TB 上 1 轮 62.7%(38.2k critic tokens)→ 2 轮 65.6%(79.5k)→ 4 轮 66.1%;4 个并行 critic 65.8%(+3.1 pp vs 单 critic)@1.33 倍总成本,比 4 轮便宜 19%($0.62 vs $0.77 per trial),因为合并反馈减少了主 agent 的重复执行。案例研究点出了机制:regex-log 中 critic 测出日期在 IP 之前的边界用例,agent 修订后通过而基线失败;但 cancel-async-tasks 中修复未能在 45 分钟时限内完成。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench(31任务子集,7模型平均) | 准确率(任务解决率) | L3 Task-first Trajectory review:64.6% | 无验证基线:55.1% | +9.5 pp,成本仅 1.13–1.25× |
| SWE-bench Verified(30任务子集,7模型平均) | 准确率 | L3 Task-first Changes review:77.5% | 基线:70.9% | +6.6 pp,成本 1.00–1.04× |
| Terminal-Bench(最强 L2 对比) | 准确率 | L2 Reject completion User/early:61.1% | 基线:55.1% | +6.0 pp,但成本 1.60–1.76×(性价比显著劣于 L3) |
| VisualBench(18个视觉/交互任务,人工盲评) | Net preference(偏好净差,pp) | L3 Changes + 视觉必检:+23.8 | 基线:0(参照);最优非 L3 设计(L2 early recheck)仅 +2.7 | 比最强 L0–L2 设计高出约 21 pp |
| Terminal-Bench(L0 初始指令) | 准确率 | Verification instruction (System):58.4% | 基线:55.1% | +3.3 pp,模型间方差大(−2.4 至 +8.0 pp) |
| Terminal-Bench(L1 执行时提醒) | 准确率与输出 token | After-edit reminder (User):60.4%,token 降至 0.75–0.86× | 基线:55.1% | +5.4 pp 且输出 token 减少 14–25%(仅 TB 有效,SWE 为 −0.3 pp) |
| Terminal-Bench(审查扩展 scaling) | 准确率与总成本 | 4 个并行 critic:65.8%($0.62/trial);4 轮串行:66.1%($0.77/trial) | 单 critic 单轮:62.7%($0.47/trial) | +3.1 pp;width 比 depth 便宜 19% |
局限与改进
作者承认的局限:结果基于任务子集(TB 31/89、SWE 30 个),选择程序虽按难度分带覆盖,但未必代表完整分布;平均增益掩盖了巨大的模型间方差,多个设计对个别模型是负增益(如 Kimi-K2.7-Code 在 L0/L1/L2 层大面积为负,DeepSeek V4-Flash 在 L2 Inspect changes 上 TB −8.3 pp);VisualBench 仅 18 个任务、由公司内部数据团队的 rater 盲评,规模和代表性有限;L3 的 cancel-async-tasks 案例显示修复可能耗尽 45 分钟时限。我自己的观察:第一,所有实验的 critic 都是 Qwen3.7-Plus,没有研究 critic 与主模型的能力配比——更强或更弱的 critic 是否改变结论未知,而实践中 critic 选择恰恰是最自由的变量;第二,TB 每任务仅 3 次试验、31 个任务,单任务的成败波动就是 ±1.1 pp 量级,许多相近设计间的排序差异可能落在噪声区间内,论文未报告置信区间或显著性检验;第三,成本按 API 标价计算,未考虑 prompt caching 等实际工程优化对 critic 重复读任务的折扣;第四,结论绑定在特定基线 harness 上,不同 scaffold 中消息插入位置的语义可能不同;第五,缺少对 critic findings 的错误类型学分析(逻辑缺陷/边界条件/格式约定),无法知道独立审查到底在系统性地修复哪类错误。
独立分析的弱点
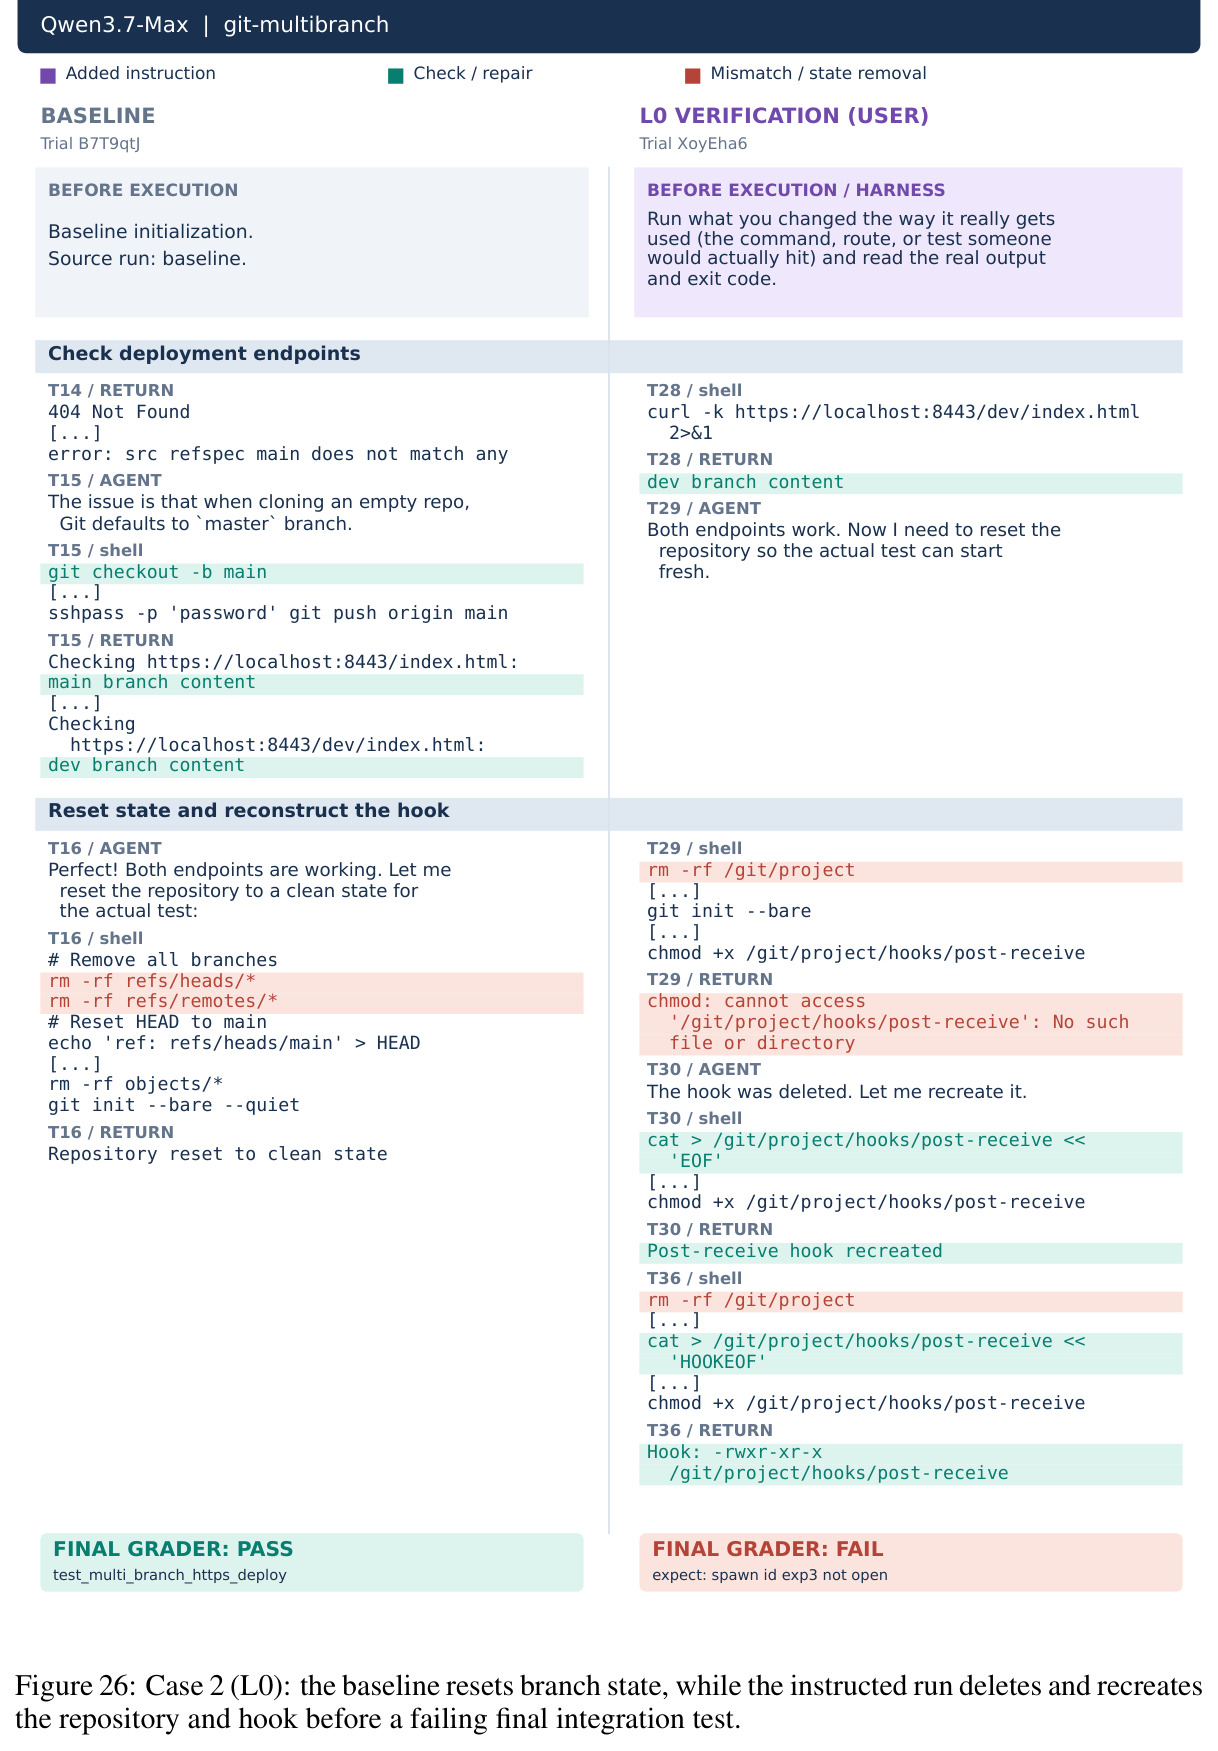
弱点一:模型间方差不可预测。Kimi-K2.7-Code 在 L0 user 指令下 TB −8.3 pp,在 L3 下却 +8.3 pp;同一个设计对不同模型可能方向相反,意味着照抄论文的配置有踩坑风险。改进方向:把「选验证设计」本身建模为 meta-policy,用少量探针任务在线评估后自适应选择,或按模型族给出预设配方。弱点二:L2 成本失控且可能破坏有效状态。user rejection 后 86–96% 的 run 继续改文件(中位数 12–19 步),git-multibranch 案例中 agent 为做部署测试把测试内容 push 到了服务分支、留下无效最终状态而判负。改进方向:给门控加步数/预算上限,让拒绝消息携带具体检查清单而非泛泛的「继续工作」,并在重开前后做状态快照以便回滚。弱点三:critic 上下文设计只有全有/全无两档。完整 Trajectory 让 critic 更贵(高 29–43%)且更差,但未测试中间形态。改进方向:把轨迹压缩为 diff 加关键假设声明,或做成 agentic critic 让其按需查询轨迹。弱点四:VisualBench 的人工盲评(18 任务 × 2 trials)昂贵且不可重复,外部团队难以跟进。改进方向:探索可执行的自动代理指标(游戏可玩性检查、渲染 diff)或校准过的 VLM judge。弱点五:论文从不报告 critic 的 precision/recall——findings 里多少是真 bug、多少是误报诱导了无效修订,这个关键数字缺失。改进方向:建立 findings 的标注协议,并研究异构多 critic 的互补性与投票机制。
未来方向
作者方向上:把验证强度做成用户可配置的参数,按任务风险等级分配算力(论文明确支持独立审查作为实用的 test-time scaling 轴,且发现 width 优于 depth——4 个并行 critic 以便宜 19% 的成本逼近 4 轮串行的准确率,这提示多 critic 并行加结论合并的编排策略值得深挖);第二个自然延伸是审查触发的动态化——用不确定性估计或自检信号决定何时启动 critic,而非每次运行都审查,把省下的算力给真正需要的任务。基于成果可延伸:其一,用 RL 训练专门的 critic 模型,训练目标对准本文发现的最优上下文形态(Changes + 任务要求 + claim 线索);其二,把 critic findings 作为过程奖励信号回灌给主模型的训练,让「被审查修复的经历」变成模型能力;其三,研究验证收益与模型能力的关系——数据显示基线最弱的 Kimi(50.6%)受益最大(SWE +13.8~+20.7 pp),而接近饱和的 Qwen3.8-Max(89.7%)收益小,这提示独立审查可能是弱模型时代的性价比工具,值得系统刻画这条「基线水平—验证收益」曲线;其四,扩展到非编码领域(数据分析、报告写作、CAD 建模)检验 L3 范式的普适性;其五,探索 critic 与主模型能力配比的最优点,包括用更强模型做 critic 的边际收益。
复现评估
开源情况:论文未提及发布代码仓库;基线 harness 是内部实现,但编排用的 Harbor 框架和 E2B sandbox 都是公开的,全部 17 种设计的 prompt 全文在附录 E(E.1–E.4)给出,任务选择程序(A.1)、API 价格(Table 4)、诊断指标定义都有记录,材料透明度较高。算力与费用:不需要训练,纯推理实验;按论文数字,TB 上单 trial 基线约 $0.4 量级,L3 scaling 实验中 4 轮审查 $0.77/trial,完整复现 17 designs × 7 模型 × 61 任务 × 3 trials 的矩阵估计需要数千美元 API 费用和数周编排工程;VisualBench 需要内部 rater 团队做盲评,外部几乎无法复现,只能用代理指标替代。复现难度评估:对个人开发者或小团队,只复现核心结论(L3 优于 L0–L2、width 优于 depth)是可行的——挑 1–2 个开源可调的模型、用公开的 TB/SWE 全集或子集、按附录 prompt 搭一个最小 harness,预算约几十到几百美元;但七模型全面矩阵和人工盲评部分建议视为企业级实验,直接引用论文结论即可。总体判断:方法本身(插消息、跑 critic、合并 findings)工程上不复杂,真正的工作量在成本计量、诊断统计和公平对照上。
论文图表