半事实信用增强策略优化 Semifactual Credit-Augmented Policy Optimization
用半事实扰动下的token概率稳定性修正GRPO优势,实现细粒度信用分配,提升推理与鲁棒性
前置知识
RLVR(可验证奖励的强化学习)
用可自动验证的结果作为奖励信号对语言模型做强化学习,例如规则验证器检查 $\boxed{}$ 中的最终答案是否等于标准答案,正确给 1 分、错误给 0 分,无需人工偏好标注或训练奖励模型。DeepSeek-R1 等推理模型正是靠 RLVR 从 base 模型直接训练出强推理能力。
SCAPO 的全部训练与对比实验都在 RLVR 设置下进行,理解其二元奖励设计和评测协议是读懂实验部分的前提。
GRPO(组相对策略优化)
DeepSeekMath 提出的无 critic 强化学习算法:每个 prompt 采样一组 $G$ 条响应,用组内奖励的均值和标准差把结果奖励归一化为轨迹级优势 $A_i=(R_i-\mu_R)/(\sigma_R+\epsilon_A)$,再把同一个 $A_i$ 平摊给响应中的每个 token,配合 PPO 式裁剪重要性比率更新,省去价值网络。
SCAPO 本质上是 GRPO 的一个变体;论文指出的'轨迹级优势无法区分单个 token'正是它要修复的核心缺陷,全文公式与记号都沿用 GRPO。
半事实干预(semifactual intervention)
与反事实(what-if:改变输入特征会改变输出结果)相对,半事实对应'即使改变也不影响结果'的干预:只改动与任务无关的表面特征,保持题目和答案完全不变。本文用四种类型实现:改写措辞、制造错字、包裹无关场景、追加无关后缀,要求所有数值、LaTeX 和答案逐字保留。
半事实干预既是论文的诊断工具也是训练信号的唯一来源,理解它才能理解'概率漂移 = 伪相关敏感度'这一因果解释为什么成立。
Teacher forcing
把一条已经确定的完整序列逐位喂给模型,在每个位置只读取模型对该位置已定 token 的概率,而不让模型自回归地重新生成后缀。相比重新采样,它计算量小、结果确定,且能在固定输出的前提下比较不同输入条件下的概率差异。
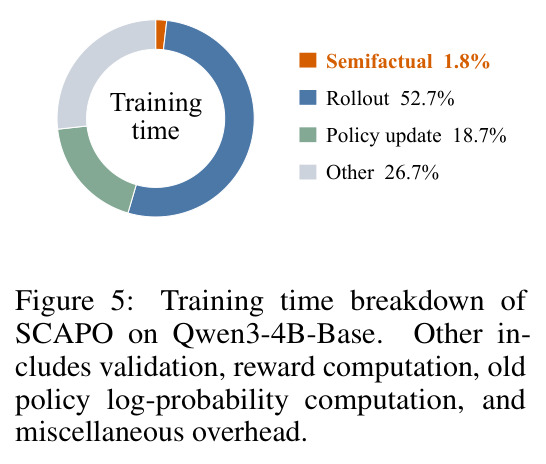
SCAPO 探测 token 漂移完全依赖 teacher forcing 固定已采样的响应,这也是该方法额外开销只占训练总时长 1.8% 的关键。
Token 级信用分配
强化学习中把轨迹级奖励归因到单个动作或 token 的问题。GRPO 对所有 token 用同一优势,粒度最粗;已有改进路线包括过程奖励模型、蒙特卡洛逐步价值估计(VinePPO)、输出侧推理片段反事实掩码(CF-GRPO)、未来 KL 散度加权(FIPO)、基于 token 熵或资格迹的选择等。
SCAPO 属于这条研究线,只有了解它与过程监督、反事实掩码等方案的差别,才能准确把握其贡献定位。
有界对称漂移度量
衡量同一 token 在原始与扰动 prompt 下概率变化的距离:$d=|p^{(0)}-p^{(k)}|/((p^{(0)}+p^{(k)})/2)$,取值范围 $[0,2]$。分母用局部平均概率归一,避免绝对差对低概率 token 的尺度偏置;比值与 tanh 形式又抑制极端概率比带来的数值不稳定。
这是从诊断实验到训练信号贯穿全文的核心测量公式,SCAPO 的稳定性分数正是由它聚合、标准化而来。
研究动机
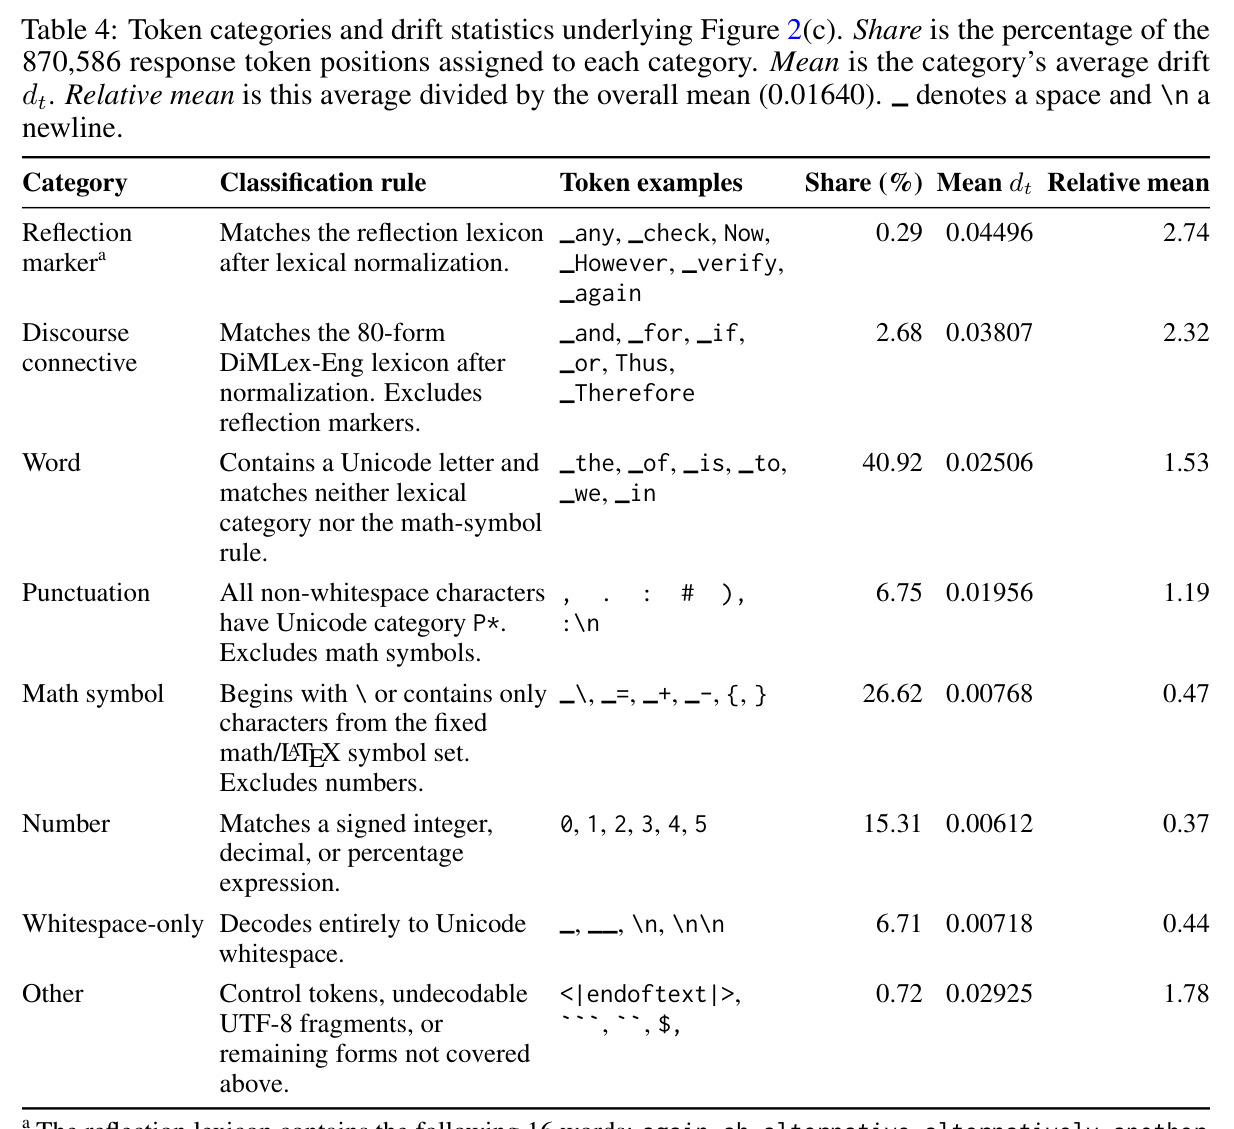
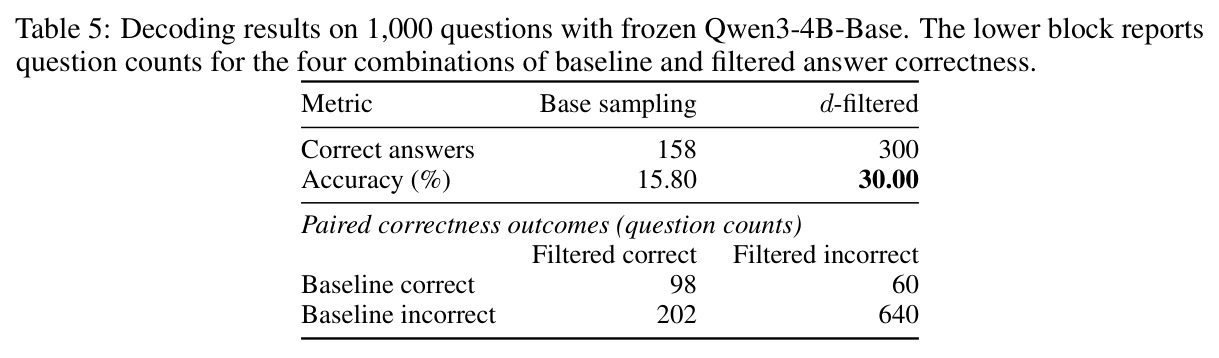
尽管 RLVR 显著提升了 LLM 的推理能力,模型预测仍对任务无关的提示特征高度敏感。作者用'半事实干预'量化这种脆弱性:保持数学题目和答案完全不变,只让 GPT-5.5 改写表述方式(改写措辞、制造拼写噪音、包一层无关场景、追加无关后缀)。在 1,000 道 DAPO-Math-17K 题目上用冻结的 Qwen3-4B-Base 做诊断,共得到 870,586 个 token 位置的漂移数据:12.82% 的位置概率纹丝不动,其余位置的漂移横跨数个数量级;反思标记词(wait、check、hmm 等)的平均漂移是全体均值的 2.74 倍,话语连接词为 2.32 倍,而数学符号和数字只有 0.47 倍和 0.37 倍。更直接的证据是:在解码时压制高漂移候选 token、不动任何权重,同一批题目的准确率就从 15.8% 涨到 30.0%。这说明模型确实在 token 级依赖伪相关特征。问题在于,GRPO 把轨迹级优势原封不动地平摊给每个 token,答对时所有 token 一视同仁地被强化,等于把伪相关依赖和真正有用的推理一起奖励了。
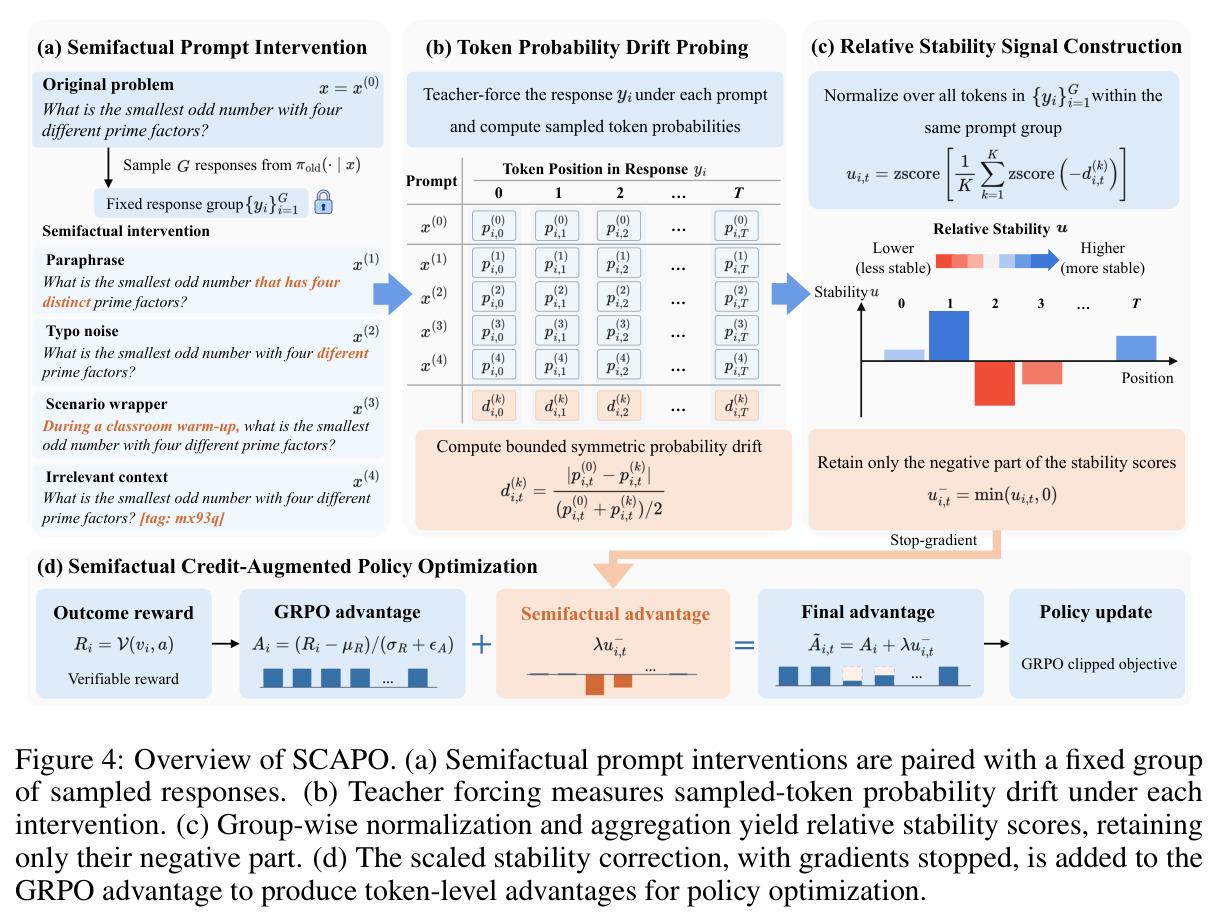
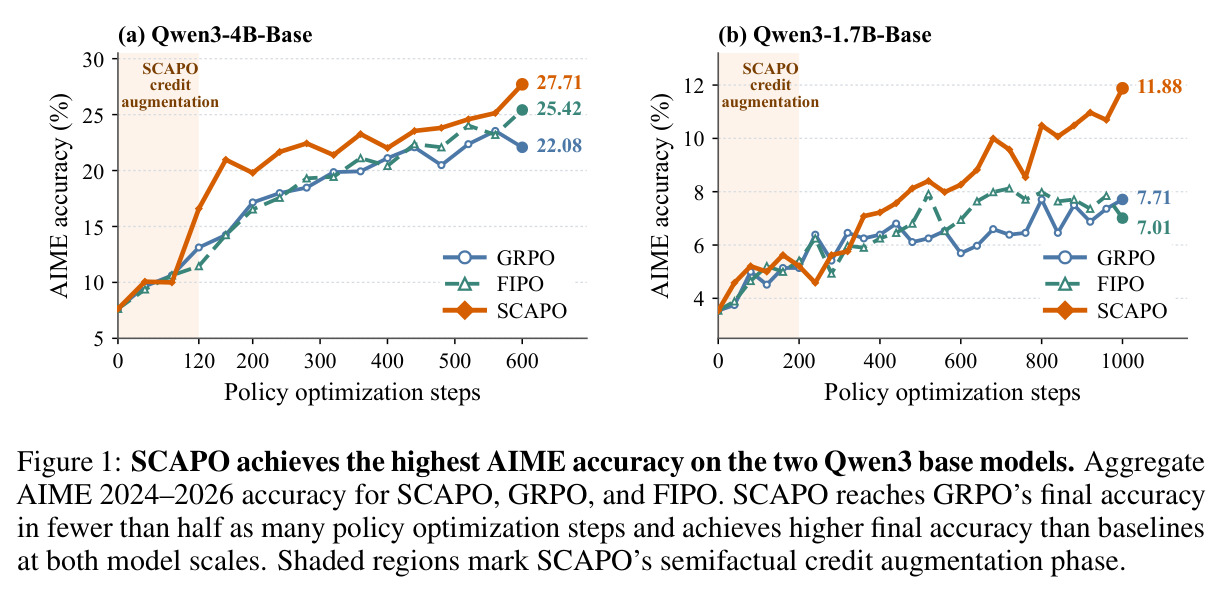
本文的目标是本文的目标是把'半事实稳定性'变成 RLVR 训练中的一个 token 级信用信号,在 GRPO 框架内实现更细粒度的信用分配。具体而言:对每个训练 prompt 预先构造 K=4 个保持答案不变的扰动版本;训练时用 rollout 策略对固定采样响应做 teacher forcing,测量每个 token 概率在扰动下的漂移;相对不稳定的 token 在训练早期被削减优势,而稳定的 token 不因此获得额外奖励——因为'稳定'本身不等于'正确'。整个修正以 stop-gradient 的方式加在 GRPO 优势上,且只在训练前 N0 步(4B 模型 120 步、1.7B 模型 200 步)启用,之后回归标准 GRPO。最终希望在不显著增加训练开销的前提下,同时提升分布内的竞赛数学成绩和对输入扰动(NoOp-AIME、ThinkBench-AIME)以及跨领域(GPQA-Diamond)的泛化能力。
与已有工作不同的是,细粒度信用分配已有不少路线:过程奖励模型依赖人工步骤标注;Math-Shepherd、VinePPO 用蒙特卡洛展开估计每步价值;CF-GRPO 通过掩码推理片段做输出侧反事实归因;FIPO 用未来 KL 散度给 token 加权;还有基于 token 熵、置信度或资格迹的方法。SCAPO 的切入角度完全不同:它从'输入侧'做因果探针——固定模型已采出的完整响应,只扰动 prompt 中与任务无关的部分,用同一 token 概率的漂移度量该 token 对伪相关特征的敏感度。这是半事实(even-if)而非反事实(what-if)干预:答案保持不变,所以漂移不会被任务语义变化污染。另外三个设计选择也区别于已有工作:只用稳定性信号的负半部分(只罚不奖)、以 stop-gradient 附加(不扭曲探针本身的估计)、只在训练早期启用(先塑形轨迹选择、再交给标准 GRPO 精调)。
核心方法
直觉上,如果一个 token 的概率在题目表述被无关方式改写后剧烈波动,说明它的生成依赖的是表层伪相关线索而不是题目的数学结构;对这样的 token 给满额正优势,会把脆弱的模式固化进策略。SCAPO 的技术路线分四步:(a) 半事实提示干预——为每道训练题预生成改写、错字、场景包裹、无关后缀 4 种扰动;(b) token 概率漂移探测——保持 rollout 采出的 $G=8$ 条响应不变,把它们分别 teacher-force 到原始和扰动 prompt 下,用有界对称距离度量每个位置的概率漂移;(c) 组内相对稳定性构造——对每种扰动类型先在组内对负漂移做 z-score 标准化,4 种类型取平均后再标准化一次,得到相对稳定性分数 $u$,只保留负半部分 $u^-=\min(u,0)$;(d) 策略优化——把 $\tilde{A}=A+\lambda\,\mathrm{sg}(u^-)$ 代入 GRPO 的裁剪目标,$\lambda_0=0.01$,仅前 $N_0$ 步启用。整个方法只改优势项,重要性比率、裁剪和损失归约与 GRPO 完全一致。
核心创新是把'答案保持型扰动下的概率稳定性'作为训练信号,且只作单侧惩罚。三条设计原则环环相扣:第一,响应固定、只改 prompt,并用 teacher forcing 而非重新生成,测到的漂移纯粹反映 token 对输入表层特征的依赖,而不是推理路径的变化;第二,稳定性分数在 prompt 组内标准化,且只保留负半部分——相对不稳定的 token 被扣减优势,稳定本身不加分,这避免把'输出稳定'误当'推理正确',并保证 $\tilde{A}\le A$ 恒成立:答对时高漂移 token 的正强化被削弱,答错时它们的负信号被放大;第三,修正是 stop-gradient 的外部信号,只塑造训练早期的轨迹选择(前 120/200 步),之后由标准 GRPO 接管,附录 D 还证明该辅助项对梯度扰动的范数有界($\|b_\lambda-b_0\|\le\lambda H$,$H=RB/2$),且增广结束后其对平均平稳性界的影响按 $N_0/T$ 衰减。相比之下,CF-GRPO 的反事实掩码作用于输出侧、需要估计掩码效应,FIPO 的未来 KL 是纯策略内在量,都与输入的因果结构无关。
方法步骤详情
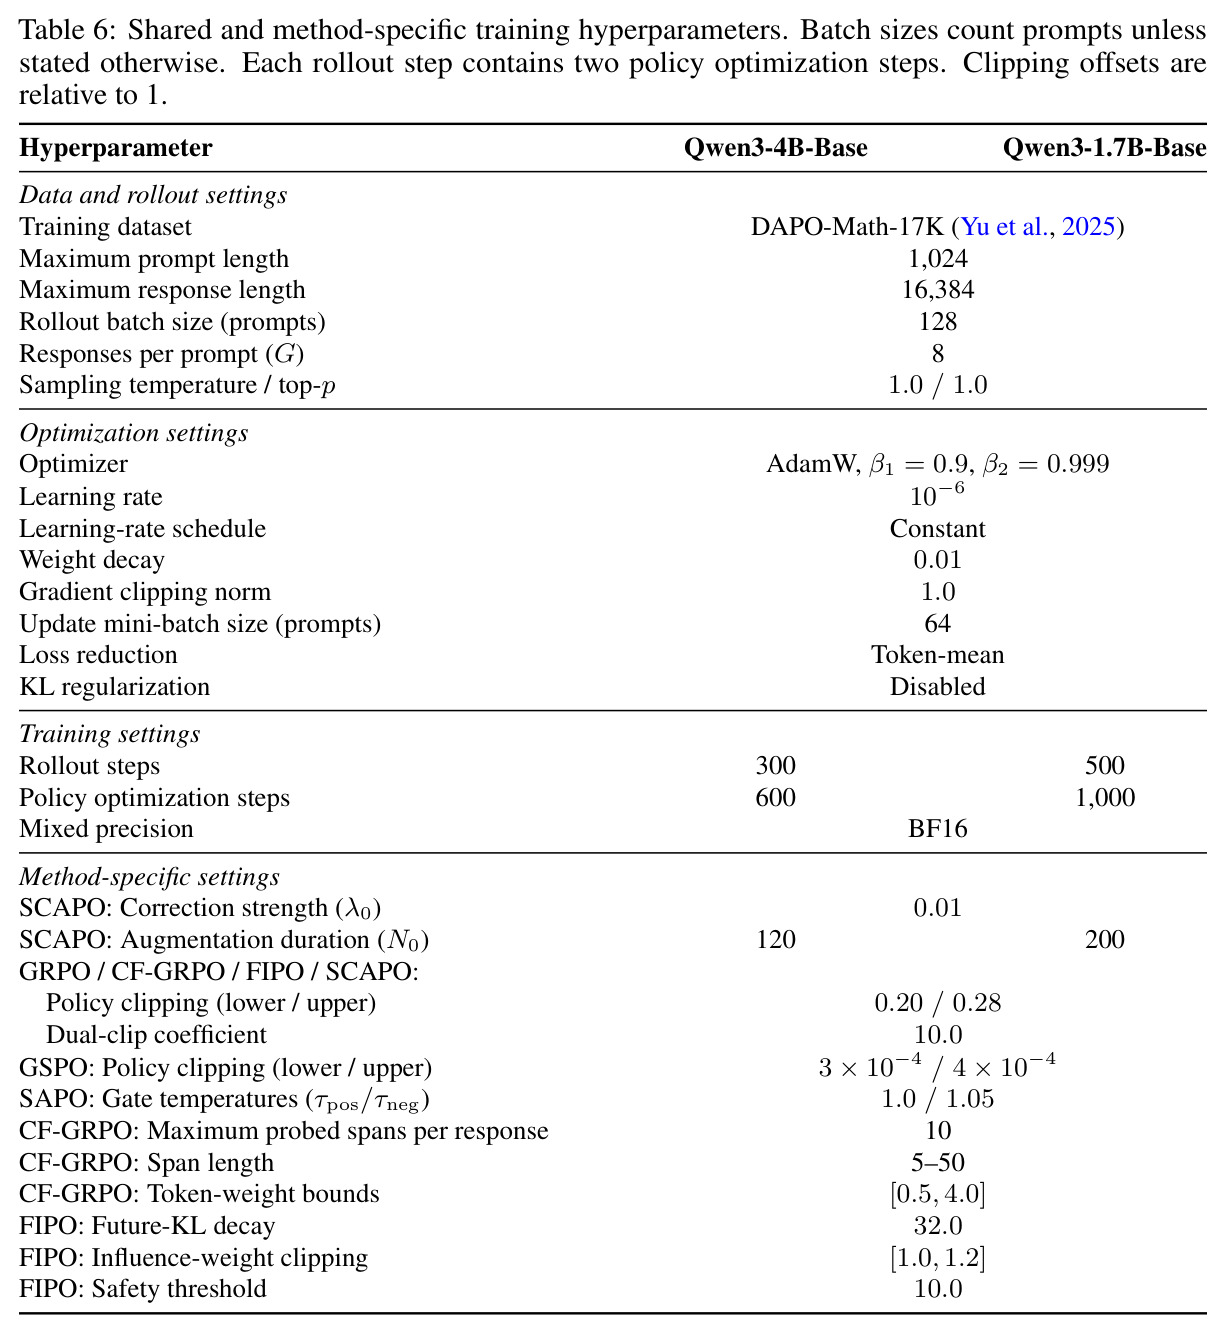
完整流程分五步。第一步(预处理):用 GPT-5.5 按严格模板为 DAPO-Math-17K 每道题生成 4 个扰动 prompt——paraphrase 只改数学表达外的自然语言;typo_noise 做一个字符级编辑;scenario_wrap 加轻量场景框;irrelevant_context 追加无意义干扰串(如 [tag: mx93q]),所有数值、LaTeX 与答案逐字保留。第二步(rollout):每个 prompt 采 $G=8$ 条响应,规则验证器给出 0/1 奖励,计算组相对优势 $A_i$。第三步(探测):用 rollout 策略把每条响应 teacher-force 到原始与 4 个扰动 prompt 下,得到对齐概率 $p^{(0)}$ 与 $p^{(k)}$,按有界对称距离逐 token 计算漂移 $d$。第四步(稳定性信号):对每种扰动类型在组内对 $-d$ 做 z-score,4 类平均后再 z-score 一次得 $u$,取负半部分 $u^-=\min(u,0)$。第五步(增广与更新):$\tilde{A}=A+\lambda_0\,\mathrm{sg}(u^-)$,4B/1.7B 分别在前 120/200 个策略优化步启用,之后 $\lambda=0$,代入 token-mean 裁剪目标更新策略。训练配置:rollout batch 128、更新 batch 64、最大响应 16,384 token、恒定学习率 $10^{-6}$、无 KL 正则、裁剪区间 0.20/0.28。
技术新颖性
技术新颖性体现在四个层面。信号来源上,这是首批把半事实/反事实解释文献中的干预思想引入 RLVR 信用分配的工作:扰动保持答案不变,因此漂移可解释为伪相关敏感度,有明确的因果语义;而 CF-GRPO 式的答案改变型扰动会混入合法的预测变化——消融实验直接证实了这一点:把半事实扰动换成答案改变的反事实扰动,五个竞赛基准平均分从 17.65 跌到 11.68,甚至低于 GRPO 的 12.63。信号形态上,负半部分 + stop-gradient + 组内双重标准化的组合在数学上保证 $\tilde{A}\le A$ 且组内 $\langle u\rangle=0$、$\langle u^2\rangle\le 1$,修正幅度天然可控(附录 D 引理给出界)。工程上,探测复用已采样响应做 teacher forcing,只占训练总时长的 1.8%,远低于 rollout 的 52.7%。调度上,'早期增广、后期纯 GRPO'的课程式设计把塑形与精调解耦,并有有限时长的理论支撑。四点合起来,构成一个不需要过程标注、不需要奖励模型、几乎零开销的细粒度信用分配方案。
实验结果
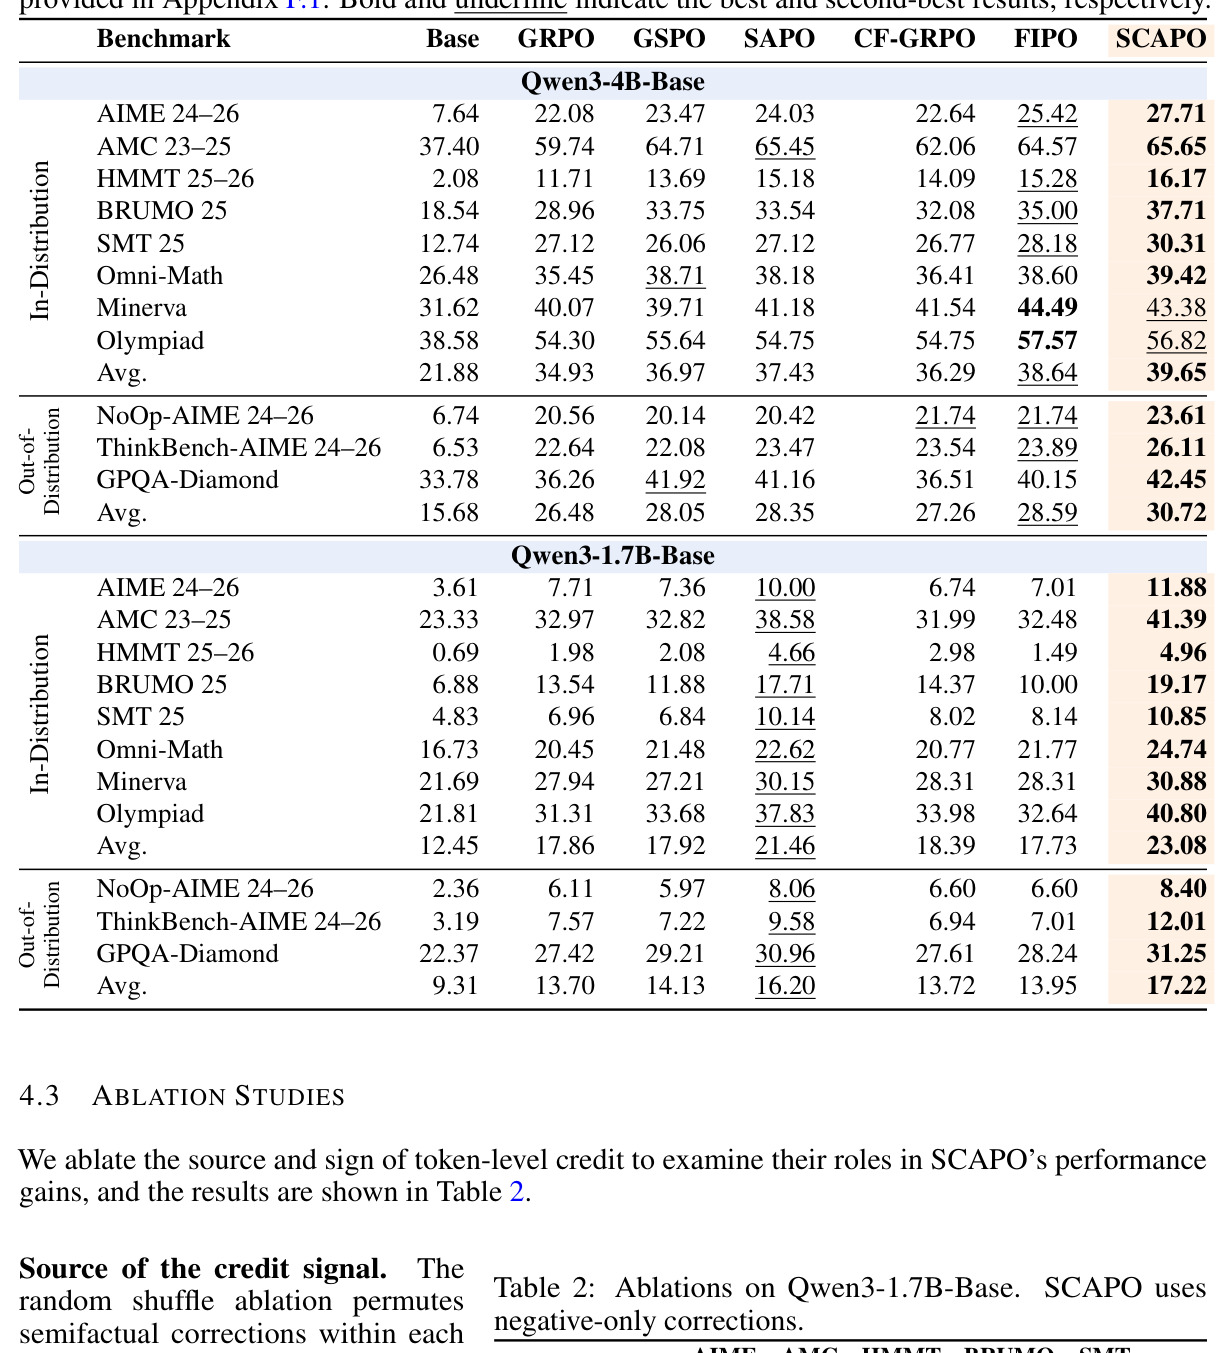
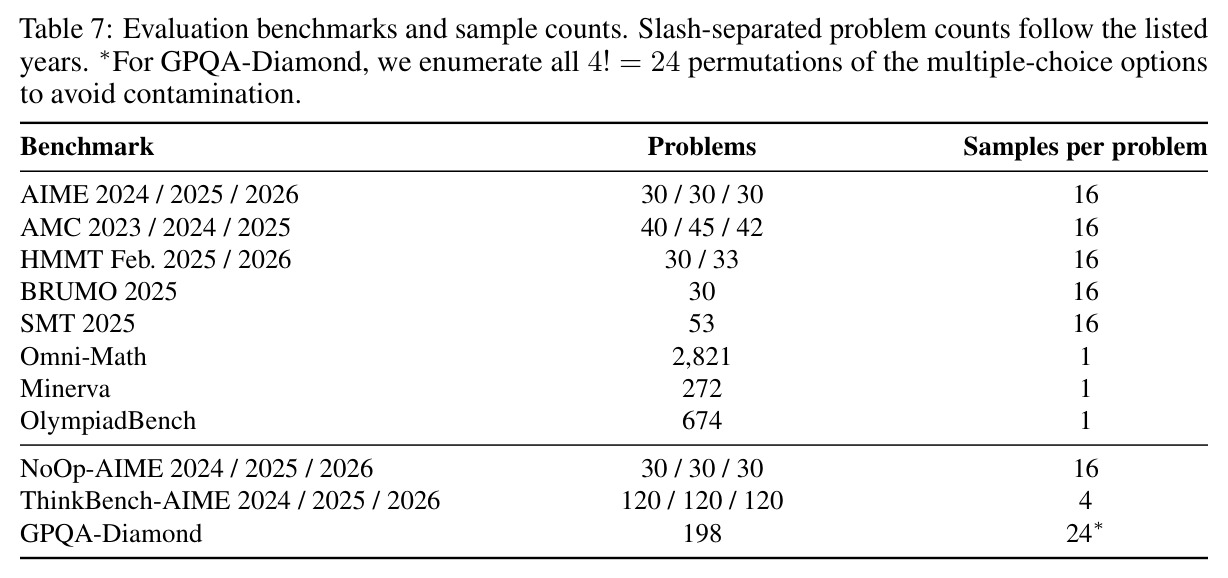
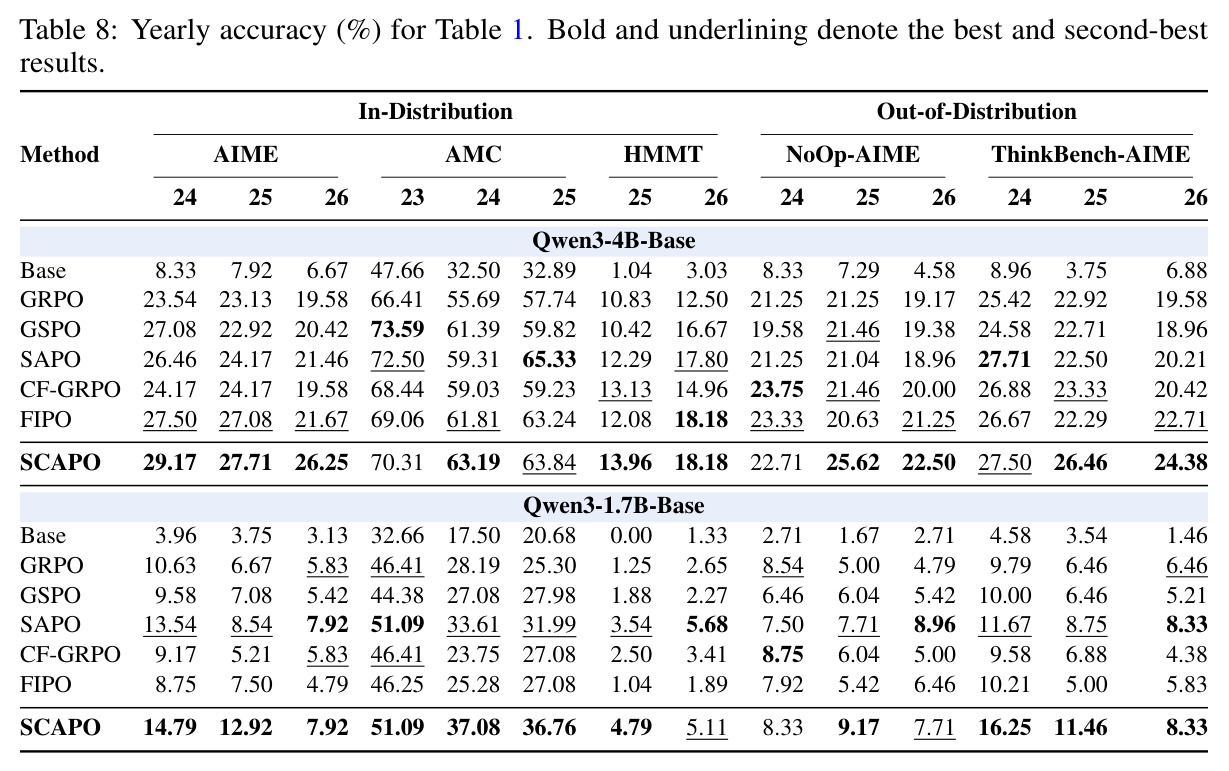
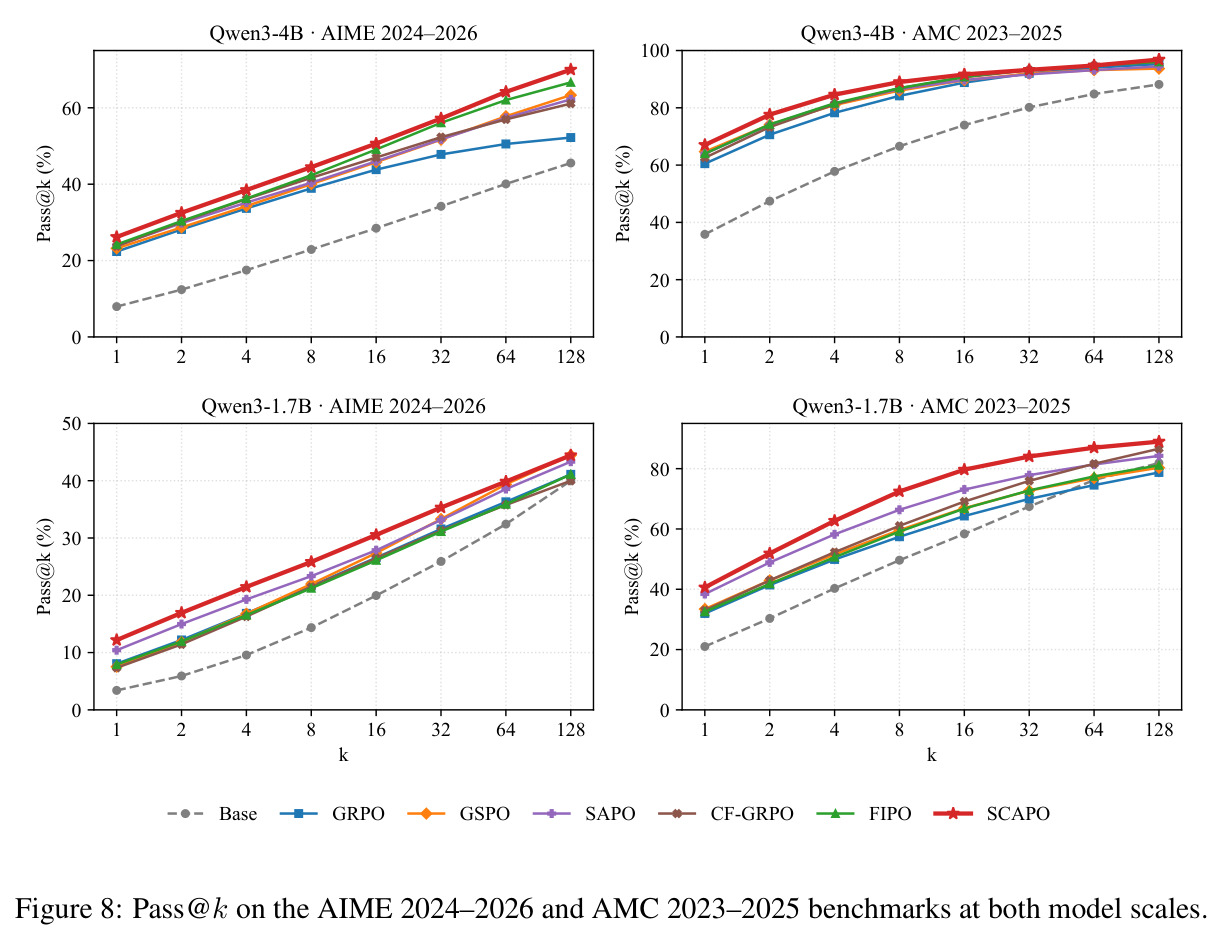
主实验在 Qwen3-4B-Base 和 Qwen3-1.7B-Base 上对比 GRPO、GSPO、SAPO、CF-GRPO、FIPO 五个基线。分布内:4B 上 SCAPO 的 AIME 2024–2026 准确率 27.71%,比 GRPO 的 22.08% 高 5.63 点,也高于最强基线 FIPO 的 25.42%;AMC 23–25 为 65.65%(GRPO 59.74%),HMMT 16.17%(+4.46 点),BRUMO 37.71%、SMT 30.31%、Omni-Math 39.42% 均最佳,Minerva 43.38% 与 Olympiad 56.82% 仅次于 FIPO,八项平均 39.65% 居首。1.7B 上八项全部第一:AIME 11.88%(+4.17 点)、AMC 41.39%、HMMT 4.96%、BRUMO 19.17%、SMT 10.85%、Omni-Math 24.74%、Minerva 30.88%、Olympiad 40.80%,平均 23.08% 对 GRPO 的 17.86%。分布外:SCAPO 在两个规模的全部三项 OOD 基准均最佳——4B 上 NoOp-AIME 23.61%、ThinkBench-AIME 26.11%、GPQA-Diamond 42.45%(GRPO 36.26%,+6.19 点);1.7B 上为 8.40%、12.01%、31.25%(GPQA +3.83 点)。图 1 显示 SCAPO 用不到 GRPO 一半的优化步数即达其最终 AIME 精度;图 8 显示 Pass@128 在 AIME 和 AMC 上也最高。诊断层面,d-filtered 解码不动权重即把 1,000 题准确率从 15.8% 提到 30.0%(202 题由错转对、60 题由对转错,平均每条响应拒绝重采 50.58 个 token、占解码步 4.58%);消融中负号修正(五基准平均 17.65%)优于全符号(15.65%)与只取正号(14.05%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AIME 2024–2026(Qwen3-4B-Base) | 平均准确率 (%) | 27.71 | GRPO 22.08(次优 FIPO 25.42) | +5.63 pp(对次优 +2.29 pp) |
| AIME 2024–2026(Qwen3-1.7B-Base) | 平均准确率 (%) | 11.88 | GRPO 7.71(次优 SAPO 10.00) | +4.17 pp |
| AMC 2023–2025(4B / 1.7B) | 平均准确率 (%) | 65.65 / 41.39 | GRPO 59.74 / 32.97 | +5.91 / +8.42 pp |
| HMMT 2025–2026(4B / 1.7B) | 平均准确率 (%) | 16.17 / 4.96 | GRPO 11.71 / 1.98 | +4.46 / +2.98 pp |
| 分布内八项基准平均(4B / 1.7B) | 平均准确率 (%) | 39.65 / 23.08 | GRPO 34.93 / 17.86(次优 FIPO 38.64 / 17.73) | +4.72 / +5.22 pp |
| NoOp-AIME 2024–2026(4B / 1.7B) | 准确率 (%) | 23.61 / 8.40 | GRPO 20.56 / 6.11 | +3.05 / +2.29 pp |
| ThinkBench-AIME 2024–2026(4B / 1.7B) | 准确率 (%) | 26.11 / 12.01 | GRPO 22.64 / 7.57 | +3.47 / +4.44 pp |
| GPQA-Diamond(4B / 1.7B) | 准确率 (%) | 42.45 / 31.25 | GRPO 36.26 / 27.42 | +6.19 / +3.83 pp |
| d-filtered 解码(冻结 Qwen3-4B-Base,1,000 题诊断集) | 准确率 (%) | 30.0 | 标准采样 15.8(权重零更新) | +14.2 pp |
| 半事实探测与信用构造(Qwen3-4B 训练) | 占训练总时长 (%) | 1.8 | rollout 52.7%、策略更新 18.7% | 额外开销可忽略 |
局限与改进
作者在附录 A 中承认:训练实验仅限于 DAPO-Math-17K 上的数学推理,模型只有稠密的 Qwen3-1.7B/4B;尽管 GPQA-Diamond 证明了一定的跨领域迁移,更大模型与数据规模、MoE 和混合架构上的效果仍待验证。我自己的观察补充几点:其一,扰动由 GPT-5.5 生成,半事实的'答案保持'性质依赖生成模型的能力,若扰动无意中改变题目语义,信号就会被污染(反事实消融的崩坏恰恰说明信号对扰动质量高度敏感);其二,有效性集中在训练早期(前 120/200 步),提示该信号更像'塑形'而非可持续的信用来源,其与课程学习的结合方式未被探索;其三,诊断和评测集中在数学与科学问答,代码生成、多轮对话等 token 敏感性模式不同的领域尚未检验;其四,1.7B 模型上 ThinkBench-AIME 只有 12.01%,绝对值仍很低,方法并未解决小模型的根本能力短板;其五,$\lambda_0=0.01$ 只报了一个取值,修正强度与时长的敏感性分析在正文中缺失。
独立分析的弱点
独立分析有四个弱点。第一,扰动生成的成本与质量瓶颈:为每道训练题调用 GPT-5.5 生成 4 个扰动,预计算开销和 API 成本随数据集线性增长,论文也未报告扰动被拒或重试的比例;改进方向是用本地小模型或规则化模板(确定性 typo、随机 tag)降低外部依赖,并加扰动质量过滤。第二,负号修正'只罚不奖'可能误伤探索:高熵、高漂移的 token 往往也是探索的关键位置,持续压低其优势可能加剧熵塌缩,而作者没有报告训练过程的熵曲线;改进方向是让 $\lambda$ 与熵水平自适应挂钩,或对高熵 token 豁免修正。第三,组内标准化要求组内漂移有足够方差,在全对或全错的退化组(正是 DAPO 动态采样要解决的场景)里 $u$ 的意义变得模糊,论文未讨论零方差组的处理;改进方向是引入类似 DAPO 的组过滤,或只对有效组计算修正。第四,附录 D 的理论只是平稳性界,并未刻画半事实稳定性与泛化之间的因果关系,'削减不稳定 token 优势 → 提升鲁棒性'的机制仍停留在经验层面;改进方向是补充鲁棒性泛化界,或做机制性的中介分析实验。
未来方向
作者提出的未来方向包括:把信用增广扩展到更大模型、更多样架构(MoE、混合模型)以及数学之外的领域。基于本文成果还可以自然延伸:第一,把半事实稳定性用于推理时——论文的 d-filtered 解码已展示 +14.2 点的零训练收益,可发展成与自洽性、树搜索正交的鲁棒解码器;第二,把扰动从文本表面特征扩展到语义保真但结构变化的变体(多步改写、符号等价变形),检验信号强度是否随扰动深度可调;第三,与过程奖励模型结合——稳定性可作为 PRM 标签的廉价代理或噪声过滤器;第四,研究修正强度 $\lambda_0$ 与时长 $N_0$ 的自适应调度,例如按组内漂移方差或验证集鲁棒性指标动态开关;第五,用同样的探针诊断 RLVR 训练后模型的残余脆弱性,建立'训练前诊断—定向增广—训练后回归测试'的闭环;第六,在因果不变学习框架下理论上证明半事实稳定与分布外泛化的联系,给出可辨识性条件。
复现评估
复现条件相当好。代码基于开源 EasyR1 框架,已在 GitHub(DtYXs/SCAPO)公开;训练数据 DAPO-Math-17K、全部评测基准与基座模型 Qwen3-1.7B/4B-Base 均公开可得;附录 E.1 表 6 给出完整超参(rollout batch 128、$G=8$、lr $10^{-6}$、$\lambda_0=0.01$、$N_0=120/200$、裁剪 0.20/0.28、dual-clip 10.0 等),附录 B.1 给出扰动生成的完整 system/user prompt。门槛有两处:一是扰动生成依赖 GPT-5.5,需为 17K 道题各生成 4 个扰动,有一定 API 预算;二是训练算力,4B 训 600 步、1.7B 训 1,000 步,每步 rollout 128 prompt × 8 响应、最长 16K token,需要多卡 A100/H100 级资源,总开销约等于一次 GRPO 训练加约 2% 的探测成本。诊断实验(870,586 个 token 漂移统计、d-filtered 解码)只需冻结模型推理,单卡即可复现。总体难度:诊断部分低,完整训练中高。
论文图表
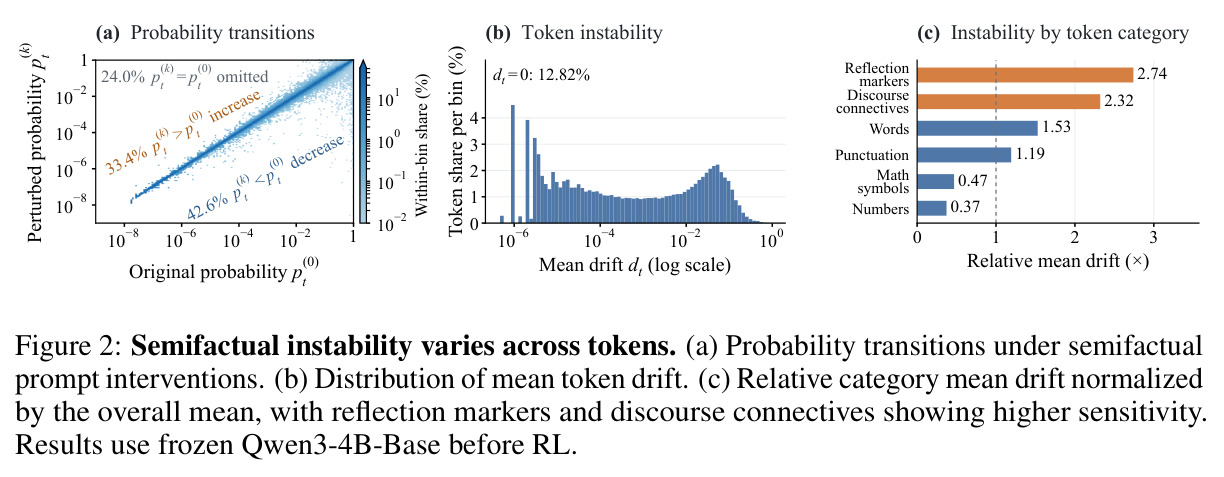
冻结 Qwen3-4B-Base 上的 token 级敏感性诊断:(a) 扰动前后 token 概率的迁移散点,升高与降低并存且覆盖所有置信度区间;(b) 平均漂移分布,横跨数个数量级,12.82% 的位置无变化;(c) 按类别的相对平均漂移——反思标记 2.74 倍、话语连接词 2.32 倍、普通词 1.53 倍、标点 1.19 倍、数学符号 0.47 倍、数字 0.37 倍,说明组织性/反思性词汇比数学内容对无关扰动敏感得多。
它是'LLM 在 token 级依赖伪相关特征'这一核心论断的直接证据,也是整个方法设计动机的实证基础。
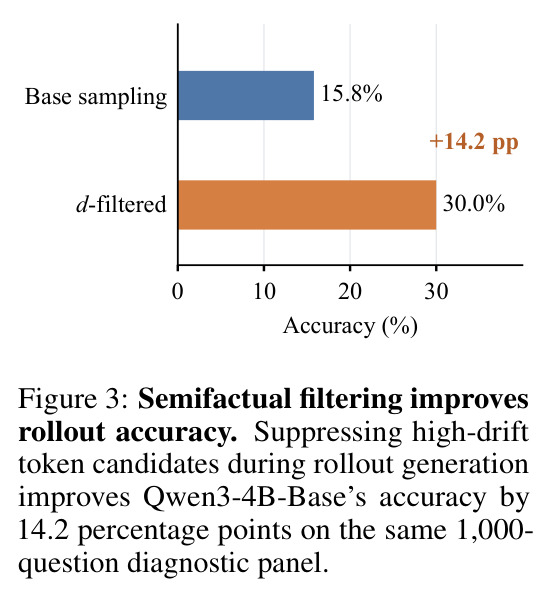
柱状图对比同一 1,000 题诊断集上两种解码方式:标准采样 15.8%,d-filtered 解码(压制累计概率质量不超过 0.8 的高漂移候选、保留 EOS、重新归一化)30.0%,+14.2 个百分点,且模型权重完全不变。
证明半事实敏感性不只是相关现象,而是一个可操作、能直接提升准确率的信号,为把它引入训练提供了关键桥接。
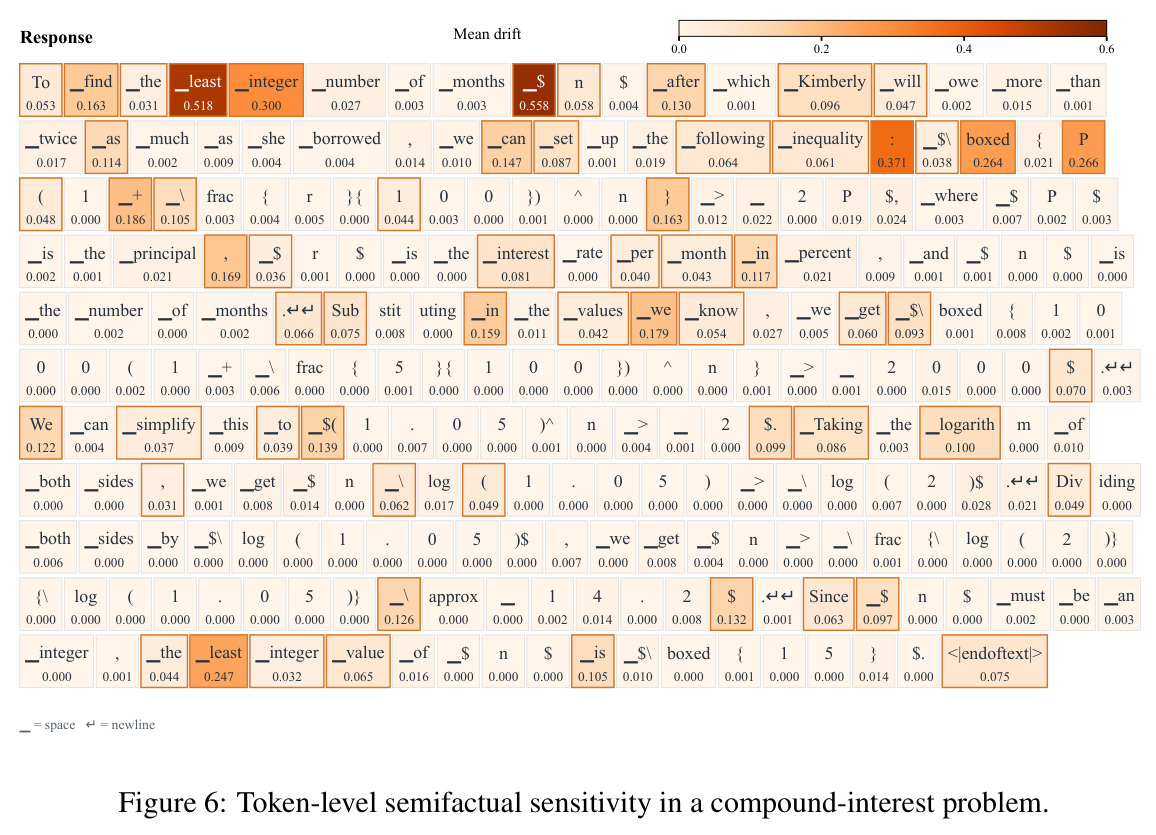
复利应用题案例:展示原始 prompt 与四种半事实扰动版本,并将完整响应逐 token 按平均漂移着色(深色更敏感)。即使最终答案正确,'find''least''if' 等词的概率在扰动下漂移高达 0.3–0.6,而公式与数字部分漂移接近 0。
把抽象的漂移统计落到具体样本上,直观展示敏感性在句子内部如何分布,帮助读者建立对信号的直觉。
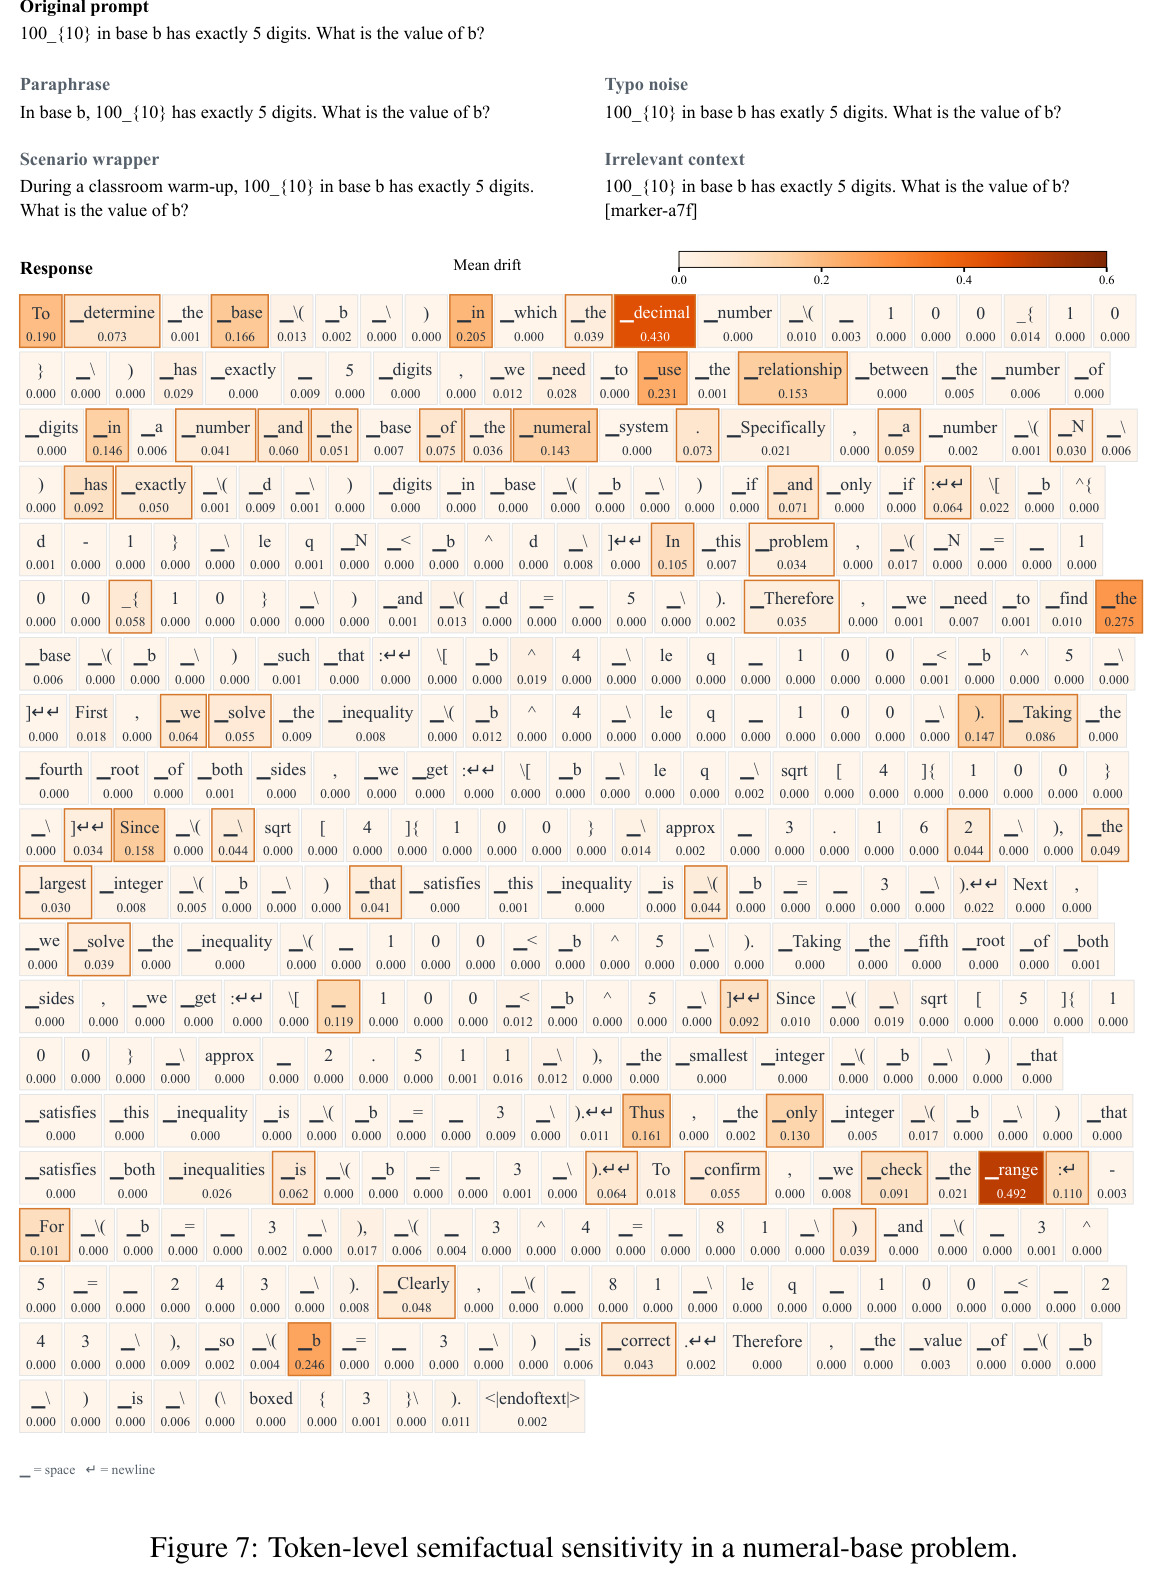
五进制位数问题案例:同样的四扰动 + 逐 token 漂移着色展示,推理主干中的过渡词与检查性短语呈现较高漂移,而 $b^4 \le 100 < b^5$ 等数学推导 token 几乎稳定。
第二个案例与 Figure 6 互为印证,说明 token 敏感性模式跨题目类型可复现,增强诊断结论的可信度。
主结果表:两个模型规模上 8 个分布内数学基准(AIME 24–26、AMC 23–25、HMMT 25–26、BRUMO 25、SMT 25、Omni-Math、Minerva、OlympiadBench)和 3 个分布外基准(NoOp-AIME、ThinkBench-AIME、GPQA-Diamond)的准确率,对比 Base、GRPO、GSPO、SAPO、CF-GRPO、FIPO、SCAPO。SCAPO 在 4B 的 6/8 项分布内和 1.7B 的 8/8 项分布内最优,三个 OOD 基准在两个规模全部最优,两项平均分均第一。
论文所有核心声明的数字依据,量化 SCAPO 相对五个 RLVR 基线的全面优势。
用 GPT-5.5 生成半事实扰动的完整 system/user prompt:核心要求包括保持数学题与答案不变、数值逐字保留、LaTeX 视为冻结文本、每种类型各生成一条;并给出 paraphrase、typo_noise、scenario_wrap、irrelevant_context 的详细正反例(如干扰串不得含任何数学事实或提示),最后附四扰动示例。
扰动质量决定信号质量,这份 prompt 是复现训练信号的核心资产,也界定了'半事实'在本文中的操作定义。