惊讶的成功与重复的失败:LLM推理中熵引导的探索信用分配 Surprising Success, Repeated Failure: Entropy-Guided Credit Assignment for Exploration in LLM Reasoning
用熵与优势符号耦合的EAPO,强化惊讶成功、纠正重复失败,保留失败响应的恢复路径
前置知识
可验证奖励的强化学习(RLVR)
用可自动验证的任务结果(如数学题最终答案对错、代码是否通过测试)作为奖励信号对大语言模型做强化学习的方法体系。奖励评估整条推理轨迹,无需人工标注每一步,已成为提升LLM推理能力的主流训练范式,代表算法包括GRPO、DAPO等。
本文的全部改进都发生在RLVR框架内:它保留结果级奖励与验证器,只重新分配token级学习信号,不了解RLVR就无法理解改进的基准设置与收益来源。
GRPO(组相对策略优化)
GRPO对每个提示采样一组$G>1$个响应,用组内奖励的标准化值作为响应优势$\hat A_i=(r_i-\text{mean})/(\text{std}+\varepsilon)$,无需价值网络;该优势被均匀赋给响应内每个token,即$\hat A_{i,t}=\hat A_i$,对所有决策一视同仁。GRPO是当前开源RLVR训练最常用的算法之一。
EAPO是GRPO的"即插即用"升级:唯一改动是把响应级优势替换为熵加权的token级优势$\hat A_{i,t}^E=\hat A_i w_{i,t}$,只有逐项理解GRPO目标才能看清改动有多小、收益从何而来。
策略熵
生成到前缀$(x,y_{i,<t})$时,策略下一个token分布的香农熵$H_{i,t}=-\sum_{v\in\mathcal V}\pi_\theta(v|x,y_{i,<t})\log\pi_\theta(v|x,y_{i,<t})$。高熵意味着多个候选延续相互竞争,常对应推理分支与探索点;低熵表示偏好集中、结论自信。它不同于只衡量单个已采样token意外程度的surprisal,刻画的是整个分布的不确定性。
熵是EAPO唯一的额外信号来源,其批级分位归一化与符号耦合加权构成本文的全部技术内容,不理解熵的含义就无法读懂式(3)(4)。
信用分配(Credit Assignment)
强化学习中决定把功劳或责任分配给哪些决策的问题。LLM推理中即判断响应内哪些token决策真正导致了最终成败。结果级奖励是稀疏的,细粒度方案通常依赖过程奖励模型、逐步价值估计或teacher/oracle条件似然等辅助信号,各有训练与工程成本。
本文标题中的credit assignment即此概念:EAPO声称以零辅助成本完成token级信用分配,这是评价其贡献大小的核心视角。
pass@k 与 avg@k
两种采样评测指标:avg@k是每题采样$k$个响应的平均准确率,衡量单次采样的可靠性;pass@k是$k$个采样中至少一个正确的概率(论文采用Chen et al. 2021的无偏估计器),衡量探索的问题覆盖上限。两者可以背离:探索能力强则pass@k高,但avg@k未必同步提升。
论文用avg@32与pass@32评测主结果,并用pass@k($k$取到256)论证探索收益,读懂这对指标才能区分"变准"与"变广"两种不同的改进。
研究动机
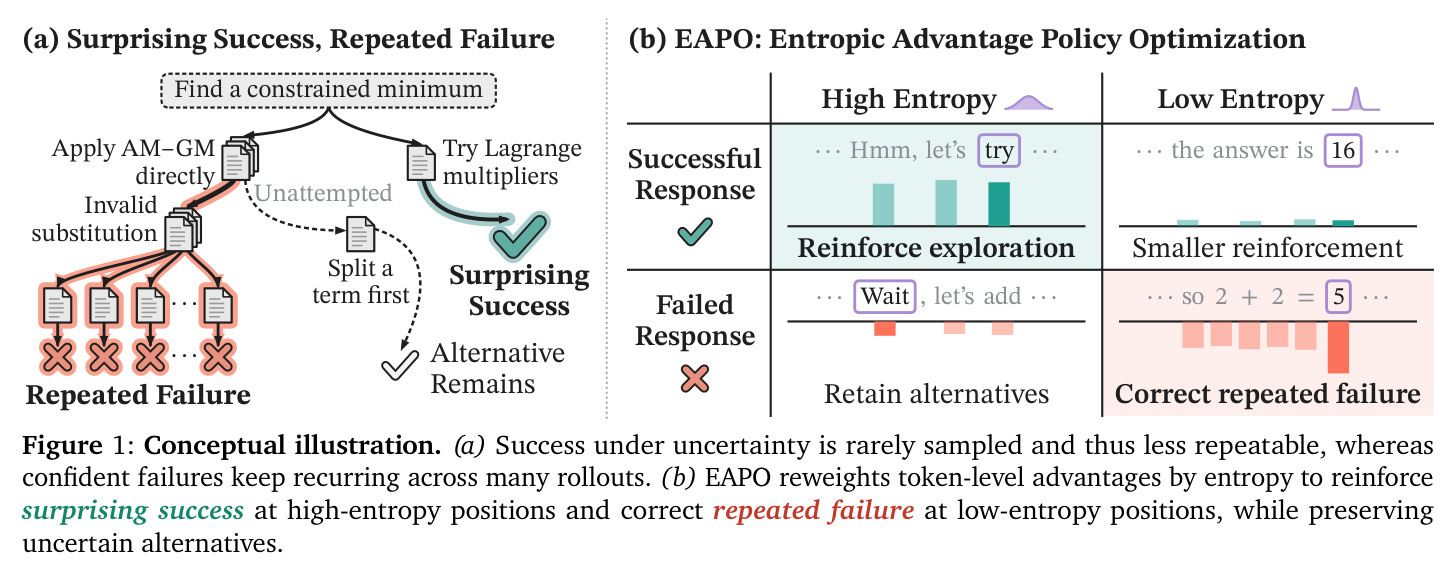
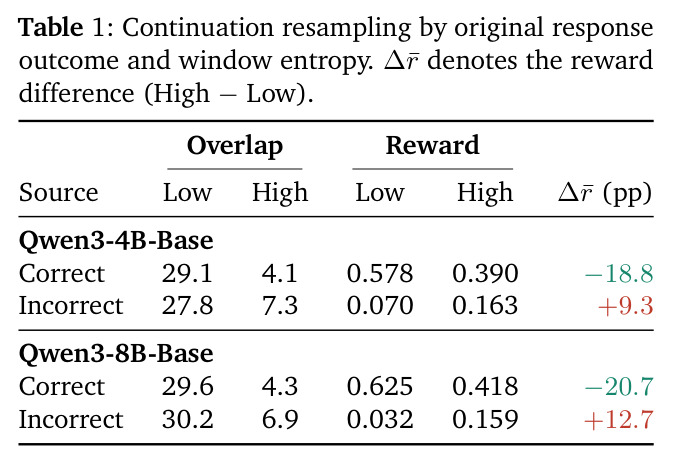
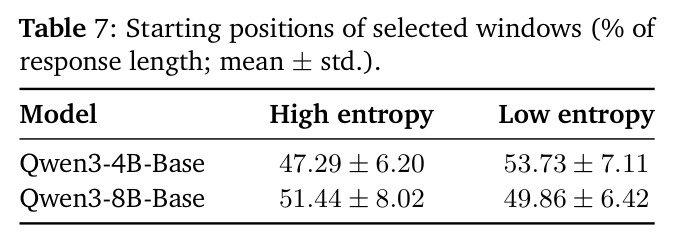
RLVR通过结果级奖励显著提升LLM推理能力,但GRPO等算法把响应级优势均匀赋给所有token,无法区分哪些决策真正导致了成败。现有细粒度信用分配方案各有代价:过程奖励模型和价值估计需要训练辅助模型,RLRT等方法依赖teacher条件似然等特权信息,某些还需额外采样。策略熵虽可从rollout策略免费获得,但已有熵基方法(EntropyAdv、HAPO、80/20)在成功与失败下以相同方式偏好高熵位置,导致失败响应中的不确定位置承受最强惩罚——而这些位置本可能经替代推理路径恢复成功。作者用重采样实验量化这一现象:Qwen3-4B-Base上,正确响应从高熵窗口重采样64个续写的答案准确率仅0.390,远低于低熵窗口的0.578(-18.8pp),说明高熵下的成功难以复现;错误响应从高熵窗口重采样反而得0.163,高于低熵窗口的0.070(+9.3pp),说明自信的低熵错误反复出现、失败响应仍保留替代成功路径。词频分析佐证:正确响应高熵位置富集"let's""consider"等探索表达,错误响应低熵位置富集"finally""confirm"等结论标记。
本文的目标是本文的目标是设计一种token级信用分配方法,把三个来自实证观察的原则编码进学习信号:对成功响应中的高熵决策给予更强强化,使"惊讶的成功"固化为可复现的行为;对失败响应中的低熵决策给予更强惩罚,纠正反复出现的自信错误;同时衰减失败响应中不确定位置的惩罚,为其保留替代推理路径和恢复机会。约束条件同样明确:整个机制只能使用策略自身的熵和已有rollout信号,不引入辅助模型、额外采样或特权信息,也无可观的额外计算开销;改动应当能直接插入现有RLVR流水线(以GRPO为基座,仅替换优势项),并在数学、逻辑、算法等多类推理任务上、在base与reasoning两类骨干上同时提升平均准确率(avg@k)与问题覆盖(pass@k),最终在保持训练稳定的前提下超越已有探索导向方法。
与已有工作不同的是,本文的独特切入是对"不确定性应当如何在强化与惩罚间发挥作用"这一问题的质疑。已有方法隐含地假设熵偏好与结果符号无关:EntropyAdv向优势加非负熵项、HAPO做有界的保号熵调整、80/20只更新熵最高的20% token,它们都在正负反馈下同样强调高熵位置。作者反过来提出非对称原则——成功下的高熵是尚未固化为稳定偏好的探索路径,应加强化;失败下的低熵是反复复发的自信错误,应强惩罚;失败下的高熵仍有竞争性备选,应减弱惩罚以免堵死恢复路径。实现上通过"符号-熵耦合":把归一化熵与优势符号相乘得到带符号不确定度$\text{sign}(\hat A_i)h_{i,t}$,用指数加权将响应优势在token间重分配,从而在强化与惩罚之间反转熵偏好。另一区别在于EAPO是"重分配"而非"加性调整":权重除以响应内均值保证优势均值不变、只改变分布形状,因此不需要抬高平均熵就能促进探索。
核心方法
方法直觉:同样的不确定性在成功和失败里含义不同。成功轨迹中的高熵决策是"没有稳定偏好却碰对了路"的探索,加强化能让成功探索可复现;失败轨迹中的低熵决策是"自信地走向同一个错误",强惩罚能阻止其复发;失败轨迹中的高熵位置仍有多个竞争延续,集中惩罚会把概率推向已偏好的延续、堵死恢复路径。技术上EAPO在GRPO之上做两步改造。第一步熵归一化:在旧策略下计算每个有效完成位置的香农熵$H_{i,t}$,用rollout批的第10/90百分位$Q_{lo},Q_{hi}$归一并裁剪:$h_{i,t}=\text{stopgrad}\,\text{clip}\big[\frac{H_{i,t}-Q_{lo}}{Q_{hi}-Q_{lo}+\varepsilon_H},0,1\big]$,stopgrad保证熵只是脱离梯度的信用信号。第二步非对称重加权:以带符号不确定度构造指数权重$w_{i,t}\propto\exp(\kappa\,\text{sign}(\hat A_i)h_{i,t})$(除以响应内均值),令$\hat A_{i,t}^E=\hat A_i w_{i,t}$替换原目标中的$\hat A_i$,其余流程不变——正优势时高熵token权重大,负优势时反转。默认$\kappa=\log 4$。
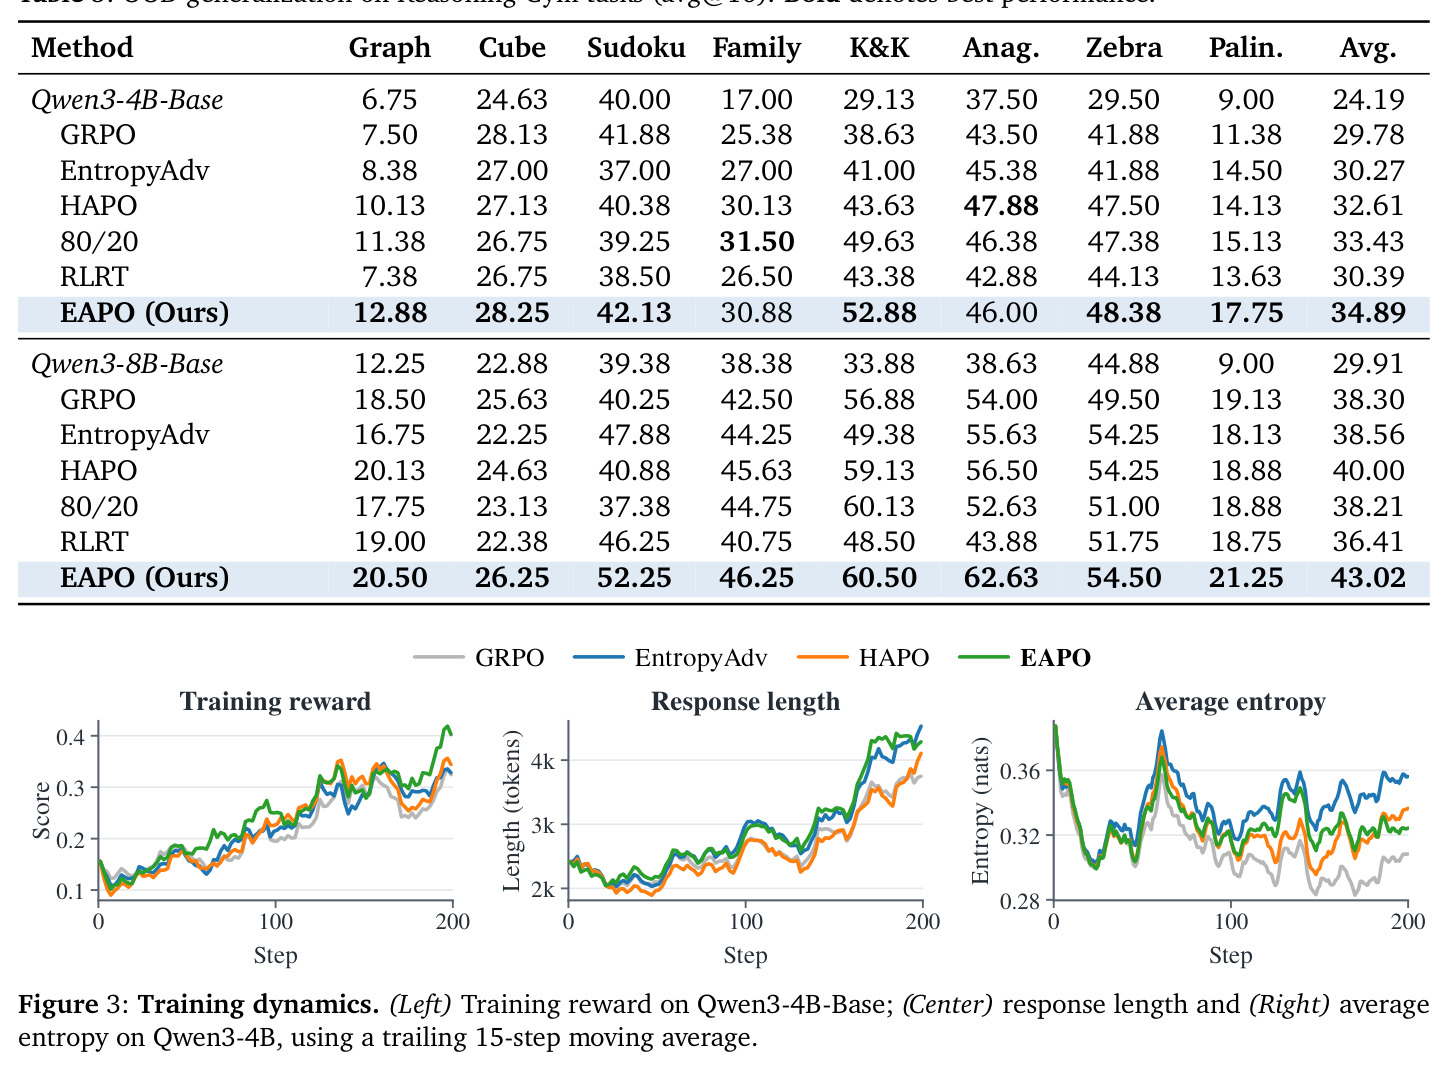
核心创新是"符号-熵耦合的响应内优势重分配",与已有方法的本质区别有三。其一,方向性由优势符号决定:正优势时$\kappa>0$的指数加权偏好高熵token,负优势时自动反转、偏好低熵token,响应内任意两个权重之比不超过$e^\kappa$,把"强化惊讶成功、惩罚重复失败"直接写进目标函数,而EntropyAdv/HAPO/80/20在正负反馈下熵偏好一致。其二,重分配而非缩放:权重除以响应内均值,保证优势均值不变、只改变token间分布,避免加性熵项带来的熵膨胀——训练结束时EAPO平均熵低于EntropyAdv/HAPO却更会探索,说明高平均熵并非有效探索的前提。其三,理论支撑:命题1证明式(4)是把KL锚定从策略空间迁移到token信用空间的唯一解(以均匀信用$u_{i,t}=1/T_i$为参考、带符号不确定度为效用,$\kappa\to 0$退化为均匀信用即GRPO);命题2表明负优势的单步logit更新会压低已采样token概率,使未选token分布的熵单调不增、KL散度单调不减,即惩罚越强分布越向已有偏好集中,为在不确定位置衰减惩罚提供形式化依据。
方法步骤详情
流程五步。第一步,rollout与响应优势:对每个提示采样$G>1$个响应,验证器打分$r_i$,按GRPO计算组内标准化优势$\hat A_i=(r_i-\text{mean})/(\text{std}+\varepsilon)$。第二步,熵计算:对响应中排除prompt与padding的有效位置集$\mathcal I_i$($T_i=|\mathcal I_i|$),在旧策略下计算香农熵$H_{i,t}$。第三步,批级归一化:收集整个rollout批的有效完成token熵,取第10/90百分位$Q_{lo},Q_{hi}$,按式(3)线性归一并裁剪到$[0,1]$得到$h_{i,t}$,加stopgrad阻断梯度。第四步,非对称加权:按式(4)计算$w_{i,t}=\exp(\kappa\,\text{sign}(\hat A_i)h_{i,t})$再除以响应内均值——正优势时高熵token权重大、负优势时低熵token权重大,响应内权重比不超过$e^\kappa$;令$\hat A_{i,t}^E=\hat A_i w_{i,t}$,正权重保持优势符号。第五步,策略更新:在原始目标中用$\hat A_{i,t}^E$替换$\hat A_i$,其余(裁剪、KL正则等)不变。方法只有超参$\kappa$($\kappa=\log K$时响应内权重比上限为$K$),默认$\kappa=\log 4$。
技术新颖性
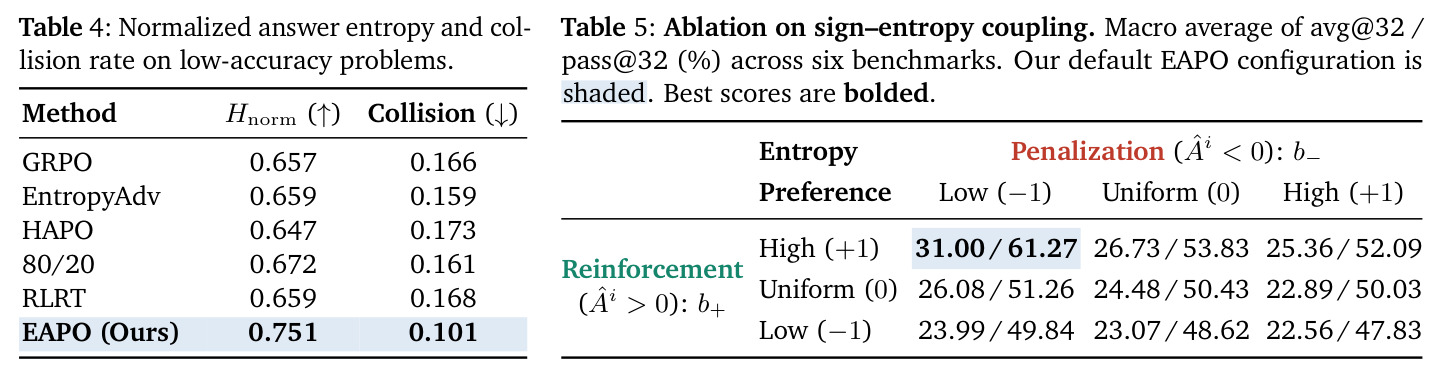
新颖性可从四个角度评估。信号成本:EAPO的token级信用完全来自策略自身熵与现有rollout优势,无需过程奖励模型、价值网络、teacher/oracle条件似然或额外前向采样,对比RLRT等需要特权信息的方法是实质性简化,一行改动即可接入现有管线。机制设计:9种符号组合消融(表5)显示$(b_+,b_-)=(+1,-1)$以31.00% avg@32显著最优,比均匀信用$(0,0)$的24.48%高6.52个百分点;固定高熵强化$b_+=+1$后,把惩罚方向从高熵(25.36%)转到低熵(31.00%)再涨5.64个百分点——证明"偏好反转"本身、而非单纯使用熵,才是收益来源。与加性方法的本质差异:EAPO保持响应内优势均值,训练后期熵低于EntropyAdv/HAPO,却取得更高的pass@k与答案多样性(表4中归一化熵0.751对0.647–0.672),重新界定了"熵-探索"关系。理论贡献:KL正则化信用分配的命题1给出权重的变分刻画,命题2的单步分析把"惩罚衰减"与"避免未选分布坍缩"联系起来,为经验设计提供了可解释框架,这在熵基探索方法中并不多见。
实验结果
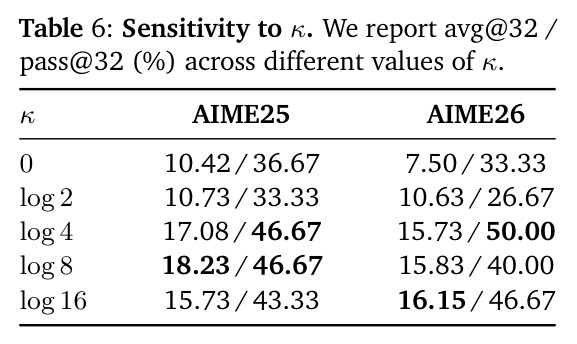
主实验(表2):六个竞赛级数学基准(AIME24/25/26、HMMT26、AMC23、MATH500-H)上以avg@32/pass@32评测。Qwen3-4B-Base上EAPO宏平均avg@32达31.0%,领先最强熵基方法EntropyAdv(25.4%)5.6个百分点、六基准全第一(如AIME24为20.2/53.3,GRPO仅12.5/33.3);Qwen3-8B-Base宏平均34.0%,超80/20(29.7%)4.3个百分点,且不需特权信息即超过RLRT。推理骨干同样领先:Qwen3-4B宏平均72.4%、Olmo-3-7B-Think-DPO达74.3%。OOD泛化(表3):Reasoning Gym八项任务上4B-Base平均34.89%(超80/20约1.46pp),8B-Base达43.02%(超HAPO 3.02pp)。探索分析(图4):AIME26上pass@k从1到256全程最高,$k=256$时多解一条基线全错的题;难题答案多样性显著更高(表4:归一化熵0.751、碰撞率0.101,其余方法0.647–0.672/0.159–0.173);认知标记词(如wait)频率六基准全部最高。消融(表5、6):$(+1,-1)$最优(31.00/61.27),比均匀信用高6.52pp;$\kappa=\log 4$默认,$\kappa=0$退化为GRPO水平(10.42/36.67)。训练动态(图3):奖励更高、响应变长、最终熵低于EntropyAdv/HAPO——高熵并非探索前提。
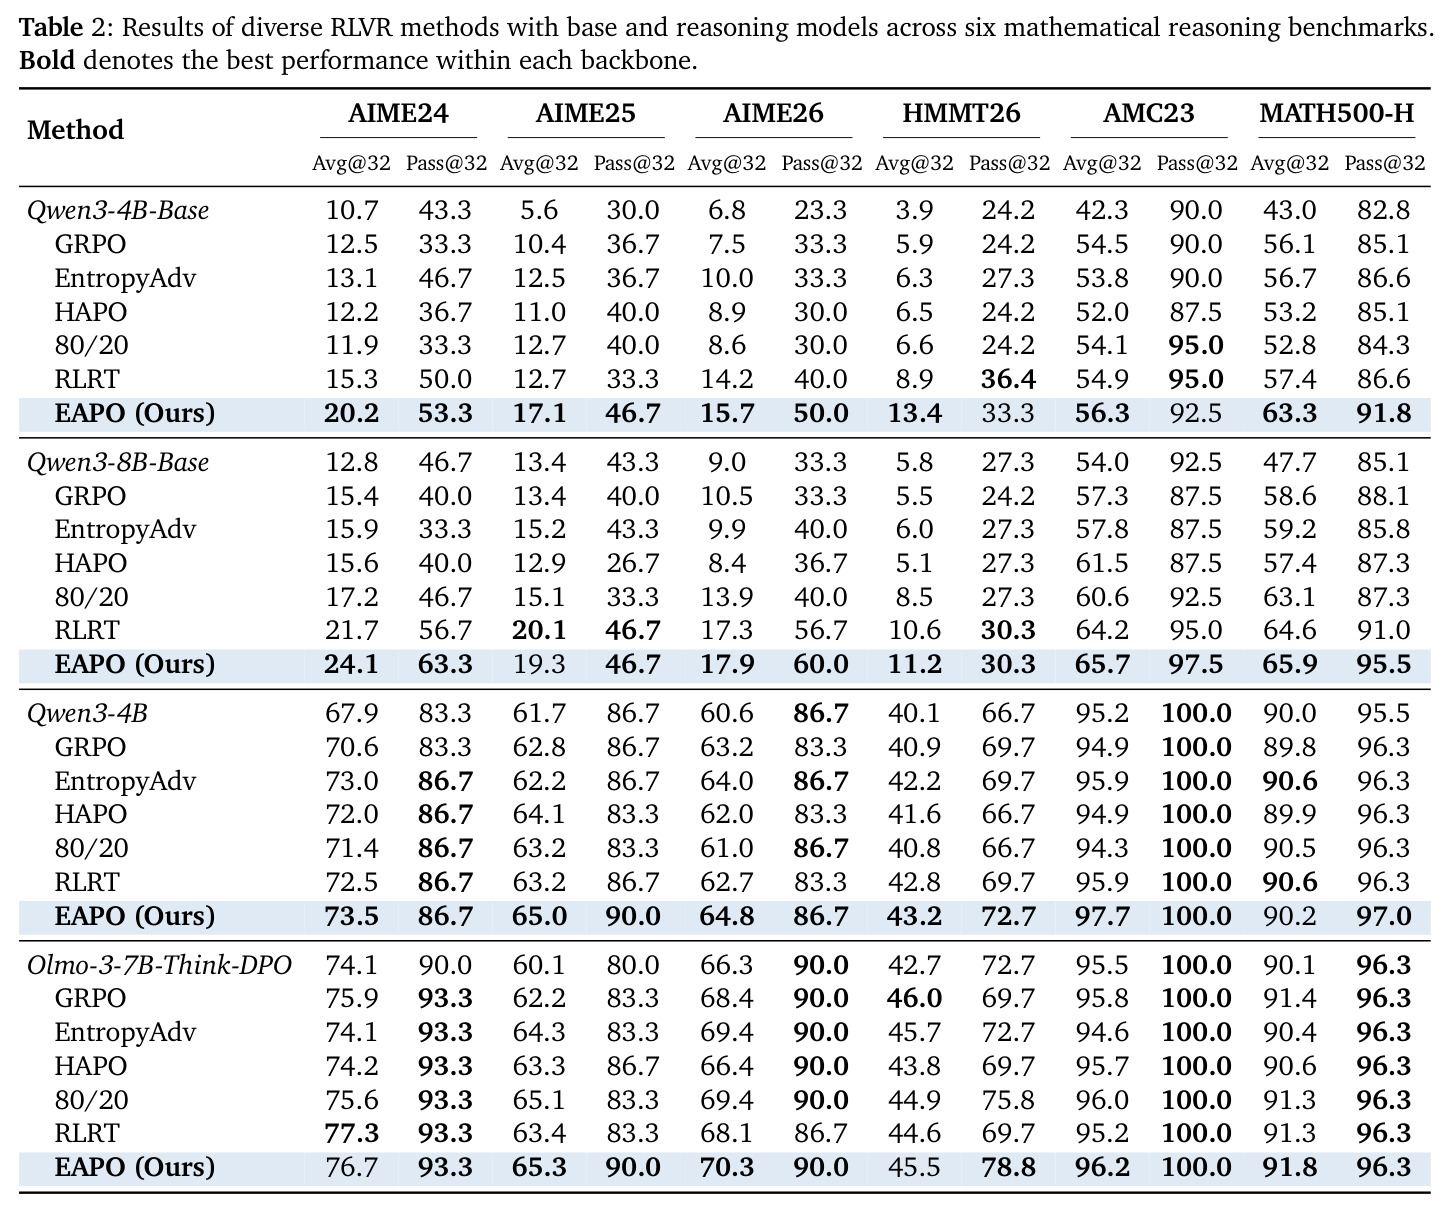
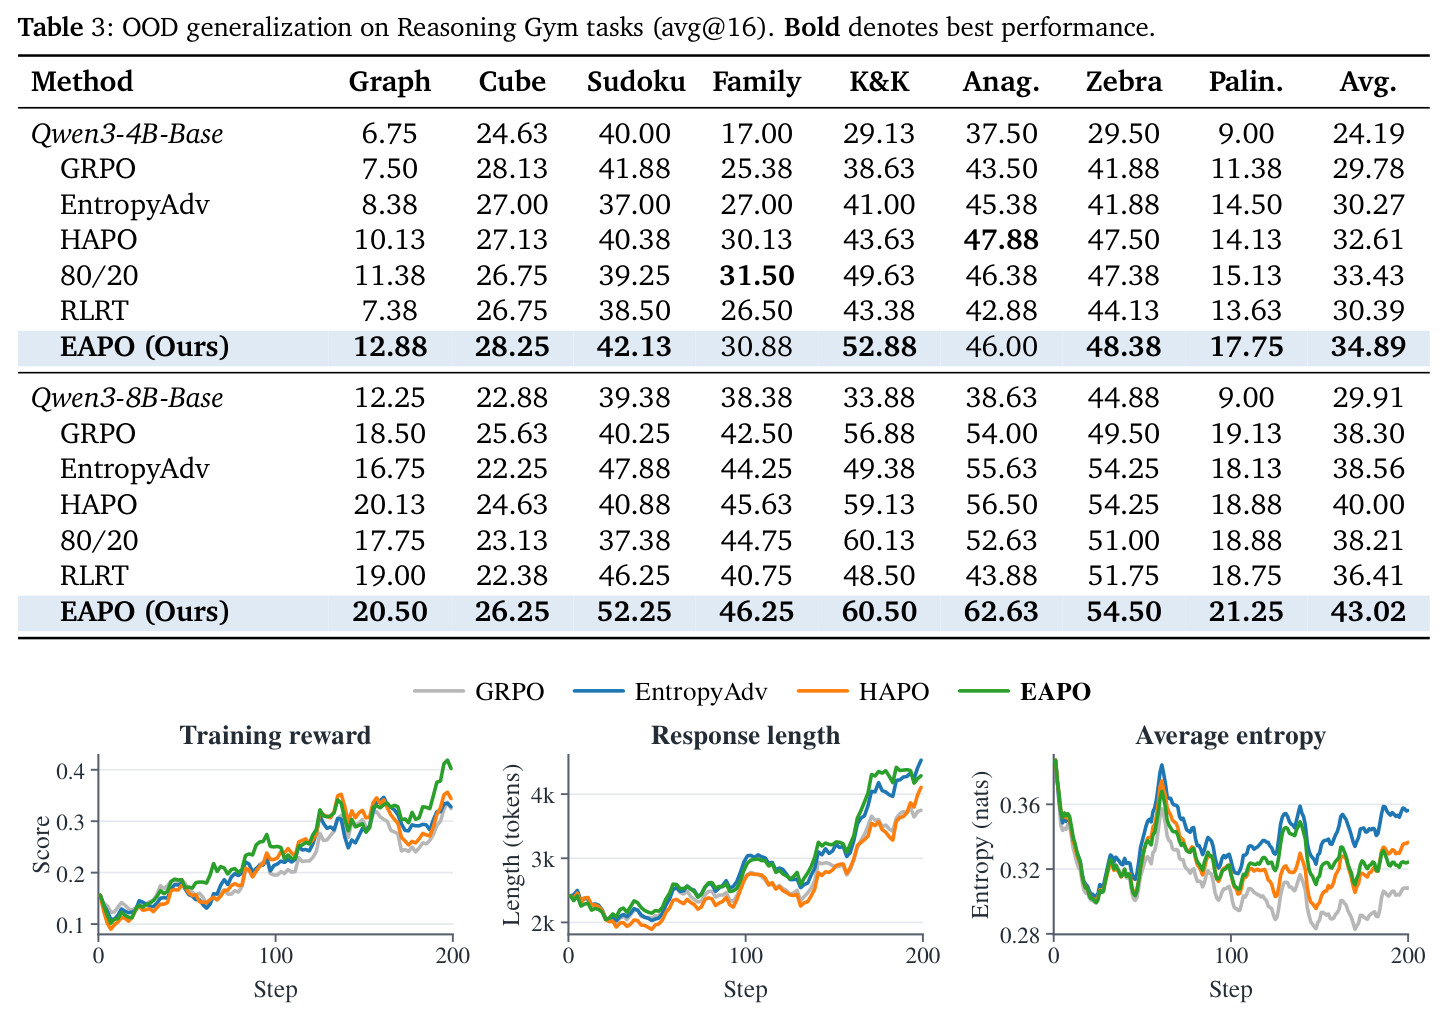
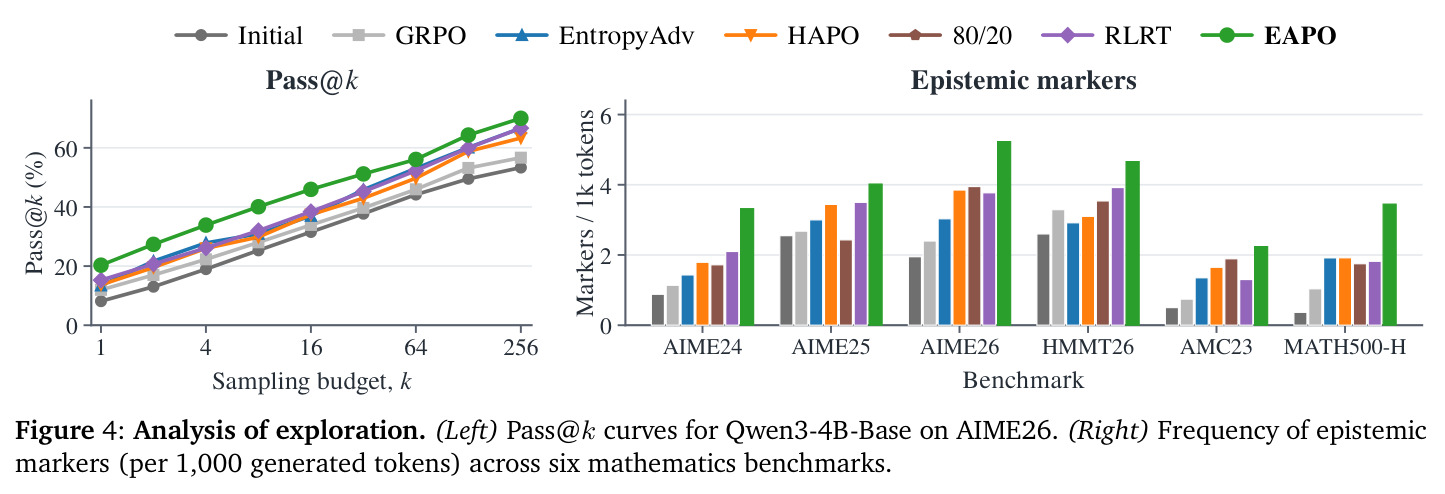
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六大数学基准宏平均(Qwen3-4B-Base) | avg@32 | 31.0% | EntropyAdv 25.4%(GRPO 24.5%) | +5.6个百分点 |
| 六大数学基准宏平均(Qwen3-8B-Base) | avg@32 | 34.0% | 80/20 29.7% | +4.3个百分点 |
| AIME24(Qwen3-4B-Base) | avg@32 / pass@32 | 20.2 / 53.3 | GRPO 12.5 / 33.3 | +7.7 / +20.0 |
| AIME26(Qwen3-4B-Base) | avg@32 / pass@32 | 15.7 / 50.0 | GRPO 7.5 / 33.3 | +8.2 / +16.7 |
| 推理骨干Qwen3-4B六基准宏平均 | avg@32 | 72.4% | EntropyAdv约71.3% | +1.1个百分点 |
| Reasoning Gym 8项OOD任务平均(Qwen3-4B-Base) | avg@16 | 34.89% | 80/20 33.43% | +1.46个百分点 |
| Reasoning Gym 8项OOD任务平均(Qwen3-8B-Base) | avg@16 | 43.02% | HAPO 40.00% | +3.02个百分点 |
| 难题答案多样性(初始avg@32≤25%的题目) | 归一化答案熵↑ / 碰撞率↓ | 0.751 / 0.101 | EntropyAdv 0.659 / 0.159(最佳熵为80/20的0.672) | 熵+0.079以上、碰撞率−0.058以下 |
局限与改进
作者承认的局限有二。其一,熵信号反映的是模型已学到的偏好与自信度,因此信用分配对模型既有偏差敏感——如果模型的不确定性与各决策对最终结果的真实贡献不对齐,重加权可能强化错误的探索方向。其二,机制分析聚焦于给定推理状态下的替代续写,尚未探索跨状态、跨轨迹的发现组合与复用。我自己的观察补充几点:在强推理骨干上收益明显收窄(Qwen3-4B宏平均72.4%对EntropyAdv约71.3%,仅+1.1pp;Olmo-3-7B约74.3%对约73.1%,+1.2pp),说明熵的探索价值随模型成熟度衰减;$\kappa$过大会牺牲训练稳定性(表6中$\kappa=\log 16$时AIME25回落到15.73/43.33),存在集中度-稳定性权衡需手工调节;批级10/90分位归一化对响应长度与题目难度构成敏感,论文未做消融;此外EAPO与熵基方法一样使响应变长,推理成本上升;评测以数学为主,Reasoning Gym的OOD验证规模也有限(8个任务、avg@16)。
独立分析的弱点
独立分析出的弱点及改进方向:(1)结果级二值优势驱动所有token重加权——失败响应中早期正确的低熵推理也会被强惩罚,可能破坏原本有效的推理链,可引入部分过程信号(如答案位置遮蔽、前缀续写探测)或与轻量过程奖励模型互补,只在错误决策附近集中惩罚。(2)熵作为不确定性度量在校准较差的模型上可能失真,尤其推理骨干经蒸馏后熵偏低且与真实能力脱节,可用答案分布熵、语义聚类多样性或自洽性波动替代或混合原始token熵。(3)归一化分位(10/90)与$\kappa$均为全局固定超参,不同训练阶段最优值不同(大$\kappa$早期收敛快、后期不稳),可设计$\kappa$退火或按题目难度分桶自适应。(4)pass@256才多解一题说明极难题的覆盖增益来自长尾,avg@32(单次可靠度)提升相对温和,若应用只关心一次通过率则收益有限,可结合测试时验证器过滤与选择性重采样放大探索收益。(5)响应变长带来推理成本上升,可加入长度感知的惩罚或效率正则加以平衡。
未来方向
作者提出的方向:将探索扩展到迭代式科学发现场景——维持多样化候选解并迭代复用、组合其中有用的成分来生成新假设与算法(受FunSearch、AlphaEvolve类工作如Novikov et al. 2025、Gottweis et al. 2026启发),研究EAPO式探索如何与跨轨迹的发现组合机制结合。基于本文成果可延伸的方向:(1)$\kappa$调度——早期用大$\kappa$加速探索、后期退火到小$\kappa$稳定收敛,呼应表6揭示的集中度-稳定性权衡;(2)与过程奖励/价值估计结合的分层信用分配,把符号-熵耦合从响应级二值符号推广到部分轨迹信号,避免惩罚早期正确决策;(3)在agentic任务(工具调用、检索、多轮对话)上验证,这类任务中"保留替代路径"的价值更突出;(4)熵校准研究——探究RLVR训练中熵与能力的错配如何影响探索类方法,设计校准后的不确定性信号;(5)跨状态/跨轨迹探索,如树搜索式分支与EAPO权重结合,或对多样候选做显式的组合学习。
复现评估
复现评估:方法实现门槛低——在GRPO训练循环中增加熵计算、批级分位归一化与指数加权约几十行代码即可,唯一超参$\kappa=\log 4$,无辅助模型或额外采样。训练与评测资源均公开:训练集DAPO-Math-17k-Processed、骨干模型Qwen3-4B/8B-Base、Qwen3-4B、Olmo-3-7B-Think-DPO、六个数学基准与Reasoning Gym都是公开资源;项目页eapo-explore.github.io提供补充材料。不确定因素:正文未明确给出开源代码仓库与训练算力规模(GPU数量、训练时长、最大序列长度等实现细节位于附录B,需按DAPO-style配置自行对齐),4B/8B规模的GRPO级RLVR训练通常需要数十张高端GPU,个人研究者难以完整复现主表;但方法思想可在1.5B级小模型与小规模数学集上低成本验证。综合判断:算法复现难度低,训练复现难度中高,核心风险在DAPO配置细节与超参敏感性。
论文图表
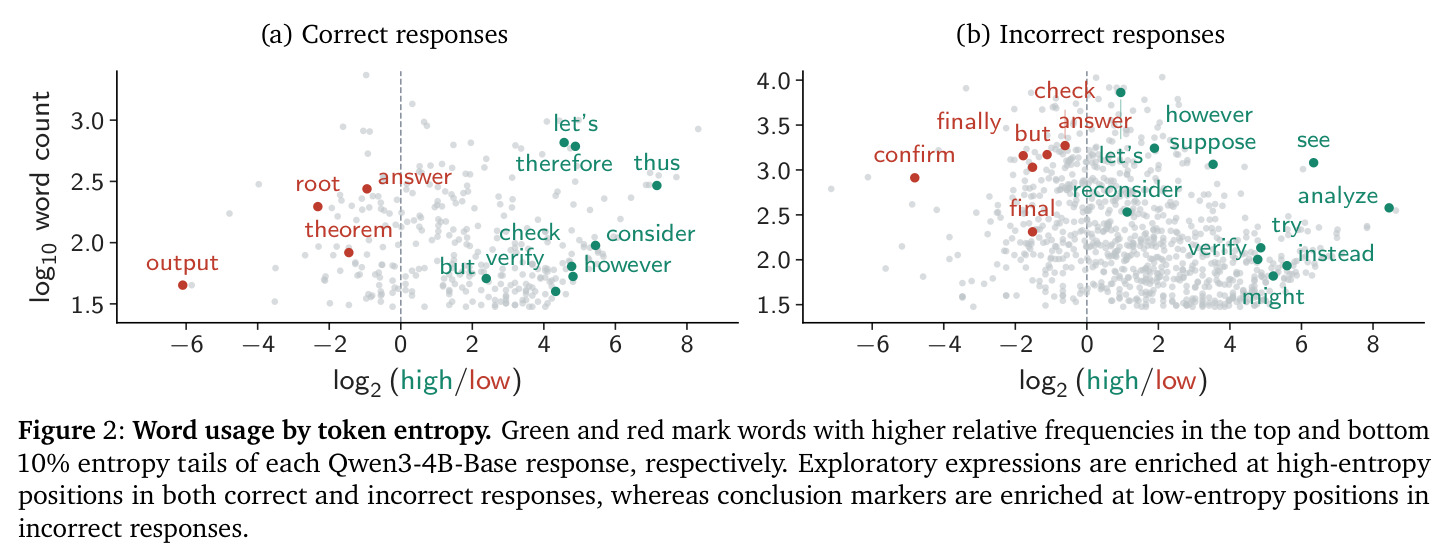
对2376条Qwen3-4B-Base数学响应,比较每条响应内熵最高10%与最低10%位置的归一化词频。绿色标记高熵尾部更常见的词(探索性表达如let's、consider、try、instead),红色标记低熵尾部富集的词。正确响应的高熵位置富集探索性表达;错误响应的低熵位置富集finally、confirm、therefore等结论标记,而错误响应的高熵位置也出现try、instead等探索词,说明失败响应仍保留替代路径。
用语言层面的证据支撑"惊讶成功来自尚未固化的探索、重复失败来自自信错误"这一核心实证观察,是引出非对称方法设计的关键一环。