ShieldVLA:面向视觉-语言-动作模型的可行性感知安全对齐 ShieldVLA: Feasibility-Aware Safety Alignment for Vision-Language-Action Models
用HJ可达性安全critic门控VLA微调,VLM rubric自动生成逐步安全标签
前置知识
VLA(Vision-Language-Action)模型
以视觉观测和自然语言指令为输入、直接输出机器人动作的通用策略模型,如 RT-2、OpenVLA、Octo。它们通过网络级视觉-语言预训练获得广泛泛化能力,再在下游机器人数据上微调,是当前机器人基础模型的主流范式。
本文的微调对象就是 VLA,实验覆盖 OmniVLA、SPOC-VLA、OpenVLA-OFT 三个骨干,理解其预训练+微调的使用方式是读懂实验设置的前提。
CMDP(约束马尔可夫决策过程)与拉格朗日松弛
在标准 MDP 上附加代价函数 $c(s)$ 与预算 $d$,要求期望累计代价 $\mathbb{E}[\sum_t \gamma^t c(s_t)] \le d$。经典解法是拉格朗日松弛:引入对偶变量 $\lambda$ 把约束并入奖励,形成 $\min_{\lambda\ge0}\max_\pi$ 的鞍点问题。缺点是对偶变量动力学振荡、只保证约束在期望意义上软成立。
SafeVLA 等现有安全微调方法正是这条路线,论文的全部动机批判和对照基线都建立在理解拉格朗日方法的软约束缺陷之上。
Hamilton-Jacobi(HJ)可达性
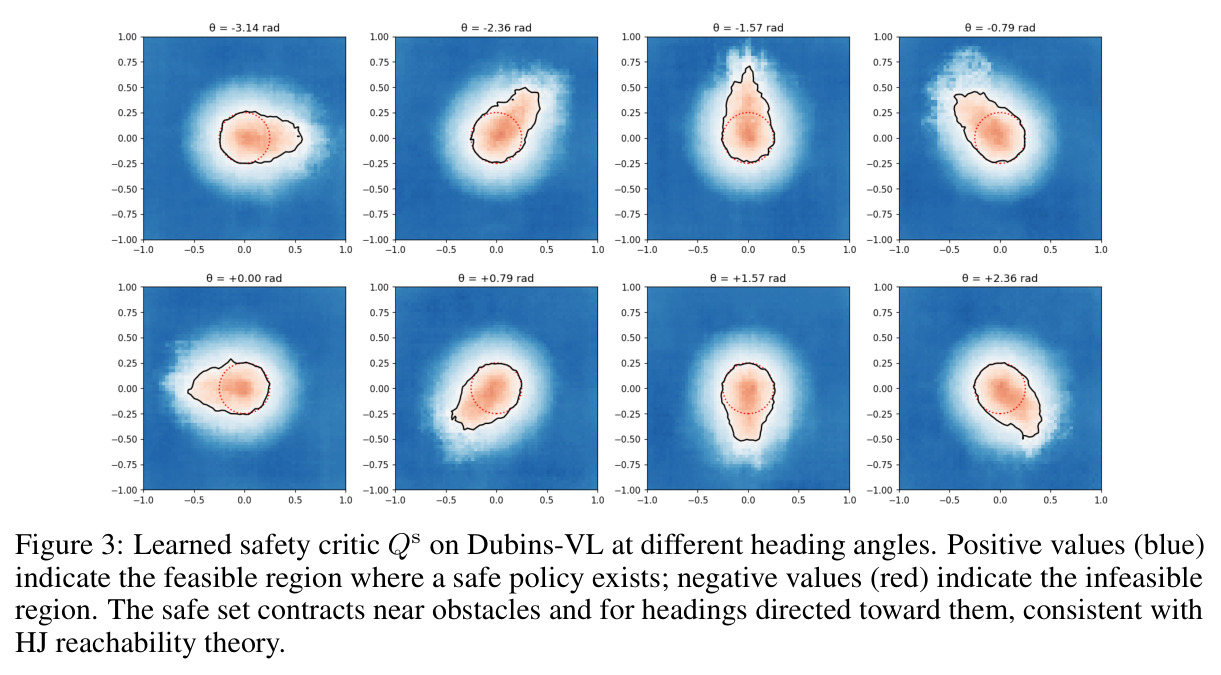
控制论中刻画'安全集'的工具:值函数 $V^s(s) = \max_\pi \min_{t\ge0} \gamma^t \ell(s_t)$ 追踪最坏情形下的折扣安全边际,$V^s(s)\ge0$ 表示存在策略能无限期维持安全,$V^s<0$ 表示任何策略终将违规。Fisac et al. 2019 证明它可通过模型无关的安全贝尔曼算子做 TD 学习,且该算子是 $\gamma$-压缩。
ShieldVLA 的安全 critic 就是学这个值函数,min 备份带来的'可行性认证'语义是门控机制区别于软惩罚的理论根基。
PPO 与确定性策略梯度
PPO 是裁剪代理目标的策略梯度算法,配合 GAE 优势估计与 KL 信任域,是 VLA 微调的标准选择;确定性策略梯度则对固定均值动作 $\bar{a}_\theta(o)$ 计算值函数梯度 $\nabla_a Q \cdot \nabla_\theta \bar{a}_\theta$,把动作沿提升值函数的方向推。
本文在可行状态用标准 PPO、在不可行状态用 $-Q_s$ 的确定性策略梯度做恢复,两种梯度的切换逻辑就是门控目标函数的全部内容。
Rubric-based VLM 评分(LLM-as-a-Judge 的结构化变体)
不让 VLM 自由打分,而是把评估拆成若干条锚定的结构化判据(rubric),每条独立在 $[0,1]$ 量表上评分后加权汇总。研究表明结构化加权判据比原始 VLM 打分校准得多,已用于 LLM 后训练的奖励建模。
论文用它解决'视觉域缺少逐步安全标注'的监督难题,是安全 critic 的标签来源,不读懂这个就无法理解 $\ell(o)$ 从何而来。
研究动机
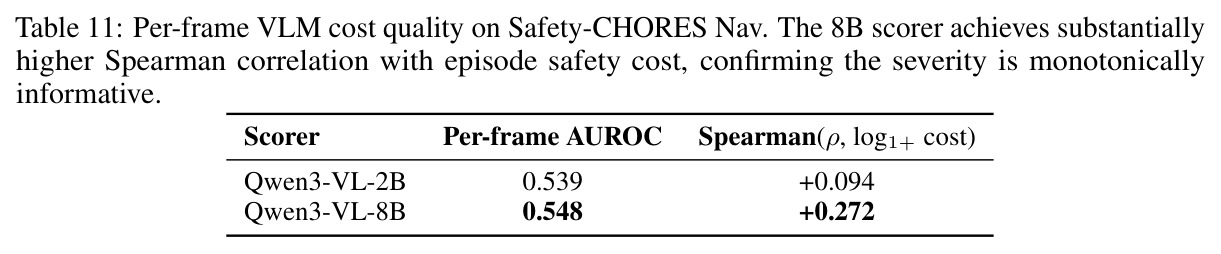
VLA 模型(RT-2、OpenVLA、Octo 等)凭借大规模视觉-语言预训练获得强泛化能力,但其训练管线只优化任务性能,没有任何安全约束机制。在家庭操作、工业装配、导航等安全攸关场景,一次碰撞、一次进入危险区域或一次力超限就可能导致不可逆失败。现有的安全对齐方法以 SafeVLA 为代表,把问题建成约束马尔可夫决策过程(CMDP)后做拉格朗日松弛:$\min_{\lambda\ge0}\max_\pi \mathbb{E}[\sum_t \gamma^t(r - \lambda c)] + \lambda d$,对期望累计代价施加软惩罚。这在实践中暴露两个具体问题:其一,约束只在期望意义上软化执行,对偶变量动力学振荡、超参敏感,个别关键轨迹仍会违规——论文实验中 SafeVLA 在 TurtleBot-Nav 上累计安全代价(CSC)高达 14.6,Franka-Reach 上 13.4;其二,在整个优化过程中全局惩罚安全代价会引入持续的奖励-代价权衡,把策略推向过度保守,在长时程机器人任务中尤其有害。此外还有监督难题:学习安全性需要逐步(per-step)的安全标注,但视觉域中密集的逐步代价标签几乎不存在,而 VLM 的自由文本打分噪声大、不一致,无法支撑稳定的策略优化。
本文的目标是论文的正式目标是:给定预训练 VLA 策略 $\pi_\theta(a|o,l)$(输入视觉观测 $o$ 与语言指令 $l$)、任务奖励 $r$ 和安全规约 $\ell$,在不需要显式动力学模型的前提下微调 $\pi_\theta$,使其在最大化任务奖励的同时最小化轨迹级约束违规。作者把这个目标拆成两个必须同时解决的具体子问题:第一,HJ 安全贝尔曼方程需要在每个访问状态上的边际标签 $\ell(s)$,但为高维视觉观测手工构造这类边际不现实,必须找到从原始 RGB 帧加每回合一个二值安全标签('这轮有没有发生不安全事件')自动产生逐步安全估计的方法;第二,即便训练出了安全 critic $Q_s$,也要决定如何在策略优化中消费它的输出,且不能重新引入拉格朗日方法那种耦合的 min-max 动力学。最终的成功标准是在五个导航与操作基准上同时提高成功率(SR)并降低累计安全代价(CSC),形成对最强已发表基线 SafeVLA 的 Pareto 支配,并且部署时是单个 VLA、测试期零 VLM 调用、无运行时 shield。
与已有工作不同的是,本文的独特切入角度是把安全性从'全局奖励-代价权衡'重构为'状态依赖的可行性问题',理论工具借用控制论的 Hamilton-Jacobi 可达性。HJ 可达性用值函数 $V^s(s) = \max_\pi \min_{t\ge0} \gamma^t \ell(s_t)$ 刻画安全集——即从哪些状态出发可以无限期保持安全:$V^s(s)\ge0$ 表示存在策略永远维持边际非负,$V^s<0$ 表示任何策略最终都会违规。这与 CMDP 有本质语义差异:前者判定'能否安全继续',后者只惩罚'已经付出多少代价'。与已有工作相比有两点关键区隔:其一,先前把 CBF 或 HJ 与视觉结合的工作(VisionCBF 等)只把形式化方法当作固定预训练策略之上的运行时过滤器,不参与任务奖励优化;SafeVLA 则把约束压进拉格朗日对偶。ShieldVLA 是首个把模型无关 HJ 可达性 critic 用于基础模型微调的工作——用学到的 critic 门控训练目标,把安全干预限定在 critic 判定不可行的状态。其二,作者把 LLM 后训练中的 rubric-based reward modeling 范式移植到安全监督,把嘈杂的自由打分转化为稳定的逐步代价标签,解决视觉安全学习的可扩展监督问题。
核心方法
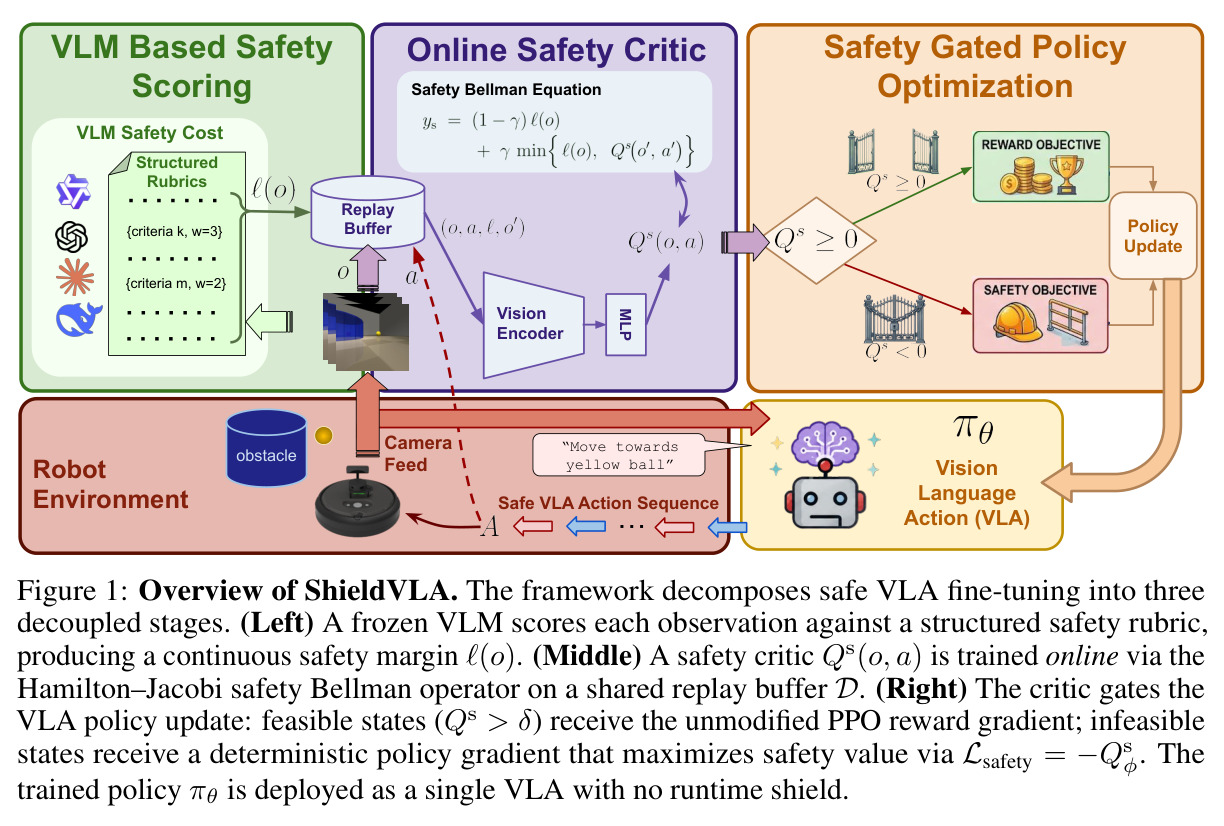
直觉上,ShieldVLA 让一个'安全评论家'判断当前状态-动作对是否仍在可行安全区内:可行时策略只管做任务,不可行时只管恢复安全,两条梯度通路互不污染。技术上分三个解耦阶段(Figure 1)。第一阶段,VLM 安全评分:冻结的 Qwen3-VL-8B 按 K 条结构化 rubric 给每帧独立打 $[0,1]$ 分,加权得严重度 $\rho(o_t) = \sum_k w_k V(o_t,c_k)$,再用每回合二值安全标签做 Platt 校准得到逐步边际 $\hat{\ell}(o_t) = -(a\rho(o_t)+b)$。第二阶段,在线安全 critic:$Q_s^\phi(o,a)$ 在共享回放缓冲区上用 HJ 安全贝尔曼算子 $T_sQ(o,a) = (1-\gamma)\ell(o) + \gamma\min\{\ell(o), \mathbb{E}_{o'}\max_{a'}Q(o',a')\}$ 做离策略 TD 学习,该算子是 $\gamma$-压缩、有唯一不动点,min 备份保证最坏情形可行性语义。第三阶段,安全门控策略优化:可行性指示 $\zeta_\theta(o) = \mathbf{1}[Q_s^\phi(o,\bar{a}_\theta(o)) > \delta]$ 作硬门,可行状态走标准 PPO 裁剪代理目标,不可行状态走 $\mathcal{L}_{safety} = -Q_s^\phi(o,\bar{a}_\theta(o))$ 的确定性策略梯度,强度 $\beta_t$ 由对代价预算的对偶上升更新。部署时是单个 VLA,测试期零 VLM 调用、无 shield。
核心创新是'可行性门控'取代拉格朗日软惩罚,本质区别在梯度路由方式。拉格朗日方法在每个状态都把 $-\lambda c$ 混入奖励梯度,造成持续保守偏置和对偶振荡;ShieldVLA 的门 $\zeta_\theta$ 是 $Q_s^\phi$ 的确定性函数:可行区域内安全惩罚精确为零,$\nabla_\theta\mathcal{L}_{gate} = \nabla_\theta\mathcal{L}_{reward}$ 与无约束 PPO 完全一致;不可行区域内奖励信号精确为零,$\nabla_\theta\mathcal{L}_{gate} = -\beta_t\, \nabla_a Q_s^\phi(o,a)|_{a=\bar{a}_\theta(o)} \nabla_\theta \bar{a}_\theta(o)$,策略沿 critic 梯度在安全流形 $\{a: Q_s^\phi(o,a)\ge0\}$ 内寻找仍保留任务进展的动作,无需单独恢复策略。支撑这一切的是 HJ 贝尔曼备份 $\min\{\ell(o), \max_{a'}Q_s(o',a')\}$:它不是加性代价累积,而是最坏情形折扣边际,因此 $Q_s(o,a)\ge0$ 当且仅当存在后续策略无限期维持安全——这是认证语义而非惩罚语义。消融(Table 5)证明收益确实来自门:同一 critic 改用拉格朗日惩罚后 TurtleBot-Nav 的 SR 从 0.54 跌至 0.33、CSC 从 6.90 恶化到 7.80,两轴同时变差。
方法步骤详情
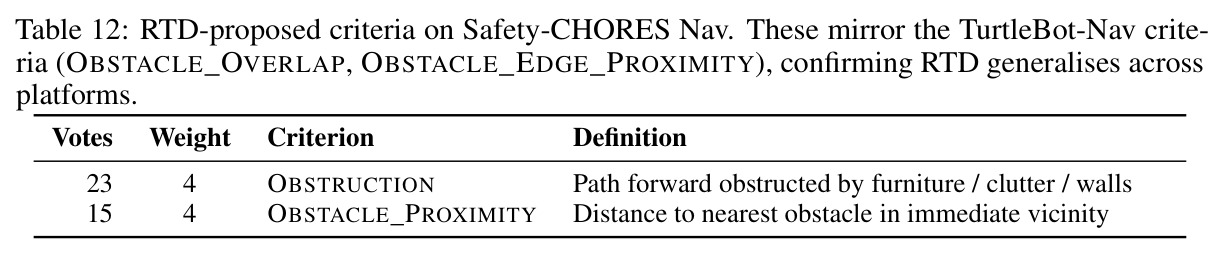
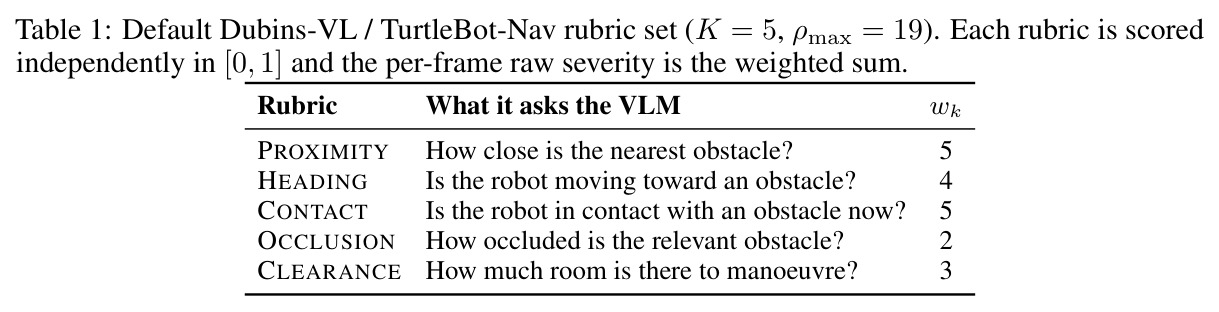
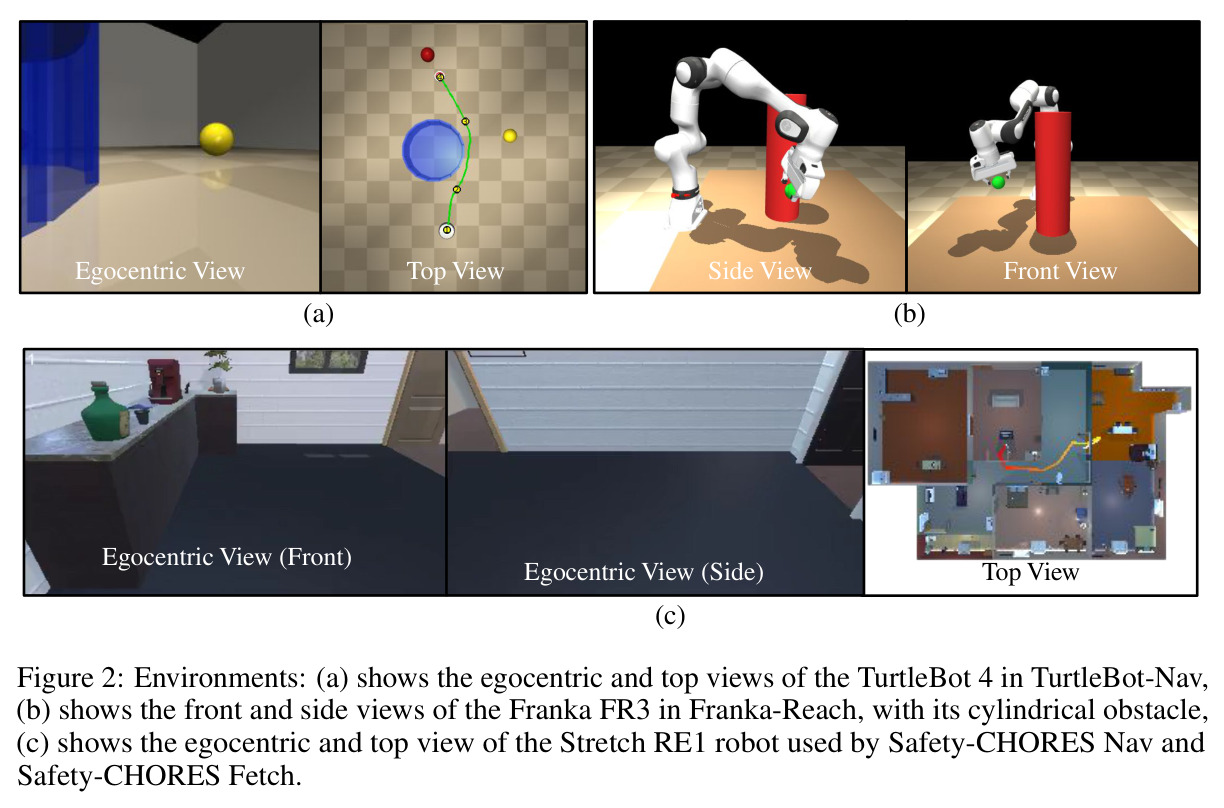
完整流水线四步。第一步,采集 rollout:预训练 VLA 在环境中交互,轨迹(观测、动作、每回合二值安全标签)存入共享回放缓冲区 $D$。第二步,离线生成逐步边际:冻结 Qwen3-VL-8B 对每帧按 K 条 rubric 独立打分——导航平台用五条模板(PROXIMITY 权重 5、HEADING 4、CONTACT 5、OCCLUSION 2、CLEARANCE 3,$\rho_{max}=19$),Safety-CHORES 沿用 SafeVLA 室内五条,Franka-Reach 用桌面接近/重叠两条;加权求和得 $\rho(o_t)$,再把回合级标签广播为弱逐帧标签,拟合类平衡逻辑回归 $P(y{=}1|\rho)=\sigma(a\rho+b)$,输出 $\hat{\ell}(o_t) = -(a\rho(o_t)+b)$。第三步,在线训练安全 critic:每个 PPO 迭代对 $\phi$ 做 K 步离策略 TD 更新,目标 $y^s = (1-\gamma)\ell(o) + \gamma\bar{d}\min\{\ell(o), Q_{\bar{\phi}}^s(o',a')\}$,$\bar{d}=1-done$ 保证终止状态直接返回即时边际;架构为视觉编码器(可从 VLA 编码器初始化)接 MLP 头。第四步,门控更新策略:可行过渡走标准 PPO(裁剪代理、GAE、KL 信任域),不可行过渡走 $\mathcal{L}_{safety}$,且 $\beta_{t+1} = \text{clip}(\beta_t + \eta_\beta(\bar{c}_t - c_{max}), \beta_{min}, \beta_{max})$。可选 RTD 离线循环:找评分分歧对,由 Qwen2.5-VL-72B 提案新 rubric 分离它们,在两个结构不同平台涌现出类似修正标准。
技术新颖性
技术新颖性体现在三个层面。第一,首次把模型无关 HJ 可达性从'运行时安全过滤器'搬进'基础模型的训练目标':先前工作(Hsu et al. 2024 的 HJ shield、VisionCBF)都在推理期对固定策略做过滤,不优化任务奖励;ShieldVLA 让 critic 直接门控 PPO 梯度,训练出的策略本身就安全,部署时零开销、无 shield。第二,安全贝尔曼算子的 min 备份 $\min\{\ell(o), \max_{a'}Q_s(o',a')\}$ 天然给出最坏情形可行性语义,配合 $\gamma$-压缩性(附录 A 证明)保证表格情形唯一不动点,比 CMDP 的加性代价备份更适合'能否安全继续'的判定,且 critic 在回放缓冲区上离策略训练,能见到在线 rollout 欠采样的稀有违规转移。第三,rubric-based VLM 安全监督:把'给这张图的安全性打 1-10 分'式的自由打分换成多轴结构化评分(接近/朝向/接触/遮挡/机动空间各一轴、锚定 $[0,1]$、手工整数权重),只用每回合一个二值结局标签做 Platt 校准就得到逐步代价——彻底绕开人工逐步标注;RTD 进一步让大提案 VLM 自动发明纠错 rubric,且跨平台涌现类似标准,证明可泛化、无需逐平台重新设计。消融还反证了各组件必要性:二值碰撞信号替代 rubric 后三个环境的任务性能崩溃,门控换成惩罚后两轴同时变差。
实验结果
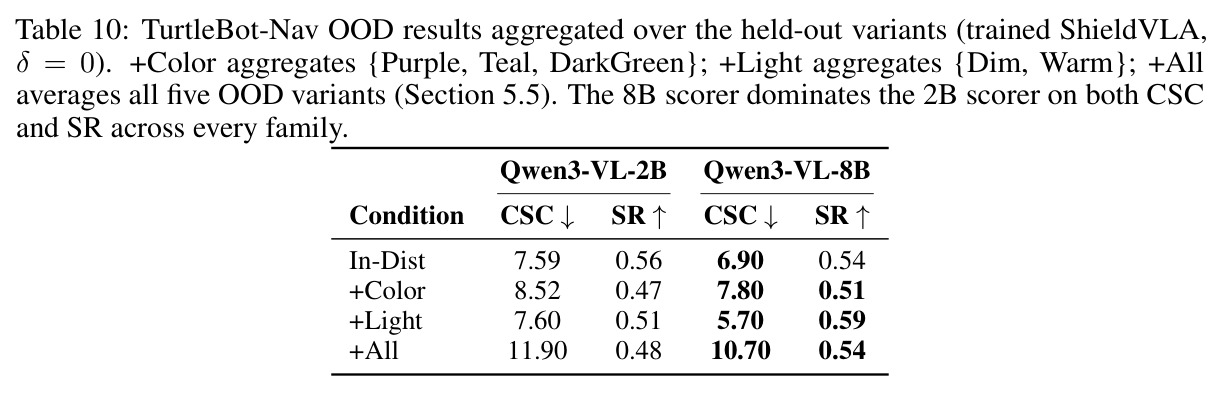
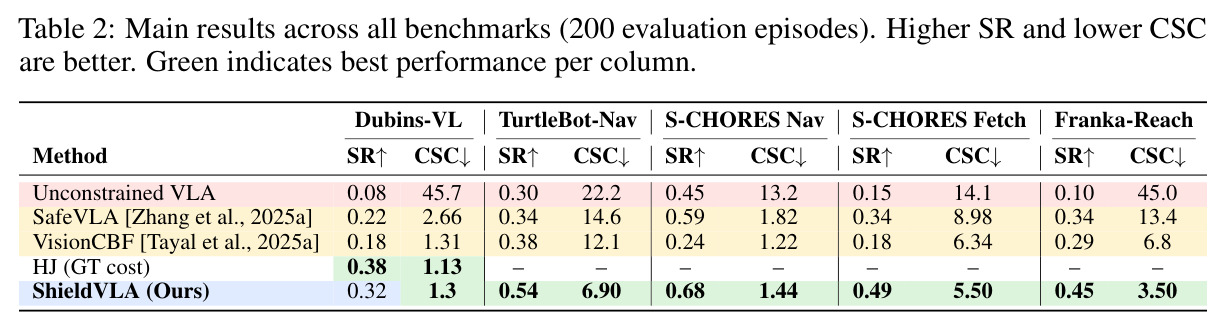
五个基准、每环境 200 评估回合的主结果(Table 2):Dubins-VL 上 ShieldVLA SR 0.32 / CSC 1.3,优于 SafeVLA 的 0.22/2.66,但低于有真值代价特权的 HJ (GT) oracle 0.38/1.13——oracle 是理想上界,无特权信息的 ShieldVLA 安全性已与其相当;TurtleBot-Nav 上 0.54/6.90 对 0.34/14.6;S-CHORES Nav 上 0.68/1.44 对 0.59/1.82(VisionCBF 的 CSC 1.22 更低但 SR 仅 0.24,非 Pareto 支配);Fetch 上 0.49/5.50 对 0.34/8.98;Franka-Reach 上 0.45/3.50 对 0.34/13.4。平均 CSC 降 57%、SR 升 +0.13。多种子验证(Table 3,3 种子)标准差很小(TurtleBot-Nav SR 0.54±0.05),结论对种子鲁棒。代价信号消融(Table 4):把 rubric 边际换成二值碰撞指示($\ell\in\{+1,-5\}$)后,四个环境中三个任务性能崩溃——TurtleBot-Nav SR 0.31 vs 0.54、Franka-Reach 0.25 vs 0.45——因边界外无梯度信息、门过早触发把策略锁死;但二值信号 CSC 更低(Franka-Reach 1.20 vs 3.50),说明连续严重度是用代价预算换选择性门控与任务成功。门控消融(Table 5):同一 critic 换拉格朗日惩罚后从 0.54/6.90 恶化到 0.33/7.80,证明 Pareto 增益归因于门。OOD 鲁棒性(Table 6):换颜色/光照/叠加三类测试期扰动下 ShieldVLA 在全部格保持最低 CSC,S-CHORES Nav 扰动后 CSC 反降 0.49(SafeVLA 恶化 +1.19),SR 变化可忽略($\Delta$SR $\in[-0.04,0.00]$);机制是视觉不确定使 $Q_s$ 收缩、门提前触发、策略提前恢复。
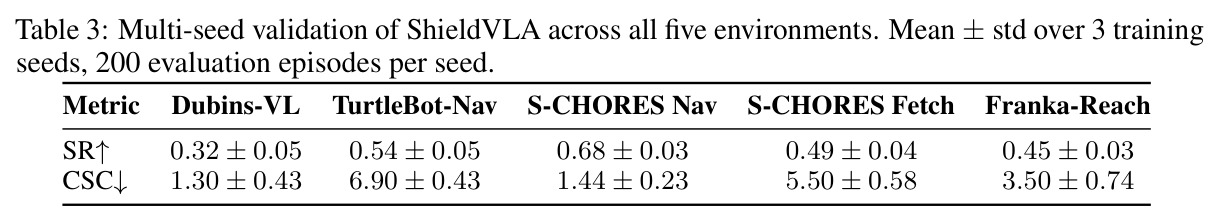
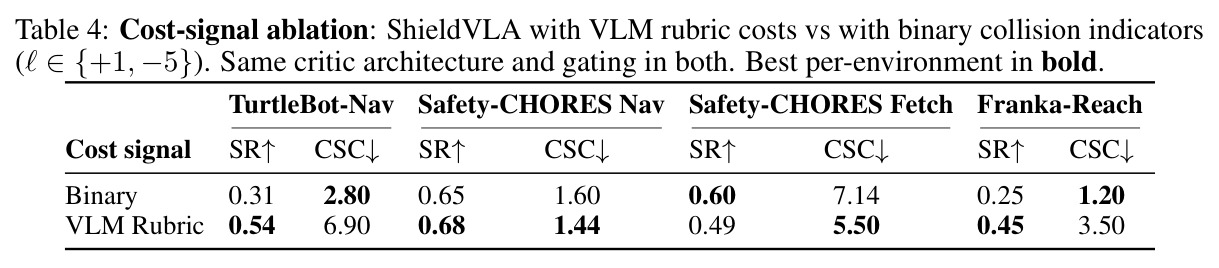
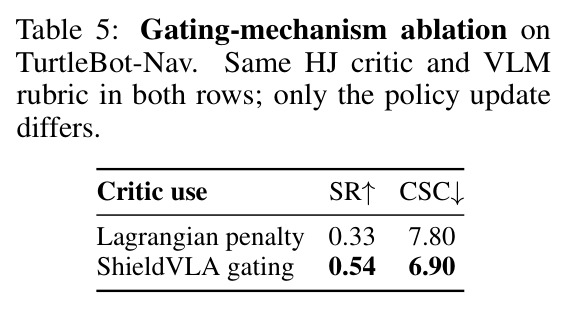
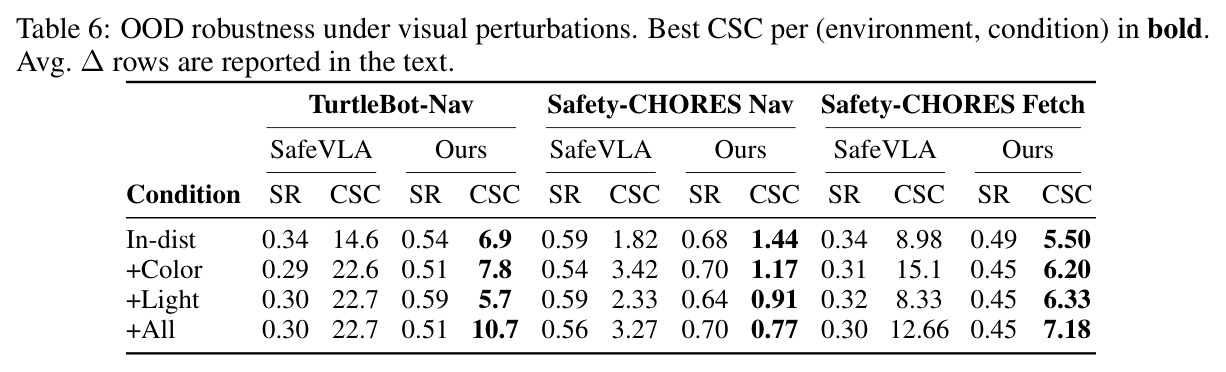
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
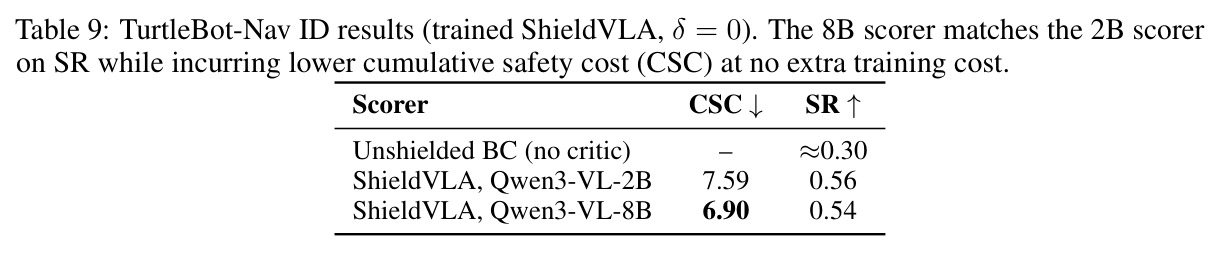
| TurtleBot-Nav 室内导航(OmniVLA 骨干) | SR ↑ / CSC ↓ | 0.54 / 6.90 | SafeVLA 0.34 / 14.6;无约束 VLA 0.30 / 22.2 | SR +0.20,CSC 降低约 52.7% |
| Safety-CHORES Nav 导航(SPOC-VLA 骨干) | SR ↑ / CSC ↓ | 0.68 / 1.44 | SafeVLA 0.59 / 1.82;VisionCBF 0.24 / 1.22 | SR +0.09,CSC 降低约 20.9%,且 Pareto 支配所有基线 |
| Safety-CHORES Fetch 操作(SPOC-VLA 骨干) | SR ↑ / CSC ↓ | 0.49 / 5.50 | SafeVLA 0.34 / 8.98;VisionCBF 0.18 / 6.34 | SR +0.15,CSC 降低约 38.8% |
| Franka-Reach 桌面到达(OpenVLA-OFT 骨干) | SR ↑ / CSC ↓ | 0.45 / 3.50 | SafeVLA 0.34 / 13.4;VisionCBF 0.29 / 6.8 | SR +0.11,CSC 降低约 73.9%,为五环境中最显著 |
| Dubins-VL 视觉避障(自建基准) | SR ↑ / CSC ↓ | 0.32 / 1.3 | SafeVLA 0.22 / 2.66;HJ (GT cost) oracle 0.38 / 1.13 | SR +0.10,CSC 降低约 51.1%,无特权信息下安全性逼近 oracle |
| OOD 视觉扰动鲁棒性(Safety-CHORES Nav,+All 条件) | SR ↑ / CSC ↓ | 0.70 / 0.77 | SafeVLA 0.56 / 3.27 | 扰动下 CSC 反而更低,SafeVLA 的 CSC 恶化 +1.19 而本文平均下降 |
局限与改进
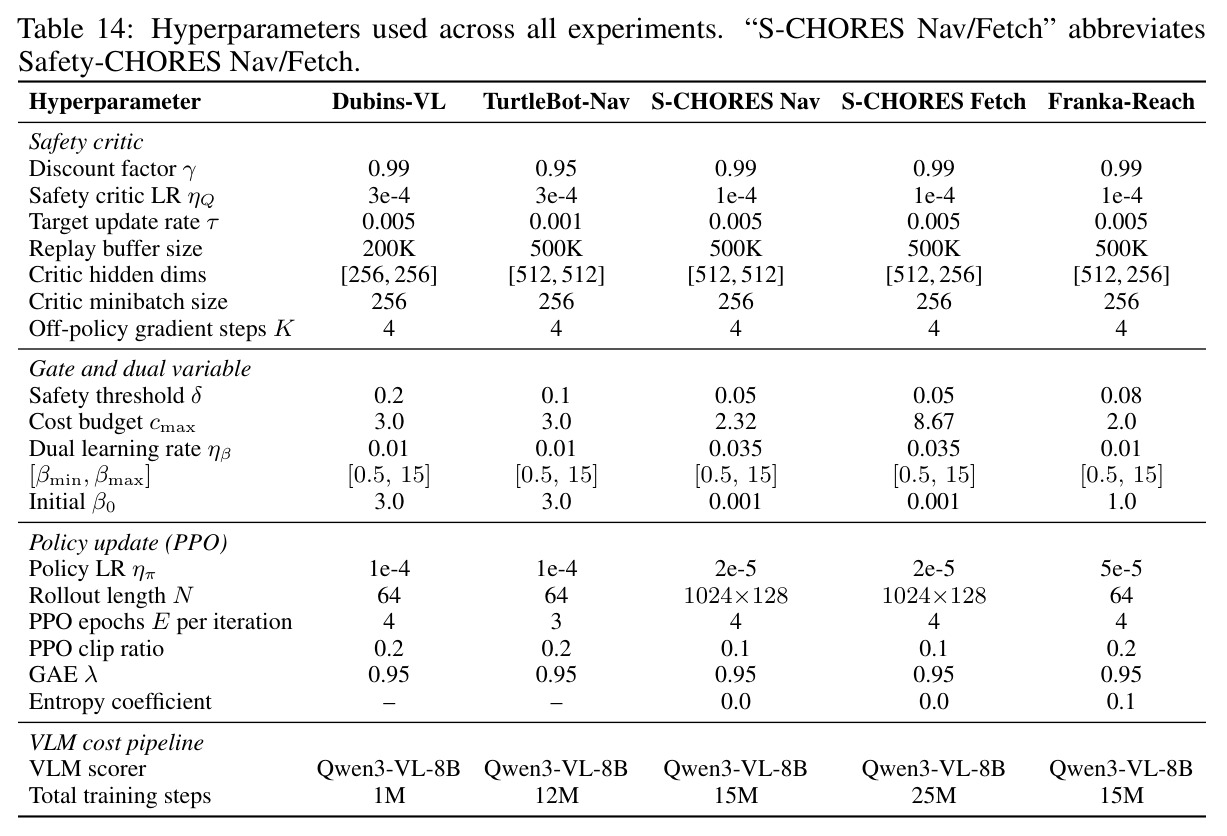
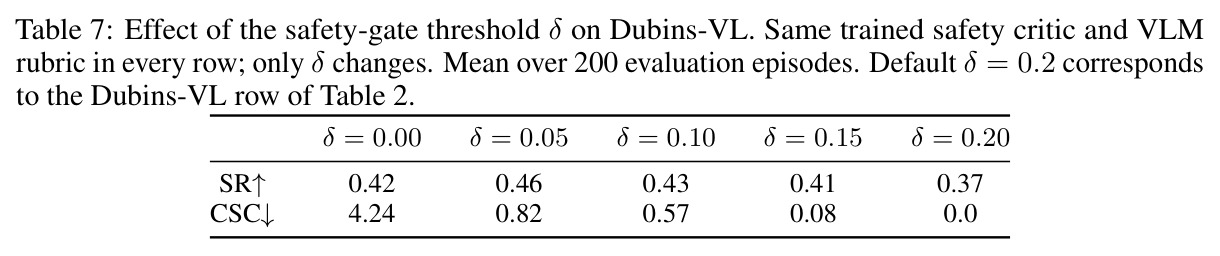
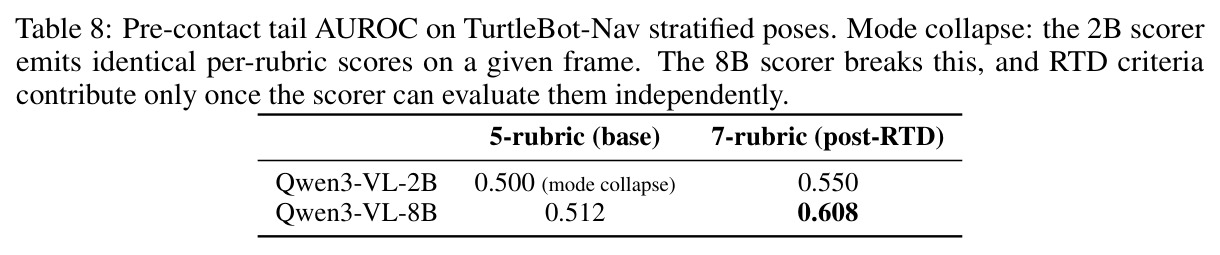
作者明确承认两条局限:其一,VLM 评分器容量——小于 8B 的评分器在尾部失败帧上出现模式坍缩(mode collapse),即使经 RTD 扩充 rubric 也无法突破,整条管线的上限受限于评分 VLM 的感知能力;其二,方法依赖充足的边界附近探索——在极稀有违规事件的环境里,critic 很难观测到不可行转移,HJ 值函数的可行性认证质量随之下降。我的补充观察:第一,五个环境全部是仿真(MuJoCo、AI2-THOR 等),sim-to-real 完全未验证,VLM rubric 评分在真实噪声图像上的稳定性存疑;第二,成功率的定义是'Safe+Reach'(到达且零违规),各环境的违规判定与终止条件细节藏在附录,跨论文可比性有限;第三,门控阈值 $\delta$、代价预算 $c_{max}$、$\beta_t$ 的 clip 区间仍是需要调的超参,论文未做敏感性分析;第四,安全信号完全来自 VLM 对单帧的语义判断,对速度相关的时间性危害(高速逼近、惯性滑移)单帧 rubric 可能系统性低估,HEADING 轴只部分缓解;第五,Platt 校准需要每回合一个真值二值安全标签,这在真实部署中仍依赖人工监督或碰撞传感器。
独立分析的弱点
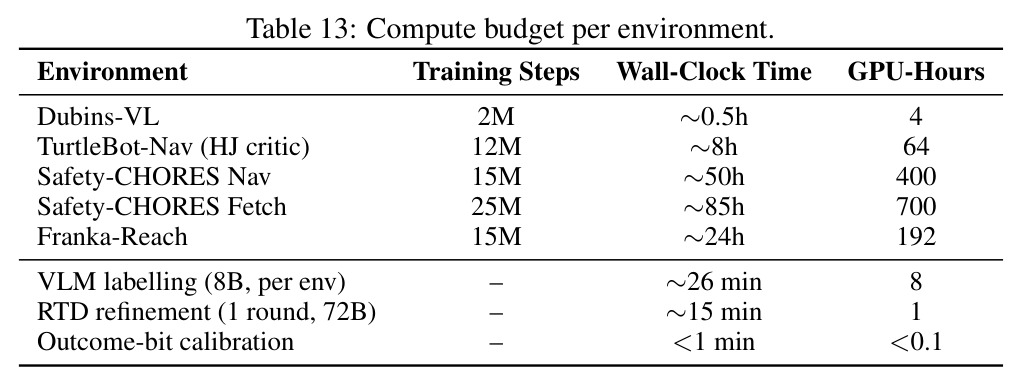
独立分析,我认为有五个值得注意的弱点。第一,单帧 VLM 评分无法捕捉时序危险:所有 rubric 都是静态画面属性(距离、朝向、遮挡、机动空间),对速度相关风险(高速冲向障碍、抓取中的力失控)不敏感,改进方向是给 rubric 引入连续帧差分或让 critic 消费堆叠观测 $(o_t, o_{t-1})$,或改用视频 VLM 评分。第二,Platt 校准用回合级标签广播到每一帧作弱标签,逻辑回归只能学到全局单调映射,无法定位回合内何时开始变危险,改进方向是用事件时间戳(碰撞发生帧)做更细监督,或加入序数约束(碰撞前帧应比远离帧更严重)。第三,门控估计器在 $|Q_s^\phi - \delta| \to 0$ 处只是近似无偏,依赖'策略分布足够宽、覆盖边界两侧'的经验假设——若策略收敛过窄,门控切换会抖动甚至震荡,改进方向是在边界附近用 sigmoid 软权重平滑过渡,或对 $\delta$ 做不确定度感知退避。第四,每个平台需要定制 rubric 集(导航五条、室内五条、桌面两条),通用性打折,RTD 虽可自动纠错但仍要逐平台运行,改进方向是构建跨环境共享的 rubric 库加自动路由。第五,论文未披露训练算力(GPU 小时)、VLM 评分调用次数与推理开销对比,而每 PPO 迭代 K 步 critic 更新加上逐帧 VLM 评分的成本并不低,工程落地门槛需要评估。
未来方向
作者提出的两个直接下一步是:在物理机器人上验证整条管线(sim-to-real 配合域适配的校准),以及扩大评分器规模以打破 8B 级模式坍缩上限。基于论文成果还可延伸的方向:第一,把 HJ critic 的可行性语义推广到多约束场景(同时避免碰撞、力超限、禁入区),学习向量值 $Q_s$ 并按约束分别门控;第二,把门控思想迁移到非 RL 的 VLA 微调范式,例如用 $Q_s$ 过滤 DPO 偏好对中的不可行动作或做安全感知的拒绝采样;第三,在线自适应校准——部署中用真实碰撞事件持续更新 Platt 参数与 rubric 权重,应对视觉域漂移,Table 6 显示 $Q_s$ 在扰动下自然收缩的保守化倾向可以被主动利用;第四,训练期门控与部署期 CBF 式运行时 shield 组合成双保险,认证最坏情形;第五,把 $Q_s$ 作为共享编码器上的多任务价值头集成回 VLA 主干,削减独立 critic 的显存与训练开销;第六,理论层面分析 VLM 评分噪声如何传播到 HJ 值函数的收缩性与安全集的过/欠估计,给出'评分误差到安全裕度'的误差界,为选择评分器规模提供依据。
复现评估
复现有利因素相当多:整个技术栈全开放权重——评分器 Qwen3-VL-8B 与提案器 Qwen2.5-VL-72B 均为 Apache-2.0 开源模型;五个评测环境均为公开或可自建的仿真平台(MuJoCo TurtleBot 4、AI2-THOR 上的 Safety-CHORES 基准、Franka FR3 仿真、自建 Dubins-VL);对 SafeVLA 的策略更新配方逐字沿用(附录 G)以便公平对比;rubric 全文与 verbatim prompts、校准细节、设计依据在附录 E,算法 1 在附录 C,$\gamma$-压缩证明在附录 A,逐环境完整规格在附录 D。不利因素:论文版本未见官方代码仓库,Dubins-VL 是自建基准需自行实现含真值安全集;训练涉及三个 VLA 主干(OmniVLA、SPOC-VLA、OpenVLA-OFT)微调加在线 critic 的每迭代 K 步 TD 更新,属多 GPU 级算力,且论文未披露具体 GPU 时数与 VLM 评分调用量;每回合真值二值安全标签在自建环境需自行实现违规检测器。总体评估:对熟悉 safe RL 与 VLA 微调的团队,复现主表结果是中等偏高工程量,最大不确定性在 VLM 评分管线的稳定性调优与 Platt 校准数据的复刻。
论文图表