递归游戏创造者:面向体验的智能体级游戏开发框架 Recursive Game Creator: An Agentic Product-Level Experience-Oriented Game Harness
四智能体闭环加编码原生玩家,把可运行的游戏原型迭代成好玩的产品级游戏
前置知识
编码智能体
以大语言模型为核心、通过生成并执行代码与环境交互的智能体。它读取任务描述后编写程序、运行程序、读取报错并迭代修订,典型系统如 Claude Code、Codex CLI。相比逐条对话输出,代码是对结构化行为的高密度表达,可复用、可版本化、可批量执行。
本文的 Builder 和 Player 本质上都是编码智能体,核心创新'写策略代码来试玩游戏'完全建立在这一范式之上,不理解它就无法理解方法的出发点。
GUI 智能体
通过截图理解屏幕内容、再输出鼠标键盘动作来操作软件的智能体。每个动作都要经历'视觉解释+模型决策'两步,延迟高且易丢失信息,但优势是适用于没有程序接口的黑盒软件和任何图形界面。
论文把 GUI 智能体试玩游戏作为主要对照路线(如 Huang et al. 2026 的工作),理解其'每步两跳'的成本与信息损失,才能体会 Coding-Native Player 的设计动机。
游戏轨迹(Trajectory)
一次完整游玩过程的结构化记录,按时间步列出观察(如血量、距离等状态)、所选动作、触发事件、进度、用时和终止原因,形如 $ au = (s_0, a_0, s_1, a_1, \ldots)$。它把'玩得怎么样'从主观印象变成可统计、可对比的证据。
整篇论文的评审环节都建立在轨迹证据上:成功率、卡点分布、游玩时长、玩家偏好推断全部从轨迹统计得出,这是评审器能给出具体诊断的前提。
递归自我改进(RSI)
智能体系统把自己的输出作为下一轮输入、借助评估反馈反复改进工件或自身的循环范式,代表工作有 Self-Refine、Reflexion、Darwin Gödel Machine 等。其成败关键在于反馈信号的质量和防止退化的版本保留机制。
本文是 RSI 在游戏开发上的完整实例化,评审器的 A/B 匿名对比与版本保留判断正是防止'越改越差'的关键部件,理解 RSI 有助于把握整个闭环的结构。
经验驱动 PCG 与偏好对齐
经验驱动程序化内容生成(Yannakakis & Togelius)把玩家模型(情绪、体验状态)接入内容生成回路;RLHF 和 DPO 则用人类偏好数据对齐模型行为。共同思想是:优化目标应该是玩家体验本身,而非表面正确性指标。
本文的 Reviewer 借鉴了这一思想,把偏好(推断出的+用户明说的)写成结构化记录来驱动迭代,但与 RLHF 不同的是全程冻结模型参数、只改游戏工件。
研究动机
当前的游戏设计智能体(如 VibeGame、Harness-of-Harness、RSIGame)已经能让大模型生成'能跑起来'的游戏,但程序正确不等于好玩:机制是否有挑战、难度是否合适、反馈是否及时、画面是否连贯,这些体验维度并没有被系统地优化。现有迭代式工作流的测试手段主要靠 GUI 智能体:截图理解画面后逐步决定鼠标键盘操作。论文指出这带来三个具体问题:一是截图驱动测试会丢失程序化接口里直接可得的结构化状态、合法动作、事件和进度信号;二是每个动作都需要一次视觉解释加一次模型决策,延迟高,无法支撑高频、细粒度的多次 rollout,导致评估证据稀疏且有偏;三是编码智能体本身擅长写代码和推理、并不擅长逐帧解读游戏画面,用 GUI 测试等于用错了模型的长处。
本文的目标是论文的目标是把智能体游戏开发从'粗糙可玩原型'推进到'产品级好玩的游戏',并支持按玩家口味定制。具体而言,作者要构建一个经验导向的递归框架 Recursive Game Creator:像真实游戏工作室一样组织设计师、建造者、玩家、评审四种角色,形成设计—实现—试玩—评审的闭环;试玩环节要能高效收集大量多样化的游玩轨迹作为证据;评审环节要能结合行为证据、视觉证据和用户显式偏好,给出针对具体游戏题材的诊断与改进意见;最终在 GameCraft-Bench 和 GameASG-Bench 上取得对比方法中最优的整体成绩,并用用户研究证明多轮迭代确实提升了真实游玩体验。
与已有工作不同的是,本文的独特切入是把'玩'本身工程化。与 Huang et al. (2026)、Videogamebench 等用 GUI 智能体测试游戏的工作不同,作者提出 Coding-Native Player:让智能体直接编写可执行的策略代码、通过程序化接口高速收集轨迹,把'快速控制'与'策略构造''视觉评审'解耦。与同期做递归自我改进的 RSIGame 只关注功能修复不同,本文把体验质量(难度、卡点、叙事、视觉)和玩家偏好作为显式优化目标。与经验驱动 PCG、RLHF 等以人类反馈训练模型参数的工作不同,本文保持模型参数完全冻结,用结构化偏好记录去迭代游戏工件本身,打通'策略→轨迹→反馈→新版本'的产品级演进链路,这在游戏智能体领域是首次完整闭环。
核心方法
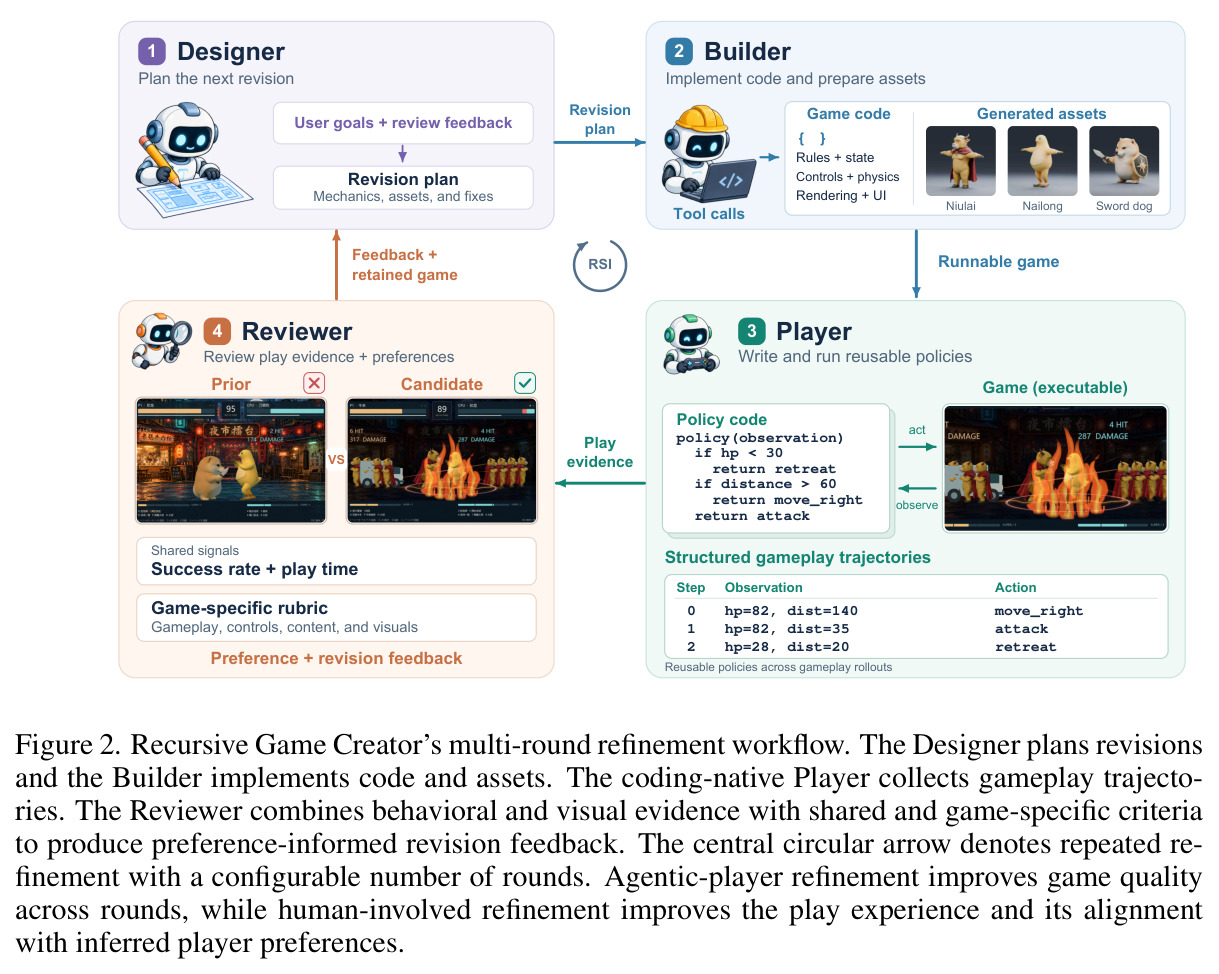
直觉上,这套框架给 AI 配了一个微缩游戏工作室。第 $t$ 轮迭代中四个角色依次接力:设计师 Designer 把用户需求 $U$、当前游戏 $G_t$ 和上轮反馈 $H_{t-1}$ 综合成计划 $P_t = \text{Design}(U, G_t, H_{t-1}) = (h_t, \Delta_t, A_t, X_t)$:$h_t$ 是体验改进假设,$\Delta_t$ 是具体改动与需保留的优点,$A_t$ 是验收目标,$X_t$ 是资产需求。建造者 Builder 先起草 $Z_t = \text{Draft}(G_t, \Delta_t)$,生成资产 $X^*_t = \text{Generate}(X_t; Z_t)$,集成出候选游戏 $C_t = \text{Integrate}(Z_t, X^*_t)$。编码原生玩家 Player 编写策略执行 rollout $\tau_{t,k} = \text{Rollout}(C_t, \pi_{t,k})$,收集证据集 $E_t = \{(\tau_{t,k}, V_{t,k})\}_{k=1}^K$。评审 Reviewer 综合行为与视觉证据按题材化标准打分,匿名对比新旧版本并决定保留哪个,意见交回设计师进入下一轮。实验中循环 3 轮即把 GameCraft-Bench 总分从 72.70 推到 77.89。
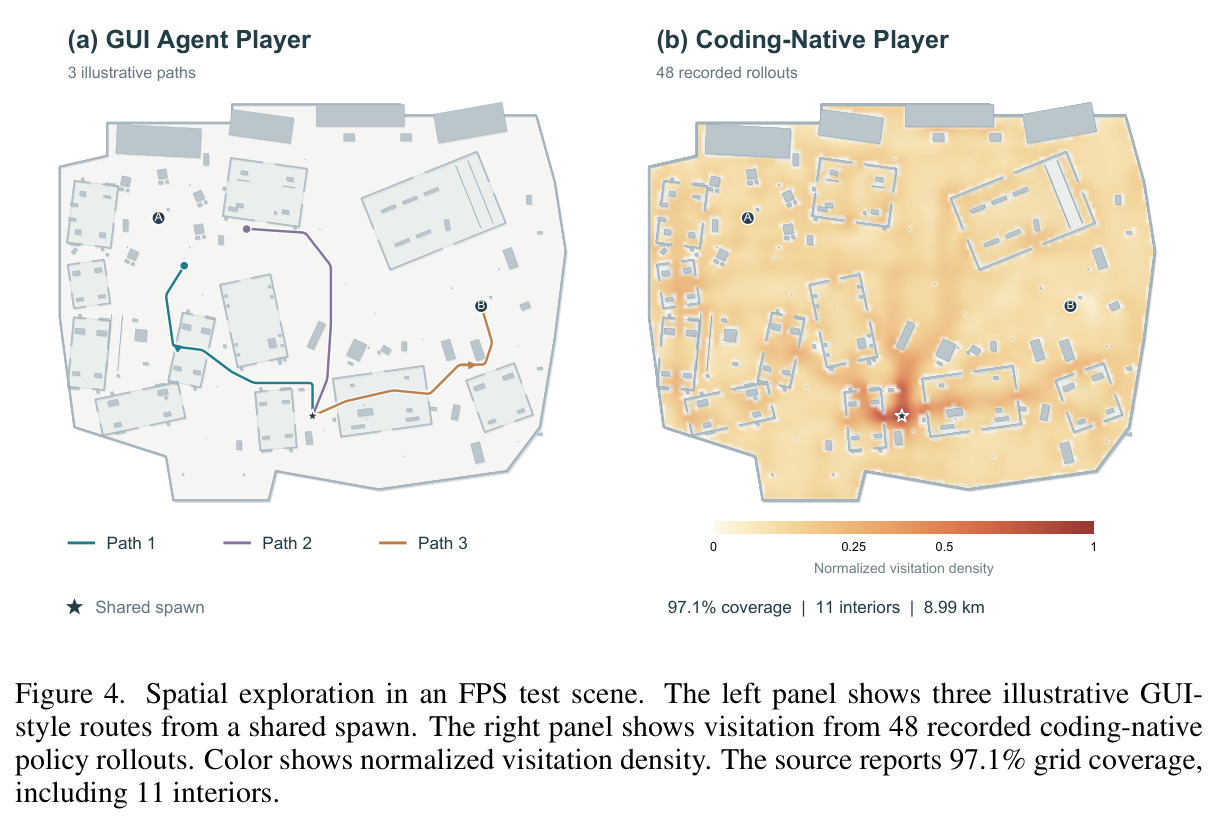
核心创新是 Coding-Native Player 与 Experience-Oriented Reviewer 的组合,前者是与已有工作的本质区别。以往用 GUI 智能体试玩,每一步动作都要'看图→模型决策',既慢又丢信息。本文让玩家智能体阅读游戏暴露的状态 schema、合法动作和测试目标,直接编写可复用的策略代码 $\pi_{t,k}$(例如 if hp < 30 return retreat、if distance > 60 return move_right 这类条件逻辑),通过程序化或命令行接口高频执行,无需每步调用模型。策略按风格、技能、探索和风险偏好刻意差异化(速通型、全收集型、高风险型等),可并行重复运行。论文归纳出四大优势:高频控制、高效轨迹收集、多样化能力模拟、结果可复现。在 FPS 测试场景中,48 次策略 rollout 覆盖了 97.1% 的地图网格、11 个室内区域、累计 8.99 公里路程。Reviewer 则用这些轨迹统计成功率、游玩时长和卡点,配合截图录像做盲态 A/B 对比,把快速控制与慢速视觉评估彻底分层。
方法步骤详情
第一步,设计:输入 $U$、$G_t$、$H_{t-1}$,输出体验假设 $h_t$、改动集 $\Delta_t$、验收目标 $A_t$(场景、玩家输入、可观察结果)与资产需求 $X_t$。第二步,建造:Builder 实现核心玩法循环与计划改动,缺资产先用占位符;框架生成资产 $X^*_t$ 后,Builder 在游戏场景中检查资产呈现及与碰撞、动画、交互区域的配合,自检后集成出候选 $C_t$。第三步,试玩:Player 读取状态 schema、合法动作和测试目标,编写策略 $\pi_{t,k}$ 派发到独立游戏实例执行,失败则修订重跑;策略按风格、技能、探索、风险刻意差异化并并行执行 $K$ 次,轨迹记录状态、动作、事件、进度、用时与终止原因。第四步,评审:Reviewer 用共享信号(成功率、游玩时长、卡点位置)加题材化 rubric(赛车看转向响应,视觉小说看对话连贯与选择后果)评估;盲态查看截图录像(不看源码、不知版本顺序);输出结构化偏好记录(期望体验、证据、偏好是推断还是用户明说、优先级)与 A/B 判断(偏好/平局/无法判定),决定保留版本并把反馈交回设计师。
技术新颖性
技术新颖性体现在三点。其一,测试范式的转移:把游戏测试从'每步视觉解释+模型决策'的 GUI 模式改为'一次写策略、多轮高速执行'的编程模式,这与 Code as Policies、Voyager、Eureka 等把代码当行为载体的工作一脉相承,但首次用于大规模收集游戏体验证据。其二,证据分层的评审设计:快速控制循环完全不碰图像,Reviewer 单独拿截图录像盲评可读性与风格,并对'发生了什么'与'为什么发生'做区分,原因不确定时明确指出还需要什么证据而非强行归因。其三,偏好显式化:评审输出严格区分推断偏好与用户显式要求,写成结构化记录驱动下一版设计,模型参数全程冻结。相比 RSIGame(只修功能)、HoH(独立评估但非体验导向)、AVR-Agent(音视频对比)、GameGPT(角色协作但无试玩证据),本文把可玩性证据、题材化 rubric、版本保留机制串成了完整闭环。
实验结果
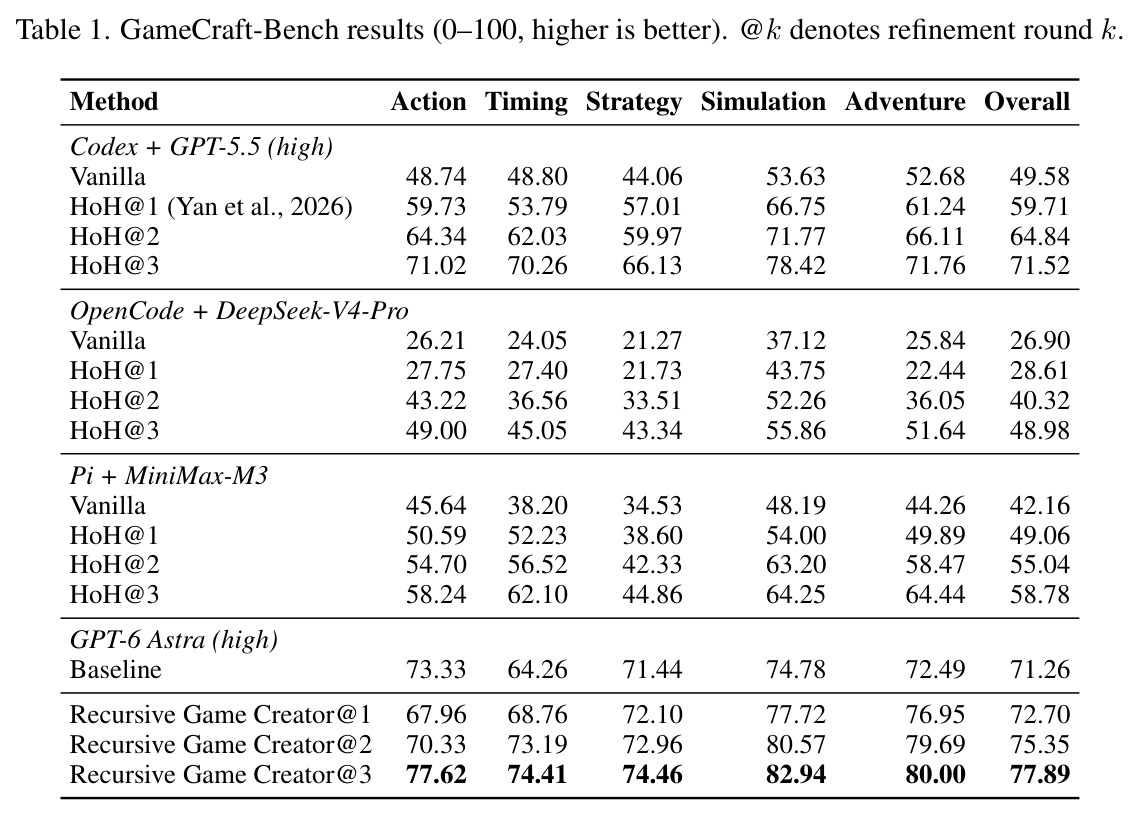
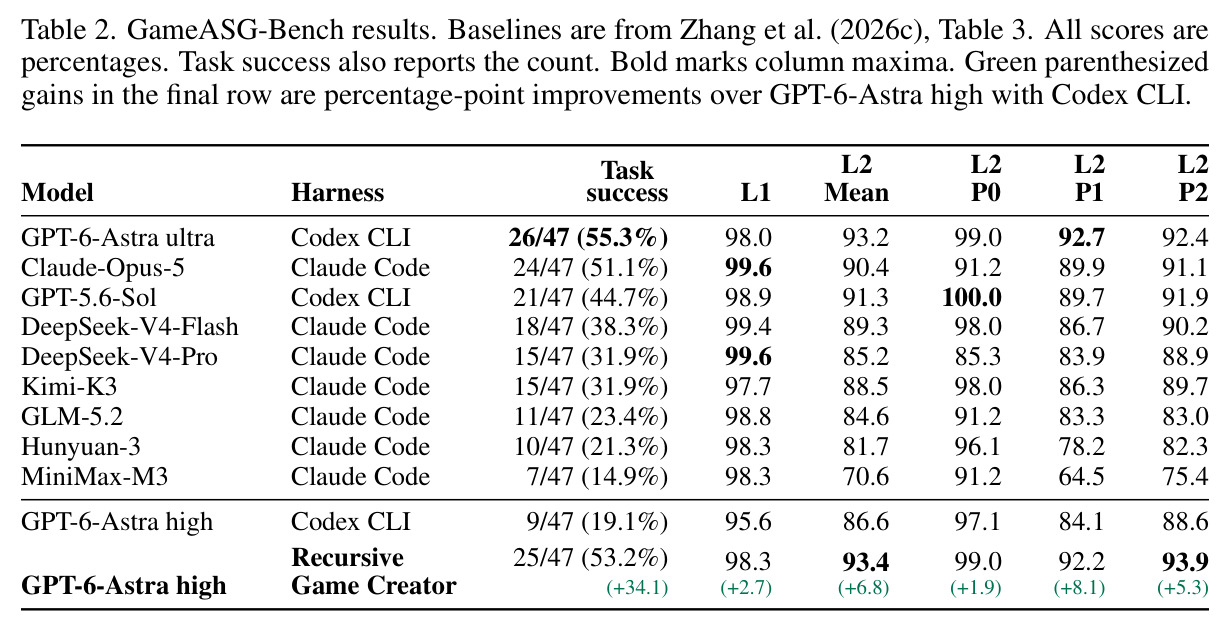
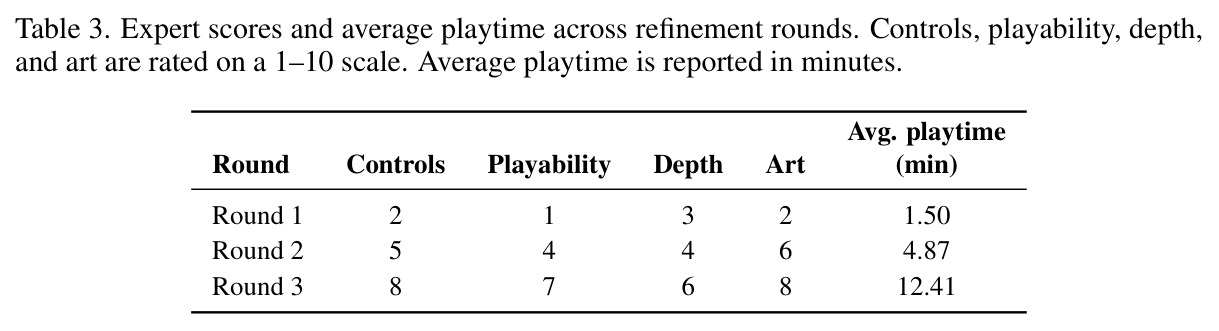
GameCraft-Bench(0-100 分,Godot 游戏):45 个任务上跑 3 轮,总分从 72.70 升到 77.89(+5.19),比同模型基线 GPT-6 Astra (high) 的 71.26 高 6.63 分,比最强基线 HoH@3 的 71.52 高 6.37 分;五类全部提升,Action 类涨幅最大(67.96→77.62,+9.66),但前两轮仍低于基线 73.33,作者推测动作游戏需控制、碰撞、反馈、成长多线协同,要多轮试玩才见效。GameASG-Bench(浏览器游戏):严格任务成功率 25/47(53.2%),比同模型基线的 9/47(19.1%)高 34.1 个百分点;L1 通过率 98.3%,L2 均值 93.4% 为全部对比配置最高(P0/P1/P2 为 99.0%/92.2%/93.9%);最强竞品 GPT-6-Astra ultra 成功率 26/47 略高,但 L2 均值 93.2% 低于本文。用户研究中专家 1-10 分评分三轮内从控制 2、可玩性 1、深度 3、美术 2 升到 8、7、6、8,游玩时长从 1.50 分钟升到 12.41 分钟。48 次 rollout 覆盖 FPS 地图 97.1% 网格、11 个室内区域、8.99 公里。
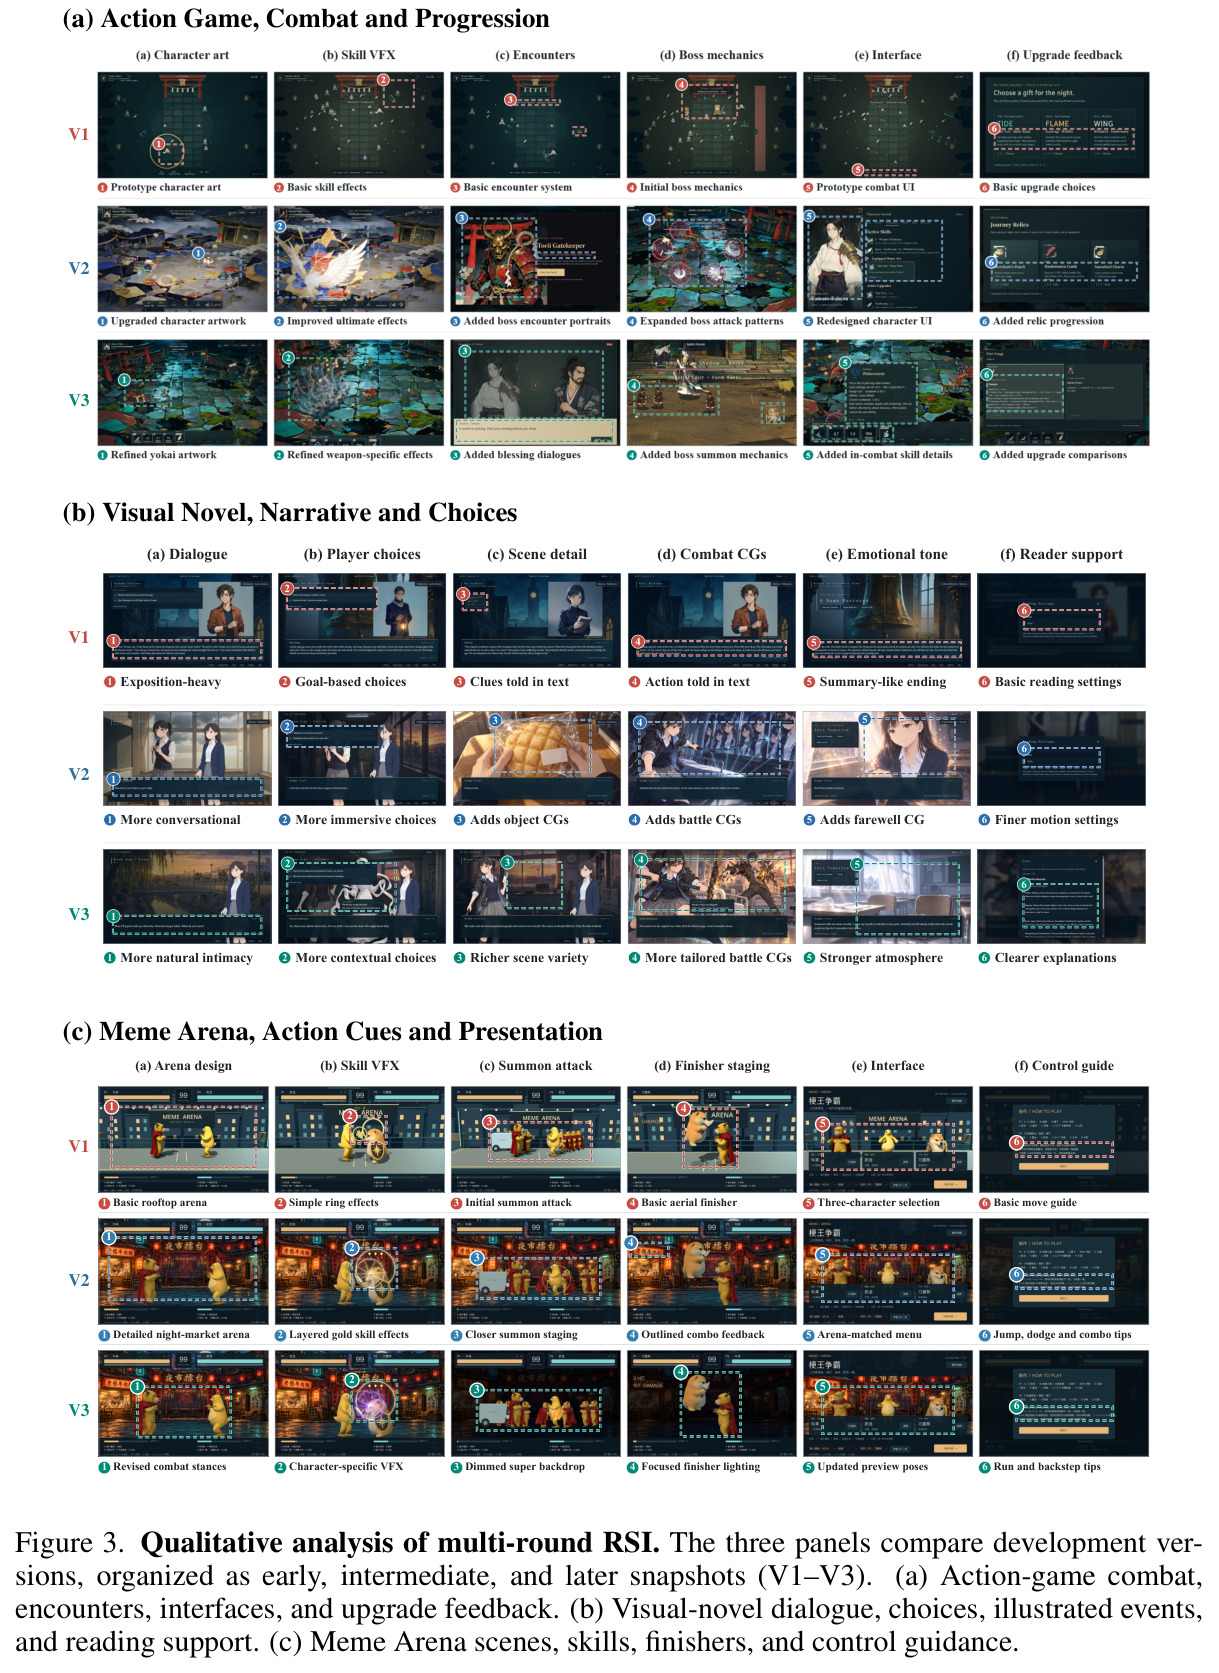
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GameCraft-Bench 整体游戏质量(45 个 Godot 任务,3 轮迭代) | 0-100 综合评分 | 77.89(第 3 轮,从第 1 轮 72.70 起 +5.19) | 同模型基线 GPT-6 Astra (high) 71.26;此前最强 HoH@3 (Codex+GPT-5.5) 71.52 | 较同模型基线 +6.63 分,较最强已报告基线 +6.37 分 |
| GameASG-Bench 严格任务成功率(源码 L1 + 运行时 L2 全通过) | 通过任务数 / 总任务数 | 25/47(53.2%) | 同模型基线 GPT-6-Astra high + Codex CLI 9/47(19.1%) | +34.1 个百分点 |
| GameASG-Bench L2 运行时检查平均通过率 | 百分比(越高越好) | 93.4%(P0 99.0% / P1 92.2% / P2 93.9%) | GPT-6-Astra ultra + Codex CLI 93.2% | +0.2pp,为所有对比配置中最高 |
| 用户研究:专家评分与游玩投入度 | 1-10 分专家评分;平均游玩时长(分钟) | 第 3 轮:控制 8、可玩性 7、深度 6、美术 8;时长 12.41 分钟 | 第 1 轮:控制 2、可玩性 1、深度 3、美术 2;时长 1.50 分钟 | 时长提升约 8.3 倍,四项评分提升 3-6 分 |
局限与改进
作者明确承认几条边界:其一,代理策略只提供多样测试行为,不能代表完整人类玩家群体,代理游玩时长也不能直接证明人类兴趣与乐趣;其二,Fig. 4 的 GUI 路线仅为示意,展示的是覆盖率而非实测加速比,公平对比必须对齐预算与观测访问权限,并把策略生成、修复、执行、评审都计入成本;其三,动作类分数前两轮仍低于同模型基线,说明协同性强的品类需要更多迭代轮次。我自己的观察:整个 harness 的上限受骨干模型(GPT-6 Astra high)与评审模型判断力制约,论文没有对组件做消融(去掉多样化策略或题材 rubric 会掉多少分不得而知);编码原生玩家要求游戏暴露程序化接口,这一前提在真实商业引擎和闭源游戏上未必成立;GameCraft-Bench 只用了 45 个任务子集,且 token、时长、rollout 数等成本完全没有量化报告;用户研究样本规模与统计显著性也未交代。
独立分析的弱点
第一,成本不透明:每轮迭代要生成并执行数十条策略、收集大量轨迹再做多模态评审,但论文未报告 token 消耗、挂钟时间和策略失败率,落地性价比无法评估,建议补一份随轮次变化的成本曲线并与 GUI 基线做预算对齐对比。第二,程序化接口假设过强:方法依赖生成游戏自带状态与动作 API,若面向 Unity/Unreal 等真实引擎或改造已有游戏,需要先写适配层,这是明显的适用范围限制,可探索自动生成接口适配器。第三,偏好推断可靠性存疑:从代理策略轨迹推断'玩家喜欢探索'这类偏好容易受策略设计偏差影响,应引入真实玩家遥测或小规模人类试玩做校准。第四,用户研究规模太小且无统计检验:三轮、1-10 分的专家评分没有交代人数和显著性,结论只能算初步证据。第五,无消融实验:四角色、多样化策略、匿名 A/B、题材 rubric 各自的贡献不明,读者无法判断哪个组件最关键。
未来方向
作者提出代码即将开源,并把该框架定位为'从功能原型迈向产品级游戏、持续适配个体玩家'的基础设施。基于成果可以延伸的方向包括:把真实玩家的遥测轨迹混入证据集,让偏好推断从代理策略走向真实人群分布;把策略库跨游戏复用,形成可迁移的测试技能库(类似 Voyager 技能库思路);用积累的偏好记录训练奖励模型,反过来微调设计师与评审的提示词甚至模型参数;对 GUI 与编码原生两条试玩路线做严格预算对齐的对照实验,量化真实加速比;扩展到 3D 引擎(如 AutoUE 的 Unreal 工作流)、多人在线游戏和长线运营的版本迭代场景;以及把成功率、时长、题材 rubric 组合成可回归追踪的复合体验评分,接入 CI 式自动化游戏质检流程。
复现评估
复现难度中等偏高。论文声明 Code is coming soon,截至发文主代码尚未开源,这是最大的不确定项。两个评测基准是公开的:GameCraft-Bench(arXiv:2606.17861,Godot 引擎游戏)与 GameASG-Bench(arXiv:2609.21293,浏览器游戏),但 GameCraft 实验只用了 Yan et al. (2026) 选出的 45 个任务子集,复现需要先还原该任务选择。骨干模型是 GPT-6 Astra (high) 这类闭源前沿模型,API 成本不低且行为可能随版本漂移;资产生成工具、Godot 运行环境、浏览器自动化测试、轨迹存储与匿名 A/B 对比等基础设施都需要自建。论文未报告总计算量与每轮成本,策略沙箱和并行 rollout 调度也有不少工程细节未披露。思路层面完全可以照着复述,工程层面四智能体编排加策略沙箱的复杂度不低,建议等官方代码发布后再动手复现。
论文图表
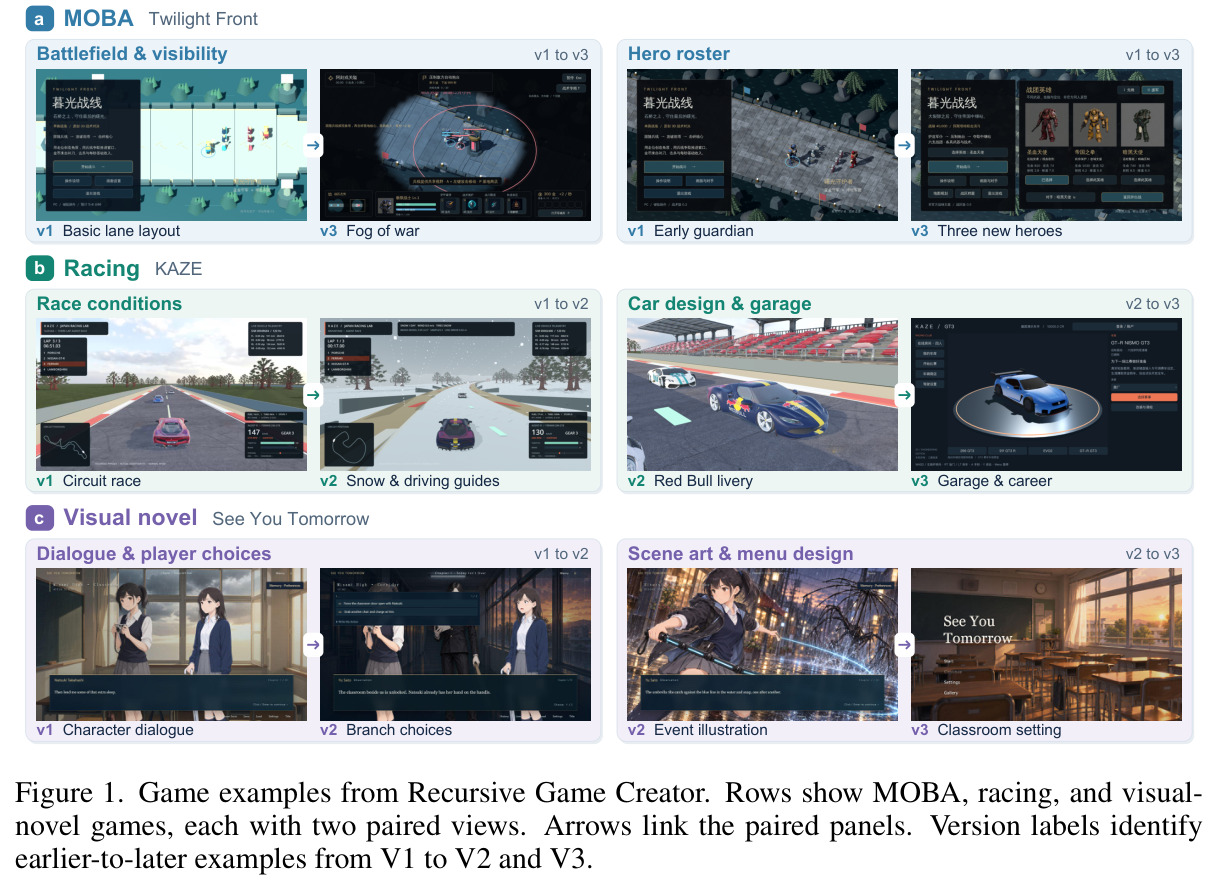
三行分别展示 MOBA 游戏 Twilight Front(战场可视性从 V1 基础兵线布局到 V3 战争迷雾,英雄阵容从早期守护者扩展三个新英雄)、赛车游戏 KAZE(比赛条件从 V1 环形赛讲到 V2 雪地与驾驶引导,车辆设计从红牛涂装到 V3 车库与职业生涯模式)和视觉小说 See You Tomorrow(对话与玩家选择从 V1 角色对话到 V2 分支选项,场景美术从事件立绘到 V3 教室场景),每行两个配对视图用箭头标注 V1 到 V3 的演进。
直观展示框架能支撑的题材广度(MOBA/赛车/视觉小说)以及多轮迭代带来的具体可见变化,是理解'产品级游戏'这一目标定位的最快入口。