基于可执行计划与自蒸馏 Transfusion 的空间音频生成与编辑 Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
AMBIT 用可执行场景计划统一 FOA 空间音频生成与编辑,并以联合在线自蒸馏同步精炼规划与渲染。
前置知识
一阶 Ambisonics(FOA)
FOA 是一种全景声(spatial audio)表示格式,用四个通道记录完整声场:$W$ 为全向分量(类似单声道压强),$Y/Z/X$ 为三个互相正交的指向性分量,编码声音的方向信息。论文采用 ACN 通道序 $[W, Y, Z, X]$ 和 SN3D 归一化,坐标约定为前 $+X$、左 $+Y$、上 $+Z$。相比双声道立体声,FOA 能表达任意方位角、俯仰角和距离的声源,是 VR/沉浸式媒体的标准格式之一。
本文的所有生成与编辑目标都是原生四通道 FOA,理解 $W$ 通道与方向通道的物理含义,才能读懂 VAE 为什么要单独监督 $W$ 重建、以及空间协方差匹配(SCM)为何要监督通道间的能量、相干性与相位关系。
Transfusion 架构
Transfusion(Zhou et al., 2025)是在同一个 Transformer 里混合两种训练目标的范式:对离散 token 用自回归(AR)下一 token 交叉熵,对连续数据(原论文为图像 latent)用扩散/流匹配损失。两种模态共享主体块,通过因果注意力(AR token)与双向注意力(连续 latent)区分接口。本文把这一范式搬到音频:AR 模式规划场景,DiT 模式渲染 FOA latent。
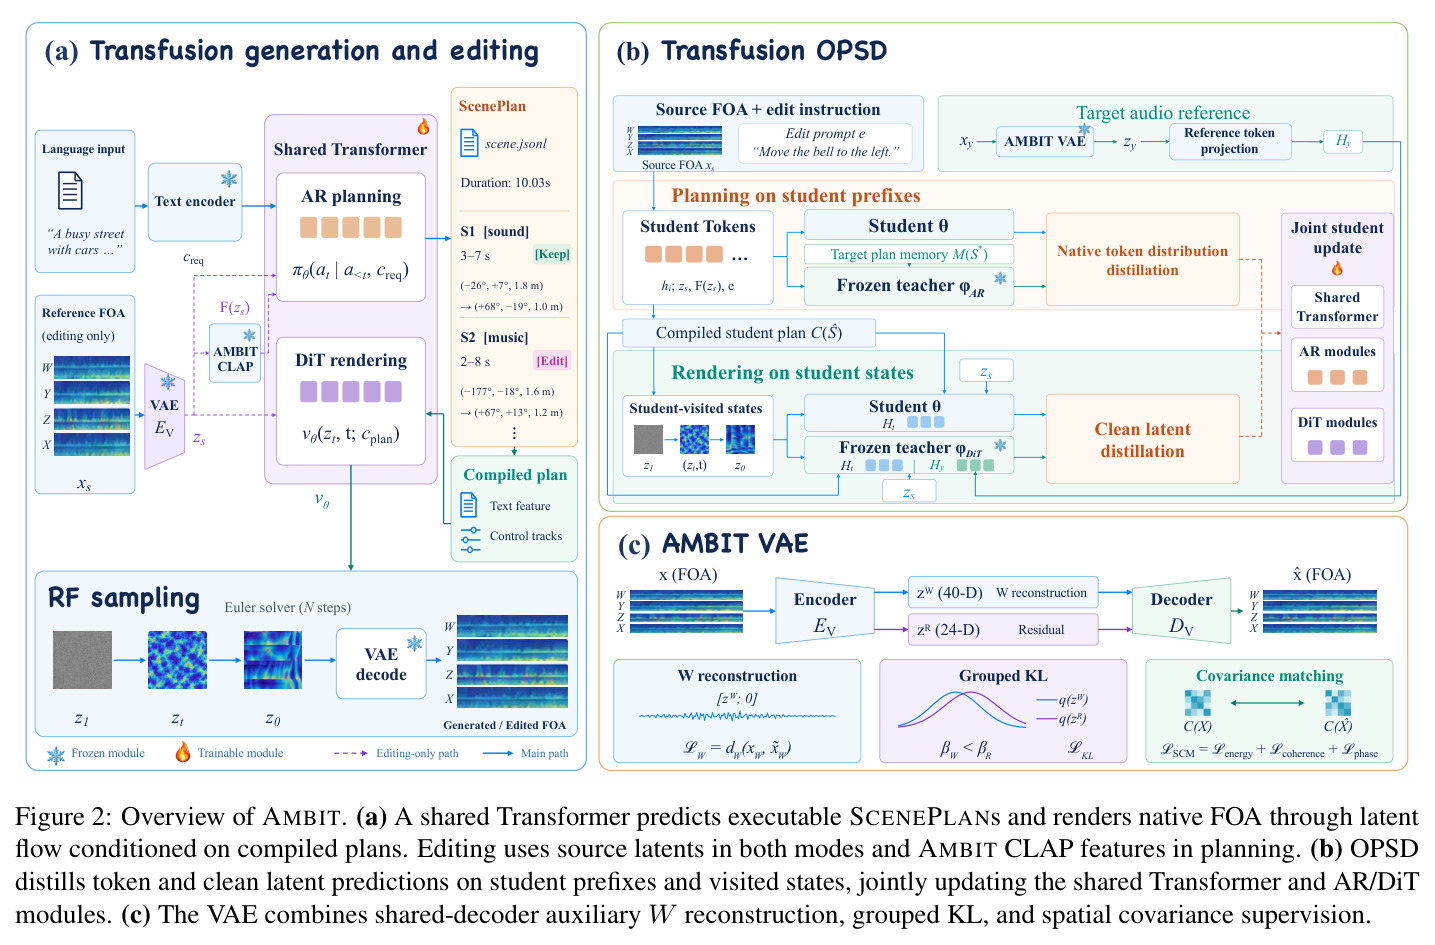
AMBIT 的整个骨架就是一个 Transfusion:共享 15 层 Transformer、332.6M 参数,同时承担离散计划预测与连续流渲染。不理解这种"一个模型两种模式"的结构,就无法理解为何后训练时规划与渲染的梯度会通过共享参数相互耦合。
整流流(Rectified Flow)
整流流是一种流匹配生成范式:训练时在干净数据 $z_0$ 与噪声 $\epsilon$ 之间线性插值 $z_t = (1-t)z_0 + t\epsilon$,让网络 $v_\theta$ 预测速度 $\epsilon - z_0$;推理时从 $t=1$ 的纯噪声出发,用 Euler 积分沿近似直线的速度场走到 $t=0$ 的数据点。相比 DDPM,路径更直、采样步数可以更少。
AMBIT 的渲染器用整流流生成 FOA latent(生成 100 步、编辑 20 步 Euler);OPSD 的渲染蒸馏正是匹配学生与教师在访问到的采样状态 $(z_j, t_j)$ 处的干净 latent 预测 $\hat{z}_0 = z_j - t_j v$,公式里的 $t_j^2$ 加权就来自这一关系。
在线自蒸馏(On-Policy Self-Distillation, OPSD)
传统 SFT 在人工参考序列上训练,而推理时模型消费的是自己生成的上下文,产生分布偏移。在线自蒸馏让学生在自己生成的序列(前缀)上接受更强教师分布的 KL 蒸馏:教师和学生读同样的学生生成前缀,教师额外获得特权信息(如标准答案),学生拟合教师的输出分布。这是 LLM 推理训练中的成熟思路,本文首次将其扩展到"离散 token + 连续流"耦合的 Transfusion 模型。
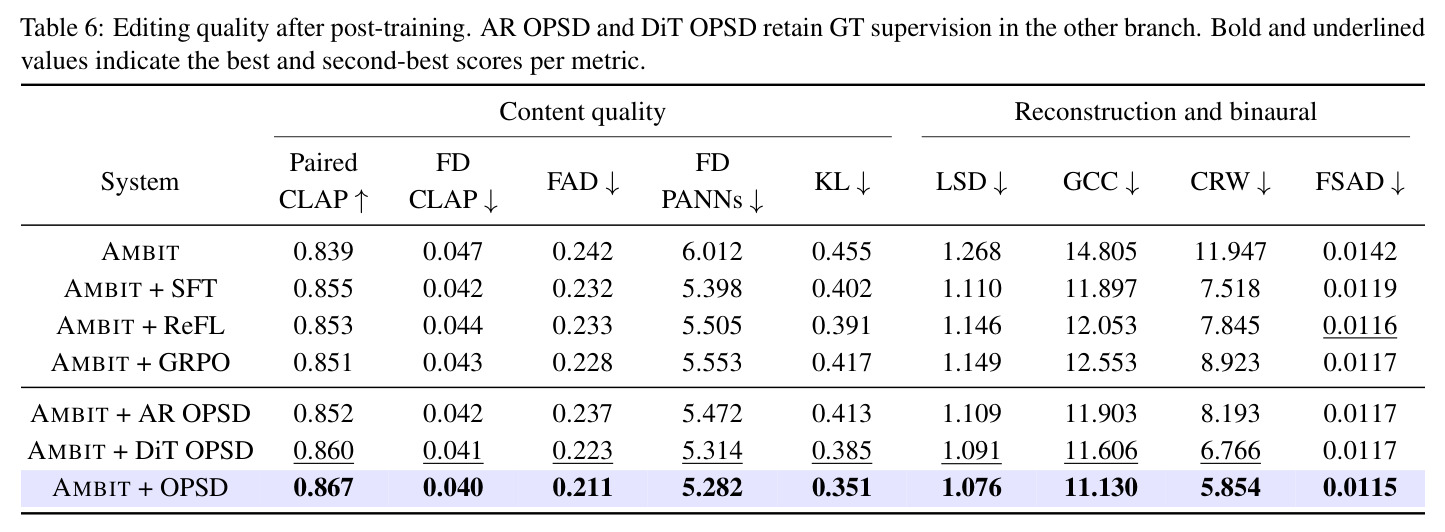
OPSD 是本文第三大贡献,也是实验中收益最大的后训练方法(Table 6 全部 9 项指标领先 SFT/ReFL/GRPO)。理解"学生计划驱动 DiT 轨迹、教师在学生访问状态上监督"这一设计,是读懂第 3.3 节和附录 E 的前提。
CLAP 对比学习
CLAP(Contrastive Language-Audio Pretraining)用对称的音频-文本对比损失训练共享嵌入空间,使匹配的音频-文本对相似度高、不匹配的相似度低,类比 CLIP。本文训练了一个定制的 AMBIT CLAP:从冻结 VAE latent 出发,设语义头(匹配内容与声源数量)和场景头(额外匹配每个源的活动时间、空间轨迹与房间属性)两个对齐头,并用交换轨迹/时间区间构造困难负样本。
编辑时 AMBIT CLAP 输出的全局与时序特征 $F(z_s)$ 是规划器"听懂"源音频、定位要改哪个源的关键条件;同时它的语义头还被用作 ReFL/GRPO 的奖励信号,理解其正负样本构造(内容不变的空间编辑是语义正样本、场景负样本)才能理解各后训练方法的差异。
语法约束解码与可执行计划
指 AR 解码时用形式文法限制每一步的合法 token 集合,保证输出序列一定能通过确定性程序编译、执行。AMBIT 的 SCENEPLAN 是一个 JSON 风格的可执行计划:规定场景时长与房间类型,给每个源(1-4 个)绑定类型、描述、语音逐字稿、活动区间 $[o_i, f_i)$ 和静态或线性 3D 轨迹(方位角/俯仰角/距离)。编译器把计划确定性地编译为语义 cross-attention token 与帧对齐的空间控制 $C(S) \in \mathbb{R}^{256 \times T}$。
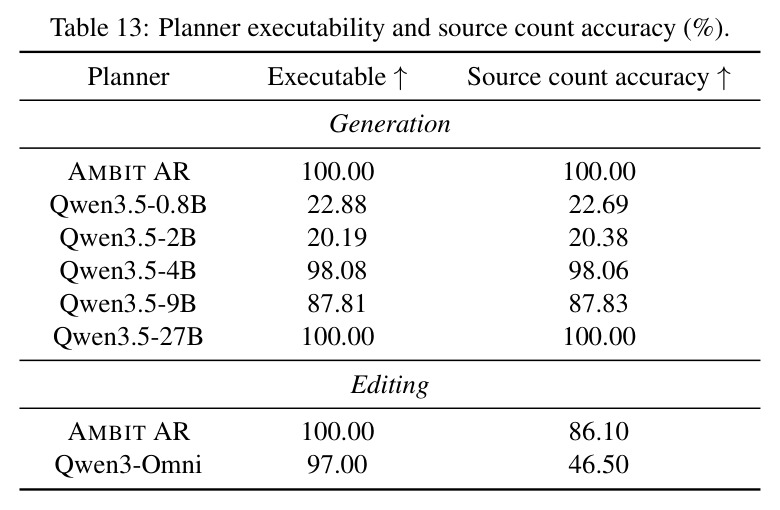
SCENEPLAN 是连接"符号级源决策"与"连续声场渲染"的桥梁,也是编辑时显式声明"改什么、留什么"的载体。Table 13 显示语法约束让 0.8B 的小规划器达到 100% 可执行率,而直接提示 LLM 只能到 22.88%。
研究动机
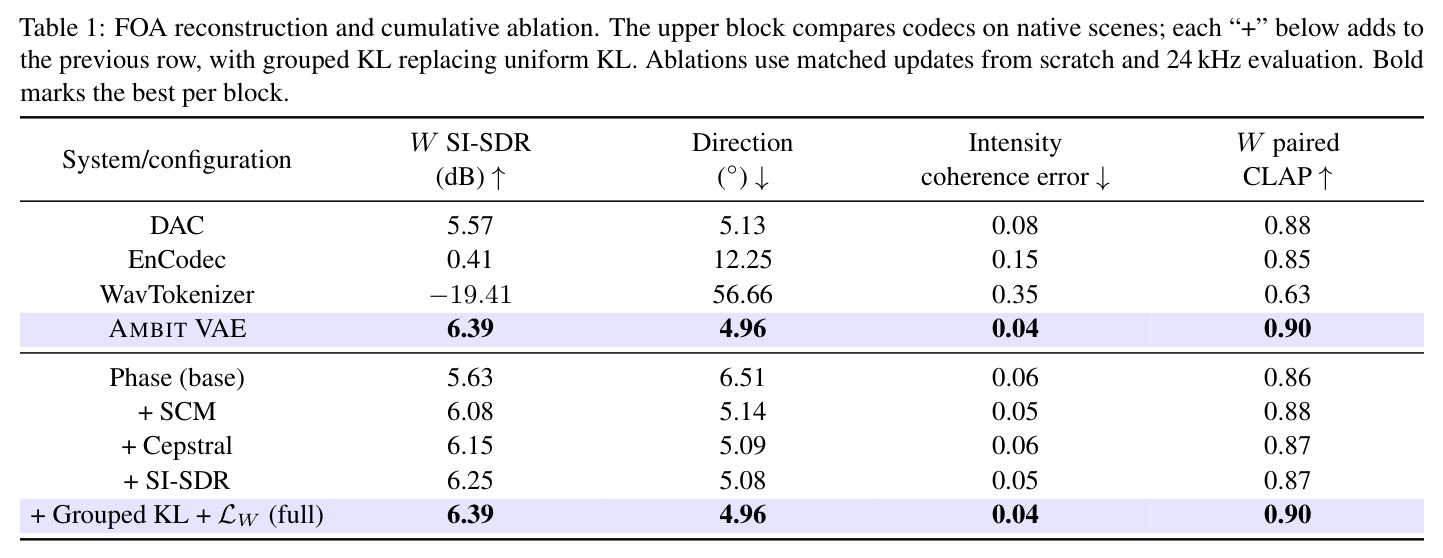
空间音频创作需要同时决定"每个源发出什么、何时活跃、如何移动"并把它们合成为连贯声场,但现有方法在三个层面断裂。其一,语言意图与源级 3D 控制脱节:ImmerseDiffusion、SonicMotion 等虽支持 FOA 文本生成与轨迹控制,AudioChat 只能做到立体声(stereo)规划,尚无模型把源绑定的内容、时间与 3D 运动统一进 FOA 创作;编辑侧的 SwanWeave 虽支持 FOA 指令编辑,但缺乏对"哪些源必须原样保留"的显式机制。其二,表征层面:连续 FOA 自编码器与离散音频编解码器(DAC、EnCodec、WavTokenizer)普遍只做逐通道重建,无法显式监督通道间的能量比、相干性与相位,导致空间结构在压缩中失真——Table 1 显示 WavTokenizer 的 W SI-SDR 低至 $-19.41$ dB、方向误差高达 $56.66^\circ$。其三,训练与推理的分布偏移:配对训练用参考前缀和真值计划,推理却依赖学生自己预测的计划,而一个预测错误的计划会同时改变给渲染器的条件和渲染器沿途经历的采样状态,这种离散-连续耦合误差无法被传统 SFT 修正。
本文的目标是本文要构建一个统一框架 AMBIT,在单一模型内同时完成原生 FOA 的文本生成与指令引导编辑,具体目标有三:第一,让语言直接落地为源级 3D 控制——用可执行、语法约束的 SCENEPLAN 明确规定每个源的内容、活动区间与 3D 轨迹,并确定性编译成渲染条件;第二,编辑时既改得准又留得住——计划描述完整目标场景(含被改与被保留的源),用对比特征锚定请求的改动、用完整参考 latent 提供符号字段之外的残余声学细节;第三,从表征上保住空间结构——设计 FOA 感知的 VAE,显式监督全向 $W$ 通道重建与通道间能量/相干/相位关系;最后,用联合在线自蒸馏(OPSD)在学生自己生成的计划与采样状态上同时精炼规划与渲染,弥合训练-推理偏移。
与已有工作不同的是,本文的独特切入是把"符号规划-确定性编译-流渲染"当作一条刚性流水线焊进一个共享 Transformer,并让后训练也尊重这条流水线的耦合结构。与以往工作的差异在于:(1)不同于用自由文本或 LLM 提示当条件,SCENEPLAN 是语法约束、可执行、可确定性编译的中间表示,从根上保证计划到帧级控制的对齐;(2)不同于掩码式或局部式音频编辑,编辑时预测完整目标场景,让"修改"与"保留"在同一符号结构中显式共存;(3)DiffusionOPSD 等已有在线自蒸馏只针对连续生成器,本文首次把 OPSD 扩展到 Transfusion 双模式:学生的离散计划决定 DiT 的条件与访问的采样状态,冻结教师分别用目标计划记忆和目标音频参考 token 在学生前缀与学生访问状态上提供监督,从而同时修正规划误差与渲染误差。
核心方法
直觉上,AMBIT 把"场景决策"和"声场渲染"变成同一个模型的两条通路:一条自回归通路逐 token 写出可执行计划(决定有什么源、何时响、往哪动),一条整流流通路把编译后的计划渲染成四通道 FOA(决定波形长什么样),两者共享 15 层宽度 1024、16 头的 Transformer 主干。技术路线上:给定输入 $\xi$(生成时为语言请求 $u$,编辑时为参考音频 $x_s$、其 AMBIT CLAP 特征 $F(z_s)$ 与编辑指令 $e$),AR 规划器 $\pi_\theta$ 预测 SCENEPLAN $\hat{S}$;确定性编译器把 $\hat{S}$ 变成语义 token $c_{\text{attn}}$ 和帧对齐空间控制 $c \in \mathbb{R}^{256 \times T}$;DiT 渲染器 $v_\theta$ 预测 latent 速度,经 Euler 积分 $\Phi[v_\theta]$ 后由 VAE 解码出 FOA 输出 $\hat{x} = D_V(\Phi[v_\theta](\epsilon; C(\hat{S}), z_s))$(式 1)。表征端用 FOA 感知 VAE(64 通道、hop 1024,$z_W$ 40 通道、$z_R$ 24 通道),后训练用联合 OPSD 精炼两个模式。
核心创新有四点,本质都是"把耦合的东两显式绑定"。第一,SCENEPLAN 作为 AR 与流渲染之间的可执行接口:不同于把控制权交给隐式的文本 embedding,计划被语法约束保证可解析,编译器确定性地把符号字段(区间重叠、轨迹关键帧)对齐到 latent 帧,渲染条件永远合法且源索引一致。第二,编辑的"完整目标场景"范式:计划同时写明被改源与保留源的全部属性,AMBIT CLAP 的语义/场景双头对比特征负责锚定"指令指向哪个源、改什么",而完整参考 latent $z_s$ 填满 64 个输入通道,为保留源提供计划字段覆盖不到的残余声学细节(音色、混响尾巴)——这是保留指标(方向 MAE 0.17 rad、电平变化 1.65 dB)大幅领先的根源。第三,FOA 感知 VAE 的空间协方差匹配(SCM):在 STFT 协方差层面显式监督能量分数 $p_i$、相干幅度 $\gamma_{ij}$ 与稳定化相位因子 $U_{ij}$(式 6、13),配合共享解码器的辅助 $W$ 重建与非对称分组 KL($\beta_W = 5\times10^{-5} < \beta_R = 2\times10^{-4}$)。第四,联合 Transfusion OPSD:学生计划既当渲染条件又决定采样轨迹,两个冻结教师(规划教师带目标计划记忆 $M(S^\star)$,渲染教师带干净目标音频参考 token $H_y$)只在学生遇到的上下文上出手(式 8、9),并通过共享参数把两路梯度耦合起来。
方法步骤详情
整个系统分五步搭建。第一步,VAE 预训练:在约 100 万条 FOA 片段(含 Spatial LibriSpeech,4 秒裁剪)上训练 Oobleck 风格 VAE,总损失 $\mathcal{L}_{\text{VAE}} = \mathcal{L}_{\text{base}} + \mathcal{L}_W + \mathcal{L}_{\text{KL}} + \lambda_{\text{SCM}}\mathcal{L}_{\text{SCM}}$(式 7,$\lambda_{\text{SCM}}=0.015$),$\mathcal{L}_W$ 把 $z_R$ 置零后复用同一解码器只重建 $W$,KL 用分组惩罚 $\mathcal{L}_{\text{KL}} = \beta_W K_W + \beta_R K_R$。第二步,AMBIT CLAP 训练:用 100 万编辑对,损失 $\mathcal{L}_{\text{align}} = \mathcal{L}_{\text{sem}} + \lambda_{\text{scene}}\mathcal{L}_{\text{scene}}$ 加绑定/配对/事件项(式 17),训练后冻结、只输出全局与时序特征 $F(z_s)$。第三步,联合监督训练:数据为 160 万生成样本 + 100 万编辑对;先做规划器 warm-up(渲染器冻结,只训 LoRA 与规划头,LoRA 秩 8),再做联合优化 $\mathcal{L}_{\text{joint}} = \mathcal{L}_{\text{AR}} + \mathcal{L}_{\text{RF}} + \lambda\mathcal{L}_{\text{struct}}$(式 4,$\lambda=0.1$),AdamW 学习率适配器/头 $10^{-4}$、共享块 $2\times10^{-6}$,共 332.6M 可训练参数,8 张 L40S。第四步,OPSD 后训练:先用 1000 次 AR 更新 + 3000 次 DiT 更新(batch 128)从同一监督模型准备两个冻结教师;随后每轮 batch 64,学生语法约束贪心解码得 $\hat{S}$ 与非强制决策前缀 $\{h_i\}$,规划教师给出目标分布 $q_i$,学生计划编译后驱动 DiT rollout($R=3$ 条噪声轨迹、各 $K=20$ 步 Euler、四个时间分层各采样一次,共 $4R=12$ 个查询状态),渲染教师在这些状态上给出干净 latent 目标,总损失 $\mathcal{L}_{\text{OPSD}} = \lambda_{\text{AR}}\ell_{\text{AR}} + \lambda_{\text{DiT}}\ell_{\text{DiT}} + \lambda_{\text{ref}}\ell_{\text{ref}}$(式 10,权重 0.1/1/0.1)。第五步,推理:生成用 100 步 Euler、guidance 3.0、rescaling 0.4;编辑用 20 步、guidance 1.0。
技术新颖性
技术新颖性体现在四层。(1)架构层面:Transfusion 此前用于文本+图像,本文是它首次承载"语言→符号计划→原生 FOA 声场"的完整管线,且 AR/DiT 两模式的条件在编辑时共享同一份源 latent(输入 384 通道 = 64 噪声 latent + 256 空间控制 + 64 参考 latent),共享表征使渲染梯度能反过来塑形规划。抽象层面,"可执行计划 + 确定性编译"把 LLM 工具调用的可靠性工程引入音频生成,Table 13 证明这让 0.8B 规划器达到 100% 可执行率,超过提示 27B LLM 的效果。(2)表征层面:SCM 是把 DirAC/FOA Tokenizer 的空间一致性思想搬进连续 VAE 的逐对通道 STFT 协方差监督,能量、相干、相位三项都用参考能量加权并做了数值稳定化(式 12-14),与逐通道相位监督正交。(3)后训练层面:这是首个针对离散-连续耦合模型的联合 OPSD——已有工作要么只蒸 LLM token(Zhao et al., 2026b),要么只蒸扩散模型连续状态(DiffusionOPSD),本文的关键洞察是学生的计划误差会传播为渲染的条件误差与轨迹误差,必须在学生自己生成的计划和访问的状态上同时蒸馏,并给出了有限步教师追踪误差上界 $\delta_K^2 \le C_{K,L}\ell_{\text{full}}$(式 32)作为分析支撑。(4)评估层面:提出区分"重建目标场景"与"保留原始源"的双视角编辑评估,以及目标级方向误差协议。
实验结果
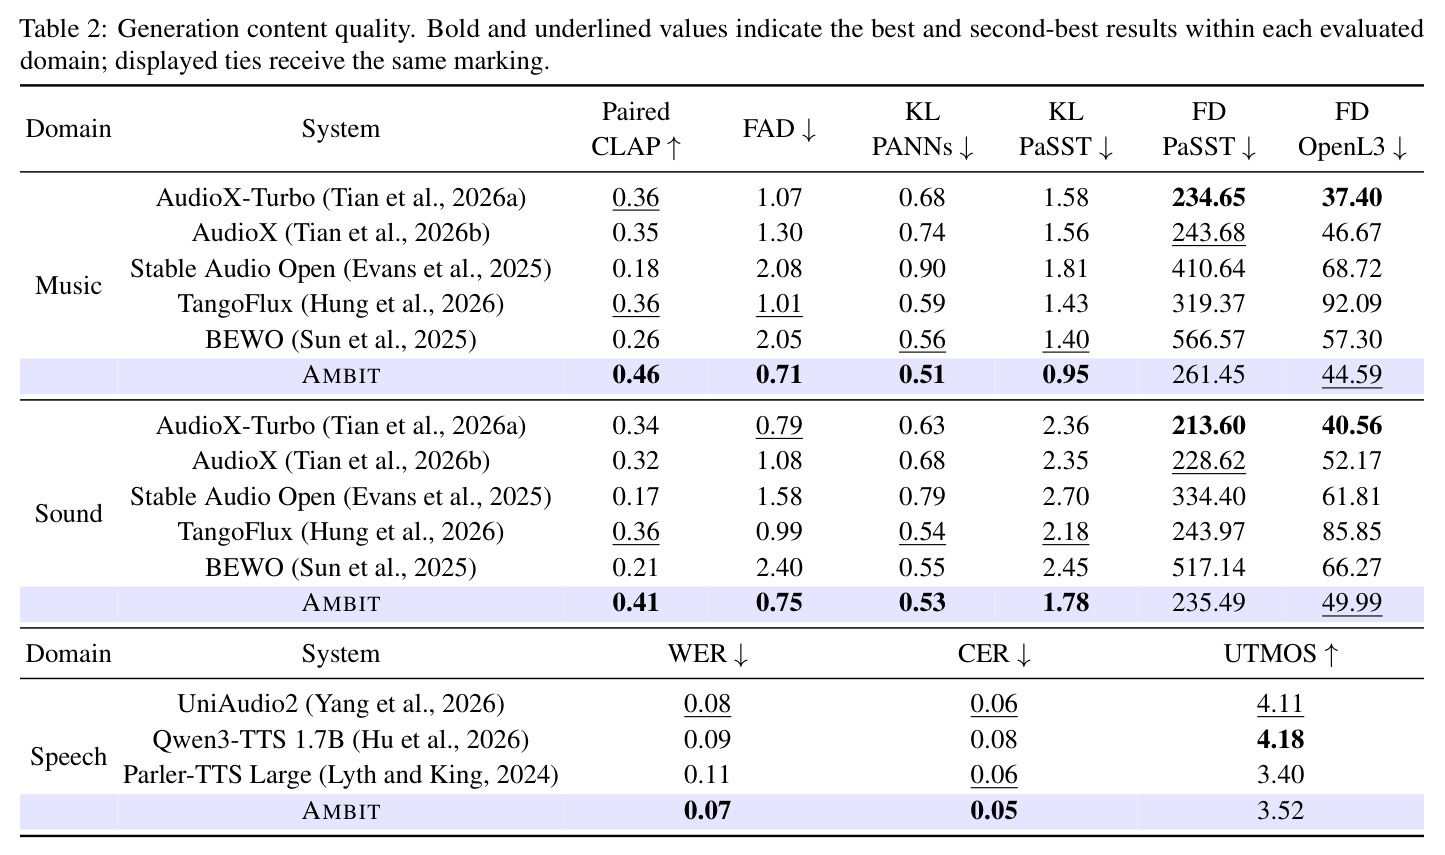
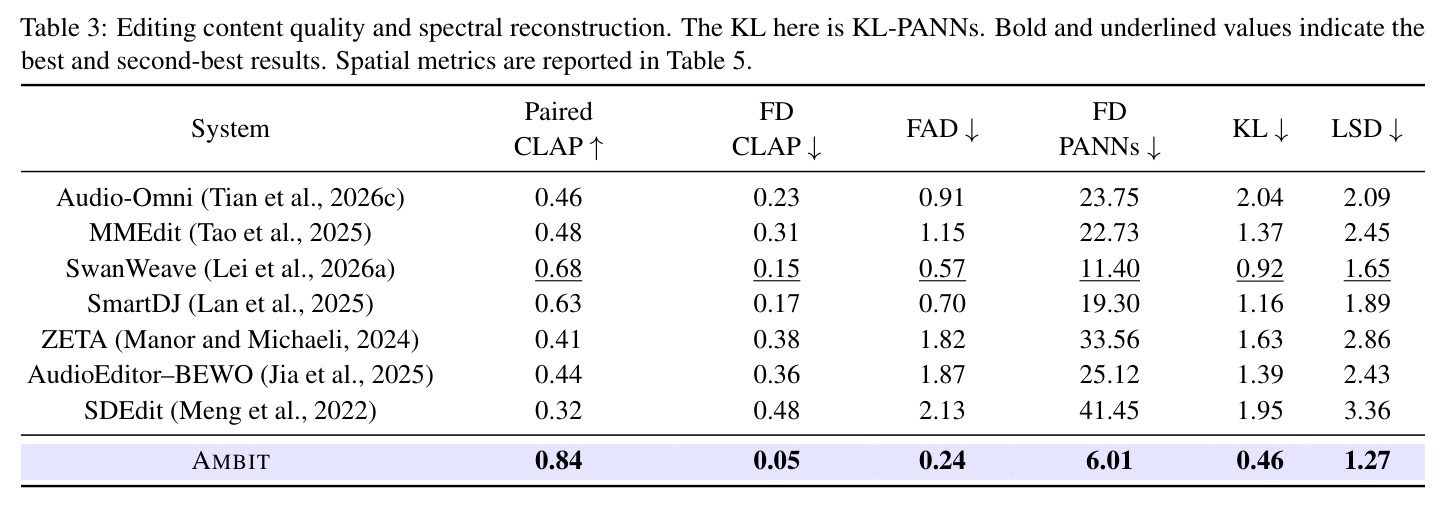
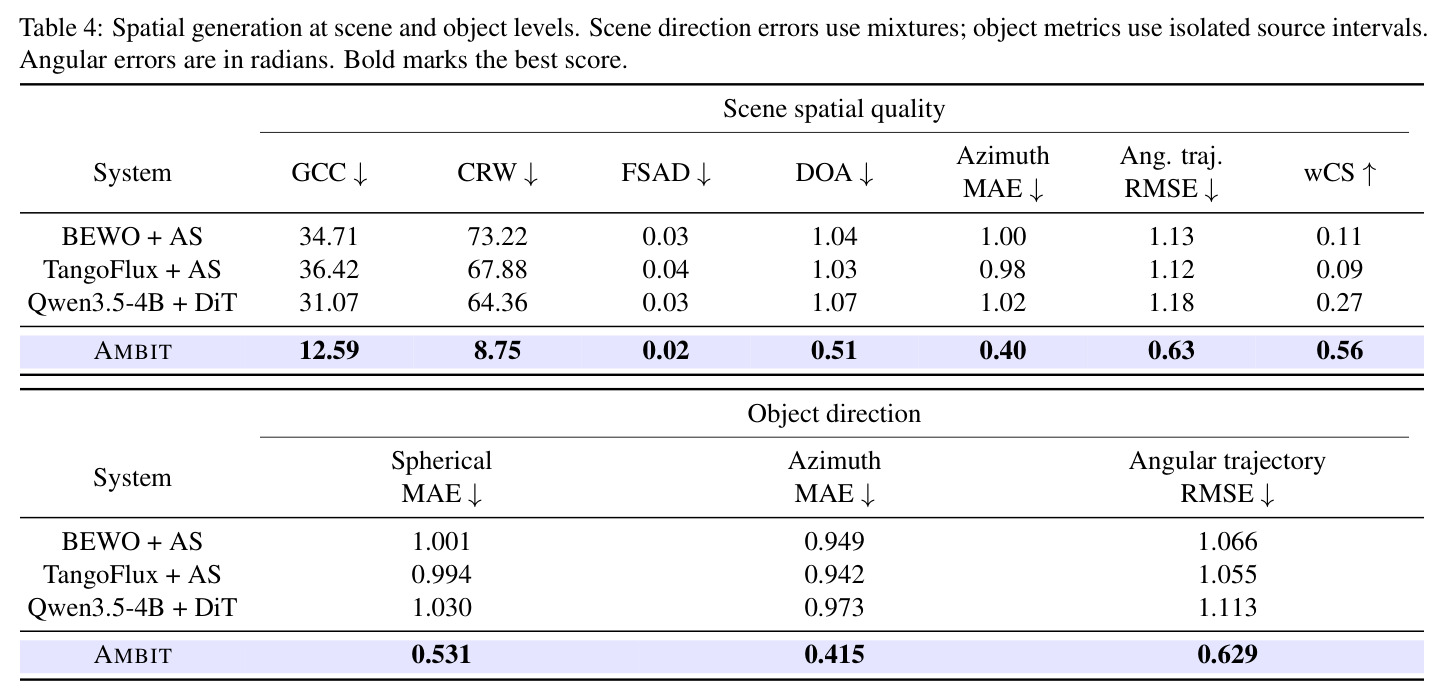
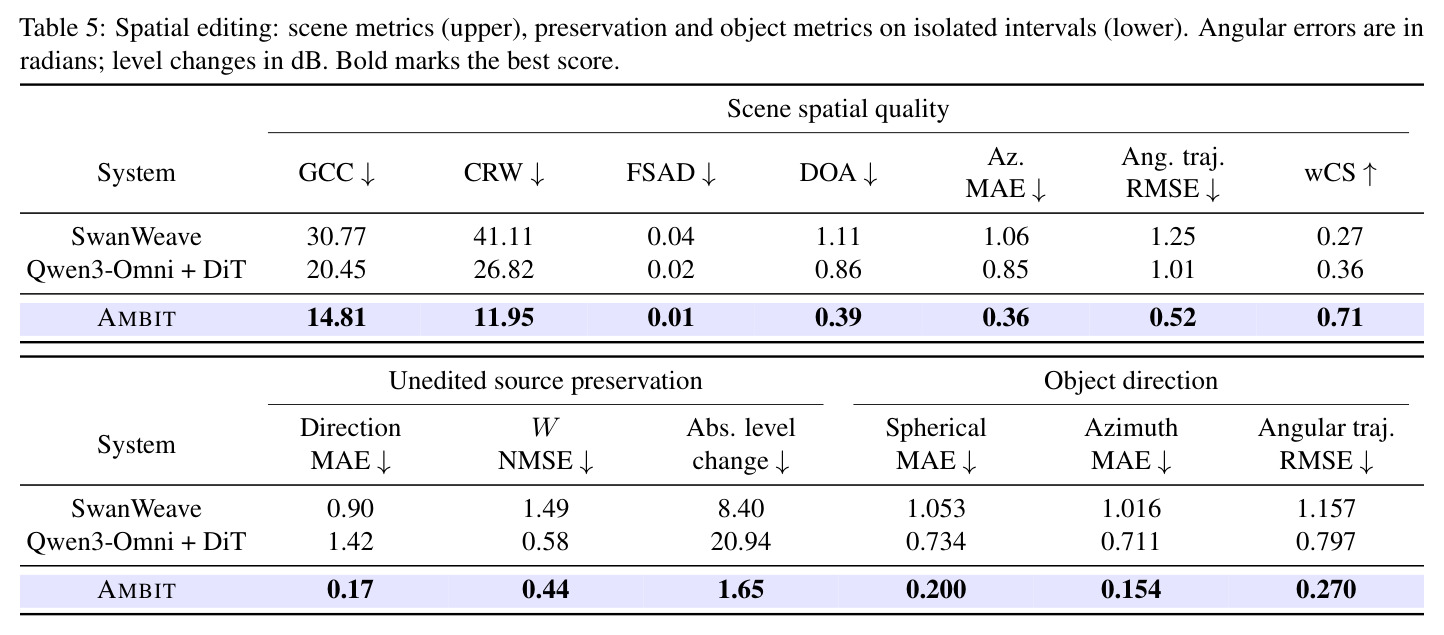
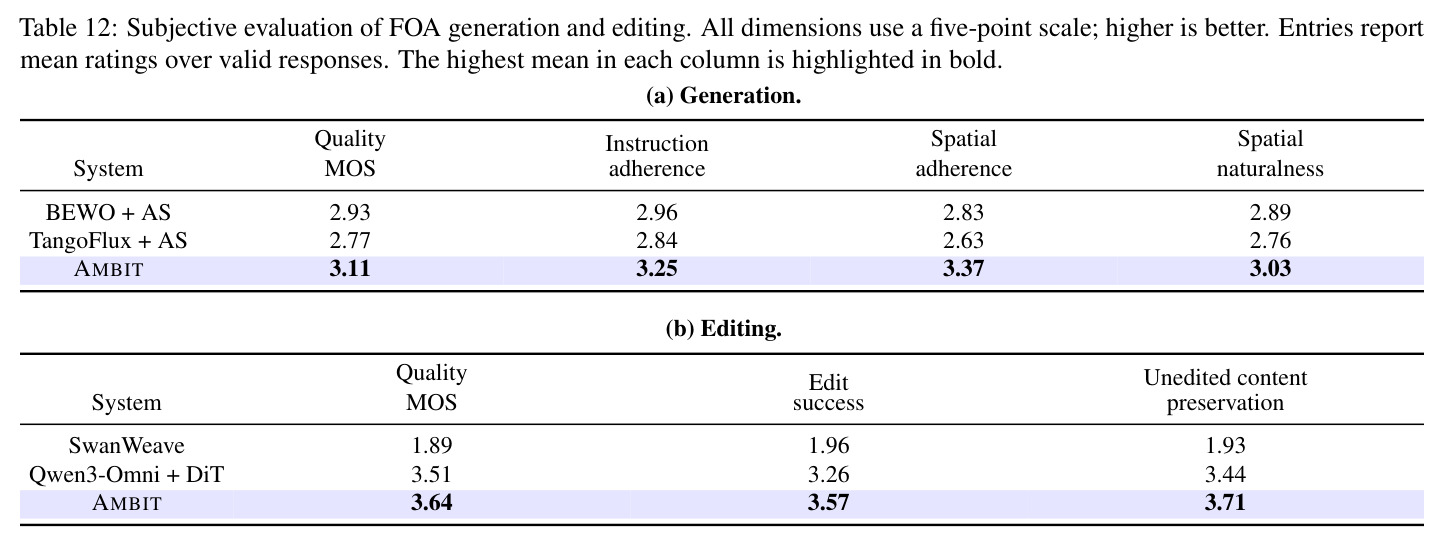
实验覆盖 VAE、生成、编辑、空间精度与后训练五条线,全部使用同一 AMBIT 检查点。VAE(Table 1,2000 条测试):AMBIT VAE 四项全面领先,W SI-SDR 6.39 dB、方向误差 $4.96^\circ$、强度相干误差 0.04、W 配对 CLAP 0.90;对比 DAC(5.57 dB/$5.13^\circ$/0.08/0.88)、EnCodec(0.41 dB/$12.25^\circ$/0.15/0.85)、WavTokenizer($-19.41$ dB/$56.66^\circ$/0.35/0.63)。消融显示 SCM 单项即把方向误差从 $6.51^\circ$ 降到 $5.14^\circ$、W SI-SDR 从 5.63 升至 6.08 dB,说明显式监督通道间关系是关键。生成(Table 2,8000 条请求):音乐 paired CLAP 0.46、FAD 0.71、KL-PANNs 0.51 均为最优(AudioX-Turbo 为 0.36/1.07/0.68);声音 0.41/0.75/0.53 同样领先;语音 WER 0.07、CER 0.05 为全场最低(Qwen3-TTS 1.7B 为 0.09/0.08),但 UTMOS 3.52 低于 Qwen3-TTS 的 4.18,显示表现力有折损。编辑(Table 3,5000 对):六项指标全胜最强的 SwanWeave——paired CLAP 0.84 对 0.68、CLAP 偏差 0.05 对 0.15、FAD 0.24 对 0.57、FD-PANNs 6.01 对 11.40、KL 0.46 对 0.92、LSD 1.27 对 1.65。空间生成(Table 4):场景 DOA 0.51 rad(级联基线约 1.03-1.07)、方位 RMSE 0.40、目标球面 MAE 0.531(基线约 1.0)、wCS 0.56;一个有趣发现是 Qwen3.5-4B+DiT 改善了双耳指标 GCC/CRW/wCS 却有更高的方向误差,说明双耳听感好不等于声源放置准。空间编辑(Table 5):场景 DOA 0.39 对 SwanWeave 1.11;未编辑源保留的方向 MAE 0.17 对 0.90、W NMSE 0.44 对 0.58(Qwen3-Omni+DiT)、绝对电平变化 1.65 dB 对 8.40 dB。后训练(Table 6):联合 OPSD 在全部 9 项指标领先(paired CLAP 0.867、FAD 0.211、FD-PANNs 5.282、KL 0.351、LSD 1.076、GCC 11.130、CRW 5.854、FSAD 0.0115),超过 SFT、ReFL、GRPO 及两个单分支变体;其中 DiT OPSD 次优、AR OPSD 仅改善 LSD/FSAD,说明渲染端蒸馏收益更大但联合最优。主观听测(Table 12,20 人):生成 MOS 3.11、空间遵从 3.37(超最强基线 +0.54);编辑质量 3.64、编辑成功 3.57、保留 3.71。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FOA 重建(编解码器对比,2000 条测试) | W SI-SDR (dB) ↑ | 6.39 | DAC 5.57 / EnCodec 0.41 / WavTokenizer -19.41 | 较最强基线 DAC +0.82 dB |
| FOA 重建(编解码器对比) | 方向误差 (°) ↓ | 4.96 | DAC 5.13 / EnCodec 12.25 / WavTokenizer 56.66 | 较 DAC 降低 0.17°,较 EnCodec 降低 59% |
| 音乐生成(8000 条请求) | Paired CLAP ↑ | 0.46 | AudioX-Turbo 0.36 / TangoFlux 0.36 / BEWO 0.26 | +0.10 |
| 音乐生成 | FAD ↓ | 0.71 | AudioX-Turbo 1.07 / TangoFlux 1.01 | 降低约 30% |
| 语音生成 | WER ↓ | 0.07 | Qwen3-TTS 1.7B 0.09 / UniAudio2 0.08 | 最低,但 UTMOS 3.52 低于 Qwen3-TTS 4.18 |
| 指令编辑(5000 对) | Paired CLAP ↑ | 0.84 | SwanWeave 0.68 / SmartDJ 0.63 | +0.16 |
| 指令编辑 | FAD ↓ | 0.24 | SwanWeave 0.57 / Audio-Omni 0.91 | 较 SwanWeave 降低 58% |
| 指令编辑 | LSD ↓ | 1.27 | SwanWeave 1.65 / SmartDJ 1.89 | -0.38 |
| 空间生成(场景级方向) | DOA 误差 (rad) ↓ | 0.51 | BEWO+AS 1.04 / TangoFlux+AS 1.03 / Qwen3.5-4B+DiT 1.07 | 误差约减半 |
| 空间生成(目标级方向) | 球面 MAE (rad) ↓ | 0.531 | TangoFlux+AS 0.994 / Qwen3.5-4B+DiT 1.030 | 误差降低约 47% |
| 空间编辑(未编辑源保留) | 方向 MAE (rad) ↓ | 0.17 | SwanWeave 0.90 / Qwen3-Omni+DiT 1.42 | 较 SwanWeave 降低 81% |
| 空间编辑(未编辑源保留) | 绝对电平变化 (dB) ↓ | 1.65 | SwanWeave 8.40 / Qwen3-Omni+DiT 20.94 | 较 SwanWeave 降低 80% |
| OPSD 后训练(编辑) | Paired CLAP ↑ | 0.867 | SFT 0.855 / ReFL 0.853 / GRPO 0.851 / DiT OPSD 0.860 | 9 项指标全面第一 |
| OPSD 后训练(编辑) | CRW ↓ | 5.854 | SFT 7.518 / GRPO 8.923 / DiT OPSD 6.766 | 较 SFT 降低 1.664 |
局限与改进
作者明确承认的限制只有一条:当前 SCENEPLAN 配置最长支持约 15 秒场景(648 个 latent 帧、hop 1024),更长声景与连续多次编辑后的声学一致性留作未来工作。结合全文可补充观察:(1)轨迹表达受限——只支持静态或 2-8 关键帧的线性运动,方位量化到 $1^\circ$、距离 0.1-50 m 对数分箱,无法表达曲线运动与复杂的源间交互;(2)编辑操作词汇小——每条指令只允许对单个源执行 SPATIAL/TIME RELOCATE、STATIC→LINEAR、LINEAR→STATIC、ADD 或 REMOVE 之一,不支持换音色、改增益、改房间等属性级修改,房间也只有干/中等/混响/户外四类;(3)域差距——训练数据主体是 Pyroomacoustics 渲染的合成场景(1.6M 生成 + 1M 编辑对),真实 FOA 测试只含 50 条 STARSS23 片段,真实混响与个体 HRTF 下的表现未充分验证;(4)语音表现力折损——UTMOS 3.52 显著低于 Qwen3-TTS 的 4.18,说明共享渲染器在韵律/音质上不如专用 TTS;(5)OPSD 上限受教师质量约束——作者自己在附录 E 承认"target-audio accuracy depends on teacher quality",两个教师都由同一个监督模型准备,蒸馏难以超越教师的Target精度;(6)主观实验规模有限——20 名被试、每任务 400 例,且保留类指标依赖活动区间掩码,混响尾巴可能污染"未编辑源"的测量。
独立分析的弱点
独立分析可指出五个具体弱点。第一,15 秒时长上限:沉浸式声景(如环境音设计)常需分钟级素材,当前模型无法流式或分块生成,改进方向是引入分块自回归 + 跨块 latent 记忆(类似 SwanSphere 的流式 DiT 思路),并让 SCENEPLAN 支持章节级结构。第二,运动模型过于简化:线性关键帧插值无法表达圆弧、加减速或遮挡导致的遮挡式变化,且通道内没有衰减/衍射建模,改进方向是样条或物理引导的轨迹参数化(可借鉴 PhysWave 的方向-距离一致性先验),并在编译器中加入遮挡计算。第三,编辑语义覆盖窄:不能"把钢琴换成吉他""把声音调小 6 dB""改成户外",而增益字段在规划编解码中恒为 0 dB,改进方向是扩展计划 schema 支持源级增益/替换/房间属性编辑,并相应扩展 AMBIT CLAP 的场景头负样本。第四,语音质量瓶颈:渲染器对语音的韵律建模不足(UTMOS 3.52 vs 4.18),可为语音模式增加专用适配器或在渲染损失中加大语音活动帧权重(现有 $w_t=3$ 的加权可再强化),或接入专用语音声码器。第五,OPSD 的教师天花板与稳定性:两教师源自同一监督模型,教师偏好的渲染误差会被学生继承;且在线 rollout + 12 次教师查询带来可观算力开销,改进方向是引入外部更强教师(如更大的 FOA 渲染模型)做异源蒸馏,或用 EMA 学生作为自举教师降低成本,并对计划-渲染耦合误差做显式课程(先固定真值计划蒸渲染,再逐步放开计划)。
未来方向
作者提出的方向:把 AMBIT 扩展到更长时长的声景创作,并评估连续多次编辑下的声学一致性。基于其成果可自然延伸的方向包括:(1)视频条件 FOA 生成——把 SCENEPLAN 的源字段与视觉检测/跟踪绑定,实现 ViSAGe 类任务但带显式可编辑计划;(2)实时/流式版本——结合因果空间声码器(如 CSAVocoder)把 20 步 Euler 渲染进一步压缩到少步蒸馏,服务 VR/游戏引擎;(3)交互式创作代理——SCENEPLAN 天然是 JSON,可让 LLM 代理多轮调用生成/编辑/查询接口,构建"音频版剪辑软件";(4)把联合 Transfusion OPSD 推广到其他双模式统一模型(如视频+音频、图像+文本的可控生成),其"学生计划驱动连续渲染轨迹"的设计是通用的;(5)评估与奖励升级——用空间理解 MLLM(Spatial-Omni 类)替代仅语义的 CLAP 奖励,使 GRPO/ReFL 能感知方向与时间误差;(6)更长程的空间一致性——引入房间脉冲响应的显式latent或可微房间声学模型,让多次编辑后的混响与距离衰减保持物理一致。
复现评估
复现评估:中等偏难但信息充分。论文提供了项目页 https://wjm-george.github.io/AMBIT/(含音频示例),正文未明确给出代码开源链接,若不开源则需要自行实现编译器、语法约束解码与规划头等工程细节。数据方面全部组件可重建:合成场景基于公开资产(LibriTTS、Hi-Fi TTS、HiFiTTS-2、AudioCaps、AudioSet、FSD50K、PicoAudio、VGGSound、MusicCaps)用 Pyroomacoustics 渲染,伪标注用 Qwen3-Omni 与 Qwen3.5 生成,管线在附录 A 写得很具体(房间分布、RT60、增益目标 $-23$ dBFS 等);但总量大——160 万生成样本 + 100 万编辑对 + 100 万 VAE 片段 + 100 万 CLAP 对。算力方面:主干模型 332.6M 可训练参数,冻结 Qwen3.5-0.8B 文本骨干,训练用 8 张 NVIDIA L40S(约 384 GB 显存总量),OPSD 教师准备 1000+3000 次更新、精炼阶段每条请求 3 条轨迹 × 20 步 Euler + 12 次教师查询——中等规模实验室可以负担,但完整复现所有消融(Table 1 的从零训练 VAE 变体、Table 6 的六种后训练)工作量不小。超参数披露非常完整:学习率、batch、OPSD 权重 $\lambda_{\text{AR}}/\lambda_{\text{DiT}}/\lambda_{\text{ref}} = 0.1/1/0.1$、采样设置(生成 100 步/guidance 3.0,编辑 20 步/guidance 1.0)、SCM 的数值稳定化与加权公式均在附录 B/C/E 给出,评估协议(KEMAR 双耳解码、方向误差掩码规则)也可照抄。综合判断:有代码则复现主要结果是可行的,从零实现约需数周工程量,主要风险在语法约束编解码器与规划头这些未附伪代码的组件。
论文图表
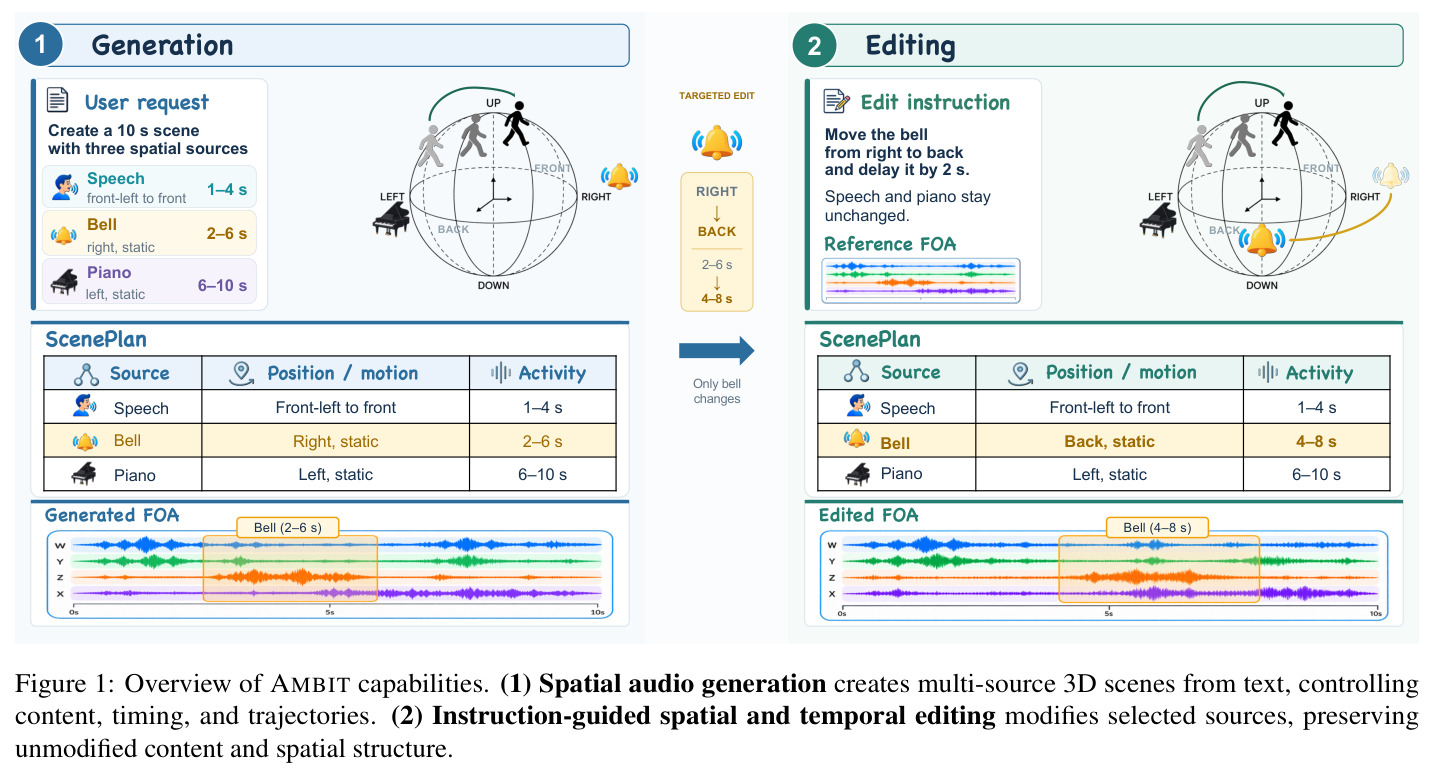
并排展示两个任务的具体例子。左半(生成):用户请求"创建一个 10 秒、三个空间源的场景",下方 ScenePlan 表格列出语音(前左到前,1-4 秒)、铃铛(右侧静止,2-6 秒)、钢琴(左侧静止,6-10 秒),最终生成 FOA 输出。右半(编辑):指令"把铃铛从右移到后方并延迟 2 秒,语音和钢琴不变",配合参考 FOA 音频,ScenePlan 中只有铃铛一行被改动(右/2-6秒 → 后/4-8 秒),其余源保持原样,输出编辑后的 FOA。
一图讲清论文要解决的两个任务和核心机制:计划如何显式区分"改哪个源"与"留哪些源",这是理解编辑范式(完整目标场景 + 保留源显式共存)的最直观入口。