面向 CVaR 策略评估的尾影响采样 Tail-Influence Sampling for CVaR Policy Evaluation
为每个可查询条件转移核推导“尾影响”分数并据此分配查询预算,实现 CVaR 的 oracle 级估计
前置知识
CVaR(条件风险价值)
低尾 CVaR$_\alpha$ 是最差 $\alpha$ 比例运行的平均回报:$\mathrm{CVaR}_\alpha(X)=\frac{1}{\alpha}\int_0^\alpha F_X^{-1}(u)\,du$。与 VaR 只给出尾部边界不同,CVaR 度量尾部平均严重程度,且是一致风险度量(Rockafellar & Uryasev, 2000)。$\alpha$ 越小对应越罕见的事件。
它是本文的估计目标:分配分数、效率界和全部实验指标(CVaR$_{10}$ MSE)都围绕它构建,其期望短缺恒等式是方法推导的起点。
Neyman 最优分配
经典分层采样结论(Neyman, 1934):把预算 $N$ 分给独立层,份额 $w_g=n_g/N$,总方差 $V(w)=\sum_g \sigma_g^2/w_g$($\sigma_g$ 为层内标准差)。由 Cauchy–Schwarz,最优份额与层标准差成正比:$w_g^*=\sigma_g/\sum_j\sigma_j$。
本文把 Neyman 分配推广到分数本身依赖未知 Bellman 续模型的 CVaR 场景,Theorem 1–3 的核心就是把 $\sigma_g$ 替换为尾影响尺度。
分布式强化学习与 categorical 投影
分布式 RL(Bellemare et al., 2017)不在固定网格 $Z=\{z_0<\dots<z_{K-1}\}$ 上逼近回报均值而是逼近回报的概率分布。Bellman 更新把“奖励+下层分布”平移后,用 categorical 投影把概率质量按线性权重分摊到相邻网格点并在端点截断。论文证明该投影在网格阈值处保持期望短缺不变(Lemma 1)。
论文的估计器是经验 categorical Bellman 不动点,所有影响函数与渐近分析都建立在这个网格表示及其保短缺性质之上。
伴随灵敏度与影响函数
影响函数度量“单次观测的扰动如何一阶地改变最终估计量”。本文解线性方程 $(I-M)^\top r=e_{x_0}$($M$ 为 Bellman 续承矩阵,$e_{x_0}$ 选根短缺坐标)得伴随权重 $r$,则一次查询的一阶效应为 $\phi_g(W)=-\frac{1}{\alpha}r^\top\Xi_g(W)$,原理类似自动微分的反向传播。
尾影响分数就是影响函数的方差,是分配规则的唯一输入;不理解误差如何经 Bellman 不动点传播到根,就无法理解为何某些核值得更多查询。
防御性混合采样
重要性采样中的经典保险策略(Hesterberg, 1995;Owen & Zhou, 2000):把目标导向设计与更宽的参考设计按固定比例混合,牺牲一点效率换取对“目标设计漏掉重要区域”的鲁棒性。本文 anchored TIS 取 $w^{\mathrm{anc}}=\frac12(w^{\mathrm{inf}}+w^{\mathrm{occ}})$,尾影响份额与访问率份额各半。
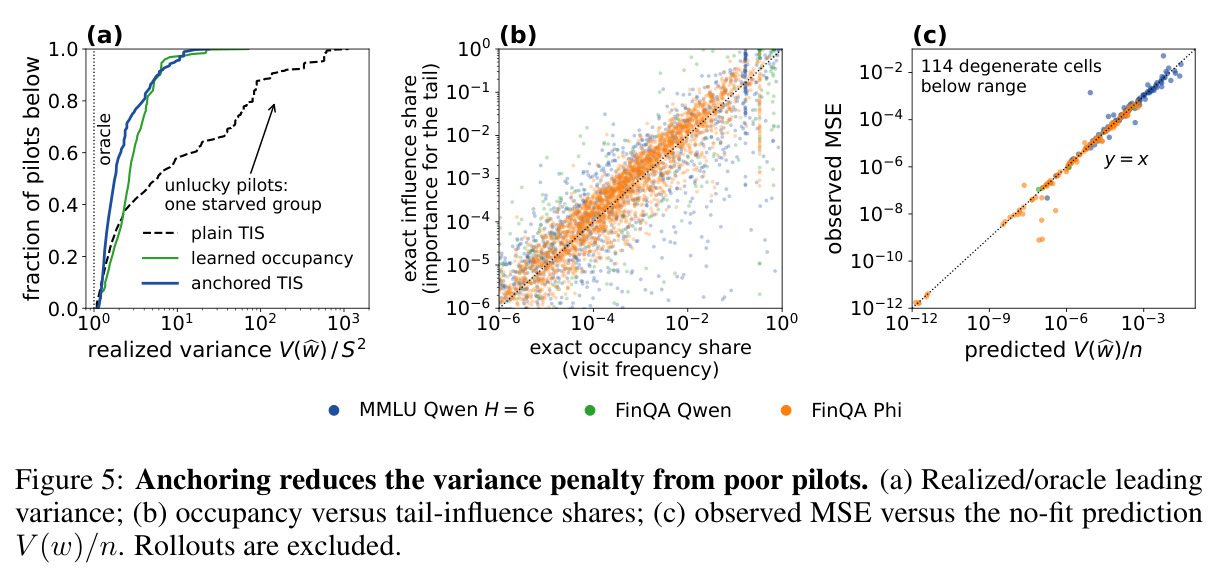
anchored TIS 是论文在 LLM 实验中真正推荐的方法,其 ≤2× oracle 保证直接源自防御混合原理;pilot 漏掉稀有致命结果的失败模式全靠它兜底。
生成模型访问与查询组
指评估器可从任意指定的(状态,动作)独立采样奖励与下一状态 $(R,S')\sim P_{s,a}$,无需先 rollout 到达该状态。论文把每个可独立重放的条件律称为查询组/核 $g=(s,a)$,组内 i.i.d.、组间独立。LLM 实验中对应“由答案与置信度重构审查提示并直接采样其响应”。
整个问题设定依赖这种访问模型——没有条件重放能力就没有“在哪里采样”的选择权,方法也就无从谈起。
研究动机
平均回报会掩盖最要命的罕见失败:一个语言模型工作流可能在绝大多数运行中回答正确,却偶尔产出严重的数值错误;机器人也可能极少进入造成损坏的状态。低尾 $\mathrm{CVaR}_\alpha$ 度量最差 $\alpha$ 比例运行的平均回报,但用蒙特卡洛完整 rollout 估计这个尾部平均代价极高:一条 $H$ 步轨迹要花 $H$ 次转移查询才换回一个回报样本——CliffWalking 中 $H=20$,FinQA 审查工作流从 3 次调用扩到 6 次调用;库存实验中 49,200 次转移只相当于 615 个最差十分位回报。更关键的是,完整 rollout 几乎把预算全花在与最坏结果无关的转移上:运行很少到达产生最坏结果的(状态,动作),例如工具返回错误值的步骤。均匀采样和按访问率采样都不能定位尾部不确定性的真正来源——常被访问的状态可能结果完全可预测,而稀有状态的不确定性却决定失败的严重程度。
本文的目标是本文设定:策略完全固定,但评估器拥有“可重置生成访问”——可直接从任意选定的(状态,动作)条件律采样下一奖励与状态,无需先 rollout 到那里。目标是在总查询预算 $N=\sum_g n_g$ 下,决定给每个可查询核 $g=(s,a)$ 分配多少查询 $n_g$,使固定策略回报 $G_H(s_0)$ 的 $\mathrm{CVaR}_\alpha$ 估计的均方误差最小。作者要的不只是启发式规则,而是完整理论:(1) 可计算的“尾影响”分配分数;(2) 证明其方差给出固定设计的半参数效率界与 oracle Neyman 分配;(3) 证明从 pilot 学习分数、截断与分配后仍达 oracle 渐近方差与含 pilot 成本的一阶 MSE,anchored 变体不超过 oracle 的 2 倍;(4) 刻画尾专项分配何时无益并给出可操作的诊断量。
与已有工作不同的是,已有工作的空档在于:分布 RL 的统计推断(Zhang et al. 2025;Cheng et al. 2026)分析“给定采样律下”的估计效率,自适应分层采样(Étoré & Jourdain 2010;Carpentier et al. 2015)学习的是层内固定量的方差,ReVar/SaVeR 等轨迹设计针对均值评估。本文的独特切入有二。第一,分配分数本身依赖未知的 Bellman 续模型和 CVaR 截断 $q_\alpha$,必须与分配一起学习——Theorem 3 正是控制“边学分数边分配”的误差。第二,同一核会在多个 Bellman 阶段被复用(同一审查提示在多步循环重复、控制策略重访同一状态),一次观测同时影响多处的回报计算;因此必须先对该样本在所有阶段的一阶效应求和(保留跨阶段协方差)再取方差,这与把每次使用当作独立观测的做法有本质区别。
核心方法
直觉:把预算花在“其结果不确定性会真实改变最差 $\alpha$ 比例运行平均值”的转移核上。技术路线分三步。第一步把 CVaR 写成期望短缺(stop-loss):$C_{\alpha,\mathrm{K}} = q_\alpha - \frac{1}{\alpha}U_H(s_0,q_\alpha)$,其中 $U_h(s,q)=\mathbb{E}[(q-Z_h(s))^+]$;“正分位数裕量”假设保证 $q_\alpha$ 在小扰动下不变、CVaR 局部线性。第二步,沿 categorical Bellman 递推 $p^*_{h,s}=\sum_a \pi_h(a|s)\,\mathbb{E}[Q(R)p^*_{h-1,S'}]$,用伴随方程 $(I-M)^\top r=e_{x_0}$ 把单次观测的短缺误差传播到根坐标 $x_0=(H,s_0,q_\alpha)$。第三步,单次查询的一阶 CVaR 效应为 $\phi_g(W)=-\frac{1}{\alpha}r^\top\Xi_g(W)$,其方差 $\sigma_g^2=\mathbb{E}[\phi_g(W)^2]$ 给出 $V(w)=\sum_g\sigma_g^2/w_g$,最小化即得经典 Neyman 分配。全程只需两层 pass(前向求短缺、反向求权重),无需稠密矩阵求逆。
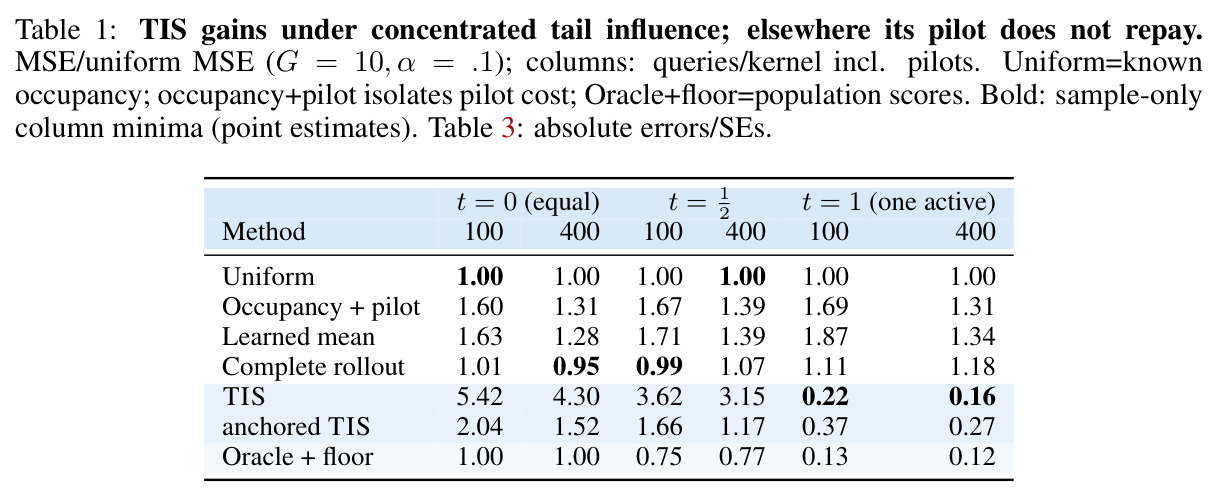
核心创新是“尾影响”这一可计算、可学习的分配信号:对每个 pilot 观测,计算它在其被复用的所有 Bellman 阶段上的短缺更新误差 $\Xi_g(W)=T_g(W;U^*)-\mathbb{E}T_g(W;U^*)$,用伴随权重 $r$ 汇总到根并除以 $-\alpha$,得到该样本对 CVaR 的总一阶效应;对效应取样本方差即得尺度 $\hat\sigma_g$。与已有方法的本质区别有两点。其一,求和发生在取方差之前:同一抽样的跨阶段协方差被完整保留(论文的 $H=2$ 例子中,把共享抽样的两次使用当独立处理会把方差算成 $25/72$,真值是 $25/36$)。其二,奖励方差、访问率、均值影响都不能替代尾分数——Proposition 1 构造了所有核访问率相同、条件均值均为 $1/2$、方差均为 $1/36$、甚至根回报律完全相同的单步模型族,其中 $V_{\text{occupancy}}=V_{\text{mean}}=1/G$ 而 $V^*=1/G^2$:10 个核时 oracle 的首阶 MSE 只有均匀采样的十分之一。
方法步骤详情
执行流程(Algorithm 1):(1) Pilot:每核抽 $m_N$ 个样本(总量约 $N^{2/3}$,如 $m_N=\lceil 4N^{2/3}/G\rceil$),拟合 categorical 网格上的转移/奖励律,逐层 Bellman 递推得根分布与根分位数 $q_\alpha$,pilot 样本随后丢弃。(2) 打分:解短缺不动点 $U^*=b+MU^*$ 与伴随方程 $(I-M)^\top r=e_{x_0}$,对每个 pilot 样本计算 $\hat d_{g,i}=-\frac{1}{\alpha}\hat r^\top T_g(W_{g,i};\hat U)$,取样本标准差 $\hat\sigma_g$。(3) 分配:$\hat w_g=(1-\lambda_N)\hat\sigma_g/\sum_j\hat\sigma_j+\lambda_N/G$,均匀探索底限 $\lambda_N=N^{-1/4}$ 为 pilot 可能低估的核保留样本(如尺度 1 和 3 的两核得 1/4 与 3/4),最大余数法取整花完预算。(4) 估计:只用新采样的主样本重解经验 Bellman 不动点,输出 $\hat C_N=q_\alpha-\frac{1}{\alpha}\hat U_H(s_0,q_\alpha)$。Anchored 变体取 $w^{\mathrm{anc}}=\frac12(w^{\mathrm{inf}}+w^{\mathrm{occ}})$,与 pilot 访问率份额各半,渐近常数满足 $V^*\le V^{\mathrm{anc}}\le 2V^*$。
技术新颖性
新颖性体现在定理层面。Theorem 1 给出分配依赖的 CLT:$\sqrt{N}(\hat C_N-C_{\alpha,\mathrm{K}})\Rightarrow\mathcal{N}(0,V(w))$,并控制非线性 Bellman 余项与分位数错格概率。Theorem 2 证明 $V(w)$ 是乘积模型中 $C_{\alpha,\mathrm{K}}$ 的局部半参数效率界(DQM 切空间),categorical Bellman 估计量正则且达到该界——给定划分后没有正则估计器能做得更好。Theorem 3 证明在 $m_N\to\infty$、$Gm_N=o(N)$、$\lambda_N\to0$、$\sqrt{N}\lambda_N\to\infty$ 的调度下,联合学习续模型、截断与分配后 TIS 仍达含 pilot 成本的 oracle 一阶 MSE。Proposition 2 给出结构性刻画:精确网格上若次大回报概率 $\pi<\alpha$,则 $\mathrm{CVaR}_\alpha$ 随均值线性移动,尾最优与均值最优分配重合,归一化尾-均影响份额的总变差距离 $\frac12\sum_g|p_g-m_g|$ 成为零成本诊断量。这套“可学习的 Bellman 依赖分配信号 + 学习后仍保 oracle 效率”组合在文献中属首次。
实验结果
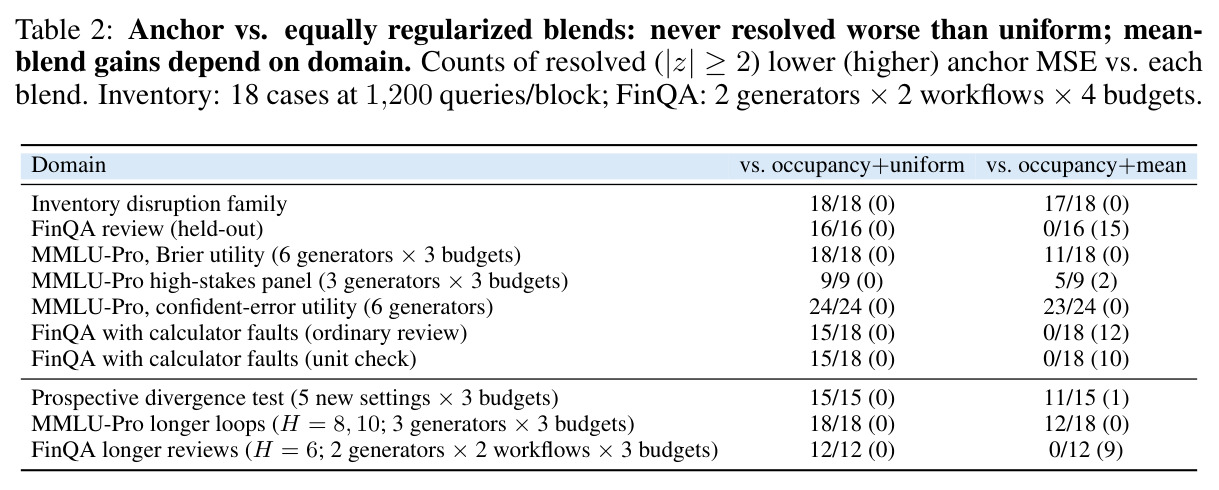
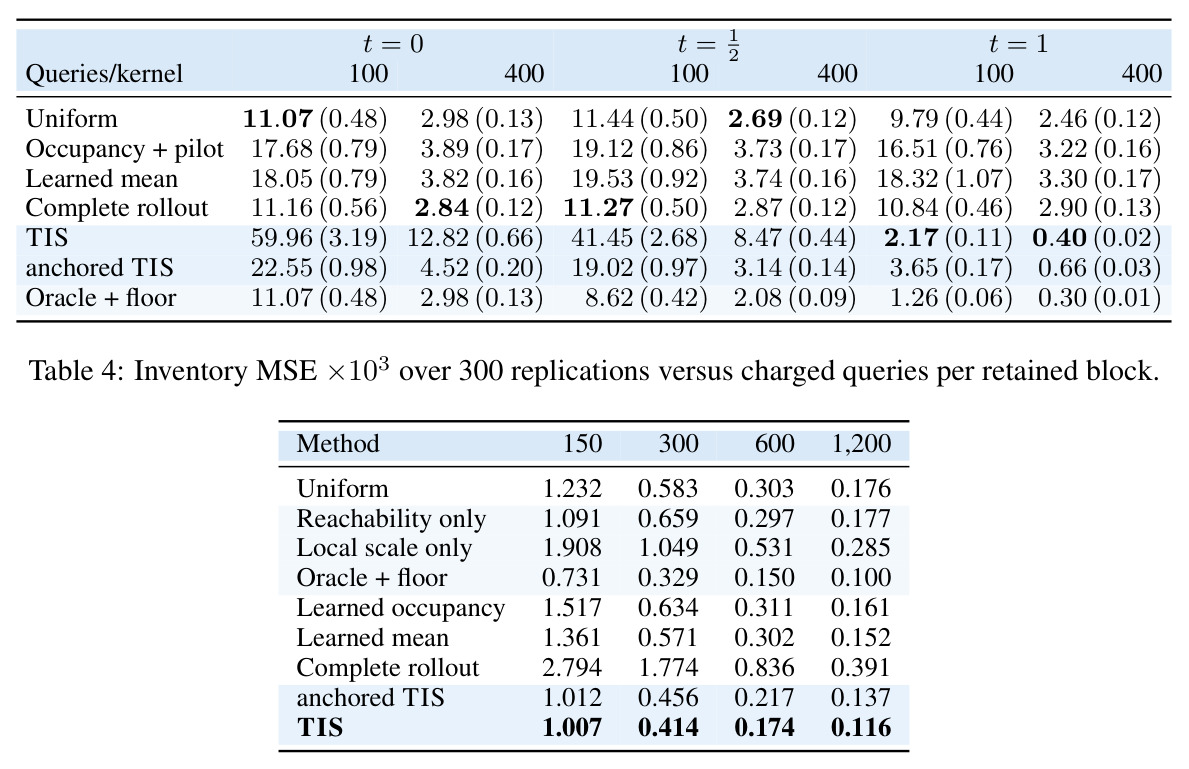
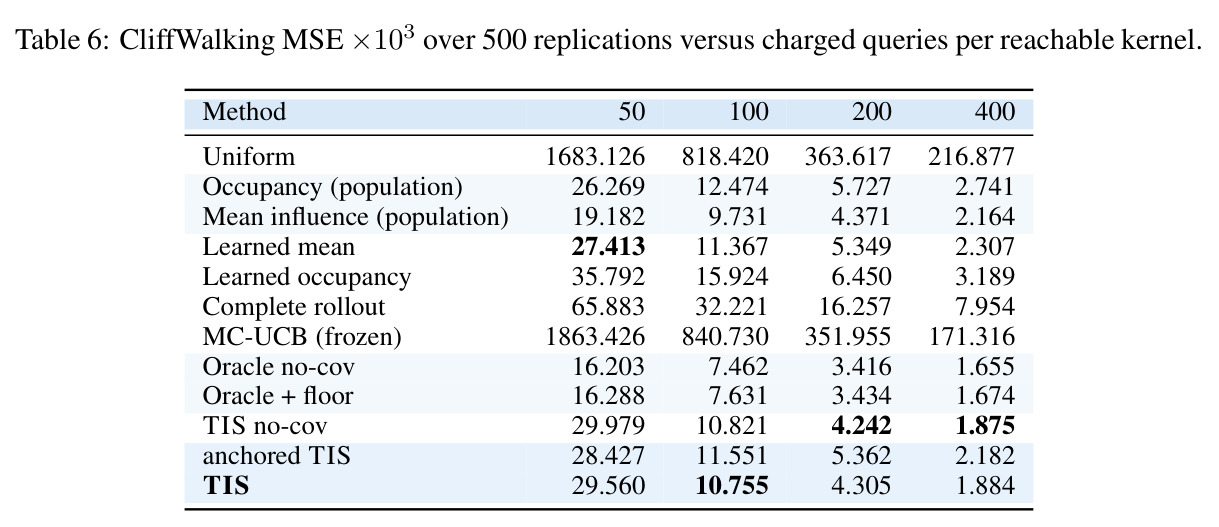
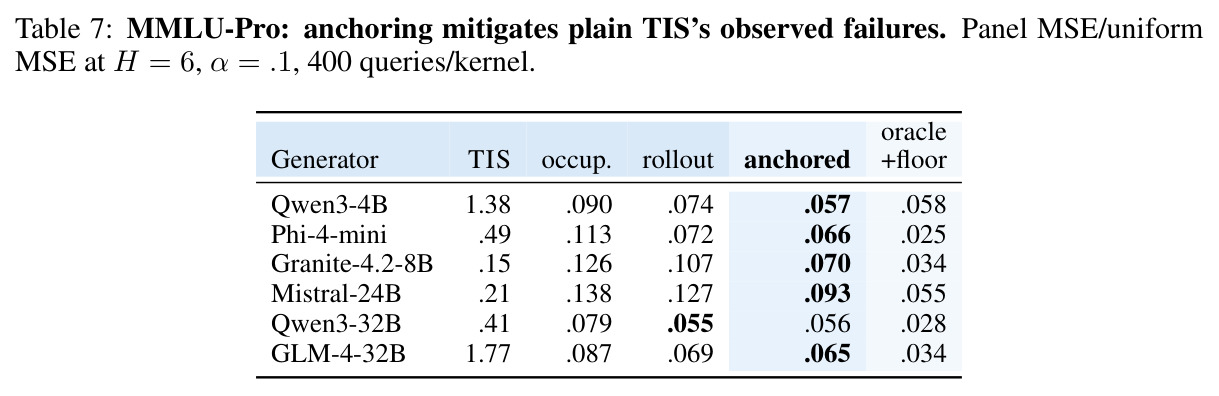
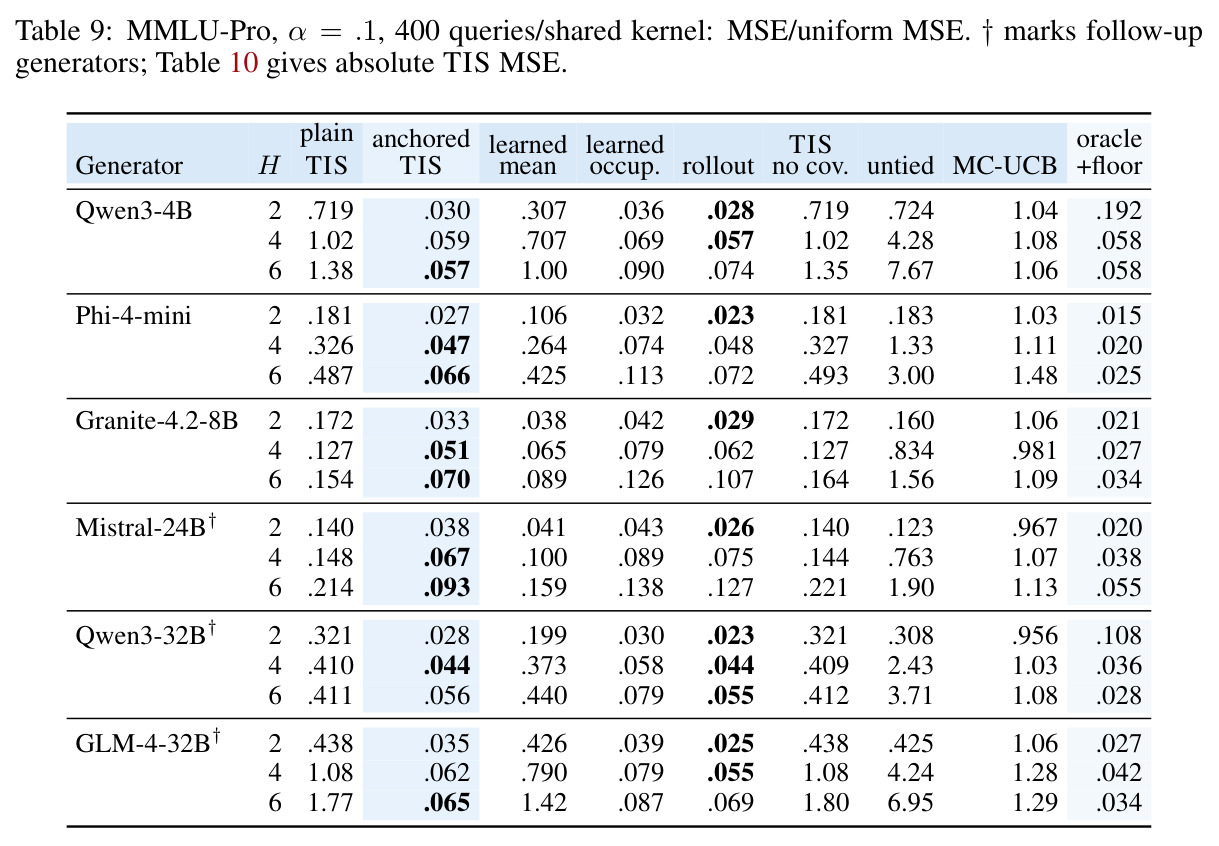
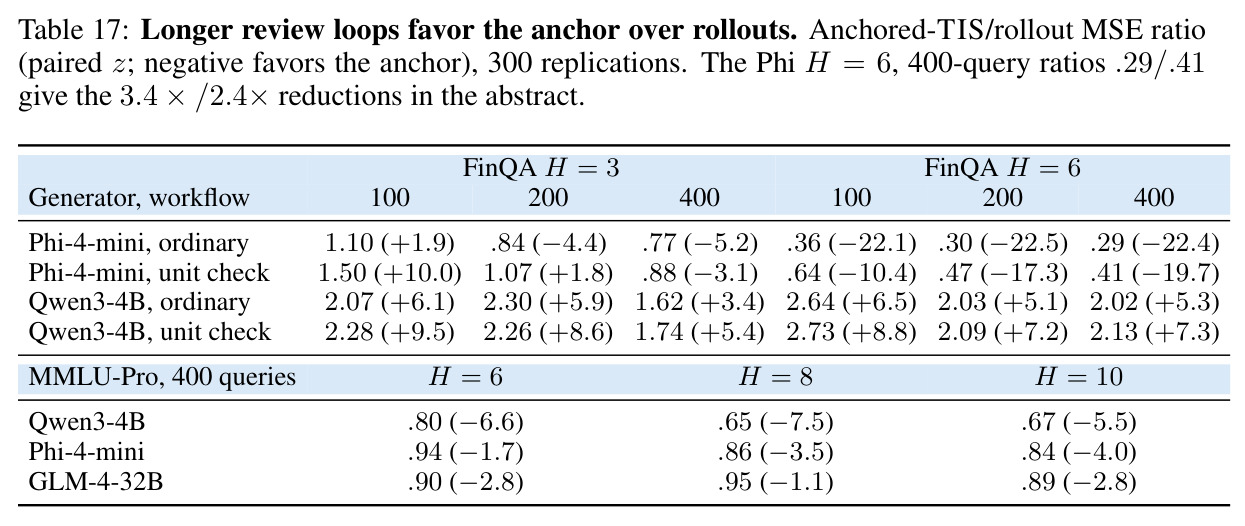
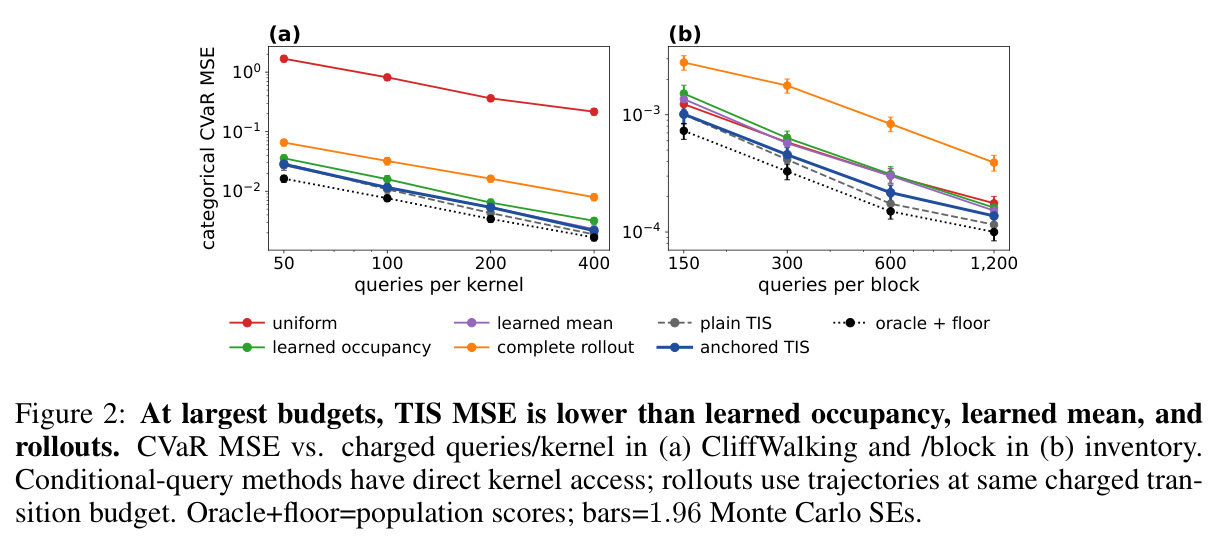
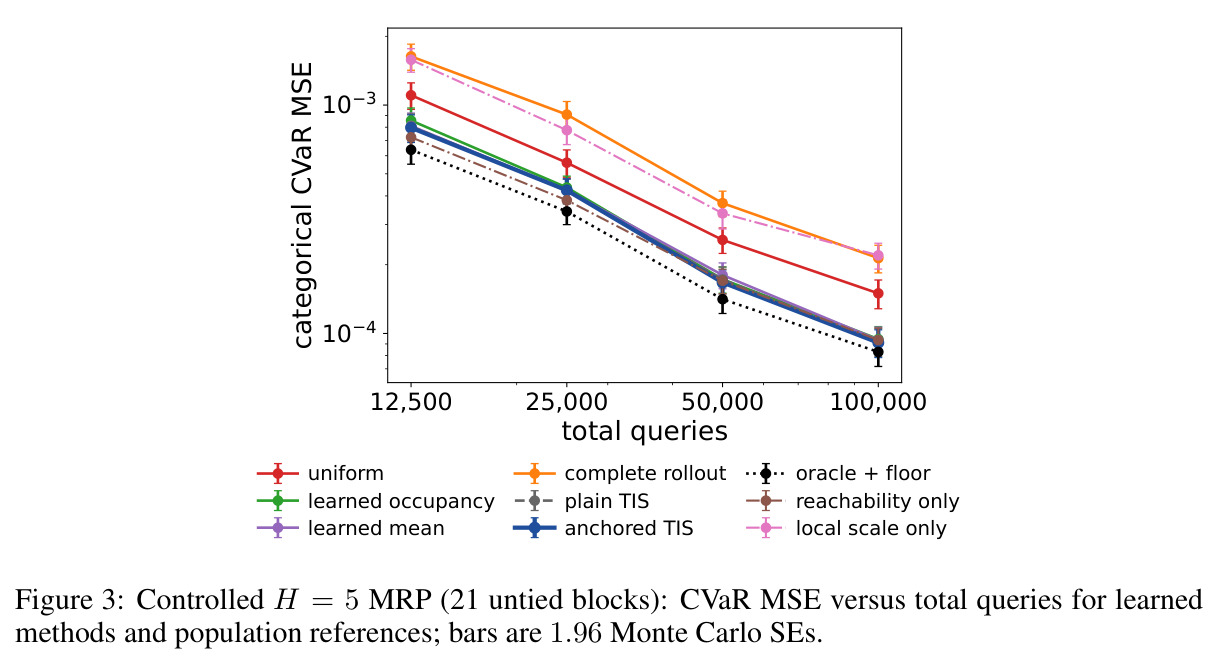
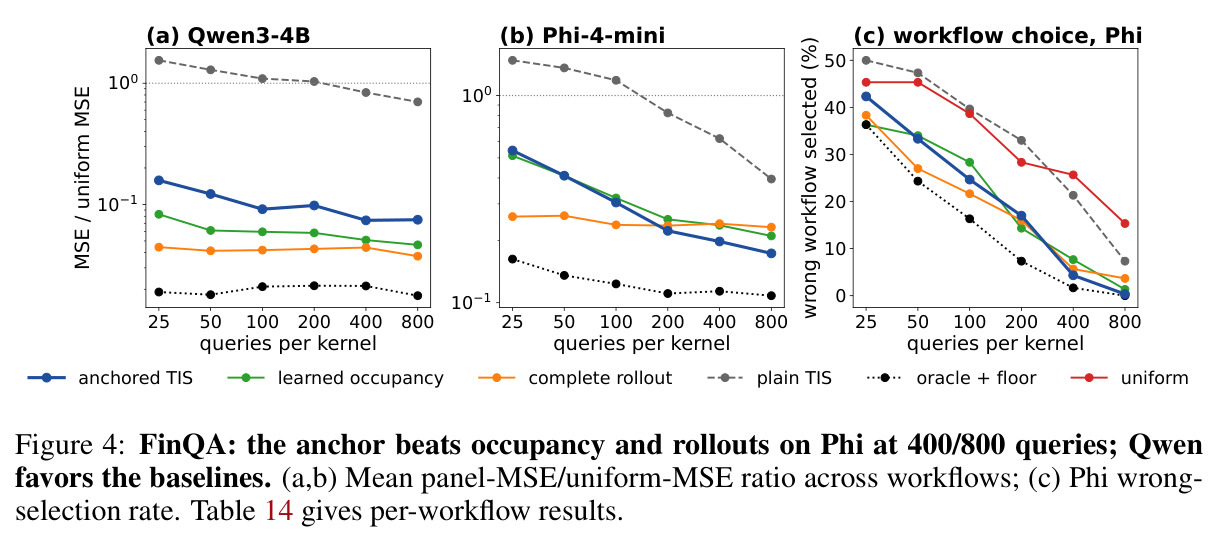
Q1(Table 1):尾影响集中于单一核(t=1)时 plain TIS 的 MSE 为均匀采样的 0.16–0.22(oracle 0.12–0.13);影响均匀(t=0)时 TIS 达均匀的 4.3–5.4 倍,pilot 不回本。Q2:CliffWalking(H=20、α=.1、149 共享核)在 400 查询/核时 TIS MSE 为 1.884×10⁻³,较 learned occupancy(3.189×10⁻³)降 40.9%、较完整 rollout(7.954×10⁻³)降 76.3%、较总体访问率降 31.3%;库存基准(H=8、41 块)在 1200 查询/块时 MSE/uniform 为 TIS 0.657、occupancy 0.918、learned mean 0.866、rollout 2.22;18 例预登记家族中位数:TIS 0.61、anchored 0.69、occupancy 0.93、rollout 2.56。Q3(MMLU-Pro,50 题 91 核):H=6 时 plain TIS 劣于均匀(Qwen3-4B 1.38、GLM-4-32B 1.77),anchored 达 0.056–0.093 并在 5/6 生成器最低;realized/oracle 方差 90 分位由 136 降至 5.8。Q4(FinQA 留出集):anchored 为均匀的 0.089–0.100(Qwen3-4B)/0.216–0.327(Phi);六调用 H=6 时 Phi anchored MSE 为 rollout 的 0.29–0.64,即 2.4–3.4× 降低。Q5(Table 2):anchored 对同等正则化 uniform blend 在 160/166 设置显著更低、无一更高,证明增益来自尾分数本身;对 mean blend 的胜负由尾-均距离诊断预测,规则在 141/148 cell 选对;方差公式还能无拟合常数预测观测 MSE(中位 log-ratio −0.001/−0.006)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Slippery CliffWalking CVaR₁₀ 估计(H=20,149 共享核,400 查询/核) | MSE ×10⁻³(500 次重复) | TIS 1.884;anchored 2.182 | learned occupancy 3.189;learned mean 2.307;complete rollout 7.954;uniform 216.877 | 较 learned occupancy 降 40.9%,较 rollout 降 76.3%,较 population occupancy(2.741)降 31.3%(oracle+floor 为 1.674) |
| 季节性 base-stock 库存评估(H=8,41 块,1200 查询/块) | MSE / uniform MSE | TIS 0.657(仅比 oracle+floor 高 15.4%) | learned occupancy 0.918;learned mean 0.866;complete rollout 2.22 | 较 occupancy 降约 28%,较 rollout 降约 70% |
| 18 例库存中断家族(预登记,1200 查询/块) | 中位 MSE / uniform MSE | TIS 0.61;anchored 0.69 | learned occupancy 0.93;learned mean 0.84;rollout 2.56 | TIS/anchor 在 18/18 例优于 occupancy 与 rollout,17/18 优于 learned mean |
| MMLU-Pro 冻结审查工作流(H=6,400 查询/共享核,6 个生成器) | MSE / uniform MSE | anchored TIS 0.056–0.093 | plain TIS 0.15–1.77(两个生成器劣于 uniform);occupancy 0.079–0.138;rollout 0.055–0.127 | 5/6 生成器上取得最低 MSE,修复 plain TIS 的 pilot 失败 |
| FinQA 留出数值审查(Phi-4-mini,H=6 六调用,400 查询/核) | anchored-TIS / rollout MSE 比值 | 0.29(普通审查)/ 0.41(unit-sign 审计) | complete rollout = 1.0(配对 z 检验 −22.4 / −19.7) | 即摘要所述 3.4× / 2.4× 的 MSE 降低;100–200 查询时 anchored 为 uniform 的 0.089–0.327 |
局限与改进
作者承认:理论保证要求固定维度 categorical 模型、正分位数裕量、组间独立查询及特定 pilot($O(N^{2/3})$)与 floor($N^{-1/4}$)调度;渐近极限是逐点的,不覆盖越来越稀有的事件或收缩裕量,有限预算 MSE 保证仍开放。与 rollout 的对比是成本匹配而非同等信息访问,条件重放能力本身在许多场景不可得。语言模型实验全部为冻结律回放,不含实时 GPU/API 成本,50 题 MMLU-Pro 面板的结论只是条件于该面板的模拟误差而非总体泛化。我的观察:收益高度依赖核复用——按层分别拟合共享提示在 H=4,6 时 MSE 是共享拟合的 4–10 倍,而真实系统状态连续、提示少有重复,表格假设适用面有限;分类网格引入至多 $H\Delta$ 表示误差且网格选择不自适应;诊断阈值 0.21 纯属经验校准;查询独立性在含缓存或上下文依赖的真实 LLM 服务中难以严格成立;plain TIS 在两个生成器上劣于 uniform 的失败也说明方法对 pilot 质量敏感。
独立分析的弱点
四个独立弱点。第一,固定维度/表格假设是最大实用障碍:真实工作流状态空间巨大,逐坐标的 categorical 递推与伴随权重无法直接扩展,改进方向是把影响传播与函数近似结合(用线性/神经表示近似 $r$ 并给出相应效率理论)。第二,pilot 失败只是被 anchor 缓解而非解决:anchor 只保证至多 2× oracle 的渐近常数,且两个成分可能同时饿死同一组——FinQA-Qwen 的近确定性稀有错误 pilot 几乎看不到,plain TIS 与 anchor 全部失效;改进方向是序贯两阶段设计,先小预算显式探测稀有事件再细分配,或引入带保险机制的重要性加权 pilot。第三,尾专项分配并非总有益:尾-均距离接近 0(FinQA 全系列、Proposition 2 稀有失败体制)时整套机制是浪费,而 0.21 阈值靠经验校准、在 H=8/10 两个新设置上预测失败;改进方向是把总变差距离做成带置信区间的正式假设检验。第四,方法要求能从任意中间状态重启查询,在无法回滚的机器人、有副作用的在线工作流中不可行,改进方向是与轨迹级重要性采样或学习到的世界模型模拟器结合。
未来方向
作者提出的方向:工具失败与多轮安全评估是自然下一步,那里罕见严重错误正是部署决策的关键;有限预算 MSE 理论与实时调用成本分析仍然开放。基于成果可延伸:(1) 把尾影响分数嵌入风险敏感策略优化的估计-改进交替循环,与 iterated-CVaR RL 的样本复杂度研究对接,形成面向尾部的主动评估-优化闭环;(2) 将伴随权重推广到近似模型与连续状态空间,研究影响函数在函数近似下的传播与偏差;(3) 把尾-均距离诊断扩展为在线触发的“是否值得尾专项评估”元准则,用于 LLM agent 部署前审计的自动决策;(4) 与主动评估文献(tinyBenchmarks、active testing)结合,把分配对象从条件转移核扩展到“测试题 × 工作流分支”的组合设计;(5) 处理相关查询与非平稳律(KV 缓存复用、模型版本漂移)下的稳健分配;(6) 与多保真模拟器/多层蒙特卡洛结合压缩 pilot 成本,并把防御混合原理推广到高尾 CVaR 与 spectral risk measures 等更一般的风险泛函。
复现评估
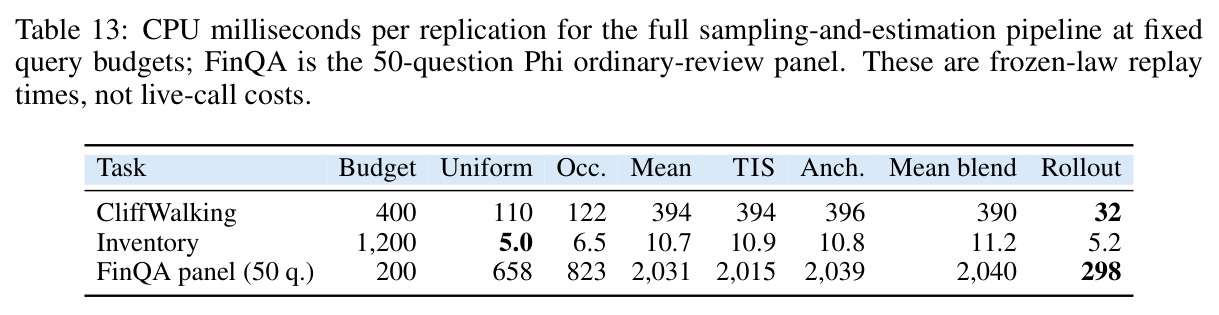
复现条件较好。代码开源(github.com/paulinebourigault/TIS),论文附完整协议并履行预登记承诺、全部报告 18 例库存家族结果。表格基准(Gymnasium slippery CliffWalking-v1、截断 Poisson 需求的季节性库存、FrozenLake/rainy Taxi)CPU 即可复现:Table 13 显示单线程 i9-13900H 上完整采样+估计管线每次复制约 394–396 ms(CliffWalking,400 查询/核),尾分数相对最强均值基线仅增加 <4% 计算量。语言模型实验是冻结律回放:需先用 6 个生成器(Qwen3-4B/32B、Phi-4-mini、Granite-4.2-8B、Mistral-Small-24B、GLM-4-32B)采集 MMLU-Pro 50 题与 FinQA(开发 20/170、留出 50/312 题)的响应,每次查询为受限两 token 抽样,此后对比全部离线、无需额外 GPU/API 调用。理论证明完整(附录 A–F),Algorithm 1 与调度参数($m_N=\lceil4N^{2/3}/G\rceil$、$\lambda_N=N^{-1/4}$)明确给出。门槛主要是渐近统计背景较深,实验协议可直接照跑,总体复现难度中等。
论文图表
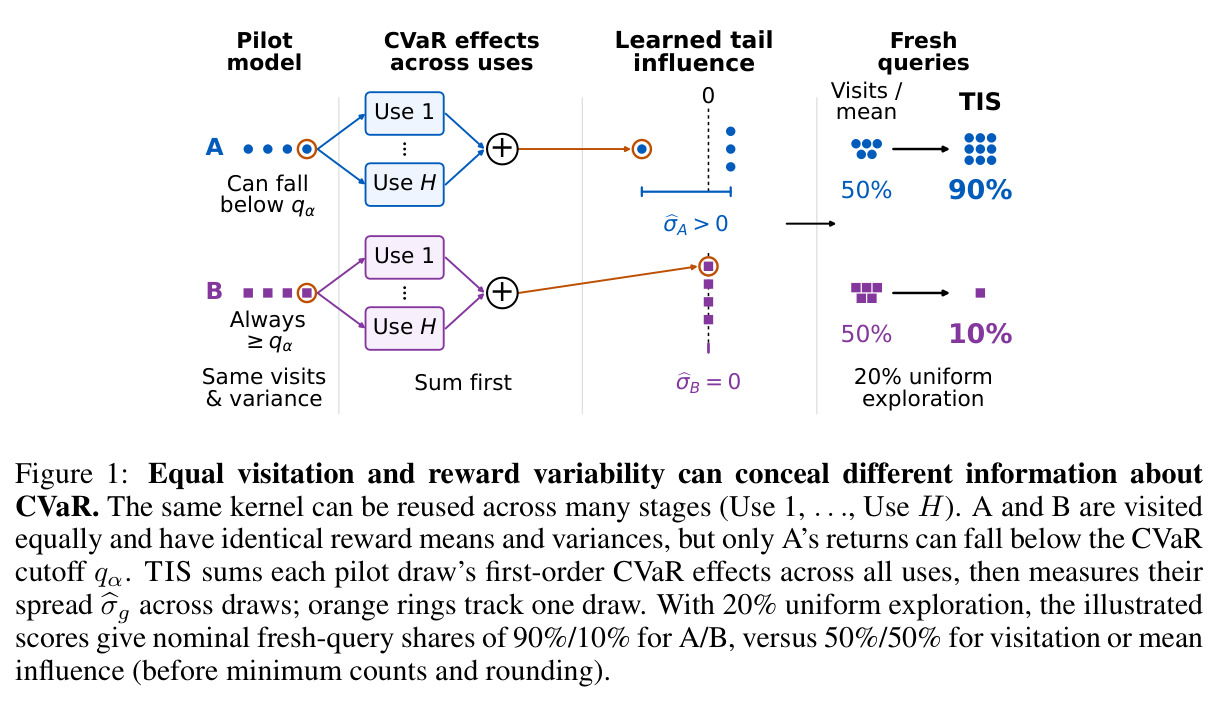
示意图:核 A 与 B 被访问的次数相同、奖励均值与方差也相同,但只有 A 的回报可能跌破 CVaR 截断 $q_\alpha$($\sigma_A>0$ 而 $\sigma_B=0$)。TIS 把每次 pilot 抽样在所有 Bellman 使用(Use 1…Use H)上的第一阶 CVaR 效应求和,再测量散布 $\hat\sigma_g$;在 20% 均匀探索底限下 A/B 获得的新查询名义份额为 90%/10%,而访问率或均值影响只能给出 50%/50%。
一图点明全文动机与核心信号:访问率和奖励变异性完全相同的两个核,对尾部估计的信息量可以天差地别;同时直观展示“先跨使用求和、再取散布”的打分方式。