重思LLM强化学习中的训练-推理失配:来源分析与校准重要性采样校正 Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It
把训练-推理失配表示为对数几率位移,在位移坐标用单一阈值截断,比值上限随置信度自动收紧
前置知识
RLVR(可验证奖励强化学习)
用可自动判分的奖励(如数学答案对错)对大语言模型做强化学习的范式,代表工作有 DeepSeek-R1、DAPO。相比依赖人类反馈的 RLHF,奖励由规则或验证器给出(本文用 math-verify 比对 \boxed{} 中的最终答案),信号稀疏但无噪声,是当前提升模型推理能力的主流后训练方法。
本文研究的失配问题就发生在 RLVR 训练管线中:rollout 由推理引擎采样、梯度由训练引擎计算,引擎间数值差异让名义上的 on-policy 训练实际上变成了 off-policy。
GRPO 与 token 级代理损失
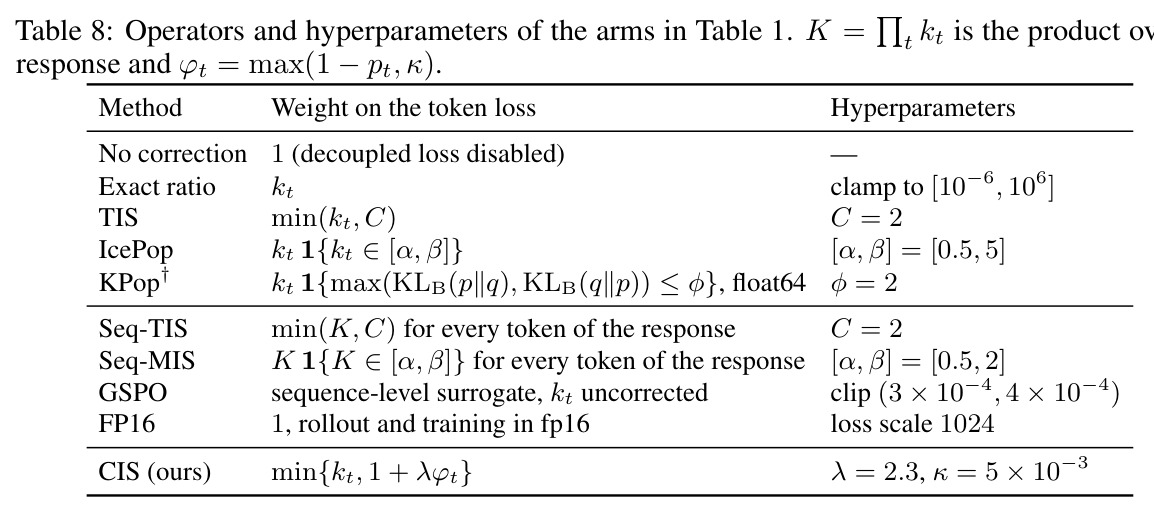
GRPO 对同一 prompt 采样一组 $G$ 个回答,用组内奖励标准化得到优势 $\hat A_{i,t}$,再用 PPO 式 clip 的 token 级代理目标更新策略,不需要价值网络。论文中所有失配校正方法都作用在这个 token 损失上:用一个权重逐 token 重加权梯度,更新比 $\rho_{i,t}$ 由 PPO clip 处理,失配比 $k_{i,t}$ 才是本文的对象。
理解公式 (1) 中 $\rho$ 与 $k$ 的分工是读懂全文的前提:CIS 不是新的策略梯度,而是对 GRPO token 损失上失配权重的一种新截断方式。
训练-推理失配(training-inference mismatch)
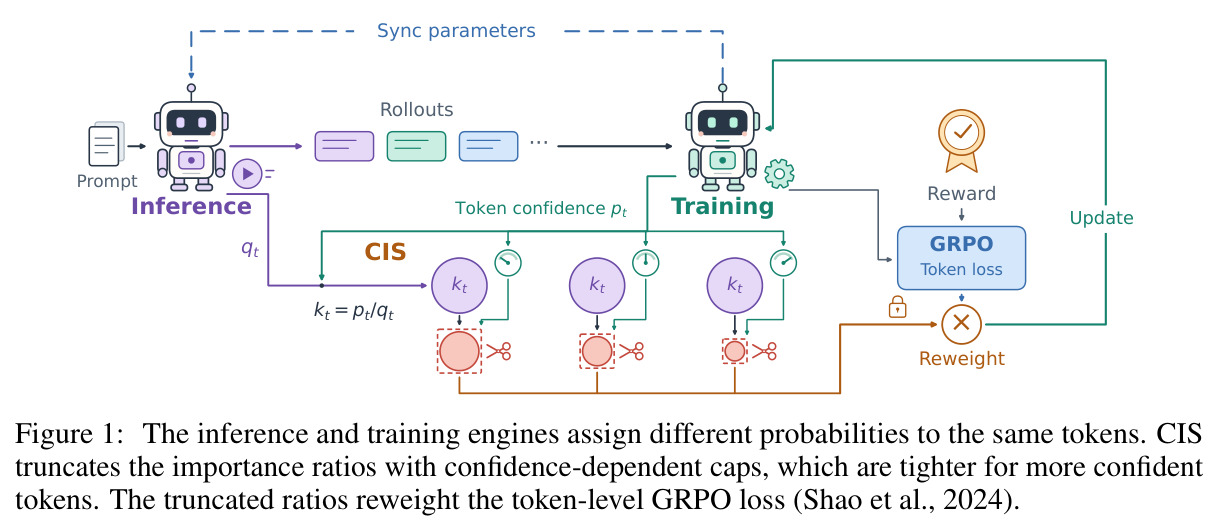
RL 后训练框架为提高吞吐,把生成与梯度计算解耦到两套引擎(如 vLLM/SGLang 负责采样,FSDP/Megatron 负责反向传播)。两引擎加载相同参数,但 kernel 实现、浮点归约顺序与 bf16 数值精度不同,对同一 token 给出不同概率;MoE 中离散的专家路由会进一步放大这种差异,严重时导致训练崩溃。
这是全文的研究对象:失配比 $k_t=p_t/q_t$ 刻画它的大小,CIS 是对它的校正,失配的重尾分布是精确校正方差爆炸的根源。
重要性采样及其截断(TIS)
用概率比 $k=p/q$ 重加权样本可以修正采样分布与目标分布的差异,得到无偏估计;但当个别样本的比值极大时,梯度估计方差失控。截断重要性采样(如 $\min(k,C)$)用引入偏差换取方差控制,这一偏差-方差权衡由 Ionides (2008) 等经典工作奠定。
本文的理论部分(Theorem 3.2 与 3.3)就是围绕“精确校正的二阶矩为何爆炸、截断如何控制它”展开的;CIS 本质上是一种新的截断位置选择,把截断从比值坐标搬到位移坐标。
MoE 路由与专家分歧
混合专家(MoE)模型每层由门控网络为每个 token 选 top-$k$ 个专家。这是离散决策:微小的数值扰动就能翻转第 4、5 名专家的排序,使两引擎在同一层激活不同的专家集合,误差随层数累积放大,最终表现为输出 logit 的大幅偏离。
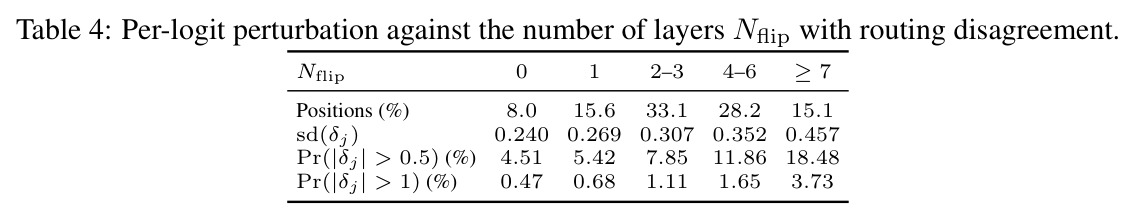
论文实测显示路由分歧是 MoE 位移重尾的主要放大器:24 层中平均 3.69 层出现分歧,从零分歧到 $\ge 7$ 层分歧,$P(|\delta_j|>0.5)$ 从 4.51% 涨到 18.48%。这解释了为什么失配在 MoE 上格外危险、也是本文只用 MoE 做训练实验的原因。
log-odds(对数几率)位移
对数几率指 $\mathrm{logit}\,p=\log\frac{p}{1-p}$。设训练引擎 logit 为 $z$、推理引擎为 $z+\delta$,则两引擎对采样 token 的概率之比可精确写成恒等式 $k_t=p_t+(1-p_t)e^{\varepsilon_t}$,其中 $\varepsilon_t=\mathrm{logit}\,p_t-\mathrm{logit}\,q_t$ 恰为两引擎 log-odds 之差——失配在 log-odds 坐标下是加性位移。
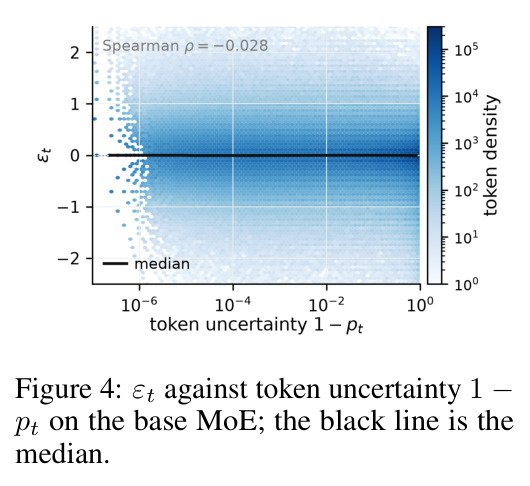
$\varepsilon_t$ 是全文的核心坐标:它的分布对 token 置信度近似不变,CIS 的单一常数阈值正是设在这个坐标里,再映射回比值空间得到随置信度收紧的上限。
研究动机
当前 RLVR 后训练框架为提升吞吐,把 rollout 生成与梯度计算解耦到两套引擎:推理引擎(vLLM、SGLang)负责采样,训练引擎(FSDP、Megatron)负责反向传播。两者加载完全相同的参数,但 kernel 实现、浮点归约顺序与数值精度的差异使它们对同一 token 给出不同概率,名义 on-policy 实为 off-policy。这个问题在 MoE 模型上格外严重:门控网络的 top-k 专家选择是离散决策,微小数值扰动就能让两引擎在某一层激活不同专家,误差逐层累积放大,多份技术报告已记载这会导致训练不稳定甚至崩溃。作者实测把问题定量化:bf16 下 Qwen1.5-MoE-A2.7B 的每-logit 扰动标准差达 0.336,是稠密对照 Qwen1.5-14B(0.079)的四倍多;9.87% 的 logit 对扰动超过 0.5(稠密仅 0.003%),最大达 10.47。常规补救是重要性采样,但两引擎在个别 token 上分歧剧烈时失配比会变得极大,精确校正方差不可控,朴素截断又引入偏差——如何取舍偏差与方差,已成为 LLM 强化学习系统的核心新问题。
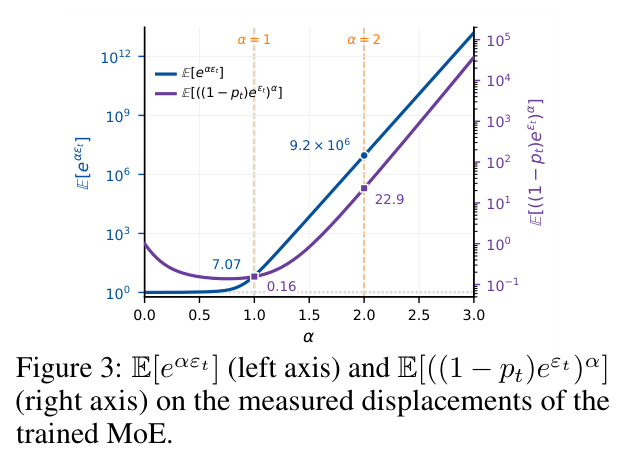
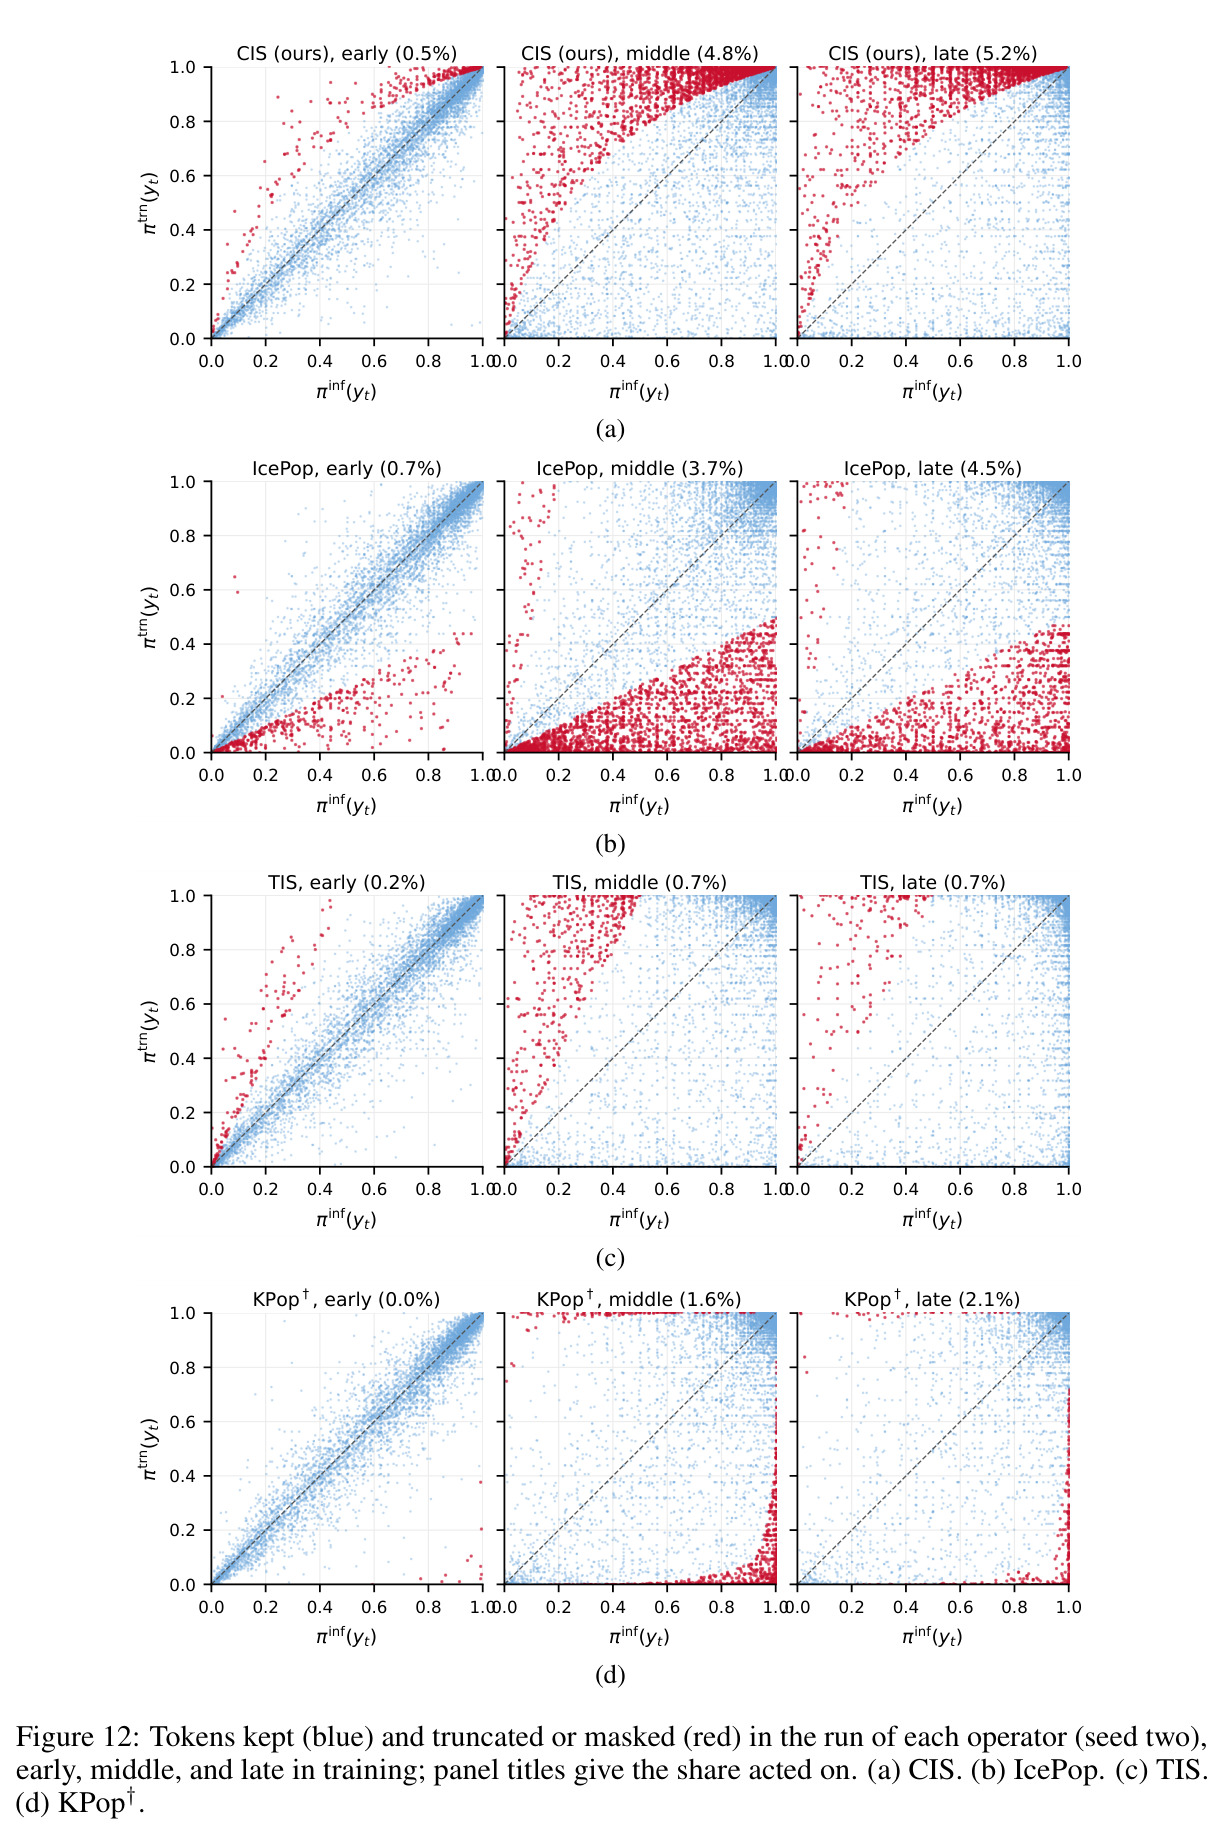
本文的目标是本文的目标是把训练-推理失配从模糊的“工程噪声”变成可定量刻画的统计对象,并从其统计结构出发推导出有原则的校正方法。具体分三步:第一步,在大规模 rollout 上同时测量两个引擎对同一采样 token 的概率,把失配精确表示为 log-odds 坐标下的加性位移 $\varepsilon_t$,并刻画其分布随 token 置信度的变化规律;第二步,从理论上解释为什么精确校正不稳定——误差由位移上尾的二阶矩 $\mathbb{E}[e^{2\varepsilon_t}]$ 主导,实测在训练后的 MoE 上达 $9.2\times10^6$——从而把问题从“要不要校正”转化为“如何截断”;第三步,构造一个只在位移坐标截断正上尾的算子 CIS(Calibrated Importance Sampling),证明它以可控偏差换取有界二阶矩,并在三个 MoE 模型与五个数学推理基准上,对比 TIS、IcePop、KPop、Seq-TIS、Seq-MIS、GSPO、FP16 等九个基线验证一致优势。
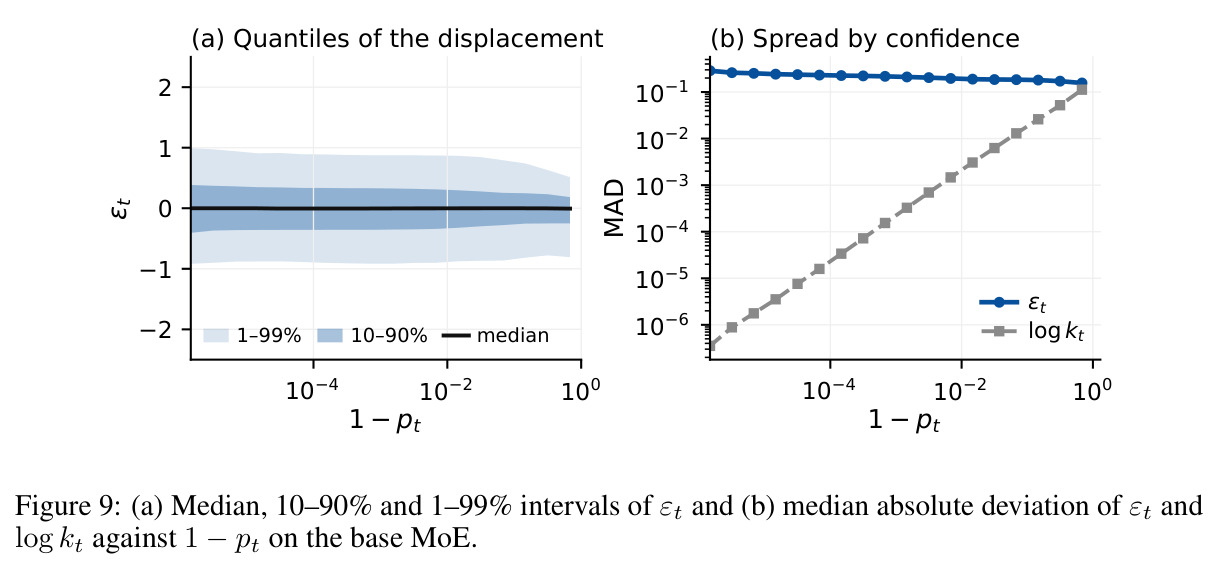
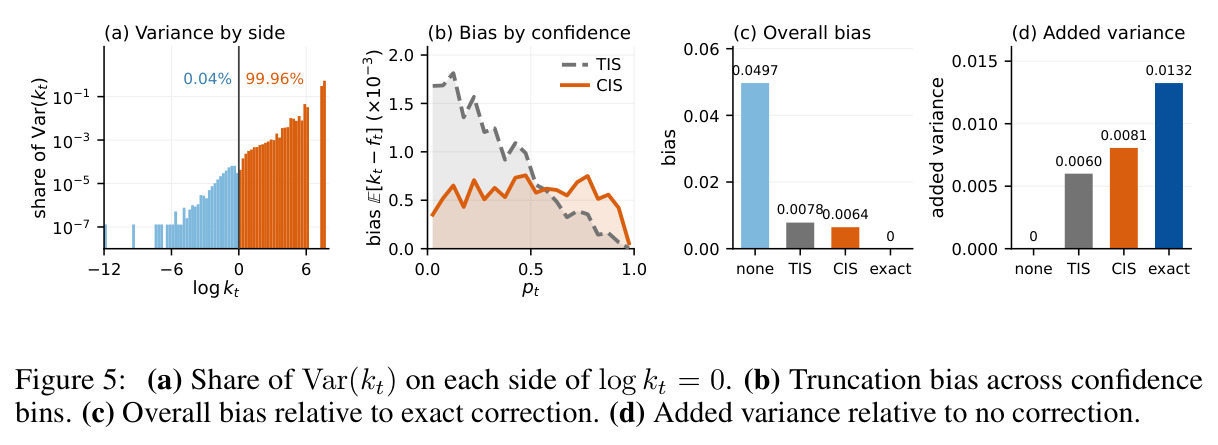
与已有工作不同的是,已有校正方法的阈值都直接作用在重要性比值 $k_t=p_t/q_t$ 或由两引擎概率导出的量上:token 级的 TIS 固定上限、IcePop 固定区间掩码、KPop 的二值 KL 掩码,序列级的 Seq-TIS/Seq-MIS/GSPO,以及数值侧的 FP16。本文的独特切入:比值混杂了两个性质不同的因素——引擎间的真实失配与 token 自身的置信度。由恒等式 $k_t-1=(1-p_t)(e^{\varepsilon_t}-1)$ 可见,同样大小的位移 $\varepsilon_t$ 在低置信 token 上会让比值大幅偏离 1,在高置信 token 上被因子 $1-p_t$ 压得几乎不动,因此固定阈值主要截断低置信 token,偏差也集中在那里。作者用大规模测量首次证明:位移 $\varepsilon_t$ 的分布对置信度近似不变——18 个对数分箱内 MAD 只变 1.8 倍,而 $\log k_t$ 的 MAD 变约 $3.2\times10^5$ 倍,Spearman 相关仅 $-0.028$——从而可在失配“源头”用单一常数阈值截断,让比值上限随置信度自动收紧。
核心方法
方法的直觉:失配产生于 logit 空间,就该在驱动它的坐标系——log-odds 位移——里测量和截断。第一步,记录两引擎对同一 token 的 log 概率,由 logit $z$ 与 $z+\delta$ 推导恒等式 $k_t=p_t+(1-p_t)e^{\varepsilon_t}$,位移 $\varepsilon_t$ 恰为两引擎 log-odds 之差。第二步,实证刻画:位移分布对置信度近似不变,但 MoE 上上尾极重($|\varepsilon_t|$ 最大 19.38)。第三步,方差分析表明误差界由 $\mathbb{E}[e^{2\varepsilon_t}]=9.2\times10^6$ 主导,且 $k_t>1$ 侧承载 99.96% 的方差,故只需单边截断正位移。第四步,施加 $e^{\varepsilon_t}\le 1+\lambda$,映射回比值即权重 $\min\{k_t,1+\lambda(1-p_t)\}$,上限随置信度收紧;对 $1-p_t$ 加下限 $\kappa=5\times10^{-3}$ 防截断舍入误差。全程逐元素运算,开销 +3.2%。
核心创新是把截断从比值坐标搬到位移坐标。比值坐标的固定上限 $k_t\le C$ 等价于位移阈值 $e^{\varepsilon_t}\le 1+\frac{C-1}{1-p_t}$:置信度越高越宽松,故它几乎不约束高置信 token、集中打击低置信 token。CIS 反其道而行:对所有置信度施加同一位移阈值 $e^{\varepsilon_t}\le 1+\lambda$,映射回比值后自动得到随置信度收紧的上限 $1+\lambda(1-p_t)$——$p_t<0.3$ 时 CIS 的截断偏差不到 TIS 一半。Theorem 3.3 证明 CIS 把无界二阶矩 $\mathbb{E}[e^{2\varepsilon_t}]$ 换成不超过 $(1+\lambda)^2$ 的有界量,代价是偏差由截断超额 $(1-p_t)(e^{\varepsilon_t}-1-\lambda)_+$ 的一阶矩控制。方差还单边:$\varepsilon_t\le 0$ 时必有 $p_t<k_t\le 1$,爆炸只来自正位移上尾,故不做下侧截断——消融显示加双侧带会使平均从 34.78 崩到 6.01。
方法步骤详情
算法 1 的输入是两侧 log 概率 $\ell^{\text{train}}$、$\ell^{\text{infer}}$(须取采样时刻原始值)与 token 损失 $\ell'_m$。第一步,恢复 $p_m=\exp(\ell^{\text{train}}_m)$ 与失配比 $k_m=\exp(\ell^{\text{train}}_m-\ell^{\text{infer}}_m)$。第二步,对置信度加下限 $\varphi_m=\max(1-p_m,\kappa)$,默认 $\kappa=5\times10^{-3}$,否则高置信端截断会落到舍入误差上。第三步,算权重 $f_m=\min\{k_m,1+\lambda\varphi_m\}$,默认 $\lambda=2.3$。第四步,以 stopgrad 后的 $f_m$ 乘 $\ell'_m$ 更新。工程细节:训练引擎必须用 flash attention,否则 packed sequence 回退会串扰污染训练侧 log 概率;权重每步同步到推理引擎;超参在 Qwen1.5-MoE 上预注册后固定用于另两模型。
技术新颖性
技术新颖性在三个层面。经验刻画:本文首次在大规模测量(6,000 个位置、约 1,230 万 token)中系统刻画失配统计结构,发现位移 $\varepsilon_t$ 对置信度近似不变(MAD 跨 18 个对数分箱仅变 1.8 倍,对照 $\log k_t$ 变 $3.2\times10^5$ 倍),并把 MoE 重尾归因到路由分歧——平均每个位置有 3.69/24 层两引擎选出不同专家集,从零分歧到 ≥7 层分歧,$sd(\delta_j)$ 从 0.240 升到 0.457。理论层面:把“失配要不要校正”转化为“如何截断”,证明误差由二阶矩主导且爆炸只来自正位移上尾,为单边截断提供理论依据而非启发式规则。算法层面:CIS 保留被截断 token 的非零权重(IcePop 是硬掩码),逐元素实现、零额外前向反向(耗时仅 +3.2%),且每个设计选择——上侧单边、位移坐标截断、数值下限——都有独立消融支撑。最接近的 KPop 虽用二值 KL 间接考虑置信度异质性,但其掩码仍是丢弃式、非由失配统计推导;CIS 的置信度相关上限是位移阈值的数学必然,而非人工设计。
实验结果
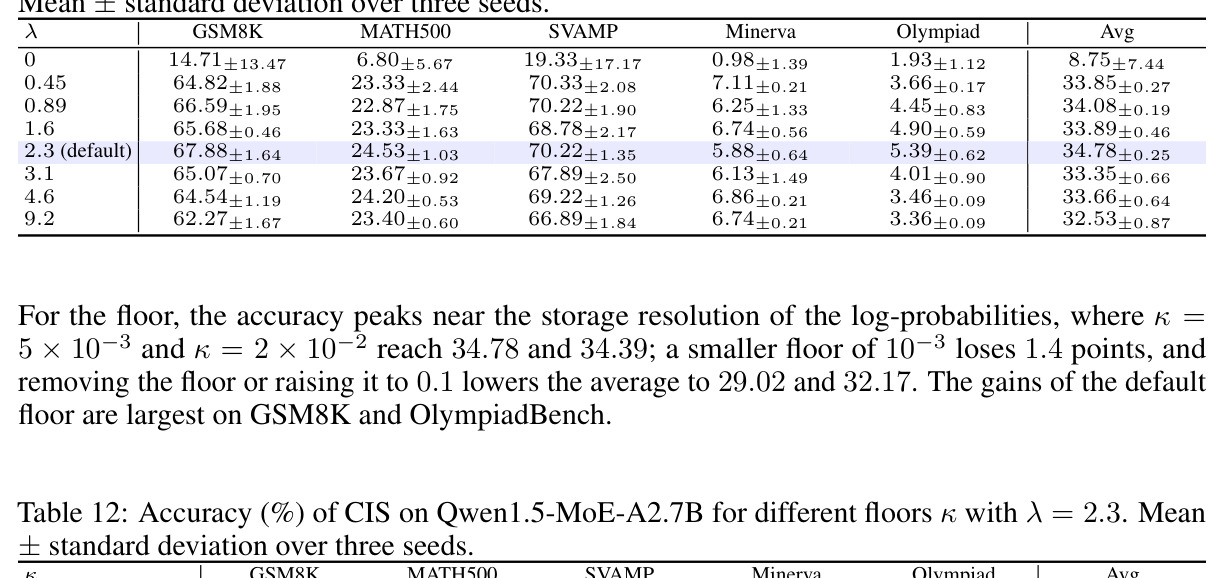
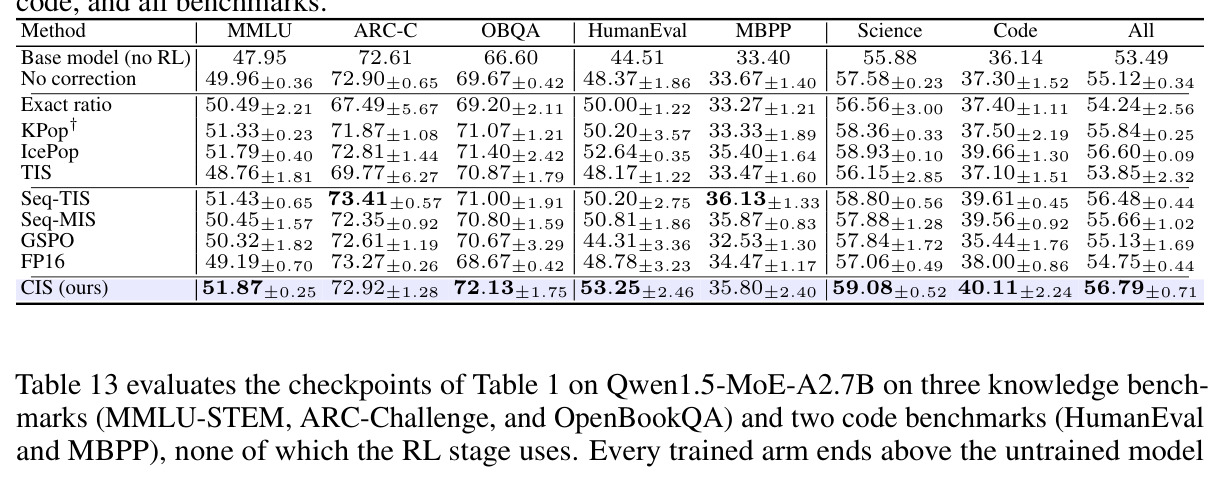
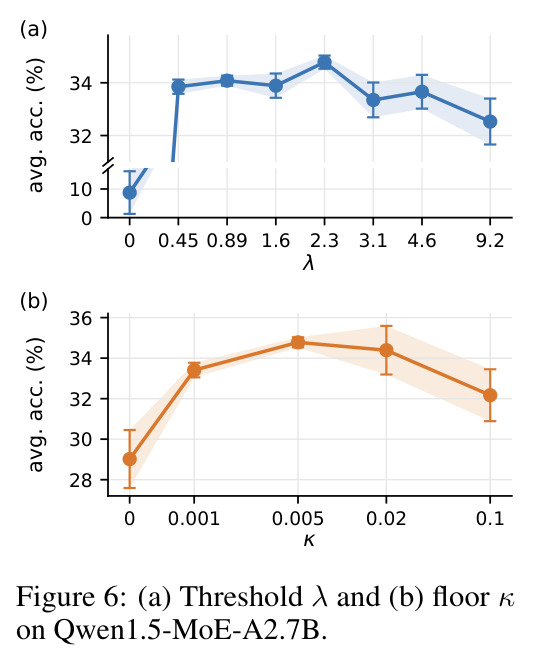
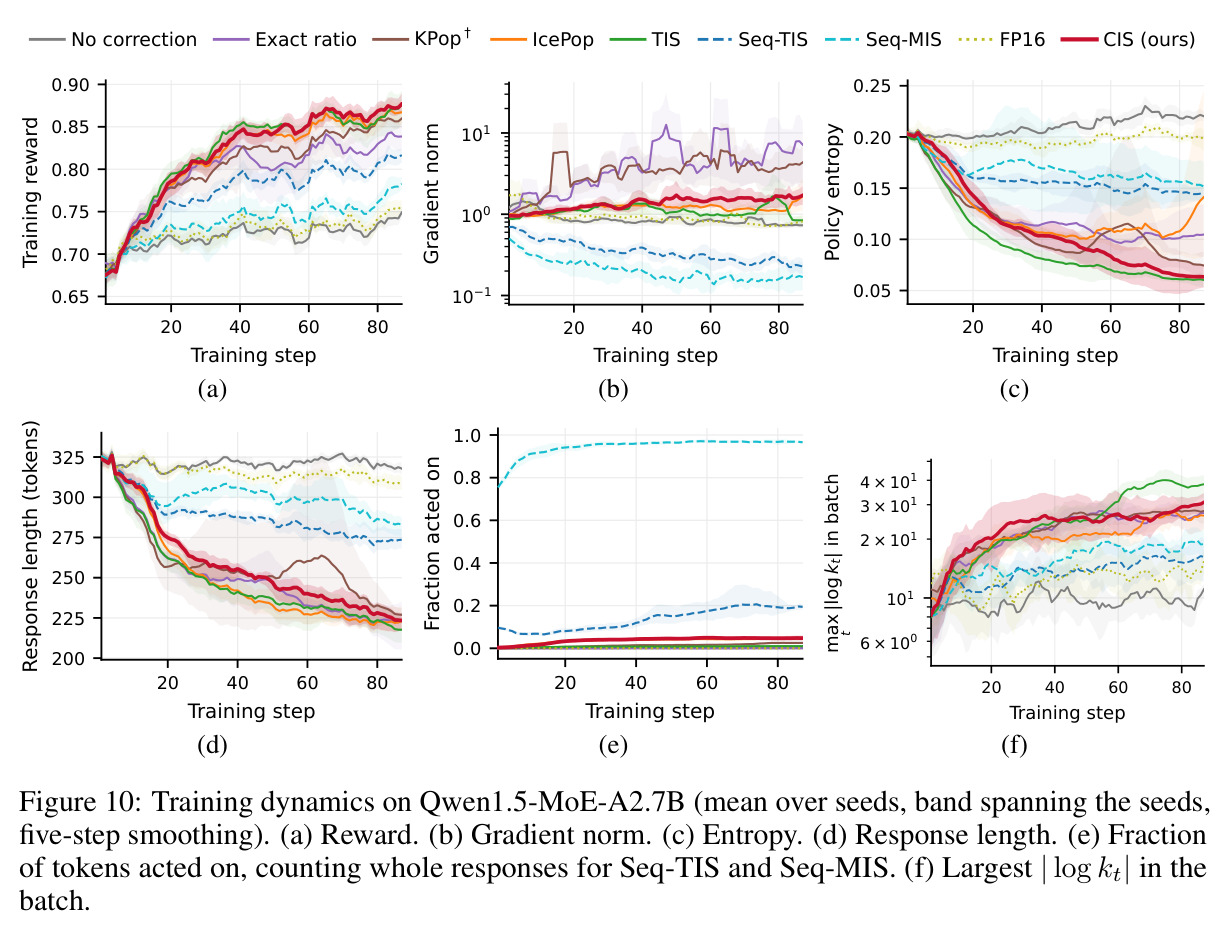
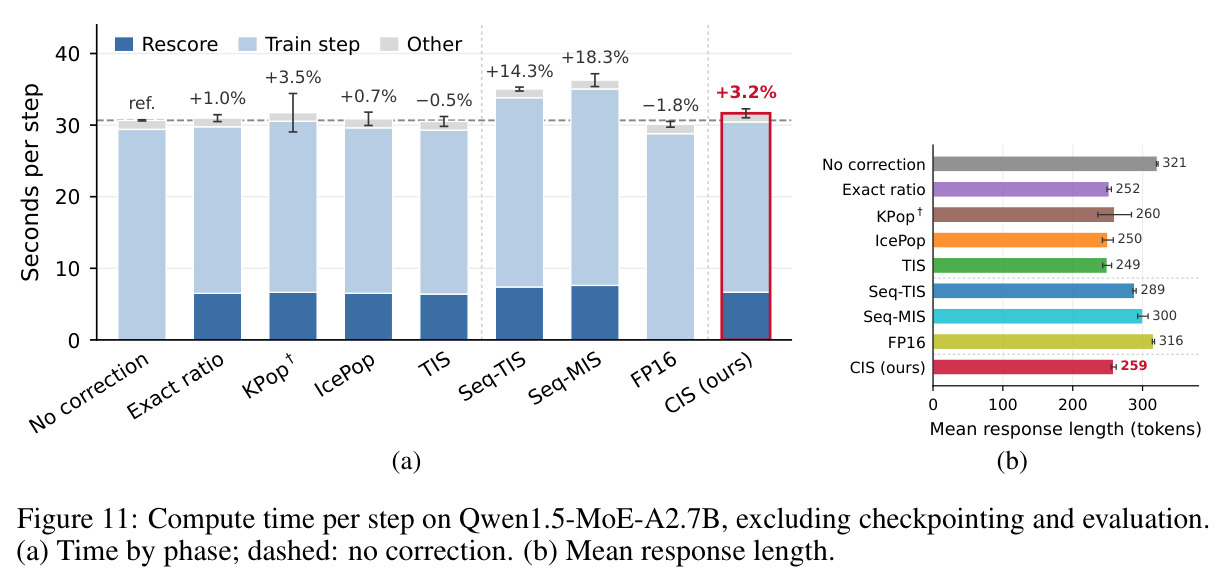
主实验(Table 1)在三个 MoE 模型上以相同配方在 GSM8K 训练,CIS 全部取得五基准最高平均。Qwen1.5-MoE-A2.7B:CIS 34.78(IcePop 34.18、无校正 30.99);DeepSeek-V2-Lite:CIS 37.16(IcePop 36.73);Qwen3-30B-A3B:CIS 69.88,训练域近饱和(base 95.22)。诊断:$k_t>1$ 侧占 99.96% 方差;$p_t<0.3$ 时 CIS 截断偏差不足 TIS 一半;总体偏差 0.0064 vs TIS 0.0078、新增方差 0.0081 vs Exact 0.0132。消融:固定上限 C=2 掉到 31.40,截断比例相近的 C=1.13 崩到 8.88,双侧带 6.01。超参:$\lambda=0$ 崩溃(8.75),任意正阈值均有效;$\kappa$ 取存储分辨率最佳。训练动态:CIS 奖励 0.867 最高、开销 +3.2%。域外:CIS 汇总 56.79 名义最高,但与 IcePop 56.60 差距在种子方差内。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Qwen1.5-MoE-A2.7B 五基准平均(GSM8K 上 RL 后,评测 GSM8K/MATH500/SVAMP/Minerva/OlympiadBench) | greedy pass@1 平均准确率 (%) | CIS 34.78±0.25(λ=2.3, κ=5×10⁻³) | IcePop 34.18;KPop† 33.50;Exact Ratio 32.48;TIS 31.40;无校正 30.99;GSPO 28.90 | 比最强基线 IcePop +0.60,比无校正 +3.79 |
| DeepSeek-V2-Lite 五基准平均 | greedy pass@1 平均准确率 (%) | CIS 37.16±0.73 | IcePop 36.73;GSPO 36.47;TIS 36.02;无校正 35.83 | 比最强基线 IcePop +0.43,比无校正 +1.33 |
| Qwen3-30B-A3B 五基准平均 | greedy pass@1 平均准确率 (%) | CIS 69.88±0.55 | GSPO 69.23;TIS 69.14;KPop† 69.06;无校正 68.26(base 67.84) | 比最强基线 GSPO +0.65 |
| Qwen1.5-MoE 训练域 GSM8K | greedy pass@1 (%) | CIS 67.88±1.64 | IcePop 66.16;KPop† 64.80;无校正 61.21;base 55.50 | 比最强基线 +1.72,比 base +12.38 |
| 截断偏差与方差诊断(base MoE,6,000 位置) | 偏差 ‖E[(f_t−k_t)ℓ′_t]‖ 与新增方差 (×10⁻³) | CIS:偏差 0.0064,新增方差 0.0081 | TIS:偏差 0.0078;Exact Ratio:新增方差 0.0132 | 偏差比 TIS 低约 18%,新增方差比 Exact Ratio 低约 39% |
| 域外汇总(3 个知识 + 2 个代码基准,共 5,489 题) | item-weighted 准确率 (%) | CIS 56.79±0.71 | IcePop 56.60;KPop† 55.84;base 53.49 | 名义最高,但与 IcePop 的差距小于种子间方差,不构成统计分离 |
局限与改进
作者承认的局限(D.6):只在 MoE 上训练,稠密模型位移集中在零附近、预计校正差异会缩小但未验证;测量与训练基于 bf16 与特定引擎组合,换 kernel 或精度后失配规模会变、$\lambda$ 需重调;理论界基于有界梯度与 token 独立性假设,任何有限 cap 都有类似界,理论无法区分 CIS 与其他有界截断;$\lambda$、$\kappa$ 在 Qwen1.5-MoE 上预注册并固定用于另两模型,基线只用默认超参、未做可比扫参;token 级校正只修正给定前缀下的条件分布、不修正前缀漂移(Seq-MIS 为此拒 95% 响应);异步时 $k_t$ 还混入策略滞后(staleness <1%)。我的补充:训练与评测全在数学推理,代码与知识基准只在 Qwen1.5-MoE 上测且优势不显著;Qwen3-30B 训练域近饱和、提升空间有限;KPop 用的是修正饱和后的 KPop† 变体而非原版;位移“不变性”只是近似(最高置信区 MAD 略宽、Spearman 相关 $-0.12$);每 arm 单节点 8×A100、仅 87 步的短程训练,未在大规模长程 RL 中检验。
独立分析的弱点
独立分析的弱点与改进方向。其一,CIS 与“源头减错”方法正交却未组合:routing replay(让两引擎选相同专家)与 FP16 直接缩小位移规模,组合可能同时降偏差与方差,是最值得先做的实验。其二,$\lambda$ 是全局常数,但失配规模随训练漂移(batch 内最大 $|\log k_t|$ 从约 10 涨到 16–38),后期截断强度在变;可把 $\lambda$ 与在线位移分位数挂钩做自适应调度。其三,截断在 token 计数上高度集中于高置信区(83% 被截 token 的 $p_t\ge 0.9$),虽按权重计过半来自 $p_t<0.9$,但持续削高置信梯度可能与熵快降相关(CIS 终态熵 0.071 vs 无校正 0.220),对探索的影响值得研究。其四,只覆盖数学任务与 2.7B–30B 规模、单节点同步训练,长链推理、agent 与多节点异步 RL(staleness 更大)未检验,需推广为“失配+滞后”联合建模。其五,理论只给上界,$\lambda$ 的选择缺指导,可发展基于实测位移分布的偏差-方差显式最小化来自动定 $\lambda$。
未来方向
作者提出的方向:把 CIS 与减少失配源头的方法组合(routing replay、FP16 训练);对每个基线做同等规模超参扫描以更公平比较;在异步训练中显式建模 stale rollout 的策略滞后。可延伸方向:其一,序列级修正在位移坐标中的版本——token 级 CIS 不修正前缀分布漂移,而位移的加性结构提示可定义响应级累计位移并设计更优雅的序列截断,避免 Seq-MIS 式 95% 拒绝率。其二,把位移分布在线监控作为 RL 基础设施健康指标——位移二阶矩(如 $\mathbb{E}[e^{2\varepsilon_t}]$)直接预测训练稳定性,可作报警信号或 kernel/精度回归测试。其三,自适应阈值:按置信度分箱在线估计位移分位数、令截断率或截断超额守恒,替代固定 $\lambda$。其四,研究稠密模型是否需要更温和校正乃至无需校正。其五,检验位移不变性在更大模型、fp8 等更低精度下是否成立,这关系 CIS 阈值的可移植性。其六,分析截断与熵/探索动力学的交互,解释为何截断比例相近的算子(CIS 3.8% vs TIS C=1.13 的 4.3%)结局天差地别。
复现评估
复现条件好。代码已开源(kzhao5/CIS-RL),基于 AReaL v2.0.0,与 TIS/IcePop 共用同一 token 级分支、只差一个权重乘子。训练数据公开:GSM8K(7,473 题),十个评测基准与 DAPO-Math-17k 测量集全部公开。配方完整:学习率 $3\times10^{-6}$、PPO clip $(0.2,0.28)$、无 KL 惩罚、每 prompt 4 样本、3 epochs 共 87 步;超参明确($\lambda=2.3$、$\kappa=5\times10^{-3}$)。算力:每 arm 8×A100-80GB,Qwen1.5-MoE 约 1.0–1.4 小时、三种子约 4 小时;失配测量另需 4×A100 约 8 分钟,中等算力即可复现主表。难度中等,坑在工程细节——训练引擎必须用 flash attention(否则 packed sequence 串扰污染 log 概率)、推理侧概率须取采样时刻原始值、KPop 需 float64 修正饱和——论文在 C.1、C.4、D.5 均有提示,附预注册契约与三种子标准差,可信度高。
论文图表
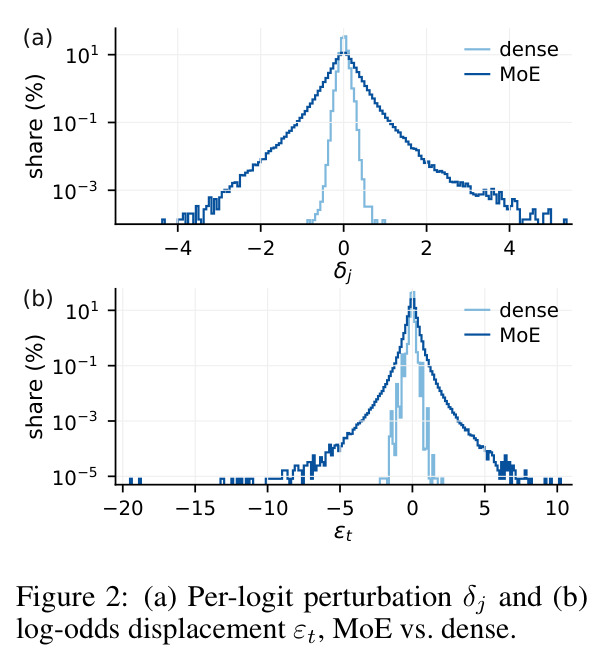
在 6,000 个测量位置上对比稠密模型与 MoE 的每-logit 扰动 $\delta_j$ 与 log-odds 位移 $\varepsilon_t$ 的分布:两者主体都集中在零附近,但 MoE 呈现明显重尾($|\varepsilon_t|$ 最大达 19.38,稠密仅 2.13)。
经验刻画的起点:证明失配不是简单的 bf16 舍入噪声,MoE 上存在由路由分歧放大的重尾——正是这个重尾让精确校正方差爆炸、必须截断。
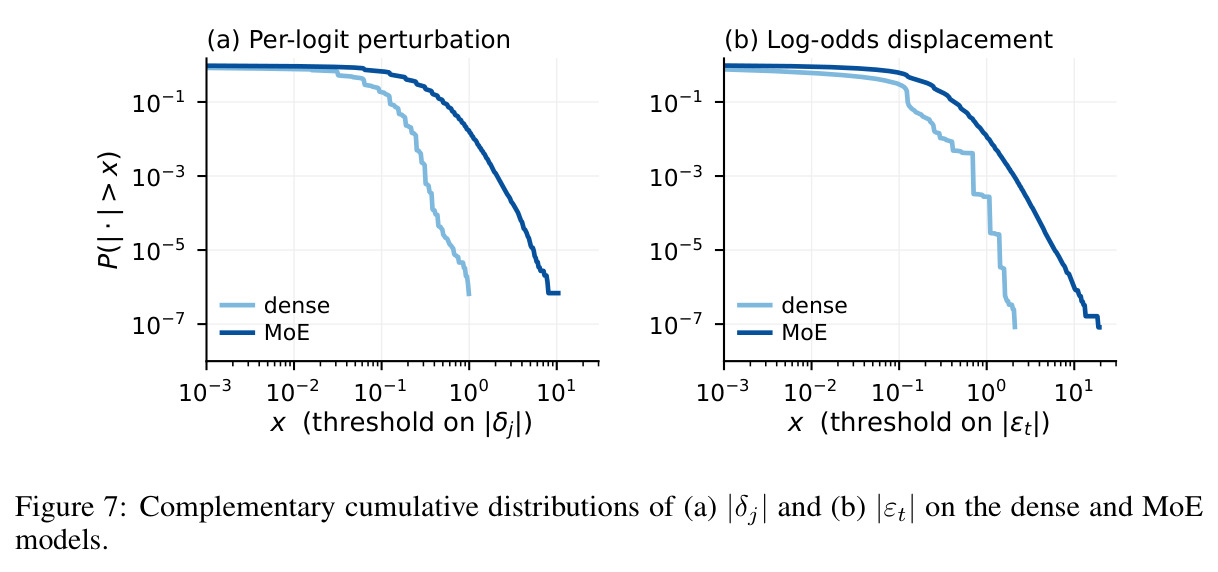
互补累积分布(CCDF)对数图:稠密模型仅 0.003% 的 $|\delta_j|>0.5$、几乎没有超过 1 的;MoE 上 9.87% 超过 0.5、1.52% 超过 1;位移 $|\varepsilon_t|>1$ 的比例从 0.028%(稠密)升到 1.13%(MoE)。
以完整尾部视图支撑“重尾是 MoE 特有”的论断,与 Figure 2 互补并量化了架构间差异。
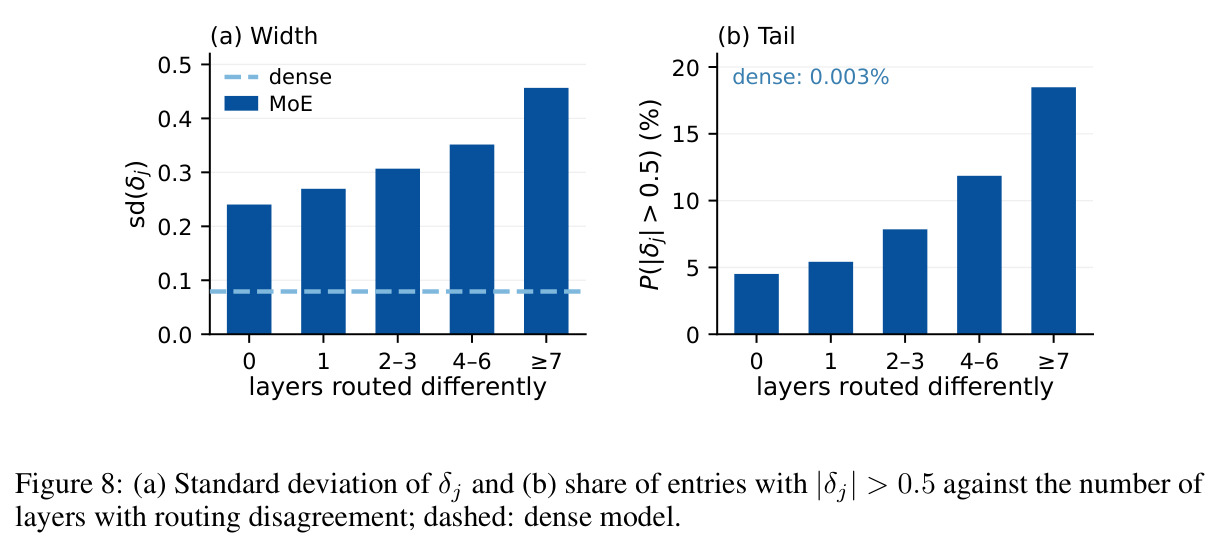
按 24 层中两引擎路由分歧层数 $N_{flip}$ 分箱:从 0 层到 ≥7 层,$sd(\delta_j)$ 从 0.240 单调升到 0.457,$P(|\delta_j|>0.5)$ 从 4.51% 升到 18.48%;全部 24 层都一致的位置仅占 8.0%。
把 MoE 重尾归因到具体机制——路由分歧,且呈单调剂量效应,是理解“失配从哪里来”的核心证据。
主结果表:三个 MoE 模型 × 10 种方法 × 5 个数学基准,三种子均值±标准差。CIS 在全部三个模型上取得五基准最高平均:Qwen1.5-MoE 34.78、DeepSeek-V2-Lite 37.16、Qwen3-30B-A3B 69.88,训练域 GSM8K 上也分别达到 67.88、72.58、95.60。
全文核心证据,支撑“CIS 在所有被评基线中取得三模型最高平均”的主张,也是 token 级/序列级/数值级各类方法横向对比的基准。
消融表:完整 CIS 34.78;换成固定比值上限 TIS C=2 掉到 31.40、C=1.13 崩到 8.88;加双侧带 $w_t\ge(1+p_t)/2$ 崩到 6.01(低于 base 的 28.93);去掉数值下限($\kappa=0$)掉到 29.02;下限抬到 0.1 掉到 32.17。
逐一验证 CIS 三个设计组件(上侧单边、位移坐标截断、小数值下限)的必要性,尤其证明“同样比例的截断放在比值坐标会摧毁训练”。
稠密 vs MoE 的 $\delta_j$ 全套统计:配对条目 1,521,672 / 1,457,477;标准差 0.079 vs 0.336;$q_{99.9}(|\delta_j|)$ 0.312 vs 2.062;$P(|\delta_j|>0.5)$ 0.003% vs 9.87%;最大值 1.00 vs 10.47。
以完整分位数表量化失配的架构差异,是 Figure 2 与 Figure 7 的数值底稿。
条件路由控制实验:稠密 0.079/0.003%/0.0001%;MoE 零分歧位置($N_{flip}=0$)0.240/4.51%/0.47%;MoE 有分歧位置 0.343/10.35%/1.62%——即使零分歧,MoE 的扰动标准差仍是稠密的约 3 倍。
诚实的因果控制:说明路由分歧是主要放大器但非唯一来源(前缀分歧传播、架构固有差异也参与),防止对机制的过度归因。
约 1,239 万稠密 / 1,229 万 MoE 采样 token 上的位移统计:$sd(\varepsilon_t)$ 0.0997 vs 0.2947;$q_{99.9}$ 0.693 vs 2.044;$P(|\varepsilon_t|>1)$ 0.028% vs 1.13%;最大值 2.13 vs 19.38。
证明重尾从 $\delta$ 经非线性映射完整传播到真正进入重要性权重的 $\varepsilon_t$,把 logit 层面的发现与方法和理论层面接起来。
五个置信度分箱的条件统计:MAD($\varepsilon_t$) 从 0.156 到 0.237(约 1.5 倍),而 MAD($\log k_t$) 从 $1.15\times10^{-1}$ 骤降到 $9.90\times10^{-6}$——全范围相差约 $3.2\times10^5$ 倍。
逐箱给出“位移近似不变 vs 比值剧烈变化”的最直接数值对照,是 CIS 核心假设(位移坐标可共享单一阈值)的定量化呈现。
十个评测基准明细:5 个数学基准(GSM8K 1,319、MATH-500 500、SVAMP 300、Minerva-Math 272、OlympiadBench 674 题,math-verify 判分)+ 3 个知识基准(MMLU-STEM 3,153、ARC-Challenge 1,172、OpenBookQA 500 题)+ 2 个代码基准(HumanEval 164、MBPP 500 题,单元测试判分)。
明确评测范围、数据划分与判分协议,是评估结论可信度与可复现性的基础。
第三 epoch 的训练统计:CIS 奖励 0.867(所有方法最高)、峰值梯度范数 3.0、作用 token 比例 3.81%;对比 Exact Ratio 峰值梯度范数 69.5、KPop† 29.2、Seq-MIS 拒绝 94.56% 的响应;batch 内最大 $|\log k_t|$ 各法介于 15.6–37.7。
从训练过程角度解释最终性能差异:方差控制差的算子梯度尖峰大、最终准确率低;掩码过狠的算子(Seq-MIS)梯度近乎消失。
$\lambda$ 扫描的逐基准结果:$\lambda=0$→8.75(崩溃),0.45→33.85,0.89→34.08,1.6→33.89,2.3→34.78(最佳),3.1→33.35,4.6→33.66,9.2→32.53。
支撑“任意正阈值均有效、对 $\lambda$ 稳健”的主张,同时展示 $\lambda=0$ 与 TIS C=1 等价时的崩溃现象,提示截断强度存在下界。
逐步耗时:无校正 30.66s 为基准;CIS 31.65s(+3.2%,其中 rescore 6.67s);Exact/IcePop/TIS 为 +1.0%/+0.7%/−0.5%;Seq-TIS/Seq-MIS 为 +14.3%/+18.3%(部分因其响应更长,289/300 vs 249–260 token);FP16 为 −1.8%。
量化的成本-收益分析:CIS 以 3.2% 的开销换取三个模型上一致的准确率领先,工程性价比一目了然。