Mara Chain:把失败当作进化阶梯的 AI 系统自动优化方法 Mara Chain: Rethinking Failure as a Stepping Stone for AI System Auto-Evolution
保留被拒候选沿链精炼,把失败证据变成阶梯,突破持久失败屏障
前置知识
提议-评估-选择循环(Propose–Evaluate–Select)
基于 LLM 的工件优化标准范式:LLM 提议一个候选配置(如提示词、技能、harness 代码),评估器在训练小批量上执行打分,仅当分数相对父代超过接受门槛才保留进入验证,否则直接丢弃并另起炉灶。GEPA、ACE、SkillOpt、AHE、Meta-Harness 等主流方法都建立在这个循环上,区别只在提议与选择策略。
本文的全部改进都针对该循环中“丢弃失败候选”这一环节,理解原范式才能看清 Mara Chain 改了什么。
可调工件(Tunable Artifacts)
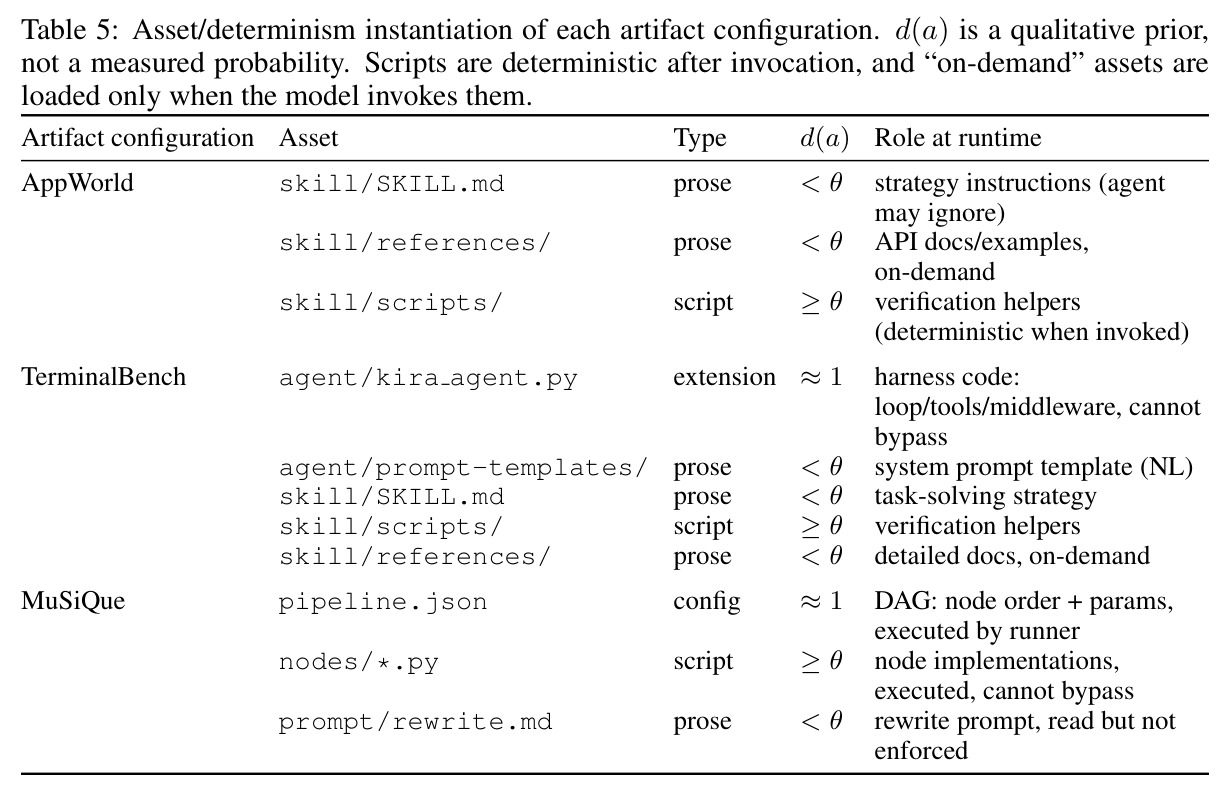
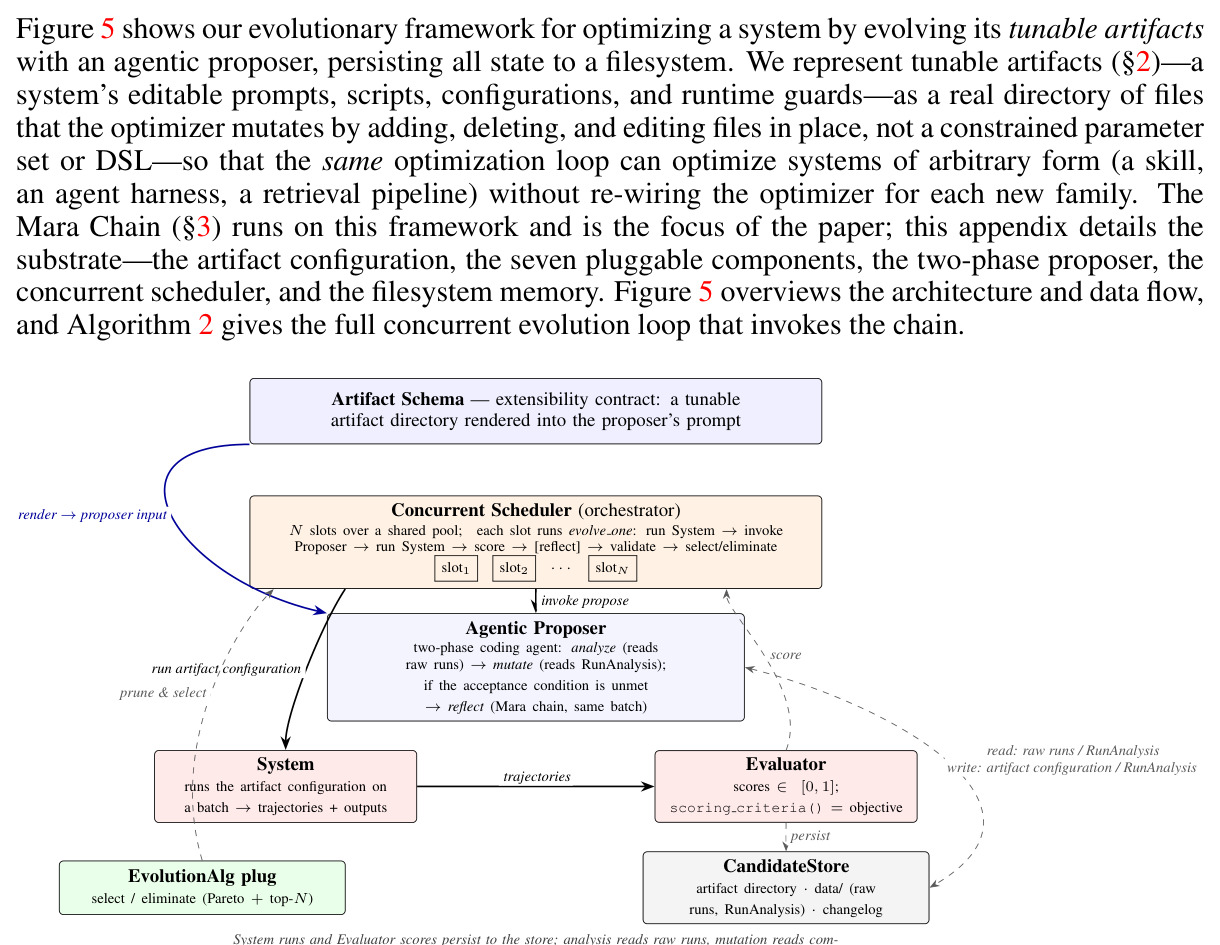
指系统中可修改的行为组件:提示词、技能文件、agent harness、脚本、配置与源码。优化这些工件而非模型权重,可以在不重训模型的情况下让已部署系统持续进化。本文用真实目录加模式(schema)统一表示它们,优化器直接增删改目录中的文件,因此技能、harness、检索流水线可以用同一个循环优化。
论文优化对象是工件而非权重,三大实验分别对应技能、harness、检索流水线三类工件实例。
Pareto 支配与 Pareto 前沿
在逐任务分数向量下,若候选 Q 在所有维度上都不比 P 差(容差 $\epsilon$ 内),称 Q 弱支配 P;过滤掉所有被支配者得到 Pareto 前沿,可保留各有所长的互补候选而非压成单一标量分。但作者证明维度 $D$ 增大时支配概率 $[1-p(1-p)]^D$ 指数衰减,$D\geq 20$ 时跌破 1%,前沿退化为整个种群,池会无界膨胀。
理解候选池为何会膨胀、为何需要 Top-N 截断,是读懂外层循环与消融的关键。
持久失败屏障(Persistent Failure Barrier)
某个未满足条件(残差 $\delta(\sigma,\tau)$)在多轮迭代中保持不变的现象:无论再投入多少 rollout 预算,同一失败被反复重新诊断,正确的修改被反复丢弃。常见诱因包括部分修复无即时分数收益、正确修改在执行中未被触发、目标条件被未满足的前置条件门控等。
这是论文定义的核心问题概念,方法动机、案例研究与消融分析全部围绕它展开。
GEPA 与反射式提示进化
GEPA 用遗传-帕累托框架对系统提示词做反射式进化:LLM 基于执行轨迹反思并变异提示词,按逐实例分数做 Pareto 选择保留互补候选。它是本文在技能优化上最强的基线,本文的 Pareto 过滤思想也直接继承自它。
论文的主要对比数据都以 GEPA 为参照(如 rollout 效率提升 65.5%),不了解它难以判断改进幅度。
研究动机
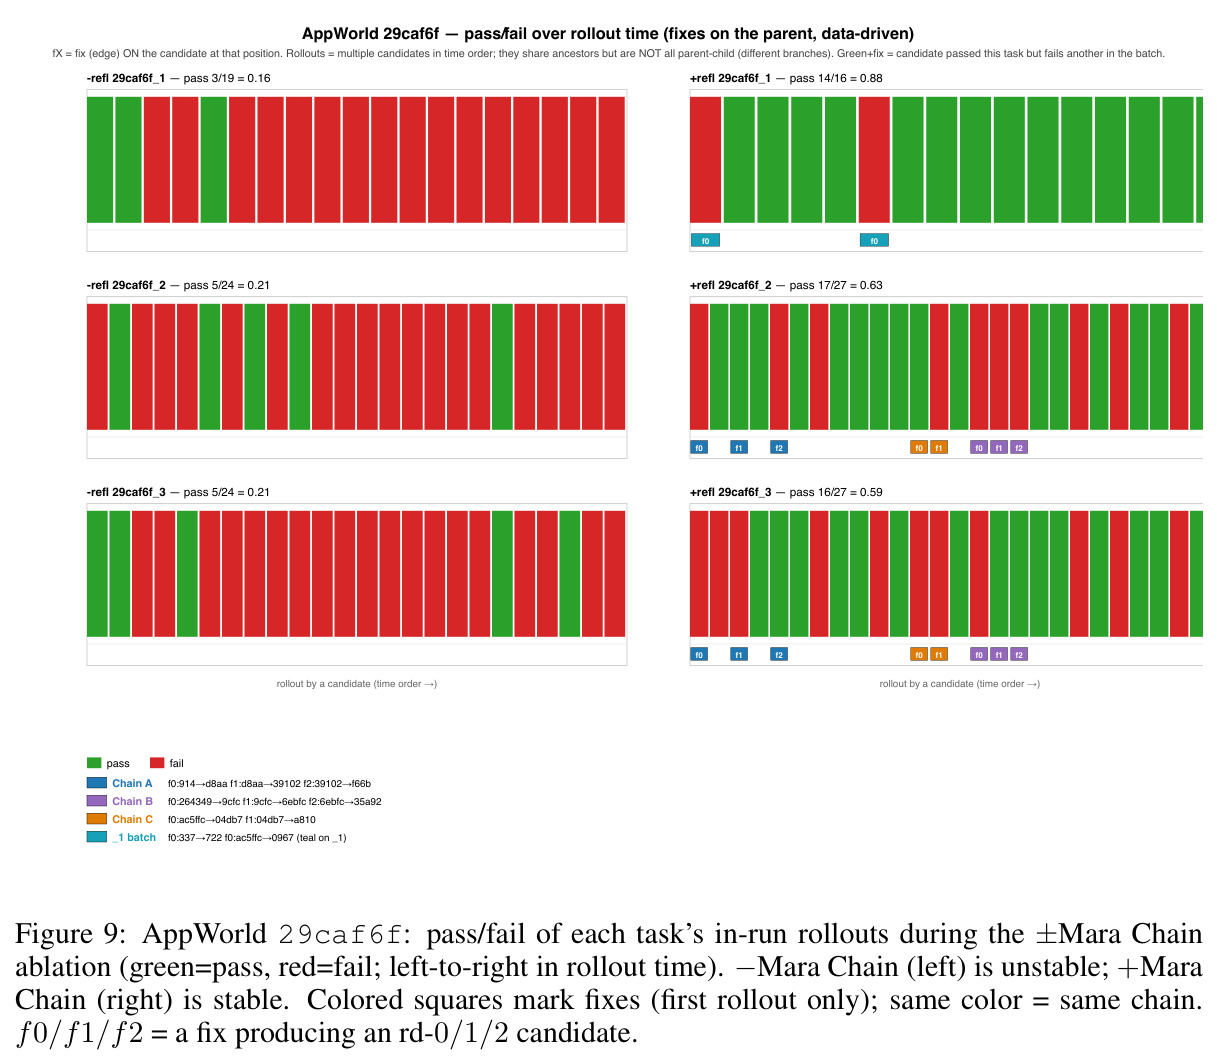
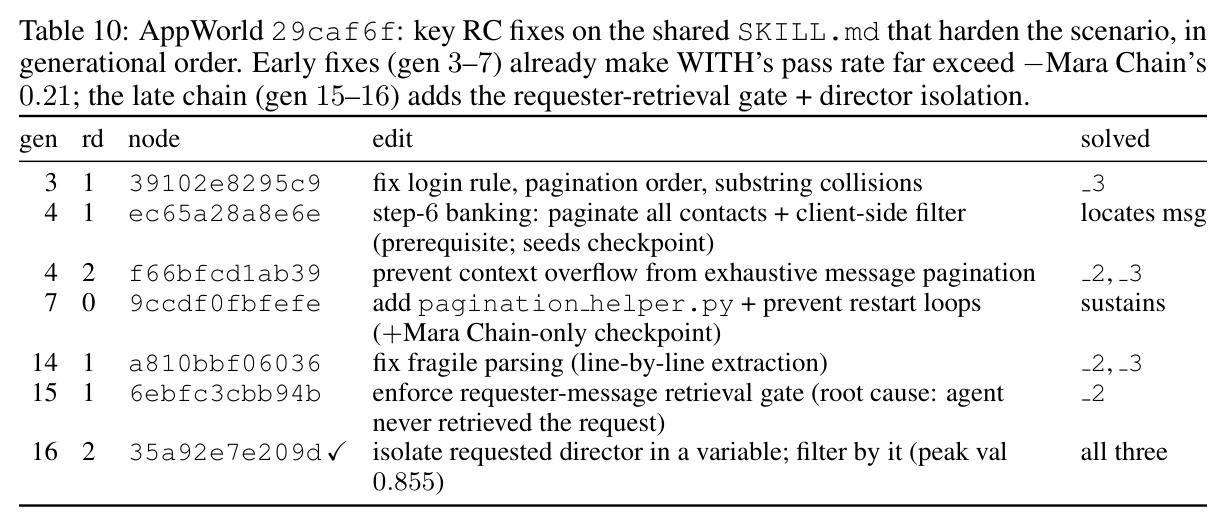
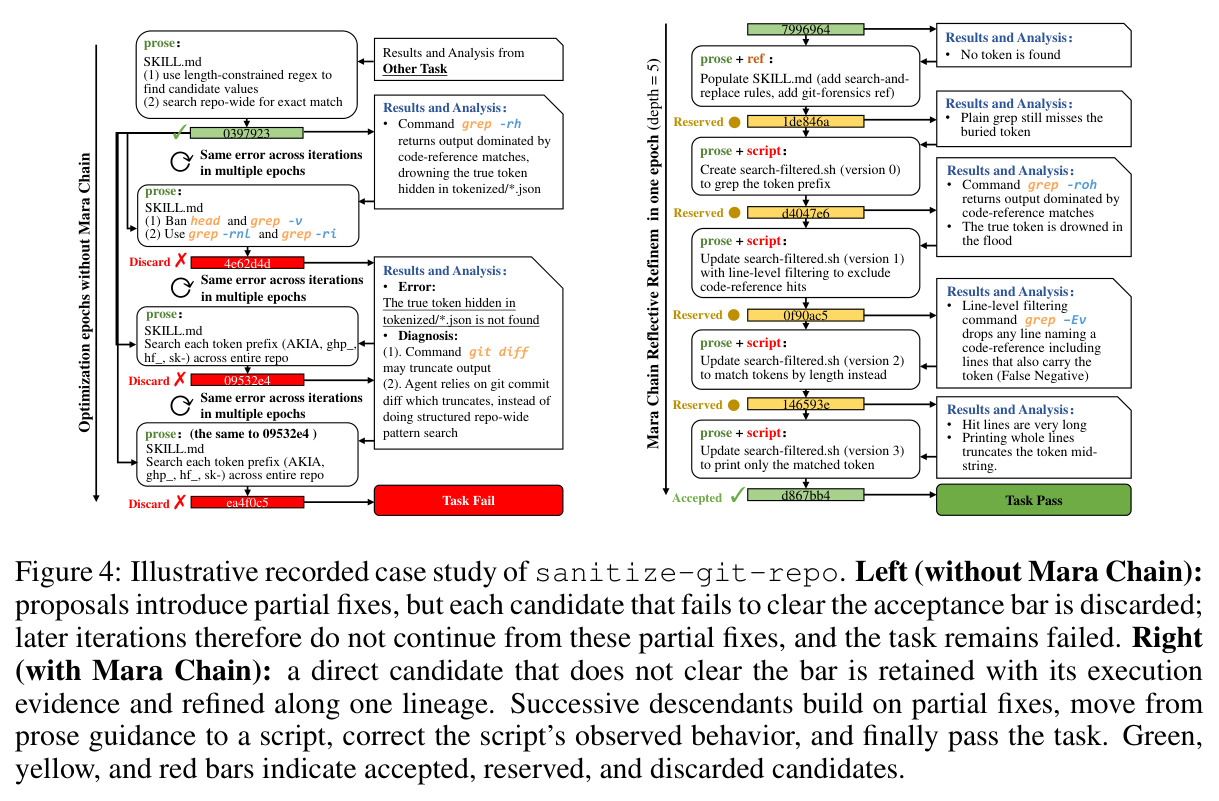
现代 AI 系统的优化越来越多地发生在提示词、技能、harness、脚本与代码等“工件”上,而非模型权重。标准做法是提议-评估-选择循环:LLM 提议候选配置,评估器打分,凡未通过接受门槛的候选一律丢弃。作者在检查 rollout 轨迹时发现,这种丢弃正是停滞的元凶:被拒候选很少一无是处——它可能携带可扩展的部分修复、方向正确但实现有 bug 的尝试,或是用实测效果排除了一条错误路线的证据;丢掉它们,后续提议只能从零重建同样的诊断。论文将其形式化为“持久失败屏障”:某个未满足条件(残差 $\delta(\sigma,\tau)$)跨迭代保持不变,再多的 rollout 预算也无济于事。案例触目惊心:TerminalBench 2.1 的 sanitize-git-repo 任务中,无链基线在超过十个提议批次里反复添加相似的部分性 prose 修复(限长正则规则、无截断规则、git 检出注意事项等),同一诊断在三个不同批次中重复出现,9 个候选全部 0 分;AppWorld 场景 29caf6f 中,“回复提及未被点名的电影”这一失败被逐字重复 54 次;−Mara Chain 运行在 104 个候选中退休了 78 个,其中包括带部分修正者。随着预算增长,分数停在平台期不再上升。
本文的目标是本文的目标是把被拒候选从“弃子”变成“垫脚石”,在固定 rollout 预算 $B$ 内打破持久失败屏障,取得更高的期望分数 $\sigma^\star=\arg\max_\sigma \mathbb{E}_{\tau\sim\mathcal{D}}\ \mathrm{score}(\mathrm{exec}(\sigma,\tau))$,同时保证成本有界。量化目标包括:在 AppWorld 技能优化上全面超过 GEPA、ACE、SkillOpt-Lite 三个专门优化器;在 TerminalBench 2.1 harness 优化上超过 AHE 与 Meta-Harness;在 MuSiQue 检索流水线上超过手写默认流水线;并验证优化结果跨 GLM-5、DeepSeek-V4-Pro、Qwen3.5-397B-A17B 三个冻结模型泛化。成本约束同样明确:链式精炼被限制在固定深度 $d$ 内,失败的链不留持久成本;候选池由 Pareto 过滤加 Top-N 截断保持有界,避免种群无限膨胀。
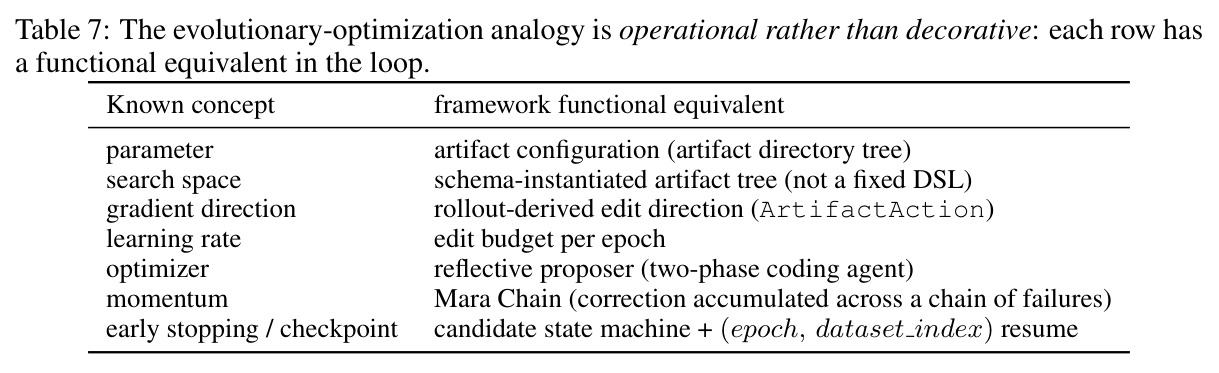
与已有工作不同的是,既有工件优化方法(GEPA、ACE、SkillOpt、AHE、Meta-Harness 等)共享一个未被质疑的假设:未过门槛的候选是死路,应丢弃或回滚。本文的独特切入是把“废弃品”重新定义为信息资源:失败尝试携带的残差、轨迹与改动历史,恰恰是跨越失败屏障所需的证据——部分修复可以延伸,sound direction 的 bug 可以修复,被排除的路线让后续提议换道。作者给出一个操作性类比:Mara Chain 之于工件优化,正如动量项之于经典迭代优化——跨步携带修正信息,让下一次更新从上一步留下的残差出发而非清零重来;不同的是,这里的“梯度”是由 rollout 证据归因出的编辑,“修正项”是自然语言诊断与代码,载体是文件系统,因此优化器必须是一个编码代理。此外,作者还指出被 GEPA 一脉忽视的池管理问题:高维逐实例验证分数下 Pareto 支配概率 $[1-p(1-p)]^D$ 指数衰减,$D\geq 20$ 时跌破 1%,纯 Pareto 过滤会让种群无界膨胀,需要 Top-N 截断配合。
核心方法
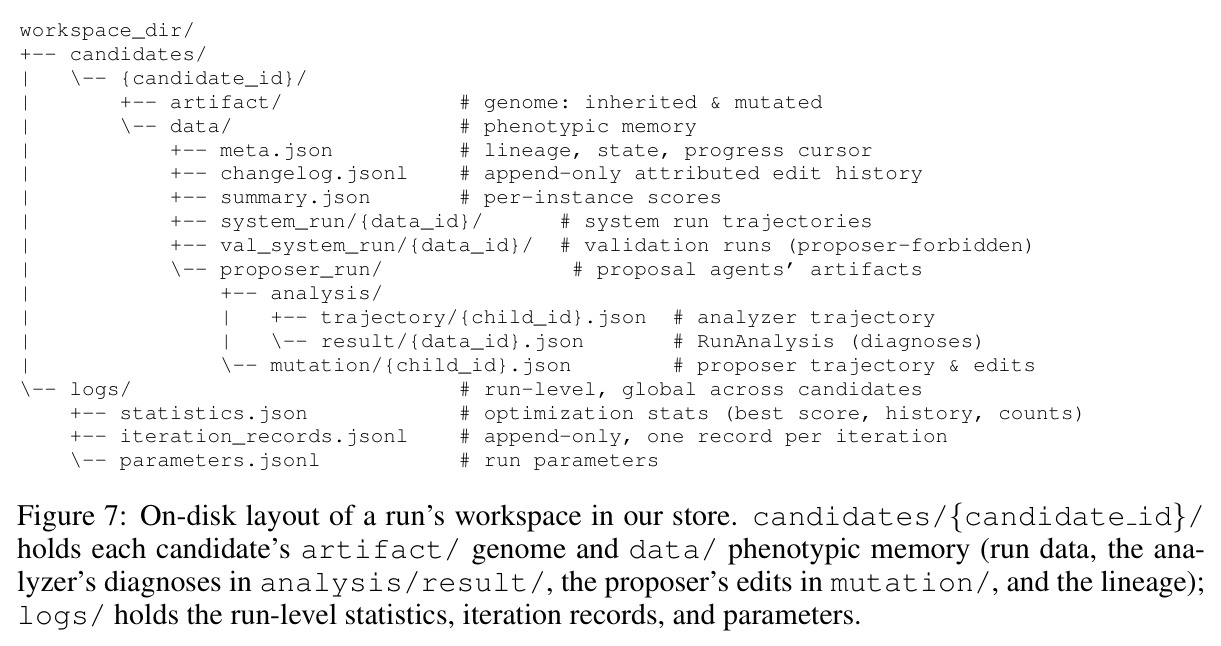
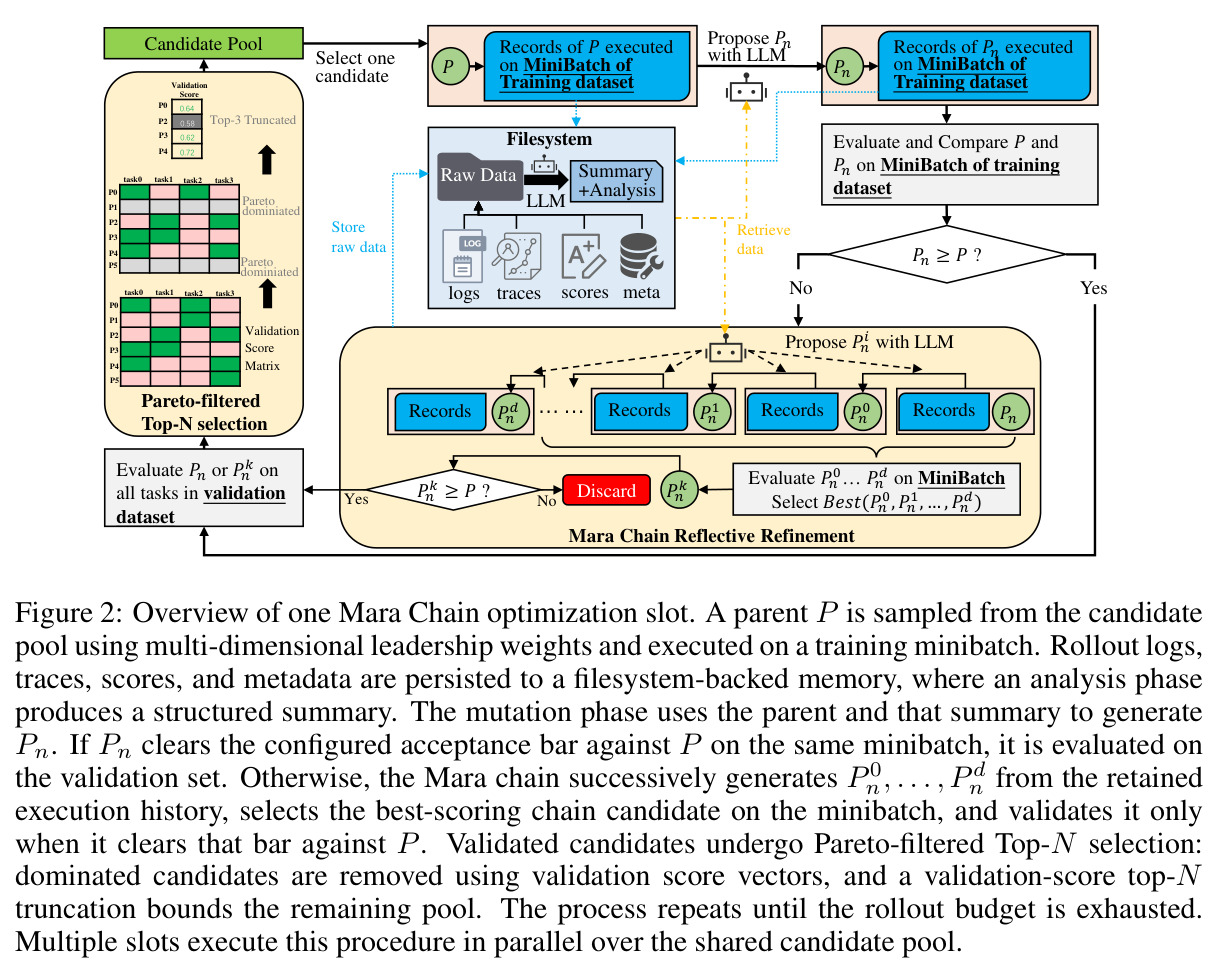
直觉上,Mara Chain 把每次失败尝试当作垫脚石:候选未达接受门槛时,不丢弃,而是保留其执行轨迹、残余失败、结构化分析与改动历史,沿一条谱系持续生成并精炼后代,每个后代都以前辈积累的证据为条件,直到某个后代越过门槛,或链深耗尽、整条链被丢弃——失败链不留下持久成本。技术路线分三层。外层是并行种群循环:多个优化槽共享候选池,按领先计数 $\ell(P)=\sum_j \mathbb{I}[z_j(P)\geq\max_Q z_j(Q)-\epsilon]$ 加权采样父代,在训练小批量上建立基线。中层是 Mara Chain 反射精炼:直接候选未过门槛时触发,链上每步组装上下文 $\Gamma_i$(逐实例分数史、先前诊断、带归因的改动日志、原始运行记录),分析后变异、rollout、打分,一旦过门槛即停;链的产物只有既最高分又过门槛者才进入验证。外层再用两阶段选择维护池:先按逐任务验证分向量做弱 Pareto 过滤(容差 $\epsilon=10^{-8}$),再按平均验证分截断保留 Top-$N$(默认 $N=3$)。所有日志、轨迹、分析持久化于文件系统记忆;提议者是不能绕过隔离守卫的 Pi 编码代理。默认配置链深 $d=5$。
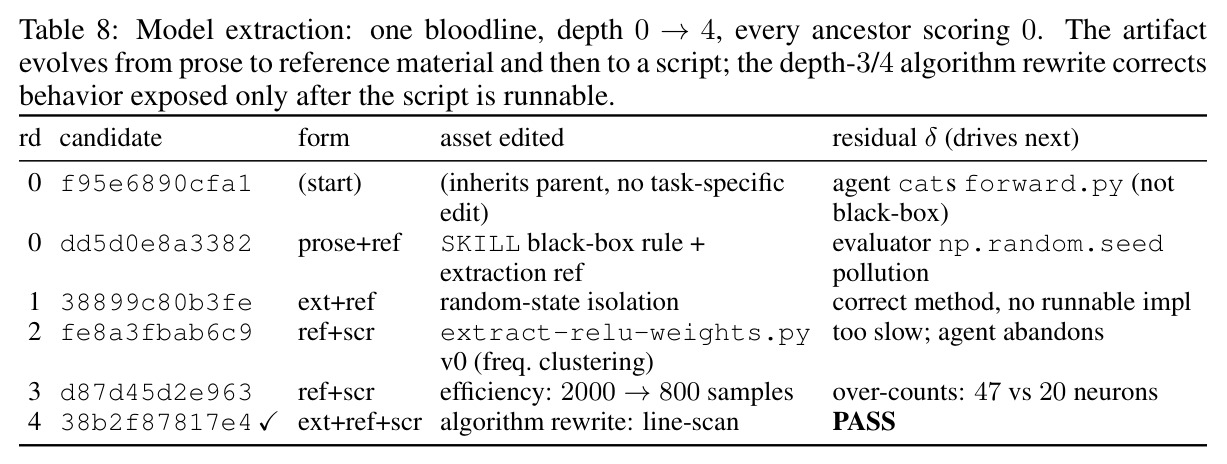
核心创新是把“拒绝”从终点变成起点:历史条件化的链式精炼。与 GEPA/ACE/SkillOpt 的本质区别在于对失败候选的处理——它们执行变异-评估-选择,未过门槛即弃,从不重跑失败候选去理解为何失败;Mara Chain 则保留候选及其全部执行证据,在同一个小批量上沿单一谱系生成后代序列 $P_{n,0},\dots,P_{n,d}$,每个后代继承前辈工件与带归因的改动日志,其分析阶段被强制执行五种诊断方法(增量证据追踪、成功提取、振荡检测、不一致模式发现、运行证据佐证),并把先前诊断归入 A–I 分类表(从未触发、内容错误、模糊、冲突、根因无关、方向耗尽、不一致、丢失的胜利、机制太弱)。其中“机制太弱”类别允许把被系统绕过的 prose 规则升级为更高可靠性的表示——工件按可靠性排序 prose $<$ script $<$ extension,论文观察到精炼链往往从低可靠的自然语言指引逐步升级为可执行代码,使最终行为由代码而非建议文本保证。有界性是设计的另一半:链深固定 $d$,失败链整体丢弃,一次失败直接提议的额外成本最多为 $d$ 次 rollout。
方法步骤详情
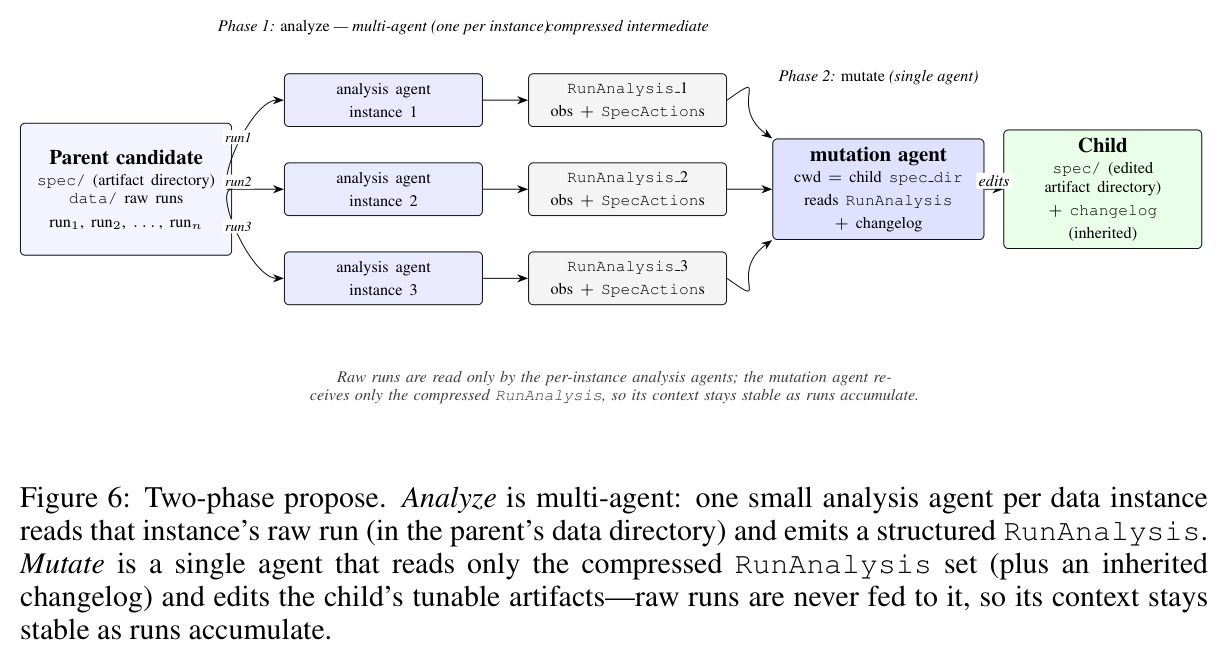
完整流程按算法 1/2 展开。第一步父代采样:外层循环从候选池按领先计数加权无放回采样父代 $P$,在训练小批量 $\mathcal{B}$ 上执行建立基线 $s_{\mathcal{B}}(P)$;父代若已满分则跳过变异。第二步直接提议:分析阶段由每实例一个小型分析代理读取原始轨迹,产出结构化 RunAnalysis;变异阶段单个代理只读压缩后的分析与继承的改动日志,原地编辑工件目录生成子代 $P_n$,在 $\mathcal{B}$ 上打分。第三步门槛判定:若 $P_n$ 相对父代改善达到门槛 $\delta$(clears 谓词,按基准与配置定义),送验证集全量评估;否则触发 Mara Chain。第四步链式精炼:链节点列表以 $\langle P,R_P\rangle,\langle P_n,R_n\rangle$ 开头;每步 $i$ 继承链末节点工件,组装上下文 $\Gamma_i$——谱系路径、带 $\Delta_{root\to id}$ 与 $\Delta_{prev\to id}$ 两列增量的逐实例分数表、归因改动日志、先前诊断、各节点最新轨迹——执行五方法诊断并变异,rollout 打分并持久化,一旦 clears 即提前停止;链结束后取链上最高分节点,仅当其 clears 父代门槛才返回送验证,否则返回 NONE 整链丢弃。第五步池更新:验证产出逐任务分数向量 $z_V(P)$,先弱 Pareto 过滤(同分保留更新代),再按平均验证分截断 Top-$N$;每槽结束时执行 eliminate 与 persist,预算 $B$ 耗尽后在飞槽排干、循环终止。
技术新颖性
与已有技术的具体区别有五点。其一,vs 提示/工件进化方法(GEPA、ACE、SkillOpt、AHE、Meta-Harness):它们都是单次搜索——候选失败即弃或回滚;Mara Chain 是把失败候选沿谱系保留并精炼的提议-评估-选择改进,且链上所有候选在同一小批量上打分保证公平比较。其二,vs 反思类方法(Reflexion、Self-Refine):它们在同一 agent 会话内重试,不维护候选种群、无 Pareto 池管理、无跨候选的归因改动日志。其三,vs 束搜索(如 ProTeGi):束分支是并行假设,而链是沿同一失败证据的顺序精炼,每步条件于前辈的可观测后果。其四,Pareto-Top-N 两阶段选择是新的:作者用 Bernoulli 模型证明支配概率 $P(A\succeq B)=[1-p(1-p)]^D$ 随维度指数衰减,$D\geq 20$ 时低于 1%,纯 Pareto 过滤退化为全种群,Top-N 截断提供了界。其五,工件可靠性梯度(prose $<$ script $<$ extension)与升级机制是 schema 与链的焊点:当证据显示修复被绕过时,链会把修复沿确定性梯度下沉,这一“表示升级”在先前工件优化器中不存在。
实验结果
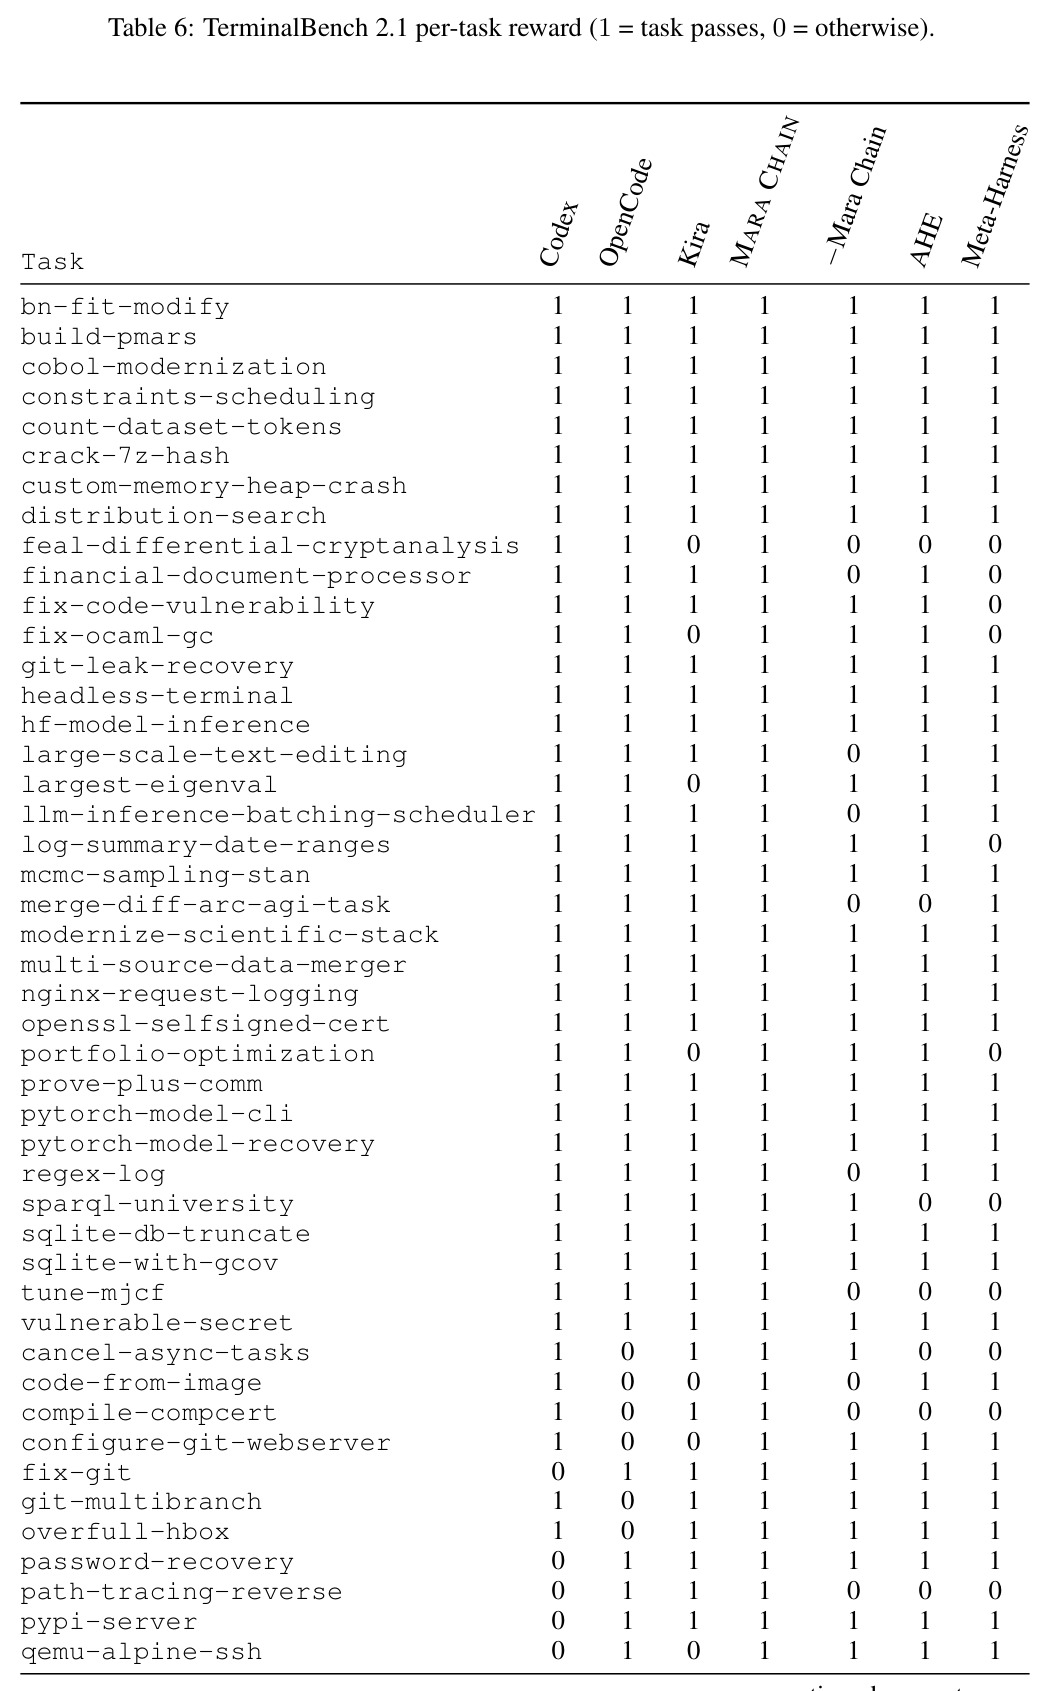
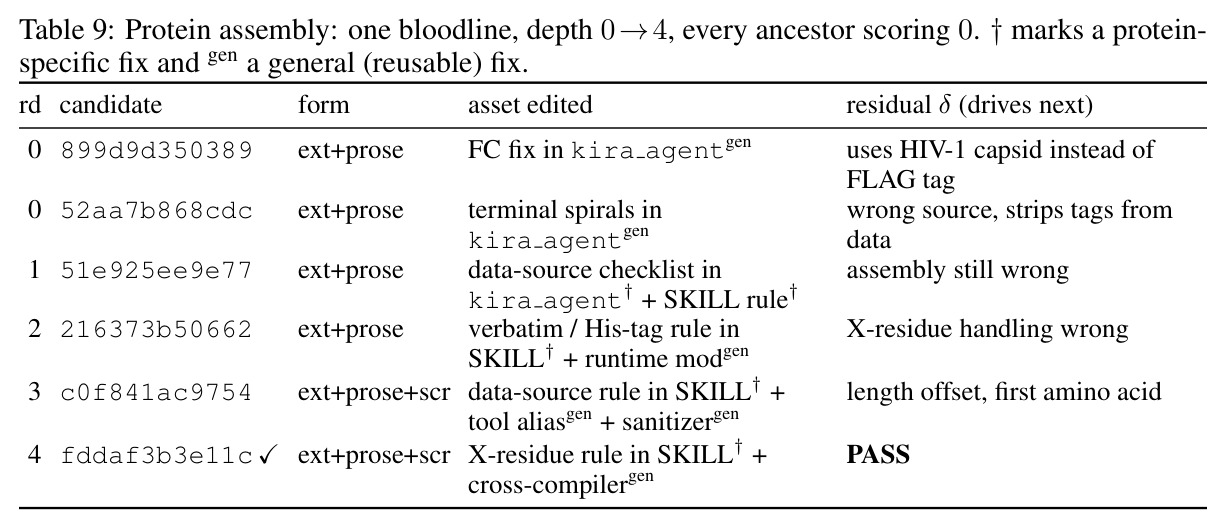
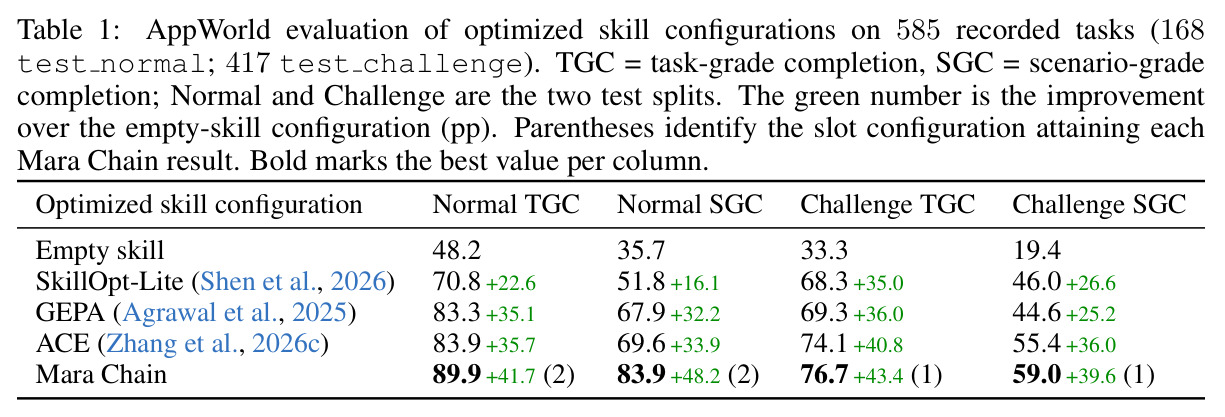
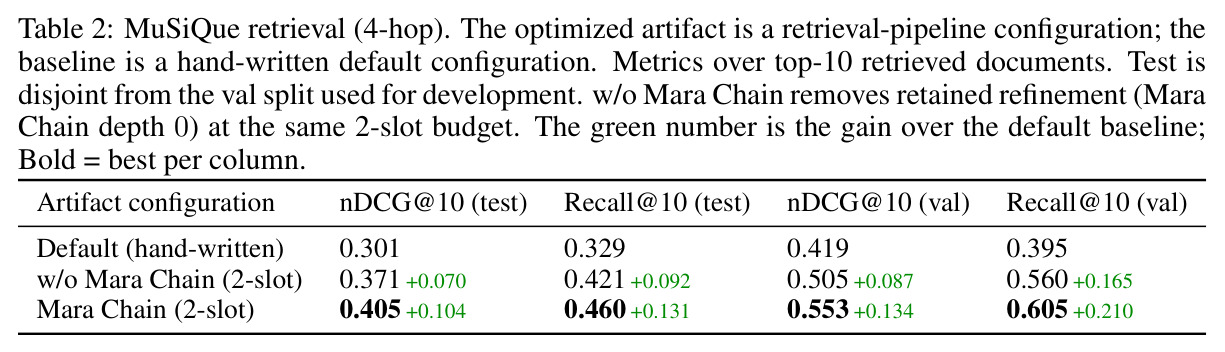
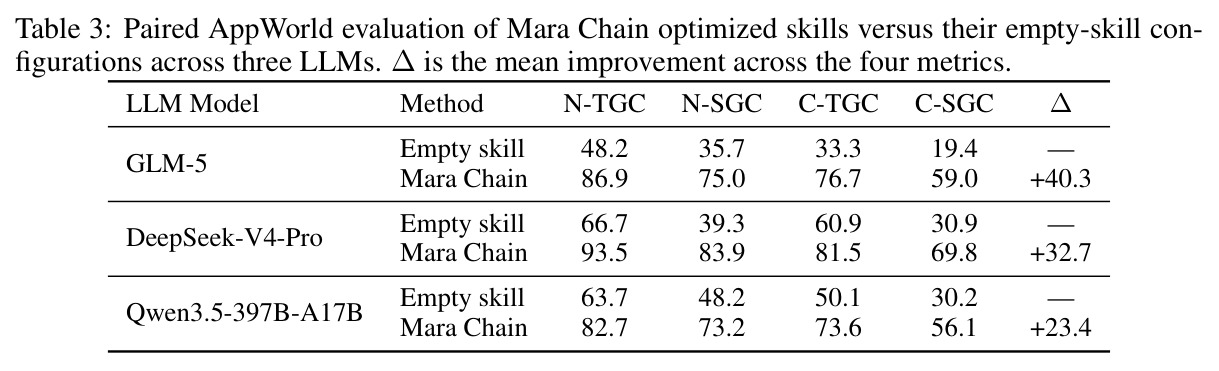
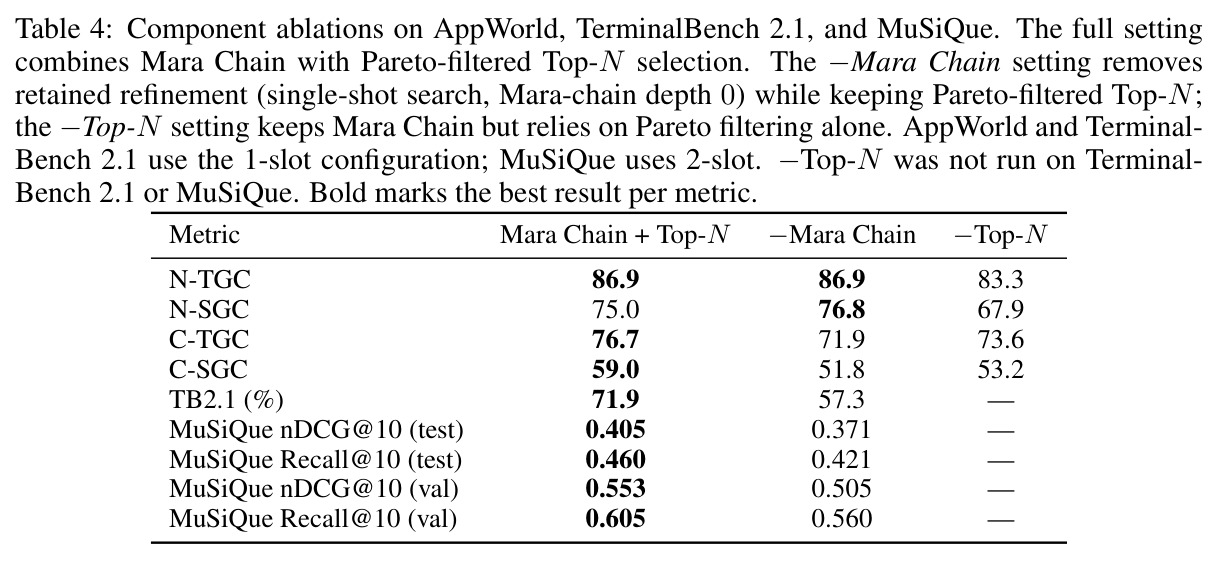
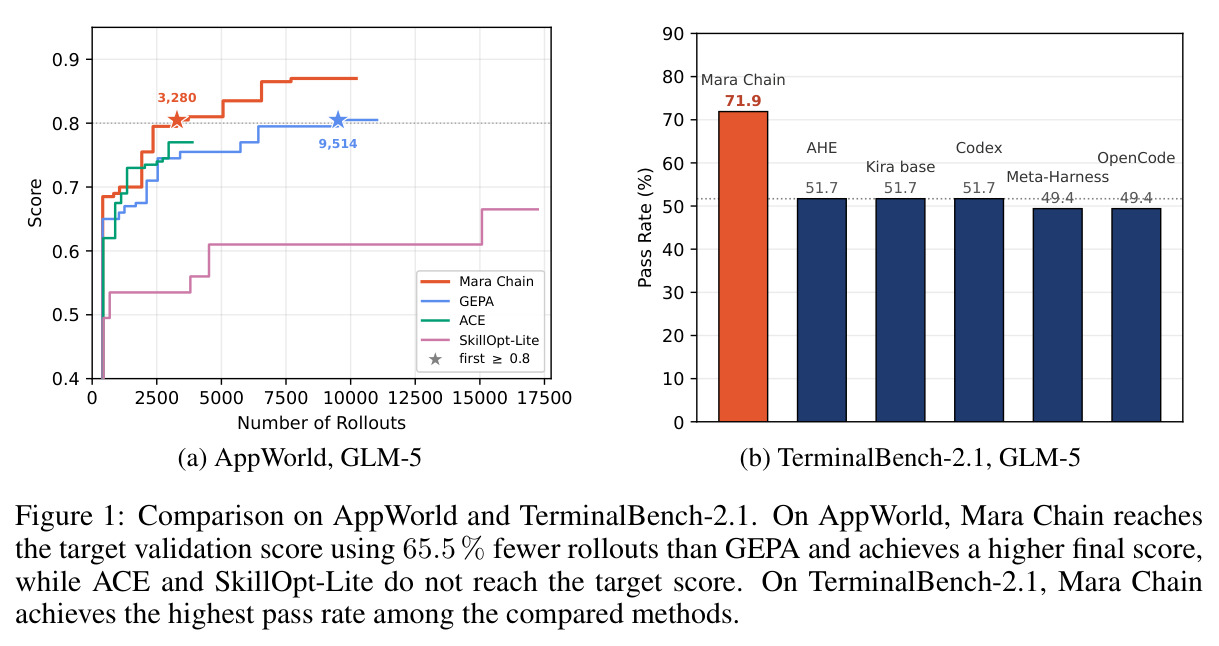
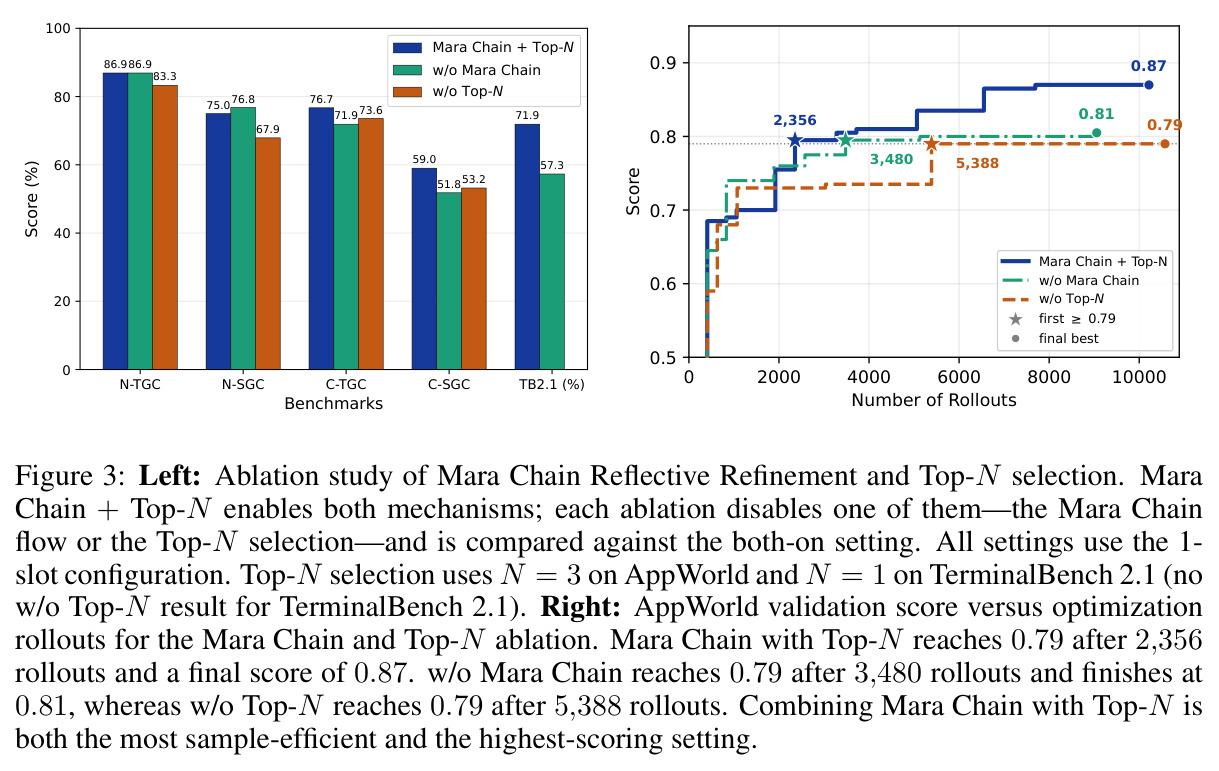
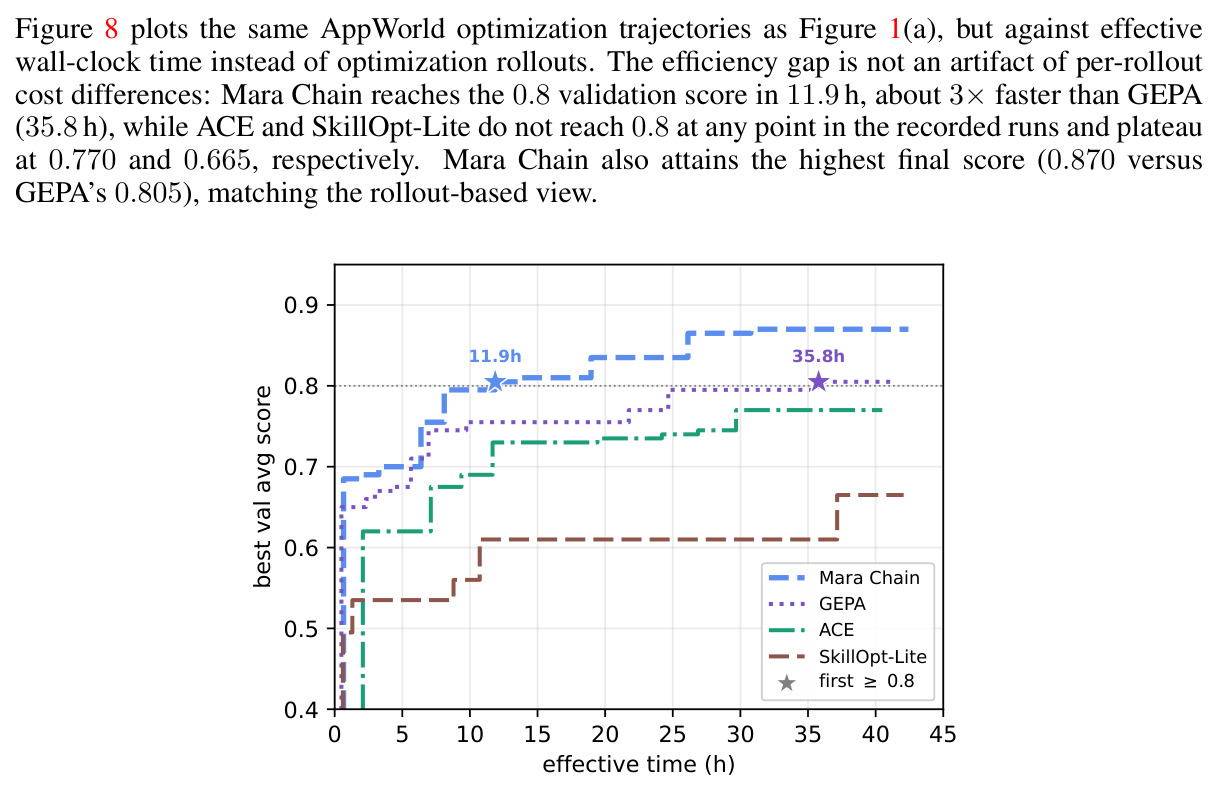
逐一分析三组主实验。AppWorld 技能优化(585 任务 = 168 test normal + 417 test challenge,GLM-5):Mara Chain 在全部四项指标上最佳——Normal TGC/SGC 89.9/83.9、Challenge TGC/SGC 76.7/59.0,全面超过 GEPA(83.3/67.9/69.3/44.6)、ACE(83.9/69.6/74.1/55.4)与 SkillOpt-Lite(70.8/51.8/68.3/46.0),相对提升最高 20.5%;较空技能基线(48.2/35.7/33.3/19.4)提升 +41.7/+48.2/+43.4/+39.6 个百分点。效率:Mara Chain 用 3,280 次 rollout 达到 0.8 验证分,GEPA 需 9,514 次(省 65.5%),ACE 与 SkillOpt-Lite 从未达到;按墙钟 11.9h vs GEPA 35.8h(约 3 倍快);终分 0.87 vs GEPA 0.805、ACE 0.770、SkillOpt-Lite 0.665。TerminalBench 2.1(89 任务,无留出集):优化后 harness 通过率 71.9%,比 AHE、Codex、Kira base(均 51.7%)高 20.2 个百分点,比 Meta-Harness、OpenCode(49.4%)高 22.5 个百分点。MuSiQue 4-hop:优化流水线 test nDCG@10/Recall@10 = 0.405/0.460,比手写默认(0.301/0.329)提升 +0.104/+0.131(相对 +34.6%/+39.8%),验证集 +0.134/+0.210。消融(图 3、表 4):去链后 TB2.1 从 71.9% 跌至 57.3%(−14.6pp),Challenge TGC/SGC 各跌 4.8/7.2pp,而容易的 Normal split 几乎不变,说明链的收益随任务难度增长;去 Top-N 则 AppWorld 全线下降(N-TGC 86.9→83.3 等);样本效率上完整设置 2,356 rollouts 达 0.79、终分 0.87,无链 3,480 次/0.81,无 Top-N 需 5,388 次才达 0.79。跨模型:较空技能四指标平均 +40.3pp(GLM-5)、+32.7pp(DeepSeek-V4-Pro)、+23.4pp(Qwen3.5-397B-A17B),全部为正。案例研究给出四个深度 4 的突破谱系:如 model-extraction 谱系从 prose 到参考再到脚本、最终重写算法得满分 1.0(20/20 行匹配、cosine $>0.99$),而其全部祖先 0 分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AppWorld 技能优化(585 任务,GLM-5) | Normal TGC | 89.9 | GEPA 83.3(ACE 83.9 / SkillOpt-Lite 70.8) | +6.0pp(较最强 GEPA);较空技能 +41.7pp |
| AppWorld 技能优化 | Challenge SGC | 59.0 | ACE 55.4 / GEPA 44.6 / SkillOpt-Lite 46.0 | +3.6pp(较最强基线 ACE) |
| AppWorld 优化效率 | 达到 0.8 验证分所需 rollouts | 3,280 | GEPA 9,514 | 减少 65.5%(约 3 倍样本效率) |
| TerminalBench 2.1 harness 优化(89 任务) | 通过率 | 71.9% | AHE 51.7% / Meta-Harness 49.4% | +20.2pp / +22.5pp |
| MuSiQue 4-hop 检索流水线 | test nDCG@10 | 0.405 | 手写默认流水线 0.301 | +0.104(相对 +34.6%) |
| MuSiQue 4-hop 检索流水线 | test Recall@10 | 0.460 | 手写默认流水线 0.329 | +0.131(相对 +39.8%) |
| 消融:TerminalBench 2.1 | 通过率 | 71.9%(Mara Chain + Top-N 完整设置) | 57.3%(−Mara Chain 消融) | +14.6pp |
局限与改进
作者承认的局限:诊断一次只看一个小批量,容易过拟合该批次的失败模式,逐实例 Pareto 选择只能缓解而非消除;上下文构建与诊断逻辑是手工设计的第一版,搜索全程固定不变。实验协议上有两点需特别注意:TerminalBench 2.1 没有留出集,89 个任务既做优化又做评估,报告的是样本内通过率(与前人 AHE、Meta-Harness 协议一致,但泛化性存疑);AppWorld 侧作者罕见地披露优化器清单缺失、1-slot/2-slot 标签的历史含义无文档,相关比较应谨慎解读。我的独立观察:其一,链式精炼有额外成本,深度 $d=5$ 意味着一次失败的直接提议最多引发 5 次额外 rollout 与分析,小预算场景可能得不偿失;其二,结果依赖强提议者(Pi + GLM-5.1)的分析质量,弱提议者下链是否会退化为噪声精炼未验证;其三,定理 1/2 的假设(残差完备性、可实现性、正支撑)属于抽象层面,作者明确表示未被实验确立;其四,四个案例谱系被作者称为“示例性而非因果识别”,机制归因仍有缺口;其五,方法顺畅运行依赖确定性评估器(AppWorld 冻结时间、精确 DB 比对),噪声评估环境下的表现未知。
独立分析的弱点
独立分析四点弱点。其一,串行链的延迟:链是顺序的,深度 4 的谱系意味着至少 5 次串行 rollout 加分析,TB2.1 的 100h 墙钟预算相当可观;改进方向是作者提出的并行 Mara-tree,或按残差相似度提前剪枝、失败模式去重。其二,小批量过拟合与打分噪声:TB2.1 批量仅 4,随机波动大,幸运批次的分数可让噪声候选过门槛;作者也承认领先计数采样在 $p$ 接近 0/1 时大量并列、估计本身有噪。改进可用 Thompson 采样、多次重复评估去噪、或基于置信区间的门槛。其三,诊断管线手工固定:五方法诊断与 A–I 分类表是硬编码先验,迁移到非 agent 领域(如数值内核优化)未必匹配;可让诊断策略可学习、可配置,或从经验库检索领域适配的诊断模板。其四,超参按基准手调:$N=3$、$d=5$、接受门槛 $\delta$ 均按任务设定,缺乏自适应机制;可按任务难度在线调整深度与门槛,作者亦将其列为未来工作。另外,验证隔离依赖 Pi 运行时的路径正则守卫,换运行时需重写等效守卫,工程可移植性有限。
未来方向
作者提出三条线。效率线:链深按问题难度自适应——难屏障加深、易屏障提前终止,并用更便宜的提议者模型与预算化深度降低墙钟与 token 成本。探索线:超越单一测试分数的多样性感知选择,把串行谱系分叉为并行的 Mara-tree;附录还提到自适应维度加权或 Thompson 采样以应对支配选择的采样噪声。可信与迁移线:为每个链节点估计置信度、低置信时回退基线配置,并把有效策略蒸馏进跨工件配置、跨领域元学习的共享经验库。基于成果可延伸的方向:把“可靠性梯度升级”(prose→script→extension)推广为显式的表示选择策略并量化其独立贡献;在更多工件家族(计算内核、数据流水线等)验证 §2 的泛化论断;在共享经验库上研究跨任务失败模式复用与失败屏障预判;以及把 MuSiQue 上“链贡献约三分之一增益”的量化模式推广为诊断工具,帮助实践者判断何时值得开链。
复现评估
代码已开源(github.com/ant-research/AntOmniEvo,蚂蚁集团),框架七组件可插拔,三个基准的工件 schema 以代码形式完整给出(AppWorld 技能、TerminalBench kira harness、MuSiQue 检索 DAG),算法 1/2 伪代码与提示模板随代码发布。基准全部公开:AppWorld v0.2.0.dev0(147 任务训练池 + 200 验证 + 585 测试)、TerminalBench 2.1(89 任务)、MuSiQue 4-hop(300/100/300 划分,测试与验证零重叠)。算力主要消耗在 API 调用:需要 GLM-5/GLM-5.1/GLM-5.2 等模型访问与 Pi 编码代理;参考预算 TB2.1 为 100h 墙钟、MuSiQue 20h、AppWorld 由图 8 看约数十小时量级。复现难度中等:附录 E 协议披露详尽,但作者坦承 AppWorld 的优化器清单缺失、1-slot/2-slot 含义不明,完全对齐论文数字有不确定性;提议者侧依赖 Pi 的扩展守卫(验证隔离、changelog 纪律),换运行时需自行实现等效守卫。对想在自有系统上应用方法的读者,框架接口清晰,主要工作量在定义工件 schema 与评分器。
论文图表