HarnessPro:基于帕累托优化的递归式 Agent 框架自我改进 HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
递归进化 Agent 框架,在帕累托前沿上同时提升任务成功率并降低约 26% 执行成本
前置知识
Agent Harness(智能体框架)
Harness 是包裹大模型的软件运行时层,负责管理模型与环境的交互,包括系统提示词、可用工具与技能、上下文与记忆机制、hooks 钩子以及验证策略等。给定任务 $x$,harness 决定智能体看到什么信息、能执行哪些动作、动作如何被落地执行,轨迹记为 $\tau_h(x) = \text{Solve}(h, x)$。它既影响任务成功率,也影响 token 消耗和延迟。
本文优化的对象不是模型本身,而是 harness 这一层。理解 harness 包含哪些可修改组件(指令、路由、hooks、工具输出压缩等),才能理解方法每一步在改什么、进化出的产物长什么样。
递归自我改进(RSI, Recursive Self-Improvement)
一种让智能体系统利用自身历史执行轨迹来改进自己的范式:先在训练任务上跑出执行轨迹,用 LLM 诊断轨迹中的失败模式与低效环节,据此修改 harness(或技能、记忆等组件),再把改进后的系统用于下一轮迭代,循环往复。代表工作包括 Darwin Gödel Machine、AHE 和本文的直接基线 RHO。
HarnessPro 建立在 RSI 框架之上,但指出此前 RSI 方法只优化成功率、不惜代价。理解 RSI 的迭代循环结构,才能理解本文如何在每轮迭代中同时注入成本信号并做帕累托筛选。
帕累托前沿与多目标优化
当需要同时优化两个相互冲突的目标(这里是最大化通过率 $PR(h)$、最小化成本 $C(h)$)时,不存在唯一最优解。若候选 $h'$ 在两个指标上都不差于 $h$ 且至少一个严格更好,则称 $h'$ 帕累托支配 $h$;所有不被任何候选支配的解构成帕累托前沿,代表不同的最优权衡点。
本文的核心贡献就是同时优化性能与成本:过滤帕罗托被支配的候选,并用归一化加权平方距离从前沿上挑选 lite/medium/heavy 三个代表点。不懂帕累托支配就无法理解候选筛选机制。
DPP(行列式点过程)
DPP 是一种定义在集合上的概率分布,子集 $Y$ 被选中的概率正比于核矩阵主子式的行列式 $\det(K_Y)$:行列式越大说明子集内元素越多样(互相负相关)。本文用难度加权的 DPP 核 $K = \text{diag}(w) S \text{diag}(w)$ 从候选任务池中挑出既难又彼此多样的 10 个训练任务(coreset),采用贪心最大化行列式而非直接采样。
轨迹分析和进化都只在 10 个任务的训练集上进行,训练集质量直接决定诊断的代表性。DPP 选 coresets 是控制进化成本的第一道关卡,也是复现本文的关键实现细节。
LLM-as-Judge 与测试合成评估
LLM-as-Judge 指让大模型直接阅读执行轨迹并判断任务是否成功,常用于无标准答案的场景,但已被证明存在偏乐观、偏好自身输出的系统性偏差。测试合成则是让 LLM 根据任务描述生成可执行测试用例(断言具体行为),用测试通过与否这一客观信号来评估,而非依赖模型的主观判断。
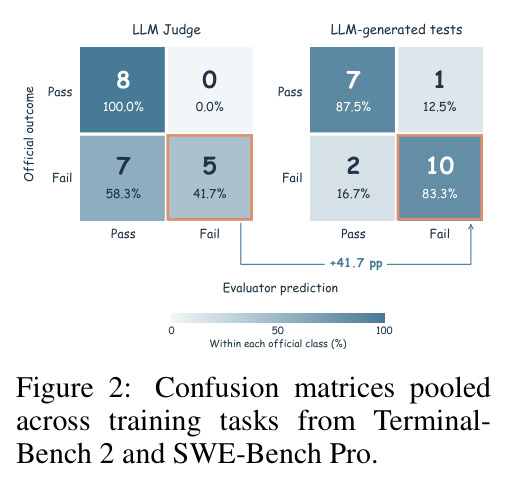
本文发现 LLM judge 判失败的召回率仅 41.7%,会放走过劣候选;改用固定 LLM 生成测试后失败召回率升到 83.3%。这一评估方式差异是方法成立的前提,也是相对 RHO 的关键改进。
研究动机
近期的 harness 递归自我改进方法(如 AHE、HarnessFix、RHO)通过分析历史执行轨迹来诊断问题并修改 harness,确实能提升任务成功率,但它们普遍以更充分的探索和更强的验证来换取性能,代价是 token 消耗和延迟的显著上涨。论文给出了具体数据:在 SWE-Bench Pro 上使用 GPT-5.5 与 Codex,RHO 把平均每任务成本从 Vanilla 的 $1.88 推高到 $2.68,涨幅 42.6%,通过率从 59.0% 提到 80.0%;延迟也从 337 秒涨到 437 秒。在实际部署中,执行成本和延迟与准确率同样重要,这种「只升不降」的权衡对企业用户并不友好。更深层的困难在于:harness 由指令、工具、技能、hooks、验证规则等组件构成,构成一个无法用梯度优化的巨大离散搜索空间;而且更多的推理、探索、验证不一定带来性能提升,盲目削减又会伤及成功率——如何区分「必要计算」与「可避免开销」是核心矛盾。
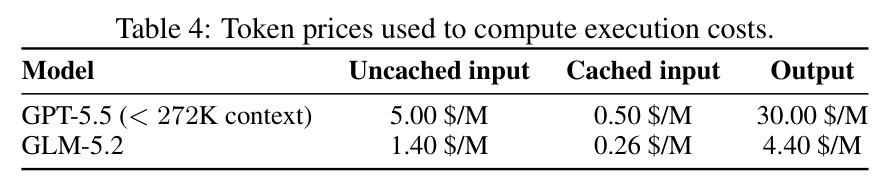
本文的目标是本文要回答的问题是:递归 harness 自我改进能否做到「更好的性能」与「更低的执行成本」同时成立?具体目标可以形式化为双目标优化问题 $\min_{h \in \mathcal{H}} (-PR(h), C(h))$,约束为 $PR(h) \ge PR(h_0)$($h_0$ 是初始 harness)。作者追求的不是单一最优点,而是推进性能-成本帕累托前沿,并输出三个代表工作点:面向成本的 lite、平衡的 medium、面向性能的 heavy,以适配不同预算的部署场景。整个过程必须在无标签设定下完成——进化期间拿不到标准答案、官方测试或评分器反馈,也不能访问验证集和测试集结果,以防基准泄漏。此外,成本按未缓存输入、缓存输入、输出 token 的不同单价(如 GPT-5.5 为 $5.00/$0.50/$30.00 每百万 token)精确核算,而非粗糙地数 token 总量。
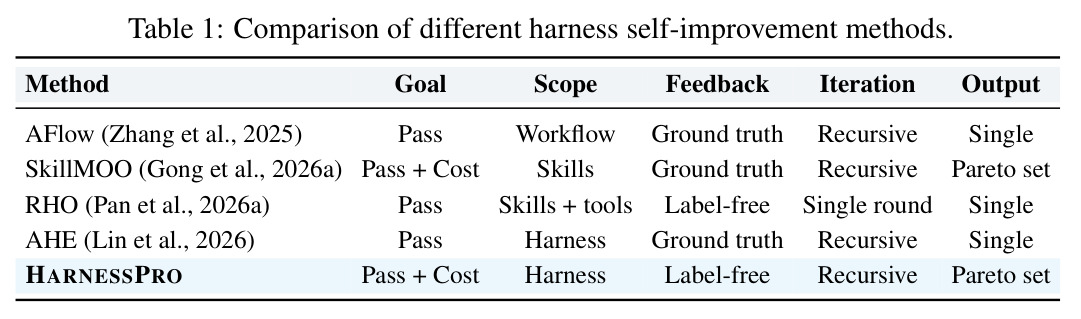
与已有工作不同的是,本文的独特切入角度有三点。第一,与只优化成功率的 RHO(用 LLM 自我偏好直接比较轨迹来选择候选)不同,HarnessPro 把成本作为一等公民纳入诊断、规划和选择的全流程,这是第一个在「整个 harness 层面」做无标签、递归、双目标优化的工作(见表 1:SkillMOO 只优化 skills 且需 ground truth,AHE 优化 harness 但需 ground truth 且只输出单一结果,RHO 只做单轮)。第二,在候选评估上用「LLM 生成固定测试」替代「LLM 直接判断」,用可复现的客观信号而非模型主观意见来判定任务成败,解决了 judge 过于乐观的问题。第三,输出形式从单一 harness 变为帕累托前沿上的 harness 序列(lite/medium/heavy),用户可按预算选择,这在此前的 harness 优化工作中没有先例。
核心方法
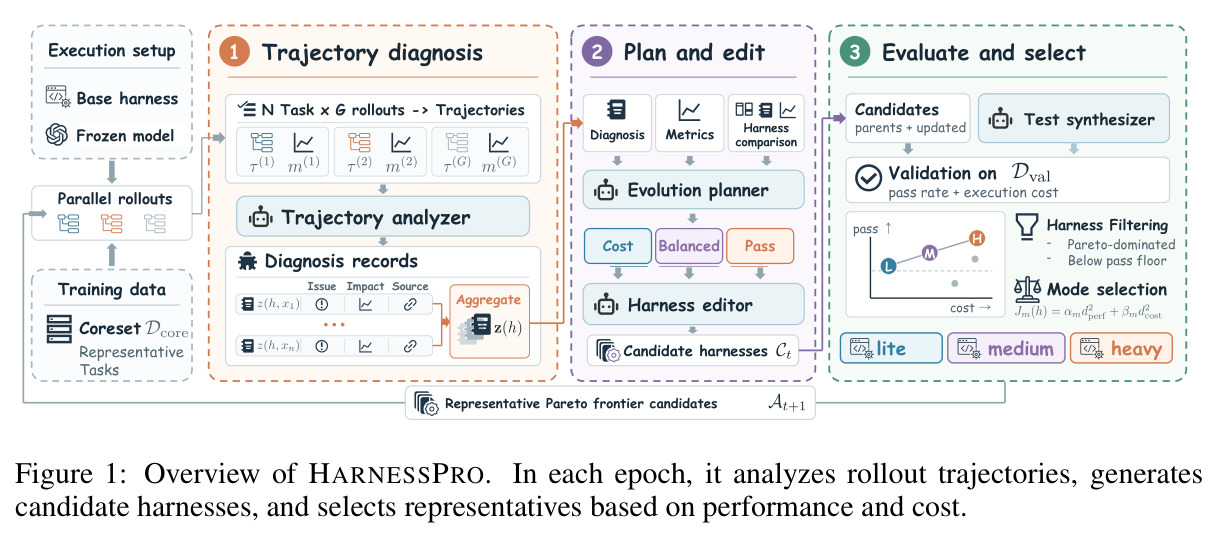
直觉上,HarnessPro 把「进化 harness」当成一个多智能体软件工程流水线:先找执行轨迹里「哪里失败了、哪里在白花钱」,再按不同性能-成本优先级写改进方案,落地成可执行的候选 harness,最后用固定测试赛马淘汰,留下帕累托前沿上的三个代表。技术路线上,每个 epoch 分三个阶段。阶段一(轨迹诊断):对候选集 $\mathcal{A}_t$ 中每个 harness,在 DPP 选出的 10 个训练任务上各跑 $G=3$ 次独立 rollout,轨迹分析智能体联合检查 $G$ 条轨迹及其指标向量 $m^{t,g}_h(x) = (\text{Pass}, c, \ell)$,输出问题清单、对性能和成本的影响、以及带文件路径和事件区间的证据(诊断超 64K token 会先做摘要)。阶段二(规划与编辑):进化规划器基于三套指令 $I_1$(降成本)、$I_2$(平衡)、$I_3$(重性能)为每个候选生成三份改进计划,并通过代码差异 $\text{Diff}(h_i^t, h_k^t)$ 对比其他候选以借鉴有效机制;harness 编辑器在各独立 workspace 中把计划实现为可执行 harness 并提交 Git 以便追溯。阶段三(评估与选择):在验证集上用固定的生成测试评估所有候选,先按公式 (7) 过滤掉低于通过率地板 $PR_{val}(h_0)$ 或被帕累托支配者,再用公式 (9) 选出 lite/medium/heavy 三个代表进入下一 epoch,直到达到 epoch 上限(TB2/SWE 3 轮、ProgramBench 4 轮)后在测试集上一次性评估。
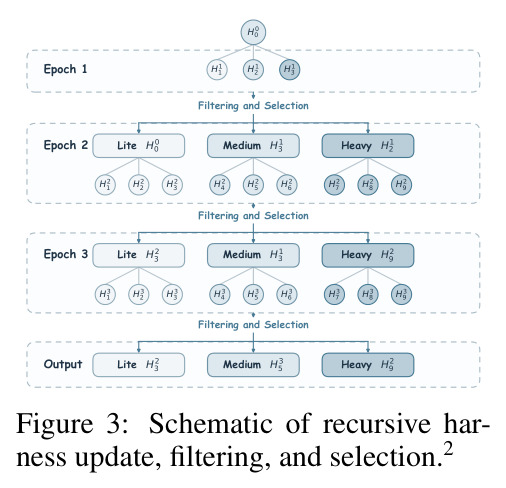
核心创新有两个。其一是「成本感知的多优先级进化」:不是给优化器加一个成本惩罚项,而是让三个并行计划各自代表一种权衡哲学——$I_1$ 只在保住正确性的前提下削减冗余探索、重复上下文和低价值验证;$I_2$ 把正确性与效率视为联合目标;$I_3$ 优先消除导致失败的 consequential failure 而非均匀加算力。加上父代共 $|\mathcal{A}_t| \times 3 + |\mathcal{A}_t|$ 个候选一起赛马,帕累托过滤天然防止「用质量换省钱」的候选存活。其二是对公式 (9) 的选择准则 $J_m(h) = \alpha_m d_{\text{perf}}(h)^2 + \beta_m d_{\text{cost}}(h)^2$,其中 $d_{\text{perf}}(h) = (P_{max} - PR_{val}(h))/(P_{max} - P_{min})$、$d_{\text{cost}}(h) = (C_{val}(h) - C_{min})/(C_{max} - C_{min})$ 是归一化偏差,三档权重 $(\alpha_m, \beta_m)$ 分别为 lite $(1,2)$、medium $(1,1)$、heavy $(2,1)$——平方距离的形式让选择对极端值敏感,且按当轮候选的实际极值归一化,避免性能和成本量纲不可比的问题。与 RHO 的本质区别在于:RHO 用 LLM 主观偏好单轮选出一个 harness,而 HarnessPro 用固定测试客观评估、递归多轮、并返回一族 harness。
方法步骤详情
完整流程见算法 1。第 1 步:对 $D_{train} \cup D_{val}$ 每个任务用初始 harness $h_0$ 收集轨迹。第 2 步:测试合成智能体对每个任务 $x$ 从任务描述 $x$ 和初始轨迹 $\tau_{h_0}(x)$ 生成测试 $S(x) = \text{TestSynth}(x, \tau_{h_0}(x))$(每次生成 10 个可执行用例,通过 MCP 工具在冻结容器中验证,禁止从初始产物反推期望值),测试全程固定以保证公平。第 3 步:在验证集上评估 $h_0$,把 $PR_{val}(h_0)$ 固定为性能地板。第 4-21 步循环 $T$ 个 epoch:Stage 1 对每个候选在训练集每任务跑 $G=3$ 次 rollout,分析器输出 $z(h,x)$ 并聚合成 $z(h)$;Stage 2 对每个候选 $h_i^t$ 和每个 $j \in \{1,2,3\}$ 并行生成计划 $p_j(h_i^t) = \text{Plan}(I_j, h_i^t, z(h_i^t), m(h_i^t), \{(\text{Diff}, z, m)\}_{k \neq i})$,编辑器实现为 $\tilde{e}_{i,j}^t$ 并提交 Git,形成 $C_t$,与父代合并为 $\tilde{C}_t = \mathcal{A}_t \cup C_t$;Stage 3 每个候选在验证集每任务跑一次,聚合 $m_{val}(h) = (PR_{val}, C_{val}, L_{val})$,先按公式 (7) 过滤(保留通过率不低于地板且不被帕累托支配者),再按公式 (9) 为每档模式选 $J_m$ 最小者作为 $h_m^{t+1}$,构成下一轮的 $\mathcal{A}_{t+1}$。第 22 步:返回 $(h_{lite}^T, h_{medium}^T, h_{heavy}^T)$,在进化完全结束后才于测试集 $D_{test}$ 上评估。
技术新颖性
技术新颖性体现在四个层面。第一,目标层面:把执行成本(按缓存/非缓存/输出 token 分档计价)和延迟作为与通过率并列的优化维度,并把输出从单点扩展为帕累托前沿上的三个档位,属于 harness 优化领域的首次(表 1 中仅有 SkillMOO 做过 skills 层面的 Pass+Cost 多目标,且依赖 ground truth)。第二,评估层面:用「冻结的 LLM 生成测试」替代 LLM judge,消融实验显示去掉测试合成器后通过率下降 3.4-10.0 个百分点,混淆矩阵实验证明失败召回率从 judge 的 41.7% 升至 83.3%,这是对「无标签评估」问题的一个务实解法。第三,机制层面:进化出的 harness 并非靠压缩上下文或单纯加大推理力度取胜,而是自发涌现出「任务自适应路由」(根据任务描述选择推理力度档位和工具调用预算)+「运行时预算 hooks」(在工具结果后附加提醒并最终阻断超预算调用,且附加方式保留提示词前缀以复用 KV 缓存)+「RTK 工具输出压缩」+「精简指令」的组合,消融证明单拿任何一个机制塞给 RHO 都会被 HarnessPro 的完整进化体帕累托支配。第四,工程层面:多候选代码差异对比、独立 workspace、Git 提交回溯等设计保证了进化过程的可追溯性。
实验结果
主实验覆盖 Terminal-Bench 2(59 个测试任务)、SWE-Bench Pro(100 个)、ProgramBench(100 个),主干模型为 GPT-5.5+Codex 0.147.0 和 GLM-5.2+Claude Code 2.1.231。第一组实验(表 2,GPT-5.5×Codex):heavy 模式在全部三个基准上取得最高通过率且成本低于 RHO——TB2 上 80.8%±1.0 对 RHO 的 76.3%(+4.5pp),成本 $0.72 对 $1.09(-33.9%),延迟 310 秒对 354 秒;SWE-Bench Pro 上 80.7%±0.6 对 80.0%,成本 $1.97 对 $2.68;ProgramBench 上 69.6%±1.03 对 68.8%,成本 $2.95 对 $3.59(-17.8%)。三基准平均下来,heavy 模式相对 RHO 通过率 +2.0pp、每任务成本 -26.1%。medium 模式用更少的钱保住接近的性能:SWE 上 79.0% 通过率(RHO 为 80.0%)但成本仅 $1.26,比 RHO 的 $2.68 低 53.0%;TB2 上与 RHO+Iteration 持平的 76.3% 但成本低 31.7%。lite 模式在三个基准上全部跑赢 Vanilla(TB2 72.9% 对 69.5%,SWE 72.3% 对 59.0%,Prog 64.3% 对 60.3%)且花费少 17.7%-57.4%。第二组实验(GLM-5.2×Claude Code)模式一致:heavy 在三个基准上全部超过 RHO 且更便宜(TB2 81.4% 对 78.0%,成本 $0.62 对 $1.00;SWE 77.3% 对 75.0%,成本 $1.01 对 $2.17;Prog 64.4% 对 63.3%,成本 $14.95 对 $17.00),且 SWE 上延迟从 RHO 的 520 秒降到 412 秒——成本优化顺带带来了速度提升。第三组实验(图 4,进化动态):TB2 上 heavy 通过率从 epoch 1 的 74.6% 升至 epoch 3 的 80.8%,成本从 $0.91 降至 $0.72;SWE 上 medium 第 2 轮通过率 70.0%→77.0% 但成本 $1.57→$1.66,直到第 3 轮才双指标同改善(79.0%、$1.26),说明多轮递归进化优于单轮。第四组实验(表 3,消融):去掉规划器,SWE medium 通过率 79.0%→73.0% 且成本 $1.26→$1.42;去掉测试合成器影响更大,三档模式在两个基准上通过率下降 3.4-10.0pp。第五组实验(表 3 下半):给 RHO 单独加动态路由(SWE 76.0%、$2.13)或预算 hooks(75.0%、$1.75)都能省钱但掉性能,统一用低推理力度更是把 TB2 打到 62.7%,三者全部被 HarnessPro 帕累托支配——说明增益来自多机制协同而非单点技巧。
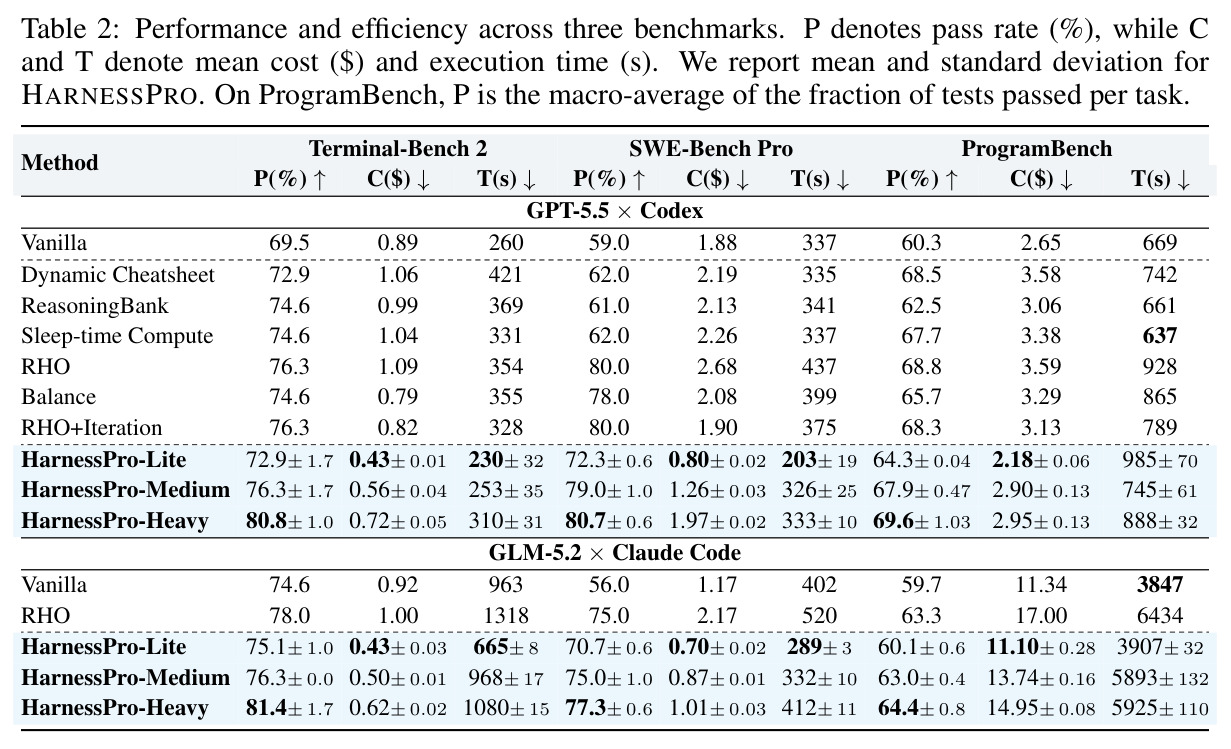
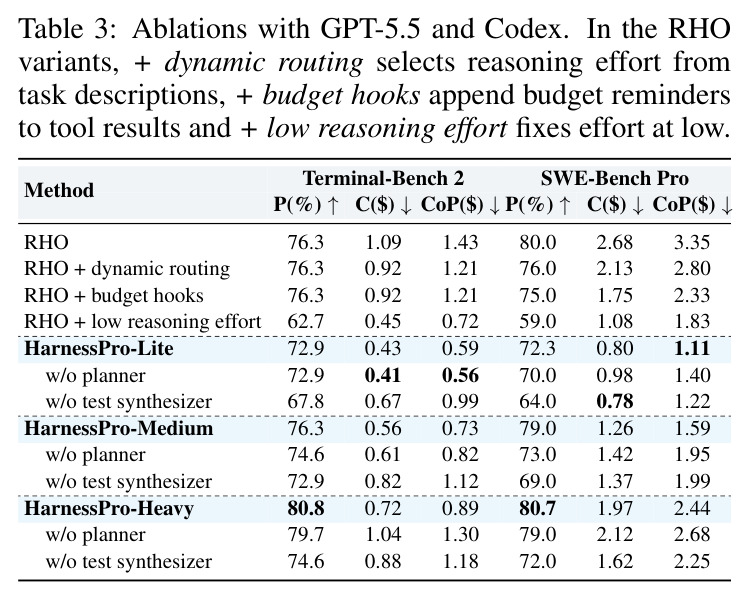
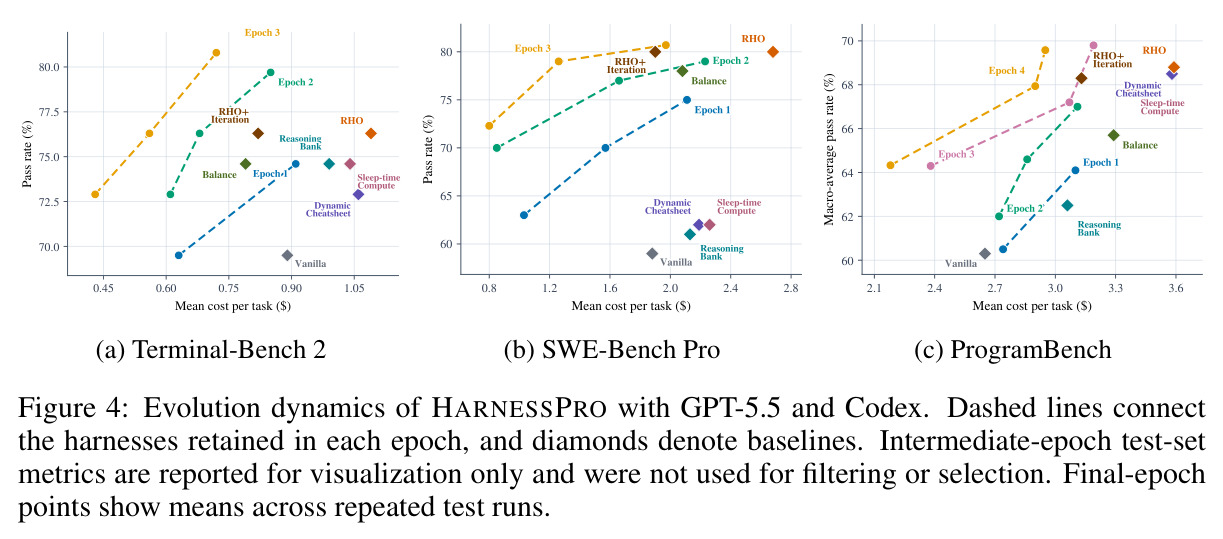
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 2(终端环境任务,GPT-5.5×Codex) | 通过率 PR / 每任务平均成本 C / 延迟 T | HarnessPro-Heavy:80.8%±1.0,$0.72±0.05,310±31s | RHO:76.3%,$1.09,354s(Vanilla:69.5%,$0.89,260s) | 通过率 +4.5pp,成本 -33.9%,延迟 -12.4% |
| SWE-Bench Pro(仓库级 issue 解决,GPT-5.5×Codex) | 通过率 PR / 每任务平均成本 C / 延迟 T | HarnessPro-Heavy:80.7%±0.6,$1.97±0.02,333±10s;Medium:79.0%,$1.26 | RHO:80.0%,$2.68,437s(Vanilla:59.0%,$1.88,337s) | Heavy 通过率 +0.7pp、成本 -26.5%;Medium 成本 -53.0% 仅让 1.0pp |
| ProgramBench(程序重建,GPT-5.5×Codex,宏平均用例通过率) | 通过率 PR / 每任务平均成本 C / 延迟 T | HarnessPro-Heavy:69.6%±1.03,$2.95±0.13,888±32s | RHO:68.8%,$3.59,928s(Vanilla:60.3%,$2.65,669s) | 通过率 +0.8pp,成本 -17.8%,延迟 -4.3% |
| 三基准平均(GPT-5.5×Codex) | 通过率增益 / 每任务成本降幅 | HarnessPro-Heavy 平均通过率 +2.0pp,平均成本 -26.1% | RHO(label-free 递归 harness 进化,仅优化通过率) | 双指标同时改善,推进帕累托前沿 |
| 三基准(GLM-5.2×Claude Code) | 通过率 PR / 成本 C | Heavy:TB2 81.4%/$0.62,SWE 77.3%/$1.01,Prog 64.4%/$14.95 | RHO:TB2 78.0%/$1.00,SWE 75.0%/$2.17,Prog 63.3%/$17.00 | 三基准全部通过率更高且成本更低(成本降 26.9%-53.5%),验证跨模型泛化 |
| 候选评估方式对比(TB2+SWE 训练任务混合) | 失败召回率(能否识别真正失败的任务) | LLM 生成固定测试:83.3% | LLM judge 直接判断轨迹:41.7% | +41.7pp,judge 会把 58.3% 的真实失败误判为通过 |
局限与改进
作者承认的局限:其一,延迟受服务器负载和网络波动影响,只作为辅助指标而非优化目标,因此 ProgramBench 上 lite 模式延迟(985s)反而高于 Vanilla(669s);其二,过滤与选择可能保留少于三个不同的 harness(脚注 2),即三档模式在某些轮次可能重叠;其三,图 4 中的中间 epoch 测试集指标仅用于可视化,筛选只用验证集,但验证集与测试集同分布的假设未被讨论。我自己的观察:第一,训练集只有 DPP 选出的 10 个任务,进化方向高度依赖 coreset 代表性,对任务分布偏移的鲁棒性存疑;第二,每次 rollout 和候选评估本身就是一笔不小的开销(每个候选每 epoch 要在训练集跑 3 次、验证集跑 1 次),论文没有报告「进化过程本身花了多少钱」,只优化了进化产物的推理成本,总拥有成本是否划算取决于部署规模;第三,成本计算依赖特定 token 单价(表 4),不同供应商的缓存折扣策略不同,结论的性价比排序可能随价格变动;第四,进化出的 profile 路由 rubric(如 five-profile 门控规则)相当复杂且针对基准任务风格调优,迁移到全新任务域的效果未验证;第五,ProgramBench 上 GLM-5.2 的成本高达 $11-17,说明方法对强依赖长上下文的场景节省有限。
独立分析的弱点
弱点一:coreset 规模过小且固定。全程只用 10 个训练任务,DPP 虽保证难度和多样性,但诊断信号方差大,一次倒霉的选择可能把进化引向局部方向;改进方向是按 epoch 动态扩充 coreset,或用上一轮各 harness 的失败分布重新加权选择。弱点二:进化开销不透明。每 epoch 需要对每个候选做 $3 \times 10$ 次训练 rollout 加验证集评估,候选数最多 $3 \times 3 + 3 = 12$ 个,token 花费可能超过后续部署节省,论文未给出进化成本账;改进方向是报告 evolution budget 并探索采样更少 rollout 的 early-stopping 策略。弱点三:LLM 生成测试的可靠性上限。83.3% 的失败召回率意味着仍有约六分之一的劣候选可能蒙混过关,且测试从初始轨迹合成,可能继承初始 harness 的理解偏差(如把 mock 实现当正确行为);改进方向是引入多合成器投票、或对争议任务补充 metamorphic 测试。弱点四:三档模式的划分是静态权重 $(1,2)/(1,1)/(2,1)$,属于手工设定,未探索权重自动搜索或输出连续可调的 knob;改进方向是把模式选择本身参数化,让用户给定预算约束后直接求解约束优化。弱点五:hooks 的「工具调用数硬上限」对需要超长探索的任务(如 ProgramBench 的 2000 轮限制场景)可能截断必要工作,lite 模式在 ProgramBench 的延迟反升说明该风险真实存在。
未来方向
作者方向:论文结论指出「成本感知进化」是实用化 RSI 的有前景方向,隐含的延伸是把延迟也纳入目标函数(三目标帕累托),以及验证进化机制在更多 harness 形态(记忆、技能、多智能体编排)上的普适性。基于成果可延伸的方向:第一,跨域迁移研究——把在编码类基准上进化的 harness 直接用于数据分析、运维等新域,量化 profile 路由 rubric 的泛化边界;第二,在线进化——目前是离线进化后冻结部署,可以设想部署期间持续收集轨迹、按漂移检测触发再进化,形成闭环;第三,进化产物作为课程——研究 lite 模式的路由决策能否蒸馏成轻量分类器,省掉每次任务前的路由调用开销(medium 路由本身是一次 GPT-5.5 medium-effort 调用);第四,与模型训练结合——把进化发现的「必要计算 vs 可避免开销」边界用作 RL 训练的成本感知奖励信号,让模型内化预算意识而非依赖外部 hooks;第五,理论化帕累托选择——当前平方距离准则权重是启发式的,可以研究基于验证集不确定性的自适应权重或贝叶斯多目标优化。第五,测试合成的置信度校准——为生成测试估计可靠度,对低置信测试加权或弃用,进一步提升无标签评估的可信度。
复现评估
论文声明代码已在链接开源(摘要附 GitHub 链接),附录提供了较高的实现透明度:算法 1 的完整伪代码、三套进化指令全文(附录 B)、测试合成器的指令/技能/MCP 验证工具接口(附录 C.3)、进化出的 medium 配置全文及 lite/heavy 的 diff(附录 D,含 profile rubric、hook.py、policy.json)。数据方面,三个基准均为公开基准,数据划分遵循 RHO 协议(59/100/100 个测试任务),DPP 超参($\epsilon=0.1$、$\theta=0.7$、$k=10$)明确给出。成本复现依赖表 4 的公开 API 定价(GPT-5.5:$5.00/$0.50/$30.00 每百万 token;GLM-5.2:$1.40/$0.26/$4.40),但价格会变动,绝对成本数字需按当前牌价折算。算力门槛:单进程 API 调用,无训练,主要成本是进化期的大量 rollout(每候选每 epoch 训练集 3 次+验证集 1 次,最多约 12 个候选、3-4 个 epoch),估计需要数百至上千次模型调用;结果报告了 TB2/SWE 三次运行、Prog 两次运行的标准差,方差不大(多数 ≤1.7pp)。难点在于环境搭建:需要复现 Codex 0.147.0 和 Claude Code 2.1.231 的特定行为,模型版本迭代后结论可能漂移;总体属于中等偏高的复现难度,开源加附录细节大大降低了门槛。
论文图表