如何循环MoE:摊平专家,解绑注意力 How to Loop MoE: Flatten the Experts, Untie the Attention
Foil在参数与计算不变下摊平专家层、解绑循环注意力,让循环MoE损失更低、路由更健康
前置知识
循环Transformer(Looped Transformer)
把同一个Transformer块(注意力+FFN)反复作用于不断演化的隐状态:第 $\ell$ 轮的输入是第 $\ell-1$ 轮的输出,网络的有效深度由循环次数 $L$ 而非存储层数决定。代表工作有Universal Transformer和Huginn,理论证明其适合需要多步迭代求解的任务,实践中用额外计算换取固定参数量的更充分利用,呼应了算力增长远快于显存容量与带宽的'内存墙'趋势。
本文全部设计都发生在循环块内部,理解'一轮循环=对同一组参数的一次访问'是理解摊平与解绑这两个操作的前提。
稀疏混合专家(Sparse MoE)
每层存放 $E$ 个专家(通常是SwiGLU FFN),每个token经路由器打分只激活 $k$ 个(本文 $k=2$),按重归一化权重组合后加回残差流。参数量远大于每token计算量,是当前大模型扩容的主流路线(DeepSeek-V3、Kimi K2等),代价是单个专家收到的训练流量变少,专家是否被真正使用、是否形成分工自Switch Transformer以来就是核心疑问。
Foil的预算约束(专家参数、每token专家调用次数固定)都是MoE特有的记账方式,不懂稀疏激活就无法理解'摊平为何不增加成本'。
Top-k路由与负载均衡
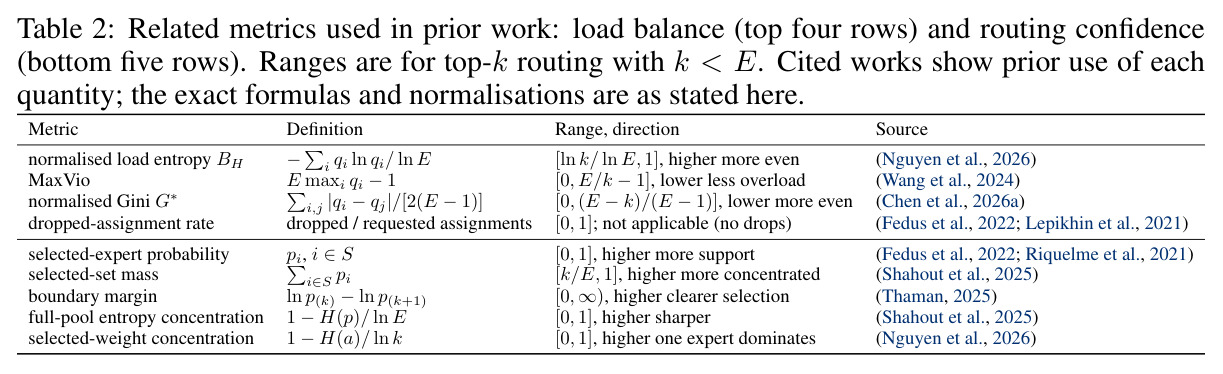
路由器对 $E$ 个专家做softmax打分取概率最高的 $k$ 个。top-k天然造成热门专家过载,实践中用辅助均衡损失(Switch Transformer形式)和z-loss稳定训练。均衡度常用 $B_2 = \frac{1/E}{\sum_i q_i^2}$(即Jain公平指数)衡量,$q_i$ 为专家 $i$ 收到的请求份额,取1表示完全均匀、下限 $k/E$ 表示所有流量集中在固定的 $k$ 个专家。
论文用 $B_2$ 加自创的MMR置信度和流量匹配掩码测试联合判断路由健康,并论证'均衡不等于健康',这是理解其消融结论的关键。
形状参数 $(E, D, L)$ 与等效专家数
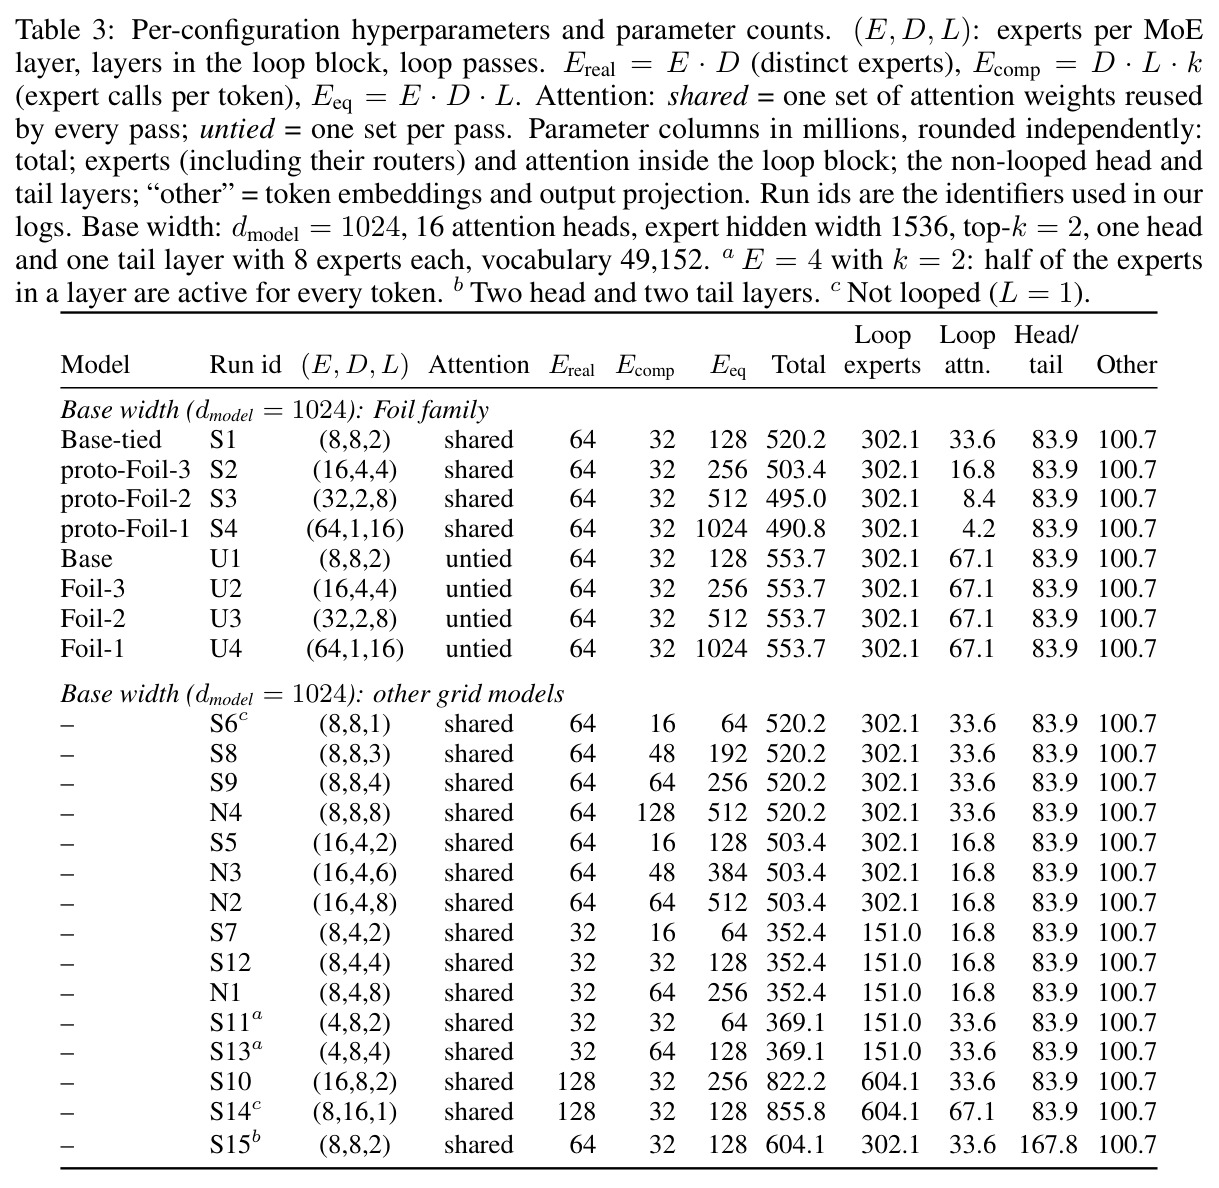
$E$ 为循环块每层专家数,$D$ 为块内物理层数,$L$ 为循环次数。四个恒等式刻画预算:真实专家数 $E_{\text{real}} = E \times D$,每token专家调用 $E_{\text{comp}} = k \times D \times L$,有效深度 $D_{\text{eff}} = D \times L$,等效专家数 $E_{\text{eq}} = E \times D \times L$(把循环展开后的等效非循环MoE规模)。摊平映射 $(E,D,L) \to (2E, D/2, 2L)$ 保持前三个不变而让 $E_{\text{eq}}$ 翻倍。
这是全文的'会计恒等式',所有实验对比都在这些量严格固定的前提下进行,是读懂实验设计的钥匙。
Chinchilla训练配比
Hoffmann等人2022年得出的结论:在给定计算预算下,模型参数量与训练token量应按约1:20的比例配置才能达到计算最优。本文八个小模型每个参数训练35–40个token,处于Chinchilla配比附近,从而保证不同形状的模型在'训练充分度'上可比,损失差异可以归因于架构而非训练量。
评估'参数固定、只改布局'的对照实验必须先排除欠训练或过训练的干扰。
研究动机
现有两条效率路线各有瓶颈。循环Transformer把同一块层反复作用于不断演化的隐状态,用计算换存储参数,但其循环核心是稠密的,参数复用率高却没有专家分工;稀疏MoE则相反,每层存放大量专家、每个token只路由到 $k$ 个(本文 $k=2$),参数量远超每token计算量,代价是一个token在每层只能看到极少数专家——专家越多,单个专家被用得越少。自Switch Transformer以来,专家是否被真正使用、是否形成分工一直是核心问题,而传统上唯一被监控的负载均衡指标回答不了它:均衡的负载可能掩盖一个对专家毫无偏好的'冷漠'路由器。此前已有工作把循环与MoE结合(如MoEUT、Loop-MoE),但都没有研究在专家参数和每token专家计算量同时固定的约束下,专家应如何在循环块内分布——每层放多少专家、块有几层、循环几次;也没有讨论'每一轮循环应该独享哪些参数'这一更细的设计维度。
本文的目标是本文要回答一个非常具体的设计问题:当专家参数量与每token专家计算量都固定时,稀疏MoE应该怎样被循环?作者把它拆成两个可操作的子问题:其一,循环块的形状 $(E, D, L)$(每层专家数、层数、循环次数)应如何选择——能否在不增加任何专家参数和专家调用次数的前提下,让每次路由决策面对更大的候选池;其二,循环各轮之间哪些参数应当共享、哪些应当独享——具体地,注意力是跨轮共享一套权重,还是给每一轮独立的注意力参数。为此作者提出Foil架构,在20B token预训练并延续训练到100B token的规模上验证:Foil是否优于未摊平的循环基线、损失是否随摊平程度单调下降、解绑注意力是否带来更健康的路由,最后把系统性消融的发现提炼成'稀疏循环MoE应使用更多每层专家与更多循环轮次'的设计准则。
与已有工作不同的是,独特之处在于把'循环MoE的内部布局'本身当作受控实验变量。此前把循环与专家结合的工作各自提出一种固定的共享方案:MoEUT把若干连续层组成重复组;ReXMoE、MoRE、Megrez2让相邻层共享专家池但保留每层独立注意力;稠密侧的One Wide FFN共享一个加宽的FFN但保留每层注意力。没有人在固定 $E_{\text{real}} = E \times D$(真实专家数)与 $E_{\text{comp}} = k \times D \times L$(每token专家调用数)的条件下系统比较 $(E,D,L)$ 的不同取法,更没人问'摊平后删掉的注意力参数去哪了'。Foil的切入点是同时动两处:摊平专家层让每次路由从更大的池子里选人;解绑注意力把摊平时本会丢失的注意力参数原样补回,且不增加任何计算。此外作者带来一套评估路由健康的组合拳($B_2$ 均衡度、MMR置信度、流量匹配的掩码测试),纠正了'只看负载均衡'的行业惯性。
核心方法
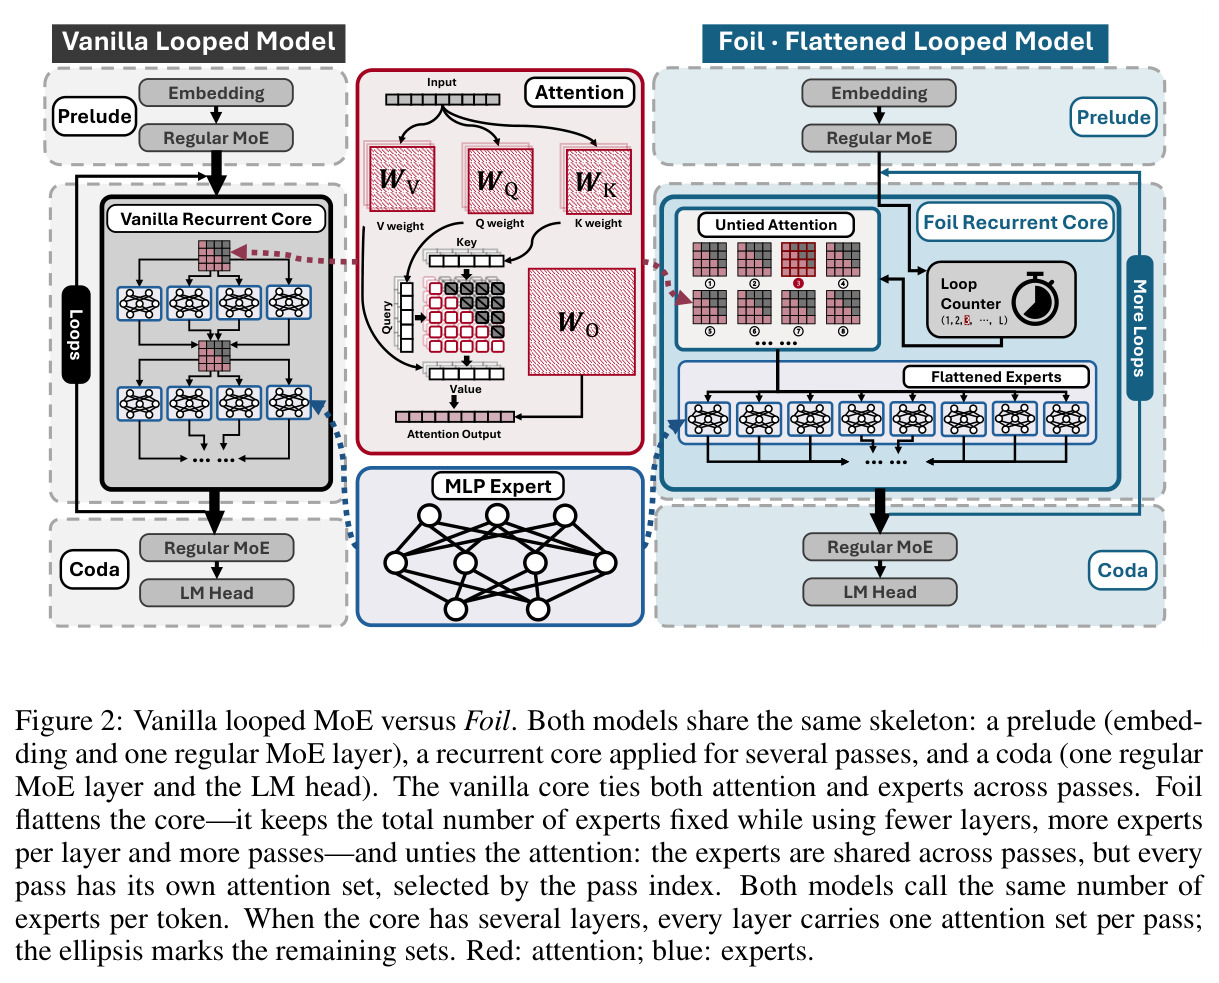
先说直觉:循环让同一个专家池被访问多次,一个token在8轮循环里可触达36个不同专家(不循环只有16个),所以'少放几层、每层多放些专家、多循环几轮'能在不增加专家参数和专家计算的前提下放大每次路由的选项。技术上,Foil建立在Huginn的循环骨架上:词嵌入 → 前奏层(1个普通MoE层,8专家)→ 循环核心($D$ 层循环块跑 $L$ 遍)→ 尾声层(1个普通MoE层)→ 输出头。摊平一步把 $(E, D, L)$ 映射为 $(2E, D/2, 2L)$:真实专家数 $E_{\text{real}} = E \times D$、每token专家调用 $E_{\text{comp}} = k \times D \times L$、有效深度 $D_{\text{eff}} = D \times L$ 全部不变,而每次路由的池 $E$ 和等效专家数 $E_{\text{eq}} = E \times D \times L$ 翻倍。从基线 $(8,8,2)$ 出发三步摊平得到 Foil-3 $(16,4,4)$、Foil-2 $(32,2,8)$、Foil-1 $(64,1,16)$,$E_{\text{eq}}$ 从128升至1024。同时解绑注意力:专家和路由器跨轮共享,但每一轮拥有独立的注意力参数(共 $D \times L = 16$ 套),摊平后总参数保持553.7M不变;带共享注意力的摊平版本称为proto-Foil,仅作对照。
核心创新有两点,本质是把'参数存在哪'与'计算花在哪'解耦。第一,摊平专家:传统循环MoE固定形状后增加轮次只会重复访问小池子;Foil证明在 $E_{\text{real}}$ 和 $E_{\text{comp}}$ 都不变时,把层数减半、每层专家翻倍、轮次翻倍,形式上等效于一个 $E_{\text{eq}}$ 翻倍的非循环模型,形式路由数按 $\binom{E}{k}^{D \times L}$ 乘法增长,等于用现有计算免费扩大了每个token的专家视野。第二,解绑注意力:经典循环设计把整块跨轮共享,摊平时注意力参数随层数减少而丢失——从 $(8,8,2)$ 的8套锐减到 $(64,1,16)$ 的1套,总参数从553.7M掉到490.8M,实验显示tied模型的损失在第一步摊平后不降反升;Foil让每轮独享注意力、只共享专家与路由器,把丢失的参数原样补回(16套,占67.1M),且因注意力本来就要跑 $D \times L$ 次,解绑不增加任何计算。从函数类角度看,tied模型恰是untied模型令各轮注意力权重相等时的特例,tied的函数类严格包含于untied,这为性能优势提供了容量上的解释。
方法步骤详情
完整流程如下。数据与优化:所有模型基于SmolLM2分词器(词表49,152)在FineWeb-Edu sample-100BT子集(101.7B token)上训练,序列打包到4096上下文,所有模型按完全相同的数据顺序读取以支持逐步配对比较;AdamW($\beta_1=0.9$,$\beta_2=0.95$,权重衰减0.1,梯度裁剪1.0,bf16),全局批96序列即393,216 token/步;学习率走WSD调度,1000步线性预热到峰值 $3\times10^{-4}$,恒定阶段后最后10%按 $1-\sqrt{\cdot}$ 衰减到峰值的5%。前奏/尾声各8专家、仅跑一次;核心每层用线性路由器做温度1的softmax取top-2,权重重归一化后加权SwiGLU专家输出并加进残差流;Foil中第 $\ell$ 轮使用第 $\ell$ 套注意力($\boldsymbol{W}_Q, \boldsymbol{W}_K, \boldsymbol{W}_V, \boldsymbol{W}_O$)。辅助损失为Switch型负载均衡损失(系数0.01)与路由z-loss(系数0.001),报告的损失只含语言建模项。20B阶段跑50,000步(19.66B token),100B延续训练从45,000步检查点恢复优化器状态与数据顺序,延长到254,313步。诊断:在255,500个探针token上计算每token触达专家数 $U_t$、负载均衡 $B_2 = \frac{1/E}{\sum_i q_i^2}$ 和路由置信度 $\text{MMR} = \exp(\bar{z}_{(1)} - \bar{z}_{(E/2)})$(与中位排序专家的logit间隔),并做流量匹配的专家掩码测试。
技术新颖性
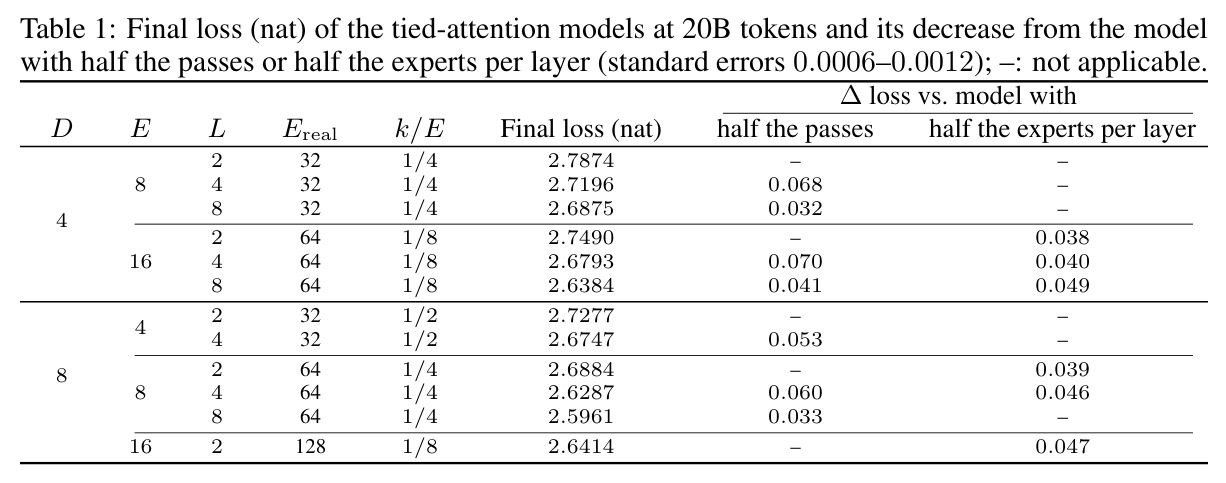
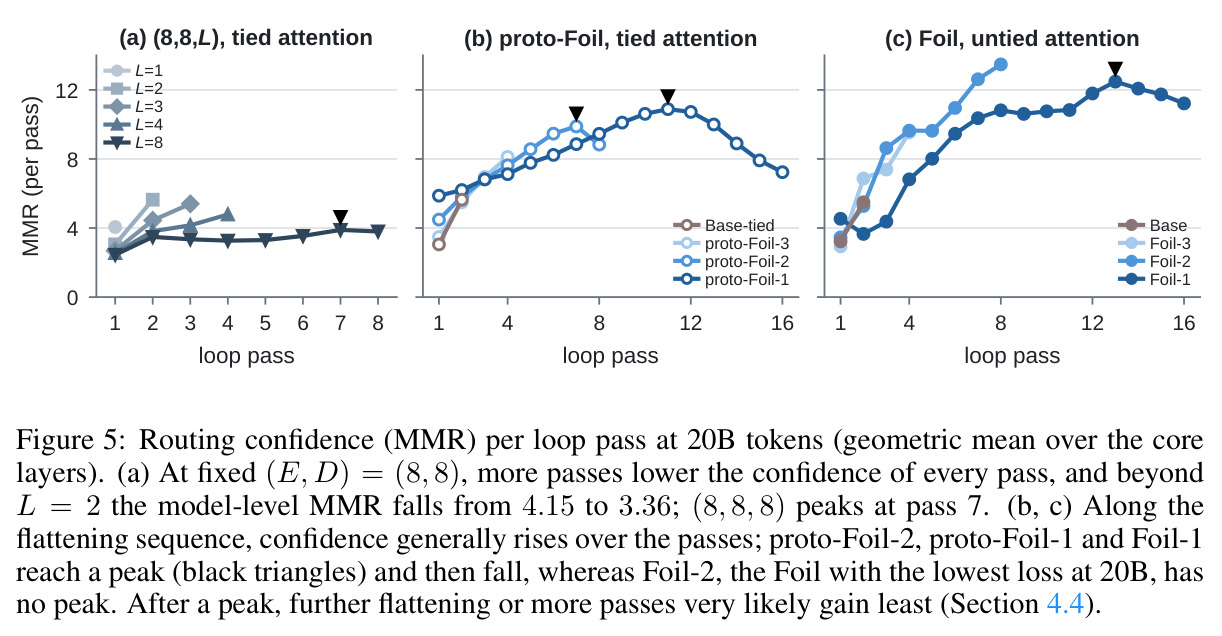
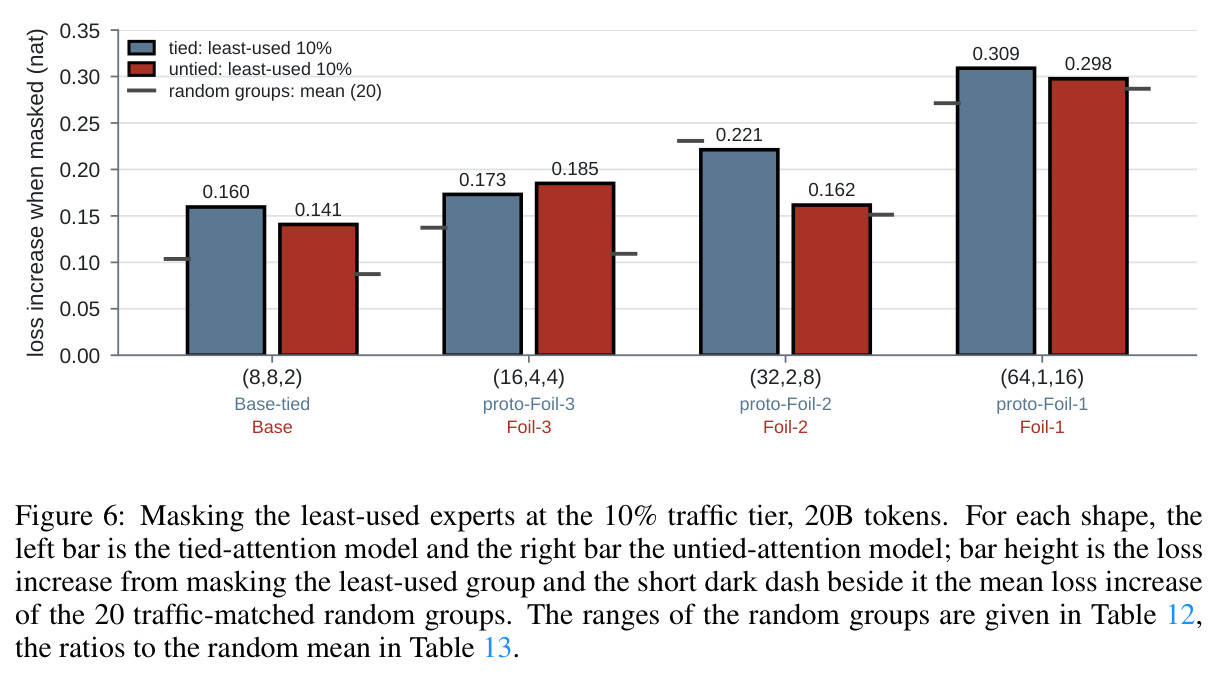
新颖性可从三个层面评价。问题层面:这是首个把循环MoE的'形状学' $(E,D,L)$ 当作受控变量、在严格固定的专家参数与计算预算下做系统扫描的研究——消融网格覆盖 $(8,4)$、$(4,8)$、$(16,4)$、$(8,8)$、$(16,8)$ 等配置、$L$ 从1到8,共35个模型;与MoEUT、ReXMoE、Megrez2等'各提一种共享方案'的做法不同,本文比较的是方案空间本身。机制层面:发现并量化了'加宽与循环互相放大'的交互效应——把 $(8,4,L)$ 加宽到 $(16,4,L)$ 的收益从 $L=2$ 时的0.038 nat增长到 $L=8$ 时的0.049 nat,三个2×2交互项两个显著为正(+0.0018、+0.0089、+0.0067)、无一为负。度量层面:提出以中位专家为参照的MMR置信度($\text{MMR} = \exp(z_{(1)} - z_{(E/2)})$,对任意池规模的完全无偏好路由器恒为1)和流量匹配掩码测试,证明'低流量专家并不低价值',并给出'MMR逐轮峰值预示循环收益枯竭'这一可操作的设计仪表。
实验结果
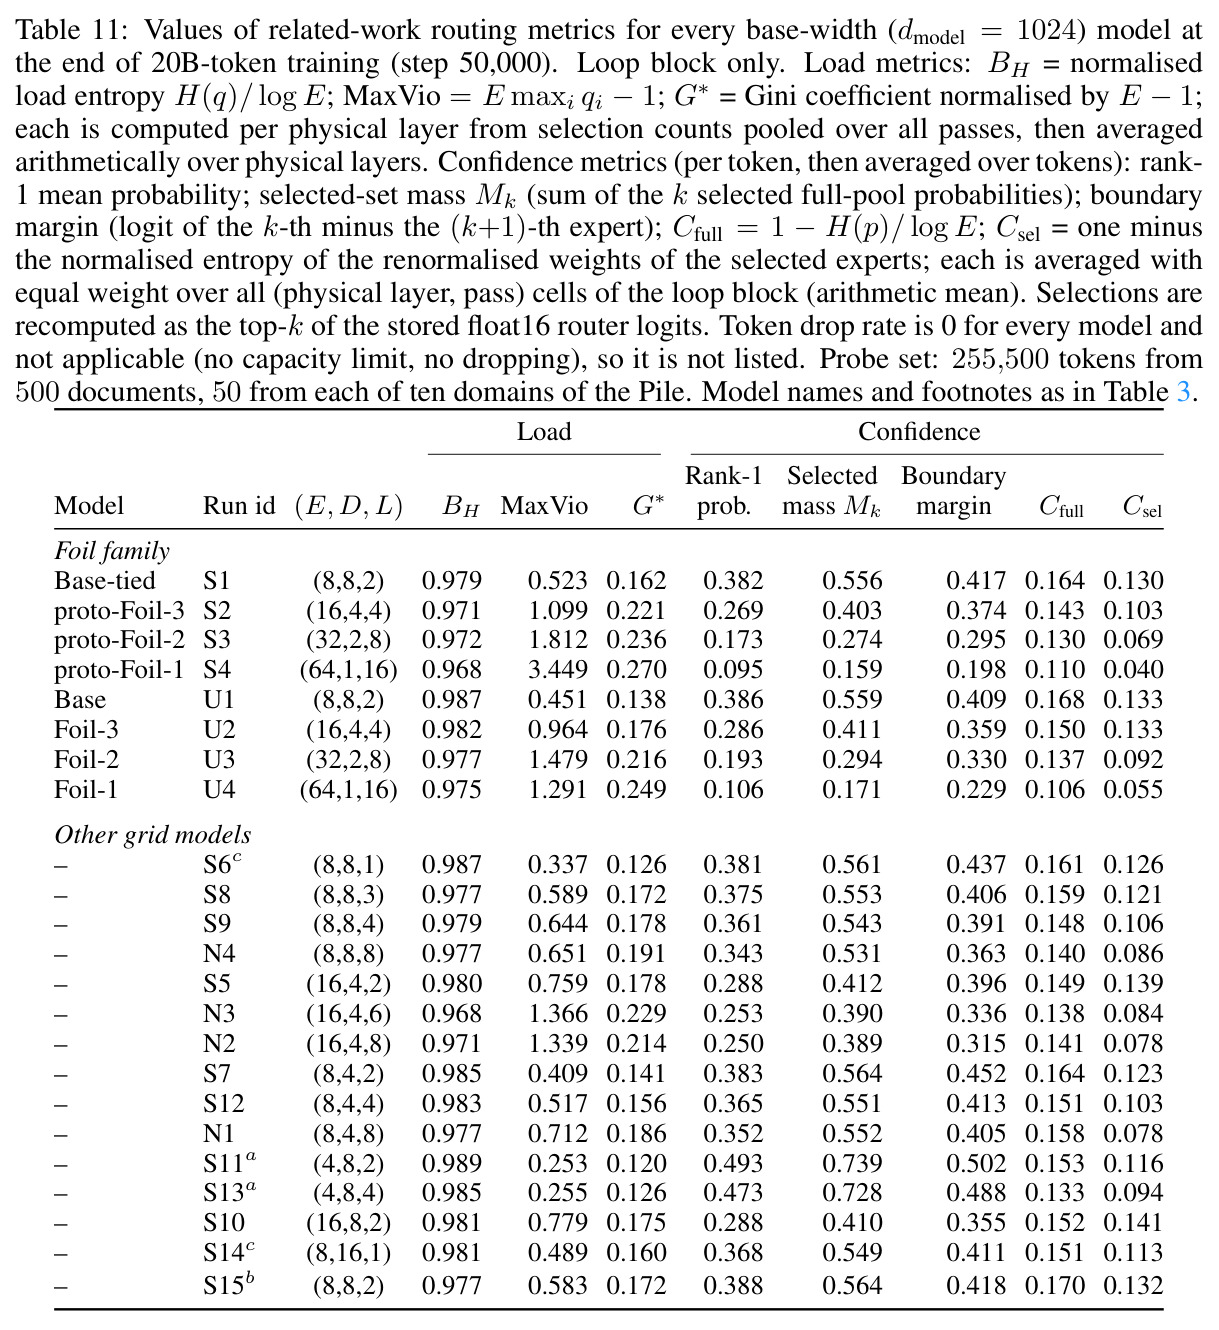
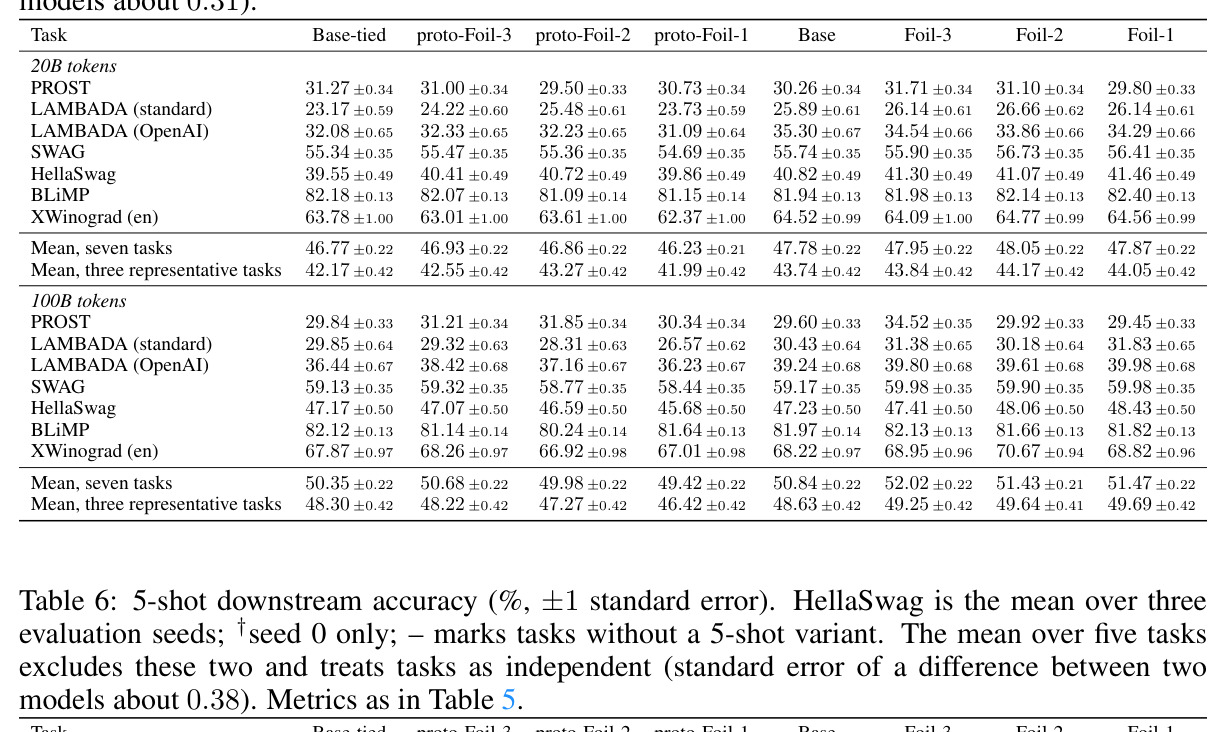
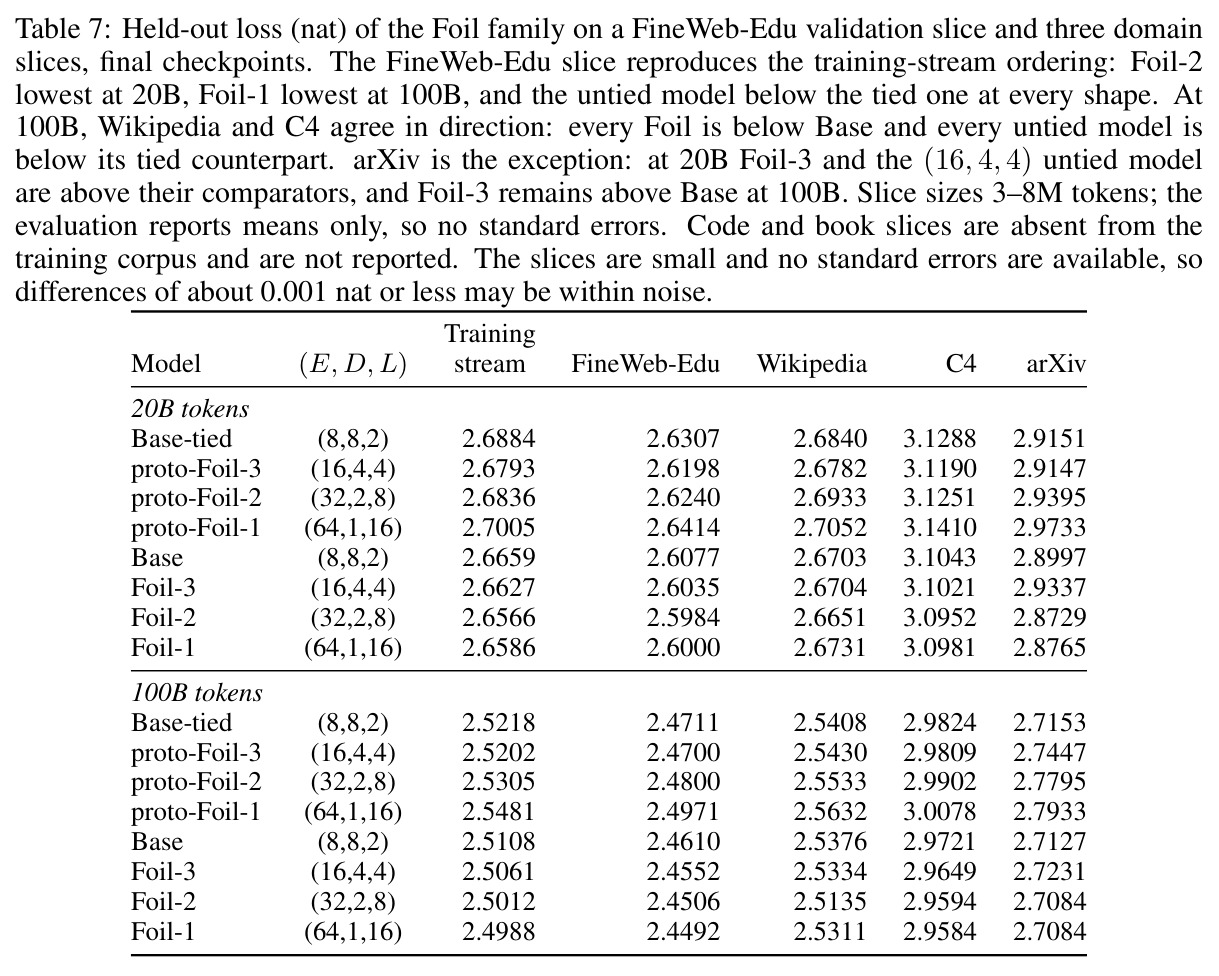
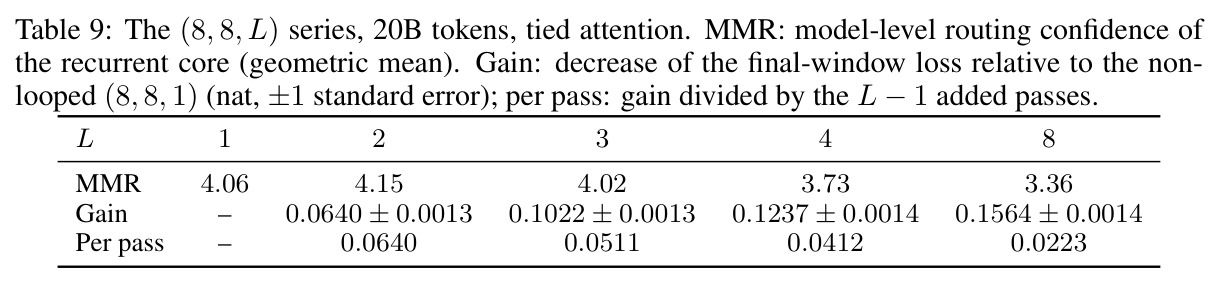
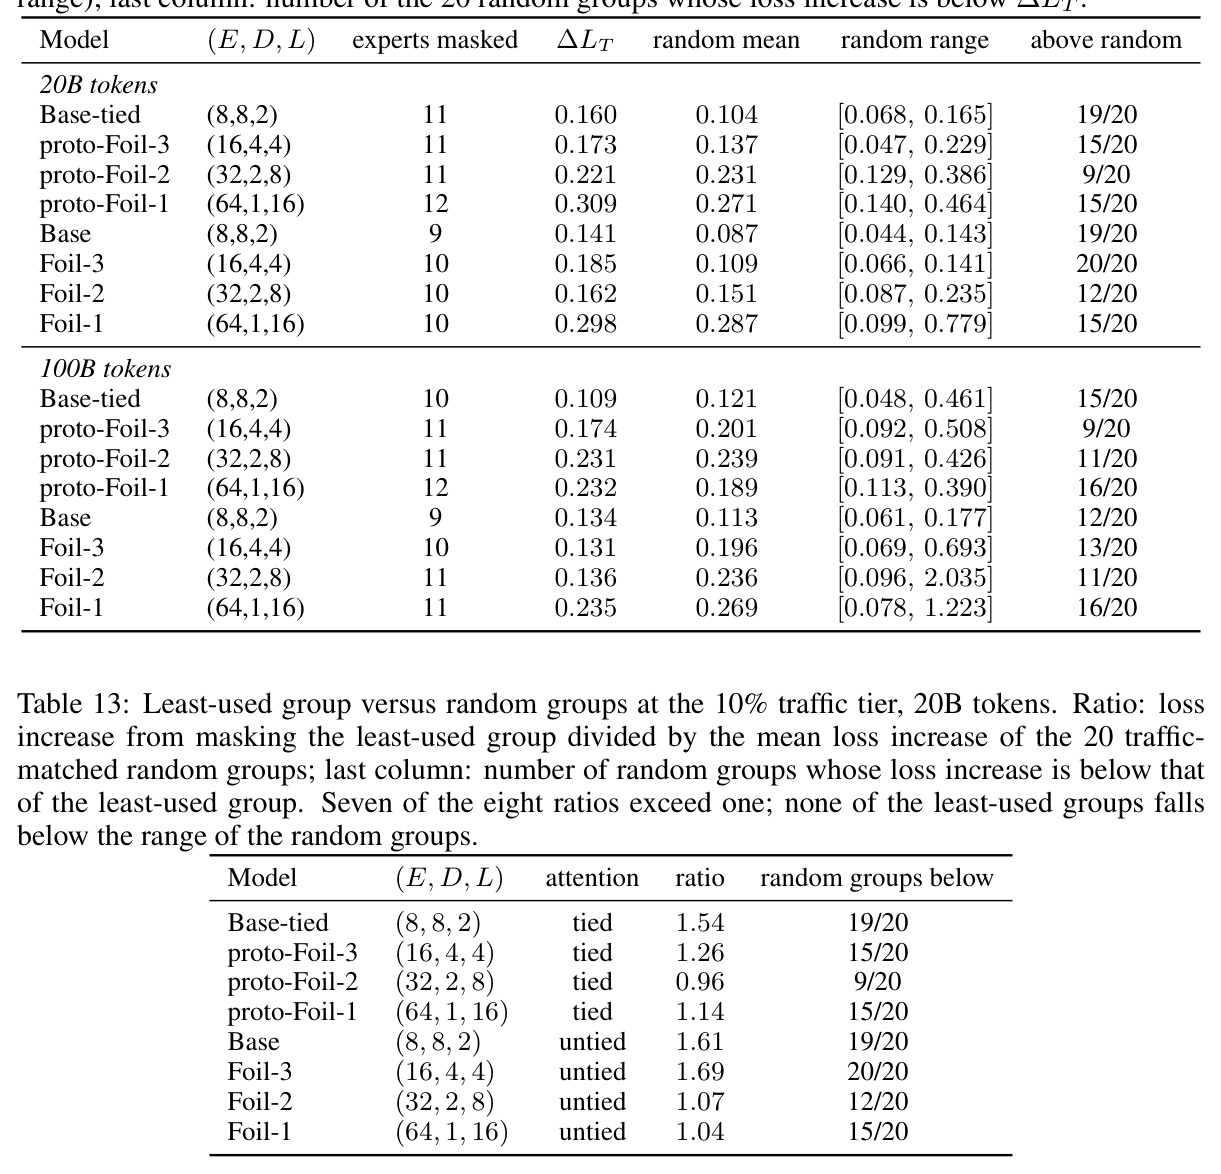
主实验分三块。其一,摊平的收益:20B token时三个Foil损失全部低于Base(Base 2.6659,Foil-3 2.6627,Foil-2 2.6566,Foil-1 2.6586 nat),Foil-2最优、比Base低约0.009 nat;延续训练到100B后损失随摊平程度单调下降:Base 2.5108 → Foil-3 2.5061 → Foil-2 2.5012 → Foil-1 2.4988 nat,最摊平的Foil-1低0.012 nat;下游七个零样本任务均值Foil-3最高(52.02 vs Base 50.84),三代表任务均值Foil-1最高(49.69 vs 48.63)。其二,解绑注意力的收益:同形状配对比较中untied全胜——20B时Foil-1比proto-Foil-1低0.042 nat,100B差距扩大到0.049 nat;tied一侧摊平第一步后损失回升(proto-Foil-1的2.700劣于Base-tied的2.688),下游三任务均值差距最大达3.3个百分点(49.69 vs 46.42)。其三,路由诊断:每个形状上untied的 $B_2$ 与MMR都更高(Base为0.947/4.21 vs tied的0.921/4.15);沿摊平序列 $B_2$ 从0.947降到0.805但损失反而更低,掩码实验表明最少用专家的损失代价在8个模型中7个高于流量匹配随机组(比值1.04–1.69)。消融确认加宽与循环互相放大:交互项+0.0018、+0.0089、+0.0067;MMR与每轮增益同向衰减($L$ 从2到8:MMR 4.15→3.36,每轮增益0.064→0.022 nat)。全部实验约1.26万H200 GPU时;种子重复实验差异 $-0.0003 \pm 0.0009$ nat,小于所有被解读的结论(均≥0.002 nat),说明结果稳健。
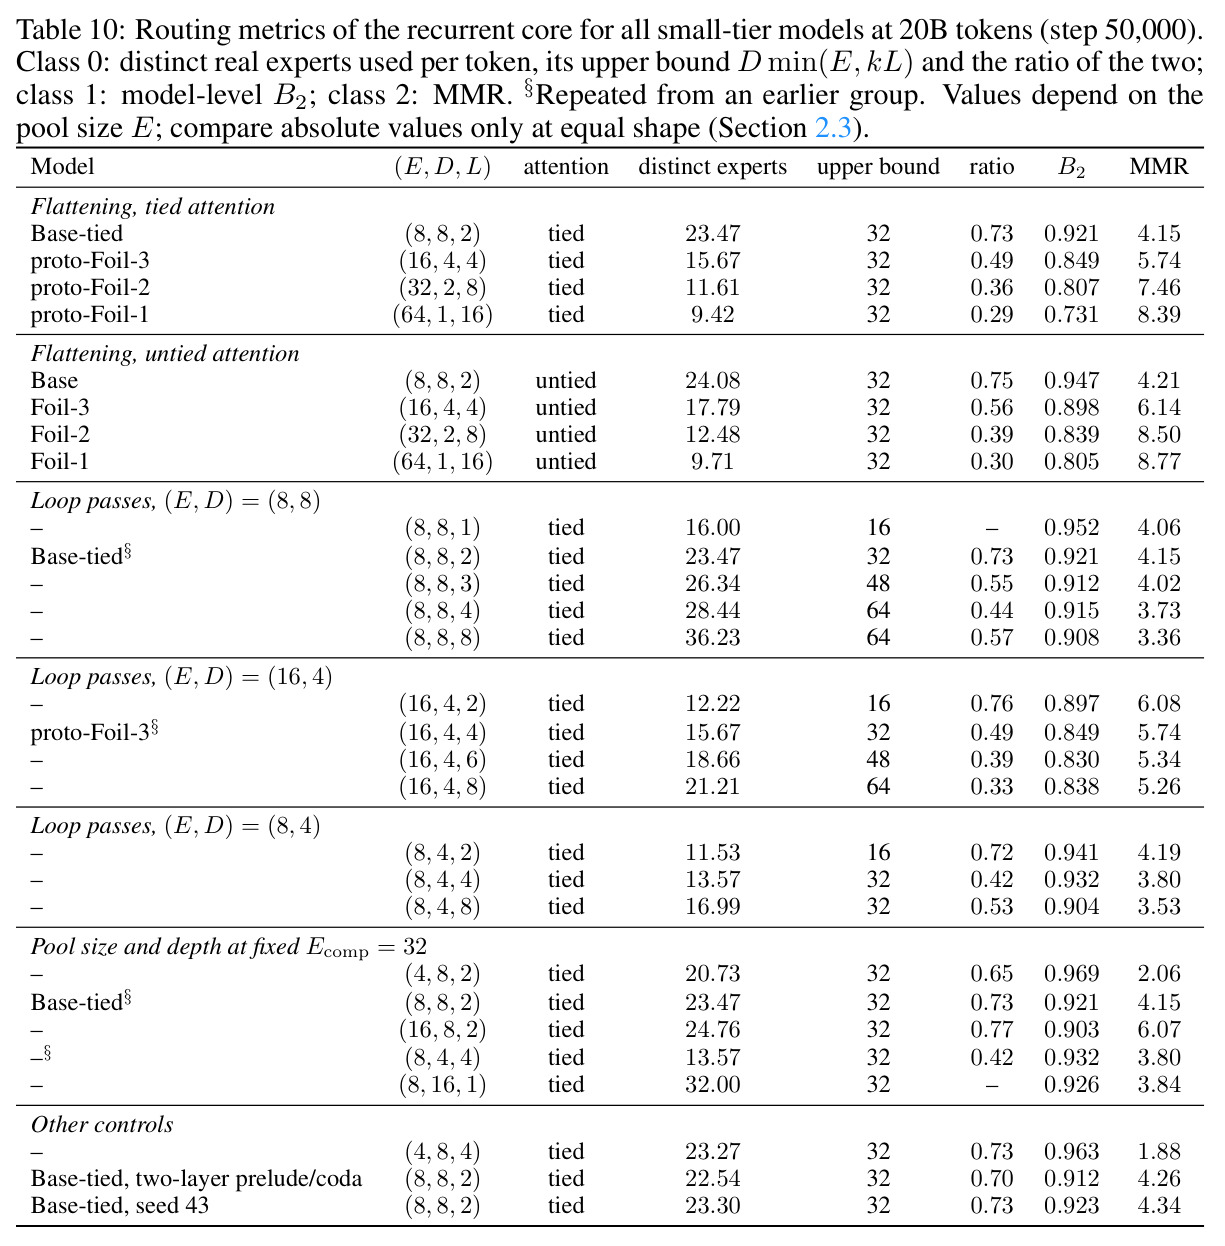
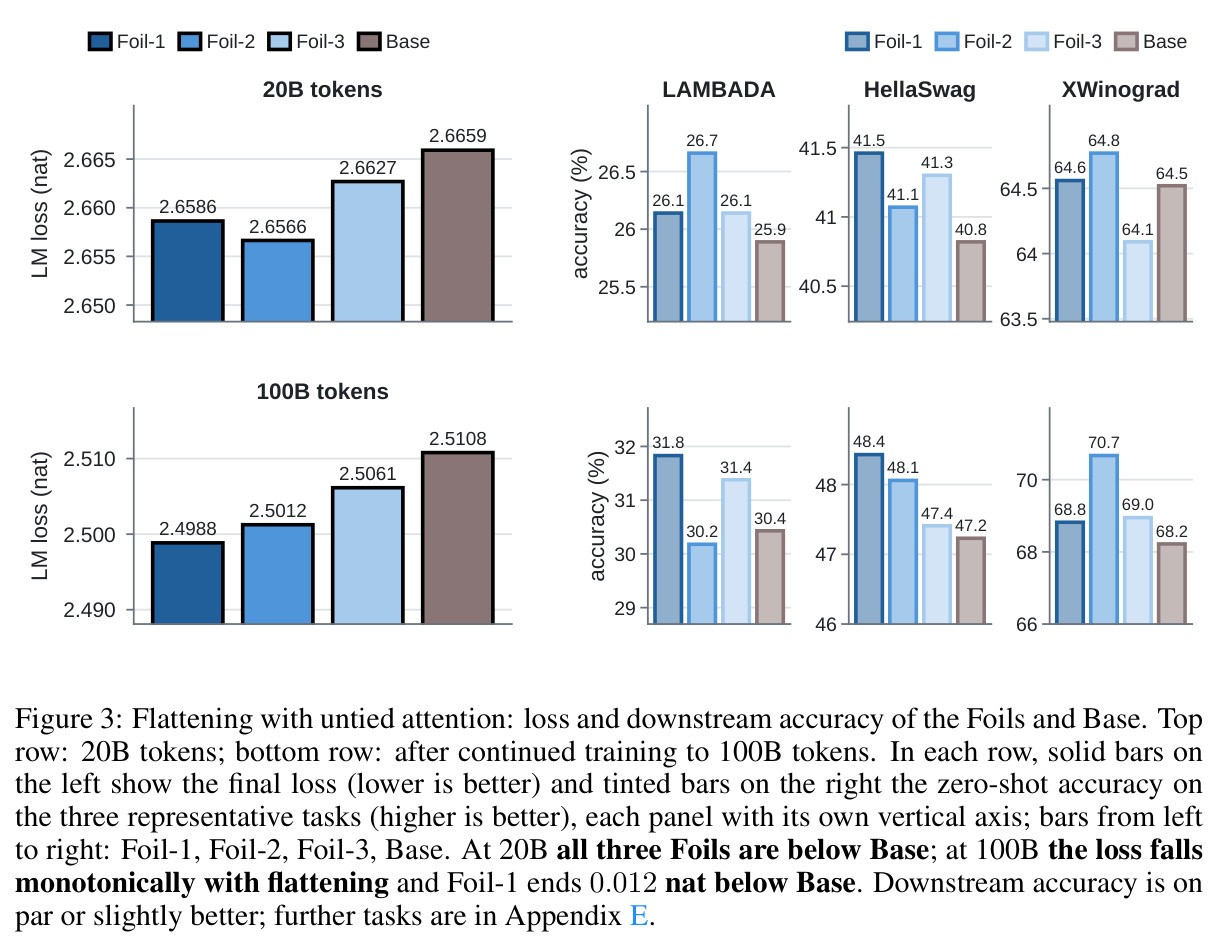
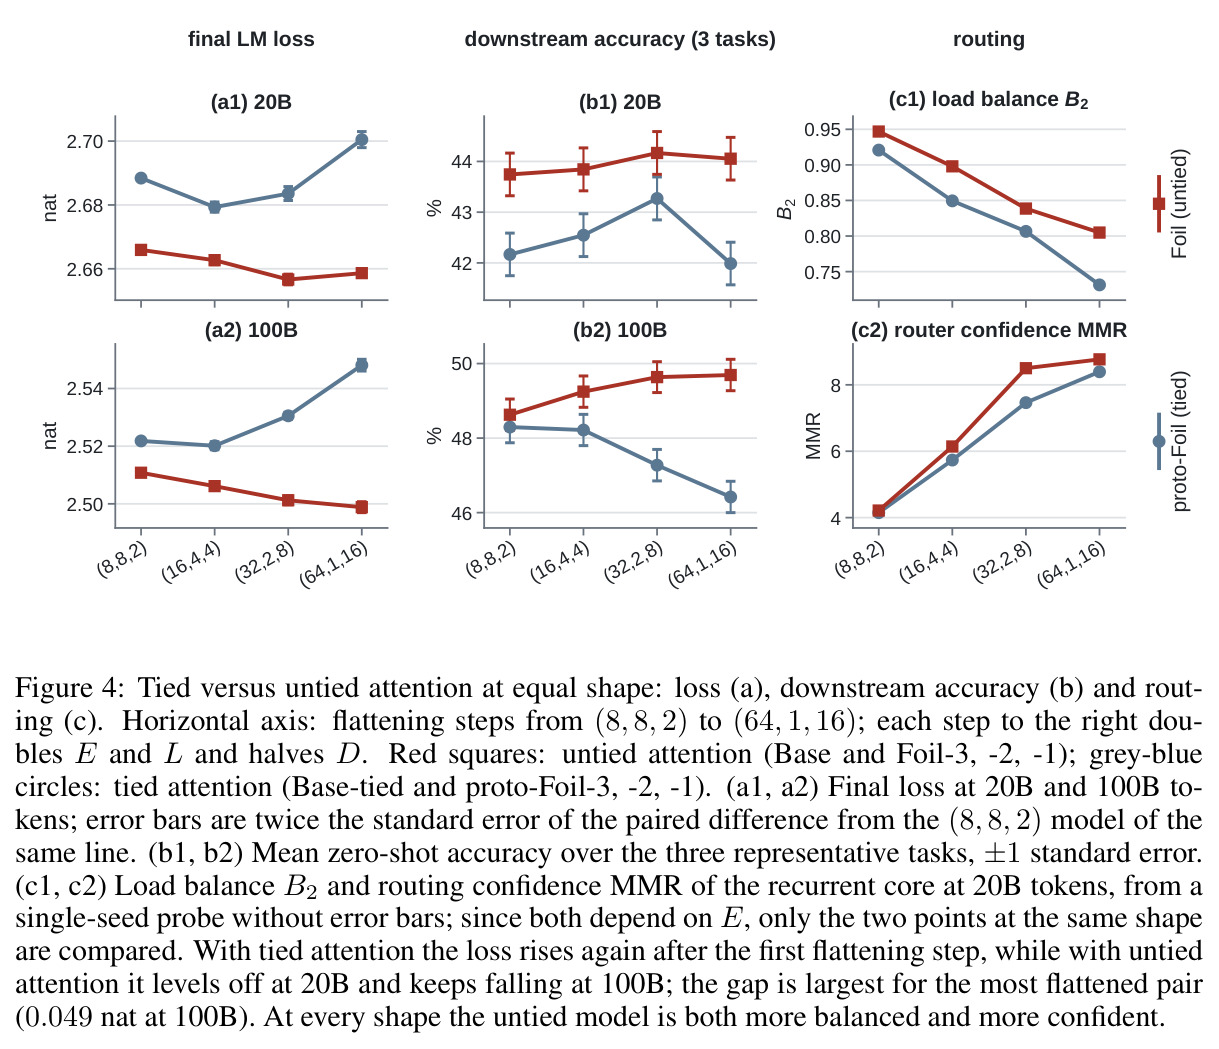
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 预训练损失·摊平收益(20B token) | 语言建模损失 (nat) | Foil-2 (32,2,8): 2.657 | Base (8,8,2): 2.666 | −0.009 nat(Foil-1为−0.007 nat) |
| 预训练损失·摊平收益(100B token延续训练) | 语言建模损失 (nat) | Foil-1 (64,1,16): 2.4988 | Base (8,8,2): 2.5108 | −0.012 nat,且随摊平单调改善 |
| 预训练损失·注意力解绑(100B token) | 语言建模损失 (nat) | Foil-1: 2.4988 | proto-Foil-1(tied注意力): 2.5481 | −0.049 nat(20B时为−0.042 nat) |
| 零样本下游·三代表任务均值(100B token) | 平均准确率 (%) | Foil-1: 49.69 | Base: 48.63;proto-Foil-1: 46.42 | +1.06 vs Base;+3.27 vs proto-Foil-1 |
| 零样本下游·七任务均值(100B token) | 平均准确率 (%) | Foil-3: 52.02 | Base: 50.84 | +1.18 个百分点 |
| 困惑度(20B token) | PPL | Foil-2: 14.25 | Base: 14.38 | −0.13 |
| 循环收益·等参数对比((8,8,1)→(8,8,2)) | 损失下降 (nat) | 循环2次降至2.688 | 非循环 (8,8,1): 2.752 | −0.064 ± 0.0013 nat |
局限与改进
作者在附录J明确承认四点局限。第一,缺少等参数等计算的非循环对照——与 $(8,8,2)$ 专家参数和计算相同的非循环模型是 $(4,16,1)$,但其激活比例 $k/E=1/2$,会把'跨层共享专家'与'稀疏激活'两个因素混在一起,因此'循环本身带来多少收益'无法在本文内部严格归因,只能引用外部证据。第二,除Base-tied的种子重复(差异 $-0.0003 \pm 0.0009$ nat)外全部单种子,且损失标准误按'相邻训练步独立'的假设计算、系统性偏乐观。第三,所有结果只在 $d_{\text{model}}=1024$ 一个宽度上取得,宽度方向的缩放规律未知。第四,消融全部在tied注意力下进行,而tied下摊平收益第一步后即消失,因此消融结论对Foil本身的量化大小未必成立。我的补充观察:绝对收益很小(0.007–0.012 nat),在553.7M规模上成立但外推到大模型存疑;摊平后路由器打分计算量 $O(E \times D \times L \times d_{\text{model}})$ 随 $E$ 增长而未被计入 $E_{\text{comp}}$;16轮顺序循环的推理延迟与16套注意力权重的显存驻留也未做硬件层面分析。
独立分析的弱点
弱点一:收益幅度与形状锁定时机不匹配。0.012 nat的改善要求训练前就锁定形状,而MMR峰值只是事后诊断指标;若在中等摊平(如Foil-2)后收益已近枯竭,继续摊平到Foil-1反而回吐0.002 nat(约三个标准误)。改进方向:把MMR逐轮曲线做成训练中的在线监控,动态决定摊平幅度与轮次。弱点二:tied消融与untied主张之间存在裂缝——'加宽与循环互相放大'等结论都在tied下测得,而Foil的收益依赖untied,两者叠加时的交互效应没有直接实验支撑。弱点三:路由器成本被排除在预算外,$E=64$ 时路由打分不到专家计算的1%,但若摊平到数千专家或 $E_{\text{comp}}$ 增大,这一点可能反转,作者未给出规模外推。弱点四:延迟敏感场景不友好——16轮顺序执行即使FLOPs与深模型匹配,wall-clock延迟更高,且16套注意力权重增加显存占用,与'用计算换存储'的初衷部分冲突;改进方向包括循环轮次的投机执行/早退机制、以及借鉴Relaxed Recursive Transformers把每轮注意力LoRA化以压缩参数。
未来方向
作者在限制一节隐含的方向包括:补做等预算非循环对照、多种子重复、多宽度实验、以及在untied条件下重跑消融。基于本文成果可延伸的方向更多:其一,摊平倍数 $a$ 的缩放律——本文从 $a=1$ 扫到 $a=8$,可否像Chinchilla那样拟合'最优摊平度随参数与数据规模变化的曲线',并与Parcae的循环缩放律对话;其二,测试时计算扩展——MMR逐轮衰减提示可以按token自适应决定循环轮次(早退或继续),把Foil变成可变深度的推理引擎,把MMR峰值用作停止准则;其三,与细粒度专家结合——Foil优化的是'层数→宽度'维度,与DeepSeekMoE式细粒度切分正交,两者可能叠加收益;其四,专家分工动力学——同一物理专家在不同轮次是否自发形成不同角色(如早轮做句法、晚轮做语义),值得做干预与探针实验;其五,重新审视辅助均衡损失——既然低流量专家不低价值、摊平后 $B_2$ 下降但损失更低,传统均衡损失可能正在压制有用的不均衡,可试验去掉均衡损失或改用 $\phi$-balancing;其六,把Foil布局迁移到视觉与多模态MoE、以及在超过1B激活参数的规模上验证。
复现评估
复现条件相当好。代码与全部配置已开源(https://github.com/SR-A-W/how-to-loop-moe);数据用公开的FineWeb-Edu sample-100BT子集,分词器为SmolLM2(词表49,152);评估覆盖36个下游任务并详细报告了7个有效任务、5-shot设定与四个域外验证片。算力方面:正文报告的实验约12,600个H200 GPU时(含早期对照与失败运行约18,200时),每个运行最多用1个8卡H200节点;最大模型仅553.7M参数、20B训练50,000步——对装备良好的学术实验室(一台8×H200节点约数天到数周可跑一个模型)可以承受,但要复现完整的35模型网格则需要明显更多资源。风险点:除一次种子重复外均为单种子,且损失标准误偏乐观,建议自行加种子重复来确认0.002 nat量级的差异;路由诊断与掩码实验需要255,500个探针token的中间路由记录,需确认仓库是否导出这些张量。总体评估:主结论(100B损失随摊平单调下降、untied优势0.049 nat)信号清晰、方差小,复现难度中等偏低。
论文图表
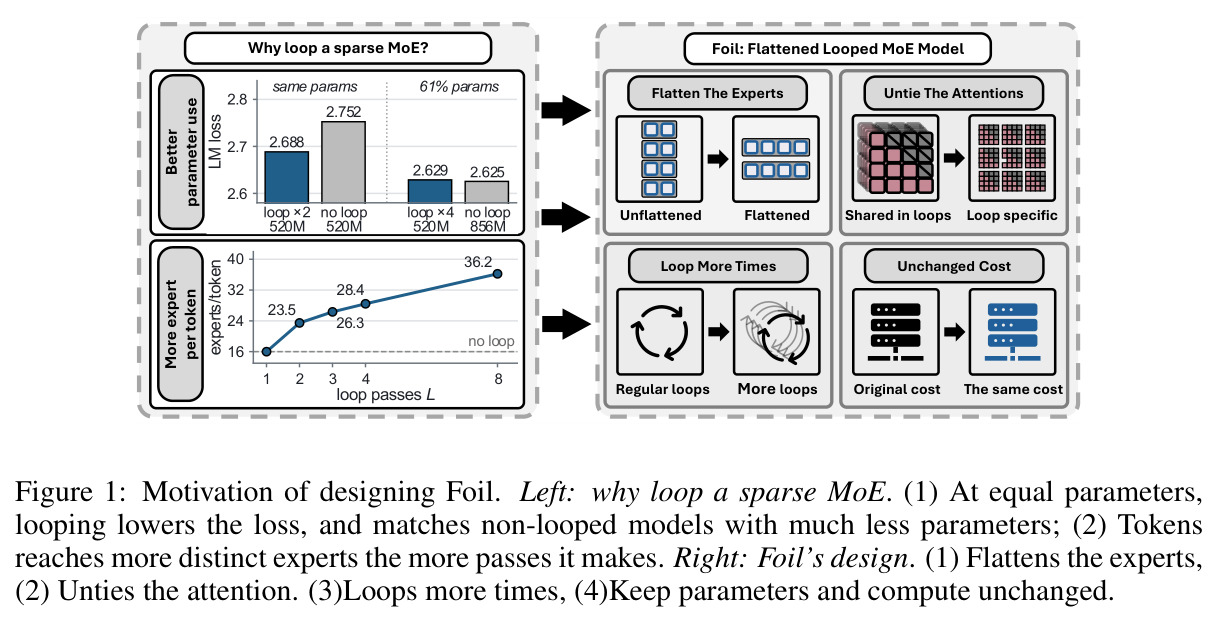
左图给出循环稀疏MoE的两个动机:(1) 等参数下循环两次使损失降低0.064 nat,且参数少得多的循环模型靠更多计算即可匹敌层数两倍的非循环模型;(2) 每token触达的不同专家数随轮次增长(不循环16个→8轮36个)。右图展示Foil的四个设计要点:摊平专家、解绑注意力、循环更多次、参数与计算成本均不变。
一页看懂全文的问题动机与方案概貌,是进入正文前的最佳导览。
上半部分:加宽(E翻倍、每token专家调用不变)在不同L下的收益——(8,4,L)→(16,4,L) 为0.038/0.040/0.049 nat(L=2/4/8);下半部分:三个2×2块的交互分析,'两者都做'减去单独加宽与单独加轮的收益,交互项为+0.0018、+0.0089、+0.0067,无一为负。
直接量化'加宽与循环互相放大'这一核心机制发现的数据表。
八个模型在20B与100B共16种组合下,掩码最少用10%流量专家组的损失增幅(0.109–0.309 nat)、20个流量匹配随机组的均值与区间,以及低于最少用组的随机组个数(9–20/20)。最少用组的损失增幅从不跌出随机组区间。
'低流量专家不低价值'结论的完整实验数据,对要不要按流量裁剪专家给出否定答案。