Meta Expert:跨层专家共享的存储与检索高效MoE架构 Meta Expert: Cross-Layer Expert Sharing for Storage- and Retrieval-Efficient MoE
提出跨层共享的Meta Expert,仅用70-80%专家数即可匹配标准MoE性能
前置知识
混合专家(MoE)
把 Transformer 的前馈网络(FFN)拆成 N 个并行的专家子网络,由路由器为每个 token 打分,只把计算交给得分最高的 k 个专家。这样模型总参数量可以很大(存储更多知识),而每个 token 的实际计算量只相当于 k 个小 FFN,实现“存储大、计算省”。FFN 占模型参数的大头,主流大模型如 DeepSeek-V3、Qwen3、Mixtral 都采用这一架构,且每层专家彼此独立、参数互不共享。
本文的全部讨论都发生在 MoE 内部:Meta Expert 就是对“专家参数如何存放与复用”这一 MoE 核心设计的改造,不熟悉 MoE 就无法理解跨层共享的对象与收益来源。
路由器与 top-k 激活
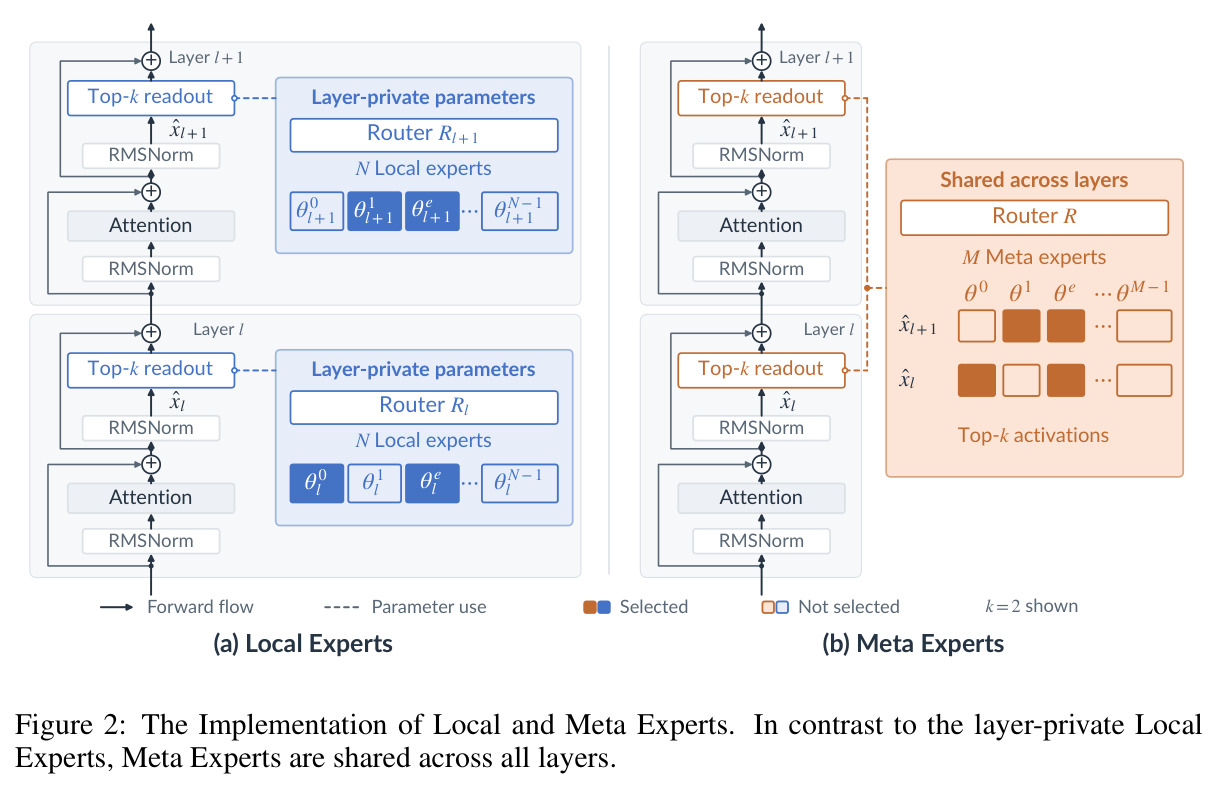
路由器 $R$ 是一个小型门控网络,读入归一化后的隐状态 $\hat{x}$,输出每个专家的打分,softmax 归一化成权重后选出得分前 $k$ 的专家加权求和:$y=\sum_{e\in\mathrm{topk}(R,\hat{x})}R(\hat{x})_e\,\phi_e(\hat{x})$。top-$k$ 决定了每个 token 的激活参数量与 FLOPs,是 MoE 中“计算成本”的控制旋钮。
论文所有对比都严格保持 top-k(每 token 激活 8 个、或 4 Meta + 4 Local)不变,从而做到 iso-FLOP 公平比较;理解这一机制才能明白“专家总数减少而性能不变”这一结论的含金量。
残差连接与梯度高速路
残差连接把每个子层写成 $x_{l+1}=x_l+\gamma E(\hat{x}_l)$,恒等分支让反向传播梯度以单位增益直通浅层,缓解深层网络的梯度消失。前向时信息逐层写入残差流且只向更深处流动;反向时梯度虽能到达浅层参数,但会被中间各层的梯度信号混合稀释,且只落在层私有的参数上,而非以激活内容的形式被浅层读出。
第 4 节理论的核心论断是:跨层共享专家相当于在激活层面增加了一条“反向残差通路”,让浅层能以 $O(1)$ 路径读取深层写入的内容。不懂残差框架就无法理解这一机理论证。
Looped Transformer(循环 Transformer)
权重共享的极端形式:把同一个 Transformer 块反复套用多次,用很少的参数“展开”出任意深度,代表工作如 Universal Transformer、DEQ、MoEUT。研究表明这类模型的推理能力可媲美更大的模型,但代价是必须增加递归次数、拉长串行计算链,训练和推理时延显著升高。
它是本文最直接的对标方案:Meta Expert 保持递归次数不变、只让候选专家池变宽,与 Looped Transformer“参数不变、递归变多”形成镜像关系,对比之下才能看清设计取舍。
线性 CKA 与谱 Gini 冗余度
CKA(中心化核齐性)衡量两组表示之间的相关结构,对正交变换和各向同性缩放不变。本文把每个专家对探针 token 响应矩阵的中心化协方差展平成向量 $\varphi_i=\mathrm{vec}(Y_i^{c\top}Y_i^c)$,两两余弦相似度构成 Gram 矩阵 $K$,再取其特征谱的 Gini 系数 $\rho=\mathrm{Gini}(\lambda)$:相似性能量集中在少数方向($\rho\to1$)说明多个专家功能坍缩、冗余严重;均匀秩-$k$ 谱时恰好 $\rho=1-k/E$。
$\rho$ 是论文除 loss 外的第二条主线证据,几乎所有缩放图都以“loss 比值 + 冗余度比值”双坐标呈现;不懂该指标就读不懂“冗余降低”这一核心主张是如何被量化的。
Iso-FLOP 缩放阶梯
固定训练算力(FLOPs)、只改变架构变量进行对比的实验方法:在深度 12/16/20/24 四个档位上,每个档位的所有变体共享相同的 token 预算、激活参数量和训练配置,唯一自由的变量是 loss。这是比较架构优劣、避免“大就是好”混淆归因的标准做法,也符合算力最优训练与缩放律的既有实践。
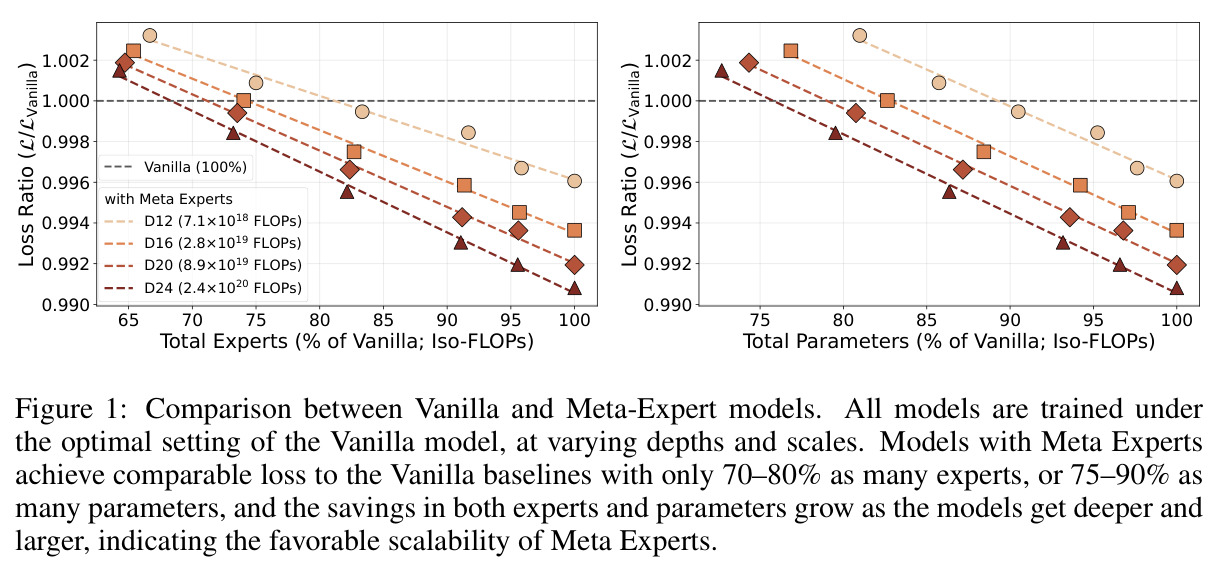
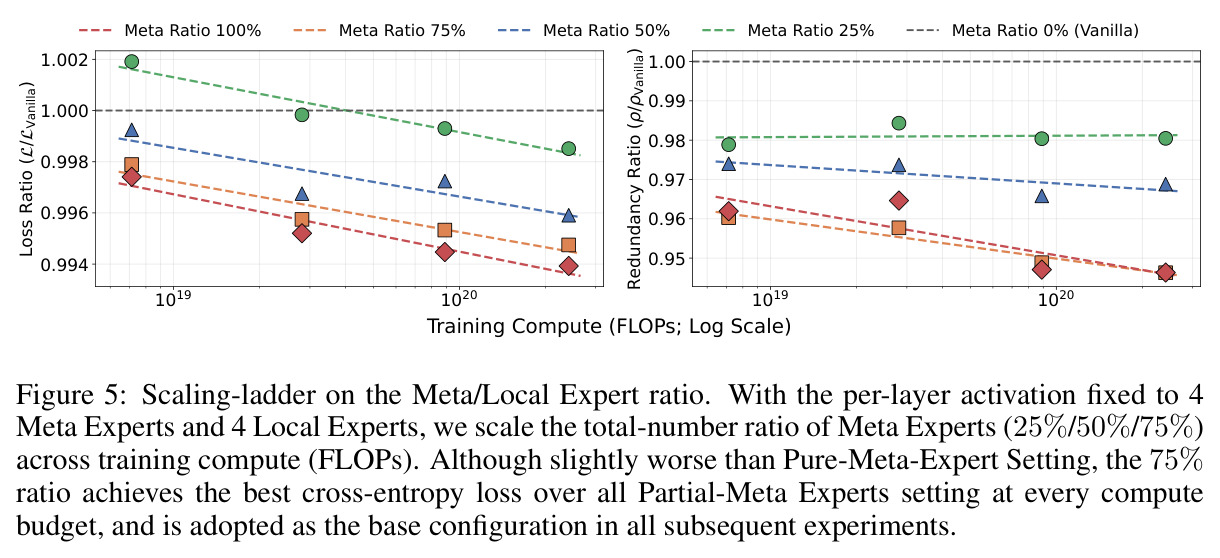
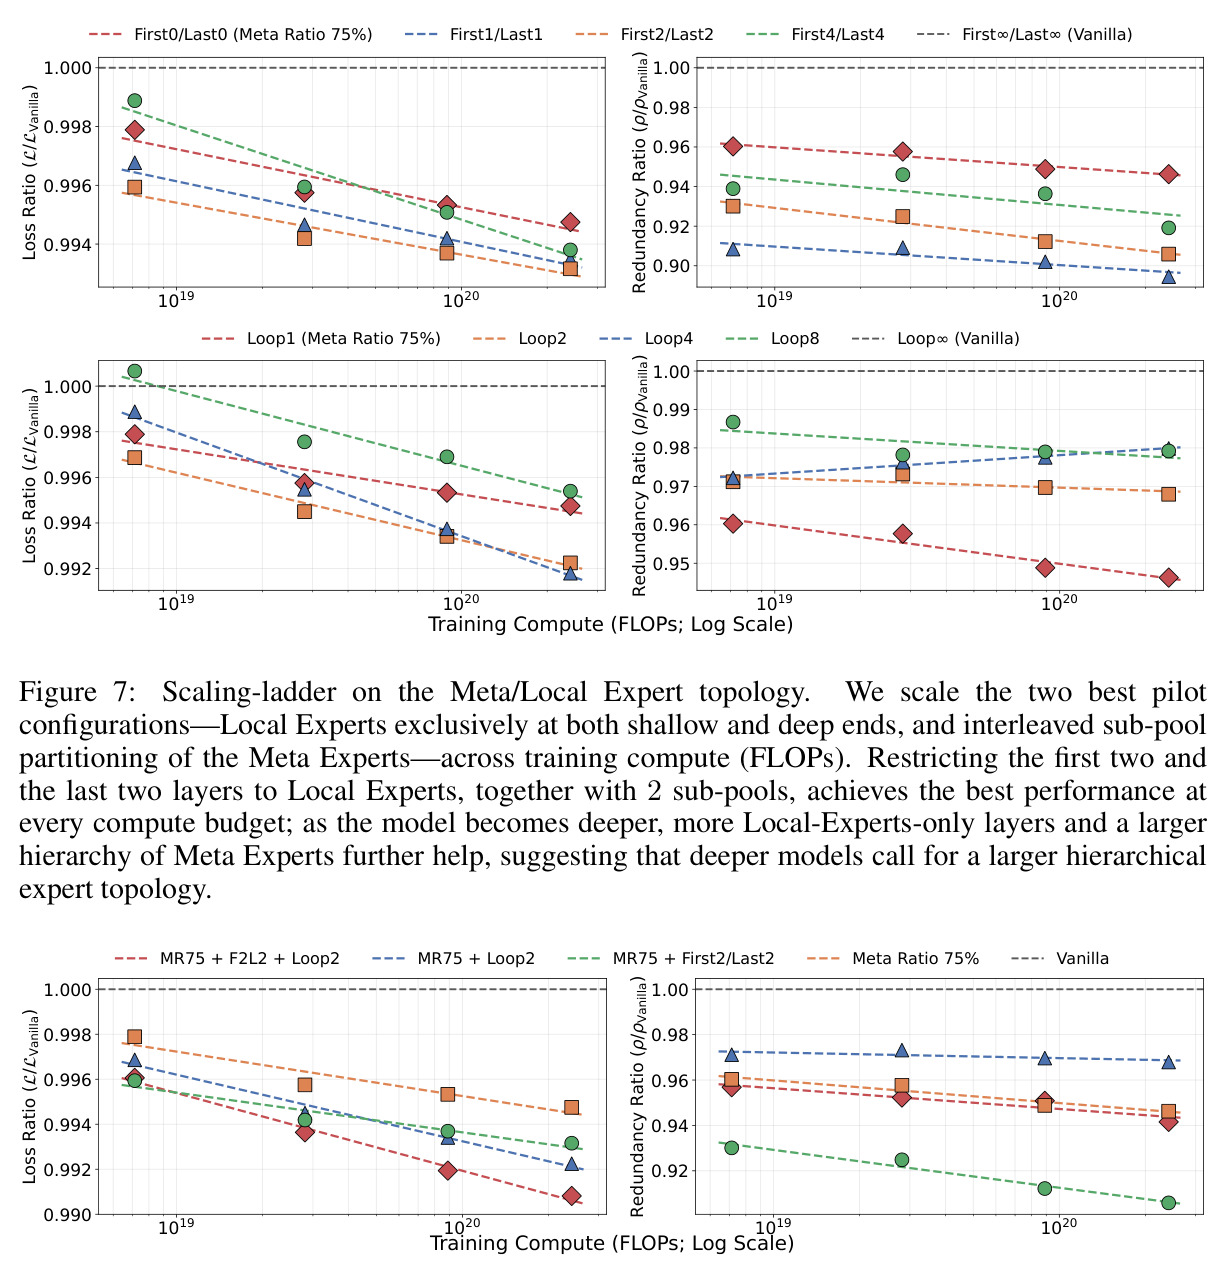
论文的主要证据形态就是四档缩放阶梯图(图 1、5、7、8),若不理解 iso-FLOP 的控制变量逻辑,会误以为性能提升来自算力差异而非架构本身。
研究动机
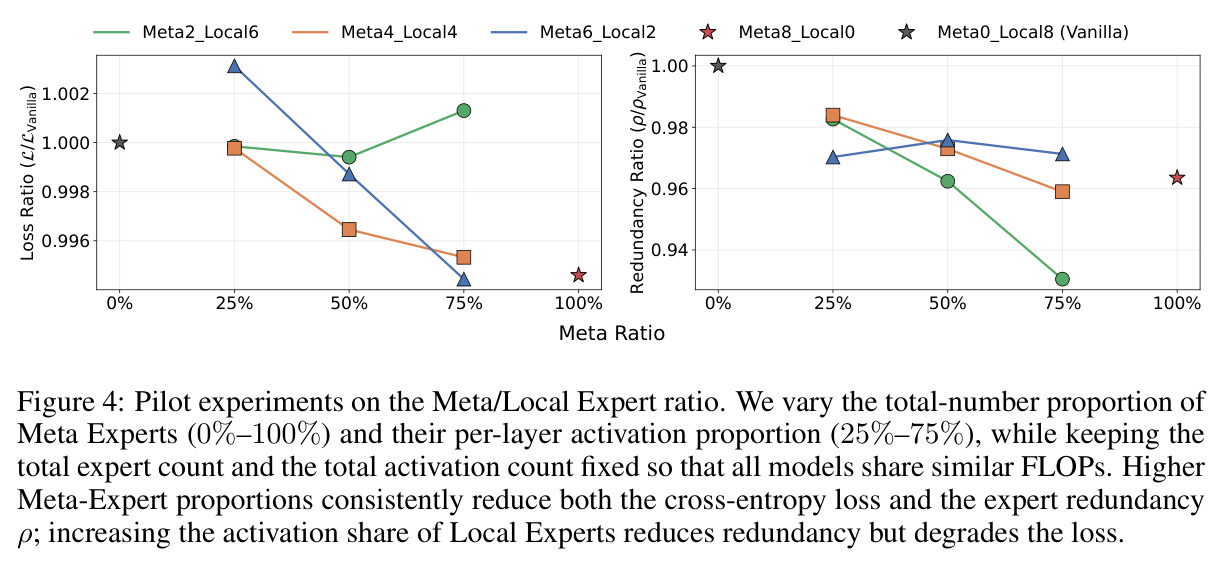
当前主流大模型几乎都采用稀疏激活的混合专家(MoE)架构来摊薄算力开销,把每层前馈网络拆成上百个专家、每个 token 仅路由到少数几个。但主流模型的专家都是“层私有”的(Local Expert):第 $l$ 层的路由器 $R_l$ 和专家参数 $\theta_l$ 与其他层完全独立初始化、独立访问。可解释性研究(Geva et al. 2021;Dai et al. 2022)表明前馈网络存储的是相对静态的知识,而 Meng et al. 2022、Takase & Kiyono 2023 等进一步发现不同层会存储大量相似知识——层与层之间虽然拓扑独立,存储内容却高度相似,存在可观的冗余。与此同时,沿宽度方向提升参数效率的细粒度专家设计(如 DeepSeekMoE)已较成熟,沿深度方向却缺乏系统方案:Looped Transformer 复用整套块参数,虽省参数但必须增加递归次数、拉长串行计算链,带来更高的计算与时延成本。作者在 2B-A0.5B 模型上实测(图 4 右侧)发现传统分层设计的专家冗余度显著偏高,如何消除这部分“浪费的存储”、又不增加计算,正是本文要解决的问题。
本文的目标是本文的目标是:在不改变每层计算量的前提下,消除 MoE 模型中专家参数的层间冗余,把“冗余存储”转化为“有效容量”。具体而言,作者希望在保持每 token 激活专家数(top-k)和专家粒度完全不变——即训练 FLOPs 与推理算力与 Vanilla MoE 一致——的条件下,用更少的总专家数和总参数量达到相同的语言建模 loss 与下游任务精度。围绕这一目标需要回答三个设计问题:跨层共享的 Meta Expert 应占总专家数的多大比例(0%–100%)、每层激活预算应如何分配给 Meta 与 Local 专家、以及共享专家池应采用什么拓扑(是否每层都要含 Meta、共享池内部是否再做层级分组轮转)。最终目标是给出一条可直接用于更大模型训练的、存储与检索双高效的 MoE 设计准则。
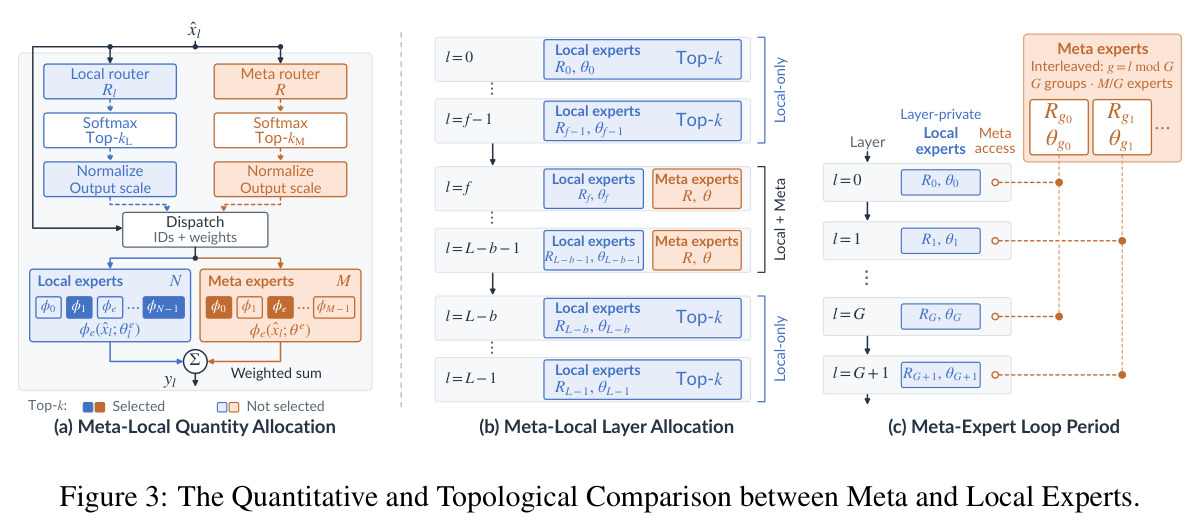
与已有工作不同的是,本文的独特切入角度有三点。其一,与 Looped Transformer“参数不变、增加递归”的 Parameter Loop 思路正相反:作者保持递归次数不变、让候选专家池变宽,再借 MoE 的稀疏激活同时锁住每层激活参数与计算量——这是一种全新的“共享但不加深”的折中方案。其二,共享粒度是专家级而非整块级:注意力层可以保持层私有,仅 FFN 专家跨层复用,且共享拓扑本身被当作可调设计空间(边界层留 Local、共享池再分 2/4/8 个子池按块状或交错方式轮转),突破了以往 MoE 权重共享工作“所有层共享一套”的单一拓扑。其三,作者不只报参数节省,还从残差通路角度给出机理解释:跨层共享隐式引入了激活层面的“反向残差连接”,使深层信息能以 $O(1)$ 路径长度被浅层读取,这种对共享收益的解释在既有文献中是首次被形式化。
核心方法
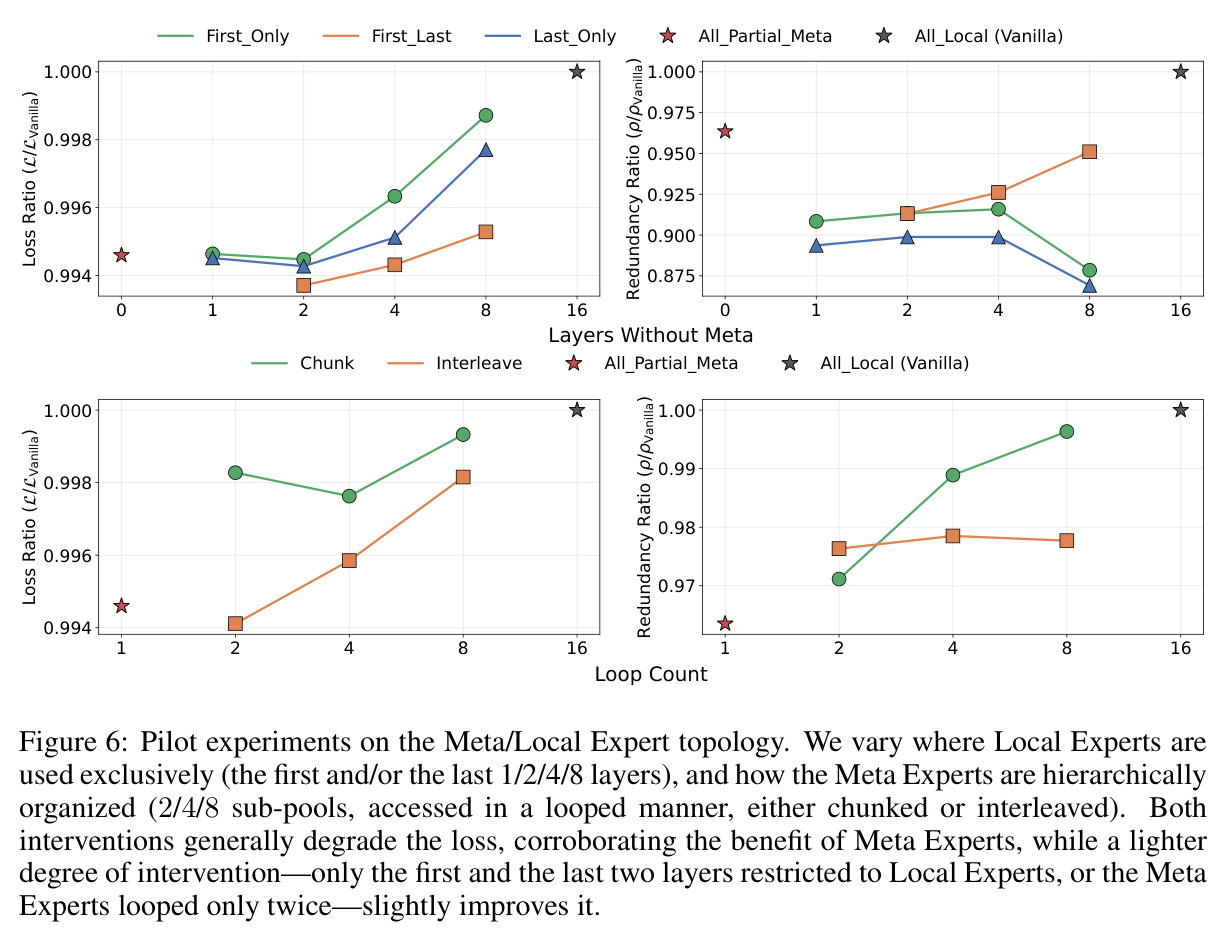
方法的直觉很朴素:既然不同层的专家学到的是相似知识,就不必每层都存一份,让所有层共用一个专家池即可。技术上,Meta Expert 把每层私有的路由器 $R_l$ 和 $N$ 个专家 $\{\phi_e(\cdot;\theta_e^l)\}$ 换成一个全层共享的路由器 $R$ 和 $M$ 个专家 $\{\phi_e(\cdot;\theta_e)\}$,输出变为 $y^l=\sum_{e\in\mathrm{topk}(R,\hat{x}^l)}R(\hat{x}^l)_e\,\phi_e(\hat{x}^l;\theta_e)$,注意力层与残差结构完全不动。作者没有一步到位地全共享,而是系统扫描两类变量:数量关系(Meta 占总专家数的 0/25/50/75/100%,每层激活预算中 Meta 占 25/50/75%)与拓扑关系(哪些层允许只放 Local 专家、共享池是否再分成子池分层级轮转)。实验流程是先在 2B-A0.5B 模型上做试点扫描,再把胜出配置放到 Qwen3.5 风格、深度 12/16/20/24 的缩放阶梯上做 iso-FLOP 验证,最后以 6B-A1.6B 模型的下游任务收尾。
核心创新是把“专家”这一知识存储单元从层私有资源变成全模型公共资源。与已有方法的本质区别有三:(1) Looped Transformer 复用整块参数但需要更多递归、更深串行计算;Meta Expert 只在专家粒度上复用,前向仍是一次性并行展开,注意力层可保持层私有,训练与推理吞吐不变。(2) 以往 MoE 权重共享工作(如 Unipool、RexMoE 等)几乎都采用“所有层共享一套”的固定拓扑,通信与显存开销难以扩展;本文保留首尾边界层 Local 专家、并把共享池划分为 2/4/8 个交错子池,让模型自己决定哪些内容值得跨深度共享。(3) KV-Cache 共享是在推理期复用激活(读取侧),Meta Expert 则在训练期就让所有层向同一参数池写入、再从同一池读取,从存储侧重塑了知识分布——这正是它能降低专家冗余度 $\rho$ 的原因,也使共享池天然成为跨深度的双向信息通道:理论分析表明层 $l$ 的参数写入对层 $m$ 读出的一阶影响为 $\Delta y_{m\leftarrow l}^{(t)}\approx-\eta\gamma^2J_m^{(t)}J_l^{(t)\top}\bar{y}_l^{(t)}$,路径长度 $O(1)$ 而非 $O(|m-l|)$。
方法步骤详情
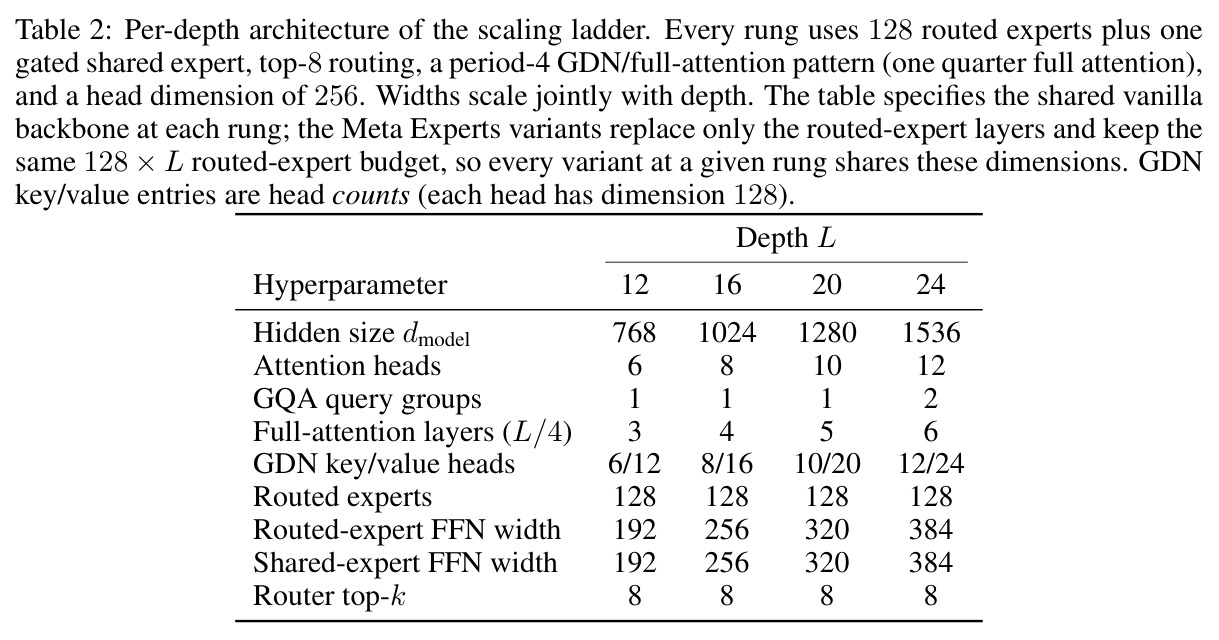
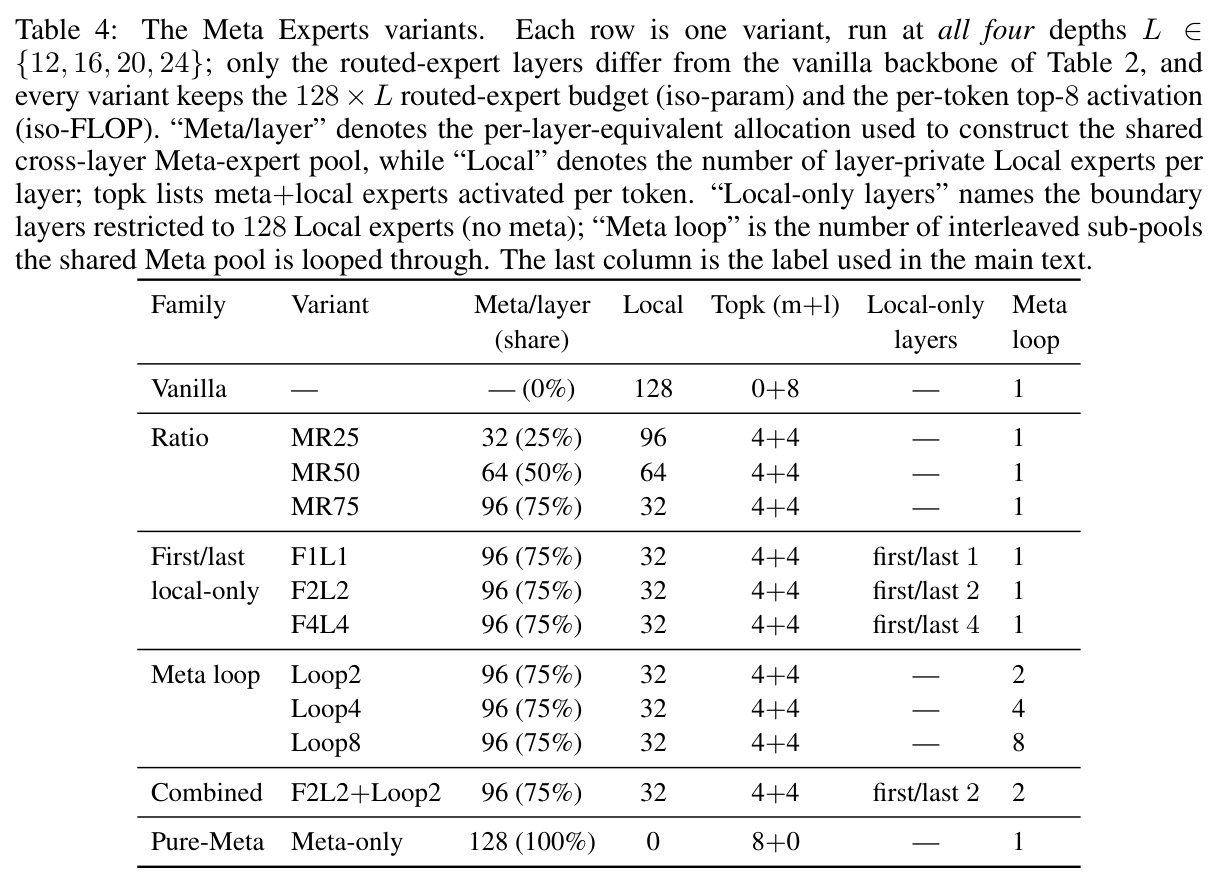
第一步,搭建基线:Qwen3.5 风格混合注意力 MoE——每层 128 个路由专家加 1 个门控共享专家、top-8 路由,注意力按周期 4 在 GDN 线性注意力与全注意力间交替,Muon 优化器、WSD 调度、序列长 8192,在 H200 上从头训练。第二步,数量消融:在 2B-A0.5B 模型扫描 Meta 占比 0–100%、激活占比 25–75%,选定每层 96 Meta/32 Local、激活 4 Meta + 4 Local 的 MR75。第三步,拓扑消融:尝试首/尾若干层纯 Local、共享池分 2/4/8 个子池轮转,确定 F2L2(首尾各 2 层纯 Local)加 Loop2(2 个交错子池)最优。第四步,缩放阶梯验证:在 L=12/16/20/24(FLOPs 从 $7.1\times10^{18}$ 到 $2.4\times10^{20}$)上以 Vanilla 最优配置做 iso-FLOP 对比并逐级叠加设计。第五步,下游评测:训练 6B-A1.6B 模型 200B token,在 MMLU、C-Eval、CMMLU、BBH、TriviaQA、OpenBookQA 上对比五个变体。第六步,冗余度量化:把每个专家对探针集响应矩阵的中心化协方差展平为 $\varphi_i=\mathrm{vec}(Y_i^{c\top}Y_i^c)$,余弦相似度构成 Gram 矩阵 $K$,取其特征谱 Gini 系数 $\rho=\sum_{i,j}|\lambda_i-\lambda_j|/(2E\sum_i\lambda_i)$ 度量冗余,$\rho\to1$ 表示专家方向坍缩合一。
技术新颖性
技术新颖性体现在三个层面。架构层面:以往跨层共享要么整块复用(ALBERT、Universal Transformer、循环 Transformer),要么全层共享一套专家池(Unipool、RexMoE 等),本文首次把“共享范围”本身作为可调设计空间——Meta/Local 数量比、每层激活配比、边界 Local 层数量、子池划分与轮转方式全部参数化,并系统给出各维度的最优组合(MR75 + F2L2 + Loop2)。度量层面:提出基于 linear-CKA 加谱 Gini 的专家冗余度 $\rho$,连续、无阈值、可跨架构与跨训练预算比较(均匀秩-$k$ 谱时 $\rho=1-k/E$,即坍缩专家方向的占比),解决了高维余弦相似度整体趋零、无法刻画函数级相似的痛点。理论层面:第 4 节的一阶分析证明共享池让层 $l$ 的写入通过 $g_l=\frac{\partial y_l^\top}{\partial\theta}\bar{y}_l$ 累加进共享参数 $\bar{\theta}=\sum_l g_l$,而层 $m$ 的读出变化 $\Delta y_{m\leftarrow l}\approx-\eta\gamma^2J_mJ_l^\top\bar{y}_l$ 中的 $J_mJ_l^\top$ 是跨层切空间核——深层内容以激活级、$O(1)$ 路径进入浅层读出,首次把跨层共享解释为激活级的双向残差通路,也统一解释了存储(写入叠加)与检索(读出经由共同码本)两方面的效率增益。
实验结果
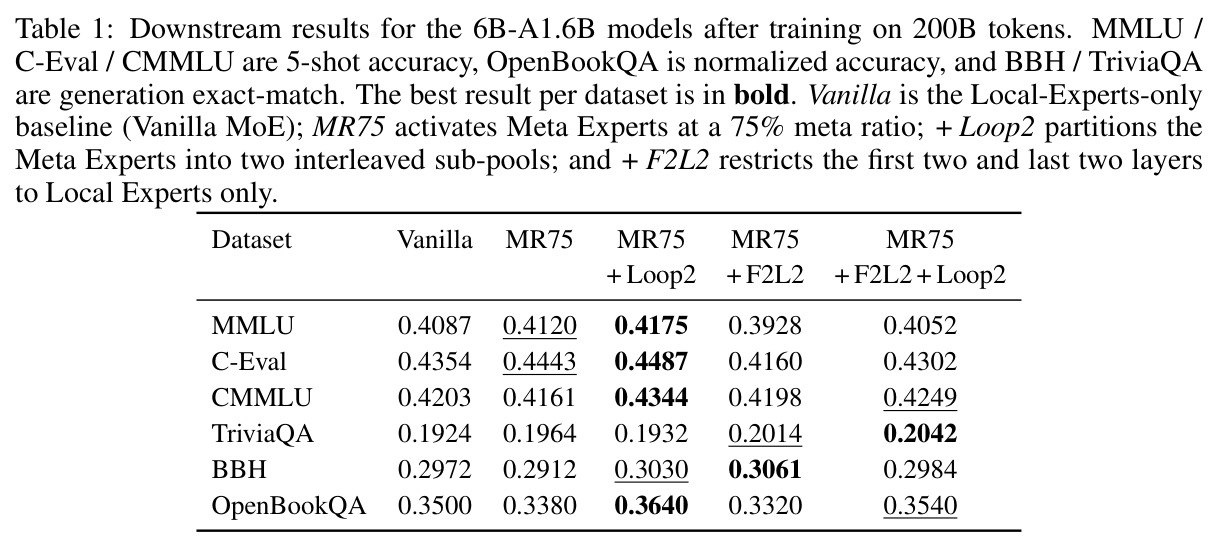
核心发现有四条。第一,Meta 占比越高越好:2B-A0.5B 试点中,Meta 总占比从 0% 提到 100%,loss 与冗余度 $\rho$ 单调下降;激活名额多给 Meta 有利,多给 Local 虽降冗余却伤 loss,暗示 Local 专家训练不充分本身就是冗余来源。第二,各设计逐级生效且可叠加:固定 4+4 激活后,75% 总占比在每个算力档位都是部分共享配置中最优;F2L2(首尾各 2 层纯 Local)与 Loop2(2 个交错子池)进一步降 loss,组合后在 $7.1\times10^{18}$–$2.4\times10^{20}$ FLOPs 每个档位都优于任何单一配置,优势随算力扩大。第三,参数节省显著:只需 70–80% 的专家、75–90% 的参数即可匹配 Vanilla loss,即省约 20–30% 专家、15–25% 参数,且模型越深越大越省。第四,下游一致占优:6B-A1.6B 训 200B token 后,六个基准中含 Meta 配置大多超过 Vanilla——C-Eval 0.4487、CMMLU 0.4344、MMLU 0.4175、TriviaQA 0.2042、BBH 0.3061、OpenBookQA 0.3640,分别高于 Vanilla 的 0.4354、0.4203、0.4087、0.1924、0.2972、0.3500;但 MR75+F2L2 单独使用时 MMLU(0.3928)反低于 Vanilla,说明拓扑收益与配置、规模相关。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语言建模(缩放阶梯 D12–D24,FLOPs $7.1\times10^{18}$–$2.4\times10^{20}$) | 达到与 Vanilla 相当 loss 所需的专家数/参数量 | 70–80% 专家、75–90% 参数(loss 比值约等于 1.0) | Vanilla MoE:100% 专家与参数 | 节省 20–30% 专家、15–25% 参数,且随模型加深增大而扩大 |
| MMLU(英语世界知识,5-shot,6B-A1.6B / 200B tokens) | 准确率 | 0.4175(MR75+Loop2) | 0.4087(Vanilla) | +0.88 个百分点 |
| C-Eval(中文多学科知识,5-shot) | 准确率 | 0.4487(MR75+Loop2) | 0.4354(Vanilla) | +1.33 个百分点 |
| CMMLU(中文知识,5-shot) | 准确率 | 0.4344(MR75+Loop2) | 0.4203(Vanilla) | +1.41 个百分点 |
| TriviaQA(开放域知识密集生成) | 生成精确匹配(EM) | 0.2042(MR75+F2L2+Loop2) | 0.1924(Vanilla) | +1.18 个百分点 |
| BBH(多步推理,思维链) | 生成精确匹配(EM) | 0.3061(MR75+F2L2) | 0.2972(Vanilla) | +0.89 个百分点 |
| OpenBookQA(常识推理) | 归一化准确率 | 0.3640(MR75+Loop2) | 0.3500(Vanilla) | +1.40 个百分点 |
| 专家冗余度(缩放阶梯全程) | CKA-Gini 冗余度 $\rho$ 相对 Vanilla 的比值 | 约 0.87–0.98,随 Meta 占比升高与算力增大持续下降 | 1.0(Vanilla) | 冗余显著降低,且规模越大差距越大 |
局限与改进
作者承认的局限包括:训练预算有限——下游实验只训了 200B token、6B-A1.6B 规模,各 Meta 变体在不同数据集上互有胜负,作者自己指出需要更大规模的缩放实验才能分出稳定优劣;纯 Meta 专家(100% 共享)可能训练不稳定,因此正文所有实验都退守到 75% 配置,不稳定的机理并未探明;轻度层级化(如 Loop2)会引入额外专家冗余却不损 loss,作者称之为有待研究的开放问题。我自己的观察有四点:其一,全部实验止步于 $2.4\times10^{20}$ FLOPs(约 6B-A1.6B),距离数百 B 参数的前线模型还有两三个数量级,共享池在超大规模下的负载均衡与路由坍缩风险未经验证;其二,论文没有报告推理吞吐、显存带宽、专家并行 all-to-all 通信等系统指标,而全层命中同一池会改变通信与缓存模式,这是部署成败的关键;其三,未与 RexMoE、Unipool 等 MoE 共享基线在相同预算下直接对比,节省幅度缺乏横向参照;其四,理论分析是一阶线性化的,$J_mJ_l^\top$ 的谱在长训练后是否衰减、共享池会不会出现信号消失,论文只承认“刻画了通路长度而非保证信号不消失”。
独立分析的弱点
第一,共享路由器是单点:所有层经同一个 $R$ 打分,若路由器学得保守,容易出现少数专家被高频激活、多数专家欠训练的马太效应,论文测了冗余度却没有报告负载均衡统计。改进方向:引入层感知的路由偏置或每层轻量适配向量。第二,F2L2 的“首尾各 2 层”是经验搜索出的常数,且单独使用时 MMLU 反而从 0.4087 掉到 0.3928,说明该组件并非在所有配置下稳健;改进方向:把边界层范围设为随深度等比缩放的可学习量,或用逐层相似度自动决定哪些层保留 Local。第三,冗余度指标依赖探针 token 集的选取,测的是响应相关性而非知识内容本身——两个响应相似但服务不同 token 子群的专家可能被误判;改进方向:结合知识神经元探针或因果干预做内容级冗余分析。第四,缺系统层面证据:共享池让所有层命中同一组权重,推断时可能提升缓存命中率、也可能造成带宽热点,论文完全没测吞吐与时延;改进方向:补充专家并行与单机部署下的端到端推理 benchmark。第五,理论只覆盖线性化的路径增益,无法解释 Loop2 为何“冗余升、loss 反而降”;改进方向:对子池轮转下的谱结构做非线性近似分析。
未来方向
作者明确提出两条延伸:把分析扩展到更大模型和更广架构;解释轻度层级化共享专家为何引入冗余却不损害性能。在此基础上还能延伸出多条路线。其一是系统协同设计:Meta 池天然适合权重常驻缓存与通信优化,可与专家并行、参数 offloading 结合,量化共享拓扑对端到端吞吐的影响。其二是与注意力侧共享融合:注意力投影乃至 KV-Cache 跨层共享能否纳入同样的“比例 + 拓扑”框架统一优化,值得探索。其三是自适应拓扑:让训练自动学习每层的 Meta/Local 配比或子池归属,替代手工设定的 F2L2/Loop2。其四是附录 A.4 埋下伏笔的梯度重加权:在共享池上引入 $\bar{\theta}=\sum_l\alpha_l g_l$ 式的层间梯度调制(范数均衡、冲突投影),显式控制各层“写入”对其他层“读取”的影响。其五是缩放定律建模:把共享率作为新变量纳入 MoE 缩放定律,预测给定算力下的最优共享配置。其六是理论深化:对切空间核 $J_mJ_l^\top$ 的谱做非渐近分析,回答共享池何时不会信号消失,并为“层级化冗余悖论”给出解释。
复现评估
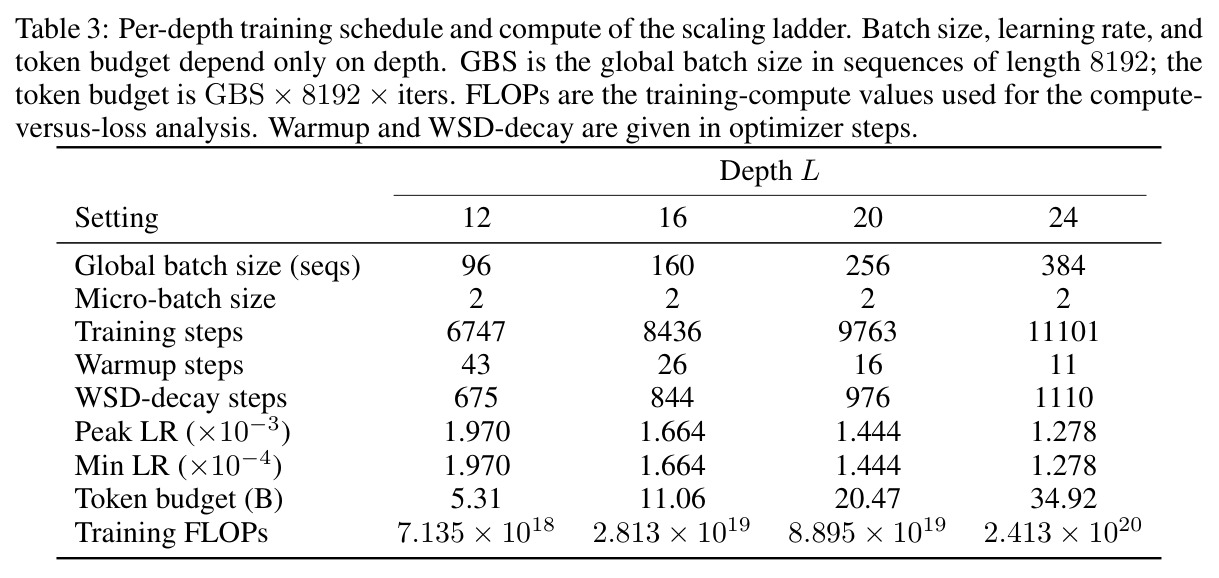
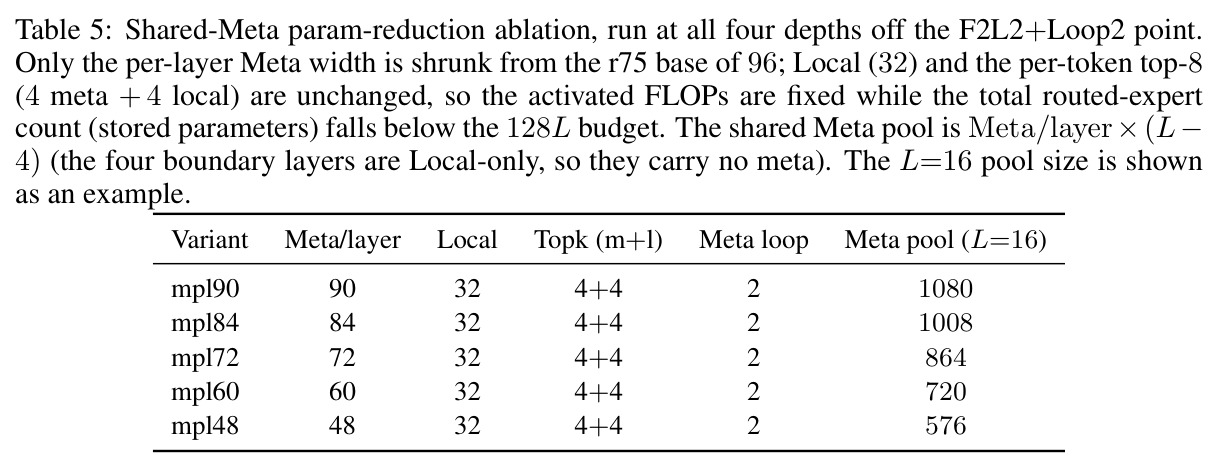
复现条件总体友好,但算力门槛不低。有利因素:模型基于开源的 Megatron-LM 实现;附录 A.3 给出完整配置——四个深度的架构表(Table 2:隐藏维 768–1536、每层 128 路由专家加 1 个门控共享专家、top-8 路由、周期 4 的 GDN/全注意力交替)与训练调度表(Table 3:全局批大小 96–384、峰值学习率 $1.97\times10^{-3}$ 至 $1.278\times10^{-3}$、token 预算 5.31B–34.92B、FLOPs $7.1\times10^{18}$–$2.4\times10^{20}$),以及全部变体定义(Table 4、5);超参直接继承 Vanilla 的算力最优配置、无需逐变体调参,评测协议(最后十步平均 loss)明确。困难因素:论文未承诺开源代码或模型权重;缩放阶梯需要 NVIDIA H200 集群,L=24 档约 $2.4\times10^{20}$ FLOPs,下游 6B-A1.6B 还要再训 200B token,估计需数百张高端 GPU 运行数周,普通实验室难以完整复现。折中路径:最小档 D12 与 2B-A0.5B 试点在几十张卡规模内可行;冗余度指标 $\rho$ 只需前向探针即可计算,核心结论可在小规模上低成本验证。
论文图表
从 MR75 出发逐步叠加设计:+Loop2(2 个交错子池)、+F2L2(首尾各 2 层纯 Local)、以及两者兼得的 MR75+F2L2+Loop2,全部与 Vanilla(loss 比值 = 1.0 的虚线)在 $10^{19}$–$10^{20}$ FLOPs 上对比。每一步精修都优于 Vanilla,组合设计增益最大,且 loss 与冗余度两方面的优势都随训练算力增长而扩大。
这是最终推荐配置的完整证据链:清晰展示各组件的边际贡献与组合效应,以及“规模越大越省”这一可扩展性论断,是 Figure 1 结论的机制级展开。