超越两轮循环:循环混合专家模型的可扩展训练配方 Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
LOOM 以残差缩放与逐环路由稳定循环 MoE,扩展到 9-12 轮并显著降损
前置知识
Looped Transformer(循环 Transformer)
把同一个 Transformer 块的权重共享地重复应用 H 次,用「循环次数」换取有效深度(物理 M 层 × 循环 H 次 = 有效 MH 层),参数量不变但计算量随 H 线性增长。思想源自 Universal Transformer 和 ALBERT,近期被证明有利于算法推理、长度泛化和潜在推理。
本文的全部内容就是把这一循环结构嫁接到 MoE 上并解决其扩展失败问题,不理解循环深度这一新扩展轴就无法理解论文动机与实验设计。
Mixture-of-Experts(MoE)与路由器
MoE 把 FFN 替换为多个专家网络,路由器为每个 token 打分并只激活 top-k 个专家,在固定计算预算下放大参数容量;通常配 z-loss 和容量因子做负载均衡。本文用 sigmoid 路由、每层 24-30 个路由专家加 2 个共享专家。
循环与 MoE 相交产生独有问题:路由器若跨循环共享,会导致「专家选择坍缩」,这是论文诊断出的两大病理之一,也是逐环路由设计的出发点。
深度诅咒(Curse of Depth)
在 Pre-LN 架构中,残差分支输出直接累加进残差流,层越深隐状态方差越大,使深层趋近恒等映射、近乎失效;Sun 等人提出用 $1/\sqrt{l}$ 缩放第 $l$ 层残差分支来控制方差增长、恢复深层的作用。
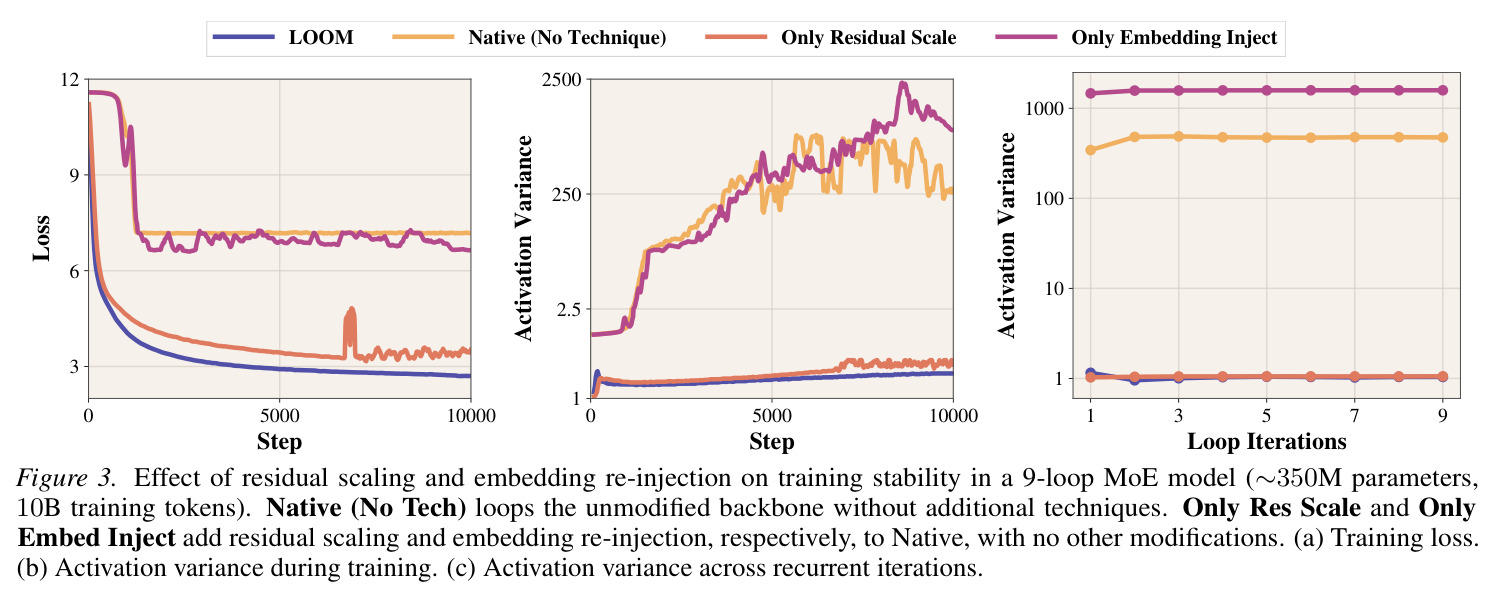
循环会让残差更新重复累积,把深度诅咒放大到极致(激活方差从 1 涨到 1000 以上并引发 loss spike),LOOM 的 $\gamma=\lambda/(H\sqrt{M})$ 正是它的循环版解药。
残差流与 RMSNorm/Pre-LN
残差流是贯穿网络的加性信息通道 $h_{t}^{\ell}=h_{t}^{\ell-1}+\mathrm{branch}(h_{t}^{\ell-1})$;Pre-LN 在每个分支入口先做 RMSNorm 归一化再计算,使梯度稳定回流;MoE 分支输出同样要经 RMSNorm 控制幅度后再写入残差流。
LOOM 的前向公式(残差缩放、嵌入重注入、Looping Residual)全部写在残差流上,读懂每个公式在操作 $h_t^{\ell}$ 的哪个位置是理解方法的前提。
ISO-FLOP 对比协议
控制两个模型的总训练计算量相同再比较性能,是公平评估架构创新的常用协议。本文以每 token 每层 $d^2$ 为单位计算 $f(H,k)=H(6+3k)$,通过随循环数缩小 top-k 使各配置的 $f\approx 84$,与 1 轮基线对齐。
论文的核心结论(等算力下 5 轮最优)只在 ISO-FLOP 协议下成立,理解 $f(H,k)$ 的构成才能看懂 Table 2 的实验设计及其「缩小 top-k」的混杂因素。
截断/分段反向传播(TBPTT)
对长序列或深度循环展开的训练,把计算图按段切开,每段独立反向传播,段间以 stop-gradient 传递隐状态,从而把激活显存从随展开长度线性增长降为近似常数,代价是梯度看不到更早的段。
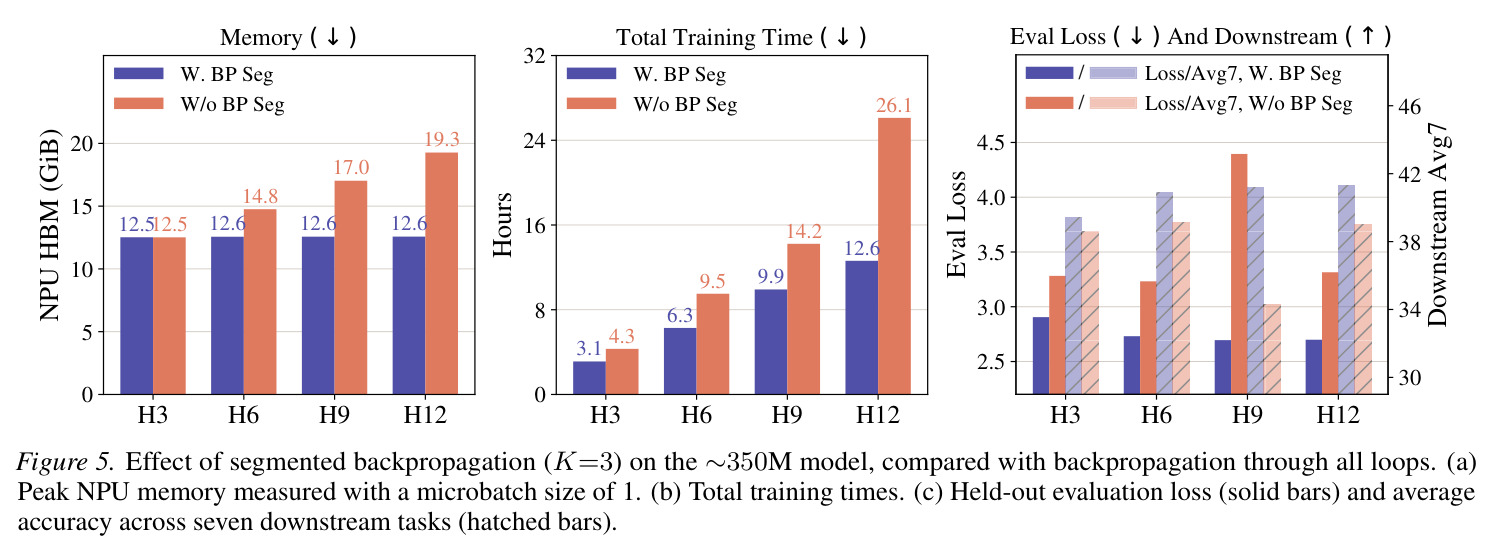
LOOM 默认每 K=3 轮切一段并在段末加 LM 监督,这是它能以约 12.6 GiB 显存训 12 轮的关键工程手段,且意外地比全反传更稳定。
研究动机
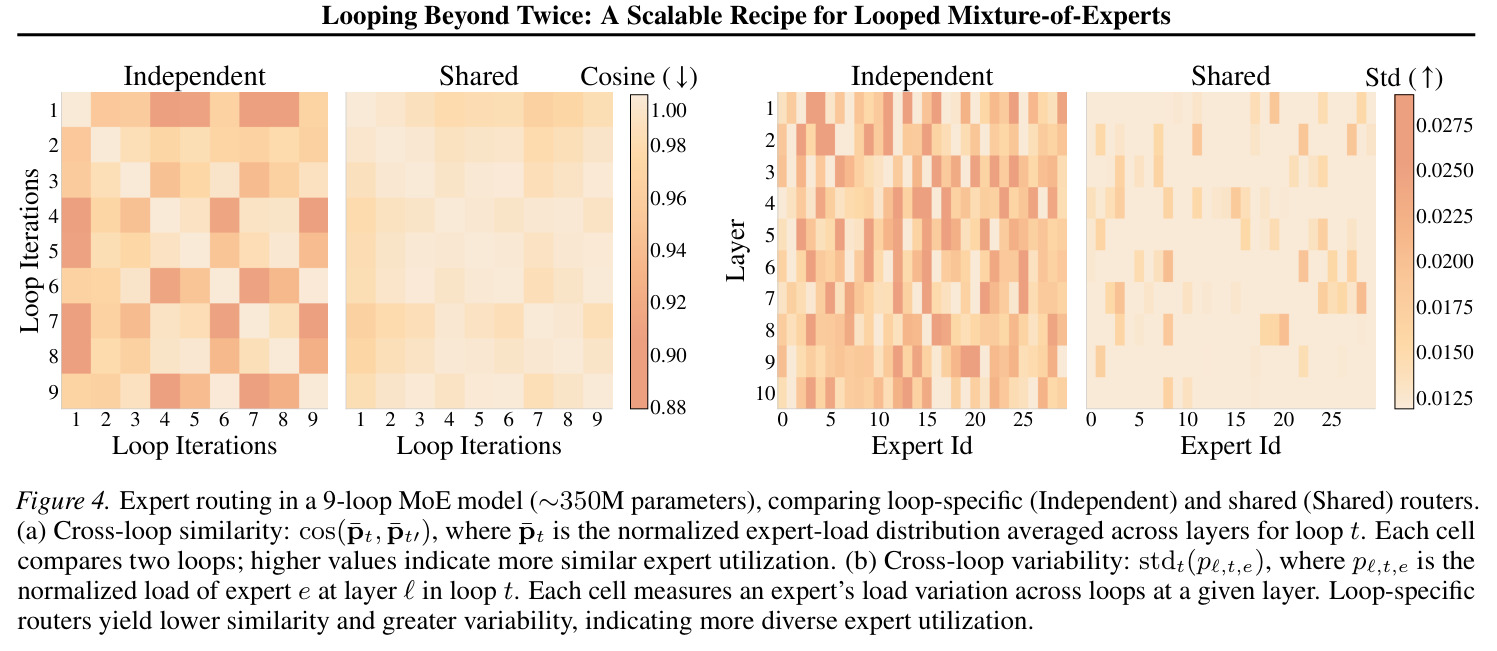
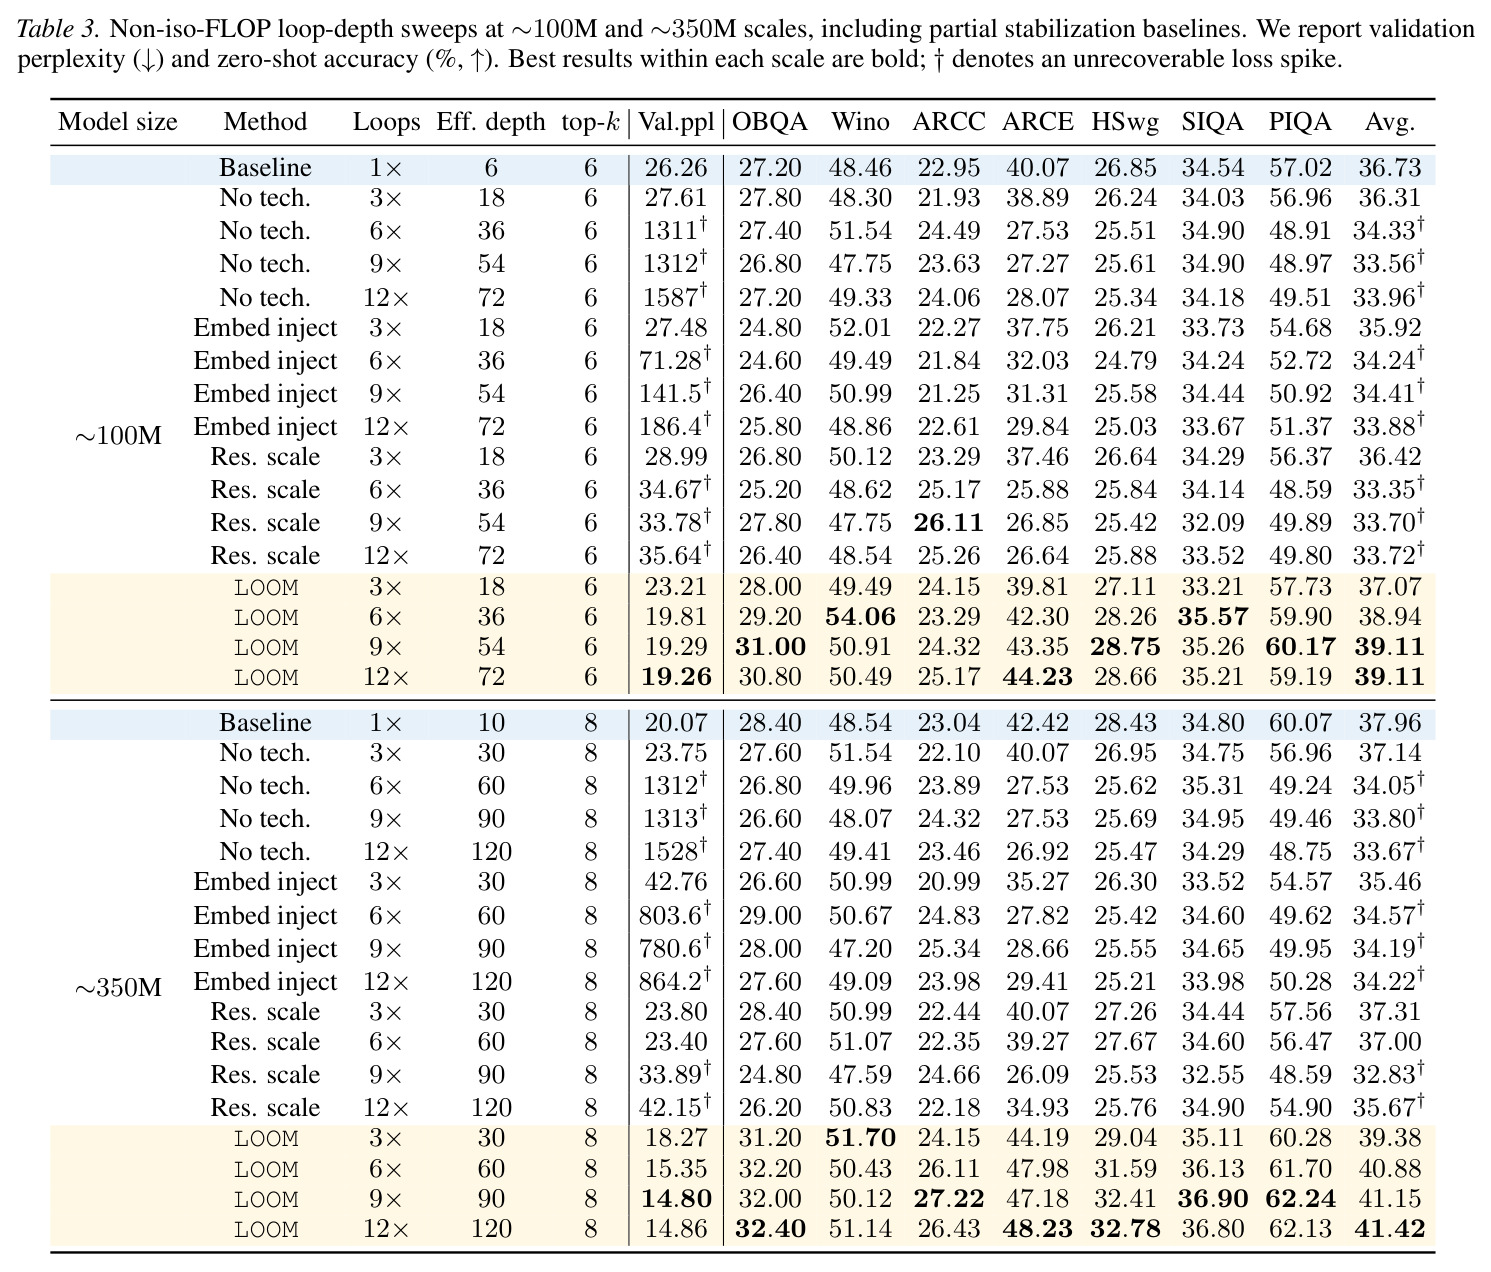
循环 Transformer 通过重复共享权重块增加有效深度,是独立于模型尺寸和数据量的新扩展轴,已被证明能改善算法推理、长度泛化与潜在推理。但当把它嫁接到大型 MoE 语言模型并在 FLOPs 对齐条件下比较时,收益迅速衰减甚至转为退化:已有循环 MoE 系统增加循环数往往导致损失上升,因此现有工作几乎都停留在两轮循环(如 SMELT 等研究认定 2 loops 最优)。作者诊断出两个根因。其一是「深度诅咒」:共享块被反复调用时残差更新不断累积,隐状态方差随循环数增长——Figure 3 显示未加稳定技术的 9 循环模型激活方差从约 1 飙升到 1000 以上,训练损失剧烈震荡甚至出现不可恢复的 loss spike,Table 3 中 100M 模型原生循环 6/9/12 轮时验证困惑度高达 1311/1312/1587。其二是「专家选择坍缩」:跨循环共享路由器时各轮几乎选中同一批专家,Figure 4 中共享路由的跨循环负载分布余弦相似度接近 0.88-1.00、专家负载标准差极低,额外迭代只是重复计算而非补充计算,增加循环深度只是增加了计算量而没有增加有效计算。
本文的目标是本文旨在回答一个核心问题:能否有效改善循环 MoE 的跨循环信息流,使循环深度稳定扩展到远超两轮的规模?具体而言,作者希望设计一个满足单一设计原则的配方——每一轮循环都贡献新的计算,同时保持循环状态的数值稳定;并在两种评测协议下验证循环深度是 MoE LLM 真实且计算高效的扩展轴:近等 FLOPs(与不循环基线计算量对齐,$f(H,k)=H(6+3k)\approx 84$)与非等 FLOPs(固定 MoE 布局、计算随 H 增长)。量化目标包括:在 100M-1.7B 参数、5B-60B token 的预训练规模上稳定训练 9-12 轮循环;等 FLOPs 下突破两轮限制做到 5 轮最优;不等 FLOPs 下让 1.7B 模型(60B token)相对 1 轮基线(困惑度 9.62、平均零样本准确率 42.4%)取得大幅提升,同时不牺牲显存与训练时间——借助分段反向传播把峰值显存控制在约 12.6 GiB、训练时间减半。
与已有工作不同的是,已有循环 MoE 探索各覆盖问题的局部:MoEUT 把 MoE 层嵌入 Universal Transformer,但未稳定整块结构的深度循环;Chain-of-Experts 在单层内部迭代专家而非循环复用共享 MoE 块;SMELT 研究计算对齐的 MoE 循环并把结论停在两轮;LoopMoE 只引入迭代自适应归一化。深度残差堆栈的稳定性研究(深度诅咒的 $1/\sqrt{l}$ 缩放、mHC 超连接、Attention Residuals、循环模型的 $\lambda/(H\sqrt{M})$ 缩放)也只在稠密或非 MoE 场景验证。本文的独特切入是先做系统性「病理诊断」再开药方:用激活方差曲线定位深度诅咒、用专家负载分布的跨循环余弦相似度定位路由坍缩,然后针对两个病灶分别给出稳定化(残差缩放 + 嵌入重注入)与多样化(逐环路由 + Looping Residual)两条互补轴,并配套分段反向传播解决工程可行性,最终形成一个完整、可跨规模零调整迁移的配方,而非单点技巧。
核心方法
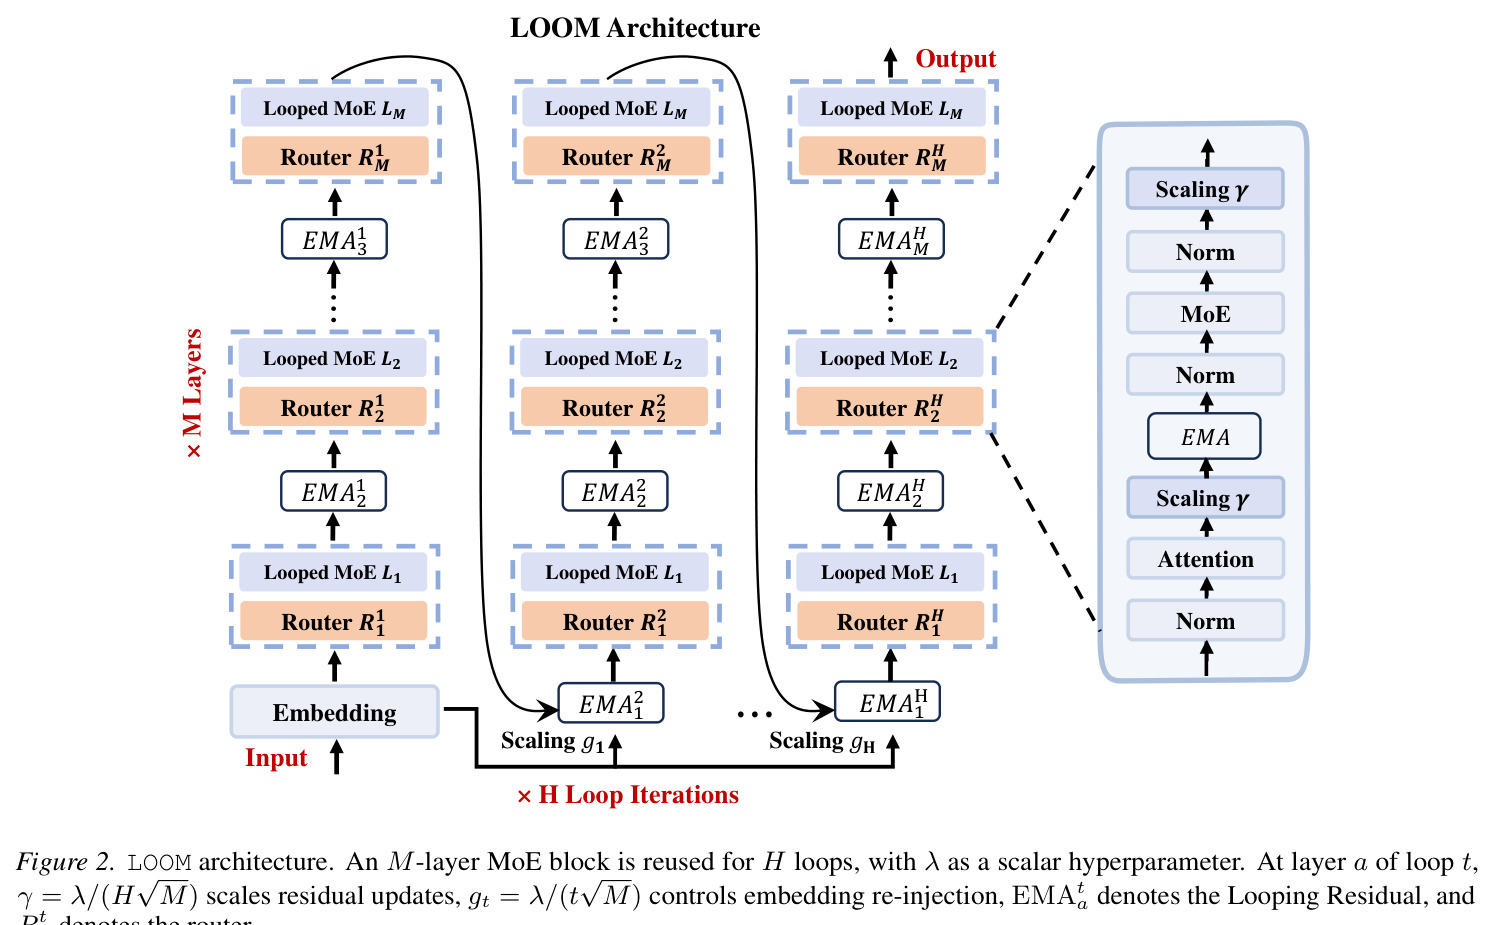
直觉上,LOOM 想让「重复使用同一组权重」变成「每轮做不同的有用功」:既要让循环状态数值上不爆炸、不漂移,又要让每一轮路由到不同的专家、并记住之前轮次的成果。技术上,LOOM 复用一个 M 层 pre-norm MoE 解码器 H 次,有效深度为 $M\times H$;注意力与专家权重跨循环共享,但每个循环配独立路由器(只增加路由参数,不复制专家)。稳定化方面:残差分支统一乘以 $\gamma=\lambda/(H\sqrt{M})$($\lambda=0.5$ 固定超参),其中 $1/H$ 约束跨循环累积、$1/\sqrt{M}$ 约束物理层间增长;同时从第 2 轮起以递减系数 $g_t=\lambda/(t\sqrt{M})$ 做凸组合重注入输入嵌入 $h_t^0=(1-g_t)h_{t-1}^M+g_t x$,防止输入信息被反复稀释、隐状态漂移。多样化方面:Looping Residual 用两条固定衰减 $\beta=0.5$ 的 EMA 记忆(跨全循环的全局记忆 + 每轮重置的局部记忆)聚合注意力输出,替代直接残差累加,让后续轮次在早前计算的基础上精炼。训练上采用 K=3 的分段反向传播,每段末做一次 LM 监督,段间以 stop-gradient 传递状态。
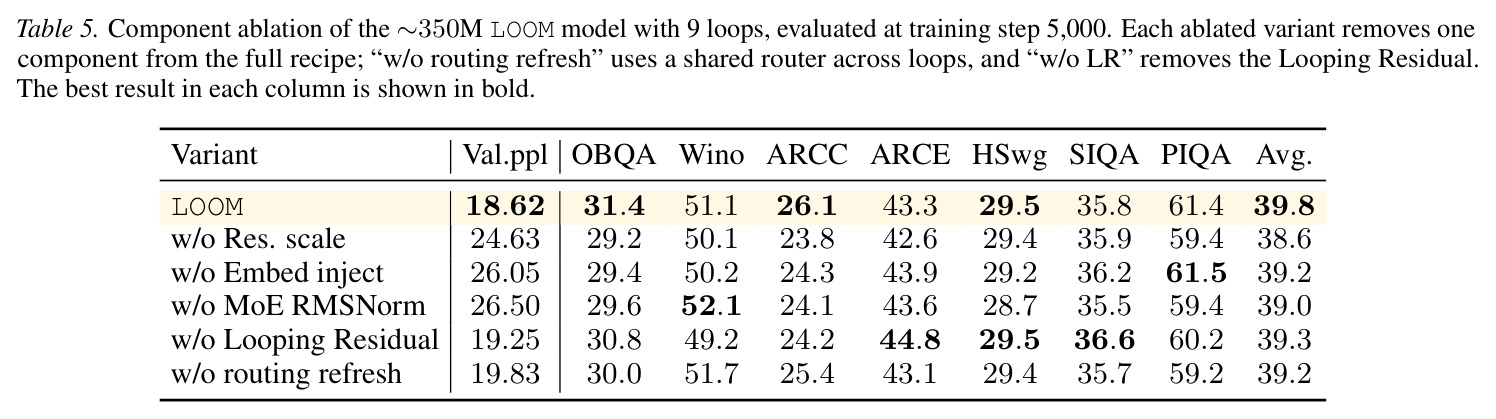
核心创新是把「深度循环失败」归因到两个可观测的病理并逐一对症下药,与已有方法的本质区别在于「完整配方 + 机制分工」。第一,残差缩放 $\gamma=\lambda/(H\sqrt{M})$ 中的 $1/H$ 因子专为循环维度设计,把跨循环残差累积的方差约束住,是对深度诅咒 $1/\sqrt{l}$ 缩放在循环 MoE 上的适配;第二,嵌入重注入系数 $g_t=\lambda/(t\sqrt{M})$ 随循环递减,使锚定信号在迭代间保持良好尺度——消融显示去掉它后 350M/9 轮的困惑度从 18.62 恶化到 26.05;第三,逐环路由器是针对「专家选择坍缩」的直接解法:专家共享而路由独立,Figure 4 证明独立路由使跨循环负载余弦相似度显著下降、专家负载标准差明显上升,每轮因此激活不同的专家组合;第四,Looping Residual 用递归 EMA $r_A=N_A/D_A$ 替代直接残差累加,只存一个累加张量和一个标量即可覆盖任意循环数,以可忽略开销让后续轮次「精炼」而非「覆盖」早前表示。分段反向传播则把以上机制在显存与时间上变得可行。
方法步骤详情
前向流程(Algorithm 1):输入 token 经嵌入得到 $x$,令 $h_1^0=x$,初始化全局 EMA 记忆 $(N_H,D_H)=(0,0)$,计算 $\gamma=\lambda/(H\sqrt{M})$。对每个循环 $t=1,\dots,H$:若 $t\ge 2$ 先做嵌入重注入 $h_t^0=(1-g_t)h_{t-1}^M+g_t x$($g_t=\lambda/(t\sqrt{M})$),并把局部记忆 $(N_L,D_L)$ 清零;随后对每层 $\ell=1,\dots,M$:计算缩放注意力输出 $o_t^{\ell}=\gamma\,\mathrm{Attn}_{\ell}(\mathrm{RMS}(h_t^{\ell-1}))$,同步更新两条 EMA($N_A\leftarrow\beta N_A+o_t^{\ell}$,$D_A\leftarrow\beta D_A+1$,$r_A=N_A/D_A$),用 $\hat{h}_t^{\ell}=h_t^{\ell-1}+r^H+r^L$ 替代直接残差累加,再由该循环专属路由器选择专家执行 MoE 更新 $h_t^{\ell}=\hat{h}_t^{\ell}+\gamma\,\mathrm{RMS}(\mathrm{MoE}_t^{\ell}(\mathrm{RMS}(\hat{h}_t^{\ell})))$。每当 $t\bmod K=0$ 或 $t=H$($K=3$)就用 LM 头对 $\mathrm{RMS}(h_t^M)$ 计算语言建模损失、反向传播并更新优化器,随后 $(h_t^M,N_H,D_H)$ 经 stop-gradient 进入下一段。配置见 Table 1:350M 取 M=10、30 路由 + 2 共享专家、top-8(6 路由 + 2 共享)、sigmoid 路由 float32、z-loss $10^{-3}$、容量因子 1.5。
技术新颖性
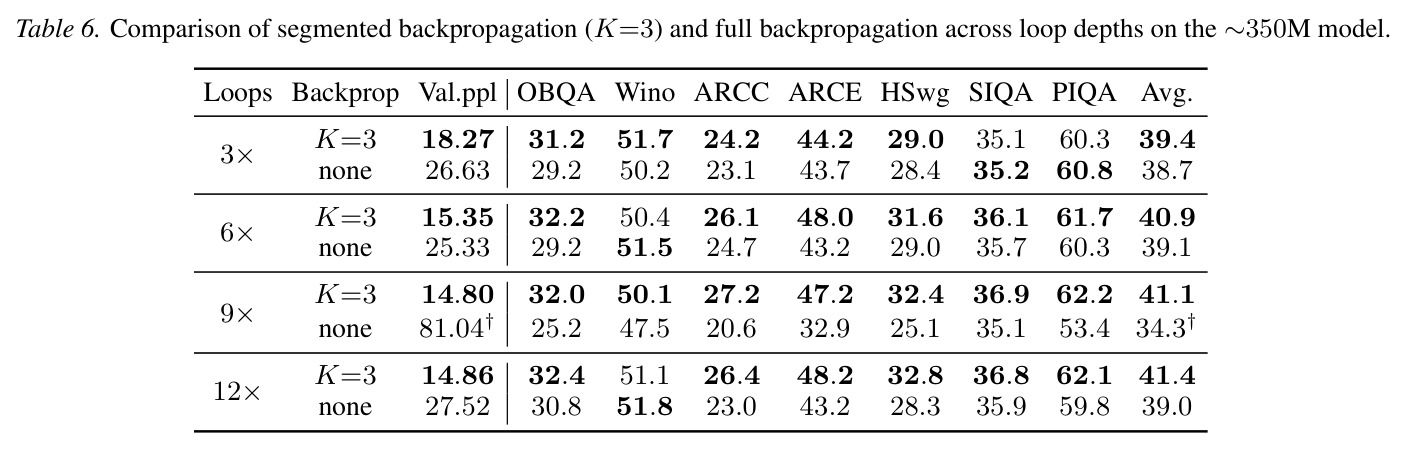
新颖性体现在四处。其一,把深度诅咒的逐层 $1/\sqrt{l}$ 缩放推广为循环感知的 $\lambda/(H\sqrt{M})$,同时约束「物理深度」与「循环次数」两个方差来源,且非可学习超参 $\lambda=0.5$ 在 100M-1.7B 间零调整迁移。其二,逐环路由 + 共享专家的解耦设计在参数上几乎免费(只增加 H 倍路由头),却把每轮计算从「重复」变为「互补」;Figure 4 的负载分布分析(余弦相似度 + 标准差热图)为此提供了此前工作没有的直接证据。其三,Looping Residual 的递归 EMA 公式以 $O(1)$ 存储(一个累加张量 + 一个归一化标量)实现跨任意循环数的指数加权聚合,区别于 Attention Residuals 等需要保存历史层输出的方案,每步仅需逐元素运算,几乎不增加显存与计算。其四,分段反向传播在段间截断梯度但保留前向信息流,使 H=12 时峰值显存从 19.3 GiB 降到 12.6 GiB、训练时间从 26.1 小时降到 12.6 小时,且比全反传更稳(9 轮全反传困惑度崩至 81.04)——把工程技巧变成了性能来源。
实验结果
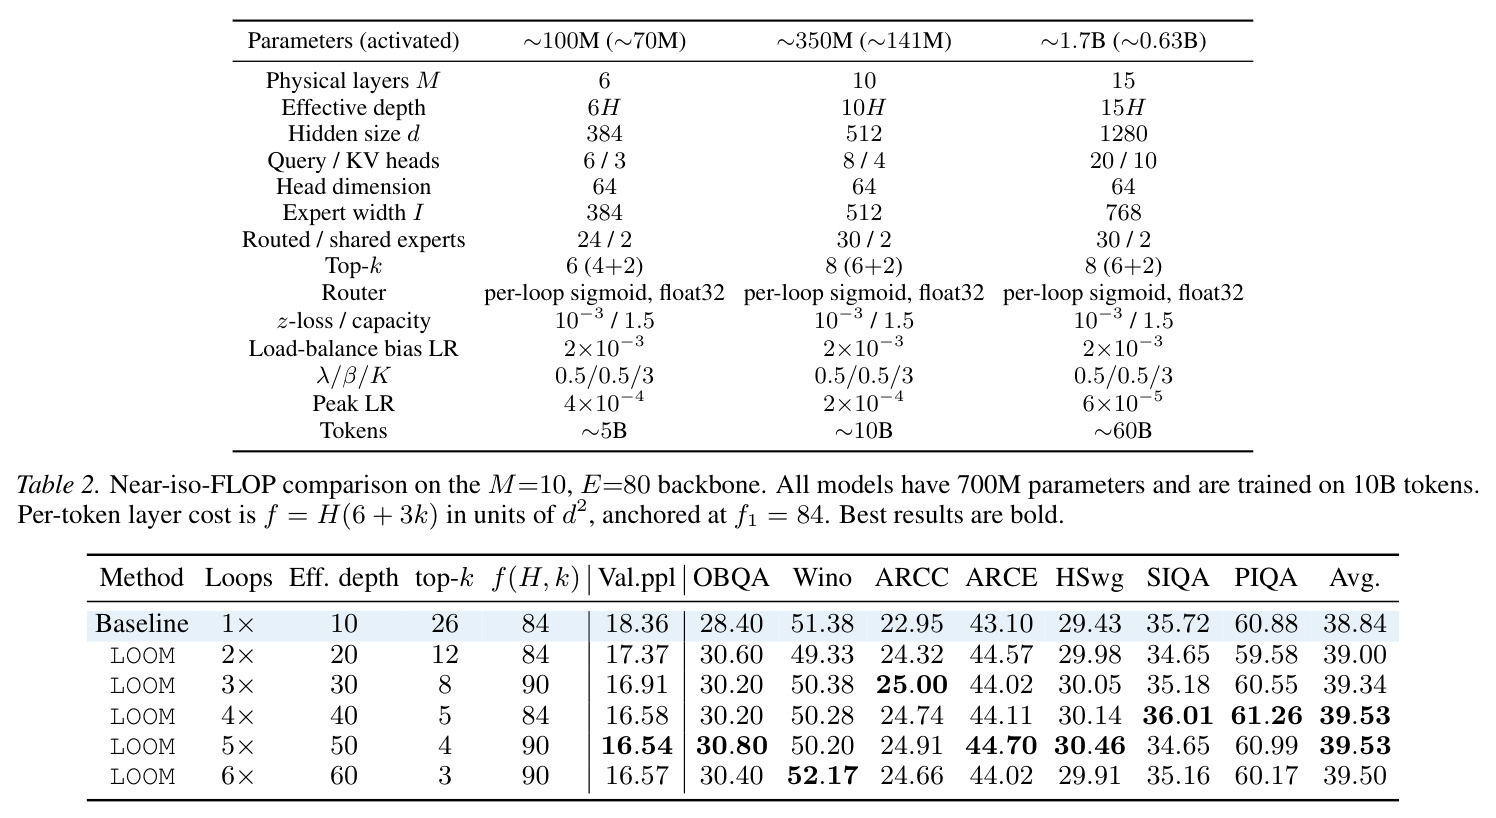
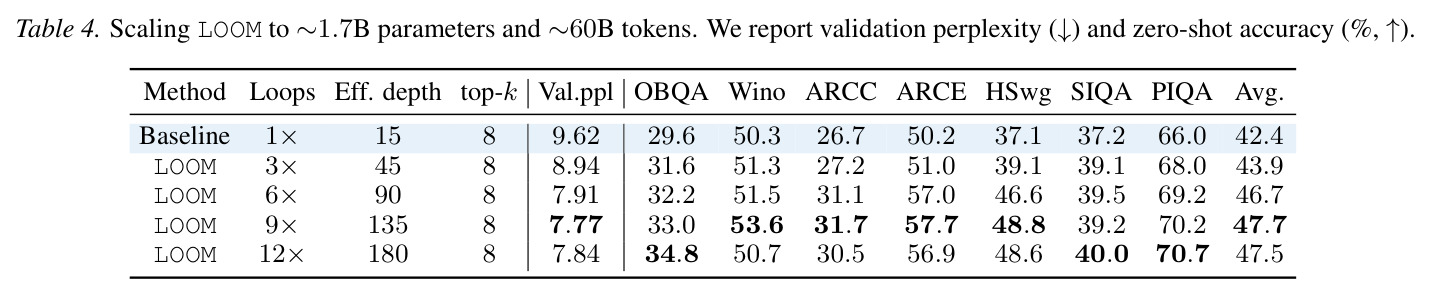
等 FLOPs 实验(Table 2,M=10、E=80、700M、10B token,$f(H,k)=H(6+3k)$ 锚定 84):基线 1× 困惑度 18.36、七任务平均 38.84%;LOOM 5× 最佳,困惑度 16.54、平均 39.53%(OBQA 30.80、ARC-e 44.70、PIQA 60.99),且 2×-6× 全部优于基线,证明等算力下循环可稳定扩展到 5 轮、远超两轮惯例。非等 FLOPs(Table 3):100M 上 LOOM 12× 困惑度 19.26(基线 26.26)、平均 39.11 vs 36.73;而原生循环 6/9/12× 直接发散(困惑度 1311/1312/1587),仅残差缩放或仅嵌入重注入也在 6× 起出现不可恢复 spike(33.78-864.2),部分基线甚至不如不循环,说明完整配方缺一不可;350M 上 LOOM 9× 困惑度 14.80(基线 20.07)、平均 41.15 vs 37.96。放大到 1.7B/60B token(Table 4):9× 最优,困惑度 9.62→7.77、平均 42.4%→47.7%(HellaSwag 37.1→48.8、PIQA 66.0→70.2),等效展开约 15B 参数,12× 饱和(7.84/47.5%)。消融(Table 5,step 5000):完整配方 18.62,去除残差缩放、嵌入重注入、MoE RMSNorm、Looping Residual、逐环路由后分别为 24.63/26.05/26.50/19.25/19.83,各组件均必要。分段反传(Table 6、Figure 5):H=12 时显存 12.6 vs 19.3 GiB、训练时间 12.6 vs 26.1 小时,各深度性能全面更优(9× 全反传困惑度崩至 81.04、平均跌至 34.3%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语言建模(等 FLOPs,FineWeb-Edu 验证集,700M/10B token) | 验证困惑度 (Val.ppl, 越低越好) | 16.54(LOOM 5× 循环) | 18.36(非循环基线 1×) | 降低 9.9% |
| 零样本常识推理 7 任务平均(700M 等算力) | 平均准确率 (%, 越高越好) | 39.53%(5× 循环) | 38.84%(1× 基线) | +0.69pp |
| 语言建模(1.7B/60B token,非等 FLOPs) | 验证困惑度 (Val.ppl, 越低越好) | 7.77(LOOM 9× 循环) | 9.62(1× 基线) | 降低 19.2% |
| 零样本常识推理 7 任务平均(1.7B/60B token) | 平均准确率 (%, 越高越好) | 47.7%(9× 循环) | 42.4%(1× 基线) | +5.3pp |
| 语言建模(350M/10B token,非等 FLOPs) | 验证困惑度 (Val.ppl, 越低越好) | 14.80(LOOM 9×) | 20.07(1× 基线);原生 9× 循环发散 | 降低 26.3% |
| 训练效率(350M,H=12,分段 vs 全反传) | 峰值显存 / 训练时间 | 12.6 GiB / 12.6 小时 | 19.3 GiB / 26.1 小时(全反传) | 显存 -34.7%,时间 -51.7% |
局限与改进
作者承认的局限:第一,收益随循环加深逐渐饱和——1.7B 上 12×(困惑度 7.84、平均 47.5%)不再优于 9×(7.77/47.7%),等 FLOPs 下 6× 也停止改善,说明循环数存在与数据/模型规模耦合的上限;第二,等 FLOPs 协议靠缩小 top-k(从 26 降到 3-4)来对齐计算 $f(H,k)\approx 84$,这同时改变了专家粒度与路由容量,可能部分混淆循环本身的收益;第三,等 FLOPs 下下游零样本提升较温和(+0.69pp),主要收益集中在困惑度。我自己的观察:其一,循环是串行的,推理时延随 H 线性增长,论文只报 NPU 训练显存与时长、未报推理延迟与吞吐;其二,分段反传每段引入额外 LM 头监督,实质是截断 BPTT 变体,对目标函数的改变缺少理论分析,K=3 也未系统扫参;其三,评测只有 7 个常识推理任务的零样本准确率,未覆盖 MMLU 等知识型任务与长上下文;其四,全部实验基于 FineWeb-Edu 单一语料、序列长 1024,跨域泛化未经检验;其五,Table 5 消融在训练早期(step 5000)评估,组件贡献的长期排序可能不同。
独立分析的弱点
弱点一:串行推理延迟。H 轮循环使前向计算在时间上串行 H 倍,等 FLOPs 只保证总计算量而非墙钟延迟,对首 token 延迟敏感的在线场景可能不友好,而论文完全没有测推理延迟。改进方向:逐 token 早退(隐藏态收敛即提前输出)、循环间投机跳过或跨请求流水并行。弱点二:等 FLOPs 设置把 top-k 从 26 压到 3-4,专家激活数剧烈变化,性能收益可能部分来自路由稀疏度改变而非深度本身;应补充固定 top-k、按比例调宽度的对照组。弱点三:分段反传的段级 LM 监督会鼓励模型在浅段就形成可用表示,可能与深层精炼目标冲突,K 仅取 3 缺乏消融;建议扫 $K\in\{1,2,4,6\}$ 并分析各段损失权重的影响。弱点四:「专家选择坍缩」的度量只用负载分布余弦相似度与标准差,未证明各轮学到语义上不同的子计算,可用专家激活的功能探针或下游任务归因进一步验证。弱点五:规模上限 1.7B/60B token,循环数-数据量-参数量的缩放律未拟合,实际选型(相同预算该买宽度还是买循环)缺乏指导;1.7B 上 12× 的轻微退化也未给出机理解释。
未来方向
作者方向:把循环深度与测试时计算/潜在推理结合(Saunshi、Geiping 等已证明循环有利于 latent reasoning),探索训练浅、推理深的自适应循环;在更大参数与更长 token 上检验 9-12 轮是否继续抬升上限。基于成果可延伸的方向:其一,逐 token 自适应循环数——用轻量控制器或熵准则决定每个 token 循环几次,把等 FLOPs 优势转化为选择性计算;其二,与密集模型缩放律联合建模,回答「相同预算下循环 vs 宽度 vs 数据」的资源分配问题;其三,把逐环路由与专家功能分化(如每轮微调专家子集、专家级 LoRA)结合,进一步压制路由坍缩;其四,将 Looping Residual 的固定 $\beta=0.5$ 改为可学习或逐层参数,并与 mHC、Attention Residuals 等残差重设计路线做系统比较;其五,在长上下文(RoPE 外推)、指令微调与 RLHF 后训练中检验循环结构的稳健性;其六,从理论上刻画 $\gamma$、$g_t$ 与隐状态方差界的解析关系,为循环数选择提供先验而非网格搜索。
复现评估
复现条件较好。论文给出 Algorithm 1 完整伪代码与 Table 1 全部超参(各规模的 M/H/隐藏维/专家数/top-k、峰值学习率 $4\times 10^{-4}$、$2\times 10^{-4}$、$6\times 10^{-5}$、WSD 10/80/10 调度、全局 batch 1024、AdamW $\beta_1=0.9$、$\beta_2=0.95$、权重衰减 0.1、梯度裁剪 1.0、z-loss $10^{-3}$、$\lambda=\beta=0.5$、K=3),摘要附代码链接(LOOM 仓库),训练数据 FineWeb-Edu 公开,评测的 7 个任务均为标准 lm-eval 套件任务且注明了 acc/acc_norm 选择。算力方面:100M-350M、5-10B token 的等 FLOPs 与消融实验单节点级加速器即可复现(论文显示 350M/10B 分段训练约 12.6 小时);1.7B×60B token 需要集群(实验在 NPU 上进行)。风险点:分段反传的段内优化器步进与微批次细节、NPU 特定优化可能造成跨硬件差异;代码是否包含全部三种规模的配置需确认。总体难度中等:小规模实验门槛低、复现价值高,大规模实验需要可观预算。
论文图表
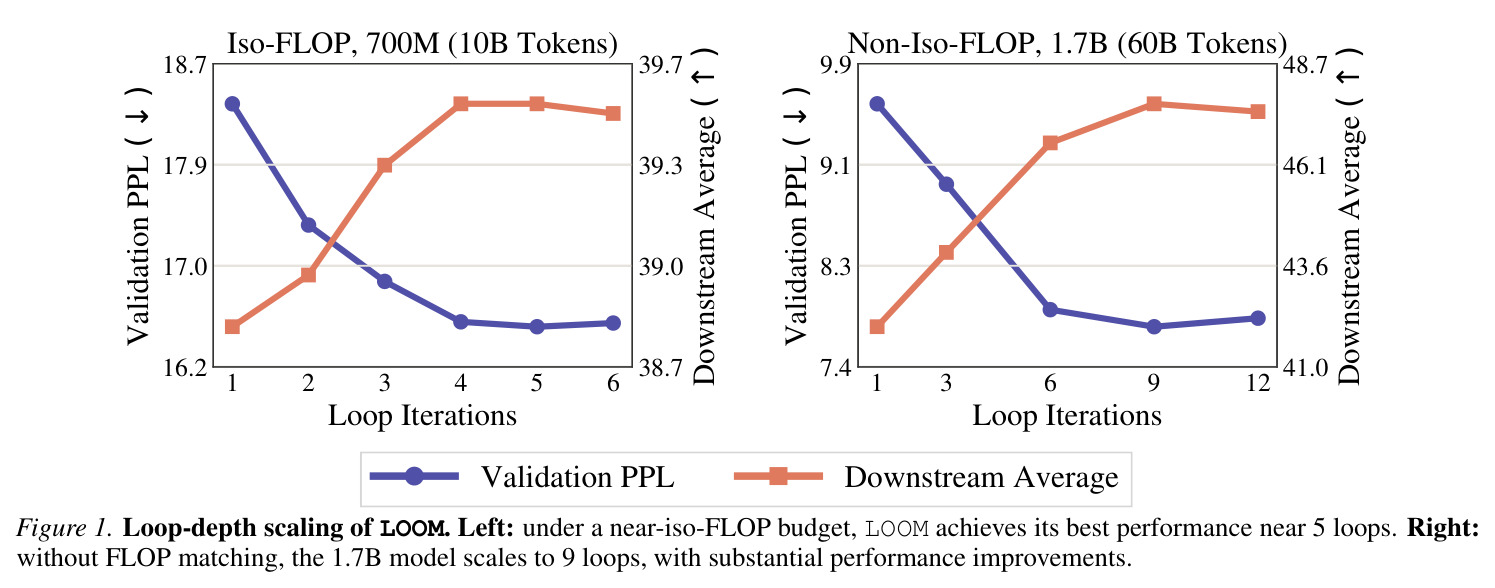
双栏折线图总结全文核心结论。左图:700M 模型、10B token 的近等 FLOP 预算下,验证困惑度(PPL,向下越好)与七任务下游平均(向上越好)随 1-6 轮循环的变化,5 轮时 PPL 达 16.54、平均准确率 39.53% 为最佳点。右图:1.7B 模型、60B token、不做 FLOP 匹配时,1/3/6/9/12 轮的表现,9 轮时 PPL 7.77、平均 47.7% 达到峰值。
这是论文的「成绩单」:一张图同时回答「循环深度能否扩展」和「最优循环数是多少」两个核心问题,并分别展示等算力与非等算力两种协议下的不同结论(5 轮 vs 9 轮),是全文主张的最直观概览。
350M 模型在 3/6/9/12× 循环下分段反传 vs 全反传的对比:分段反传困惑度依次 18.27/15.35/14.80/14.86,全反传为 26.63/25.33/81.04(†)/27.52;9× 全反传出现不可恢复 spike 且平均准确率跌至 34.3%,各深度下分段的七任务平均均高出 0.7-6.8pp。
证明分段反传不仅省显存还显著提升稳定性与性能,解释了非等 FLOPs 主实验默认采用 K=3 的原因,对复现者是最关键的训练配置决策。