对数线性复杂度的块稀疏注意力 Block Sparse Attention with Log-Linear Complexity
用键金字塔逐层LSE筛选,把块稀疏注意力的选择开销从O(N²/C)降到O(N log N)
前置知识
自注意力的二次复杂度
标准 Transformer 中每个 token 的 query 要与全部 $N$ 个 key 做点积并归一化,注意力矩阵大小为 $N\times N$,计算与显存随序列长度平方增长。这是长上下文建模的根本瓶颈,训练时预填充尤其昂贵。
本文要解决的核心问题就是把这个二次开销压下来,理解瓶颈来源才能理解稀疏化的动机。
块稀疏注意力(BSA)
把 key/value 序列切成大小为 $C$ 的连续块,每个 query 只选出 $K$ 个相关块,在选中块的原始 K/V 上计算注意力。由于硬件友好的分块矩阵乘,注意力阶段可降到线性,但选择阶段要对全部 $M=\lceil N/C\rceil$ 个块打分。
PISA 是 BSA 的改进版,本文所有对比基线(NSA、MoBA、HiLS)都是块稀疏注意力家族的成员,必须先理解这个框架。
Top-K 块选择
为每个 query 计算它与每个块摘要的相关分数(如点积 $q_t^\top \bar{k}_i/\sqrt{d}$),保留分数最高的 $K$ 个块。常规做法要扫描所有块,选择复杂度为 $O(N^2/C)$,是稀疏注意力在长序列下残留的二次瓶颈。
PISA 的全部创新就在于把这一步从'全量打分'改为'金字塔逐层有界打分',这是论文标题中 log-linear 的来源。
LogSumExp(LSE)
函数 $\log\sum_j \exp(z_j)$,是 $\max_j z_j$ 的平滑上界。对块内各 key 的 logits 取 LSE,近似等于该 query 落入这个块的注意力质量的 log 域表示。泰勒展开给出 $\log m + \bar{z} + \tfrac{1}{2}\mathrm{Var}(z)+\cdots$,即均值加方差修正。
LSE 是 PISA 的打分函数:叶子块用原始 key 的精确 LSE,中间层用子块摘要的 LSE,论文用它解释为何选择质量高于均值打分。
GQA 分组查询注意力
多个 query 头共享同一个 KV 头以压缩 KV 缓存,每组内 $G_Q$ 个 query 头对应 1 个 KV 头。块选择时同组 query 头共享同一组选中块,LSE 分数在组内求和后做 Top-K。
论文的内核设计(跨头求和式 22、IO 分析中的 $G_Q=16$)都建立在 GQA 结构上,不理解它就看不懂 Algorithm 1。
Triton 与 IO 感知内核
Triton 是面向 GPU 的 tile 级编程语言,适合写融合 kernel。IO 感知设计关注 HBM 与 SRAM 之间的数据搬运量:长序列下加载 Q/K 的访存开销往往超过计算本身,通过 kernel 融合与数据复用(如一个 key tile 服务多个 query)可大幅降耗。
PISA 的两阶段/单阶段内核选择完全由 Q/K IO 代价公式(式 25–31)驱动,这是效率实验 9.95 倍加速的基础。
研究动机
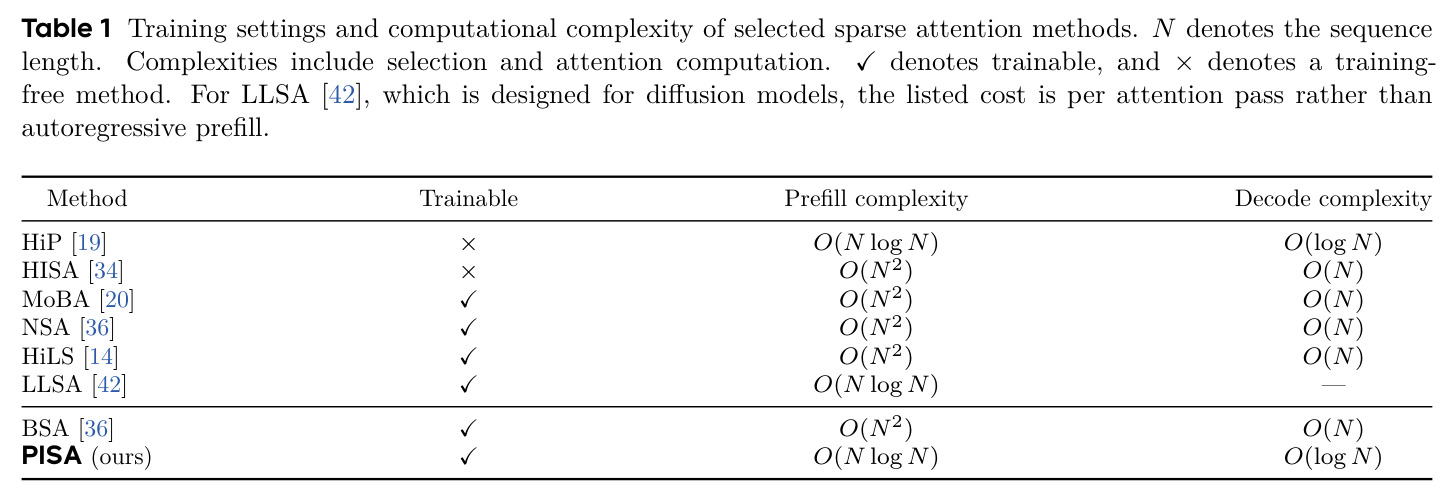
自注意力的计算量随序列长度 $N$ 呈 $O(N^2)$ 增长,长上下文训练与推理代价高昂。块稀疏注意力把键值切成大小为 $C$ 的连续块、每个 query 只对 $K$ 个选中块算注意力,注意力阶段能降到线性,但常规 Top-K 选择要求为每个 query 与全部约 $N/C$ 个候选块逐一打分,选择阶段仍是 $O(N^2/C)$,成为长序列下的主要计算瓶颈。论文 Table 1 显示,可训练的稀疏方法 MoBA、NSA、HiLS、BSA 的预填充复杂度全是 $O(N^2)$,只有训练免的 HiP 做到了 $O(N\log N)$。此外,单层打分用均值池化或学习投影的摘要做点积,与块内真实注意力质量有偏差,导致稀疏方法在 RULER 等长上下文检索任务上普遍明显落后于全注意力。
本文的目标是本文的目标是设计一种可训练的块稀疏注意力机制,把 Top-K 块选择阶段本身的复杂度从 $O(N^2/C)$ 降到预填充 $O(N\log N)$、解码每步 $O(\log N)$,同时保持与 BSA、NSA、HiLS 相当的语言建模和常识推理性能,并在检索类任务(containment 与 RULER needle-in-a-haystack)上优于这些稀疏基线。方法必须在真实预训练中可训练(区别于训练免的 HiP),并配备训练/预填充与解码两套硬件感知的 Triton 内核,使得在 256K token 的选择基准上能取得数量级的延迟优势。
与已有工作不同的是,已有层级式漏斗选择(HiP)是训练免的采样式方法,而可训练的 NSA/MoBA/HiLS/BSA 都停留在单层全量打分。本文的独特切入是把'层次化候选收窄'与'有理论动机的分数聚合'结合起来:用均值池化构造 $O(\log N)$ 层的键金字塔,每层只在不超过 $gK$ 个候选上打分;打分函数不是普通点积,而是子块 logits 的 LogSumExp——它恰好是块内注意力质量的软上界,泰勒展开可分解为一阶均值与二阶方差修正的组合(式 32–34),从而同时给出 PISA-1/PISA-2 两个可对照的消融变体,把'为什么 LSE 打分更准'变成可实证的问题。
核心方法
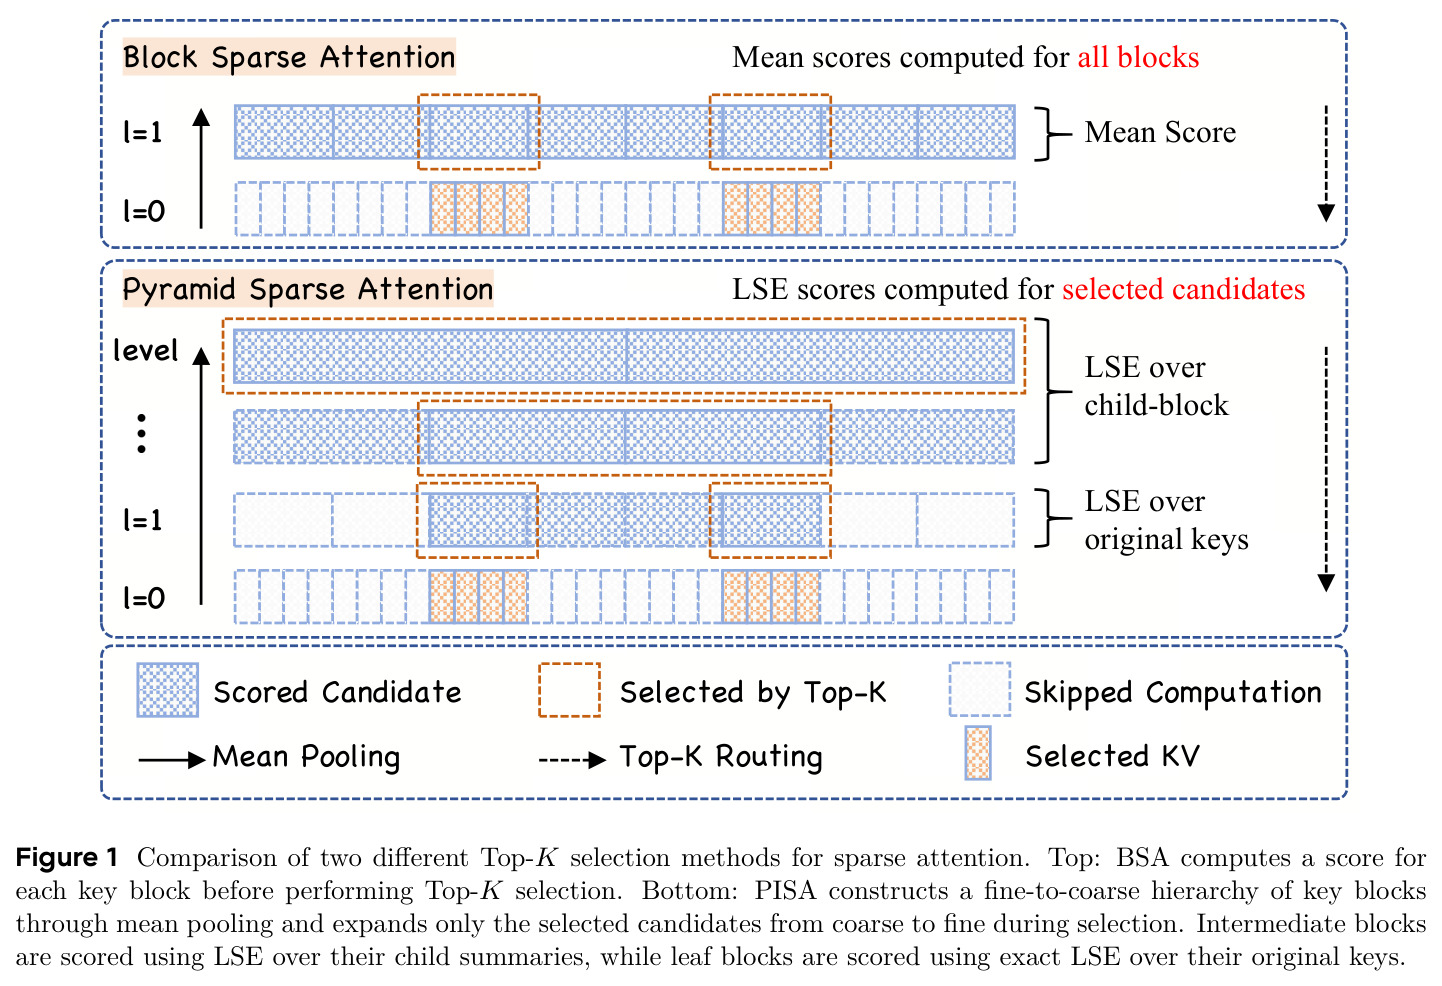
直觉上,与其让每个 query 扫描全部 $\lceil N/C\rceil$ 个叶子块,不如先在极粗粒度上淘汰掉大部分序列,再逐层细化,每一层只检查上一层幸存者的孩子。技术上,PISA 先把 level 0 的 $N$ 个原始 key 以 $g_0=C=64$ 聚合成 level 1 的叶块,此后每层把 $g=2$ 个相邻块聚成一块并做均值池化得到摘要 $\bar{k}^{(\ell)}_i$(式 10–15),共 $O(\log N)$ 层。选择从最粗层 $A^{(L)}_t=\{1\}$ 出发:每层对不超过 $gK$ 个候选计算 LSE 分数,SelectK 保留 $K$ 个,把它们展开成子块作为下一层候选(式 16–20),直到 level 1 得到叶块索引集 $I_t$,最后在选中块的原始 K/V 上算注意力。由于每层候选数有界,单 query 路由代价 $O(\log N)$,$N$ 个 query 的预填充总代价 $O(N\log N)$,解码每步 $O(\log N)$。实现上用 Triton 写了训练/预填充的两阶段内核和解码的单阶段融合内核,GQA 组内 query 头共享所选块。
核心创新是把选择阶段本身从 $O(N^2/C)$ 降为 $O(N\log N)$,手段是'有界候选集 + LSE 层次打分'。与 BSA/NSA/MoBA 的本质区别在于:后者每个 query 都要对全部 $M=\lceil N/C\rceil$ 个块打一遍分;PISA 每层只对至多 $gK$ 个候选打分,候选数与 $N$ 无关,被淘汰的块整体跳过。打分函数同样关键:候选块 $K^{(\ell)}_i$ 的分数是其孩子 logits 的 LogSumExp,$s^{(\ell)}_{t,i}=\log\sum_{r\in Ch_{\ell-1}(i)}\exp(q_t^\top \bar{k}^{(\ell-1)}_r/\sqrt{d})$(式 21)。对叶子层,$\bar{k}^{(0)}_r=k_r$ 即原始 key,LSE 正是该 query 落入此块的注意力质量的 log 域度量;对中间层则用孩子摘要近似。泰勒展开 $s=\log m+\bar{z}+\tfrac{1}{2}\mathrm{Var}(z)+\cdots$ 表明均值打分(BSA 式)只是 LSE 的一阶截断,方差项捕捉'块内是否有尖锐高分',这正是层级路由需要的信息。
方法步骤详情
第一步建金字塔:level 0 是 N 个单 key,以 $g_0=C=64$ 聚出 $M_1=\lceil N/C\rceil$ 个叶块,此后每层 $g=2$ 相邻聚合,摘要 $\bar{k}^{(\ell+1)}_i=\frac{1}{|Ch_\ell(i)|}\sum_r \bar{k}^{(\ell)}_r$,共 $O(\log N)$ 层。第二步训练/预填充两阶段内核(Algorithm 1):Stage 1 从最粗层开始,每个程序加载 GQA 组 $H(h)$ 内全部 query 向量一次,逐层对候选算 LSE、按 $u^{(\ell)}_{h,t,i}=\sum_{h'\in H(h)} s^{(\ell)}_{h',t,i}$ 跨头求和后 SelectK,并把幸存块展开为子块,候选索引全程留在程序内,不物化 query–key 分数矩阵;Stage 2 把需要对同一叶块打分的 query 聚簇并切成 $Q_{tile}=4$ 的 tile,每个 key 块只加载一次、被 tile 内约 64 个 query 复用,算精确 LSE 后由独立 kernel 做最终 Top-K。第三步解码用单阶段融合内核:金字塔缓存只增量更新新 token 的叶均值及其祖先路径,一个内核走完所有层级直达叶块,避免多次 kernel 启动。第四步在选出的至多 $K$ 个叶块的原始 K/V 上做注意力输出。IO 分析给出两阶段叶层 Q/K 代价 $O(NgKdG_Q + NCgKd/Q_{tile})$,在 $G_Q+C/Q_{tile}=16+16=32<C=64$ 时优于单阶段的 $O(NgKCd)$,这解释了两种内核的分工。
技术新颖性
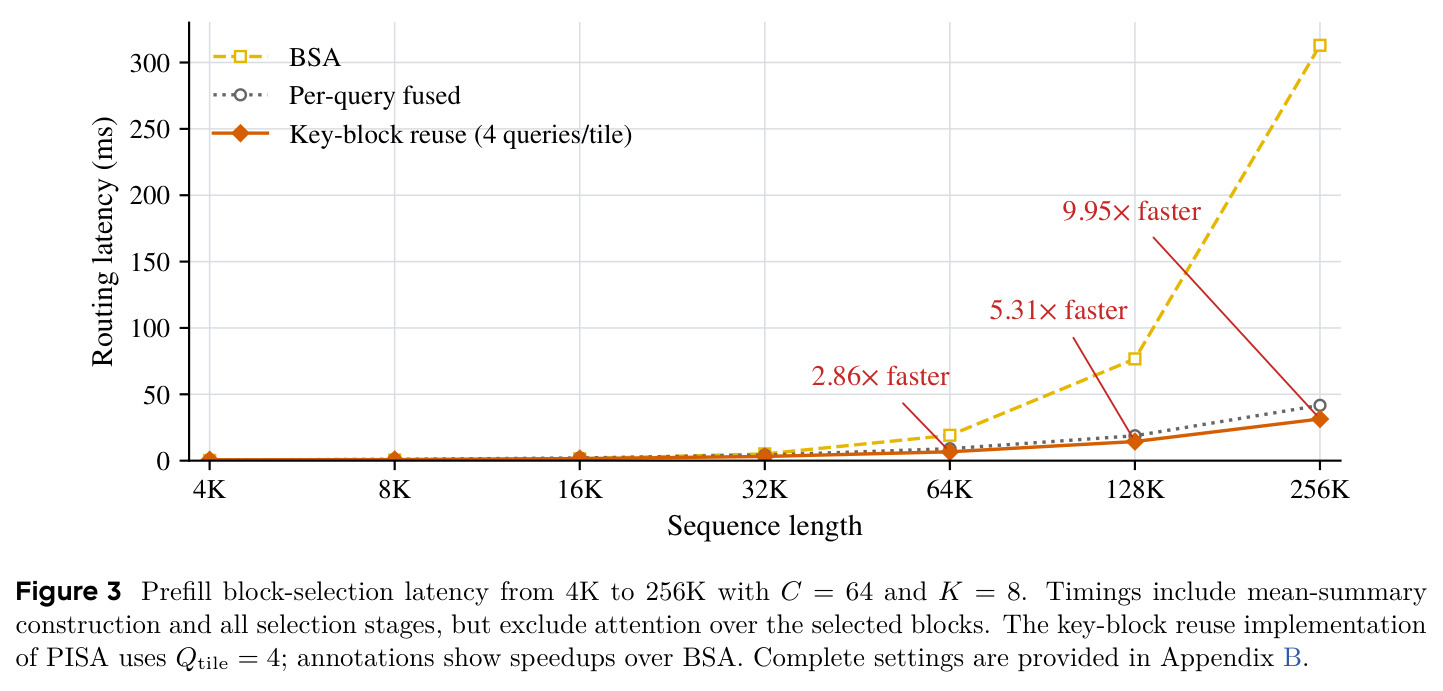
新颖性有三层。算法层面:把 HiP 式的层级漏斗首次做成可训练、能进预训练的块稀疏注意力,预填充 $O(N\log N)$ 优于 MoBA/NSA/HiLS/BSA 的 $O(N^2)$,解码 $O(\log N)$ 与 HiP 持平但支持训练(Table 1 中 trainable 且 $O(N\log N)$ 的只有 PISA 和面向扩散模型的 LLSA)。打分函数层面:用子块 logits 的 LSE 做块分数,而非均值池化点积或学习投影,LSE 有'块内注意力质量软上界'的概率解释,配套泰勒展开的方差修正视角和 PISA-1/PISA-2/PISA 三级消融,把设计选择变成可验证的科学问题。系统层面:两阶段与单阶段内核的选择基于显式的 Q/K IO 代价推导(式 25–31),跨 query 复用 key tile、跨头复用 query 加载,在 256K 序列上比 BSA 的选择快 9.95 倍;与 NSA 不同,PISA 不需要额外学习压缩分支,全部金字塔由均值池化免费得到。
实验结果
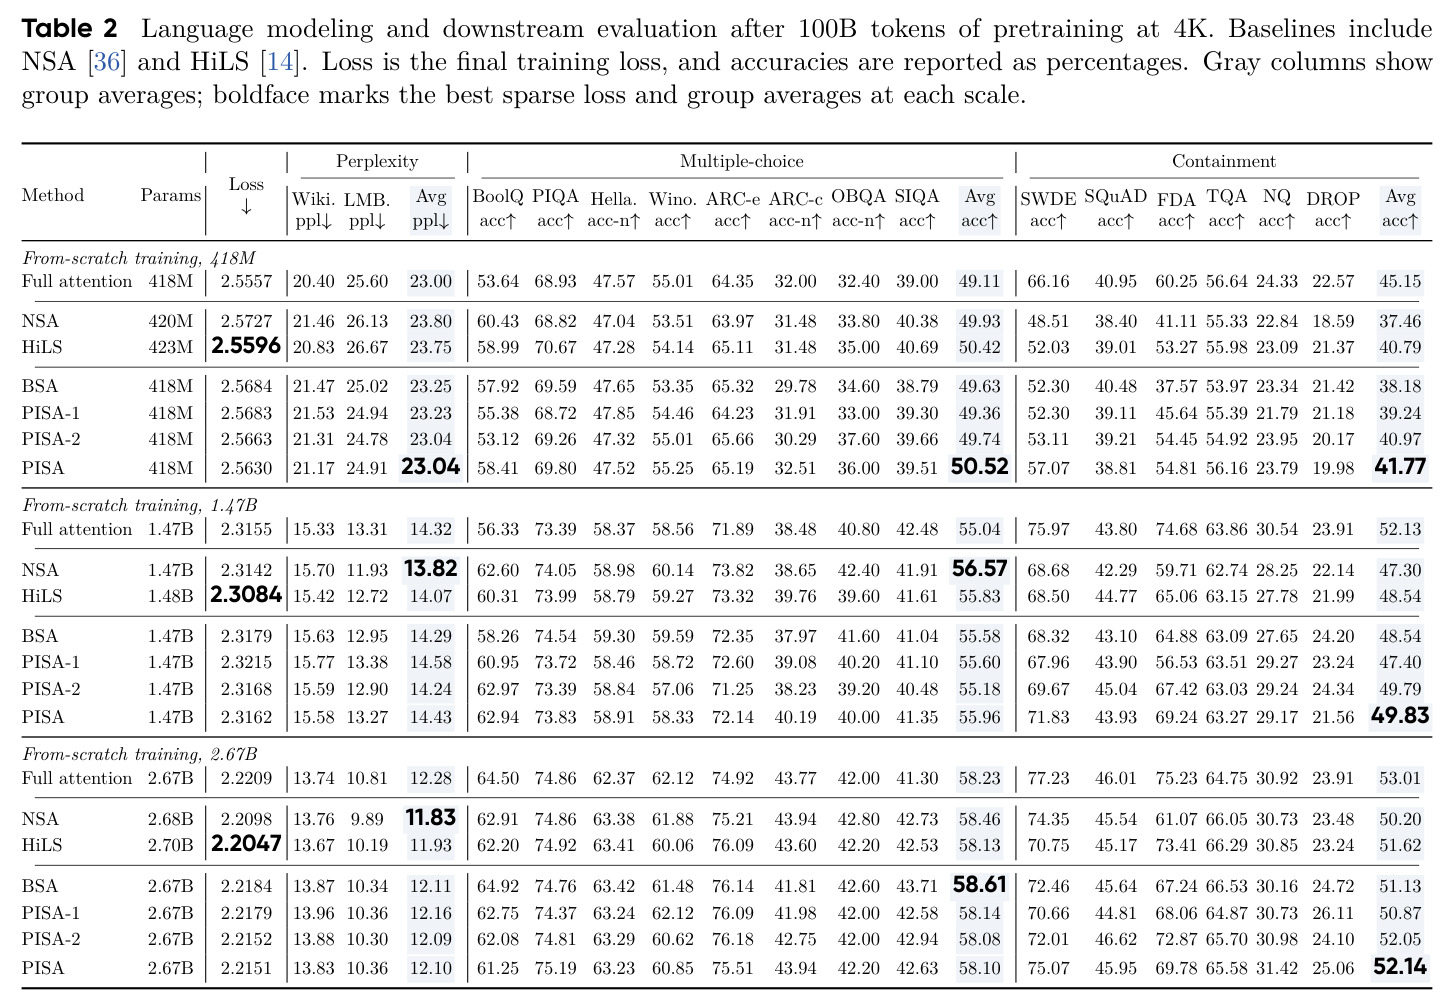
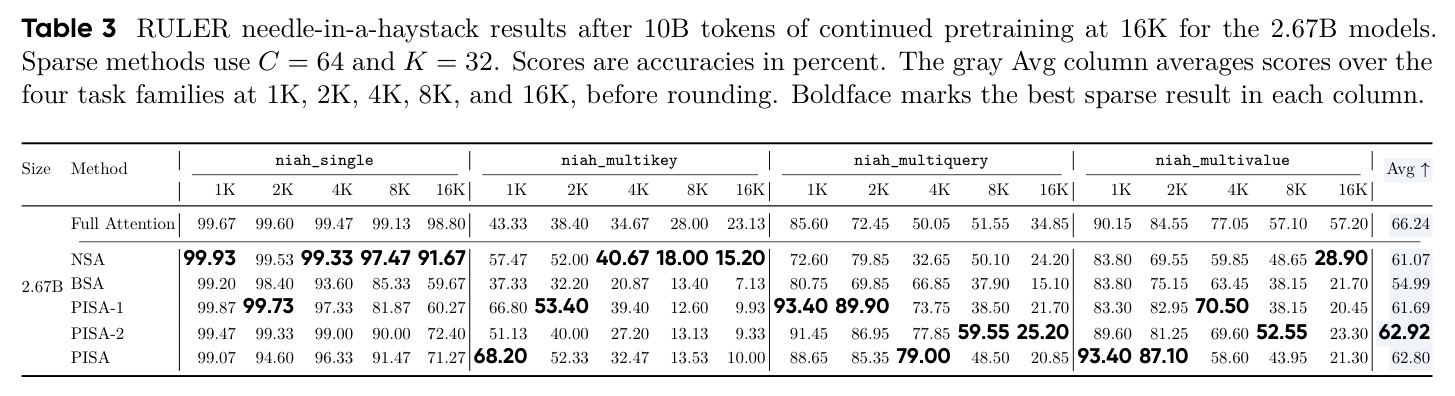
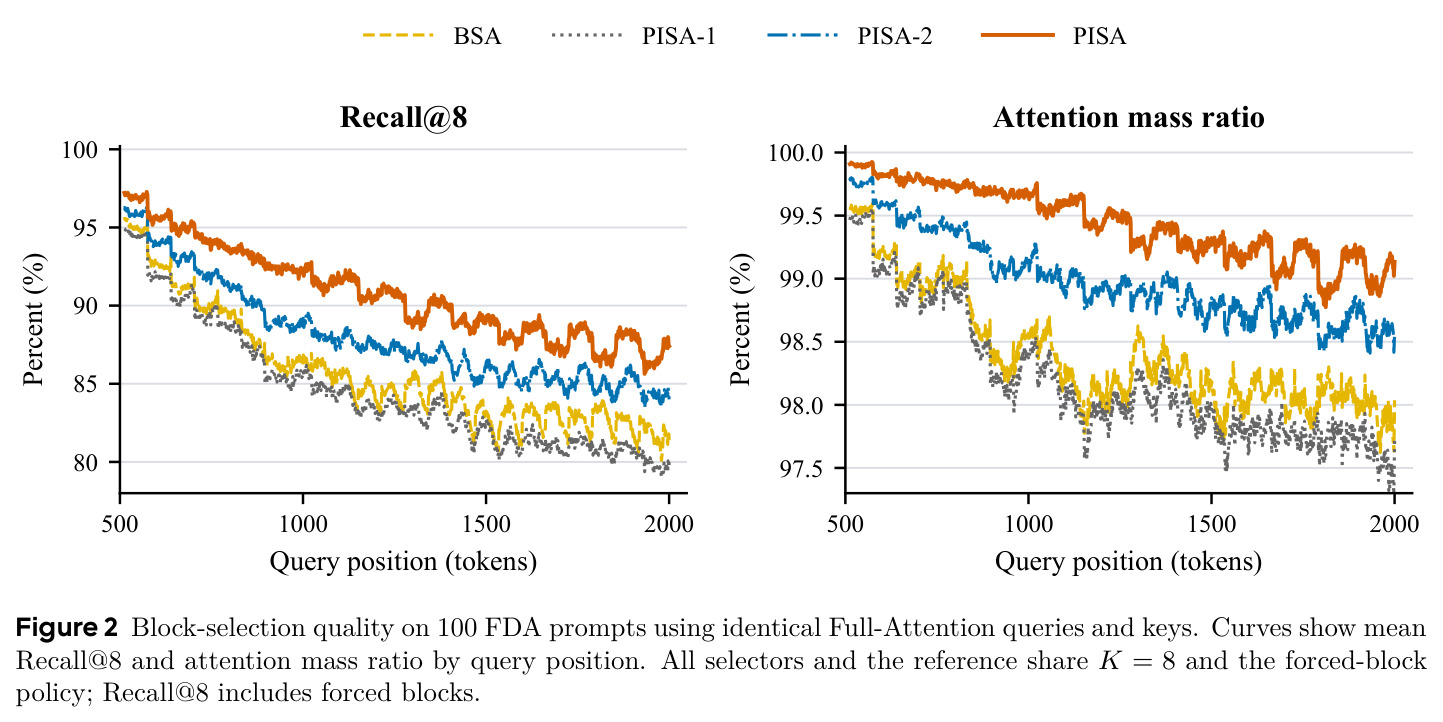
①语言建模(Table 2,418M/1.47B/2.67B 各预训练 100B token@4K):PISA 训练损失为 2.5630/2.3162/2.2151,优于 BSA(2.5684/2.3179/2.2184)与 PISA-1/PISA-2,2.67B 时略逊于 NSA 的 2.2098;常识推理平均与稀疏基线持平(2.67B:PISA 58.10 对 NSA 58.46、HiLS 58.13);containment 六任务平均在三档规模均为稀疏最高:41.77/49.83/52.14,2.67B 超 HiLS 51.62、BSA 51.13、NSA 50.20,但仍低于全注意力 53.01。②消融:完整 LSE 在三档规模的损失与 containment 平均均超一阶 PISA-1(均值打分)与二阶 PISA-2(均值+½方差),支持 LSE 高阶项的价值。③长上下文(Table 3,CPT 10B token@16K,RULER 四类 niah):PISA 平均 62.80,为稀疏最好之一(PISA-2 62.92、NSA 61.07、BSA 54.99),逼近全注意力 66.24;niah_multiquery@4K 达 79.00 对 NSA 32.65。④选择质量(Figure 2,100 条 FDA 提示、K=8):PISA 的 Recall@8 与注意力质量保持率随 query 位置全程最高。⑤效率(Figure 3,C=64、K=8):64K/128K/256K 下选择延迟比 BSA 快 2.86×/5.31×/9.95×,Q4 实现再快约 1.3×;但 4K–16K 区间 BSA 仍更快。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 预训练语言建模(2.67B,100B token@4K) | 最终训练损失 | 2.2151 | BSA 2.2184 / NSA 2.2098 / HiLS 2.2047 | 损失低于 BSA,与 NSA/HiLS 相当(后两者略低) |
| Containment 六任务平均(2.67B) | 平均准确率 (%) | 52.14 | BSA 51.13 / HiLS 51.62 / NSA 50.20 / Full 53.01 | 稀疏方法中最高,比 NSA 高 1.94 个百分点 |
| RULER niah 平均(2.67B,1K–16K) | 平均准确率 (%) | 62.80 | BSA 54.99 / NSA 61.07 / Full 66.24 | 比 BSA 高 7.81 个百分点,逼近全注意力 |
| 预填充块选择延迟(256K 序列,C=64, K=8) | 延迟加速比 | 9.95× 于 BSA | BSA 单层选择 | 256K 时近 10 倍,128K 5.31×,64K 2.86× |
| 块选择质量(100 条 FDA 提示) | Recall@8 与注意力质量保持率 | 全程最高(曲线领先) | BSA / PISA-1 / PISA-2 | LSE 打分的选择与全注意力参考块重叠度和质量保持均最佳 |
局限与改进
作者坦承的局限:中短序列(4K–16K)上 BSA 的单层选择更快,PISA 的层级路由收益要到 64K 以上才显现;containment 平均仍落后全注意力(2.67B:52.14 对 53.01);16K 的 niah_single 上 PISA 只有 71.27,明显低于全注意力 98.80,niah_multikey@16K 仅 10.00 对全注意力 23.13,说明深层漏斗在超长精确检索上有漏检风险。我的补充观察:实验止步 2.67B 和 16K CPT,未验证更长时间或 100K+ 上下文的训练稳定性;Table 3 中 PISA-2 平均 62.92 略高于完整 LSE 的 62.80,LSE 的优势并非在所有设置下稳定;效率基准只测选择阶段延迟,未报告端到端预填充/解码 wall-clock;金字塔要求块对齐,难以表达任意跨度依赖;解码 $O(\log N)$ 依赖缓存祖先路径的增量一致性,论文未做相应消融。
独立分析的弱点
第一,深层漏检不可恢复:粗层 Top-K 一旦丢掉含关键信息的块,下层无从挽回,16K niah_single 的 71.27% 和 multikey@16K 的 10.00% 是直接证据;改进方向是随层级递增候选预算、在粗层引入保底块,或用束搜索式的跨层回溯替代贪心逐层选择。第二,短序列无优势:4K–16K 时层级少、多 kernel 启动开销占主导,反而慢于 BSA;可自适应退化——当叶块数 $\lceil N/C\rceil\le gK$ 时直接单层精确打分。第三,中间层 LSE 用均值摘要近似,误差随深度累积,PISA-2 偶尔反超完整 LSE 也说明二阶截断已经够用;可探索学习式摘要(NSA 投影)与 LSE 的混合打分。第四,评测面窄:只覆盖语言建模、常识与 niah,缺少代码/多模态长文、RULER 其他子任务与真实 agent 长上下文负载;端到端延迟数据缺失使 9.95× 的意义打了折扣。第五,解码路径每步串行依赖层级展开,小 batch 下并行度受限,与投机解码等技术的兼容性未知。
未来方向
作者提出的延伸点包括附录 B 的完整强制块策略、以及把选择基准推到 256K 所展示的超长上下文方向。基于成果可继续做的:①把金字塔摘要与跨层 KV 蒸馏(IndexCache、LongCat 思路)结合,进一步压低叶层 IO 与缓存体积;②利用 LSE 分数的软性做可微 Top-K/直通估计,实现端到端路由学习,理论上可弥补漏检;③把 PISA 推广到扩散 Transformer(对接 LLSA 的层级选择场景)与视觉长序列;④解码端与分页 KV 管理、投机解码协同,消解单内核串行路由的并行度限制;⑤理论侧给出层级均值池化相对全注意力质量的下界,刻画何时漏检、K 与深度如何权衡;⑥在 MoE 与长文档 agent 工作负载上验证 $O(N\log N)$ 预填充的实际收益,并补齐端到端 wall-clock 评测。
复现评估
论文未提及开源代码或模型权重,复现需自行实现。有利条件是描述相当完整:算法有式 7–24 的完整数学定义、Algorithm 1 的两阶段伪代码、式 25–31 的 IO 推导,超参明确($C=64$、$g=2$、$K=8$ 预训练/$K=32$ CPT、$Q_{tile}=4$、$G_Q=16$、LSE 打分、强制块策略在附录 B、训练与评测协议在附录 C,基线为 NSA/HiLS/BSA 官方设计)。困难在于算力:三档规模各需 100B token 预训练加 10B CPT@16K,完整对照属于工业级成本。建议的复现路径是先做 418M 单档预训练验证 Table 2 的损失与 containment 趋势,再单独复现 Figure 2/3——选择质量和延迟基准只需要一个全注意力 checkpoint 的 Q/K 张量,无需完整预训练,难度中等。Triton 内核部分需要较强的 GPU 工程能力。
论文图表
两阶段块选择的完整伪代码:Stage 1 对每个 query 位置与 KV 头并行,逐中间层计算 LSE(式 5)、跨 query 头求和(式 6)、SelectK 并展开子块,候选留在程序内;Stage 2 按叶块聚簇 query、以 $Q_{tile}$ 为单位并行加载 key 块做精确 LSE 打分;最后独立 kernel 做最终 Top-K 输出 $I^{(1)}_{t,h}$。
实现层面的核心参考:GQA 跨头共享、候选寄存器化、query 聚簇复用 key 等所有工程细节都在此伪代码中,是复现内核的依据。