DoSA:点积稀疏注意力 DoSA: Dots Sparse Attention
用分数上界证书无损剪枝稀疏注意力索引器,Indexer最高加速2.74倍
前置知识
DeepSeek 稀疏注意力(DSA)与多头索引器
DSA 用一个轻量多头索引器为每个 query 对所有可见 key 打分:$s_i=\sum_{h=1}^{H} w_h[q_h^\top k_i]_+$,其中 $[\cdot]_+$ 是 ReLU、$w_h$ 是可正可负的头权重,然后只取 Top-K 个 token 进入真正的注意力计算。索引器本身仍要遍历全部 key,长上下文下反而成为新的瓶颈。
DoSA 的全部优化对象就是这个带符号 ReLU 索引器,看懂其打分公式和正负头的不对称性是理解证书构造的前提。
Top-K 阈值与子集下界
全集中第 K 大的分数 $\tau_K(\Omega)$ 是入选 Top-K 的门槛。经典检索结论(Turtle & Flood 1995;Broder et al. 2003)指出:任取至少 K 个可见 key 组成子集 $S$,其第 K 大分数满足 $\tau_K(S)\le\tau_K(\Omega)$。因此只要某候选的分数上界 $U_i<\tau_K(S)$,它必然进不了 Top-K,可以安全丢弃。
DoSA 的无损性完全建立在这条子集阈值下界上,是全部剪枝正确性的基石。
WAND / MaxScore 检索剪枝
文档检索中的经典技术:为每个词项的贡献预存上界,维护当前 Top-K 的最小阈值,凡上界低于阈值的文档直接跳过精排打分,从而避免给所有文档算全分。Block-Max WAND 进一步按 posting-list 块收紧上界。
DoSA 把同一剪枝原理首次搬到 DSA 的带符号多头 ReLU 分数上,并论证块级上界太松、需要逐 key 的更紧证书。
ReLU 次可加性、正齐次性与 Cauchy–Schwarz
$[a+b]_+\le[a]_+ + [b]_+$(次可加),$[ca]_+=c[a]_+$($c\ge0$ 时正齐次),再配合 Cauchy–Schwarz 不等式 $|x^\top k|\le\|x\|_2\|k\|_2$,就能把未计算头的贡献压缩成一个成本低廉、可证明的分数上界。
论文的全部不等式——正头投影界、负头聚合界、联合残差界——都由这三条基本性质推出,是读懂附录 A 证明的钥匙。
TTFT 与预填充(prefill)
TTFT(Time To First Token)指从发出请求到收到第一个 token 的端到端延迟。长 prompt 的预填充阶段要一次性处理全部上下文,索引器开销随 key 数量线性增长,因此 TTFT 与 Indexer 微基准延迟是衡量长上下文服务性能的两级核心指标。
论文用这两级指标量化收益,图1还给出 Indexer 占预填充 GPU 时间的比例随上下文长度的变化,直接决定加速收益的上线。
FP8 精度与保守数值封装
FP8 是 8 位浮点格式,Tensor Core 用它换取吞吐,但舍入误差可能破坏不等式的方向。保守封装要求用定向舍入/向上取整计算所有上界,并为辅助向量重构、权重折叠、key 范数摘要等留出显式误差余量,保证数值域上 $s_i^{ref}\le U_i^{num}$ 依然成立。
GPU 筛选用 FP8 执行,附录 C 专门规定数值条件与全量恢复机制,是论文'无损'声明成立的关键工程细节。
研究动机
稀疏注意力的本意是只访问少量 key,但'找到这些 key'本身仍要密集扫描。DeepSeek 稀疏注意力(DSA)用多头索引器给每个可见 key 打分再取 Top-K,每次打分都需要点积、ReLU 激活和带符号加权求和,这在长上下文预填充时形成新的密集瓶颈。论文实测:约 100 万 token 时,Indexer 占 GLM-5.2 预填充 GPU 时间的 73.0%、DeepSeek-V3.2 的 90.8%;占逻辑矩阵 FLOPs 的 47.4% 和 83.2%,且占比随上下文增长持续攀升(GLM-5.2 在 128K 时仅 23.6%)。已有加速方案各有短板:GVR 利用解码期时间相关性预测阈值、DeepSelect 用有界缓冲流式处理已物化的分数、LiteTopK 把打分与候选过滤融合以减少分数回写,但它们仍要对每个 key 做全部头的打分;MISA 用更少的头预筛再重排,但被排除的赢家无法被重排找回。也就是说,稀疏注意力内部藏着一个'为省计算而引入的密集计算',MoE 式的容量与激活分离在注意力选择环节尚未实现。
本文的目标是论文的目标是:在不改变 DSA 原始路由规则的前提下,把 token 选择变成条件计算——凡能证明某个 key 不可能进入 Top-K,就不为它计算完整分数。具体要同时削减三类开销:其一是全头打分的算术量,只对少数幸存者计算原始 H 头分数;其二是稠密分数回写的 HBM 流量,只有达到阈值的分数才写回显存;其三是 Top-K 选择器的工作量,选择器只处理紧凑编码后的记录。同时必须给出严格保证:任何被跳过的 key 都满足'分数上界 < Top-K 阈值下界'的可证条件,最终 Top-K 结果与全量打分完全一致(含并列时的统一 tie 规则),即所谓'无损'优化,而非近似筛选。这使 DoSA 可以直接接入现有 DSA 模型而不改变其训练好的检索行为。
与已有工作不同的是,作者的独特切入是把文档检索领域的经典上界剪枝(MaxScore、WAND、Block-Max WAND)引入 DSA 的带符号多头 ReLU 打分,核心观察是:'Top-K 选择需要的是足够拒绝候选的证据,而不是完整分数'。挑战在于 DSA 分数 $s_i=\sum_h w_h[q_h^\top k_i]_+$ 的头权重 $w_h$ 有正有负:直接丢掉正权头不安全,丢掉负权头虽然安全但会让上界太松、几乎剪不动。为此论文设计了专为带符号 ReLU 分数量身定制的逐 key 证书:非负投影复用已保留头的点积、联合残差界利用被省略正头之间的几何相关性、激活频率多数投票选择负头聚合方向以避免相消。与 Block-Max WAND 的块级上界(必须覆盖块内每个 key,因而必然松)不同,DoSA 追求利用 query 头几何与激活结构的逐 key 紧界,这是它能实现高剪枝率的根本原因。
核心方法
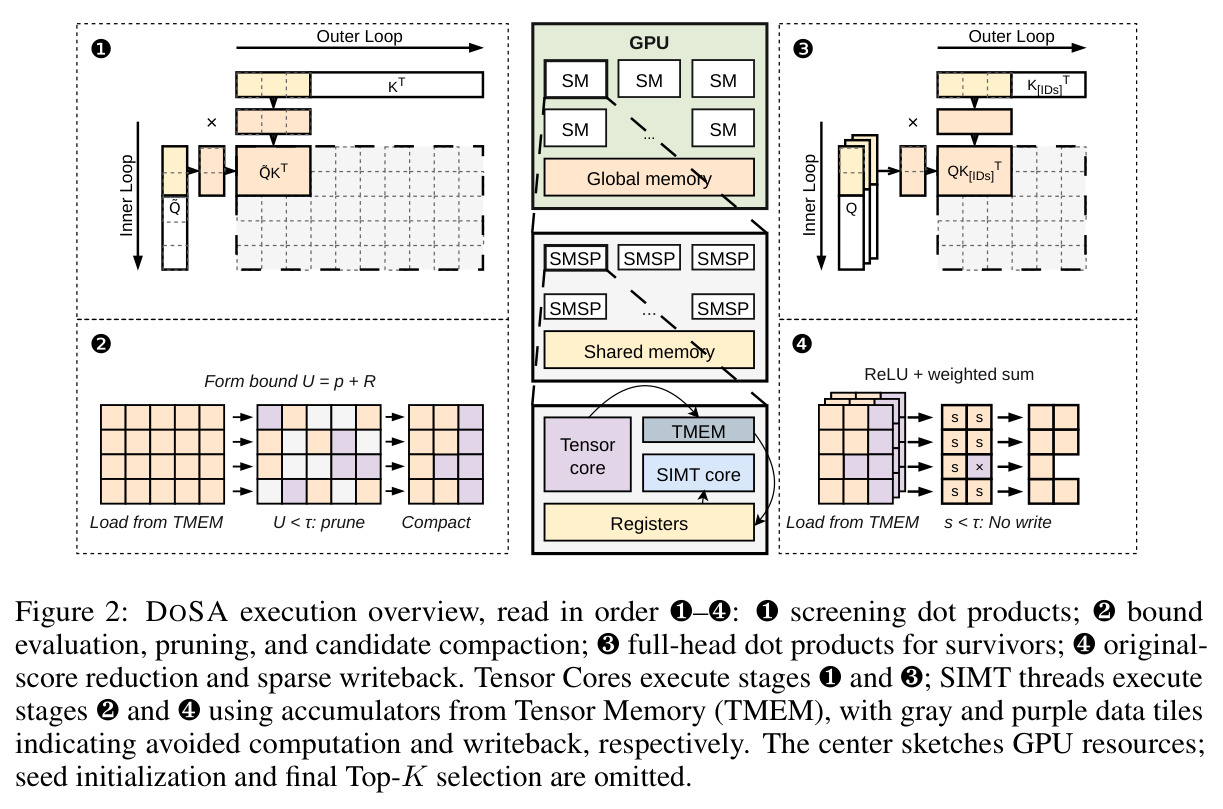
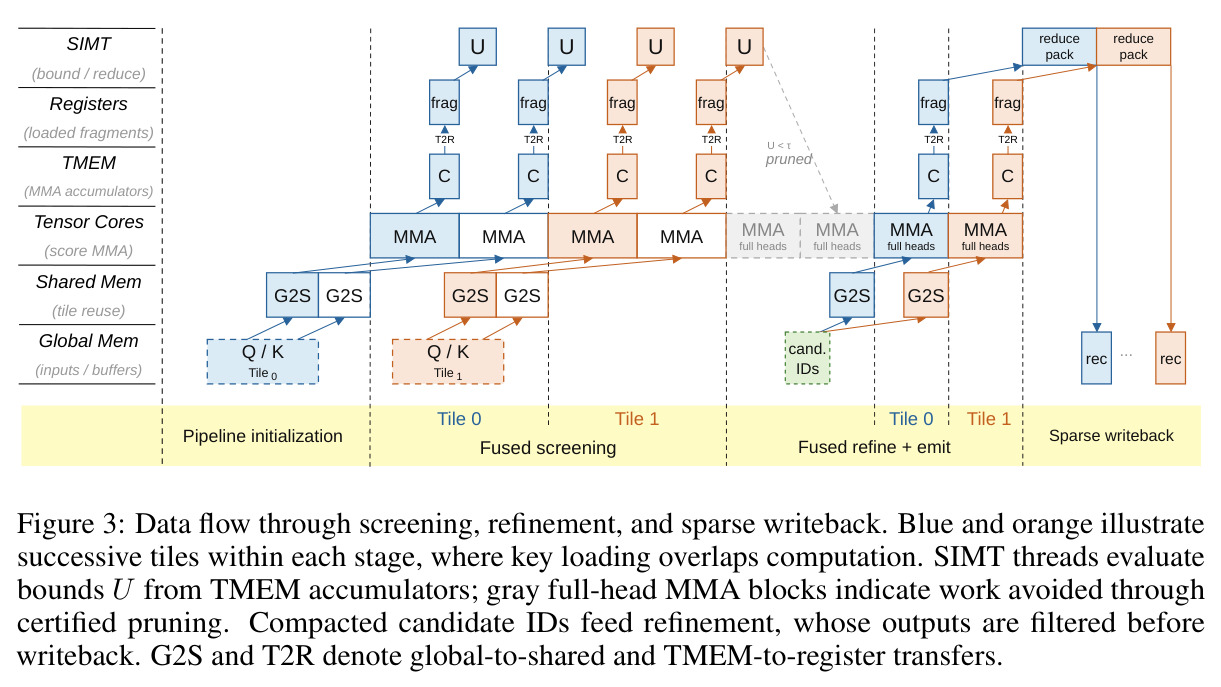
直觉:一个 token 进不了 Top-K,只要它的分数上界低于真实 Top-K 阈值的某个下界。DoSA 分四步把这一直觉工程化。第一步,选取 $|S|\ge K$ 个可见种子 key,用原始打分器精确打分,取其第 K 大作为阈值下界 $\tau$。第二步,只保留一部分头 $R$ 直接打分:正权头贡献难以紧致上界、优先保留;负权头按 $|w_h|\|q_h\|_2\min(p_h,1-p_h)$ 的优先级挑选,$p_h$ 是该头在种子 key 上的激活频率。第三步,为被省略的正头构造非负投影上界(投影部分复用已算点积),为被省略的负头构造聚合下界(它只被从上界中减去,低估是安全的),组合成分数证书 $U_i$。第四步,GPU 上先跑廉价筛选 kernel:凡 $U_i<\tau$ 的 key 直接剪掉,幸存者进入全 H 头精排,只有 $s_i\ge\tau$ 的分数被紧凑写回并参与最终 Top-K。整个流程与原始索引器的精确 Top-K 选择等价(定理 1),灰色瓦片代表的计算与紫色瓦片代表的回写都被证书免除了。
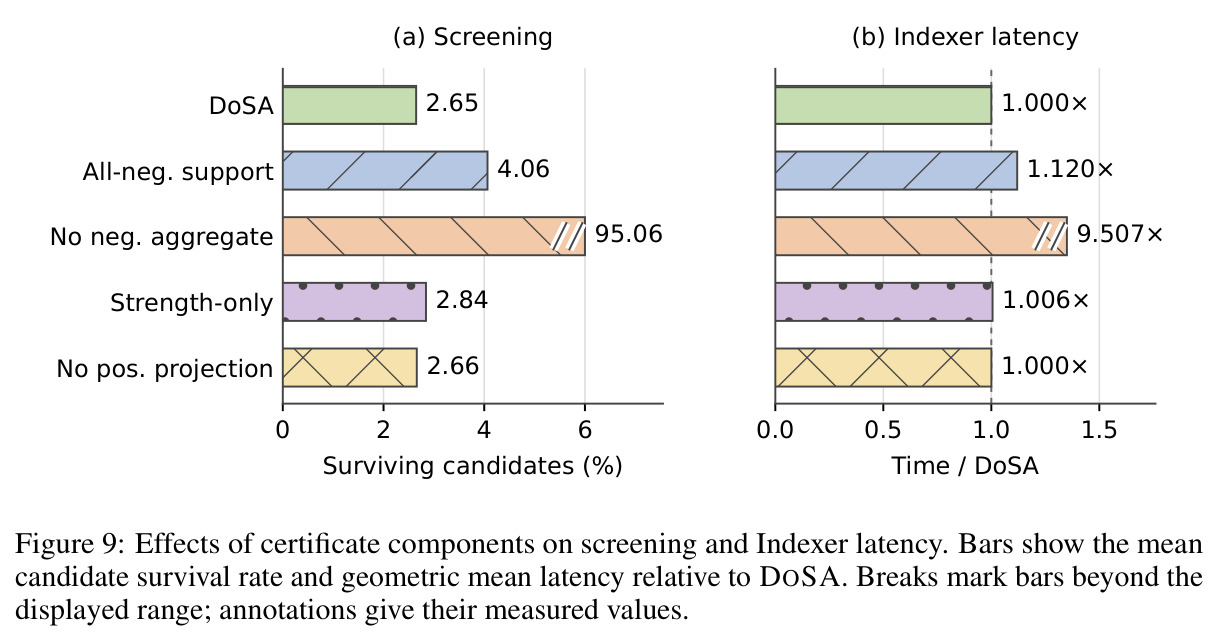
核心创新是针对带符号 ReLU 多头分数的‘可证拒绝证书’,关键洞察有三层。其一,拒绝不需要全分:若候选分数上界 $U_i<\tau_K(S)\le\tau_K(\Omega)$,则必然落选,这是经典检索剪枝原理在注意力索引器上的重现。其二,带符号分数必须区别对待正负头:正头用非负投影 $[q_h^\top k]_+\le\beta_h[q_{j^*_h}^\top k]_+ + \|d_h\|_2\|k\|_2$ 上界化,其中 $\beta_h=\frac{[q_h^\top q_{j^*_h}]_+}{\|q_{j^*_h}\|_2^2}$ 使投影部分复用已保留头的点积;负头用激活多数支撑集 $A=\{h\in N: p_h\ge 1/2\}$ 的聚合方向 $a_A=\sum_{h\in A}|w_h|q_h$ 估计减法量级,ReLU 次可加性保证它不超过真实被减去的量,且混入不活跃头会因相消而放松上界。其三,联合残差界 $E_P^{joint}\le E_P$ 利用被省略正头残差的相关性进一步收紧,且不增加任何 key 读取。与 MISA 等近似筛选的本质区别:DoSA 的排除是数学上可证的、无损的。
方法步骤详情
完整流程如下。①种子初始化:取可见种子集 $S$(至少 K 个 key,实现用四锚点初始化),用原始 H 头打分器精确打分,$\tau\leftarrow\tau_K(S)$,阈值在整个扫描期固定。②头预算规划:设保留头预算 $r$;若 $|H^+|\le r$ 则保留全部正头并用负头补齐,优先级为 $|w_h|\|q_h\|_2\min(p_h,1-p_h)$;否则按 $w_h\|q_h\|_2$ 留最强的 $r$ 个正头。③构造证书:为每个省略正头选锚点 $j^*_h$ 并算 $\beta_h,d_h$,折叠权重 $\tilde w_j=w_j+\sum_h w_h\beta_h$,残差允许量取 $E_P$ 或联合界;负头聚合 $a_A$ 用激活多数支撑集。④筛选 kernel:query 按保留头数分组成定宽 tile 以便 Tensor Core 密集 MMA,复用种子分数与两条 FP8 辅助行,逐 key tile 计算 $U_i$,$U_i<\tau$ 即剪除,warp ballot 打包幸存掩码。⑤精排与回写:幸存者共享 key 加载并做全 H 头原始打分(组内 key 幸存至少两个界即进共享流),仅 $s_i\ge\tau$ 的分数以单调紧凑码写回。⑥精确选择:Top-K 保留严格高于边界码的记录,边界并列用原始分数与统一 tie 序裁决。解码阶段保留全量 FP8 打分,用近期被选 key 作见证给出保守阈值,做紧凑选择。
技术新颖性
技术新颖性体现在四个方面。第一,这是首个针对 DSA 带符号 ReLU 索引器的无损逐 key 证书:此前 GVR、DeepSelect、LiteTopK 都绕不开全头打分,MISA 的少头筛选加重排无法找回被排除的赢家,DoSA 用不等式保证被跳过的都是必然落选者。第二,证书构造利用索引器的结构性质而非通用技巧:ReLU 次可加性与正齐次性给出正头投影界和负头聚合界,Cauchy–Schwarz 给出残差范数允许量,联合残差界 $E_P^{joint}=\frac12(\|\sum_h u_h\|_2+\sqrt{\sum_{h,\ell}|u_h^\top u_\ell|})$ 利用残差方向的相互关系且不需要额外 key 摘要。第三,激活信息驱动的头选择:$p_h$ 只影响效率不影响正确性,多数支撑集 $A$ 被证明最小化可分离的松弛代理 $J(A)$。第四,系统层面的三重节省协同:筛选减少算术、稀疏回写减少 HBM 流量、紧凑单调码减少选择输入,消融显示三者分别贡献 37.4%、23.4%、合计 47.3% 的延迟削减,说明剪枝必须配套执行策略才能兑现收益。
实验结果
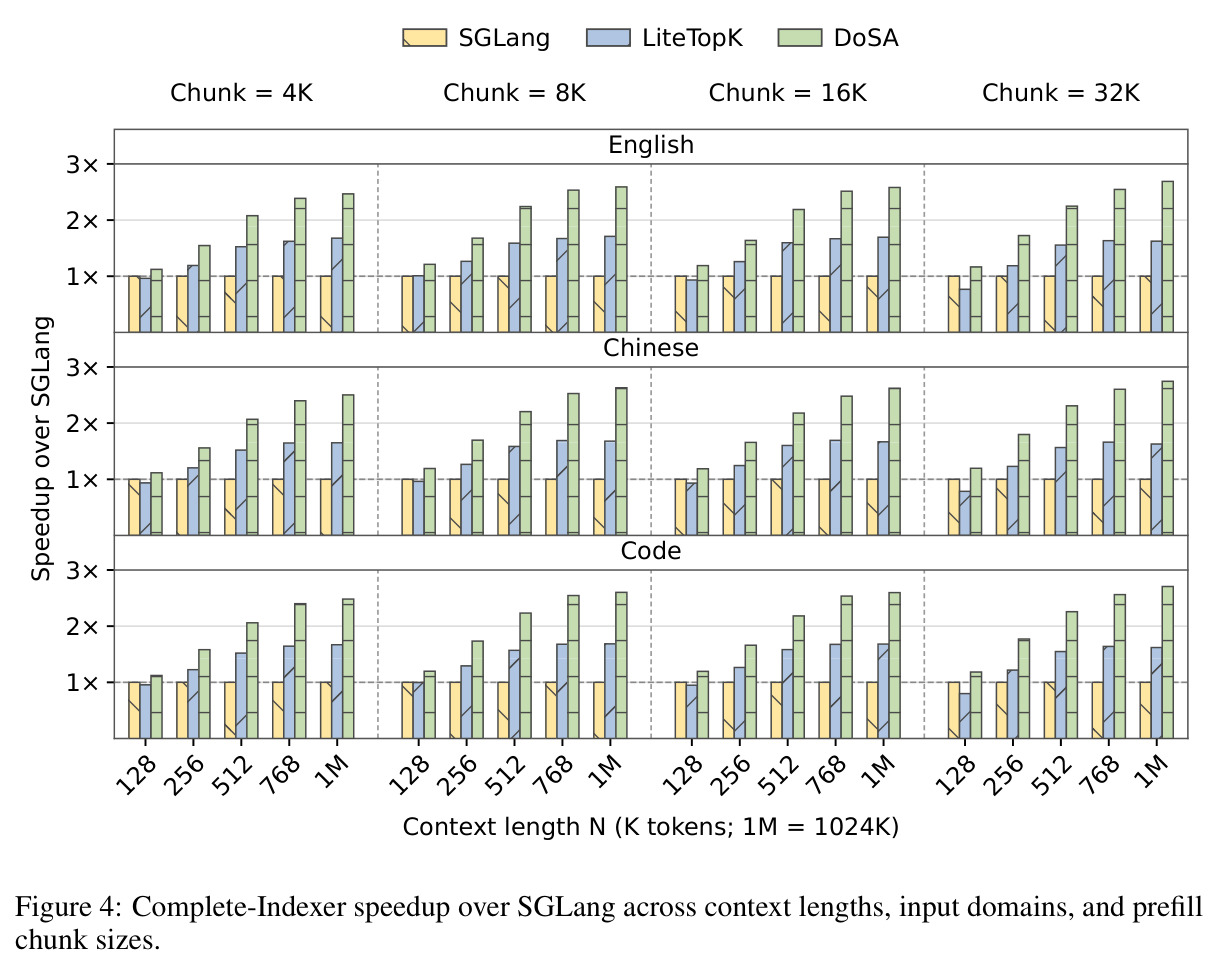
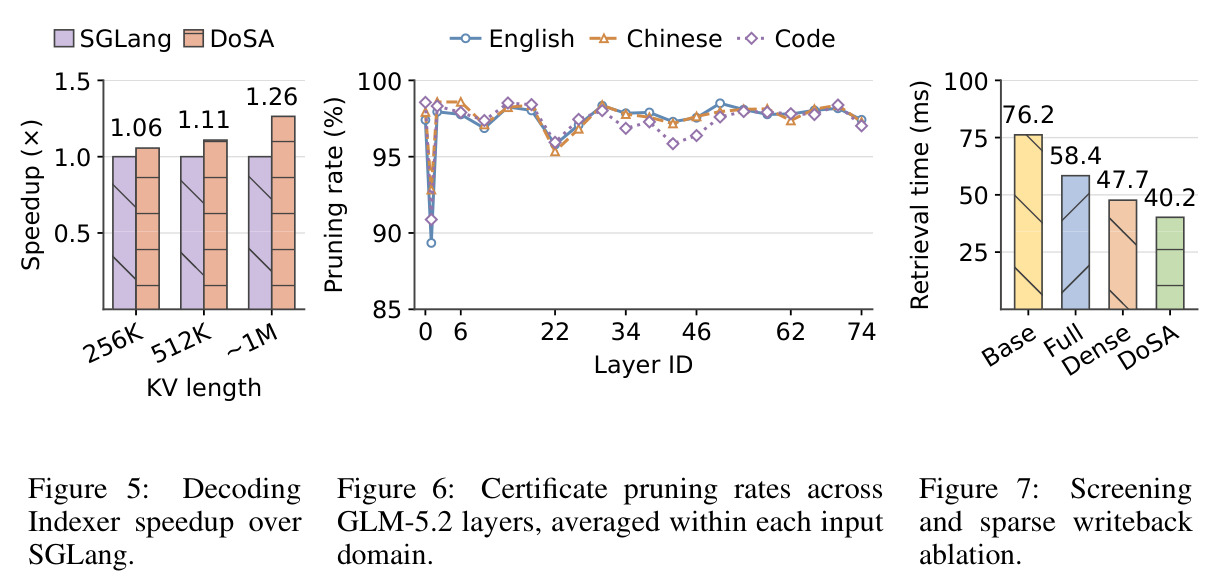
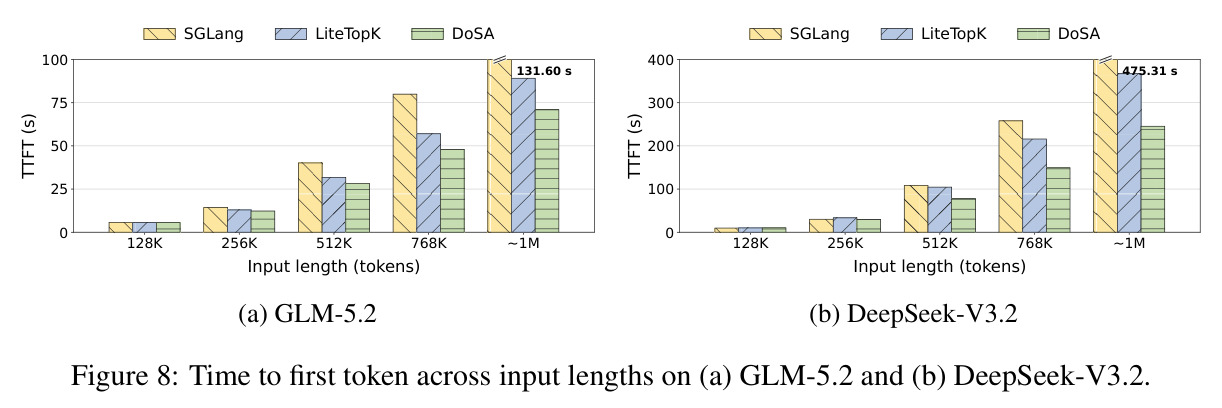
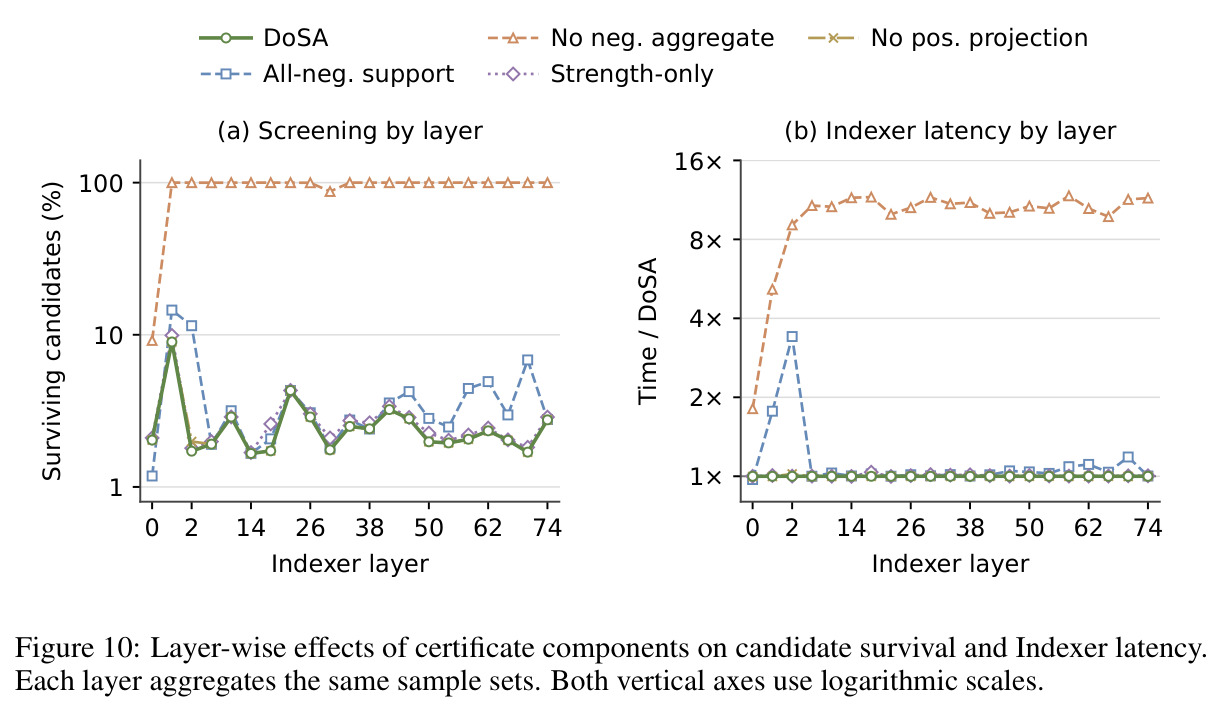
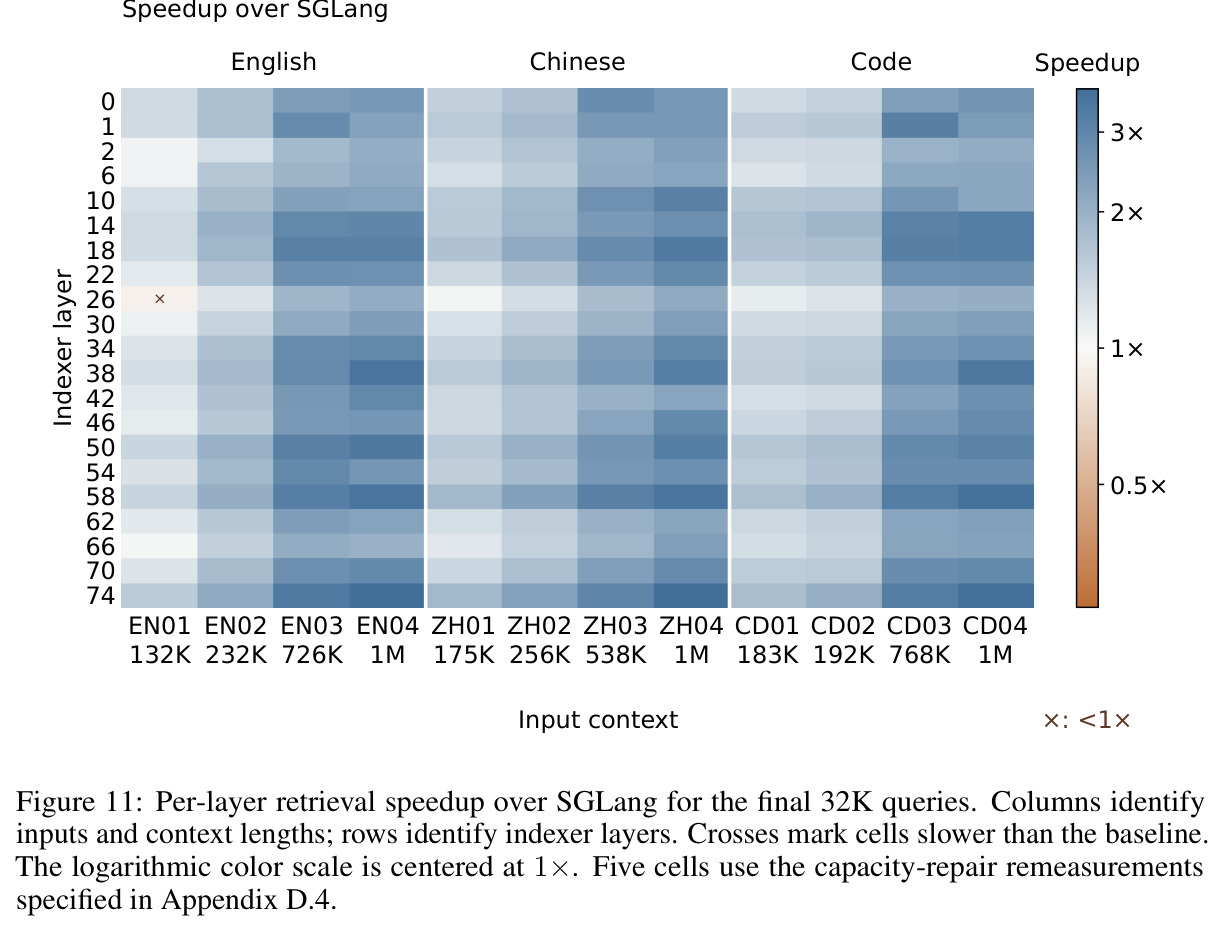
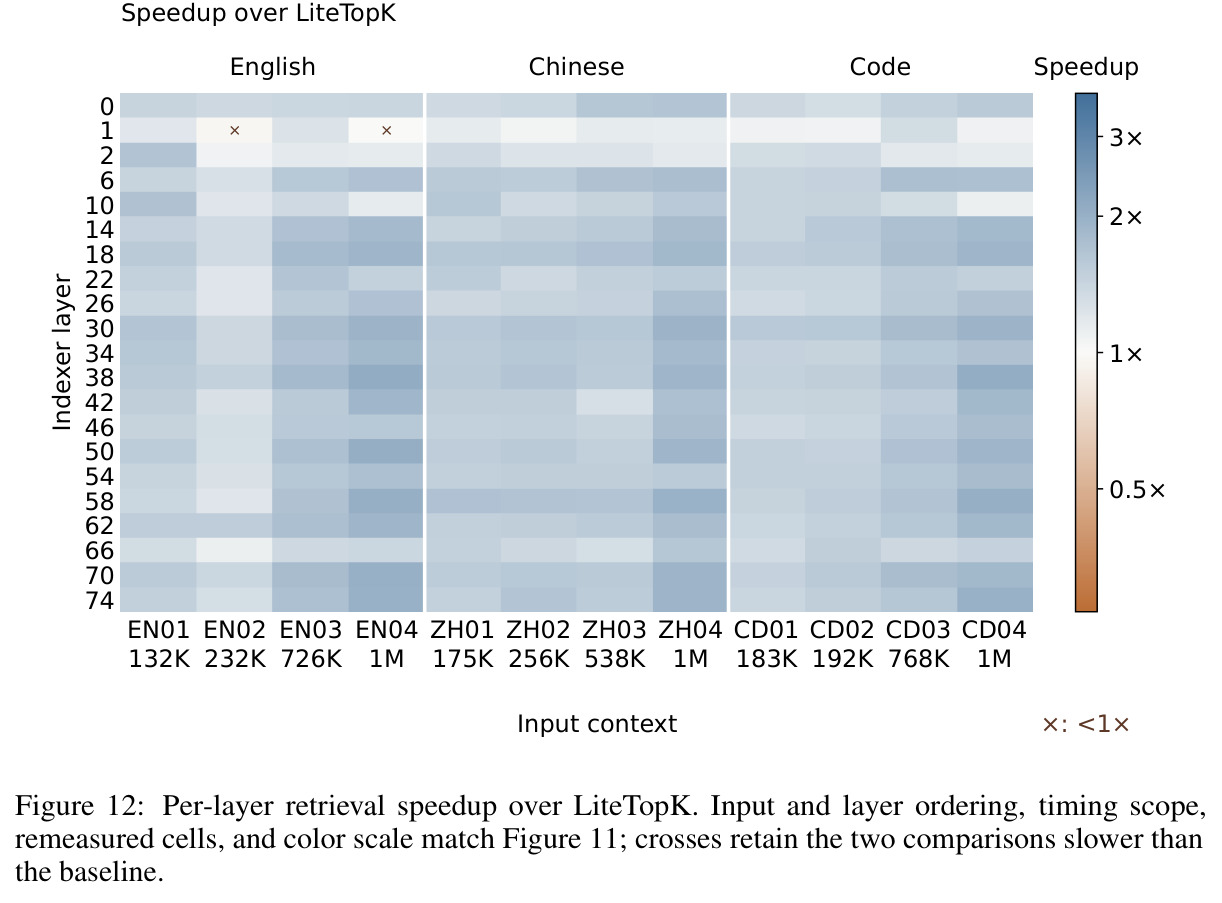
微基准:128K–1M 上下文 × 4K/8K/16K/32K chunk × 英/中/代码三域共 60 种配置中 DoSA 全部最快。对 SGLang 加速 1.12–2.74×,512K 以上全部 >2×,1M 时 2.47–2.74×;对 LiteTopK 加速 1.17–1.69×。收益主要由上下文长度驱动:英文 16K query 下从 128K 的 1.19× 涨到 1M 的 2.58×,而 chunk 从 4K 扩到 32K 只从 2.47× 变到 2.69×。端到端:约 1M token 时 TTFT 对 SGLang 在 GLM-5.2 上加速 1.86×、DeepSeek-V3.2 上 1.94×(近乎减半),对 LiteTopK 为 1.26×/1.50×;Amdahl 定律解释收益随上下文增长——GLM-5.2 的 Indexer 时间占比从 128K 的 23.6% 涨到 1M 的 73.0%,DeepSeek-V3.2 达 90.8%。解码:用时间一致性做紧凑选择,256K/512K/~1M 下加速 1.06×/1.11×/1.26×。剪枝率:三域平均 97.2%–97.5%,21 层中 20 层 >95%,仅第 1 层 89%–93%。消融:单独筛选延迟降 37.4%,单独稀疏回写降 23.4%,合计降 47.3%(1.90×);去掉负头聚合后幸存率从 2.65% 飙到 95.06%、Indexer 时间涨 9.507×;聚合全部负头因相消使幸存率升到 4.06%、延迟+12.0%。逐层检索:252 格中 251 格(99.6%)快于 SGLang(最高 3.74×),250 格(99.2%)快于 LiteTopK(最高 2.08×)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Indexer 预填充微基准(英/中/代码,128K–1M,4K–32K chunk) | 完整 Indexer 延迟加速比 | 最高 2.74×(1M 时 2.47–2.74×) | SGLang v0.5.18 | 60/60 配置全部最快,范围 1.12–2.74×,512K 以上全部 >2× |
| Indexer 预填充微基准(同上) | 完整 Indexer 延迟加速比 | 最高 1.69× | LiteTopK | 范围 1.17–1.69× |
| 端到端 TTFT,GLM-5.2,~1M token(TP8,32K chunk) | TTFT | 1.86× 加速 | SGLang | 近乎减半;对 LiteTopK 为 1.26× |
| 端到端 TTFT,DeepSeek-V3.2,~1M token(TP8,16K chunk) | TTFT | 1.94× 加速 | SGLang | 近乎减半;对 LiteTopK 为 1.50× |
| 解码阶段 Indexer(~1M KV 缓存) | Indexer 加速比 | 1.26×(256K/512K 时为 1.06×/1.11×) | SGLang | 纯靠减少选择工作量 |
| 证书剪枝率(GLM-5.2 全 21 个索引层) | 剪枝率 p = 1 − N_keep/N_screen | 域平均 97.2%–97.5%,20/21 层 >95% | 无(新指标) | 仅第 1 层为 89%–93% |
| LOFT SciFact 检索消融(16K query × 896K key,21 层平均) | 检索延迟 | 筛选+稀疏回写合计降 47.3%(1.90×) | Base(两者皆关闭) | 单独筛选 −37.4%,单独回写 −23.4% |
局限与改进
作者承认的局限:DoSA 仍要扫描每一个 key,短上下文或界太松时收益抵不过筛选成本(解码阶段收益因此只有 1.06–1.26×);数值保证要求相对原始打分器做保守求值,并列 Top-K 集合可能产生不同的生成文本;所有测量只证明计算收益,不涉及超过训练上下文的任务精度提升。我自己的观察:①微基准只在单卡 GLM-5.2 上做,端到端只有 TTFT,没有解码吞吐、训练场景或多卡扩展性数据;②阈值 $\tau$ 在扫描期固定,种子质量直接决定幸存率,种子不好时候选缓冲可能溢出,需要全量恢复这类昂贵兜底(附录 C.3),作者还记录了一次容量修复增加 9.94 GiB 工作区;③联合残差界的 query 侧代价对省略正头数是平方级($\sum_{h,\ell}|u_h^\top u_\ell|$),头预算规划开销可观;④方法强绑定'带符号 ReLU 加权和'这一特定索引器形式,NSA/MoBA/MiniMax 等块状或混合方案无法直接套用;⑤第 1 层剪枝率偏低(89%–93%),浅层收益有限;⑥FP8 定向舍入、保守范数、恢复路径等数值机制工程复杂度高,重实现门槛不低。
独立分析的弱点
弱点一:解码期收益有限且依赖时间一致性假设。当近期被选 key 不再活跃(话题突变)时见证阈值退化、收益趋近于零,可结合 GVR 的验证-精化框架或自适应回退全量打分。弱点二:种子阈值单次固定、缺乏在线加强机制——扫描中途可周期性用已算出的精确分数更新 $\tau$(经典检索中阈值单调提升),进一步压缩幸存集;论文只证明'额外精确分数只会提高阈值下界',但未在主流程实现。弱点三:候选缓冲容量问题在极端情况下无解——所有分数相等时全员通过,缓冲满需精确合并或全量恢复;可为 $U_i$ 设计分位数引导的动态阈值或两遍扫描策略。弱点四:方法绑定特定打分形式,推广到其他索引架构需重新推导证书,与块摘要结合是可行路径。弱点五:联合界的平方复杂度限制省略正头数量,可用附录 A.1 的分组残差界在紧致度与开销间自适应权衡。弱点六:只在 GLM-5.2(32 头)与 DeepSeek-V3.2(64 头)两个家族上验证,头数、权重分布、激活频率差异对证书紧致度的影响缺乏敏感性分析。
未来方向
作者提出两个方向:其一,训练期正则化证书松弛度,鼓励索引器学出'更容易被安全跳过'的几何结构,把推理优化的先验前移到训练目标;其二,把逐 key 证书扩展为块级上界:用紧凑的 key 块摘要构造块级界,界低于阈值的块可以整块跳过、连 key 向量都不必读取,有望同时降低打分与访存成本,类比 Block-Max WAND 之于 WAND。基于本文成果还可延伸:①与跨层索引复用(IndexCache)、跨层预测(SparDA)正交叠加,多层共享筛选结果与种子分数;②把激活频率 $p_h$ 与支撑集选择做成在线统计,随分布漂移自适应更新;③在服务系统中把节省的 Indexer 时间转化为更大 Top-K 或更长上下文,研究精确选择下的质量-速度权衡;④解码阶段结合推测解码或块验证,把 1.06–1.26× 的温和收益放大;⑤把证书构造抽象成通用库,推广到其他带符号门控打分场景,例如 MoE 路由的 Top-K 专家选择。
复现评估
复现条件中等偏友好但硬件门槛高。有利因素:代码开源于 GitHub(github.com/llm-sys/flash-indexer);评测数据全部公开(InfiniteBench 英/中书籍与代码、Project Gutenberg、SQLite 源码、HELMET/LongBench v2、LOFT SciFact);被测模型 GLM-5.2 与 DeepSeek-V3.2 均为开源权重;附录 A/B 给出全部证明与代价分析,附录 C 给出数值条件与恢复机制,论文还附带 CPU 层面的代数关系与固定阈值选择检查。不利因素:需要支持 FP8 Tensor Core 的高端 NVIDIA GPU,端到端实验用 8 卡张量并行;微基准虽单卡但复现 1M 上下文需大显存与 KV 缓存空间;逐层热图(252 格 × 每格 12 次重复)与每配置 10 次计时的消融计算量可观;作者在 AI 使用声明中说明初版 GPU kernel 由生成式 AI 起草后人工修订,内核级调优可能仍需专家经验。总体而言:算法层结论(证书有效性、剪枝率量级)较易复现,完整性能数字需要相当的系统工程投入。
论文图表
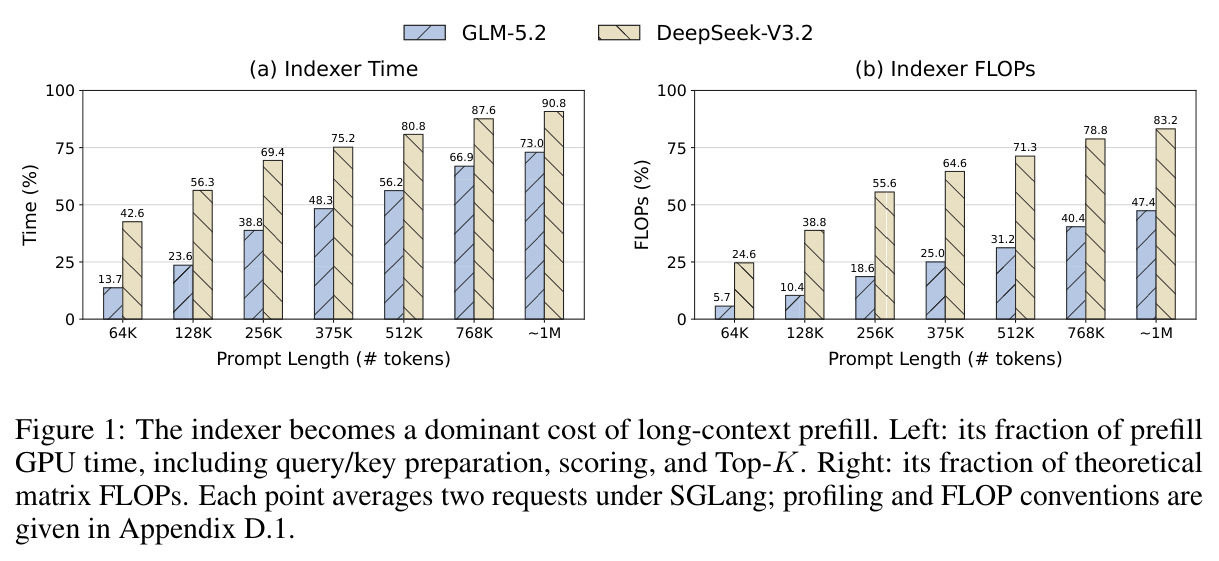
左右两个柱状图分别给出 GLM-5.2 与 DeepSeek-V3.2 的 Indexer 占预填充 GPU 时间的比例和占理论矩阵 FLOPs 的比例,横轴为 64K 到约 1M 的 prompt 长度。时间占比从 64K 时的 13.7%/18.6% 增长到 1M 时的 73.0%/90.8%;FLOPs 占比在 1M 时达 47.4%/83.2%。
这张图量化了论文要解决的核心问题:索引器开销随上下文增长而主导预填充,且时间占比高于算术占比,说明减少选择与访存流量和减少打分同等重要。它也是理解端到端收益随上下文放大的 Amdahl 分析的基础。
按层绘制的剪枝率曲线:英/中/代码三域平均剪枝率为 97.2%–97.5%,21 层中 20 层超过 95%,最低点是第 1 层(89%–93%),其余层均超 95%。
剪枝率直接决定筛选是否有算术净收益(附录 B.3 的成本模型),这张图证明证书在实际模型上足够紧,且层间差异(几何主导)大于域间差异。
以 LOFT SciFact 检索任务(16K query、896K key、21 层平均)做消融:Base(全关)、Full(仅稀疏回写)、Dense(仅筛选)、DoSA(全开)的检索延迟占比。筛选单独降 37.4%,回写单独降 23.4%,合计降 47.3%(1.90× 加速)。
它把端到端收益分解为两个可独立开关的机制,并显示两者互补:剪枝必须配合稀疏回写才能兑现为带宽节省,是理解系统设计合理性的关键证据。