超越未来预测:以去噪作为机器人控制的生成式适配 Beyond Future Prediction: Denoising as Generative Adaptation for Robot Control
放弃未来预测目标,直接对当前观测去噪并共训动作,更鲁棒且训练开销减半
前置知识
扩散 Transformer(DiT)
把去噪扩散模型的主干替换为 Transformer 的生成模型,通过预测噪声或速度场,把随机噪声逐步还原为图像/视频 latent。FLUX.2、Z-Image 等大规模文生图/图像编辑模型均基于 DiT,在海量图文对上学到像素级的视觉结构与语言条件化能力。
本文研究的核心问题正是“预训练 DiT 的生成先验如何迁移到机器人控制”,NowWAM 直接把 DiT 的原生去噪目标当作适配接口使用。
流匹配与速度预测
一种扩散式生成训练范式:在噪声水平 $\sigma$ 下,模型预测把带噪样本 $z_{t,\sigma}$ 拉回干净样本的速度场,目标为 $v^*=\epsilon-z_t$,损失是预测与目标的均方误差。相比经典噪声预测,速度参数化更稳定,是现代 DiT(如 FLUX 系列)的标准训练目标。
NowWAM 的生成损失 $\mathcal{L}_{\text{denoise}}=\|\hat{v}_t-(\epsilon-z_t)\|_2^2$ 就是速度预测目标,读懂方法部分必须先理解它。
去噪轨迹与噪声调度 σ
去噪轨迹指样本从纯噪声到干净数据所经历的连续状态序列,噪声水平 $\sigma\in[0,1]$ 刻画加噪程度。训练时按某分布采样 $\sigma$(均匀或偏向低噪端),推理时取 $\sigma=0$ 的干净端点。本文用 $\sigma=\frac{s^u}{1+(s-1)u}$ 实现可偏移的采样分布。
本文的核心论断是“动作学习必须耦合跨去噪轨迹的表征”:Clean only 训练掉了约 6 个百分点的结论直接建立在这一概念上。
生成式共训练
在机器人策略微调中,把预训练生成模型的原生生成损失与动作预测损失联合优化的做法。未来目标共训练(Fast-WAM/ImageWAM)额外引入一条未来观测目标流做生成适配;NowWAM 则让当前观测流本身承担生成目标,不再需要独立的辅助目标。
全文比较的正是“未来目标共训练”与“当前去噪共训练”两种公式,分清这两种范式是理解论文贡献的前提。
VLA 与 DiT–MoT 结构
视觉-语言-动作(VLA)模型把预训练视觉-语言表征适配为动作输出。DiT–MoT 指生成 DiT 骨干与参数独立的动作专家 DiT 并存:骨干逐层通过掩码混合注意力向动作专家提供视觉-语言上下文(K、V),动作 token 与骨干交互但参数分离。
NowWAM 沿用 DiT–MoT 并明确“动作通路不变、只改视觉适配接口”,不了解该结构就无法判断论文改动的确切范围。
LIBERO 与 LIBERO-Plus 基准
LIBERO 是仿真机器人操纵基准,含 Spatial/Object/Goal/Long 四套任务,强策略已近饱和(约 98%);LIBERO-Plus 在其上引入相机、机器人本体、语言、光照、背景、噪声、布局七类扰动,共 10,030 个评测回合,专门检验分布偏移下的鲁棒性。
论文主战场就是 LIBERO-Plus(87.7%)与标准 LIBERO(98.4%),不看懂两个基准的构成与难度差异,就无法理解各数字的意义。
研究动机
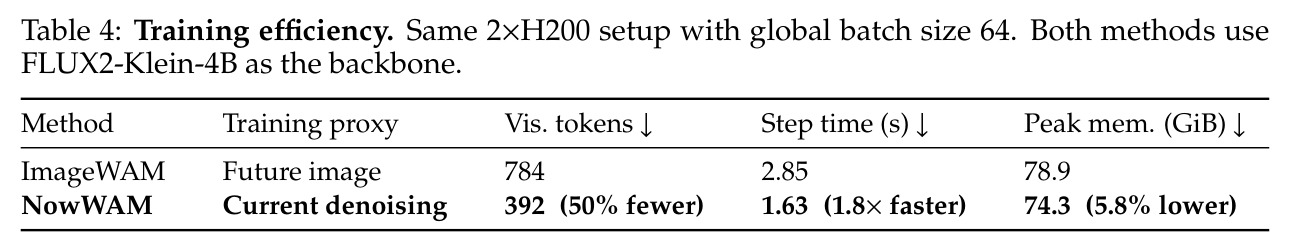
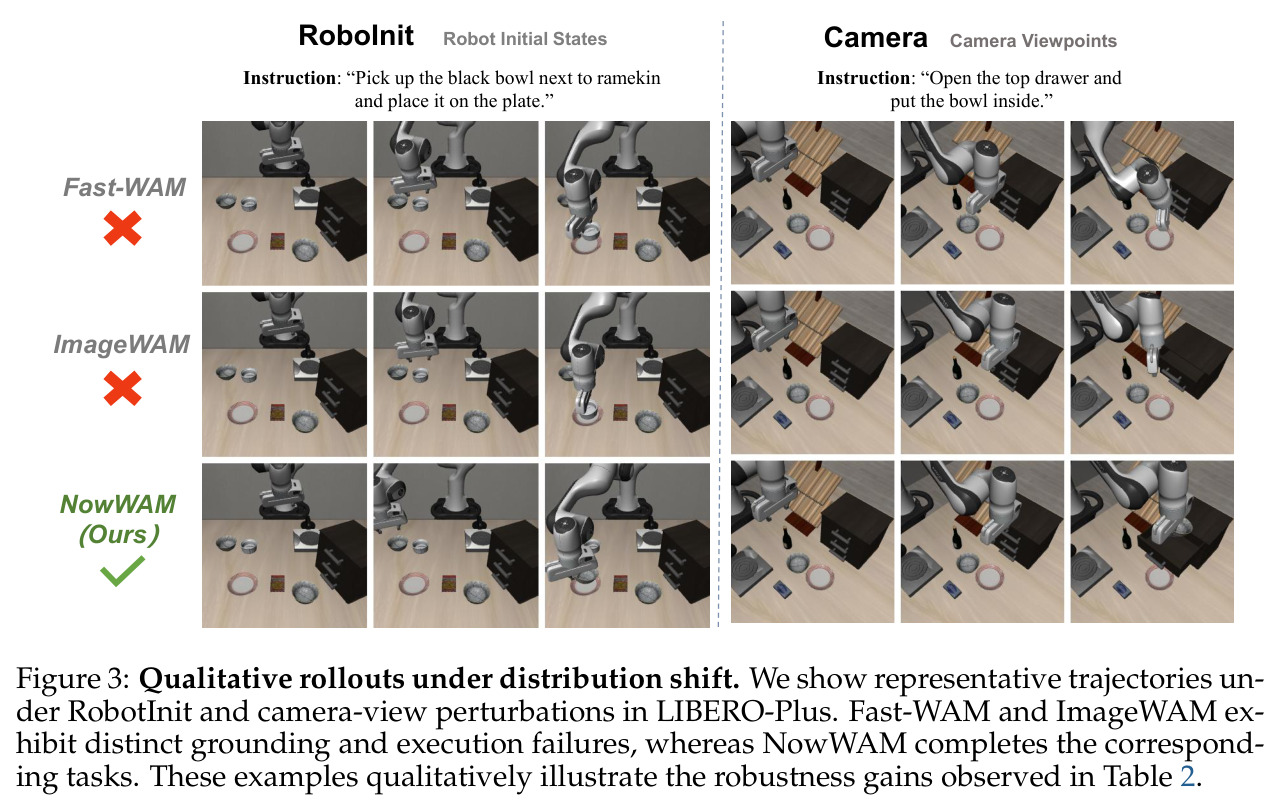
自 UniPi 以来,把预训练生成式扩散 Transformer(DiT)用作机器人策略底座的主流做法,是让模型额外预测未来视觉观测:早期方法把预测出的未来直接放进动作回路,近期工作如 Fast-WAM 与 ImageWAM 则把未来预测移出推理阶段,仅保留为训练期的生成式共训练目标。这条演进路线留下一个基础疑问:既然未来预测已不参与部署推理,“预测未来”本身还能解释生成式共训练为什么有效吗?代价也很明显:独立目标流使训练时视觉 token 翻倍到 784 个,ImageWAM 在 2×H200 上单步耗时 2.85 秒、峰值显存 78.9 GiB;而这类基线在 LIBERO-Plus 分布偏移下表现脆弱——Fast-WAM 仅 49.5%,甚至 π0 也只有 53.6%,鲁棒性亟需改善。
本文的目标是本文要回答两个问题:预训练生成式 DiT 到底为动作学习贡献了什么?这种生成先验应当以什么接口适配到控制?具体目标是:在严格匹配的受控实验中分离“生成式初始化”“辅助视觉目标的时间语义”“是否沿去噪轨迹训练”三个因素,检验未来预测是否必不可少;并据此设计一个不依赖任何未来目标的共训练公式,要求其在标准 LIBERO(近饱和,强策略约 98%)上不损失操纵能力,在 LIBERO-Plus 鲁棒性基准(10,030 回合、七类扰动)与 RoboCasa GR1 少样本迁移(24 个任务、每任务 100 条示范、共 1,200 回合)上超越未来目标基线,同时把训练视觉 token 数与单步耗时显著降下来。
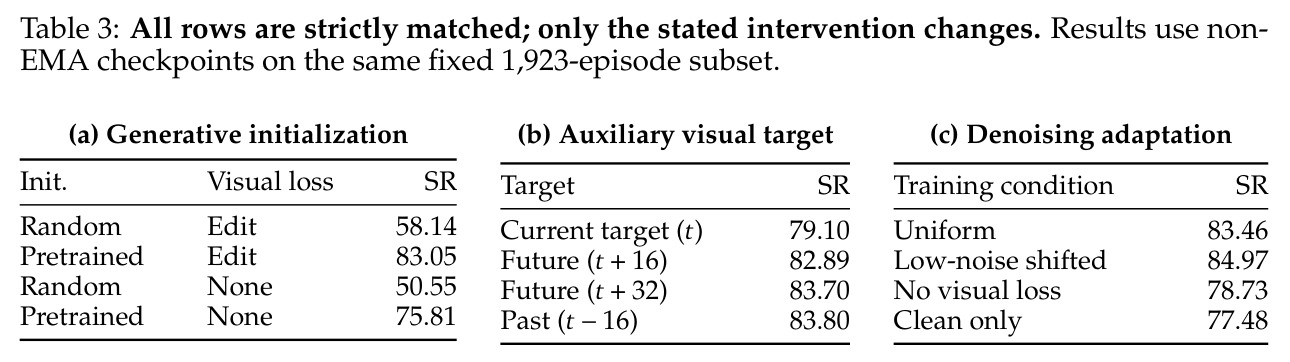
与已有工作不同的是,作者的独特切入点来自受控消融给出的关键线索:在匹配设置下,用未来目标 $t+16$、$t+32$ 分别得到 82.89% 与 83.70%,而过去目标 $t-16$ 达到 83.80%——过去与未来表现相当,说明收益无法归因于前向时间语义。既然如此,生成适配未必需要独立的时间目标流,真正关键的可能是 DiT 原生的去噪轨迹本身。于是作者把生成接口拉回 DiT 自带的加噪-去噪过程,直接对用于控制的当前视觉流去噪,让同一条视觉流同时承担生成适配与动作学习;这彻底移除了“未来预测”,还意外兼容没有任何时序或编辑预训练的纯文生图骨干 Z-Image,形成与所有已有生成式策略都不同的公式。
核心方法
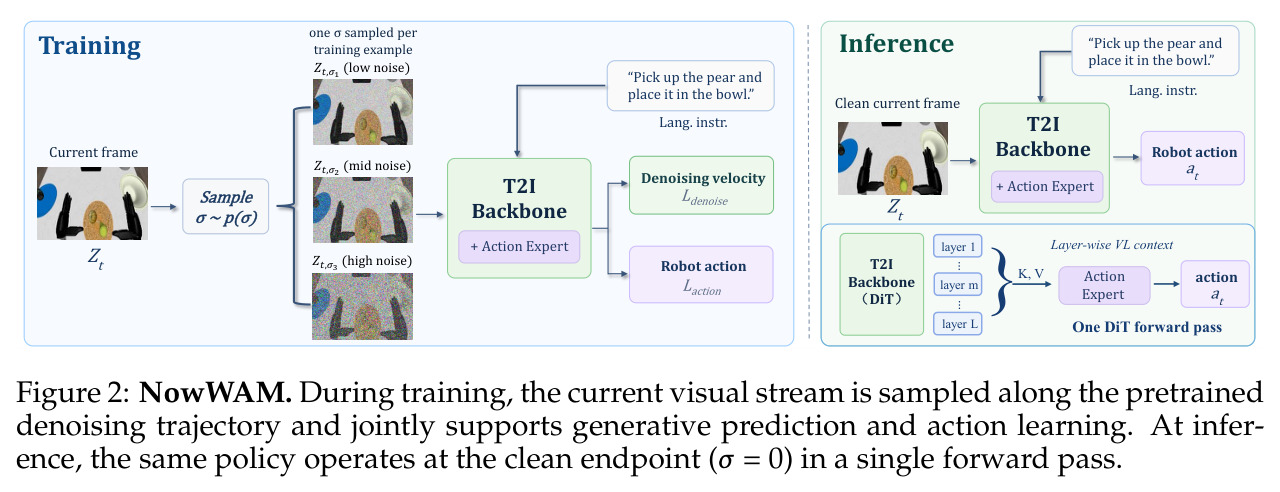
直觉上,预训练 DiT 的价值在于其在大规模图像/视频生成中学到的像素级视觉-语言结构,而不在于“生成未来”这个输出接口;因此可以把原生的加噪-去噪训练目标直接搬到动作学习所用的当前观测上。技术上,NowWAM 训练时从预训练去噪轨迹采样噪声水平 $\sigma$,对当前观测 latent $z_t$ 加噪得到 $z_{t,\sigma}=(1-\sigma)z_t+\sigma\epsilon$,用速度预测损失 $\mathcal{L}_{\text{denoise}}=\|\hat{v}_t-(\epsilon-z_t)\|_2^2$ 做生成适配,同时用掩码均方误差损失 $\mathcal{L}_{\text{action}}$ 监督连续动作序列,总损失为 $\mathcal{L}=0.5\,\mathcal{L}_{\text{denoise}}+1.0\,\mathcal{L}_{\text{action}}$。推理时固定 $\sigma=0$,直接在干净当前帧上单次前向预测动作,无需视觉去噪 rollout,也无需任何辅助视觉流。
核心创新是把“生成适配”与“动作学习”耦合在同一条视觉流上:训练时动作专家读取的视觉-语言上下文来自沿去噪轨迹采样的 $z_{t,\sigma}$,动作表征横跨从高噪到干净的连续去噪状态,而非只看干净端点。这与未来目标共训练(Fast-WAM/ImageWAM 的两流公式 $[l\,|\,z_t\,|\,z^+_{t,\sigma}\,|\,a]$)有本质区别:后者必须维护一条独立的辅助目标流,且目标 token 不进入动作回路;NowWAM 的单流公式 $[l\,|\,z_{t,\sigma}\,|\,a]$ 既去掉了未来预测,也去掉了额外目标 token。消融证明这并非简单换目标:Clean only(固定 $\sigma=0$ 但保留视觉损失)只有 77.48%,去掉视觉损失只有 78.73%,而均匀采样达 83.46%、偏向低噪的采样达 84.97%——收益来自动作学习与原生生成目标在去噪轨迹上的耦合。
方法步骤详情
第一步,采样噪声水平:取 $u\sim U(0,1)$,按 $\sigma=\frac{s^u}{1+(s-1)u}$ 采样,$s<1$ 使样本偏向低噪端(论文最优设置)。第二步,构造输入:对当前观测 latent $z_t$ 加噪得 $z_{t,\sigma}=(1-\sigma)z_t+\sigma\epsilon$,与语言 $l$、动作 $a$ 组成单流序列 $[l\,|\,z_{t,\sigma}\,|\,a]$。第三步,DiT–MoT 前向:预训练生成 DiT 骨干处理视觉与语言流,逐层通过掩码混合注意力把视觉-语言上下文(K、V)提供给参数独立的动作专家 DiT。第四步,联合优化:去噪损失 $\mathcal{L}_{\text{denoise}}=\|\hat{v}_t-(\epsilon-z_t)\|_2^2$ 与动作掩码 MSE 按权重 0.5 与 1.0 相加,无效动作维度与 padding token 被排除。第五步,部署推理:$\sigma=0$ 时 $z_{t,0}=z_t$,策略退化为 $[l\,|\,z_t\,|\,a]$,单次前向输出动作,无去噪迭代。
技术新颖性
新颖性体现在四个层面。问题层面:首次用严格受控实验(所有行只改一个干预、共用同一 1,923 回合 LIBERO-Plus 子集)证明过去/未来目标等效($t-16$ 83.80% ≈ $t+32$ 83.70%),推翻了“未来预测是生成共训练收益来源”的流行叙事。公式层面:把生成适配从“独立目标流”简化为“当前流原生去噪”,单流设计省掉一半视觉 token(784→392),单步时间从 2.85 秒降至 1.63 秒(1.8 倍加速)。架构层面:证明纯文生图 DiT(Z-Image-6B,无图像编辑、无时序预训练)同样达到 87.8%,说明该接口不依赖视频生成或编辑能力。工程层面:速度目标直接复用 DiT 预训练的流匹配形式,骨干结构零改动,方法可近乎即插即用地迁移到其他生成式策略。
实验结果
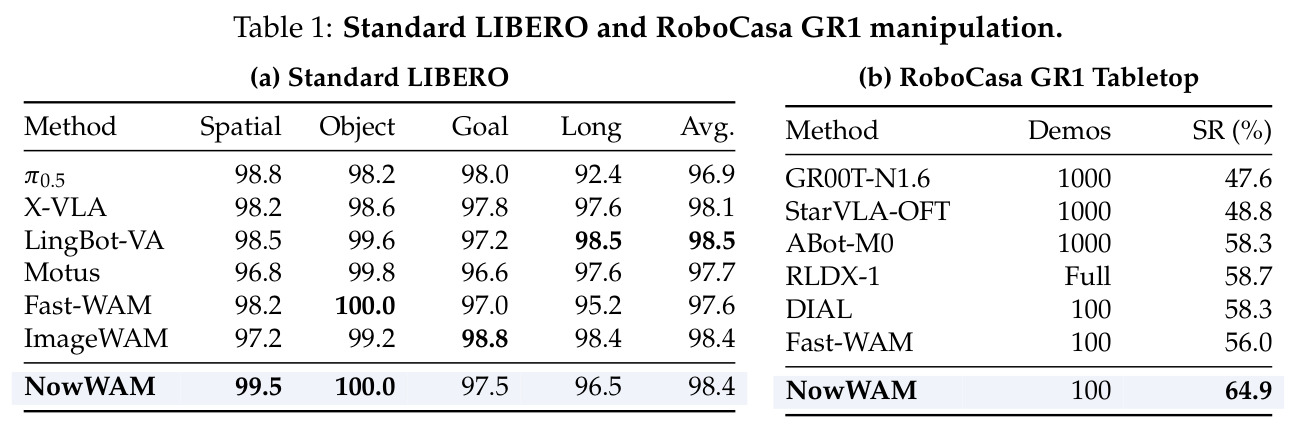
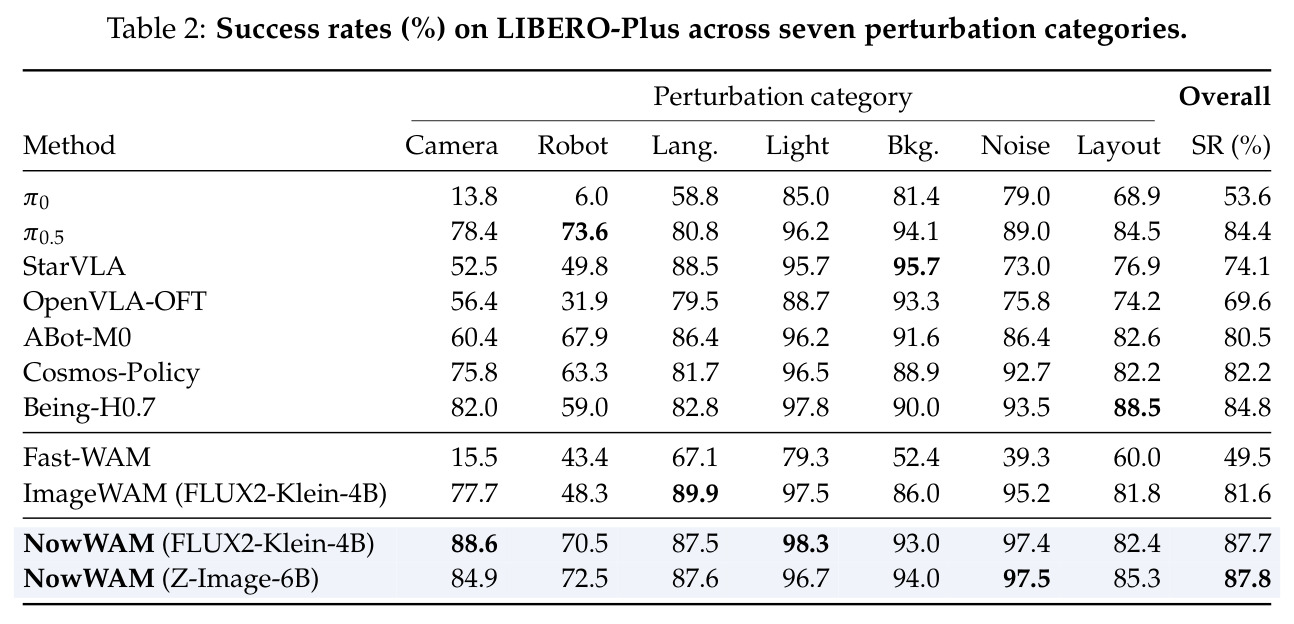
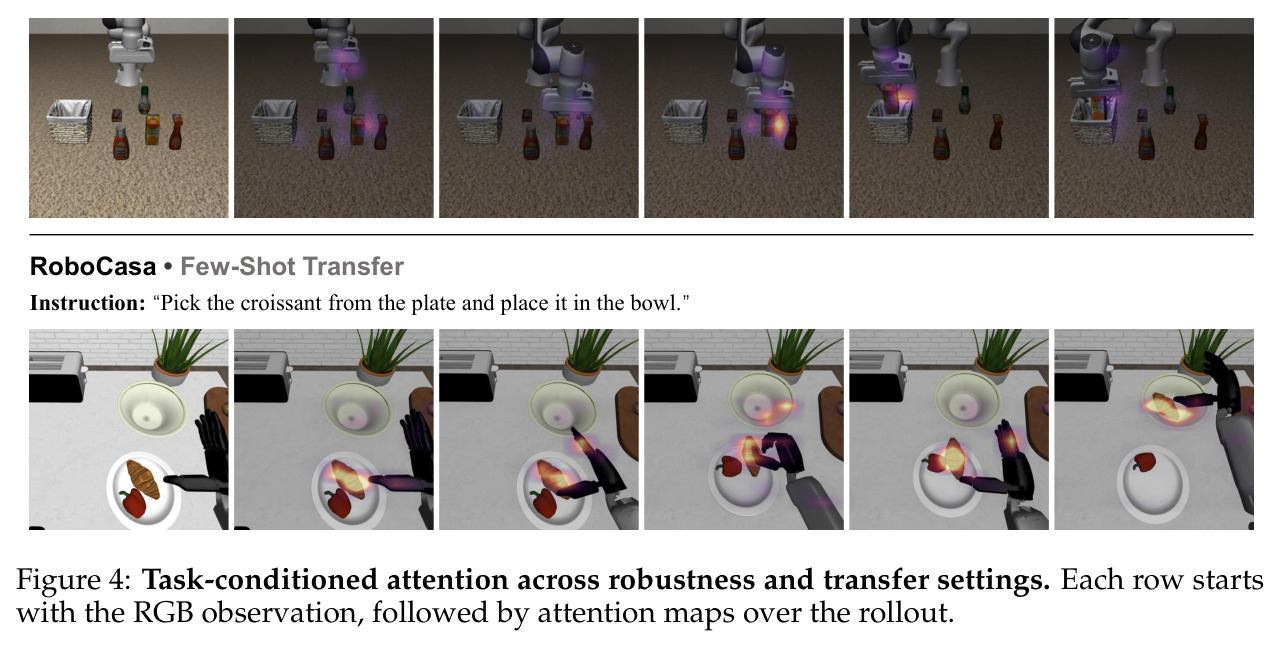
鲁棒性主结果:LIBERO-Plus 全量 10,030 回合上,NowWAM(FLUX2-Klein-4B)达 87.7%,比未来目标基线 ImageWAM 的 81.6% 高 6.1 个百分点,并超过 π0(53.6%)、π0.5(84.4%)、Being-H0.7(84.8%)、Cosmos-Policy(82.2%);增益集中在相机 88.6%、机器人本体 70.5%、背景 93.0% 等视觉扰动。纯文生图骨干 Z-Image-6B 达 87.8%,证明不依赖视频/编辑预训练。分布内:标准 LIBERO 平均 98.4%,与最强基线持平,不损失操纵能力。少样本迁移:RoboCasa GR1 每任务 100 条示范、共 1,200 回合,达 64.9%,优于 DIAL 58.3% 与 Fast-WAM 56.0%。消融揭示三层结论:预训练初始化贡献巨大(Edit 目标 58.14%→83.05%,无视觉损失 50.55%→75.81%);过去目标 $t-16$(83.80%)与未来 $t+32$(83.70%)相当,前向时间语义非必需;Clean only 77.48% 与无视觉损失 78.73% 均明显低于均匀采样 83.46% 与低噪偏移 84.97%,去噪轨迹上的生成监督是关键。效率:视觉 token 784→392(减半),单步 2.85s→1.63s(1.8×),峰值显存 78.9→74.3 GiB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO-Plus 鲁棒性评测(7 类扰动,10,030 回合) | 成功率 % | 87.7(FLUX2-Klein-4B)/ 87.8(Z-Image-6B) | ImageWAM 81.6;π0.5 84.4;Being-H0.7 84.8;Fast-WAM 49.5;π0 53.6 | +6.1(对比 ImageWAM) |
| 标准 LIBERO(分布内操纵) | 四套件平均成功率 % | 98.4(99.5/100.0/97.5/96.5) | ImageWAM 98.4;X-VLA 98.1;LingBot-VA 98.5 | 与最强基线持平 |
| RoboCasa GR1 Tabletop 少样本迁移(24 任务 × 100 示范) | 成功率 %(1,200 回合) | 64.9 | DIAL 58.3、Fast-WAM 56.0(同为 100-shot);GR00T-N1.6 47.6(1000-shot) | +6.6(对比 DIAL) |
| LIBERO-Plus 去噪轨迹消融 | 成功率 %(1,923 回合子集,非 EMA) | 低噪偏移采样 84.97 | Clean only 77.48;无视觉损失 78.73 | +7.5(对比 Clean only) |
| 训练效率(2×H200,全局 batch 64,FLUX2-Klein-4B) | 视觉 token 数 / 单步时间 / 峰值显存 | 392 / 1.63 s / 74.3 GiB | ImageWAM:784 / 2.85 s / 78.9 GiB | token 减半、1.8× 加速、显存降 5.8% |
局限与改进
作者承认的局限:未来建模对显式动力学或长时程规划可能仍有用,本文只在所研究的短时程操纵设定中证明其非必需;增益集中在视觉扰动,语言项 87.5% 实际略低于 ImageWAM 的 89.9%。我自己的观察:其一,全部实验限于 LIBERO、LIBERO-Plus、RoboCasa 仿真环境,没有真机部署结果,仿真到现实的差距未验证;其二,依赖 FLUX.2-Klein-4B、Z-Image-6B 这类数十亿参数骨干,训练需 2×H200 级算力且要求预计算并缓存文本嵌入与 VAE latent;其三,RoboCasa 仍需每任务 100 条目标示范,少样本不等于零样本;其四,动作头是连续动作的掩码 MSE,未讨论与扩散/流动作头或离散化动作的组合;其五,消融使用非 EMA 检查点和 1,923 回合子集,绝对数值与主表(EMA、全量 10,030 回合)不可直接比较;噪声采样参数 $s$ 与损失权重 $\lambda_{\text{vis}}$ 的敏感性只有粗粒度扫描。
独立分析的弱点
第一,仿真局限:LIBERO 系列以桌面抓放为主,接触动力学简单,NowWAM 在精细接触、软体形变或长时程组合任务上是否仍占优未知,改进方向是接入更高保真仿真或直接真机评测。第二,鲁棒性机理解释偏相关性:受控实验证明了“去噪轨迹必要”,但为何跨噪声状态的视觉-语言表征更鲁棒缺乏机理分析,可用线性探针、表征几何与注意力统计深入验证。第三,语言扰动上 87.5% 略低于 ImageWAM 的 89.9%,说明去掉未来目标流可能损失部分指令-视觉对齐信号,可在低噪端采样之外补充轻量的语言对比约束。第四,训练需微调数十亿参数的 DiT 骨干(2×H200、全局 batch 64),门槛高,可探索 LoRA/适配器式的轻量生成适配,让小团队也能复用。第五,动作监督是朴素 MSE,与扩散动作头、action chunking、量化动作的结合未验证,可能限制高频灵巧操作的表现。
未来方向
作者展望:未来建模对显式动力学与长时程规划仍可能有用,可与 NowWAM 的当前去噪接口互补,形成“训练时去噪适配 + 规划时世界模型”的混合方案。基于成果可延伸的方向包括:把该接口迁移到视频生成骨干,检验时序预训练在更动态任务(移动操作、双臂协作)中的价值;将“轨迹条件化训练、干净端点推理”的思想用于 VLA 中间层表征的正则化;结合 DROID、Open X-Embodiment 等真机数据验证跨本体泛化;探索 RL 微调与去噪共训练的叠加效应;针对语言扰动的短板,把指令嵌入也纳入生成适配流;以及研究噪声采样分布 $s$ 的自适应调度、把 1.8× 的训练加速通过蒸馏进一步转化为推理端效率优势。
复现评估
复现条件评估:论文给出项目主页 https://xmz111.github.io/NowWAM,但正文中未明确承诺开源训练代码与权重,需关注后续发布情况。依赖资产大多公开:骨干为 FLUX.2-Klein-4B 与 Z-Image-6B 等开源 DiT,基准 LIBERO、LIBERO-Plus(10,030 回合公开协议)与 RoboCasa GR1 的 24 个公开 ID 任务均可获取;训练细节较完整($\lambda_{\text{vis}}=0.5$、$\lambda_{\text{act}}=1.0$、低噪偏移采样、EMA 主结果与非 EMA 消融、全局 batch 64、文本嵌入与 VAE latent 预计算缓存)。算力门槛较高:效率测量基于 2×H200,数十亿参数 DiT 的联合微调预计需要多卡训练数天。总体难度中高:若代码开源,拥有 4×A100/H100 级资源的团队可复现主结果;仅复现消融(1,923 回合子集、非 EMA)成本明显更低。
论文图表
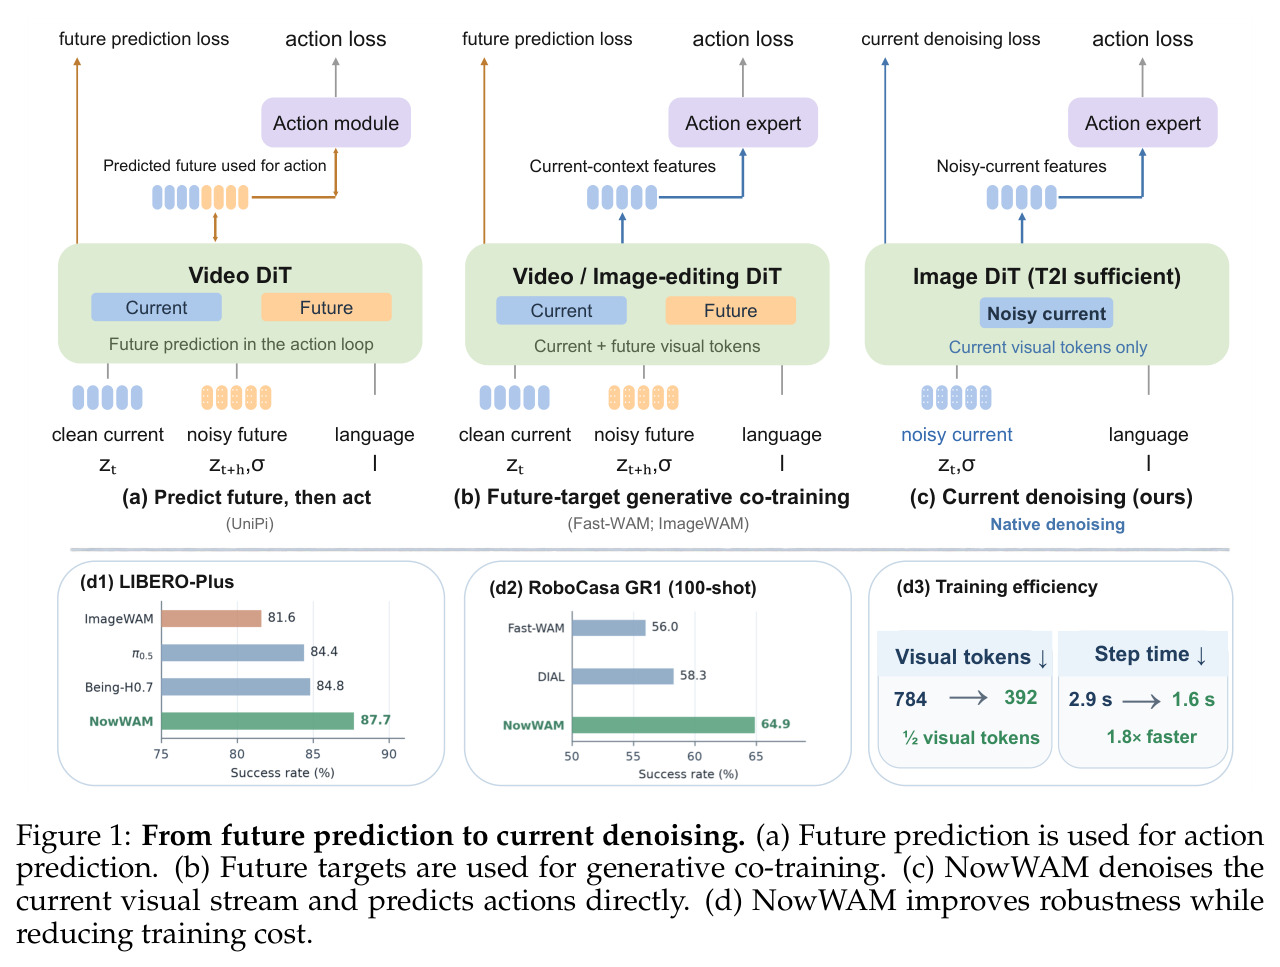
(a)(b)(c) 三联范式对比:早期方法(UniPi)把未来预测直接放进动作回路;Fast-WAM/ImageWAM 把未来预测移出推理、仅作训练期生成目标;NowWAM 则对当前视觉流本身去噪并直接预测动作。(d) 汇总结果:LIBERO-Plus 与 RoboCasa GR1 100-shot 上的提升,以及训练效率——视觉 token 784→392、单步时间 2.85s→1.63s(1.8× 加速)。
一张图讲清论文的问题演进(未来在环 → 未来作训练目标 → 无未来目标)与核心结论,是理解动机与贡献的最佳入口。