面向世界动作模型的自蒸馏未来视频表征学习 Self-Distilling Future Video Representations for World Action Models
FRED用自蒸馏提升单步去噪的未来视频表征质量,大幅增强机器人操作泛化
前置知识
世界动作模型(World Action Model, WAM)
在预训练视频扩散模型基础上微调得到的通用机器人策略,联合建模未来观测与动作,让大规模在野视频学到的时空先验迁移到机器人控制。新一代 WAM 把视频生成压缩为单步去噪,用独立的轻量动作解码器从中间隐状态 $h$ 预测动作,避免大骨干网络迭代去噪的高推理延迟。
本文所有改进都围绕 WAM 的「单步去噪 + 独立动作解码器」架构展开,理解该架构是理解 FRED 动机与设计的前提。
视频扩散模型(VDM)与 DiT 骨干
以 Diffusion Transformer 为骨干的视频生成模型,通过迭代去噪从噪声生成视频。本文使用 Wan2.2-TI2V-5B(5B 规模)与 Wan2.1-I2V-14B(14B 规模),其中间层特征被证明携带丰富的语义与运动信息,可被动作解码器直接消费。
FRED 直接操作 VDM 的中间层表征(5B 取第 18 层、14B 取第 25 层),需要理解这些层输出的隐状态 $h$ 是什么、如何被动作解码器用作条件。
流匹配(Flow Matching)
一类生成建模目标,学习从噪声分布到数据分布的概率流速度场,训练时回归速度,推理时用 Euler ODE 求解得到样本。它简洁高效,是本文视频支路与动作解码器共用的训练与采样框架。
论文总损失 $\mathcal{L}_{video}=\mathcal{L}_{FM}+\lambda_{SD}\mathcal{L}_{SD}$ 中的 $\mathcal{L}_{FM}$ 就是流匹配损失,动作解码器 $\pi_\phi$ 也用它训练与采样,不识流匹配就看不懂训练目标。
自蒸馏与动量教师(EMA/DINO 式)
不借助外部老师网络,而是维护学生参数的指数滑动平均副本作为教师:$\theta^-\leftarrow m\theta^-+(1-m)\theta$。教师输出 logits 中心化(减均值 $m$)并用锐化温度 $\gamma_2$ 做 softmax 以防表征坍缩,学生用温度 $\gamma_1$ 对齐教师分布,损失为 KL 散度,是 DINO 系自监督方法的标配技巧。
FRED 的核心损失正是这种 DINO 式 patch 级自蒸馏,理解 EMA 教师与中心化/锐化技巧才能读懂公式 (2)(3) 与防坍缩设计。
表征探测(Probing)
冻结骨干网络特征,只训练一个轻量分类头(本文用 attentive probe)去预测预定义标签(未来运动原语类别),以探测准确率衡量特征中蕴含的信息量,是评估视觉表征质量的经典手段,无需微调整个模型。
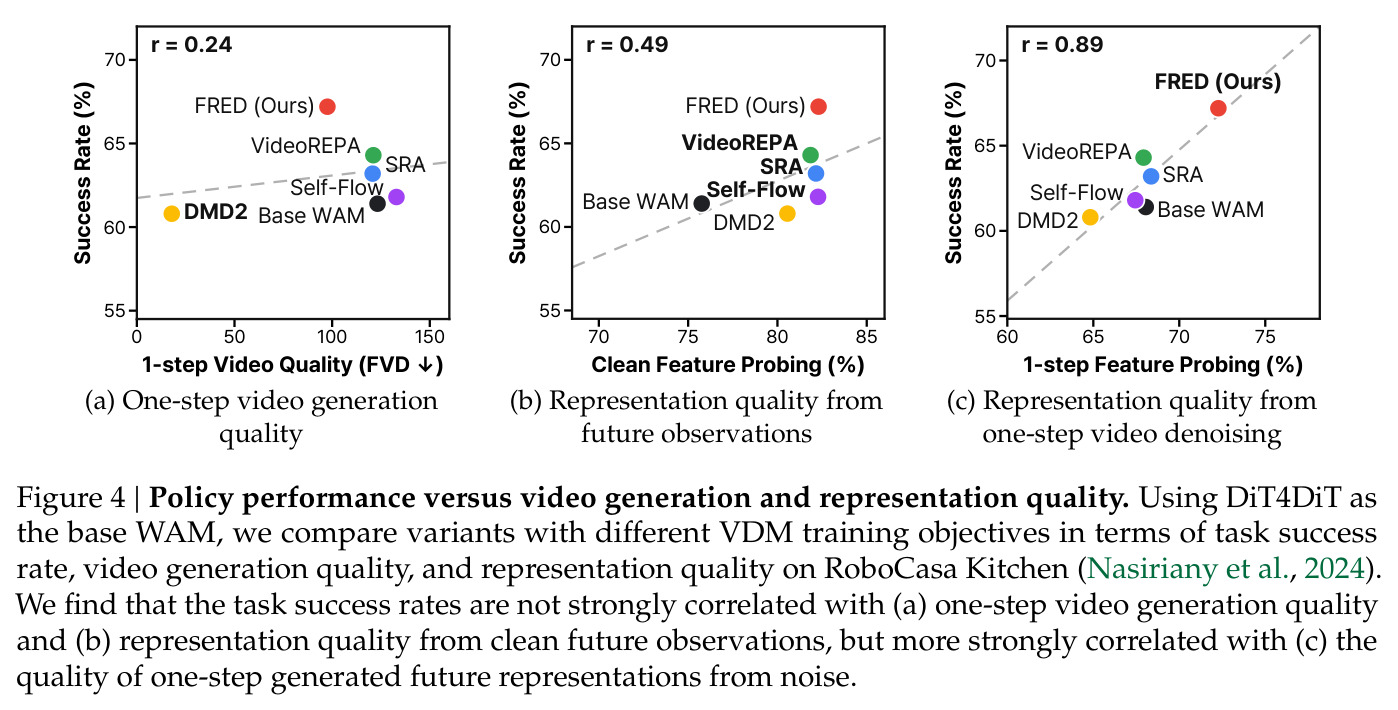
Figure 1 与 Figure 4 的核心证据都来自探测准确率,作者用它论证「从噪声一步生成的表征质量决定控制性能」(相关性 $r=0.89$)。
CKNNA
Centered Kernel Alignment 的最近邻版本,用于比较两个网络表征空间的结构相似度:先对特征做中心化,再检验两组表征在样本间的最近邻关系是否一致。值越高说明两组特征的相对几何结构越接近,对噪声和线性变换鲁棒。
论文用 CKNNA 量化「从噪声生成的表征」与「干净未来观测的表征」的结构对齐程度,是 Figure 1b 的关键指标,支撑蒸馏目标合理性的论证。
研究动机
将预训练视频扩散模型(VDM)改造成世界动作模型(WAM)已成为学习通用机器人策略的主流路线。为满足实时控制需求,最新一代 WAM(DiT4DiT、Fast-WAM、AGRA 等)采用「单步去噪 + 独立动作解码器」架构:VDM 只从高斯噪声 $\epsilon\sim\mathcal{N}(0,I)$ 做一次前向传播,取中间隐状态 $h$ 交给轻量 DiT 解码器预测动作,避开大骨干的迭代去噪。问题在于动作解码器直接消费这些中间表征,策略好坏完全取决于 $h$ 是否编码了充分的未来机器人-物体动态。作者通过探测实验发现:从噪声生成的隐状态确实随训练逐渐携带未来运动信息(10 万步内探测准确率持续上升、与干净未来观测表征的 CKNNA 相似度同步提高),但与直接从干净未来帧提取的同层表征相比仍存在明显精度差距。这一差距直接反映在控制性能上:5B 规模最强基线在域外任务成功率仅 10.4%、长时程任务仅 31.7%,DiT4DiT 域外甚至为 0.0%,说明「从噪声一步生成足够有信息量的未来表征」正是此类 WAM 的性能瓶颈。
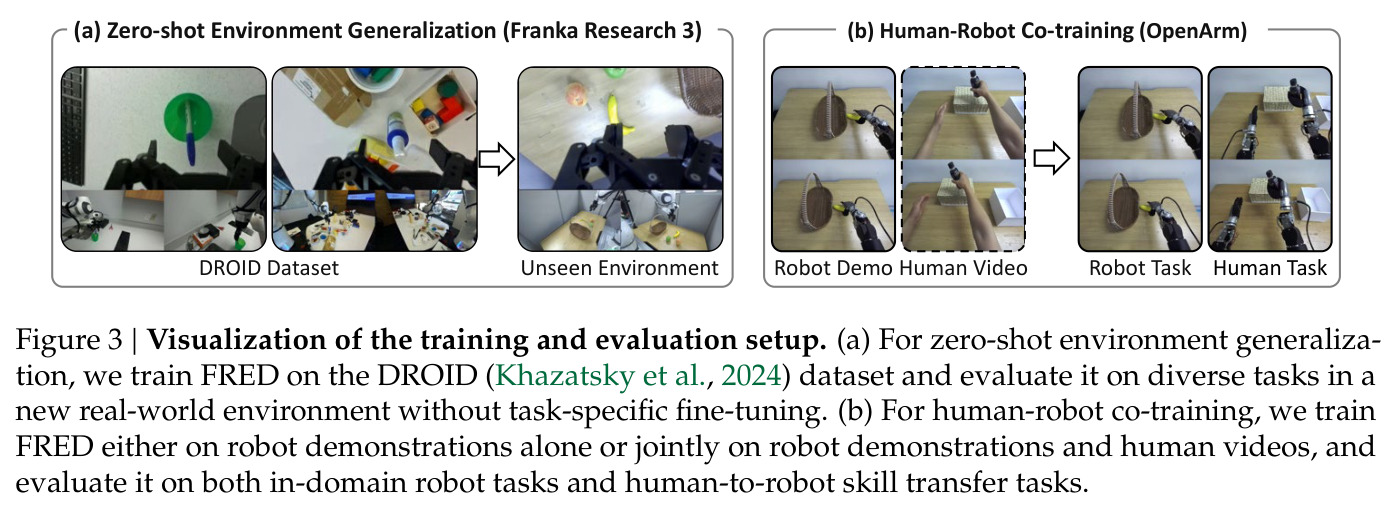
本文的目标是本文的目标是系统性提升单步去噪型 WAM 中未来视频表征的质量,从而直接改善动作预测与泛化能力。作者提出把 VDM 重新解读为「未来表征生成器」$h=f_\theta(\epsilon\mid o_t,c)$:输入当前观测与任务指令,从纯噪声一步生成供动作解码器使用的中间表征。训练目标由此从「生成高质量视频」转向「从噪声生成尽可能接近真实未来观测表征的表征」。具体量化目标包括三个层面:其一,缩小从噪声生成表征与干净未来观测表征之间的探测精度差距(Figure 1a);其二,提升两者在 CKNNA 结构相似度上的对齐程度(Figure 1b);其三,把表征质量提升转化为真实世界控制收益——DROID 零样本环境泛化中长时程任务进度从 61.7% 提到 81.7%、域外任务从 10.4% 提到 52.1%,OpenArm 人形机器人上人到机器人技能迁移成功率从 19.4% 提到 50.0%,同时保持单步推理低延迟(14B 仅 0.406 秒)。
与已有工作不同的是,与已有扩散表征学习工作的本质差异在蒸馏目标的选择。REPA/VideoREPA 将扩散模型中间特征对齐到外部冻结视觉编码器(如 DINOv2)的表征,SRA 用扩散模型自身较低噪声水平的特征作目标,Self-Flow 把自监督目标嵌入流匹配,但它们都不是针对「从噪声一步生成的表征直接决定动作解码器输入」这一 WAM 特有场景设计的。FRED 的独特切入是:用动量教师(EMA 学生副本)从带噪真实未来观测 $o^\tau_{t+1}=(1-\tau)o_{t+1}+\tau\epsilon$ 提取同层表征作蒸馏目标,让「未来观测」而非「外部编码器」定义表征该长成什么样,从而保留 VDM 的预训练时空先验、不把中间特征锚死在固定外部表征空间。叠加历史观测条件化提供运动上下文、阻断动作损失回传梯度两个设计,作者把表征学习从辅助正则升级为 WAM 训练的核心目标,并用相关性分析($r=0.89$ 对 $r=0.24$)证明一步生成表征质量才是控制性能的关键变量,而非视频生成质量。
核心方法
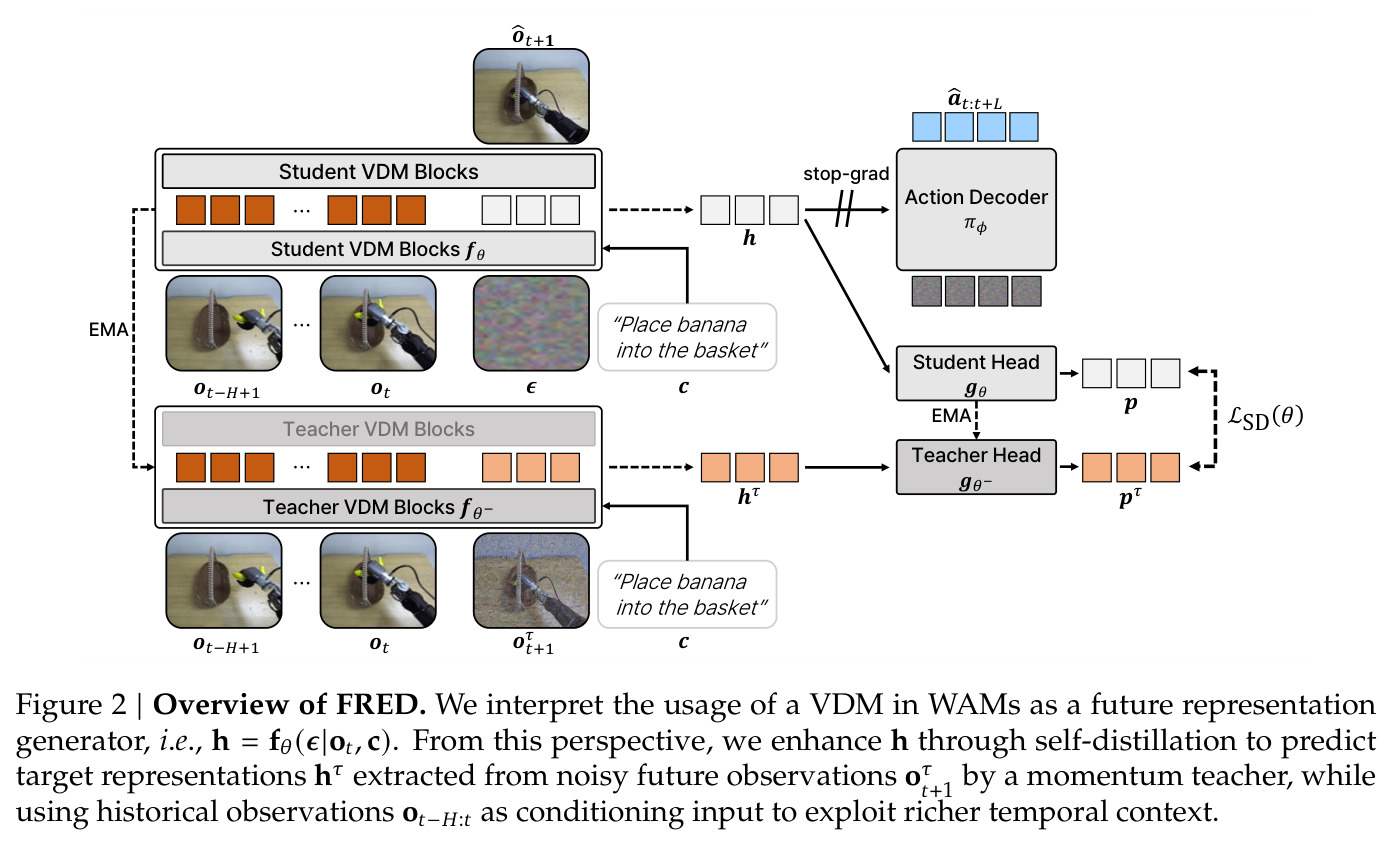
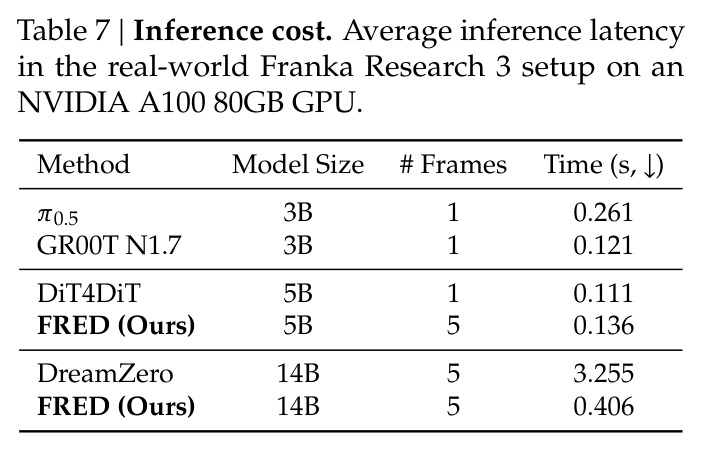
FRED 的整体思路一句话概括:既然动作解码器只消费「从噪声一步生成的未来表征」,那就直接监督这个表征。直觉上,让一次前向传播凭空从高斯噪声猜出未来画面很难,但如果有一个老师能看着带轻度噪声的真实未来帧提取「标准答案」表征,学生就可以通过模仿老师学会从「当前状态 + 噪声」到「未来表征」的映射。技术上,FRED 保持 WAM 架构不变(视频骨干 + 独立 DiT 动作解码器),在视频骨干第 18 层(5B)或第 25 层(14B)取中间表征 $h$,视频支路同时训练流匹配损失 $\mathcal{L}_{FM}$ 与自蒸馏损失 $\lambda_{SD}\mathcal{L}_{SD}$(默认 $\lambda_{SD}=0.01$),动作解码器单独用流匹配损失训练且不回传梯度到视频骨干。学生输入噪声 $\epsilon$ 与 4 帧历史观测 $o_{t-H:t}$,EMA 动量教师输入带噪未来帧(教师噪声水平 $\tau=0.25$),二者经 patch 级投影头后用 KL 散度对齐。推理时单步前向得 $h$,动作解码器用 Euler ODE 输出动作块,5B 与 14B 规模推理延迟分别仅 0.136 秒与 0.406 秒,比多步去噪的 DreamZero(3.255 秒)快约 8 倍。
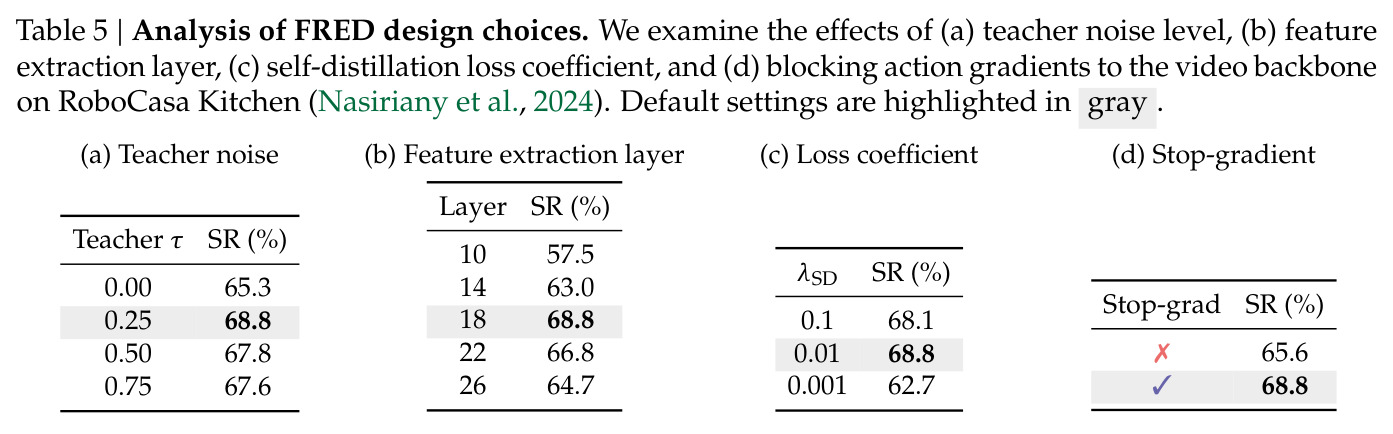
核心创新是把「未来表征生成」显式化为训练目标,并用自监督蒸馏闭环实现,与已有方法的本质区别有三点。其一,蒸馏目标是「真实未来观测的表征」而非外部编码器表征:动量教师 $f_{\theta^-}$ 从带噪未来帧 $o^\tau_{t+1}=(1-\tau)o_{t+1}+\tau\epsilon$ 提取同层特征 $h^\tau$,学生 $f_\theta$ 从噪声生成 $h=f_\theta(\epsilon\mid o_t,c)$,两者在同一表征空间对齐,避免把中间特征强行拉向固定的外部表征分布(这是与 AGRA 对齐冻结编码器的根本不同),VDM 预训练先验得以保留。其二,教师输入用中等噪声水平 $\tau=0.25$ 而非干净帧:消融显示 $\tau=0$ 仅 65.3%、$\tau=0.25$ 达 68.8%,作者推测中等损坏水平的扩散表征信息量最大,这与「扩散特征在中间噪声最强」的已有观察一致。其三,损失采用 DINO 式 patch 级 KL:$p=\mathrm{softmax}(g_\theta(h)/\gamma_1)$,教师端中心化并锐化 $p^\tau=\mathrm{softmax}((g_{\theta^-}(h^\tau)-m)/\gamma_2)$ 防止坍缩。叠加历史条件化与阻断动作梯度(65.6%→68.8%),构成完整框架。
方法步骤详情
训练与推理流程分五步。第一步构造输入:从专家演示取出历史观测 $o_{t-H:t}$(默认 4 帧历史加当前帧)、当前帧 $o_t$、指令 $c$、真实未来观测 $o_{t+1}$ 与本体状态 $q_t$。第二步学生前向:高斯噪声 $\epsilon\sim\mathcal{N}(0,I)$ 经过学生视频骨干前若干层 $f_\theta$(条件于 $o_t$、历史与 $c$)得到中间表征 $h=f_\theta(\epsilon\mid o_t,c)$,取第 18 层(5B)/第 25 层(14B)特征,同时送入动作解码器 $\pi_\phi(a^\tau\mid q_t,h)$ 与学生投影头。第三步教师前向:EMA 教师 $f_{\theta^-}$ 处理带噪未来帧 $o^\tau_{t+1}=(1-\tau)o_{t+1}+\tau\epsilon'$($\tau=0.25$)得到目标表征 $h^\tau$,经教师投影头 $g_{\theta^-}$ 并中心化。第四步计算自蒸馏损失 $\mathcal{L}_{SD}=\frac{1}{N}\sum_i\mathrm{KL}(p^\tau_i\Vert p_i)$,与视频流匹配合成 $\mathcal{L}_{video}=\mathcal{L}_{FM}+\lambda_{SD}\mathcal{L}_{SD}$;教师按 $\theta^-\leftarrow m\theta^-+(1-m)\theta$ 更新。第五步动作流匹配损失只更新解码器 $\phi$,不更新视频骨干。推理时单步前向得 $h$,动作解码器用 Euler ODE 采样输出未来 $L$ 步动作。
技术新颖性
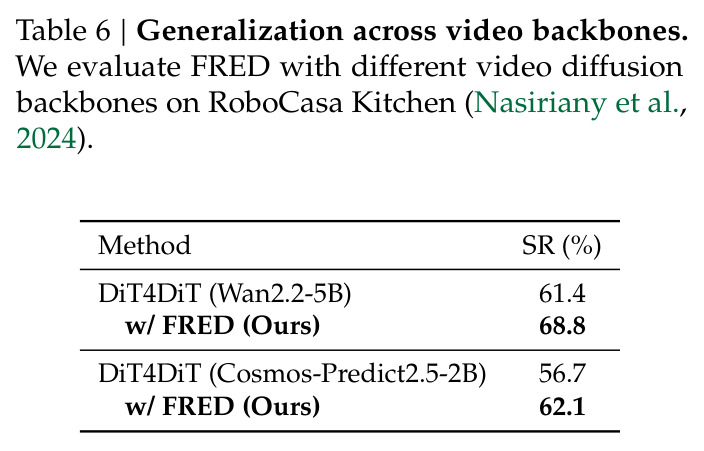
技术新颖性体现在四个层面。第一,视角创新:论文把 VDM 在 WAM 中的角色重新定义为「未来表征生成器」,并用探测实验(Figure 1)证明该表征随训练自然涌现但仍不充分,这为「直接监督它」提供了实证依据,而不是把隐状态当作视频生成的副产品。第二,目标设计创新:蒸馏目标取自动量教师看到的带噪未来观测,且最优噪声水平为 $\tau=0.25$ 而非 0,区别于 SRA 用低噪声自身特征、VideoREPA/AGRA 对齐外部冻结编码器的做法,蒸馏发生在模型自己的表征空间内。第三,工程化创新:历史条件化(去掉后 68.8%→64.8%)、特征层选择(第 18 层最优 68.8%,浅至第 10 层仅 57.5%)、损失系数 $\lambda_{SD}=0.01$、动作梯度阻断等设计均有系统消融支撑,且方法跨骨干通用(Wan2.2-5B、Wan2.1-14B、Cosmos-Predict2.5-2B 上 56.7%→62.1%)。第四,评估方法创新:用未来运动原语探测、CKNNA 结构相似度与三方相关性分析($r=0.89$ 对 FVD 的 $r=0.24$)把「表征质量—控制性能」链条量化,为后续 WAM 研究提供了新的评价维度。
实验结果
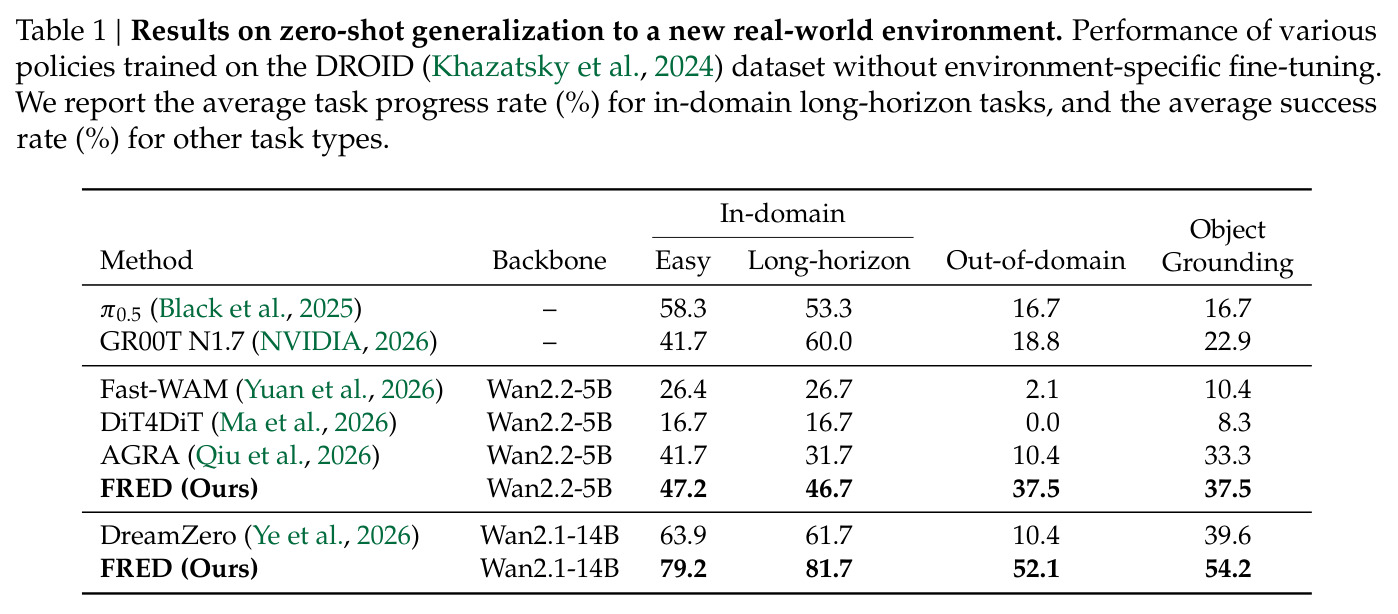
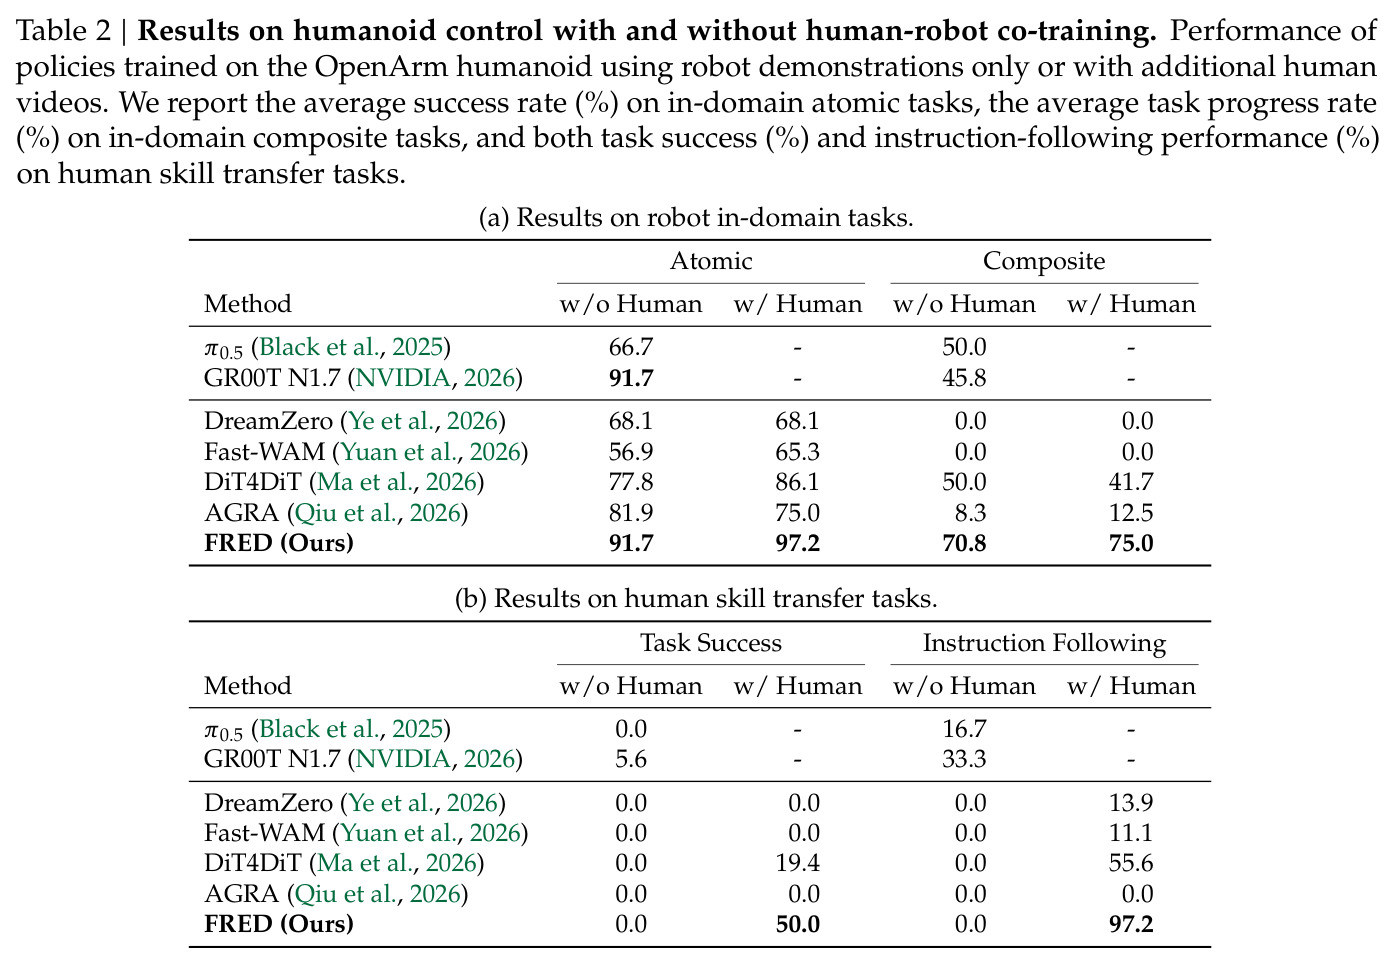
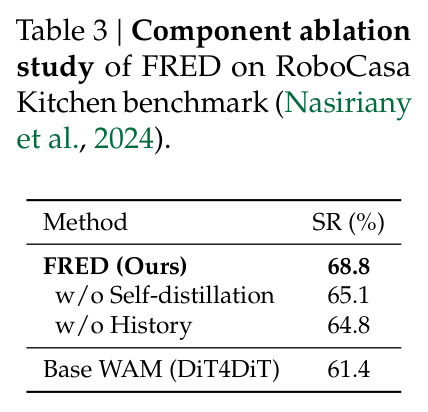
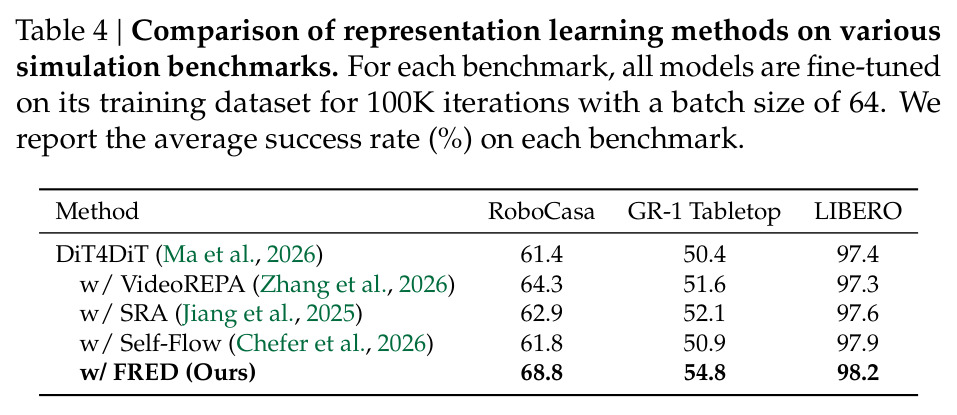
核心发现分四块。第一,零样本环境泛化(Table 1):5B 规模 FRED 在简单/长时程/域外/接地任务达 47.2%/46.7%/37.5%/37.5%,全面超过 AGRA(41.7%/31.7%/10.4%/33.3%)与 DiT4DiT(域外 0.0%);14B 规模达 79.2%/81.7%/52.1%/54.2%,较同骨干 DreamZero(长时程 61.7%、域外 10.4%)大幅领先,也超 π0.5 与 GR00T N1.7。第二,人到机器人技能迁移(Table 2):FRED 在仅有人类演示的任务上成功率 50.0%、指令遵循 97.2%,远超最强基线 DiT4DiT 的 19.4%/55.6%,DreamZero、AGRA、Fast-WAM 成功率均为 0;不共训人类视频时所有方法成功率接近 0;共训还使域内原子任务 91.7%→97.2%、复合任务 70.8%→75.0%。第三,消融与对比(Table 3、4):RoboCasa Kitchen 上 FRED 68.8%,去自蒸馏降为 65.1%,去历史条件降为 64.8%,基线 DiT4DiT 仅 61.4%;对比 VideoREPA(64.3%)、SRA(62.9%)、Self-Flow(61.8%),FRED 在三个仿真基准一致领先。第四,相关性分析(Figure 4):任务成功率与一步生成表征质量的相关系数 $r=0.89$,远高于与一步视频生成质量 FVD($r=0.24$)和干净观测表征质量($r=0.49$)的相关,直接支撑「表征生成器」论点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 零样本环境泛化:域外任务(DROID 训练,Wan2.1-14B) | 成功率 (%) | 52.1 | DreamZero 10.4 | +41.7 个百分点(π0.5 为 53.3 但系任务进度口径) |
| 零样本环境泛化:长时程任务(DROID 训练,Wan2.1-14B) | 任务进度率 (%) | 81.7 | DreamZero 61.7 | +20.0 个百分点 |
| 零样本环境泛化:域外任务(DROID 训练,Wan2.2-5B) | 成功率 (%) | 37.5 | AGRA 10.4 | +27.1 个百分点 |
| 零样本环境泛化:长时程任务(DROID 训练,Wan2.2-5B) | 任务进度率 (%) | 46.7 | AGRA 31.7 | +15.0 个百分点 |
| 人到机器人技能迁移(OpenArm 人形,含人类视频共训) | 任务成功率 (%) | 50.0 | DiT4DiT 19.4(DreamZero/AGRA/Fast-WAM 均为 0) | +30.6 个百分点 |
| 人到机器人技能迁移指令遵循(OpenArm,含人类视频共训) | 指令遵循率 (%) | 97.2 | DiT4DiT 55.6 | +41.6 个百分点 |
| RoboCasa Kitchen 仿真(DiT4DiT 为基线 WAM) | 成功率 (%) | 68.8 | DiT4DiT 61.4(VideoREPA 64.3 / SRA 62.9 / Self-Flow 61.8) | +7.4 个百分点 |
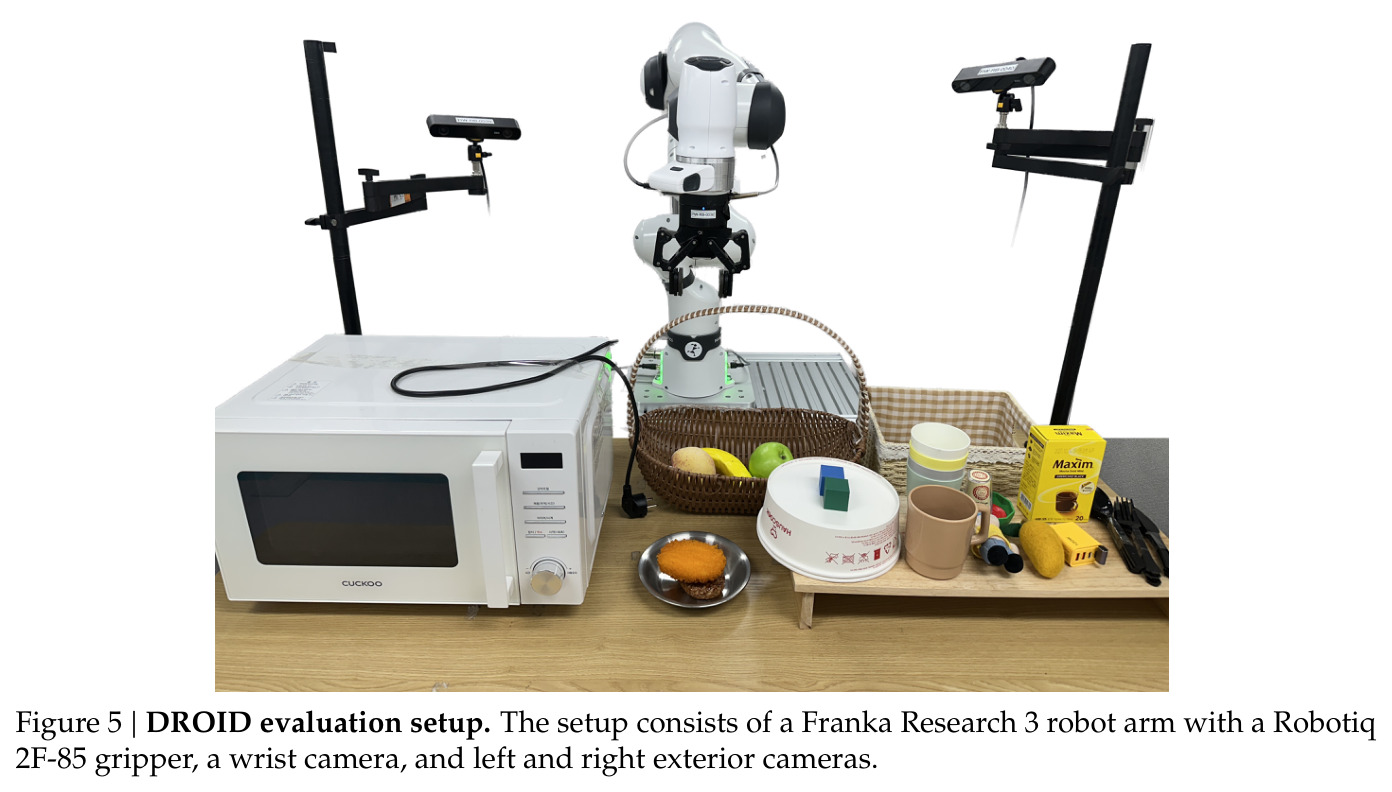
| 14B 真实机器人推理延迟(Franka Research 3,A100 80GB) | 平均单次推理时间 (秒) | 0.406 | DreamZero 3.255 | 约 8 倍加速 |
局限与改进
作者在附录 F 承认的局限与可观察到的短板包括:其一,实验依赖特定真实平台(Franka Research 3 与 OpenArm 人形)和自建任务集,DROID 评估任务与指令覆盖有限,域外任务的定义(训练指令中缺少的动作动词)带有较强主观性,结果可能对任务设计敏感。其二,教师噪声水平、特征层、$\lambda_{SD}$ 等超参通过 RoboCasa Kitchen 网格搜索得到,跨域直接复用不一定最优;自蒸馏依赖真实未来观测 $o_{t+1}$,因此只能用于有完整演示的配对数据,无法直接利用无监督视频流。其三,人类视频共训虽带来 50.0% 的迁移成功率,但距可靠部署仍有差距,且人类数据需要与机器人同环境采集,扩展到大规模互联网视频尚未验证。其四,成功率对比基于有限次数的真实机器人评估(多为几十次试验),论文未报告方差与显著性检验,19.4% 对 50.0% 这类结论的统计置信度有待确认。其五,方法假设「下一帧未来」是有效预测目标,对需要更长远时域规划或接触丰富任务的收益未量化。
独立分析的弱点
独立分析可见几个弱点。第一,蒸馏目标依赖真实未来观测,限制了从无动作、无未来配对的海量互联网视频中学习表征的可能,一个直接改进是教师输入改用模型自身预测的未来帧,或设计多步噪声课程在纯视频上预训练表征生成器。第二,自蒸馏只在单一层(第 18/25 层)施加且要求与动作解码器取特征同层,层选择与噪声水平、损失系数耦合,调参负担重,可探索多层一致性损失或自适应层选择。第三,KL 蒸馏在 patch 级对齐,可能忽略全局时序一致性,对长时程任务可引入时序加权的蒸馏权重或多步未来目标。第四,动作梯度阻断虽提升平均成功率(65.6%→68.8%),但意味着动作目标完全无法塑造表征,未来可探索可学习的梯度缩放而非硬阻断。第五,指令遵循 97.2% 与成功率 50.0% 的差距表明模型常常「知道要做什么但做不对」,提示低层技能先验或人类数据规模仍是瓶颈。第六,真实机器人评估试验次数有限且未报告置信区间,50.0% 对 19.4% 的结论稳健性需要第三方大规模复现确认。
未来方向
作者在结论与附录 F 中希望这项「表征学习与 WAM 结合」的工作能推动高效、可泛化的机器人基础模型研究。基于成果可延伸的方向包括:第一,把自蒸馏目标扩展到互联网规模无动作视频,先以纯视频自蒸馏预训练表征生成器,再在机器人数据上微调,充分释放视频预训练价值;第二,探索更长的未来时域与层级化目标(预测多帧未来、子目标表征),服务长时程任务规划;第三,将 FRED 与一步视频生成蒸馏(如 DMD2)结合,检验表征质量与生成质量能否同时提升——Figure 4 显示两者相关性很弱($r=0.24$),值得拆解研究;第四,把人类视频来源从同环境演示扩展到 egocentric 大规模数据集(如 Ego4D),测试跨视角、跨具身的技能迁移上限;第五,在动作解码器端引入一致性蒸馏进一步压缩延迟,逼近更高频控制;第六,从理论上解释为何中等噪声水平($\tau=0.25$)的教师目标最优,与扩散表征随噪声水平变化的规律建立更一般的联系。
复现评估
复现条件较为友好。代码开源于 GitHub(suhyeok-jang/FRED),模型权重发布在 HuggingFace(FRED-AGI-LAB/models),附录 A 给出关键实现细节:5B 用 Wan2.2-TI2V-5B 骨干加 16 层 DiT 解码器,14B 用 Wan2.1-I2V-14B 加 24 层解码器,特征层(第 18/25 层)、$\lambda_{SD}=0.01$、教师噪声 $\tau=0.25$、4 帧历史、EMA 反向衰减 warmup 调度均有说明。数据方面 DROID 公开可用,但 OpenArm 人形机器人数据与人类视频为自采,附录 G 提供了完整基准数字。算力方面仿真部分(RoboCasa、GR-1 Tabletop、LIBERO)训练 10 万步、batch 64,可在多卡服务器复现;真实机器人评估需要 Franka Research 3 或 OpenArm 实体硬件,14B 规模需 A100 80GB 级别多卡。总体而言:仿真结论与消融趋势复现难度中等,自蒸馏损失与 EMA 教师代码量小、易于移植到其他 WAM 代码库;但零样本环境泛化与人机迁移结论因自建任务和硬件门槛,完全复现难度偏大。
论文图表
两个子图:(a) 以 DiT4DiT 为基座 WAM,展示从噪声生成的隐状态($\tau=1.0$)在未来运动原语探测上的准确率随训练迭代(2 万到 10 万步)持续上升,但始终低于从干净未来观测提取的表征($\tau=0.0$)的探测准确率;(b) 用 CKNNA 度量从噪声生成的表征与干净未来观测表征的结构相似度,同样随训练上升,FRED 训练后进一步拉近两者。
这是动机部分的核心证据:证明「从噪声一步生成的表征确实是 WAM 的信息瓶颈」,直接引出 FRED 的设计动机,是理解全文逻辑链的起点。