HARMONY:面向单目图像到三维场景合成的分层智能体推理框架 HARMONY: Hierarchical Agentic Reasoning for MONocular Image-to-Scene Synthesis
分层VLM思维链推理搭配VGGT几何精修,从单张照片重建语义与几何双对齐的组合式3D室内场景
前置知识
视觉几何基础模型(VGGT)
VGGT(Visual Geometry Grounded Transformer)是一类前馈 Transformer,输入一张或多张图像即可直接输出稠密点图、相机内外参与深度估计。它把传统 SfM/MVS 多步流水线压缩为一次前向推理,但在单目输入下,点云在被遮挡区域和小物体处噪声较大、估计不完整。
HARMONY 全流程依赖 VGGT 提供点云、相机参数和曼哈顿坐标系,是相机标定与深度精修两步的几何基座;不理解它的输出形式,就无法看懂第 3.1 节标定和第 3.3 节尺度求解。
VLM 与智能体推理(Agentic Reasoning)
VLM 是同时接收图像与文本输入的大模型(本文用 GPT-5.5),具备开放词汇识别、空间关系描述与代码生成能力。智能体推理指把复杂任务拆解为多步思维链,让模型按『观察—行动—自我批评—修正』的循环迭代执行,而不是一次性端到端输出结果。
HARMONY 的核心正是让 VLM 以分层思维链规划家具的摆放顺序、朝向与配对关系,并用反思回路自我纠错;理解 agentic 范式才能分清它与端到端重建网络的本质差别。
曼哈顿世界假设
室内场景中墙面、地板、天花板与大型家具的边缘大多沿三根互相正交的主轴排列,这一先验称为曼哈顿假设。实现上通常对表面法线做 SVD 聚类估计出三根主轴,再沿各轴做直方图拟合定位地板、天花板与墙体所在平面。
论文靠该假设从 VGGT 点云中定位最深的墙角锚点 $X_f, X_c$,并据此闭式求解相机的相似变换,是理解相机标定数学推导的前提。
组合式(Compositional)3D 场景重建
与 NeRF、3D 高斯等整场一次成型的隐式表示不同,组合式重建把场景表示为『空房间几何 + 独立物体网格 + 每个物体的位姿与材质』的集合。物体分别生成、单独放置,因此可编辑、可复用,还能直接导出给物理引擎与机器人仿真器。
HARMONY 的输出形态正是组合式场景(每个物体 $O_i=(M_i,T_i,p_i,\Theta_i)$),理解它与整体表示的差异,才能明白为什么必须做逐物体检测、关系推理与摆放。
Chamfer 距离与 F-score
Chamfer 距离衡量预测点云与真值点云之间双向最近邻距离的均值,越小几何越准;F-score 在给定距离阈值下统计预测点与真值点互相匹配上的比例,如 F@0.1 较宽松、F@0.001 非常严苛,能反映细粒度对齐质量。
论文在 Front3D 上用 CD 与三档阈值 F-score 评估几何质量,是判断 HARMONY 相对 CAST、SAM3D 等基线在几何精度上领先幅度的关键指标。
PBR 材质与重光照
基于物理的渲染(PBR)用粗糙度、金属度、折射率(IOR)、透射率等参数刻画材质表面,使同一几何在不同光照条件下渲染出真实外观。先估计这些材质参数与光源属性,再用 Blender Cycles 这类路径追踪器即可对重建场景做照片级重光照。
HARMONY 第 3.4 节和附录 C.5 让 VLM 估计每个物体的 PBR 因子与每个光源的开关、颜色、强度,这是其渲染结果在感知指标上占优的原因之一。
研究动机
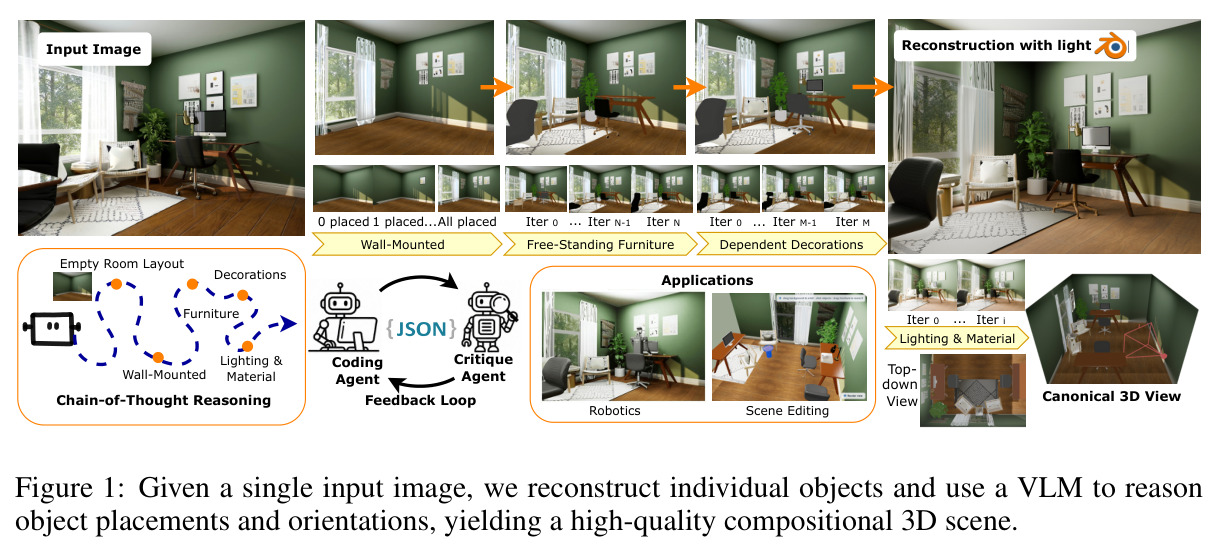
从单张室内照片恢复完整 3D 场景是本质病态问题:单视角只能拍到部分几何,物体间遮挡严重,2D 图像也不提供精确尺度与空间关系线索。现有工作走两条路且各有硬伤。第一条是基于视觉几何与生成模型的自底向上流水线(Gen3DSR、CAST、3D-RE-GEN、SAM3D 等):先估计点云/深度,再分割、修补、逐物体重建,最后靠低层感知信号对齐拼装;由于缺少对物体间关系(例如椅子该朝向书桌哪一侧)的显式推理,它们在遮挡物体和小装饰品上频繁出错——物体朝向噪声大、支撑关系断裂(悬浮或穿透)、小物件整只丢失。第二条是用 VLM 做空间推理:文本条件方法(如 SceneSmith)只能通过资产检索加手工先验(如『床的默认朝向』)摆放,局限于简单物体的模板化布局;图像条件方法(VIGA、SAGE)虽与输入语义对齐,却受制于 VLM 无法做精确数值与视觉-几何推理的固有弱点,摆放位置不准,渲染结果与输入可见失配。语义理解与几何精度此前始终难以兼得。
本文的目标是本文的具体目标是:给定一张室内场景的单目照片,输出一个组合式 3D 场景——包含空房间几何(墙、地板、天花板与门窗开口),以及每个物体的网格、纹理、位姿和 PBR 材质参数——使得从输入视角渲染的图像在语义与感知上都与参考图高度一致,同时物体间保持正确的空间关系(靠墙、放在上面、朝向、成组配对)。方法层面要求完全由现成基础模型组合编排、零训练零微调,从照片到可导入 Blender/Isaac Sim 的 full.glb 全程无人工干预;评测上要求在带 3D 真值的合成数据(Front3D)和真实照片上都优于现有重建基线,并把单图组合式重建的适用范围从简单物体场景推进到复杂、杂乱的真实室内。
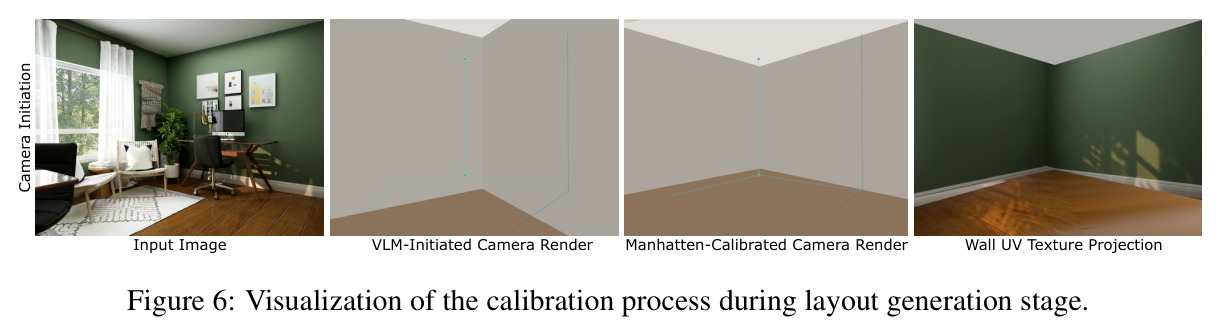
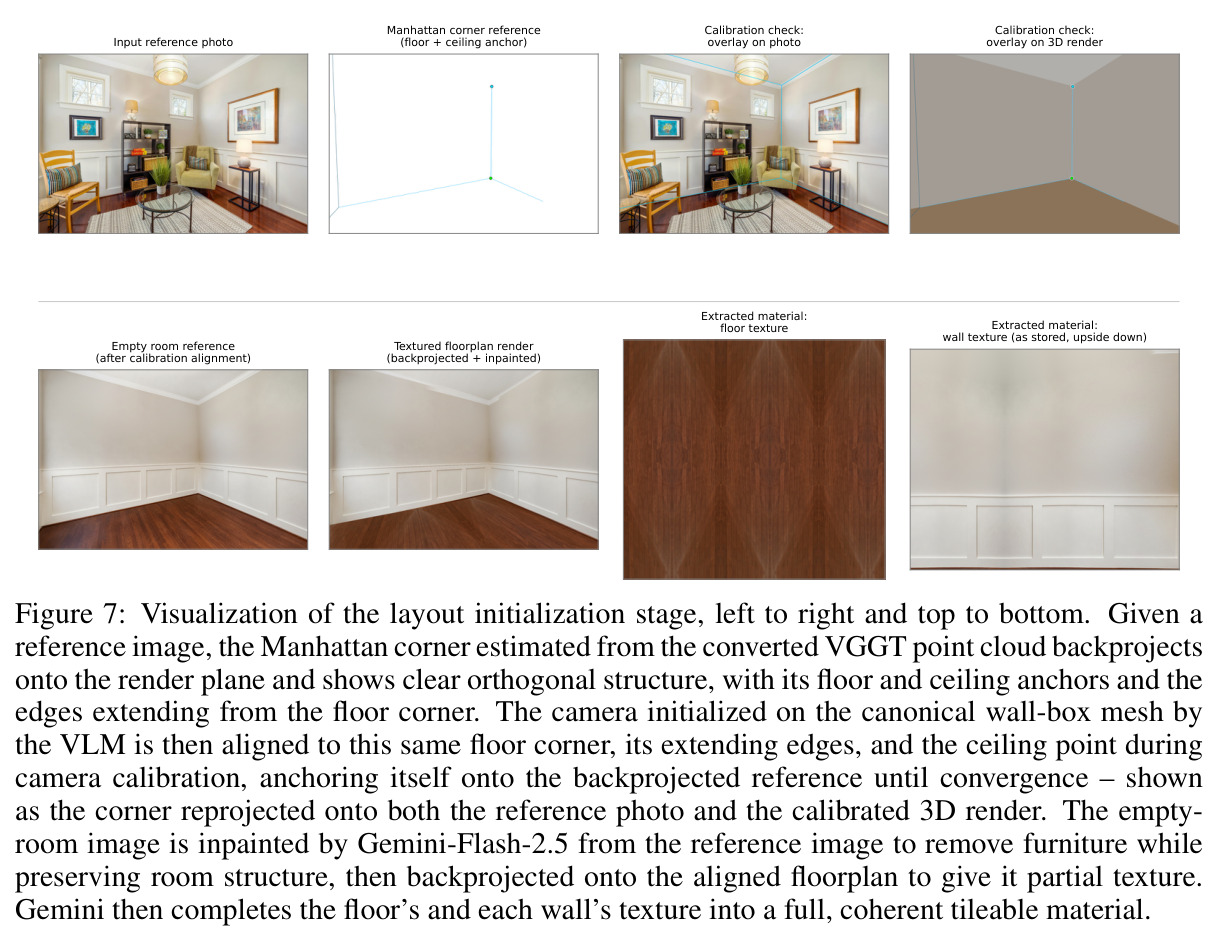
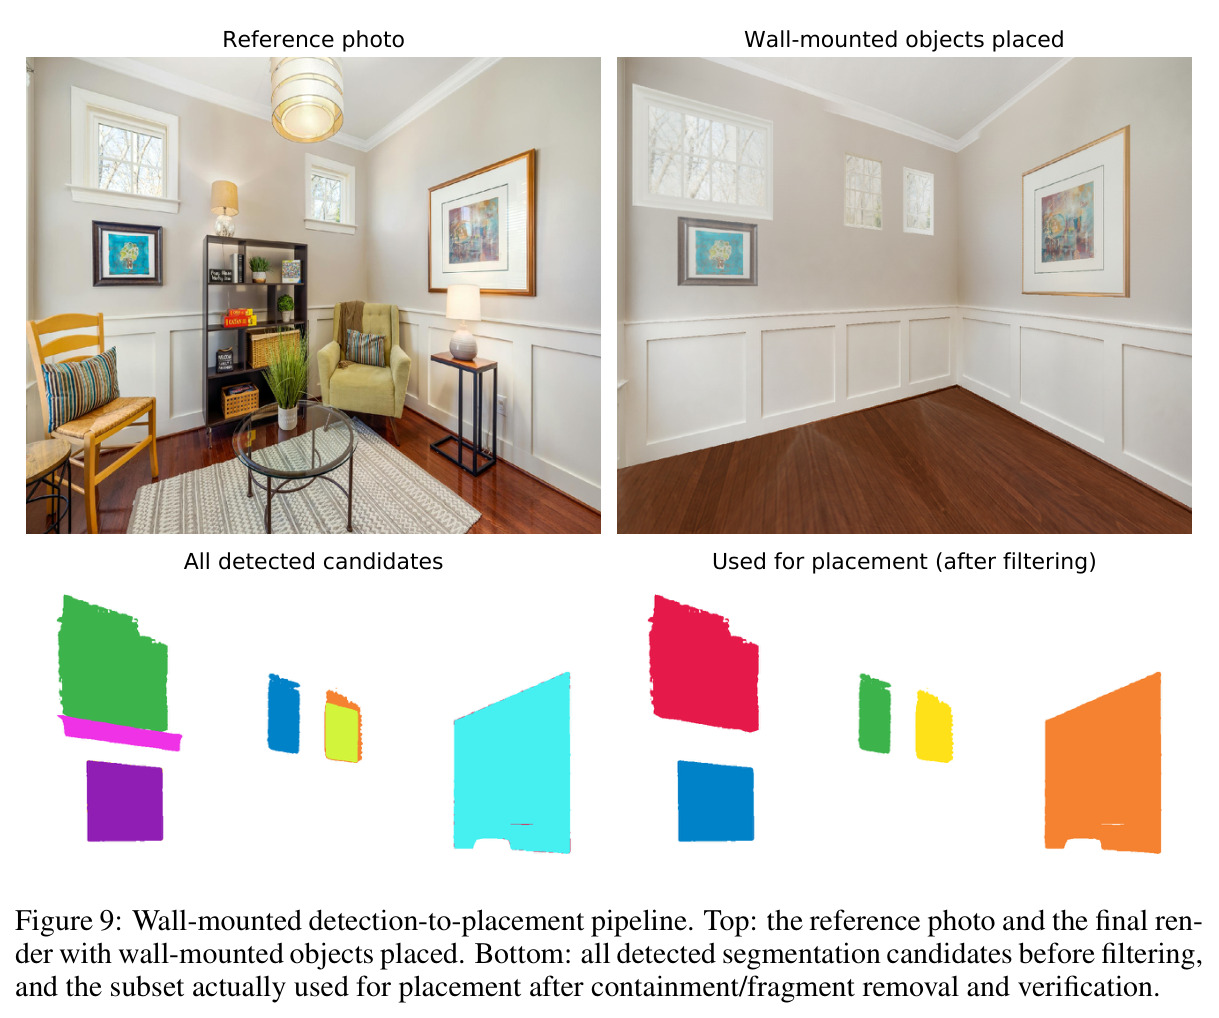
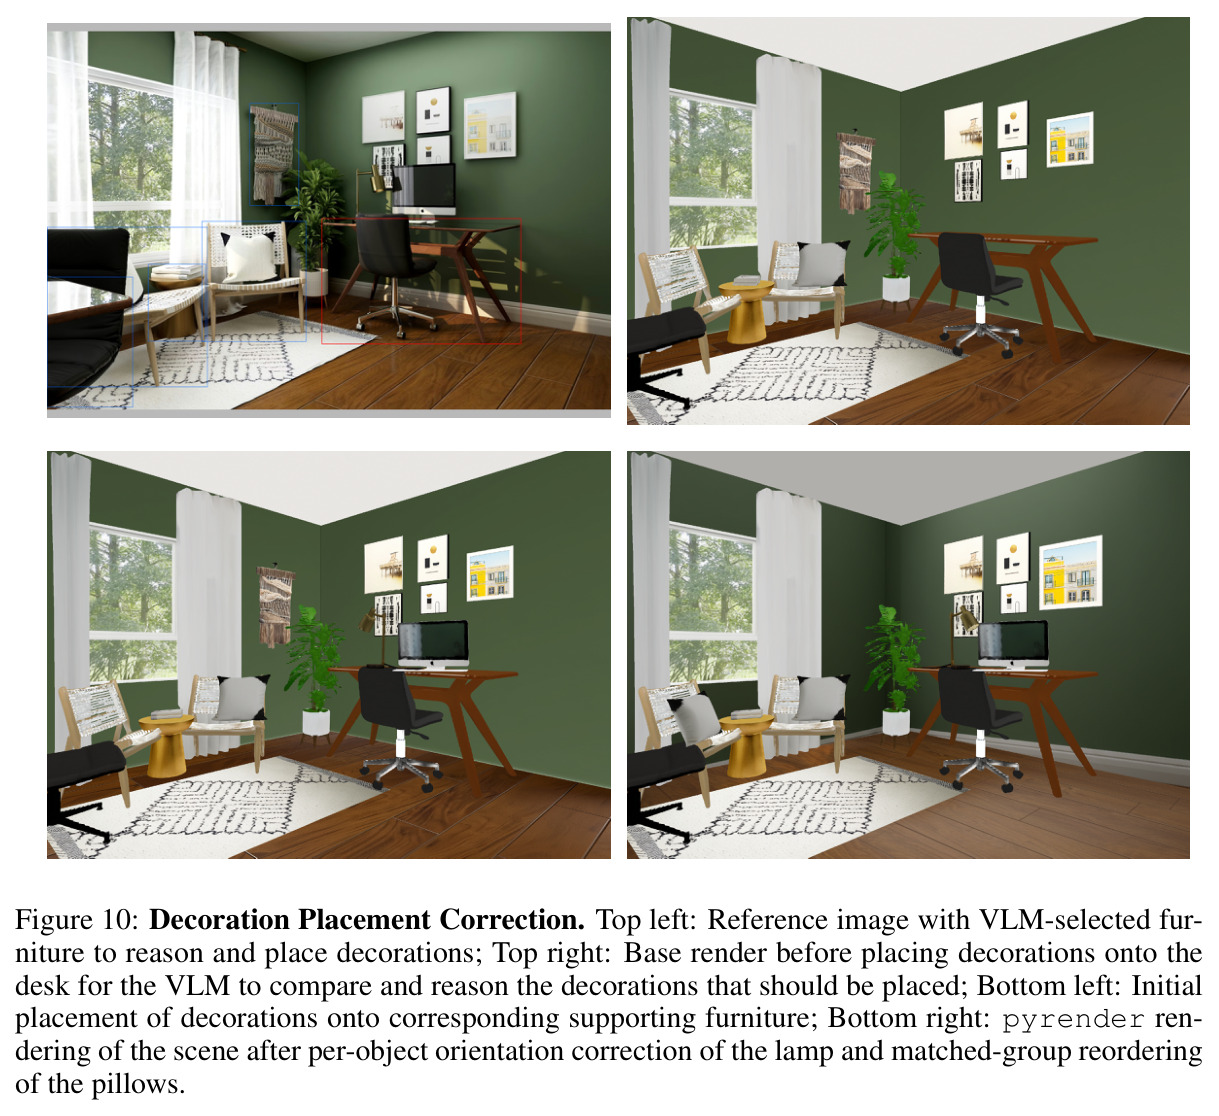
与已有工作不同的是,本文的独特切入是把『VLM 管语义关系、几何模型管度量精度』组织成分层思维链流水线,而非两者各自为战或简单串联。三个关键差异点:(1) 在任何摆放之前,先用 VLM 找语义锚点(图像中最深的房间角落)、用 VGGT 找几何锚点(曼哈顿坐标系下的最深地板角),再用一个闭式相似变换把两个锚点钉在一起完成相机标定,为后续所有推理建立统一的语义-空间坐标系;(2) 摆放不是一次性完成,而是按『墙上物 → 家具与天花板 → 装饰品』三层推进,家具内部再按离锚角的远近做深度优先遍历——每放一个新物体时,它之前摆放的东西都在其后方,视野干净无遮挡,VLM 判断朝向与配对不受杂乱干扰;(3) VLM 给出语义正确的粗摆放后,用轮廓对齐定横向位置、用点云前表面深度定纵向距离并解开尺度-深度歧义,逐物体做几何精修;每个阶段结束还有反思式反馈回路对照输入图纠错,阻断误差向下游传播。
核心方法
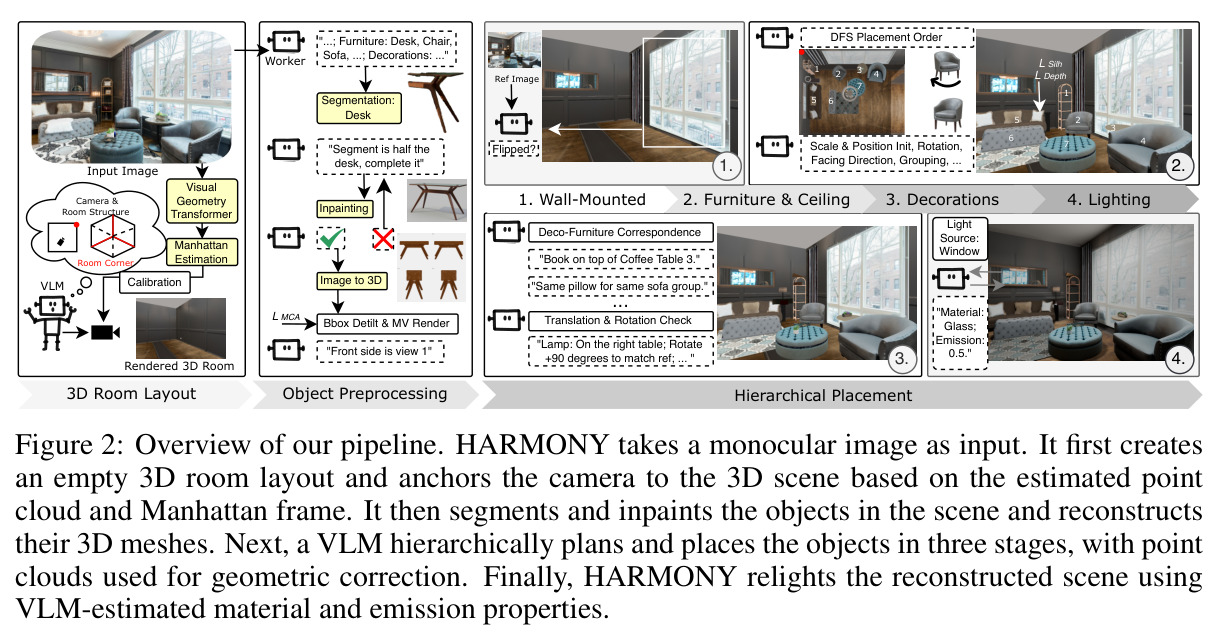
HARMONY 的直觉很朴素:重建房间就像装修——先立四面墙并确定站位(相机标定),再装墙上物件、摆大件家具、最后放桌面饰品,每做完一步都回头对照图纸检查。技术上是六阶段顺序流水线,场景表示为 $S=(G,\{O_i\})$,每个物体 $O_i=(M_i,T_i,p_i,\Theta_i)$ 携带网格、纹理、位姿与 PBR 因子。阶段一:VLM 从参考图估计房间尺寸先验(如卧室约 $(3,4,3)$ 米)并识别最深墙角,VGGT 从点云估计曼哈顿坐标系,闭式求解相似变换完成相机标定。阶段二:分层检测物体(LocateAnything + SAM2),VLM 描述加 Gemini 图像编辑修补遮挡,Hunyuan3D-2 生成网格,PCA 规范化后由 VLM 标注正面朝向。阶段三:VLM 按锚角深度优先顺序推理摆放,每个物体放置后做轮廓-点云双路几何精修与碰撞消解。阶段四:VLM 估计材质与光源并用 Blender Cycles 重光照。每阶段后有反思回路。全程在 NVIDIA L40(46GB)上每景耗时 20–90 分钟,平均每物体调用 VLM 3.4 次,无人工干预。
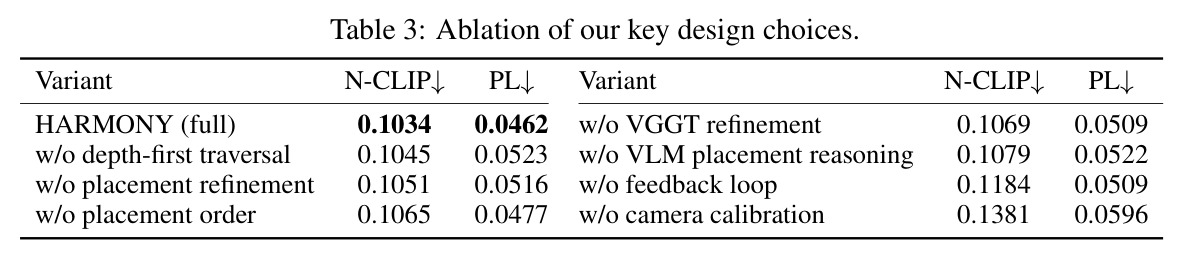
核心创新是把场景重建重构为『有全局几何锚定的结构化图像监督推理』。与已有方法的本质区别有三。其一,已有 agentic 方法(如 VIGA)只对最终渲染做整体批评,缺乏对单个物体位姿的直接几何监督;HARMONY 在每个物体放置后立即做两路耦合精修:图像空间用分割掩码对齐轮廓,水平偏移 $\Delta u = \hat{u}_c - u_c$ 反投影为横向平移 $p \leftarrow p + \frac{\Delta u}{f_x} Z \hat{r}$,表观角尺寸 $\alpha = \hat{w}/f_x = s\, w_{\mathrm{obj}}/Z$ 只能确定尺度-深度比 $s/Z$;深度空间用 VGGT 点云前表面的稳健均值(迭代中值加 MAD 剔除离群点)校正 $Z'$,最终真实尺度 $s = \alpha Z'/w_{\mathrm{obj}}$——轮廓与深度信息互补而非冗余。其二,深度优先遍历利用『后放者必在前景』的观察,让 VLM 始终在无遮挡的干净视图里判断朝向与配对。其三,每阶段的反思式反馈(缺失补齐、成组尺寸均衡、错误配对重挂)把错误就地修复。消融显示去掉相机标定 N-CLIP 从 0.1034 劣化到 0.1381、去掉反馈回路劣化到 0.1184,证明这些设计正是性能来源。
方法步骤详情
第一步,房间布局与相机初始化:VLM 估计房间尺寸先验并标记最深墙角与各墙面标签;VGGT 输出点云、内参 $K$ 与外参 $(R_0,t_0)$,经 SVD 法线聚类得曼哈顿三轴 $a_w, a_v, a_d \in \mathbb{R}^3$,直方图拟合六个包围平面,取地板与两面墙的交点为最深地板角 $X_f$ 及其正上方的 $X_c$;闭式求解尺度 $s = H_{\mathrm{room}}/\|X_c - X_f\|$、平移 $t = X_f^c - s R_{\mathrm{align}} X_f$,相机旋转 $R = R_0 R_{\mathrm{align}}^\top$、中心 $c = s R_{\mathrm{align}} c_0 + t$。第二步,物体分割与重建:分层检测(墙上物→家具/天花板→装饰),VLM 结合上下文描述(『桌子被遮一半,补全它』)交给图像编辑模型修补,Hunyuan3D-2(八叉树 384、25 步扩散、8 万面片)出网格,PCA 去倾斜后由 VLM 从 2×2 四向渲染中选正面。第三步,分层摆放:VLM 以锚角为参考给出深度优先顺序和关系描述(『沙发背靠左墙』『花瓶在书桌上』),随后做轮廓-点云精修;碰撞对取位移更小的一方 $k=\arg\min\|\delta_k\|$,无法解耦时由 VLM 重排顺序。第四步,反思回路对照渲染与输入检查缺失、错配与顺序错误,装饰阶段后清点补缺。第五步,VLM 估计 PBR 材质与光源属性,与 Cycles 渲染迭代对齐。
技术新颖性
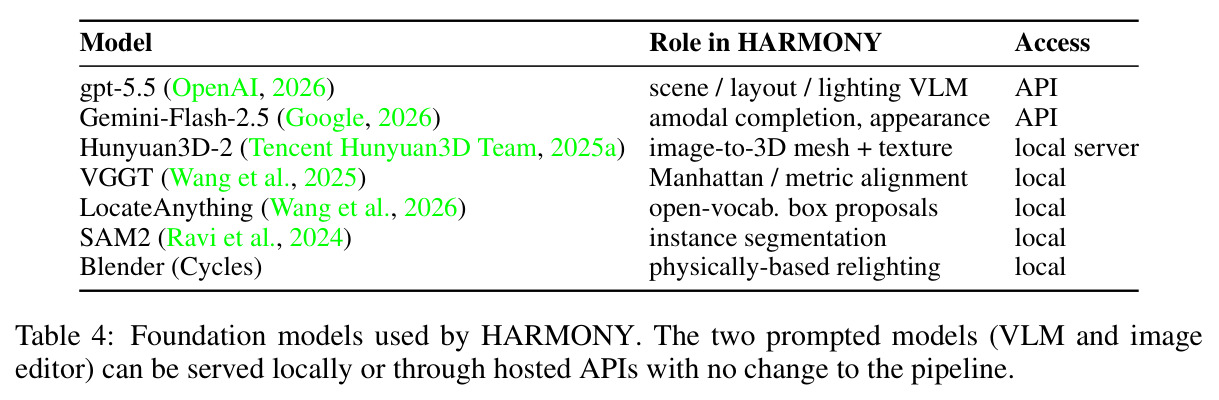
技术新颖性体现在四点。(1) 语义-几何双锚定标定:以往要么纯 VLM 估相机(数值不准),要么纯几何估计(缺语义对应),本文用 VLM 找到的语义墙角与曼哈顿几何墙角做点对,一次闭式相似变换同时解出旋转 $R_{\mathrm{align}}$、尺度 $s$ 和平移 $t$,无需任何迭代优化,且消融证明它是单项贡献最大的组件(N-CLIP 劣化 0.0347)。(2) 分层思维链摆放协议:把 SceneSmith 式的层级顺序从文本条件迁移到图像条件场景,并新增家具的深度优先遍历——『先远后近、逐层解锁干净视野』的顺序设计是本文独有的,去掉它 PL 从 0.0462 升到 0.0523。(3) 耦合的轮廓-深度精修:作者敏锐指出轮廓固有地无法区分物体尺度和深度(只能约束比值 $s/Z$),于是先用它定横向位置与比值,再用点云定绝对深度反解真实尺度,两路信号各司其职。(4) 阶段门控的反思式反馈:不同于 VIGA 只在末端对完整渲染做整体批评,HARMONY 在每个摆放阶段后对照参考图检查缺失项、错误配对与排序问题,还能对成组物体(如成对座椅)做尺寸均衡与位置重排。整个过程零训练,全部由 GPT-5.5、Gemini-Flash-2.5、Hunyuan3D-2、VGGT、SAM2、Blender 等现成模型编排完成。
实验结果
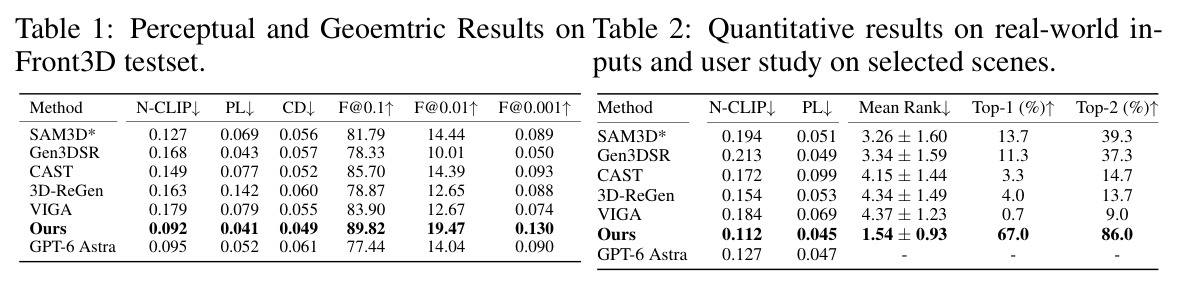
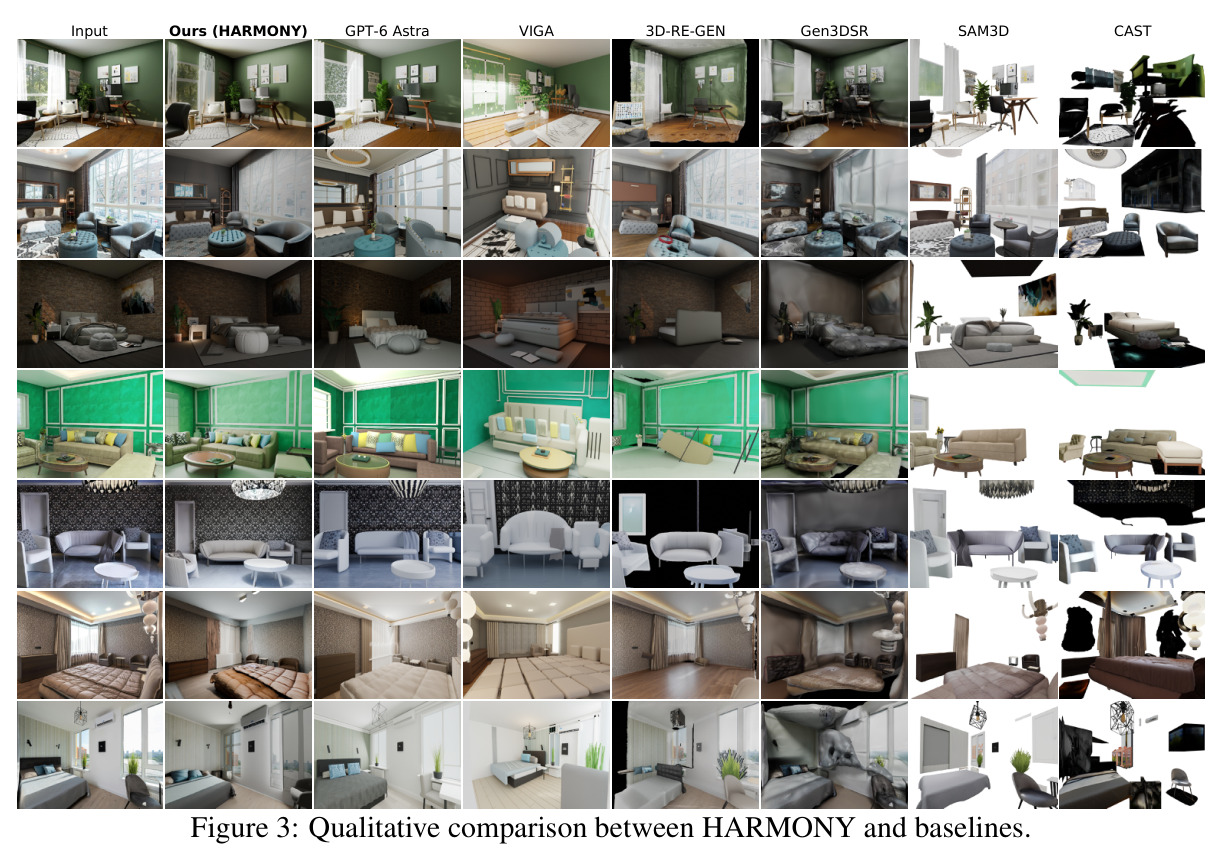
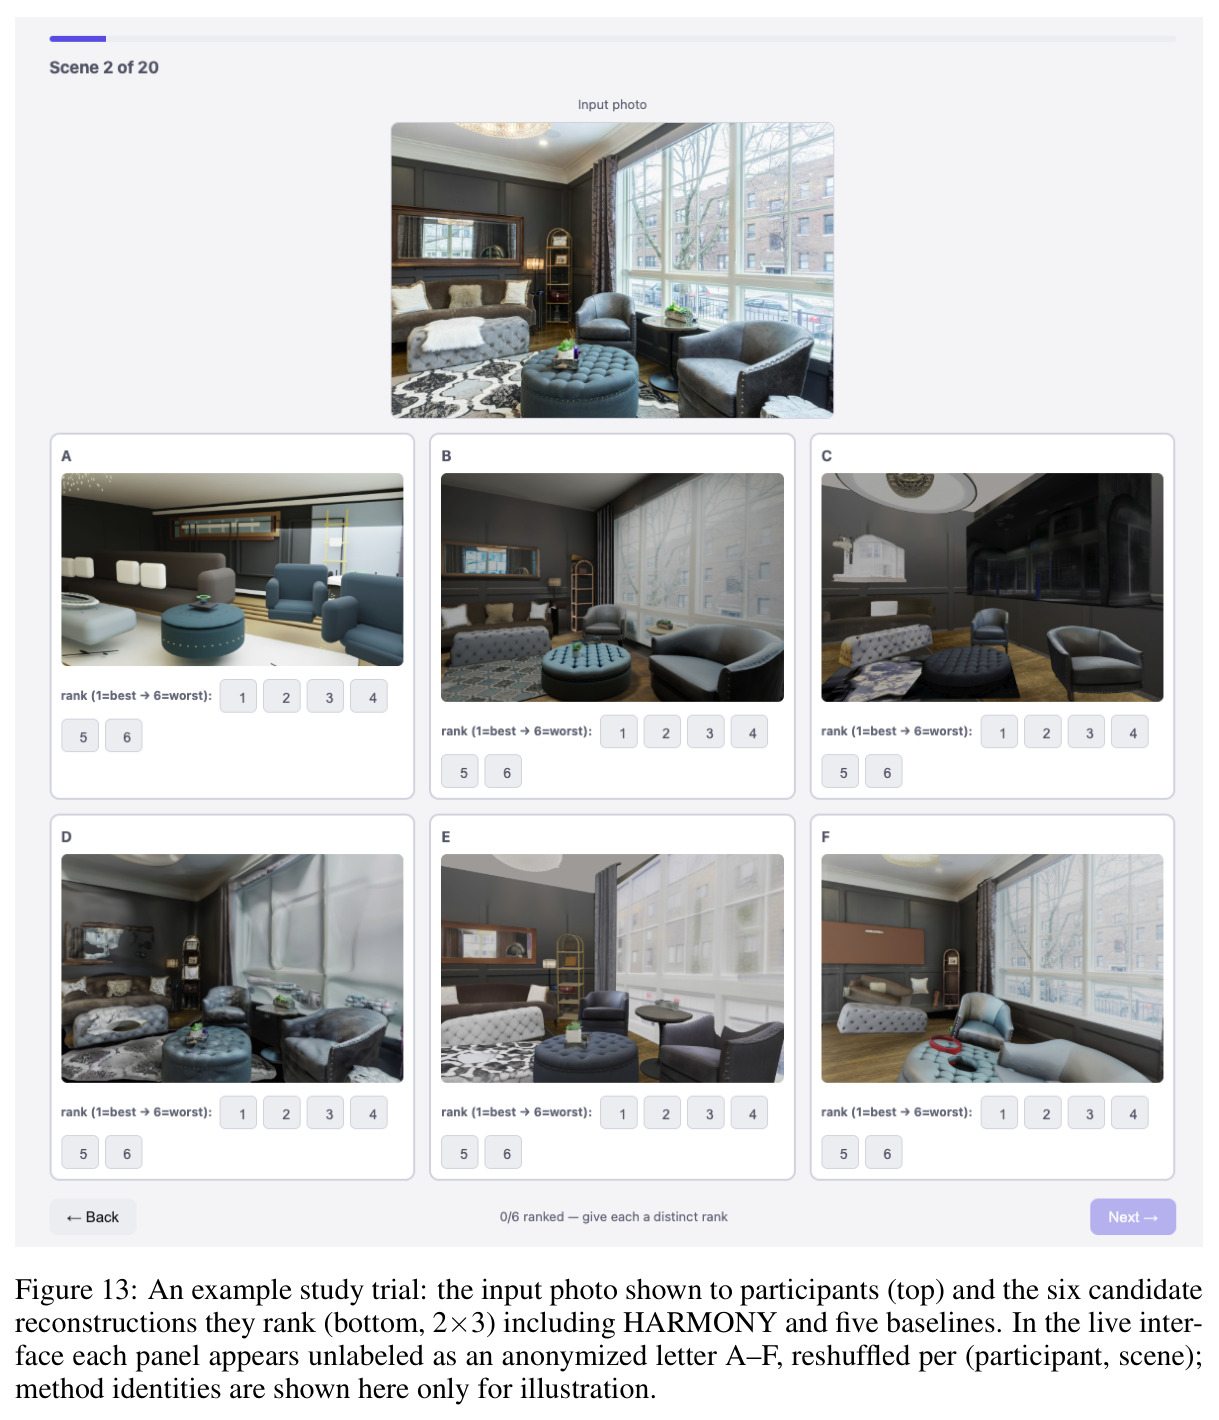
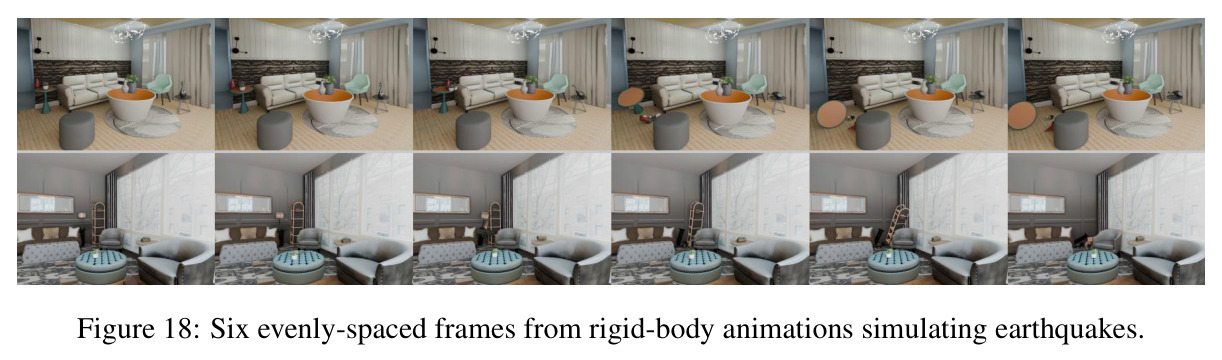
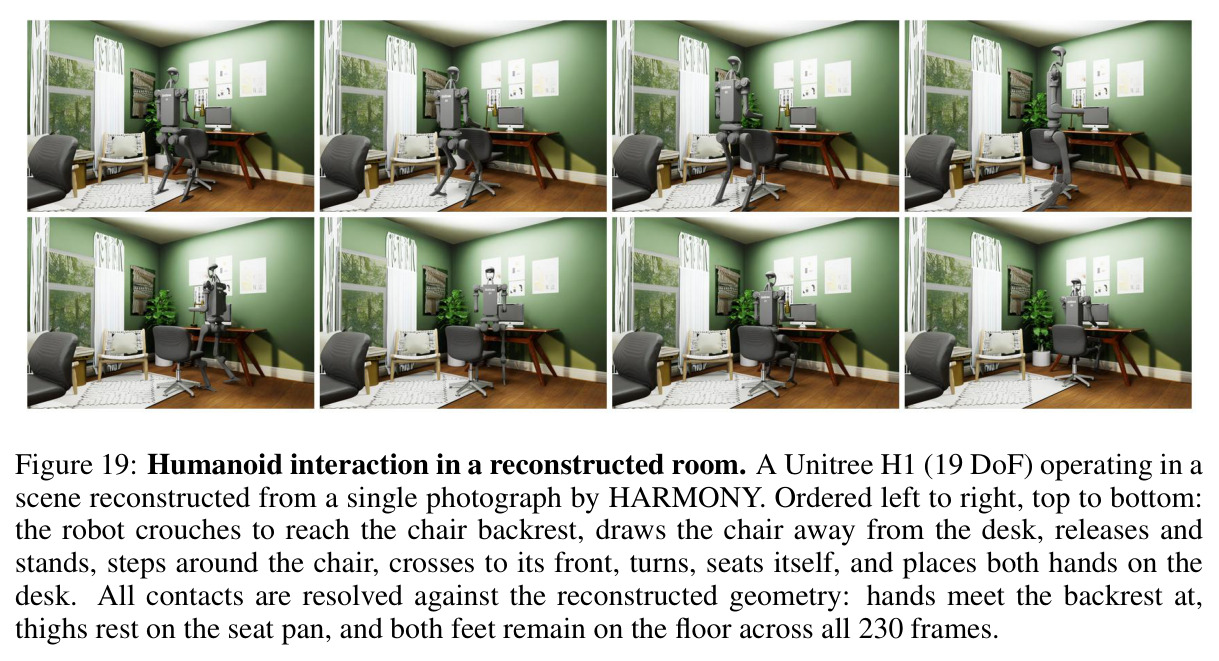
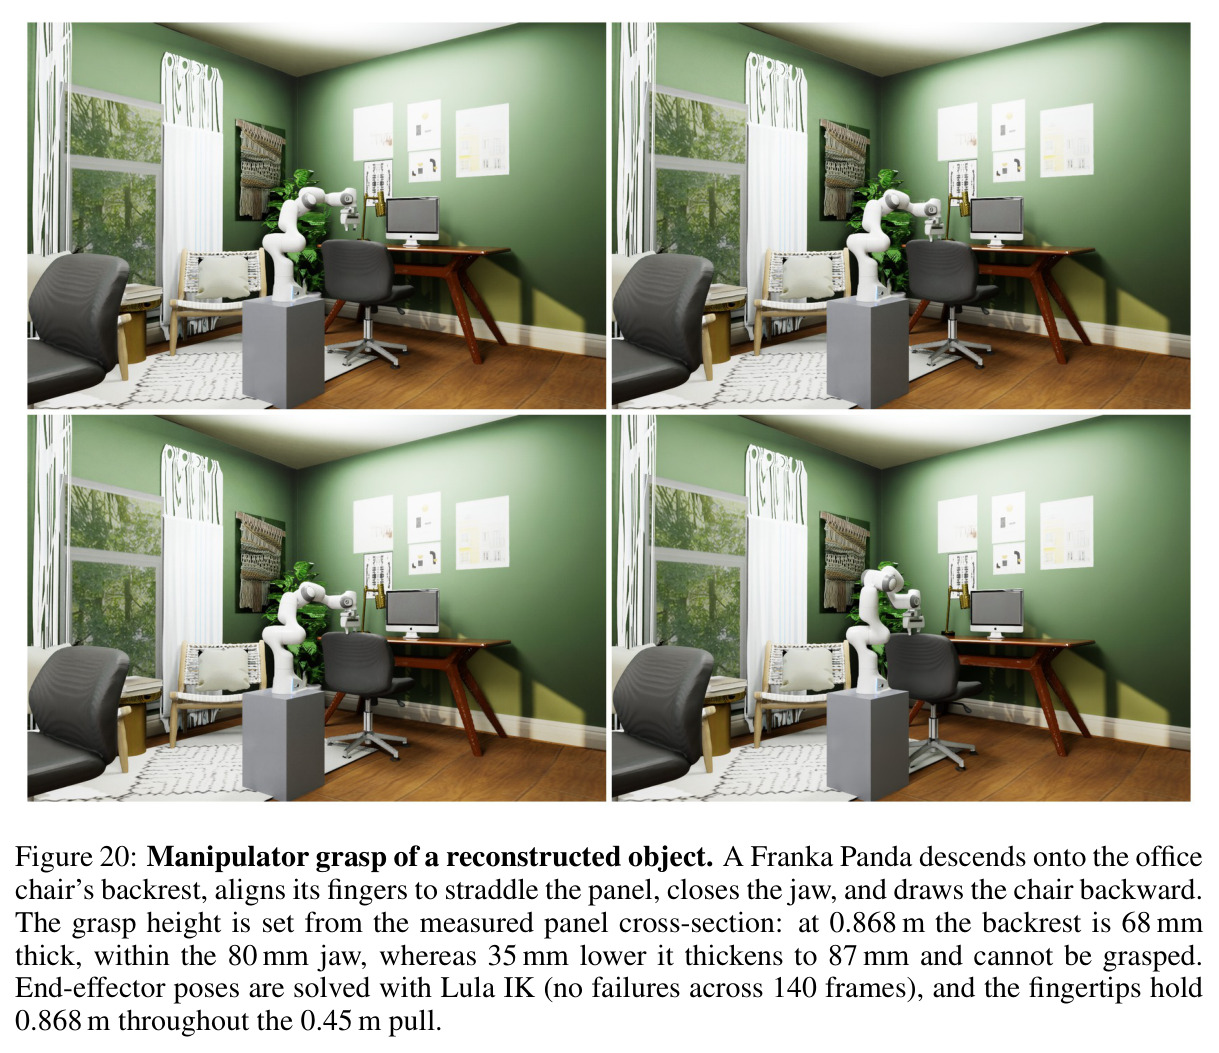
在 Front3D 100 张带 3D 真值的合成图上(Table 1),HARMONY 全指标第一:N-CLIP 0.092(GPT-6 Astra 0.095、SAM3D* 0.127、VIGA 0.179),PL 0.041(Gen3DSR 0.043),Chamfer 距离 0.049(CAST 0.052),F@0.1 达 89.82(CAST 85.70),F@0.01 达 19.47(约为 SAM3D* 14.44 的 1.35 倍),F@0.001 达 0.130(约为 CAST 0.093 的 1.4 倍)——宽松阈值下各家差距不大,严苛阈值下优势放大,说明细粒度几何对齐才是真正强项;GPT-6 Astra 观感尚可但几何误差大,如床不贴墙。在 30 张真实照片上(Table 2),N-CLIP 0.112、PL 0.045 均最佳(最接近的 3D-ReGen 为 0.154)。16 人用户研究(20 场景、六方法匿名强制全排序)中平均排名 1.54±0.93,67.0% 场景排第一、86.0% 进前二,最强基线 SAM3D* 仅 13.7%/39.3%。消融(Table 3)显示去掉相机标定伤害最大(0.1034→0.1381),其次反馈回路(→0.1184),去深度优先遍历则 PL 0.0462→0.0523。失败模式:25.9% 检测框接地置信度低于 0.35(罕见类别词表失配),但去重后真实摆放失败仅 0.3%。附录验证了下游可用性:地震刚体仿真中高书架倾倒而重沙发几乎不动;Unitree H1 人形机器人(19 自由度)在重建场景拉椅、就坐、触桌,230 帧接触全部由重建几何求解;Franka Panda 用 80mm 夹爪抓取 68mm 厚椅背拉动 0.45m,IK 140 帧零失败。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Front3D 单图场景重建(语义感知) | N-CLIP ↓ | 0.092 | SAM3D* 0.127 / VIGA 0.179 / GPT-6 Astra 0.095 | 较最强基线 SAM3D* 降低 27.6% |
| Front3D 单图场景重建(像素保真) | PL(光度损失)↓ | 0.041 | Gen3DSR 0.043 / GPT-6 Astra 0.052 | 全场最佳,较 GPT-6 Astra 降低 21.2% |
| Front3D 场景几何精度 | Chamfer Distance ↓ | 0.049 | CAST 0.052 / VIGA 0.055 | 较 CAST 降低约 5.8% |
| Front3D 场景几何精度(严苛阈值) | F-score@0.01 ↑ | 19.47 | SAM3D* 14.44 / CAST 14.39 | 提升约 34.8% |
| Front3D 场景几何精度(最严苛阈值) | F-score@0.001 ↑ | 0.130 | CAST 0.093 / GPT-6 Astra 0.090 | 提升约 39.8% |
| HARMONY30 真实室内照片重建 | N-CLIP ↓ | 0.112 | 3D-ReGen 0.154 / GPT-6 Astra 0.127 | 较 3D-ReGen 降低 27.3% |
| 真实照片用户研究(16 人 × 20 场景六方排序) | 平均排名 ↓ / Top-1 / Top-2 | 1.54±0.93 / 67.0% / 86.0% | SAM3D* 3.26±1.60 / 13.7% / 39.3%;VIGA 4.37±1.23 / 0.7% / 9.0% | Top-1 高出最强基线 53.3 个百分点 |
局限与改进
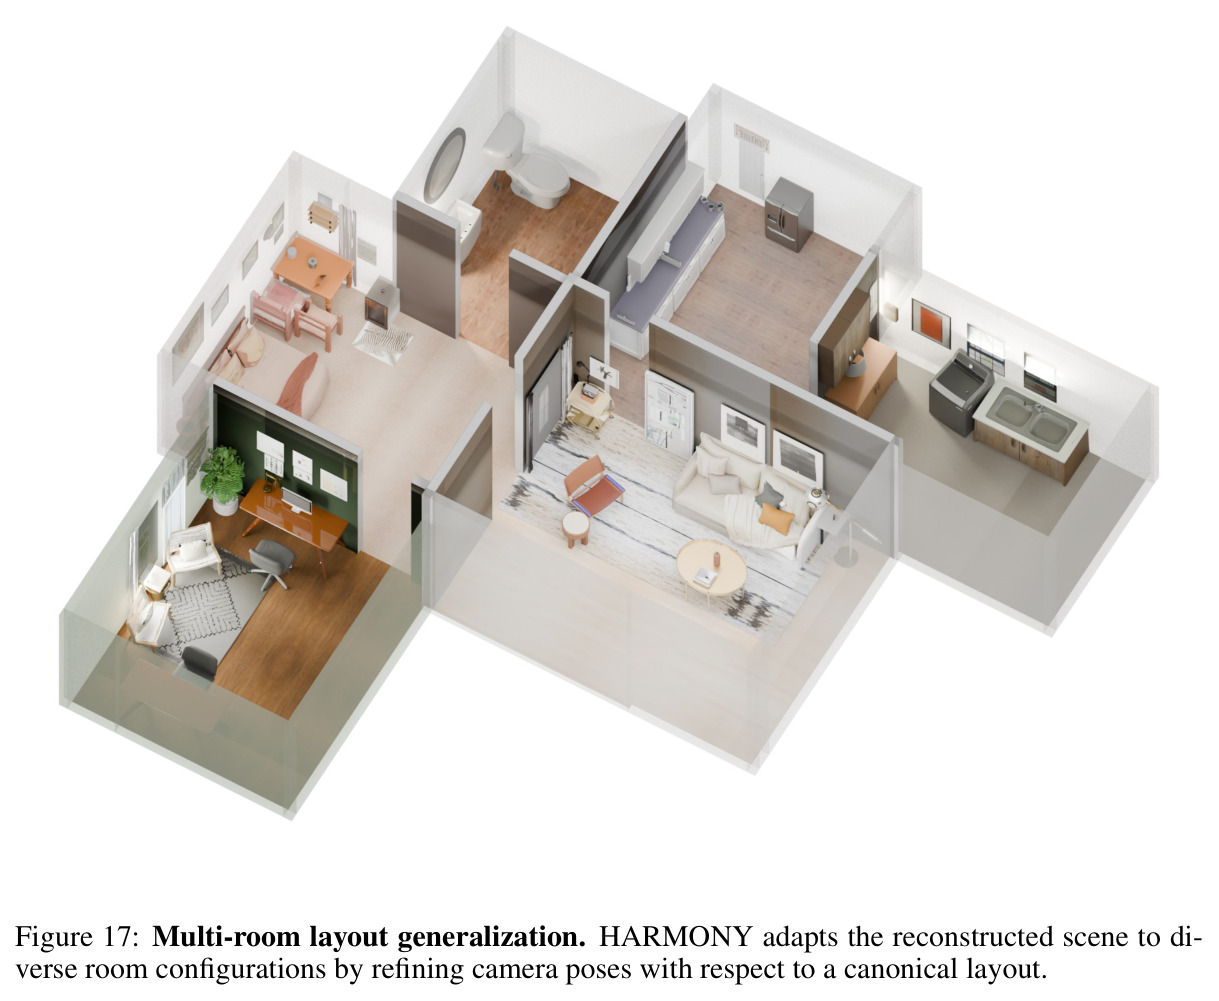
作者承认的局限有两类失败案例:一是罕见类别的同义词失配,VLM 与检测器词表对不上导致 25.9% 的检测接地置信度低于 0.35(如健身房器械),不过经路由与去重后真正的摆放失败只有 0.3%;二是近景物体被图像边缘严重裁剪时(前景截断式重遮挡),VLM 虽能推断语义关系,但重建网格在该渲染视角下缺乏约束,质量下降。我自己的观察还有几点:其一,流水线深度依赖闭源商业 API(GPT-5.5、Gemini-Flash-2.5),成本与可复现性受制于外部服务;其二,每景 20–90 分钟、平均每物体 3.4 次 VLM 调用的串行思维链,无法满足实时或大规模生成需求;其三,曼哈顿假设与矩形单间先验在曲面墙、开放布局等场景会失效,多房间也只是靠相机标定自然泛化(Fig. 17)而非显式建模;其四,完全不处理铰接物体(抽屉、门、可躺椅),作者也把关节推断留给未来;其五,评估方面感知指标(N-CLIP/PL)对『位置对了但材质错了』这类错误不敏感,几何真值只来自 100 张合成图,用户研究仅 16 人 20 场景,规模都偏小,结论的统计强度有限。
独立分析的弱点
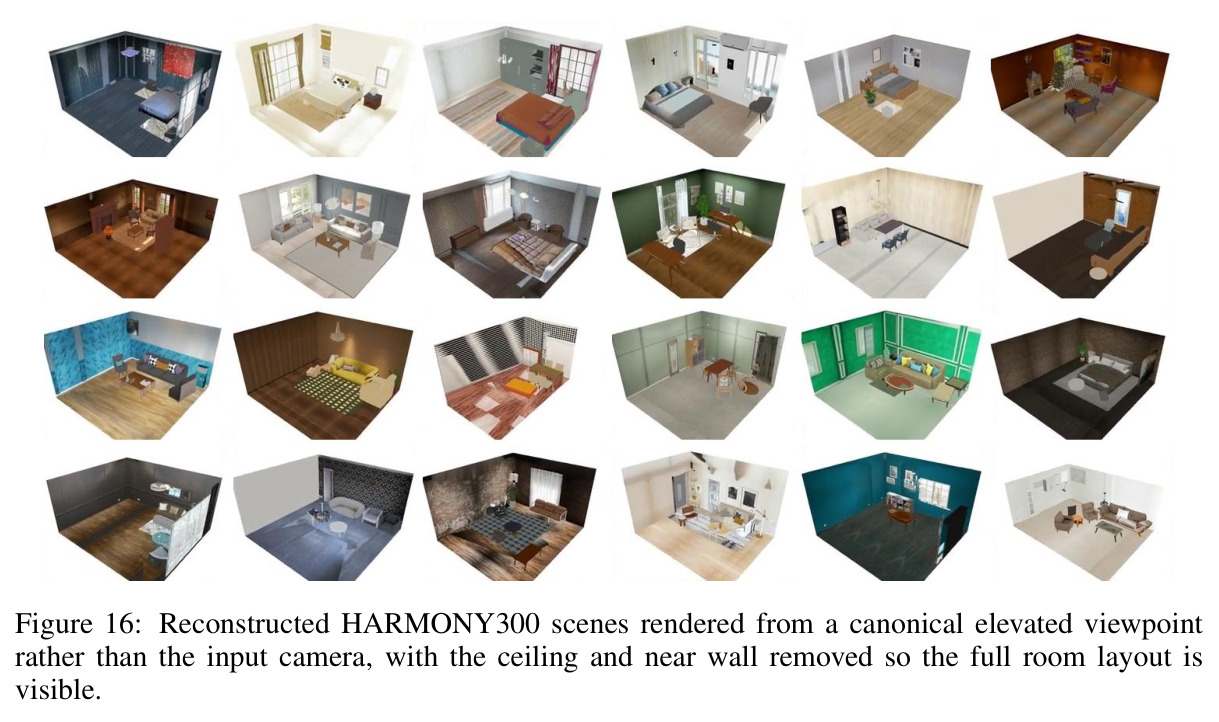
第一,误差链单点依赖:相机标定只依赖最深墙角这一个锚点的匹配,消融证明它影响最大,角点检测或 VGGT 点云的局部噪声都可能让整个下游失配——可引入多锚点冗余(多个墙角、墙线联合求解)与重投影一致性检验提高鲁棒性。第二,深度精修假设前表面点云可见:对重遮挡物体或玻璃、镜面等弱回波表面,迭代中值加 MAD 仍会偏移,可让 VLM 先估计物体可见比例再加权,或采用多假设深度。第三,装饰品尺度靠 VLM 常识(如『显示器约 0.55×0.45×0.22 米』),遇到非常规尺寸物件会出错,可用同一场景同类物体间的相对约束交叉校验。第四,碰撞消解只做局部最小位移 $\|\delta_k\|$,密集场景可能陷入局部解而触发代价高昂的整序重排,可引入轻量物理引擎做全局求解。第五,反馈回路以输入视角渲染相似度为准,无法发现『物体朝向在输入视角下不可辨别』或逻辑性错误,可加俯视图/规范视角的多视角自检——附录的 canonical view 渲染已具备这个条件。第六,『墙上物→家具→装饰』的层级是人写死的规则,对吊床、楼梯这类跨层级物体会失配,可让 VLM 依据场景自动构建摆放依赖图。
未来方向
作者明确提出两个方向:扩展到多视角输入(多视图天然消解单目歧义,VGGT 本身支持多图输入)和物体关节推断(抽屉、门等可动部件),使场景真正可交互。在此基础上可以延伸:其一,把输出直接用作具身智能训练环境——附录已验证 Isaac Sim 中 Unitree H1 人形与 Franka Panda 可在重建场景完成接触操作,『照片一键转仿真』对机器人 sim-to-real 与场景数据增广价值很大;其二,用 HARMONY 自产数据做蒸馏:随文发布的 HARMONY300(300 张带逐物体位姿、关系标注的场景)可以训练前馈式场景生成器,把 20–90 分钟压到秒级;其三,增量式场景编辑:由于输出是组合式资产,可结合文字指令做物体替换、重排与重光照(Fig. 1 已展示场景编辑应用雏形);其四,显式建模非曼哈顿与多房间拓扑:把单矩形房间先验推广到 L 形、开放厨房等任意平面图,需要在布局阶段引入图结构;其五,与视频结合,利用时序信息恢复重遮挡区域与物体关节,并支持动态场景重建。
复现评估
复现难度中等偏高,但开源基础优于同类工作。有利条件:方法零训练,全部由现成模型编排,Table 4 明确列出模型分工——GPT-5.5(场景/布局/光照 VLM)与 Gemini-Flash-2.5(图像修补)走 API,Hunyuan3D-2、VGGT、LocateAnything、SAM2、Blender Cycles 本地部署;附录 C 公开了每个阶段近乎逐字的提示词模板(作者承诺完整字节级模板随代码发布);附录 B 给出相机标定全部固定超参(行带比例 $\rho=0.2$、法线阈值 $\tau=0.7$、百分位 98/97)和完整伪代码 Algorithm 1,Hunyuan3D 设置(八叉树 384 / 25 步 / 8 万面)也写明;基准 HARMONY300 以 CC-BY-NC-4.0 发布,含参考图、物理光照渲染、实例分割 colormap、逐物体尺寸/位置/关系标注与标定相机,196 张来自 Pexels、100 张来自 3D-FRONT,授权清晰。不利条件:核心 VLM 是闭源 API,长期可得性与费用不可控;每景 20–90 分钟需 NVIDIA L40(46GB)级显卡;CAST 官方未开源,评测用的是第三方实现,3D-RE-GEN 与 VIGA 也被作者做了非默认改动(背景修补换成 gpt-image-2、VIGA 换用 SAM3D+GPT-5.5),严格对齐论文数字需要相同模型版本。总体而言,一张 24GB+ 显卡加 API 预算即可尝试,主要门槛在多模型工程整合。
论文图表
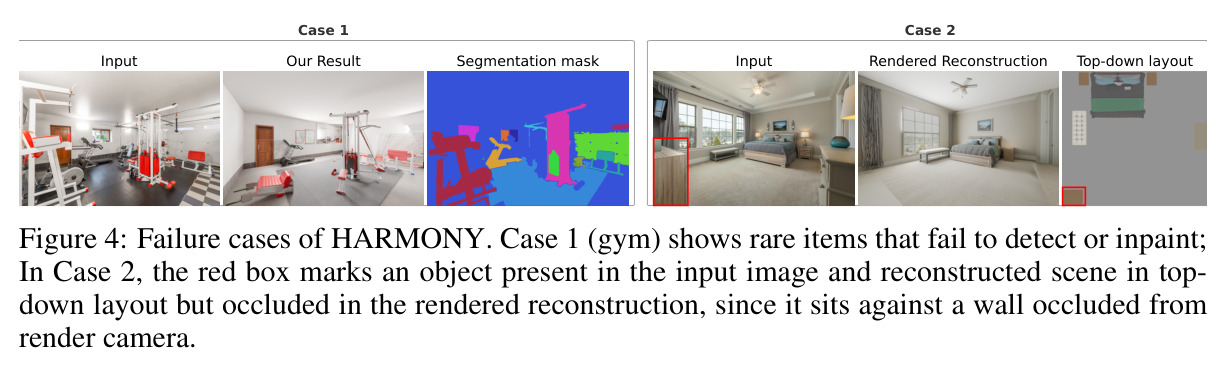
失败案例图:Case 1 是健身房场景,罕见器械因 VLM 与检测器词表失配而检测/修补失败;Case 2 中红框标出的物体在俯视布局中存在,但从渲染相机看被遮挡,说明近景裁剪或视角盲区会导致渲染与输入不一致。
论文少有地展示了方法的边界条件,两类失败模式直接对应正文 4.5 节的分析(25.9% 低置信度检测、前景裁剪重遮挡),是评估方法适用范围的关键。
HARMONY30 真实照片感知指标与用户研究:HARMONY 的 N-CLIP 0.112、PL 0.045 均为最佳;用户研究中平均排名 1.54±0.93、Top-1 67.0%、Top-2 86.0%,远超 SAM3D*(3.26±1.60、13.7%、39.3%)和 VIGA(4.37±1.23、0.7%、9.0%);GPT-6 Astra 因无公开完整流程未参与用户研究。
证明方法在真实世界图像上的泛化能力(合成榜第一可能是过拟合协议),人类主观评估的巨大优势是对感知指标局限性的有力补充。