Tetris3D:让物体彼此严丝合缝的3D场景生成 Tetris3D: 3D Scene Generation With Objects That Fit Together
以邻域几何与物理关系为条件自回归生成每个物体,从单图重建物理一致的3D场景
前置知识
流匹配(Flow Matching)与 DiT
流匹配是一类连续归一化流生成范式:模型学习一个速度场 $v_\theta$,把简单噪声分布沿常微分方程输运到数据分布,训练目标比传统扩散的 DDPM 更简洁稳定。DiT(Diffusion Transformer)用 Transformer 替代 U-Net 作为去噪骨干,把每个空间单元(这里是体素)当作 token,配合自适应归一化等条件机制,是当前 3D/视频生成的主流架构。TRELLIS.2 的两个生成阶段都是基于流匹配的 30 块 DiT。
Tetris3D 完全构建在 TRELLIS.2 的两阶段流匹配 DiT 之上,理解条件注入(在每层 DiT 的 token 上做加法)和零初始化门控的设计都依赖对 DiT token 化工作机制的认识。
TRELLIS.2 的稀疏体素表示(SS + SLAT)
TRELLIS.2 把 3D 生成拆成两阶段:第一阶段生成稀疏结构(SS),即二值占用网格 $O \in \{0,1\}^{N_s \times N_s \times N_s}$,勾出粗几何;第二阶段在 $L$ 个活动体素上生成结构化潜变量(SLAT),每个体素携带描述局部几何 $f^{\text{shape}}$ 与材质 $f^{\text{mat}}$ 的特征元组。这种 field-free 的稀疏体素方案让生成只集中在物体表面附近,分辨率与效率兼得。
Tetris3D 的所有交互条件(深度占据、图像特征、邻域距离场)都定义在与生成完全相同的 3D 体素网格上,才能实现逐 token 空间对齐注入;不理解 SS/SLAT 就无法理解条件为何能『对号入座』。
Amodal 补全(非模态补全)
Amodal 感知指推断物体被遮挡部分的完整几何/外观,而非只建模可见区域。在 3D 生成中,amodal 方法(如 Amodal3R、GENA3D)从部分可见的图像出发补全被遮挡的 3D 形状,通常用可见性掩码引导注意力来区分可见与不可见 token。核心难点是:不可见区域没有任何直接的图像证据,必须靠先验或上下文推断。
Tetris3D 处理的正是多物体互相遮挡的场景重建,其 V2I(visible-to-invisible)注意力是对现有 amodal 注意力机制的改进——让不可见 token 显式查询可见 token,且能利用邻居物体的上下文而非仅靠自身可见区域。
截断无符号距离场(Truncated UDF)
无符号距离场 $d(x)$ 给出空间每点到最近表面的距离(不区分内外),兼容非水密网格,这是相对有向 SDF 的关键优势。截断版本在 $d(x) \ge \tau$ 处直接截为无信息,只保留表面附近厚度为 $\tau$ 的壳层。Tetris3D 还附带指向最近表面点的方向向量 $u(x)$ 与该点法向 $n(x)$,用邻近度因子 $(1-d(x)/\tau)$ 加权。
空间上下文条件 $c_{\text{int}}$ 的数学定义完全建立在截断 UDF 上,它告诉生成模型『这个体素离邻居表面多近、朝哪个方向、那边朝向如何』,是防止穿透和悬浮的核心信号。
VLM 物理依赖推理与置信度加权拓扑排序
视觉语言模型(如 Qwen3-VL-30B)可从图像推断物体间的物理依赖:杯子依赖桌子支撑,故桌子应先生成。依赖图是有向图(stack/lean/contain 为有向边,touch 为无向边),但 VLM 预测可能含冲突或环(如两物体互相支撑),直接拓扑排序会失败。Tetris3D 的算法 1 用子集动态规划求最优生成序:每一步只添加已有邻居被生成的物体,并最小化被违背有向边的置信度之和。
自回归生成顺序是本文方法的骨架——没有正确的物理依赖顺序,交互条件所依赖的邻居几何就不存在;理解这个排序算法才能理解整个推理管线如何从单图自动运行。
研究动机
从单张图像重建物体级 3D 场景,要求把每个物体恢复成共享场景空间中独立完整的 3D 实体,这直接服务于物理仿真、VR/AR 与机器人操作等下游应用。但现有方法难以保证物体间的细粒度空间兼容性:以 SAM-3D、ShapeR、WorldSculpt 为代表的『独立生成再组装』管线逐个生成物体、再用 FoundationPose 等工具对齐,对物体如何贴合毫无显式引导,合成场景常出现穿透与悬浮;以 MIDI、SceneGen、SceneMaker 为代表的多实例联合生成虽通过注意力隐式耦合形状与位姿,但交互信息只隐含在注意力或位姿层面,无法约束相邻表面级的贴合。更棘手的是,物体交互恰好发生在彼此遮挡的区域——例如杯子底部与桌面的接触面被杯身自身挡住——仅凭可见证据几乎无法推断这些区域的几何。在 Toys4K 基准上,此前最好的方法穿透深度 PD 为 0.1177(WorldSculpt),SAM-3D 的场景级 Chamfer 距离高达 25.19,多数方法物理仿真后平均位移超过 100,说明重建出的场景根本无法通过物理稳定性检验,难以直接用于仿真与机器人。
本文的目标是本文的目标是构建单图 3D 场景重建生成框架 Tetris3D,使其恢复的物体在几何与物理两个层面彼此连贯:几何上不穿透、不悬浮、表面精确接触;物理上符合图中描绘的支撑(stack)、倚靠(lean)、容纳(contain)、接触(touch)等交互关系。核心挑战在于交互区域往往被遮挡,模型必须能从邻居几何与关系线索中推断被遮挡部分应有的形状与位姿。作者设定了三个具体子目标:(1) 每个物体的形状生成都以其邻居几何和物理关系为显式条件,让交互线索参与去噪过程本身;(2) 物体直接以图中观察到的位姿生成在场景(相机)坐标系中,省去独立的位姿估计与后对齐步骤,避免对齐误差;(3) 在合成(Toys4K)与真实(MessyKitchens、Picasso)场景上同时取得重建质量、生成质量与物理稳定性的最优表现,并且整条管线(分割、深度、关系推理)都能用现成模型自动化。
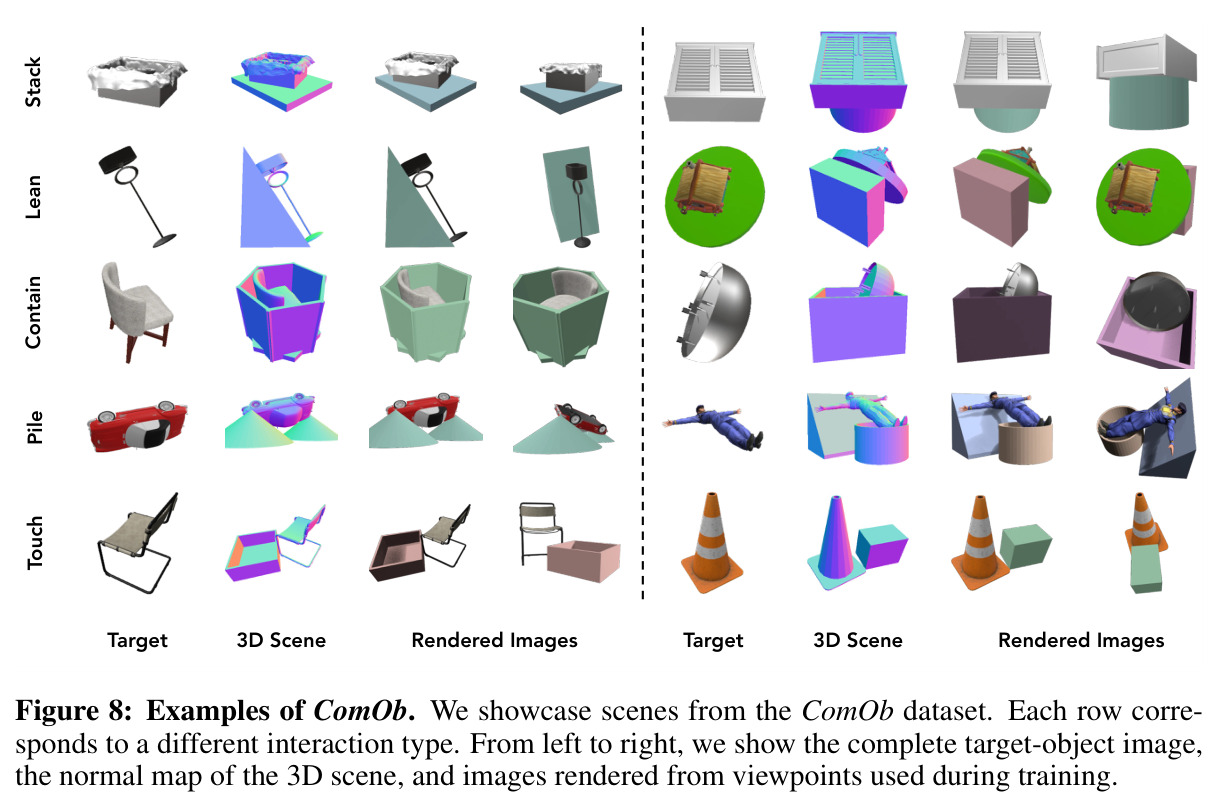
与已有工作不同的是,本文的独特切入点是把物理交互从『事后评估指标』转变为『生成过程的条件与线索』。已有工作的物理处理大致分三路:独立生成后测试时用 VLM 关系图修正位姿或在环仿真(PhysScene3D、SimUScene 等),局限域场景生成中把物理内置进生成过程,或多实例单次生成靠注意力隐式耦合。Tetris3D 则显式地将两类信息——邻域空间上下文(截断无符号距离场 + 方向向量 + 法向量)与关系类型(stack/lean/contain/touch/none 的可学习嵌入)——以体素对齐的方式注入每个 DiT 层的对应 token,实现空间精确对齐的局部引导。此外,它用 VLM 推断物理依赖层次并做置信度加权拓扑排序,让自回归顺序本身编码『先支撑后依赖』的物理逻辑,先重建的支撑物表面成为后续物体生成的交互上下文;V2I 交叉注意力进一步让被遮挡 token 显式向可见 token 查询完成补全。训练侧配套构建了带逐对物理关系标注、含自然遮挡的 120 万场景数据集 ComOb,填补了通用物体交互训练数据的空白。
核心方法
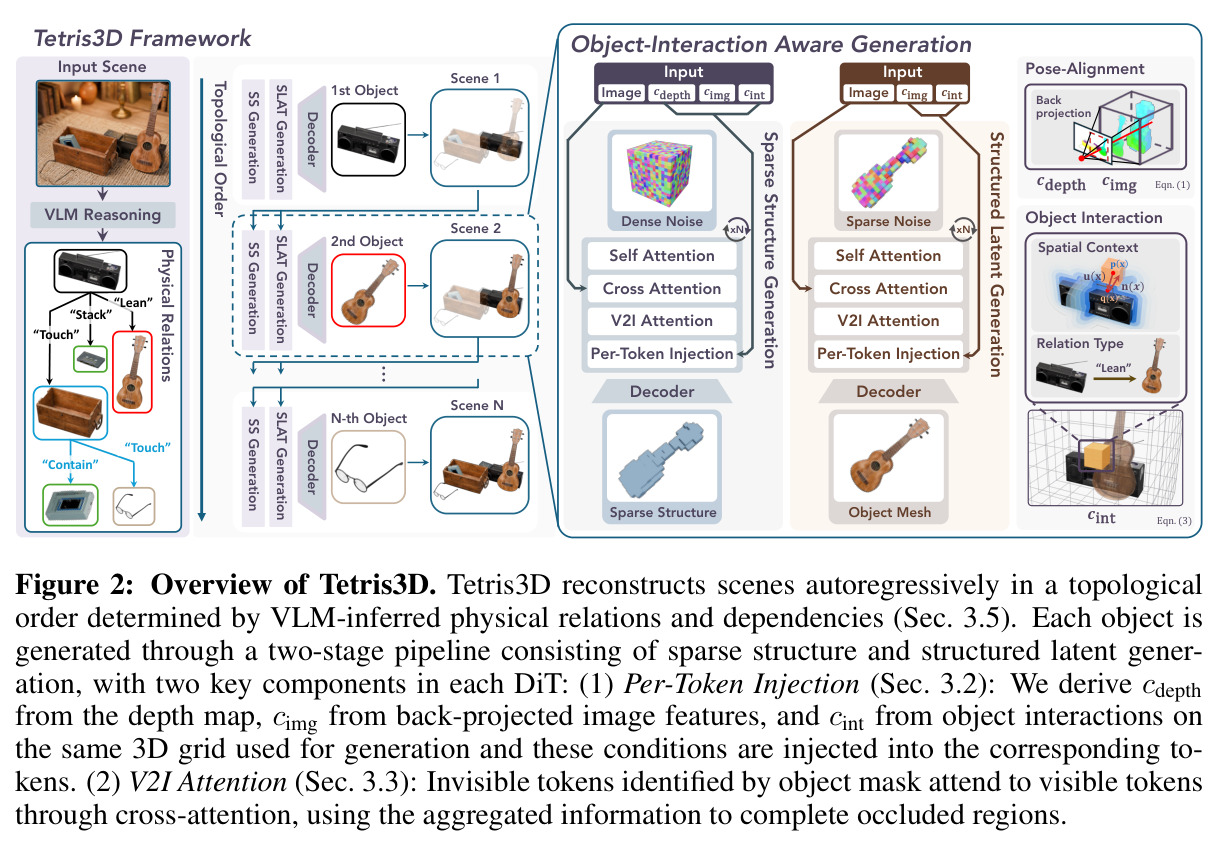
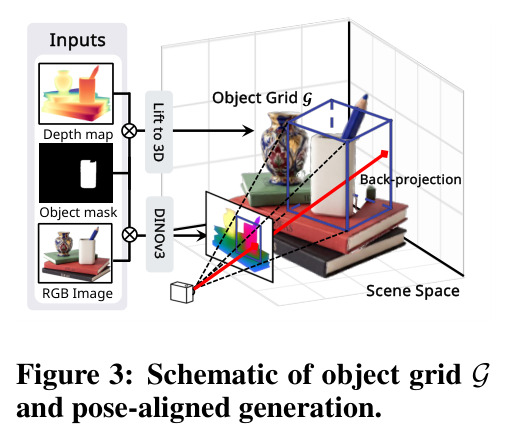
直觉上,人理解场景时会利用周围几何推断一个物体能占据的空间、利用物理关系推断它应该如何倚靠或嵌入邻居——Tetris3D 把这两种线索直接喂给生成模型。技术路线建立在 TRELLIS.2 之上:每个物体经两阶段流匹配扩散生成,第一阶段稀疏结构生成($v_{\text{SS}}$)在粗网格上去噪并解码为二值占用网格 $O$,第二阶段结构化潜变量生成($v_{\text{SLAT}}$)只在 $L$ 个活动体素 token 上生成几何与材质特征,两阶段均为 30 块 DiT 并以冻结 DINOv3 图像特征为条件。整个场景按物理依赖顺序自回归生成:VLM(Qwen3-VL-30B)从图像推断带置信度的有向依赖图,经置信度加权最优拓扑排序得到生成顺序,先生成物体的重建表面随即成为后生成物体的交互条件。每个物体在由深度图反投影定义的物体网格 $\mathcal{G}$ 中生成,深度占据、反投影图像特征与交互条件在同一个 3D 网格上定义并逐 token 注入,因此物体直接以场景位姿生成,无需位姿后对齐;V2I 注意力负责补全被遮挡区域。
核心创新是『物体交互条件』的显式构造与空间对齐注入。与已有方法的本质区别在于:独立生成+组装方法(SAM-3D、ShapeR)根本没有交互引导;多实例方法(MIDI、SceneMaker)把耦合藏在注意力里且只作用于位姿;amodal 方法(Amodal3R、GENA3D)补全时只看物体自身可见区域。Tetris3D 为目标物体网格 $\mathcal{G}$ 中每个体素 $x$ 计算三重条件:深度占据 $c_{\text{depth}}$(反投影点云所在体素取可学习嵌入 $e^{\text{depth}}$)、图像特征 $c_{\text{img}}$(DINOv3 特征沿相机光线投影 $\pi(x)$)、交互条件 $c_{\text{int}}$——后者由截断无符号距离 $d(x)$、指向最近表面点的方向 $u(x)$、该点法向 $n(x)$ 与关系嵌入 $W_{\text{rel}}r(x)$ 组合,并用邻近度因子 $(1-d(x)/\tau)$ 加权,$d(x) \ge \tau$ 的体素不接收条件。这些量都定义在与生成相同的 3D 网格上,经 MLP 投影后加到对应 token(式 4),并用零初始化的可学习门控 $\lambda_{\text{depth}}$、$\lambda_{\text{int}}$ 保证微调初期不破坏预训练先验。V2I 注意力则让不可见 token 作为查询、可见 token 作为键值进行交叉注意力(式 5),显式完成遮挡区域的信息补全。
方法步骤详情
完整流程分五步。(1) 场景解析:输入单张 RGB 图,用 SAM3 提取实例掩码,Qwen3-VL-30B 两阶段提示(先做带颜色对应的物体清单,再推断物理关系及置信度),得到有向依赖边(stack/lean/contain)与无向 touch 边;算法 1 用子集动态规划做置信度加权最优拓扑排序,最小化被删边的置信度之和来化解环,ground 平面为根节点。(2) 构建物体网格:对目标物体 $o_i$,将其掩码内像素按深度反投影为部分点云 $P$,在包围 $P$ 并留 margin 的立方体上定义网格 $\mathcal{G}$,遮挡掩码取 $M^i_{\text{occ}}=\bigcup_{j \ne i} M_j$。(3) 条件构造:按式 (1)(2)(3) 计算 $c_{\text{depth}}$、$c_{\text{img}}$、$c_{\text{int}}$,图像特征按遮挡比例 $\rho$ 与空嵌入混合 $\tilde{f}=(1-\rho)f+\rho e_{\text{empty}}$。(4) 两阶段生成:SS 与 SLAT 的每个 DiT 层按式 (4) 逐 token 注入条件(token 特征更新 $h^{(l)}(x) \leftarrow h^{(l)}(x)+\text{MLP}^{(l)}_{\text{img}}(c_{\text{img}})+\lambda_{\text{depth}}\text{MLP}^{(l)}_{\text{depth}}(c_{\text{depth}})+\lambda_{\text{int}}\text{MLP}^{(l)}_{\text{int}}(c_{\text{int}})$),V2I 注意力按式 (5) 更新不可见 token,流匹配采样后解码出该物体的完整网格,其几何随即成为后续物体的交互上下文。(5) 训练:在 ComOb 上从 TRELLIS.2 与 Pixal3D 初始化微调,SS 训 20 万步约 7 天、SLAT 训 10 万步约 9 天(2×H200,batch 16,AdamW,学习率 $10^{-4}$),课程学习按 1:2:1 混合完整图/原语遮挡图/合成遮挡图,并对深度做射线向高斯扰动(概率 0.3)与 10% 体素丢弃增强。
技术新颖性
技术新颖性体现在四个层面。其一,条件设计的粒度:以体素级截断 UDF + 方向 + 法向 + 关系嵌入描述『这个体素离哪个邻居表面多近、朝哪个方向、属于什么物理关系』,相比图像级或场景级条件的局部引导精确得多,且 UDF 天然兼容非水密网格。其二,注入机制:因为条件与生成共享同一 3D 网格,可实现逐 token 空间对齐注入,配合零初始化门控(借鉴 Flamingo)在保留 TRELLIS.2/Pixal3D 预训练先验的同时渐进引入新条件,这在 3D 场景生成中是新的系统性设计。其三,V2I 注意力:与 Amodal3R 的遮挡感知注意力相比(消融中 CD-S 4.29 对本文 3.90),它显式以不可见 token 为查询、可见 token 为键值,信息流向更明确,且对遮挡掩码的定义(其余物体掩码之并)不依赖 amodal 分割。其四,自回归顺序即物理:把『先支撑后依赖』编码为生成顺序,用 VLM 置信度 + 最优拓扑排序处理真实场景中相互支撑造成的环,而隐式耦合方法无法提供这种逐物体的局部几何引导。配套的 ComOb(120 万场景、340 万标注样本、约 40 万独特物体、12 种参数化原语、MuJoCo 沉降仿真 + 逐对关系标注 + 交互诱导的自然遮挡)本身也填补了通用物体物理交互数据的空白。
实验结果
实验覆盖三个基准与多组消融。在 Toys4K(评估场景由 ComOb 生成器用与训练不相交的物体布置原语构造,全方法使用真值深度)上,Tetris3D 场景级 Chamfer 距离 CD-S 为 3.68,显著优于 ShapeR 的 5.72、WorldSculpt 的 8.68 与 SAM-3D 的 25.19;物体级 CD-O 0.97、F1-S 0.8407、IoU-B 0.7918、ICP 对齐后残余旋转误差仅 5.29°,均为全场最优;生成质量上 MMD 1.501、COV 83.11%、P-FID 1.599 领先;物理稳定性提升最显著:穿透深度 PD 仅 0.0036,比 WorldSculpt 的 0.1177 低约 33 倍,仿真 300 秒后平均位移 Dmean 38.91、峰值比动能 Epeak 0.1721 J/kg,大幅领先所有基线。在真实场景 MessyKitchens 上 CD-S 0.11、PD 0.0011,Picasso 上 CD-S 0.27、PD 0.0016;而 SceneGen 在 MessyKitchens 的 PD 高达 27.21、Dmean 2354.5 几乎崩溃,证明方法可泛化到真实杂乱接触场景。使用 MoGe3 估计深度时(Table 4)CD-S 升至 7.56、ICP-Rot 升至 12.7° 但仍是全场最佳,仅 Uni3D/ULIP 语义分被 SAM-3D 反超;用 VLM 推断关系替代真值标注(Table 5)CD-S 仅从 3.68 变为 3.76、PD 从 0.0036 变为 0.0038,几乎无损,说明自动化管线可行。消融(Table 3)显示:去掉交互条件后 PD 从 0.0192 暴涨至 0.4980(约 26 倍)、CD-S 从 3.90 升至 8.56,是性能的最大来源;去掉 V2I 注意力 CD-S 升至 4.46、PD 升至 0.0270,换成 Amodal3R 注意力为 4.29,均不及 V2I 设计。与 GPT-6 Astra 智能体式生成(Fig 9)相比,Tetris3D 的形状位姿更忠实于输入图像,agent 方案出现穿透、位姿错配与悬浮。
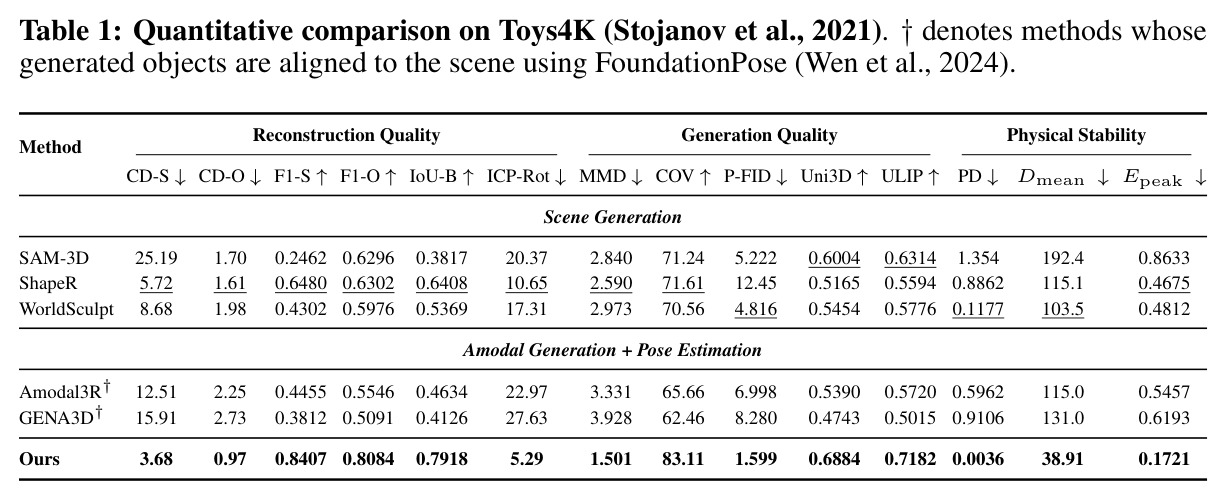
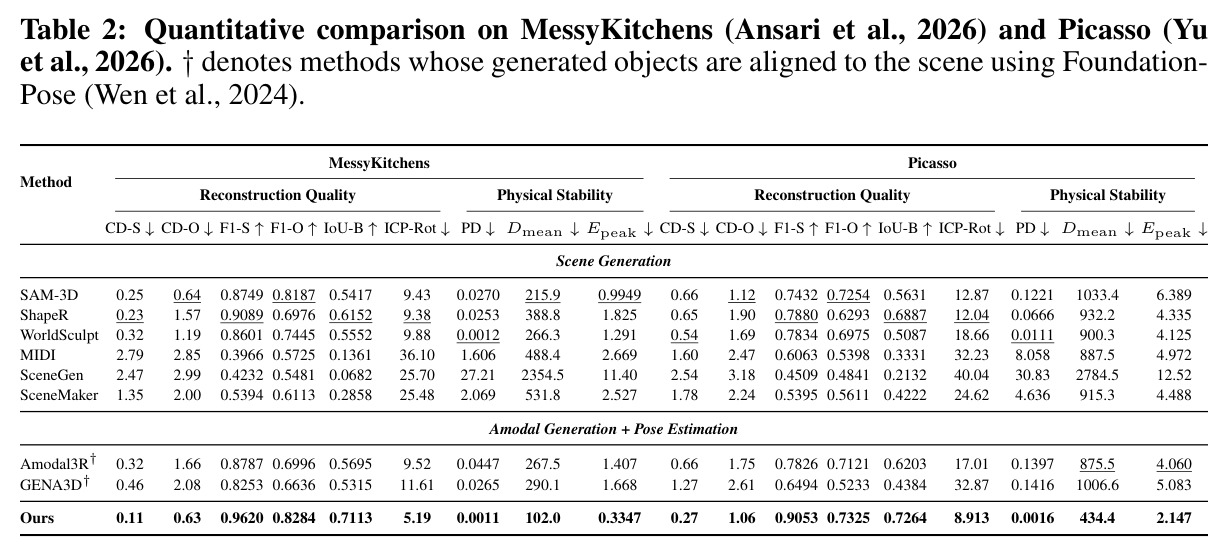
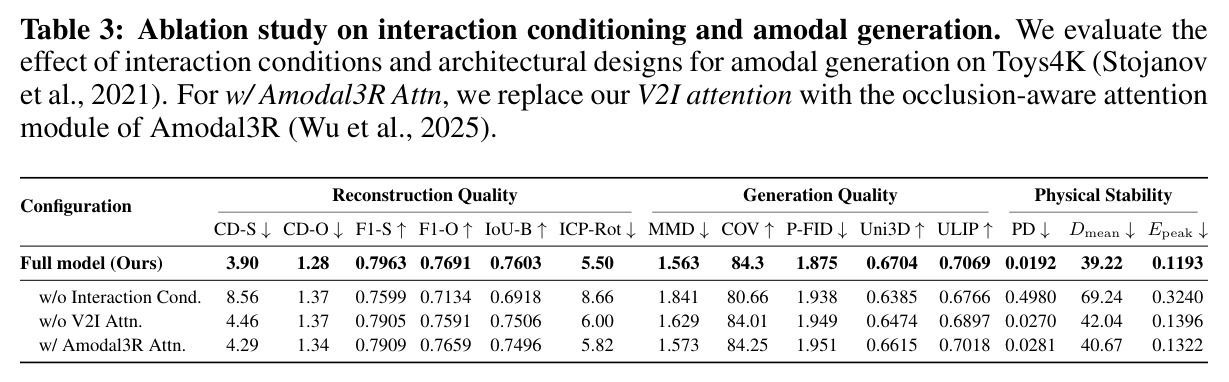
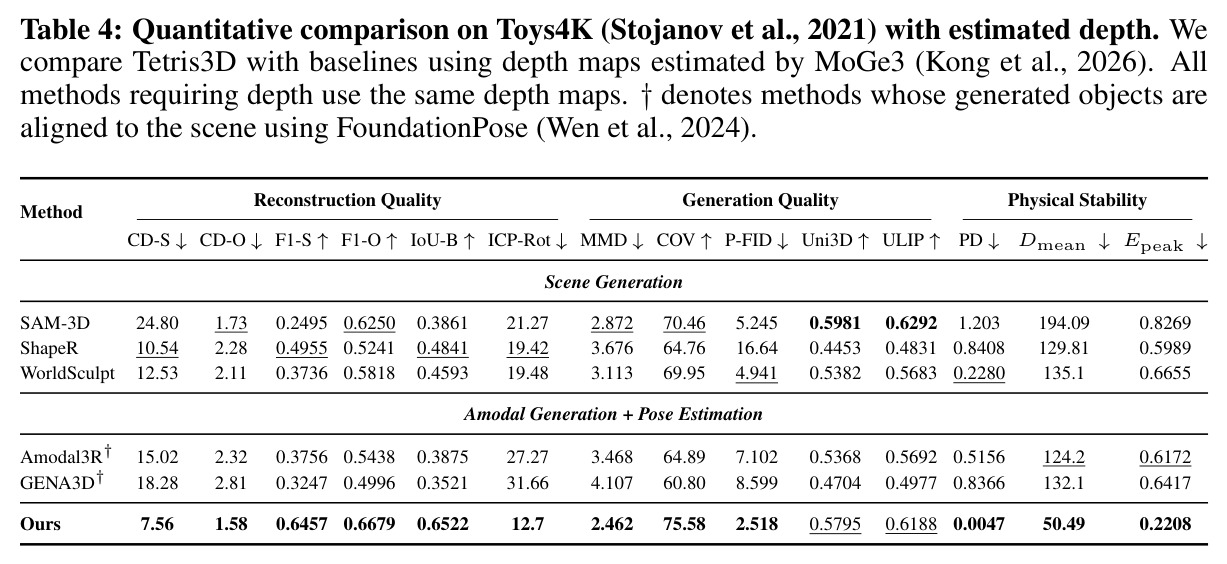
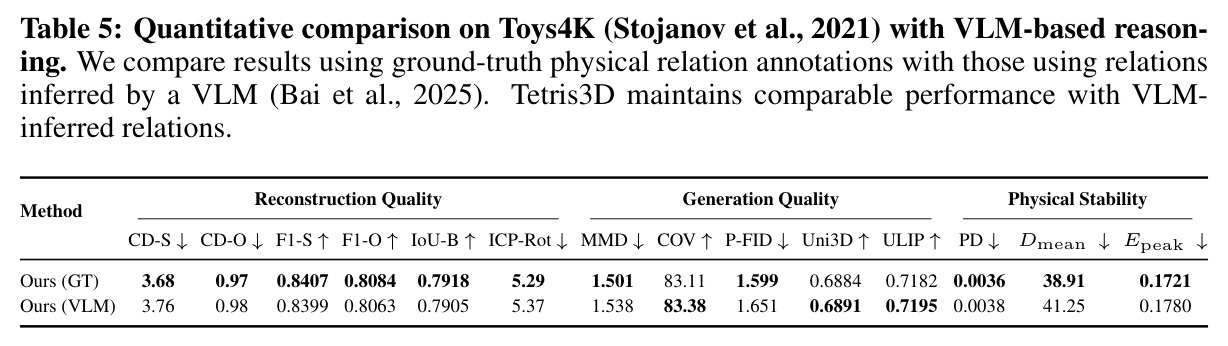
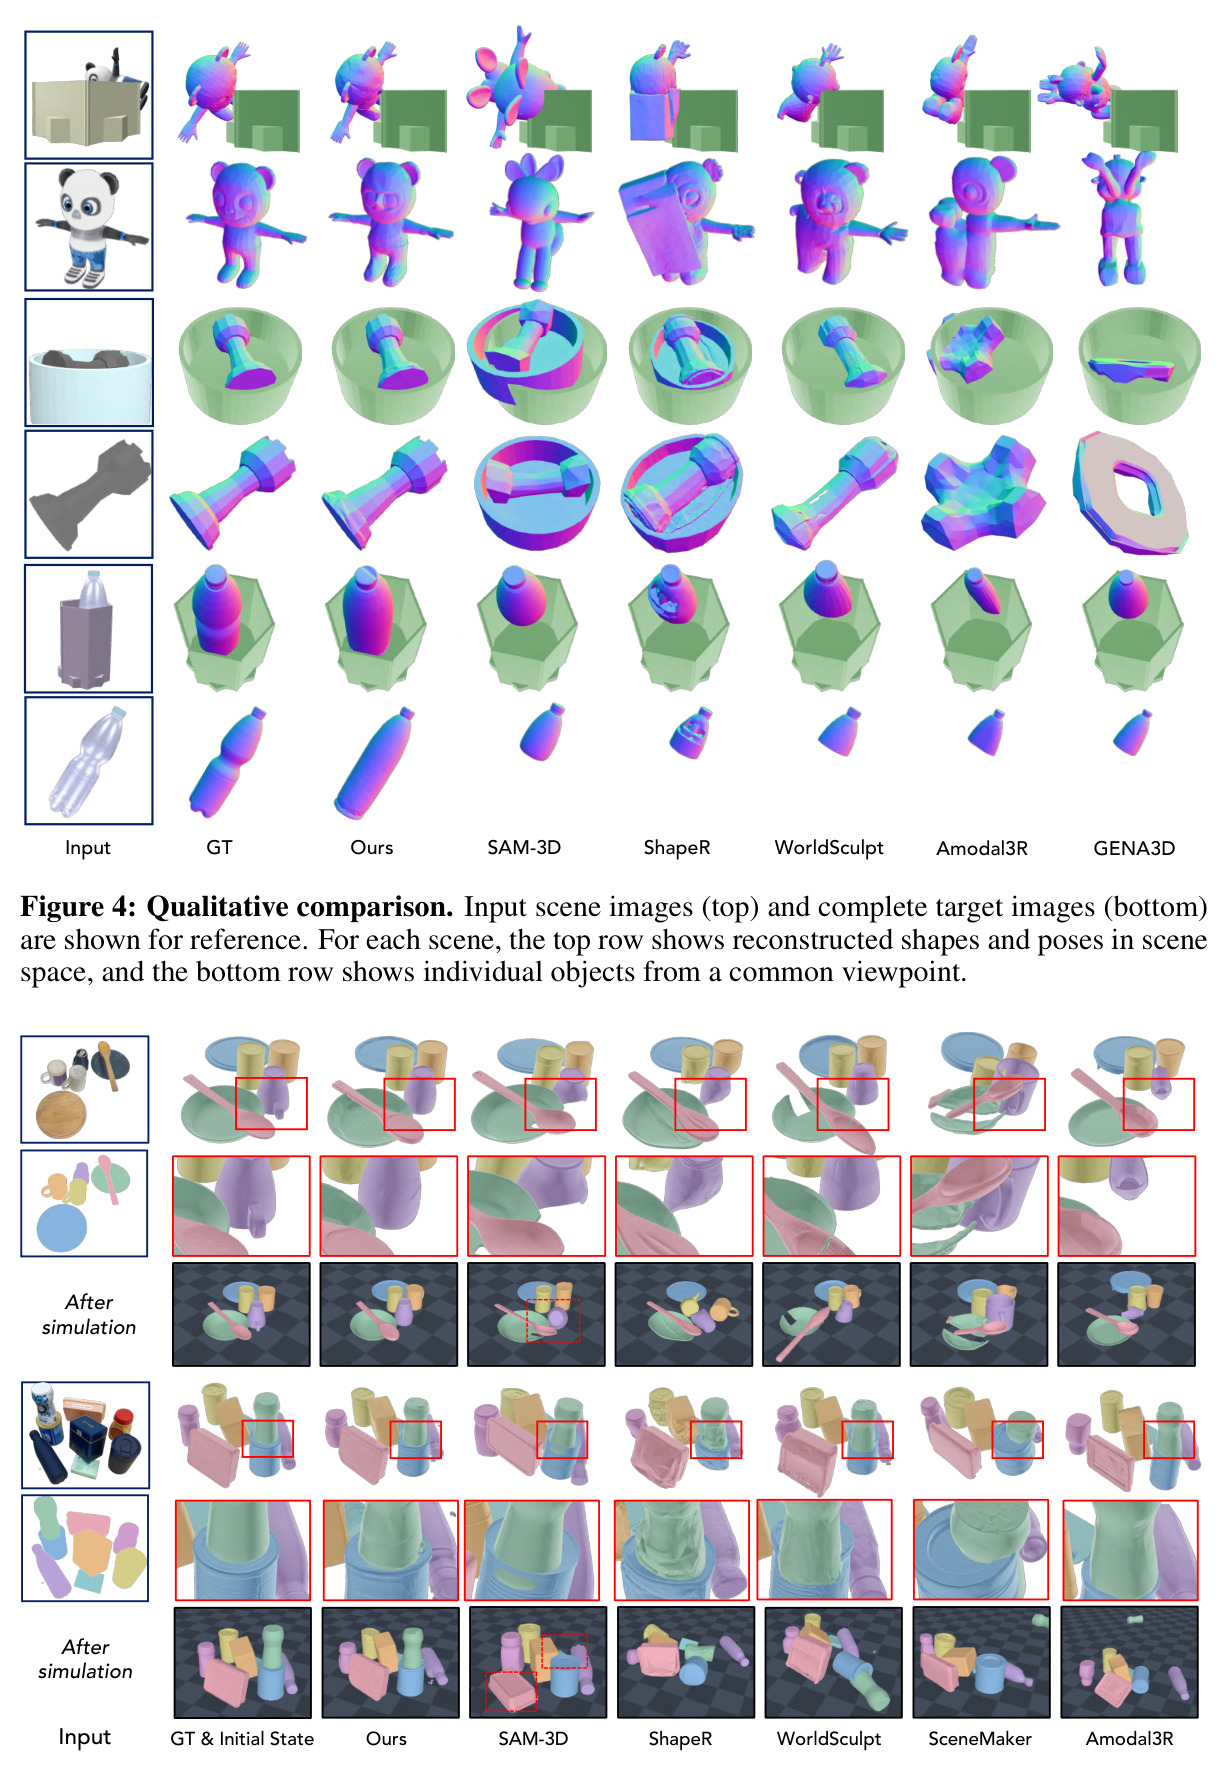
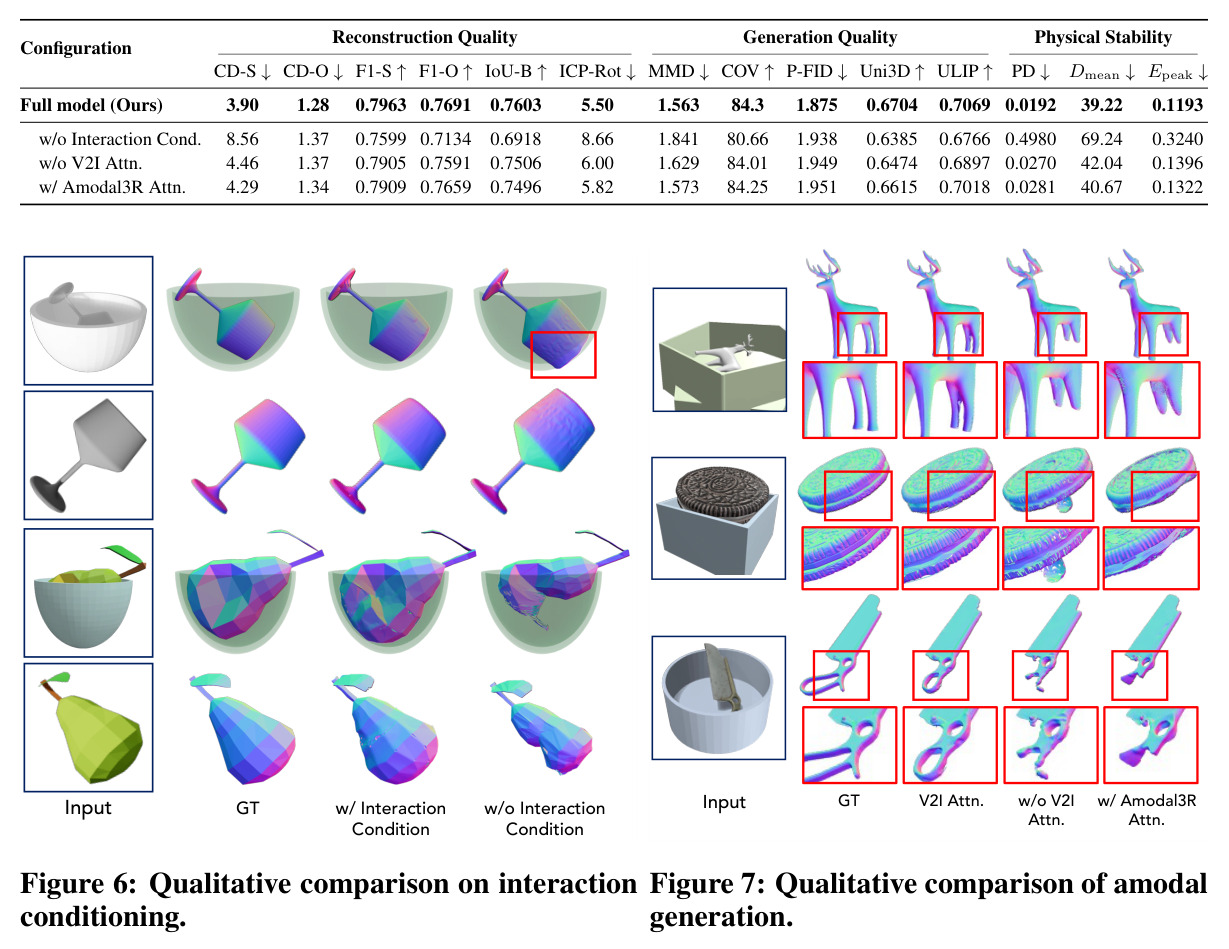
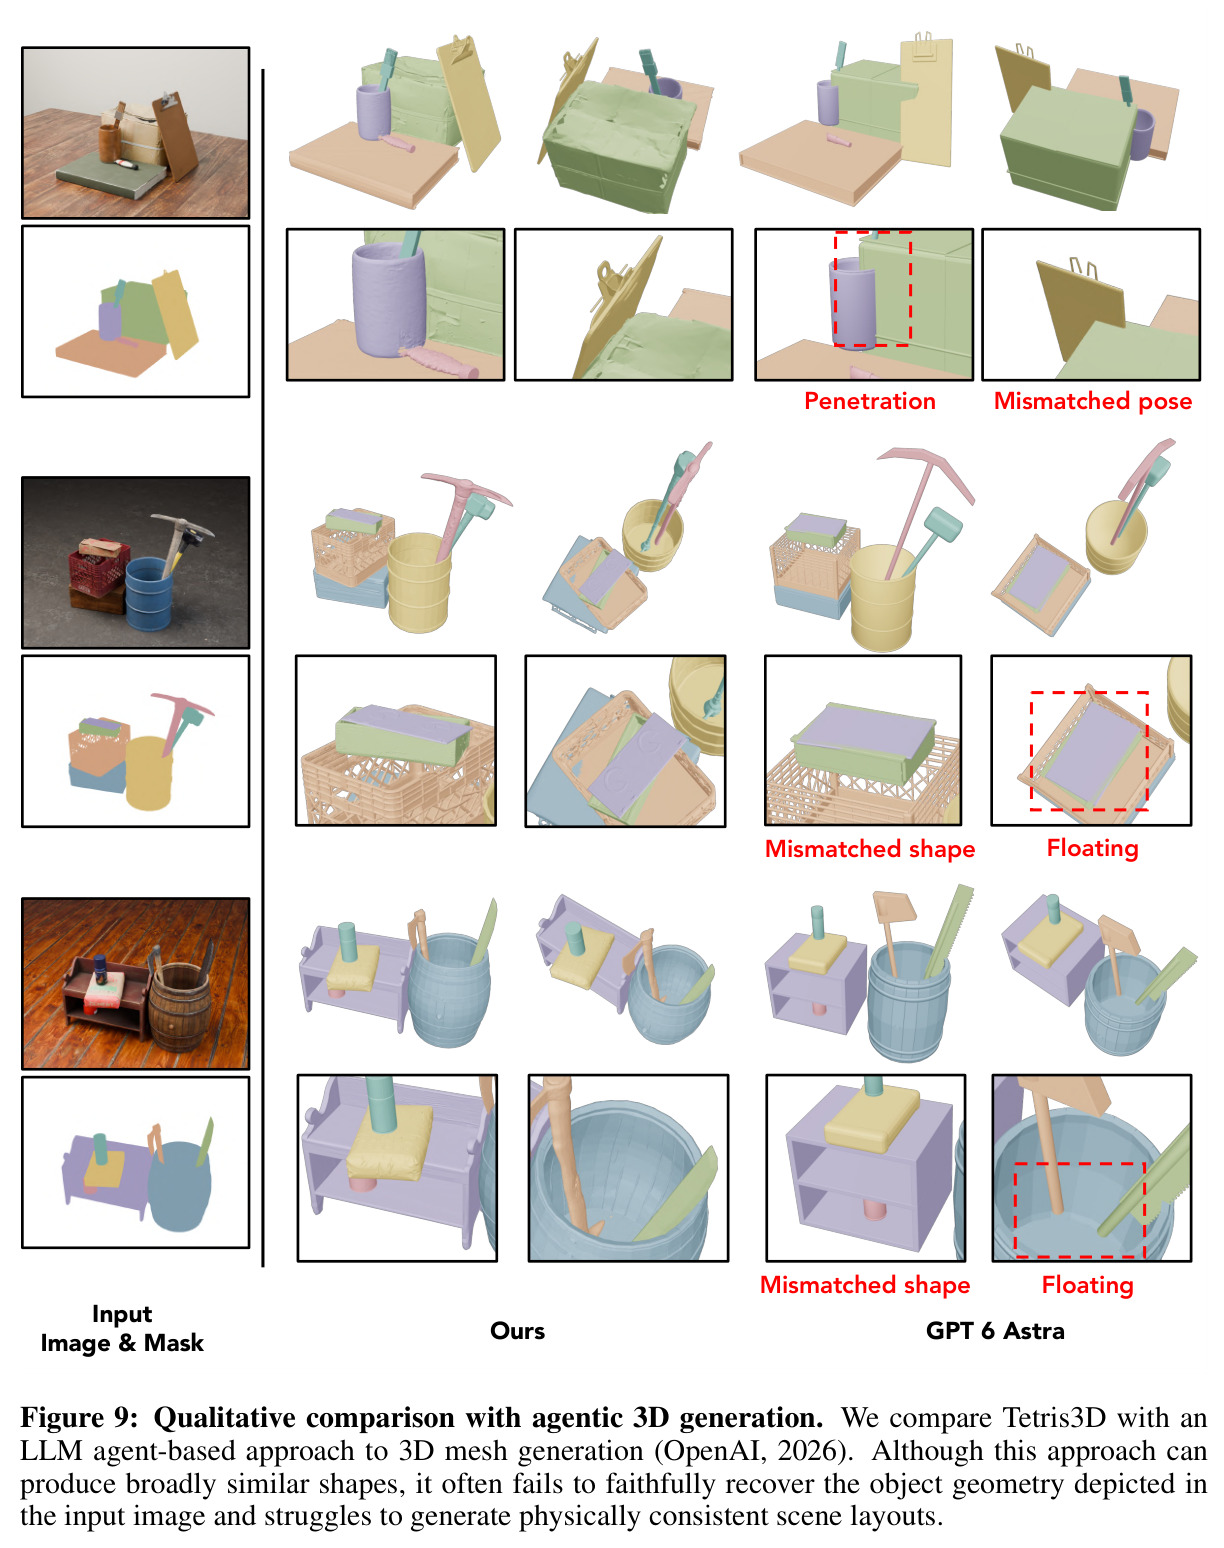
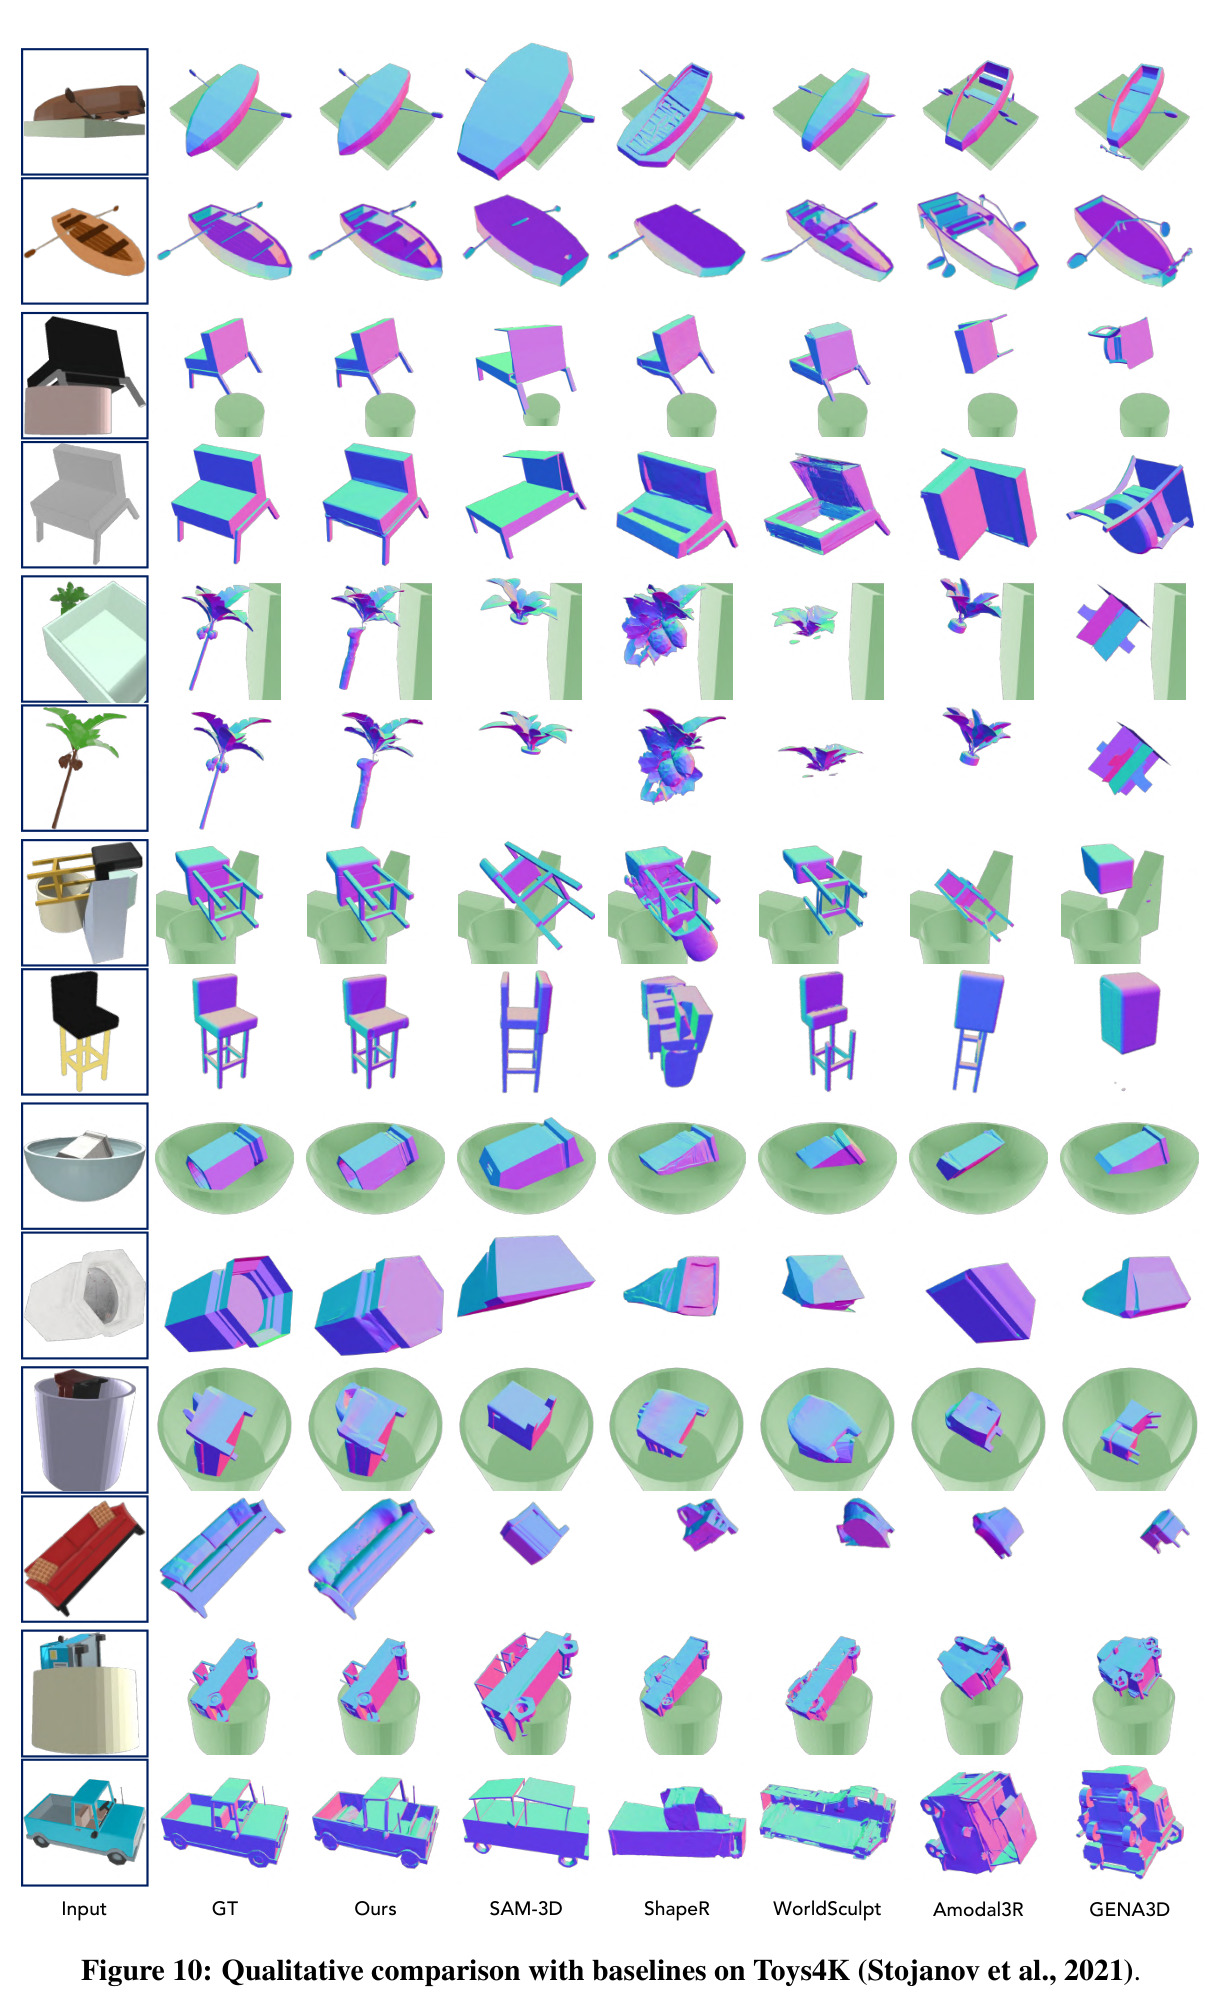
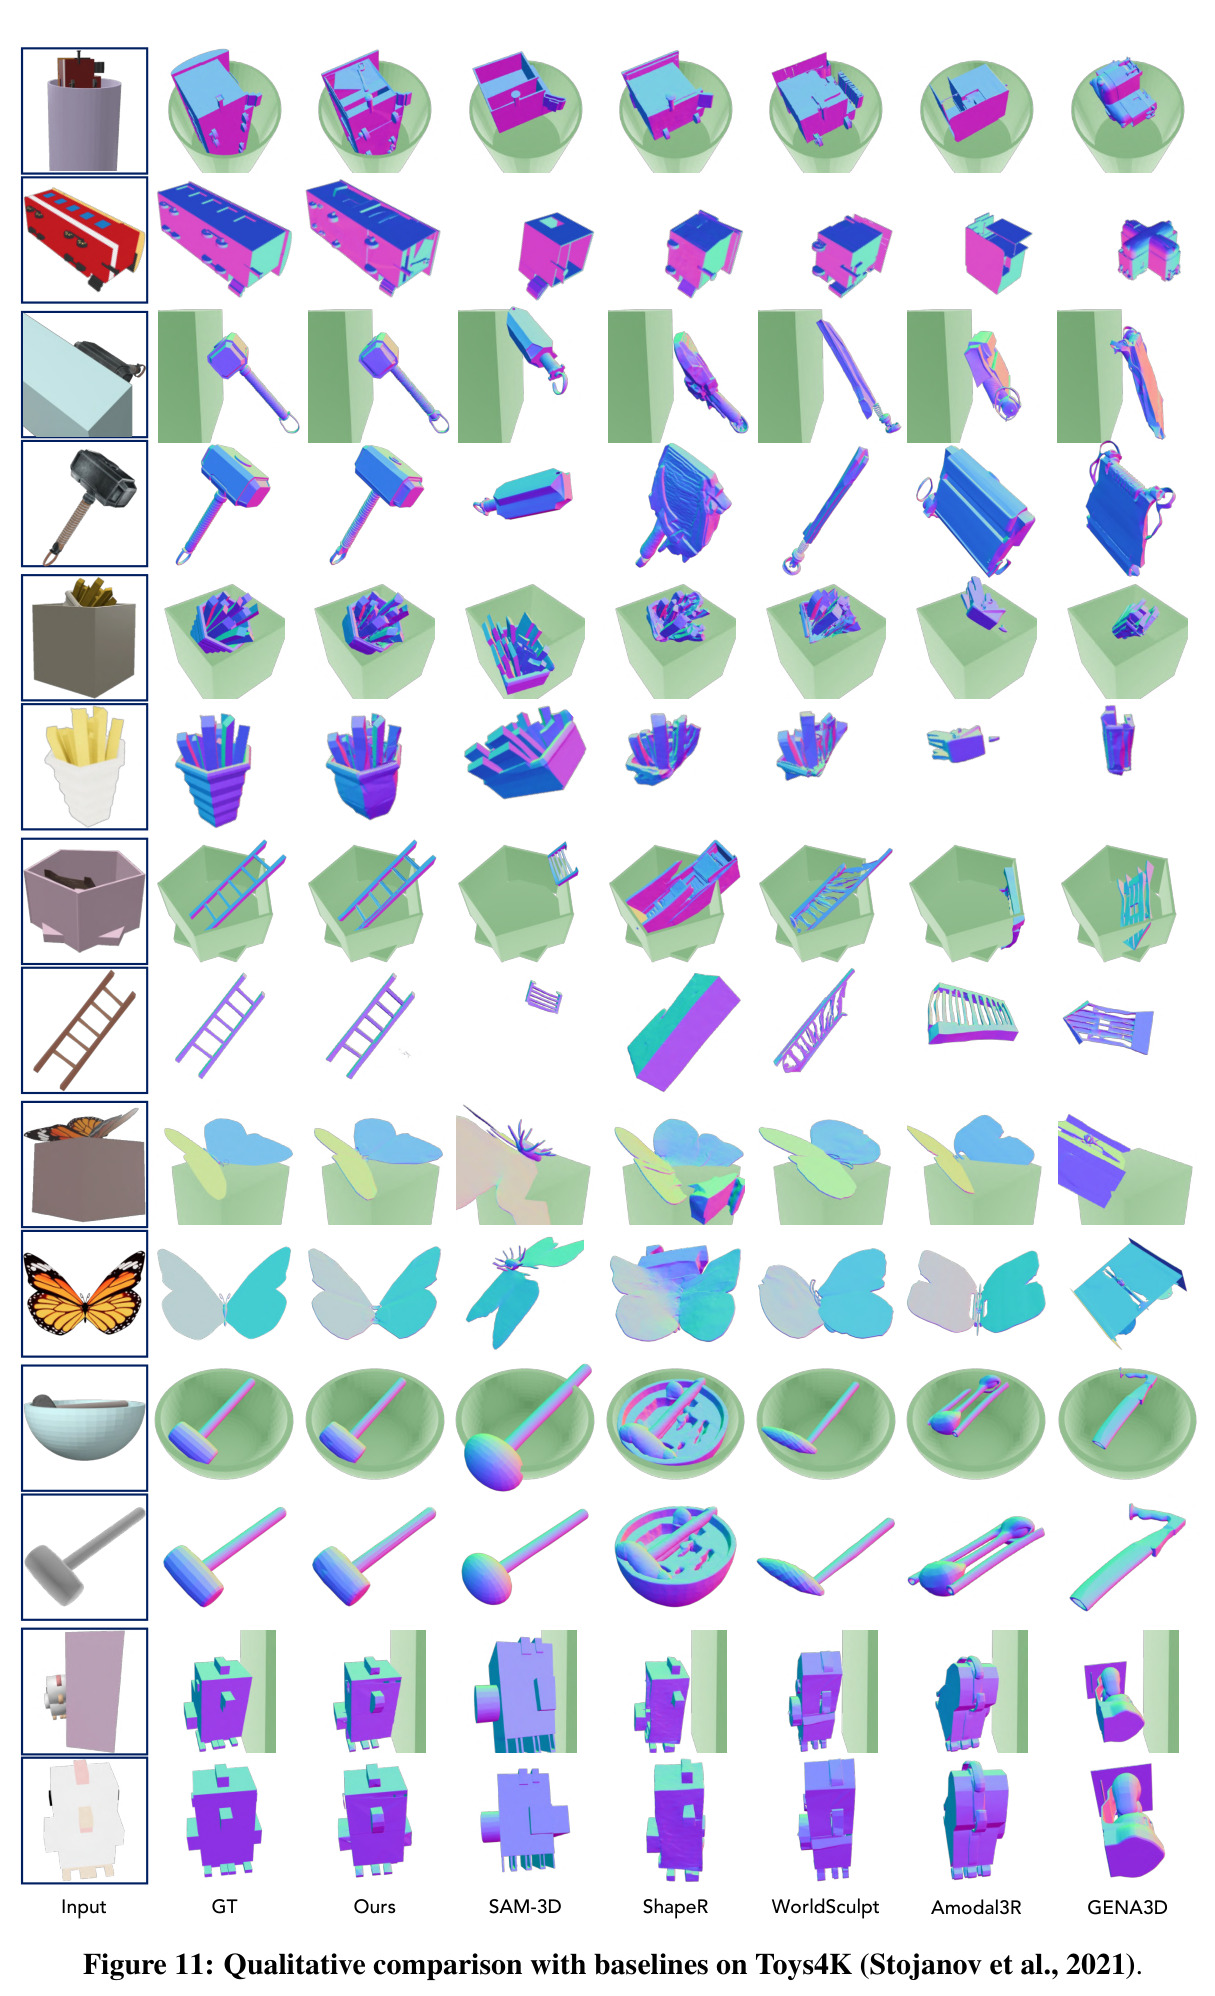
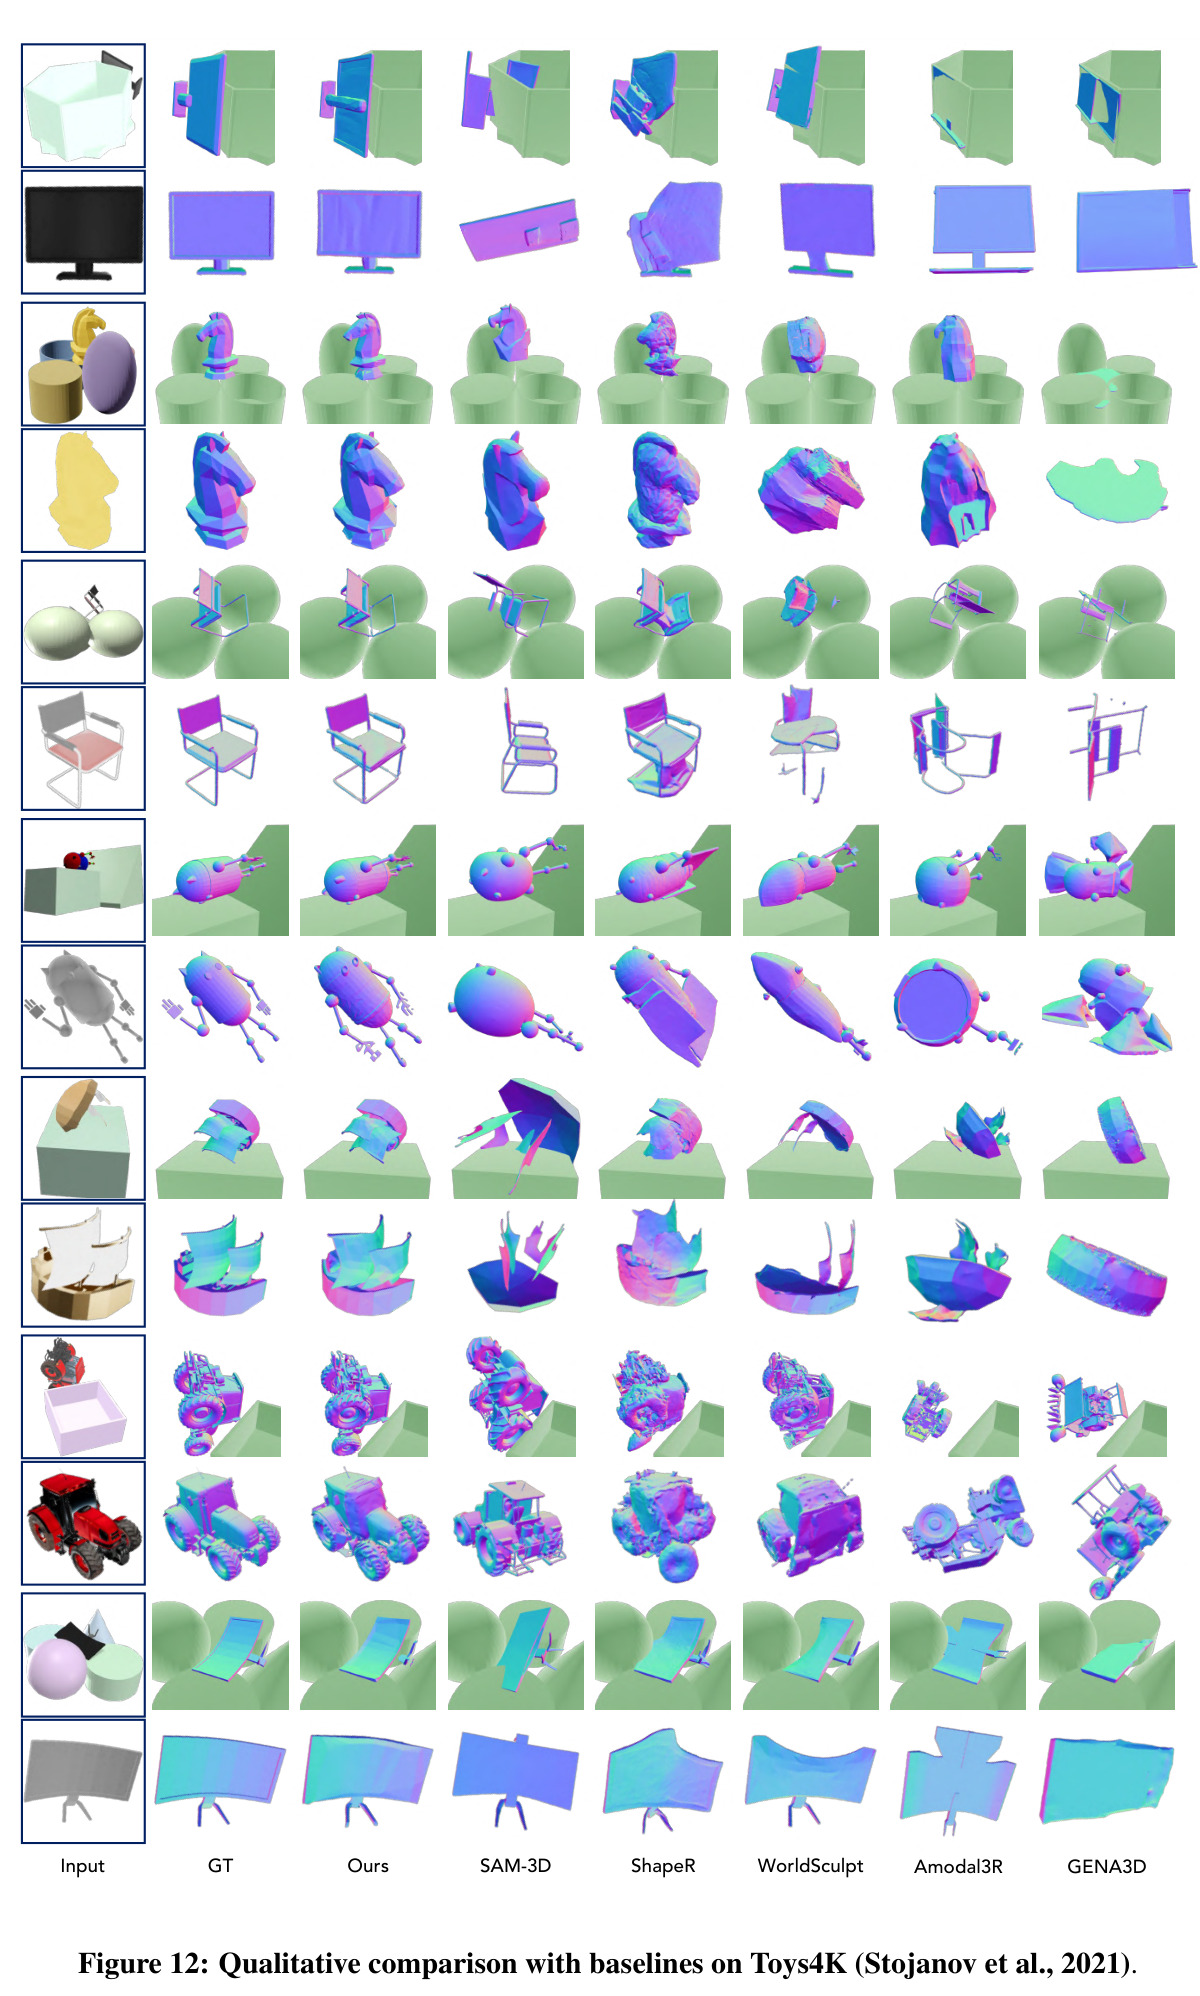
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Toys4K 场景重建(合成基准,真值深度) | CD-S(场景级 Chamfer 距离,×10⁻²,越低越好) | 3.68 | ShapeR 5.72 / WorldSculpt 8.68 / SAM-3D 25.19 | 较最强基线 ShapeR 降低约 36%,较 SAM-3D 降低约 85% |
| Toys4K 物理稳定性 | PD(穿透深度,越低越好) | 0.0036 | WorldSculpt 0.1177 / SAM-3D 1.354 | 比 WorldSculpt 低约 33 倍,比 SAM-3D 低约 376 倍 |
| Toys4K 位姿精度 | ICP-Rot(ICP 对齐后残余旋转角,度) | 5.29 | ShapeR 10.65 / Amodal3R 22.97 | 约为最强基线的一半 |
| MessyKitchens 真实场景重建 | CD-S | 0.11 | ShapeR 0.23 / SAM-3D 0.25 / SceneGen 2.47 | 较最强基线降低约 52% |
| Picasso 真实场景重建 | CD-S | 0.27 | WorldSculpt 0.54 / ShapeR 0.65 | 降低约 50%-58% |
| MessyKitchens 物理稳定性 | PD | 0.0011 | WorldSculpt 0.0012 / SceneGen 27.21 | 与最优基线持平或更优,鲁棒性远超隐式耦合方法 |
| Toys4K 消融:交互条件贡献 | PD / CD-S | 0.0192 / 3.90(完整模型) | 去掉交互条件后 0.4980 / 8.56 | 26 倍 PD 差距,证明交互条件是主要增益来源 |
| Toys4K 估计深度鲁棒性 | CD-S | 7.56 | ShapeR 10.54 / SAM-3D 24.80 | 仍为全场最佳,但较自身真值深度结果(3.68)翻倍 |
局限与改进
作者在附录 E 中明确承认两点局限:其一,交互条件只是『学到的引导』而非硬物理约束,无法保证每个生成配置都物理有效;其二,推理管线依赖多个现成模块——MoGe3 深度估计、SAM3 分割、Qwen3-VL 关系推理——它们的误差会扭曲物体网格与投影特征,或导致错误的交互条件与生成顺序,且由于自回归机制,先前物体的误差会向后续物体传播。我的补充观察:(1) Toys4K 的评估场景本身是用 ComOb 生成器布置原语构造的,与训练分布同源,可能高估了合成基准上的优势(尽管真实基准确实验证了泛化能力);(2) 关系词汇封闭于 {stack, lean, contain, touch, none} 五类,无法表达缠绕、悬挂、铰接等复杂交互;(3) 逐物体串行自回归使推理时间随物体数线性增长,物体众多的真实场景开销可观;(4) 估计深度下 CD-S 从 3.68 翻倍到 7.56,说明对深度质量相当敏感;(5) 外观评估只依赖点云-图像语义相似度(ULIP/Uni3D),纹理与材质保真度未被充分量化;(6) 依赖图中环的消解依赖 VLM 给出的置信度标量,置信度本身的校准性没有单独评估。
独立分析的弱点
独立分析四个弱点。其一,自回归误差无恢复机制:若支撑物体(如桌面)形状有偏差,所有依赖物体的交互条件都被污染,且先生成的物体无法在看到后续物体后修正,改进方向是引入生成后的全局联合精化阶段,或对高置信度依赖做多次重打样择优。其二,对深度质量高度敏感:使用 MoGe3 估计深度时 CD-S 从 3.68 升至 7.56、ICP-Rot 从 5.29° 升至 12.7°,在透明、反光、弱纹理物体上单目深度估计会更糟,可考虑深度与形状的联合迭代估计,或对深度条件引入逐体素不确定性加权(现有训练仅做均匀高斯扰动增强)。其三,关系表示封闭且离散:五类可学习嵌入无法表达接触面积、摩擦系数、软硬程度等连续物理属性,也无法描述多物体同时接触一处的组合关系,可用开放词汇关系描述或连续物理参数回归替代固定嵌入表。其四,串行推理瓶颈:$N$ 个物体需 $N$ 次两阶段扩散采样,可利用物理依赖图的层次性做分块并行去噪(无依赖关系的物体同时生成)。另有一个设计层面的观察:遮挡掩码定义为其余物体掩码之并,过于保守——目标物体背后并未被遮挡的区域也被视为不可见,可能过度依赖生成先验而非图像证据。
未来方向
作者在讨论中提出的方向是减少对现成模块的依赖、并对估计条件的不确定性建模。在此基础上有若干自然延伸:(1) 把软物理约束升级为硬约束,例如在流匹配去噪过程中嵌入可微物理引擎的投影或能量项,使物理有效性在采样时得到保证而非事后祈祷;(2) 延伸到动态场景与交互仿真——ComOb 本就由 MuJoCo 生成,可直接衔接机器人操作中的『重建-仿真-执行』闭环,让重建场景成为策略学习的仿真环境;(3) 开放词汇物理关系:用 VLM 的语言空间替代五类封闭嵌入,支持磁吸、悬挂、缠绕等长尾交互,并随 VLM 能力提升自动受益;(4) 非刚性/可变形物体(布料、绳索、食物)的交互重建,现有刚性 UDF 条件不适用,需要时变或拓扑灵活的邻域表示;(5) 与可微仿真联合训练,让模型学到摩擦、重心等真实物理量而非仅视觉合理性;(6) 置信度校准:对 VLM 关系预测做不确定性估计,在排序与条件注入中传播该不确定性;(7) 将 ComOb 的自动场景生成管线(原语布置 + 沉降仿真 + 关系标注)推广为通用物理交互数据引擎,服务于具身智能预训练。
复现评估
复现难度评估为中高、但完全可行。论文给出项目页(cvlab-kaist.github.io/Tetris3D),正文未明确承诺代码与权重开源,需关注项目页动态。数据方面,ComOb 的构建流程在附录 B.3 描述得非常完整:约 40 万 TRELLIS-500K 目标物体 + 12 种参数化原语(盒、板、圆柱、圆锥、球、楔、管、环面、杯、敞口箱、多边形箱、碗),按交互类型规则化布置后经 MuJoCo 沉降仿真(最终观测窗内线速度 <0.025 m/s、角速度 <0.12 rad/s 才保留),Blender EEVEE 渲染(FOV 35°-70°,目标可见率限制在 0.3-0.9),工程量不小但每一步都可复现。算力门槛友好:仅需 2 张 NVIDIA H200,SS 模型 20 万步约 7 天、SLAT 模型 10 万步约 9 天,batch 16,模型从开源的 TRELLIS.2(1.83B/1.68B 参数)与 Pixal3D 初始化微调,而非从零训练。推理侧还需 MoGe3、SAM3、Qwen3-VL-30B 三个开源模型与 MuJoCo。若作者放出权重与 ComOb 数据,复现主表结果的难度不大;若需从零搭建数据管线,主要成本在仿真过滤阈值与渲染参数的调试上。
论文图表
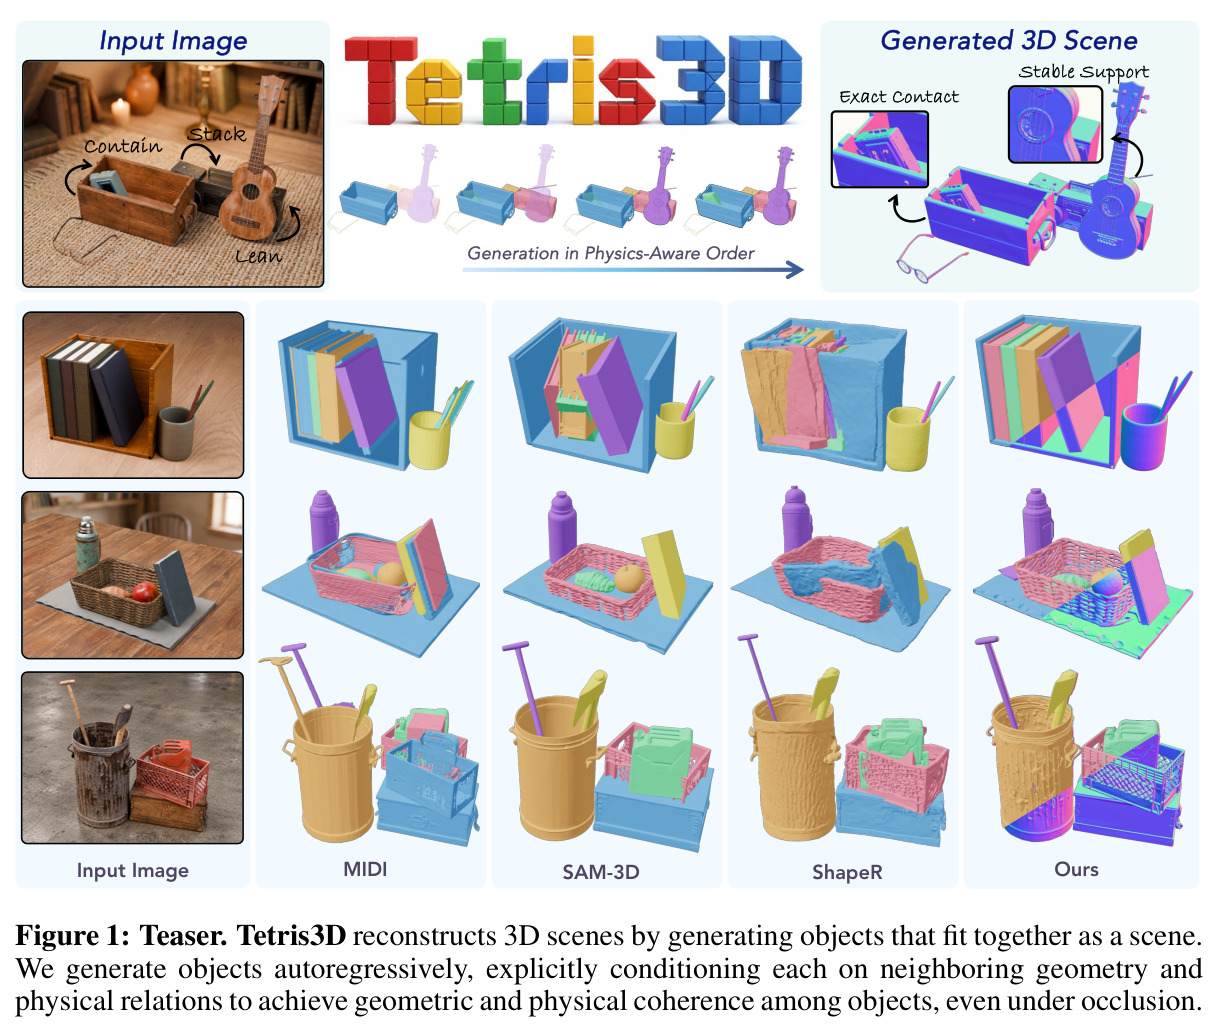
预告图。上半部分展示 Contain(容纳)、Stack(堆叠)、Lean(倚靠)三类交互的输入图像与生成的 3D 场景,标注了『Exact Contact(精确接触)』与『Stable Support(稳定支撑)』两个关键特性;下半部分将 Tetris3D 与 MIDI、SAM-3D、ShapeR 在同一输入下的重建结果对比。
一图概括论文要解决的问题与卖点:物体间几何物理连贯(贴合、支撑),且在遮挡下依然成立;与基线的直观差距是理解全文动机的最佳入口。
MessyKitchens 真实场景上的定性对比。第一列显示场景图像与逐物体掩码(颜色与生成场景中物体对应),每个场景给出重建结果及物理仿真(MuJoCo)后的最终状态;对比 SAM-3D、ShapeR、WorldSculpt、SceneMaker、Amodal3R。Tetris3D 重建经仿真后保持稳定,多数基线坍塌或漂移。
展示方法在真实图像上的泛化能力与物理稳定性的直观差异,仿真前后对比是把『物理一致性』从抽象指标落到可视证据的关键。
Amodal 生成的消融定性对比:V2I 注意力、去掉 V2I 注意力、换成 Amodal3R 注意力三种配置下被遮挡区域的补全效果。V2I 注意力的补全最完整准确,去掉后遮挡区域出现缺损,Amodal3R 注意力居中。
为 V2I 注意力设计的优越性提供视觉证据,补充 Table 3 中 CD-S 3.90 vs 4.29 vs 4.46 的定量对比。
置信度加权物理排序算法:输入物体集合、地面根节点、带置信度的有向依赖边与无向接触边,通过子集动态规划增量构建生成序——每步只添加至少有一个物理相关物体已生成的顶点,并最小化与当前序冲突的有向边置信度之和,最后回溯得到完整生成顺序 $\pi$。
解决真实场景中 VLM 预测的循环依赖(如两物体互相支撑)问题,是自回归推理管线能自动运行的算法核心,理解生成顺序如何确定必不可少。