Lean Pool:AI 维护的形式化数学档案库 Lean Pool: An AI-Maintained Archive of Formalized Mathematics
AI 智能体自动收录、升级、优化 Lean 形式化证明,建成数学界的「形式化 arXiv」。
前置知识
Lean 定理证明器与证明内核
Lean 是一种交互式定理证明器兼编程语言:数学命题被写成类型,证明被写成程序。其核心是体积极小的内核(kernel),每条声明最终都会被还原为内核可独立检查的证明项;只要内核正确、信任基础(propext、Classical.choice、Quot.sound 三条公理)无误,通过内核检查的证明就在逻辑上无懈可击。这种「小内核、大环境」架构让机器生成的证明也能被机械验证。
Lean Pool 的一切设计都以「内核保证正确性」为前提:收录规则(禁 sorry、公理白名单)、CI 检查、依赖升级修复全都以内核为最终裁判。理解这一点,才能理解为何让 AI 自动生成和合并数学代码是安全的。
Mathlib
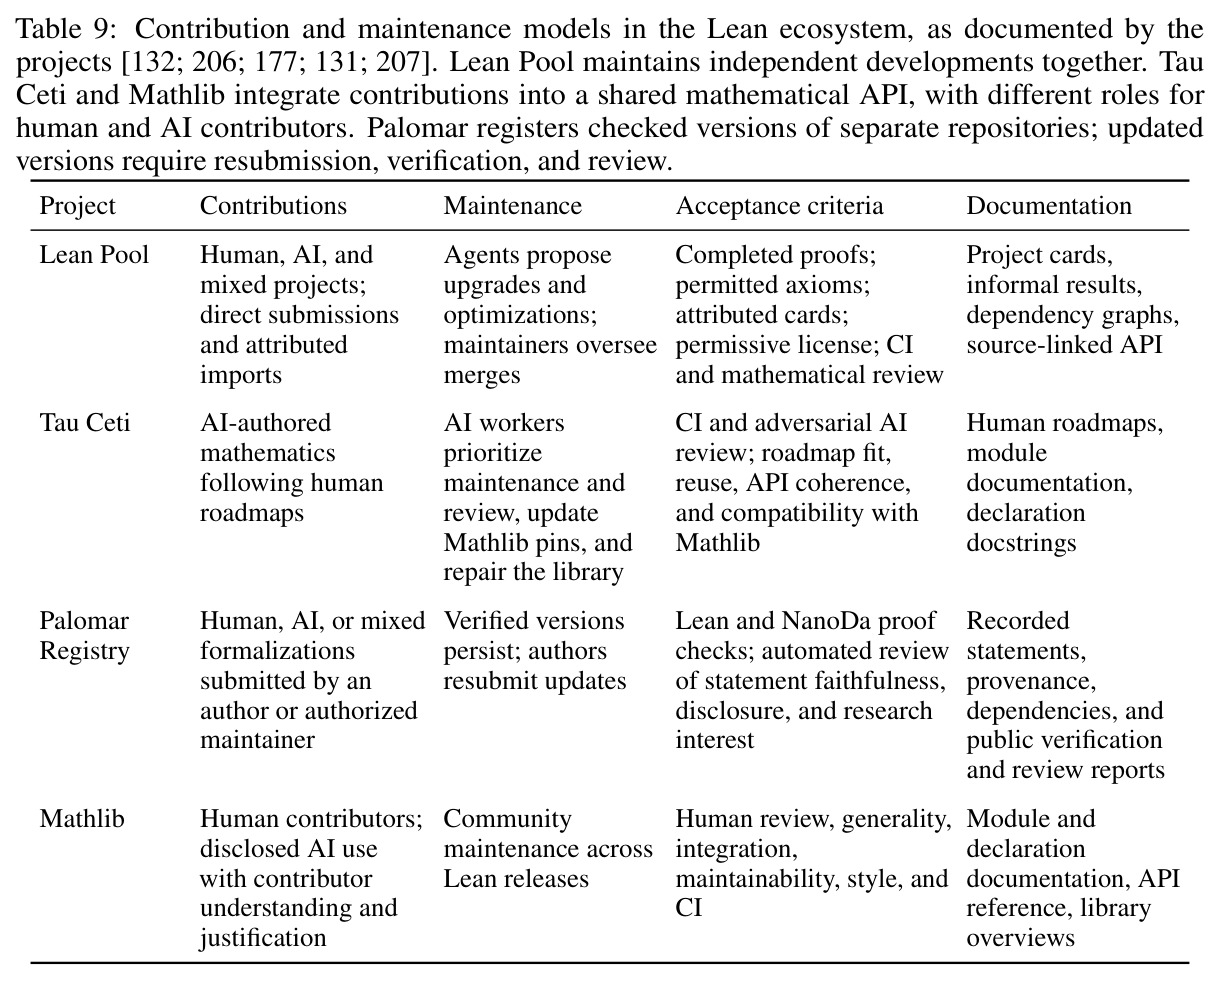
Mathlib 是 Lean 4 的社区数学库,由人工评审维护,包含大量基础定义、引理与定理,是绝大多数 Lean 数学项目的共同依赖。它的评审标准极高(通用性、API 一致性、可维护性、风格),导致增长只能呈线性;Navier–Stokes 爆破、PFR 猜想这类研究级数学的专用形式化通常进不了 Mathlib。
论文的出发点正是 Mathlib「装不下」研究级数学且增长受限;同时 Lean Pool 与 Mathlib 共享构建和 linter 基础设施,Mathlib 每次版本变更都会触发整个档案库的兼容性维护,是全文所有「升级修复」工作的起因。
形式化与自动形式化
形式化指把非形式数学证明翻译成定理证明器可检查的代码;自动形式化(autoformalization)则用 LLM 等 AI 系统完成这一翻译。形式化不仅验证证明没有逻辑漏洞,还迫使作者显式写出所有隐含假设。当 AI 生成数学论证的速度超过人类阅读能力时,形式化成为「先机械验证、再慢慢消化」的关键手段,OpenAI 的十大数学进展与 Navier–Stokes 爆破结果都附带了 Lean 形式化。
这些 AI 产出的完整形式化正是 Lean Pool 要收纳、维护的对象;理解形式化的价值,才能理解「让完成的证明持续可用」为什么是一件值得专门建基础设施的事。
sorry、admit 与公理白名单
在 Lean 中,sorry/admit 是占位符,表示「此处证明未完成」,含 sorry 的声明会被标记为依赖 sorryAx 公理;随意添加新公理同样能绕过证明义务。Lean Pool 的准入规则要求项目不含任何 sorry/admit,且只允许 Classical.choice、propext、Quot.sound 三条标准公理,CI 还会在编译产物层面审计是否有人用 set_option 等手段偷偷绕过检查。
这条线划出了「完成的数学」与「半成品」的分界,也是 Lean Pool 敢于让 AI 自动汇总并合并代码的信任根基;读懂它才能理解论文中「admission rules」部分的所有机械检查。
AI 智能体(agent)
AI 智能体是以 LLM 为核心、能自主执行多步软件工程任务的程序:读代码、跑编译、改写证明、开 PR、根据 CI 反馈迭代。Lean Pool 用一套「每日任务」组织智能体工作:发现新项目、审查开放 PR、修复依赖升级导致的编译错误、优化既有代码、发布公告;任务定义(提示词)保存在单独的自动化仓库中,随档案演化持续修订。
论文的核心主张就是「AI 能承担档案库的增长、维护与优化」,全文的运营数据(六次版本升级、97 个修复任务成功 95 个、库级删码 5 万行)都是对这一主张给出的证据链。
持续集成(CI)与 linter
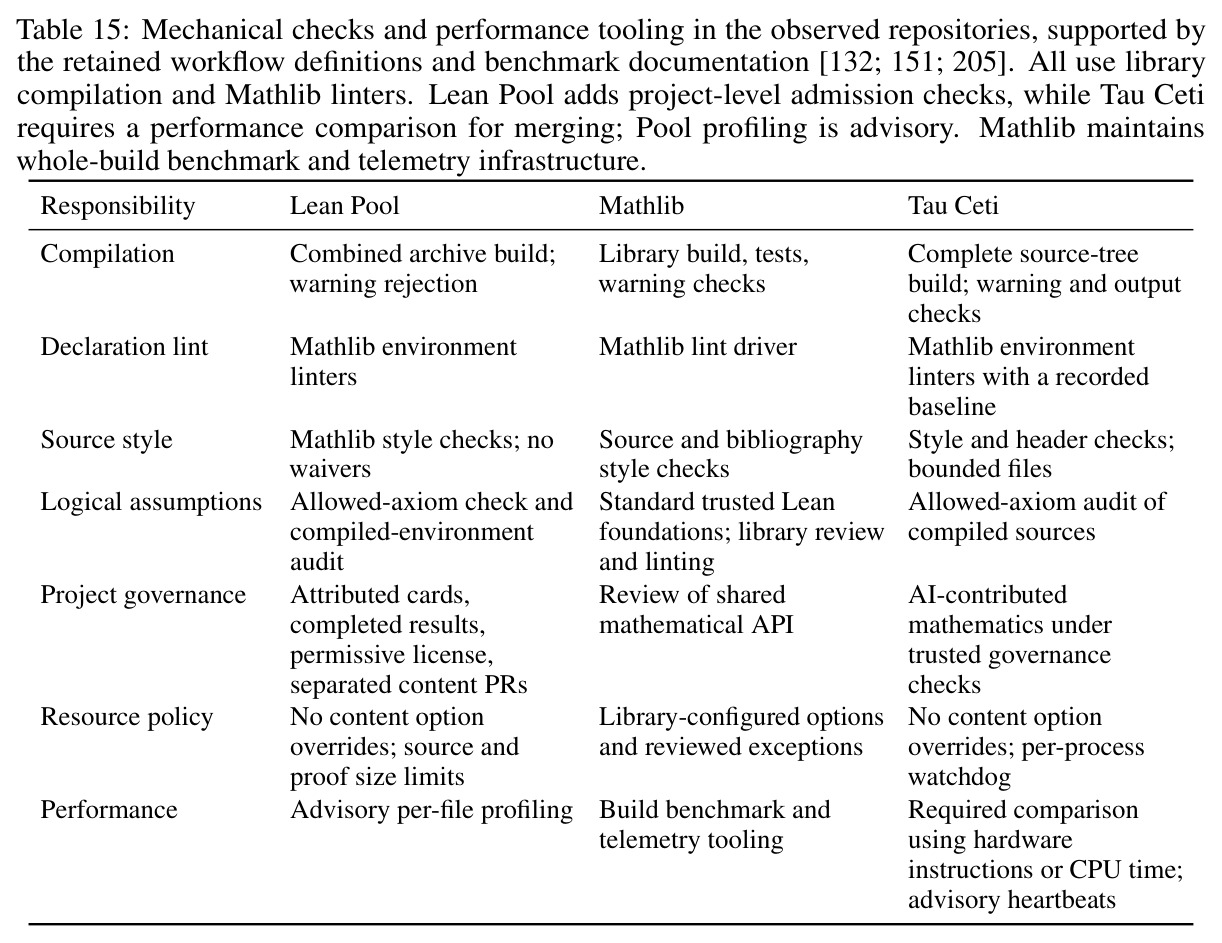
持续集成指每次提交都自动完整构建并运行检查的工程实践;linter 是静态检查工具,用于发现不规范命名、冗余参数、风格偏差等。Lean Pool 的 CI 在 Mathlib 的构建与 lint 基础上叠加档案特有检查:项目卡完整性、公理白名单、证明与文件大小上限、绕过检测,并对新文件输出心跳数与 elaboration 时间的编译成本剖析(目前仅为建议性)。
CI 是质量控制的第一道机械防线,LLM 数学评审是第二道语义防线,二者共同构成论文第 3、7 节的准入与维护机制,也是与 Mathlib、Tau Ceti 对比(Table 15)的框架。
研究动机
生成式 AI 产出数学论证的速度已超过数学家阅读消化的速度:OpenAI 的「数学与理论计算机科学十大进展」和 Navier–Stokes 有限时间爆破等工作都随发布给出了很长的 AI 生成证明与配套 Lean 形式化。当生成变得廉价,验证与沉淀成为瓶颈,而基础设施跟不上:Lean 的标准数学库 Mathlib 因严格人工评审只能线性增长,缺少研究级数学所需的定义与定理;与此同时,散落在 GitHub 各处的独立形式化项目一旦上游停止维护,就会随 Lean/Mathlib 版本演化迅速失效——本文导入的 211 个项目原本被 pin 在从 4.5.0-rc1 到 4.34.0 的数十个不同 Lean 版本上,甚至有项目停留在 2023-08-19 的 nightly 版本。完成却无人维护的证明既找不到、也编译不了、更没法被后续工作 import,就无法成为新研究的基石。
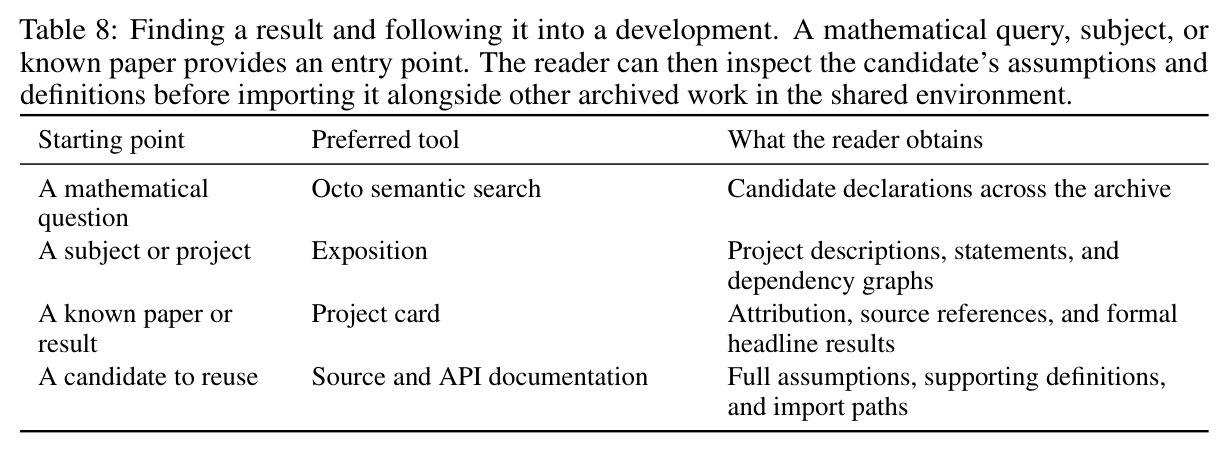
本文的目标是本文提出并实际运营 Lean Pool——一个由 AI 智能体负责增长、维护与优化的「活的」形式化数学档案库,为已完成的完整形式化提供持久、可搜索、保持归属的统一环境。四个具体目标:(1)增长:智能体自动发现 Apache-2.0/MIT 许可、无 sorry、公理合规的严肃完整形式化并带署名汇入(pooling),人类也可直接提交;(2)维护:Lean/Mathlib 每发布新版本,自动探测失败项目、派发修复智能体、整库验证后合并,保证全部 211 个项目始终可编译;(3)优化:定期开展库级证明压缩、编译速度与内存优化;(4)发现与复用:通过项目卡、Exposition 依赖图和 Octo 语义搜索让读者找到定理、检查假设并把结果 import 到新工作中,最终成为 arXiv 的形式化对应物。
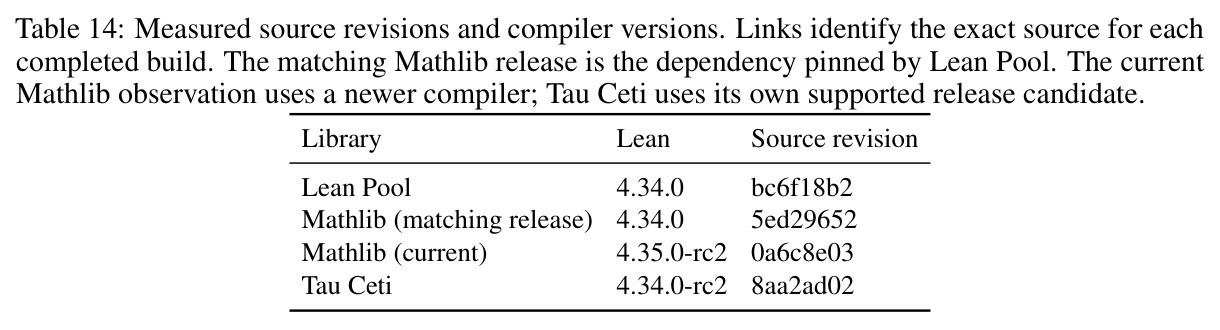
与已有工作不同的是,既有方案各有盲区:Mathlib 要求把结果改写进统一数学 API 并经人工评审,质量高但增长慢,装不下研究级专用数学;Isabelle 的 AFP 与 Palomar Registry 采用注册制,存档验证过的静态快照,但更新需作者重新提交验证,没人做持续维护;Tau Ceti 是 AI 按人类路线图编写的单一库,不做跨项目汇聚。Lean Pool 的独特切入是把「档案」升级为「活档案」:接受独立开发、保留各自归属与项目结构的完整项目(而非并入统一 API),把传统上依赖志愿者人力的跨项目维护——依赖升级修复、库级 proof golfing、编译优化——整体交给 AI 智能体流水线,用 Lean 内核保证证明正确、linter 与 LLM 评审保证陈述质量。作者团队此前的编译器反馈修复(APRIL)、语义搜索(Octo/TheoremGraph)与专家评审案例研究提供了组件级基础,本文首次给出整体架构与运营证据。
核心方法
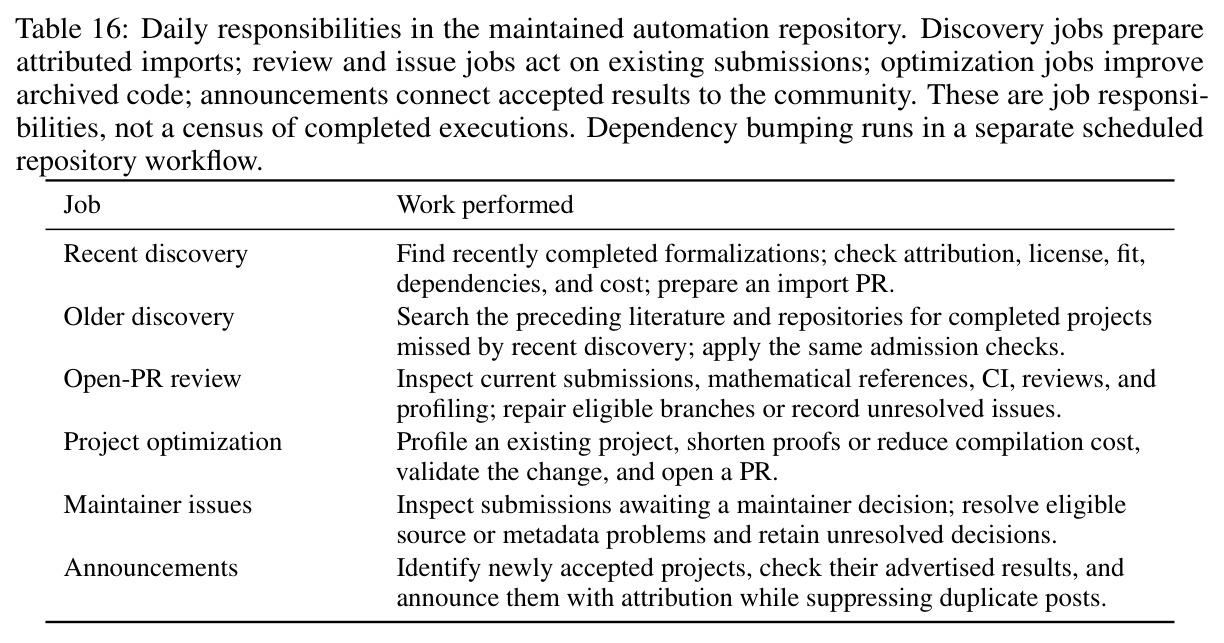
直觉很简单:arXiv 存论文,Lean Pool 存与之配对且始终可编译的形式化。系统由一个档案仓库加一个自动化仓库构成,五条工作流环环相扣。收录:智能体每日执行「近期发现」和「历史发现」,核对归属、许可证与依赖成本后生成保留上游署名的导入 PR;CI 做整库构建、拒绝意外警告、运行 Mathlib 环境/风格 linter 与档案专属质量门(项目卡、公理白名单 Classical.choice/propext/Quot.sound、禁止 set_option 与绕过、大小限制、编译产物审计),再经 LLM 数学评审判断形式陈述是否忠实对应所宣传的数学。维护:独立定时工作流检测新 Lean/Mathlib 版本,先用未改动源码探测,把失败项目分配给修复智能体,汇总补丁并整库构建后开草稿 PR 交维护者把关。优化:每日任务剖析热点文件,缩短证明或降低 elaboration 成本。发布:Exposition 站点导出项目卡与百万级依赖图,Zulip 频道带归属地公告新收录结果。
核心创新是把「数学档案的持续维护」本身变成 AI 可执行的工程任务,让增长与维护解耦。与 Mathlib 的本质区别:Mathlib 强制统一 API、人工评审,增长必然线性;Lean Pool 只要求「能编译、无作弊、说清自己证明了什么」,保留项目独立性并接受 AI 生成的证明,从而跟上 AI 形式化的产出速度。与 Palomar/AFP 的本质区别:注册制档案保存的是静态快照,依赖一变就死;Lean Pool 用「探测→分配→修复→集成」流水线让整个档案随 Lean 从 4.30 一路升到 4.34。与 Tau Ceti 的区别:后者是单一 AI 编写库,前者是多个独立项目的联邦,并用 LLM 评审补上形式验证管不了的「陈述忠实性」问题。这种「内核管正确、linter 管规范、LLM 管语义忠实、agent 管体力劳动」的四层分工,加上把每次升级和优化都记录成可测量、可复核的数据,是全文最重要的设计思想。
方法步骤详情
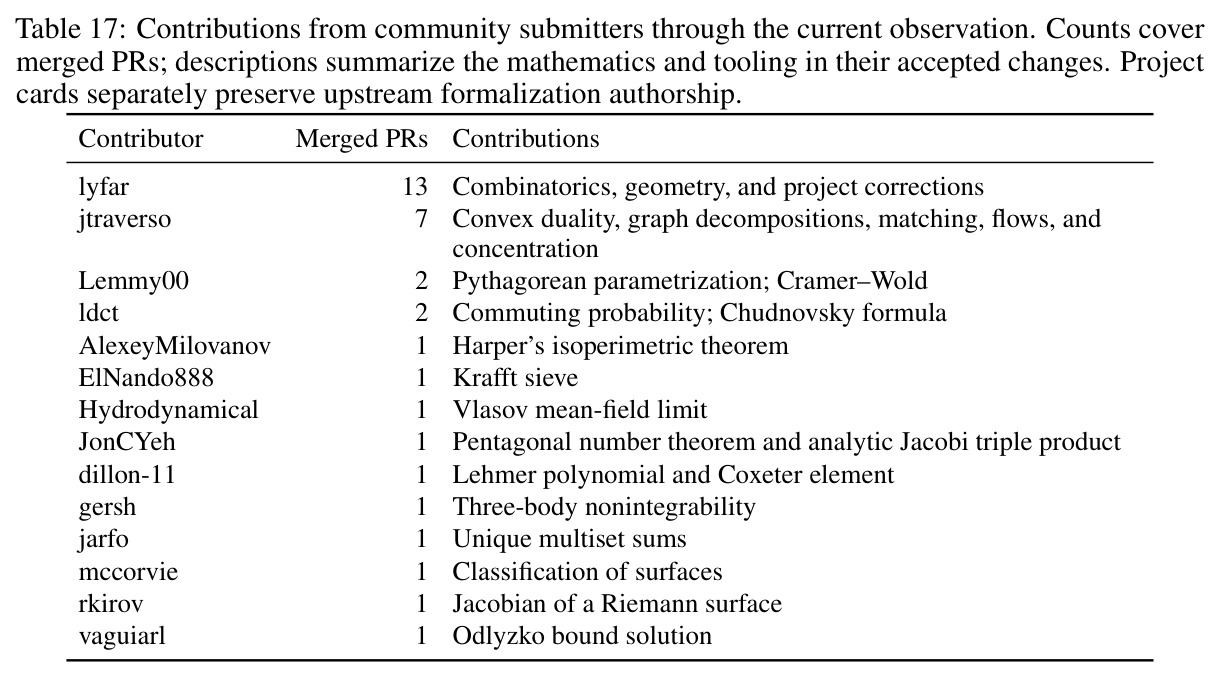
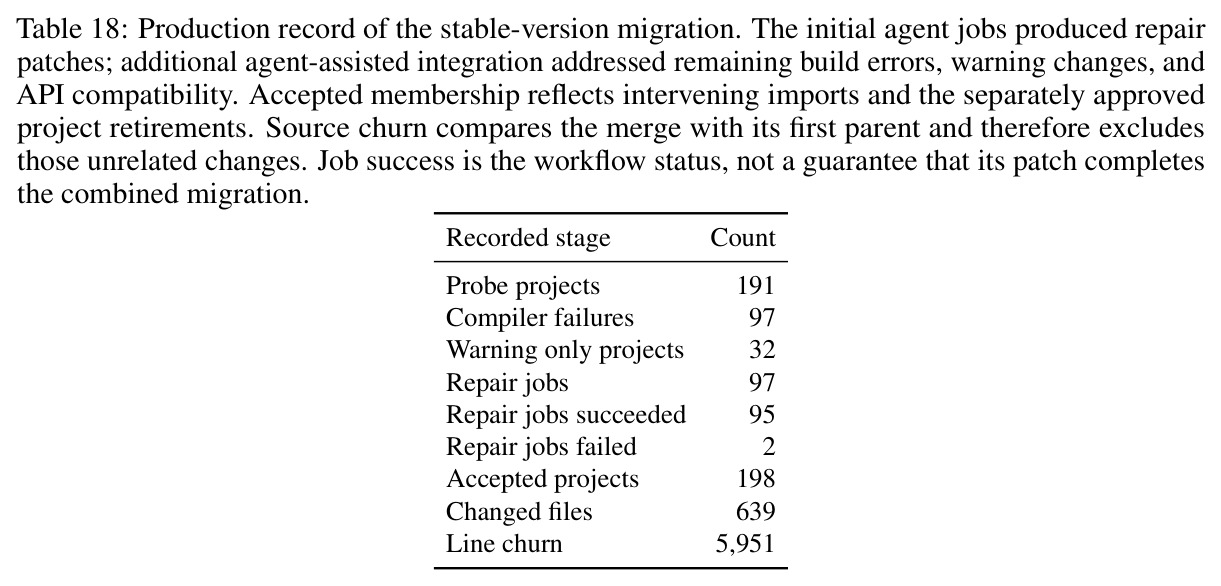
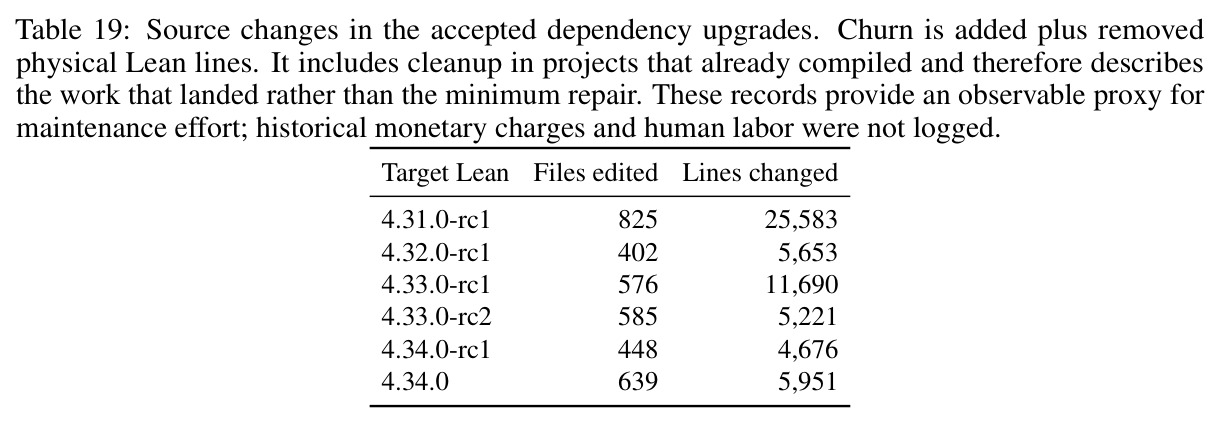
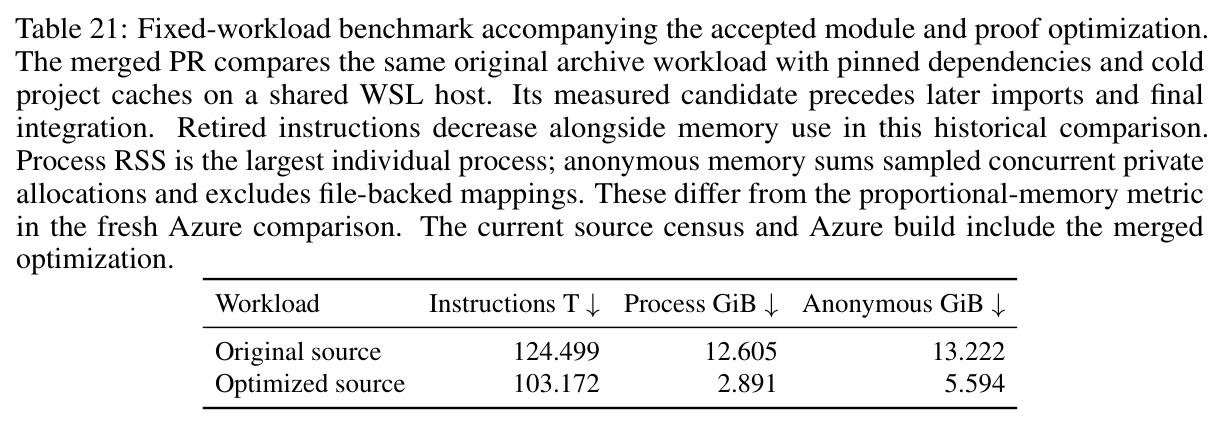
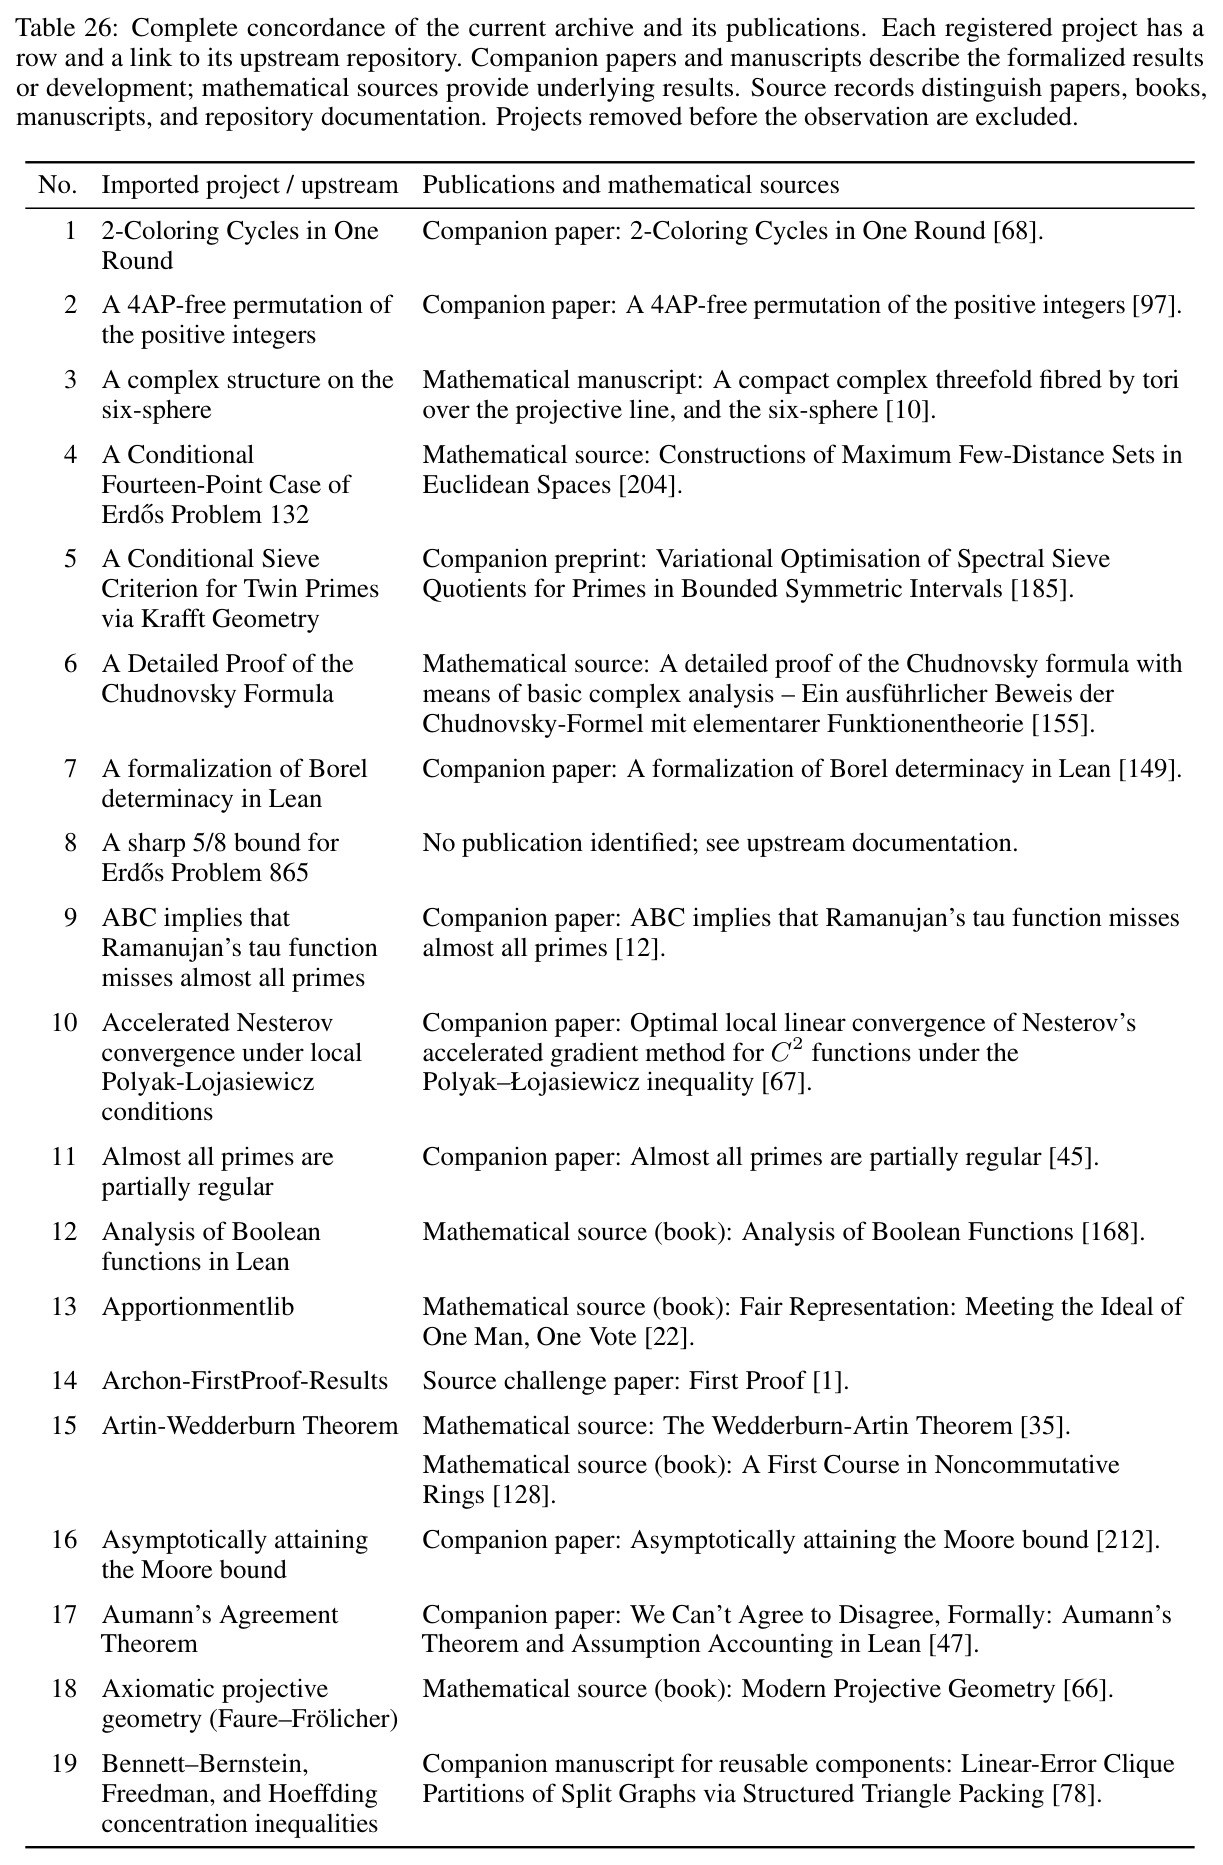
第一步·发现:「近期发现」与「历史发现」两个每日任务检索文献与仓库中的完整形式化,检查归属、许可证、题材契合度与依赖成本,生成保留上游署名的导入 PR;人类贡献者可直接提交,共 63 个社区 PR 被合并。第二步·准入:CI 整库构建并拒绝意外警告,运行 Mathlib 环境/风格 linter 与档案专属检查器(项目卡须含作者、上游、证明来源、标签、配非形式陈述的主结果;公理白名单;禁止 linter 豁免与诊断命令;源码与证明大小限制;编译产物审计防绕过),随后 LLM 评审给出 approve/要求修改/讨论三种结论,审查陈述不匹配、归属错误、结果不完整与重复定义。第三步·升级:独立工作流检测到新版后先用旧源码探测(如 4.34.0-rc1→4.34.0 时 191 个项目 97 个编译失败),给失败项目派发修复智能体,汇总补丁、整库构建后开草稿 PR;稳定版迁移中 97 个修复任务成功 95 个,最终 198 个项目合并。第四步·优化:剖析任务测量心跳与 elaboration 时间,产出如 PR 339 删 54,965 行的库级压缩与多项项目级提速。第五步·发布:文档流水线缓存项目图导出,Zulip 带归属公告。
技术新颖性
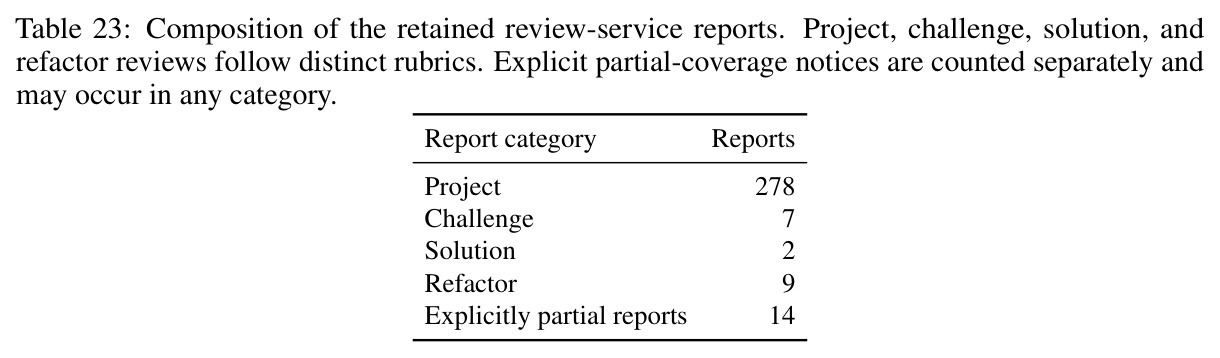
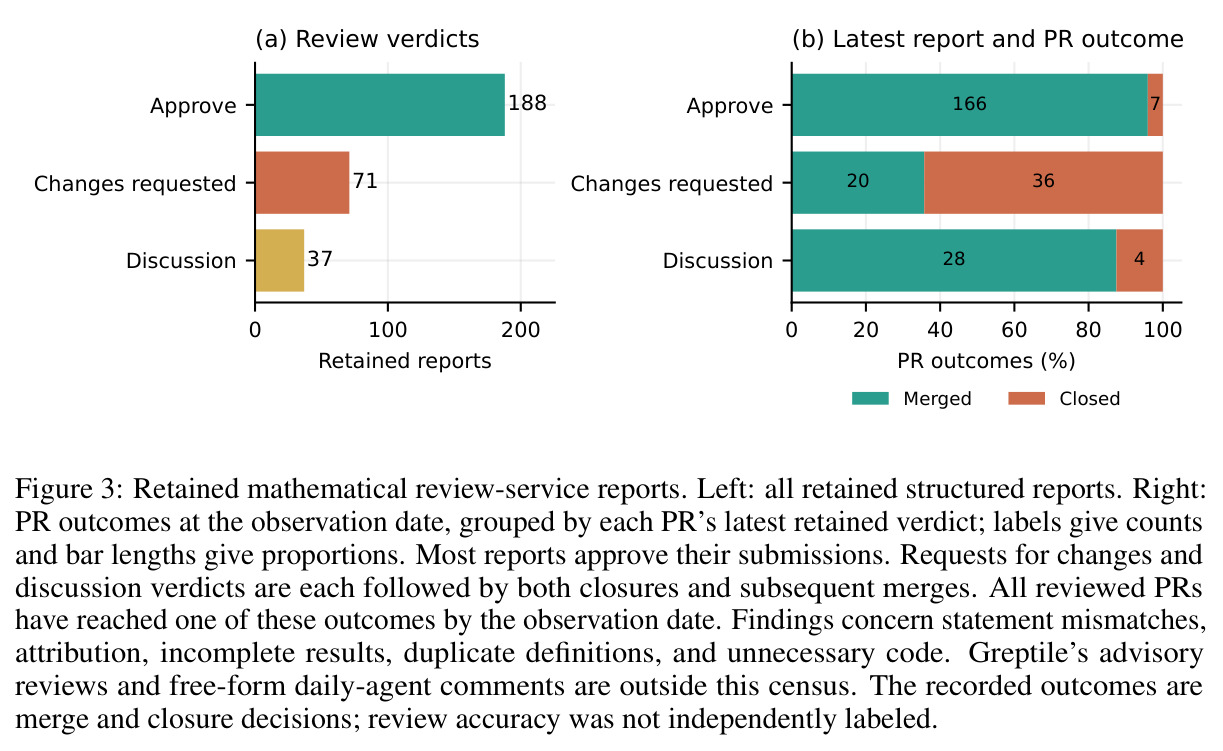
其一,这是首个把「AI 维护大型数学代码库」本身当作可测量对象的系统:论文记录了六次版本升级的重放与生产日志、97 个修复任务成功 95 个、五对优化 PR 在同一台 Azure VM 上的整库干净构建对照(固定依赖、输入预热、比例驻留内存采样),并用第三方 LeanEval 审计交叉验证档案确实被复用。以运营数据说话的写法在形式化数学社区没有先例。其二,LLM 数学评审被工程化为带结构化结论、价格记录与覆盖清单(manifest)的服务:296 份保留报告(188 份 approve、71 份要求修改、37 份讨论),API 阶段中位成本仅 0.20 美元/份,这是对「LLM 能否当数学审稿人」的一次规模化实战检验。其三,论文自身就是实验:人类只写 1 页,其余包括数据收集、分析实现、图表生成与文献综述几乎全部由 AI 完成,作者对稿件负责,并声明所有数字来自保留记录、验证流程会检查源哈希并重算每张表。它把形式化数学从「库工程」(Mathlib 模式)推进到了「档案生态工程」。
实验结果
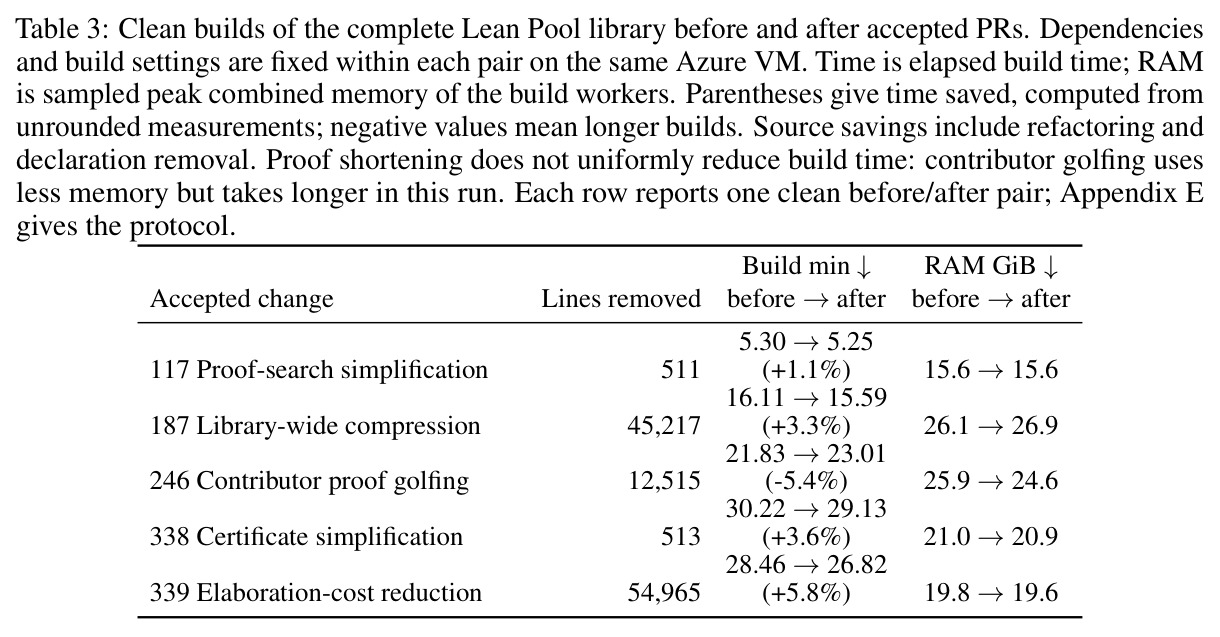
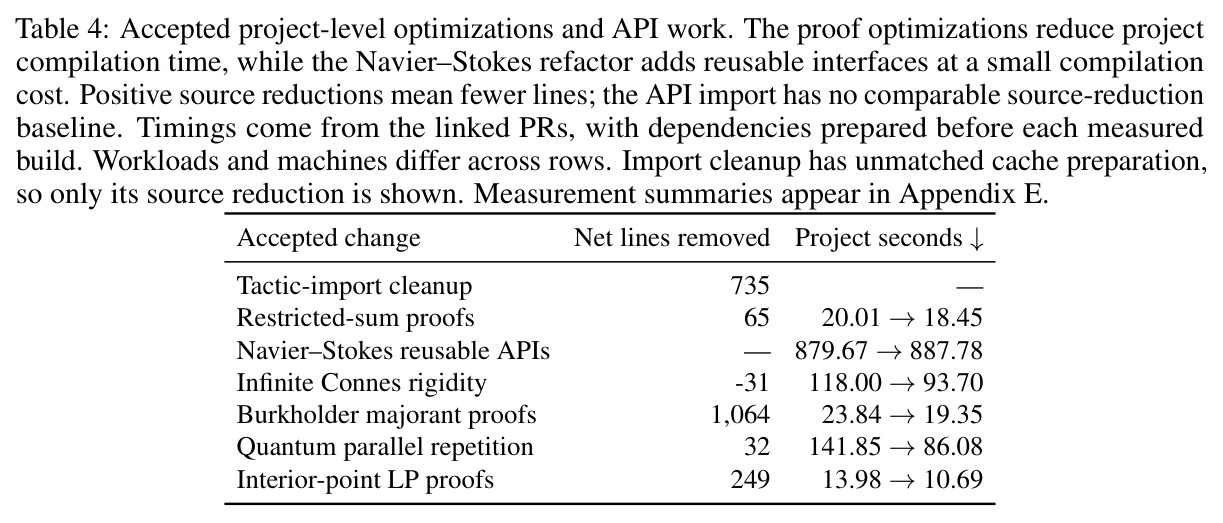
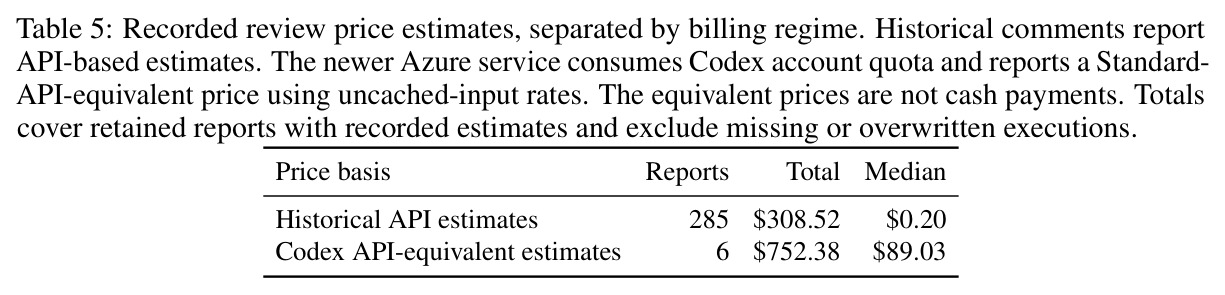
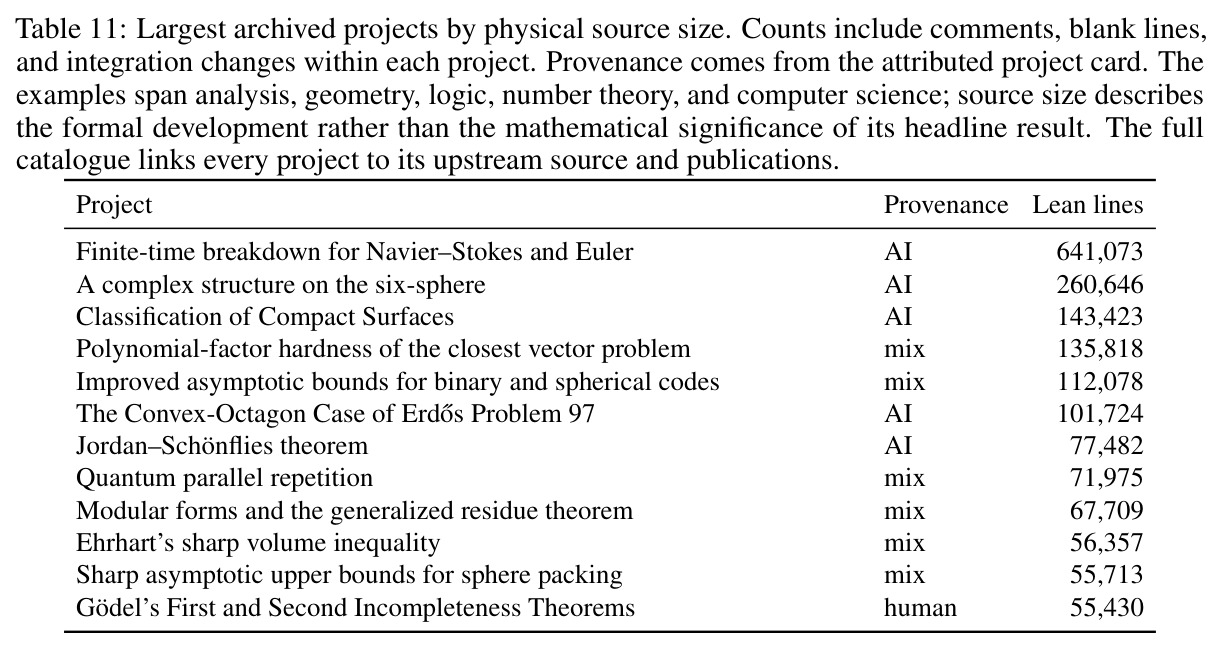
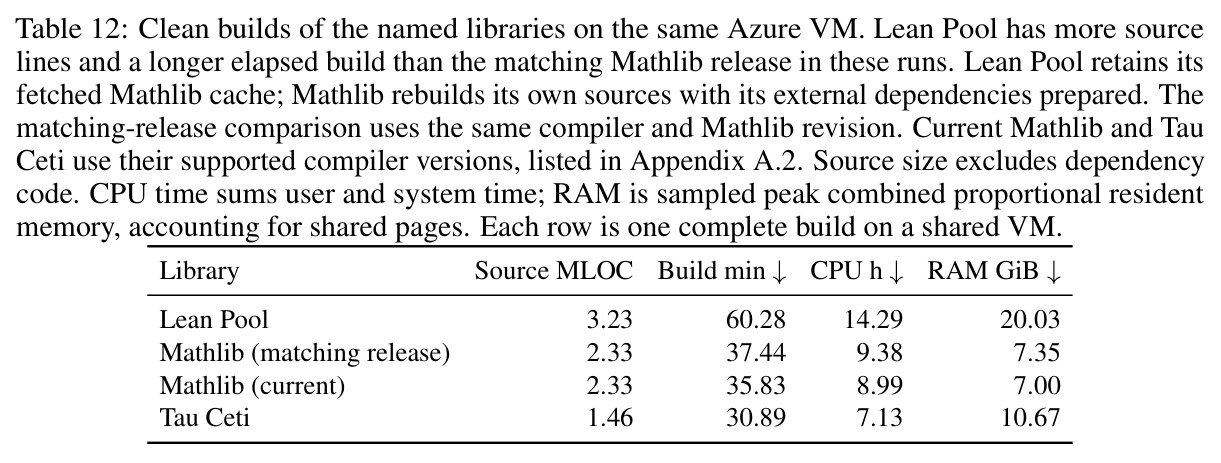
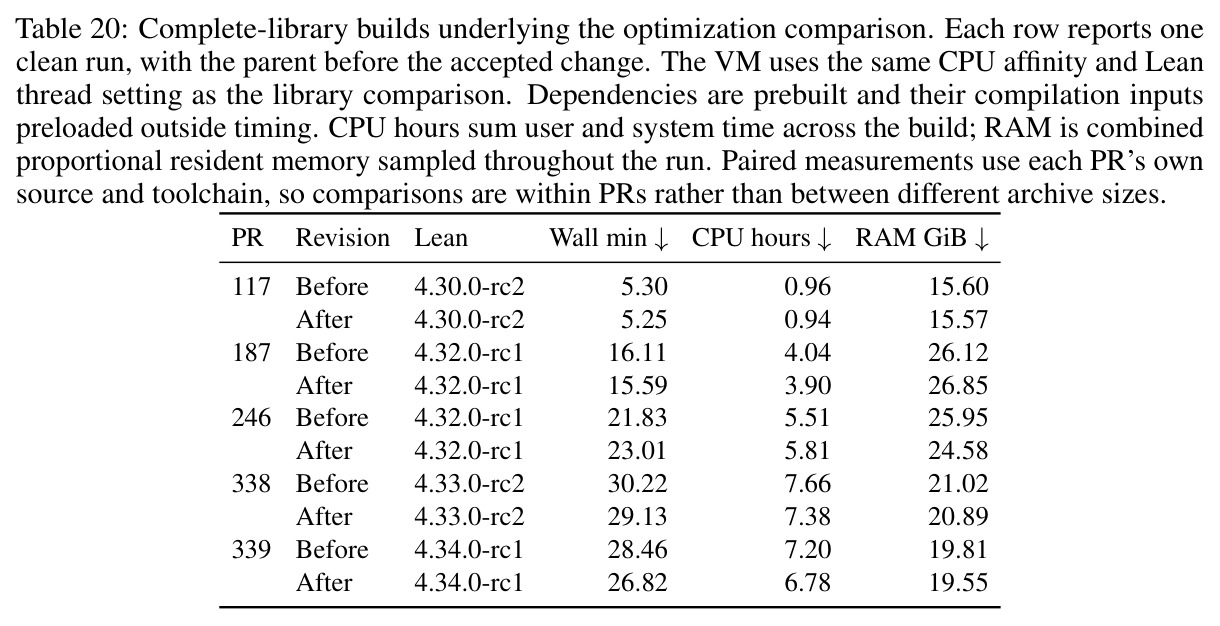
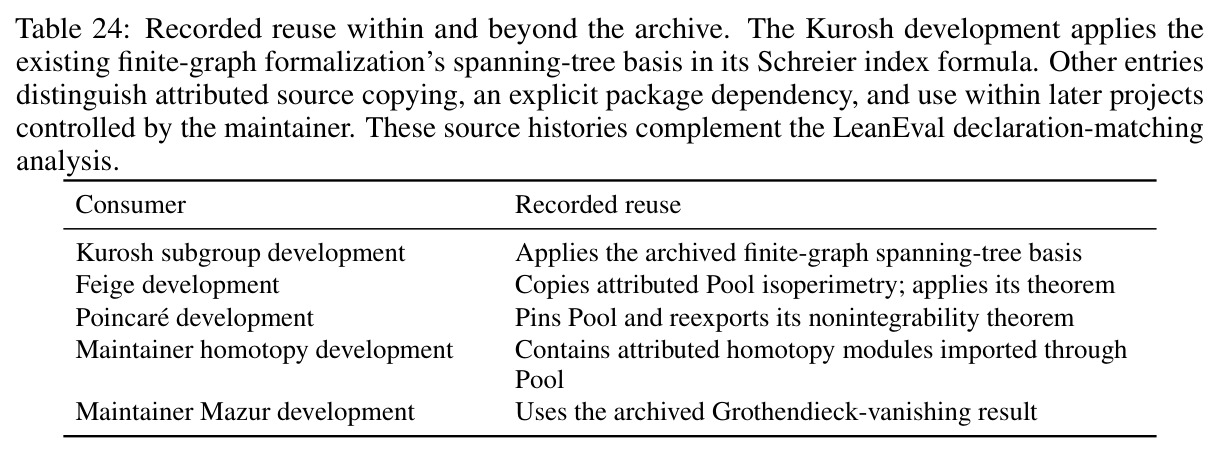
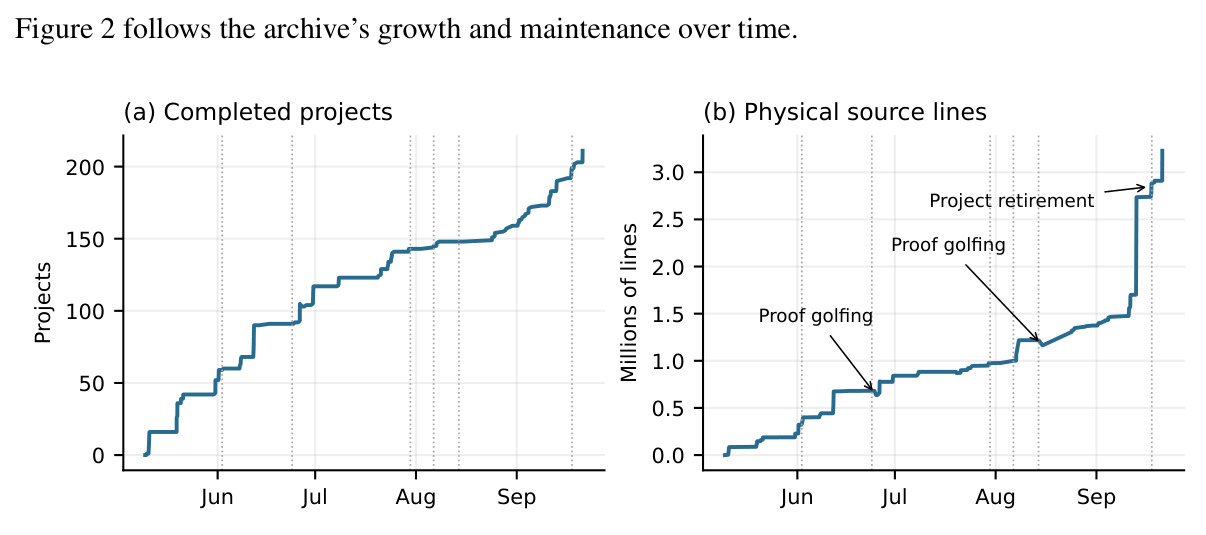
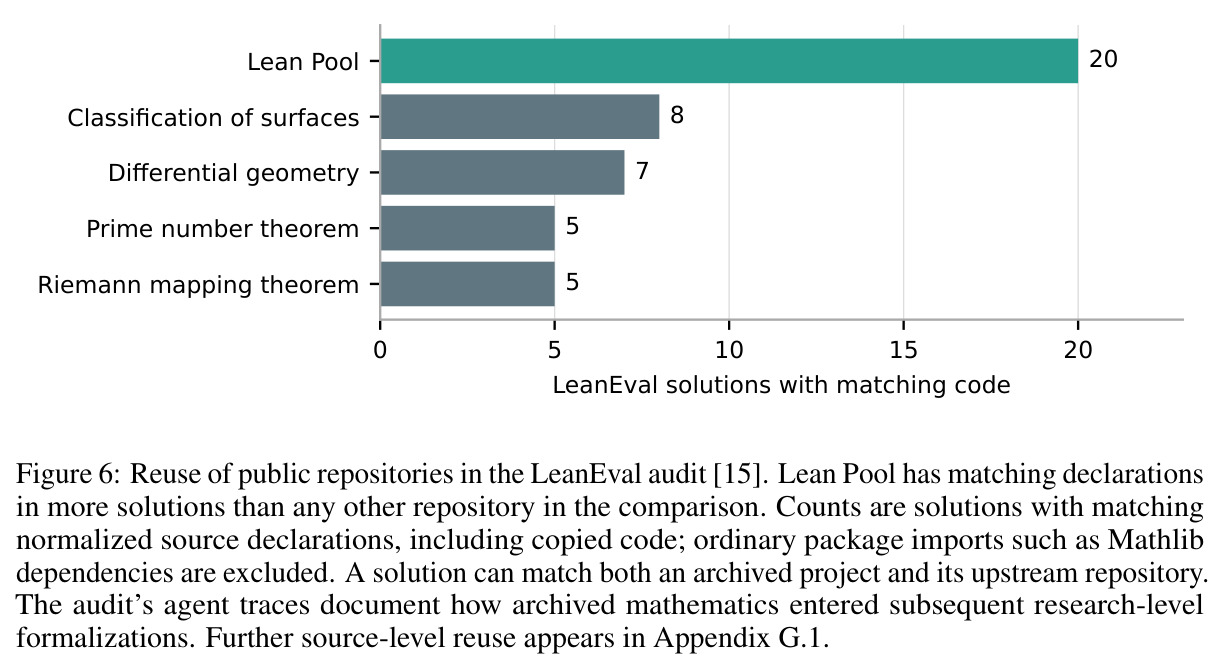
规模:截至 2026-09-21,Lean Pool 有 211 个完成项目、3,228,485 行 Lean 代码、193,862 个声明、837 个注册主结果;人类/AI/混合项目为 70/102/39,AI 参与已过半。维护:六次升级(4.30.0-rc2→4.34.0)的编译失败率在约 2%–75% 间波动;稳定版迁移 97 个修复任务成功 95 个,最终 198 个项目整库合并。优化:PR 187 库级压缩删 45,217 行、整库 16.11→15.59 分钟;PR 339 删 54,965 行、28.46→26.82 分钟($-5.8\%$);而 PR 246 golfing 删 12,515 行编译反而变慢——更短不等于更快;项目级最优为量子并行重复 141.85→86.08 秒(约 $-39\%$)。构建:整库 3.23 MLOC 需 60.28 分钟、20.03 GiB(Mathlib 2.33 MLOC 需 37.44 分钟、7.35 GiB)。评审:296 份报告,188 approve/71 要求修改/37 讨论,approve 的 PR 几乎全部合并(166/7);285 份 API 报告共 $308.52、中位 $0.20/份。复用:LeanEval 第三方审计中 Lean Pool 以 20 个解匹配代码居所有外部仓库之首(第二名仅 8)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 整库干净构建(与同类库同硬件对比) | 编译时间 / 峰值内存 | Lean Pool(3.23 MLOC):60.28 分钟 / 20.03 GiB | Mathlib 匹配版本(2.33 MLOC):37.44 分钟 / 7.35 GiB | 源码规模 +39% 的情况下时间 +61%、内存 +173%,量化了「多项目联邦」相对「统一库」的编译开销 |
| 依赖升级自动修复(稳定版迁移) | 修复任务成功率 | 95/97(97.9%),整库 198 个项目成功合并 | 无自动化基线;Mathlib 模式依赖人工志愿者逐项修复 | 639 个文件、5,951 行改动完成整库跨版本迁移,2 个失败项由后续集成修复 |
| 库级代码压缩 | 删除源码行数 / 整库编译时间 | PR 339:删 54,965 行,28.46→26.82 分钟($-5.8\%$);PR 187:删 45,217 行,$-3.3\%$ | 各自改动前的整库干净构建(同机、依赖固定) | 但 PR 246 golfing 删 12,515 行编译反而 $+5.4\%$,证明「更短」与「更快」并不等价 |
| 项目级编译优化 | 单项目编译时间 | 量子并行重复 141.85→86.08 秒;Connes 刚性 118.00→93.70 秒;内点 LP 13.98→10.69 秒 | 各项目优化前的干净构建 | 最高约 $-39\%$;反例是 Navier–Stokes 可复用接口重构使编译 879.67→887.78 秒,展示接口化的代价 |
| 档案被后续研究复用(LeanEval 第三方审计) | 源码声明匹配的解题数 | Lean Pool:20 个解 | 其他公开仓库最高 8 个(紧曲面分类) | 2.5 倍于第二名,是被复用最多的外部仓库,直接支撑「活档案」的核心主张 |
| LLM 数学评审成本 | 单份报告价格(中位) | 历史 API 阶段 $0.20(285 份共 $308.52) | 新 Azure 服务的 Codex API 等效估价中位 $89.03(6 份共 $752.38) | 两种计价相差约 445 倍,提示真实运营成本可能远高于历史 API 估计,关乎可持续性 |
局限与改进
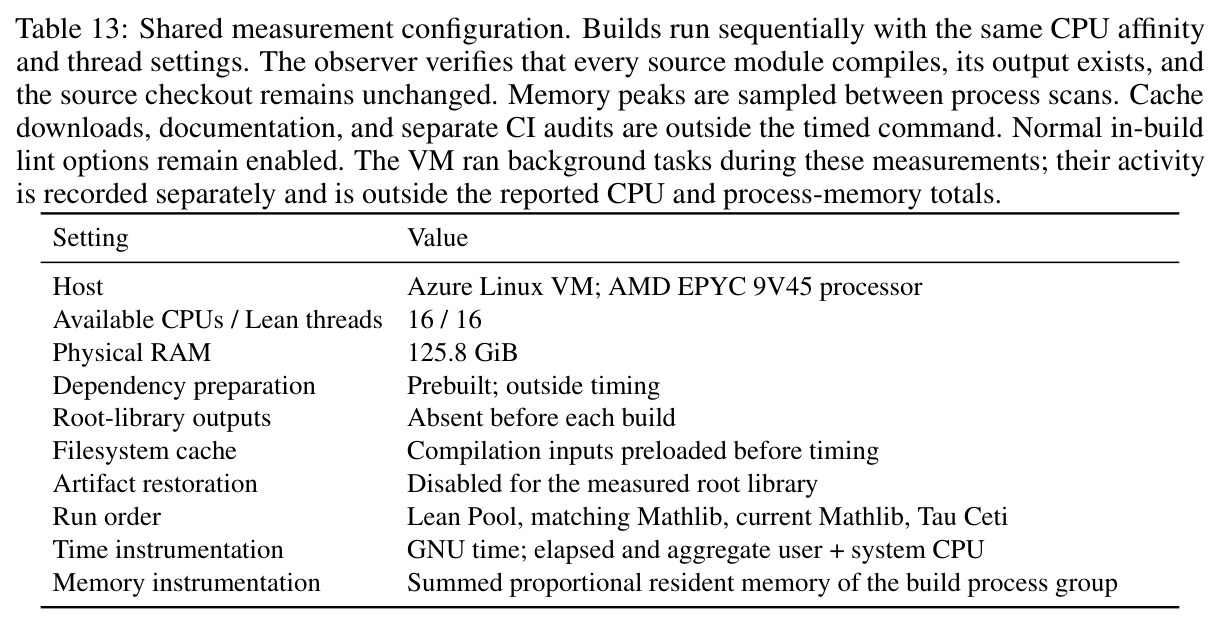
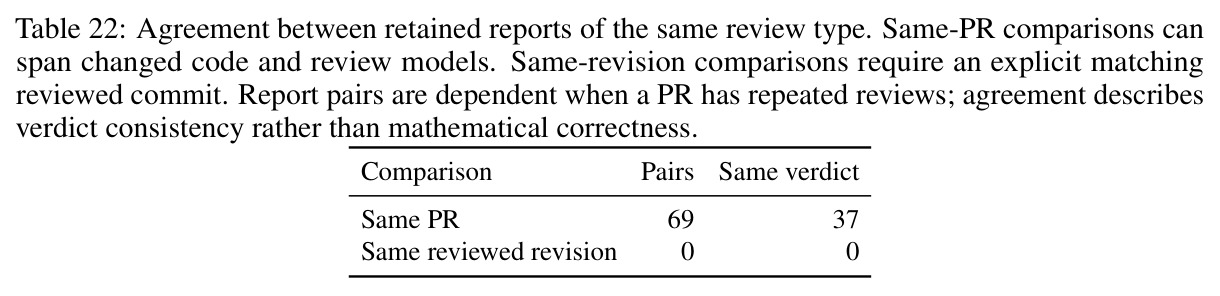
作者明确承认的局限:数学评审的准确性从未被独立标注——论文只有 merge/close 结果,无法判断 LLM 评审的假阳/假阴率;同一 PR 的重复评审 69 对中仅 37 对结论一致(约 54%),且评审服务在观察日之前已被手动暂停,最近一批导入未被覆盖;稳定版迁移「成功构建只确立接受下来的陈述可编译,不确立升级前每个声明类型等价」,即修复可能静默改变语义(迁移 PR 确实加强了可测性、sigma-有限性与极大性等辅助假设);价格是等效估计而非发票,被覆盖的执行记录无法恢复;构建测量在共享 Azure VM 上进行,后台任务虽被排除在统计外仍可能引入噪声。我自己的观察:整库构建成本相对 Mathlib 明显偏高(60.28 对 37.44 分钟、内存 20.03 对 7.35 GiB),若项目数继续增长,统一环境的可扩展性会成为硬瓶颈;复用证据中「匹配代码」包含复制而非 import,证据强度有限;GitHub 账号无法度量人与 agent 的劳动分工;837 个主结果缺乏重要性分级,档案存在被低价值结果稀释的风险。
独立分析的弱点
独立分析四点弱点。其一,「可编译」不等于「忠实」:LLM 评审只检查陈述与所宣传数学的对应关系,缺乏对抗性验证,一旦漏掉细微的假设削弱(如把 $\sigma$-有限性悄悄弱化),后续复用者会直接踩坑——可引入多评审员投票加反例生成智能体做交叉质询,并把假设 diff 纳入 CI。其二,修复智能体可能通过「加强辅助假设」让编译通过:稳定版迁移的 PR 记录里确实出现了加强可测性、sigma-有限性与极大性假设的改动,这会静默降低定理的可用范围——应在升级时对每个声明做升级前后类型与假设的结构化 diff,任何弱化都要求人工确认。其三,经济可持续性存疑:评审成本从历史 API 中位 $0.20 涨到 Codex 等效中位 $89.03(约 445 倍),按 6 份 $752.38 的速率外推,年化成本会迅速超过志愿者人时成本——需要分级评审通道(低风险改动走廉价抽检)。其四,治理过度集中:自动化仓库、维护者账号与评审服务都围绕单一维护者运转,社区贡献最多的个人也只有 13 个合并 PR,系统的长期韧性未经检验——可借鉴 Mathlib 的多维护者签名与轮值机制。
未来方向
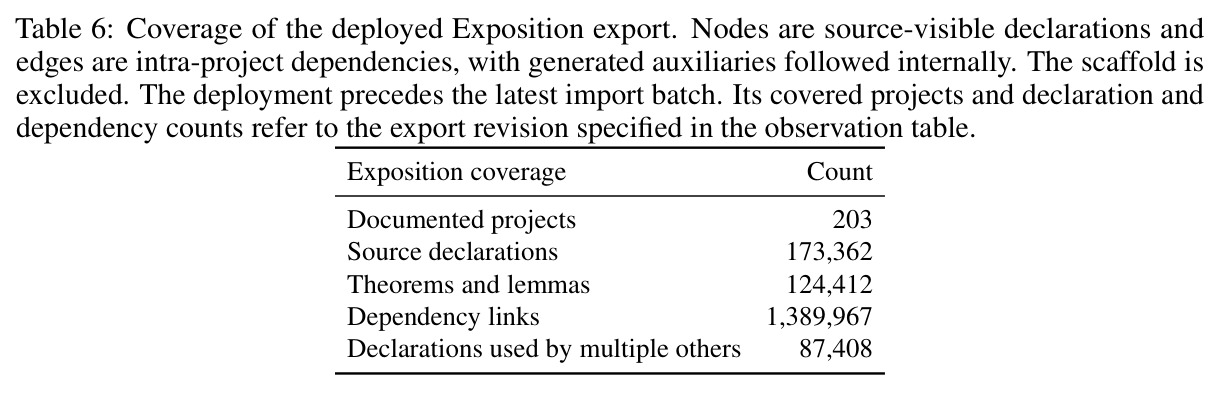
作者提出的愿景:随着形式化变容易、新数学结果一发表即被形式化,Lean Pool 将成为 arXiv 的形式对应物——低摩擦发布、保留归属、形式依赖图镜像文献引用图。基于本文成果可自然延伸的方向:(1)把「论文→Lean」自动形式化管道接到收录入口,形成 AI 生成+AI 收录的闭环(OpenAI 的 Navier–Stokes 工作已展示前半段);(2)利用 Exposition 已导出的约 139 万条依赖边训练或约束证明搜索,让跨项目复用从「人找定理」变成「agent 主动推荐引理」;(3)从 Pool 中提炼可反哺 Mathlib 的通用 API——Navier–Stokes 重构已开始添加可复用接口,但付出了 879.67→887.78 秒的编译代价,接口化与编译成本的权衡值得系统研究;(4)把升级时的「声明类型等价」验证自动化,让语义保持成为机器检查项而非人工审阅项;(5)与 Tau Ceti、Palomar、Mathlib 建立互操作与去重标准,避免四大仓库重复形式化同一结果;(6)对 837 个主结果建立引用与影响力追踪,给档案加一层「重要性」索引。
复现评估
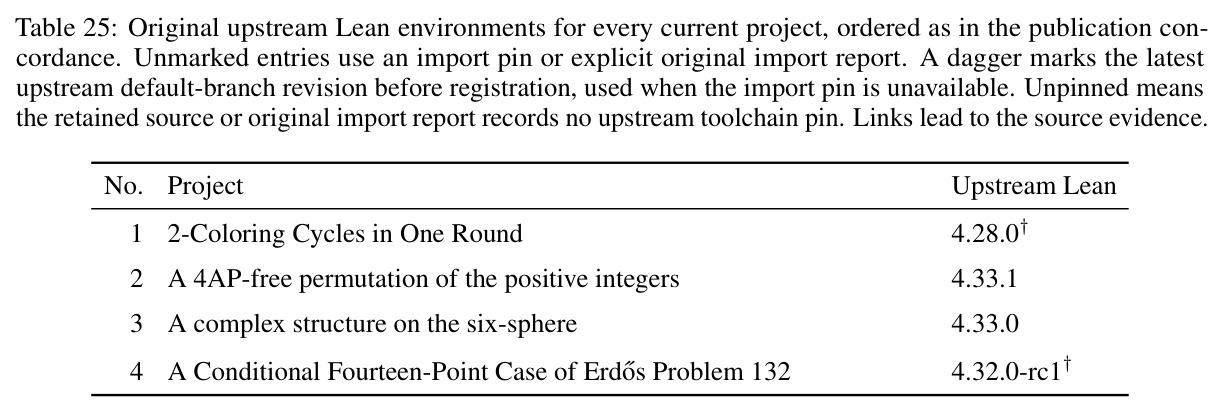
开源情况很好:档案仓库、索引站、Exposition 站点、Zulip 公告频道全部公开;附录 A 逐项定义了每个证据的观察日期与测量总体,附录 H/I 给出全部 211 个项目的上游 Lean 版本与出版物对照表;原始记录与分析程序单独保留,验证流程会检查源哈希并重算所有表格与图。复现门槛主要在算力与账号:整库干净构建需要 16 核、约 125.8 GiB 内存的 Azure VM(Lean Pool 需 60.28 分钟、14.29 CPU 小时),五对优化对比各需一次固定依赖的干净构建;LLM 评审走 Codex 账号配额,成本与行为难以精确复现,且部分历史执行记录已被覆盖;评审服务当前处于手动暂停状态,无法现场观察。总体评估:克隆档案并验证「能编译」很容易(公开仓库直接 lake build 即可);复现论文运营数字中等偏难,需要解析公开 PR 记录与保留报告;从零把六个每日任务加升级流水线整套跑起来最难,因为提示词与 runner 虽开源但强依赖具体模型的行为稳定性。
论文图表
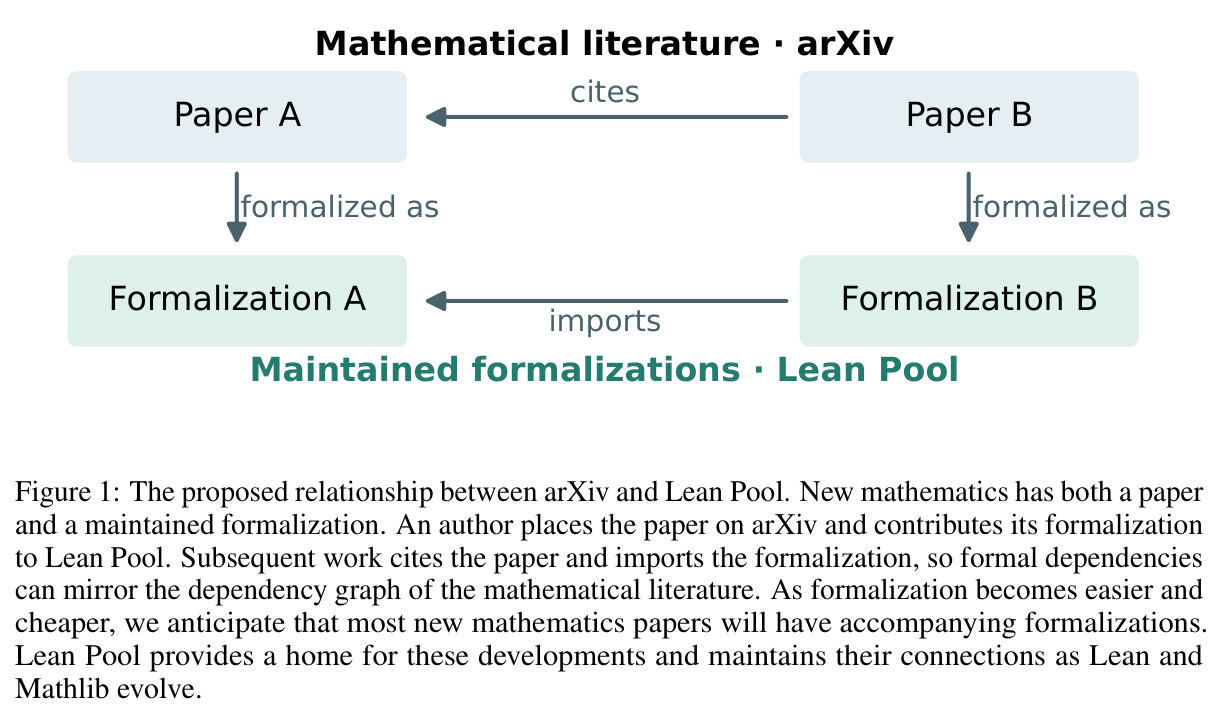
示意图:论文 A、B 发表在 arXiv 并互相引用,其形式化 A、B 汇入 Lean Pool 并互相 import,使形式依赖图镜像数学文献的引用图;作者把论文放上 arXiv 的同时把形式化贡献给 Lean Pool。
这是全文的愿景图,一图道出 Lean Pool 的定位——形式化世界的 arXiv,也是理解「为什么要维护项目间连接」的钥匙。
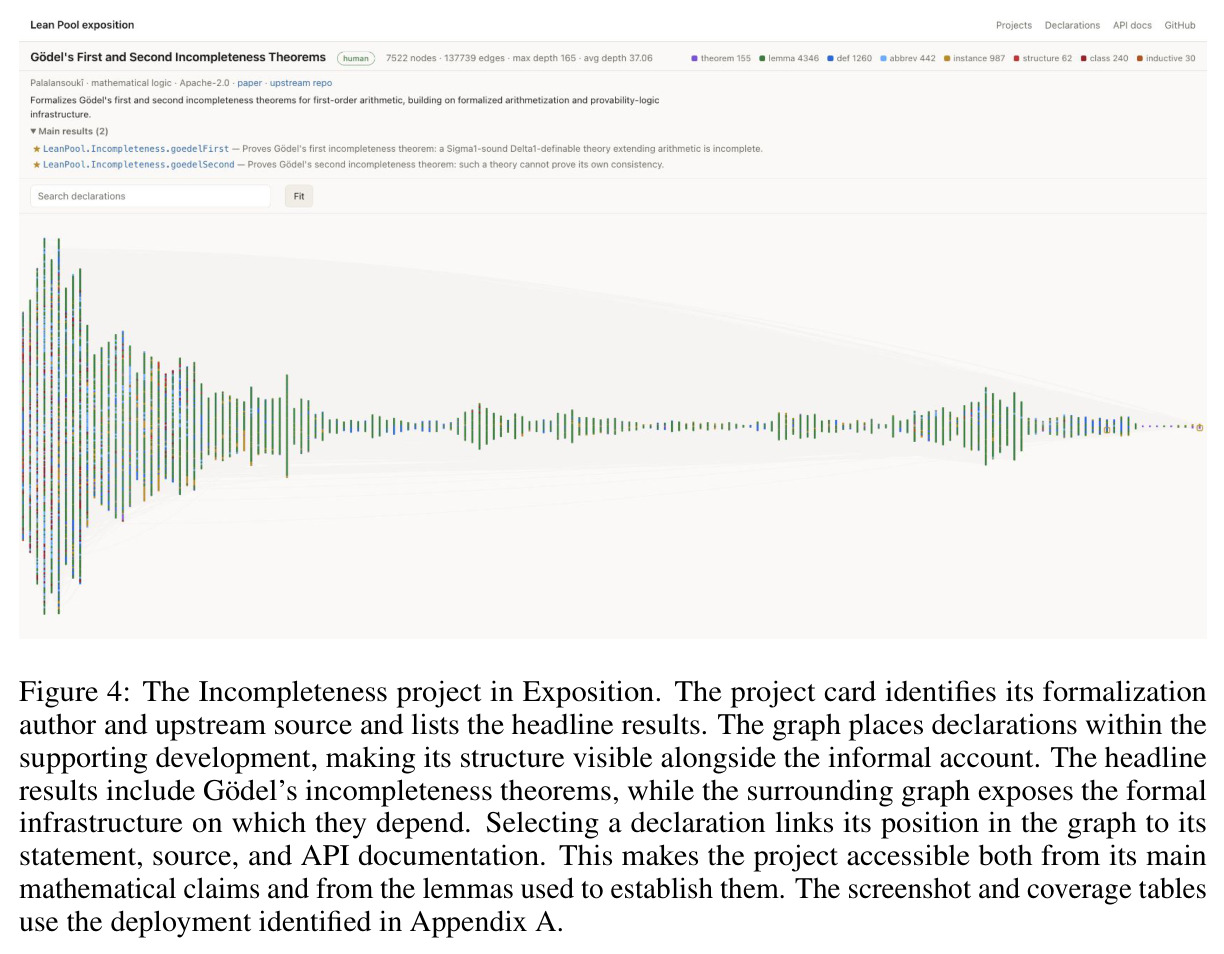
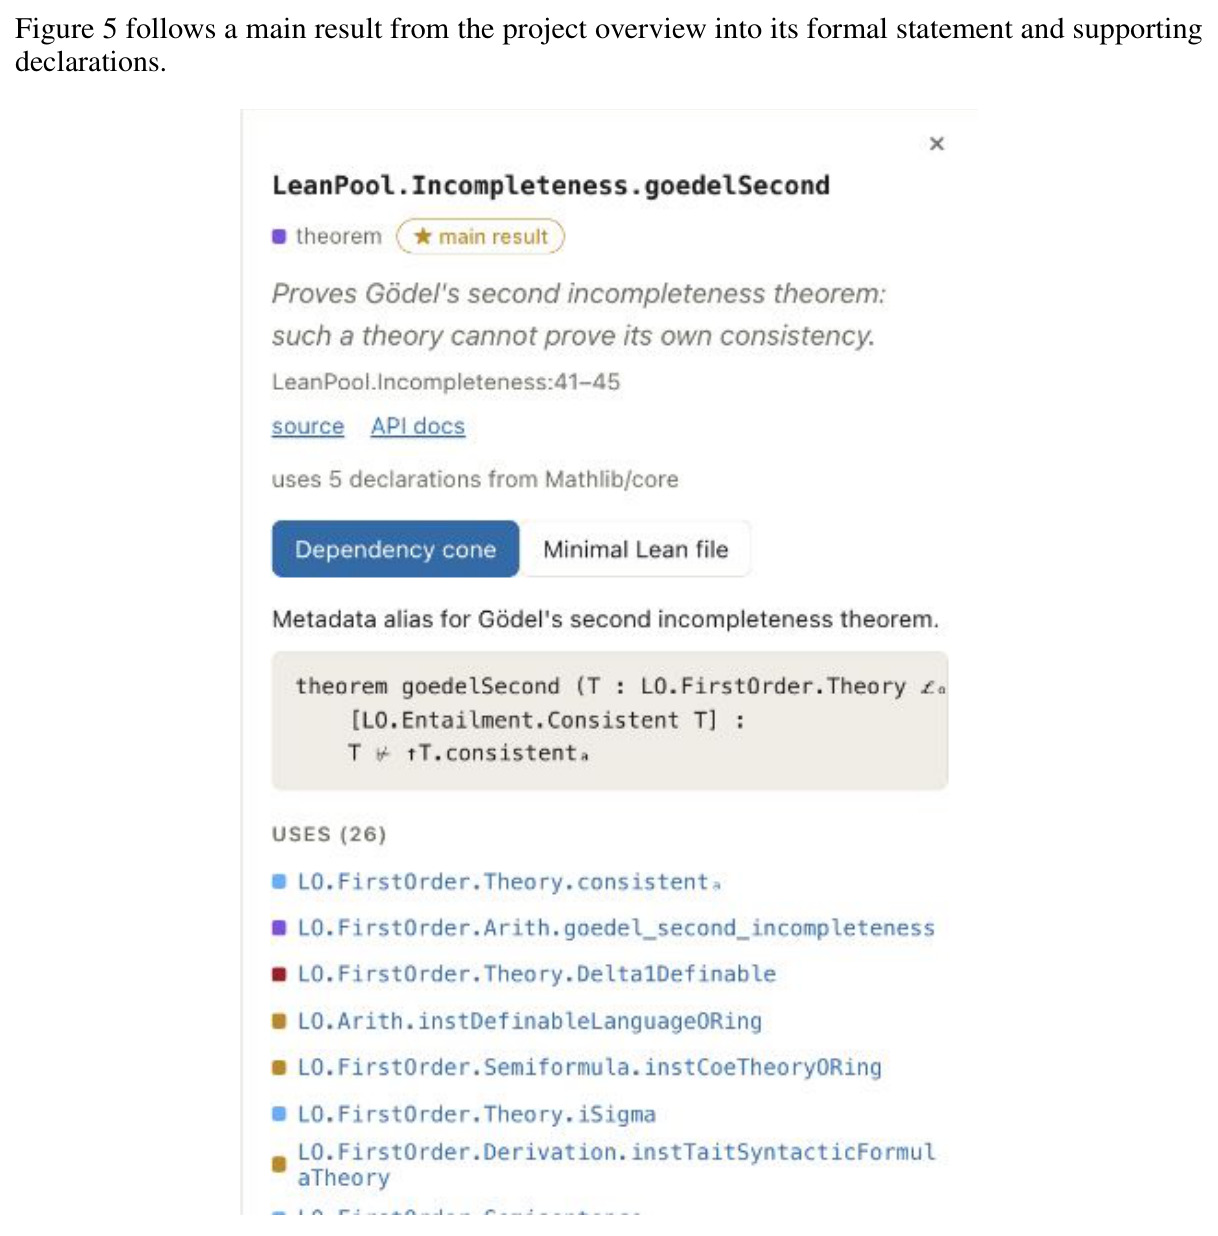
档案普查:211 个完成项目、7,043 个源文件、3,228,485 物理源码行、193,862 个声明命令、837 个注册主结果、人类/AI/混合项目 70/102/39、18 位提交贡献者、63 个社区 PR 被合并。
全库规模与人类/AI 构成的基准数据,「AI 项目过半」是本文最醒目的事实。
六次升级的探测结果:59 个项目中 44 个失败、91/58、143/100、145/19、148/3、191/97,失败率在约 2%–75% 之间波动。
量化依赖演化对档案的破坏力,也是修复智能体工作量的直接度量。
逐项给出所有证据的观测时间戳:源码普查 2026-09-21 06:07 UTC、评审报告截至 9-13、Exposition 导出 9-20、LeanEval 分析 9-12、构建测量 9-21 等。
档案持续变化,所有数字必须锚定到观测时刻才有意义,这是解读全文数据的前提。