LeanPRM:基于 Lean 验证的自然语言证明过程监督 LeanPRM: Lean-Grounded Process Supervision for Natural Language Proof Verification
用Lean为自然语言证明逐步自动标注,训练出胜过人工标注PRM800K的证明验证器
前置知识
过程奖励模型(PRM)
PRM 是对推理过程逐步打分的模型:给定题目和分步解答,为每一步输出“正确/错误”标签并给出整体判定;与之相对的结果奖励模型(ORM)只看最终答案。PRM 通常用人工步骤标注或蒙特卡洛 rollout 估计每步成功率来训练,是 best-of-N 搜索与过程监督 RL 的核心组件。
本文解决的核心问题正是:在没有最终答案可查的开放证明场景下,如何低成本获得训练 PRM 所需的步骤级正确性标签。
Lean 与 Mathlib 形式化验证
Lean 4 是交互式定理证明器:证明写成一系列 tactic(如 intro、have、rw),编译器逐条做 elaboration 检查,任何一步不成立都会报错并定位到该行,因此“编译通过”是正确性的机械判据;Mathlib 是其社区数学库。逐步报错特性正是 LeanPRM 自动打标签的关键。
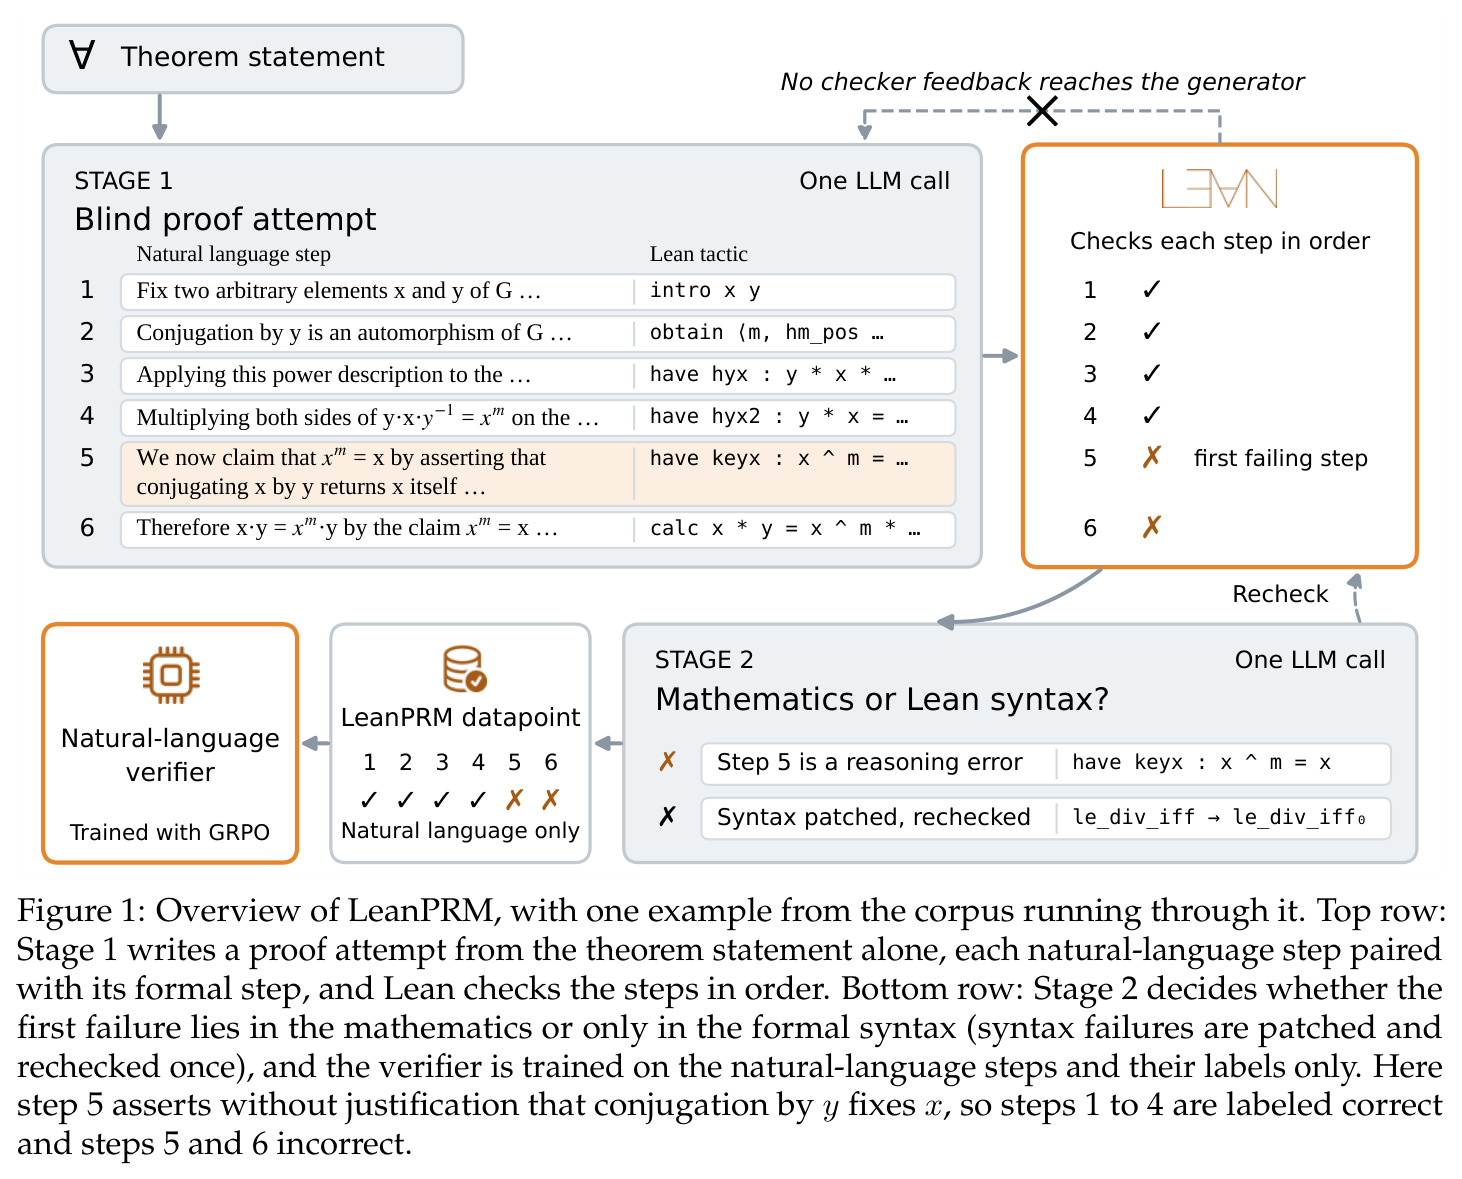
LeanPRM 用 Lean 充当免费标注员:每个自然语言步骤绑定一条 tactic,编译错误即可精确指出首个出错的数学步骤。
PRM800K 与过程监督数据
Lightman 等人(OpenAI, 2023)发布的大规模人工标注数据集:约 8 万道 MATH 题、约 80 万个步骤级正确性标签,用于训练“Let's Verify Step by Step”中的过程奖励模型。它是过程监督的标杆数据,但标注成本极高,且只覆盖带最终答案的竞赛题解答。
论文把“同配方下用 PRM800K 训练的验证器”作为核心基线,用来量化 Lean 自动标注相对人工标注的优劣。
GRPO(组相对策略优化)
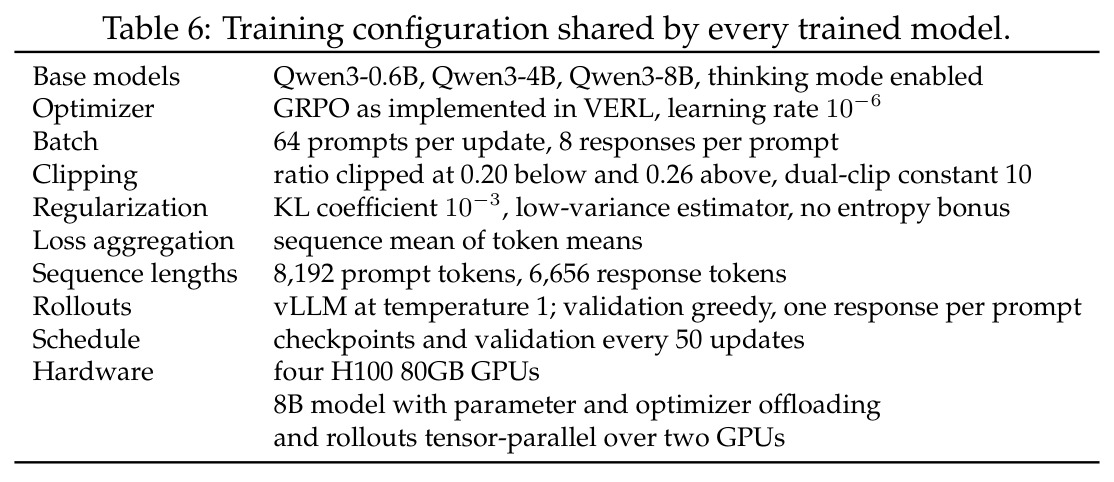
DeepSeek 提出的类 PPO 强化学习算法:对同一提示采样一组响应(本文 8 个),用组内奖励归一化值作为每个 token 的优势,省去价值网络;配合 ratio 裁剪与 KL 惩罚(系数 $10^{-3}$)稳定训练。本文用 VERL 实现,在 4 张 H100 上训练 Qwen3。
实验的公平性建立在“所有被比较的验证器(含 PRM800K 基线)都用同一 GRPO 配方训练 500 步”之上。
best-of-N 选择
让生成模型对同一问题独立采样 N 个候选解答,再用一个验证器从中挑出它接受的一个,以“验证器搜索”换取“生成器能力”。这是推理时最常用的扩展手段,其收益完全取决于验证器区分对错的能力——验证器接近随机时该方法失效。
论文用 IMO-GradingBench 上的 best-of-N 检验标注质量的实际价值:LeanPRM 验证器 N=16 时选中率 35.9%(随机 32.4%),PRM800K 基线几乎贴着随机线。
研究动机
AI 系统已能写出很长很难的数学证明——从长期未决问题的解答到费马大定理的完整机器校验证明——而逐步核对它们的正确性正成为新瓶颈。训练一个能廉价检查证明的学习型验证器,需要每一步的正确性标签,但开放证明恰恰缺这种标签:人工标注昂贵,PRM800K 仅为短解答就投入了约 80 万个步骤标注,判定证明显然更难;从最终答案自动导出步骤标签的方法(如 Math-Shepherd 用 rollout 成功率估计步骤质量)在“没有最终答案可查”的证明上完全失效;而把每条非形式证明手工形式化到 Lean 又需要专家级投入。其后果是:AI 生成的证明对非专家几乎无法评估,训练下一代数学系统的可靠过程监督信号极度稀缺。
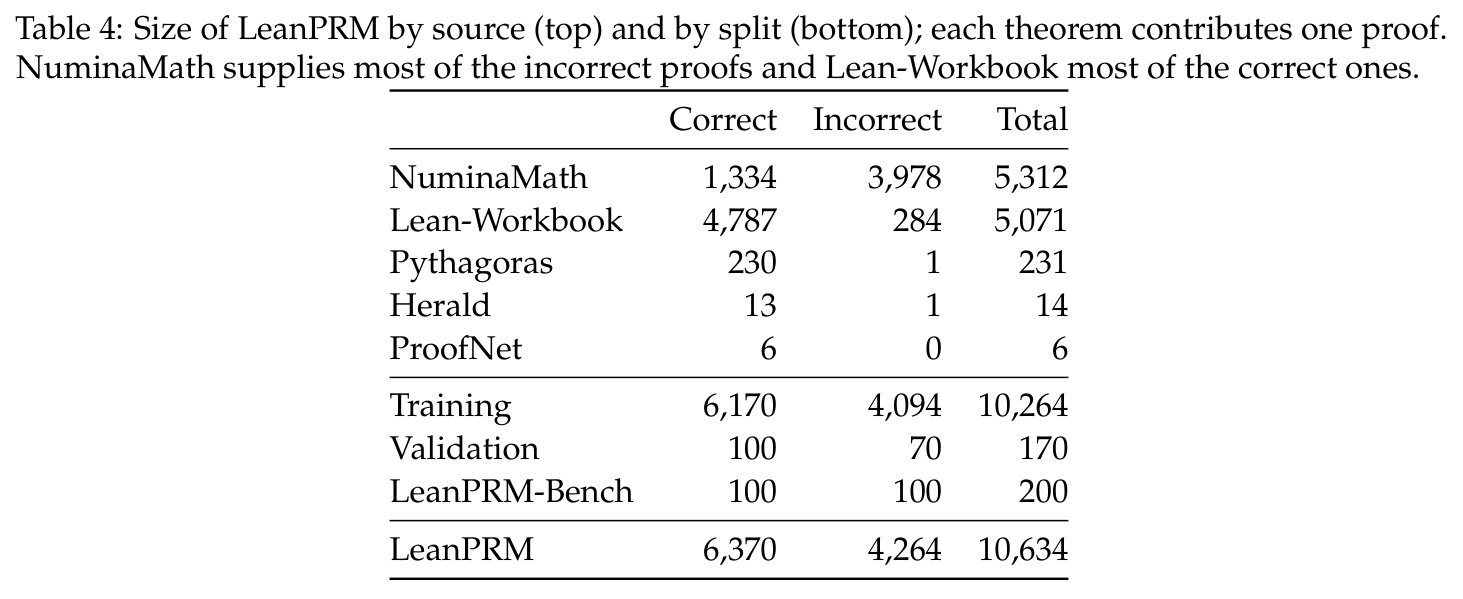
本文的目标是本文的目标是构建一条完全无人工标注的流水线:利用 Lean 证明助手这一精确的机械检查器,为自然语言证明的每一步自动生成正确性标签,产出包含 10,634 条证明、152,005 个步骤标签的语料;同时发布留出基准 LeanPRM-Bench(200 条带步骤标签与错误类别的证明)。在此基础上做严格受控的验证:同一基座模型、同一训练配方、同一算力预算(500 步更新)下,用 LeanPRM 训练的验证器能否超过用 PRM800K 人工标签训练的验证器,能否在 IMO 级问题的 best-of-N 中真正选出更好的证明,以及收益是否在 0.6B 到 8B 的各参数规模上稳健成立。
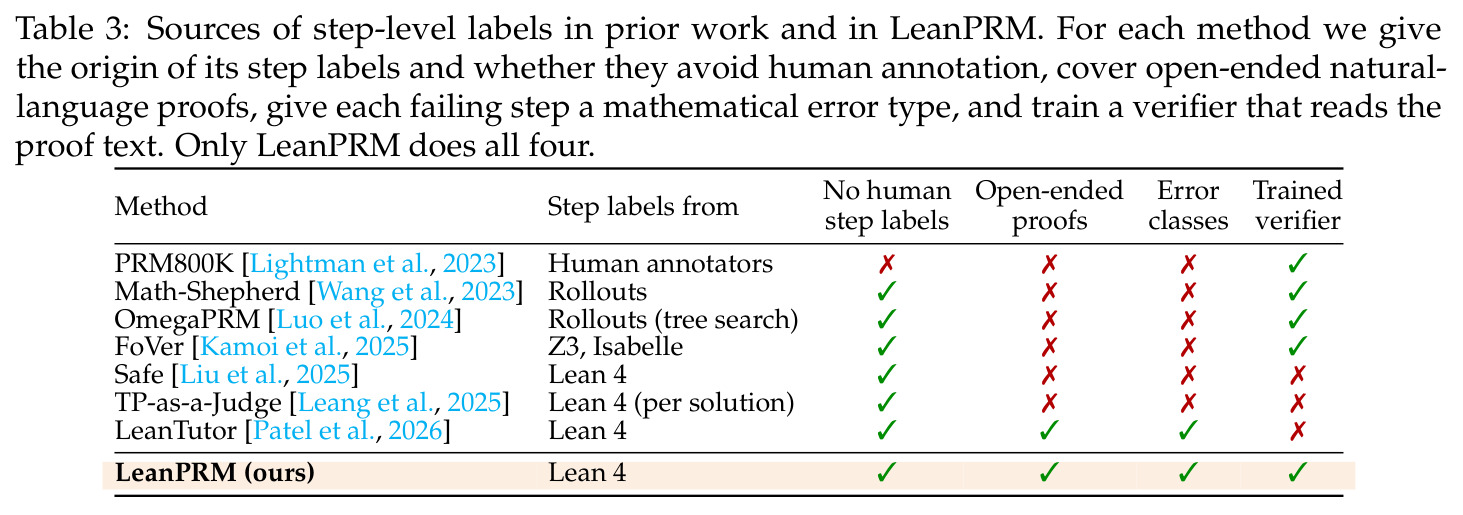
与已有工作不同的是,已有工作的标签来源各有缺口:PRM800K 依赖人力;Math-Shepherd、OmegaPRM 从 rollout 统计导出标签,要求存在可查的最终答案;FoVer 用 Z3/Isabelle 标注的是形式化推理轨迹而非开放自然语言证明;Safe 与 Theorem-Prover-as-a-Judge 用 Lean 4 做推理时检查或数据筛选,但不训练验证器;LeanTutor 逐步检查学生证明却不把标签用于训练。本文的独特切入是“Lean 只离线用一次”:让模型把自然语言步骤与 Lean tactic 一一配对地盲写证明——从不把编译反馈反馈给生成者,从而保留模型真实的错误;由于句子与 tactic 一一对应,编译错误天然定位到唯一一步;再用一次模型调用把失败分成“数学错误”与“纯语法错误”。无人工标注、开放证明、错误类别、训练验证器四个条件,此前没有任何方法同时满足。
核心方法
直觉上,LeanPRM 把 Lean 当成一次性的离线标注员:先让模型在得不到任何反馈的情况下“盲写”证明,再用 Lean 的逐行报错充当免费标签,最后训练出的验证器只读自然语言,部署时完全不需要 Lean。技术上分两阶段。阶段一(证明生成):从约 17,800 条定理陈述(NuminaMath-LEAN 的困难档、Lean-Workbook 等)出发,一次模型调用让模型同时写出编号的自然语言步骤和一一对应的 Lean tactic,且绝不把编译器输出反馈给生成模型——这样语料中的错误都是模型自发犯的,无需人为注入。阶段二(验证与错误分类):用 Lean 4 + Mathlib(v4.25.0-rc2)编译形式化证明,首个失败 tactic 之前的所有自然语言步骤标为正确,失败步及其后全部标为错误;再用一次模型调用读取报错信息,判定失败属于数学错误(赋予十类之一)还是纯语法错误(只许修补一次且修补后须编译通过),并剔除病态题目与文—形不一致的样本。
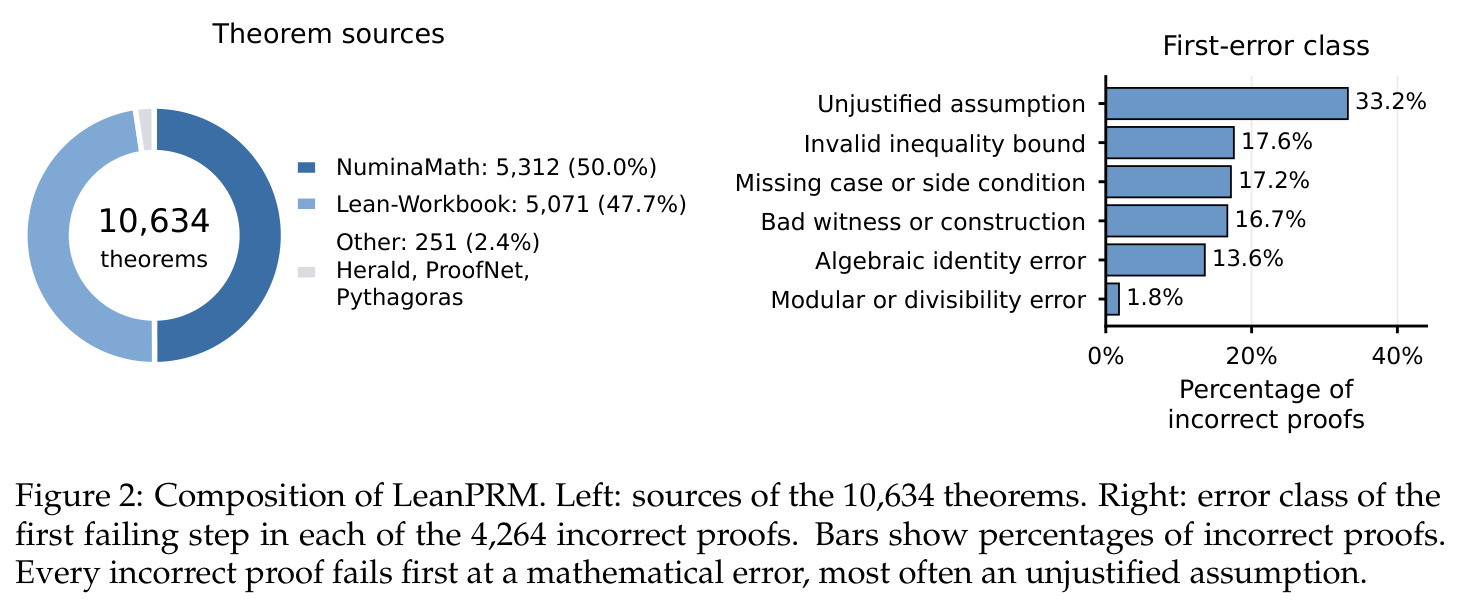
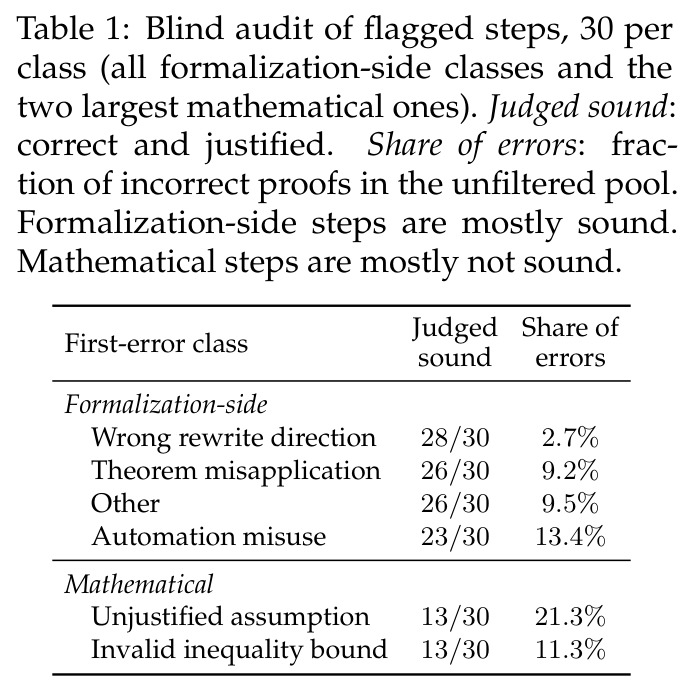
核心创新是把“形式化验证”与“自然语言监督”解耦:Lean 从不检查自然语言本身,也不在推理时参与,只在造数据时离线用一次。与已有方法的本质区别有三点。其一,盲生成:模型只看定理陈述、一次性写出 NL+tactic 配对证明,看不到编译反馈,因此错误是模型真实会犯的,不必提示它犯错。其二,步级定位:每个自然语言句子绑定一条 tactic,编译错误天然定位到唯一一步,绕开了“给自然语言步骤找形式化对应”这一传统难题。其三,错误类型分离:第二次模型调用把失败分成数学错误与形式化失败,双盲审计显示形式化侧类别的步骤 77%–93% 在数学上其实是对的,因此全部剔除,保证语料中每个负样本的首个错误都是真实数学错误(其中“未加论证的假设”占 33.2%)。训练出的验证器输入输出都只有自然语言。
方法步骤详情
流程分七步。①收集约 17,800 条定理陈述,主要来自 NuminaMath-LEAN 与 Lean-Workbook。②盲生成:Claude Sonnet 5(早期子集用 Opus 4.8)一次调用写出编号步骤,每句数学散文配一条 Lean tactic;禁止 sorry 等占位符,词法过滤确保自然语言不提及 Lean、tactic 等词。③用 Lean 4 + Mathlib(v4.25.0-rc2)编译形式证明,输出对生成者不可见;首个失败 tactic 之前的步骤标“正确”,失败步及其后全部标“错误”。④第二次也是最后一次模型调用读取题目、步骤与报错,返回四选一:correct(编译通过且描述忠实)、mathematical error(指认首错步并赋十类错误之一)、syntax repair(只许修语法一次且须编译通过)、discard(题目病态或文—形不一致)。⑤质量门控:13,940 条有标注,过滤去重后 13,007 条,按盲审剔除形式化侧首错样本后剩 10,634 条(6,370 对/4,264 错)。⑥按定理分组切分为训练 10,264、验证 170、基准 200。⑦训练:Qwen3 thinking 模式 + GRPO,每题采 8 个响应,奖励 $r = 0.7\,R_{\text{step}} + 0.3\,\mathbb{1}[\hat{v}=v]$,含错证明取 $R_{\text{step}} = R_c \cdot R_i$,500 步更新。
技术新颖性
技术新颖性体现在三点。第一,据作者所知,这是首个用 Lean 为自然语言证明大规模生成步骤级标签的框架:FoVer 标注的是形式化推理轨迹,Safe 与 TP-as-a-Judge 只在推理时用 Lean 打分而不训练验证器,LeanTutor 面向教学反馈不产出训练数据。第二,“无最终答案”场景的标签难题被结构性简化——不再需要蒙特卡洛 rollout 估计步骤价值,而是把证明问题转化为“配对形式化 + 编译定位”,标签来自独立于被监督模型的外部判定程序,正确性标准显式且可复现。第三,奖励设计上用 $R_c \cdot R_i$ 的乘积,在“首个错误后全为错”的标签约定下同时惩罚两种常数预测,比常见度量更简洁。此外,十类错误分类学(6 类数学错误 + 4 类形式化错误)与基于双盲审计的类别级剔除协议,为自动数据集构建提供了可复用的质量保证模板。
实验结果
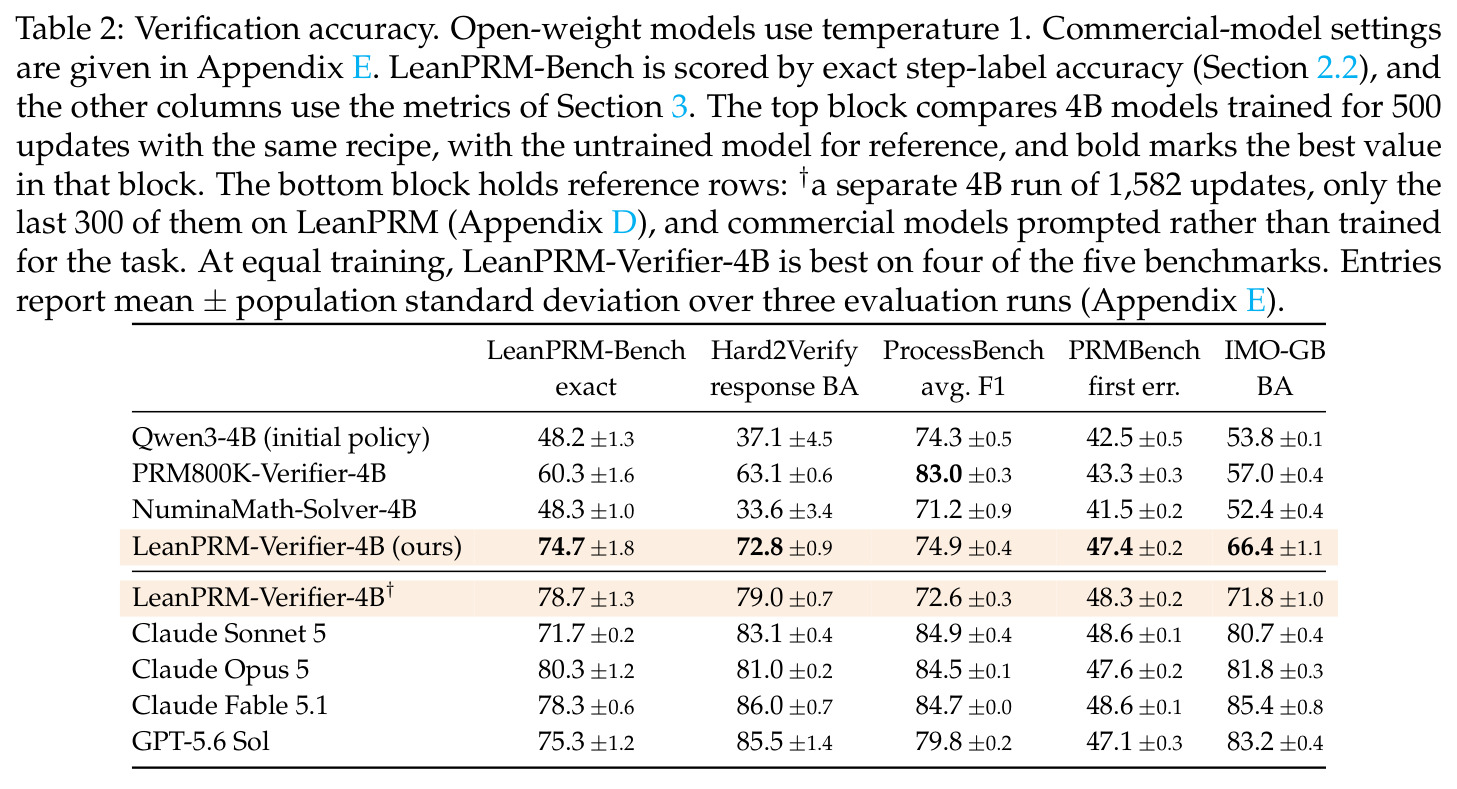
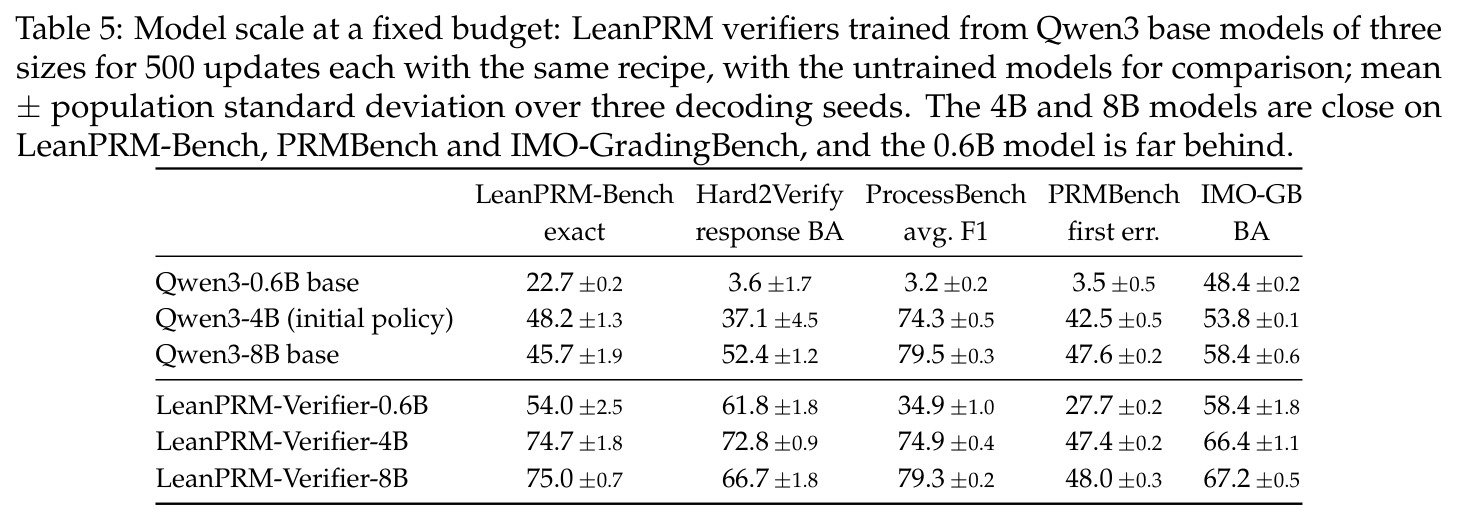
核心对比严格受控:同一 Qwen3-4B 基座、同一 GRPO 配方、同为 500 步更新,只换训练数据。① LeanPRM-Bench(精确步骤标签准确率):LeanPRM-Verifier-4B 达 74.7,PRM800K 版 60.3,未训练基座 48.2,领先 14.4 分;四个商用模型在 71.7–80.3 之间。② Hard2Verify:72.8 vs 63.1(+9.7)。③ PRMBench:47.4 vs 43.3(+4.1)。④ IMO-GradingBench:66.4 vs 57.0(+9.4)。⑤ 唯一落后的 ProcessBench:74.9 vs 83.0(−8.1),作者归因于标注约定不同且其短解答与 PRM800K 同分布。否定性发现同样重要:NuminaMath-Solver-4B 把自验证题的答题准确率从 30.0% 提到 47.5%,但验证指标与未训练模型几乎持平,说明解题 RL 不会自动产生验证器。测试时扩展:best-of-N 中 LeanPRM 在 N=16 选中正确证明 35.9%(随机 32.4%),PRM800K 版仅 33.2%——它接受了约 79% 的证明而实际只有 30% 正确。规模上,0.6B/4B/8B 训练后分别提升约 31/27/29 分,4B 与 8B 几乎持平。
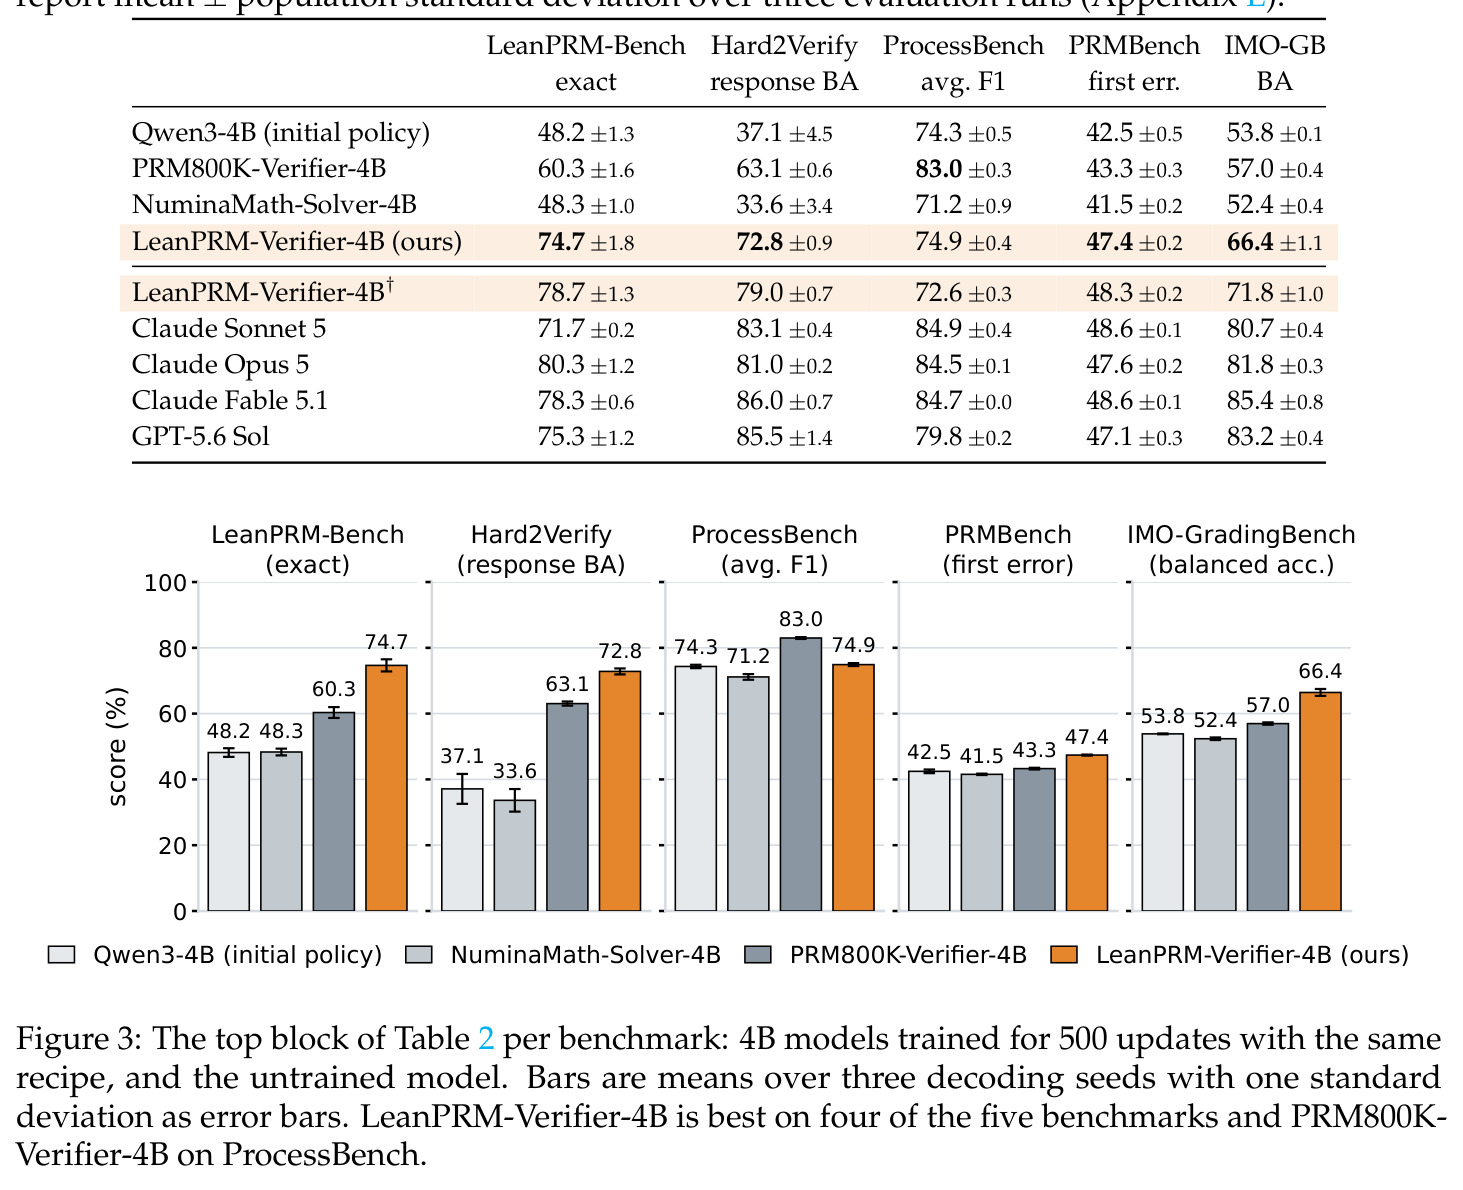
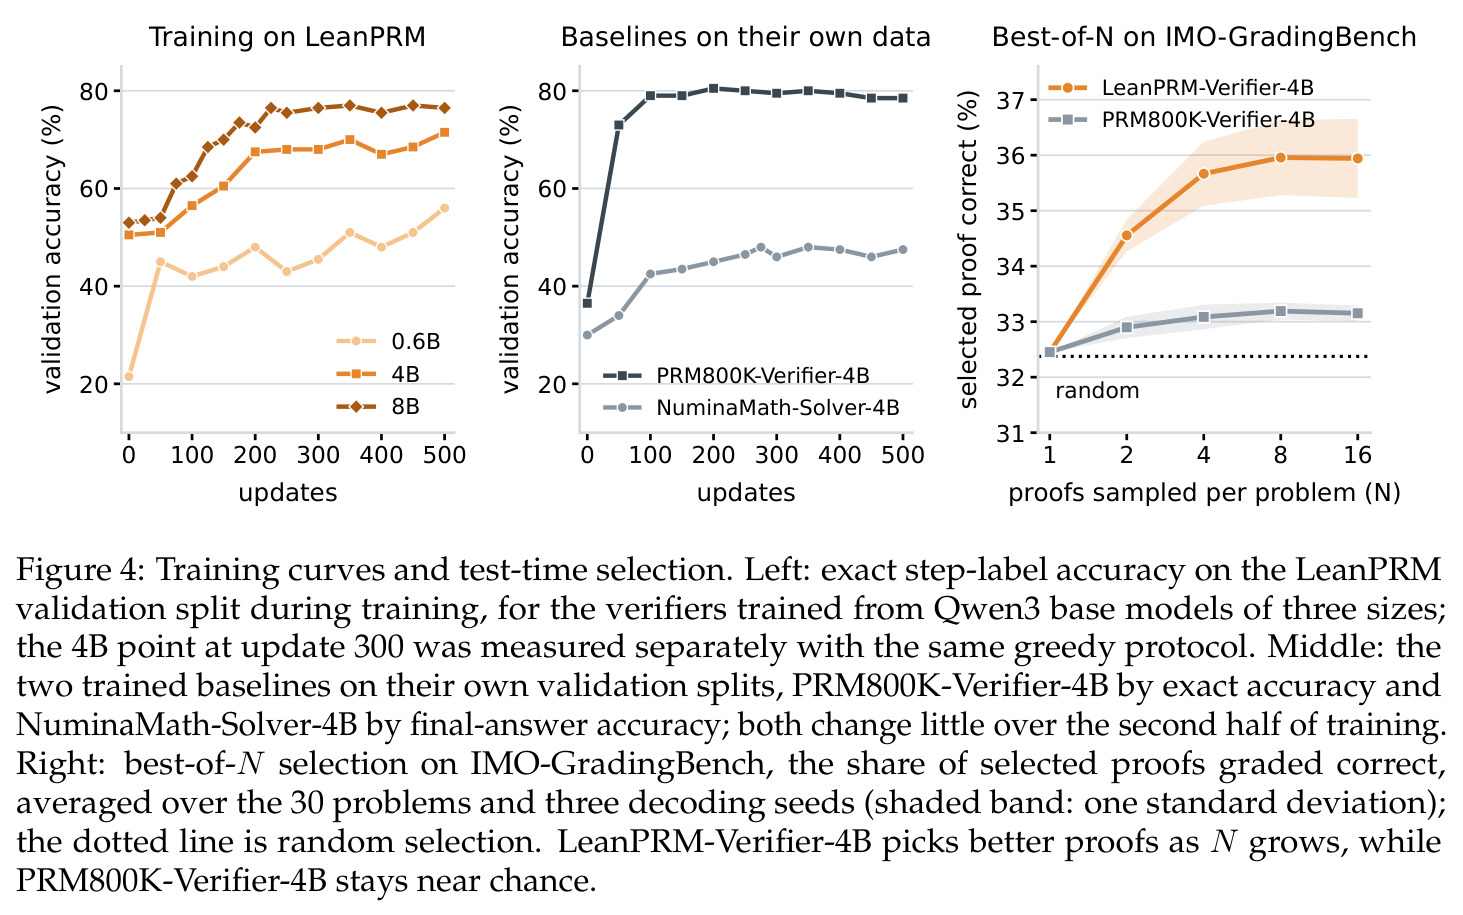
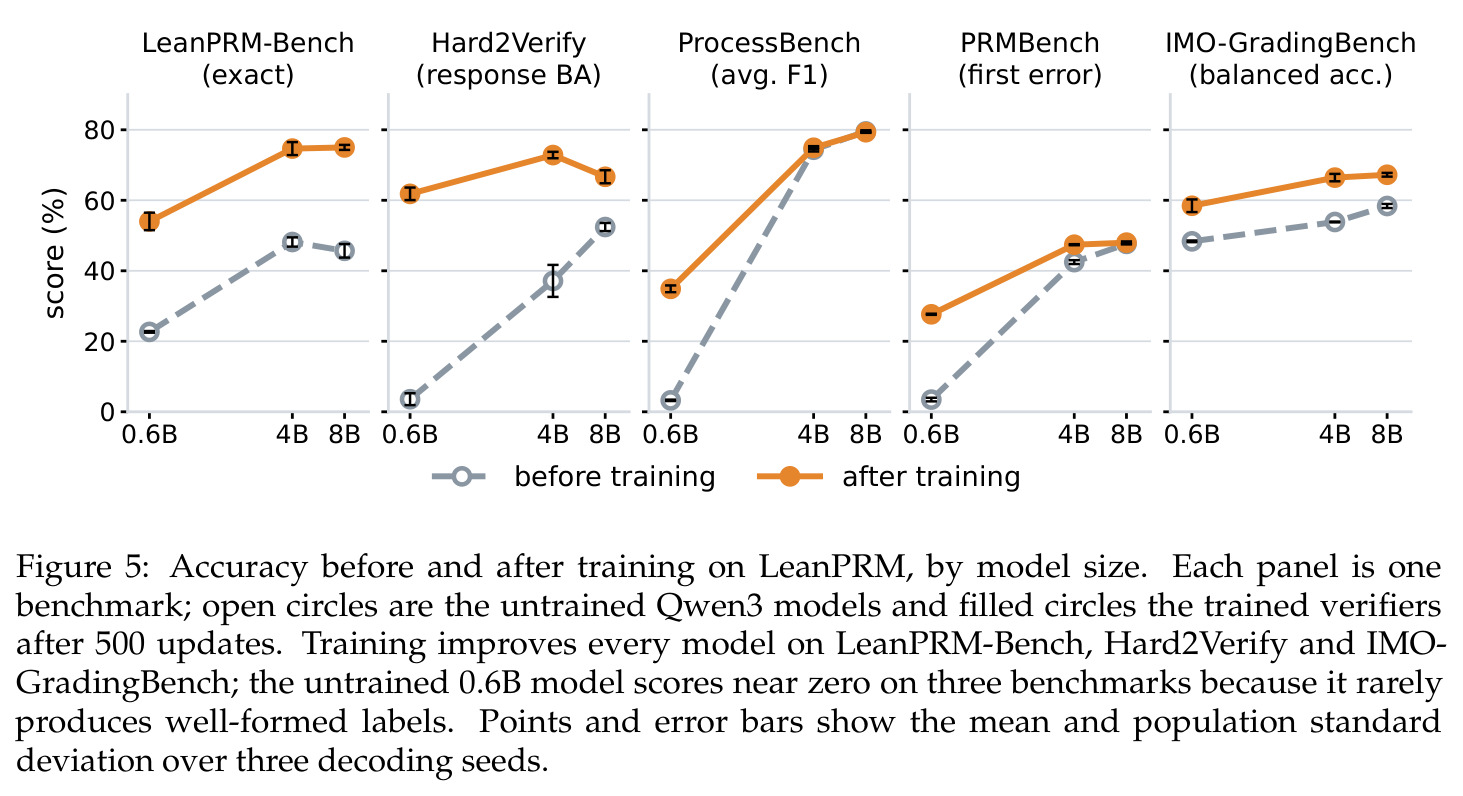
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LeanPRM-Bench 步骤级验证 | 精确步骤标签准确率 | 74.7 | 60.3(PRM800K-Verifier-4B,同配方同预算) | +14.4 |
| Hard2Verify 困难证明验证 | 响应级平衡准确率 | 72.8 | 63.1(PRM800K-Verifier-4B) | +9.7 |
| ProcessBench 首错识别 | 平均 F1(四子集,3,400 例) | 74.9 | 83.0(PRM800K-Verifier-4B) | −8.1(唯一落后项,归因标注约定与分布差异) |
| PRMBench 失败模式探测 | 首错准确率(6,216 行) | 47.4 | 43.3(PRM800K-Verifier-4B) | +4.1 |
| IMO-GradingBench IMO 级评分 | 平衡准确率(二值化,987 候选) | 66.4 | 57.0(PRM800K-Verifier-4B) | +9.4 |
| IMO 级 best-of-N 选择(N=16) | 选中正确证明的比例 | 35.9% | 32.4%(随机选择);33.2%(PRM800K-Verifier-4B) | +3.5 / +2.7 |
局限与改进
作者承认的局限:数学错误与形式化失败的分离依赖一次模型分类,只用单个裁判模型在样本上抽查,边界步骤可能带错误标签;没有做“同一批证明由 LLM 裁判标注再训练”的对照,无法区分收益多少来自标签质量、多少来自证明风格的数据分布;LeanPRM-Bench 与训练数据出自同一流水线、同一批 Claude 生成器,泛化证据主要靠四个外部基准支撑;负样本全部来自 Claude 自己的错误,错误类型覆盖面可能窄于一个完整验证器应检测的范围。我的补充观察:① ProcessBench 落后 8.1 分暴露标注约定(首错即错 vs 只在影响有效性时才算错)与数据分布的不匹配,跨约定泛化仍是开放问题;② 标签是二值的,“正确但论证不充分”与“严格证明”不加区分,附录 G 显示训练后提前报警次数随训练单调上升(158→236→379),验证器可能系统性偏严格;③ 语料主题集中于代数、不等式、数论,几何与分析薄弱,且 98% 的数据只来自两个源集合。
独立分析的弱点
独立分析的弱点与改进方向:① 阶段二分类器是单次 LLM 调用,数学错误与语法错误的边界判断缺少外部校验,误把真数学错误当语法错误剔除会直接损失困难负样本——可引入第二个独立模型交叉验证,或用“修补后能否编译”作为更客观的锚点,并对剔除样本做主动复审。② “首个错误之后全错”的约定虽然自洽,但丢弃了后继步骤的独立信息,且奖励对首错位置过度敏感——可为后继步骤估计条件正确性或引入部分信用,缓解信号稀疏。③ 生成器只有 Claude 两款模型,错误分布单一,难度筛选使错误集中在假设跳跃与不等式放缩(合计 50.8%)——用多个不同家族、不同规模的生成器,并按错误类别主动均衡采样,可显著扩大负样本覆盖。④ 语料仅 1 万条证明、152K 步标签,规模仍小——结合定理陈述自动生成(作者已提出)可数量级扩展。⑤ 训练奖励强制 verdict 与逐步标签一致,可能促使模型学会“表面自洽”而非真验证——可把一致性要求作为随训练渐进放宽的课程信号,并监控模型在人类判定样本上的偏差。
未来方向
作者提出的方向:① 把“带可精确校验部件的开放任务”这一方法论迁移到其他无最终答案的领域,例如代码(测试套件作校验器)与科学(模拟器作校验器);② 自动生成新定理陈述,使语料在规模与难度上超越现有形式化集合;③ 把 LeanPRM 验证器用作奖励模型训练证明器,或为人类难以核对的 AI 证明提供步级反馈——随着模型逼近并超越人类专长,这一点愈发重要。基于其成果可延伸的方向:① 用 LeanPRM 验证器做过程监督 RL(本文只训练了验证器本身),检验能否提升自然语言证明器的生成质量;② 把标签约定做成可配置(首错即错 / 影响有效性才算错),消除与 ProcessBench 类基准的约定错配;③ 扩展到 40 步以上的长证明以及分析、拓扑等非竞赛数学,检验编译定位机制的规模化上限;④ 探索“学习型验证器 + Lean 抽检”的混合推理时系统,在关键步骤用形式化检查兜底,兼得成本与可靠性。
复现评估
复现条件较好。开源情况:语料(10,634 条证明、152,005 个步骤标签、错误类别)、LeanPRM-Bench(200 条带标签、错误类与形式证明)及项目页(rlafuente.com/lean-prm)均已发布;附录 I 完整给出全部提示词(生成、分类、审计、验证器),附录 J 给出全部超参。算力:训练用 4×H100 80GB,VERL 的 GRPO + vLLM rollout,8B 需参数/优化器 offloading 与张量并行;500 步更新即可复现主表。数据构建需 Claude Sonnet 5/Opus 4.8 的 API(每条定理约 2 次调用、约 1.78 万条陈述),API 费用是主要成本,但完全无人工标注。难度评估:训练与评测部分为中等——开源模型加公开配方即可复现主要表格;数据生成部分依赖闭源前沿模型,若 Claude 版本更迭,错误分布可能与论文不完全一致;Lean/Mathlib 版本锁定在 v4.25.0-rc2,复现时需固定环境。
论文图表
定理:1985 个素因子均小于 26 的不同自然数中存在四个数其乘积为完全四次幂。第 5 步用未展开的强归纳断言“n 元光滑集至少产生 (n−512)/2 对同奇偶向量”,Lean 在该步失败(类别:未加论证的假设)。Sonnet 5、Fable 5.1 全盘接受,Opus 5 与 GPT-5.6 Sol 首次在第 6 步反对,LeanPRM-Verifier-4B† 精确标出第 5 步。
定性展示 Lean 标注训练出的 4B 验证器在错误定位粒度上可以超过前沿商用模型。
关于二次函数和为零的存在性证明,在第 19 步定义 S 后停止、未产出两个不同零点。按本文约定“提前停止的论证最后一步为错”,LeanPRM-Verifier-4B† 标出末步,而其他所有系统均判全部正确。
说明“不完整即错”的标签约定,以及训练后验证器对论证未完成的敏感性——这是其他系统系统性漏判的错误类型。
一个 Lagrange 型恒等式中第一个平方项系数写错,Lean 的 ring 检查失败(类别:代数恒等式错误)。四个商用系统与 PRM800K 版都标第 8 步错,LeanPRM-Verifier-4B† 却接受了该证明。全部四个商用系统都正确、训练模型错误的情形共 12 例(占 128 例中的 12)。
提醒读者训练模型并非全面占优,是理解其误判模式与局限的重要反例。
四步配对证明(平方非负、展开恒等式、代入、整理),每步均有对应 tactic 落实(sq_nonneg、ring、rw、linarith),全部标为正确;此类正确尝试在语料中有 6,370 条。
展示语料中正样本的形态与“自然语言 1:1 对应 tactic”的构造要求。
定理要求对任意界 N 存在 n > N 整除其全部因子的 k 次幂之和;模型提议 n=1,第 4 步试图对任意 N 证明 1 > N 而失败。Lean elaboration 在该步报错,Stage 2 赋予类别“无效不等式放缩”,第 4、5 步标为错误。
展示负样本如何自然产生、编译错误如何定位首错步、错误如何被自动归类。
证明 d|n 蕴含 2^d−1 整除 2^n−1 时,第 3 步引用了一个数学上正确、但以当前 Mathlib 不接受的名称形式书写的引理,编译失败,Stage 2 归为“定理误用”;盲审显示该类 30 例中 26 例数学上健全,这正是形式化侧类别被整体剔除出语料的原因。
具体解释“为什么数学对了也会编译失败”,以及按错误类别剔除策略的实证依据。