PaperFormalizer:作者在环的研究论文 Lean 自动形式化流水线 PaperFormalizer: Author-in-the-Loop Autoformalization of Research Papers in Lean
作者在环的智能体流水线:找出论文证明漏洞并自动形式化为 Lean 验证版本
前置知识
Lean 与 Mathlib
Lean 是微软开发的交互式定理证明器兼编程语言,数学证明被写成代码后必须逐行通过类型检查,任何逻辑缺口都无法通过编译。Mathlib 是其社区数学库,已收录大量从本科到研究生水平的经过机器验证的数学结果。
PaperFormalizer 的最终产出就是 Lean 代码,论文反复强调的无 sorry、无额外公理等证明标准都建立在 Lean 的机制之上,不了解它就无法理解验证的可信度从何而来。
自动形式化(Autoformalization)
把自然语言表达的数学定义、命题与证明自动翻译成 Lean 这类形式语言并让机器完成证明的研究方向。难点在于自然语言歧义:同一句话可能有多种形式化读法,形式化错读法就证明了作者没想说的话。
本文流水线的第二阶段(规划、脚手架、证明填充、链接)就是自动形式化的工程实现,理解这一概念才能看清它和 LeanMarathon、LeanFlow 等全自动方案的异同。
sorry 与公理
sorry 是 Lean 中留给未完成证明的占位符,代码能编译通过但不构成真正的证明;额外公理则是人为引入、绕过构造性证明的假设。检验一份 Lean 开发是否可信,标准做法就是确认既无 sorry、也未使用超出系统标准公理集的公理。
案例研究中论文的七个结果被验证为无 sorry 且无额外公理,这是流水线输出的质量底线,也是 reviewer agent 在证明填充阶段逐条检查的内容。
编码智能体(Coding Agent)
在终端或 IDE 中自主读写文件、执行命令、多步推理的大模型系统,代表产品如 Claude Code 与 Codex CLI。它们能长时程运行多阶段工作流,并在关键节点暂停等待人类输入。
整个 PaperFormalizer 流水线并不独立存在,而是运行在编码智能体内部:作者从 Claude Code 或 Codex 启动它,流水线通过本地网页与作者交互。
语句依赖图
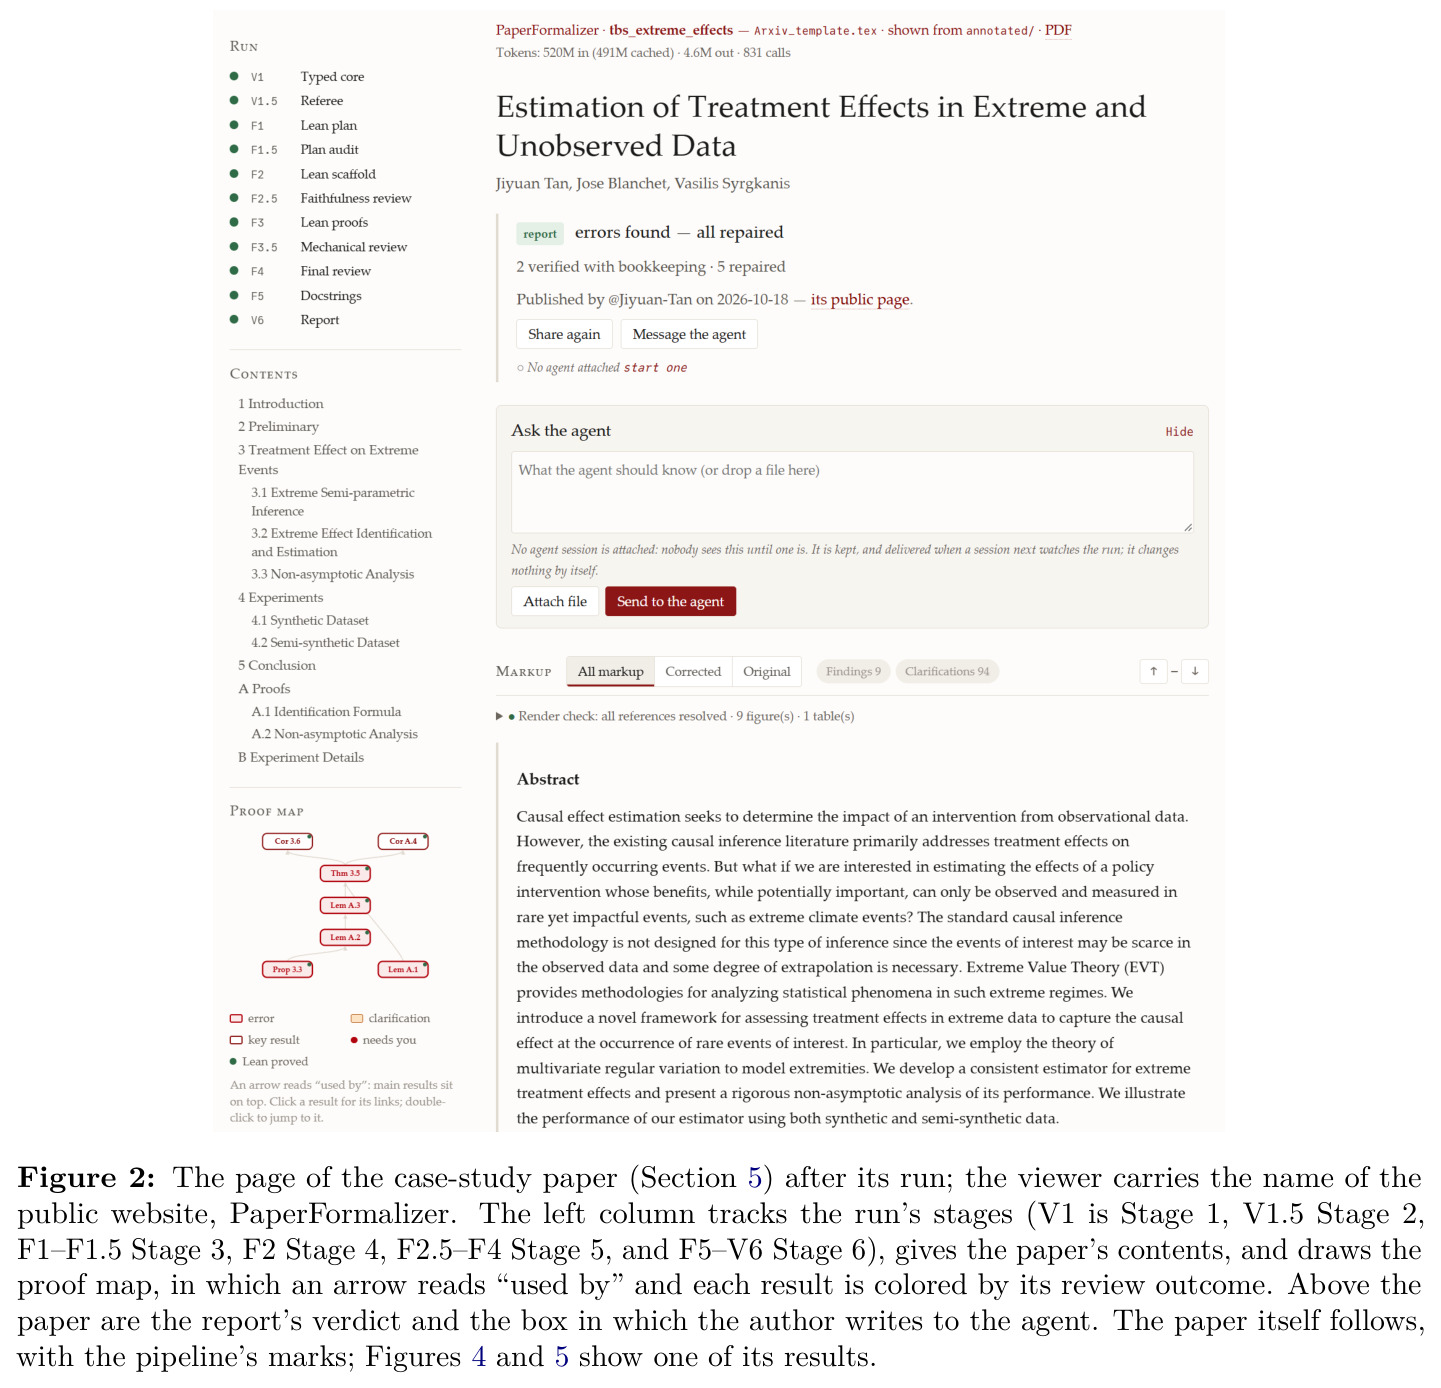
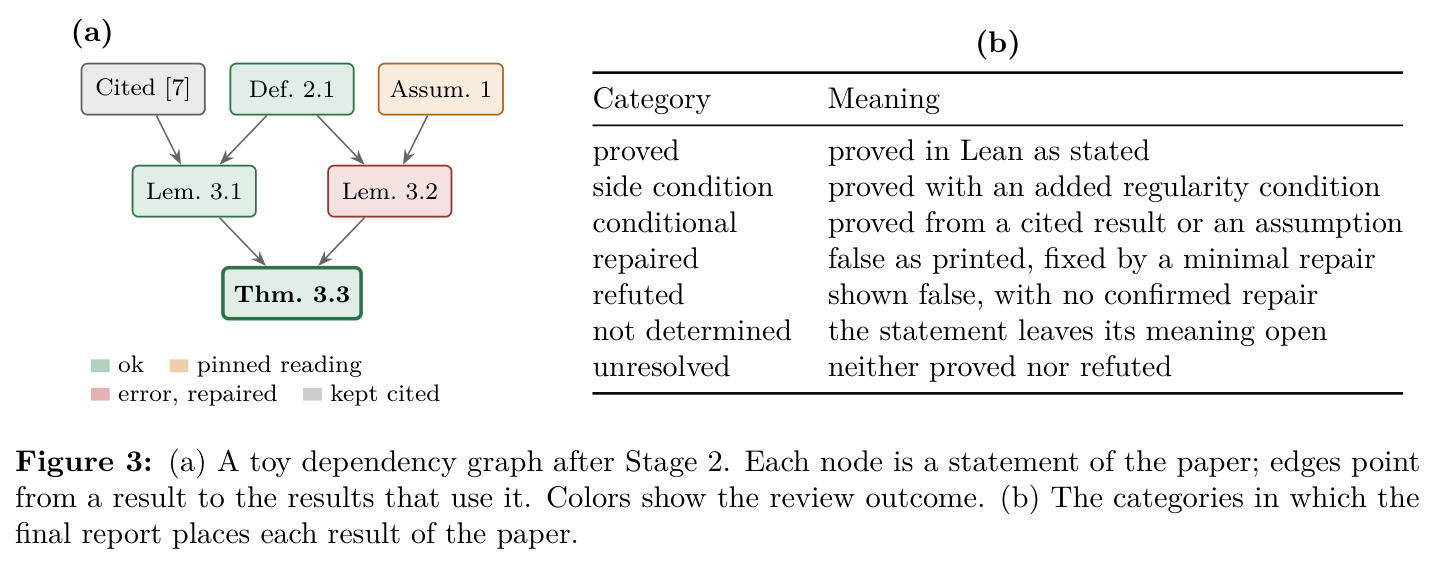
把论文中每个定义、假设、引理、命题、定理、推论及被引用的结果各作为一个节点,当某条语句的陈述或证明使用了另一节点时连一条边,构成的有向图。它决定了审查与形式化的处理顺序,也可视化为证明地图。
这是流水线组织一切工作的核心数据结构:转录阶段生成它,审查按依赖序遍历它,网页上的证明地图用颜色展示每个节点的审查结果。
极值处理效应与 Hill 估计量
案例研究论文涉及未观测噪声取极端值时的处理效应 $\theta_{NETE}$,噪声被建模为尾部指数为 $\beta$ 的多元正则变化分布;估计尾部指数的经典工具是 Hill 估计量,其收敛速率依赖 $\beta$ 与同质性指数 $\alpha$ 的关系。
读懂案例研究中 Proposition 3.3 的反例与 Lemma A.1、A.2 的速率修复(如 $\alpha<\beta$ 条件、$1/3$ 速率、$\log n$ 因子)需要这些极值理论背景。
研究动机
统计、机器学习、运筹与数学领域的许多理论论文依赖长而繁琐的技术证明。即使经过多轮仔细校对,作者仍容易忽略看似不重要的细节:某个边界情形、缺失的正则性条件、或某个需要论文从未陈述过的假设的推理步骤。斯坦福团队自己的论文就是活例——那篇极值数据处理效应论文的 7 个结果中有 5 个与印刷版本不符。用 Lean 这类证明助手可以杜绝此类漏洞,但手工形式化一篇论文需要既精通论文领域又精通 Lean 的人花费数周。近期的智能体系统虽能自动形式化非形式化数学,可研究论文带来两个机器无法独自解决的问题:其一,自然语言有歧义,同一命题可有多种读法,形式化了错的读法就等于证明了作者从未想说的东西;其二,当命题被证明为假时通常有多种修复方式,逻辑上改动最小的修复仍可能牺牲作者最在意的结论部分,例如放弃作者真正关心的结果内容。这两个问题都取决于作者的意图,机器无法代答。
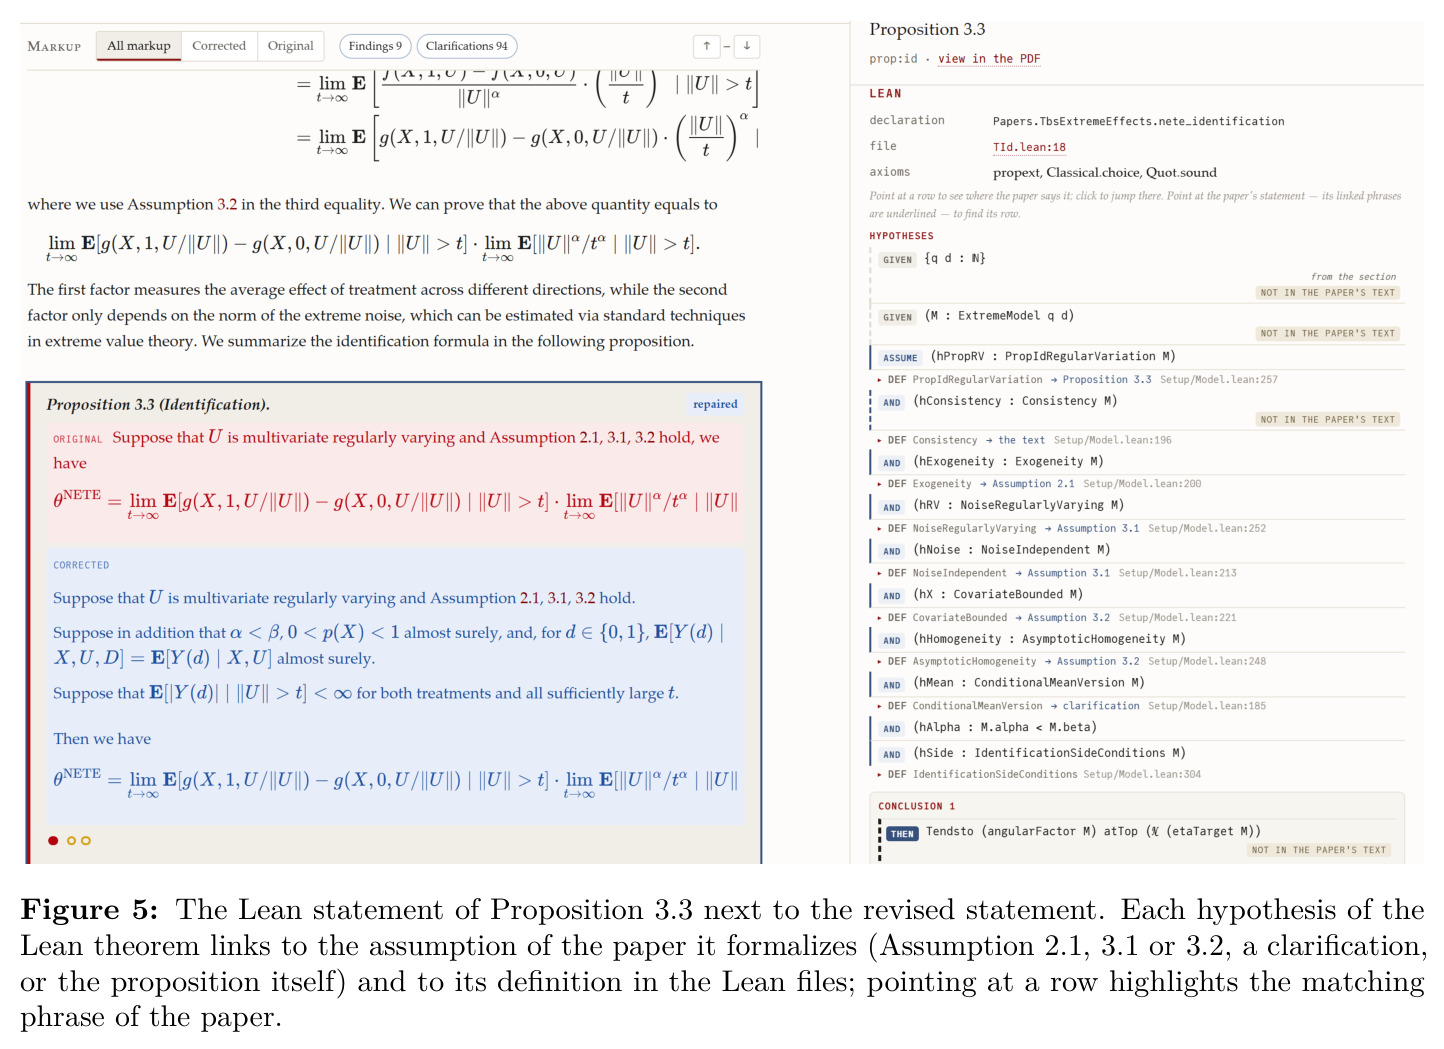
本文的目标是本文的具体目标是:帮助作者在投稿前或发表后强化自己的论文——自动定位证明中的每个漏洞、推荐修复方案,并产出一个 Lean 验证版本的论文,包括三样东西:一份修订后的论文、一份变更报告、以及每条 Lean 声明都与论文语句相互链接的 Lean 代码。与此同时,所有可能改变论文主张的决策必须留给作者:当命题存在多于一种读法时流水线停下来询问;凡会实质性削弱主要结果的修复都以提案形式呈现,作者可接受、拒绝或给出新指示;哪些结果晋升进个人工具包、论文是否公开分享也完全由作者决定。案例研究的量化目标是让 7 个结果全部通过 Lean 证明,并把 94 处隐式读法显式化为澄清供作者确认。
与已有工作不同的是,现有工作分布在光谱两端却没人占据中间:一端是 OSVerify 与 Rethlas-OSV,只在自然语言层面审查论文或解答的数学,把审计后的发现交给人类专家;另一端是 Rethlas、Archon、LeanMarathon 与 LeanFlow,把非形式化论证或整篇论文形式化为 Lean 4,但作者并不参与。PaperFormalizer 的独特切入是站在两者之间并引入作者在环:先做自然语言审查并提出修复,再把每个语句形式化为 Lean 并证明,遇到歧义读法或会实质性改变主要结果的修复就暂停询问作者。另一个未被开掘的角度是成本递减:每位作者维护一个随论文积累而增长的个人 Lean 工具包,验证过的论文可公开分享,让后续研究者直接复用已验证的 Lean 代码,使形式化从一次性工程变成可复利的资产。
核心方法
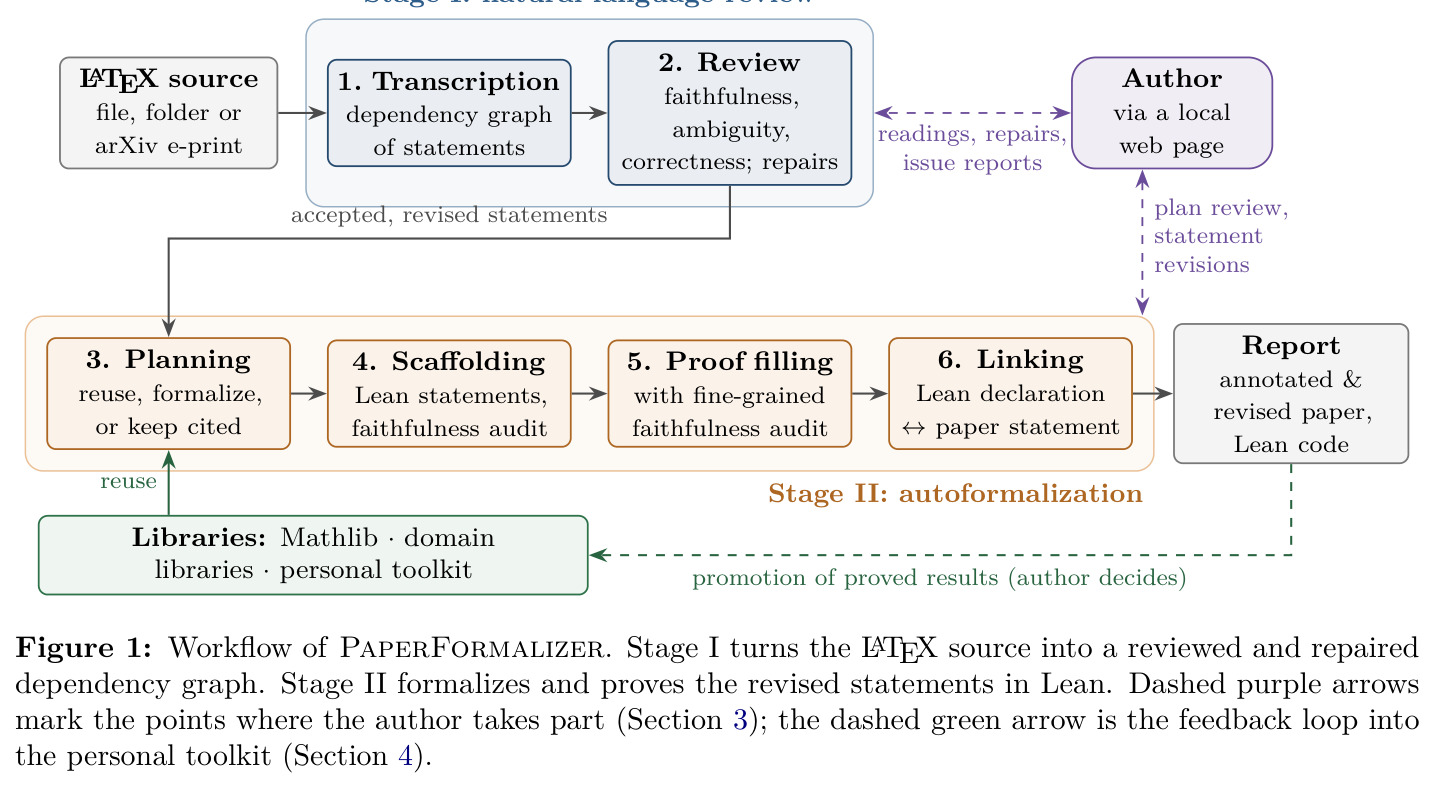
整体直觉是:一篇论文的数学本质上是语句之间的依赖图,逐节点审查与形式化即可系统地发现漏洞。流水线分两大阶段共六步,由作者在编码智能体中启动,运行时打开本地网页展示进度并收集决策。第一阶段是自然语言审查:第 1 步转录,智能体把 .tex 文件、文件夹或 arXiv e-print 拆成节点——每个定义、假设、引理、命题、定理、推论或引用结果一个节点,使用关系加边,文本在公式内断裂的节点退回重转录;第 2 步审查,reviewer 按依赖顺序沿忠实性(是否忠于论文)、歧义性(读法是否唯一)、正确性(命题是否成立)三轴检查每个节点,可从上下文推断的读法被固定,否则停下问作者。第二阶段是自动形式化:第 3 步规划决定复用、形式化或保留引用;第 4 步脚手架写出留空的 Lean 语句并编译核对;第 5 步证明填充循环中 workers 经语言服务器查询 Lean、reviewer 复查;第 6 步把每条 Lean 声明链接回论文语句并生成报告。案例运行最终产出 136 个文件约 26,000 行 Lean 代码。
核心创新是把作者在环确立为设计原则:只有作者知道一条语句想说什么、怎样的修复最符合意图。凡语句存在多于一种读法,流水线停下来用自然语言加 TEX 符号询问作者;凡会实质性改变主要结果的修复都以提案呈现,作者可接受、拒绝、让 fixer 带指导重试或撤销误读;智能体自行做出的削弱裁定也列在清单下供批准。第二大创新是三层个人工具包与反馈闭环:底层是只读的 Mathlib 与领域库,中层是可复用的 Foundations 与 Tricks,顶层是每篇论文一个模块树;每次运行在规划后(引用而未证明的结果)与报告后(已证明结果的一般形式)两次提议晋升,提案用普通数学语言写成,且由 Lean 检查晋升不改变任何已有语句。模型层面采用双家族分工:多数角色用 Codex CLI 上的 gpt-6.1-sol,而 Lean 规划、第二独立 reviewer 与工具包 curation 用 Claude Code CLI 上的 Claude Opus,保证写代码与终审来自不同模型。
方法步骤详情
输入为 .tex 文件、文件夹或 arXiv e-print。第 1 步转录:智能体把论文拆成节点,每个定义、假设、引理、命题、定理、推论或引用结果一个节点,使用关系加边,文本在公式内断裂则退回重转录。第 2 步自然语言审查:reviewer 按依赖序三轴检查;只有论文设定内构造出反例才判错,退化反例(零方差、空类)改为加 side condition;fixer 提出保留关键贡献的最小修复,独立 reviewer 复核;引用结果下载原文逐条对照。第 3 步规划:对每条语句决定复用(从 Mathlib、Causalean/StatLean/FoML/optlib 或个人工具包用关键词加 Loogle、LeanSearch 搜索)、形式化或保留引用;非主要结果的引用通常保留为显式假设;另一智能体审查计划忠实性。第 4 步脚手架:写出证明留空的 Lean 语句并编译,逐条对照原语句审计。第 5 步证明填充:workers 循环填证明、经 Lean 语言服务器查询,reviewer 检查忠实、无 sorry、无额外公理;若暴露论文语句错误则提议回审查,作者批准。第 6 步链接与报告:Lean 声明链接到论文语句;报告将结果归入 proved、side condition、conditional、repaired、refuted、not determined、unresolved 七类,按 major/minor/no errors 汇总,输出标注版与修订版 TEX 及 Lean 代码。
技术新颖性
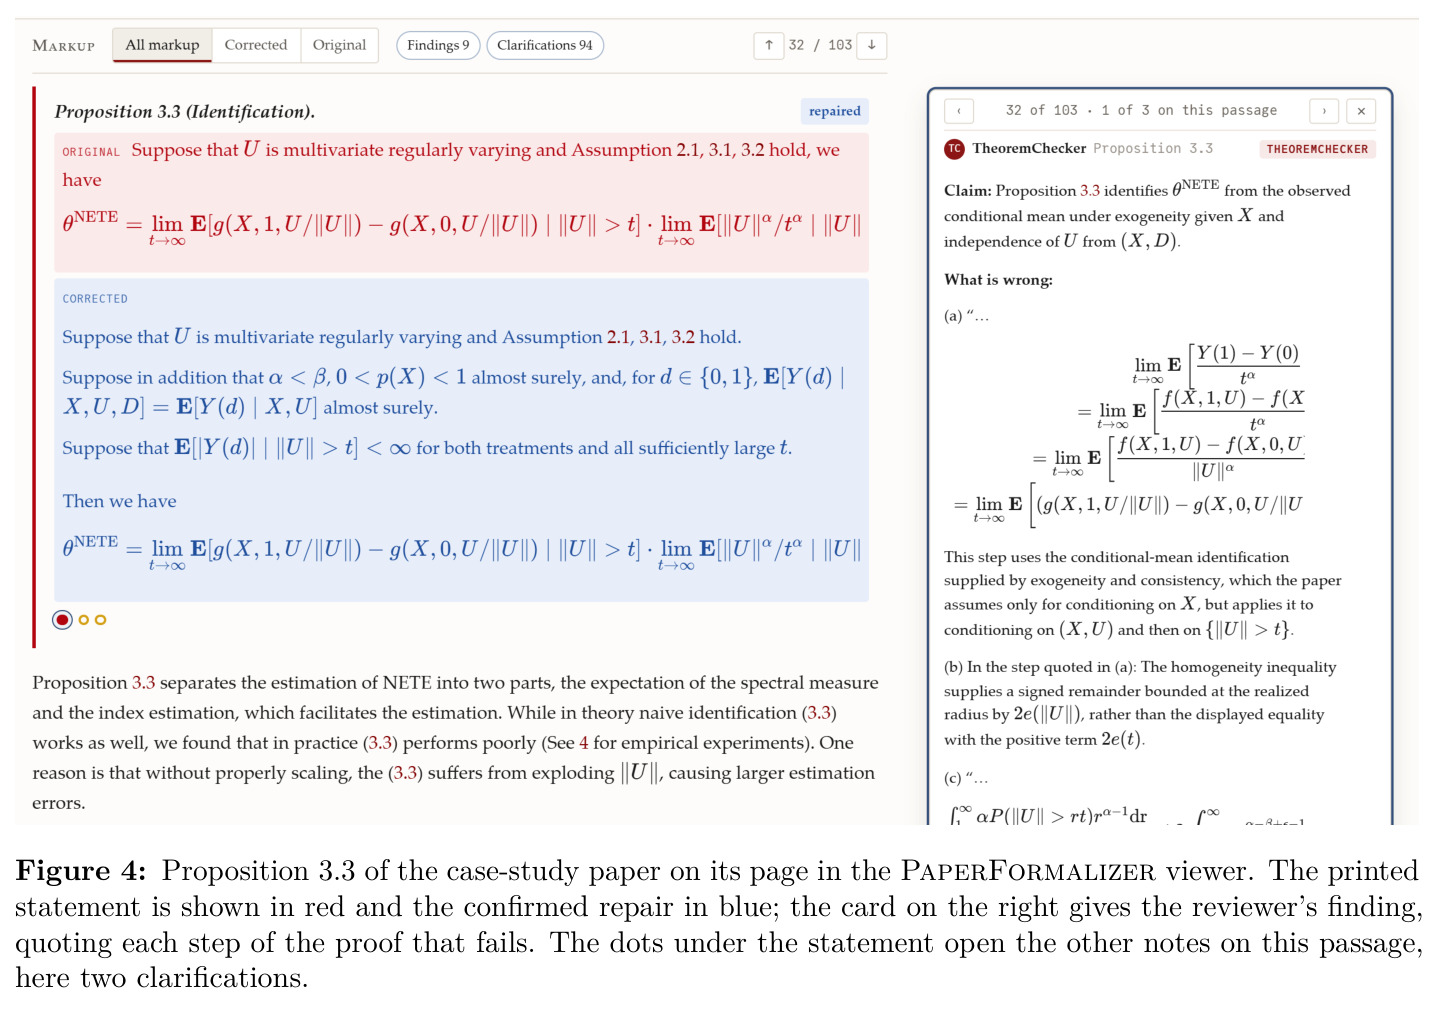
技术新颖性有四点。第一,把人机协作形式化确立为独立问题:全自动方案(LeanMarathon、LeanFlow)在歧义处猜测读法,纯审查方案(OSVerify、Rethlas-OSV)止步于自然语言,本文让形式化的严格性反过来暴露歧义与错误,再由作者裁决意图。第二,报错标准严谨:只有论文设定内构造出反例才判命题为假——案例中 Proposition 3.3 的反例用 $X\sim\mathrm{Unif}[0,1]$、$P(W>w)=w^{-3}$ 的构造算出右端 $3/2$ 对真值 $\theta_{NETE}=3/4$;退化反例只加 side condition。第三,双模型家族交叉审核:gpt-6.1-sol 写代码,Claude Opus 负责规划与第二独立复审,规划与终审来自不同家族,降低同源盲区,所有角色可经环境变量替换。第四,工具包反馈闭环使成本随论文数递减:案例复用了 Foundations 层 13 个模块约 2,500 行代码(Chernoff 界、事件上条件化、Rényi 表示),验证一次即沉淀为可复用资产。
实验结果
案例研究《Estimation of Treatment Effects in Extreme and Unobserved Data》:修订版中全部 7 个结果在 Lean 中证明,无 sorry、无额外公理;审查发现其中 5 个与印刷版不符,错误追溯到两个独立根源——Proposition 3.3($\theta_{NETE}$ 识别式)与 Lemma A.1(自适应 Hill 估计量速率),Theorem 3.5 与 Lemma A.2、A.3 继承前者错误。Proposition 3.3 的机器反例给出右端 $3/2$ 对真值 $3/4$;修复保留识别公式并添加 $\alpha<\beta$、$0<p(X)<1$、条件均值外生性 $E[Y(d)\mid X,U,D]=E[Y(d)\mid X,U]$、尾部均值有限,另有三处小漏洞(含径向极限应为 $\beta/(\beta-\alpha)$)。Lemma A.1 修复后速率在 $\beta<1$ 时指数为 $1/3$、$\beta=1$ 时保留 $\log n$ 因子;Lemma A.2 的反例用指标 $3/2$ 的对称稳定噪声显示误差尺度 $n^{-2/15}$ 而印刷界仅 $n^{-1/5}$。共 94 处读法显式化为澄清。Lean 开发共 136 文件约 26,000 行,复用工具包 13 个模块约 2,500 行。另两篇论文:最优传输 12 个结果全部按原样证明;神经因果模型 29 个结果证明 20 个、反驳 2 个。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 案例论文(极值处理效应)形式化 | Lean 验证通过的结果数 | 7/7 全部证明(其中 5 个经作者确认的修复),无 sorry、无额外公理 | 原论文印刷版:7 个结果中仅 2 个按原样成立 | 从 2/7 正确提升到 7/7 Lean 验证,并额外显式化 94 处隐式读法 |
| 最优传输论文形式化 | Lean 验证通过的结果数 | 12/12 按原样全部证明 | 手工形式化(需要数周专家工作量) | 全自动通过,无需任何修改 |
| 神经因果模型论文形式化 | 结果证明/反驳数 | 29 个结果中证明 20 个、反驳 2 个 | 原论文 29 个结果未经形式化验证 | 发现 2 个无法修复的错误命题(均非主要结果),其余 7 个未定 |
局限与改进
作者层面承认的局限:当错误本质性、没有任何修复能保住原命题时(神经因果模型论文中被反驳的 2 个结果),流水线只能证伪而无法帮忙;论文留白处的问题(如重叠常数能否依赖样本量)只有作者能回答,流水线必须停下等待。整体局限:评估仅覆盖作者自己的 3 篇论文(极值统计、最优传输、因果模型),全部属于 Mathlib 与领域库覆盖较好的概率统计方向,没有独立第三方论文的外部基准,也没有与 OSVerify、LeanMarathon、LeanFlow 的任何定量对比——引言中的 Table ?? 甚至是破损引用,正式的结果对照表缺失。运行成本与耗时完全未量化:26,000 行 Lean 代码背后的 token 消耗、墙钟时间、人工决策等待时长均无数据。此外系统绑定 gpt-6.1-sol 与 Claude Opus 两个闭源模型,能力漂移可能改变行为,结果难以跨时间复现。
独立分析的弱点
第一,评估自选自评:三篇论文均来自作者团队且作者本人兼任流水线的决策者,5/7、15/29 的错误发现率既可能体现流水线能力,也可能反映这几篇论文本身的疏漏密度,存在自利偏差。改进方向是在共享网站上征集第三方论文做盲测前瞻评估。第二,领域覆盖窄:所有案例都在概率、统计与运筹范围内,Mathlib 覆盖强的代数、数论方向可能因复用率更高而更顺利,而形式化基础薄弱的应用机器学习理论(大量渐近启发式论证)可能导致大量语句落入 unresolved,系统在该场景的表现未知。第三,正确性判定依赖模型找反例的能力:漏报(错误命题未被构造出反例)的风险没有任何量化估计,单个 reviewer 漏看即可能放过错误,尽管第二 reviewer 用了不同模型家族,仍缺少对抗性冗余的实验。第四,人工环节可能阻塞:作者不在线时整条流水线停在决策点,94 处澄清的逐一确认对作者是可观负担,可考虑按风险分级批量处理、低风险裁定自动执行事后审批。
未来方向
作者提出的目标方向:让 Lean 验证成为写论文的常规步骤而非独立项目,作者投稿或发表时附上 Lean 证明;随着更多作者共享验证论文,公共集合中的已验证数学不断增长,一篇论文的 Lean 代码成为下一篇的起点。基于其成果可自然延伸的研究:建立量化基准——每篇论文的澄清数、修复数、按七类分类的证明成功率、token 成本与墙钟时间,并形成公开榜单以支持系统间公平对比;与期刊或 arXiv 的持续集成结合,实现提交时增量式形式化;扩展到 Rocq(Coq)与 Isabelle 等其他证明助手;跨作者挖掘共享 Foundations,把个人工具包演化成领域级公共库;累积 pinned readings 形成领域歧义词典,从统计上减少询问作者的次数;对 refuted 与 not determined 类结果开发更强的反例搜索与假设最小化算法。
复现评估
复现条件总体友好但依赖闭源服务。代码完全开源在 GitHub(Jiyuan-Tan/PaperFormalizer),在 Claude Code 或 Codex CLI 中安装即可运行;领域库(Causalean、StatLean、FoML、optlib)安装时选择;每个角色可用环境变量替换模型,并文档化了回退策略(Claude Code 不可用时其角色回落到高推理档的 gpt-6.1-sol)。数据层面:三篇已验证论文连同修订版 TEX 与 PDF、带 reviewer 笔记的发现列表、报告及全部 Lean 代码都在 paperformalizer.org 公开分享,Lean 代码可独立于流水线直接复用,案例的 136 文件约 26,000 行代码是极佳的极值统计形式化素材。算力上无需自有 GPU,但需要两个闭源模型的 API 或订阅,token 消耗未披露,预计单篇成本不低。复现难度:对熟悉 Lean 与编码智能体的研究者属于中等偏低;但完整复现案例中作者在环的决策过程(接受哪些修复、回答 94 处澄清)需要作者级领域知识。
论文图表