无需显式轨迹的3D扩散策略前瞻学习 Learning Foresight without Explicit Trajectories for 3D Diffusion Policies
用未来夹爪状态监督出的紧凑趋势隐变量,为3D扩散策略提供软性前瞻而不做显式轨迹规划。
前置知识
扩散策略(Diffusion Policy)
把机器人动作生成建模为条件去噪扩散过程:训练时对真实动作块 $A_t$ 逐步加噪得到 $x_\tau$,网络 $D_\theta$ 学习在观测条件下预测干净动作,损失通常为 $\mathcal{L}=\mathbb{E}\|D_\theta(x_\tau,\tau,c)-A_t\|_2^2$;推理时从高斯噪声出发经若干步(如10步DDIM)迭代去噪,输出一段连贯动作序列。它能天然表达多峰动作分布,是当前操作学习的主流骨干之一。
本文的全部改动都作用在扩散动作生成骨干上:趋势隐变量作为去噪条件、门控FiLM作用于去噪UNet瓶颈,理解扩散策略才能看懂'最小干预'到底改在哪里。
DP3 与 3D 点云观测
DP3 用点云代替RGB图像作为视觉观测:先用PointNet式编码器把稀疏3D点压缩成特征向量,再与机器人状态拼接,作为扩散UNet的全局条件。点云显式暴露场景几何与空间关系,对视角变化更鲁棒,样本效率高,便于从仿真迁移到真机。
本文自称'3D扩散策略'方法,输入表示、未来目标定义(任务空间笛卡尔坐标)、四大基准评测协议全部沿用DP3的点云设定,是与DP3*严格对照的前提。
Receding Horizon 与动作分块执行
策略每次接收最近 $N$ 帧观测,预测覆盖 $H$ 步的动作块,但只执行其中前 $n_a$ 步,然后重新观测、重新规划。本文沿用DP3设定 $N=3$、$H=8$、$n_a=6$,即从动作块索引 $N-1$ 处开始执行6步。这种滚动执行让策略能根据最新观测持续修正。
趋势隐变量在每个重规划周期被重新计算并刷新,理解这个执行循环才能明白'每周期更新的软条件'如何与稠密动作预测配合工作。
FiLM 与门控特征调制
FiLM(Feature-wise Linear Modulation)用条件向量预测逐通道缩放 $\alpha$ 和偏置 $\beta$,对中间特征做 $\tilde{x}=(1+\alpha)\odot x+\beta$ 的仿射调制。本文进一步加门:$\gamma=\sigma(W_\gamma c+b_\gamma)$,输出 $y=x+\gamma\odot(\tilde{x}-x)$;缩放/偏置投影零初始化、门偏置为负,保证分支初始为严格恒等映射,随训练才逐渐生效。
门控FiLM是本文把趋势信息直接注入去噪骨干的唯一附加通路,'仅限瓶颈+门控恒等初始化'这一保守注入设计是消融中性能最优的关键架构选择。
辅助监督与表征塑形
在主任务损失之外增加辅助损失(本文为未来夹爪状态的MSE)来训练某个中间隐变量,迫使它编码与未来相关的信息;推理时丢弃辅助解码器,只保留隐变量作为条件。这与'把预测未来当作中间控制目标'根本不同——前者只塑造表征内容,后者约束可执行动作。
这是全文的核心思想:'用未来教模型表征什么,而不是执行什么'。消融显示未来监督在LIBERO-40上贡献了+27.06个百分点,是本文增益的主要来源。
研究动机
3D扩散策略(如DP3)把几何观测直接映射为稠密动作序列,擅长回答'当前什么动作可行',但成功操作还依赖对'交互正朝哪发展'的预判:抓取前要知道下一步接触哪里,双手传递要协调两臂的接近—抓取—转移—释放,堆叠要提前知道目标高度与顺序。标准扩散策略并不区分这两种角色,局部控制与长程交互结构都要从同一个动作学习目标里隐式恢复。已有的直接办法是让模型预测航点、关键帧或完整轨迹,但这要求预测器给出比控制器实际需要更多的信息:轨迹规定了机器人'该去哪',而动作生成可能只需要'交互如何演化'的粗粒度提示;更糟的是,一旦把预测未来转成中间控制目标,预测误差就会约束后续行为,即使新观测表明应该修正动作也难以摆脱。数据上问题很直观:DP3在RoboTwin2.0五十任务混合训练中只有56.1%成功率,LIBERO-40点云评测仅37.08%,其中LIBERO-Goal套件低至8.73%,多阶段长程任务的失败尤其集中。
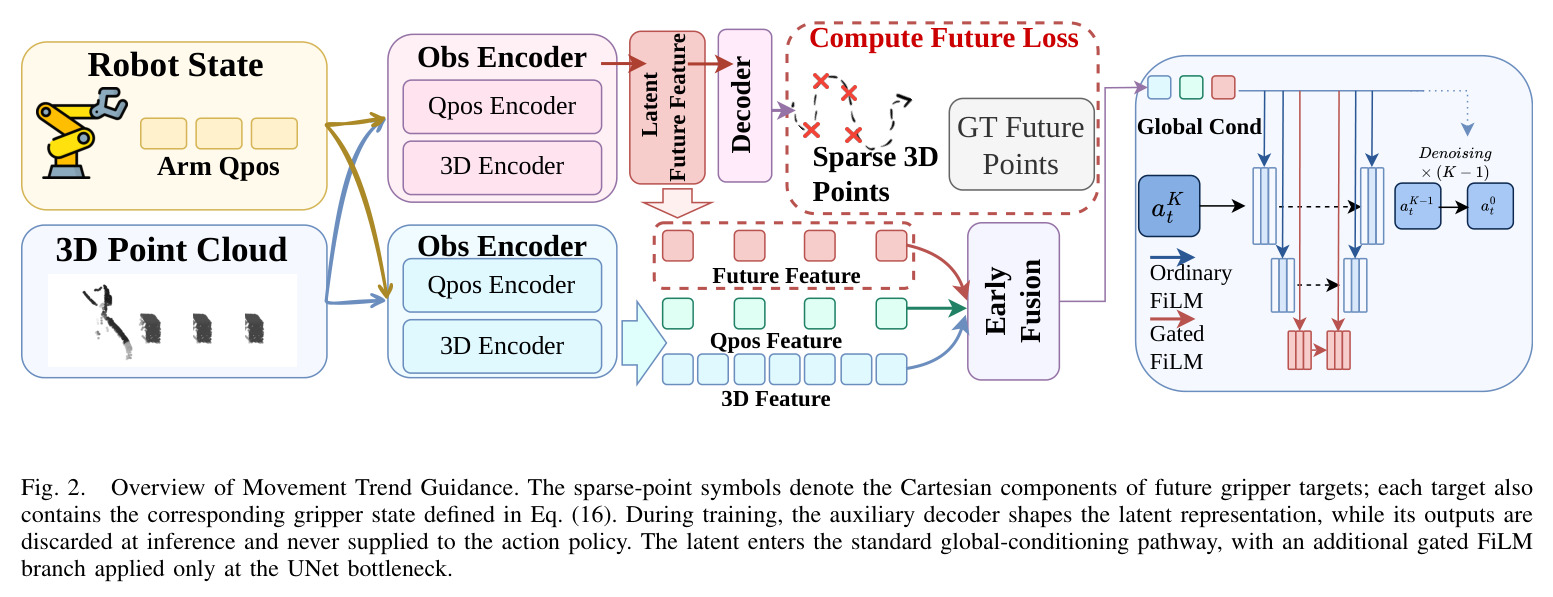
本文的目标是本文目标是让3D扩散策略在完全保留原有稠密动作预测与receding-horizon执行框架的前提下,获得'前瞻'能力而不引入任何显式规划目标。具体做法:从 $N=3$ 帧点云加机器人状态的历史中,学习一个256维的紧凑'运动趋势'隐变量 $z_t$;训练时用稀疏的未来夹爪状态(偏移 $\Delta=5,10,15,20$ 帧,每目标仅含末端xyz位置加1个夹爪开合标量,共 $4\times2\times4=32$ 个标量)作为辅助监督去塑造这个隐变量;推理时解码出的未来坐标全部丢弃,只保留隐变量本身作为面向未来的条件。注入方式坚持最小干预:隐变量走DP3原有的标准全局条件通路,仅额外增加一个限定在扩散UNet瓶颈层的门控FiLM分支,参数只增加3.52%(9.23M),推理延迟只增加1.23%(50.28ms到50.90ms)。
与已有工作不同的是,本文的独特切入是把'前瞻'从规划问题重新表述为表征塑形问题,并与三类已有方案明确划界。其一,显式中间结构方法(HDP利用接触结构、DTP生成任务相关2D轨迹)把未来变成被跟踪的目标,误差会传导且限制修正;本文的未来状态只在训练期作为监督信号存在。其二,未来视觉表征方法(FLARE把策略特征与未来观测隐变量对齐、ForeDiffusion预测并注入未来视角表征)建模的是'未来会看到什么';本文直接在3D任务空间用稀疏夹爪状态监督,建模'交互将如何演化',信息更贴近操作本体且维度极小。其三,与这些方法重模块、重耦合的设计相反,本文坚持保守注入——趋势隐变量经由标准全局条件通路进入网络,唯一的直接调制(门控FiLM)被刻意限制在压缩的UNet瓶颈处,使高层趋势塑造全局动作结构、而不干扰观测驱动的局部去噪。
核心方法
直觉上,与其指望策略从动作损失里隐式'悟出'交互走向,不如在训练时直接用未来夹爪位置告诉趋势编码器该压缩什么信息——但又不像轨迹预测方法那样把这个未来变成执行时必须到达的目标。技术路线分四步:第一,轻量趋势编码器 $F_\phi$ 把 $N=3$ 帧的(点云,机器人状态)历史映射为 $z_t=F_\phi(O_t)\in\mathbb{R}^{256}$,$z_t$ 取自辅助输出头之前的隐藏层;第二,辅助解码器 $G_\omega$ 把 $z_t$ 解码为 $K=4$ 个未来夹爪目标 $\hat{P}_t\in\mathbb{R}^{K\times2\times4}$(4个偏移×左右两个夹爪槽位×4维),用MSE监督后,解码结果在推理时丢弃;第三,$z_t$ 经小MLP投影为 $u_t$,与每帧点云特征、状态特征融合并拼接成全局扩散条件 $c_t=[h_{t-N+1};\ldots;h_t]$,送入DP3式扩散UNet去噪 $H=8$ 的动作块;第四,在UNet瓶颈处附加门控FiLM分支。全部模块以单一端到端目标 $\mathcal{L}=\mathcal{L}_{diff}+\lambda_{future}\mathcal{L}_{future}$($\lambda_{future}=1.0$)联合优化,不引入独立规划模块。
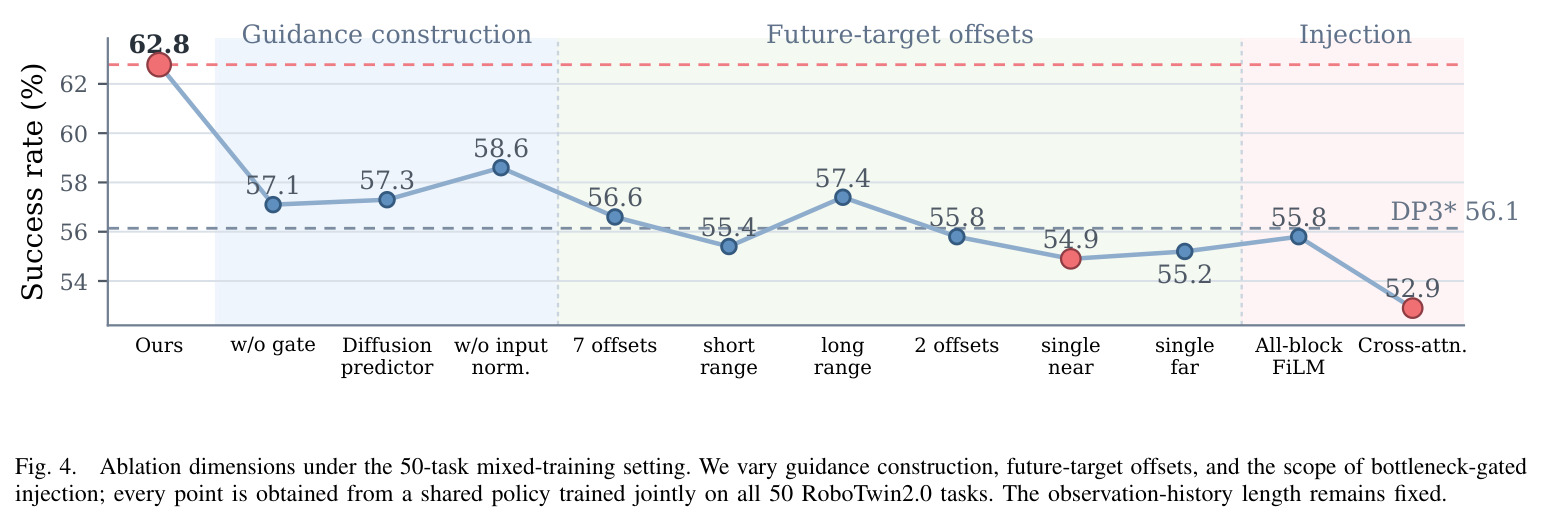
核心创新是'前瞻即表征塑形':把未来信息的作用从中间控制目标降级为训练期监督信号,隐变量 $z_t$ 是辅助头之前的隐藏层,训练结束后解码出的未来坐标被完全丢弃,推理只保留 $z_t$。它与已有方法的本质区别有三层。第一,相比航点/轨迹预测(DTP等),不产生预测误差向执行的传导,也没有硬跟踪约束,策略始终可以依据最新点云观测自由修正局部动作——这正是'保留DP3稠密动作与滚动执行形式'的含义。第二,相比未来视觉表征(FLARE/ForeDiffusion),本文在3D任务空间用稀疏夹爪状态监督,只需32个标量的训练信号就能显著塑形表征,而把同样的未来点直接嵌入条件反而低6.65个百分点(LIBERO-40上65.28%对71.93%),说明'用未来塑形表征'优于'把未来作为条件'。第三,注入架构上的洞见:消融证明瓶颈限定门控FiLM(62.8%)显著优于全块FiLM(55.8%)和交叉注意力(52.9%,甚至低于DP3*基线56.1%),高层趋势应当塑造全局动作结构而不应主导局部去噪行为。
方法步骤详情
完整流程如下。(1)输入归一化:点云坐标与机器人状态按训练数据估计的逐维限幅缩放到 $[-1,1]$,该归一化独立于未来目标处理。(2)趋势编码:每帧 $e_i=E_{trend}(P_i,q_i)$,时间拼接后通过两层隐宽256的MLP得到 $z_t=F_\phi([e_{t-N+1};\ldots;e_t],[q_{t-N+1};\ldots;q_t])$。(3)辅助监督:解码器输出偏移 $\Delta=\{5,10,15,20\}$ 帧的夹爪目标,每目标为左右夹爪槽位的4维量(末端位置xyz加1个夹爪开合标量),损失 $\mathcal{L}_{future}=\frac{1}{8K}\sum_{k=1}^{K}\sum_{g}\|\hat{p}^{(g)}_{t+\delta_k}-p^{(g)}_{t+\delta_k}\|_2^2$;超出演示长度的偏移截断到末帧,目标直接用各基准自带的笛卡尔坐标系,不做额外归一化。(4)条件融合:$u_t=\psi(z_t)$ 与每帧点云/状态特征融合 $h_i=F_{fuse}([f^P_i;f^q_i;u_t])$,拼接为全局条件 $c_t$;RoboTwin2.0实验中对比双方共用同一64维学习式任务嵌入以保证公平。(5)动作扩散:前向 $x_\tau=\sqrt{\bar{\alpha}_\tau}A_t+\sqrt{1-\bar{\alpha}_\tau}\epsilon$,样本预测损失 $\mathcal{L}_{diff}=\mathbb{E}\|D_\theta(x_\tau,\tau,c_t)-A_t\|_2^2$。(6)门控FiLM:$\alpha=W_\alpha c$,$\beta=W_\beta c$,$\gamma=\sigma(W_\gamma c+b_\gamma)$,$\tilde{x}=(1+\alpha)\odot x+\beta$,$y=x+\gamma\odot(\tilde{x}-x)$;投影零初始化加负门偏置,仅置于UNet瓶颈,下采样与上采样块只走普通条件通路。(7)推理:batch为1、10步DDIM去噪,执行 $\hat{A}_t$ 中从索引 $N-1$ 起的6步动作,重新观测后重算 $z_t$ 再规划;$z_t$ 每个滚动周期刷新,且永不直接转成指令或跟踪路径。
技术新颖性
技术新颖性体现在四点。(1)问题形式化新:首次把'前瞻'明确表述为对紧凑趋势隐变量的表征学习问题而非规划问题,并用参数匹配消融严格证明增益来自未来监督而非额外容量——LIBERO-40上保留同样隐变量架构但去掉未来损失的变体只有44.87%(仅比DP3高7.79点),加上未来监督后跳到71.93%(再+27.06点)。(2)监督信号极简:4个偏移×2夹爪×4维共32个标量即可显著塑形256维隐变量,且同样信息若在推理时直接作为条件嵌入反而有害,揭示了'塑形优于条件化'这一可迁移的设计原则。(3)注入架构有系统洞见:门控FiLM的零初始化+负偏置设计保证训练起点严格等价于原DP3,消融对比瓶颈限定/全块/交叉注意力三种注入给出'保守注入'结论,为后续条件注入类工作提供了明确的设计指南。(4)跨骨干初步验证:趋势条件同样把transformer基线ACT在六任务验证上从24.00%提升到51.67%,暗示该方法不绑定扩散UNet这一特定骨干。整个方法只增加9.23M参数(+3.52%)和0.62ms延迟(+1.23%),工程代价极低。
实验结果
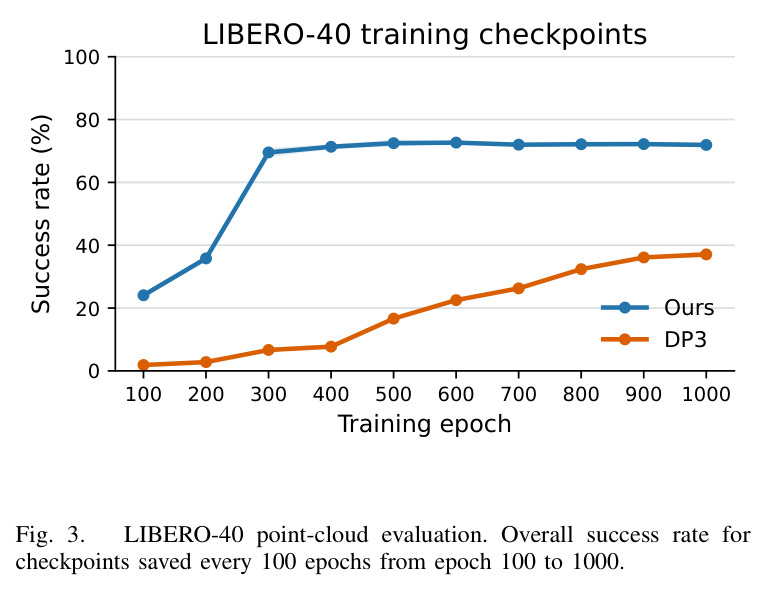
逐一分析核心实验。(1)RoboTwin2.0五十任务混合训练:Ours*达62.8%,比同任务嵌入的DP3*(56.1%)高6.7点,在38/50个任务上提升;官方单任务设定下Ours为61.7%对DP3的55.2%,并大幅领先RDT(34.5%)、π0(46.4%)、ACT(29.7%)、DP(28.0%);最大单任务增益为rotate_QRcode +37、place_shoe +26、move_pillbottle_pad +22、move_playingcard_away +21;类别层面多物体堆叠+10.5、双手传递+8.5、单臂操作+7.9、铰接交互+7.6、抓取搬运+7.3、精确定位+5.5、工具使用+2.6。(2)LIBERO-40点云评测:epoch-1000整体71.93%±0.49%对DP3的37.08%±1.21%(+34.85点),其中LIBERO-Goal从8.73%跃升至77.53%(+68.80),Spatial +31.80、Object +26.00、LIBERO-10 +12.80;训练曲线上Ours在epoch 300即达69.55%,超过DP3的最终水平,且三个rollout种子上的标准差很窄,说明优势稳定而非偶然。(3)DexArt四任务:平均59.25%对DP3的52.0%(+7.25),为全部对比方法最高(VITA 55.3%、FreqPolicy 54.3%)。(4)SO101真机五任务:72.0%对DP3的49.0%(+23点),SimpleDP3为43.0%、DP为33.0%。(5)关键消融:参数匹配但无未来损失的隐变量44.87%、显式未来点条件化65.28%;去掉门控FiLM降至57.1%、换扩散趋势预测器57.3%、去掉输入归一化58.6%;所有非默认偏移配置(7偏移56.6%、短程55.4%、长程57.4%、2偏移55.8%、单近54.9%、单远55.2%)均低于默认$\{5,10,15,20\}$的62.8%;全块FiLM 55.8%、交叉注意力52.9%。(6)按DP3*基线成功率分桶:<30%的11个任务平均+6.1点(10个任务提升)、30–40%桶+12.0点、40–80%的21个任务+9.8点、>80%的13个任务平均变化0.0点(天花板效应),说明该方法在基线'有合理动作先验但缺未来几何线索'时互补价值最大。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboTwin2.0 五十任务混合训练(50演示/任务,100次评测/任务) | 成功率 (%) | 62.8 (Ours*) | DP3* 56.1 | +6.7(38/50任务提升) |
| RoboTwin2.0 官方单任务设定 | 成功率 (%) | 61.7 | DP3 55.2 | +6.5(并领先 RDT 34.5、π0 46.4) |
| LIBERO-40 点云评测(epoch 1000,6000次评测) | 成功率 (%) | 71.93 ± 0.49 | DP3 37.08 ± 1.21 | +34.85(LIBERO-Goal 套件 +68.80) |
| DexArt 四任务(铰接物体灵巧操作) | 成功率 (%) | 59.25 | DP3 52.0 | +7.25(对比方法中最高) |
| SO101 真机五任务(推方块/叠碗/叠方块/提篮/递瓶) | 成功率 (%) | 72.0 | DP3 49.0 | +23.0 |
| RoboTwin2.0 六任务 ACT 架构迁移验证 | 成功率 (%) | 51.67 (ACT + Trend) | ACT 24.00 | +27.67 |
局限与改进
作者承认的局限:失败分析发现机械臂会遮挡大部分被操作物体,导致点云不完整,缺失的几何同时损害基线与趋势估计,在需要精确接触、抓取对准或放置的任务中最明显——这些任务上改进确实有限(如place_dual_shoes仅16%、place_mouse_pad 5%、stack_blocks_three 3%);工具使用(+2.6)与精确定位(+5.5)类别增益小,因为成功强依赖细粒度局部几何;基线>80%的13个任务平均变化为0,接近天花板。我自己的观察:其一,DexArt报告'最佳5个checkpoint平均'而LIBERO固定epoch-1000评测,聚合口径不一致且该协议可能带来有利偏差;其二,趋势隐变量 $u_t$ 在所有 $N=3$ 帧间共享、每周期整体刷新,时间分辨率粗糙,无法表达帧级演化的趋势变化;其三,监督目标只有末端夹爪位姿,不含物体运动或接触事件,对工具使用、颜色/尺寸排序等物体中心任务信息量有限(blocks_Ranking_RGB仅5%);其四,交叉注意力注入反而低于基线(52.9%对56.1%),说明结论对注入架构敏感,迁移到新骨干需重新搜索注入点;其五,真机验证仅5个任务、单一SO101平台,且只用点云未利用RGB纹理信息。
独立分析的弱点
独立分析的弱点及改进方向。(1)遮挡脆弱性:趋势从局部观测估计,机械臂遮挡被操作物体时隐变量质量下降,而恰恰是遮挡严重的精确接触任务最需要前瞻;改进方向为多视角点云融合、学习式点云补全,或给趋势分支加置信度门控,在不确定时自动降权。(2)固定偏移超参:默认 $\{5,10,15,20\}$ 是经验选择,长短程配置均掉点(短程55.4%、单近54.9%对62.8%),且不同任务的最优前瞻距离天然不同;改进方向为可学习偏移或按任务自适应的多尺度偏移采样。(3)监督信号单一:仅夹爪末端位姿,无物体级未来信息;改进方向为辅以物体关键点轨迹或接触图监督,专门帮助工具使用与精确定位。(4)时间聚合粗糙:$u_t$ 对所有观测帧共享,丢失趋势的帧内动态;改进方向为每帧或每偏移独立隐变量加时间注意力融合。(5)架构敏感性:交叉注意力注入失败说明'隐变量与局部去噪耦合过强有害'的边界尚不清楚;改进方向为研究门控强度随去噪步数的调度或分层注入策略。(6)评测口径:DexArt最佳checkpoint平均可能高估性能,建议统一固定checkpoint协议复核。
未来方向
作者提出的方向:在更多样的物体、场景与扰动设置下验证真机迁移是重要后续工作。基于本文成果可延伸的方向:(1)与VLA基础模型结合——把运动趋势隐变量作为即插即用的前瞻条件注入π0、RDT类大规模模型,其+3.52%参数的轻量性特别适合这种场景;(2)与世界模型结合——趋势隐变量本身可视为压缩的短期前瞻想象,可用于离线策略评估或安全探索;(3)自适应前瞻——按任务阶段动态调整监督偏移或隐变量有效维度;(4)扩展到灵巧手与高自由度系统,监督目标从夹爪状态推广到关节级或物体级运动趋势;(5)多模态未来监督(物体运动、接触事件、力信号)以突破精确定位与工具使用类任务的瓶颈;(6)理论层面解释'表征塑形优于显式条件化'的现象,可能与信息瓶颈或多任务学习中的梯度冲突有关;(7)在强域随机化设置下检验趋势隐变量的跨域不变性,评估其能否成为可复用的通用表征。
复现评估
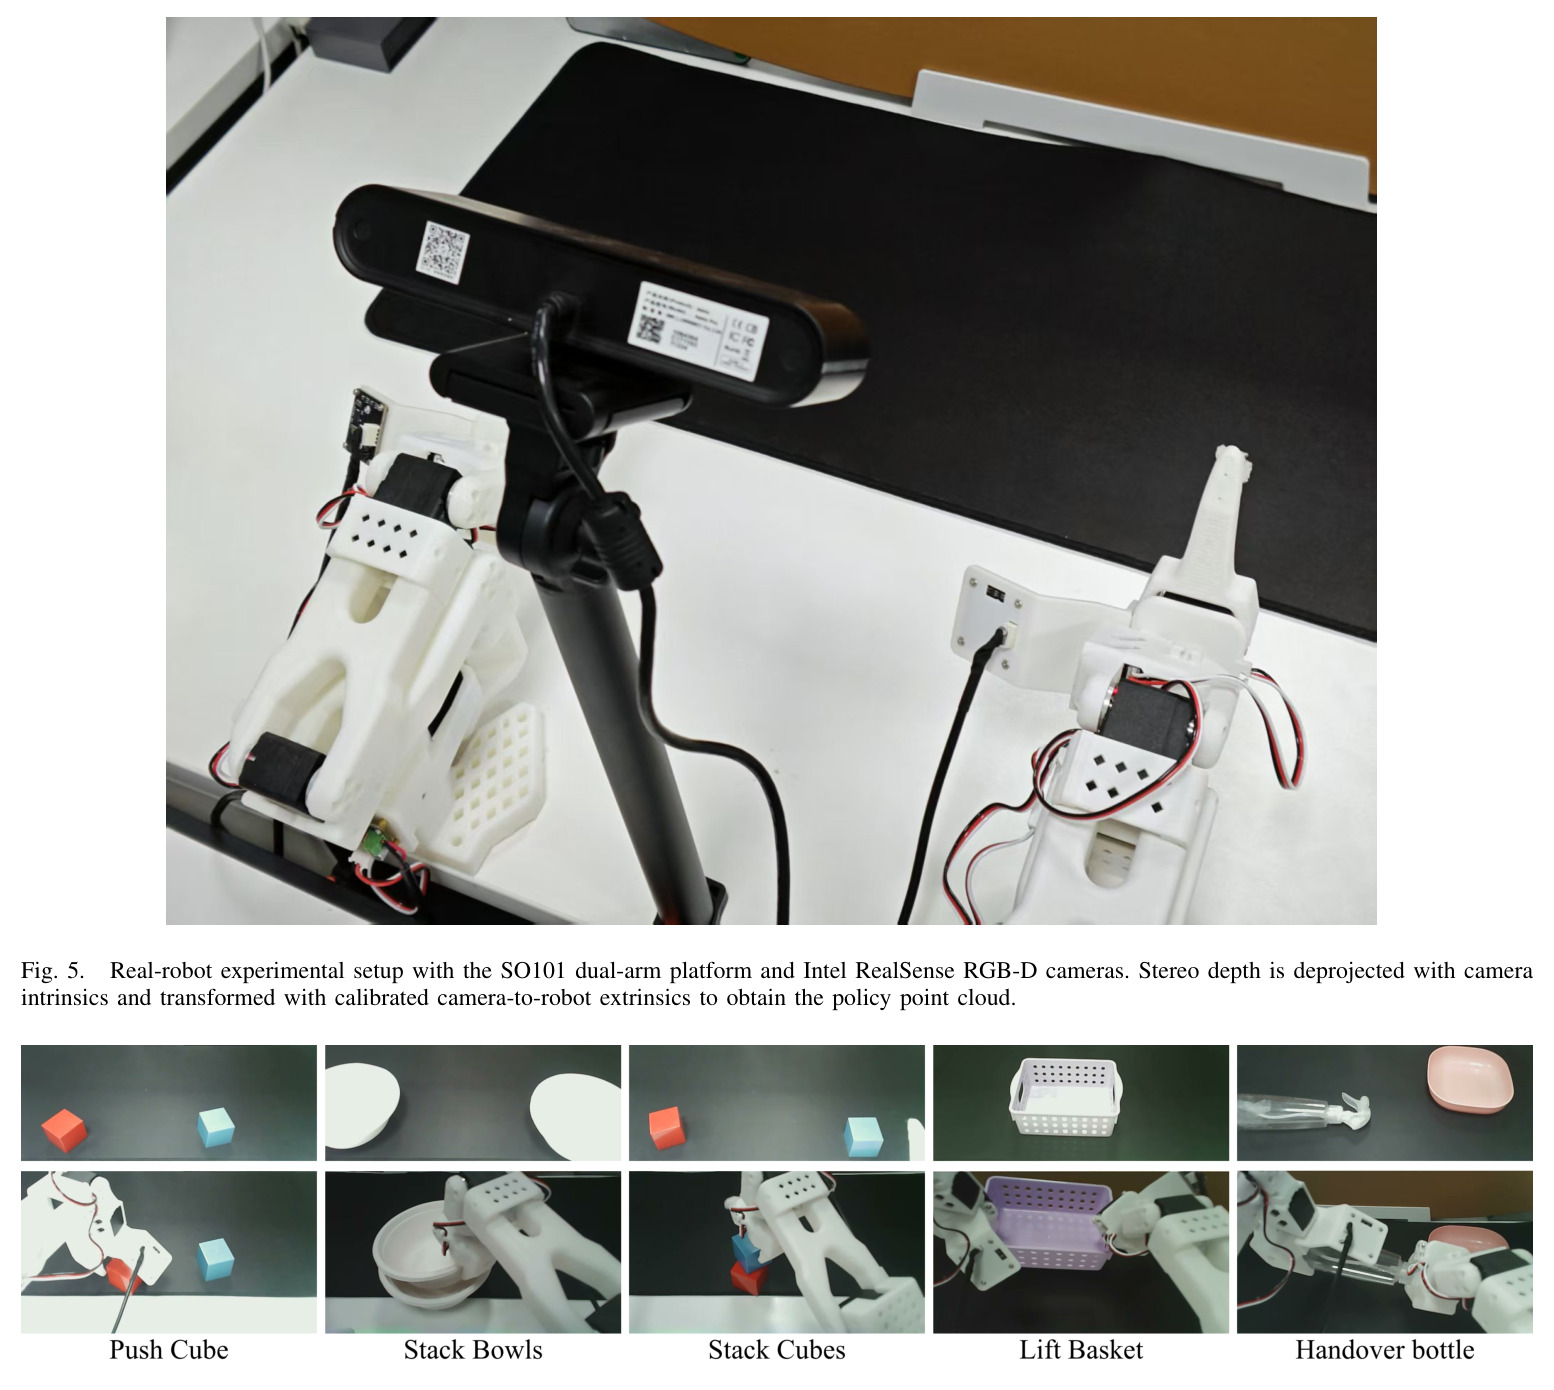
复现条件总体较好。代码已开源(github.com/zhangzhongbo2213/movement-trend-guidance);仿真数据全部由各基准模拟器生成,无需自采:RoboTwin2.0每任务50条演示、每任务100次评测,LIBERO-40每任务50条演示(stride-4时间子采样),DexArt每任务100条演示;真机使用开源SO101双臂平台加Intel RealSense RGB-D相机,立体深度经标定内参反投影、外参变换到机器人坐标系,LeRobot遥操作每任务采50条演示、每任务20次评测。算力方面为单张RTX 4090(推理batch为1、10步DDIM),优化器AdamW、学习率 $1.0\times10^{-4}$,RoboTwin与DexArt训练3000 epochs、LIBERO训练1000 epochs。模型仅比DP3多9.23M参数(+3.52%),推理延迟50.28ms到50.90ms(+1.23%),训练开销与DP3基本相当。主要难点:LIBERO评测量大(每个checkpoint需6000次评测、评测10个checkpoint);需严格复现各基准官方协议与真机点云标定流程;部分设计(偏移集合、负门偏置、仅瓶颈注入)的敏感性未完整给出选择指引。总体复现难度中等偏低,适合作为跟进研究的基线。
论文图表
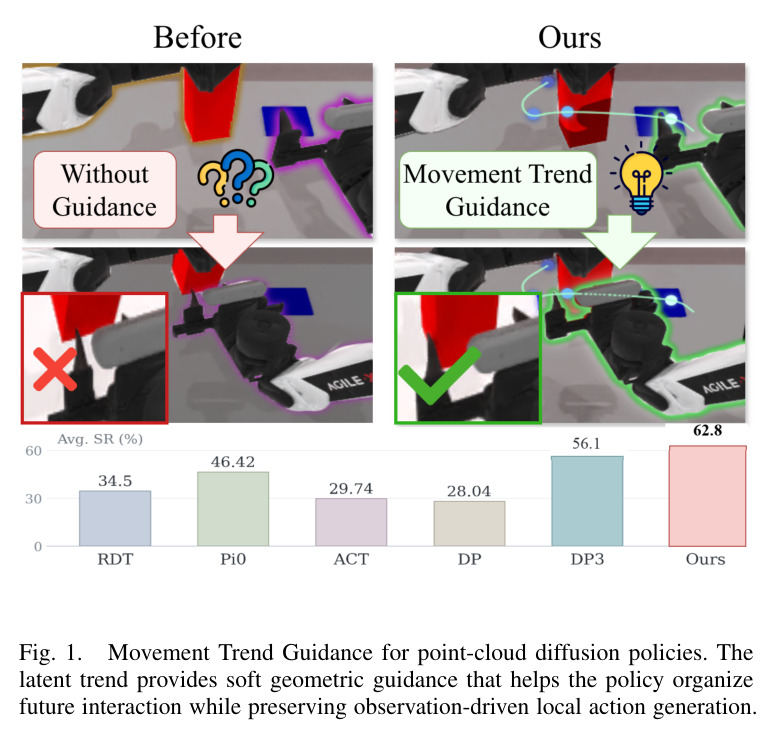
概念示意图:从短观测历史中学习一个隐式趋势表征,作为软几何引导帮助策略组织未来交互,同时保持由当前观测驱动的局部动作生成。
一图概括全文核心思想——前瞻以'隐式趋势潜变量'而非显式轨迹的形式提供,是理解论文动机的最快入口。
五个真机任务(推方块、叠碗、叠方块、提篮、递瓶)的操作过程演示序列,展示双臂在接触、传递、堆叠等阶段的实际执行情况。
给出真机任务的直观场景与执行质量,帮助读者判断72.0%对49.0%的提升发生在怎样的物理交互中。
RoboTwin2.0七大类别成功率对比:官方设定下Ours 61.7%对DP3 55.2%,并领先RDT 34.5%、π0 46.4%、ACT 29.7%、DP 28.0%;五十任务混合训练中Ours* 62.8%对DP3* 56.1%,其中双手传递94.0%、铰接交互80.0%、多物体堆叠48.3%提升最明显。
主结果表,同时覆盖官方对照与受控混合训练对照,是评估本文方法整体水平与各类别增益分布的核心证据。
LIBERO-40四套件epoch-1000结果:Spatial 58.20%对26.40%(+31.80)、Object 93.53%对67.53%(+26.00)、Goal 77.53%对8.73%(+68.80)、LIBERO-10 58.47%对45.67%(+12.80),整体71.93%±0.49%对37.08%±1.21%(+34.85),每套件1500次评测、共6000次。
最大幅度的改进证据,尤其LIBERO-Goal近9倍的提升直接说明'前瞻'对多阶段长程任务的决定性作用,且多种子标准差很小。
DexArt四任务(水龙头、笔记本、马桶、水桶)对比:Ours平均59.25%(41/87/76/33),高于VITA 55.3%、FreqPolicy 54.3%、DP3 52.0%、SimpleDP3 47.5%等全部对比方法,比DP3高7.25点。
证明方法在机器人形态、任务结构、物体类别都不同的铰接物体灵巧操作环境中的泛化性,是对RoboTwin2.0结论的独立验证。
SO101真机五任务成功率:Ours平均72.0%(推方块75、叠碗75、叠方块85、提篮45、递瓶80),显著高于DP3的49.0%、SimpleDP3的43.0%、DP的33.0%,其中叠碗与递瓶任务提升最大。
证明增益能从仿真迁移到真实物理系统(含点云标定误差与真实动力学),是方法实用性的关键证据。
LIBERO-40引导构造消融:完整方法71.93%±0.49%;参数匹配但无未来损失的隐变量变体仅44.87%±0.33%(比DP3只高7.79点);把5/10/15/20偏移的未来点直接嵌入条件的显式条件化变体为65.28%±0.19%。
本文最重要的科学证据:分离'额外容量''未来监督''塑形vs条件化'三个因素,证明增益主要来自未来监督的表征塑形而非容量或信息本身。
六任务ACT迁移验证:ACT平均24.00%提升到ACT+Trend的51.67%(+27.67),其中stack_bowls_two 25到73(+48)、move_can_pot 22到67(+45)、place_cans_plasticbox 16到48(+32)、click_alarmclock 32到63(+31),仅hanging_mug小幅提升(7到10)。
证明运动趋势条件不是扩散UNet特有的技巧,对transformer基线同样有效,支持方法的潜在通用性(但作者谨慎限定于所测设置)。
五十个任务的逐任务成功率全表:Ours*在38/50任务上超过DP3*,单任务极端案例如rotate_QRcode 40到77、shake_bottle系列达到100%、handover_mic 95到100;同时暴露短板如place_mouse_pad 5%、stack_blocks_three 3%、blocks_Ranking_RGB 5%等仍接近失败。
提供最细粒度的证据:既能看到改进的广度(38/50),也能定位失败集中区(遮挡、精细放置、颜色排序),是分析方法适用边界的第一手数据。
DP3在LIBERO-40上epoch 100至1000每个checkpoint的四套件成绩:整体从1.88%缓慢爬升到37.08%,LIBERO-Goal始终低于10%,显示基线在多阶段任务上学习极其困难。
与Table IX对照构成完整的训练动态对比,说明DP3的失败不是训练不充分而是结构性缺陷,本文方法恰好补上这一缺陷。
本文方法在LIBERO-40上的逐checkpoint成绩:epoch 100已达24.08%,epoch 300即69.55%,此后10个checkpoint稳定在71%至72.67%区间,各套件同步快速收敛。
展示方法不仅终点高而且收敛快3倍以上(epoch 300超过基线终点),对未来监督加速表征学习的机制提供了间接证据。
引导构造消融的逐任务明细:平均而言DP3* 56.1%、Ours* 62.8%、去门控57.1%、扩散预测器57.3%、去输入归一化58.6%;逐任务可见部分任务对特定组件更敏感,如rotate_QRcode在去门控时从77跌到52、open_microwave在扩散预测器下反而达94。
揭示消融结论的任务级异质性:平均值之外,个别任务对组件的依赖方向相反,提示组件贡献并非在所有任务上同质。
偏移配置逐任务消融:各配置平均56.6%(7偏移)、55.4%(短程2/4/6/8)、57.4%(长程20/30/40/50)、55.8%(2偏移)、54.9%(单近{5})、55.2%(单远{30}),均低于默认{5,10,15,20}的62.8%;长程在handover_mic上暴跌至66但部分长程任务受益。
支撑'默认偏移在近期接触相关性与长程运动方向间取得最佳平衡'的论断,同时显示偏移选择存在任务间的权衡,为自适应偏移研究提供数据。
注入方式逐任务消融:瓶颈限定门控FiLM 62.8%、全块FiLM 55.8%、交叉注意力52.9%(低于DP3*基线56.1%);交叉注意力在adjust_bottle上甚至跌至0%,而handover_block上反而达98%,呈现极端的任务级方差。
'保守注入'结论的最直接证据:让高层趋势主导浅层局部精化(全块)或强耦合(交叉注意力)都会损害性能,该表对设计条件注入方式有普遍参考价值。