DexForesight:用隐式空间前瞻锚定灵巧操作策略 DexForesight: Grounding Dexterous Policies with Implicit Spatial Foresight
训练时用动作条件化世界模型教策略预知手与场景动态,部署时只留策略本体
前置知识
世界动作模型(WAM, World Action Model)
一类把"预测未来"与"动作生成"耦合的机器人学习框架:模型在给定当前观测与动作序列的条件下,同时生成未来图像、视频或状态,用这些预测指导动作选择或规划。代表工作如 Cosmos3(推理时联合生成未来视频与动作)、Fast-WAM(训练时预测、推理时跳过未来生成)、WLA(用 World Expert 做未来预测)。
本文的出发点正是 WAM 的两个痛点——部署依赖在线深度重建、每个控制步显式生成未来开销大;理解 WAM 才能明白"隐式前瞻"到底改了什么。
VLA(视觉-语言-动作)策略
以预训练视觉-语言模型(VLM)为骨干的机器人策略,输入图像、语言指令与机器人状态,直接输出动作块(action chunk),代表如 π0.5 与 GR00T N1.7。本文仿真实验把方法挂在 GR00T N1.7 上,真机策略基于 QwenVLA(在约 370 小时自采语料上预训练),世界模型骨干则从 RynnBrain 初始化。
DexForesight 是"即插即用"增强某个 VLA 骨干的方法,读实验前必须知道它在每个平台上分别增强的是哪个骨干。
前向运动学与 URDF
URDF 是机器人的链式刚体描述文件,记录每个连杆的几何与关节连接关系。前向运动学(FK)根据关节角度计算连杆上任意固定点在机器人基座坐标系下的 3D 位置。本文在 URDF 链接上采样 M 个持久锚点,用记录的关节状态经 FK 算出手指表面点云,因此无需相机即可定位被遮挡手指的位置。
手流预测目标 $F_{t,k}$ 完全建立在 FK 锚点之上,这是"监督被遮挡手指"这一核心卖点的技术基础。
表征级对齐(知识蒸馏的隐式形式)
知识蒸馏把教师模型的输出或中间表征迁移给学生;表征级对齐不拷贝 logits,而是让学生中间特征与教师特征在余弦相似度或分布结构上匹配。本文的对齐还额外匹配查询之间的成对相似度矩阵 $K = \bar{Z}\bar{Z}^{\top}$,即保留教师表征的"关系几何",而不只是逐点回归每个特征向量。
查询对齐是把世界模型知识送进策略隐空间的唯一通道,公式 (5) 的 token 损失与 relation 损失是全文方法的灵魂。
DINOv3 特征
DINOv3 是自监督预训练的视觉基础模型,其特征对物体形状、几何与语义变化敏感。本文的视觉动力学专家不预测未来像素,而预测 DINOv3 特征残差 $\Delta V_{t,k} = \Phi(I_{t+\delta_k}) - \Phi(I_t)$,即在冻结特征空间中度量"场景如何随动作变化",回避了重建纹理、背景等与决策无关的外观细节。
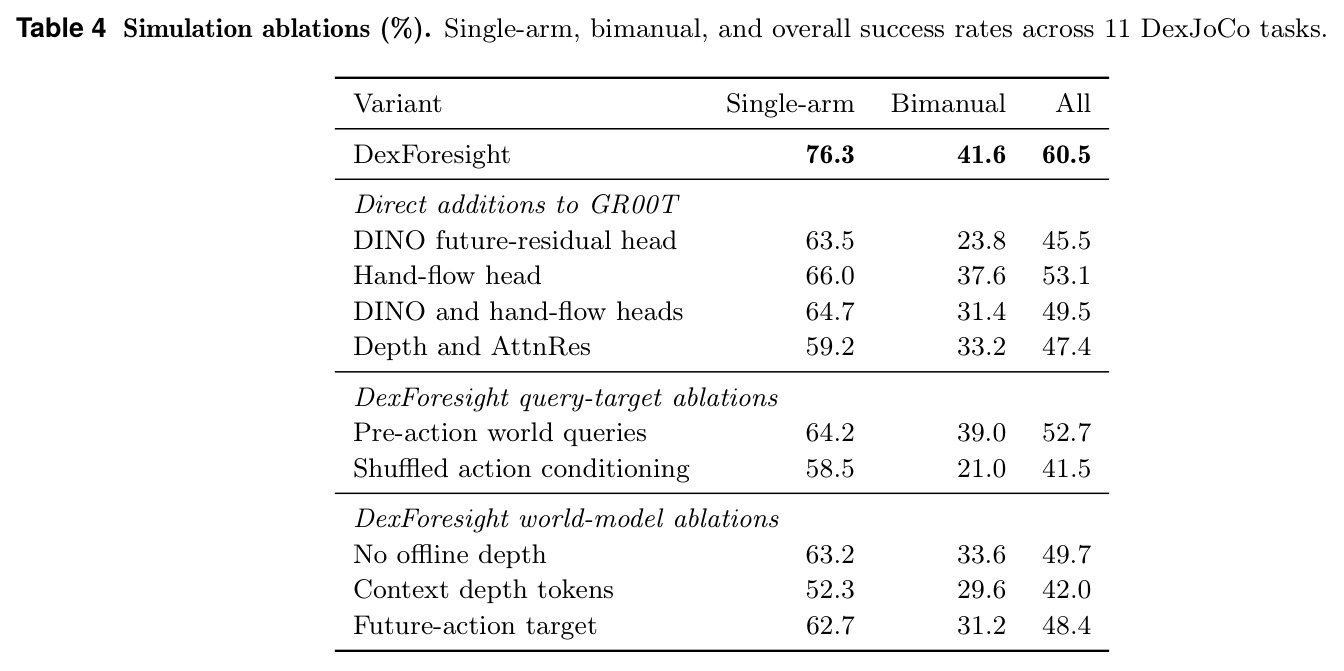
理解"预测特征变化而非像素"这一设计取舍,是看懂消融表中 DINO future-residual head 一行为什么只有 45.5% 的前提。
研究动机
灵巧手操作要求策略具备空间前瞻(spatial foresight):抓握时多根手指要绕开物体表面运动,而 16-22 自由度的灵巧手在相机视野中经常部分被遮挡,仅看当前画面无法推断手指真实状态,必须预知"动作会如何改变手-场景构型"。现有世界动作模型(WAM)通过显式预测未来来获得这种知识,但落到灵巧操作上有两大障碍。其一,预测所需的空间信息超出可见表面:即使场景深度估计准确,被遮挡的手指仍然不可见,只有机器人自身运动学模型与关节状态才能补全;而把在线深度重建塞进部署管线又带来计算开销和时间一致性难题——手与物体持续运动时,深度视频必须逐帧保持稳定。其二,推理时先"想象"未来再决策的 WAM 设计代价高昂:论文实测 Cosmos3 生成 16 帧未来视频需要 930 毫秒,而常规策略推理仅约 227 毫秒,慢了 4 倍以上,且未来图像中的纹理、背景等外观细节对动作选择帮助有限。
本文的目标是本文的目标是把动作条件化的空间前瞻能力"教"给策略,但把世界模型彻底留在训练阶段:训练时用离线场景深度(真机由 StereoAnyVideo 从双目示范序列估计,仿真由 MuJoCo 直接渲染)、URDF 手部几何与示范轨迹训练一个空间世界模型,让它联合预测手部锚点的 3D 运动和视觉特征变化;随后冻结世界模型,通过查询对齐把其预测表征迁移进策略隐空间,用对齐后的特征条件化动作生成。部署时只保留策略本体,输入仅为当前 RGB、语言指令和机器人状态,不执行世界模型、不做在线深度重建、不解码任何未来输出,且推理时延几乎不变(230.4ms 对比 QwenVLA 的 227.4ms,仅增加 3.0ms)。量化目标是在 11 个 DexJoCo 仿真任务和 3 个真机灵巧任务上同时超越 VLA 基线与显式预测式 WAM。
与已有工作不同的是,本文抓住两个被忽视的点。第一,预测知识不必通过显式未来生成来使用:对动作选择真正关键的是"动作如何改变手-场景构型",而非重建出完整的未来画面,因此可以只在训练时运行世界模型、部署时彻底删除,这与 Cosmos3、WLA 等推理时生成未来的路线形成鲜明对照。第二,灵巧手前瞻的监督信号应当"具身感知"(embodiment-aware):以往空间接地方法(如 Spatial Forcing 对齐预训练 3D 基础模型的表征、ReconVLA 辅助重建)关注的是静态场景几何,而本文把离线深度(管场景)与机器人运动学(管手指,天然覆盖相机看不见的手指)组合成动作条件化的动态预测目标。此外,深度只作为训练时的条件输入——注入的是当前几何,预测目标不需要未来时间步的深度标签——从设计上就把重建从部署依赖中剥离,这比"部署时用估计深度"的方案在工程上干净得多。
核心方法
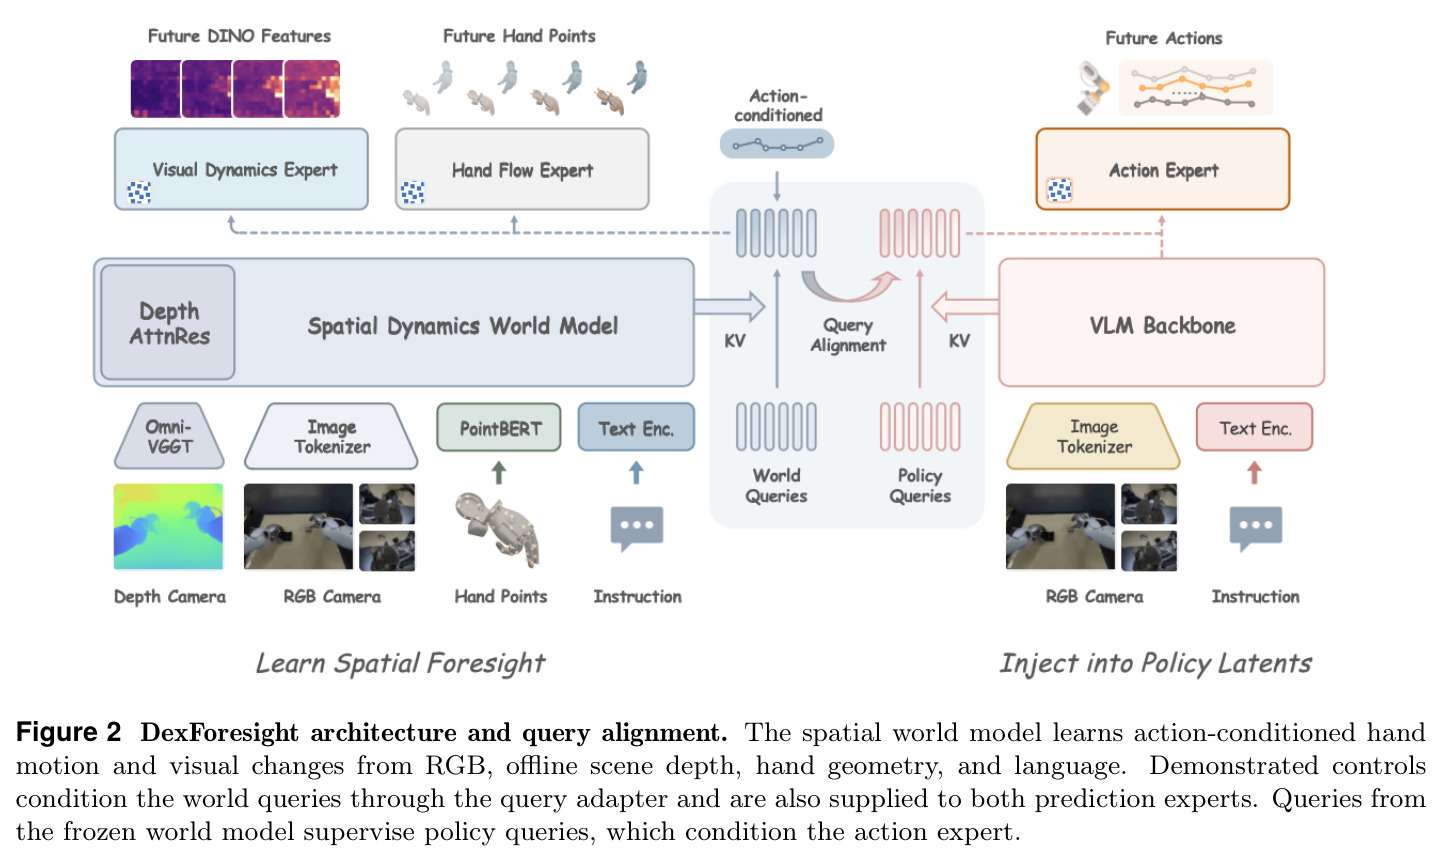
直觉:学徒先观察老师傅如何预判工件和手势的走向,把这种预判内化成自己的直觉,之后独自干活时不再需要老师在场。技术路线分两步。第一步训练动作条件化空间世界模型:骨干从 RynnBrain 初始化,输入多视角 RGB、语言、机器人状态历史与手部几何(在 URDF 链接上采样的持久点云经前向运动学变换,由 Point-BERT 编码);离线深度经 OmniVGGT 编码为几何 token,在骨干第 $W=\{2,6,10,14,18,22,26\}$ 层后用交叉注意力注入,并按 Attention Residual 原则用 token 级路由器在第 $R=\{4,8,12,16,20,24,28\}$ 层聚合各注入层输出。$N$ 个可学习世界查询读取第 12/20/28 层隐藏态,经动作条件适配器接收示范控制($K=4$ 个时隙,在 16 帧未来窗口的四个四帧区间各采样一个偏移 $\delta_k$),条件化手流专家与视觉动力学专家。第二步冻结世界模型,让策略查询去对齐冻结的世界查询,对齐后的策略查询拼接进动作专家上下文生成动作块;部署时只跑策略。
核心创新是把"空间前瞻"从部署时的显式未来生成,重构为训练时的隐式表征迁移。已有 WAM(Cosmos3 推理时生成未来视频、WLA 挂 World Expert、Fast-WAM 推理时虽跳过未来生成但仍执行世界模型)都把预测能力放在部署链路里;DexForesight 的世界模型训练完即冻结,仅作"教师"提供查询级监督,策略从不执行它。对齐不只逐 token 匹配,还保留教师查询间的相似度结构:$$\mathcal{L}_{\text{policy}} = \mathcal{L}_{\text{action}} + \lambda_{\text{align}} \mathcal{L}_{\text{token}} + \beta \mathcal{L}_{\text{relation}}$$ 其中 $\mathcal{L}_{\text{token}} = \sum_{i=1}^{N} (1 - \langle \bar{z}^{\pi}_i, \bar{z}^{w}_i \rangle)$ 逐个匹配查询,$\mathcal{L}_{\text{relation}} = \|K^{\pi} - K^{w}\|_F^2 / (2N)$ 匹配成对余弦相似度矩阵 $K = \bar{Z}\bar{Z}^{\top}$。另一独特点是持久手锚点流目标:锚点固定在 URDF 链接上跨帧保持对应,$F_{t,k} = P_{t+\delta_k} - P_t$ 是逐点位移而非整体末端位移,强迫表征编码每根手指连杆如何演化,且经前向运动学覆盖被遮挡手指。示范动作 $U_t$ 只是世界模型的训练期条件(消歧该建模哪个未来),策略从不接收它,因此对齐是辅助目标而非对教师的精确重建。
方法步骤详情
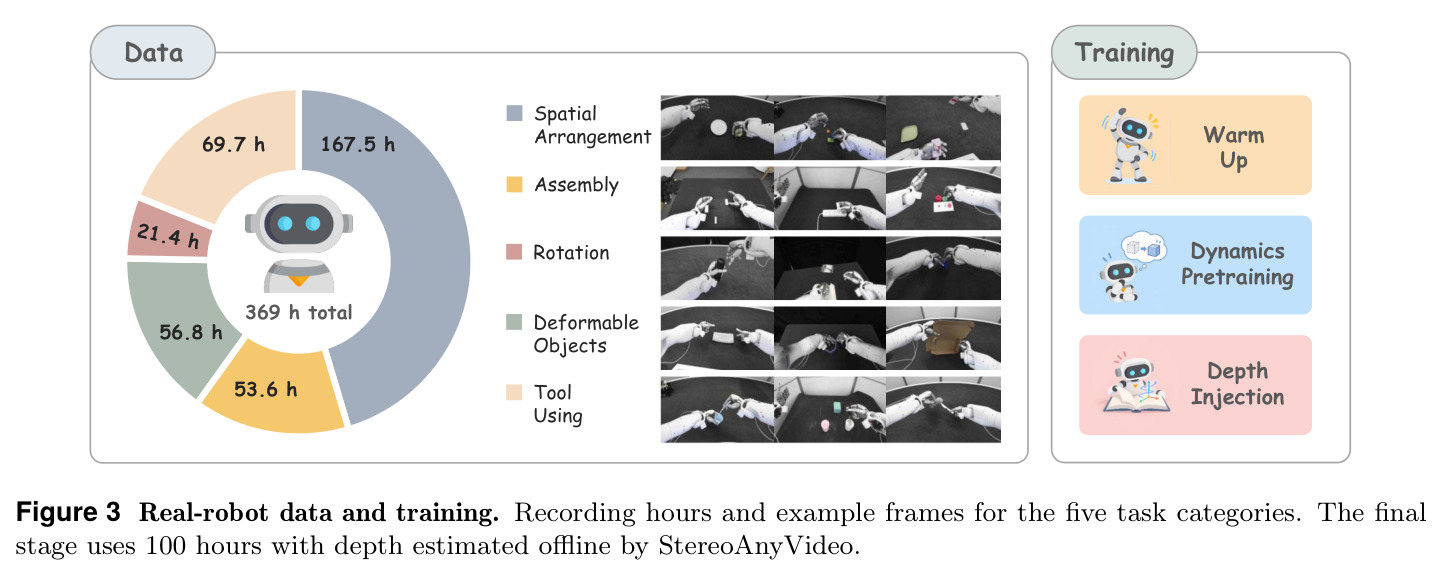
(1) 数据准备:约 370 小时、60 任务、五大类别真机示范(空间布置 69.7h、装配 167.5h、旋转 56.8h、可变形物体、工具使用 53.6h);对覆盖真机评测三类的 100 小时子集用 StereoAnyVideo 离线估计深度;在 URDF 链接上采样 $M$ 个持久手部锚点,用记录的关节状态经前向运动学得到基座系点云。(2) 世界模型三阶段训练:warmup 联合优化预训练骨干与新预测模块;动力学预训练仅用 RGB+语言+手/状态历史(无深度)学动作条件化交互动力学;深度注入阶段在 100 小时子集上用冻结的 OmniVGGT 提几何特征、可学习融合模块注入骨干。预测目标 $\mathcal{L}_{\text{world}} = \mathcal{L}_{\text{hand}} + \lambda_v \mathcal{L}_{\text{visual}} + \lambda_c \mathcal{L}_{\text{context}}$,两专家预测加噪目标并以 Smooth L1 约束恢复的干净目标,未来视野 dropout 采样前缀长度 $h \in \{1,\dots,K\}$。(3) 策略训练:冻结世界模型,新增 $N$ 个策略查询读取 VLM 隐藏层,经学习投影映射到世界查询空间做对齐;策略查询经 $W_{\text{act}}$ 投影后拼接进动作专家上下文 $\tilde{C}_t = [C_t; Z^{\pi}_t W_{\text{act}}]$。仿真基于 GR00T N1.7,真机基于 370 小时语料预训练的 QwenVLA,每任务微调 30 epoch。(4) 部署:删除世界模型、深度编码器、手几何编码器与两个预测专家,仅保留查询读取器与上下文投影,每次观测只算一次上下文并在动作采样间复用,实测推理 230.4ms。
技术新颖性
与相关工作的具体区别:(1) Spatial Forcing 对齐预训练 3D 基础模型的表征,提升的是静态场景几何感知;本文对齐的是动作条件化的动态预测表征,且监督信号具身感知(来自机器人自身运动学),能覆盖被遮挡手指。(2) EgoWAM 用 3D 光流做预测目标但面向人机共训;本文用持久手锚点流,在铰接运动中保持逐点对应关系。(3) ReconVLA 用辅助重建提升空间感知,需要解码像素;本文预测 DINOv3 特征残差,不解码任何图像。(4) Fast-WAM 虽在推理时跳过未来生成,但世界模型仍在链路中;本文部署时连世界模型执行都没有,知识转移完全发生在训练期。(5) 深度注入采用交叉注意力加 Attention Residual 式 token 级路由:$M_j = H_j + \gamma_j \mathrm{CA}_j(H_j, E_t)$,小初始化的残差尺度 $\gamma_j$ 保证初始化时接近预训练计算;消融显示这比把深度 token 直接拼进上下文高 18.5 个百分点(60.5% 对 42.0%),说明"如何注入几何"本身是被低估的设计变量。
实验结果
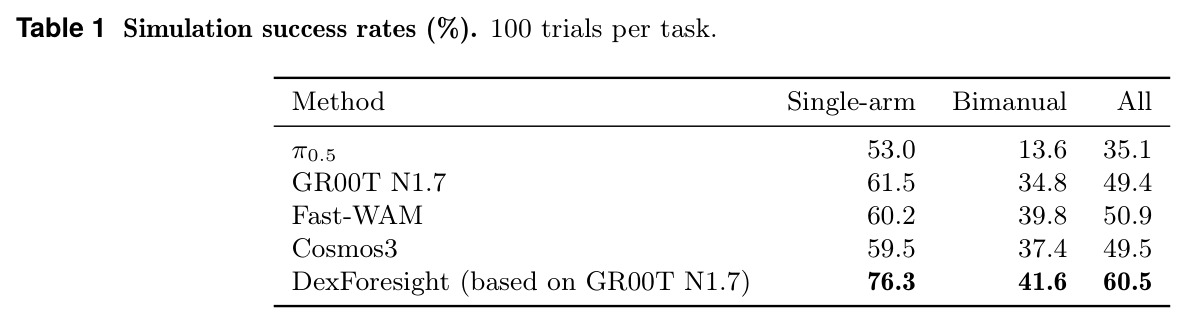
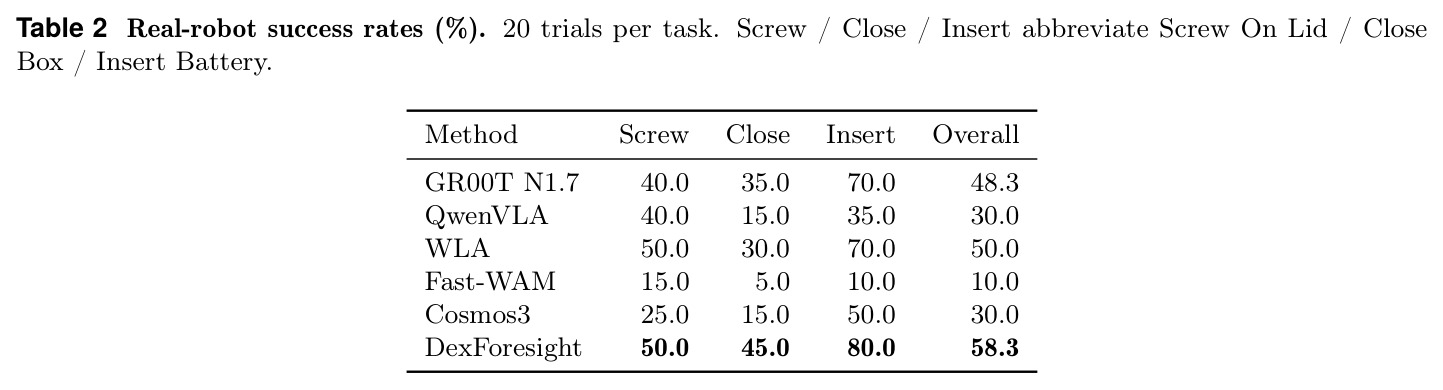
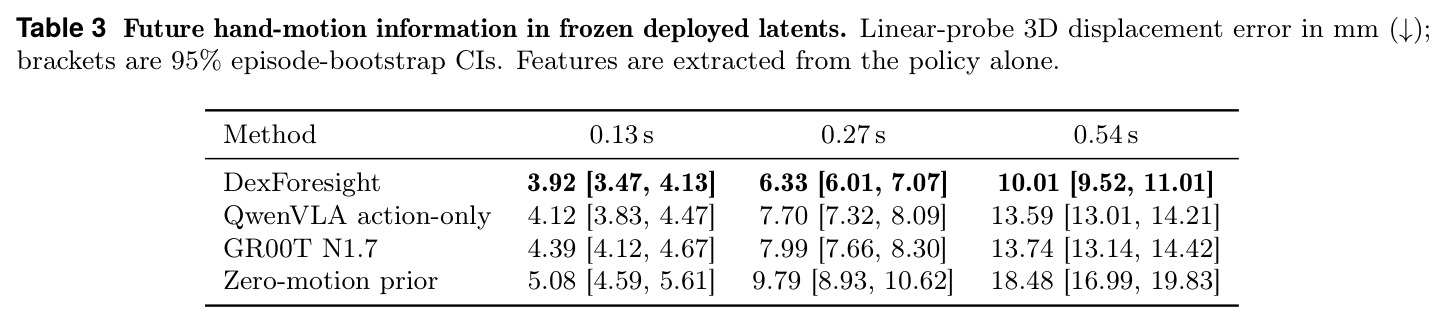
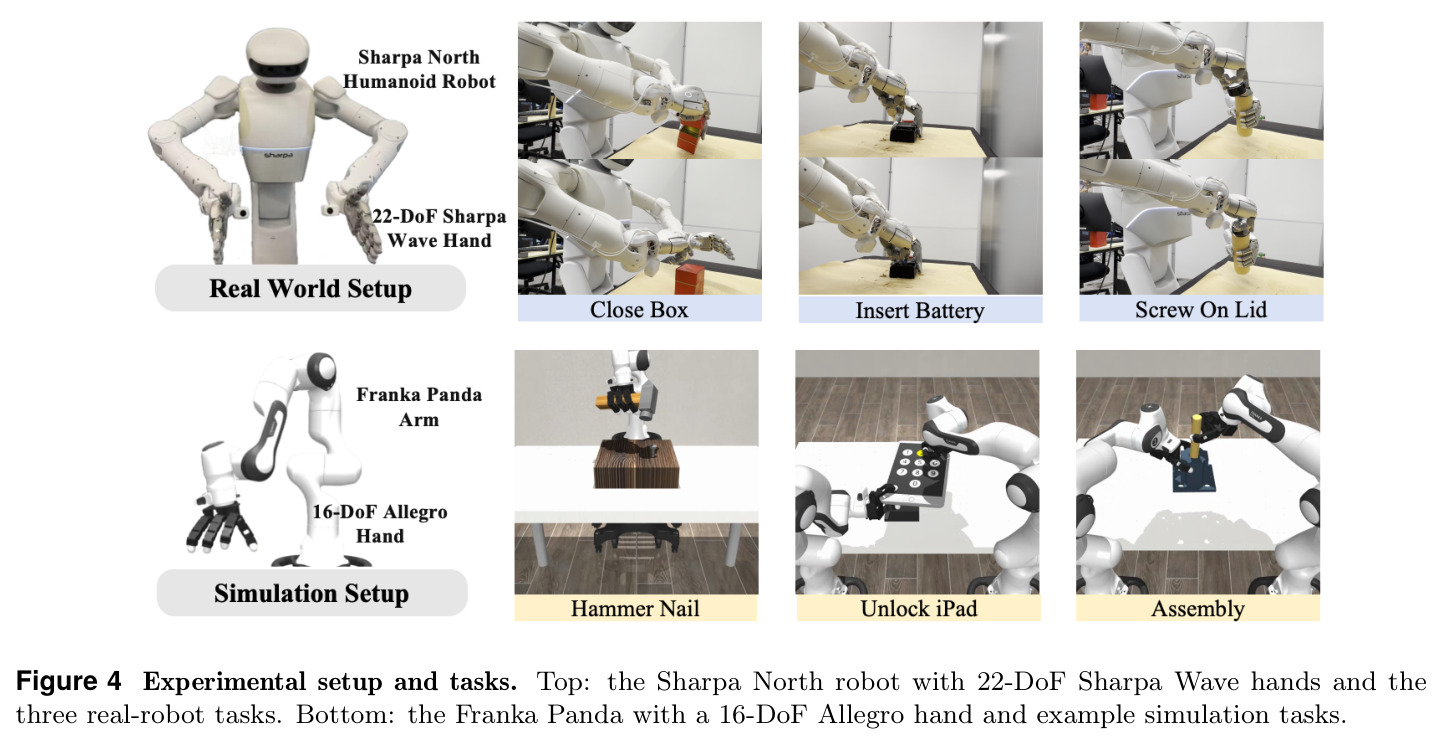
逐项看数据。仿真:11 个 DexJoCo 任务、每任务 100 次试验,DexForesight(基于 GR00T N1.7)总成功率 60.5%(单臂 76.3%、双臂 41.6%),比最强基线 Fast-WAM 的 50.9% 高 9.6 点,比自身骨干 GR00T N1.7 的 49.4% 高 11.1 点;Cosmos3 为 49.5%、π0.5 仅 35.1%,且两个组别均第一。真机:Sharpa North 配 22 自由度 Sharpa Wave 手,Close Box / Insert Battery / Screw On Lid 三任务各 20 次试验(held-out 物体位置),DexForesight 58.3%(Screw 50.0、Close 45.0、Insert 80.0),高于 WLA 50.0%、GR00T N1.7 48.3%、Cosmos3 与 QwenVLA 各 30.0%、Fast-WAM 10.0%。成本:推理 230.4ms,仅比 QwenVLA 的 227.4ms 多 3.0ms(1.3%),而 Cosmos3 仅视频生成就需 930ms。RQ2 表征探针:冻结部署特征训练线性 ridge 探针预测 0.13/0.27/0.54s 后的 3D 手点位移,DexForesight 误差 3.92/6.33/10.01mm,架构同构的 QwenVLA action-only 为 4.12/7.70/13.59mm,GR00T N1.7 为 4.39/7.99/13.74mm,零运动先验 5.08/9.79/18.48mm;0.54s 处误差降低 26.3% 且差距随时程拉大,证明预测信息在删除世界模型后仍线性可及。迁移 vs 直接预测:在 GR00T 上直接加 DINO 残差头 45.5%、手流头 53.1%、双头 49.5%、深度+AttnRes 47.4%,均低于查询对齐的 60.5%;教师目标消融:无动作条件的 pre-action 查询 52.7%,打乱条件动作暴跌到 41.5%(低于骨干),未来动作目标替代手运动仅 48.4%。RQ3:去掉离线深度,仿真降 10.8 点(60.5→49.7),真机降 15.0 点(58.3→43.3,Screw 35.0、Close 25.0、Insert 70.0);上下文深度 token 版本仅 42.0%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 11 个 DexJoCo 仿真任务(每任务 100 试验) | 任务成功率 (%) | DexForesight 60.5(单臂 76.3 / 双臂 41.6) | Fast-WAM 50.9;GR00T N1.7 49.4;Cosmos3 49.5;π0.5 35.1 | 较最强基线 +9.6 点,较自身骨干 +11.1 点 |
| 真机三任务(Close Box / Insert Battery / Screw On Lid,各 20 试验) | 任务成功率 (%) | DexForesight 58.3(Screw 50.0 / Close 45.0 / Insert 80.0) | WLA 50.0;GR00T N1.7 48.3;Cosmos3 30.0;QwenVLA 30.0;Fast-WAM 10.0 | 较最强基线 +8.3 点 |
| 部署策略推理时延(真机,同硬件) | 单次推理时间 (ms) | DexForesight 230.4 | QwenVLA 227.4;Cosmos3 视频生成 930 | 仅 +3.0ms(1.3%),比显式生成未来快 4 倍以上 |
| 冻结部署特征的线性探针:未来 3D 手点位移 | 位移误差 (mm),0.13/0.27/0.54s | 3.92 / 6.33 / 10.01 | QwenVLA action-only 4.12 / 7.70 / 13.59;GR00T N1.7 4.39 / 7.99 / 13.74;零运动先验 5.08 / 9.79 / 18.48 | 0.54s 处误差降低 26.3% |
| 仿真消融:直接在 GR00T 上加预测头 | 总成功率 (%) | 查询对齐 60.5 | 手流头 53.1;DINO+手流双头 49.5;深度+AttnRes 47.4;DINO 残差头 45.5 | 较最强直接预测控制 +7.4 点 |
| 真机消融:去除离线深度 | 总成功率 (%) | 43.3(Screw 35.0 / Close 25.0 / Insert 70.0) | 完整 DexForesight 58.3 | 深度贡献 +15.0 点 |
局限与改进
作者承认的:WLA 与 Fast-WAM 属于外部对照,架构与训练差异使其不能当作单变量因果控制;真机每任务仅 20 次试验,失败集中在预期的空间挑战(Screw 的手指遮挡、Insert 的物体部分遮挡、Close 的盖-盒几何),即使最好的方法也只有 50%-80% 成功。我的补充观察:(1) 统计功效不足,8-10 个百分点的差异在 20 次试验下置信区间很宽,主表未报告区间(探针实验反而做了 95% bootstrap CI);(2) 离线深度只覆盖 100 小时子集且去深度后真机暴跌 15 点,说明教师质量强依赖 StereoAnyVideo 在该批数据上的深度质量,反光、透明或强遮挡场景的深度误差会传导给学生;(3) 方法假设有精确的 URDF 运动学与可靠关节状态读数,对软体手、欠驱动或标定不精的硬件不直接适用;(4) 仿真用 GR00T N1.7、真机用 QwenVLA,两个骨干上机制虽然都有效,但缺少同一骨干横跨仿真与真机的系统性对照;(5) 部署时无显式推理,对长时程或高速动力学任务(如抛接、快速穿线)是否足够未验证。
独立分析的弱点
(1) 学生上限受教师质量钳制:查询对齐逼近的是世界查询的表征,若世界模型对分布外动作预测错误,学生会继承系统性偏差,且教师预测没有显式的不确定性度量供学生参考;改进方向是引入不确定性加权对齐,或训练多个异构教师取其一致区域。(2) 离线深度是隐性重资产:100 小时双目序列的 StereoAnyVideo 估计耗时与存储成本论文未报告,且深度绑定固定相机位姿,换机位需重跑整个离线管线;改进方向是改用单目深度基础模型,或完全绕开深度、仅用接触一致性与手运动学自监督学习几何。(3) 评测规模偏小:真机 20 试验/任务难以支撑 8 点级差异的显著性结论,且主表未做 bootstrap;改进是每任务至少 50 试验并统一报告 95% bootstrap CI。(4) 手锚点假设 URDF 精确:若存在标定误差或手指柔顺形变,锚点会偏离真实手表面,手流目标随之失真;改进是结合触觉读数或在线点云配准校正锚点位置。(5) 语言指令侧信息缺失:60 任务语料的指令多样性与模板化程度未披露,指令泛化能力存疑;改进是报告指令分布并加入改写指令的鲁棒性评测。
未来方向
作者方向:把框架推广到更多 VLA 骨干与更大规模语料;五大类别中可变形物体与工具使用尚未进入真机深度注入阶段,补全后教师可覆盖更丰富的动力学形态。可延伸方向:(1) 用策略查询与世界查询的偏离度做在线置信度估计或分布外检测——推理时把策略自身预测的动作回灌保留的教师副本,比较两组查询的相似度,可低成本预警危险动作;(2) 把视觉动力学专家从手锚点扩展到场景级点流,覆盖被操作物体的运动,逼近完整 3D 场景流预测;(3) 与强化学习结合:对齐后的前瞻表征可作 RL 的观测增强或用于 reward shaping,让"预知手指轨迹"直接进入优化信号;(4) 学生部署回收的数据回流再训练教师,形成师生迭代闭环;(5) Attention Residual 式多模态路由可推广到触觉、力/力矩等模态的注入;(6) 理论层面量化"关系结构保持"($\mathcal{L}_{\text{relation}}$)与下游控制性能的联系,回答为什么保留查询间相似度几何比逐点回归更有效。
复现评估
项目页 dexforesight.github.io 已上线,但正文未见明确的开源代码、模型权重或 370 小时数据承诺。复现分级评估:仿真部分中等难度、可行性较高——DexJoCo 11 任务公开,深度可直接由 MuJoCo 渲染(无需 StereoAnyVideo),骨干 GR00T N1.7 有公开实现,是验证"查询对齐 + 手流目标是否有效"的最佳切入点;真机部分难度很高——需要 Sharpa North 级别的 22 自由度灵巧手平台、双目相机、约 370 小时跨 60 个任务的遥操作示范采集,以及 StereoAnyVideo、OmniVGGT、Point-BERT、DINOv3、RynnBrain、QwenVLA 等一长串第三方模型的版本对齐。算力上,世界模型三阶段训练加策略微调(真机每任务 30 epoch)估计需要多卡 A100 级别训练数天,100 小时深度离线估计本身也是不小的预处理开销。若目标是方法验证而非精确复刻,建议按论文 Table 4 的消融配置在仿真里复现关键数字(60.5% 对直接加预测头的约 45-53%),这一步最能检验核心主张。
论文图表
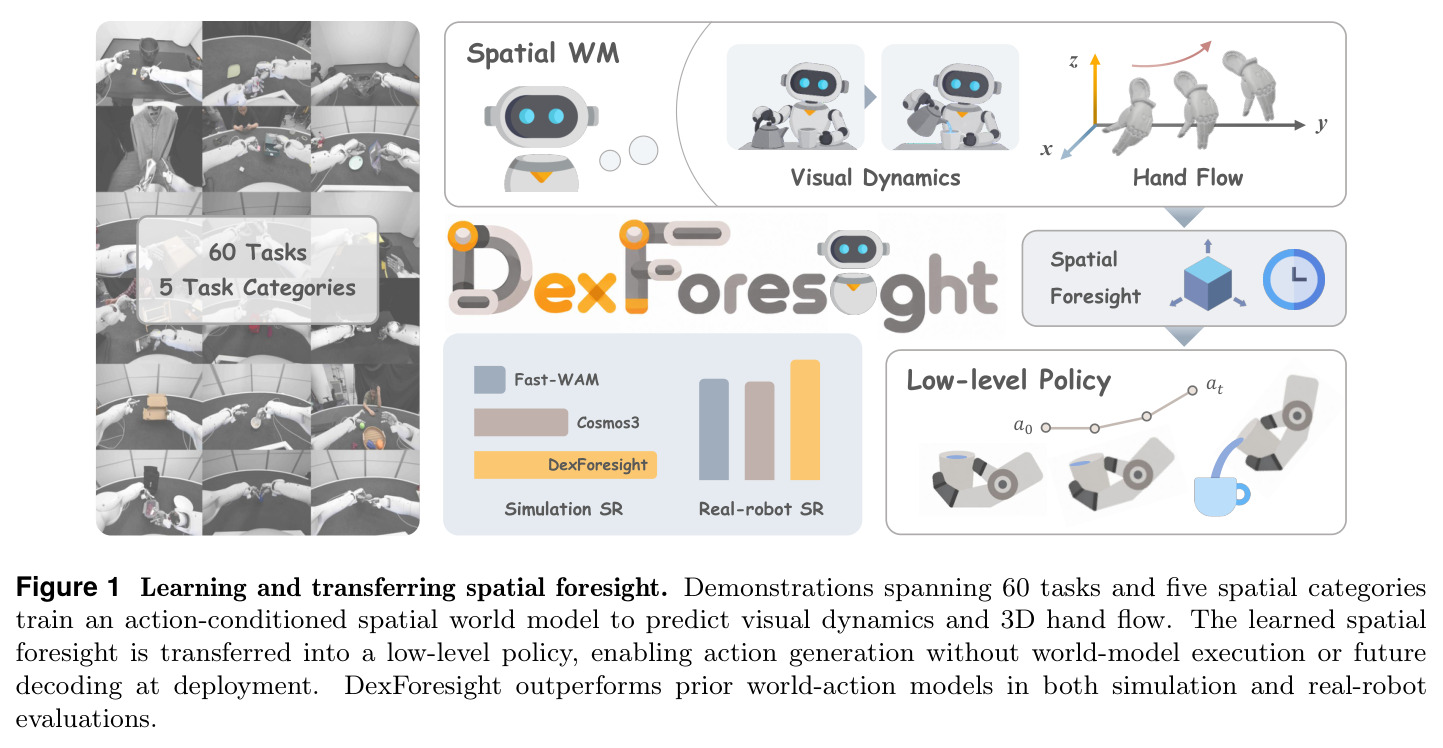
总览图:覆盖 60 个任务、五个空间类别的示范数据训练一个动作条件化的空间世界模型,联合预测视觉动力学与 3D 手流;学到的空间前瞻随后迁移进低层策略,部署时不执行世界模型、不解码未来。图下方对比 DexForesight 与先前世界动作模型(Fast-WAM、Cosmos3)在仿真与真机上的成功率。
一张图看懂论文的"训练时学预测、部署时只跑策略"两段式主张,是与显式预测式 WAM 划清界限的入口。