智能体先验引导的策略学习 Agent Priors-guided Policy Learning
用技能的结构先验同时塑形训练泛化并指导运行时技能选择组合
前置知识
扩散策略(Diffusion Policy)
将机器人策略表示为条件去噪扩散模型:给定观测历史,从高斯噪声出发迭代去噪,直接生成一段未来动作序列(action chunk)。训练时对演示动作加噪并预测噪声(epsilon-prediction),通常用一维 U-Net 实现,DDPM 训练、DDIM 采样。它能表达多峰动作分布、拟合精细接触操作,是近年少样本模仿学习的主流骨干。
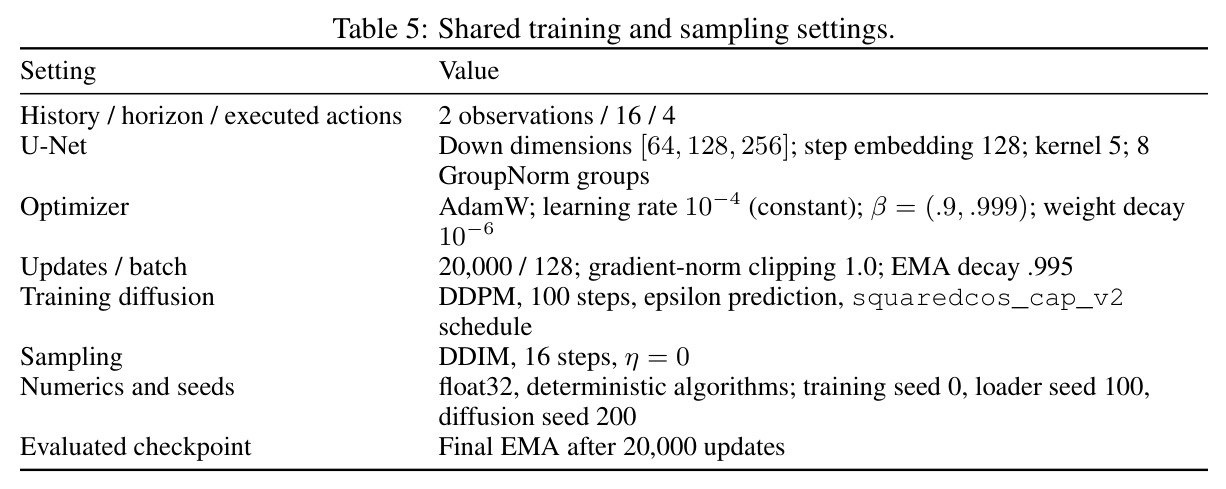
APPL 中所有技能策略与两条基线(B0、SinglePrior)都以条件 1D U-Net 扩散策略为骨干(Exp.1 每模型 20,000 步更新、预测 16 步执行前 4 步),先验正是通过改表示、改动作坐标系、加辅助损失作用在这一骨干上,不懂扩散策略就读不懂先验的"训练实现"。
结构先验(归纳偏置)
对"行为依赖哪些关系"的显式假设,例如抓取只依赖夹爪相对物体的位姿,与物体在世界坐标系的绝对位置无关。实现上可把动作或观测变换到物体坐标系 $x_{loc}=R_t^\top(x_{world}-p_t)$,也可设计等变网络或辅助损失。先验决定策略在演示之外的泛化方向:猜对先验,少样本也能外推;猜错则被错误对称性束缚。
本文全部贡献建立在"同一个先验既塑形训练又描述接口"的双重角色上,先验概念是理解其动机、方法与消融实验的核心词汇。
技能泛化与组合泛化
技能泛化指单个技能策略从演示未覆盖的起始状态(物体移位、前一技能留下的中间状态)仍能达成子目标,文中用成功区域 $W(\pi_i)$(成功概率至少 $1-\epsilon$ 的起始观测集合)刻画;组合泛化指通过跳过、重排或新拼接已学技能去解演示中不存在的任务。两者耦合:新组合会产生技能泛化必须覆盖的入口状态。
论文的问题定义、两类 OOD 评测(motion-level / task-level)与 composition 划分、以及"接口要忠实且有信息量"的形式化($A_i\subseteq W(\pi_i)$ 且 $A_i\approx W(\pi_i)$)都建立在这对概念上。
任务与运动规划(TAMP)的符号接口
TAMP 把任务层(离散符号规划)与技能层(连续控制)分离,用符号算子的前置条件与效果连接,例如"抽屉已关才能执行开抽屉"。符号可人工编写,也可从数据共同发明,如 SymSkill 联合学习谓词、算子与相对系动力学系统技能。符号接口精确但抽象,丢失了技能在物理上真正可行的连续区域信息。
APPL 的出发点正是"符号/语言接口看不到策略的泛化结构"这一信息缺口,理解 TAMP 才能明白它替代与补充了什么,以及与 SymSkill 的三点区别。
工具增强的 LLM 智能体
以大语言模型为决策核、通过工具调用(读写代码与文档、运行检查、提交产物、观测状态)完成多阶段任务的系统,通常配合固定提示词与冻结工具集。本文有两个:离线构建智能体负责分段、提出先验、实现策略、分析验证结果;在线运行时智能体每回合读取接口文档、选择策略、绑定类型化参数并设定停止条件,全程不改权重。
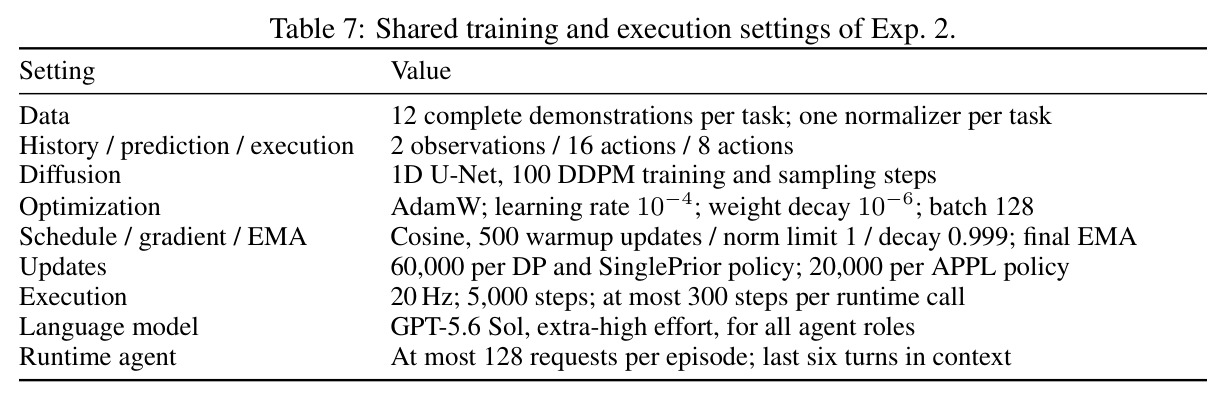
APPL 的构建与部署由这两个 LLM 智能体驱动(Exp.1 设计用 GPT-6 Astra、Exp.2 构建与运行用 GPT-5.6 Sol),附录 C 逐字公开全部提示词,模型与提示词直接影响结果与可复现性。
视觉-语言-动作模型(VLA)
在海量机器人数据上预训练的单体模型,把摄像头图像与语言指令直接映射为动作序列(如 π0.5 有 4.14B 参数),靠数据广度而非显式结构获得泛化,但对布局与物体位姿变化的鲁棒性仍受限;也可作为技能库被高层智能体按名字调用。
Exp.2 的 Agent+VLA 基线把 π0.5 在与 APPL 相同的 204 个技能段(112,761 帧、17 条指令)上微调,由同一运行时智能体调用,用来检验"语言名字接口"与"先验文档接口"的差别。
研究动机
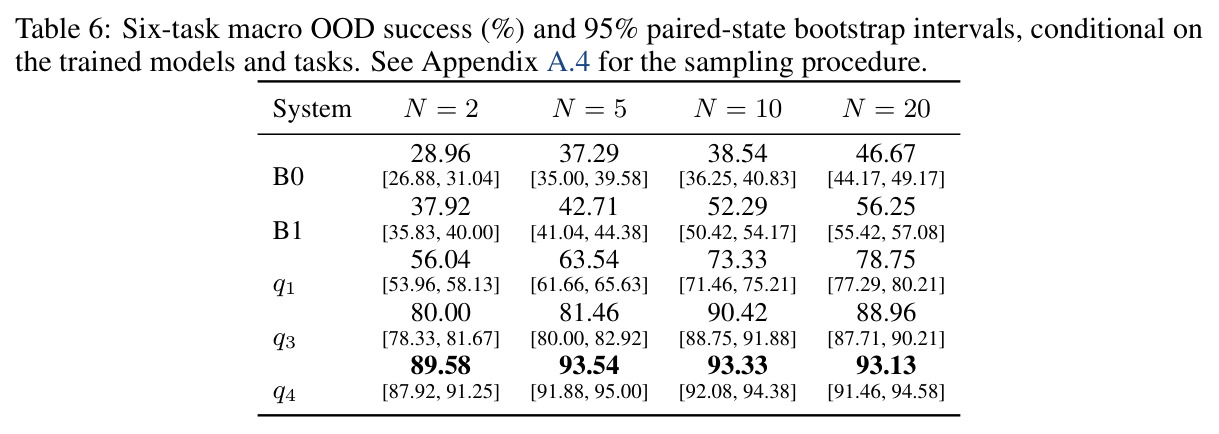
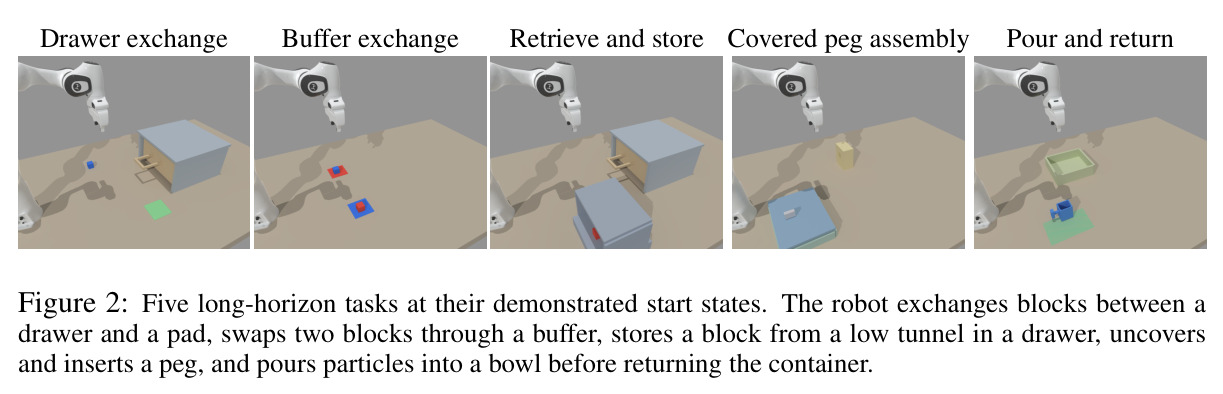
机器人只能从昂贵的少量完整演示学习(Exp.1 每任务仅 2–20 条、Exp.2 每任务 12 条),部署却要面对新目标、新操作顺序与移位的物体。这需要两类互相依赖的泛化,但任务层与技能层之间信息丢失:技能在哪里可行由其策略训练所用的结构决定,组合层却只能通过名字、指令或符号算子这种"另一套描述"看到技能。后果有具体数据支撑:朴素 Diffusion Policy 在六个 MetaWorld 任务上平均 OOD 成功率仅 37.86%(2 条演示时 28.96%);ManiSkill 五个长程任务上全任务 DP 移位物体后成功率仅 10.0%。VLA 靠数据广度但 LIBERO-Plus 等鲁棒性基准显示其对布局与位姿变化脆弱;TAMP 的符号前置条件要么手工编写、要么从预定义族学习(最接近的 SymSkill 被固定在相对坐标系+动力学系统控制器这一族);LLM 智能体调用技能工具时只知名字与可行性估计,技能间交接是常见失败来源。
本文的目标是在只给定 $N$ 条完整无分割演示 $\mathcal{D}_N$ 与任务知识 $K$ 的条件下,离线构建一个冻结系统 $S=(C,L)$:策略库 $L$ 允许同一技能保留多个策略实现,组合器 $C$ 在运行时只通过接口 $I_i$ 看到并依次调用策略,最大化测试目标分布上的期望成功率 $J(S)=\mathbb{E}_{g,o_0}[Succ(g,o_T)]$。更精确地说,要求学到的技能策略其成功区域 $W(\pi_i)$ 覆盖新组合可能产生的入口状态,同时每个接口声明的适用区域 $A_i$ 满足两条性质:忠实($A_i\subseteq W(\pi_i)$,不把策略调到会失败的地方)且有信息量($A_i\approx W(\pi_i)$,不放弃本可成功的调用)。构建过程不得使用测试分布信息,部署后库与智能体全部冻结、每回合记忆重置。
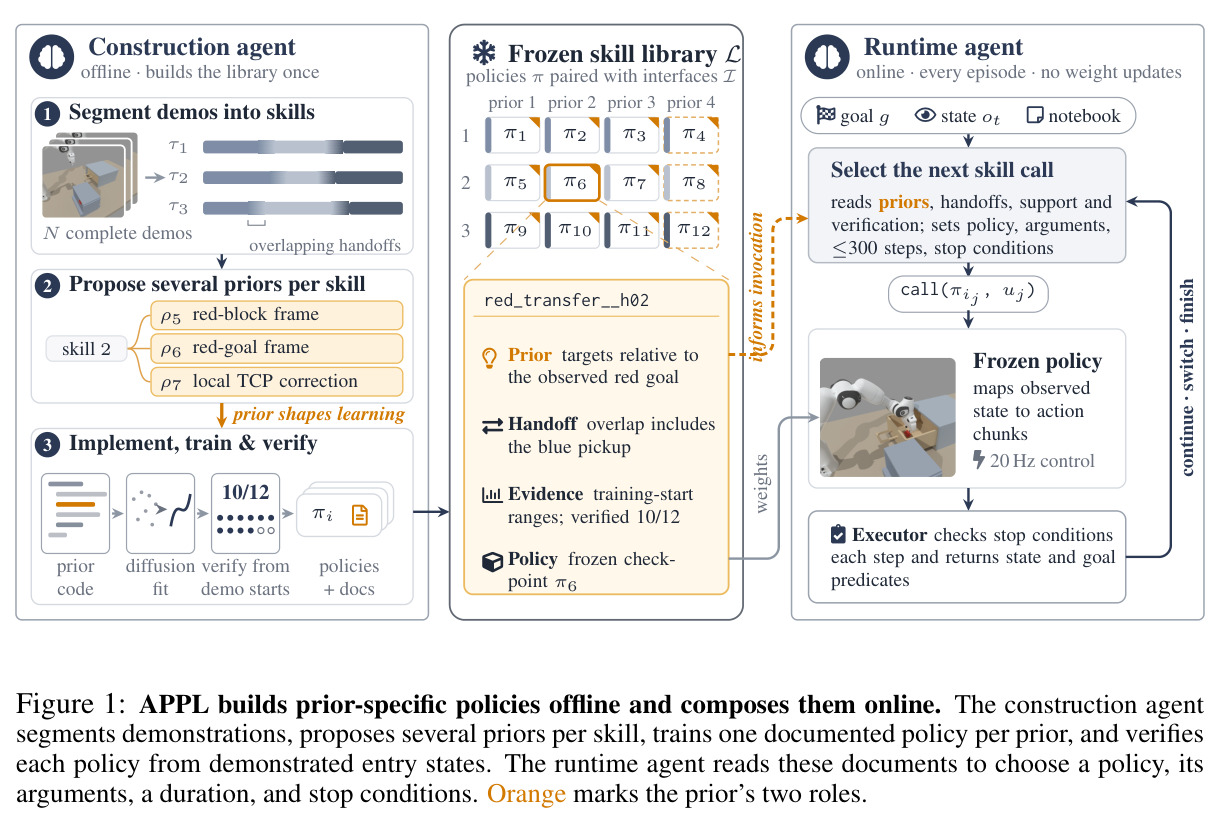
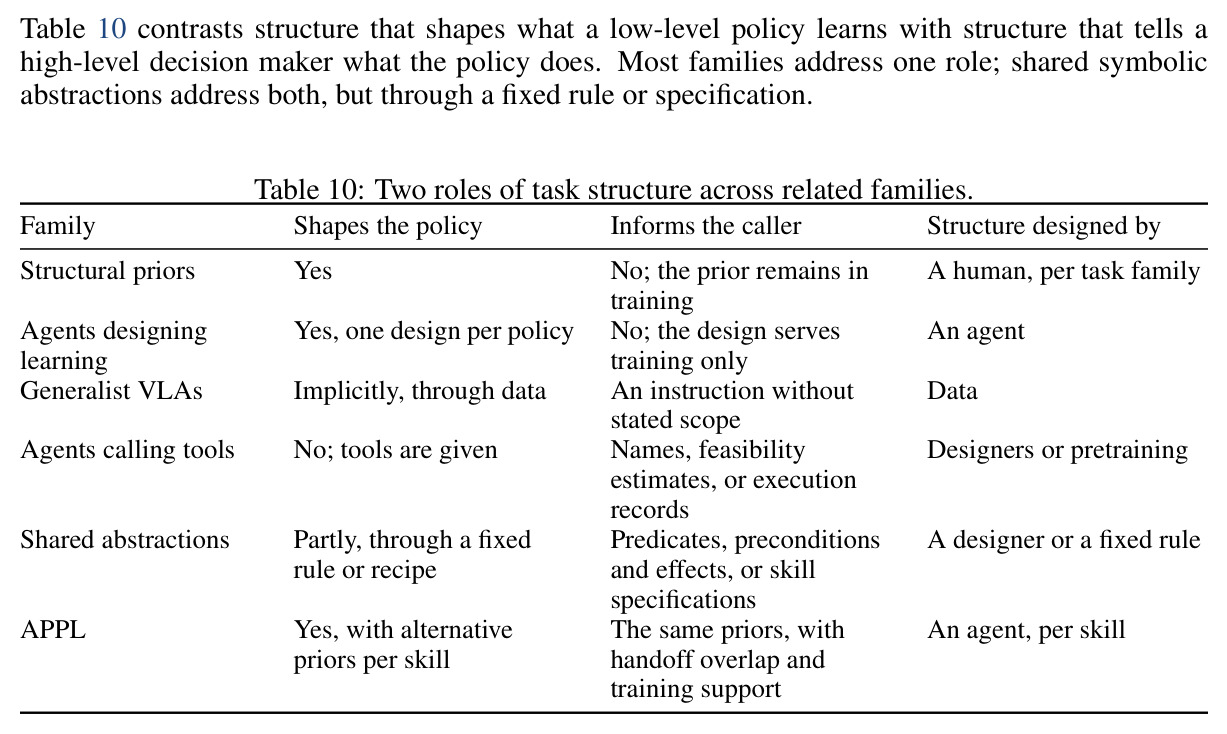
与已有工作不同的是,本文的独特切入是把每个技能的"结构先验"提升为组合层与技能层之间的接口:同一先验既作为训练时的归纳偏置实现进表示、动作坐标系或辅助损失,塑造策略的泛化范围;又用自然语言连同交接条件、训练支持与验证证据写进运行时文档,让组合层知道每个实现"为何可信、何处适用"。与最近邻工作的差别明确:LGA/KALM 让模型选表示先验,但每任务只产出一个设计且只用于训练;SymSkill 的结构被固定在相对系+动力学系统这一族,每个算子绑定单一策略;Harness VLA、BATON 等 agentic 系统在策略存在之后才从执行记录学习操作范围。APPL 则让构建智能体按技能从开放设计空间提议多个先验、保留备选策略,并使先验信息在第一次执行之前就可被运行时智能体读取。
核心方法
直觉是:在物体相对坐标系中训练的抓取策略天然能迁移到新的物体位置——但只有把这一点写成文档告诉任务层,任务层才会在物体移位时主动选它。APPL 据此分两阶段。离线构建:构建智能体把 $N$ 条完整演示分割成可复用技能(相邻技能段在交接处有意重叠),为每个技能提出约 3 个预期失败模式互补的结构先验,逐先验实现并训练一个条件扩散策略,再从演示入口状态验证每个策略、据反馈增补第 4 个先验,最后为每个策略写接口 $I_i=(d_i,h_i,s_i,v_i)$(先验描述、交接条件、训练支持、验证证据)并冻结库。在线组合:运行时智能体读取目标谓词、交互历史与回合笔记本,可检视任一策略的完整接口,选择策略、绑定类型化参数、设定时长(至多 300 步)与数值停止条件;执行器以新鲜观测驱动策略并逐步检查条件,触发即交还控制权,任务目标达成时立即中断调用。
核心创新是结构先验的双重角色及其对接口性质的耦合。训练侧(coverage),先验 $\rho_i$ 限定策略类 $\Theta_{\rho_i}$ 并可加辅助损失:$\theta_i=\arg\min_{\theta\in\Theta_{\rho_i}}\mathbb{E}_{\mathcal{D}_{k(i)}}[\ell_{BC}(\theta)+\lambda_i\,\ell^{aux}_{\rho_i}(\theta)]$,由此塑造策略演示之外的行为,即成功区域 $W(\pi_i)$。描述侧(selection),同一先验给出适用性假设 $A_i=\{o:\phi_{\rho_i}(o)\in R_i\}$,其中 $\phi_{\rho_i}$ 是先验定义的观测变换、$R_i$ 是变换后演示覆盖的区域;接口通过先验描述、实测训练支持与交接条件把这一假设传达给运行时智能体。因为声明的适用性建立在塑造策略的同一假设上,$A_i\subseteq W(\pi_i)$ 的忠实性获得机制性支撑(虽不保证成立)。这把"选什么策略结构"从一次性设计决策变成可提议、可实现、可在运行时复选的按技能假设,并让同一技能的多个先验版本互为备选。
方法步骤详情
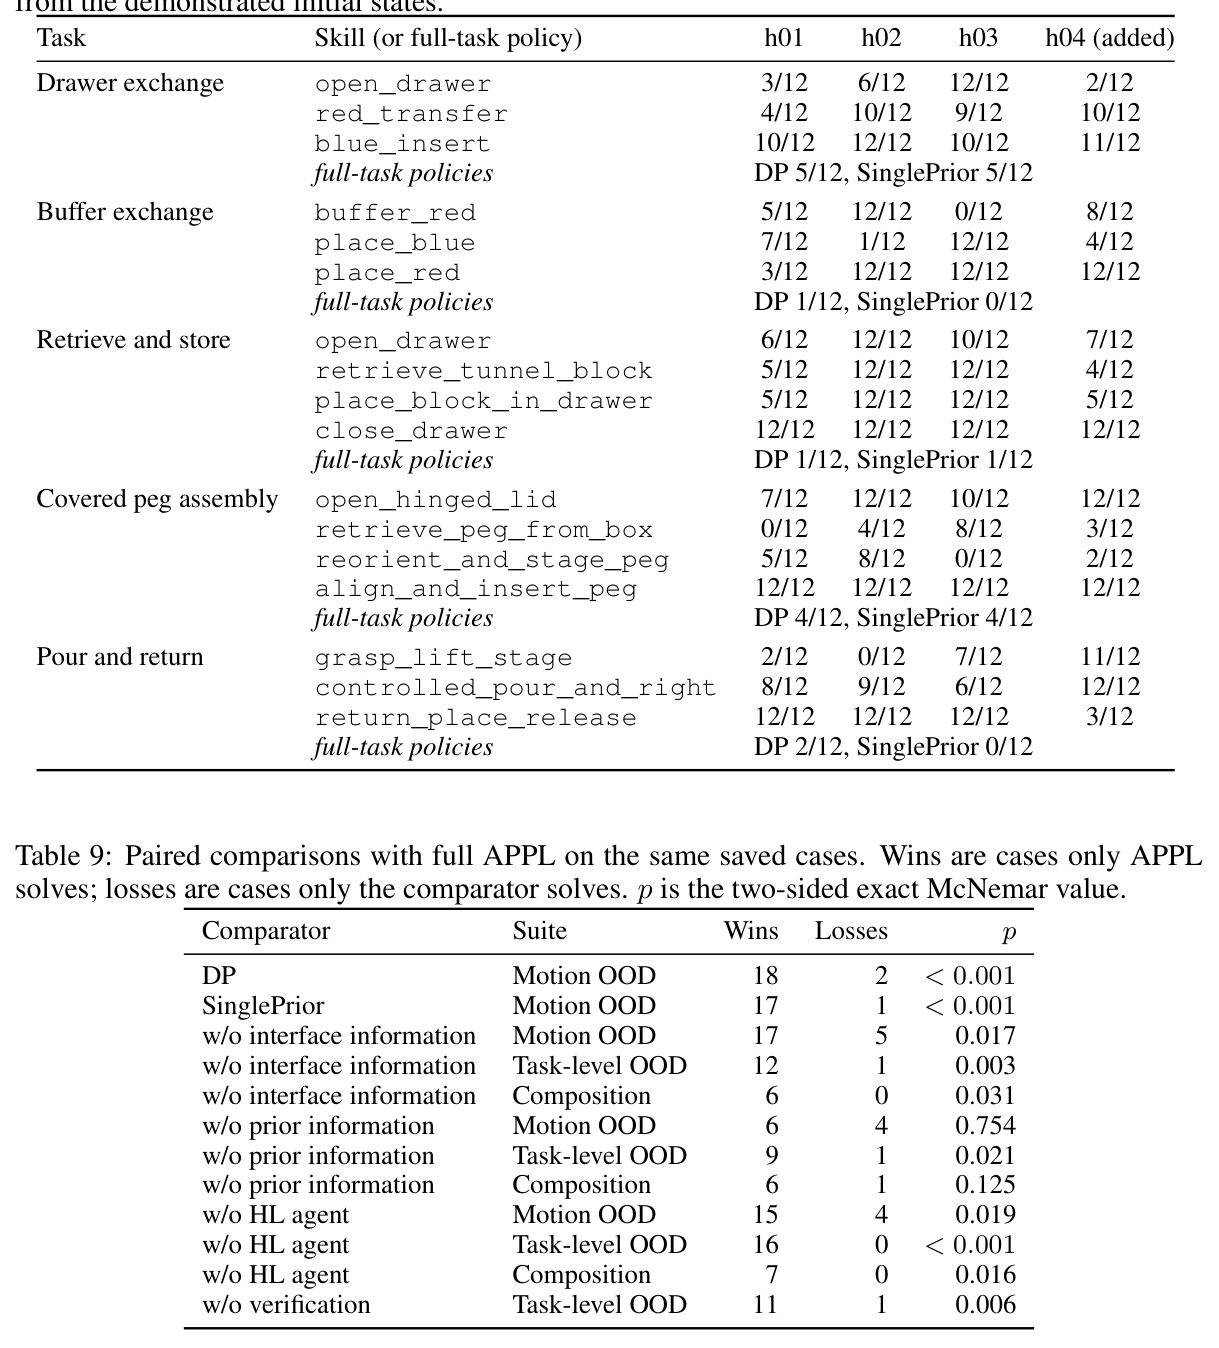
第一步,技能分段:构建智能体逐条轨迹提议边界,把执行同一可复用操作的段归为技能数据集 $\mathcal{D}_k$;相邻技能包含前任结尾与后继开头的重叠动作监督,用原演示的转移拓宽交接处的训练支持而不新增数据。第二步,提议先验:每技能从不同族提出约 3 个"预期失败模式互补"的先验,至少一个针对被操纵物体的位移。第三步,实现与训练:按固定接口写代码——构建因果观测历史、在先验指定坐标系编码动作并解码回原生命令,可加辅助损失;例如物体系先验用 $x_{loc}=R_t^\top(x_{world}-p_t)$、$\Delta x_{loc}=R_t^\top\Delta x_{world}$、$\Delta x_{world}=R_t\Delta x_{loc}$ 变换末端目标,经共享逆运动学解算为关节指令,每个先验独立训练一个条件扩散策略。第四步,验证:每个策略从其训练段的演示入口状态启动、运行 1.5 倍段长、按预定义退出判据在末态评分;智能体只读这些结果写报告,并为每技能增补第 4 个先验 h04 再验证一次。第五步,写接口 $I_i=(d_i,h_i,s_i,v_i)$ 并声明类型化参数(操作对象、目的地等)。第六步,运行时组合:$(i_j,u_j,m_{j+1})\sim R_\alpha(\cdot\,|\,h_{t_j},g,m_j,\mathcal{L})$ 选出策略调用与参数,执行器逐步检查数值停止条件(如夹爪宽度小于 3 cm 且物体抬升超过 4 cm),任务目标达成即中断;智能体随后可继续当前技能、换实现、换技能或结束任务。
技术新颖性
与最近邻方法的本质区别有三点。其一,对 SymSkill:其结构被固定在相对系谓词+动力学系统控制器这一预定义族,每个算子绑定单一技能策略,规划器读符号前置/后置条件;APPL 让构建智能体按技能从开放设计空间(表示、动作坐标系、编码器、辅助损失)提议不同族的先验,同一技能保留多个策略由运行时智能体选择,接口是自然语言先验+交接重叠+实测训练支持+验证证据。其二,对 LGA/KALM/ATK:它们也用(视觉)语言模型选表示先验,但每任务一个设计、先验只作为策略输入用于训练;APPL 的先验同时写进训练目标与运行时文档,这是作者明确主张的真正新意。其三,对 Harness VLA、BATON、RoboHarness 等 agentic 调度系统:它们在策略存在后从执行记录学习入口条件与操作范围,APPL 的文档来自构建时的先验与训练数据的交接重叠,首次执行前就可用;Agentic Skill Discovery 虽保留每技能多策略变体但把选择留作未来工作,APPL 正是用先验补上了这一选择环节。
实验结果
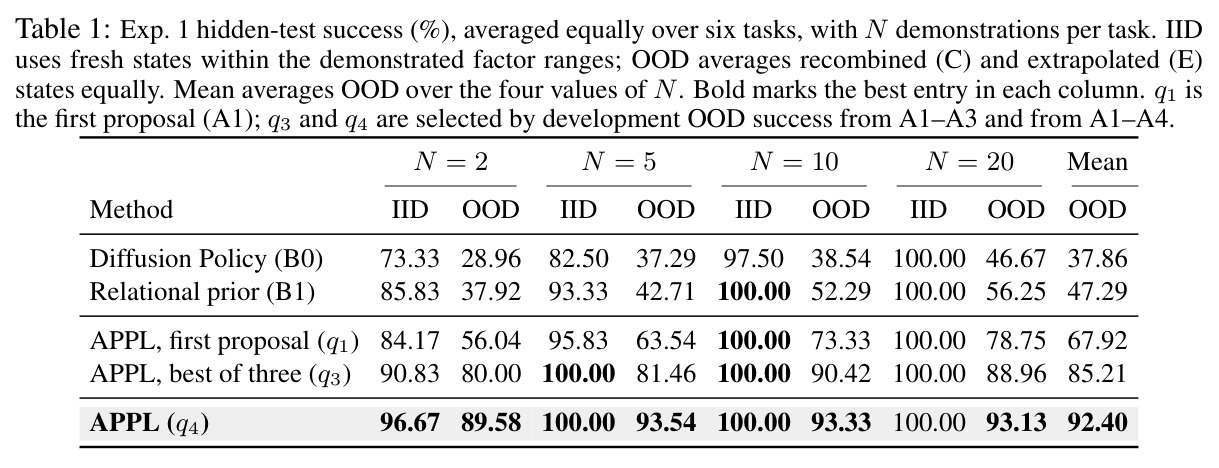
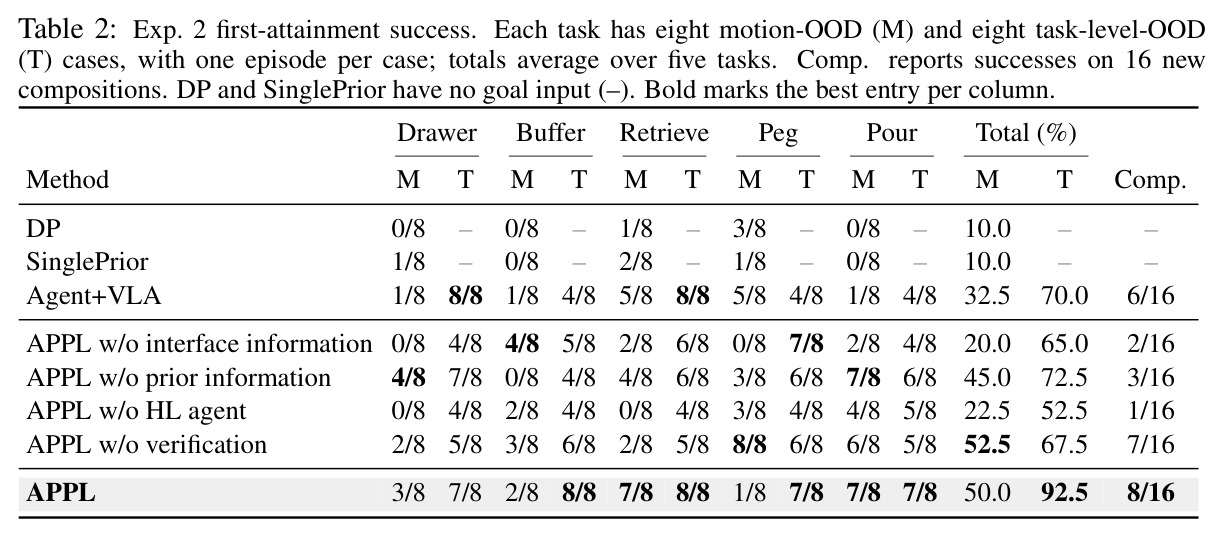
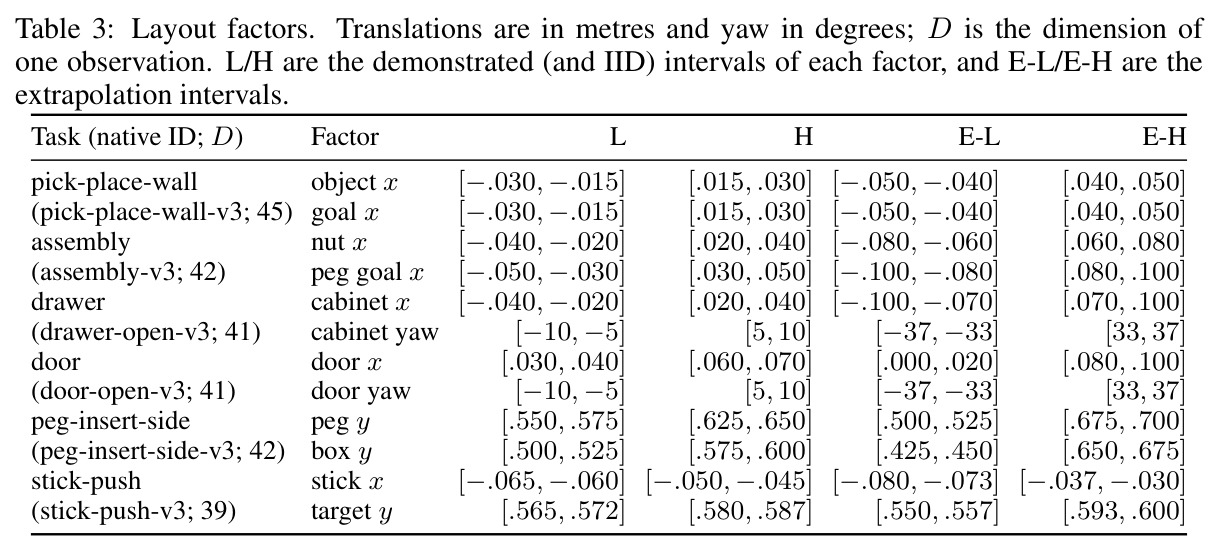
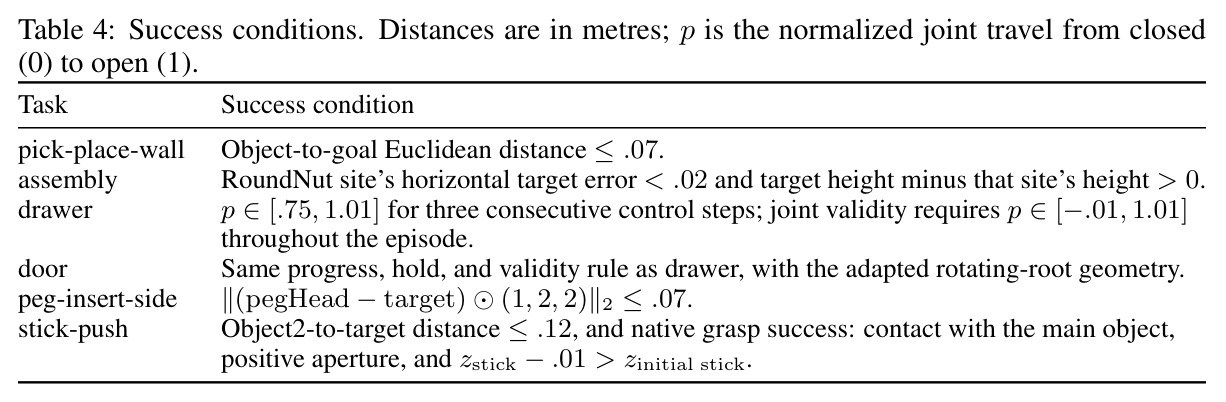
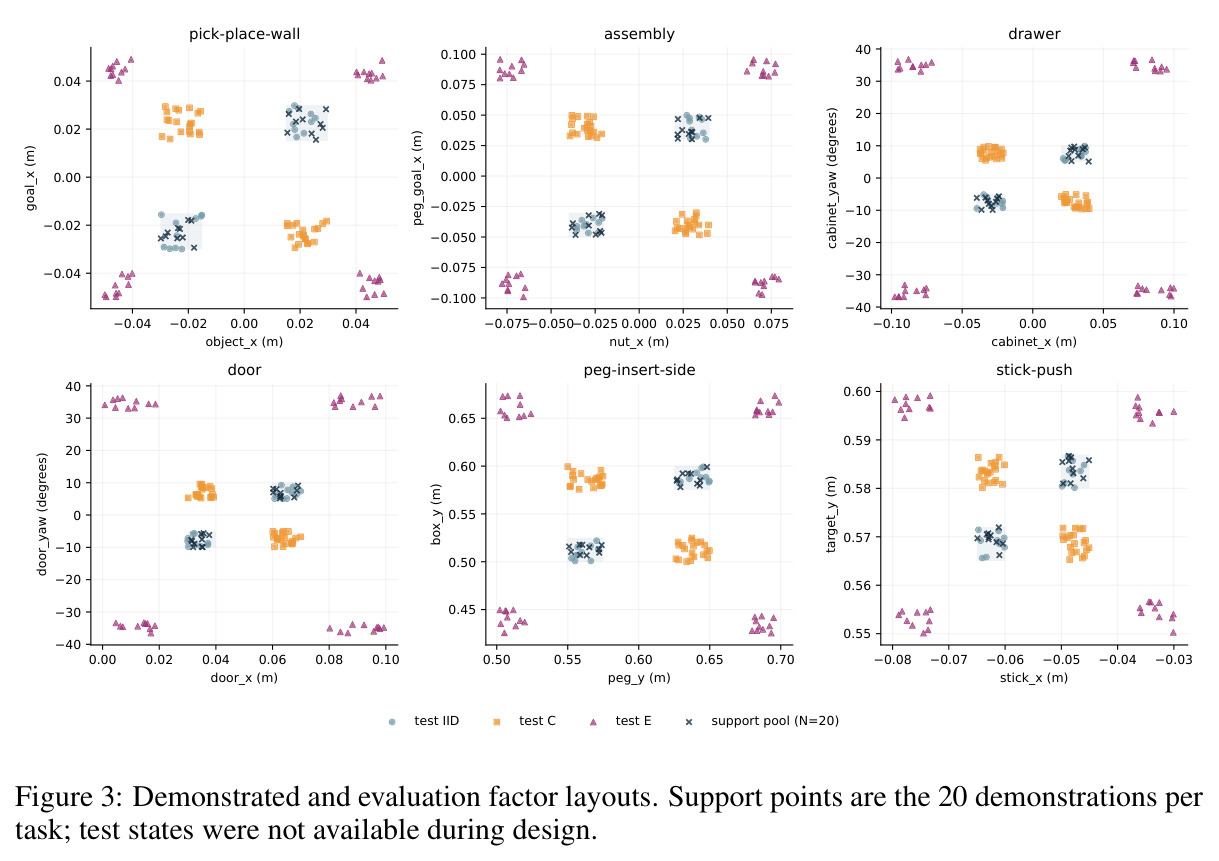
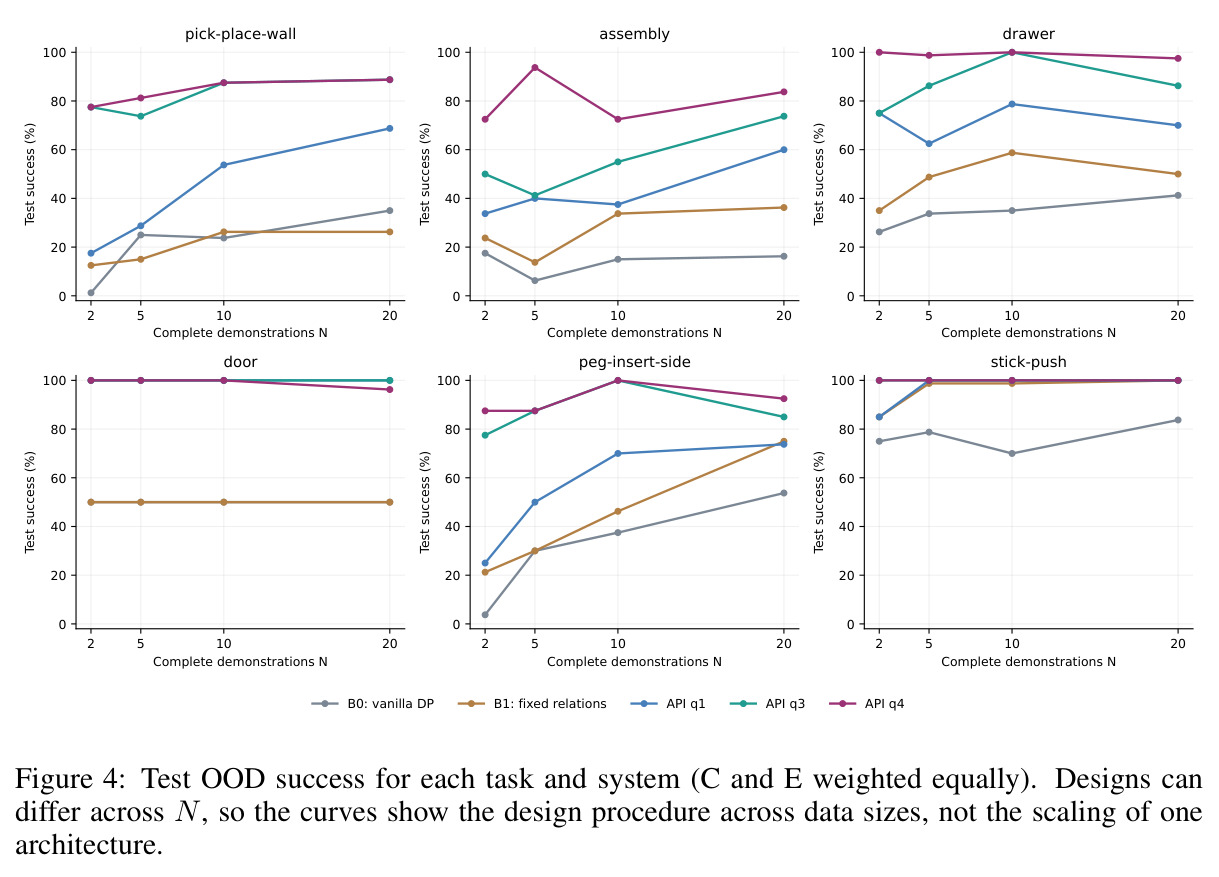
Exp.1(MetaWorld 六任务、嵌套演示数 $N\in\{2,5,10,20\}$、共 144 个模型、隐藏测试):APPL q4 的宏平均 OOD 成功率 92.40%,对比朴素扩散策略 B0 的 37.86% 与固定关系先验 B1 的 47.29%;$N=2$ 时 89.58% vs 28.96%/37.92%,对 B1 的领先在四档 $N$ 下分别为 51.67/50.83/41.04/36.88 个百分点。流程分解:首次提议 q1 已超 B1 18.1–22.5 点;三选一开发集选择 q3 再加 10.2–24.0 点;验证反馈轮 q4 又加 2.9–12.1 点(24 个条件中 15 个选中 A4,测试上 10 升、13 平、1 降)。$N=20$ 时外推区 E 成功 B0 25.42%、B1 36.25%、q4 88.33%。典型修订:drawer/$N{=}2$ 用可逆残差动作编码 $z_{xyz}=L_\theta a_{xyz}+4P_{xy}e$ 从 75.00% 升至 100.00%;assembly/$N{=}5$ 移除目标位置捷径从 41.25% 升至 93.75%;也有负例 door/$N{=}20$ 从 100.00% 降至 96.25%。Exp.2(ManiSkill 五个长程任务、每任务 12 条演示):移位物体 OOD 上 APPL 50.0%,DP 与 SinglePrior 均 10.0%(McNemar $p<0.001$),Agent+VLA 32.5%;任务级 OOD 92.5%(重入 18/20、前缀目标 19/20);16 个未见组合解出 8 个(Agent+VLA 6/16)。消融证明接口信息本身关键:同一策略库隐藏全部接口信息后三指标跌至 20.0%/65.0%/2-16;仅恢复验证分数与退出判据(w/o prior information)升至 45.0%/72.5%/3-16;用固定规则替换智能体为 22.5%/52.5%/1-16。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MetaWorld 技能泛化(六任务宏平均) | 隐藏测试 OOD 成功率,N=2 条演示 | 89.58%(APPL q4) | 28.96%(vanilla DP);37.92%(固定关系先验 B1) | +60.62 / +51.66 个百分点 |
| MetaWorld 技能泛化(六任务宏平均) | 隐藏测试 OOD 成功率,四档 N 平均 | 92.40%(APPL q4) | 37.86%(B0);47.29%(B1);67.92%(q1 首次提议) | +54.54 / +45.11 / +24.48 个百分点 |
| MetaWorld 外推区(E) | N=20 时的外推成功率 | 88.33%(q4) | 25.42%(B0);36.25%(B1) | +62.91 / +52.08 个百分点 |
| ManiSkill 五任务移位物体 OOD | 首达成功率(8 布局×5 任务) | 50.0%(APPL) | 10.0%(全任务 DP);10.0%(SinglePrior);32.5%(Agent+VLA) | +40.0 / +40.0 / +17.5 个百分点(对 DP/SinglePrior p<0.001) |
| ManiSkill 任务级 OOD(中途重入+前缀目标) | 首达成功率(8 案例×5 任务) | 92.5%(APPL) | 70.0%(Agent+VLA);65.0%(隐藏接口信息消融) | +22.5 / +27.5 个百分点 |
| ManiSkill 未见技能组合 | 16 个新组合的解出数 | 8/16(APPL) | 6/16(Agent+VLA);2/16(隐藏接口信息消融) | +2 / +6 个案例 |
局限与改进
作者承认的局限:结构先验只描述"意图上的泛化",不保证能力,策略仍可能在演示支持之外失败;库中缺少恢复类技能;验证协议只允许演示入口状态、按固定时长末态评分,可能误导选择——覆盖销装配中 h03 的 0/12 分数掩盖了它在第 347–384 步间曾瞬时满足交接判据(570 步才评分),带着该报告的完整 APPL 在该任务上仅 1/8,反而低于不做验证的 8/8。我自己的观察:其一,成功按"首次达成目标"计并有执行器辅助停止,未评估目标状态的持续性——案例 C-N3 中方块以约 1.66 m/s 的平均速度下落途中被记成功;其二,motion-OOD 划分是在看过更难划分的结果之后把位移减半选定的,四个 drawer 组合案例也在结果出来后才被重分类,评测协议存在事后选择成分;其三,构建与运行都依赖 GPT-6 Astra(max reasoning effort)与 GPT-5.6 Sol 这类前沿闭源模型,运行时每回合最多 128 次请求且仿真暂停等待推理;其四,全部实验是结构化状态输入的仿真操作(仅 VLA 基线用图像),视觉观测与真机迁移未验证。
独立分析的弱点
弱点一:验证与部署分布错配。只在演示入口状态末态评分,既发现不了"瞬时满足交接条件"的策略(h03 案例),也可能在分布移位下误排策略(覆盖销装配 8/8→1/8 的反转);改进方向是把验证对象定义为"策略+入口分布+交接规则"的组合,报告判据满足的时间区间而非仅末态。弱点二:无恢复能力。演示不含失败轨迹,物体掉落、抓取把抽屉碰关后库中无技能可用;可增补恢复技能族,或在运行时检测到先验文档声明的"预期失败签名"时触发性地采集定向数据。弱点三:忠实性无保证。$A_i\subseteq W(\pi_i)$ 只是假设,先验错误或网络未实现先验时智能体会系统性选错;可引入廉价的运行时前置检查或 SymSkill 式反应式恢复作为回退。弱点四:对前沿 LLM 依赖重、推理成本高(每回合至多 128 次请求、仿真暂停等待推理),真机实时性差;可把运行时决策蒸馏为小模型或缓存常见情形。弱点五:每技能 3–4 个策略加验证轮带来约 4 倍训练与评测开销,而对先验差异无意义的技能(如各先验都 12/12 的 close_drawer)纯属浪费,成本应按技能自适应分配。
未来方向
作者提出的方向:改进验证使其与部署时的入口分布和交接规则对齐(在真机上无法做 OOD 试验时尤为关键);通过定向数据采集或数据增强扩展技能的支持范围;集成运动规划器等互补工具以弥补学习策略的失败模式。基于本文成果可延伸的:把 SymSkill 的已学谓词与反应式恢复嵌入 APPL 接口,作为执行检查与回退行为,形成互补;让运行时的调用记录反哺构建——检测到 $A_i$ 与实测行为不符时自动更新文档或触发再训练,构成闭环;把接口文档从自然语言推进为可执行的前置条件检查;在视觉观测与语言指令端到端的设定下检验先验接口是否仍有效;研究并行技能、动态障碍等更丰富组合类型下的组合泛化边界;以及系统比较"多先验备选+运行时选择"与"更强单先验"的算力-性能权衡。
复现评估
文档与代码基础属上乘:作者承诺发布实验代码、智能体生成的全部策略实现、固定提示词、评估用例与回合结果;附录 A/B 详列任务改造、数据划分、训练超参(1D U-Net、AdamW 学习率 $10^{-4}$、Exp.1 每模型 20,000 步、Exp.2 中 APPL 策略 20,000 步而全任务策略 60,000 步、DDPM 100 步)与评估协议,附录 C 逐字公开设计、分段、验证、运行时四类智能体的提示词。硬门槛有三:其一,构建/设计需要 GPT-6 Astra(reasoning effort max)、运行时与使用说明需要 GPT-5.6 Sol 等特定闭源模型,重跑会产生不同设计与决策,数值不会精确一致;其二,算力可观——Exp.1 训练 144 个扩散策略,Exp.2 每技能 4 个先验策略外加微调 4.14B 参数的 π0.5(112,761 帧、20,136 步、bf16 混合精度),需要多卡 GPU 数天量级;其三,流水线环节多(分段、先验实现、验证、文档、运行时),工程复刻成本高。总体评级:中高难度,适合有仿真操作与 LLM 智能体工程经验的团队。
论文图表