SoL-Pi:递归扩展自动研究循环,打造高效智能体线束 SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness
用自动研究循环自动进化智能体线束,token 成本降约三分之一
前置知识
Agent Harness(智能体线束)
包裹 LLM 的工程外壳,负责把模型输出变成工具调用、管理上下文与对话历史、处理观察反馈、决定委派与终止。同一个模型配不同 harness 表现差异巨大(SWE-agent 证明接口设计本身会显著影响性能),本文对比的 Pi、Codex、Claude Code 都是 harness。
论文的全部优化都发生在 harness 层而非模型层,理解这条边界才能看懂四个机制到底改的是什么、为什么不需要重新训练模型。
RSI(Recursive Self-Improvement)
递归自我改进:让 AI 系统改进自身或其组件,再用改进后的系统继续下一轮改进。理论源头是 Gödel Machine,实践形态包括 Darwin Gödel Machine 自改 agent 代码。本文是让研究 AI 迭代改进 agent harness,未来再用更高效的 harness 驱动下一轮研究。
SoL-Pi 的搜索管线本质上是一条工程化的 RSI 循环,论文的核心主张——RSI 能产出可跨环境迁移的改进——也建立在这个概念之上。
Prompt Cache(提示缓存与读/写计价)
API 对重复前缀提供缓存:cache read 单价远低于普通输入,cache write 略高于普通输入。缩短上下文虽省输入 token,但会改写缓存前缀、降低复用率并产生重写开销,因此最优策略取决于输入节省与缓存重写成本之间的权衡,而非单纯看缓存命中率。
Online Context Compact 的成本门控公式、以及 Table 4 中缓存读降/写升但总成本反降的现象,都要靠这套计价模型才能理解。
Context Compaction(上下文压缩)
长任务中对话历史与环境观察不断累积,接近上下文窗口时把历史摘要化以腾出空间。压缩太频繁浪费 token 且丢失信息,太晚则有溢出风险;何时触发压缩是 harness 设计的关键决策点,直接影响长程任务的成败与成本。
论文把何时压缩从固定规则改成计划步完成边界上的经济决策(节省与缓存重写成本的比较),这正是四个保留机制之一的核心。
Held-out Evaluation(留出评估)
把一部分评测数据在搜索/训练期间完全隔离,直到候选方案冻结之后才允许使用,且评估结果无论好坏都不回流到搜索过程,用来度量对未见任务的真实泛化能力,防止对评测集过拟合。
本文最重要的方法论主张就是搜索反馈与留出评估严格分离(EdgeBench 的 11+40 任务划分),这是全文结论可信度的基石,也是与先前自动 harness 工作的关键区别。
研究动机
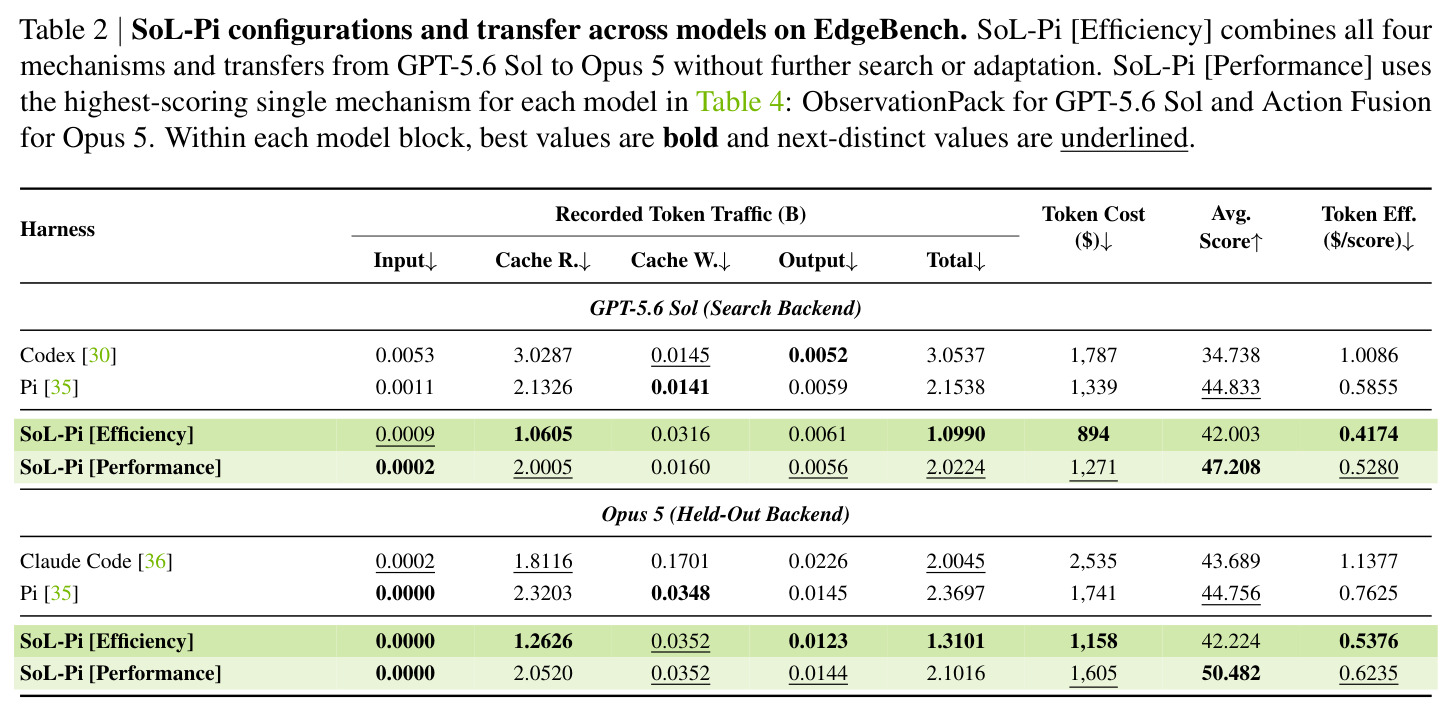
随着编码智能体从有监督的代码补全走向全天候无人值守的自主探索,其工作从单次预测扩展为包含推理、工具调用与反馈的长轨迹,token 开销随之成为一等系统工程问题。现有效率优化大多集中在降低单 token 成本:更快的注意力内核与推理服务基础设施、量化等模型压缩、或改用更便宜的模型。论文选择的正交方向是 harness 层:harness 决定模型如何与工具、上下文和观察交互,直接决定 token 用量。但优化 harness 在实践中很难——工具使用、上下文管理、验证、委派、恢复与终止紧密耦合,局部有益的改动可能引发下游失败,或只是把 token 成本推迟到执行后期。人工开发 harness 需要翻查海量执行轨迹、归纳反复出现的失败模式再翻译成代码改动,成本高且难以跨任务扩展。代价是真实的:在 EdgeBench 51 个公开任务上,原生 Codex(GPT-5.6 Sol)花费 $1,787,Claude Code(Opus 5)花费 $2,535,即便高效的第三方 harness Pi 也要 $1,339。
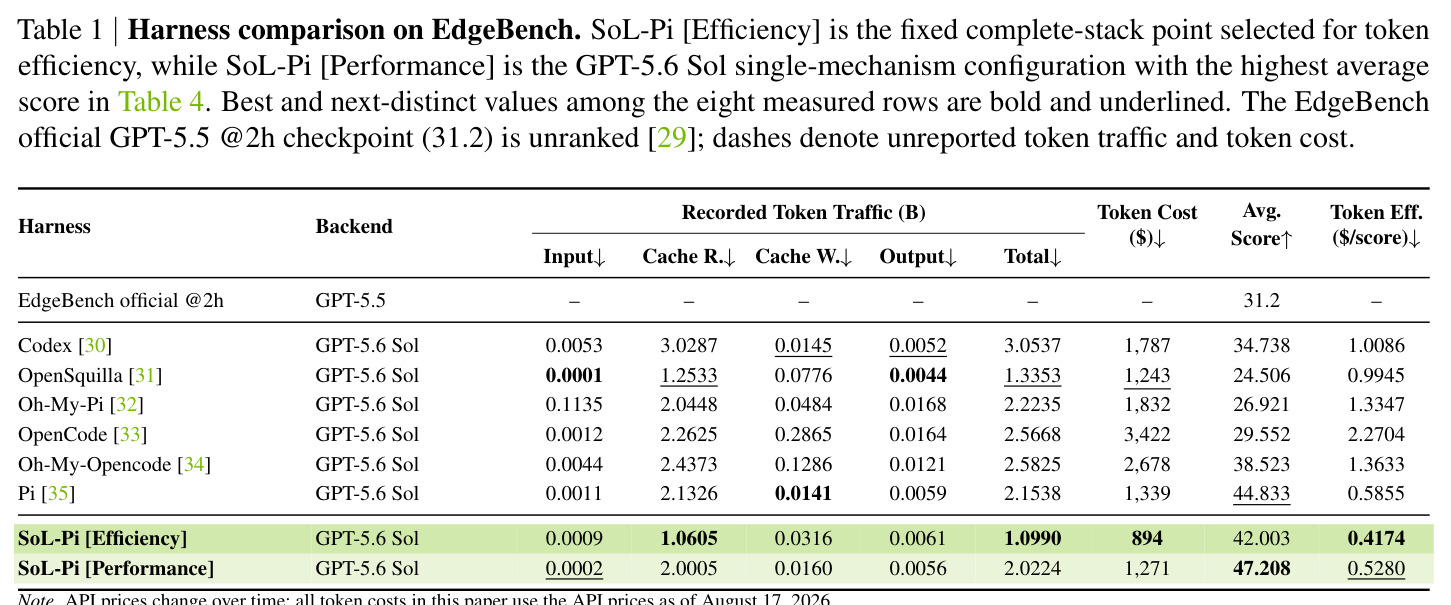
本文的目标是本文的目标是让 AI 自主完成原本由人类工程师承担的 harness 优化:以 RSI(递归自我改进)为灵感,在 harness 层面扩展自动研究循环,从大量真实任务环境中自动发现可复用的 token 效率机制。具体而言,研究 AI 观察基线 harness(Pi)的执行轨迹,提出候选改动,在准备好的开发环境中实验验证;候选必须在能力指标保持于预定义容差内的前提下,至少改进一项预定义的效率指标。最终目标是将保留下来的机制集成为一个可冻结、可跨任务迁移的高效 harness(SoL-Pi),并在从未参与搜索的留出评测(EdgeBench)上证明:性能与 Pi 相当的同时,token 流量降低 44.7–49.0%,API 成本降低约三分之一,从而把自动化 harness 发现推向生产级结果。
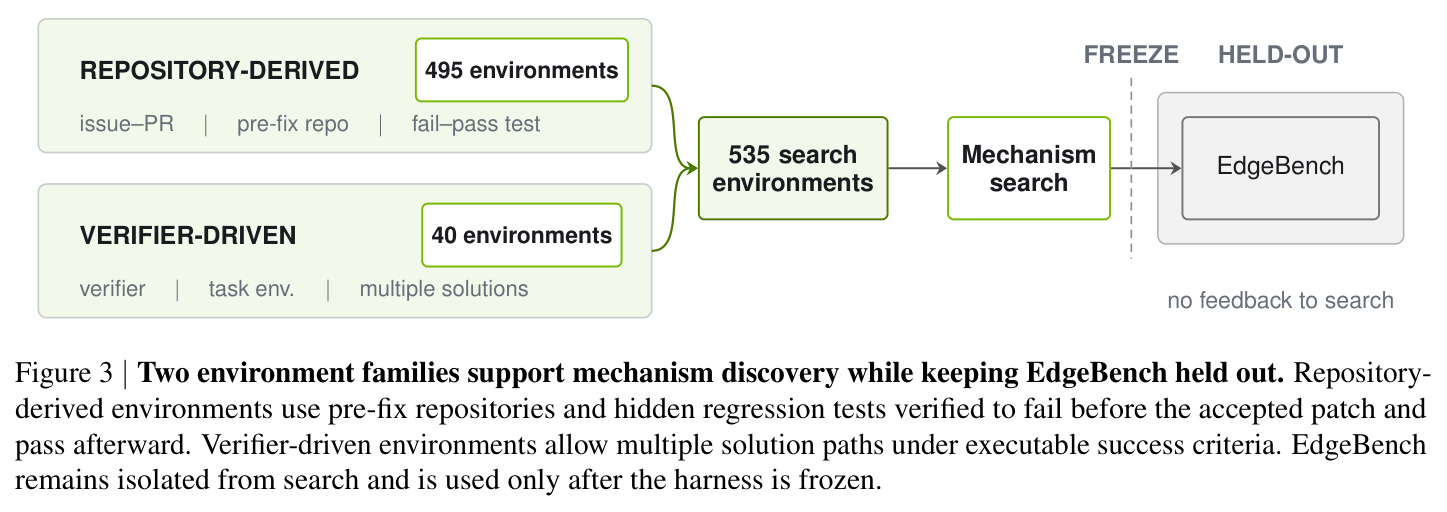
与已有工作不同的是,已有自动化 harness 工作证明了可行性:Meta-Harness 搜索可执行的 harness 程序,RHI 针对单个任务迭代精炼 agent loop 的提示规格。但近期留出任务研究(Wang et al.)发现,进化出的 harness 常过拟合搜索所用任务,在未见任务上收益有限。SoL-Pi 的独特切入有三点。其一,严格隔离:能力指标、容差、效率指标在搜索前固定且不交给优化 agent 控制,EdgeBench 在 harness 冻结后才启用,验证失败即否决、绝不回流搜索,从机制上杜绝针对评测打补丁。其二,广度乘深度的漏斗式编排:约 152 个提案方向、535 个可执行环境、3,000+ 次运行、60,000+ 次交互,搜索以可丢弃的隔离谱系并行扩展,单个失败不传染其他实验。其三,层次选择:不在模型或提示层做文章,而在行动执行、上下文压缩、观察处理、委派读取四个 harness 环节寻找可迁移的具体改动。
核心方法
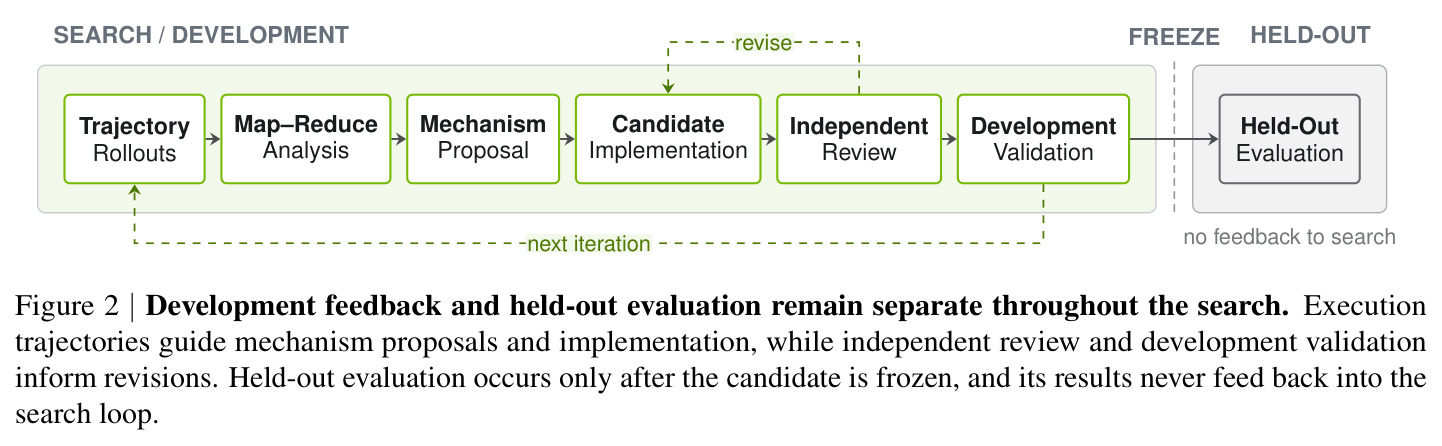
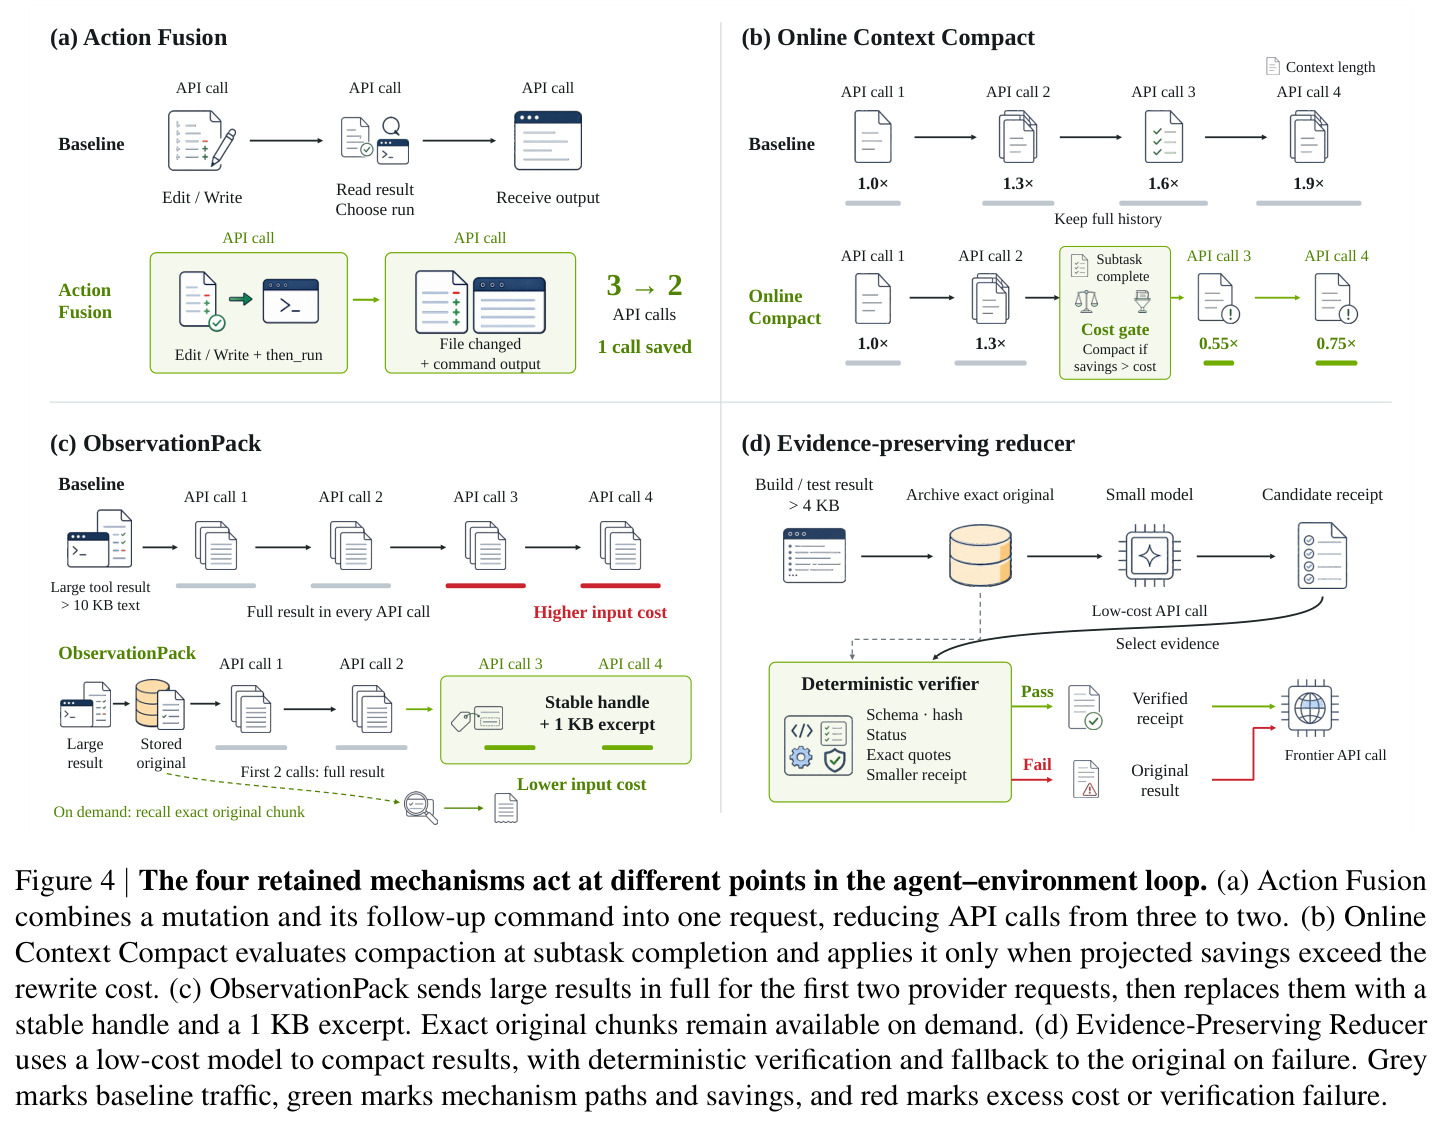
直觉上,与其让工程师通宵读 trace 调 harness,不如让一个研究 AI 专职做这件事:它观察基线 Pi 在开发环境中的执行轨迹,定位可避免的开销,提出候选 harness 改动,实验验证后保留或丢弃,如此循环。技术路线上,SoL-Pi 把 harness 改进组织为从广度到深度的漏斗:外层从 152 个提案方向出发(分属上下文、进度、工具、委派、提示与策略、改进与评估六个家族),先用 Oracle Analysis 分析已有轨迹找出可避免的工作量;每个入选方向进入独立的内层搜索谱系,按提案、实现、独立评审、固定实验、保留或修订或丢弃的自动研究循环推进。整个搜索在 495 个仓库任务加 40 个带可执行验证器的合成任务(共 535 个环境)上进行,累计 3,000+ 次运行和 60,000+ 次智能体—环境交互。搜索最终保留四个机制:Action Fusion、Online Context Compact、ObservationPack、Evidence-Preserving Reducer,分别覆盖行动执行、上下文压缩、观察处理与委派读取,集成调参后冻结为 SoL-Pi,再在留出的 EdgeBench 上做最终评估。
核心创新是能力约束下的效率选择加上搜索与评估的彻底隔离。每个候选要过两道串联的门:能力门要求所有预先声明的指标变化落在固定容差内($\forall i:\ |m_i - m_i^{\text{base}}| \le \tau_i$),效率门要求至少改进一项预先声明的效率指标;两门皆过者中保留非支配解。指标、容差与验收规则在搜索前冻结、不接受优化 agent 操纵,防止它钻验收标准的空子。与 Meta-Harness、RHI 等已有工作的本质区别在于对泛化的处理:开发反馈与留出评估全程分离,EdgeBench 的 51 个任务中 11 个仅用于冻结候选的一次性准入检查,其余 40 个只做最终泛化评估,留出结果无论好坏都不回流搜索。与 GEPA、ADAS、AFlow 等提示/工作流搜索也不同:SoL-Pi 修改的是可执行的 harness 代码,验收目标是 token 效率这一系统级指标,并通过 152 个方向、535 个环境的规模化搜索证明这些改进能够跨任务、甚至跨模型(GPT-5.6 Sol 到 Opus 5 无任何适配)迁移。
方法步骤详情
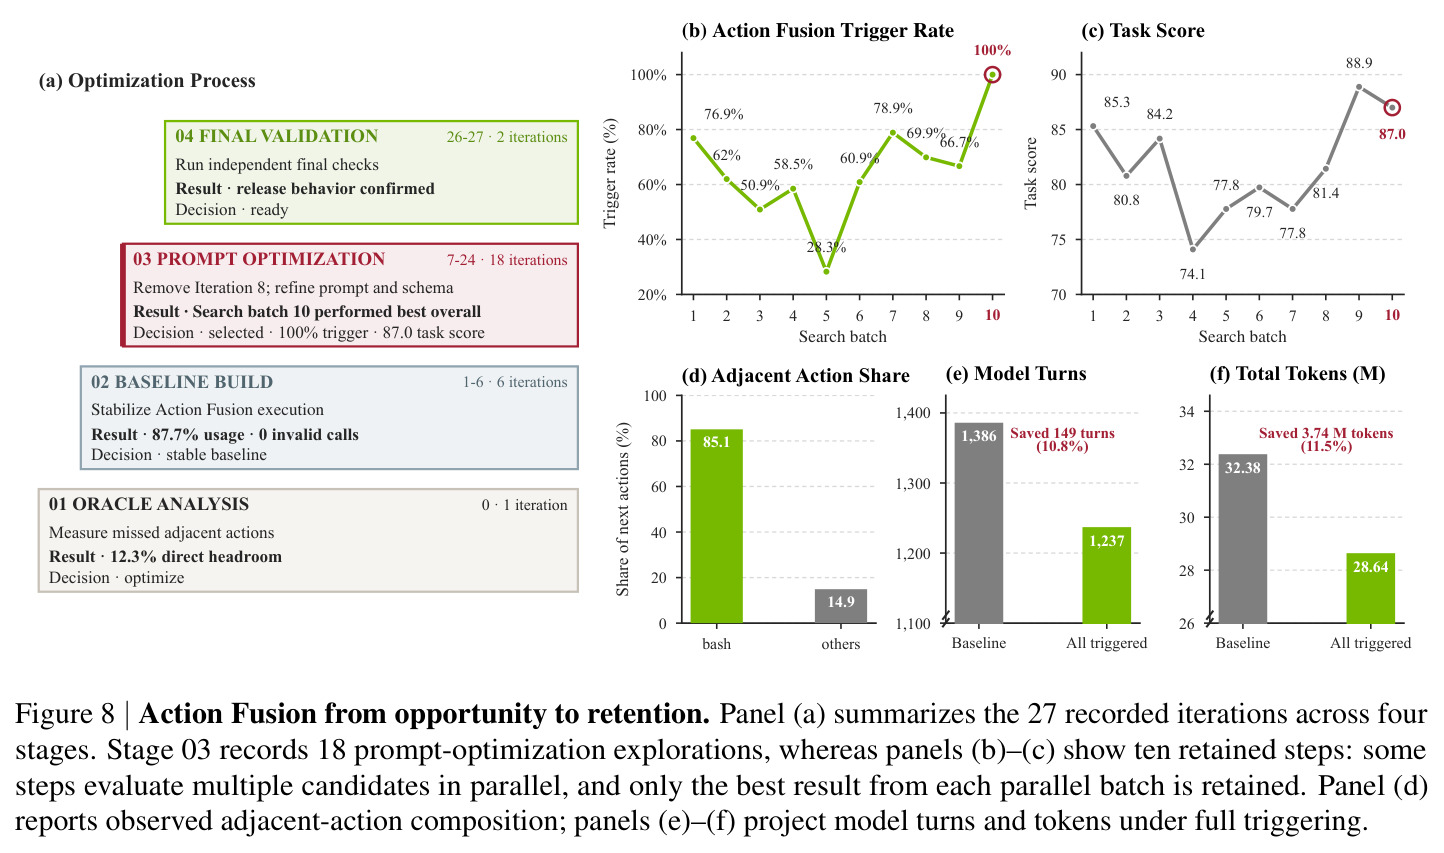
流程分八步。(1) Oracle Analysis:在开发轨迹中量化可避免的工作,例如发现 12.3% 的直接相邻动作(编辑后立即 build/run)值得合并,由此催生 Action Fusion 谱系。(2) 方向分配:152 个方向按六个提案家族组织,每个方向必须指认具体开销来源并提出对应 harness 改动。(3) 独立谱系运行:每个谱系是共享 skill 模板的一次性实例,按 Ralph Loop 式实现—评审循环推进,独立评审未通过则打回修订。(4) Map-Reduce 轨迹分析:多个分析器分别检查重复动作、上下文增长、超大观察与稀疏诊断信号,reducer 汇总为候选级结论指导下一轮提案。(5) 双门筛选:能力容差门加效率改进门,保留非支配解。(6) 集成四个机制并调超参。(7) 冻结源码、配置、指标、容差与验收规则。(8) 留出评估:EdgeBench 11 个任务做一次性准入,40 个做最终评估。四个机制的工作方式:Action Fusion 给文件修改工具加可选 then_run 命令,一次请求返回两次结果,API 调用从 3 降到 2;Online Context Compact 在 update_plan 的计划步完成边界估计剩余请求数,当投影节省 $\text{Savings} > \text{Cost}$(缓存重写开销按上下文规模与 cache 写/读价格比估算)或接近窗口上限时触发原生压缩;ObservationPack 对超过 10 KiB 的工具输出先原样发送 2 次请求,之后替换为稳定句柄加大小加约 1 KB 首尾摘录,可按需取回原文;Evidence-Preserving Reducer 把预设命令产生的 $\ge$4 KiB 构建日志交给低成本的 GPT-5.6 Luna 提炼成 receipt,确定性验证器检查 schema、源哈希、退出码、精确引文与大小,失败即回退原日志。
技术新颖性
技术新颖性有四点。第一,优化目标与层次新:把 token 效率当作 harness 层的一等验收目标,而现有自动化智能体设计(GEPA 反思改提示、ADAS/AFlow/AgentSquare 搜工作流与组件、DGM/Hyperagents 自改 agent 代码)很少以成本为筛选标准。第二,验收协议新:双门筛选加非支配保留加全程隔离的留出评估,直接回应了进化 harness 过拟合搜索任务的已知问题,是同类工作中少见的严格泛化设计。第三,规模化方式新:以可丢弃的 skill 模板谱系并行扩展搜索,单个谱系失败不影响其他实验;作者类比预训练提出 harness pretraining 的设想——让 harness 像模型一样见过足够多的任务与轨迹。第四,产物新:保留下来的不是提示模板而是可集成的工程机制,且论文展示自动研究能自发发明中间验收指标(Action Fusion 谱系自己引入 trigger rate 与任务分一起验收,最终达到 100% 触发率与 87.0 任务分),说明这类循环具备一定的元认知式自我改进能力。
实验结果
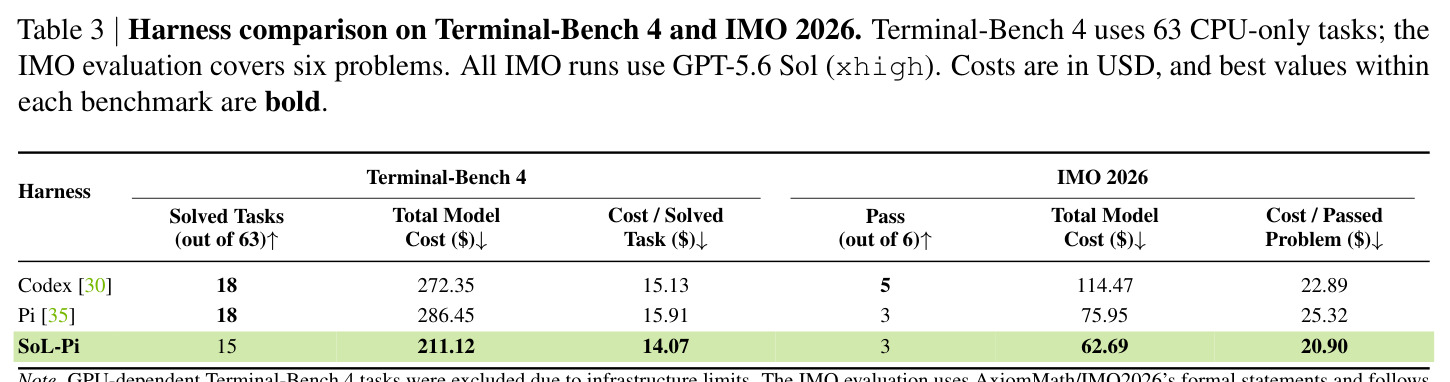
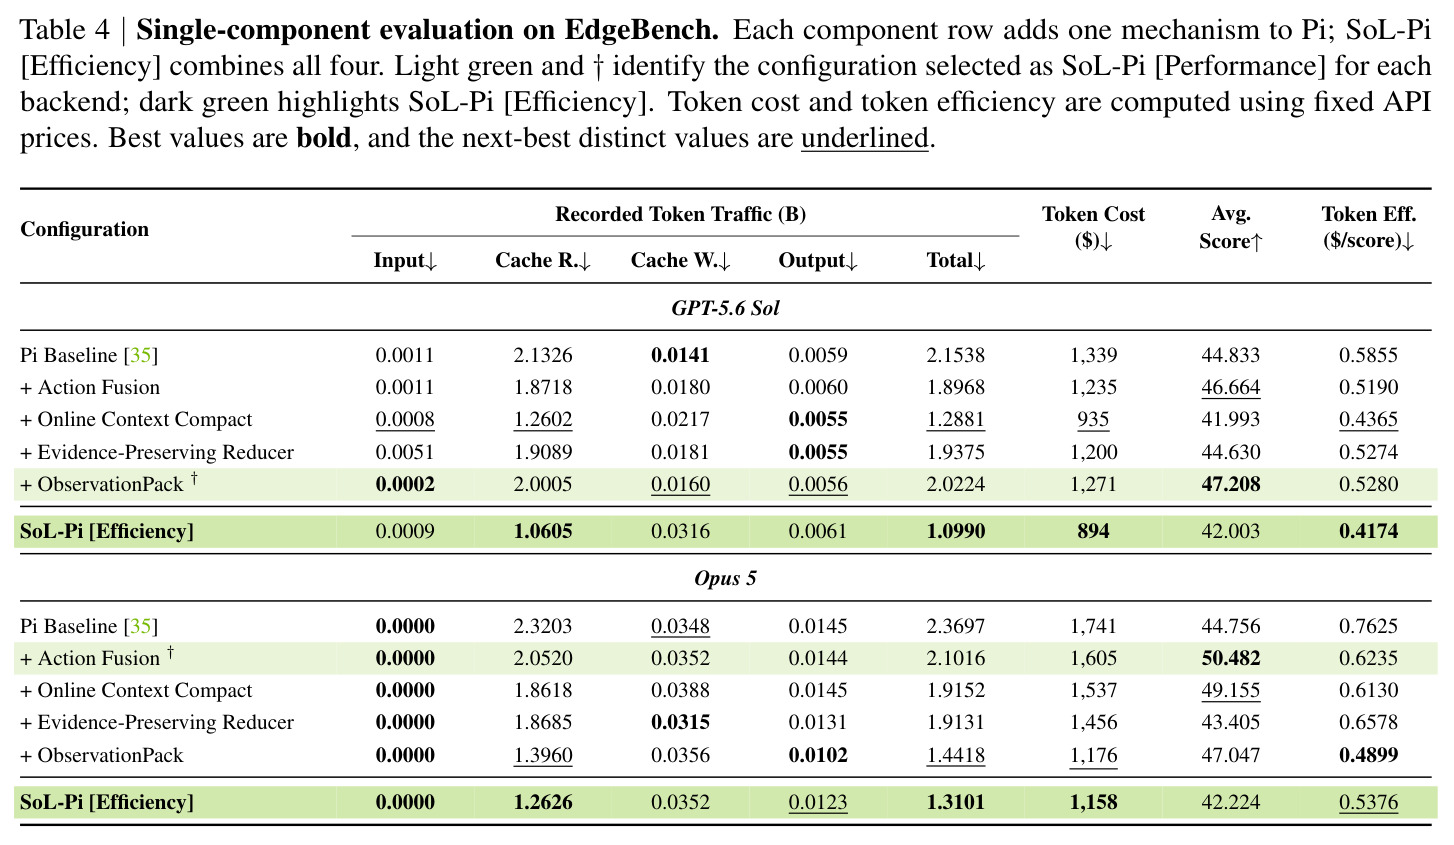
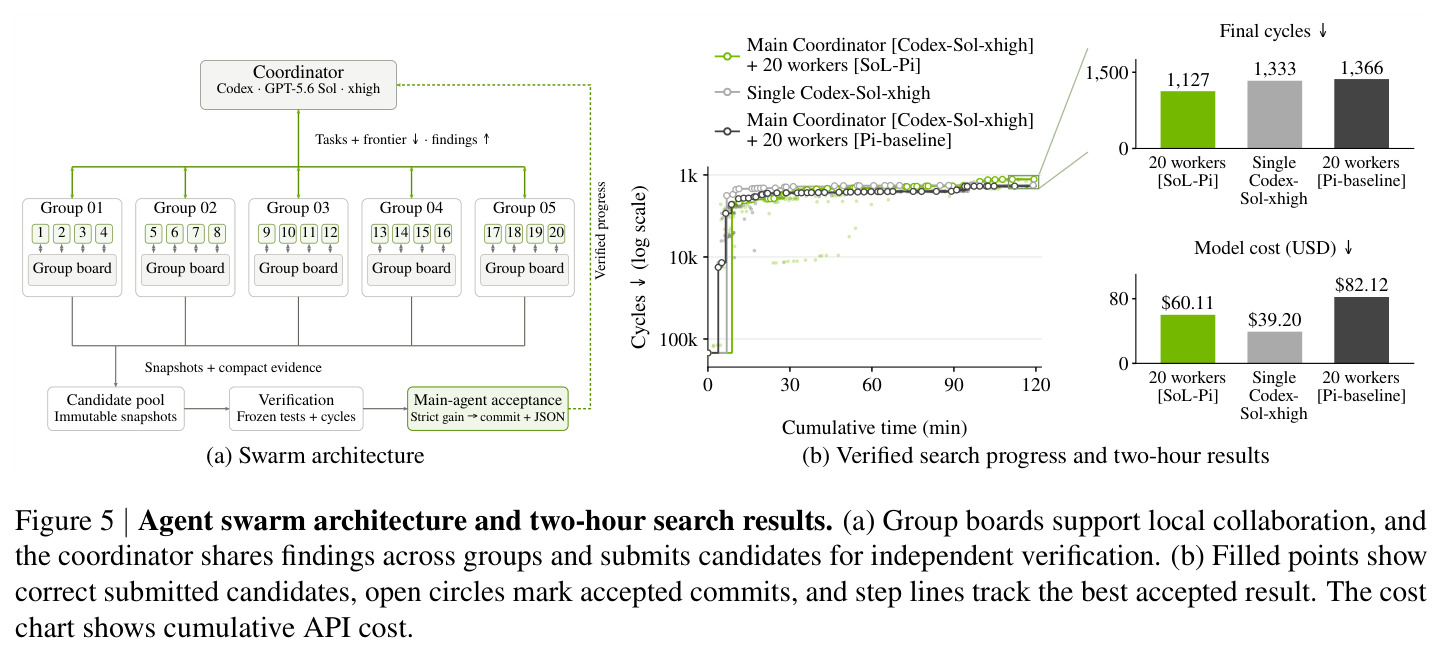
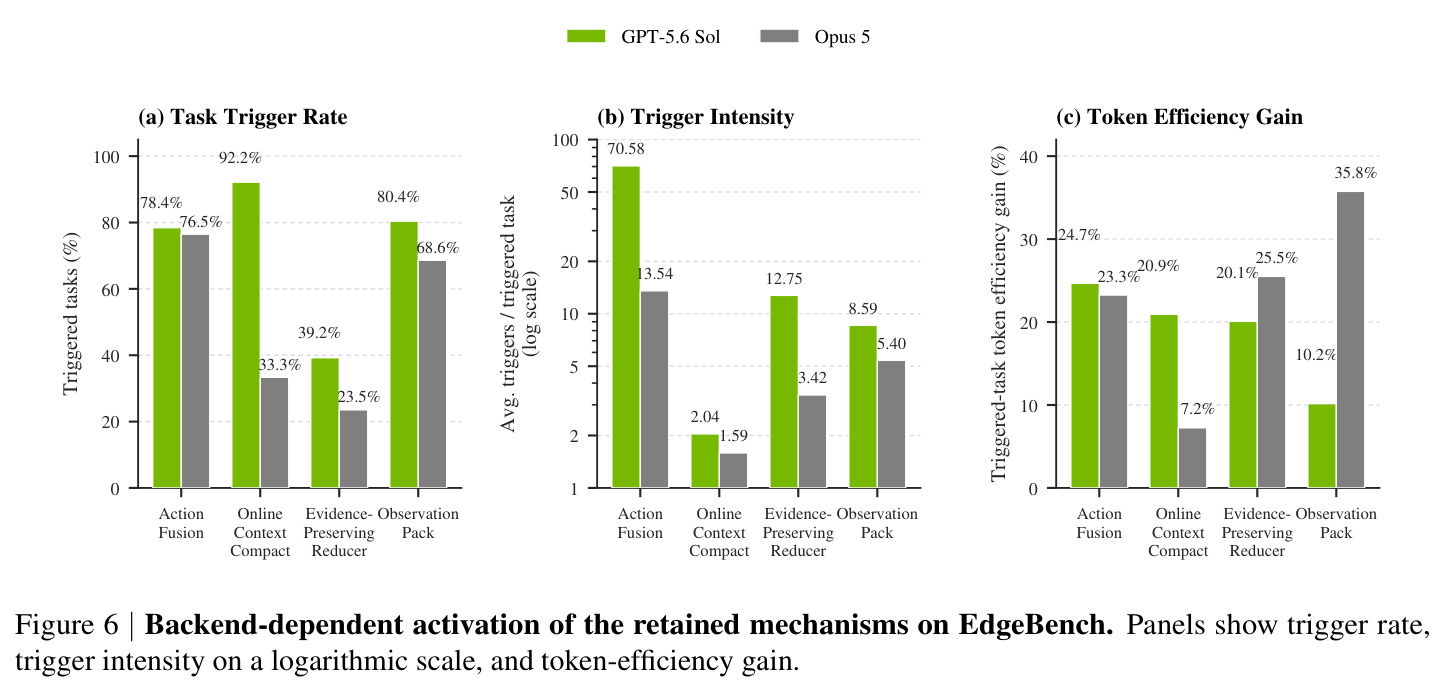
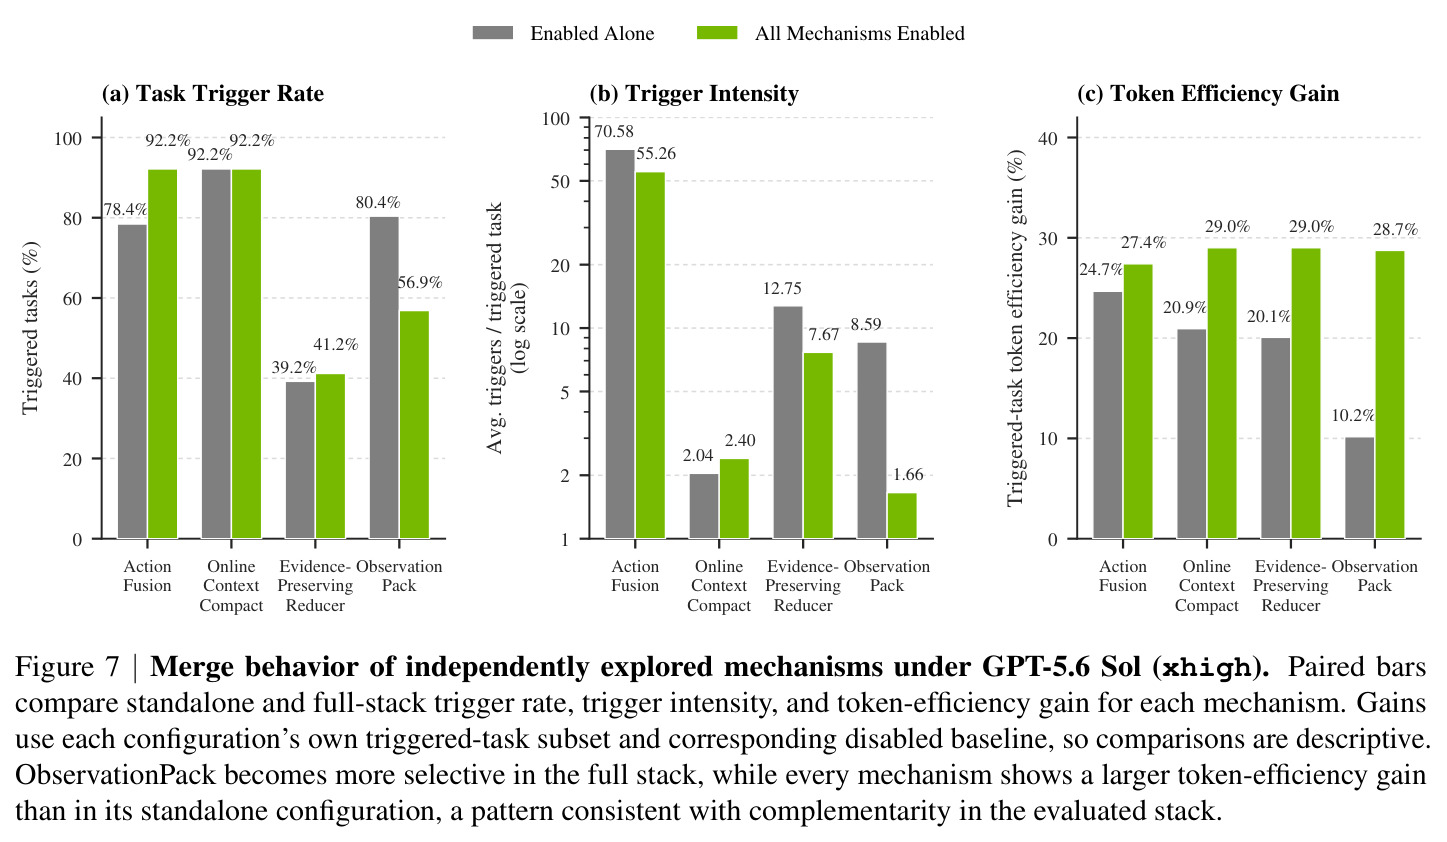
EdgeBench(51 个公开任务)是主战场。GPT-5.6 Sol 下:Pi 得 44.833 分、$1,339、2.1538B tokens;SoL-Pi[Efficiency](四机制全开)42.003 分(保留 93.7%)、$894(降 33.2%)、1.0990B tokens(降 49.0%),token 效率 $\$0.4174$/分 vs Pi 的 $\$0.5855$/分;SoL-Pi[Performance](单机制 ObservationPack)47.208 分(+5.3%)、$1,271、效率提升 9.8%。对比原生 Codex(34.7 分、$1,787)省 50.0%。Opus 5 迁移(无任何适配):SoL-Pi[Efficiency] 42.224 分(94.3%)、$1,158(较 Pi 的 $1,741 降 33.5%)、tokens 降 44.7%;Performance 点(Action Fusion)50.482 分(+12.8%);对比 Claude Code(43.7 分、$2,535)省 54.3%。折算每小时省 $8.75–$13.50(vs 原生)或 $4.36–$5.71(vs Pi)。Terminal-Bench 4(63 个 CPU 任务):SoL-Pi 解 15 题、$211.12,较 Pi(18 题、$286.45)总成本降 26.3%,单题 $14.07 最低。IMO 2026(Lean 4 验证):过 3/6 题、$20.90/题最低(Codex 5/6、$22.89;Pi 3/6、$25.32)。两小时内核优化 swarm:SoL-Pi 群 1,127 cycles/$60.11,较 Pi 群(1,366/$82.12)省 26.8%,且通过全部 8 个速度阈值(Pi 群只过 7 个)。消融(Table 4):四机制单独加入均降 tokens,Sol 下 ObservationPack 分最高(47.208),Opus 5 下 Action Fusion 分最高(50.482);合并后每机制的效率增益都大于单独使用(ObservationPack 33.3% 升至 56.9%),提示互补;缓存读 2.13B 降至 1.06B、写 0.014B 升至 0.032B,总成本仍降,说明应看全任务成本而非缓存命中率。总结:最佳候选提升 5.3–12.8% 分数与 9.8–18.2% 效率,完整栈在性能相当下省 44.7–49.0% tokens。
局限与改进
作者承认的局限:完整栈为效率牺牲了分数(GPT-5.6 Sol 下 42.0 vs Pi 的 44.8,约 6%);harness 只在 GPT-5.6 Sol 轨迹上优化,迁到 Opus 5 后各机制触发率与强度明显下降(如 Action Fusion 触发率 78.4% 降至 68.6%);搜索非常昂贵,无法在固定预算下做广度/深度受控对比,作者明确表示这些数字不构成 scaling law;机制间存在重叠,ObservationPack 在全栈中变得更保守,疑与 Reducer 在观察密集轨迹上职责重叠。我自己的观察:Terminal-Bench 4 解题数从 18 掉到 15,IMO 只过 3/6(Codex 过 5/6),说明效率栈在高难任务上有真实能力代价;swarm 虽比 Pi 群省 26.8% 成本,但最终 cycles(1,127)反而低于单 Agent(1,333),省钱的群体未必搜得更深;EdgeBench 只用了公开的 51/134 任务,代表性存疑;所有成本按 2026-08-17 API 价格计算,价格波动会改变结论;论文未报告多种子方差与显著性检验,1–3 分的分数差可能落在噪声区间内。
独立分析的弱点
独立分析的弱点与改进方向:(1) 效率栈的分数损失(42.0 vs 44.8)源于静态四机制组合的一刀切策略,可引入按任务/阶段自适应的机制门控(bandit 或轻量路由器),让高风险任务回退基线行为;(2) 跨后端触发率骤降说明机制参数与后端行为强耦合,改进方向是作者提出的多后端训练,或为每个后端学习一组条件化超参;(3) ObservationPack 与 Reducer 职责重叠导致全栈下触发变保守,可学习机制间的组合策略,或按输出类型做确定性分工;(4) Reducer 依赖另一个 LLM(GPT-5.6 Luna),引入额外延迟、费用与失败面,虽有确定性验证与回退,但可探索纯规则的证据抽取先行、LLM 只做兜底;(5) 评测只覆盖 EdgeBench 51 个公开任务且未报告方差,建议多种子重复实验并给出置信区间,同时把 134 个任务全集纳入评估;(6) 搜索成本高到无法做广度/深度消融,可先在小环境集上建立廉价的代理指标(如触发率乘以预估节省)来预测候选价值,从而降低搜索成本、支撑 scaling law 研究。
未来方向
作者提出的方向:(1) Pre-training the Harness——类比 LLM 预训练,让 harness 在海量任务与轨迹上持续更新,假设可执行环境数量与研究想法多样性的扩展能带来持续收益;(2) Multi-Backend Training——从多个 LLM 后端的轨迹中学习 harness,提升机制触发的稳定性与鲁棒性;(3) Recursive Efficient Improvement——用 SoL-Pi 作为下一轮自动研究的起始 harness,更低的单次运行成本让固定预算覆盖更多环境、轨迹与想法,效率既是研究产物也是扩大搜索的资源;(4) 系统研究搜索广度与深度在固定预算下的 scaling law。基于本文成果可延伸的方向:把四个机制抽象为上下文经济的通用原语,迁移到多模态与计算机操作类 agent;用强化学习或离线策略优化训练机制门控器;开放想法池与谱系模板,形成社区共建的自动 harness 生态;把成本感知纳入 agent 的行动规划器,在每次工具调用前预估 token 预算。
复现评估
复现评估:论文首页提供 Code 与 Blog Post 链接,四个机制实现为 Pi(开源编码 harness)的扩展,工程可读性较高;评测资产基本可得——EdgeBench 公开 51/134 任务、Terminal-Bench 4 公开、IMO 2026 使用 AxiomMath/IMO2026 的形式化陈述与 Humanfia 验证设置。复现四个机制本身难度中等:核心是 Pi 工具 schema 扩展(then_run)、计划步边界钩子、大输出归档与句柄检索、以及带确定性验证器的日志压缩(辅助模型为 GPT-5.6 Luna high)。但复现完整搜索非常昂贵:535 个环境需从 GitHub issue-PR 对构建前置仓库并验证 fail-pass 测试,共 3,000+ 次运行、6 万+ 次交互;仅一次 Pi 在 EdgeBench 的评测就花费 $1,339(GPT-5.6 Sol),全流程估计 $10^4 量级以上,且依赖 GPT-5.6 Sol、Opus 5 等闭源旗舰模型。结论:机制与评测可复现,端到端搜索建议只复现单条谱系——Action Fusion 案例的 27 次迭代、四阶段完整轨迹是很好的施工蓝图。
论文图表
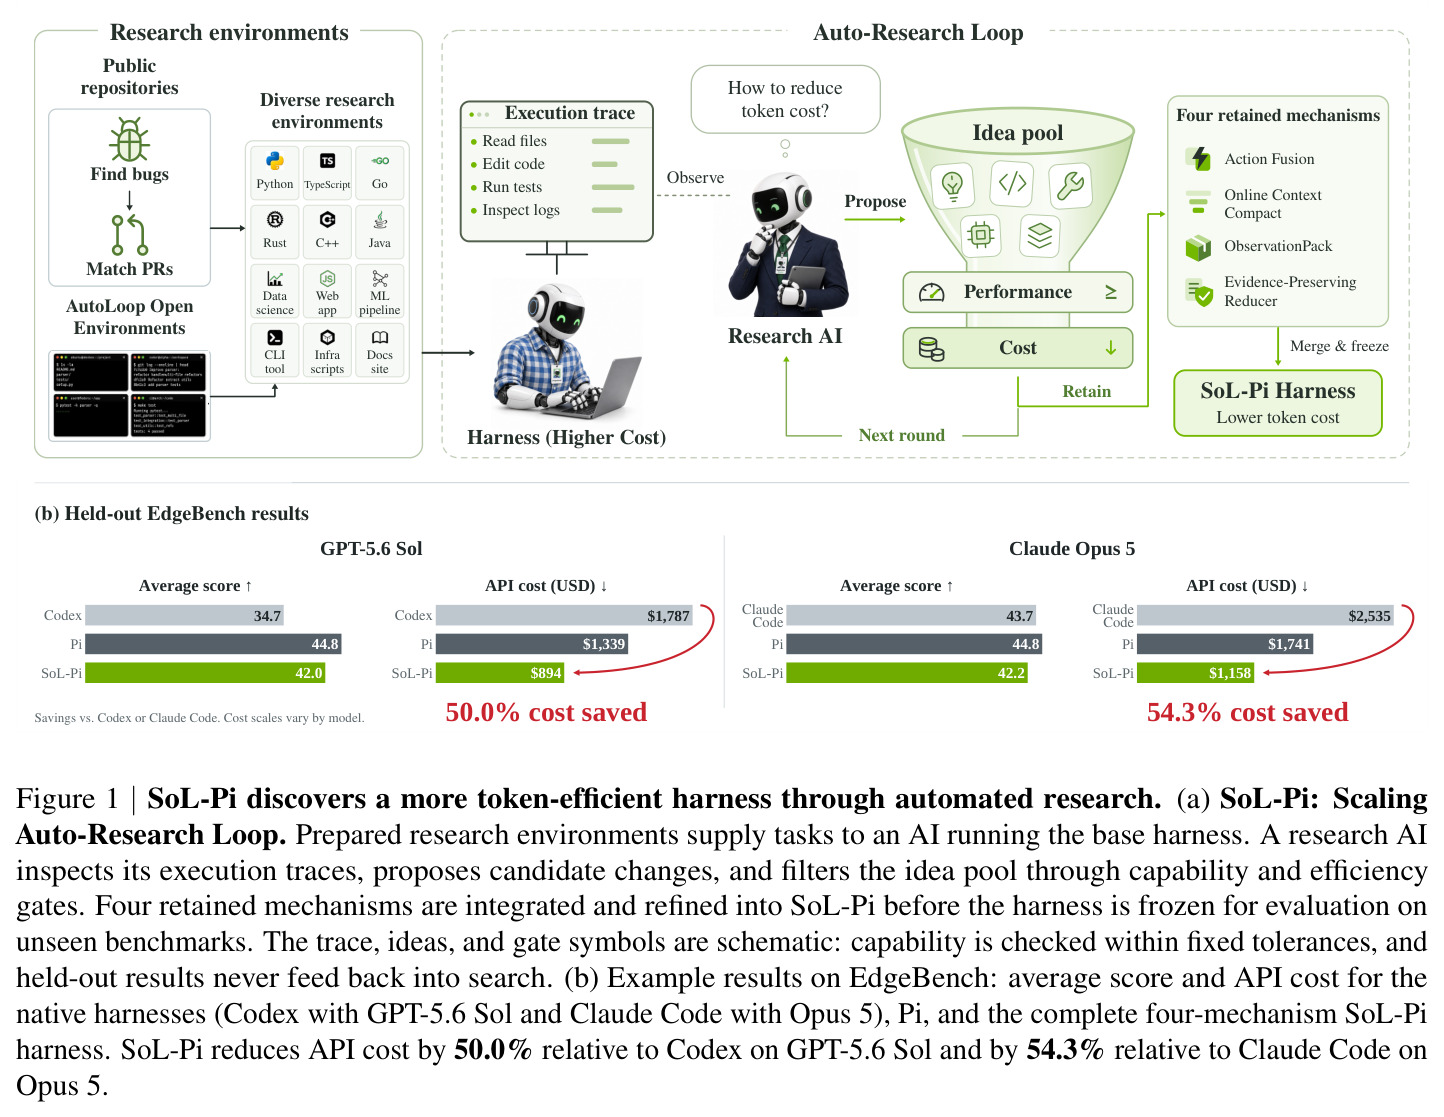
双面板总览图。(a) 展示 SoL-Pi 的自动研究循环:多样的研究环境(公共仓库、开源管线、web 应用、CLI、文档等)为运行基线 harness 的 agent 供任务,研究 AI 检查执行轨迹、提出候选改动,经能力门与效率门筛选想法池,最终四个保留机制集成并冻结为 SoL-Pi。(b) 给出 EdgeBench 上的关键结果条形图:GPT-5.6 Sol 下 Pi 44.8 分/$1,339,SoL-Pi 42.0 分/$894(较 Codex 的 $1,787 省 50.0%);Opus 5 下 Claude Code 43.7 分/$2,535,SoL-Pi 42.2 分/$1,158(省 54.3%)。
一图读懂全文:既给出问题框架(harness 层自动研究循环)又给出最重要的量化结论(约省一半成本),是向他人介绍论文时的首选入口。